Obsidian MCP Server
Servidor MCP auto-hospedado para Obsidian: busca semântica e de texto completo, grafo de wikilinks, CRUD de notas, OAuth e um guia de vault auto-descritivo.
Documentação
Servidor MCP do Obsidian

Um sistema de memória para seus agentes de IA — armazenado como markdown simples que você pode abrir no Obsidian.
Um servidor Model Context Protocol auto-hospedado que dá a cada agente que você conecta um lugar durável e compartilhado para lembrar das coisas. O armazenamento não é um banco de dados vetorial que você não consegue enxergar: é uma pasta de arquivos markdown no seu cofre do Obsidian, apoiada por busca de texto completo e semântica e pelo seu próprio grafo de wikilinks. O Obsidian é a janela humana para isso — abra uma nota, leia exatamente o que um agente escreveu sobre você, corrija, exclua ou leve a pasta inteira para outro lugar. Autodescritivo também — agentes leem o que você lê, linkam o que você linka e captam a estrutura da sua pasta, o esquema de frontmatter e as convenções de tags na primeira chamada em vez de serem instruídos do zero a cada sessão.
Para ser preciso sobre o escopo: o que o servidor fornece é armazenamento acessível via MCP, busca por palavras-chave e semântica, e operações de grafo sobre notas markdown, para quaisquer clientes MCP que você conectar. Os agentes direcionam suas próprias leituras e escritas. Não há extração automática, consolidação ou pipeline de decaimento rodando por trás deles — um agente lembra de algo porque escreveu uma nota e esquece porque alguém deletou uma.
Stack: Python 3.12, FastAPI, PostgreSQL com pgvector. Embeddings
plugáveis (Ollama bge-m3 ou OpenAI text-embedding-3-{small,large}).
Conteúdo
- Por que isso existe
- Uma sessão no teclado
- Uma sessão longe do teclado
- O que vem no pacote
- vs. outros servidores MCP do Obsidian
- Para quem é isso
- Painel de controle
- Início rápido
- Atualização
- Expectativas de custo
- O cofre autodescritivo
- Modo multiusuário
- Configuração
- Arquitetura
- Estrutura do projeto
- Desenvolvimento
- Notas de segurança
Por que isso existe
Há três coisas acontecendo aqui, e elas são mais interessantes juntas do que separadas.
1. Memória de agente que você pode realmente ler
Se você deixar um agente rodar por um tempo, ele precisa de memória. A maioria das configurações resolve isso com um armazenamento vetorial opaco, um blob SQLite ou um serviço de "memória" gerenciado que você não consegue enxergar. Isso funciona até você querer saber o que o agente acha que sabe sobre você, ou precisar corrigir algo, ou quiser entender por que ele acabou de fazer uma sugestão estranha.
Este servidor oferece um acordo diferente. A memória do agente vive como arquivos markdown no seu cofre. Estrutura de pastas, nomes de arquivos, frontmatter, tudo visível. Você pode abrir o arquivo no Obsidian e lê-lo. Você pode editá-lo. Você pode excluí-lo. Você pode usar grep nele. A "memória" do agente é um artefato auditável por humanos que fica no mesmo lugar que suas próprias notas, com as mesmas ferramentas disponíveis.
O laboratório doméstico é o caso de uso que me convenceu disso. Meu cofre tem notas sobre o rack, a rede e cada integração do Home Assistant. Eu posso dizer "configure um modo de luz noturna no banheiro principal, 1% depois das 23h" e um agente sysadmin encontra a configuração certa, faz a mudança e atualiza o documento na mesma passada. Seis meses depois, quando eu esqueci como funciona, a resposta está no cofre, não enterrada em algum histórico de chat que não consigo pesquisar.
A busca semântica e o grafo de wikilinks ainda funcionam sobre esse material, então a recuperação é rápida e conceitual. Mas o substrato são arquivos que você possui, não uma caixa preta.
2. Uma camada de memória compartilhada entre você e seus agentes
A outra metade funciona no sentido contrário: o cofre não é apenas a memória dos agentes, é a minha. Eu penso no meu cofre do Obsidian como meu exocórtex. O "eu grande", que inclui notas, calendários, scripts, busca e assistentes de IA, é substancialmente mais capaz do que o "eu pequeno" do cérebro biológico sozinho. Também é onde eu faço a maior parte do meu pensamento, porque escrever algo é em si uma forma de pensamento.
O problema é que, até recentemente, o cofre era passivo. Eu tinha que ir procurar as coisas. Agentes que queriam me ajudar tinham que ser instruídos do zero a cada sessão, e não tinham como ver o que eu já havia escrito sobre um tópico.
Este servidor resolve isso. Agora o mesmo cofre alimenta minha escrita diária e qualquer agente que eu conecte a ele. O agente lê o que eu leio, linka o que eu linko, segue os mesmos wikilinks, vê o mesmo frontmatter. Quando eu escrevo uma nota de projeto no domingo, meu agente de briefing de segunda-feira de manhã já sabe disso. Quando o agente deixa notas de uma sessão de pesquisa, elas aparecem na minha busca normal do Obsidian.
Uma versão concreta disso: eu passo uma sessão no Claude Code em um projeto, finalizo, envio os commits e depois apenas digo "atualize o Obsidian." O agente lê o guia do cofre, descobre onde as notas de projeto vivem na minha estrutura, escolhe o formato e frontmatter certos e deixa um registro de sessão que eu posso depois transformar em um relatório de status. Sem passar caminhos, sem dizer a ele o que escrever — as convenções já estão no cofre, e ele as segue.
Essa é a ideia do exocórtex tornada concreta: um lugar que guarda contexto, e tanto o humano quanto os agentes lendo e escrevendo nele nos mesmos termos.
3. O cofre segue você
A coisa que ainda me surpreende é que isso é voltado para a internet. Mesmo cofre, mesmas notas, acessíveis de qualquer lugar onde eu esteja falando com um agente — Claude em uma aba do navegador, Claude no meu celular no trem, um fluxo de trabalho n8n disparando em um agendamento, uma sessão do Claude Code em qualquer laptop à minha frente. Tudo atrás de OAuth ou uma chave bearer, tudo atingindo a mesma fonte de verdade.
Então, quando ouço um podcast interessante no trajeto e quero pensar em voz alta sobre isso com o Claude no meu celular, o agente não está começando do zero. Ele pode puxar o que eu já escrevi sobre tópicos adjacentes, trazer à tona uma nota que deixei pela metade há seis meses e, no final da conversa, sugerir atualizações e escrevê-las. O cofre não precisa estar perto de mim para ser a coisa na qual estou trabalhando. (Uma sessão longe do teclado mostra exatamente um desses casos.)
Uma sessão no teclado
Para tornar o abstrato concreto, uma transcrição curta de uma sessão real. Chamadas de ferramentas inline; o usuário digita em inglês simples e o agente escolhe a ferramenta certa.
you  > find anything I've written about why retrieval-augmented
       chat is hard

claude
  → semantic_search(query="why retrieval-augmented chat is hard")
    • 2025-12-03 - RAG failure modes.md
    • 2025-10-18 - Chunking tradeoffs.md
    • 2024-06-22 - Vector recall vs precision.md

  the closest hit is your December note on RAG failure modes. let
  me see what it's connected to.

  → get_neighborhood(path="2025-12-03 - RAG failure modes.md",
                     depth=1)
    8 connected notes. notable ones:
    • "Hybrid search" — a re-ranking design you sketched but
      didn't ship
    • "Out-of-distribution queries" — a half-finished draft from
      October
    • "Embedding model choice" — links to bge-m3, your current
      model

  you have three connected pieces here: a failure-modes catalog,
  an unshipped hybrid-search sketch, and an abandoned O-O-D draft.
  want me to summarize all three together, or pull up the draft
  so you can decide whether to finish it?

you  > pull up the draft, and tag it #revisit-2026 in frontmatter
       while you're there

claude
  → read_note(path="2025-10-18 - OOD queries (draft).md")
  → set_frontmatter(
      path="2025-10-18 - OOD queries (draft).md",
      updates={"tags": ["draft", "rag", "revisit-2026"]}
    )

  here's the draft, and the tag is on. you stopped right before
  the section on confidence thresholds; the open question you
  left yourself was…
Duas coisas para notar. Primeiro, o agente não precisou ser informado em qual
pasta procurar ou quais ferramentas usar — ele escolheu. Segundo, a
escrita no final é estruturada (set_frontmatter mutando YAML, não
um regex sobre o corpo do arquivo), então a nota faz o ciclo completo de forma limpa. O
cofre autodescritivo e o grafo de wikilinks estão fazendo o trabalho que
torna isso natural.
Uma sessão longe do teclado
A transcrição acima é o caso fácil: estou em uma mesa, posso ver o que o agente está fazendo, e o Obsidian está a um alt-tab de distância. A sessão que realmente mudou como eu penso sobre este servidor não tinha nada disso.
Eu estava caminhando com um podcast de saúde nos ouvidos — um longo, duas pessoas que claramente discordavam uma da outra, uma hora disso. Eu tinha meu celular e nenhuma intenção de voltar para casa para um laptop. Então puxei a transcrição do episódio, entreguei ao Claude no meu celular e conversamos sobre isso enquanto eu continuava caminhando: qual era a afirmação real, quais partes eu já tinha notas, onde isso contradizia algo que eu havia decidido meses atrás e escrito na época.
O agente teve o cofre o tempo todo. Ele trouxe à tona o que eu já havia escrito sobre o tópico, sinalizou que duas datas em uma nota mais antiga estavam erradas e perguntou se uma decisão que eu havia registrado no ano passado ainda valia dado o que o episódio argumentava. Quando voltei, ele já tinha escrito tudo: as decisões de saúde que eu realmente havia tomado durante a caminhada, as correções de datas na nota antiga, algumas novas notas sobre o episódio em si — e, porque a conversa continuava voltando a isso, uma nota durável sobre como eu decido em quais especialistas confiar em questões médicas em primeiro lugar. Essa última é o artefato ao qual continuo voltando. Não era sobre o episódio; era o raciocínio por trás de toda uma classe de decisões, e agora está no cofre onde o próximo agente o encontrará.
Nunca abri o Obsidian. Nem na caminhada, nem quando cheguei em casa. A sessão inteira — recuperação, argumento, correção e a escrita que saiu dela — passou por um agente, e o cofre é simplesmente onde ela pousou. O Obsidian é como eu verifico o trabalho depois, não como o trabalho é feito. Essa inversão é a maior parte da razão pela qual este projeto parece do jeito que parece.
O que vem no pacote
O servidor expõe 25 ferramentas MCP em cinco famílias, além da camada de autenticação e operações ao redor delas.
Busca e descoberta
keyword_search(query, folder?, tags?, frontmatter?, limit=20), texto completo via PostgreSQLtsvector; as configurações de busca de texto são configuráveis viaFTS_CONFIGS(veja Idioma(s) da busca de texto completo)semantic_search(query, folder?, tags?, frontmatter?, limit=15), similaridade vetorial via pgvector, um trecho de pré-visualização por notalist_notes(folder?, limit=50), ordenado por tempo de modificaçãoget_recent(folder?, limit=20), alterados recentementeget_tags(limit=50), tag e contagemget_vault_guide(), o guia básico do Obsidian mais oCLAUDE.mddeste cofre, servido ao vivo
Leitura e escrita
read_note(path, section?, offset=0, limit?)retorna um resultado estruturado —path,title,tags,frontmatter_yamle uma visão JSONfrontmatter,heading(leituras de seção),contente truncamento como dados (truncated,offset,next_offset,total_chars,outline,notice). Limitado porMAX_READ_RESPONSE_CHARS(padrão 40.000) — veja Limites de tamanho de resposta.section=<heading>retorna o corpo de uma seção em vez da nota inteira;offsetcontinua uma leitura truncada.create_note(path, content), escrita atômica, recusa sobrescritaedit_note(path, …)com quatro modos mutuamente exclusivos: substituição completa (padrão),append=True,find=…(com opcionalreplace_all) ousection=<heading>(cabeçalhos ATX, suportaParent/Childestilo caminho e#Ndesambiguação ordinal).dry_run=Trueretorna um diff unificado sem escrever. Clientes legados podem usaroperation="append";operation="replace"seleciona explicitamente substituição completa.move_note(from_path, to_path, rewrite_links=False), realoca e opcionalmente reescreve referências recebidas[[Old]],[[Old|alias]],[[Old#anchor]],![[Old]]e[[folder/Old]]em notas de origemdelete_note(path, permanent=False), exclusão suave para.trash/<YYYYMMDD-HHMMSS>-<basename>-<8 hex>por padrão, via um único rename sem substituição, então nunca sobrescreve uma entrada de lixeira existente (um sistema de arquivos que não consegue fazer esse rename faz a exclusão suave recusar com um erro nomeado em vez de cair em fallback).permanent=Truedesvincula.set_frontmatter(path, updates, remove?), mutação estruturada de YAML. O corpo fica byte-idêntico quando apenas o frontmatter muda.
Acesso a arquivos (não-Markdown)
Leitura/escrita/navegação bruta de arquivos arbitrários do vault (PDFs, imagens, assets de habilidades, arquivos de dados) — peers distintos das ferramentas de notas, que permanecem somente-Markdown. Transporte de bytes puro: sem extração de PDF/texto no servidor, sem incorporação ou indexação de arquivos não-Markdown.
read_file(path, encoding="auto", offset=0, limit?), retorna arquivos semelhantes a texto como texto, imagens como um bloco de imagem inline que renderiza no cliente, e outros binários como uma string base64.text/base64forçam a forma. Recusa arquivos acima deMAX_FILE_READ_BYTES(padrão 10 MB); resultados de texto são adicionalmente limitados porMAX_READ_RESPONSE_CHARSe continuam viaoffset.hash_only=Trueretorna ocontent_hashdo arquivo inteiro sem conteúdo; resultados base64 incluem esse hash em seu cabeçalho. Resultados de texto permanecem como texto simples.write_file(path, content, encoding="base64", overwrite=False), coloca um arquivo no vault; base64 para binário,textpara UTF-8. Sem sobrescrita por padrão, cria automaticamente diretórios pais, escrita atômica. Limitado aMAX_FILE_WRITE_BYTES(padrão 25 MB).list_files(folder=".", pattern="*", recursive=False, limit=200), navegação estilolsde arquivos e subdiretórios com tamanho e mtime, filtrável por glob e com limite de resultados.delete_file(path, permanent=False), exclusão suave de um arquivo não-Markdown para.trash/<YYYYMMDD-HHMMSS>-<basename>-<8 hex>com um único rename atômico. Recusa Markdown (isso édelete_note), diretórios e symlinks.
Todos os quatro reutilizam a proteção contra travessia de caminho e excluem qualquer caminho com um componente começando com . (diretórios-ponto e arquivos-ponto) (.obsidian, .git, .trash, …), correspondendo à regra de visibilidade do indexador.
Protegendo edições contra leituras obsoletas
Passe o content_hash de uma leitura como expected_hash ao editar, atualizar frontmatter, mover ou excluir uma nota, sobrescrever um arquivo bruto ou excluir um arquivo bruto. O token canônico é sha256:<64 lowercase hex>, calculado sobre os bytes completos do arquivo bruto; um read_note de seção ou truncado ainda retorna o hash do arquivo inteiro. Para arquivos brutos, use read_file(hash_only=True) ou o cabeçalho base64. Não faça hash do texto retornado você mesmo.
Um token obsoleto recusa a operação antes da mutação, com uma linha JSON final MCP-REFUSAL nomeando stale_precondition e o hash atual. Releia e reconsidere a edição antes de tentar novamente. Movimentos vinculam apenas a nota de origem; movimentos e exclusões ainda permitem uma edição in-place após sua comparação de pré-voo. Sobrescritas mantêm sua verificação de bytes separada dentro da chamada. Publicações de escrita bem-sucedidas relatam um novo hash quando disponível.
O argumento é opcional por padrão. WRITE_PRECONDITION_REQUIRED=true o exige nas chamadas destrutivas suportadas; habilite isso somente após os clientes fornecerem tokens. Criação é isenta e recusa um token fornecido como no_incumbent. Arquivos acima do limite de leitura não podem ser protegidos.
Transferência de arquivos
Nenhum cliente MCP pode entregar a uma ferramenta os bytes de um arquivo que o usuário está olhando, então write_file só é utilizável quando o agente já tem o conteúdo. Essas ferramentas fecham essa lacuna com links de capacidade de curta duração, resgatados sobre as rotas públicas /transfer/*.
request_upload(path, overwrite=False, expires_in?), gera um link de uso único vinculado a exatamente um caminho de destino. O humano abre, escolhe um arquivo, e ele chega empath— nada mais pode ser escrito com ele.check_upload(upload_id), relatapending/uploading/completed(com caminho, tamanho, sha256 e MIME) /unknown(um stream iniciado e o servidor nunca registrou como terminou — leia o caminho antes de re-cunhar) /revoked(a credencial ou a raiz do vault mudou sob o link) /expired, escopado à identidade que o cunhou.request_download(path, expires_in?), gera um link que o humano pode usar para salvar um arquivo do vault. Utilizável mais de uma vez até expirar, e vinculado aos bytes exatos do arquivo no momento da cunhagem.import_from_url(url, path, overwrite=False), busca um asset https público diretamente no vault sob uma política explícita de negação de saída (sem endereços privados, loopback, link-local, metadata ou tunelados, em qualquer grafia, re-verificados a cada redirecionamento).
O token viaja no fragmento da URL, que navegadores nunca enviam, então nenhum alvo de requisição gerado pelo servidor ou log de acesso o contém. Uploads são reivindicados antes de um byte do corpo ser lido, publicados atomicamente com semântica de não-sobrescrita, e vinculados no momento da cunhagem ao estado do arquivo contra o qual foram cunhados — um link não pode silenciosamente desfazer uma edição feita enquanto esperava. MCP_HOSTNAME ou BASE_URL devem estar definidos; sem uma origem pública, as ferramentas de cunhagem recusam em vez de emitir um link localhost.
Grafo de wikilinks
get_backlinks(path, limit=50), notas que linkam PARApathget_links(path), links de saída, tanto resolvidos quanto pendentesget_neighborhood(path, depth=1, limit=50), BFS não direcionado sobre o grafo de links resolvidos, limitado a profundidade ≤ 5 e limite ≤ 200find_related(path, limit=10), vizinhos semânticos via embeddings de chunk médios e distância de cosseno pgvector, deduplicados por notafind_orphans(folder?, limit=50), notas com zero links resolvidos de entrada ou saída
Autenticação e operações
- Chaves de API com o prefixo
omcp_, armazenadas como hashes SHA-256, com escopos de permissãoreadereadwrite. Ferramentas de escrita recusam em chaves somente-leitura. - Fluxo OAuth 2.0 PKCE (S256) para clientes públicos e confidenciais, incluindo ChatGPT, Claude Desktop e claude.ai. Registro dinâmico padrão para ambos os níveis de permissão do vault; o usuário escolhe a concessão real na tela de consentimento.
- Painel de controle (Jinja2, CSS escrito à mão, Chart.js fornecido, CSP baseado em nonce) para chaves, logs de uso, status do indexador, informações do provedor de embeddings e um reset de zona de perigo.
- Cada chamada de ferramenta é registrada em
usage_logscom nome, parâmetros (truncados a 200 caracteres), duração, tamanho da resposta e o nome da credencial chamadora — registrado no momento da chamada, então a trilha de auditoria sobrevive à exclusão da chave ou cliente OAuth que descreve. /healthé não autenticado e retornastatusmais dois campos de capacidade:transfer_mount_check_available(o kernel suporta a verificação de montagem que transferências de escrita precisam) evault_named_staging_fallback_active(uma escrita realmente foi encenada sob um nome neste processo)./healthtambém carrega um objetoindexer(status,task_running,failing_scopes,embedding_failing_scopes,max_consecutive_failures,quarantined_notes,last_success_at), e ostatusde nível superior torna-se"degraded"quando a tarefa do indexador morreu, qualquer contador de falha de índice, embedding ou enumeração — ou a execução de re-derivações incompletas de um escopo — atingeINDEXER_DEGRADED_AFTER_FAILURES, ou uma nota é colocada em quarentena. O código HTTP permanece 200 — um reinício não pode reparar o conteúdo do vault ou uma interrupção do provedor, e Kubernetes usa/healthpara liveness — então monitore o campostatus(uma verificação de palavra-chave ou JSON para"status":"ok"), não o código de status. Apenas contagens: sem caminho, texto de erro ou id de usuário.
Cada escrita — ferramentas de notas, write_file, uploads e importações — encena os novos bytes em um inode temporário, fsync-os, e só então publica. Criação publica com um hard link atômico do kernel que recusa sobrescrever; move_note e a exclusão suave publicam com um único rename não-substituinte; uma sobrescrita é um rename no mesmo diretório sobre o destino. O diretório de destino (e qualquer diretório que a chamada criou) é fsync-ed depois, então uma falha no meio da escrita não pode truncar uma nota nem perder uma que o servidor relatou como escrita.
A encenação acontece em um inode sem nome onde o sistema de arquivos suporta um, então nenhum nome temporário é visível no vault. Em uma montagem que recusa isso (alguns exports NFS fazem), essas escritas recusam com um erro nomeando VAULT_ALLOW_NAMED_STAGING_FALLBACK; definir essa flag traz a encenação nomeada de volta em ambos os caminhos de escrita como uma garantia declarada e mais fraca. Veja Requisitos do sistema.
vs. outros servidores MCP do Obsidian
Existem vários servidores MCP existentes para Obsidian, e a maioria deles resolve um problema diferente deste. Os leves são cola sobre o plugin Local REST API do Obsidian ou o sistema de arquivos: eles permitem que um agente alcance os arquivos, mas não constroem nenhuma infraestrutura própria. Eles são ótimos se "eu só quero que o Claude leia minhas notas" é o objetivo e você mantém o Obsidian rodando localmente.
Este servidor está no outro extremo do espectro: um backend real com um índice persistente, recuperação semântica, um grafo de wikilinks, OAuth e uma UI administrativa. O custo é Postgres e Docker. O benefício é tudo que você pode construir em cima disso.
| Este servidor | MarkusPfundstein/mcp-obsidian | StevenStavrakis/obsidian-mcp | jacksteamdev/obsidian-mcp-tools | |
|---|---|---|---|---|
| Índice persistente (Postgres) | ✅ | — | — | — |
| Busca semântica (vetores) | ✅ | — | — | — |
| Consultas de grafo de wikilinks | ✅ | — | — | parcial |
| Roda sem Obsidian aberto | ✅ | — | ✅ | — |
| Fluxo de cliente OAuth 2.0 | ✅ | — | — | — |
| Vaults multi-usuário / por usuário | ✅ | — | — | — |
| UI administrativa + logs de uso | ✅ | — | — | — |
| Escritas atômicas + diffs de dry-run | ✅ | — | — | — |
| Custo de configuração | Postgres + Docker | Obsidian + plugin REST | Somente Python | Plugin Obsidian |
A comparação reflete os recursos documentados de cada projeto no momento da escrita; verifique os detalhes antes de apostar neles.
vs. sistemas de memória hospedados
A comparação que importa mais, agora que a maior parte do meu tráfego no vault é de agentes em vez de mim, é contra memória como um serviço: seu agente chama uma API, o serviço armazena o que é dito, e devolve o que julga relevante depois. mem0, Zep e Letta são os nomes que as pessoas geralmente usam. O que segue é sobre essa arquitetura — memória atrás de um limite de serviço — não sobre a lista de recursos atual de qualquer produto, que se move mais rápido do que um README pode acompanhar.
A diferença é onde a memória vive e quem pode abri-la.
- Legibilidade. Quando a memória está atrás de uma API de serviço, lê-la significa qualquer endpoint ou console que o serviço expõe, na forma que armazena. Aqui a memória é o artefato:
Health/2026-08 - Trusting expertise.md, em uma pasta, no seu editor, emgrep. Não há lacuna entre o que o agente armazenou e o que você pode olhar. - Compartilhada com você e entre agentes. Um serviço de memória é geralmente escopado a um aplicativo e seus usuários; a escrita do próprio humano é um sistema diferente. Aqui é um corpus único. Eu escrevo nele manualmente, e cada cliente conectado — Claude Desktop, Claude Code, Claude no telefone, um workflow n8n — lê e escreve os mesmos arquivos nos mesmos termos. Uma nota que digito no domingo é contexto para um agente na segunda sem etapa de importação.
- Portabilidade. O caminho de saída de uma pasta de markdown é
cp -r. Sem formato de exportação, sem script de migração, sem pergunta sobre o que você ficaria segurando se um projeto parasse de ser mantido. Isso é uma propriedade de arquivos, não algo que este servidor faz por você. - Autodescrição. As regras vivem no corpus em vez de na configuração do cliente.
CLAUDE.mdna raiz do vault diz a cada agente, na sua primeira chamada, onde as coisas vão e qual frontmatter carregam, então convenções são versionadas ao lado das notas que governam.
O que a forma hospedada compra em troca é real e vale a pena dizer claramente. Não há Postgres para rodar, nenhuma versão de pgvector para manter atualizada, nenhum contêiner para cuidar — você obtém uma camada de memória adicionando uma dependência, que é um trade genuinamente melhor para a maioria das pessoas. E sistemas nessa classe tipicamente fazem trabalho que este servidor deliberadamente não tenta: extrair fatos de uma conversa automaticamente, reconciliar os que se contradizem, e pontuar relevância ou decair memórias antigas para que não empurrem as novas. Aqui um agente lembra algo porque decidiu escrever uma nota, e o julgamento sobre o que vale manter é do agente, não do servidor. Se você quer memória que se cura sozinha, essa é uma razão justa para escolher a outra forma.
vs. um agente com acesso bruto a arquivos
A outra linha de base não é um servidor MCP: aponte o Claude Code, um MCP de sistema de arquivos genérico ou qualquer agente com ferramentas de arquivo diretamente para a pasta do cofre. Isso funciona — até que uma gravação dê errado. Um agente que reescreve um arquivo inteiro a partir de sua memória de uma leitura anterior acabará sobrescrevendo uma nota, seguindo um symlink para onde não deveria ou "organizando" sua configuração .obsidian. Nada em uma API de arquivo bruta oferece resistência. O caminho de gravação deste servidor é moldado exatamente por esse tipo de incidente e assume que o chamador acabará fazendo algo errado:
- Edições direcionadas em vez de reescritas.
edit_notepode abordar uma string de busca ou uma seção única em vez de substituir o arquivo, edry_run=Trueretorna o diff unificado antes que qualquer coisa seja aplicada.set_frontmattermuta YAML estruturalmente e deixa o corpo byte-idêntico. - Padrões sem sobrescrita.
create_noteewrite_filerecusam sobrescrever um arquivo existente; substituir um é uma opção explícita. - Gravações atômicas. O conteúdo é preparado e renomeado no lugar contra um descritor aberto no momento da validação — uma nota nunca fica meio escrita, e o arquivo que é substituído é o arquivo que foi verificado.
- Exclusões reversíveis.
delete_noteedelete_filefazem exclusão suave para.trash/com um rename sem substituição;permanent=Trueé a saída de emergência explícita, não o padrão. - Contenção comprovada pelo kernel. Os caminhos são resolvidos sob a raiz do cofre via
openat2(RESOLVE_BENEATH | RESOLVE_NO_SYMLINKS | RESOLVE_NO_MAGICLINKS), gravações recusam um symlink como componente final, e diretórios de ponto (.obsidian,.git,.trash) estão fora do alcance de toda ferramenta. - Respostas limitadas. Leituras são limitadas e a truncagem é dados (
truncated,next_offset, um esboço) em vez de perda silenciosa, então uma nota enorme não pode inundar o contexto de um agente em uma edição ruim. - Uma trilha de auditoria. Cada chamada é atribuída a uma chave e registrada; o painel de controle mostra quem tocou no quê e quando.
Quando um agente se comporta mal através deste servidor, você recebe uma chamada recusada, um diff, uma entrada na lixeira e uma linha no log de uso. Quando ele se comporta mal com acesso bruto a arquivos, você recebe o que git diff puder recuperar — se o cofre estivesse no git.
Para quem é isso
- Pessoas de homelab que já rodam Postgres e Docker, ou estão dispostas a configurá-los. O custo de configuração é o preço de entrada para as camadas semântica e de grafo.
- Pessoas que mantêm um cofre opinativo — lógica de posicionamento de tarefas, esquemas de frontmatter, taxonomia de tags — e querem que agentes sigam essas convenções na primeira chamada em vez de serem instruídos a cada sessão.
- Qualquer pessoa rodando mais de um cliente MCP (Claude Desktop, Claude Code, Claude no navegador, n8n) contra as mesmas notas e cansada de reexplicar o cofre para cada um.
- Pessoas que querem que a memória do agente viva como arquivos markdown simples que possam ler, editar, usar grep e versionar, não em um armazenamento vetorial opaco ou um serviço de memória gerenciado.
Para quem não é
- "Só quero que o Claude leia minhas notas" com a configuração mais leve possível. Use um dos projetos de cola de sistema de arquivos acima; você não precisa disso.
- Qualquer pessoa que não queira rodar um banco de dados. Não há fallback SQLite; pgvector está fazendo trabalho real, e um Postgres gerenciado com suporte a pgvector faz parte da stack.
- Pessoas que querem um produto hospedado pronto para uso. Este é um servidor auto-hospedado que você mesmo executa.
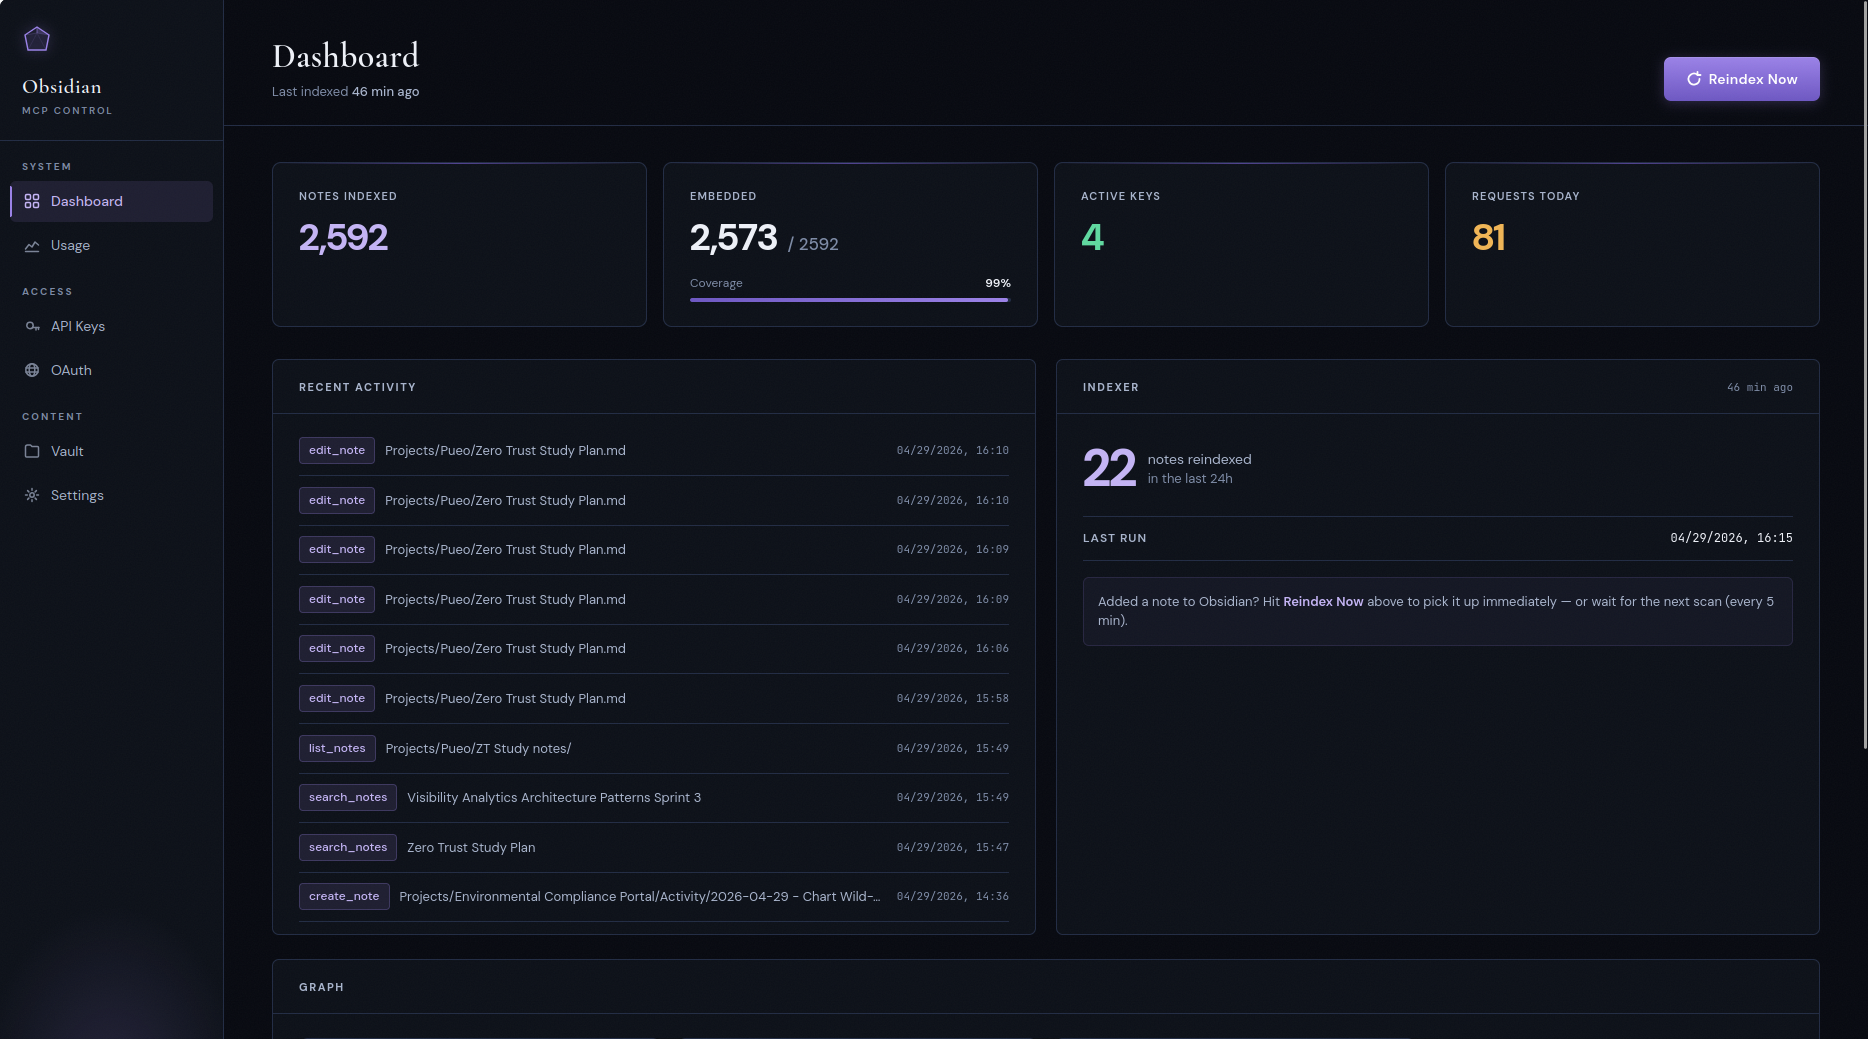
Painel de controle
O servidor vem com uma UI administrativa embutida para as partes das operações que são mais fáceis de olhar do que consultar: emitir chaves, observar o indexador, examinar o tráfego de chamadas de ferramentas e redefinir embeddings quando você troca de provedor.
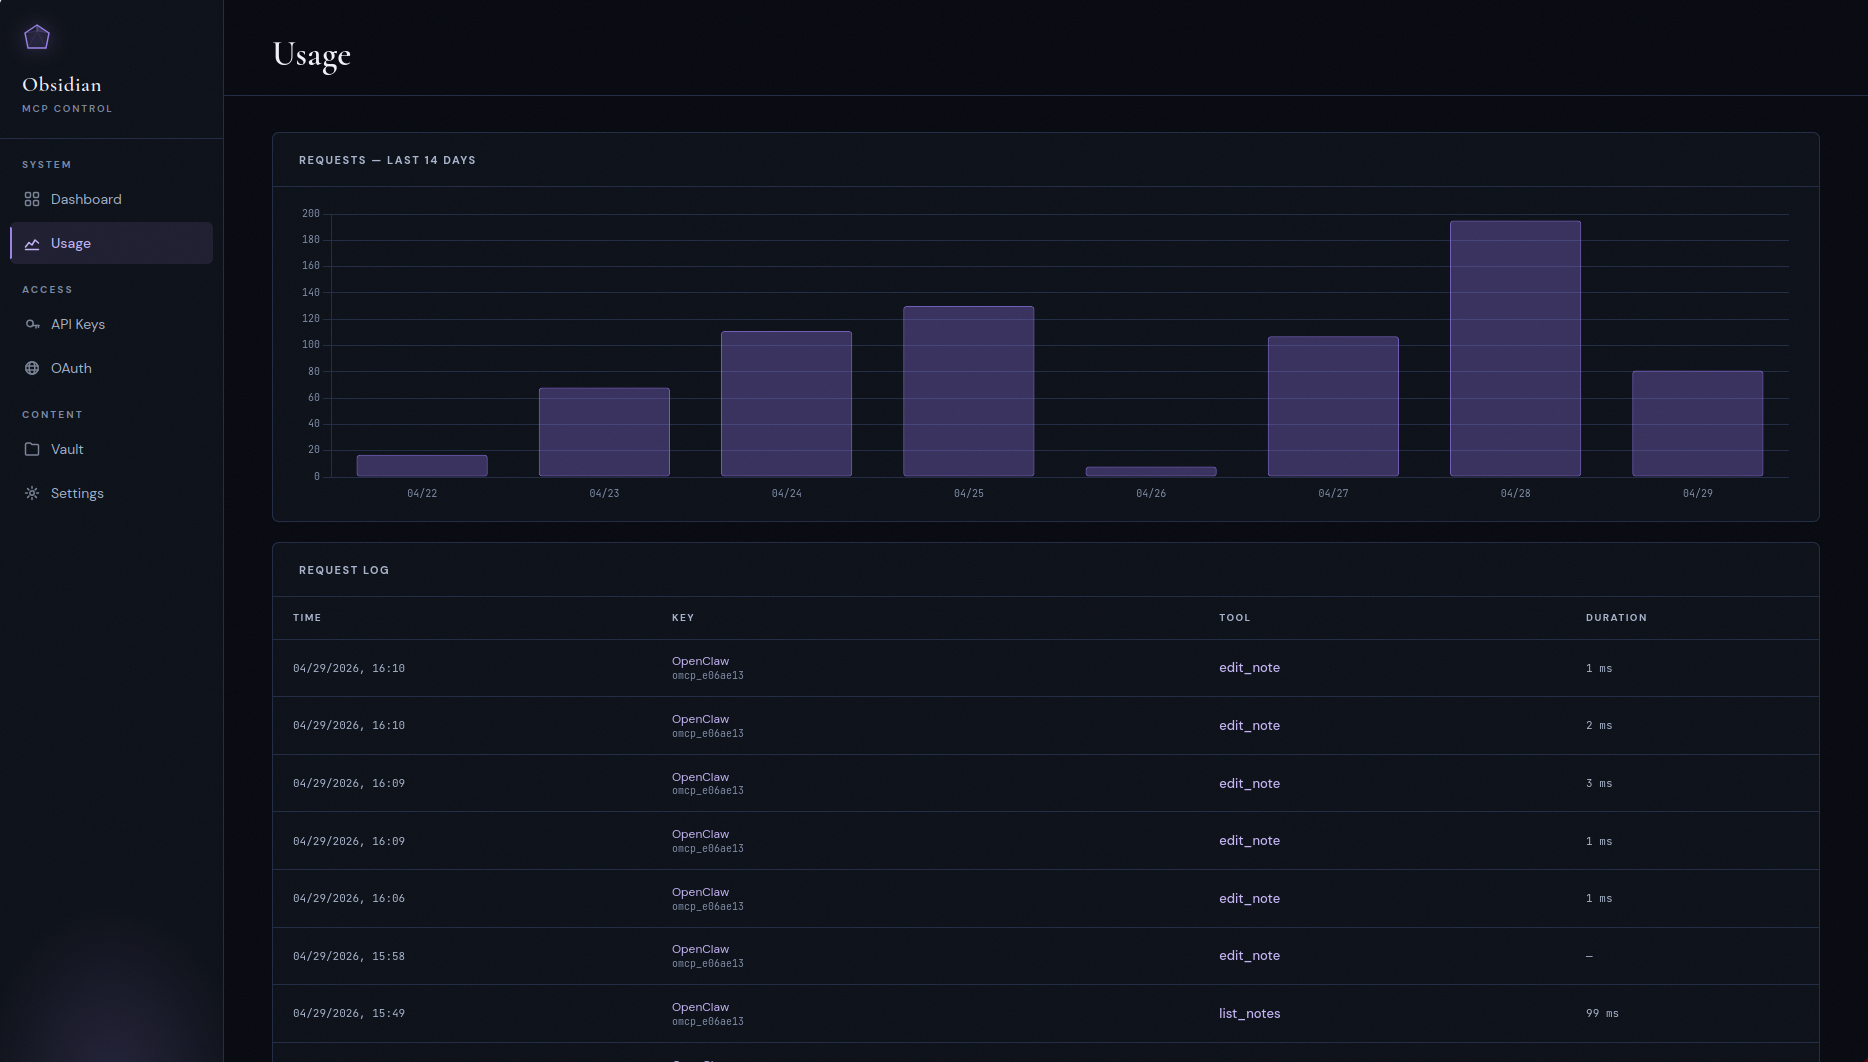
Uso
Log de auditoria por chamada de ferramenta com um histograma de solicitações de 14 dias. Cada chamada MCP é registrada com a chave chamadora, nome da ferramenta, duração e tamanho da resposta — útil para notar um agente malcomportado queimando tokens em algo que não deveria.
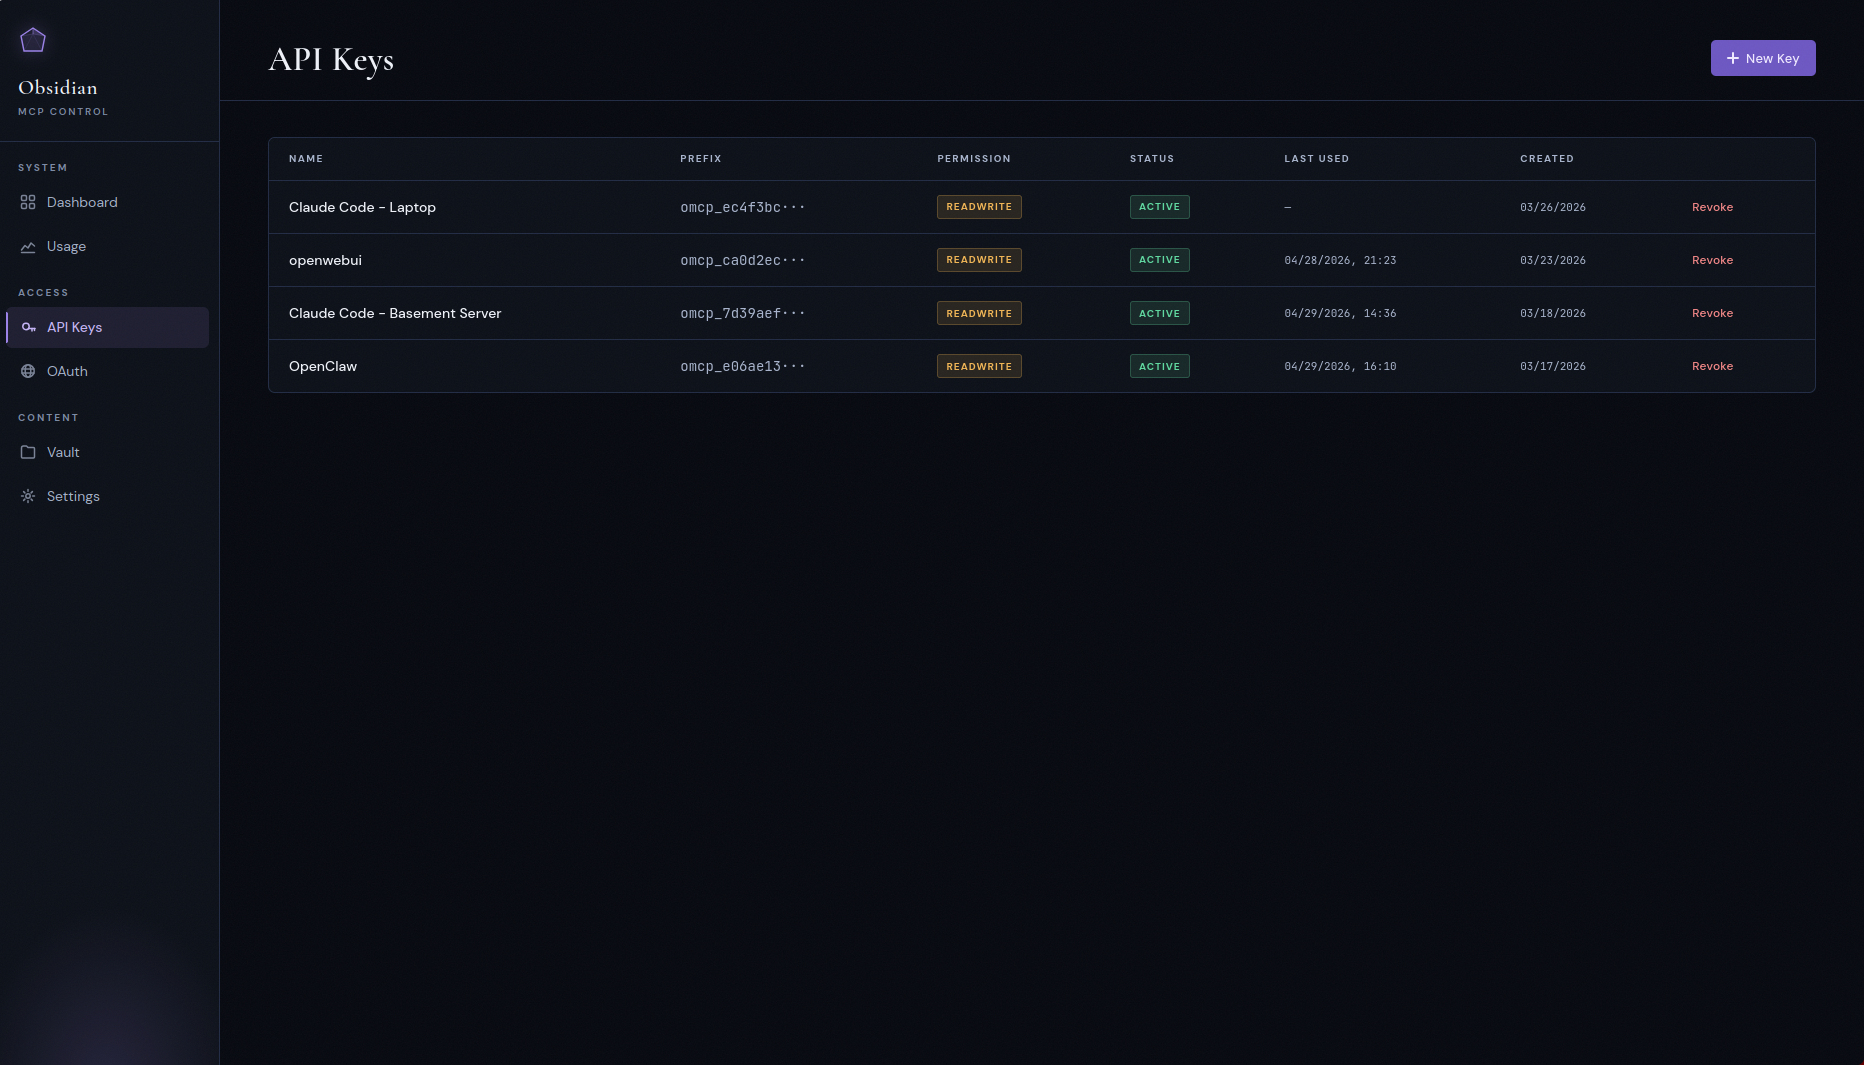
Chaves de API e clientes OAuth
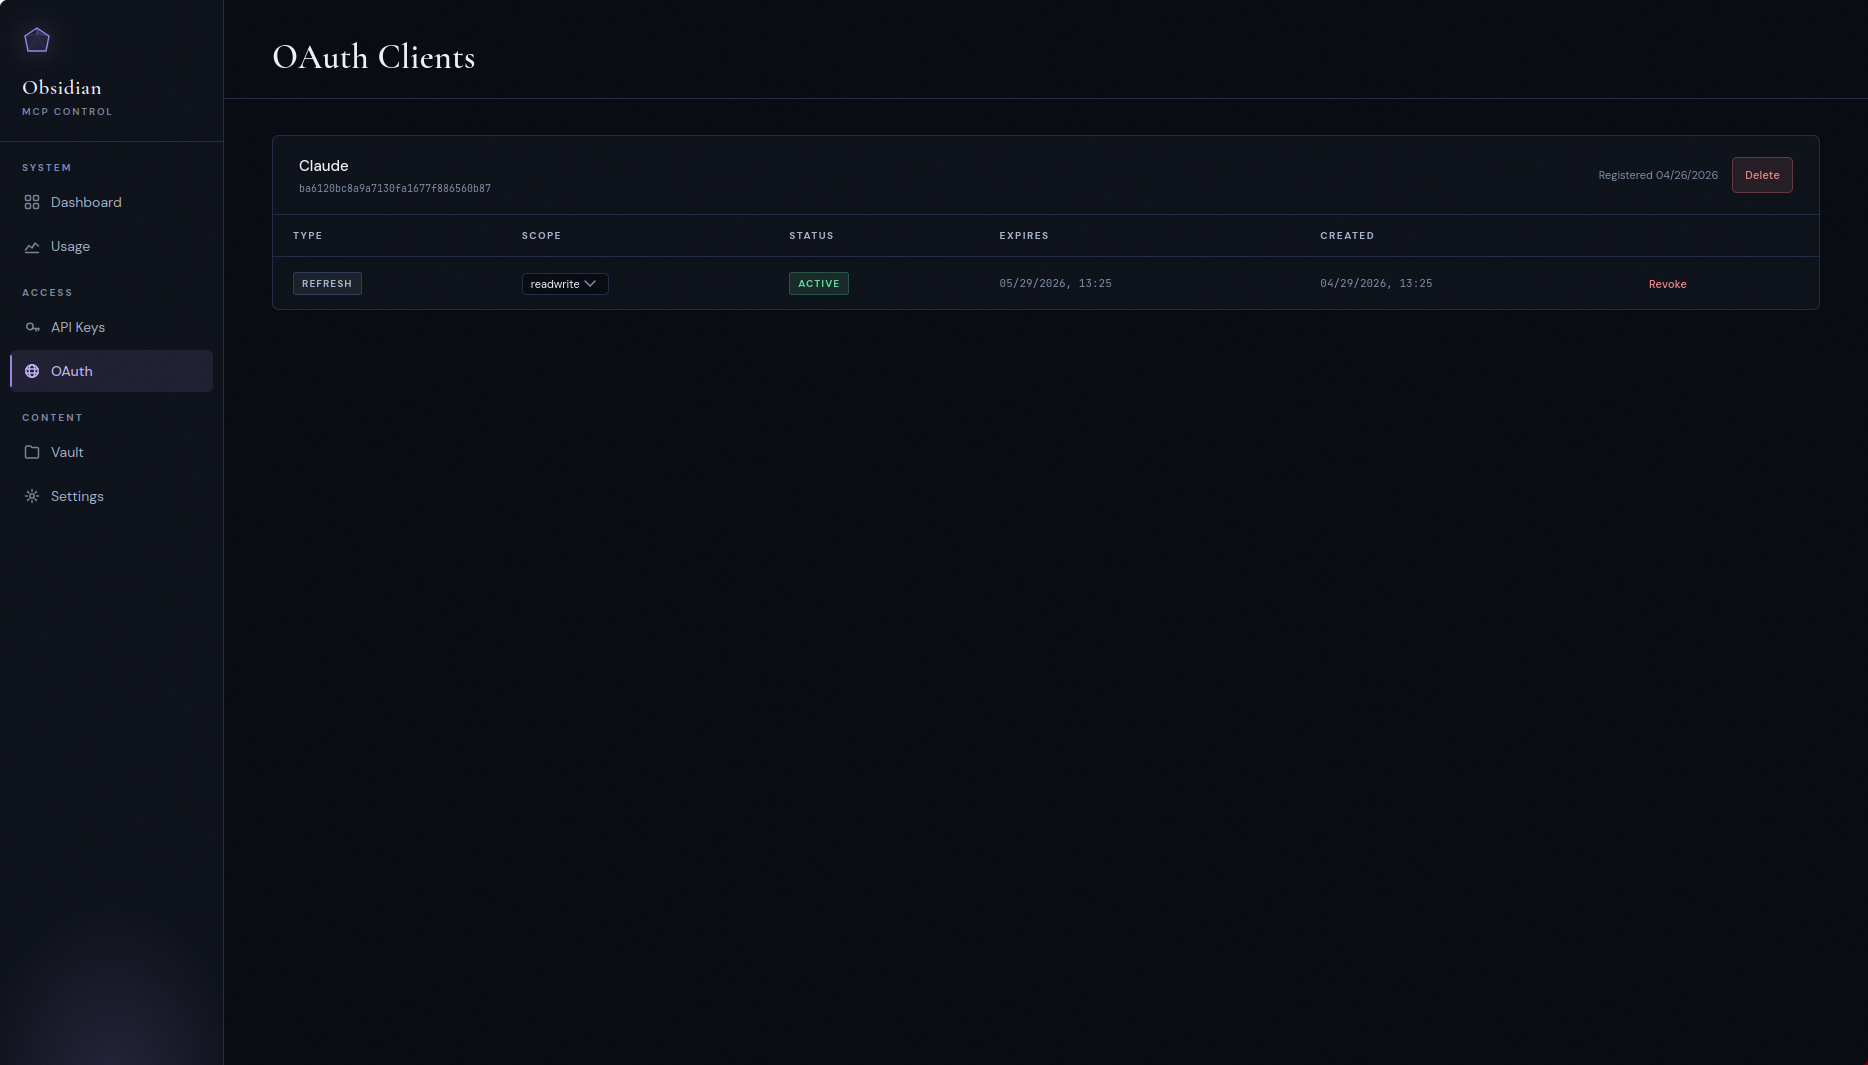
Chaves Bearer com escopos read / readwrite para clientes de API, e um fluxo OAuth 2.0 PKCE separado para clientes como ChatGPT, Claude Desktop e claude.ai que esperam uma dança de código de autorização adequada. O servidor OAuth suporta autenticação de endpoint de token pública (none) e confidencial (client_secret_post), além de refresh tokens.
A página de cada cliente lista suas concessões — uma linha por aprovação /authorize, não por token — com um controle Revogar e um seletor de permissão por concessão, então revogar realmente encerra a sessão em vez de deixar um refresh token para cunhar um substituto. Linhas revogadas e expiradas permanecem listadas, esmaecidas, por uma semana.
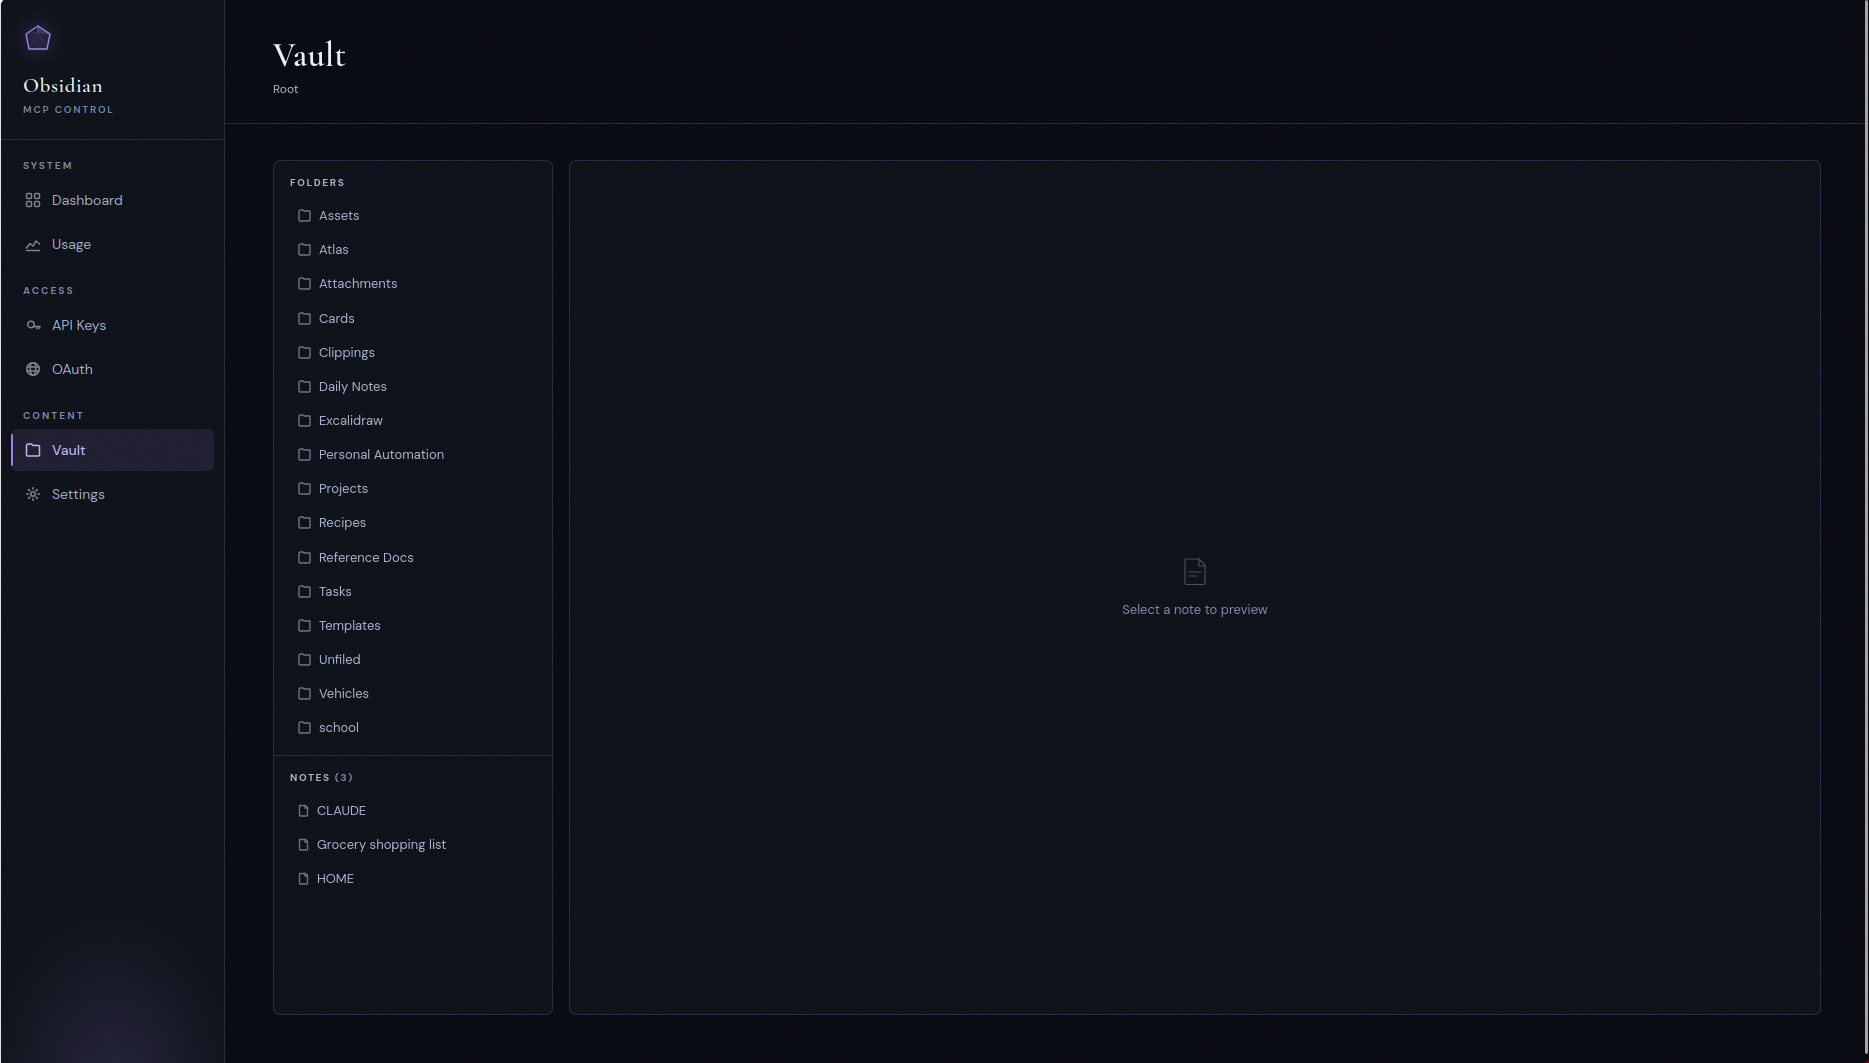
Navegador do cofre
Uma árvore de arquivos somente leitura do cofre montado, principalmente para verificar se o contêiner vê o que você pensa que vê.
Configurações
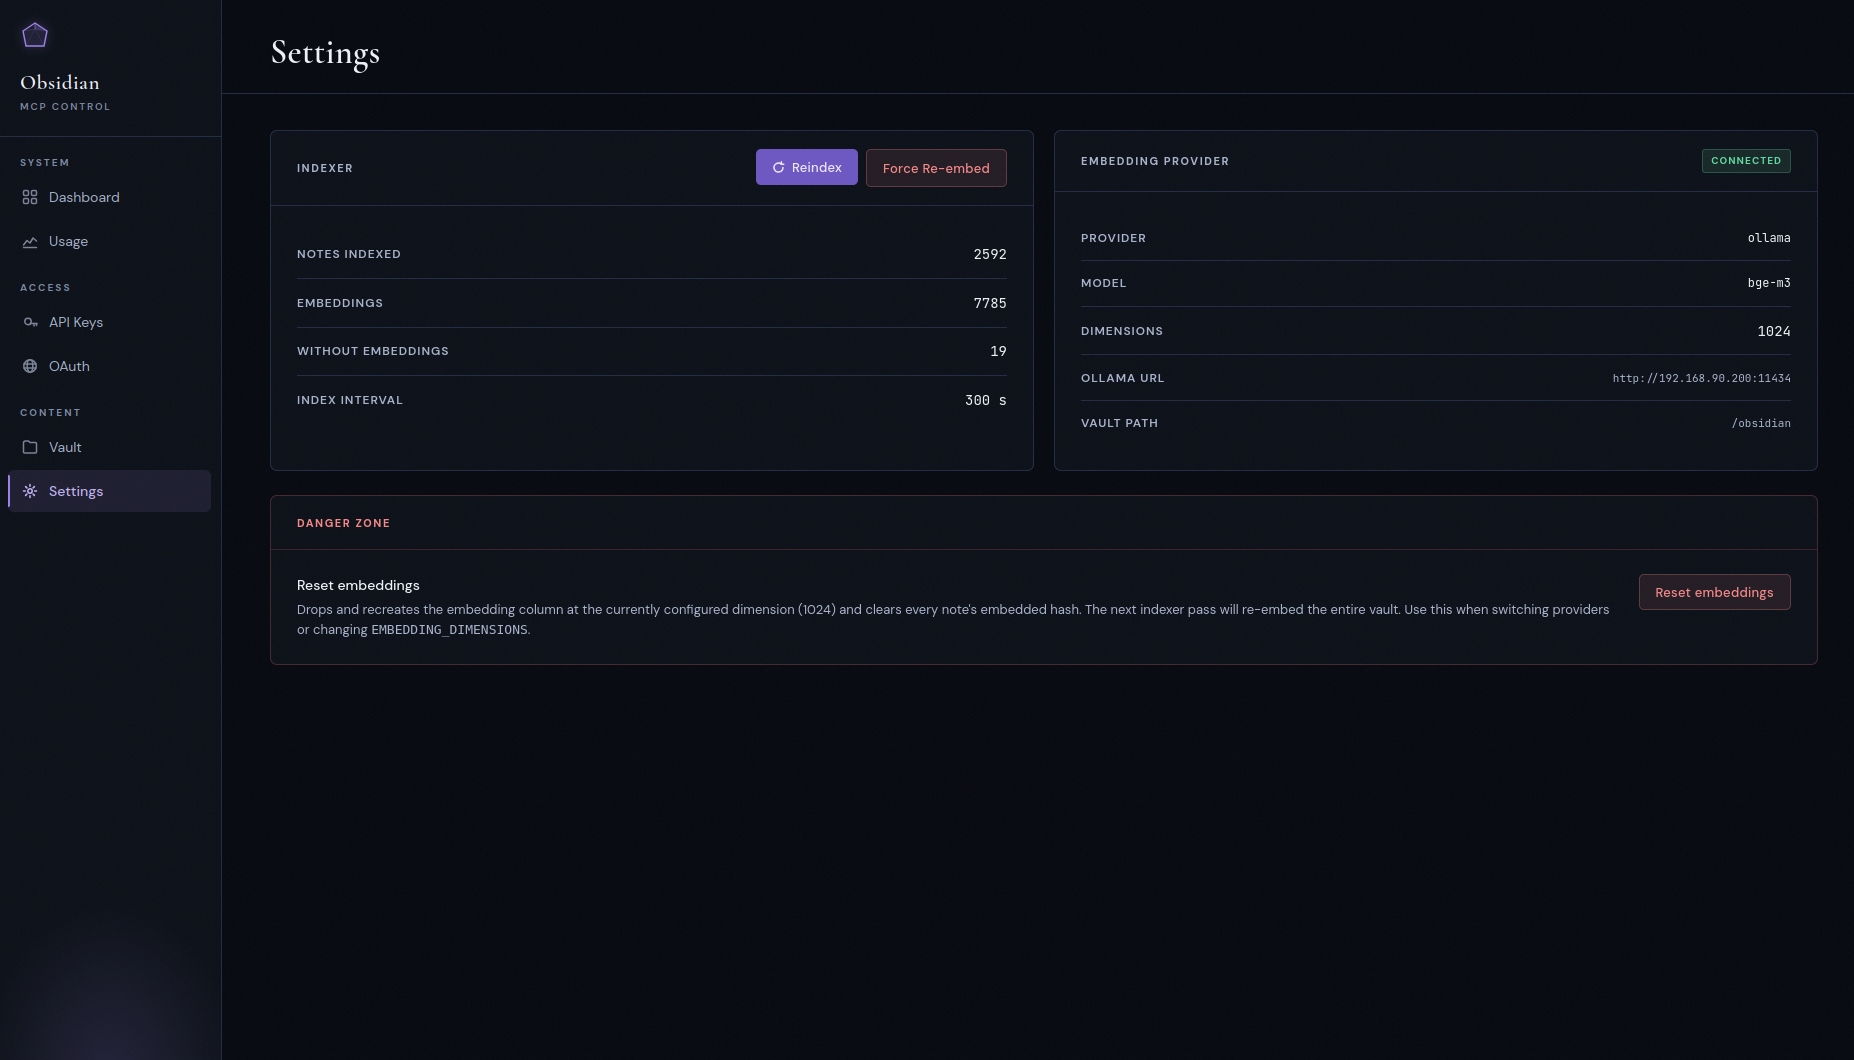
Status do indexador, provedor e modelo de embedding atuais, caminho do cofre e a zona de perigo: Redefinir embeddings (descarta e recria a coluna de embeddings na dimensão configurada — use ao trocar de provedor) e Forçar re-embed (mantém a coluna, limpa o hash de conteúdo incorporado de cada nota para que a próxima passada re-embuta o cofre). Ambos pausam o indexador enquanto rodam.
O painel separa duas coisas que costumavam ser confundidas: Última execução é o batimento cardíaco do próprio indexador — a última passada concluída, tenha ou não algo mudado — e Última mudança detectada é o indexed_at mais recente em qualquer nota. Um cofre quieto faz o segundo ficar antigo enquanto o indexador está perfeitamente saudável.
Início rápido
Implantando em um VPS do zero? Veja
DEPLOYMENT.mdpara o passo a passo completo: configuração do Postgres, Caddy e TLS, sincronização do cofre via Nextcloud e as armadilhas que mordem implantações de primeira viagem. Rodando Kubernetes? Vejadocs/deployment-kubernetes.mde os manifestos kustomize emdeploy/kubernetes/.
A configuração Caddy incluída falha fechada em /admin, /api e /authorize; substitua o hash de autenticação básica do placeholder antes de iniciá-lo.
Pré-requisitos
- Docker e Docker Compose
- Uma instância PostgreSQL 16 alcançável a partir do contêiner, com
pgvector0.8.0 ou mais recente instalado - Ou uma instância Ollama rodando
bge-m3, ou uma chave de API OpenAI. Qualquer coisa que fale o protocolo de embeddings OpenAI funciona (Azure OpenAI, OpenRouter, Together, etc.). - Linux, kernel 5.6 ou mais recente (veja abaixo)
Requisitos do sistema
O servidor verifica estes na inicialização e informa qual falhou em vez de se comportar mal mais tarde.
Kernel Linux ≥ 5.6. Cada diretório abaixo da raiz do cofre é aberto com um único openat2(RESOLVE_BENEATH | RESOLVE_NO_SYMLINKS | RESOLVE_NO_MAGICLINKS), que é o que faz o kernel — não o aplicativo — provar que uma gravação permaneceu dentro do cofre. Não há fallback: em um kernel mais antigo, ou sob um perfil seccomp de contêiner que bloqueia openat2, o servidor registra o motivo e sai com código não zero.
Kernel ≥ 5.8 para transferência de arquivos. O STATX_MNT_ID de statx() é como uma publicação recusa um destino que está em um mount diferente do diretório de staging (um bind mount aninhado sob a raiz do cofre falharia apenas depois que um corpo de upload inteiro tivesse sido transmitido). Abaixo de 5.8, o servidor registra um aviso e inicia: request_upload, import_from_url e PUT /transfer/upload recusam, e todo o resto — leituras, gravações de notas, busca, downloads, o painel, OAuth — não é afetado. /health relata como transfer_mount_check_available.
pgvector ≥ 0.8.0. Busca semântica filtrada precisa de hnsw.iterative_scan, que chegou no 0.8.0. Uma extensão mais antiga aceita a configuração como um placeholder desconhecido e silenciosamente executa um plano que descarta candidatos pós-filtro — resultados de busca silenciosamente piores — então o servidor sai. Corrija com ALTER EXTENSION vector UPDATE ou uma imagem de banco mais recente.
Sistema de arquivos. Sensível a maiúsculas e não normalizante (ext4, xfs e os bind mounts usuais). Deve suportar hard links dentro da raiz do cofre e renameat2(RENAME_NOREPLACE); sem eles, criação de notas, move_note e a exclusão suave recusam com um erro nomeado em vez de degradar para uma publicação que pode sobrescrever. O_TMPFILE é desejado, mas opcional: onde não estiver disponível, defina VAULT_ALLOW_NAMED_STAGING_FALLBACK=true para aceitar staging nomeado (veja Configuração). Hosts macOS e Windows estão fora do escopo; rode o contêiner em uma VM Linux.
1. Clone, configure, aponte para seu cofre
git clone https://github.com/maxkuminov/obsidian-mcp.git
cd obsidian-mcp
cp .env.example .env
$EDITOR .env
Em docker-compose.yml, aponte o volume /obsidian para seu cofre:
volumes:
  - /path/to/your/vault:/obsidian
2. Escolha um backend de embedding
Opção A, OpenAI (zero infraestrutura local):
EMBEDDING_PROVIDER=openai
OPENAI_API_KEY=sk-...
EMBEDDING_DIMENSIONS=1024
OPENAI_EMBEDDING_MODEL=text-embedding-3-small
O servidor valida OPENAI_API_KEY na inicialização e recusa iniciar se estiver faltando.
Opção B, Ollama (auto-hospedado, GPU recomendada):
EMBEDDING_PROVIDER=ollama
OLLAMA_URL=http://your-ollama-host:11434
EMBEDDING_ALLOW_PLAINTEXT=true
EMBEDDING_MODEL=bge-m3
EMBEDDING_DIMENSIONS=1024
Este é o padrão. Omitir EMBEDDING_PROVIDER cai para Ollama.
A URL de embedding deve ser https, ou http para um host de loopback (localhost, 127.x, ::1). http em texto puro para qualquer outro host — outro contêiner como http://ollama:11434 incluído — recusa iniciar a menos que EMBEDDING_ALLOW_PLAINTEXT=true reconheça que chunks e consultas cruzam esse salto sem criptografia. .env.example vem com isso definido por esse motivo; remova-o uma vez que o endpoint esteja https (use EMBEDDING_CA_FILE para uma CA interna). Dentro de um contêiner, localhost é o próprio contêiner, então um Ollama no host Docker ainda precisa da substituição.
3. Implante
make init       # data dirs and .env from template (skip if you've already edited)
make db-init    # create database, user, and pgvector extension
make deploy     # build, push to local registry, run migrations, recreate container
A primeira implantação preenche o índice, o grafo de wikilinks e os embeddings. Para um cofre de 2 a 3 mil notas no Ollama com GPU, isso leva alguns minutos. Em text-embedding-3-small, são segundos.
4. Conecte um cliente
Emita uma chave de API no painel de controle e aponte seu cliente MCP para:
URL:  https://obsidian-mcp.<your-domain>/mcp
Auth: Bearer omcp_...
Para Claude Desktop, adicione a claude_desktop_config.json:
{
  "mcpServers": {
    "obsidian": {
      "url": "https://obsidian-mcp.<your-domain>/mcp",
      "headers": { "Authorization": "Bearer omcp_..." }
    }
  }
}
Para Claude Code:
claude mcp add obsidian --transport http \
  --url "https://obsidian-mcp.<your-domain>/mcp" \
  --header "Authorization: Bearer omcp_..."
A primeira coisa que qualquer agente deve fazer em uma nova sessão é chamar get_vault_guide(). É assim que ele aprende sua estrutura de pastas, convenções de nomenclatura e esquema YAML antes de escrever qualquer coisa.
Atualizando
Puxe, então make deploy (ou reconstrua sua stack compose); migrações rodam na inicialização. Leia isto primeiro ao atualizar através do release de transporte interno e CSP do painel:
- Quebra: endpoints de embedding em texto puro devem ser reconhecidos. Se a URL de embedding ativa (
OLLAMA_URL, ouOPENAI_BASE_URLcom o provedor OpenAI) forhttp://para um host não loopback — o padrãohttp://ollama:11434incluído — adicioneEMBEDDING_ALLOW_PLAINTEXT=truea.envantes de implantar, ou o servidor recusa iniciar com uma mensagem nomeando a configuração. - TLS do banco tem uma única fonte. Um parâmetro TLS em
DATABASE_URL(?ssl=…,?sslmode=…) ou qualquer variável de ambientePGSSL*é recusado na inicialização; mova-o paraDATABASE_SSL_MODE. O padrão,prefer, é o comportamento que você tinha antes. - Clientes de embedding ignoram as configurações de rede do ambiente.
HTTP(S)_PROXY,SSL_CERT_FILE/SSL_CERT_DIRe.netrcnão se aplicam mais ao salto de embedding. UseEMBEDDING_CA_FILEpara uma CA interna. - O painel agora envia uma Content-Security-Policy baseada em nonce (
PANEL_CSP=enforce), e htmx foi removido dele. Se um controle do painel se comportar mal, definaPANEL_CSP=report-only(ouoff) e recrie o contêiner; sem reconstrução. - Novas configurações opcionais:
DATABASE_SSL_MODE,DATABASE_SSL_CA_FILE,DATABASE_SSL_CERT_FILE,DATABASE_SSL_KEY_FILE,EMBEDDING_ALLOW_PLAINTEXT,EMBEDDING_CA_FILE,PANEL_CSP. Veja Configuração, eDEPLOYMENT.mdpara mover ambos os saltos para TLS verificado.
Expectativas de custo
Se você seguir o caminho da OpenAI (o caminho realista em um VPS somente com CPU), o gasto com o primeiro índice é pequeno e o estado estável é quase gratuito. Números aproximados assumindo uma nota média em torno de 1.500 tokens (três chunks de 512 tokens), na taxa publicada pela OpenAI no momento da escrita:
| Modelo | $/1M tokens | 1k notas | 10k notas | 100k notas |
|---|---|---|---|---|
text-embedding-3-small | $0,02 | ~$0,05 | ~$0,50 | ~$5,00 |
text-embedding-3-large | $0,13 | ~$0,30 | ~$3,00 | ~$30,00 |
Após o primeiro índice, apenas notas alteradas são re-incorporadas. O custo contínuo é proporcional às edições — centavos por mês para um cofre típico.
Se você auto-hospedar o Ollama com uma GPU, o custo de incorporação é o que sua conta de energia cobrar. Ollama em CPU funciona, mas é lento demais para ser utilizável em um cofre com mais de algumas centenas de notas.
O cofre autodescritivo
Esta é a parte que a maioria dos projetos "MCP para Obsidian" ignora. Eles param em ler, escrever e listar. A pergunta interessante não é "o agente consegue alcançar os arquivos", é "o agente conhece as regras?"
Se você tem um cofre opinativo — lógica de posicionamento de tarefas, convenções de pastas, frontmatter obrigatório, taxonomia de tags — um agente com acesso de escrita pode causar danos reais sem esse contexto. Tarefas caem na pasta errada. Nomes de arquivo com data nua colidem com modelos. Tags erradas quebram consultas do Dataview. A camada de dados funciona bem; a camada de contexto é onde as falhas aparecem.
A correção é pequena. Mantenha um arquivo de instruções legível por máquina
(CLAUDE.md na raiz do cofre) que descreve as próprias regras do sistema.
Exponha-o como uma ferramenta dedicada. Cada agente conectado o chama uma vez no
início de uma sessão e imediatamente sabe como o cofre funciona.
Atualize o arquivo, e cada agente vê a mudança na próxima chamada. Sem
configuração no lado do cliente. Sem injeção de prompt no sistema. O cofre é
autoritativo sobre suas próprias regras.
get_vault_guide() faz exatamente isso. Ele retorna uma cartilha genérica do
Obsidian (sintaxe de wikilink, sintaxe de incorporação, convenções de tags,
literais comuns de plugins) mais o CLAUDE.md do cofre ao vivo. A dica
para chamá-lo primeiro está embutida nas descrições das ferramentas de escrita,
para que o agente seja puxado para o comportamento correto mesmo sem prompts.
Modo multiusuário
O modo de usuário único é o padrão e funciona exatamente como descrito acima — um cofre, um conjunto de chaves de API, sem conceito de usuário no aplicativo. O modo multiusuário é um sinalizador opcional que transforma o mesmo contêiner em uma pequena implantação multi-tenant: login com nome de usuário/senha no aplicativo, escopo de cofre por usuário, uma função de administrador para solução de problemas e uma função de usuário regular que vê apenas suas próprias chaves/clientes OAuth/uso. Um contêiner, um Postgres, isolamento estrito entre usuários.
Ative-o em uma implantação existente sem perda de dados — seu cofre e chaves atuais são transferidos para o administrador de bootstrap.
Ativação
- Defina
MULTI_USER_MODE=truee umSECRET_KEYforte em.env(openssl rand -hex 32é suficiente). O aplicativo se recusa a iniciar com umSECRET_KEYde espaço reservado incondicionalmente — incluindo o modo de usuário único — então isso não é algo que o sinalizador ativa. make deploy(oudocker compose up -d --force-recreate).- Visite o painel. Como a tabela
usersestá vazia, você é roteado para/admin/register— o formulário de bootstrap único. Ele ainda está atrás do middlewarechain-oauth@filedo Traefik, então apenas pessoas que o Traefik já confia podem reivindicar administração. - Registre-se com um nome de usuário e senha escolhidos. O formulário de
bootstrap pré-preenche
vault_pathcom o queVAULT_PATHfoi definido, então suas notas existentes imediatamente pertencem a este novo administrador. Sem re-indexação, sem re-incorporação, sem perda de dados — cada nota previamente indexada, chave de API, cliente OAuth e linha de log de uso é preenchida retroativamente para o usuário de bootstrap em uma única transação.
Convidando usuários
-
Edite
docker-compose.ymlpara adicionar uma montagem de volume para o cofre do novo usuário sob/vaults/<username>. Caminhos de host com espaços devem ser citados como uma única string YAML:volumes: - "/storage/vaults/alice:/vaults/alice" - "/storage/shared/bob/Obsidian:/vaults/bob"make deploypara aplicar. -
No painel,
/admin/users/create— escolha um nome de usuário e defina uma senha inicial. -
/admin/users/{id}/edit— defina ovault_pathdo usuário para o caminho do contêiner que você acabou de montar (por exemplo,/vaults/bob). O formulário mostra um menu suspenso de diretórios/vaults/*não atribuídos que existem no disco. -
Compartilhe as credenciais fora de banda. O usuário faz login em
/admin/auth/login, obtém suas próprias visualizações de chaves/OAuth/uso e não pode ver as notas de outros usuários.
O que os administradores veem
Os administradores veem chaves de API, clientes OAuth e logs de uso para todos
os usuários; eles possuem a página de Configurações (provedor de incorporação,
gatilho de indexador, zona de perigo) e a página de Usuários. Os administradores
não navegam pelo conteúdo dos cofres de outros usuários através do painel —
isso é intencional. Solucionar problemas no cofre de outro usuário significa
inspecioná-lo via docker exec ou reatribuir temporariamente seu
vault_path, não espionar pela interface.
Reversão
Defina MULTI_USER_MODE=false, reinicie. As chaves de API existentes continuam
funcionando (filtros por usuário são ignorados quando nenhum contexto de usuário
está definido), a interface de login e os cookies de sessão desaparecem, e o
painel volta ao seu modo somente OAuth do Traefik. O esquema permanece no lugar,
então voltar ao modo multiusuário mais tarde retoma de onde você parou sem
re-bootstrap (a tabela users não está vazia, então /admin/register
está fechado).
Restrições e limites conhecidos
- O indexador itera usuários ativos sequencialmente a cada ciclo. Bom para dezenas de usuários; centenas exigiriam paralelização.
- A recuperação de senha é conduzida pelo administrador — não há redefinição
baseada em e-mail. Um usuário conectado pode rotacionar sua própria senha
em
/admin/account(senha atual, nova senha, confirmação; mínimo de 12 caracteres), o que desconecta seus outros navegadores e mantém aquele em que a mudança foi feita conectado. A redefinição do administrador continua sendo o caminho de recuperação para alguém que não consegue entrar de forma alguma, e também encerra toda sessão ativa da conta que ela redefine. /admin/auth/logine/admin/account/passwordsão limitados por taxa a 5 solicitações por minuto; o limite de login é baseado no endereço do cliente, e a mudança de senha carrega dois limites independentes — um por conta, um por endereço. O armazenamento do limitador é em memória e por processo, então os contadores são redefinidos na reinicialização. O portão OAuth do Traefik na frente do painel ainda é a principal defesa contra força bruta; se você expor/admin/auth/loginà internet aberta, coloque um middleware de limite de taxa na frente dele também.- As sessões do painel são linhas no lado do servidor (
user_sessions), então sair, mudar uma senha, uma desativação ou uma exclusão realmente as encerra. O trade-off: a primeira implantação do build que introduziu o registro desconecta toda sessão ativa do painel uma vez, porque um cookie emitido antes dele não carrega ID de sessão e é recusado em vez de ser mantido. Todos entram novamente; nada mais muda. - O validador
vault_pathnão resolve links simbólicos, então um administrador pode tecnicamente apontar um usuário para arquivos do host via um/vaults/<name>com link simbólico. Trate/vaults/como um limite de confiança do administrador. O que é verificado, desde o guarda de sobreposição de raiz do cofre: as raízes de dois usuários ativos não podem nomear diretórios sobrepostos. Cada raiz é aberta uma vez e comparada por identidade de inode —(st_dev, st_ino), que detecta um alias de link simbólico ou uma montagem bind nomeando um diretório duas vezes — e por um teste de contenção componente a componente sobre os dois caminhos reais canônicos em ambas as direções, que detecta um par ancestral/descendente como/vaults/teame/vaults/team/private. Uma atribuição conflitante é recusada no painel nomeando o outro usuário, e as mesmas verificações são reexecutadas antes de cada passagem de índice, então um alias criado após a atribuição coloca ambas as contas em quarentena: suas ferramentas MCP, passagens de índice e resgates de transferência são recusados até que um administrador corrija, e nenhuma linha de índice é excluída. Uma raiz que não pode ser aberta de forma alguma coloca apenas sua própria conta em quarentena. O que ainda não é detectado, e a consequência: uma montagem bind que enxerta o cofre de um usuário — ou qualquer montagem aninhada dentro dele — em um caminho dentro da raiz de outro usuário.mount --bind /vaults/b /vaults/a/innerdeixa ambos os inodes de raiz distintos e ambos os caminhos canônicos fora um do outro, então nenhuma verificação o vê, e o usuário A pode então ler, sobrescrever e excluir cada nota no cofre do usuário B através das ferramentas de escrita comuns, enquanto a passagem de índice de A arquiva as notas de B sob a conta de A, então as buscas de A retornam o conteúdo de B. A mesma lacuna cobre um alias acessível de uma raiz que não pôde ser examinada: esse par continua servindo. Nenhuma condição é relatada em lugar algum. Ambas exigem que um administrador escreva uma montagem bind na configuração de implantação — que é por isso que/vaults/e as montagens do arquivo compose são o limite de confiança do administrador, não apenas as strings de caminho. Este é um limite permanente e declarado, em vez de uma correção pendente: a detecção de montagem foi especificada, falhou em uma nova topologia em cada uma das três rodadas de revisão e foi descartada. A regra do operador: nunca monte o diretório de um usuário, ou qualquer coisa aninhada nele, dentro da raiz de outro usuário.
Configuração
| Variável | Padrão | Finalidade |
|---|---|---|
DATABASE_URL | — | postgresql+asyncpg://user:pass@host/db. Nenhum parâmetro TLS aqui — eles são recusados; use DATABASE_SSL_MODE. |
DATABASE_SSL_MODE | prefer | TLS do banco de dados: disable, prefer (tenta TLS, recai em texto puro), require (criptografa, sem verificação), verify-ca, verify-full. Modos estritos saem se a sessão não estiver criptografada. Qualquer variável PGSSL* é recusada. |
DATABASE_SSL_CA_FILE | — | Pacote de CA (PEM) para verify-ca / verify-full; exigido por ambos, recusado com qualquer outro modo. Sem fallback para o armazenamento do sistema. |
DATABASE_SSL_CERT_FILE | — | Certificado do cliente (PEM). Somente modos estritos (require, verify-ca, verify-full); defina junto com DATABASE_SSL_KEY_FILE ou não defina. |
DATABASE_SSL_KEY_FILE | — | Chave privada do cliente para DATABASE_SSL_CERT_FILE. Ambos ou nenhum. |
VAULT_PATH | /obsidian | Montagem do vault no contêiner |
SECRET_KEY | — | Chave do assinante itsdangerous |
INDEX_INTERVAL_SECONDS | 300 | Cadência de reindexação periódica |
INDEXER_DEGRADED_AFTER_FAILURES | 3 | Falhas consecutivas de qualquer contador de indexador (o índice de um escopo passa, seu embed passa, sua re-derivação incompleta, ou a enumeração de usuários do próprio tick) nas quais /health reporta degraded e uma linha CRITICAL "intervenção manual necessária" é registrada. |
INDEXER_QUARANTINE_RETRIES_PER_TICK | 5 | Quantas vezes uma passada de índice pode reverter e reexecutar um escopo após colocar em quarentena uma nota que o banco de dados recusa (um erro de exceção de dados ou limite de programa em sua linha, vetor de palavras-chave, movimentação ou links). Além disso, a passada falha como uma falha comum; as notas já encontradas permanecem em quarentena para o próximo tick. |
MULTI_USER_MODE | false | Login no aplicativo, vaults por usuário. Veja Modo multi-usuário. |
VAULT_ROOT_OBSERVE_TIMEOUT_SECONDS | 10 | Quanto tempo a verificação de sobreposição da raiz do vault espera em uma raiz antes de desistir dela. A expiração coloca em quarentena essa única conta (root unexaminable) e a verificação continua, então uma montagem travada não pode segurar a inicialização. Somente modo multi-usuário. |
MCP_HOSTNAME | — | Nome de host público. Deriva BASE_URL, ALLOWED_ORIGINS e ALLOWED_HOSTS como https://<host>. Exigido (ou BASE_URL) para as ferramentas de transferência. |
BASE_URL | derivado | Origem pública explícita. HTTPS exceto em loopback. |
ALLOWED_ORIGINS | derivado | Origens CORS, lista JSON |
ALLOWED_HOSTS | derivado | Cabeçalhos Host aceitos, lista JSON. localhost é sempre adicionado. |
SESSION_MAX_AGE | 604800 | Vida útil da sessão do painel, segundos (modo multi-usuário). Absoluta — a linha do lado do servidor nunca é estendida, então uma sessão usada diariamente ainda expira |
SESSION_COOKIE_NAME | omcp_session | Nome do cookie da sessão do painel |
PANEL_CSP | enforce | Content-Security-Policy no painel, páginas de login e consentimento: enforce, report-only (mesma política, somente relatórios), ou off. Uma alavanca de reversão — altere e recrie o contêiner, sem reconstrução. Qualquer coisa exceto enforce registra um WARNING a cada início. |
SESSION_TOUCH_INTERVAL_SECONDS | 60 | Quão desatualizado o last_seen_at de uma sessão pode ficar antes que um GET/HEAD validado o reescreva. Somente telemetria — nada autoriza com base nele. Deve ser ≥ 1. |
SESSION_PURGE_RETAIN_DAYS | 7 | Quanto tempo uma linha de sessão de painel morta é mantida, medido a partir do mais tardio entre sua expiração e sua revogação, para que uma revogação permaneça visível pela janela inteira. Deve ser ≥ 1. |
OAUTH_KNOWN_REDIRECT_HOSTS | claude.ai,chatgpt.com | Hosts de redirecionamento que a tela de consentimento exibe como destinos de conector conhecidos. JSON ou CSV. Correspondidos por igualdade exata de host — sem curingas, sem sufixos; entradas contendo *, /, @ ou espaços internos são recusadas na inicialização. Uma lista vazia significa que cada cliente é mostrado como não verificado. |
MAX_FILE_READ_BYTES | 10485760 | Limite de read_file (10 MB); limita o que o servidor lê do disco |
MAX_FILE_WRITE_BYTES | 26214400 | Limite de write_file (25 MB), comprimento de bytes decodificados |
MAX_READ_RESPONSE_CHARS | 40000 | Limite de read_note / read_file no que é retornado ao chamador (≈10K tokens). Veja Limites de tamanho de resposta. |
FTS_CONFIGS | english | Configuração(ões) de busca de texto para busca por palavras-chave. JSON ou CSV. Veja Idioma(s) de busca de texto completo. |
TRANSFER_TOKEN_TTL_SECONDS | 600 | Vida útil padrão de um link de transferência. expires_in por chamada é limitado a 60–3600. |
TRANSFER_MAX_UPLOAD_SECONDS | 600 | Quanto tempo um upload reivindicado pode transmitir antes que o token seja gasto |
TRANSFER_MAX_CONCURRENT_UPLOADS | 4 | Fluxos de upload simultâneos |
IMPORT_ALLOW_HTTP | false | Permitir que import_from_url busque http simples. Desativado por padrão. |
VAULT_ALLOW_NAMED_STAGING_FALLBACK | false | Aceitar staging nomeado em sistemas de arquivos sem O_TMPFILE. Uma flag, ambos os caminhos de escrita. Veja Requisitos do sistema. |
WRITE_PRECONDITION_REQUIRED | false | Exigir expected_hash em chamadas destrutivas suportadas. Criação é isenta; habilite depois que os clientes adotarem hashes de leitura. |
EMBEDDING_PROVIDER | ollama | ollama ou openai |
EMBEDDING_DIMENSIONS | 1024 | Largura da coluna pgvector |
OLLAMA_URL | http://ollama:11434 | Usado quando o provedor é Ollama. Deve ser https, loopback http, ou coberto por EMBEDDING_ALLOW_PLAINTEXT. |
EMBEDDING_MODEL | bge-m3 | Nome do modelo Ollama. Alterá-lo após a implantação requer make reset-embeddings; o servidor se recusa a iniciar até que os vetores armazenados correspondam. Veja Trocando provedores ou modelos. |
OLLAMA_KEEP_ALIVE | -1 | Quanto tempo o Ollama mantém o modelo residente. -1 o fixa; uma duração Go (30m) libera VRAM quando ocioso. Somente Ollama. |
OPENAI_API_KEY | — | Exigido quando o provedor é OpenAI |
OPENAI_BASE_URL | https://api.openai.com/v1 | Substituição para Azure ou proxies. Mesma regra de transporte que OLLAMA_URL quando este provedor está ativo. |
EMBEDDING_ALLOW_PLAINTEXT | false | Permitir http para um host de embedding não-loopback. Sem isso, tal URL se recusa a iniciar. .env.example o define como true para corresponder ao seu padrão http://ollama:11434. |
EMBEDDING_CA_FILE | — | Âncora de confiança (PEM) para um endpoint de embedding https atrás de uma CA interna; substitui o pacote certifi padrão. Recusado com uma URL http. Clientes de embedding ignoram HTTP(S)_PROXY, SSL_CERT_* e .netrc. |
OPENAI_EMBEDDING_MODEL | text-embedding-3-small | Modelo OpenAI. Alterá-lo após a implantação requer make reset-embeddings; o servidor se recusa a iniciar até que os vetores armazenados correspondam. Veja Trocando provedores ou modelos. |
CHUNK_SIZE | 512 | Aproximadamente tokens por chunk (heurística de 4 caracteres) |
CHUNK_OVERLAP | 0 | Sobreposição de tokens entre chunks |
EMBEDDING_EXCLUDE_PATTERNS | ["*.excalidraw.md","Excalidraw/*"] | Globs ignorados pelo embedder. Arquivos excluídos permanecem pesquisáveis por palavras-chave. |
MCP_AUTH_FAILURE_LIMIT | 60 | Autenticações /mcp falhas que um endereço de cliente pode fazer por janela antes de um 429. Verificado antes da consulta de credenciais, então uma sonda recusada não custa consulta. Null desativa. Veja Limites de taxa. |
MCP_AUTH_FAILURE_WINDOW_SECONDS | 300 | A janela sobre a qual esse orçamento é contado. |
MCP_AUTH_FAILURE_TABLE_SIZE | 4096 | Slots de contador na tabela de endereços de tamanho fixo, com sal por processo. Memória é O(tamanho); colisões apenas tornam o controle mais estrito. |
MCP_RATE_LIMIT_PER_MINUTE | 120 | Chamadas de ferramenta sustentadas por minuto por principal (uma chave de API, ou uma concessão OAuth). Null — com o burst — desativa o bucket geral. |
MCP_RATE_LIMIT_BURST | 30 | Capacidade do bucket geral. Deve ser definido junto com sua taxa ou anulado junto com ela. |
MCP_WRITE_RATE_LIMIT_PER_MINUTE | 60 | Chamadas sustentadas de mutação de vault por minuto por principal — as oito ferramentas de escrita, mais PUT /transfer/upload cobrado ao principal que cunhou a capacidade. |
MCP_WRITE_RATE_LIMIT_BURST | 15 | Capacidade do bucket de escrita. |
MCP_LIMITER_MAX_TRACKED_PRINCIPALS | 10000 | Principais que mantêm sua própria entrada de limitador antes que outros compartilhem uma entrada de estouro. |
MCP_REFUSAL_LOG_INTERVAL_SECONDS | 10 | Quanto tempo uma janela de coalescência de recusa de taxa/slot permanece aberta. Dentro dela, uma recusa não escreve nada; a linha que chega representa 1 + suppressed recusas. |
MCP_CONCURRENCY_MODE | shadow | off, shadow, ou enforce. Shadow observa pressão sem rejeitar ou esperar. Veja Admissão de concorrência. |
MCP_CONCURRENCY_WAIT_SECONDS | 0 | Espera de admissão de ferramenta no modo enforce, 0–5 segundos. Shadow exige zero. |
MCP_CONCURRENCY_TOOLS | 4 | Teto global de ferramentas no modo enforce, também sujeito a tetos de classe, locatário (3) e principal (2). |
MCP_CONCURRENCY_REQUESTS | 32 | Teto de solicitações MCP completas, incluindo streams abertos; teto por impressão digital do portador padrão é 4. |
MCP_CONCURRENCY_AUTH | 2 | Teto de sessão de banco de dados de autenticação. Liberado antes da entrega da resposta ou trabalho downstream. |
MCP_CONCURRENCY_WRITERS | 1 | Teto do gravador de log de uso; inclui inserções de fallback. Padrões: 64 gravadores pendentes e uma espera de modo enforce de 0,25 segundos. |
DEFAULT_DAILY_REQUEST_LIMIT | 5000 | Cota diária que uma chave de API recém-criada recebe quando o chamador não diz o contrário. Chaves existentes não são tocadas; um null explícito (ou um campo de painel em branco) ainda significa ilimitado. |
MCP_REJECT_UNKNOWN_ARGUMENTS | true | Recusar uma chamada de ferramenta que carrega um argumento que a ferramenta não declara (um erro de ferramenta nomeando-o), e publicar additionalProperties: false em cada esquema de entrada. false restaura a ignorância silenciosa do SDK — uma reversão para um cliente que envia extras; altere e recrie o contêiner. false registra um WARNING a cada início. |
MCP_SANDBOX_MODE | false | Somente avaliação de registro. Ignora DB, indexador, provedor de embedding e autenticação /mcp para que a introspecção funcione sem dependências externas. Não habilite em produção. |
Veja .env.example para o conjunto completo com comentários. Para gasto
de primeiro índice no OpenAI, veja Expectativas de custo acima.
O limite de corpo de solicitação do transporte MCP é derivado, não configurado:
max(2 × MAX_FILE_WRITE_BYTES, 6 × 10 MB) + 1 MiB, que é 61 MiB com
os padrões. Ele tem que acompanhar os limites de escrita para que cada
escrita suportada seja recusada pela ferramenta — com uma mensagem acionável — em vez de
pelo transporte com um HTTP 413 simples. Aumente MAX_FILE_WRITE_BYTES e
o limite do transporte segue.
Trocando provedores ou modelos
Modelos diferentes produzem vetores em espaços diferentes, e a distância cosseno entre dois espaços é sem sentido. Então qualquer mudança no que produziu os vetores armazenados requer um re-embed completo — não apenas uma troca de provedor. Isso é cada um de:
EMBEDDING_PROVIDEREMBEDDING_MODEL(Ollama) ouOPENAI_EMBEDDING_MODEL(OpenAI) — incluindo uma troca entre dois modelos da mesma dimensão, que o guarda de dimensão não pode verEMBEDDING_DIMENSIONSCHUNK_SIZEeCHUNK_OVERLAP
O servidor armazena uma impressão digital dessa configuração e a compara na inicialização. Em uma incompatibilidade, ele registra ambas as impressões digitais e os campos que diferem, nomeia o reparo e sai com código não-zero — então uma troca de modelo que costumava misturar dois espaços vetoriais em uma coluna silenciosamente, para sempre, agora para o processo em vez disso.
Os passos, nesta ordem:
- Atualize
.env. make deploy(oudocker compose up -d --force-recreate). O novo contêiner se recusará a iniciar — na verificação de impressão digital, ou na verificação de dimensão se a largura mudou — e essa recusa é o ponto: um contêiner que não inicia não incorpora nada enquanto o reset é executado.make reset-embeddingsenquanto ele está parado. O alvo édocker compose run --rm, então ele inicia um contêiner único que lê seu.enveditado: ele recria a coluna na nova dimensão, limpa cadaembedded_content_hash, e registra a nova impressão digital na mesma transação.- Reinicie o serviço. Ele inicia silenciosamente, porque as linhas armazenadas realmente foram produzidas sob a configuração que ele está executando agora, e a próxima passagem do indexador reincorpora o cofre.
Isso inverte o conselho antigo de reset-antes-de-recriar. Essa ordem
era segura apenas enquanto nada dependia de uma afirmação armazenada sobre a
configuração; agora o reset é o que escreve essa afirmação, então ele precisa
ser executado com o novo .env em vigor e sem nenhum contêiner de configuração antiga
capaz de incorporar contra ele. Pular uma etapa custa tempo em vez de
correção — um bloqueio de geração no nível do banco de dados faz com que as
certificações de um contêiner de configuração antiga sejam recusadas em vez de registradas —
mas a ordem acima é a que nunca precisa depender disso.
A manutenção aguarda uma passagem de indexação em andamento. Esse mesmo bloqueio
de geração é adquirido no início da transação da passagem do indexador e mantido até
que ela seja confirmada, então make reset-embeddings e make rebuild-tsvectors bloqueiam
até que a passagem termine — até alguns minutos em um cofre grande — em vez de
se intercalar com ela. Essa espera é o comportamento exigido, não uma
parada para contornar: um reset que ocorre no meio da passagem é precisamente a
intercalação que armazena vetores de uma configuração sob uma
impressão digital que nomeia outra. Nenhum dos comandos define um tempo limite curto de bloqueio,
e nenhum deve receber um — e como o servidor define um statement_timeout de 60 segundos
em cada conexão, ambos os comandos (e os resets da
zona de perigo do painel) elevam esse tempo limite para a aquisição em si e o
restauram assim que o bloqueio é deles. Sem isso, um comando iniciado
contra um serviço ativo era cancelado após um minuto em vez de esperar,
o que parece um comando quebrado em vez de um índice ocupado.
Você também pode usar Configurações → Zona de perigo → Redefinir incorporações no painel de controle, que executa o mesmo SQL — incluindo o registro de impressão digital — enquanto o servidor está em execução (pausa o indexador, executa o SQL, retoma).
A impressão digital registra a configuração, não o artefato do modelo.
bge-m3é uma tag mutável do Ollama, entãoollama pullpode substituir os pesos por trás dela, eOLLAMA_URL/OPENAI_BASE_URLsão deliberadamente excluídos da impressão digital — apontar para outro host ou proxy geralmente é uma mudança de infraestrutura que serve o artefato idêntico, e incluí-la exigiria uma reincorporação completa para um. A consequência é uma limitação aceita: substituir o artefato por trás de um nome de modelo inalterado — baixando novamente uma tag, ou apontando para um host que serve pesos diferentes sob o mesmo nome — mistura espaços vetoriais sem detecção. Isso exigemake reset-embeddings, e nenhuma verificação de inicialização detectará isso se você pular essa etapa. Nenhum valor disponível para o servidor distingue os dois casos, e uma sondagem teria que confiar no endpoint que está verificando.
Idioma(s) de pesquisa de texto completo
keyword_search é executado sobre um tsvector do PostgreSQL. A configuração de pesquisa de texto
que ele usa — o stemmer e o dicionário de palavras de parada — é
controlada por FTS_CONFIGS. O padrão é english, que reproduz
o comportamento histórico exatamente, então implantações existentes não precisam de ação.
FTS_CONFIGS é uma lista, configurável como JSON
(FTS_CONFIGS=["simple","norwegian"]) ou separada por vírgulas
(FTS_CONFIGS=simple,norwegian). Cada nota é indexada sob cada
configuração listada, e uma consulta corresponde se a análise de qualquer configuração listada for encontrada.
É isso que torna um cofre de idiomas mistos funcional:
FTS_CONFIGS | Comportamento |
|---|---|
english | Stemmer Snowball em inglês (padrão; running ↔ run). |
simple | Agnóstico de idioma. Sem stemming ou palavras de parada — corresponde a formas exatas de palavras. Um padrão fundamentado para cofres de idiomas mistos: a pesquisa por palavras-chave é o braço de correspondência exata, enquanto semantic_search (bge-m3 é multilíngue) cuida da recuperação morfológica. |
english,norwegian | Ambos os stemmers aplicados — morfologia do lado das palavras-chave para dois idiomas ao mesmo tempo. |
simple,norwegian | Lexemas literais mais stems em norueguês. |
A configuração é global — aplicada a todos os cofres (consistente com
EMBEDDING_MODEL, CHUNK_SIZE, etc., que também são globais). Para uma
instância multiusuário de idiomas mistos, defina um superconjunto (por exemplo,
["english","norwegian"], ou ["simple"]). Configuração de FTS por usuário é uma
extensão futura limpa, mas não está implementada.
Um nome de configuração com erro de digitação ou não instalado falha rapidamente na inicialização com uma mensagem listando as configurações disponíveis na sua instância do Postgres, em vez de produzir pesquisas silenciosas com zero resultados.
Alterar FTS_CONFIGS exige uma reconstrução, e o servidor se recusa a
iniciar até que ela seja executada. Os tsvectors armazenados são calculados no momento da indexação,
então eles ficam desatualizados quando a lista de configurações muda — e um stemmer desatualizado não é
apenas incompleto. Sob english, o token running é armazenado como
o lexema run, então uma consulta sob simple para run corresponde a uma nota
que não contém a palavra — um falso positivo, indistinguível
de um resultado real. Os vetores de palavras-chave, portanto, falham de forma fechada exatamente como
as incorporações: o servidor armazena uma impressão digital de FTS_CONFIGS, compara
na inicialização e, em uma mudança de associação, registra ambas as listas e as
entradas diferentes, nomeia a reconstrução e sai com código diferente de zero. (Reordenar os
mesmos nomes não é uma mudança: uma nota é indexada sob cada configuração e uma
consulta corresponde se qualquer uma for encontrada, então a ordem não muda nada e não é comparada.)
O runbook:
- Edite
FTS_CONFIGSem.env. make deploy. O novo contêiner recusa na verificação de impressão digital de palavras-chave e permanece parado.make rebuild-tsvectors. Ele reconstrói cada escopo que contém linhas — cada proprietário, incluindo linhas sem proprietário no modo de usuário único — em uma transação, e registra a nova impressão digital somente se cada um deles relatar uma reconstrução concluída. É tudo ou nada: um escopo que ele não consegue reconstruir reverte tudo, nomeia o escopo e o motivo, e não escreve nenhuma impressão digital, porque a impressão digital é uma única afirmação sobre cada linha retida.- Reinicie. Ele inicia silenciosamente.
Se o passo 3 nomear um escopo que ele não conseguiu reconstruir — um usuário cujo cofre não está atribuído, um locatário ainda rederivando sua proveniência, ou linhas sem proprietário no modo multiusuário — há três recursos, em ordem de preferência:
- Resolva o escopo: atribua ou exclua o usuário, ou deixe a rederivação terminar, e então execute novamente a reconstrução.
- Exclua ou reatribua as linhas sem proprietário, e então execute novamente a reconstrução.
- Coloque
FTS_CONFIGSde volta ao valor anterior. Isso limpa a recusa imediatamente, sem nenhuma reconstrução — uma edição de configuração é sempre reversível, o que impede que essa recusa se torne uma interrupção.
A reconstrução relê cada nota e recalcula seu content_tsvector
sob a(s) nova(s) configuração(ões). Ela reconstrói apenas o índice de palavras-chave — ela não
toca em incorporações/vetores e não faz chamadas de API, então
termina em segundos para alguns milhares de notas. (Não confunda com o
fluxo caro de make reset-embeddings.)
Ressalva de tokenização: o parser de tsvector ainda divide em pontuação e hífens independentemente da configuração, então
bge-m3é tokenizado embge+m3.simplepreserva formas de palavras, não strings com pontuação; correspondência exata de string com pontuação exigiria um índice de trigramas e está fora do escopo.
Limites de tamanho de resposta
Um resultado de ferramenta é entrada do modelo. O que read_note retorna é alimentado
diretamente de volta na próxima solicitação do chamador, então uma leitura ilimitada é
um prompt ilimitado — e o chamador geralmente descobre isso apenas quando seu
provedor de inferência rejeita a solicitação.
MAX_READ_RESPONSE_CHARS (padrão 40.000, aproximadamente 10 mil tokens) limita
o que read_note e os resultados de texto de read_file retornam. É um
limite diferente de MAX_FILE_READ_BYTES, que limita o que o
servidor lê do disco. Uma nota de 3 MB está confortavelmente dentro do limite de leitura de 10 MB
e ainda assim destruirá uma janela de contexto; ambos os limites são necessários e
têm valores corretos diferentes.
Ele se aplica por componente, não uma vez para a resposta inteira: a
janela de content recebe o limite, o outline de título recebe-o
independentemente, e os campos de metadados (title, tags,
frontmatter_yaml e sua visualização JSON, heading) compartilham um terceiro. Uma
leitura truncada pode carregar todos os três, então planeje para um pior caso de
aproximadamente 3 × MAX_READ_RESPONSE_CHARS mais prosa fixa — dobrado novamente
porque o resultado do MCP carrega tanto conteúdo estruturado quanto um bloco de texto JSON,
e multiplicado pelo escape JSON para conteúdo que é principalmente
caracteres de controle.
Quando uma nota excede o limite, você obtém a primeira janela mais a truncagem como
dados — truncated, o next_offset para continuar de onde parou, total_chars —
e, para uma leitura de nota inteira, um outline das seções da nota:
{"entries": [
  {"ordinal": 1, "depth": 1, "text": "Client Records",
   "size": 2855343, "exceeds_cap": true,  "duplicate": false},
  {"ordinal": 2, "depth": 2, "text": "Balance Sheet.xlsx",
   "size": 391199,  "exceeds_cap": true,  "duplicate": false},
  {"ordinal": 3, "depth": 2, "text": "Lease Agreement.pdf",
   "size": 464,     "exceeds_cap": false, "duplicate": false},
  {"ordinal": 4, "depth": 2, "text": "Invoice 2025-044.pdf",
   "size": 1075,    "exceeds_cap": false, "duplicate": true}
 ], "truncated": false}
Paginar uma nota de vários megabytes 40 mil por vez é tecnicamente possível e
praticamente inútil, então prefira o esboço: leia a única seção que você
quer com read_note(path, section="Lease Agreement.pdf"). As seções são
endereçáveis de três maneiras — o ordinal #N mostrado no esboço, a
forma de caminho estilo Parent/Child, e o texto exato do título. O ordinal é
a única forma que separa títulos duplicados irmãos, que compartilham
todos os ancestrais e, portanto, não podem ser desambiguados por caminho; notas
geradas por extração em massa tendem a estar cheias deles.
Um #N simples sempre seleciona por posição, então um ordinal que entregamos a você em um
esboço nunca pode ser obscurecido por um título que por acaso se chama
#2. Esse título permanece acessível pela forma de caminho (Parent/#2) ou
pelo seu próprio ordinal.
O esboço em si é limitado pelo limite: uma nota com milhares de
títulos obtém uma listagem truncada que relata quantas seções foram
omitidas (omitted) e o intervalo ordinal completo (first_ordinal,
last_ordinal), em vez de um esboço maior que a janela de conteúdo
que o acompanha. Metadados que não cabem em seu orçamento são descartados inteiros
e relatados em metadata_omissions — nunca cortados no meio e nunca marcados
dentro do próprio campo, então nada em um campo controlado pela nota é
um prefixo ou prosa do servidor. frontmatter_yaml é a
fonte YAML do bloco frontmatter com as linhas de cerca removidas, normalizada para LF (o mesmo
resíduo de terminador declarado que content carrega); é a cópia
autoritativa, e a visualização JSON de frontmatter ao lado é uma conveniência que é
omitida, com um motivo, quando o YAML contém algo que o JSON não pode expressar.
limit pode reduzir o limite para uma única chamada, mas nunca aumentá-lo. Se seus
clientes realmente querem leituras maiores, aumente MAX_READ_RESPONSE_CHARS —
essa é uma decisão do operador, tomada uma vez, por alguém que conhece a
implantação.
Atualização: três mudanças visíveis de contrato.
read_noteem uma nota grande costumava retornar o conteúdo inteiro; agora ele trunca. A resposta é autodescritiva, então um agente não precisa de conhecimento prévio para continuar, mas um script que presumia leitura completa da nota deve passarsection=ou aumentar o limite.E
read_notecostumava retornar uma única string renderizada — um cabeçalho# <title>/**Path:**, um separador\n---\n, e então o conteúdo. Agora ele retorna campos, porque cada componente daquele cabeçalho era controlado pela nota: uma nota podia forjar o separador, então um agente que recuperava o corpo da seção dividindo a resposta podia recuperar uma string forjada e gravá-la de volta sobre a seção. Um cliente que analisava o envelope antigo deve lercontent(e, para leituras de seção,heading) em vez disso; clientes que ignoramstructuredContentainda recebem um bloco de texto JSON inequívoco.Sessões de painel agora são linhas no lado do servidor, então todos são desconectados uma vez nessa atualização. Um cookie emitido antes dela não carrega identificador de sessão, e tal cookie é recusado em vez de ser aceito retroativamente — aceitá-lo manteria a janela de replay antiga aberta por mais sete dias após a correção ser publicada. Entre novamente; não há nada para migrar.
Limites de taxa
O consumidor deste servidor é um agente, e um agente com rajadas de repetição ou com injeção de prompt é uma entrada comum. Três controles limitam a velocidade com que uma credencial pode criar trabalho.
- Um bucket geral —
MCP_RATE_LIMIT_PER_MINUTE(120) sustentado,MCP_RATE_LIMIT_BURST(30) de capacidade — em cada chamada de ferramenta. - Um bucket de escrita — 60/min, rajada 15 — que as oito ferramentas
de mutação do cofre devem passar adicionalmente, e que
PUT /transfer/uploadconsome também, cobrado do principal que cunhou a capacidade, para que a taxa de escrita não possa ser contornada cunhando links e resgatando-os. - Um orçamento por endereço para falhas de autenticação
/mcp— 60 falhas por 5 minutos — verificado antes da consulta de credencial, então uma sonda recusada não custa consulta ao banco de dados.
O bucket é por principal: uma chave de API, ou uma concessão OAuth.
Atualizar um token de acesso continua a mesma cota em vez de
cunhar uma nova, e duas aprovações /authorize separadas para o mesmo
cliente mantêm cotas independentes.
O que um agente realmente vê. Uma recusa é um resultado comum de ferramenta — nunca um erro de protocolo, nunca um conjunto de resultados vazio silencioso — e termina com uma linha legível por máquina:
Error: this credential exceeded its general rate limit of 120 calls per minute, so the call was refused before it ran. Nothing was read, written, or counted against the daily quota. Retry in 3 seconds, or slow the calling loop down.
MCP-REFUSAL {"code":"rate_limited","scope":"principal","limit":120,"limit_unit":"calls_per_minute","retry_after_seconds":3}
O sentinela MCP-REFUSAL está no início da linha e o JSON é uma linha, então
sobrevive a ser citado em uma transcrição. Uma ferramenta estruturada retorna o
mesmo texto em seu campo de erro declarado. retry_after_seconds está
presente apenas onde esperar pode realmente ajudar — uma recusa por
cofre não atribuído ou argumento não codificável o omite em vez de convidar um
loop que não pode terminar. A mesma forma cobre a cota diária
(over_quota), o limite de comprimento de consulta (argument_too_long), e recusas
de corpo de ferramenta como not_found, already_exists e invalid_path. Uma escrita
parcial também carrega um resultado tipado: leia sua explicação antes de tentar novamente,
porque alguns bytes podem já ter sido alterados. Resultados de busca vazios e
chamadas no-op bem-sucedidas permanecem sucessos.
As recusas de transporte estão fora desse contrato, porque não
há chamada de ferramenta para responder: uma solicitação não autenticada acima do orçamento ou uma recusa de concorrência MCP de solicitação/autenticação
recebe HTTP 429 com Retry-After, e o mesmo vale para um PUT /transfer/upload acima da taxa — que libera sua reivindicação em vez de consumi-la,
então o mesmo link ainda é resgatável quando o bucket se encher.
Notas operacionais.
- O estado do limitador está no processo e não é persistido, então um reinício começa
com cada bucket cheio. Isso é válido apenas porque o contêiner roda
--workers 1; aumentar o número de workers multiplica cada taxa acima pelo número de workers. - Recusas aparecem em
/admin/performancecomo contagens de recusa, não nos percentis de latência. Recusas repetidas de taxa e de slot forçado são coalescidas — uma linha por credencial/ferramenta/escopo porMCP_REFUSAL_LOG_INTERVAL_SECONDS, cada uma representando1 + suppressedrecusas — para que um loop de recusa não possa tornar a escrita do log a carga. - Os padrões de velocidade são estimativas contra uma amostra pequena. Leia
/admin/performancepor uma semana antes de tratar qualquer um como definitivo, e desative um definindo-o vazio,nullounone(zero é recusado na inicialização). - A cota diária é o teto durável e é separada: chaves criadas
a partir de agora recebem
DEFAULT_DAILY_REQUEST_LIMIT(5.000), chaves que já existiam mantêm o que tinham, e concessões OAuth não têm teto diário — apenas limites de velocidade.
A justificativa está em
docs/architecture/rate-limits.md.
Admissão de concorrência
A admissão de concorrência vem com MCP_CONCURRENCY_MODE=shadow. Ela registra
pressão sob concurrency_shadow em linhas de uso existentes e emite eventos
de segurança limitados para pressão de solicitação/autenticação. Chamadas mantêm seu resultado
real, contabilidade de cota e duração. O modo sombra observa a ocupação atual
com espera zero; ele não prevê como o tráfego se comportaria sob aplicação.
No modo enforce, o servidor limita solicitações MCP completas (incluindo streams
SSE abertos), sessões de banco de dados de autenticação, ferramentas e escritores de log de uso.
Ferramentas passam por velocidade, cofre e verificação de argumentos antes de adquirir slots; a cota
diária é verificada depois. Uma ferramenta rejeitada recebe slot_timeout sem
gastar cota diária. Espera zero significa admissão ou recusa imediata; uma espera
positiva usa uma fila limitada e um prazo. Uma dica de repetição não é uma promessa de que
uma chamada em execução terminará até aquele momento.
As quatro classes de ferramentas têm como padrão uma chamada concorrente cada: semantic_search
usa embedding, find_related usa vetor, as oito ferramentas de mutação do cofre usam
escrita, e as ferramentas restantes usam outro. Tetos globais, de locatário e de principal
têm como padrão 4, 3 e 2. Atualização OAuth mantém o mesmo principal. Tetos de solicitação completa e
por portador têm como padrão 32 e 4, autenticação 2, e escritores de uso
- Todas as configurações e limites de fila estão listados em
.env.example.
A inicialização valida o orçamento do pool como auth + 2 × tools + writers + 4 ≤ 15.
As quatro conexões de folga são compartilhadas com painel, OAuth, indexação e
trabalho de transferência; essa aritmética não pode garantir disponibilidade quando esses outros
consumidores a esgotam. O modo sombra não aplica esse orçamento. O controlador
está no processo e requer a implantação existente de worker único.
Revise observações de pressão e ocupação de streams de longa duração antes de habilitar
enforce. Escolha off para desativar a admissão de concorrência; os limites de velocidade
existentes e cotas diárias ainda se aplicam. Sombra requer espera zero de ferramenta e nunca
adiciona espera de escritor ou descarta uma linha de uso por causa de sua pressão observada.
Arquitetura
┌──────────────┐                       ┌──────────────────────┐
│ MCP clients  │   HTTP + Bearer key   │   FastAPI app        │
│  Claude Desk │ ────────────────────▶ │  ┌────────────────┐  │
│  Claude Code │                       │  │  MCP server    │  │
│  n8n agents  │                       │  │  (25 tools)    │  │
│  OpenWebUI   │                       │  └─────┬──────────┘  │
└──────────────┘                       │        ▼             │
                                       │  ┌────────────────┐  │
                                       │  │  Services:     │  │
                                       │  │  - vault       │  │
                                       │  │  - search      │  │
                                       │  │  - embeddings  │  │
                                       │  │  - links       │  │
                                       │  │  - indexer     │  │
                                       │  └─────┬──────────┘  │
                                       │        ▼             │
                                       │  ┌────────────────┐  │
                                       │  │ Postgres +     │  │
                                       │  │ pgvector       │  │
                                       │  └────────────────┘  │
                                       └──────────┬───────────┘
                                                  ▼
                                       ┌────────────────────┐
                                       │  Embedding         │
                                       │  provider          │
                                       │  (Ollama / OpenAI) │
                                       └────────────────────┘
Pipeline de indexação
.md files in vault
    ↓ skip dot-dirs
parse frontmatter, extract tags (YAML + inline #hashtags)
    ↓ SHA-256 hash
skip if unchanged
    ↓
UPSERT notes_metadata (path, title, tags[], frontmatter JSONB,
                       content_hash, tsvector, modified_at)
    ↓
extract wikilinks/embeds/markdown-links → resolve targets →
note_links (source_id, target_id or NULL for dangling)
    ↓
chunk content (512 tokens, no overlap) → embed via provider →
note_embeddings (note_id, chunk_index, chunk_text, embedding[N])
    ↓
set embedded_content_hash = content_hash
O indexador roda na inicialização e a cada INDEX_INTERVAL_SECONDS (5
minutos por padrão). Hashes são apenas de conteúdo, então o detector de mudanças
ignora variações de mtime. Embeddings obsoletos são detectados pela
incompatibilidade de embedded_content_hash != content_hash.
Esquema do banco de dados
| Tabela | Propósito |
|---|---|
notes_metadata | Caminho, título, tags, frontmatter, hash de conteúdo, hash de embedding, tsvector, hora de modificação |
note_embeddings | Uma linha por chunk. embedding é vector(EMBEDDING_DIMENSIONS). |
note_links | Grafo de wikilinks: IDs de origem/destino, target_path, tipo (link, embed, markdown) |
api_keys | Tokens de portador com hash, prefixo para exibição, permissão, expiração |
usage_logs | Auditoria por chamada de ferramenta |
oauth_clients, oauth_codes, oauth_tokens | Estado PKCE OAuth 2.0, incluindo o id de concessão que une os tokens de um consentimento |
transfer_tokens | Linhas de capacidade por trás dos links /transfer/*: direção, caminho de destino, estado, impressão digital, expiração |
users | Modo multiusuário: login, papel, vault_path por usuário, e o cofre sob o qual o índice foi construído pela última vez |
user_sessions | Uma linha revogável por sessão de navegador de painel ativa, chaveada no SHA-256 do id de sessão do cookie. Cascateia com o usuário. |
Índices GIN em content_tsvector e tags[]. Índices B-tree nas
chaves estrangeiras quentes. Índice de expressão HNSW pgvector
(embedding::halfvec(N)) halfvec_cosine_ops (m=16, ef_construction=64),
construído quando a dimensão é ≤ 2000; resultados são reclassificados pela
distância de precisão total. Consultas definem
hnsw.ef_search=80 e deduplicam por nota em Python após uma busca excessiva de 5x.
Estrutura do projeto
src/
  main.py             FastAPI app, lifespan, MCP mount
  config.py           pydantic-settings
  database.py         async SQLAlchemy engine/session
  models/db.py        ORM models
  mcp_server/         MCP server, tools, auth middleware
  services/           vault ops, anchored filesystem, search, FTS,
                      embeddings, links, indexer, transfer
  transfer/           public /transfer/* capability-redemption routes
  auth/               login, sessions, per-request identity context
  api/                control-panel REST endpoints
  control_panel/      Jinja2 templates and static assets
  oauth/              OAuth 2.0 authorization-code flow
alembic/              database migrations
scripts/              one-off ops scripts (e.g. reset_embeddings.py)
tests/                pytest suite + smoke-test docs
openspec/             change proposals (spec-driven workflow)
Desenvolvimento
pip install -r requirements-dev.txt
pytest
A suíte de testes unitários cobre a abstração do provedor de embedding, o
comportamento de lote e repetição da OpenAI, validação de configuração e a
verificação de inicialização de incompatibilidade de dimensão. Testes vinculados à rede usam respx para
simular httpx, então nenhum acesso real à rede é necessário.
Para executar o servidor fora do Docker:
DATABASE_URL=... SECRET_KEY=... VAULT_PATH=... uvicorn src.main:app --reload --no-proxy-headers
Alvos do Make
make init             First-time setup (data dirs, .env)
make build            Build Docker image (no cache)
make build-cached     Build Docker image (with cache)
make push             Push the image to the configured registry
make image            Build and push
make deploy           Build, scan, push, backup, migrate, recreate container
make up / down / restart / shell   Container lifecycle
make logs             Tail container logs
make db-init          Create database, user, and pgvector extension
make db-migrate       Run alembic migrations
make db-check         alembic check — schema vs. ORM models (must be clean)
make test-schema      Schema gate: migrations vs. models on a throwaway pgvector container
make db-backup        Dump database to backups dir
make db-restore FILE=<path>   Restore from a backup
make reindex          Explain how to trigger a reindex (panel only; there is no headless trigger)
make reset-embeddings Drop and recreate embedding column at configured dim
make rebuild-tsvectors Recompute keyword index for FTS_CONFIGS (no embeddings, no API calls)
make status           Show container and health status
make audit            Audit Python dependencies (pip-audit)
make trivy            Scan the local image for HIGH/CRITICAL CVEs (SCAN_IMAGE=obsidian-mcp:local for the bundled stacks)
make clean            Remove containers and images (data preserved)
make deploy executa todo o pipeline: build, varredura de imagem, push, backup de banco
de dados, alembic upgrade head, e então recria o contêiner. Execute
make test-schema antes de qualquer implantação que carregue uma migração, e
make db-check depois de uma.
Notas de segurança
- Chaves de API usam o prefixo
omcp_e são armazenadas como hashes SHA-256. A chave bruta é exibida exatamente uma vez na criação. - O painel de controle deve ficar atrás de um gateway de autenticação
externo. O
docker-compose.ymlincluído usa Traefik com uma cadeia OAuth. Não exponha o/admindiretamente à internet. - As sessões do painel são linhas no lado do servidor. O cookie assinado carrega um ID aleatório de 256 bits; o banco de dados armazena apenas seu SHA-256, então um dump do banco de dados não contém sessão utilizável. Sair revoga essa linha, e uma alteração de senha, um reset de administrador, uma desativação ou uma exclusão revoga todas as sessões da conta.
- A tela de consentimento OAuth identifica o cliente sobre o qual está perguntando:
o host de redirecionamento para o qual o código de autorização seria enviado (obtido
do hostname da URI, nunca do seu
netloc, e exibido em punycode em vez de decodificado), o ID de cliente gerado pelo servidor e a data de registro. Cada renderização diz que o aplicativo se registrou e não é verificado por este servidor; um host fora doOAUTH_KNOWN_REDIRECT_HOSTSé destacado como não reconhecido. - A chave OpenAI é renderizada na página de configurações como
key[:8] + "..." + key[-4:]e nunca aparece completa em HTML ou fontes JS. - A travessia de caminho é bloqueada na camada de serviço, e a contenção é
comprovada pelo kernel: cada diretório abaixo da raiz do vault é aberto
com um
openat2(RESOLVE_BENEATH | RESOLVE_NO_SYMLINKS | RESOLVE_NO_MAGICLINKS)a partir de um descritor de raiz aberto, e o restante da operação age nesse descritor em vez de re-percorrer um nome. - Ferramentas de mutação agem no caminho como nomeado. Um componente final que é um symlink é recusado (nomeando o alvo do link) em vez de ser seguido, então um alias dentro do vault não pode redirecionar uma escrita. Leituras ainda seguem links, que é para isso que um alias serve.
- Cada guarda de caminho também recusa componentes ocultos, então
.obsidian,.git,.trashe similares estão fora do alcance de toda ferramenta. - Links de transferência carregam seu token no fragmento da URL, que os navegadores
nunca enviam, e são resgatados apenas a partir de um cabeçalho
Authorization: Bearer. Mantenha o log de cabeçalhos desligado no seu proxy reverso e APM. Tokens desconhecidos, expirados, consumidos e revogados todos recebem um único 404 idêntico das rotas públicas; o status preciso vem da ferramenta autenticadacheck_upload. import_from_urlbusca apenas endereços genuinamente públicos, sob uma lista de negação explícita reaplicada a cada redirecionamento.- A autenticação
/mcpfalha é orçada por endereço de cliente, contada antes da consulta de credenciais, então uma sonda recusada não custa sessão de banco de dados nem consulta. O endereço vem dos cabeçalhos de proxy que o aplicativo confia, nunca de um cabeçalho lido diretamente, e uma requisição sem endereço resolvível é cobrada em um slot compartilhado em vez de isenta. O que isso limita é o trabalho de banco de dados que um chamador não autenticado pode forçar; não é uma defesa contra adivinhar uma chave de 256 bits. Veja Rate limits. - Consultas parametrizadas em todo lugar. Sem interpolação de strings em SQL.
- Cabeçalhos de resposta incluem HSTS,
X-Content-Type-Options: nosniff,X-Frame-Options: DENYeReferrer-Policy: no-referrer. O painel, login e páginas de consentimento adicionam uma Content-Security-Policy com nonce por resposta e sem script inline (PANEL_CSP). - Os saltos do próprio aplicativo são verificados na inicialização: o banco de dados segue
DATABASE_SSL_MODE, e o endpoint de incorporação deve serhttpsou loopback, a menos queEMBEDDING_ALLOW_PLAINTEXTdiga o contrário. Cada início registra uma linha de transporte por salto e um evento de segurançainternal_transport_plaintextpara cada salto ainda em texto claro.
Status
Autor único, em uso ativo como exocórtex pessoal do mantenedor (mais de 2.500 notas, múltiplos agentes conectados). Público para qualquer pessoa que queira fazer um fork. Issues e PRs são bem-vindos, mas espere revisão opinativa. Este é um sistema funcional, não uma plataforma genérica.
Licença
MIT. Veja LICENSE.