knowledge-rag
Sistema RAG local para Claude Code com busca híbrida (semântica + BM25), reclassificação por cross-encoder, chunking consciente de markdown, 9 formatos de arquivo, monitor de arquivos e 12 ferramentas MCP. Zero servidores externos. pip install knowledge-rag
Documentação
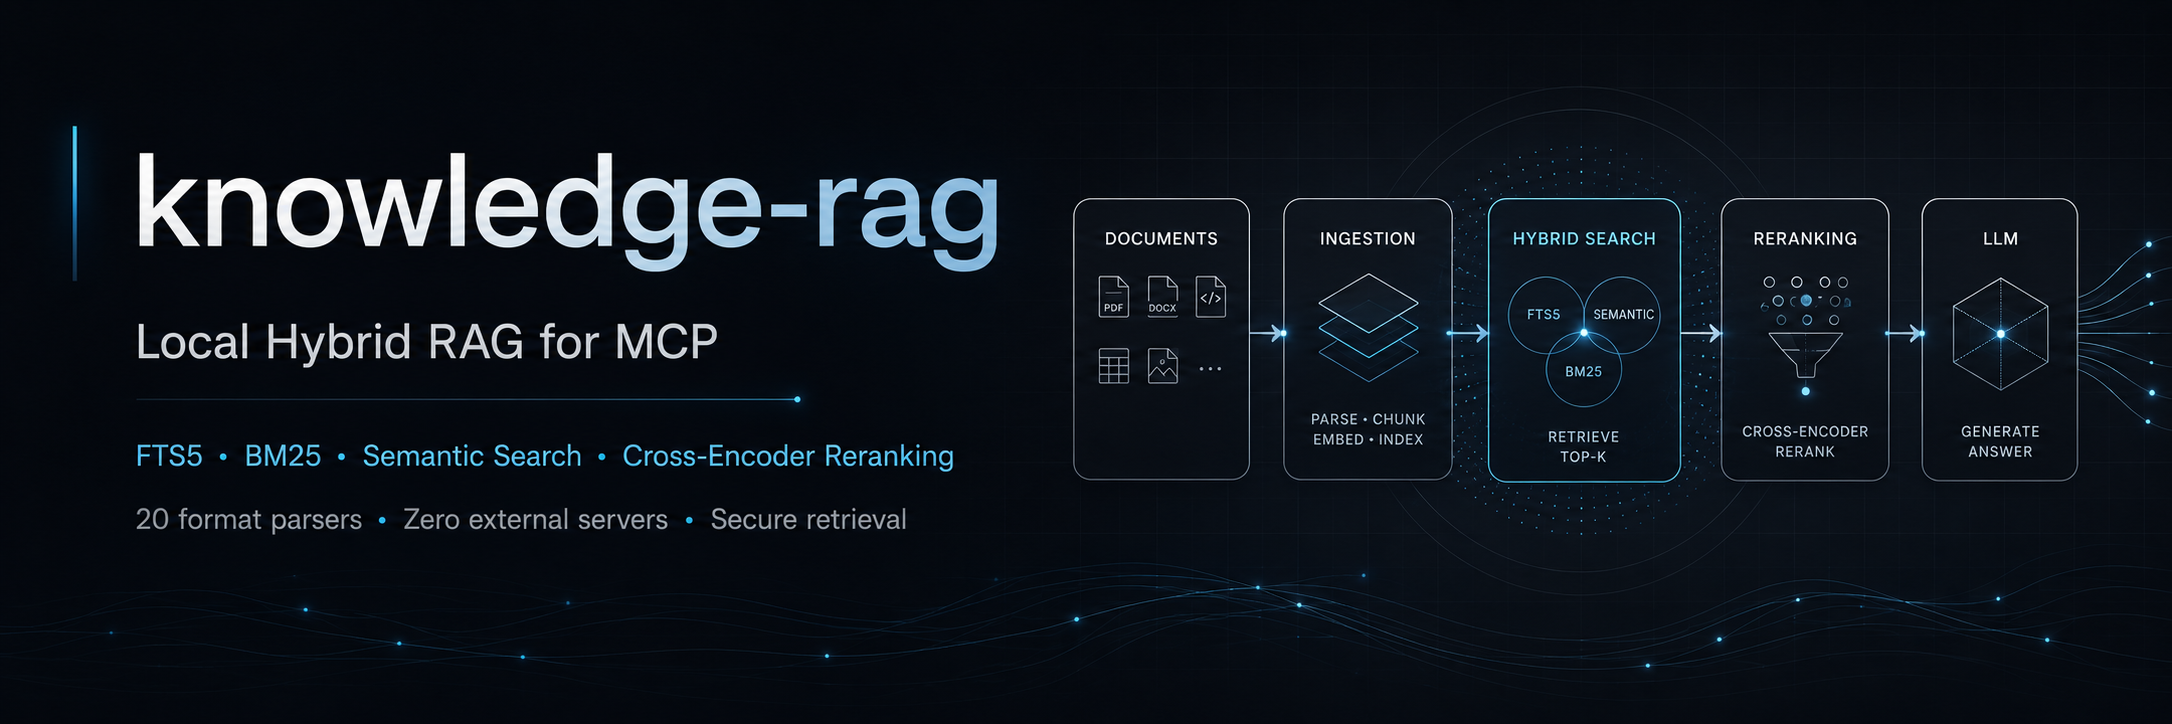
knowledge-rag


O servidor RAG local focado em MCP para Claude Code, Cursor e todos os agentes de IA.
Busca híbrida · Reordenação por cross-encoder · 35 formatos de arquivo · 100% local · Zero nuvem · Infraestrutura de nível empresarial embutida.
pip install knowledge-rag → restart Claude Code → search_knowledge("your query")
Início Rápido · Por que knowledge-rag · Comparar · Recursos Empresariais · Documentação
⭐ Histórico de Estrelas

Gráfico atualizado diariamente por GitHub Action
🎯 Por que knowledge-rag
A maioria dos frameworks de RAG cai em uma de três armadilhas: (1) exigem que você envie seus dados para uma API na nuvem, (2) entregam 300 blocos de construção e 0 padrões opinativos, ou (3) empacotam RAG como um recurso de 5% de uma plataforma muito maior que você não pediu.
knowledge-rag faz uma coisa bem: é o servidor RAG local nativo de MCP que Claude Code, Cursor, Windsurf, VS Code, Cline, Gemini CLI e Zed podem consultar de imediato — com infraestrutura empresarial (autenticação bearer, métricas Prometheus, limite de taxa, sondas de saúde, logging JSON estruturado, reindexação sem downtime) que nenhum outro OSS focado em RAG oferece embutido.
🔒 100% local, 0% nuvemSeus arquivos nunca saem da máquina. Sem dependência de fornecedor, sem dor de cabeça com residência de dados, sem dependência forçada de nuvem. Conforme LGPD / GDPR / HIPAA por arquitetura — porque não há nada a cumprir quando nada sai. |
🚀 Configuração sem atrito
|
🛡️ OSS de nível de produçãoPortão de qualidade com 7 pilares em todo PR (35+ verificações automatizadas), matriz de CI OS×Python de 9 células (Linux + Windows + macOS × 3.11/3.12/3.13), testes de caos noturnos + soak de 50K iterações + teste de mutação. 700+ testes. 0 regressões conhecidas. |
💰 Custo contínuo zeroSem contas de tokens. Sem camada SaaS. Sem recursos pagos escondidos atrás de um muro. Licença MIT, para sempre. Roda no laptop que você já tem — GPU opcional, CPU funciona bem com FastEmbed ONNX. |
📊 Como knowledge-rag se compara a outros frameworks de RAG
Auditamos 16 frameworks e plataformas populares de RAG (LlamaIndex, LangChain, ChromaDB, Weaviate, Qdrant, RAGFlow, LightRAG, DSPy, GraphRAG, Haystack, RAG-Anything, kotaemon, txtai, llmware, Dify, open-webui, FastGPT) para que você possa escolher com honestidade.
Legenda: ✅ embutido · 🟡 plugin / nível pago / parcial · ❌ não disponível · ⚠️ preocupação com licença ou padrão
| Dimensão | 🎯 knowledge-rag | LlamaIndex | LangChain | Haystack | RAGFlow | txtai | open-webui | Dify | Qdrant |
|---|---|---|---|---|---|---|---|---|---|
| 100% local, zero nuvem | ✅ | 🟡 | ✅ | 🟡 | 🟡 | ✅ | ✅ | 🟡 | 🟡 |
| Nativo MCP (Claude/Cursor) | ✅ 13 ferramentas | 🟡 pkg | 🟡 adaptador | 🟡 wrapper | 🟡 add-on | ✅ | ✅ consumidor | ✅ | ❌ |
| Híbrido BM25 + semântico | ✅ 128× mais rápido | 🟡 | 🟡 | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| Reordenação por cross-encoder | ✅ embutido | ❌ | 🟡 | ✅ | ✅ fundido | ❌ | ✅ | 🟡 | 🟡 |
| Autenticação bearer embutida | ✅ | ❌ | ❌ | ❌ núcleo | ❌ | 🟡 | ✅ RBAC | ✅ OAuth2 | ✅ |
Prometheus /metrics | ✅ | ❌ | ❌ | ❌ núcleo | ❌ | ❌ | ✅ OTel | ❌ | ✅ |
| Limite de taxa | ✅ janela deslizante | ❌ | ❌ | ❌ | ❌ | ❌ | ✅ | ✅ | ✅ |
Sondas de saúde (/health) | ✅ | ❌ | ❌ | ❌ | ❌ | ❌ | 🟡 | 🟡 | ✅ |
| Logging JSON estruturado | ✅ opt-in | ❌ | ❌ | ❌ | ❌ | ❌ | ✅ OTel | 🟡 | ✅ |
| Reindexação sem downtime | ✅ | ❌ | ❌ | ❌ | ❌ | ❌ | ❌ | ❌ | ✅ |
| Reindexação assíncrona em segundo plano | ✅ + polling | ❌ | ❌ | ❌ | ❌ | ❌ | ❌ | ❌ | 🟡 |
| GPU CUDA opcional | ✅ 12 auto | ❌ | 🟡 | ✅ | ✅ | ✅ | ✅ | 🟡 | 🟡 |
| Formatos de arquivo embutidos | ✅ 20 | 0 (LlamaParse=$) | 50+ plugins | ✅ 36+ | 8+ | ? | ? | ~10 | ❌ |
| Configuração < 5 min POC | ✅ pip 1-liner | ✅ | ✅ | ✅ | ❌ 16GB RAM | ✅ | ✅ docker | ✅ docker | ✅ |
| Caos noturno + soak + mutação | ✅ | ❌ | ❌ | ❌ | ❌ | ❌ | ❌ | ❌ | ❌ |
| Licença | ✅ MIT | MIT | MIT | Apache-2.0 | Apache-2.0 | Apache-2.0 | ⚠️ preservadora | ⚠️ restritiva | Apache-2.0 |
As 5 dimensões onde knowledge-rag é único: sondas de saúde + logging JSON + Prometheus + limite de taxa + autenticação bearer simultaneamente embutidos em um servidor MCP OSS focado em RAG. Reindexação sem downtime + reindexação assíncrona em segundo plano + caos/soak/mutação noturnos estão documentados no README de ninguém mais.
🚀 Início Rápido (3 minutos, do zero à sua primeira consulta)
Escolha seu caminho de integração — knowledge-rag entrega o mesmo servidor por todos os canais.
Caminho 1 — Claude Code, Cursor, Windsurf, Cline, VS Code, Gemini CLI, Zed (MCP)
pip install knowledge-rag
knowledge-rag init                    # scaffolds config.yaml + documents/
Coloque seus PDFs, markdown e arquivos de código em documents/. Reinicie seu cliente MCP. Pergunte:
search_knowledge("your query")
É isso. A primeira consulta carrega o modelo de embeddings ONNX (~200MB, download único). Consultas subsequentes são armazenadas em cache e atingem latência abaixo de um segundo.
Caminho 2 — Servidor HTTP / SSE (multi-usuário, air-gapped, balanceado)
# config.yaml
server:
  transport: "sse"                    # or "streamable-http"
  host: "0.0.0.0"
  port: 8179
  auth:
    bearer_token: "your-secret-token"
  rate_limit:
    enabled: true
    requests_per_minute: 60
  metrics:
    enabled: true
    port: 9179
  logging:
    format: "json"                    # ELK / Loki / Datadog / CloudWatch ready
knowledge-rag --transport sse
- Sonda de saúde:
curl http://your-host:8179/health→ 200 + payload JSON - Coleta Prometheus:
http://your-host:9179/metrics - Despachante MCP: autenticado via
Authorization: Bearer your-secret-token
Caminho 3 — Docker (modelos pré-baixados, pronto para air-gapped)
docker pull ghcr.io/lyonzin/knowledge-rag:latest
docker run -v $(pwd)/documents:/app/documents -p 8179:8179 ghcr.io/lyonzin/knowledge-rag:latest
Guia de instalação completo com todos os 5 métodos, 8 configurações de clientes MCP e configuração de GPU: docs/INSTALLATION.md →
🤖 Habilidades prontas para agentes de IA
Instalar knowledge-rag dá ao seu agente 13 ferramentas MCP. Ele não diz ao agente quando usá-las. É isso que a pasta skills/ resolve — habilidades comportamentais prontas para Claude Code, Cursor, Windsurf, Cline, Zed, VS Code Copilot que transformam "IA com acesso a RAG" em "IA que realmente usa RAG primeiro".
10 habilidades, licença MIT, organizadas por tipo:
| # | Habilidade | O que faz |
|---|---|---|
| 1 | rag-check-first | Busca no corpus antes de responder qualquer afirmação técnica |
| 2 | rag-cite-sources | Toda afirmação acompanha citações path:line |
| 3 | rag-onboard-context | A primeira interação de uma sessão verifica o que está indexado |
| 4 | rag-deep-dive | Perfuração em 3 etapas: search → fetch → find similar |
| 5 | rag-web-fallback | Só acessa a web quando o RAG local retorna vazio |
| 6 | rag-troubleshoot | Bug / erro → RAG primeiro para correções anteriores |
| 7 | rag-code-review | Revisão consulta ADRs / padrões antes de comentar |
| 8 | rag-index-decisions | Após uma decisão, indexa de volta — fecha o ciclo de feedback |
| 9 | rag-security-first | Tarefas de segurança: MITRE / CVE / runbook primeiro |
| 10 | rag-evaluate-quality | Verificação semanal — MRR@5 · Recall@5 · Precision@5 |
Instalação — escolha o caminho mais curto para sua máquina:
# Option 1 — Via skills.sh (needs Node — one command, zero clone)
npx skills add lyonzin/knowledge-rag

# Option 2 — Via our install.sh (no Node needed; works on Linux/macOS/WSL/Git Bash)
curl -fsSL https://raw.githubusercontent.com/lyonzin/knowledge-rag/master/skills/install.sh | bash
Ambos reiniciam o Claude Code e você está pronto. A opção 2 suporta --project, --only rag-check-first,rag-cite-sources, --dry-run, --help.
Para Cursor, Windsurf, Cline e instruções manuais completas → skills/README.md · Catálogo completo com cadeias de habilidades → skills/CATALOG.md
🛠️ As 13 ferramentas MCP que seu agente recebe
Após a instalação, seu agente de IA recebe automaticamente estas 13 ferramentas:
| Ferramenta | Finalidade |
|---|---|
search_knowledge | Semântica híbrida + BM25 com reordenação por cross-encoder |
get_document | Recupera o conteúdo completo de um documento |
search_similar | Encontra documentos semelhantes a uma referência |
evaluate_retrieval | Mede MRR@5 · Recall@5 · Precision@5 |
add_document | Indexa um novo documento via MCP |
update_document | Reindexa um documento alterado |
remove_document | Remove um documento e todos os seus chunks |
add_from_url | Busca, sanitiza e indexa uma URL |
list_documents | Enumera documentos indexados |
list_categories | Auto-taggeado pelo caminho da pasta |
get_index_stats | Tamanho do corpus, taxa de acerto de cache, dimensão do embedding |
reindex_documents | Reconstrução incremental inteligente OU nuclear |
get_reindex_status | Polling de progresso ao vivo (reindexação assíncrona) |
Referência completa da API com detalhes de parâmetros, esquemas de retorno e exemplos: docs/API.md →
🏢 Recursos Empresariais (embutidos, zero configuração)
Todo framework de RAG afirma ser "pronto para produção". Aqui está o que knowledge-rag entrega no núcleo OSS, verificado por testes de regressão, que concorrentes ou cobram, ou transformam em plugin, ou simplesmente não têm.
Segurança
|
Observabilidade
|
Escala e desempenho
|
Confiabilidade
|
💼 Casos de Uso (corpora reais, equipes reais)
Equipes de Segurança — Red / Blue / CTF
Preset: cybersecurity.yaml · 8 categorias · 200+ palavras-chave de roteamento · 69 expansões de consulta
Ingira MITRE ATT&CK, relatórios de ameaças, writeups de exploits, relatórios de incidentes. Pesquise a partir do Claude Code com search_knowledge("privilege escalation windows") e obtenha recall instantâneo em todo o seu corpus. Air-gapped — nada sai do laptop.
Equipes de Desenvolvimento — Documentos de Design, Runbooks, Código
Preset: developer.yaml · 9 categorias · 150+ palavras-chave de roteamento · 50+ expansões
Substitua a busca no Confluence. Ingira documentos de arquitetura, ADRs, runbooks, código, especificações de API. Devs perguntam ao seu agente de IA "como autenticamos o serviço de pagamento" e obtêm o ADR exato + citação do arquivo de implementação.
Laboratórios de Pesquisa — Artigos, Cadernos, Datasets
Preset: research.yaml · 9 categorias · 100+ palavras-chave de roteamento · 40+ expansões
Indexe artigos do arXiv, cadernos de laboratório, documentação de datasets. A busca semântica encontra artigos por intenção, não apenas por palavras-chave — o reranking com cross-encoder destaca o realmente relevante em vez de cinco que compartilham um termo.
Base de Conhecimento Empresarial — Air-gapped, Auditável
Preset: general.yaml · tela em branco, busca semântica pura
Implante via SSE em uma única VM. 40+ usuários autenticados via bearer token, com rate limit, monitorados por Prometheus, sondas /health conectadas ao seu load balancer, logs JSON enviados ao Datadog. Sem chamadas em nuvem. Atende aos requisitos de localidade de dados LGPD, GDPR e HIPAA por design.
Verificado em escala: reprodução em produção em um corpus de 5.889 documentos / 75.016 chunks com consultas concorrentes durante um rebuild nuclear — zero downtime, zero erros (veja CHANGELOG v4.8.3).
🏗️ Arquitetura em resumo
Visão de ponta a ponta de como clientes MCP, o pipeline de recuperação, armazenamento e a infraestrutura empresarial se conectam. Cada seta é um caminho de código real — nada aqui é aspiracional.
flowchart TB
    subgraph CLIENTS["MCP Clients (any of these)"]
        C1[Claude Code]
        C2[Claude Desktop]
        C3[Cursor]
        C4[Windsurf]
        C5[VS Code · Cline · Gemini CLI · Zed]
    end

    subgraph TRANSPORT["Transport Layer"]
        T1[stdio<br/>1 process per client]
        T2[SSE / streamable-http<br/>1 server serves N clients]
    end

    subgraph MIDDLEWARE["ASGI Middleware Chain (HTTP mode)"]
        M1[HealthMiddleware<br/>/health · /healthz]
        M2[BearerAuthMiddleware<br/>constant-time compare]
        M3[Rate Limiter<br/>sliding window]
    end

    subgraph MCP["13 MCP Tools (frozen contract)"]
        MT1[search_knowledge]
        MT2[get_document · search_similar]
        MT3[add_document · add_from_url · update · remove]
        MT4[reindex_documents · get_reindex_status]
        MT5[list_documents · list_categories · get_index_stats · evaluate_retrieval]
    end

    subgraph SEARCH["Retrieval Pipeline"]
        R[Query Router<br/>lexical vs semantic]
        F[FTS5 Fast-Path<br/>opt-in · lt 10ms]
        BM[BM25 Inverted Index<br/>128x faster than baseline]
        SE[Semantic Search<br/>FastEmbed ONNX lazy-loaded]
        RRF[Reciprocal Rank Fusion]
        CE[Cross-Encoder Rerank<br/>MiniLM-L-6-v2]
        QC[Query Cache<br/>LRU + 5-min TTL]
    end

    subgraph STORAGE["Storage (100% local)"]
        CH[ChromaDB<br/>vectors + metadata<br/>WAL mode]
        FT[SQLite FTS5<br/>lexical index<br/>WAL + busy-timeout]
        MD[index_metadata.json<br/>durable state]
    end

    subgraph INGEST["Document Ingestion"]
        FS[documents/ folder]
        WD[Watchdog<br/>10s debounce]
        PA[35 Parsers<br/>MD · PDF · DOCX · code · IaC · IPYNB]
        CK[Chunker<br/>markdown-aware · code-aware]
        EM[FastEmbed ONNX<br/>384D bge-small-en-v1.5]
        DD[SHA256 Dedup]
        SW[Zero-downtime Staging Swap<br/>rollback on validation fail]
    end

    subgraph OBS["Enterprise Observability (opt-in)"]
        PM[Prometheus /metrics<br/>7 canonical + histograms]
        LG[Structured JSON logs<br/>ELK · Loki · Datadog · CloudWatch]
        HC[Health payload<br/>version · uptime · cache stats]
    end

    subgraph CFG["Configuration"]
        YM[config.yaml<br/>+ 5 domain presets]
    end

    C1 & C2 & C3 & C4 & C5 -->|MCP protocol| T1
    C1 & C2 & C3 & C4 & C5 -.->|remote deploy| T2
    T1 --> MCP
    T2 --> M1 --> M2 --> M3 --> MCP

    MT1 --> QC
    QC -->|cache miss| R
    R -->|lexical| F
    R -->|semantic| SE
    R -->|hybrid| BM
    F --> CH
    F --> FT
    BM --> CH
    SE --> CH
    BM --> RRF
    SE --> RRF
    RRF --> CE
    CE --> QC

    MT2 --> CH
    MT3 --> INGEST
    MT4 --> SW
    MT5 --> CH

    FS --> WD --> PA
    PA --> CK --> EM --> DD --> CH
    SW -.->|atomic swap| CH
    SW -.-> FT
    CH -.-> MD

    MCP -.->|instrumented| PM
    MCP -.->|logs| LG
    M1 --> HC

    YM -.-> SEARCH
    YM -.-> STORAGE
    YM -.-> OBS
    YM -.-> MIDDLEWARE

    classDef client fill:#3776AB,stroke:#1e5a8a,color:#fff
    classDef transport fill:#00A67E,stroke:#006e54,color:#fff
    classDef middleware fill:#6b46c1,stroke:#4c1d95,color:#fff
    classDef storage fill:#4b5563,stroke:#1f2937,color:#fff
    classDef obs fill:#dc2626,stroke:#7f1d1d,color:#fff
    classDef ingest fill:#f59e0b,stroke:#78350f,color:#fff

    class C1,C2,C3,C4,C5 client
    class T1,T2 transport
    class M1,M2,M3 middleware
    class CH,FT,MD storage
    class PM,LG,HC obs
    class FS,WD,PA,CK,EM,DD,SW ingest
Lendo o diagrama (de cima para baixo):
- Qualquer cliente MCP — Claude Code, Cursor, Windsurf e outros 5 — conecta-se via transporte de sua escolha (stdio para uso pessoal, SSE/streamable-http para equipes).
- O modo HTTP encadeia 3 middlewares ASGI em ordem: sondas de saúde primeiro (sempre respondidas), depois autenticação bearer (cercada por
WWW-Authenticate), depois limitador de taxa (janela deslizante). - Todas as 13 ferramentas MCP são decoradas com
@rate_limited+@instrument— Prometheus conta cada chamada, o limitador de taxa aplica RPM+burst, ambos com custo zero quando desabilitados. search_knowledgeverifica o cache de consultas primeiro; em caso de cache miss, roteia pelo Query Router (classificador regex) para o fast-path FTS5 (léxico) ou o pipeline híbrido (BM25 + semântico + RRF + rerank com cross-encoder).- O armazenamento é 100% local: ChromaDB (modo WAL) para vetores + metadados, SQLite FTS5 (WAL + busy-timeout) para o fast-path léxico,
index_metadata.jsonpara estado durável. - A ingestão de documentos é contínua: o watchdog observa
documents/, 35 parsers lidam com cada formato, o chunker respeita limites de idioma, FastEmbed ONNX gera embeddings, SHA256 deduplica, e um swap de staging realiza rebuilds sem downtime com rollback em caso de falha. - Observabilidade empresarial (opt-in) —
/metricsdo Prometheus, logs JSON estruturados, payload/health— conecta-se aos mesmos pontos de instrumentação, sem necessidade de mudanças de código. config.yaml(com 5 presets de domínio) controla todos os subsistemas — sem spaghetti de variáveis de ambiente, sem caminhos hardcoded.
Arquitetura completa — 4 diagramas Mermaid detalhados (Visão Geral do Sistema · Fluxo de Consulta · Ingestão de Documentos · efeito hybrid_alpha): docs/ARCHITECTURE.md
📄 35 Formatos de Arquivo — analisados nativamente, sem plugins
Cada parser é ciente de chunks — Markdown divide em cabeçalhos ##, código divide em limites de função/classe, notebooks ignoram saídas base64, PDFs usam PyMuPDF, planilhas extraem folha por folha. 33 formatos são habilitados por padrão; os 2 formatos MetaTrader são opt-in (adicione em documents.supported_formats em config.yaml).
| # | Formato | Extensão | Parser | Padrão | Notas |
|---|---|---|---|---|---|
| 1 | Markdown | .md | Ciente de seção (divide em ##) | Sim | Cabeçalhos preservados como limites de chunk |
| 2 | Texto Puro | .txt | Chunking de tamanho fixo | Sim | 1000 caracteres + 200 de sobreposição |
| 3 | .pdf | Extração PyMuPDF | Sim | Apenas PDFs baseados em texto (sem OCR) | |
| 4 | Word | .docx | python-docx | Sim | Cabeçalhos preservados como markdown |
| 5 | Excel | .xlsx | openpyxl | Sim | Extração folha por folha |
| 6 | PowerPoint | .pptx | python-pptx | Sim | Extração slide por slide |
| 7 | Jupyter Notebook | .ipynb | Parser ciente de células | Sim | Apenas células Markdown + código; ignora saídas/base64 |
| 8 | JSON | .json | Ciente de estrutura | Sim | Extração de chave-valor achatada |
| 9 | CSV | .csv | Parser baseado em linhas | Sim | Cabeçalhos + linhas como texto |
| 10 | XML | .xml | Parser XML | Sim | Elemento raiz + metadados de namespace |
| 11 | Python | .py | Parser ciente de código | Sim | Funções/classes como chunks |
| 12 | C Source | .c | Parser ciente de código | Sim | Funções / structs / includes extraídos |
| 13 | C/C++ Header | .h | Parser ciente de código | Sim | Declarações de função + structs extraídos |
| 14 | C++ Source | .cpp | Parser ciente de código | Sim | Classes / structs / includes extraídos |
| 15 | JavaScript | .js | Parser ciente de código | Sim | Funções / classes / imports (ESM + CJS) |
| 16 | React JSX | .jsx | Parser ciente de código | Sim | Mesmo que o parser JS |
| 17 | TypeScript | .ts | Parser ciente de código | Sim | Funções / classes / interfaces / enums / imports |
| 18 | React TSX | .tsx | Parser ciente de código | Sim | Mesmo que o parser TS |
| 19 | Go | .go | Parser ciente de código | Sim | Funções / structs / imports extraídos |
| 20 | Rust | .rs | Parser ciente de código | Sim | Funções / structs / enums / traits / imports use |
| 21 | Kotlin | .kt | Parser ciente de código | Sim | Funções (incl. membros de classe) / classes extraídas |
| 22 | YAML | .yaml | Parser YAML | Sim | Kubernetes kind / apiVersion / name extraídos |
| 23 | YAML | .yml | Parser YAML | Sim | Mesmo que o parser YAML |
| 24 | HuJSON | .hujson | Parser HuJSON | Sim | JSON com comentários + vírgulas finais (ex.: ACLs Tailscale) |
| 25 | CUE | .cue | Parser ciente de código | Sim | Imports / package extraídos |
| 26 | Protocol Buffers | .proto | Parser Proto | Sim | Services / messages / RPCs extraídos |
| 27 | Rego | .rego | Parser ciente de código | Sim | Políticas OPA — imports / package extraídos |
| 28 | SQL | .sql | Parser SQL | Sim | Nomes de tabelas + tipos de statement extraídos |
| 29 | Shell | .sh | Parser Shell | Sim | Nomes de funções extraídos |
| 30 | jq | .jq | Parser Shell | Sim | Indexado como script estilo shell |
| 31 | Dockerfile | Dockerfile | Parser de texto | Sim | Correspondido por nome de arquivo exato (sem extensão) |
| 32 | Makefile | Makefile | Parser de texto | Sim | Correspondido por nome de arquivo exato (sem extensão) |
| 33 | Tiltfile | Tiltfile | Parser ciente de código | Sim | Starlark — funções def / load() extraídos |
| 34 | MQL4 Source | .mq4 | Parser de código | Não | MetaTrader — opt-in via documents.supported_formats |
| 35 | MQL4 Header | .mqh | Parser de código | Não | MetaTrader — opt-in via documents.supported_formats |
Habilite um formato opt-in — adicione a extensão em
documents.supported_formatsno seuconfig.yaml:documents: supported_formats: [".md", ".pdf", ".mq4", ".mqh"]
Referência completa do parser com notas por formato: docs/CONFIGURATION.md
🔌 Escolha sua integração MCP
|
Claude Code |
Claude Desktop |
Cursor |
Windsurf |
VS Code |
Cline · Gemini CLI · Zed |
Guia completo de configuração do cliente com schemas JSON por cliente: docs/INSTALLATION.md#use-with-other-mcp-clients →
⚙️ Configuração em 30 segundos
# config.yaml — everything is optional; defaults just work

paths:
  documents_dir: "./documents"
  data_dir: "./data"

models:
  embedding:
    profile: "compact"                  # "compact" | "quality" | "multilingual" | "custom"
    gpu: "auto"                         # "auto" | "true" | "false"
  reranker:
    enabled: true                       # cross-encoder rerank

search:
  default_results: 5
  max_results: 100

server:                                 # optional — SSE / HTTP mode
  transport: "stdio"                    # or "sse" / "streamable-http"
  auth:
    bearer_token: ""                    # set a secret to enable auth
  rate_limit:
    enabled: false
  metrics:
    enabled: false
  logging:
    format: "text"                      # or "json"
Presets pré-construídos: cybersecurity.yaml · developer.yaml · research.yaml · general.yaml · multilingual.yaml
Referência completa de configuração — cada campo, cada padrão, guia de tuning: docs/CONFIGURATION.md →
🔒 Segurança & Conformidade
knowledge-rag é projetado para equipes que não podem deixar seus documentos saírem do perímetro.
| Requisito | Como knowledge-rag atende |
|---|---|
| Localidade de dados (LGPD / GDPR / HIPAA) | 100% on-premise, zero chamadas de rede de saída após o download inicial do modelo |
| Implantação air-gapped | Modelos ONNX pré-cacheados; defina HF_HUB_OFFLINE=1 para forçar zero-rede |
| Monitoramento de CVEs | Dependabot (semanal) + pip-audit + Socket + CodeQL |
| Segurança da cadeia de suprimentos | PyPI Trusted Publishing via OIDC (sem tokens de longa duração) |
| Divulgação de vulnerabilidades | Aviso de segurança privado via SECURITY.md |
| Atestados de release assinados | Atestados de release do GitHub em cada versão publicada |
| Builds reproduzíveis | requirements.txt bloqueado com versões fixadas |
| Acesso autenticado | Middleware de bearer token em transportes SSE / HTTP (comparação em tempo constante, RFC 6750) |
| Rate limiting | RPM + burst por cliente em janela deslizante (opt-in, custo zero quando desabilitado) |
| Logging pronto para auditoria | Logs JSON estruturados opt-in → envie para seu SIEM |
| Defesas contra path traversal | Guardas CWE-22 / CWE-59 em 6 ferramentas CRUD |
| Defesa contra injeção de prompt | Sanitização em 3 camadas em add_from_url (OWASP LLM01:2025) |
Badge OpenSSF Best Practices: aprovado · ID do projeto #13864
📈 Números que importam
- Mais de 26.000 downloads totais no PyPI · mais de 250 estrelas no GitHub · mais de 70 equipes empresariais (privadas + comunidade)
- Mais de 700 testes coletados · proporção de 1,33:1 teste-código · gate de tendência codecov ±0,5 pp
- Mais de 35 verificações de status em cada PR (matriz de 9 células SO×Python · 7 pilares de qualidade)
- 35 formatos de arquivo analisados nativamente · 13 ferramentas MCP congeladas · 5 predefinições de domínio (cyber · dev · pesquisa · multilíngue · geral)
- BM25 128× mais rápido que a linha de base · cross-encoder +1,88 pp Recall@10 (p<0,001) · cache −40% latência p95
- Mais de 1.800 arquivos / 39 K chunks indexados em < 3 min em um laptop moderno (corpus típico de desenvolvedor)
- Verificado em produção em corpora de 5.889 documentos / 75.016 chunks
Painel de benchmark público: https://lyonzin.github.io/knowledge-rag/
📚 Documentação
| Documento | O que contém |
|---|---|
| Guia de instalação | 5 métodos de instalação · 8 integrações de clientes MCP · configuração de GPU |
| Referência da API | Referência completa para todas as 13 ferramentas MCP |
| Referência de configuração | Todos os campos de config.yaml · predefinições · ajuste |
| Arquitetura | 4 diagramas Mermaid: Visão Geral do Sistema · Fluxo de Consulta · Ingestão · hybrid_alpha |
| Solução de problemas | 11 problemas comuns + soluções |
| Guia de caminho rápido FTS5 | Caminho rápido lexical opcional — quando e como |
| Operações de reindexação | Reconstrução sem tempo de inatividade · retomada · checkpoint |
| Configuração de GPU | Instalação do CUDA 12 + solução de problemas |
| Migração para v4.8.0 | Perfil de incorporação · multilíngue · sem tempo de inatividade |
| Política de segurança | Modelo de ameaças · canal de divulgação |
| Contribuição | Desenvolvimento · testes · processo de PR |
| Changelog | Todas as notas de versão desde v1.0.0 |
🤝 Comunidade e Suporte
- Relatar um bug → Abrir uma issue
- Fazer uma pergunta → Discussões no GitHub
- Relatar uma vulnerabilidade → Aviso de segurança (privado)
- Contribuir → CONTRIBUTING.md
SLA de resposta (melhor esforço, projeto comunitário):
- Relatórios de segurança: dentro de 48 h
- Relatórios de bugs com reprodução: dentro de 5 dias úteis
- Solicitações de recursos: triadas no próximo ciclo de versão
🗺️ Versões recentes
- v4.8.5 (2026-08-13) — Observabilidade empresarial: endpoint
/health+ registro estruturado JSON opcional - v4.8.4 (2026-08-13) — Patch: correções de segurança + durabilidade + defensivas
- v4.8.3 (2026-08-10) — Hotfix crítico: endurecimento de reconstrução nuclear + reindexação inteligente em corpora com mais de 50 mil chunks
- v4.8.2 (2026-08-10) — Versão opcional do caminho rápido lexical FTS5
- v4.8.0 (2026-08-06) — Base multilíngue + reindexação sem tempo de inatividade
Histórico completo: CHANGELOG.md →
📜 Licença
Licença MIT — LICENSE. Para sempre. Sem venda de serviços em nuvem, sem licenciamento duplo, sem cláusulas restritivas. Faça fork, venda derivados, incorpore em produtos comerciais — a licença não se importa.
🙏 Agradecimentos
Construído sobre os ombros de projetos incríveis de código aberto:
- Anthropic MCP — especificação do Model Context Protocol + SDK Python
- ChromaDB — banco de dados vetorial que simplesmente funciona
- FastEmbed — incorporações ONNX, sem inchaço do PyTorch
- HuggingFace — hospedagem de modelos + cross-encoder
Xenova/ms-marco-MiniLM-L-6-v2 - BAAI — o modelo de incorporação
bge-small-en-v1.5
Contribuidores da comunidade: @Hohlas · @eeshsaxena · Sergey Khokhlov · e todos que abriram issues ou PRs.
Construído por Ailton Rocha (Lyon.) · Dê uma estrela ⭐ se isso economizar seu tempo · Relatar um problema · Contribuir
knowledge-rag — o servidor RAG local com prioridade MCP para Claude Code, Cursor, Windsurf e todos os agentes de IA.