Clarify Prompt MCP
Um servidor MCP que transforma prompts vagos em prompts otimizados para plataforma para mais de 58 plataformas de IA em 7 categorias — com suporte para registrar plataformas personalizadas e fornecer arquivos de instrução em markdown.
Documentação
ClarifyPrompt MCP



Um compilador de prompts MCP sensível ao contexto que transforma prompts vagos em prompts otimizados para plataforma, para mais de 60 plataformas de IA em 7 categorias — fundamentado nos sinais do seu espaço de trabalho (CLAUDE.md, AGENTS.md, .cursorrules, package.json), na intenção resolvida e nas capacidades do modelo de destino.
Envie um prompt bruto. O ClarifyPrompt reúne o contexto certo, resolve o que você realmente está tentando fazer e retorna uma versão especificamente otimizada para Midjourney, GPT Image 2, Veo, Runway, Kling, Seedance, Higgsfield, ElevenLabs, Suno, Claude, ChatGPT, Cursor ou qualquer uma das 61 plataformas suportadas — com a sintaxe, os parâmetros, a estrutura e a fundamentação corretos.
Novo na 1.16.0: o lançamento da atualidade das plataformas. Cada pacote integrado teve seus fatos verificados em relação à documentação atual dos fornecedores (2026-10-05) — Midjourney V8.x, Runway Gen-4.5, Veo 3.1, Kling 3.0/Omni, Pika 2.2, Suno v6, ElevenLabs v3, gpt-4o-mini-tts, GPT Image 2 — cada entrada agora carrega uma data
verifiedAt. Sora aposentado em todos os lugares (a OpenAI encerrou a API de Vídeos em 2026-09-24, sem substituto); novas plataformas: Seedance, ElevenLabs Music v2.5, Lyria 3.5. Além do benchmark de atualidade de dialeto: 12 dos modelos mais novos do Ollama Cloud foram solicitados a escrever prompts de plataforma sem aviso prévio — 12/13 emitiram flags obsoletos do Midjourney, 12/12 escreveram prompts fluentes para o falecido Sora, zero hesitação. O modo fundamentado reexecuta as mesmas solicitações com os fatos dos pacotes injetados e os resultados se invertem. Veja o benchmark e CHANGELOG.md.Novo na 1.15.0: Nano Banana (Google Gemini 2.5 Flash Image) agora é uma plataforma de imagem integrada —
optimize_prompt(platform: "nano-banana")compila prompts de imagem em seu estilo nativo (direção de cena em linguagem natural, termos fotográficos, frases de edição que preservam identidade, texto dentro da imagem). Além da compatibilidade com os modelos mais recentes em todos os provedores:claude-sonnet-5,gpt-5/série o e Gemini rejeitamtemperaturee/oumax_tokens; o cliente agora envia os parâmetros corretos (proativamente para IDs de raciocínio conhecidos e aprende o restante a partir de um400). Verificado ao vivo contra Anthropic, OpenAI, Gemini e Ollama Cloud. Veja CHANGELOG.md.Novo na 1.14.1: Saída de texto portátil por padrão — um prompt
chat/document/codesem plataforma explícita agora permanece neutro em relação à plataforma, em vez de assumir silenciosamente os idiomas do Claude (tags XML); nomeie uma plataforma para optar pelo ajuste específico do fornecedor. Além disso, o painel de composição do MCP Apps agora mostra um selofor <platform>e um antes/depois limpo de Seu prompt → Otimizado (com um alternadorshow changes) em vez de um diff sempre ativo. Veja CHANGELOG.md.Novo na 1.14.0: Um painel de composição interativo via MCP Apps. Em hosts que falam a extensão
io.modelcontextprotocol/ui(Claude Desktop, ChatGPT, Cursor, VS Code, …),compose_promptrenderiza um painel ao vivo: visualização original versus otimizada, todas as seis pontuações de crítica, os estágios do pipeline e ações de Aceitar / Revisar — Aceitar registra o resultado no loop de memória do ClarifyPrompt, Revisar envia seu feedback de volta para o chat. Um recursoui://autônomo; hosts sem a extensão não veem nenhuma mudança. Veja CHANGELOG.md.Novo na 1.13.0: Reescritas em linguagem simples. Prompts otimizados agora usam palavras comuns e cotidianas em vez de cair em vocabulário formal ("use", nunca "utilize") — a especificidade vem de detalhes concretos, não de sinônimos mais sofisticados.
critique_promptganhou uma 6ª dimensão padrão,plain_language, para que os loopsauto_revisecorrijam o desvio de registro automaticamente. Também corrigido: ummodeexplícito (por exemplo,simple) não é mais descartado silenciosamente para modelos locais pequenos sob a modelagem compacta do prompt do sistema. Veja CHANGELOG.md.
A prova de que isso importa — medido, não afirmado
Por que este projeto existe? Porque "apenas pergunte ao modelo" ficou silenciosamente desatualizado, e nós medimos isso. Os modelos são congelados no momento do treinamento; as plataformas lançam novas versões mensalmente (e matam as antigas). O resultado é que pedir a um modelo moderno um prompt de plataforma é pedir a uma enciclopédia de 2024 os preços de 2026.
Em 2026-10-05, executamos um benchmark público: pedimos a 12 dos modelos mais novos do Ollama Cloud que escrevessem prompts para plataformas atuais reais, em duas condições, mesmas solicitações, mesmos modelos:
- BRUTO — o modelo sozinho, sem ajuda. O que um usuário obtém em um chat simples.
- FUNDAMENTADO — as mesmas solicitações com os fatos de plataforma verificados injetados primeiro — os mesmos dados de pacote que o ClarifyPrompt injeta em cada chamada
optimize_prompt. (É isso que "fundamentação" significa: o modelo lê o cartão de referência em vez de confiar em sua memória congelada.)
132 respostas avaliadas por condição, verificadas em relação à documentação do fornecedor no mesmo dia. Auditoria completa de cada resposta bruta: evals/dialect-benchmark/out/final.json.
Os resultados, em uma linha:
| BRUTO (modelo sozinho) | FUNDAMENTADO (fatos do pacote injetados) | |
|---|---|---|
| dialeto atual | 36 | 117 |
| desatualizado | 35 | 0 |
| misto / genérico | 7 / 54 | 1 / 14 |
Mesmos modelos. Mesmas solicitações. 35 respostas desatualizadas → 0.
Como isso se parece na prática:
- Sora 2, 12 de 12. A OpenAI encerrou a API de Vídeos em 2026-09-24 (aplicativo de consumo em 26 de abril). Onze dias depois, todos os modelos — incluindo GPT-OSS, os pesos abertos da própria OpenAI — escreveram prompts fluentes e confiantes para um produto que não existe. Ninguém disse isso. Nem uma única resposta hesitante, nem um aviso de corte de conhecimento.
- Midjourney, 12 de 13. Todos recorreram a
--v 6.1. O padrão atual é V8.2 desde junho. Duas versões principais desatualizadas, uniformemente. - Com os fatos do pacote injetados, todos os modelos mudaram. Mesmos modelos: todos os 12 disseram que o Sora foi descontinuado; todos os 12 fixaram
--v 8.2; o pior desempenho bruto foi de 3 atuais / 5 desatualizados → 8 / 0.
Custo total de ambas as condições: $0,71. Harness + arquivo de fatos + script de avaliação: evals/dialect-benchmark/ — reproduza com node evals/dialect-benchmark/run.mjs.
A leitura honesta: os modelos não sabem os dialetos atuais — mas com uma camada de conhecimento mantida, eles executam perfeitamente. O conhecimento é a lacuna; a camada de pacotes é o produto. E é isso que optimize_prompt é: fundamentação, em cada chamada, com pacotes que atualizamos em relação à documentação ao vivo e datamos com verifiedAt.
Como Funciona
O ClarifyPrompt faz duas coisas que um modelo de prompt simples não consegue. Cada saída abaixo é uma captura real e não editada de optimize_prompt executado neste repositório (veja Proveniência no final desta seção).
1 — Ele conhece cada plataforma. Mesmo prompt bruto, destino diferente, saída completamente diferente:
You write:    "a dragon flying over a castle at sunset"

→ Midjourney  A colossal, majestic dragon with shimmering scales soaring over a towering
              medieval stone castle, dramatic sunset sky with vibrant orange and deep purple
              hues, cinematic fantasy concept art, volumetric lighting, highly detailed
              --ar 16:9 --v 6.1 --s 250 --q 2

→ DALL-E      A majestic dragon with glowing crimson scales soars over a towering medieval
              stone castle, silhouetted against a vibrant orange and purple sunset sky.
              Rendered in a high-fantasy digital art style with dramatic, warm lighting and
              highly detailed textures, wide aspect ratio.

→ Nano Banana A majestic dragon with deep crimson scales and a leathery, bat-like wingspan
              glides through the warm, golden-hour sky just above a towering medieval castle
              made of weathered grey stone. ... Frame this as a wide cinematic landscape shot
              using a 24mm lens at f/8 for deep depth of field, camera positioned at a
              slightly elevated three-quarter angle... Aspect ratio 16:9.
O Midjourney recebe flags --ar/--v/--s/--q; DALL-E e Nano Banana recebem linguagem natural sem flags — e o Nano Banana adiciona direção fotográfica (lente, f-stop, ângulo de câmera) e clima explícito, seu estilo documentado. Mesma ideia, dialeto nativo de cada plataforma.
Observe o
--v 6.1na captura do Midjourney acima. Essa captura é real (2026-06-22) — e o modelo recorreu a um flag de versão que já estava duas versões principais desatualizado; o padrão atual do Midjourney é V8.2. Os pesos do modelo são congelados no momento do treinamento; os dialetos das plataformas mudam mensalmente. Essa lacuna é exatamente o que os pacotes de plataforma verificados do ClarifyPrompt (datados deverifiedAt, atualizados em relação à documentação atual) existem para fechar — veja a história da desatualização.
2 — Ele sabe no que você está trabalhando. Esta é a parte que um modelo não consegue falsificar. Solte uma frase vaga enquanto edita src/transport.ts neste mesmo repositório, e o mecanismo a fundamenta no seu espaço de trabalho real — package.json, estado do git, o arquivo ativo — e resolve a intenção antes de moldar a saída:
You write:    "add a configurable request timeout to the http transport"
              · active file: src/transport.ts   · resolved intent: production-code
              · grounded in: active-file · workspace-meta · git-state · environment ·
                target-model · platform-hints

→ Cursor      Implement a configurable request timeout for the HTTP transport in
              `src/transport.ts`.
              Requirements:
              1. Add a new environment variable `CLARIFYPROMPT_HTTP_TIMEOUT` … (default 30000 ms)
              2. Apply this timeout to all incoming requests in the streamable-http transport
              …
              5. Preserve existing behavior for stdio and a2a transports
              …
              The implementation should be added to the streamable-http section of
              `startTransport()`.
              (excerpted — the full rewrite has 7 numbered requirement groups)
Nada naquela frase de uma linha mencionou a convenção de nomenclatura CLARIFYPROMPT_HTTP_*, o ponto de entrada startTransport() ou os transportes stdio/a2a que ela deve preservar — o mecanismo leu isso do arquivo ativo e do package.json e os incorporou. Essa é a diferença entre reformular um prompt e compilá-lo contra o contexto.
3 — Ele pode executar todo o pipeline. clarify → fundamentar/otimizar → criticar → revisar, em uma única chamada compose_prompt — veja Anteriormente na 1.4.0 — o pipeline componível abaixo.
Proveniência. Saídas de imagem capturadas via
glm-5.2:cloud, a saída de código fundamentada viaqwen3-coder:480b-cloud— ambos modelos de nuvem Ollama servidos pelo endpoint compatível com OpenAI do Ollama (LLM_API_URL=http://localhost:11434/v1), executados por meio deoptimize_promptneste repositório em 2026-06-22 (a captura do Nano Banana adicionada em 2026-07-03, mesmo modeloglm-5.2:cloud). O ClarifyPrompt é agnóstico em relação ao modelo (qualquer API compatível com OpenAI, local ou hospedada); as saídas dependem do modelo — as suas diferirão na redação, não na estrutura.
O que há de novo na 1.16.0
O lançamento da atualidade das plataformas. Os pacotes haviam apodrecido — o Midjourney ainda era --v 6.1 enquanto o padrão atual é V8.2, o pacote de vídeo ainda descrevia "Runway Gen-3" e "Google Veo 2", e a entrada do Higgsfield ainda roteava para um modelo morto. Cada pacote integrado teve seus fatos verificados em relação à documentação atual dos fornecedores em 2026-10-05, e cada entrada verificada agora carrega uma data verifiedAt para que a desatualização seja visível, rastreável e passível de CI.
Sora aposentado em todos os lugares. A OpenAI descontinuou o aplicativo Sora em 2026-04-26 e encerrou a API de Vídeos + todos os IDs de modelo sora-2 em 2026-09-24, sem substituto nomeado. Removido dos pacotes, orientação de estratégia, cartão A2A, documentação de ferramentas, README e palavras-chave do npm. Novas plataformas de primeira classe: seedance, eleven-music (ElevenLabs Music v2.5), lyria (Google 3.5).
O benchmark de atualidade de dialeto (evals/dialect-benchmark/) — a prova de por que este projeto existe. Pedimos a 12 dos modelos mais novos do Ollama Cloud que escrevessem prompts de plataforma, sem aviso prévio, e avaliamos as respostas em relação aos mesmos fatos verificados:
- 12 de 13 modelos que responderam emitiram
--v 6.xdesatualizado do Midjourney (V8.2 é o padrão desde junho) - 12 de 12 escreveram prompts fluentes para o Sora 2 — um produto que a OpenAI encerrou 11 dias antes da execução. Incluindo GPT-OSS, os pesos abertos da própria OpenAI. Zero modelos hesitaram ou mencionaram um corte de conhecimento.
- Modo fundamentado (
BENCH_GROUNDED=1) reexecuta as solicitações idênticas com os fatos dos pacotes injetados no prompt do sistema — o delta antes/depois no mesmo elenco é a tese do produto tornada mensurável: os modelos não sabem os dialetos atuais, mas com uma camada de conhecimento mantida, eles executam. - Descoberta bônus: dois modelos de controle do benchmark retornaram HTTP 410 aposentado no meio da execução (
qwen3.5:397b, 2026-09-25) — os modelos também giram, não apenas os dialetos.
O que há de novo na 1.15.0
Nano Banana, integrado. O Google Gemini 2.5 Flash Image ("Nano Banana") agora é uma plataforma de imagem de primeira classe — optimize_prompt(category: "image", platform: "nano-banana") compila sua ideia em seu estilo de prompt nativo: direção de cena em frases completas (não pilhas de palavras-chave), terminologia fotográfica para câmera/lente/profundidade, iluminação explícita, frases de edição que preservam a identidade do sujeito, consistência de personagem com múltiplas referências e texto confiável dentro da imagem. Como em toda plataforma de imagem, o ClarifyPrompt compila o prompt; você o envia ao modelo.
Compatibilidade com os modelos mais recentes, em todos os provedores. Modelos com raciocínio ativado rejeitam parâmetros que o clarifyprompt sempre enviava: claude-sonnet-5 e modelos de raciocínio da OpenAI rejeitam temperature; gpt-5 / série o também rejeitam max_tokens (eles exigem max_completion_tokens). Todas as chamadas para eles falhavam e degradavam para o prompt original. Agora o cliente envia o corpo correto — proativamente para IDs de raciocínio conhecidos (sem ida e volta desperdiçada) e, para qualquer coisa que as dicas não reconheçam (incluindo modelos futuros), ele aprende com o 400 e tenta novamente. Modelos que aceitam os parâmetros padrão são byte-idênticos. Verificado ao vivo contra Anthropic (claude-sonnet-5), OpenAI (gpt-5), Gemini (gemini-flash-latest) e Ollama Cloud (glm-5.2:cloud). Modelos de raciocínio pensam muito — aumente o LLM_TIMEOUT_MS (o padrão de 30s geralmente é curto demais).
Novidades na 1.14.1
Portátil por padrão. Quando você otimiza um prompt de texto (chat, document, code) sem nomear uma plataforma, o ClarifyPrompt agora retorna saída neutra de plataforma — estrutura limpa e portátil que funciona em qualquer assistente — em vez de silenciosamente usar os idiomas do Claude (suas tags XML <task>/<context>). Nomeie uma plataforma (platform: "claude", "chatgpt", … qualquer uma das 60) para optar pelo ajuste específico dessa plataforma. Categorias criativas (imagem/vídeo/voz/música) não mudaram: a saída delas precisa de um formato de plataforma concreto, então o padrão principal (Midway, Runway, …) ainda se aplica.
Painel de composição mais claro. O painel MCP Apps agora mostra um selo for <platform> (ou general purpose), renderiza seu prompt original como um bloco rotulado Seu prompt acima da saída otimizada e mostra o prompt otimizado de forma simples — com um alternador show changes para o diff em nível de palavra — em vez de um diff sempre ativo.
Novidades na 1.14.0
compose_prompt agora tem uma cara. O ClarifyPrompt inclui um painel MCP Apps (extensão io.modelcontextprotocol/ui) que hosts compatíveis renderizam inline ao lado do resultado da ferramenta:
- Original vs otimizado, como diff em nível de palavra — veja exatamente o que o compilador mudou.
- Crítica, visualizada — todas as seis dimensões (clareza, especificidade, alinhamento de intenção, adequação de formato, adequação de comprimento, linguagem simples) como barras de pontuação, com o veredito e a trilha de auditoria
stagespor chamada como selos. - Aceitar — um clique registra
save_outcome(accepted)no painel, alimentando o loop de memória few-shot, e informa silenciosamente ao modelo que o prompt foi aceito. - Revisar… — digite o que deve mudar; o painel envia de volta para o chat para o modelo recompor.
- Ciente de esclarecimento — quando o estágio de pré-esclarecimento interrompe a cadeia com perguntas, o painel as renderiza (com respostas sugeridas) em vez de um diff.
Implantação de risco zero: o painel é um único recurso HTML autocontido (ui://clarifyprompt/compose-panel.html, CSS/JS inline — o sandbox da extensão bloqueia solicitações externas) vinculado ao compose_prompt's _meta.ui. Hosts sem a extensão o ignoram completamente; a saída de texto + structuredContent é byte-idêntica. Roda no piso SDK ^1.29 existente. Nova bateria determinística npm run test:apps trava a fiação.
Também novo: o harness de avaliação ganhou uma verificação max_reading_grade — um teto determinístico de Flesch–Kincaid que trava o comportamento de linguagem simples da 1.13.0 como um portão mensurável (lixo de registro formal pontua ~20+; reescritas simples ~3–6).
Novidades na 1.13.0
Reescritas em linguagem simples, de ponta a ponta. LLMs lidam com palavras comuns e cotidianas de forma mais confiável do que sinônimos formais do mesmo significado — e modelos locais pequenos, os alvos padrão do ClarifyPrompt, são os que mais se beneficiam. Esta versão incorpora isso em todos os estágios que moldam a redação da saída:
- O otimizador prefere palavras comuns. Um novo princípio central no prompt de sistema compartilhado ("USE COMMON WORDS") se aplica a todas as 7 estratégias de categoria e tanto a
optimize_promptquanto aground_prompt: nunca troque por uma palavra mais rara quando uma comum carrega o mesmo significado. Detalhe significa mais informação, não palavras mais sofisticadas — especificidade, estrutura e restrições não são tocadas. critique_promptganhou uma 6ª dimensão padrão:plain_language. Ela penaliza vocabulário desnecessariamente formal ou raro quando uma palavra mais simples serviria. Como o passe de reescrita aplica todas as sugestões de dimensões com pontuação abaixo de 7, loopsauto_reviseagora corrigem o desvio de registro de graça. Overrides personalizados decriterianão são afetados.- Corrigido:
modeexplícito não é mais silenciosamente descartado para modelos locais pequenos. A modelagem compacta de prompt de sistema costumava cortar as instruções de modo inteiramente — entãomode: "simple"não tinha efeito em modelos classe 3B. Todo modo agora sobrevive à modelagem compacta como uma regra de uma linha. - Duas novas fixtures de avaliação protegem o comportamento:
31-plain-language-vocabulary(a saída otimizada não deve conter palavras de registro formal) e32-shape-compact-keeps-mode(a linha de modo alcança modelos pequenos).
Novidades na 1.12.1
A correção real para o problema #3: modelos de canal de pensamento agora produzem prompts otimizados de forma confiável em vez de retornar conteúdo vazio intermitentemente. Tanto gpt-oss:20b-cloud quanto glm-5.2:cloud passaram de vazio ~40% das execuções para 0%.
Reinvestigar do zero derrubou a causa raiz documentada. Nunca foi "o shim /v1 do Ollama descarta o canal final de harmonia." Esses modelos gastam seu orçamento de max_tokens no canal de pensamento primeiro e nunca alcançam o canal final — então content volta "" (pior com esforço de raciocínio maior). Duas alavancas, aplicadas juntas porque famílias diferentes honram alavancas diferentes:
- Um piso de
max_tokens(8192) para modelos de raciocínio detectados — a alavanca universal. Ela ataca a causa raiz diretamente, então funciona independentemente de qual botão de pensamento uma família respeita. É um teto, não um alvo: respostas curtas terminam cedo, então não há latência adicionada. reasoning_effort: "low"— para famílias que o respeitam (gpt-oss), também reduzindo latência/custo. Ajuste comLLM_REASONING_EFFORT(low|medium|high).
As alavancas são genuinamente específicas de família: gpt-oss honra reasoning_effort mas ignora o think do Ollama; glm é exatamente o oposto — ignora reasoning_effort, então apenas o piso de orçamento o salva.
A detecção é robusta, não uma lista de modelos codificada (que apodreceria conforme novos modelos fossem lançados). "Este é um modelo de pensamento?" é respondido, cacheado por modelo, por: (1) o próprio runtime — o /api/show do Ollama reporta uma capacidade thinking (é assim que minimax-m3:cloud é detectado, sem correspondência de nome); (2) aprendizado por resposta — qualquer trace de raciocínio, ou conteúdo vazio com tokens, marca esse modelo daí em diante (funciona para qualquer provedor); (3) uma pequena dica de nome como último recurso. Modelos sem raciocínio permanecem byte-idênticos, e o retry de conteúdo vazio agnóstico de nome é o backstop final. Validado em gpt-oss:20b-cloud, glm-5.2:cloud e minimax-m3:cloud (todos 0% vazio na primeira chamada).
A "mudança para o
/api/chatnativo do Ollama" proposta anteriormente era um beco sem saída —/api/chatcomthink:falseainda retorna conteúdo vazio para gpt-oss (ele o ignora), e teria adicionado um segundo caminho de código frágil.
Novidades na 1.12.0
Passo #7 — o passo final — do roteiro de modernização MCP: o ClarifyPrompt agora fala A2A (Agente-para-Agente), então outros agentes podem chamá-lo para compilar prompts. stdio continua sendo o padrão; nada sobre configurações existentes muda.
Defina CLARIFYPROMPT_TRANSPORT=a2a e o ClarifyPrompt sobe como um peer A2A descobrível no http embutido do Node (a única nova dependência é o @a2a-js/sdk oficial, que por si só puxa apenas uuid):
| Endpoint | Propósito |
|---|---|
GET /.well-known/agent-card.json | Cartão de agente — descoberta: identidade, capacidades, a habilidade compile-prompt-for-platform |
POST /a2a | A2A JSON-RPC 2.0: message/send, message/stream (SSE), tasks/get, tasks/cancel, … |
GET /health | Sonda de vivacidade |
CLARIFYPROMPT_TRANSPORT=a2a CLARIFYPROMPT_HTTP_PORT=3000 npx clarifyprompt-mcp
# → card:  http://127.0.0.1:3000/.well-known/agent-card.json
# → a2a:   POST http://127.0.0.1:3000/a2a   (message/send · message/stream)
Todo o roteiro compensa aqui — uma mensagem A2A de entrada flui pelo mesmo pipeline de composição, e os primitivos construídos nos passos anteriores mapeiam diretamente para a semântica A2A:
- Compilar — um
message/sendcom o prompt bruto (texto simples, ou JSON{ prompt, platform?, category?, … }) retorna uma tarefa cujo artefato carrega o prompt otimizado (texto) mais o resultado de composição estruturado completo (dados). - Streaming (progresso 1.10.0 → A2A) —
message/streamemite eventosstatus-updateconforme cada estágio do pipeline roda, depois o artefato, via SSE. - Cancelamento (AbortSignal 1.10.0 → A2A) —
tasks/cancelaborta a composição em andamento em milissegundos e reporta um estado terminalcanceled. - Esclarecimento (elicitação 1.9.0 → A2A) — esclarecer está desligado por padrão para peers one-shot; opte com
pre_clarify: 'auto' | 'always'e um prompt ambíguo pausa a tarefa no estado de primeira classeinput-requireddo A2A com as perguntas (texto legível + dados estruturados). Responda na mesma tarefa e ele compila.
Configure a URL pública base anunciada no cartão com CLARIFYPROMPT_A2A_BASE_URL (útil atrás de um proxy); porta/host são compartilhados com streamable-http. Nova bateria determinística npm run test:a2a dirige descoberta de cartão, uma compilação ao vivo, o round-trip de esclarecimento e streaming SSE.
Novidades na 1.11.0
Passo #6 do roteiro de modernização MCP: uma fábrica de transporte plugável — o ClarifyPrompt agora pode servir via Streamable HTTP, a pista para A2A e hosts MCP remotos. stdio continua sendo o padrão; nada sobre configurações existentes muda.
Transportes
Defina CLARIFYPROMPT_TRANSPORT:
| Valor | Comportamento |
|---|---|
stdio (padrão) | Um servidor sobre stdin/stdout — exatamente como antes |
streamable-http | MCP Streamable HTTP sobre o http embutido do Node (sem novas deps): sessões com estado (mcp-session-id), streaming SSE, uma sonda /health |
a2a | Servir como um peer A2A (Agente-para-Agente) — cartão de agente, JSON-RPC + SSE (veja 1.12.0 acima) |
Botões HTTP (no modo streamable-http / a2a): CLARIFYPROMPT_HTTP_PORT (3000), CLARIFYPROMPT_HTTP_HOST (127.0.0.1 — somente localhost por padrão), CLARIFYPROMPT_HTTP_PATH (/mcp, apenas streamable-http).
CLARIFYPROMPT_TRANSPORT=streamable-http CLARIFYPROMPT_HTTP_PORT=3000 npx clarifyprompt-mcp
# → POST http://127.0.0.1:3000/mcp  ·  GET http://127.0.0.1:3000/health
O registro de ferramentas/recursos mudou para uma fábrica createServer() exportada: stdio recebe um servidor, streamable-http recebe um por sessão (o padrão recomendado pelo SDK, seguro contra GHSA — nunca compartilha um servidor entre clientes HTTP). Nova bateria determinística npm run test:http dirige uma sessão HTTP completa.
Novidades na 1.10.0
Passo #5 do roteiro de modernização MCP, núcleo estável: compose_prompt é cancelável e reporta progresso ao vivo. Agnóstico de modelo, opt-in, totalmente retrocompatível.
Cancelamento
Um AbortSignal é encanado por todo o caminho LLM (simpleGenerate → chat → fetch, combinado com o timeout por chamada) e cada estágio do motor. Quando um cliente envia notifications/cancelled para uma chamada compose_prompt, a solicitação de modelo em andamento aborta imediatamente e o loop de revisão para no próximo limite de estágio — em vez de rodar cada iteração até o fim. O sinal alcança fetch independentemente de qual modelo/provedor está configurado.
Progresso
Inclua um progressToken na solicitação compose_prompt _meta e o servidor emite notifications/progress em cada estágio (esclarecer / otimizar / fundamentar / criticar) com um contador monotônico e uma mensagem humana como optimizing prompt [iter 2/3]. Hosts podem mostrar um status ao vivo em uma composição longa de múltiplas iterações. Sem token → sem notificações, zero overhead.
Por que não tarefas MCP (ainda)
Roadmap #5 nomeou a API de tasks do MCP. Ela ainda é experimental/ no SDK ("pode mudar sem aviso prévio"), sua referência tem ~600 linhas, e nenhum cliente atual fala o protocolo tasks/* — então uma implementação completa seria código inutilizável e desativado por padrão hoje. O valor real (compose cancelável + com relatório de progresso) é entregue aqui em primitivas estáveis; o wrapper experimental de async-task é adiado para chegar com o #7 (A2A), que o trabalho de base AbortSignal aqui já prepara. A nova bateria determinística npm run test:cancel trava o comportamento.
O que há de novo na 1.9.0
Passo #4 do roteiro de modernização do MCP: clarify_with_user pode obter respostas através da UI de formulário nativa do host. Opt-in, totalmente retrocompatível.
Esclarecimento interativo
Passe elicit: true. Em um cliente que suporta elicitação MCP, as perguntas de esclarecimento se tornam um formulário real:
- cada pergunta é um campo,
optionsse tornam dropdowns de enum, e cadasuggestedAnsweré o valor padrão do campo (aceite com um clique); - o usuário responde inline; o motor retorna
answers: [{ question, dimension, answer, usedSuggested }]comelicited: true.
Sem elicit, em um cliente sem capacidade, ou se o round-trip falhar, a ferramenta retorna o mesmo JSON de perguntas brutas de sempre — todos os chamadores existentes não são afetados. decline / cancel são expostos via elicitationAction.
Isso transforma o esclarecimento de "aqui está um blob JSON de perguntas, você renderiza" em um momento interativo de primeira classe em hosts como o Claude Desktop. O mapeamento vive em um pequeno módulo puro (src/engine/clarification/elicit.ts), reutilizável pelo estágio de pré-esclarecimento do compose_prompt mais tarde. A nova bateria determinística npm run test:elicit (helpers puros + um round-trip ao vivo com mock-client) trava isso.
O que há de novo na 1.8.0
Passo #3 do roteiro de modernização do MCP: as superfícies de leitura do motor se tornam modelos de recursos navegáveis com autocompletar de argumentos. Nenhuma mudança de ferramenta ou comportamento do motor.
Modelos de recursos
Quatro modelos se juntam ao clarifyprompt://categories estático, cada um apoiado por um getter existente do motor:
| Modelo de URI | O que ele lê |
|---|---|
clarifyprompt://platforms/{category}/{id} | Configuração completa de uma plataforma — resources/list enumera todas as 60+ como URIs individuais |
clarifyprompt://traces/{date} | Índice de resumo do trace de otimização para um dia UTC |
clarifyprompt://packs/{id} | Metadados de um knowledge pack carregado |
clarifyprompt://memory/facts/{scope} | Fatos lembrados ao vivo sob um escopo |
Hosts MCP com navegador de recursos (Claude Desktop, Cursor) agora obtêm uma árvore navegável em vez de um único blob estático.
Autocompletar
completion/complete resolve as variáveis do modelo: {category} → os 7 IDs de categoria, {id} → IDs de plataforma escopados pelo {category} escolhido, {date} → dias com traces, IDs de pack, escopos de memória. (O autocompletar MCP se aplica apenas a argumentos de prompt + variáveis de modelo de recurso — não a entradas de ferramenta; o ClarifyPrompt não registra prompts, então ele vive nos modelos.)
Capacidades
O servidor agora anuncia resources (com modelos) e completions em initialize. A nova bateria determinística npm run test:resources trava a superfície.
O que há de novo na 1.7.1
Patch corrigindo #3: um prompt otimizado vazio e silencioso de modelos cuja resposta não caiu em content.
- Lê todos os três nomes de campo do canal de pensamento (
reasoning/thinking/reasoning_content) — corrige DeepSeek / qwen-thinking e similares. - Tenta novamente uma vez, depois falha ruidosamente quando o conteúdo está vazio, independentemente de qualquer campo de pensamento. Isso cobre o caso real do problema #3: a saída de harmonia do gpt-oss através do shim
/v1do Ollama gera tokens (completion_tokens > 0) mas retornacontent: ""sem campo de pensamento. O motor agora degrada para o prompt original + umerrorexposto em vez de retornar em branco. - Recuperar genuinamente a saída de harmonia do gpt-oss (via
/api/chatnativo do Ollama) foi rastreado como acompanhamento — resolvido na 1.12.1, que provou que o caminho/api/chatera um beco sem saída e corrigiu a causa raiz real (um piso demax_tokens+reasoning_effortpara modelos de raciocínio; veja as notas da 1.12.1 acima). - Nova bateria determinística
npm run test:thinkingtrava a regressão com respostas simuladas (sem dependência de nuvem ao vivo).
Verificado: test:thinking, bateria de raciocínio (gpt-oss degrada ruidosamente; o raciocinador genuíno kimi-k2-thinking:cloud ainda retorna conteúdo real), integração, day2, evals, wire.
O que há de novo na 1.7.0
Passo #2 do roteiro de modernização do MCP: toda a superfície de ferramentas migrou do shorthand obsoleto server.tool() (removido no SDK 2.0) para server.registerTool(). Nenhuma mudança de comportamento do motor; retrocompatibilidade total.
O que os hosts obtêm
- Títulos — toda ferramenta tem um nome de exibição legível por humanos ("Esquecer um fato", não
memory_forget). - Anotações de comportamento — todas as 23 ferramentas declaram
readOnlyHint/destructiveHint/idempotentHint/openWorldHint. As três ferramentas destrutivas (memory_forget,unload_pack,unregister_platform) são sinalizadas para UIs de confirmação; os sete inspetores somente leitura são sinalizados como seguros para chamada livre; as sete ferramentas que alcançam a rede (LLM / embeddings / busca web) carregamopenWorldHint: true. - Saída estruturada — toda ferramenta declara um
outputSchemae retornastructuredContentjunto com o texto JSON. Os schemas são permissivos por design (tudo opcional, pass-through) — eles documentam a forma sem nunca rejeitar a saída do motor.
Retrocompatibilidade
O conteúdo de texto é byte idêntico para toda ferramenta — incluindo as três ferramentas list_* que retornam array, cujo texto permanece um array simples enquanto structuredContent o envolve em um objeto conforme a especificação MCP. Retornos de erro inalterados. Verificado: wire 7/7, integração 9/9, day2, 26/27 evals com zero erros de validação de saída.
Encontrado durante a verificação
#3 — respostas do canal de pensamento gpt-oss em nuvem podem produzir um optimizedPrompt vazio (mudança de API remota expondo uma lacuna pré-existente de nome de campo em client.ts; correção alvo para 1.7.1).
O que há de novo na 1.6.8
Release de manutenção fechando os loops que a cascata 1.6.5→1.6.7 abriu. Nenhuma mudança de código do motor, superfície de ferramentas MCP, plataforma ou env-var.
Alterado
- A matriz de CI agora testa Node 24 (LTS ativo atual, EOL abril 2028) junto com 18/20/22 em Ubuntu + macOS. A matriz anterior testava duas versões Node EOL, mas não a LTS atual. Verificado antes do merge que as dependências nativas (
better-sqlite3+sqlite-vec) carregam e funcionam no Node 24.16.0 em um contêinernode:24-slimsem toolchain.enginespermanece>=18— compatibilidade máxima, e testamos o que afirmamos. - Runner de publicação movido de Node 20 → 22, mantendo um runtime EOL fora do caminho crítico de release (combina com a base do Dockerfile).
Processo
- Nova verificação de ship
CP-13 — lockfile regeneration safetycodifica a lição da cascata 1.6.5→1.6.6→1.6.7: um úniconpm install --package-lock-onlydescartou silenciosamente 4 de 5 binários de plataformasqlite-vec(quebrou o CI Linux) e puxou um bumpbetter-sqlite3dentro do caret que derrubou os prebuilds do Node 20 (quebrou o build Docker). A verificação exigenpm installcompleto em mudanças de dependência, um diff de lockfile para dependências de plataforma descartadas + saltos de versão de dependência nativa, e um gate local de carregamento Docker slim. Dogfooded neste release.
O que há de novo na 1.6.7
Patch do Dockerfile. Nenhuma mudança de código do motor, superfície de ferramentas MCP, plataforma ou env-var.
Corrigido
CI / docker buildfalhou na 1.6.6 comnpm error gyp ERR! find Python. Causa raiz:better-sqlite3@12.10.0(lançado 2026-05) removeu explicitamente binários precompilados para Node.js v20 e v23 porque o Node 20 atingiu EOL em abril de 2026. A regeração do lockfile da 1.6.6 puxou 12.10.0 dentro do caret^12.9.0, enode:20-slimnão tem Python + toolchain C++ para compilar do código-fonte. Bump da base do Dockerfile paranode:22-slim— LTS ativo atual, ainda tem prebuilds funcionando.- A matriz de build CI não-Docker (Node 18 / 20 / 22 em macOS + Ubuntu) ainda passa porque runners regulares podem compilar do código-fonte como fallback. Apenas a imagem Docker slim tropeça.
Verificado localmente
docker build → verde. O contêiner pode require('better-sqlite3') + require('sqlite-vec') limpo. Todos os 5 binários de plataforma sqlite-vec ainda em package-lock.json (a correção da 1.6.6 se manteve).
O que há de novo na 1.6.6
Patch de lockfile + harness seguindo a 1.6.5. Nenhuma mudança de código do motor, superfície de ferramentas MCP, plataforma ou env-var. Envia o documento de auditoria de completude MCP.
Corrigido
package-lock.jsonperdeu 4 de 5 binários de plataformasqlite-vecdurante o bump do SDK da 1.6.5. Meunpm install --package-lock-onlylocal reteve apenas o bináriosqlite-vec-darwin-arm64do mantenedor.npm cinos runners Ubuntu do CI falhou comno such module: vec0porquesqlite-vec-linux-x64não estava no lock. Onpm install clarifyprompt-mcp@1.6.5do usuário final nunca foi afetado (o tarball npm não envia lockfile; usuários resolvem plataformas no momento da instalação). Regenerado comnpm installcompleto para que todas as 5 plataformas (darwin-arm64,darwin-x64,linux-arm64,linux-x64,windows-x64) voltem.- O gravador de relatório HTML do harness de eval travou em entradas ERRORED (
evals/run.mjs:729). O renderizador pré-existente assumia que toda execução não pulada e não filtrada tinha um campoevaluation.checks, mas execuções com erro carregam um campoerrorem vez disso. Adicionado um branch explícito de status com erro — o harness agora degrada graciosamente e sai limpo mesmo quando fixtures falham.
Documentos incluídos
docs/audits/mcp-completeness-2026-05.md— auditoria diagnóstica da superfície MCP do motor contra o SDK + especificação atuais. Tabela de registro ferramenta por ferramenta, análise de lacunas de recursos, delta de recursos do SDK (1.12 → 1.29 → 2.0-alpha), declarações de capacidade, esboço de refatoração de transporte, nota de viabilidade A2A e um roteiro de modernização sequenciado em 7 passos. O artefato por trás do planejamento da próxima sessão. Nenhuma mudança de motor prescrita inline.
Números
- 5 plataformas sqlite-vec no lockfile (era 1).
npm audit --production: 0 vulnerabilidades (inalterado). Ferramentas: 23 (inalterado). Fixtures de eval: 30 (inalterado).
O que há de novo na 1.6.5
Patch de segurança. Nenhuma mudança de código do motor, superfície de ferramentas MCP, plataforma ou env-var.
Corrigido
- CVE-2026-0621 — ReDoS no regex
UriTemplatedo@modelcontextprotocol/sdk(corrigido no SDK1.25.2). O piso^1.12.1anterior permitia resoluções vulneráveis em caches npm desatualizados; bump para^1.29.0para que o próprio piso seja corrigido. - GHSA-345p-7cg4-v4c7 — Instâncias compartilhadas de servidor/transporte vazam dados de resposta entre clientes (corrigido no SDK
1.26.0). Não explorável na prática para o ClarifyPrompt (um host = uma instância de servidor), mas o código vulnerável agora está completamente fora do grafo de dependências. - 7 vulnerabilidades transitivas (2 moderadas, 5 altas) na subpilha de transporte HTTP incluída no SDK (
hono,express-rate-limit,fast-uri,ip-address,path-to-regexp,qs,@hono/node-server). Limpas vianpm audit fix. Nunca afetaram o runtime — o ClarifyPrompt é somente stdio e não carrega o transporte HTTP — mas eram ruído nos relatóriosnpm auditdos usuários e faziam a instalação parecer insegura.
Números
npm audit --production→ 0 vulnerabilidades (eram 2 CVEs do SDK + 7 transitivas).package-lock.json: líquido −336 linhas (o caret antigo puxava pesados acessórios de transporte HTTP não utilizados; a correção os trocou por alternativas mais enxutas).- Ferramentas: 23 (inalterado). Plataformas: 60+ (inalterado). Fixtures de eval: 30 (inalterado).
- Teste de wire + bateria de integração + day2 + raciocínio + 29/30 evals passam contra o novo piso no Ollama local. A única falha de eval (
analyzer-creative-media) é uma flake pré-existente do classificador qwen-coder-7b — verificada como independente do SDK ao reverter com stash e re-executar.
Por que o bump do piso importa
^1.12.1 era uma documentação enganosa — a resolução de caret estava, na verdade, puxando o 1.27.1 do SDK para qualquer npm install novo desde o início de 2026. O aumento do piso alinha a linha de base declarada com o que o npm já estava fazendo para a maioria dos usuários, ao mesmo tempo em que garante o piso para usuários com caches desatualizados. Isso também nos posiciona para a eventual migração do 2.0.0-alpha quando essa linha se estabilizar (o SDK moderno deprecia o registro abreviado .tool() / .prompt() / .resource() em favor de registerTool() / registerPrompt() / registerResource() com title + outputSchema + annotations).
O que há de novo na 1.6.4
Patch de documentação + processo. Sem mudanças no motor, ferramentas MCP ou plataforma — mas uma limpeza significativa no modelo de distribuição de pacotes.
Registro de pacotes consolidado de volta ao repositório do motor
O LumabyteCo/clarifyprompt-packs (o registro separado de pacotes da comunidade criado no 1.3 com o princípio certo, mas na escala errada) foi arquivado. Seus três pacotes iniciais já viviam na pasta packs/ deste repositório; o registro deveria ser o lar canônico, mas na prática tudo sempre foi distribuído daqui via tarball npm. A divergência cobrou seu preço: o higgsfield-creative-handbook foi lançado no 1.6.2 e nunca chegou ao registro, mesmo com o próprio README do registro dizendo aos usuários para buscar pacotes lá.
Resultado líquido da 1.6.4:
- Fonte única de verdade. Os pacotes de conhecimento
packs/*.md+ as configurações de plataformapacks/platforms/*.yamlvivem todos emclarifyprompt-mcpe são distribuídos no tarball npm. - Nova seção de nível superior Knowledge packs neste README explica o modelo de carregamento (
load_knowledge_pack({source: "<url-or-path>", scope: ...})), os três pacotes iniciais + Higgsfield, a semântica de escopo e como contribuir. - Novo
packs/README.md— guia de autoria de pacotes (esquema de frontmatter, limites de chunk, padrão de qualidade). Extraído do registro arquivado para que o conteúdo não se perca. - Redirecionamento de tombstone no repositório arquivado. Quem visitar
clarifyprompt-packsverá um banner apontando para cá.
Quando a divisão volta?
Quando houver uma função de força: uma fila de PRs da comunidade apenas para pacotes, contagem de pacotes >20 ou licenciamento/governança divergentes. Até lá, o custo de manutenção de manter dois repositórios sincronizados não compensava para um público que não se materializou.
Números
- Ferramentas: 23 (inalterado).
- Plataformas: 60+ (inalterado).
- Pacotes de conhecimento incluídos: 4 (
anthropic-brand-voice,higgsfield-creative-handbook,nextjs-14-best-practices,sox-compliance) — os mesmos da 1.6.2/1.6.3, apenas agora canônicos. - Fixtures de avaliação: 30 (inalterado).
- Tamanho do tarball: inalterado em relação à 1.6.3.
O que há de novo na 1.6.3
Patch. A execução de push de tag do CI da 1.6.2 revelou dois problemas reais — corrigidos aqui sem alterar nenhum código do motor.
Corrigido
evals/fixtures/28-context-includes-git-state.yamlanteriormente afirmavagit_branch_present: true, mas o GitHub Actions faz checkout em modo detached-HEAD, ondebundle.git.branché corretamenteundefined(apenas o SHA + commits recentes são populados). Relaxado para afirmar apenasbundle_has_git: true— isso é o que é realmente invariante entre ambientes locais e de CI.evals/fixtures/17-critique-strong-prompt-accepts.yamlafirmavaverdict: accept+overall_score_min: 7em um prompt forte. O avaliador do gpt-4o-mini calibra de forma mais rigorosa que o do qwen2.5-coder:7b e ocasionalmente retornava um campooverallmalformado que o parser padronizava para 0 → veredito=rejeitar. A intenção real do fixture é verificar a fiação do motor (5+ dimensões, os nomes padrão de dimensões presentes, sem erro de harness) — não comparar a calibração de avaliadores entre modelos. Removidas as afirmações de veredito e pontuação rígida; mantidas as verificações de nível de fiação.- Badge Glama do README trocado de
<img>inline (às vezes quebrado via proxy camo do GitHub) para um badge de link de texto shields.io que é estável em todas as superfícies de renderização.
Notas
- Sem mudanças no código do motor. Sem novas ferramentas MCP (ainda 23). Sem mudanças de plataforma (ainda 60+). Sem mudanças de variáveis de ambiente.
- Linhas de base de avaliação inalteradas no Ollama local. Este é um endurecimento específico de CI — execuções locais contra qwen-coder-7b produziram os mesmos resultados antes e depois.
- A falha do portão de publicação do CI que apareceu no push da tag v1.6.2 foi consequência da falha de avaliação (a etapa
Wait for evals workflowbloqueou a publicação). Agora que os fixtures subjacentes não falham falsamente no gpt-4o-mini + CI em detached-HEAD, o portão de publicação também é liberado.
O que há de novo na 1.6.2
Patch. Dois lançamentos aditivos, ambos sem mudanças de código do ponto de vista do motor:
Pacote de conhecimento do manual criativo da Higgsfield
packs/higgsfield-creative-handbook.md — um pacote markdown estilo comunidade documentando as convenções reais da Higgsfield: regras de seleção de modelo (quais dos 13 modelos para qual caso de uso), fluxo de treinamento de personagem Soul ID, vocabulário de movimentos de câmera, padrão de estrutura de prompt (prosa longa, não tags de palavras-chave), edição multi-referência, modos do Marketing Studio, armadilhas comuns (não traduzir flags do Midjourney literalmente), especificações de saída.
Carregue-o explicitamente:
load_knowledge_pack source="https://raw.githubusercontent.com/LumabyteCo/clarifyprompt-mcp/main/packs/higgsfield-creative-handbook.md"
…ou, como ele é distribuído no tarball npm, aponte para a cópia instalada. O Context Curator fundamenta prompts direcionados à Higgsfield nos chunks deste pacote automaticamente via recuperação semântica. Veja a seção Knowledge packs para o modelo completo de carregamento + escopo.
npm run matrix — executor de matriz de avaliação multi-modelo
O evals/matrix.mjs executa npm run eval sequencialmente contra N modelos e combina os resultados em um único HTML lado a lado (evals/matrix.html por padrão). Ativa os fixtures com portão por classe de modelo (shape-small-local-model / shape-mid-tier-model / shape-reasoning-model) que execuções de modelo único pulam, e expõe deltas como "qwen-7b falha em analyzer-creative-media, mas gpt-4o-mini passa" em um relance.
npm run matrix -- --models qwen2.5-coder:7b-instruct-q4_K_M,gpt-oss:20b-cloud,glm-5.2:cloud
Gera uma tabela de tema escuro — linhas = fixtures, colunas = modelos, células = passou / falhou / pulou / erro com tooltips mostrando quais verificações falharam.
Correção complementar: o evals/run.mjs ganha uma flag --json-out <path> que escreve resultados estruturados por modelo (o matrix.mjs usa; agentes de CI também podem usar).
Números
- Sem mudança na superfície de ferramentas. Ainda 23 ferramentas MCP.
- Sem mudança na contagem de plataformas. 60+ plataformas (
packs/platforms/*.yamlinalterado). - 30 → 30 fixtures (sem novos fixtures; a matriz é ferramenta, não cobertura).
- Tarball cresce ~10 KB para o pacote de conhecimento. O
evals/matrix.mjsNÃO está no tarball — é uma ferramenta de mantenedor/contribuidor, não um artefato de runtime.
O que há de novo na 1.6.1
Patch. Adiciona Higgsfield como plataforma alvo nas categorias image e video. Sem mudanças de código — apenas adições puras de YAML de pacotes de plataforma e um fixture de avaliação.
A Higgsfield é uma plataforma criativa multi-modelo que expõe seu próprio servidor MCP em https://mcp.higgsfield.ai/mcp. Dentro de uma conexão você obtém:
- Imagem: Soul 2.0, Soul Cinema, Soul Cast (consistência de personagem), Flux 2, Seedream 5, Nano Banana Pro, GPT Image 2
- Vídeo: Cinema Studio, Veo 3.1, Kling 3.0, WAN 2.6, Seedance 2.0 (Sora 2 removido em 2026-09-24 — a OpenAI encerrou a API Videos sem substituto)
- Fluxos de trabalho: treinamento de personagem Soul ID, Lipsync Studio, UGC Factory, Marketing Studio, virality_predictor
As entradas de plataforma ClarifyPrompt da 1.6.1 expõem os identificadores de modelo e convenções de estilo de prompt da Higgsfield (prosa natural de formato longo; composição + iluminação + texturas + clima; até imagens 4K / vídeo de 15 s / Soul ID para consistência de personagem) como dicas de sintaxe para o curador.
Padrão recomendado: instale tanto o clarifyprompt-mcp QUANTO o MCP da Higgsfield no seu cliente (Claude Desktop / Cursor / AI Butler / Claude Code). Use optimize_prompt(platform: 'higgsfield', ...) ou compose_prompt(platform: 'higgsfield', ...) para compilar e depois passe o prompt compilado para a ferramenta generate_image / generate_video da Higgsfield. MCPs compõem no cliente; o ClarifyPrompt permanece na camada de "compilação".
29 → 30 fixtures de avaliação. Mesma superfície de ferramentas MCP da 1.6.0 (23 ferramentas, 1 recurso). Sem mudanças de variáveis de ambiente.
O que há de novo na 1.6.0
Quatro adições direcionadas nos quatro pilares do motor (memória / agêntico / modelos / contexto), cada uma lançada atrás de fixtures de avaliação reais. 3 novas ferramentas MCP (23 no total). Totalmente compatível com 1.5.x — sem ferramentas removidas, sem campos removidos, sem mudanças obrigatórias de variáveis de ambiente.
Memória — CRUD explícito de fatos (memory_remember, memory_forget, memory_list_facts)
Antes da 1.6, fatos só entravam na memória persistente via reflexão sobre save_outcome — implícito, extraído por LLM, após o fato. A 1.6 adiciona o caminho explícito:
memory_remember— insere diretamente uma tripla(subject, predicate, object)com confiança explícita. Fonte marcada comouser:explicit. Auto-incorporada para recuperação semântica futura.memory_forget— exclusão suave (invalidated_atbi-temporal) de um fato por id. Idempotente: esquecer novamente um fato já invalidado é um no-op e retornasuccess: falselimpo.memory_list_facts— lista fatos ativos em um escopo (padrãouser), opcionalmente filtrados por predicado. Ordenados por mais recentemente observado.
Isso fecha a lacuna óbvia de UX em que o motor só podia aprender de resultados — agora os usuários podem dizer "lembre que prefiro X" diretamente.
Agêntico — novo loop de revisão max_iterations do compose_prompt
O compose_prompt costumava revisar uma vez (o improvedPrompt da crítica substituía a otimização, se o veredito não fosse accept). A 1.6 adiciona um loop:
{ "prompt": "...", "post_critique": true, "auto_revise": true, "max_iterations": 3 }
Cada iteração após a primeira reexecuta optimize + critique no prompt melhorado da iteração anterior. Para em verdict=accept, sem improvedPrompt para realimentar ou no limite. O pre_clarify só roda uma vez (não faz sentido perguntar de novo em uma reescrita). A resposta inclui um novo campo iterations mostrando quantas iterações foram executadas. Limite rígido de 5 para evitar custos descontrolados.
Modelos — roteamento de modelo por estágio
Cada estágio de composição agora pode mirar um modelo diferente:
{
  "prompt": "...",
  "clarify_model": "qwen2.5-coder:7b-instruct-q4_K_M",
  "optimize_model": "claude-sonnet-5",
  "critique_model": "gpt-4o-mini"
}
Execute o clarify em um modelo local barato, otimize no modelo frontier de grande orçamento, critique no avaliador barato. A substituição flui por todas as camadas — optimization.metadata.model e critique.judgeModel na resposta refletem o modelo real que executou cada estágio.
Contexto — sinais de estado do git + ambiente
Dois novos coletores de sinais alimentam o Context Curator:
bundle.git— branch atual, SHA curto, flag de sujeira, últimos 5 títulos de commits. Permite que o motor fundamente prompts em "no que você está iterando" sem que você precise explicitar. Detectado viagit rev-parse/git status/git log; falha suavemente quando o diretório atual não é um repositório.bundle.environment—nowIso/weekday/timezone(IANA deIntl.DateTimeFormat). Ajuda com prompts sensíveis a tempo ("envie este e-mail amanhã"). JS puro, nunca falha.
Ambos são candidatos de baixa utilidade no curador (não dominarão o orçamento), mas aparecem como fontes de fundamentação quando relevantes.
Cobertura de avaliação
23 → 29 fixtures (6 novos):
- 24
memory-remember-persists/ 25memory-forget-invalidates— round-trip de CRUD Me1 - 26
compose-loop-iterates— infraestrutura de loop A1 (novas verificaçõesiterations_min/iterations_max) - 27
compose-per-stage-models-honored— roteamento por estágio M1 (novas verificaçõesoptimization_model_eq/critique_model_eq) - 28
context-includes-git-state/ 29context-includes-environment-time— sinais C1 + C4 (novas verificaçõesbundle_has_git/bundle_has_environment/git_branch_present)
Linha de base local no qwen2.5-coder:7b: 25 passaram / 1 falhou / 3 pulados / média de 97%. A única falha permanece o sinal persistente de classe de modelo analyzer-creative-media (intocado).
O que há de novo na 1.5.2
A primeira versão em que o portão de avaliação do CI (contra gpt-4o-mini) impulsionou o diff. Três correções reais que o portão capturou no momento em que conectamos o segredo OPENAI_API_KEY:
- O armazenamento de memória agora suporta qualquer dimensão de embedding (#2). A tabela vec persistente estava codificada para 768 dimensões (o padrão do nomic-embed-text), então qualquer pessoa configurando
EMBED_MODEL=text-embedding-3-small(1536),voyage-3(1024),embed-english-v3.0(1024) ou qualquer modelo não-768 encontrariaDimension mismatch: expected 768, got Nna primeira chamada dememory_search. O armazenamento agora deriva o nome da tabela da dimensão real do embedder e cria a tabela específica da dimensão na inicialização. Instalações existentes com 768 dimensões não são afetadas. - Sobrescrita por variável de ambiente
LLM_TIMEOUT_MSno cliente LLM. O padrão permanece em 30s; usuários em modelos hospedados lentos podem aumentá-lo. O fluxo de avaliação usa 120s paragpt-4o-mini. - Harness de avaliação reforçado — não trava mais quando uma ferramenta lança uma exceção (o SDK retorna respostas de erro em texto puro; o harness costumava
JSON.parsee morrer). Um fixture ruim não derruba mais a execução inteira. - Badge de avaliações ao vivo. O fluxo de trabalho
evals.ymlroda a cada push para a main. O badge[![evals]](...)no topo deste README é seu status em tempo real. Atualmente verde em 20/0/3 · 100% emgpt-4o-mini.
Nenhuma nova ferramenta MCP. Nenhuma mudança na superfície de variáveis de ambiente (apenas um LLM_TIMEOUT_MS opcional adicionado). Totalmente compatível com 1.5.x.
O que há de novo na 1.5.1
Um release de patch sobre a 1.5.0. Apenas melhorias de documentação e processo de publicação; o comportamento em tempo de execução é idêntico ao da 1.5.0.
- Superfícies de marketing do README atualizadas — o release 1.5.0 foi publicado com o README ainda na 1.4.0 em três lugares (blockquote do título, cabeçalho "O que há de novo em X", anotação "cumulativo até X"). Todas as outras superfícies de versão (
package.json,package-lock.json,server.json,src/index.ts,CHANGELOG) estavam corretas, mas o texto divergiu porque nada automatizado o tocava. A 1.5.1 corrige isso. - Duas novas auditorias de verificação de publicação —
CP-11(coerência das superfícies de marketing do README) falha automaticamente se qualquer um dos três itens acima não referenciar opackage.json#versionatual.CP-12(validade do formato do pacote Platform) analisa cadapacks/platforms/*.yamle valida a conformidade do esquema. O CP-11 foi promovido para a habilidade de verificação de publicação com escopo de usuário (entre projetos) no mesmo dia, então projetos futuros também se beneficiam. - Nenhuma mudança de código. Nenhuma nova ferramenta MCP. Nenhuma nova variável de ambiente. Mesma anatomia de tarball da 1.5.0, mais alguns centenas de bytes de CHANGELOG.
O que há de novo na 1.5.0
Plataformas integradas tornam-se declarativas. Os 58+ arrays de plataformas TypeScript codificados migram para packs/platforms/*.yaml — adicionar uma plataforma integrada agora é uma edição de YAML, não uma edição de TS. A camada TypeScript vira um carregador em tempo de execução com uma tabela de fallback codificada. YAML malformado nunca mais pode travar o servidor.
packs/platforms/
  chat.yaml       9 platforms
  code.yaml       9
  document.yaml   8
  image.yaml     10
  music.yaml      4
  video.yaml     11
  voice.yaml      7
  README.md      contributor docs
Para adicionar uma nova plataforma integrada: anexe uma entrada ao arquivo de categoria relevante, execute npm run build, abra um PR. Nenhuma edição de TS é necessária. Plataforma personalizada via runtime (register_platform) ainda funciona de forma idêntica para plataformas instaladas pelo usuário.
- Cobertura de avaliação da camada de memória. O harness de avaliação agora suporta
setup: [{tool, args}, ...]— uma lista de chamadas de ferramentas MCP executadas ANTES doinputprincipal. Dois novos fixtures o usam: um carrega um pacote de conhecimento inline e verifica se o chunk aparece emgrounding.sourcesapós o pipeline de embed → store → retrieve → curate → ground; o outro prova a qualidade da classificação de busca vetorial. 23 fixtures no total (eram 20 na 1.4.0). - Modernização da infraestrutura de testes. As baterias de teste de integração e Day-2 costumavam afirmar strings de versão literais (
1.3.0,16 tools) e quebravam a cada bump. Agora elas leemEXPECTED_VERSIONdepackage.jsone verificam a presença de um conjunto de ferramentas, em vez de uma contagem de ferramentas. Bumps futuros não quebram mais os testes. - Materiais de adoção.
docs/adoption/inclui corpo de Show HN pronto para copiar e colar, posts do Reddit, thread do Twitter, template de PR para awesome-mcp-servers e especificações de submissão de catálogo (mcp.so, Smithery, mcp-get, PulseMCP, modelcontextprotocol/servers). - Uma nova dependência de runtime:
js-yamlpromovida de devDependency para o carregador de plataformas (~200 KB). - Mesma superfície de ferramentas MCP da 1.4. 20 ferramentas, 1 recurso. Nenhuma ferramenta nova; nenhuma removida; formatos de resultado inalterados.
Anteriormente na 1.4.0 — o pipeline componível
Quatro operações principais como ferramentas MCP de primeira classe que se compõem. Use qualquer ferramenta isoladamente ou execute a cadeia inteira em uma chamada:
  ┌─────────────┐     ┌─────────────────────┐     ┌──────────────┐
  │  clarify    │ →   │  ground OR optimize │ →   │   critique   │
  │  (optional) │     │       (core)        │     │  (optional)  │
  └─────────────┘     └─────────────────────┘     └──────────────┘

  one call = compose_prompt(prompt, [sources], post_critique, auto_revise, ...)
clarify_with_user— Dado um rascunho ambíguo, retorna 1–3 perguntas de esclarecimento direcionadas, cada uma com umsuggested_answerque você pode aceitar literalmente, 2–4optionsopcionais de seleção rápida e uma tagdimension(audience/scope/format/length/tone/constraints/goal/platform). Faz curto-circuito comclarificationNeeded: falseem prompts confiantes e bem formados, para que flua limpo na frente deoptimize_promptsem custo de latência por chamada.ground_prompt— A variante estrita e aumentada por recuperação deoptimize_prompt. Fontes fornecidas pelo chamador são fixadas na prioridade mais alta — acima das regras do projeto, acima das instruções fixadas — e rastreadas individualmente no trace comouser-source:N. Modo estrito: zero fontes não vazias → erro, sem fall-through silencioso. Limite de corpo por fonte (4000 caracteres) para que uma única colagem enorme não domine o orçamento.critique_prompt— LLM-como-juiz. Pontua um prompt candidato de 0–10 em 5 dimensões padrão (clareza, especificidade, alinhamento de intenção, adequação de formato, adequação de comprimento) — ou seus próprios critérios — com justificativa por dimensão + sugestões concretas, uma pontuação geral e um veredito (accept/revise/reject). Abaixo derevise_threshold(padrão 7.0), também retorna umimprovedPromptque você pode usar. Use-o antes do voo ("este prompt é bom o suficiente para o modelo caro?"), em postmortem ("o prompt foi a causa?") ou para escolher por A/B a melhor de N variantes de otimização.compose_prompt— Uma chamada MCP executa o pipeline canônico. Decide automaticamente o ramo ground vs. optimize com base em se você passousources.pre_clarify: 'auto' | 'always' | 'never'.post_critique: trueadiciona uma passagem de juiz.auto_revise: truesubstituifinal_promptpela reescrita quando o veredito não éaccept. Retorna um array de auditoriastagespor estágio para que o chamador veja exatamente o que foi executado.- Harness de avaliação v0 — Testes de regressão determinísticos sob
evals/. 20 fixtures YAML cobrem as superfícies de analyzer, shape, intent-overlay, grounding, clarify, critique, ground e compose.npm run evalproduz um resumo no console + um relatório HTML autossuficiente com tema escuro. A matriz multi-modelo é apenas bash: executeLLM_MODEL=... npm run eval -- --report-path evals/report-X.htmlpor modelo. - Avaliações com gate de CI (opt-in) — Quando
OPENAI_API_KEYé definido como segredo do repositório, o harness de avaliação roda no CI contragpt-4o-minicomo gate de release. Desligado por padrão; nada sai da sua máquina sem o segredo. - 5 novas ferramentas MCP (20 no total).
optimize_prompttambém ganha um ponto de injeçãouserProvidedSources— tantoground_promptquantocompose_prompto usam internamente, mas ele está disponível diretamente se você quiser controle explícito sem a validação de modo estrito.
Carregado da 1.3: memória persistente + pacotes de conhecimento + aprendizado reflexivo. O curador continua pontuando e ajustando fontes de grounding na janela restante do modelo alvo.
explain_last_curationainda fornece um detalhamento por chamada de candidatos selecionados vs. rejeitados com motivos.
O que está incluso (cumulativo até 1.16.0)
- Context Engine — coleta automaticamente regras do workspace (
CLAUDE.md,AGENTS.md,.cursorrules,.clinerules,clarify.md), detecta frameworks e linguagens a partir depackage.jsone manifestos irmãos, rastreia um trecho de arquivo ativo e mantém um buffer circular por sessão de otimizações recentes e seus resultados. PromptAnalyzerunificado — uma chamada LLM produz{ category, intent, recommendedMode, confidence }juntos. 10 intenções:production-code,brand-voice,stakeholder-comm,data-extract,creative-media,technical-spec,analysis,quick-draft,exploration,unknown. A intenção supera palavras-chave de superfície em ambiguidade.- Modelagem de prompt ciente do modelo alvo — prompt do sistema,
maxTokensetemperaturese adaptam à janela de contexto do LLM downstream e à intenção resolvida. Modelos locais pequenos recebem um prompt compacto; Claude/GPT-4/Gemini recebem a riqueza completa. - Contexto de Grounding (único, ordenado por prioridade) — instruções fixadas pelo usuário → regras do projeto → arquivo ativo → exemplos aceitos anteriores → busca na web → metadados do workspace → dicas do modelo alvo → instruções de plataforma personalizada → dicas de sintaxe integradas. Sem mais silos de contexto paralelos.
- Recuperação de sessão (save_outcome) — o chamador relata
accepted | edited | rejectedpor otimização; saídas aceitas semelhantes na mesma sessão são injetadas como exemplos few-shot em prompts futuros semelhantes. Suportado por memória persistente (SQLite + sqlite-vec), então resultados aceitos sobrevivem a reinicializações. - Rastreamento JSONL local — cada otimização escreve uma linha de trace estruturada (agora com campos
shape,groundingSources,error) em$CLARIFYPROMPT_HOME/traces/YYYY-MM-DD.jsonl. Nada é enviado. Alternável viaCLARIFYPROMPT_TRACE=off. $CLARIFYPROMPT_HOMEunificado — uma variável de ambiente para tudo que o ClarifyPrompt escreve.CLARIFYPROMPT_CONFIG_DIR/CLARIFYPROMPT_DATA_DIRlegados ainda funcionam (aviso de depreciação, silenciável).- Três transportes —
stdio(padrão),streamable-http(MCP sobre Nodehttp, sessões com estado +/health) ea2a(um peer Agent-to-Agent: cartão de agente, JSON-RPCmessage/send+ SSEmessage/stream, cancelamento de tarefas, esclarecimentoinput-required). Uma variável de ambienteCLARIFYPROMPT_TRANSPORT; o comportamento de stdio é byte-idêntico ao anterior. - 61 plataformas, 7 categorias, pacotes datados por
verifiedAt, plataformas personalizadas — cada fato integrado verificado contra a documentação atual do fornecedor em 2026-10-05, com novas plataformas (Seedance, ElevenLabs Music, Lyria) e Sora aposentada. - Qualquer LLM, qualquer provedor. Um caminho de código funciona com qualquer API compatível com OpenAI — Ollama (local + nuvem), LM Studio, vLLM, OpenAI, Google Gemini, xAI Grok, Groq, Mistral, DeepSeek, Cohere, Perplexity, Together, Fireworks, OpenRouter — além de Anthropic Claude diretamente. Modelos de raciocínio (
o1/o3/o4,deepseek-reasoner,gpt-oss,*-thinking) são detectados automaticamente e recebem um orçamento de tokens maior para que realmente produzam conteúdo. Veja 15+ exemplos de provedores pré-configurados abaixo. - Apache-2.0, para sempre. Núcleo de código aberto, sem relicenciamento.
Início Rápido
Com Docker
Puxe a imagem publicada do GitHub Container Registry (multi-arquitetura: amd64 + arm64, com proveniência assinada + SBOM):
docker pull ghcr.io/lumabyteco/clarifyprompt-mcp:latest
Toda a configuração é passada em tempo de execução — nada é embutido na imagem, então ela é segura para compartilhar e não contém segredos:
# stdio (for MCP hosts that launch the container)
docker run --rm -i \
  -e LLM_API_URL=http://host.docker.internal:11434/v1 \
  -e LLM_MODEL=qwen2.5:7b \
  -e CLARIFYPROMPT_HOME=/data \
  -v clarifyprompt-data:/data \
  ghcr.io/lumabyteco/clarifyprompt-mcp:latest

# or serve over HTTP / A2A
docker run --rm -p 3000:3000 \
  -e CLARIFYPROMPT_TRANSPORT=a2a -e CLARIFYPROMPT_HTTP_HOST=0.0.0.0 \
  -e LLM_API_URL=http://host.docker.internal:11434/v1 -e LLM_MODEL=qwen2.5:7b \
  ghcr.io/lumabyteco/clarifyprompt-mcp:latest
Monte um volume em
CLARIFYPROMPT_HOMEpara persistir memória, traces e pacotes entre execuções. PasseLLM_API_KEY/EMBED_API_KEYcomo variáveis de ambiente-e(ou--env-file) em tempo de execução — nunca os embuta em uma imagem.
Com Claude Desktop
Adicione ao seu claude_desktop_config.json:
{
  "mcpServers": {
    "clarifyprompt": {
      "command": "npx",
      "args": ["-y", "clarifyprompt-mcp"],
      "env": {
        "LLM_API_URL": "http://localhost:11434/v1",
        "LLM_MODEL": "qwen2.5:7b"
      }
    }
  }
}
Com Claude Code
claude mcp add clarifyprompt -- npx -y clarifyprompt-mcp
Defina as variáveis de ambiente no seu shell antes de iniciar:
export LLM_API_URL=http://localhost:11434/v1
export LLM_MODEL=qwen2.5:7b
Com Cursor
Adicione ao seu .cursor/mcp.json:
{
  "mcpServers": {
    "clarifyprompt": {
      "command": "npx",
      "args": ["-y", "clarifyprompt-mcp"],
      "env": {
        "LLM_API_URL": "http://localhost:11434/v1",
        "LLM_MODEL": "qwen2.5:7b"
      }
    }
  }
}
Com AI Butler
AI Butler é um runtime de agente de IA pessoal auto-hospedado — um único binário Go, chat multicanal, hub de ecossistema MCP. Coloque o ClarifyPrompt na configuração mcp.servers e o agente adota todas as 23 ferramentas como capacidades nativas, chamáveis de qualquer canal (chat web, terminal, Telegram, Slack, etc.). O AI Butler descobre ferramentas dinamicamente via tools/list do MCP, então adicionar/remover ferramentas no ClarifyPrompt atualiza a superfície do agente automaticamente — sem necessidade de editar a configuração no lado do butler.
Edite ~/.aibutler/config.yaml:
configurations:
  mcp:
    servers:
      - name: clarifyprompt
        command: clarifyprompt-mcp
        env:
          LLM_API_URL: "http://localhost:11434/v1"
          LLM_MODEL: "qwen3-vl:8b"
Reinicie o AI Butler. O log de inicialização confirma que as ferramentas estão conectadas:
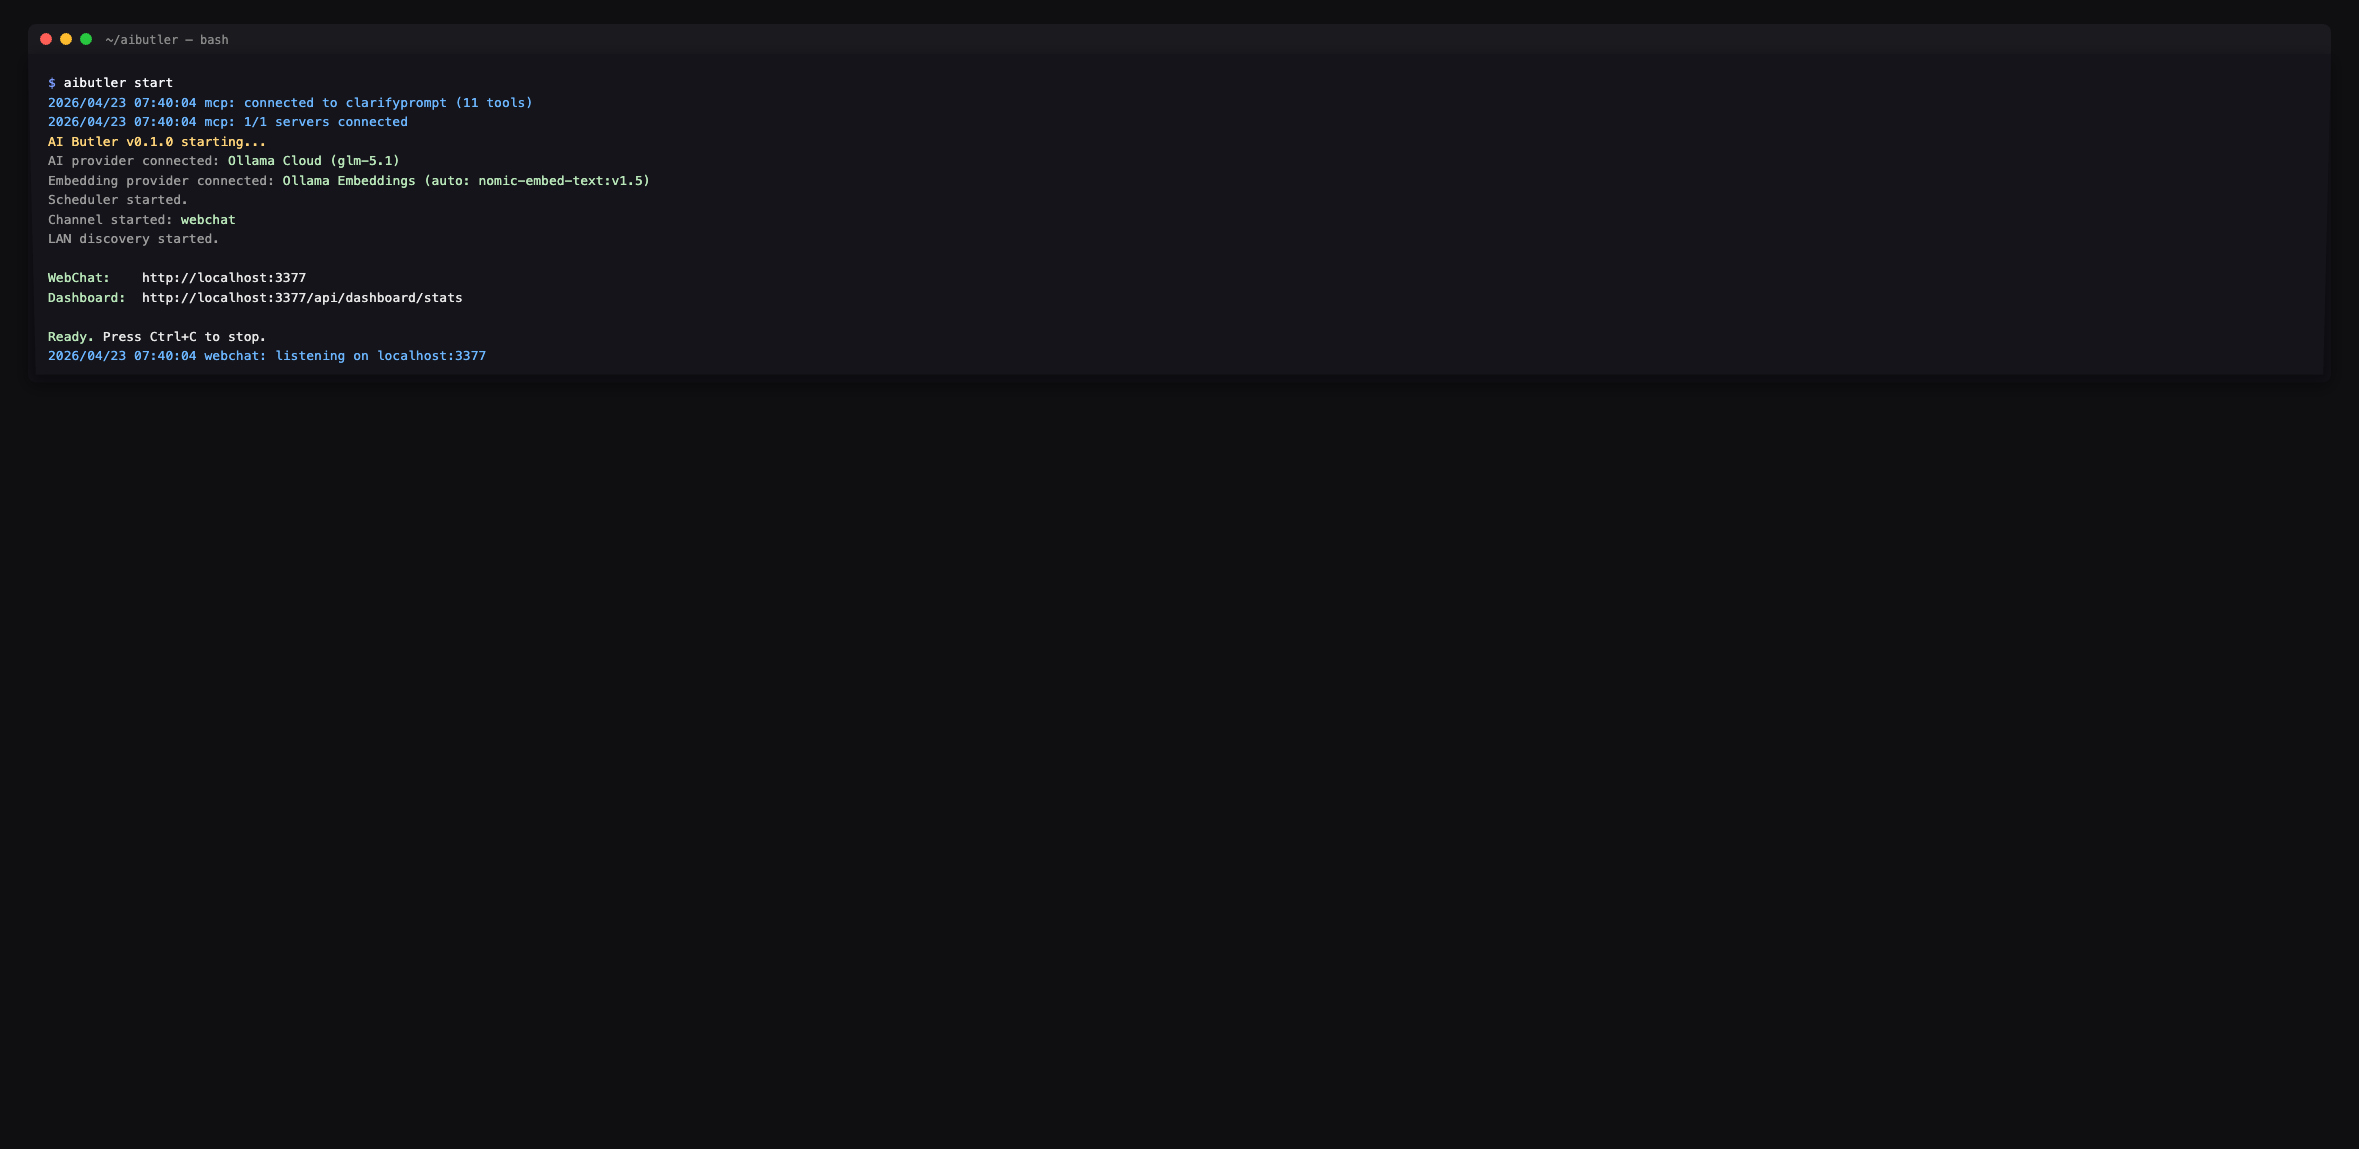 O agente enumera toda a superfície sob solicitação — cada ferramenta prefixada
com
clarifyprompt.:
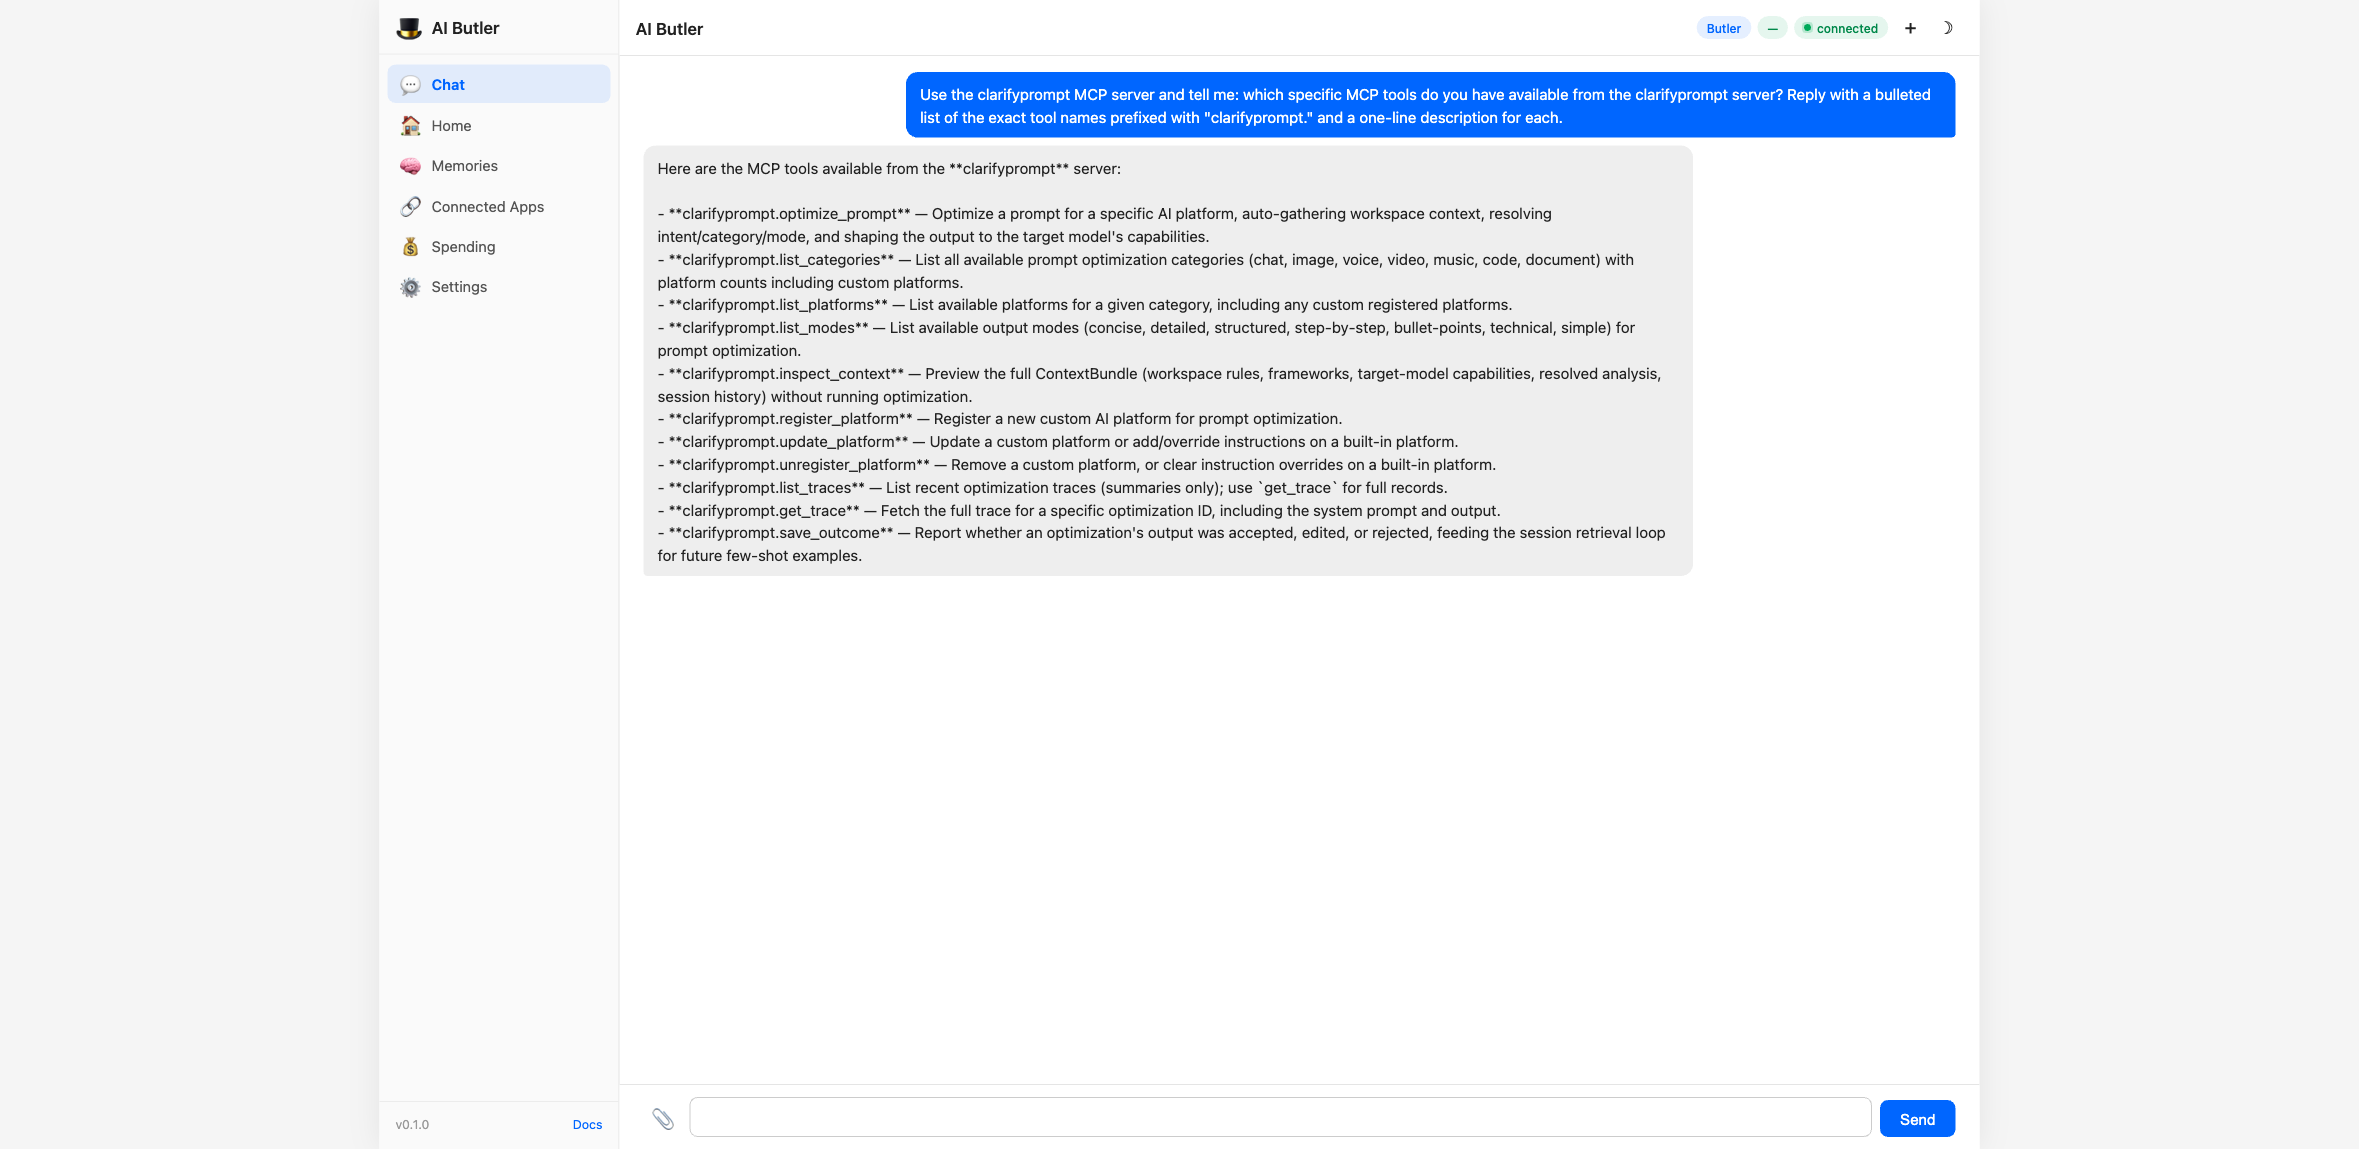
📸 As capturas de tela acima são de uma integração da era 1.2 (11 ferramentas). O
1.6.xatual expõe 23 ferramentas —optimize_prompt,clarify_with_user,ground_prompt,critique_prompt,compose_prompt, além das ferramentas de gerenciamento / inspeção / memória (memory_search,memory_remember,memory_forget,memory_list_facts, ferramentas de pacote de conhecimento, rastros, plataformas personalizadas, etc.). O AI Butler as detecta automaticamente via descobertatools/listdo MCP; nenhuma alteração de configuração é necessária.
Conduza o Context Engine de ponta a ponta
Você pode visualizar o que o mecanismo coletaria (sem executar a
otimização) usando inspect_context:
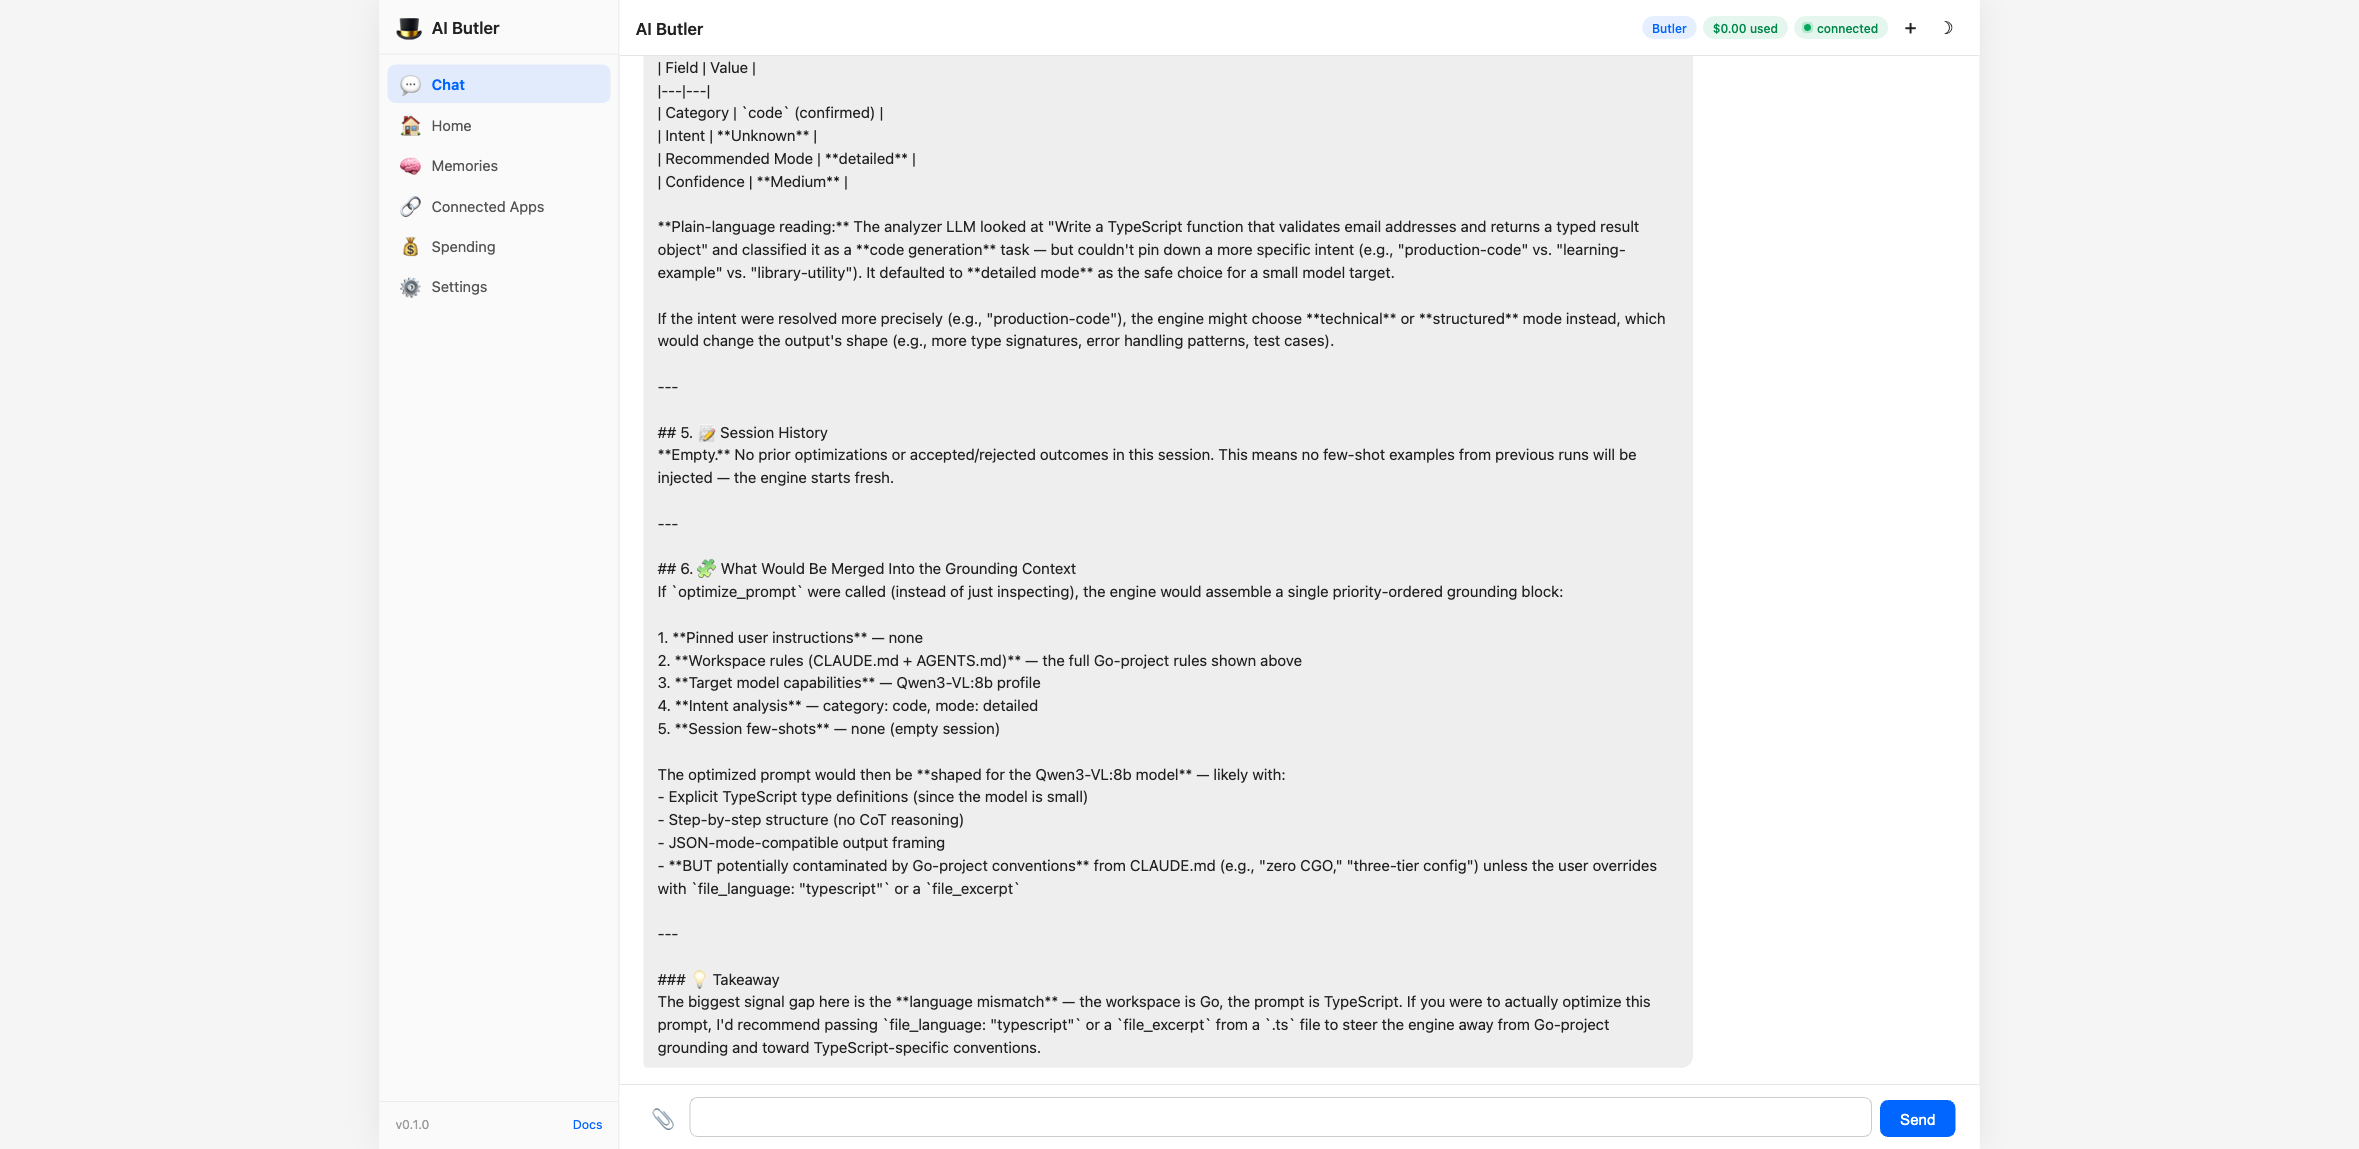
Em seguida, execute o otimizador real para qualquer uma das 60+ plataformas suportadas:
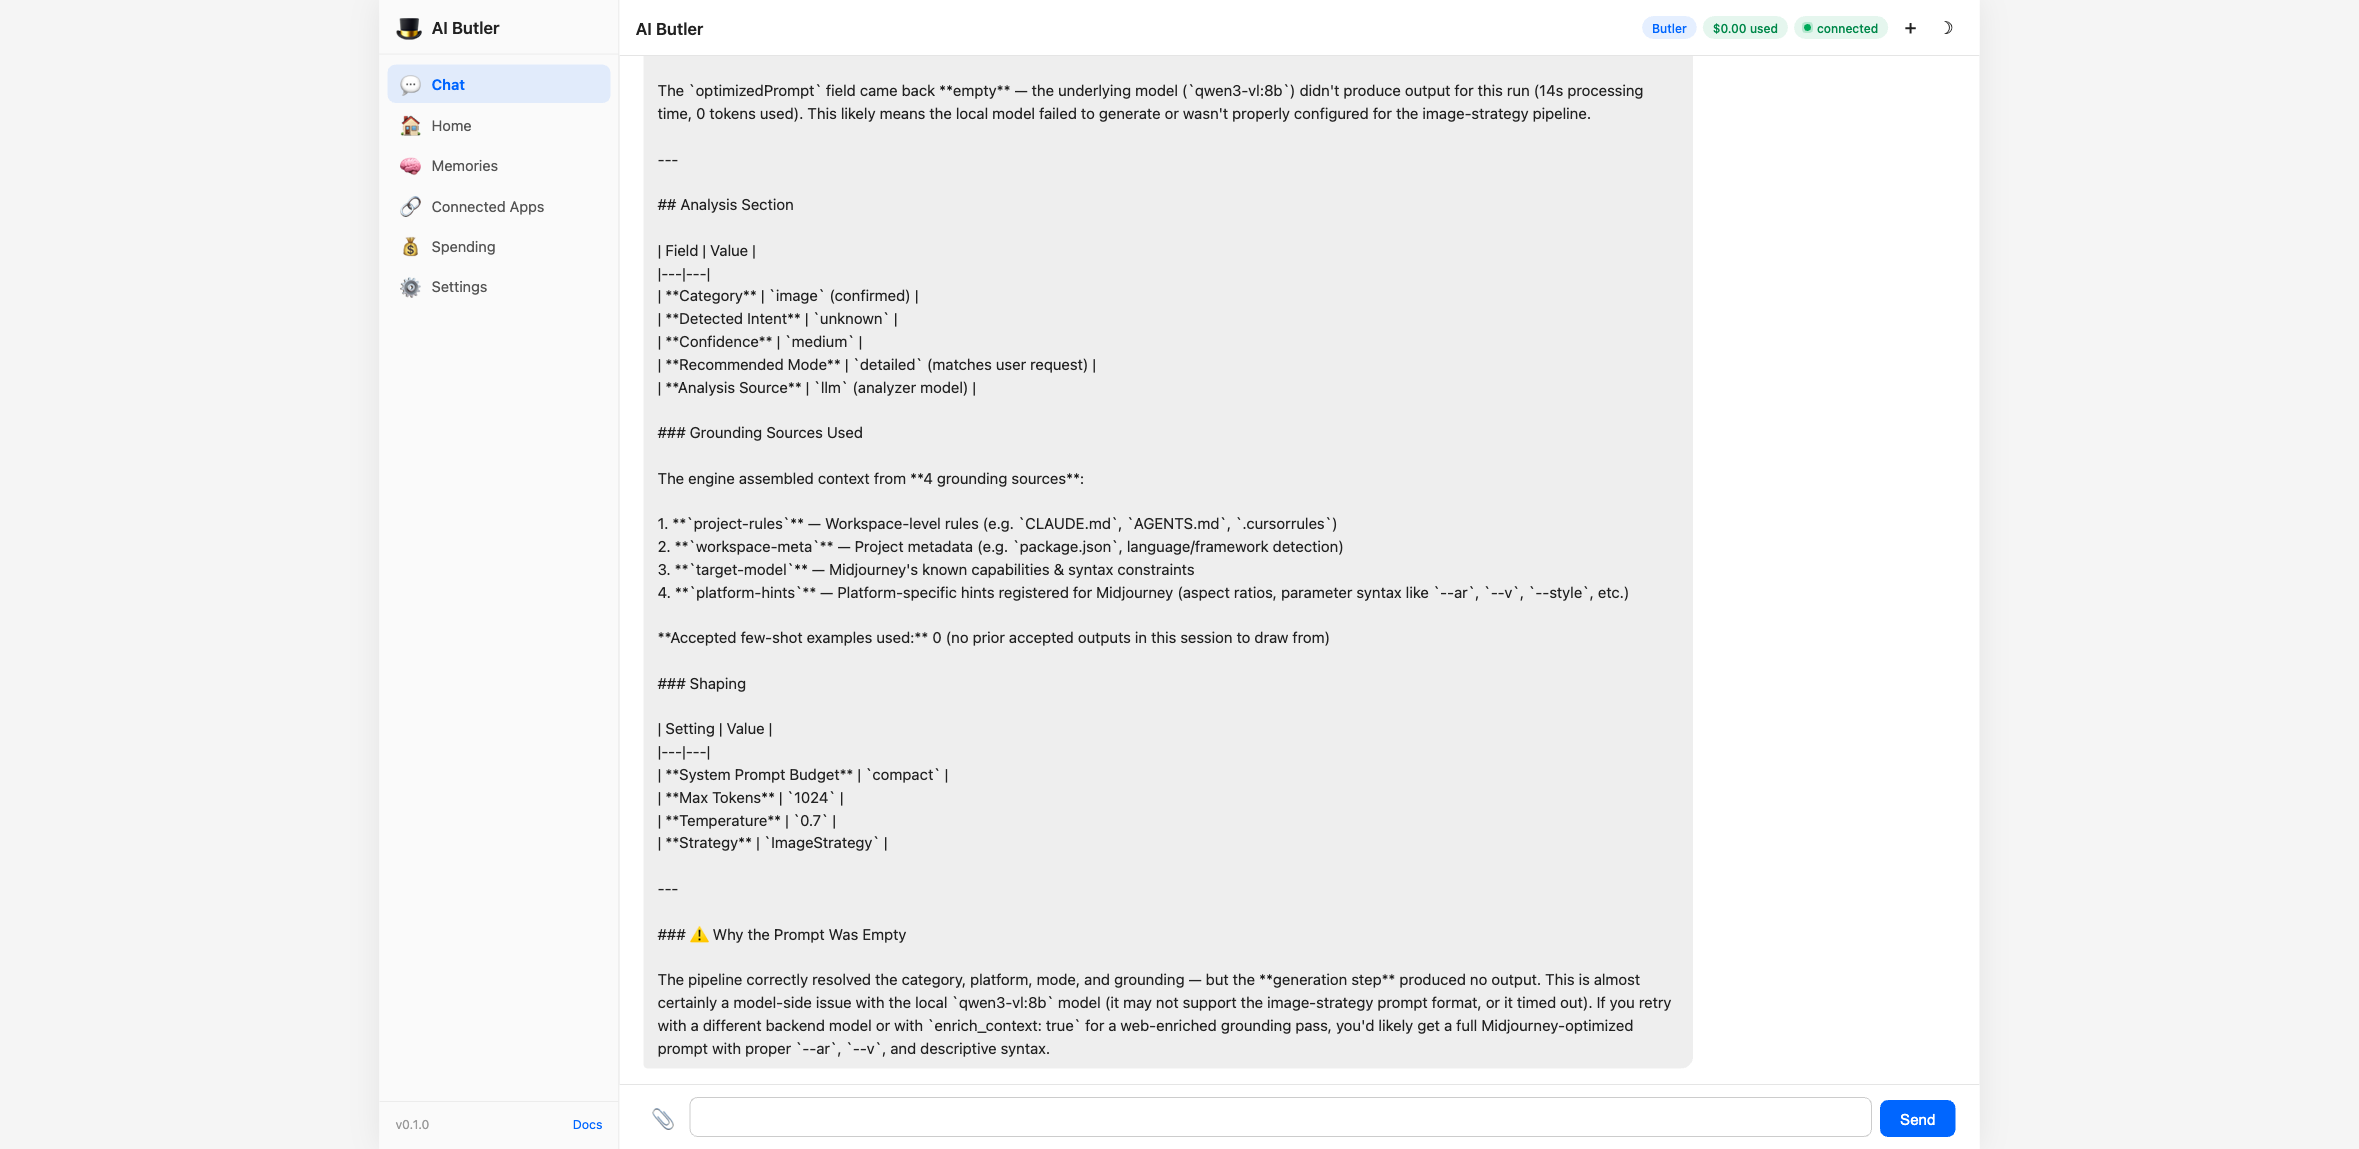
Cada otimização gera uma única linha JSONL em
~/.clarifyprompt/traces/YYYY-MM-DD.jsonl — estritamente local, nunca
enviada. A ferramenta list_traces transforma isso em um resumo consultável
com suporte a replay via get_trace:
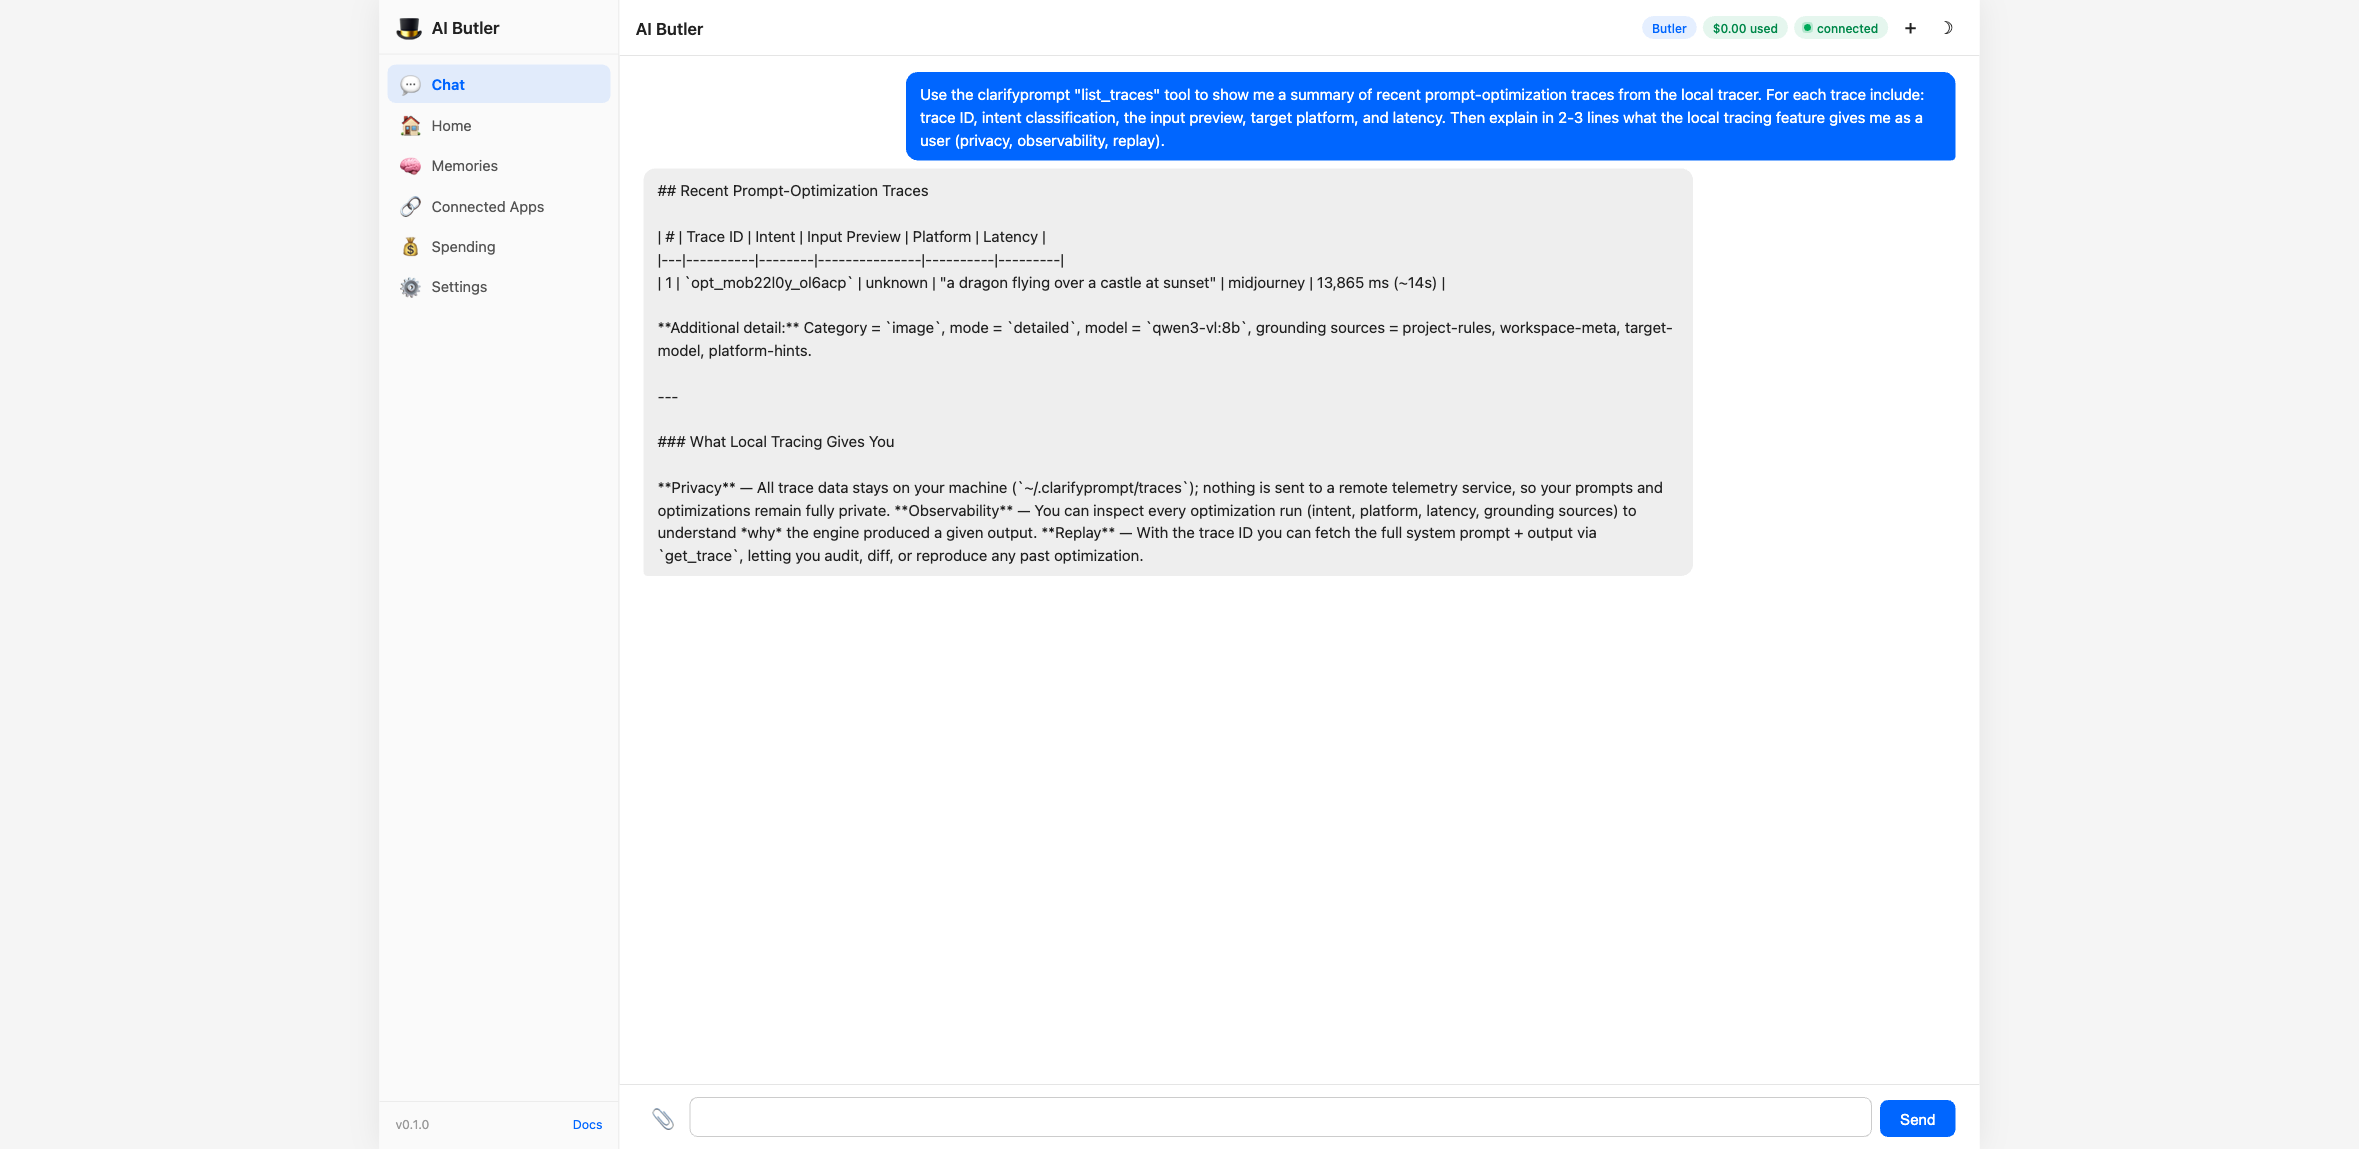
O passo a passo completo da integração — incluindo todas as 11 ferramentas acionadas via chat, opções de configuração e exemplos de uso em linguagem natural — está na documentação do AI Butler: Integrate an MCP Server.
Configuração e o painel de composição
Tudo o que você precisa para executar o pipeline completo e (em hosts compatíveis) ver o painel de resultados interativo.
O modelo que faz o trabalho
O ClarifyPrompt chama um endpoint compatível com OpenAI ou Anthropic, definido via env:
LLM_API_URL=http://localhost:11434/v1     # Ollama shown; any OpenAI-compatible URL works
LLM_API_KEY=                              # empty for local Ollama; a key for hosted providers
LLM_MODEL=qwen2.5:7b                      # the model that rewrites and judges
A saída é dependente do modelo — a estrutura (a sintaxe de uma plataforma, as dimensões de crítica) é consistente entre modelos; o texto exato e as pontuações variam por modelo.
Execute o pipeline completo em uma única chamada
compose_prompt({
  "prompt": "write a product update email about our new dashboard",
  "platform": "claude",     // target a platform's tuning; omit for portable, neutral output
  "pre_clarify": "never",   // "auto" | "always" | "never"
  "post_critique": true     // adds the LLM-as-judge pass (verdict + the six score dimensions)
})
Retorna { optimization: { id, sessionId, originalPrompt, platform, … }, finalPrompt, critique: { verdict, overallScore, dimensions[] }, stages[] }.
Direcionando uma plataforma
platform: (em optimize_prompt ou compose_prompt) seleciona o ajuste de uma plataforma — ex.: midjourney, dall-e, veo, suno, claude, chatgpt, cursor (61 integradas, datadas por verifiedAt, + quaisquer que você registre). Para chat, as plataformas são os modelos (claude, chatgpt, gemini, llama, deepseek, …). Categorias de texto (chat/document/code) produzem saída portátil e neutra em relação à plataforma quando você omite platform — nomeie uma para optar pelos idiomas específicos daquela plataforma.
Modelos por estágio (ex.: um modelo mais forte como crítico)
compose_prompt pode rotear cada estágio para um nome de modelo diferente:
compose_prompt({
  "prompt": "…",
  "optimize_model": "qwen2.5:14b",   // rewrite on a cheaper model
  "critique_model": "gpt-4o",        // judge on a stronger one
  "clarify_model":  "qwen2.5:7b"
})
Importante: todos os nomes por estágio usam o mesmo
LLM_API_URL— a substituição altera apenas o nome do modelo, não o endpoint. Portanto, comLLM_API_URLapontando para Ollama, cada modelo por estágio deve ser um modelo Ollama; apontando para OpenAI, cada modelo deve ser um modelo OpenAI. Para realmente misturar provedores (ex.: um modelo local para otimizar +gpt-4opara criticar), aponteLLM_API_URLpara um gateway que atenda ambos os nomes — OpenRouter, um proxy LiteLLM ou qualquer roteador compatível com OpenAI. (optimize_promptpor si só não tem substituição de modelo por chamada; ele usaLLM_MODEL.)
O painel de composição interativo (MCP Apps)
Em hosts que suportam a extensão io.modelcontextprotocol/ui — Claude Desktop, Cursor, VS Code, … — compose_prompt renderiza um painel ao vivo ao lado do resultado: seu prompt original, a saída otimizada (com um alternador de diff mostrar alterações), um selo for <platform> / general purpose, as seis barras de pontuação de crítica e as ações Aceitar / Revisar. Aceitar registra o resultado via save_outcome (alimentando o loop de memória few-shot); Revisar envia seu feedback de volta ao chat. Hosts sem a extensão não são afetados — eles recebem o mesmo texto + resultado structuredContent e nenhum painel.
Plataformas Suportadas (61 integradas, datadas por verifiedAt, personalizadas ilimitadas)
| Categoria | Plataformas | Padrão |
|---|---|---|
| Imagem (12) | Midjourney (V8.x), OpenAI image (GPT Image 2/DALL-E 3), Stable Diffusion, Flux (2), Ideogram, Leonardo AI, Adobe Firefly, Grok Aurora, Google Imagen (4), Nano Banana, Recraft, Higgsfield | Midjourney |
| Vídeo (12) | Runway (Gen-4.5), Pika (2.2), Kling (3.0/Omni), Luma (Ray 2), Minimax/Hailuo (2.3), Google Veo (3.1), Seedance (2.0/2.5), Wan (2.6), HeyGen, Synthesia, CogVideoX, Higgsfield | Runway |
| Chat (9) | Claude, ChatGPT, Gemini, Llama, DeepSeek, Qwen, Kimi, GLM, Minimax | Claude |
| Código (9) | Claude, ChatGPT, Cursor, GitHub Copilot, Windsurf, DeepSeek Coder, Qwen Coder, Codestral, Gemini | Claude |
| Documento (8) | Claude, ChatGPT, Gemini, Jasper, Copy.ai, Notion AI, Grammarly, Writesonic | Claude |
| Voz (7) | ElevenLabs (v3), OpenAI TTS (gpt-4o-mini-tts), Fish Audio, Sesame, Google TTS, PlayHT, Kokoro | ElevenLabs |
| Música (6) | Suno (v6), Udio, ElevenLabs Music (v2.5), Google Lyria (3.5), Stable Audio, MusicGen | Suno |
Ferramentas
optimize_prompt
A ferramenta principal. Otimiza um prompt para uma plataforma de IA específica.
{
  "prompt": "a cat sitting on a windowsill",
  "category": "image",
  "platform": "midjourney",
  "mode": "concise"
}
Todos os parâmetros, exceto prompt, são opcionais. Quando category e platform são omitidos, o ClarifyPrompt os detecta automaticamente a partir do conteúdo do prompt.
Três modos de chamada:
| Modo | Exemplo |
|---|---|
| Zero-config | { "prompt": "sunset over mountains" } |
| Somente categoria | { "prompt": "...", "category": "image" } |
| Totalmente explícito | { "prompt": "...", "category": "image", "platform": "dall-e" } |
Parâmetros:
| Parâmetro | Obrigatório | Descrição |
|---|---|---|
prompt | Sim | O prompt a ser otimizado |
category | Não | chat, image, video, voice, music, code, document. Detectado automaticamente quando omitido. |
platform | Não | ID da plataforma (ex.: midjourney, dall-e, veo, claude). Usa o padrão da categoria quando omitido. |
mode | Não | Estilo de saída: concise, detailed, structured, step-by-step, bullet-points, technical, simple. Padrão: detailed. |
enrich_context | Não | Defina true para usar pesquisa na web para enriquecimento de contexto. Padrão: false. |
session_id | Não | Une otimizações relacionadas para que a memória da sessão possa influenciar chamadas subsequentes. Gerado automaticamente quando omitido. |
file_path | Não | Caminho do arquivo ativo — infere o idioma e molda dicas de plataforma. |
file_language | Não | Substituição explícita de idioma para o arquivo ativo. |
file_excerpt | Não | Trecho curto (≤2 KB) do arquivo ativo para fundamentar a reescrita. |
cwd | Não | Diretório de trabalho para verificar CLAUDE.md / AGENTS.md / .cursorrules / package.json. Padrão: cwd do servidor. |
user_locale | Não | Dica de localidade (ex.: en-US, ar-EG) para informar tom e idioma. |
user_pinned_instructions | Não | Instruções de usuário fixas e sempre aplicadas (bloco curto de memória central). |
include_bundle | Não | Incluir o resumo do ContextBundle resolvido na resposta. Padrão: false. |
skip_intent_resolution | Não | Pular a chamada LLM do classificador de intenção (mais rápido; perde o sinal de intenção). Padrão: false. |
Resposta (1.2.0):
{
  "id": "opt_mo9vlg9i_foohjx",
  "sessionId": "sess_mo9vlfn3_abc123",
  "originalPrompt": "a dragon flying over a castle at sunset",
  "optimizedPrompt": "a majestic dragon flying over a medieval castle at sunset --ar 16:9 --v 8.2 --style raw --q 2 --s 700",
  "category": "image",
  "platform": "midjourney",
  "mode": "concise",
  "modeSource": "analyzer",
  "analysis": {
    "category": "image",
    "intent": "creative-media",
    "recommendedMode": "detailed",
    "confidence": "high",
    "source": "llm"
  },
  "grounding": {
    "sources": ["project-rules", "workspace-meta", "target-model", "platform-hints"],
    "acceptedExamplesUsed": 0
  },
  "shape": {
    "systemPromptBudget": "standard",
    "maxTokens": 2048,
    "temperature": 0.9
  },
  "metadata": {
    "model": "qwen2.5:14b-instruct-q4_K_M",
    "processingTimeMs": 3911,
    "strategy": "ImageStrategy"
  },
  "detection": { "autoDetected": true, "detectedCategory": "image", "detectedPlatform": "midjourney", "confidence": "high" },
  "intent": { "detected": "creative-media", "confidence": "high" }
}
O campo de classificação canônico é analysis. Os campos detection e intent são aliases obsoletos mantidos para compatibilidade retroativa 1.x; eles serão removidos na 2.x.
modeSource informa como o modo final foi decidido (user se você passou um, analyzer se foi orientado por intenção, default se nenhum dos dois).
grounding.sources lista quais seções do Grounding Context contribuíram, em ordem de prioridade. grounding.acceptedExamplesUsed informa quantos exemplos few-shot o mecanismo extraiu do histórico save_outcome.
shape informa como o prompt do sistema foi dimensionado para o seu modelo de destino.
clarify_with_user (novo na 1.4.0)
Dado um rascunho de prompt ambíguo, retorna 1–3 perguntas de esclarecimento direcionadas em vez de adivinhar. Use como um pré-estágio antes de optimize_prompt quando você não conseguir saber se a solicitação do usuário produzirá uma boa reescrita.
{
  "prompt": "make it better",
  "force": true
}
Resposta:
{
  "clarificationNeeded": true,
  "reason": "Clarification recommended (analyzer confidence=low; intent=unknown; prompt is short (12 chars); caller passed force=true).",
  "questions": [
    {
      "question": "What outcome do you want from this prompt — what does success look like?",
      "reasoning": "The draft is ambiguous on the goal/audience dimension; pinning this typically resolves most downstream ambiguity.",
      "suggestedAnswer": "Make the email shorter, clearer, and more action-oriented.",
      "options": ["Make it shorter", "Make it more formal", "Make it more persuasive"],
      "dimension": "goal"
    }
  ],
  "analysis": { "category": "chat", "intent": "unknown", "confidence": "low" }
}
suggestedAnswer está sempre preenchido — o chamador pode aceitá-lo literalmente e seguir em frente. options é opcional; clientes de UI podem renderizá-lo como botões de seleção rápida. A tag dimension classifica qual eixo a pergunta aborda.
Atalho: quando a confiança do analisador é high E o prompt é não trivialmente longo, a ferramenta retorna clarificationNeeded: false sem chamada LLM além do analisador — para que você possa colocá-lo em pipeline na frente de optimize_prompt sem custo de latência em cada chamada. Passe force: true para desabilitar o atalho.
ground_prompt (novo na 1.4.0)
Variante estrita e aumentada por recuperação de optimize_prompt. Fontes fornecidas pelo chamador são fixadas na prioridade mais alta — acima das regras do projeto e instruções fixas — para que a reescrita seja fundamentada no material que você forneceu, em vez do que o curador decidir ser relevante.
{
  "prompt": "rewrite the launch announcement to match our voice",
  "category": "document",
  "platform": "claude",
  "sources": [
    {
      "label": "Brand Voice Rules",
      "body": "Tone: warm, plain-spoken, no jargon. Always lead with the user benefit. Avoid 'leverage', 'synergy', 'robust'. Max sentence length: 18 words.",
      "kind": "rules"
    },
    {
      "label": "Launch Draft",
      "body": "Today we're launching FlowSync Pro — a tool to leverage AI synergy for robust team coordination...",
      "kind": "draft"
    }
  ]
}
Retorna o mesmo formato de optimize_prompt mais usedSources (quais fontes realmente entraram na fundamentação curada) e droppedSources (fontes que estavam vazias ou foram descartadas). As fontes aparecem no rastro como user-source:0, user-source:1, etc.
Modo estrito: zero fontes não vazias → erro, não passagem silenciosa. O limite de corpo por fonte é de 4000 caracteres para que uma única colagem enorme não domine o orçamento.
critique_prompt (novo na 1.4.0)
LLM-como-juiz. Pontua um prompt candidato de 0–10 em 6 dimensões padrão e (quando abaixo do limite) retorna uma reescrita melhorada.
{
  "prompt": "make it good",
  "revise_threshold": 7
}
Resposta:
{
  "overallScore": 2.0,
  "verdict": "reject",
  "summary": "Reject — substantial rewrite required.",
  "dimensions": [
    { "name": "clarity", "score": 1, "rationale": "...", "suggestions": ["Specify what 'it' refers to", "..."] },
    { "name": "specificity", "score": 0, "rationale": "...", "suggestions": [...] },
    { "name": "intent_alignment", "score": 3, "rationale": "...", "suggestions": [...] },
    { "name": "format_fitness", "score": 2, "rationale": "...", "suggestions": [...] },
    { "name": "length_appropriateness", "score": 1, "rationale": "...", "suggestions": [...] },
    { "name": "plain_language", "score": 4, "rationale": "...", "suggestions": [...] }
  ],
  "improvedPrompt": "Improve the README's getting-started section: shorten...",
  "improvements": ["Specified the artifact (README's getting-started section)", "Added concrete success criteria", "..."],
  "judgeModel": "qwen2.5-coder:7b-instruct-q4_K_M"
}
Parâmetros:
| Parâmetro | Padrão | Descrição |
|---|---|---|
prompt | — | Prompt candidato a ser pontuado. |
original_prompt | — | Ao criticar uma versão otimizada, a solicitação original do usuário. Usado para a dimensão intent_alignment. |
criteria | 6 padrões | Dimensões personalizadas: [{ name, description }, ...]. Até ~8 dimensões. |
revise_threshold | 7.0 | Pontuação geral abaixo deste valor aciona a passagem de reescrita. |
skip_rewrite | false | Pular a passagem de reescrita completamente (mais rápido; apenas retorna pontuações). |
Verificação de sanidade: se o juiz inflar overall mais de 2,5 pontos acima da média por dimensão, o mecanismo corrige.
compose_prompt (novo na 1.4.0)
O pipeline canônico. Uma chamada executa esclarecer → fundamentar/otimizar → criticar → revisão automática opcional.
{
  "prompt": "Write a TypeScript function that takes an array of email strings and returns only those that match RFC 5322 syntax. Include unit tests using Vitest with at least 6 test cases.",
  "pre_clarify": "auto",
  "post_critique": true,
  "auto_revise": true
}
Resposta (truncada):
{
  "stages": [
    { "name": "clarify",  "ranAt": "...", "durationMs":  541, "summary": "no clarification needed (short-circuit)" },
    { "name": "optimize", "ranAt": "...", "durationMs": 3128, "summary": "5 grounding source(s) selected" },
    { "name": "critique", "ranAt": "...", "durationMs": 3422, "summary": "verdict=accept, score=8.4" }
  ],
  "finalPrompt": "Write a TypeScript function `validateEmails(emails: string[]): string[]` that...",
  "clarificationRequired": false,
  "clarification": { "clarificationNeeded": false, ... },
  "optimization": { "id": "opt_...", "optimizedPrompt": "...", ... },
  "critique": { "overallScore": 8.4, "verdict": "accept", ... }
}
finalPrompt é o que você deve enviar downstream. Ele é igual a optimization.optimizedPrompt (ou grounding.optimizedPrompt) a menos que auto_revise: true E o veredito da crítica não seja accept E haja um improvedPrompt — nesse caso, finalPrompt é a reescrita e revised: true.
Ramificação:
| Entradas | Caminho |
|---|---|
sem sources | ramo optimize_prompt (fundamentação curada automaticamente) |
sources não vazio | ramo ground_prompt (estrito, fontes fornecidas pelo chamador fixadas) |
pre_clarify: "auto" (padrão) | esclarecer é executado; faz atalho sem exibir perguntas em prompts confiantes |
pre_clarify: "always" | esclarecer sempre é executado e INTERROMPE a cadeia se perguntas surgirem |
pre_clarify: "never" | pular esclarecer completamente |
post_critique: true | crítica é executada após otimizar/fundamentar |
auto_revise: true (com post_critique: true) | quando o veredito !== accept e há um improvedPrompt, substituir finalPrompt |
Parada forçada: se o clarify levantar perguntas (isso só acontece quando pre_clarify: "always", ou auto em um prompt de baixa confiança), a cadeia para e retorna clarificationRequired: true. O chamador responde às perguntas, edita o prompt para incorporar as respostas e faz nova chamada (normalmente com pre_clarify: "never" para pular a segunda passada de clarify). |
Adições da versão 1.6.0
-
max_iterations(1–5, padrão 1) — loop de revisão agêntica. Comauto_revise: trueEpost_critique: true, oimprovedPromptde cada iteração realimenta o fluxo de otimização+crítica até que o veredito seja aceito, não haja improvedPrompt disponível ou o limite seja atingido. O pré-clarify só dispara uma vez. A resposta incluiiterationsmostrando quantas iterações foram executadas. -
clarify_model/optimize_model/critique_model— roteamento de modelo por etapa. Cada um substitui a variável de ambienteLLM_MODELpara aquela etapa. Use para rotear a composição entre níveis de custo/qualidade — por exemplo, clarify local barato, otimização frontier hospedada, crítica barata:{ "prompt": "...", "post_critique": true, "clarify_model": "qwen2.5-coder:7b-instruct-q4_K_M", "optimize_model": "claude-sonnet-5", "critique_model": "gpt-4o-mini" }optimization.metadata.modelecritique.judgeModelna resposta refletem o modelo real que executou cada etapa.
inspect_context (novo na 1.2.0)
Pré-visualize o ContextBundle que o ClarifyPrompt montaria para um determinado prompt — regras do workspace, frameworks, capacidades do modelo-alvo, intenção resolvida e histórico da sessão — sem executar a otimização completa. Útil para depurar por que uma otimização resultou daquela forma.
{
  "prompt": "Write an email to finance explaining the Q2 spend variance",
  "category": "document",
  "cwd": "/path/to/your/project"
}
Retorna o ContextBundle completo como JSON.
list_traces (novo na 1.2.0)
Lista resumida dos traces de otimização recentes capturados pelo tracer local (quando CLARIFYPROMPT_TRACE=local, o padrão).
{ "day": "2026-04-22", "limit": 50 }
Retorna IDs de trace, prévias de entradas, intenções resolvidas, famílias-alvo e latências — nunca o prompt de sistema completo (use get_trace para isso). Omita day para obter o dia mais recente com dados.
get_trace (novo na 1.2.0)
Busca o trace completo de uma única otimização por ID, incluindo o prompt de sistema exato, o resumo do bundle e a saída.
{ "id": "opt_xxx", "lookback_days": 7 }
save_outcome (novo na 1.2.0)
Informa ao ClarifyPrompt se uma otimização passada foi accepted, edited ou rejected. Saídas aceitas tornam-se exemplos few-shot para prompts futuros semelhantes na mesma sessão. Na versão 1.3+, isso também alimentará a camada de memória persistente. Espera-se que o IDE/agente/chamador invoque isso após o usuário agir com base na otimização.
{
  "optimization_id": "opt_xxx",
  "session_id": "sess_yyy",
  "verdict": "accepted",
  "diff": "optional: the user's edited version or a patch"
}
list_categories
Lista todas as 7 categorias com contagens por plataforma (integradas e personalizadas) e padrões.
list_platforms
Lista as plataformas disponíveis para uma determinada categoria, incluindo plataformas personalizadas registradas. Mostra qual é a padrão e se instruções personalizadas estão configuradas.
list_modes
Lista todos os 7 modos de saída com descrições.
register_platform
Registra uma nova plataforma de IA personalizada para otimização de prompts.
{
  "id": "my-llm",
  "category": "chat",
  "label": "My Custom LLM",
  "description": "Internal fine-tuned model",
  "syntax_hints": ["JSON mode", "max 2000 tokens"],
  "instructions": "Always use structured output format",
  "instructions_file": "my-llm.md"
}
| Parâmetro | Obrigatório | Descrição |
|---|---|---|
id | Sim | ID único (minúsculas, alfanumérico com hífens) |
category | Sim | Categoria à qual esta plataforma pertence |
label | Sim | Nome legível da plataforma |
description | Sim | Descrição curta |
syntax_hints | Não | Dicas de sintaxe específicas da plataforma |
instructions | Não | Instruções de otimização inline |
instructions_file | Não | Caminho para um arquivo .md com instruções detalhadas |
update_platform
Atualiza uma plataforma personalizada ou adiciona substituições de instruções a uma plataforma integrada.
Para plataformas integradas (ex.: Midjourney, Claude), você pode adicionar instruções personalizadas e dicas extras de sintaxe sem modificar as originais:
{
  "id": "midjourney",
  "category": "image",
  "instructions": "Always pin the current version (--v 8.2), prefer --style raw",
  "syntax_hints_append": ["--no plants", "--tile for patterns"]
}
Para plataformas personalizadas, todos os campos podem ser atualizados.
unregister_platform
Remove uma plataforma personalizada ou limpa as substituições de instruções de uma plataforma integrada.
{
  "id": "my-llm",
  "category": "chat"
}
Para plataformas integradas, use remove_override_only: true para limpar suas instruções personalizadas sem afetar a própria plataforma.
Plataformas Personalizadas e Instruções
O ClarifyPrompt suporta o registro de plataformas personalizadas e o fornecimento de instruções de otimização — semelhante a como .cursorrules ou CLAUDE.md orientam o comportamento da IA.
Como Funciona
- Registre uma plataforma personalizada via
register_platform - Forneça instruções inline ou como um arquivo
.md - Otimize prompts direcionados à sua plataforma personalizada — as instruções são injetadas no pipeline de otimização
Arquivos de Instrução
As instruções podem ser fornecidas como arquivos markdown armazenados em ~/.clarifyprompt/instructions/:
~/.clarifyprompt/
  config.json                    # custom platforms + overrides
  instructions/
    my-llm.md                   # instructions for custom platform
    midjourney-overrides.md     # extra instructions for built-in platform
Exemplo de arquivo de instrução (my-llm.md):
# My Custom LLM Instructions

## Response Format
- Always output valid JSON
- Include a "reasoning" field before the answer

## Constraints
- Max 2000 tokens
- Temperature should be set low (0.1-0.3) for factual queries

## Style
- Be concise and technical
- Avoid filler phrases
Substituir Plataformas Integradas
Você pode adicionar instruções personalizadas a qualquer uma das 61 plataformas integradas usando update_platform. Isso permite personalizar como os prompts são otimizados para plataformas como Midjourney, Claude ou Veo sem modificar os padrões.
Diretório de Configuração
O diretório de configuração tem como padrão ~/.clarifyprompt/ e pode ser alterado via variável de ambiente CLARIFYPROMPT_CONFIG_DIR. Plataformas personalizadas e substituições persistem entre reinicializações do servidor.
Pacotes de conhecimento
Um pacote de conhecimento é um documento markdown com frontmatter YAML opcional que ensina algo durável ao ClarifyPrompt — uma voz de marca, uma convenção de código, um regime de conformidade, um padrão de prompting específico de domínio. Os pacotes são divididos em blocos nos limites de H2, incorporados e disponibilizados para recuperação semântica em toda chamada subsequente de optimize_prompt / compose_prompt. O Context Curator pontua seus blocos juntamente com sinais do workspace, arquivos de instrução e fontes de fundamentação, e então ajusta a seleção de maior utilidade à janela de tokens restante do modelo-alvo.
Pacotes iniciais incluídos
Quatro pacotes acompanham cada tarball npm em packs/:
| Pacote | O que ensina |
|---|---|
anthropic-brand-voice | Tom público, registro e escolhas de palavras da Anthropic |
higgsfield-creative-handbook | Seleção de modelo Higgsfield, estrutura de prompt, movimentos de câmera, fluxo de trabalho Soul ID |
nextjs-14-best-practices | Convenções do Next.js 14 App Router server-first |
sox-compliance | Salvaguardas Sarbanes-Oxley 404 para trabalho financeiro assistido por IA |
Carregando um pacote
load_knowledge_pack({
  source: "https://raw.githubusercontent.com/LumabyteCo/clarifyprompt-mcp/main/packs/nextjs-14-best-practices.md",
  scope: "user"
})
Ou carregue localmente — por caminho absoluto, ou relativo ao pacote instalado:
load_knowledge_pack({ source: "/path/to/my-team-style-guide.md", scope: "project" })
load_knowledge_pack({ source: "./node_modules/clarifyprompt-mcp/packs/sox-compliance.md", scope: "session" })
Escopos
user— persistido em$CLARIFYPROMPT_HOMEe disponível em todos os projetos nesta máquina.project— persistido, mas com escopo na identidade da árvore de trabalho atual (project-id derivado decwd+ remote git quando presente).session— com escopo na sessão MCP atual; não recuperado após a reinicialização do servidor.
Pacotes de todos os três escopos são pontuados juntos no momento da recuperação; o curador decide quais blocos sobrevivem ao orçamento de tokens.
Autoria e contribuição
As regras de autoria de pacotes (esquema de frontmatter, orientação de limites de blocos, o padrão de qualidade para PRs serem mesclados) estão em packs/README.md. Contribuições chegam via PR contra este repositório. Apache-2.0, salvo licenciamento duplo no frontmatter.
Por que os pacotes vivem no repositório do motor (e não em um registro separado)
Resumidamente: eles costumavam viver. De 1.3 até 1.6.3 havia um registro separado de LumabyteCo/clarifyprompt-packs. Em 1.6.4 ele foi arquivado e consolidado de volta em clarifyprompt-mcp/packs/ porque a disciplina de dois repositórios estava pagando custo de manutenção para um público de contribuidores externos que não se materializou — e o pacote higgsfield-creative-handbook foi lançado em 1.6.2 sem nunca chegar ao registro, exemplo A da deriva. A divisão faz sentido quando houver uma função de força real (fila de PR da comunidade, contagem de pacotes >20, licenciamento/governança divergentes). Até lá, o modelo de repositório único mantém a fonte da verdade singular e inequívoca.
Configuração do LLM
O ClarifyPrompt usa um LLM para otimizar prompts. Funciona com qualquer API compatível com OpenAI e com a API da Anthropic diretamente.
Variáveis de Ambiente
| Variável | Obrigatória | Descrição |
|---|---|---|
LLM_API_URL | Sim | URL do endpoint da API |
LLM_API_KEY | Depende | Chave da API (não necessária para Ollama local) |
LLM_MODEL | Sim | Nome/ID do modelo |
LLM_TIMEOUT_MS | Não | Timeout de requisição do LLM por chamada em ms. Padrão 30000 (30s). Aumente para modelos locais grandes — ex.: um qwen3-next:80b de 50 GB pode levar ~120s por chamada, o que excede o padrão e apareceria como timeout. LLM_TIMEOUT_MS=180000 é um valor seguro para modelos locais grandes. |
LLM_REASONING_EFFORT | Não | (1.12.1+) Nível de raciocínio para modelos com canal de pensamento (gpt-oss, glm, *-thinking, deepseek-r, qwq): low | medium | high. Padrão low. Esses modelos também recebem um piso de max_tokens para que seu trace de raciocínio não esgote a resposta final (#3). Ignorado para modelos sem raciocínio. |
CLARIFYPROMPT_HOME | Não | Raiz canônica (1.2.0+) para tudo que o ClarifyPrompt grava — plataformas personalizadas, arquivos de instrução .md, traces, banco de memória e pacotes de conhecimento. Padrão: $XDG_DATA_HOME/clarifyprompt ou ~/.clarifyprompt. |
CLARIFYPROMPT_TRACE | Não | off | local | otel. Padrão: local. Os traces são estritamente JSONL local; nada é enviado. |
EMBED_API_URL | Não | (1.3.0+) Endpoint de embeddings para recuperação de memória + pacotes de conhecimento. Qualquer endpoint /v1/embeddings compatível com OpenAI. Padrão LLM_API_URL quando não definido — usuários de Ollama funcionam direto. |
EMBED_API_KEY | Não | (1.3.0+) Chave da API de embeddings. Padrão LLM_API_KEY quando não definida; não necessária para Ollama local. |
EMBED_MODEL | Não | (1.3.0+) Padrão: nomic-embed-text:v1.5 (768-dim, puxe com ollama pull nomic-embed-text). Troque para text-embedding-3-small para OpenAI, voyage-3 para Voyage, embed-english-v3.0 para Cohere. |
EMBED_DIMENSION | Não | (1.3.0+) Dimensão de saída dos embeddings. Padrão: 768. Deve corresponder ao seu modelo de embeddings (1536 para OpenAI text-embedding-3-small, 1024 para Voyage, etc.). |
SEARCH_PROVIDER | Não | Provedor opcional de enriquecimento por busca web quando enrich_context: true. Um de tavily (padrão) | brave | serper | serpapi | exa | searxng. |
SEARCH_API_KEY | Não | Chave da API para o SEARCH_PROVIDER configurado. Não necessária para SearXNG auto-hospedado. |
SEARCH_API_URL | Não | URL do endpoint de busca. Necessária apenas para SearXNG auto-hospedado (aponte para sua instância). |
CLARIFYPROMPT_SUPPRESS_LEGACY_WARN | Não | Defina como 1 para silenciar a dica de depreciação de uma linha quando CLARIFYPROMPT_CONFIG_DIR / CLARIFYPROMPT_DATA_DIR forem usados. |
CLARIFYPROMPT_CONFIG_DIR | Não | Legado alias para CLARIFYPROMPT_HOME. Ainda funciona; será removido na 2.x. |
CLARIFYPROMPT_DATA_DIR | Não | Legado alias para CLARIFYPROMPT_HOME. Ainda funciona; será removido na 2.x. |
Exemplos de Provedores
Ollama (local, gratuito):
LLM_API_URL=http://localhost:11434/v1
LLM_MODEL=qwen2.5:7b
Ollama — modelos em nuvem via passagem local (recomendado):
Se seu Ollama local estiver conectado ao Ollama Cloud, qualquer modelo :cloud roteia por ele de forma transparente — mesma URL, sem chave de API separada. A tabela de capacidades detecta automaticamente variantes de raciocínio/pensamento (gpt-oss, kimi-k2-thinking, qwen3-thinking, deepseek-r1, etc.) e aumenta maxTokens para que terminem de pensar e realmente produzam conteúdo.
LLM_API_URL=http://localhost:11434/v1
LLM_MODEL=gpt-oss:20b-cloud        # or kimi-k2.6:cloud, qwen3-next:80b-cloud, glm-4.6:cloud, etc.
Ollama — endpoint em nuvem direto (sem instalação local):
LLM_API_URL=https://ollama.com/v1
LLM_API_KEY=your-ollama-cloud-key
LLM_MODEL=qwen2.5:7b
OpenAI:
LLM_API_URL=https://api.openai.com/v1
LLM_API_KEY=sk-...
LLM_MODEL=gpt-4o
Modelos de raciocínio (
gpt-5,o3,o4-mini) também funcionam — o cliente lida automaticamente com os requisitos demax_completion_tokensetemperaturedeles. Eles pensam extensivamente, então aumente oLLM_TIMEOUT_MS(ex.:180000); o padrão de 30s geralmente é curto demais.
Anthropic Claude:
LLM_API_URL=https://api.anthropic.com/v1
LLM_API_KEY=sk-ant-...
LLM_MODEL=claude-sonnet-5
Google Gemini:
LLM_API_URL=https://generativelanguage.googleapis.com/v1beta/openai
LLM_API_KEY=your-gemini-key
LLM_MODEL=gemini-flash-latest
Use um modelo que sua chave consiga acessar — IDs mais antigos (ex.:
gemini-2.0-flash,gemini-2.5-flash) retornam404 "no longer available to new users"em chaves mais novas.gemini-flash-latestrastreia o modelo flash atual. (Nota:gemini-2.5-flash-image— "Nano Banana" — é um modelo de imagem; ele não pode serLLM_MODEL, que precisa ser um modelo de texto. Direcione-o como uma plataforma de imagem.)
Groq:
LLM_API_URL=https://api.groq.com/openai/v1
LLM_API_KEY=gsk_...
LLM_MODEL=llama-3.3-70b-versatile
DeepSeek:
LLM_API_URL=https://api.deepseek.com/v1
LLM_API_KEY=your-deepseek-key
LLM_MODEL=deepseek-chat
OpenRouter (qualquer modelo):
LLM_API_URL=https://openrouter.ai/api/v1
LLM_API_KEY=your-openrouter-key
LLM_MODEL=anthropic/claude-sonnet-4
Veja .env.example para a lista completa de mais de 20 provedores suportados, incluindo Together AI, Fireworks, Mistral, xAI, Cohere, Perplexity, LM Studio, vLLM, LocalAI, Jan, GPT4All e outros.
Busca na Web (Opcional)
Habilite o enriquecimento de contexto definindo enrich_context: true na sua chamada optimize_prompt. O ClarifyPrompt buscará na web o contexto relevante antes de otimizar.
Provedores de busca suportados:
| Provedor | Variável | URL |
|---|---|---|
| Tavily (padrão) | SEARCH_API_KEY | tavily.com |
| Brave Search | SEARCH_API_KEY | brave.com/search/api |
| Serper | SEARCH_API_KEY | serper.dev |
| SerpAPI | SEARCH_API_KEY | serpapi.com |
| Exa | SEARCH_API_KEY | exa.ai |
| SearXNG (auto-hospedado) | — | github.com/searxng/searxng |
SEARCH_PROVIDER=tavily
SEARCH_API_KEY=your-key
Antes e Depois
Imagem (Midjourney)
Before: "a cat sitting on a windowsill"

After:  "a tabby cat sitting on a sunlit windowsill, warm golden hour
         lighting, shallow depth of field, dust particles in light beams,
         cozy interior background, shot on 35mm film, warm amber color
         palette --ar 16:9 --v 8.2 --style raw --q 2"
Vídeo (Veo 3.1)
Before: "a timelapse of a city"

After:  "Cinematic timelapse of a sprawling metropolitan skyline
         transitioning from golden hour to blue hour to full night.
         Camera slowly dollies forward from an elevated vantage point.
         Light trails from traffic appear as the city illuminates.
         Clouds move rapidly overhead. Ambient city soundscape builds
         as the lights come on (native audio). Duration: 8s, extendable.
         Style: documentary cinematography, 4K, 16:9."
Código (Claude)
Before: "write a function to validate emails"

After:  "Write a TypeScript function `validateEmail(input: string): boolean`
         that validates email addresses against RFC 5322. Handle edge cases:
         quoted local parts, IP address domains, internationalized domain
         names. Return boolean, no exceptions. Include JSDoc with examples
         of valid and invalid inputs. No external dependencies."
Música (Suno)
Before: "compose a chill lo-fi beat for studying"

After:  "Compose an instrumental chill lo-fi beat for studying.
         [Tempo: medium] [Genre: lo-fi] [Length: 2 minutes]"
Mecanismo de Contexto (1.2.0)
Cada otimização passa por cinco etapas integradas que fluem um único pacote de contexto de ponta a ponta:
- Análise — uma única chamada de LLM
analyzePrompt()produzcategory,intenterecommendedModejuntos para que não possam discordar. A intenção vence as palavras-chave superficiais quando há conflito (ex.:"validate emails"→codee nãodocument). - Reconciliação de modo — a
modeexplícita do usuário vence; caso contrário, aplica-se a recomendação derivada da intenção do analisador;modeSourcena resposta informa qual foi usada. - Modelagem do prompt — o sinal de capacidade do modelo-alvo orienta o
systemPromptBudget(compacto para modelos locais pequenos, rico para modelos com contexto de 100K+),maxTokens,temperature(ciente da intenção) e se exemplos são incluídos. - Sobreposição de intenção — uma sobreposição curta por intenção (
production-code: exige tratamento de erros e testes;data-extract: exige schema estrito;brand-voice: comece com tom; etc.) incorporada ao prompt de sistema da estratégia. - Contexto de Fundamentação — um único bloco ordenado por prioridade que mescla instruções fixadas do usuário → regras do projeto → arquivo ativo → exemplos few-shot da sessão → busca na web → metadados do workspace → dicas do modelo-alvo → instruções personalizadas da plataforma → dicas de sintaxe integradas.
O que é coletado (ContextBundle)
- Projeto — primeiro arquivo correspondente de
CLAUDE.md,AGENTS.md,.cursorrules,.clinerules,clarify.md,.clarify/rules.md.package.jsonmais manifestos irmãos (pyproject.toml,Cargo.toml,go.mod,Gemfile,composer.json, …) orientam a detecção de framework e linguagem. - Arquivo — entradas opcionais
file_path/file_language/file_excerpt. - Sessão — buffer circular (20 ops/sessão) de otimizações e resultados recentes. Saídas aceitas são recuperadas como exemplos few-shot para prompts futuros semelhantes.
- Modelo-alvo — o LLM que faz a reescrita, comparado a uma tabela de capacidades.
- Usuário — localidade, modo preferido, instruções fixadas (fundamentação de maior prioridade).
Inspecionando o que o mecanismo vê
Use a ferramenta inspect_context para visualizar o pacote completo sem executar uma otimização. Mesma forma que optimize_prompt retorna quando include_bundle: true.
Estendendo o contexto
Coloque um AGENTS.md / clarify.md / CLAUDE.md na raiz do seu projeto. A próxima otimização o captará automaticamente. Para alimentar saídas aceitas de volta em reescritas futuras, chame save_outcome depois que o usuário agir sobre o resultado.
Rastreamento
$CLARIFYPROMPT_HOME/traces/YYYY-MM-DD.jsonl
Cada otimização grava uma linha JSONL capturando {id, ts, sessionId, category, platform, mode, input, bundleSummary, systemPrompt, output, model, strategy, latencyMs, shape, groundingSources, error}. Use list_traces para resumos e get_trace para registros completos.
Postura de privacidade:
- Os rastreamentos são estritamente locais. Nenhuma chamada de rede externa para infraestrutura de propriedade do ClarifyPrompt.
- Apenas chamadas para o endpoint de LLM que você configurou (
LLM_API_URL) e o provedor de busca opcional (SEARCH_API_KEY). - Desative o rastreamento completamente com
CLARIFYPROMPT_TRACE=off. - Não há telemetria nesta versão. Quando uma opção de telemetria for lançada, será opt-in, anônima e documentada antes de o build incluí-la.
Limitações conhecidas e roadmap
Persistência de memória (lançada)
O loop de save_outcome + recuperação few-shot persiste em SQLite + sqlite-vec sob $CLARIFYPROMPT_HOME — sessões, otimizações, resultados, fatos e blocos de pacotes sobrevivem a reinicializações. Um buffer circular em memória permanece apenas como caminho rápido na mesma sessão. Entradas com escopo de sessão são vinculadas ao ID da sessão, portanto não são recuperadas por sessões posteriores.
A qualidade da intenção escala com o modelo que executa o analisador
O analisador roda no mesmo LLM_MODEL que faz a reescrita. Na bateria de integração:
- Qwen 2.5 7B e 14B → correto em todos os prompts bem formados testados.
- Llama 3.2 3B → ocasionalmente se compromete demais em prompts ambíguos (ex.: marcou
"make it better"comobrand-voice/highquandounknown/lowé a resposta certa). Modelos maiores no mesmo prompt retornaram corretamenteunknown/low.
Orientação: prefira um modelo local de 7B+ (ou qualquer modelo hospedado de fronteira) como LLM_MODEL. Chamadas sensíveis à latência podem definir skip_intent_resolution: true para pular o analisador; o mecanismo recorre à categoria de dica do usuário e ao modo padrão, perdendo o modo orientado por intenção e a sobreposição, mas mantendo fundamentação e forma. O harness de avaliação incluído (evals/, npm run eval) traz um conjunto público de fixtures para você pontuar o analisador com seus próprios fixtures e detectar regressões em mudanças de modelo ou classificador.
Modelos recomendados
Pontue você mesmo com o executor de matriz incluído: npm run matrix -- --models <a>,<b>,…. Uma execução recente (2026-06, suíte de 30 fixtures, limite de aprovação 0.85, pontuação = média das pontuações dos fixtures):
| Modelo | Onde | Pontuação da suíte | Notas |
|---|---|---|---|
glm-5.2:cloud | nuvem · raciocínio | 99% | Melhor geral. Orçamento de pensamento tratado automaticamente (1.12.1). |
gpt-oss:20b-cloud | nuvem · raciocínio | 98% | Pesos abertos da OpenAI; reasoning_effort aplicado automaticamente (1.12.1). |
qwen2.5-coder:7b | local | 97% | Um pequeno modelo local lida com quase toda a suíte — o padrão local-first validado. |
gemma4:31b-cloud | nuvem | 92% | Versátil sólido. |
Os poucos fixtures abaixo do limite em qualquer execução são os casos subjetivos de classificação de analyzer-* intenção/modo e formulação de fundamentação (variação de conteúdo entre modelos), não erros de pipeline — os fixtures determinísticos do pipeline (clarify, ground, critique, compose, memory, packs) passam em todos os modelos. O padrão permanece local-first (qwen2.5:7b); use um modelo de fronteira/raciocínio quando quiser os últimos pontos de precisão de intenção. Modelos de raciocínio (gpt-oss, glm, *-thinking, …) são ajustados automaticamente (um piso de max_tokens + reasoning_effort) para não retornarem conteúdo vazio — veja LLM_REASONING_EFFORT.
A tabela de capacidades não é exaustiva
Entradas atuais: Claude, GPT-4/série-o, Gemini, Grok, DeepSeek (chat + raciocínio), Qwen, Llama, Mistral/Codestral, Mixtral, Gemma, Phi, Cohere Command, Aya, Kimi, GLM, Minimax, GPT-OSS, Yi, Nemotron. Modelos desconhecidos caem para a forma de prompt capabilities: {} e standard — ainda funcionais, apenas sem dimensionamento ciente do modelo. Adicionar entradas é uma edição apenas de dados em src/engine/context/targetModelSignals.ts.
Modelos de raciocínio / cadeia de pensamento
Suportados como caso de primeira classe. O mecanismo detecta automaticamente raciocinadores no nível de família (o1/o3/o4, deepseek-reasoner, gpt-oss) e no nível de variante (qualquer coisa cujo ID corresponda a /\b(thinking|reasoner|reasoning)\b/ ou /\br[12]\b/: kimi-k2-thinking:cloud, qwen3-thinking:72b, qwen-r1-distill, etc.). Para esses, maxTokens é automaticamente aumentado para ≥ 8192 para que o modelo tenha espaço para pensar E produzir conteúdo. O campo reasoning nunca é exibido como o prompt otimizado — apenas content é.
Arquitetura
clarifyprompt-mcp/
  src/
    index.ts                           MCP server entry point (23 tools, 6 resources: 1 static + 4 templates + 1 ui panel)
    apps/                              MCP Apps compose panel (panel.html template + panel.ts, bundled at build time)
    engine/
      config/
        categories.ts                  CategoryConfig type + CATEGORIES const (loaded from YAML in 1.5.0)
        platformLoader.ts              (1.5.0) YAML pack loader — reads packs/platforms/*.yaml at boot
        paths.ts                       Unified $CLARIFYPROMPT_HOME resolver (1.2.0)
        persistence.ts                 ConfigStore — JSON config + .md file loading
        registry.ts                    PlatformRegistry — merges built-in + custom
      context/                         Context Engine (1.2.0)
        types.ts                       ContextBundle + signal types + AnalysisSignal
        projectSignals.ts              CLAUDE.md / AGENTS.md / .cursorrules / manifests scan
        fileSignals.ts                 Active-file path + language + excerpt
        sessionSignals.ts              In-memory per-session ring buffer + outcome retrieval
        targetModelSignals.ts          Model → capabilities mapping
        promptAnalyzer.ts              Unified analyzer: category + intent + recommendedMode
        gitSignals.ts                  (1.6.0) branch + HEAD + dirty + recent commits
        environmentSignals.ts          (1.6.0) nowIso + weekday + timezone
        bundle.ts                      Bundle orchestrator
      trace/                           Local tracing (1.2.0)
        types.ts                       TraceEntry schema (shape, groundingSources, error)
        writer.ts                      JSONL + OTel-stub writer, reader, lookup
      memory/                          Persistent memory + knowledge packs (1.3.0)
        store.ts                       SQLite + sqlite-vec; bi-temporal facts, outcomes, packs
        packs.ts                       Knowledge-pack loader (local / URL / inline)
        reflection.ts                  LLM fact extraction on save_outcome
      llm/client.ts                    Multi-provider LLM client (OpenAI + Anthropic)
      search/client.ts                 Web search (6 providers; results merge into Grounding Context)
      optimization/
        engine.ts                      Core orchestrator — analyzer, shape, grounding, retrieval, trace
        curator.ts                     Token-budget grounding curator (1.3.0)
        groundingContext.ts            Priority-ordered context assembly + mode/shape helpers
        types.ts                       OptimizationContext + result shape (UserProvidedSource)
        strategies/
          base.ts                      Bundle-aware base strategy (intent overlay + shape-aware sizing)
          chat.ts                      9 platforms
          image.ts                     12 platforms
          video.ts                     11 platforms
          voice.ts                     7 platforms
          music.ts                     4 platforms
          code.ts                      9 platforms
          document.ts                  8 platforms
      clarification/clarify.ts         (1.4.0) clarify_with_user — targeted questions w/ defaults
      grounding/ground.ts              (1.4.0) ground_prompt — strict caller-provided grounding
      critique/critique.ts             (1.4.0) critique_prompt — LLM-as-judge + optional rewrite
      composition/compose.ts           (1.4.0) compose_prompt — canonical clarify→ground/opt→critique pipeline
  evals/                                Eval harness v0 (1.3.0; setup: multi-call in 1.5.0)
    run.mjs                            YAML fixtures → MCP server → scored HTML report
    fixtures/*.yaml                    33 deterministic fixtures
    schema.json                        Fixture schema
  scripts/build-panel.mjs               (1.14.0) bundles the MCP Apps panel into dist/apps/
  packs/                                Knowledge packs + platform packs (single source of truth, 1.6.4+)
    README.md                          Pack authoring guide (frontmatter, chunks, quality bar)
    *.md                               Knowledge packs — 4 bundled, community-contributable via PR
    platforms/*.yaml                   (1.5.0) built-in AI platform declarations — 7 files, 58 platforms
  docs/adoption/                        (1.5.0) launch-post drafts + catalog submission specs
Docker
docker build -t clarifyprompt-mcp .
docker run -e LLM_API_URL=http://host.docker.internal:11434/v1 -e LLM_MODEL=qwen2.5:7b clarifyprompt-mcp
Desenvolvimento
git clone https://github.com/LumabyteCo/clarifyprompt-mcp.git
cd clarifyprompt-mcp
npm install
npm run build
Teste com o MCP Inspector:
npx @modelcontextprotocol/inspector node dist/index.js
Defina as variáveis de ambiente na seção "Environment Variables" do Inspector antes de conectar.
Testes + avaliações
| Comando | O que faz |
|---|---|
npm run test:integration | Bateria de integração do dia 1 (intenção + fundamentação + forma) |
npm run test:day2 | Bateria de memória + curador + reflexão do dia 2 |
npm run test:reasoning | Cobertura de modelos de raciocínio (aumento de maxTokens de cadeia de pensamento) |
npm run test:wire | Teste de fumaça do wire MCP (servidor inicia, lista de ferramentas, round-trip de initialize) |
npm run test:all | Todas as quatro baterias em sequência |
npm run eval | Executa os 20 fixtures de avaliação determinísticos + renderiza evals/report.html |
npm run eval -- --filter <name> | Executa apenas fixtures que correspondem a <name> (ou uma tag) |
npm run eval -- --quiet | Saída apenas com código de saída (amigável para CI) |
Detalhes do harness de avaliação, formato de fixture e instruções da matriz multi-modelo: evals/README.md.
CI / Portões de qualidade
O repositório inclui um workflow do GitHub Actions (.github/workflows/ci.yml) com cinco jobs:
| Job | Executa em | O que controla |
|---|---|---|
build | todo push + PR | Typecheck + build + teste de fumaça de inicialização no Node 18/20/22 em Linux + macOS |
secrets-audit | todo push + PR | git-grep por prefixos conhecidos de chaves de API em arquivos rastreados |
evals | todo push + PR (opt-in) | npm run eval contra gpt-4o-mini. Pula com sucesso quando o segredo OPENAI_API_KEY não está definido; bloqueia publicação quando configurado e qualquer fixture regride |
docker | todo push + PR | docker build + teste de fumaça de inicialização do contêiner |
publish | apenas pushes de tag | npm publish --provenance quando a tag corresponde a package.json#version, condicionado a todos os quatro jobs acima |
Para habilitar avaliações como portão de lançamento no seu fork:
- Repo → Settings → Secrets and variables → Actions → New repository secret
- Nome:
OPENAI_API_KEY· Valor: uma chave de API da OpenAI com acesso agpt-4o-mini - Faça push ou re-execute qualquer workflow
Custo: ~$0,005 por execução de CI (17 fixtures ativos × ~1500 tokens de entrada × ~600 tokens de saída no preço do gpt-4o-mini). O relatório HTML do harness de avaliação é enviado como artefato de build (retenção de 30 dias) para que você possa inspecionar qualquer falha sem re-executar localmente.
Para habilitar publicação npm em pushes de tag: adicione um segredo NPM_TOKEN com um Granular Access Token com escopo para clarifyprompt-mcp (com bypass-2FA habilitado). Mesmo fluxo em Settings.