engram-rs-mcp
Servidor MCP para engram — memória persistente, semelhante ao cérebro, para agentes de IA.
Documentação
engram-rs


Mecanismo de memória para agentes de IA. Dois eixos: tempo (decadência e promoção em três camadas) e espaço (árvore de tópicos auto-organizável). Memórias importantes são promovidas, ruído desaparece, conhecimento relacionado se agrupa automaticamente.
A maioria das memórias de agentes é um armazenamento plano — despeje tudo, busca por palavras-chave para recuperar. Sem esquecimento, sem organização, sem ciclo de vida. O engram-rs adiciona a parte que torna a memória realmente útil: a capacidade de esquecer o que não importa e trazer à tona o que importa.
Um único binário Rust, um único arquivo SQLite, zero dependências externas. Sem Python, sem Redis, sem banco vetorial — curl | bash e ele roda. Binário de ~10 MB, ~100 MB de RSS, latência de busca de dígitos únicos em ms.
Início Rápido
# Install (interactive — will prompt for embedding provider config)
curl -fsSL https://raw.githubusercontent.com/kael-bit/engram-rs/main/install.sh | bash

# Store a memory
curl -X POST http://localhost:3917/memories \
  -d '{"content": "Always run tests before deploying", "tags": ["deploy"]}'

# Recall by meaning
curl -X POST http://localhost:3917/recall \
  -d '{"query": "deployment checklist"}'

# Restore full context (session start)
curl http://localhost:3917/resume
O Que Ele Faz
Ciclo de Vida em Três Camadas
Inspirado no modelo de memória Atkinson–Shiffrin, as memórias são gerenciadas em três camadas por importância:
Buffer (short-term) → Working (active knowledge) → Core (long-term identity)
      ↓                       ↓                           ↑
   eviction              importance decay           LLM quality gate
- Buffer: Ponto de entrada para todas as novas memórias. Armazenamento temporário — removido quando abaixo do limite
- Trabalho: Promovido via consolidação. Nunca excluído, a importância decai em taxas diferentes por tipo
- Núcleo: Promovido através do portão de qualidade LLM. Nunca excluído
Portão de Qualidade LLM
A promoção não é uma suposição baseada em regras — um LLM avalia cada memória em contexto e decide se ela realmente merece retenção de longo prazo.
Buffer → [LLM gate: "Is this a decision, lesson, or preference?"] → Working
Working → [sustained access + LLM gate] → Core
Decadência Automática
A decadência é orientada por atividade — ela só dispara durante ciclos ativos de consolidação, não por tempo de relógio. Se o sistema estiver ocioso, as memórias permanecem intactas.
Decadência exponencial segue a curva de esquecimento de Ebbinghaus — rápida no início, depois cauda longa. As memórias nunca desaparecem completamente (piso = 0,01), permanecendo recuperáveis sob consultas precisas. Quando uma memória é recuperada, ela recebe um impulso de ativação, fortalecendo o conhecimento usado com frequência.
| Tipo | Taxa de decadência | Meia-vida | Caso de uso |
|---|---|---|---|
episodic | Mais rápida | ~35 épocas | Eventos, experiências, contexto limitado no tempo |
semantic | Média | ~58 épocas | Conhecimento, preferências, lições (padrão) |
procedural | Mais lenta | ~173 épocas | Fluxos de trabalho, instruções, guias práticos |
Visualizações de Algoritmos
| Gráfico | O que mostra |
|---|---|
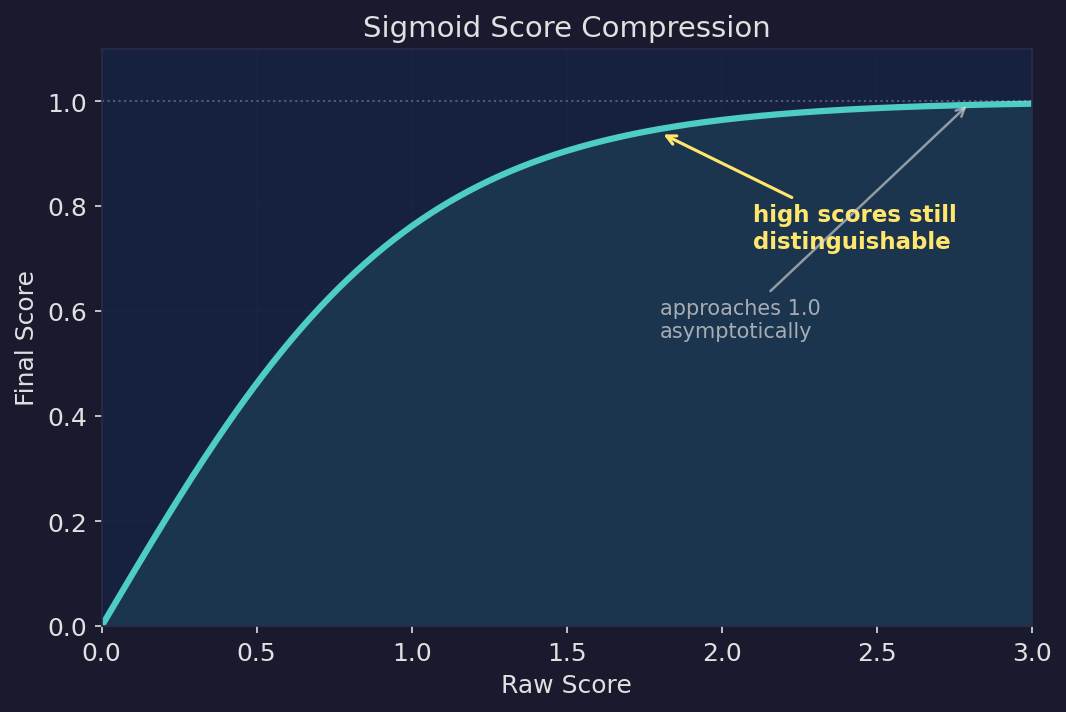 | Compressão de pontuação sigmoide. Pontuações brutas são mapeadas através de uma função sigmoide, aproximando-se de 1,0 assintoticamente. Resultados de alta relevância permanecem distinguíveis em vez de serem esmagados no mesmo valor. |
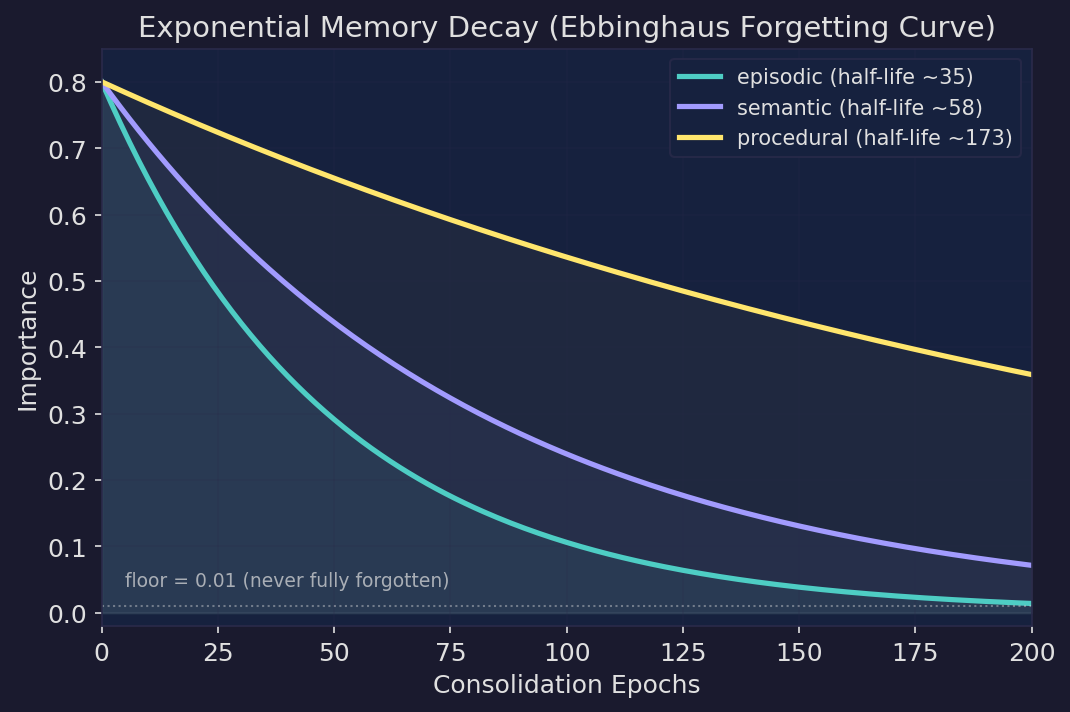 | Curva de esquecimento de Ebbinghaus. Decadência exponencial com taxas diferenciadas por tipo — memórias episódicas desaparecem mais rápido, procedurais mais lentamente. Piso em 0,01 significa que as memórias nunca desaparecem completamente; elas permanecem recuperáveis sob consultas precisas. |
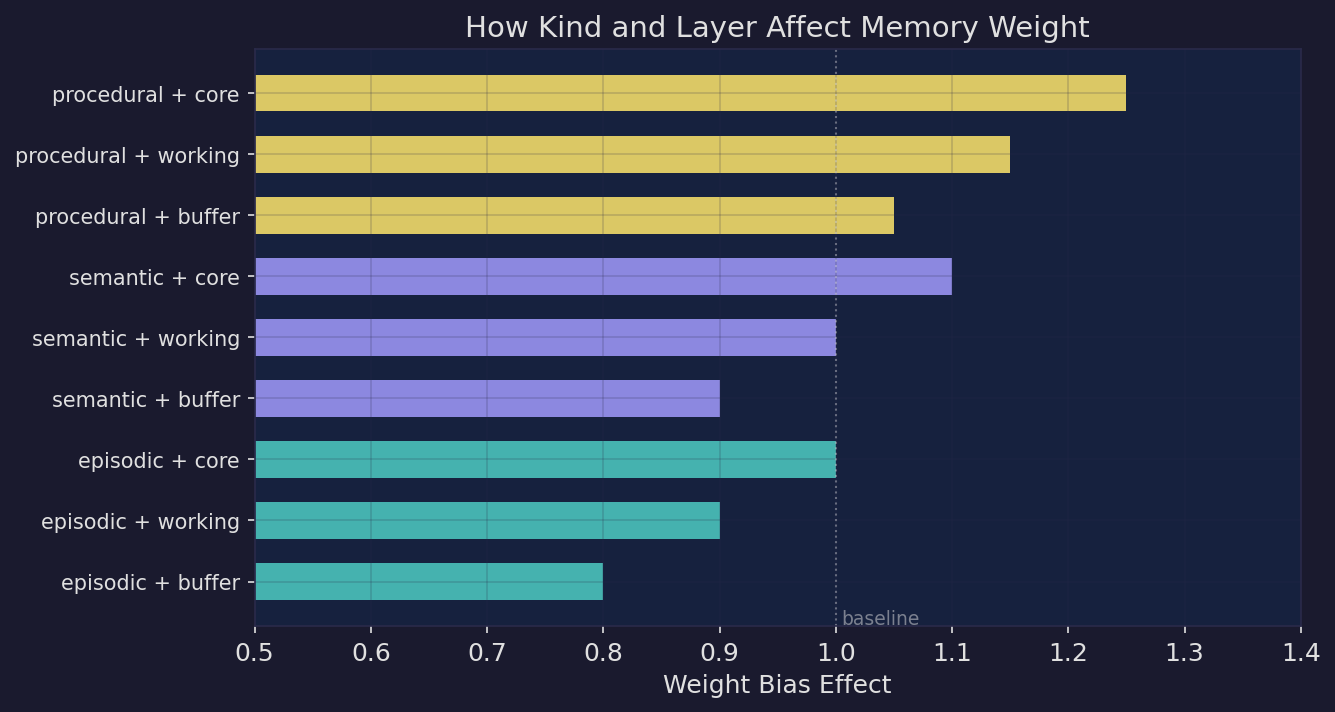 | Viés de peso tipo × camada. Vieses aditivos ajustam o peso da memória por tipo e camada. Memórias procedurais+núcleo classificam mais alto, episódicas+buffer mais baixo — mas a dispersão permanece limitada para que nenhuma combinação domine. |
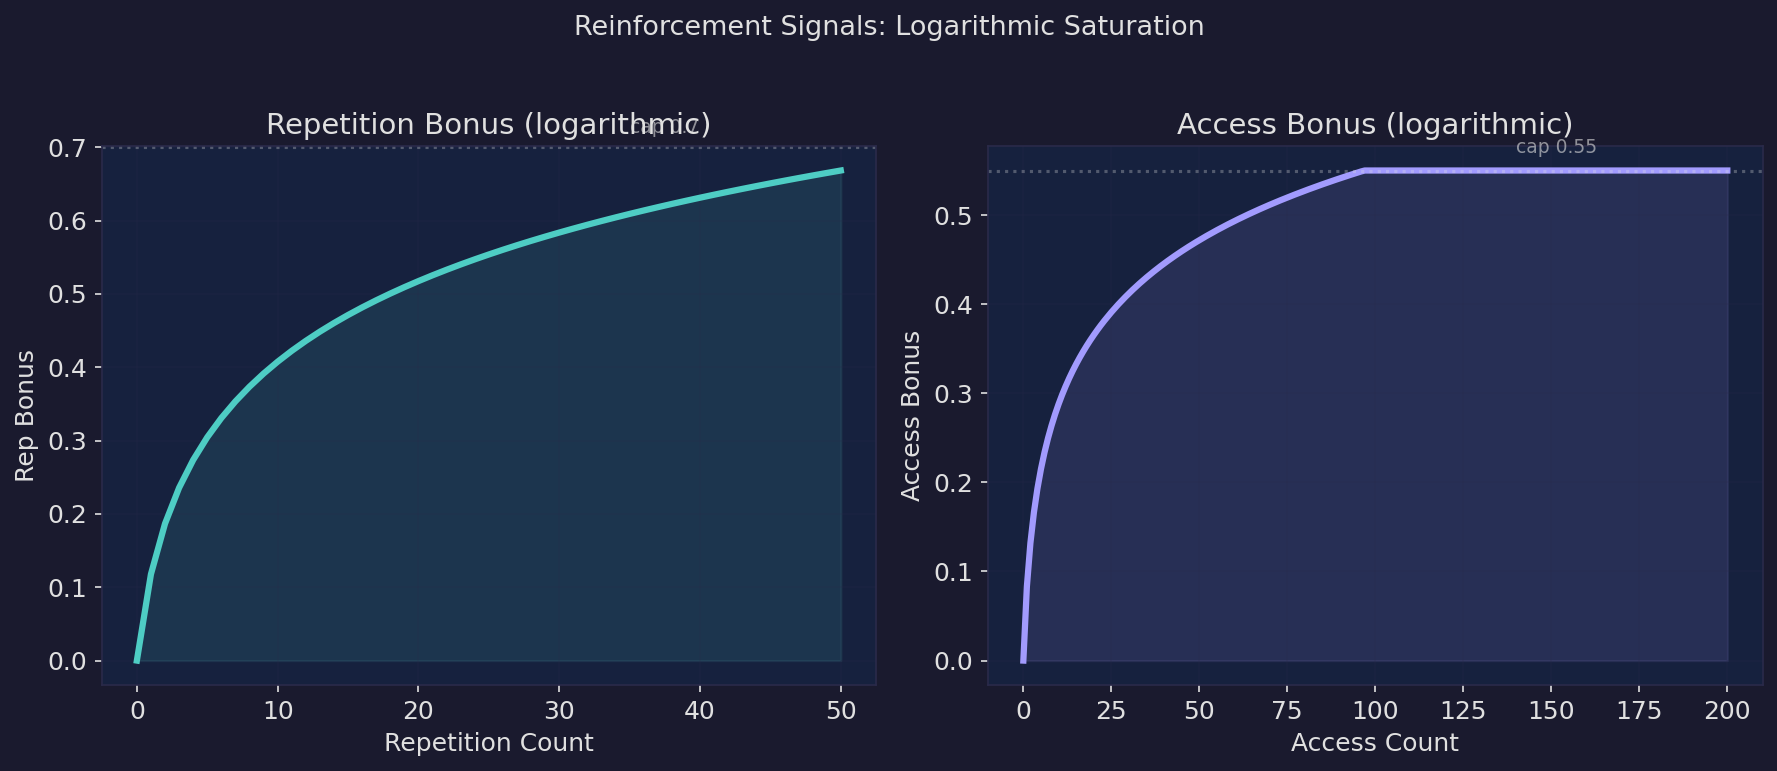 | Sinais de reforço. Bônus de repetição e acesso seguem saturação logarítmica. Interações iniciais importam mais; as posteriores contribuem com retornos decrescentes, distinguindo entre "usado ocasionalmente" e "usado diariamente". |
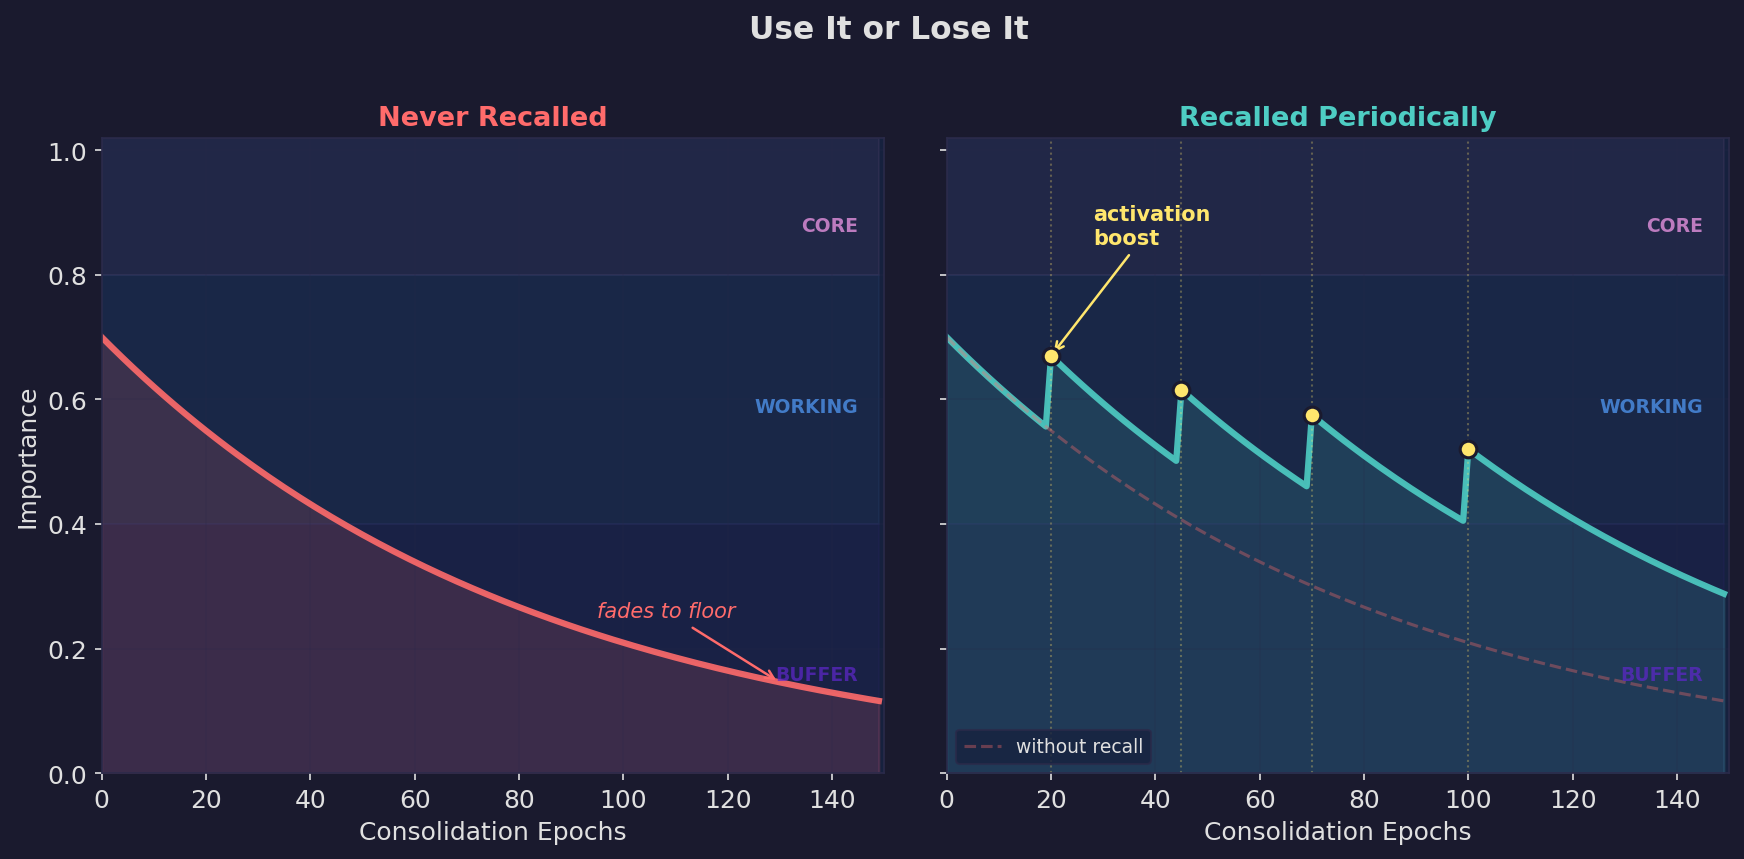 | Use ou perca. À esquerda: uma memória que nunca é recuperada decai para a camada de buffer. À direita: recuperação periódica dispara impulsos de ativação que mantêm a memória na camada de trabalho. Linha tracejada mostra a trajetória sem recuperação para comparação. |
Deduplicação e Mesclagem Semântica
Duas memórias dizendo a mesma coisa com palavras diferentes? Detectadas e mescladas automaticamente:
"use PostgreSQL for auth" + "auth service runs on Postgres"
→ Merged into one, preserving context from both
Árvore de Tópicos Auto-Organizável
Agrupamento vetorial agrupa memórias relacionadas, o LLM nomeia os agrupamentos. Sem necessidade de marcação manual:
Memory Architecture
├── Three-layer lifecycle [4]
├── Embedding pipeline [3]
└── Consolidation logic [5]
Deploy & Ops
├── CI/CD procedures [3]
└── Production incidents [2]
User Preferences [6]
O problema que isso resolve: a busca vetorial exige fazer a pergunta certa. Árvores de tópicos permitem que agentes naveguem por assunto — escaneie o diretório, aprofunde-se no ramo certo.
Gatilhos
Marque uma memória com trigger:deploy, e o agente pode recuperar todas as lições de implantação antes de executar:
curl -X POST http://localhost:3917/memories \
  -d '{"content": "LESSON: always backup DB before migration", "tags": ["trigger:deploy", "lesson"]}'

# Pre-deployment check
curl http://localhost:3917/triggers/deploy
Recuperação de Sessão
O agente acorda, chama GET /resume, recebe o contexto completo de volta. Sem necessidade de escanear arquivos:
=== Core (24) ===
deploy: test → build → stop → start (procedural)
LESSON: never force-push to main
...

=== Recent ===
switched auth to OAuth2
published API docs

=== Topics (Core: 24, Working: 57, Buffer: 7) ===
kb1: "Deploy Procedures" [5]
kb2: "Auth Architecture" [3]
kb3: "Memory Design" [8]
...

Triggers: deploy, git-push, database-migration
| Seção | Conteúdo | Propósito |
|---|---|---|
| Núcleo | Texto completo de regras permanentes e identidade | As coisas inesquecíveis |
| Recentes | Memórias alteradas recentemente | Continuidade de curto prazo |
| Tópicos | Índice de tópicos (sumário) | Aprofundar sob demanda, sem carregamento completo |
| Gatilhos | Marcas pré-ação | Recuperação automática de lições antes de operações arriscadas |
O agente lê o diretório, encontra tópicos relevantes, chama POST /topic para expandir sob demanda.
Busca e Recuperação
Embeddings semânticos + busca por palavras-chave BM25 com tokenização CJK (jieba). Pontuação ponderada por IDF — termos raros são impulsionados, termos comuns são automaticamente rebaixados. Sem listas de stopwords para manter.
# Semantic search
curl -X POST http://localhost:3917/recall \
  -d '{"query": "how do we handle auth", "budget_tokens": 2000}'
# Note: min_score defaults to 0.30. Use "min_score": 0.0 to get all results.

# Topic drill-down
curl -X POST http://localhost:3917/topic \
  -d '{"ids": ["kb3"]}'
Manutenção em Segundo Plano
Totalmente automática, orientada por atividade — sem gravações significa que o ciclo é pulado:
Consolidação (a cada 30 minutos)
- Decadência — reduz a importância de memórias não acessadas
- Deduplicação — mescla memórias quase idênticas (cosseno > 0,78)
- Triagem — LLM categoriza novas memórias do Buffer
- Portão — LLM avalia em lote candidatos à promoção
- Reconciliação — resolve pares semelhantes ambíguos (resultados em cache)
- Reconstrução da árvore de tópicos — re-agrupa e nomeia
Destilação de Tópicos — quando um tópico cresce demais (10+ memórias), conteúdo sobreposto é condensado em menos entradas, mais ricas.
Isolamento por Namespace
Instância única, múltiplos projetos. Use X-Namespace para isolar:
curl -X POST http://localhost:3917/memories \
  -H "X-Namespace: my-project" \
  -d '{"content": "API uses OAuth2 bearer tokens"}'
Instalação
# macOS / Linux
curl -fsSL https://raw.githubusercontent.com/kael-bit/engram-rs/main/install.sh | bash

# Windows (PowerShell)
irm https://raw.githubusercontent.com/kael-bit/engram-rs/main/install.ps1 | iex
Docker
docker run -d --name engram-rs \
  -p 3917:3917 \
  -v engram-data:/data \
  -e ENGRAM_LLM_URL=https://api.openai.com/v1 \
  -e ENGRAM_LLM_KEY=sk-... \
  ghcr.io/kael-bit/engram-rs:latest
Configuração do LLM
O engram-rs funciona sem um LLM — busca por palavras-chave e ciclo de vida baseado em regras ainda funcionam. Adicionar um LLM desbloqueia recursos inteligentes (triagem, portão, mesclagem, nomeação de tópicos):
export ENGRAM_LLM_URL=https://api.openai.com/v1
export ENGRAM_LLM_KEY=sk-...

# Any OpenAI-compatible API (Ollama, LM Studio, etc.)
export ENGRAM_LLM_URL=http://localhost:11434/v1

# Anthropic native
export ENGRAM_LLM_PROVIDER=anthropic
export ENGRAM_LLM_KEY=sk-ant-...
Configuração de modelo em dois níveis — modelo forte para julgamento, leve para processamento de texto:
ENGRAM_GATE_MODEL=gpt-4o          # quality decisions
ENGRAM_LLM_MODEL=gpt-4o-mini     # text processing
Para Agentes de IA
Adicione ao prompt de sistema do seu agente:
Set up engram-rs (persistent memory) by following the guide at:
https://raw.githubusercontent.com/kael-bit/engram-rs/main/docs/SETUP.md
Integração
Funciona com Claude Code, Cursor, Windsurf, OpenClaw e qualquer ferramenta compatível com MCP.
17 ferramentas MCP (documentação MCP) | API HTTP completa (Guia de configuração)
# MCP (Claude Code)
npx engram-rs-mcp

# MCP (Cursor / Windsurf / generic)
{"mcpServers": {"engram": {"command": "npx", "args": ["-y", "engram-rs-mcp"]}}}
Painel Web
Interface web integrada em http://localhost:3917/ui para navegar pelas memórias, visualizar a árvore de tópicos e monitorar o uso do LLM.
Especificações
| Binário | ~10 MB |
| Memória | ~100 MB de RSS em produção |
| Armazenamento | SQLite, sem banco de dados externo |
| Linguagem | Rust |
| Plataformas | Linux, macOS, Windows (x86_64 + aarch64) |
| Licença | MIT |
Licença
MIT