TokenKnows
Capture sessões de codificação com IA (Claude Code / Codex / Cursor) e destile-as em relatórios semanais, ADRs e um grafo de conhecimento — auto-hospedado.
Documentação
TokenKnows
Transforme sessões de codificação com IA em conhecimento vivo — relatórios semanais, ADRs, revisões de incidentes, livros, habilidades de agente e um grafo de conhecimento.




English | 简体中文
O que é o TokenKnows?
Você passa horas programando em par com Claude Code, Codex e Cursor. As decisões, caçadas a bugs e trade-offs de design dessas sessões evaporam no momento em que o terminal fecha. O TokenKnows captura tudo isso automaticamente e destila em ativos de conhecimento estruturados e vinculados a evidências:
captura (6 coletores) → destilação (pipeline de LLM em 5 estágios) → ativos (7 tipos de documentos) → revisão / redação / publicação
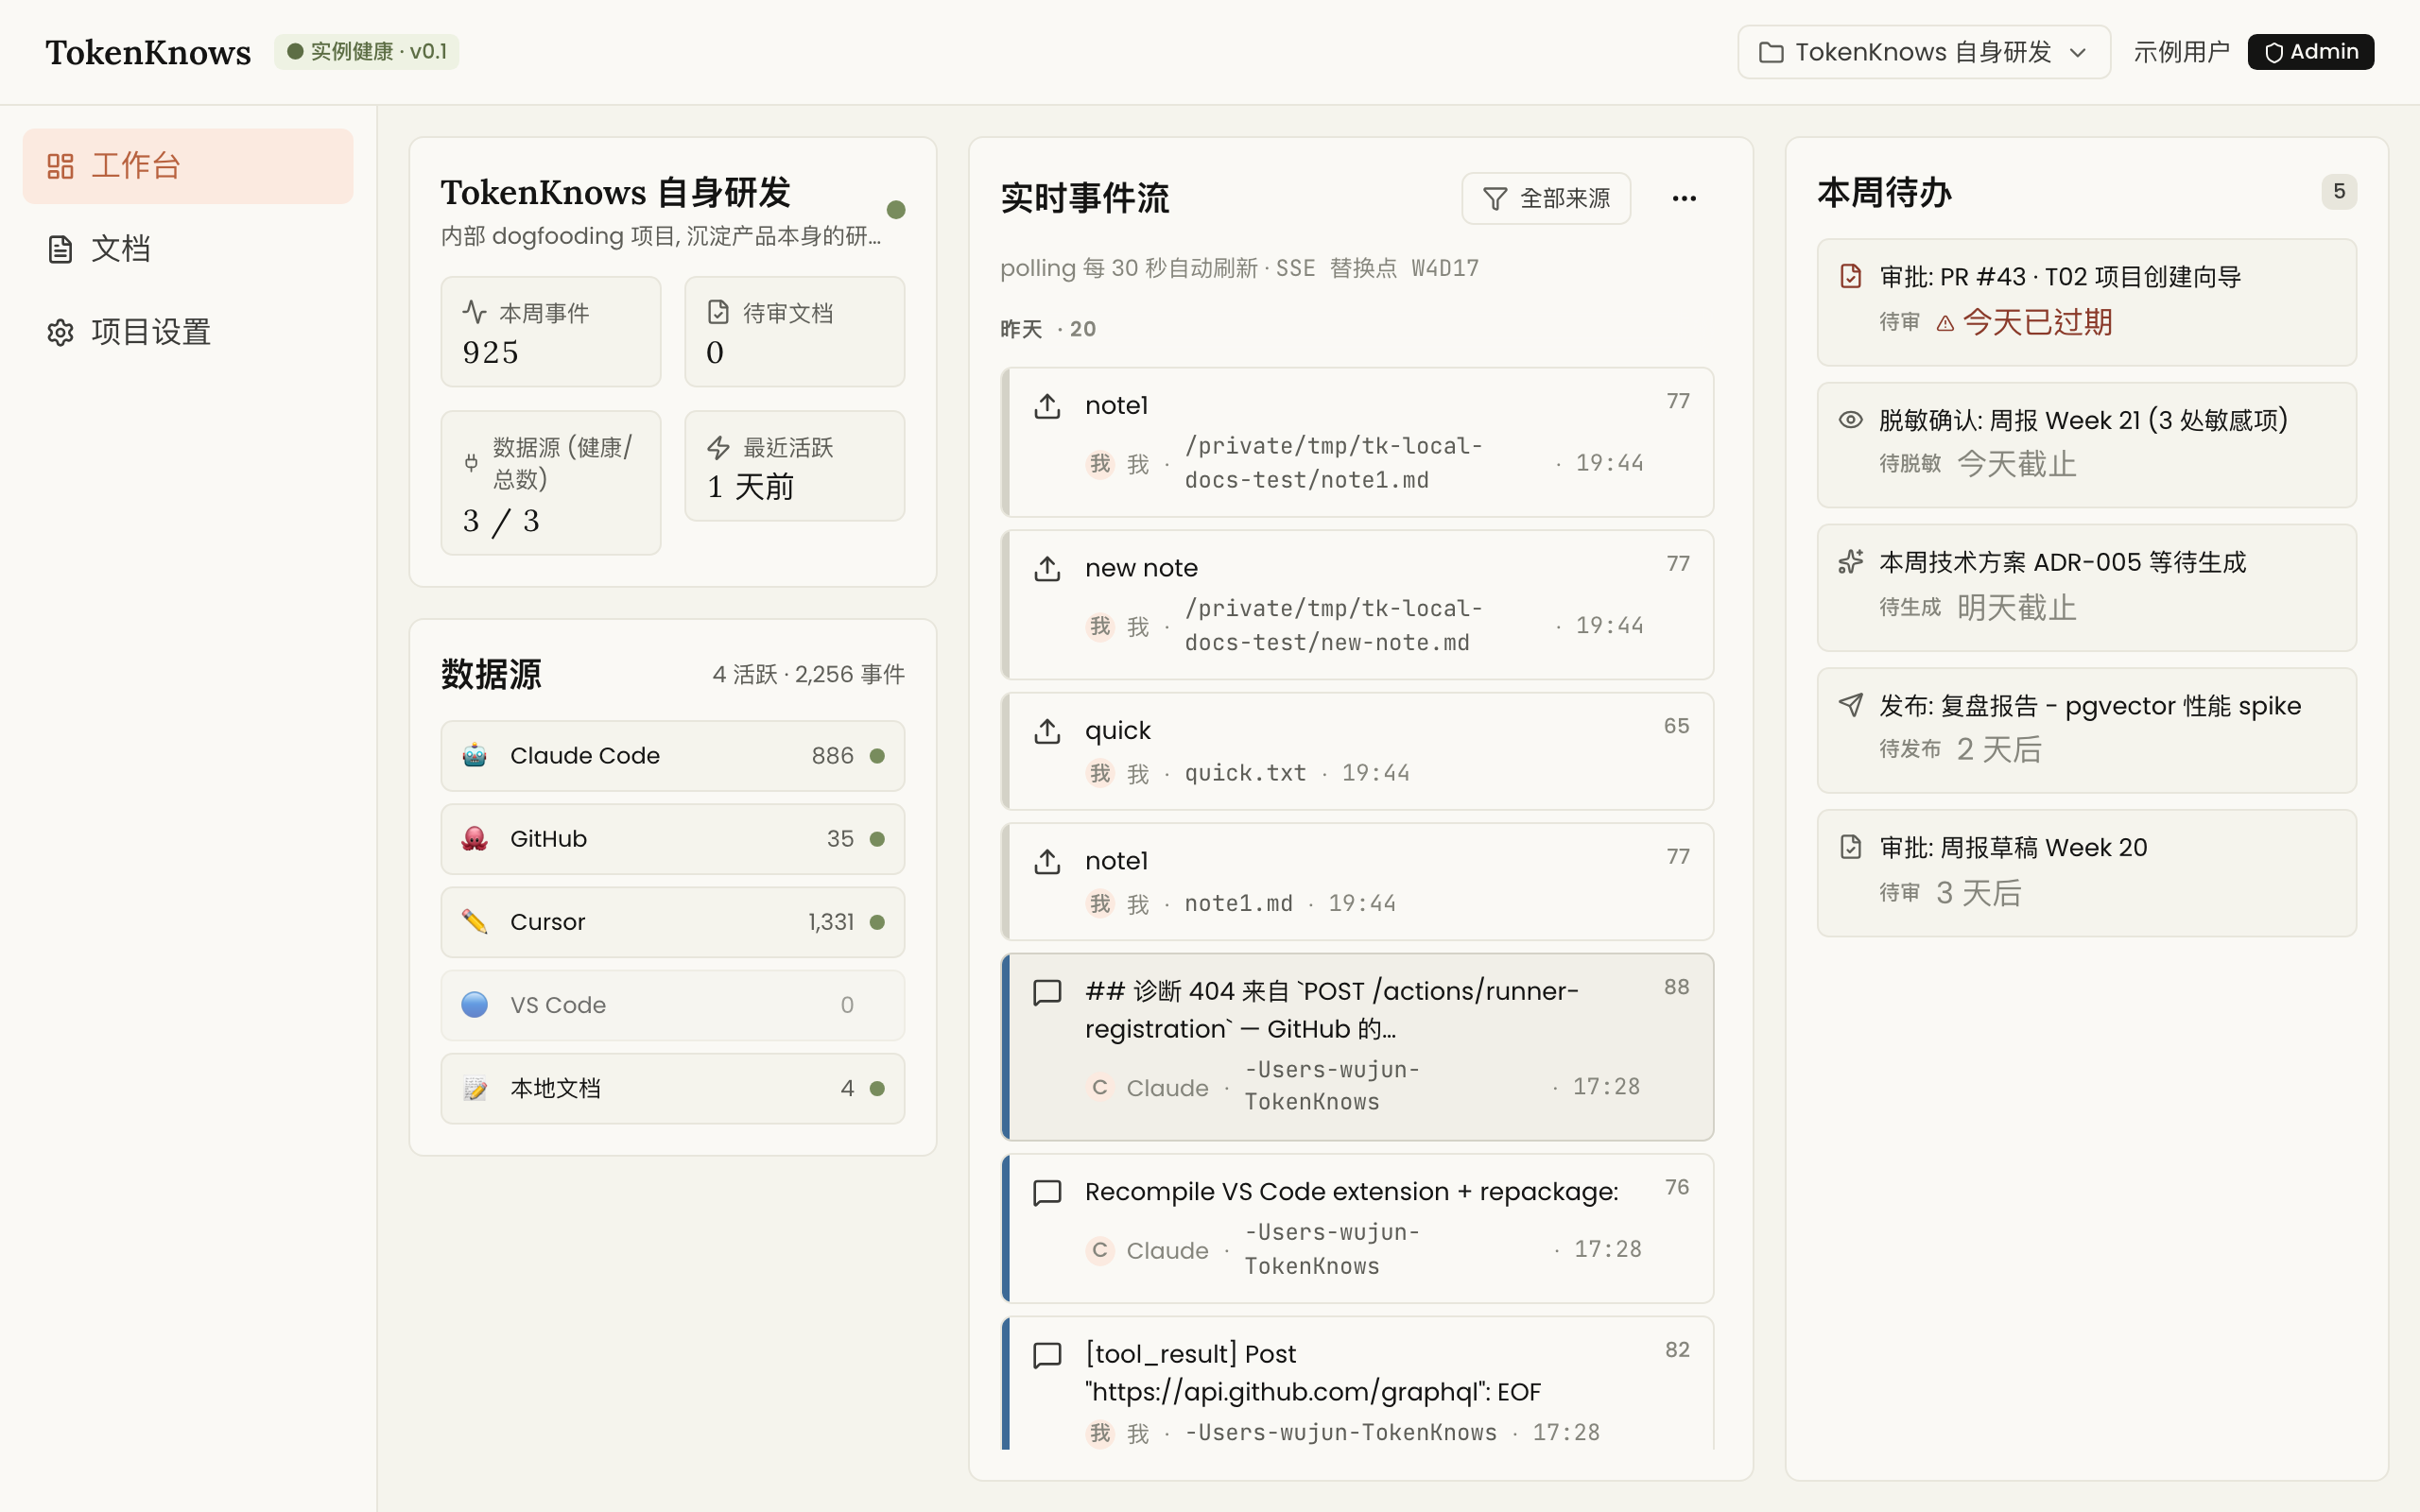
- 📡 Captura tudo — Claude Code, Codex, Cursor, VS Code, PRs/commits/issues do GitHub e documentos locais, tudo via observadores de arquivos locais e polling de API. Sem webhooks, sem túneis.
- 📝 Sete tipos de ativos — relatórios semanais, designs técnicos, ADRs, revisões de incidentes, livros longos, habilidades de agente reutilizáveis (SKILL.md) e um grafo de conhecimento de entidades.
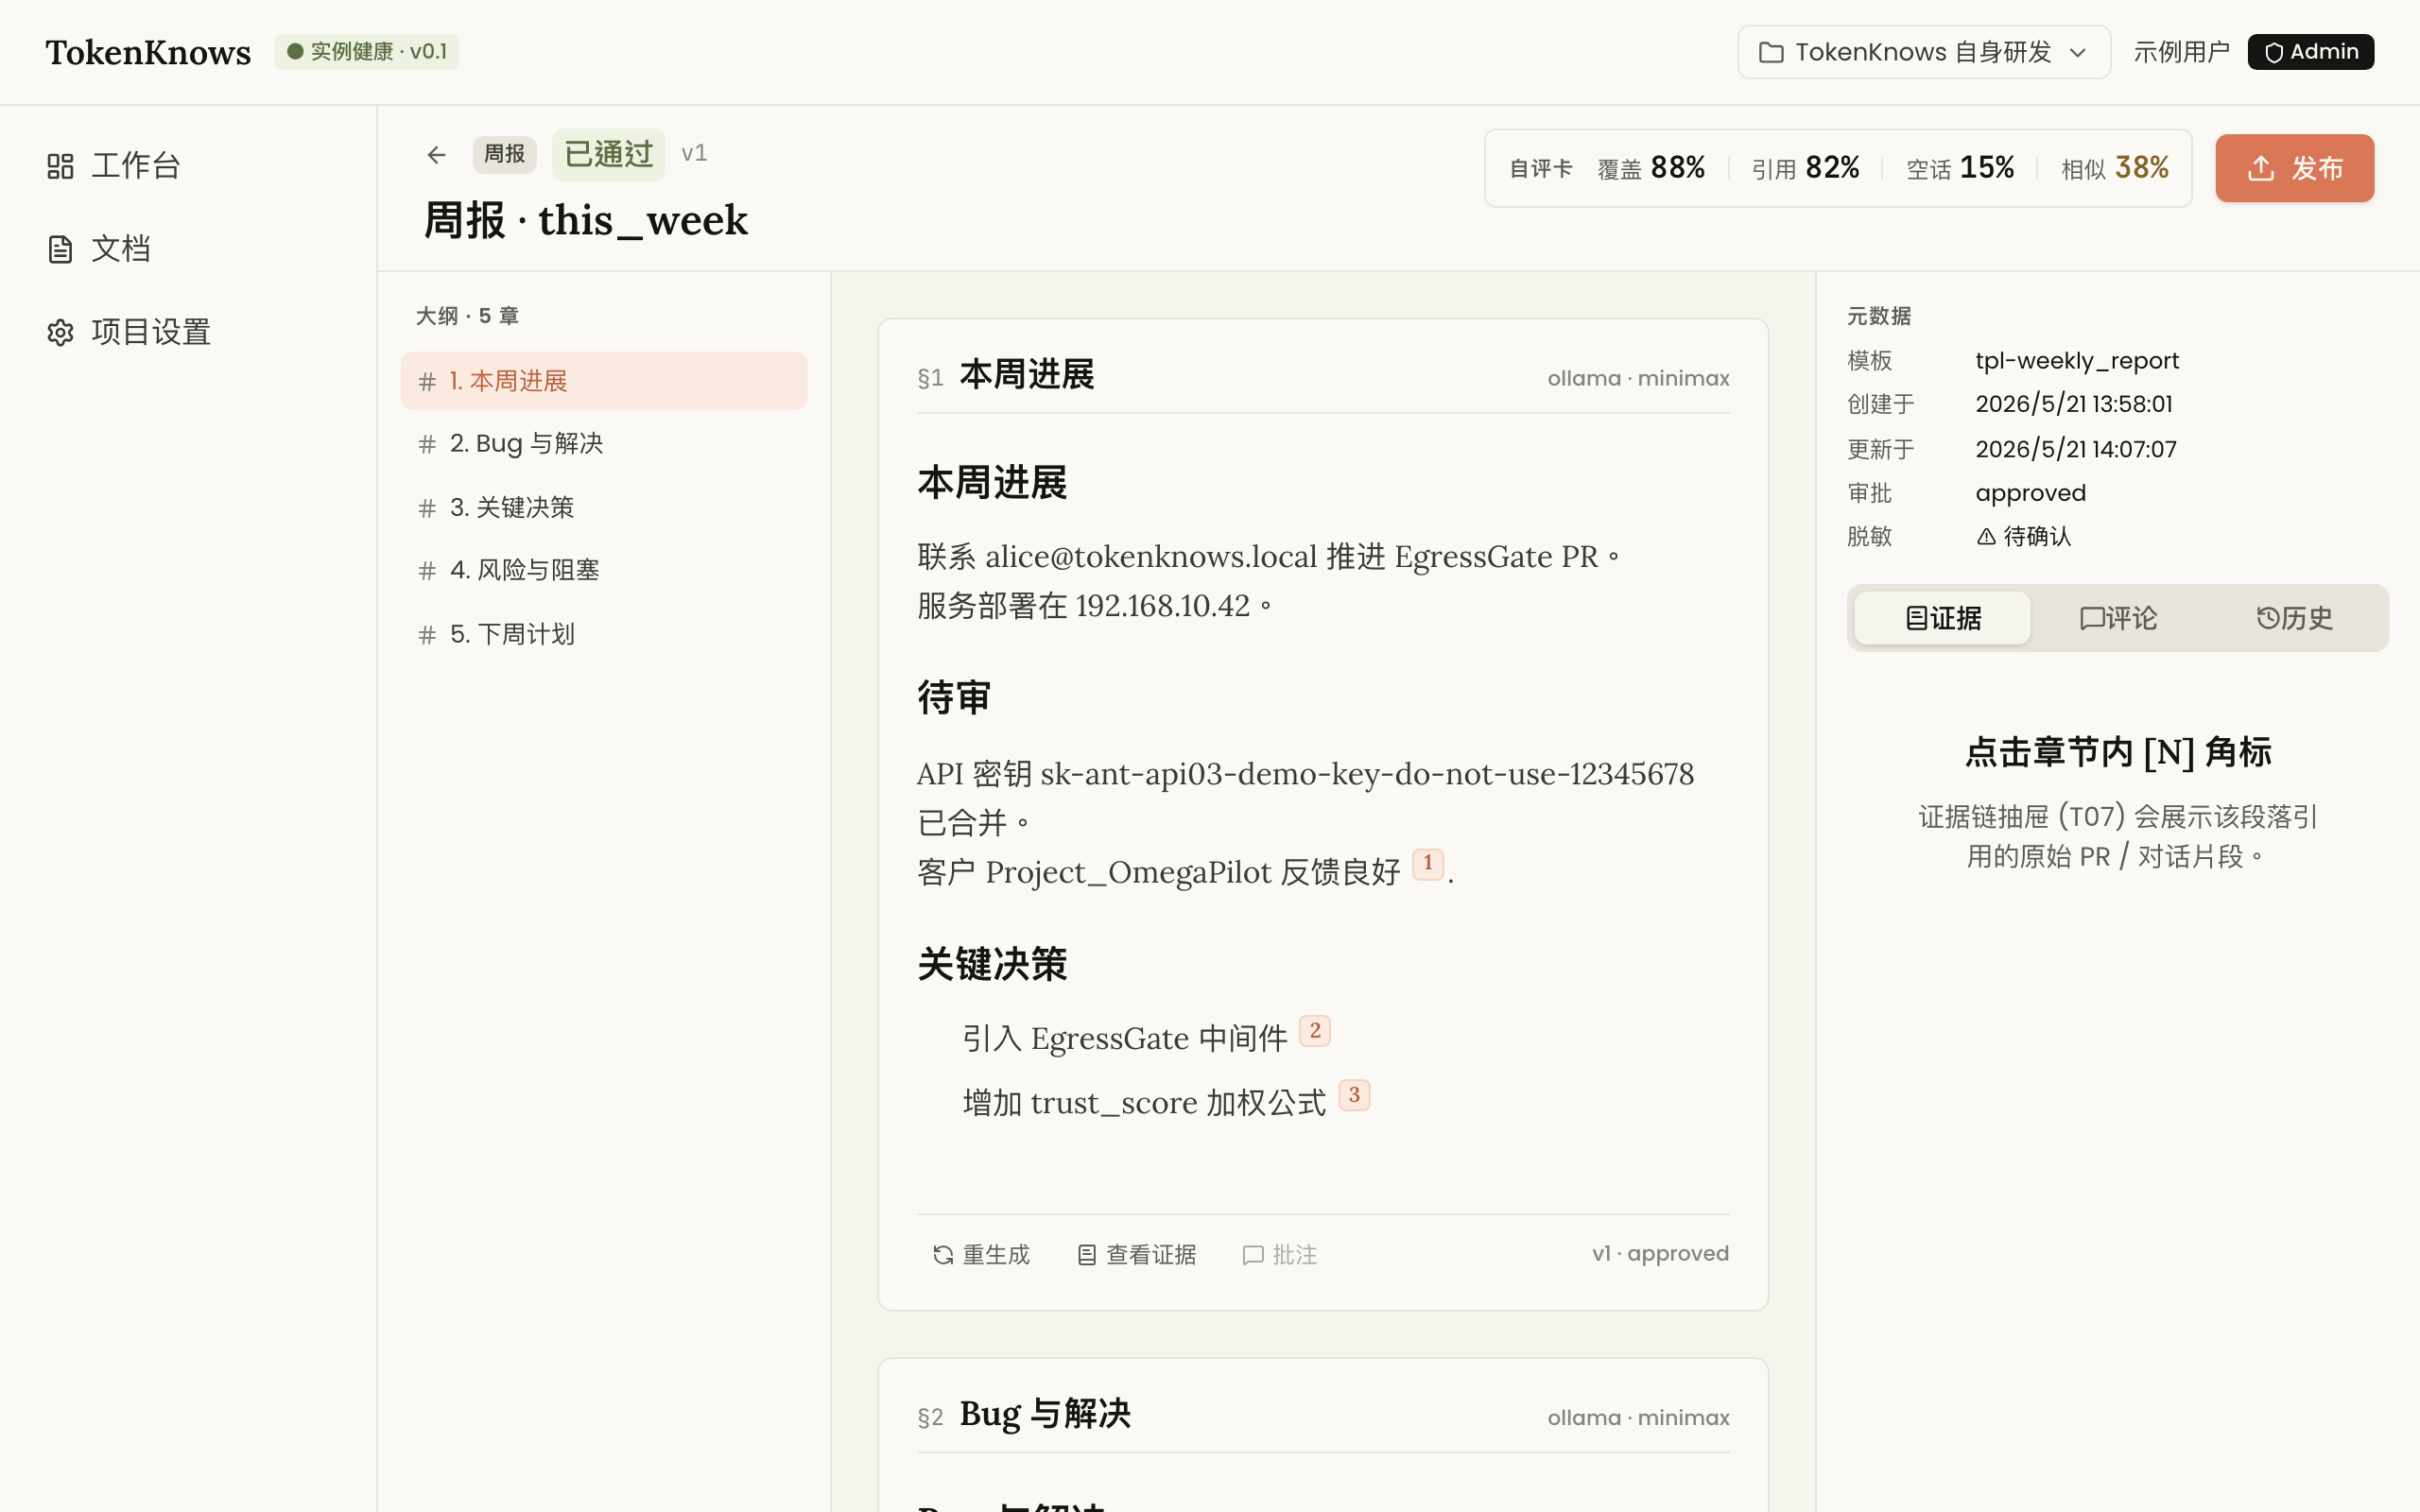
- 🔗 Vinculado a evidências — cada parágrafo rastreia até o PR / conversa / commit original, classificado por
cosine × trust × recencyem ≥2 fontes. - 🔒 Local-first, zero egress por padrão — um gate de egress de LLM em três camadas (instância ∧ projeto ∧ tarefa) com registro de auditoria completo. Combine com Ollama e execute todo o pipeline com zero chaves na nuvem.
Demonstração
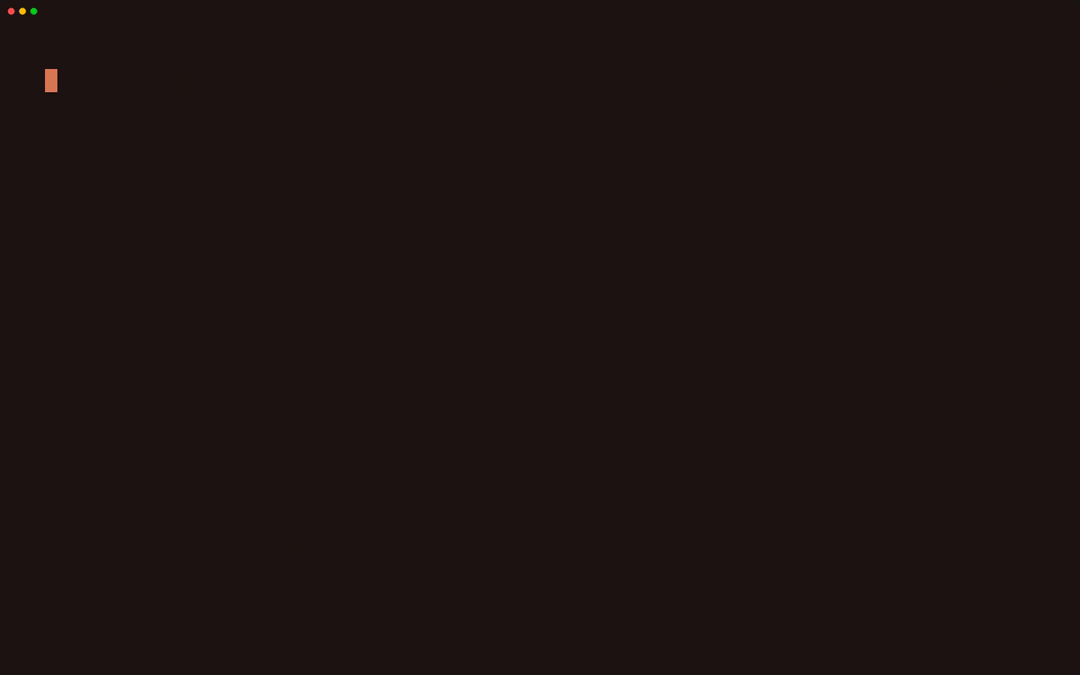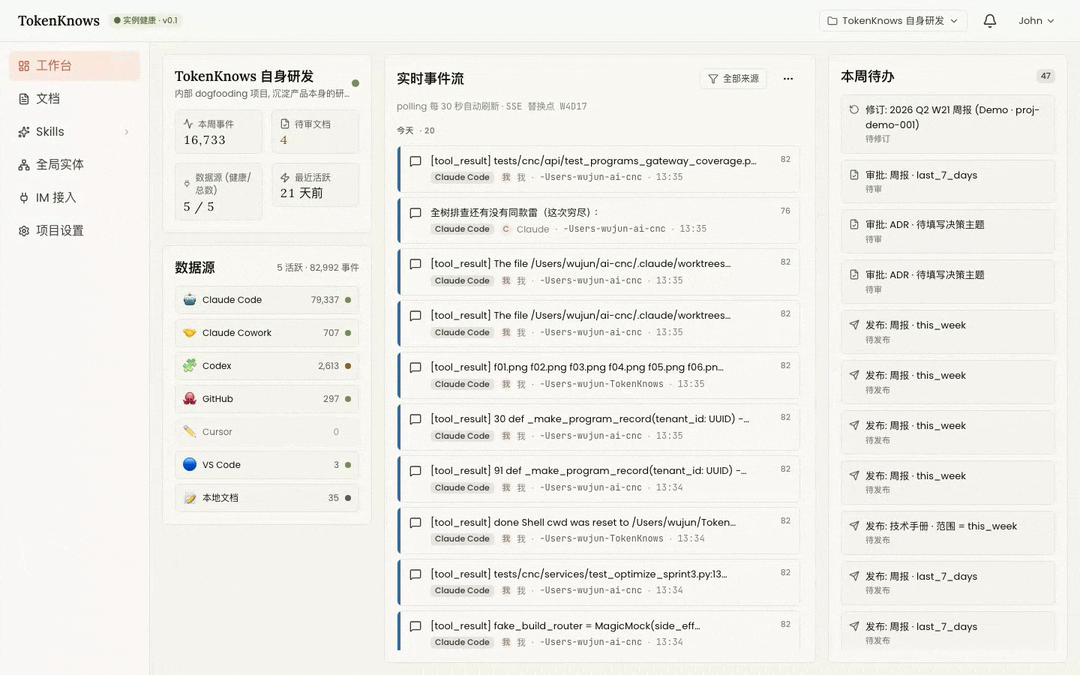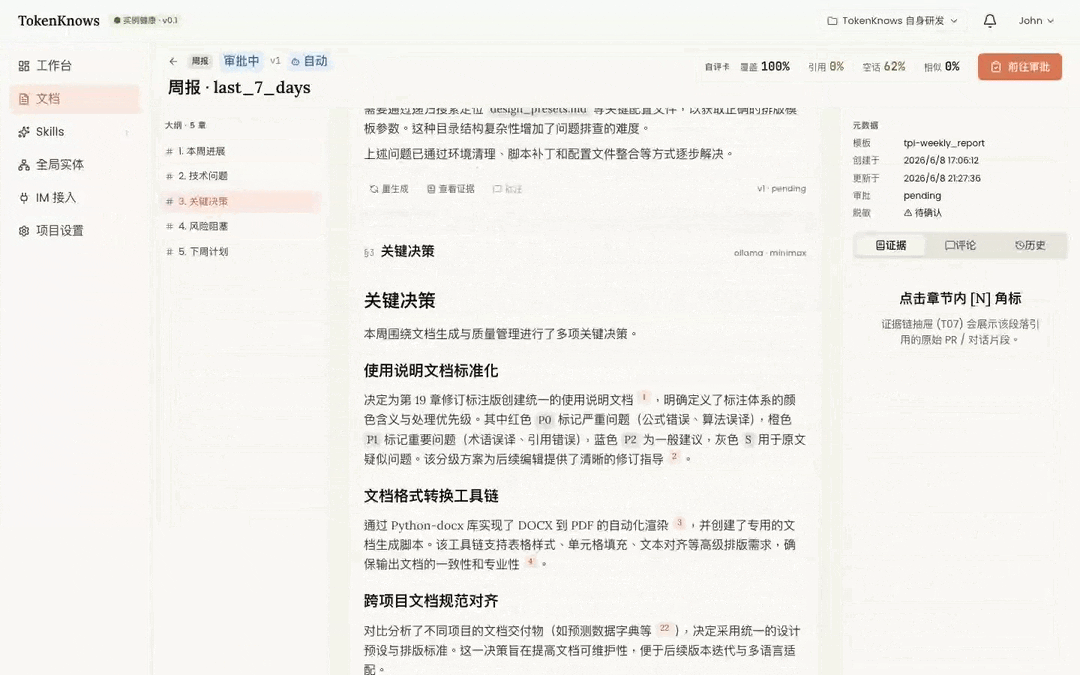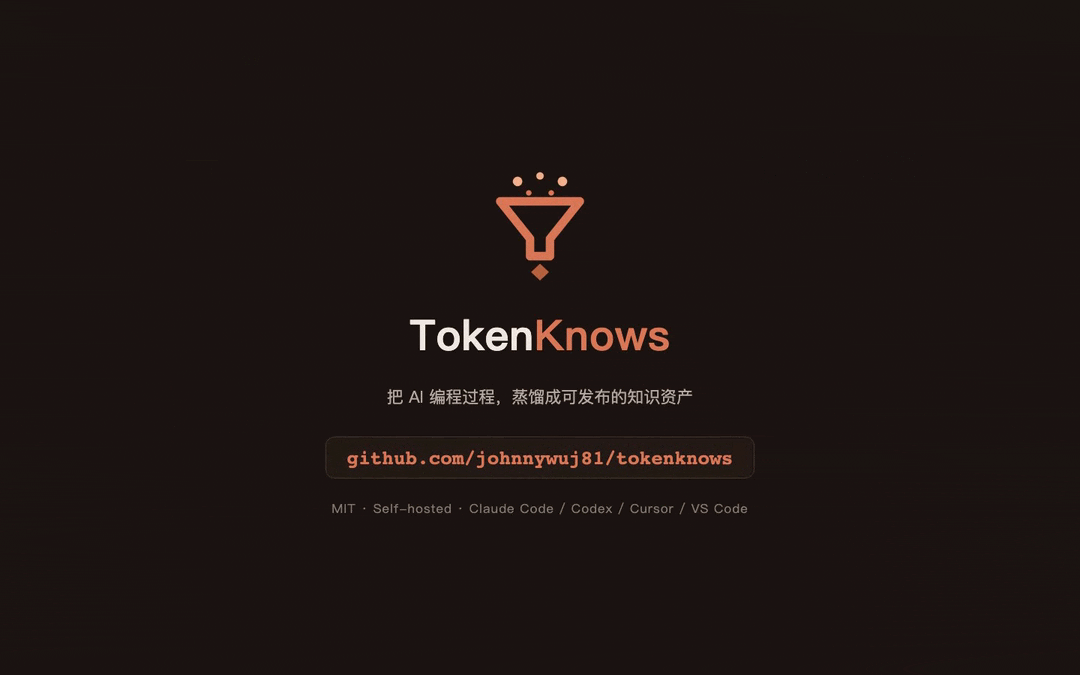
| Workbench | Página de documento |
|---|---|
 |  |
| Gaveta de evidências | Recibo de publicação + diff de versão |
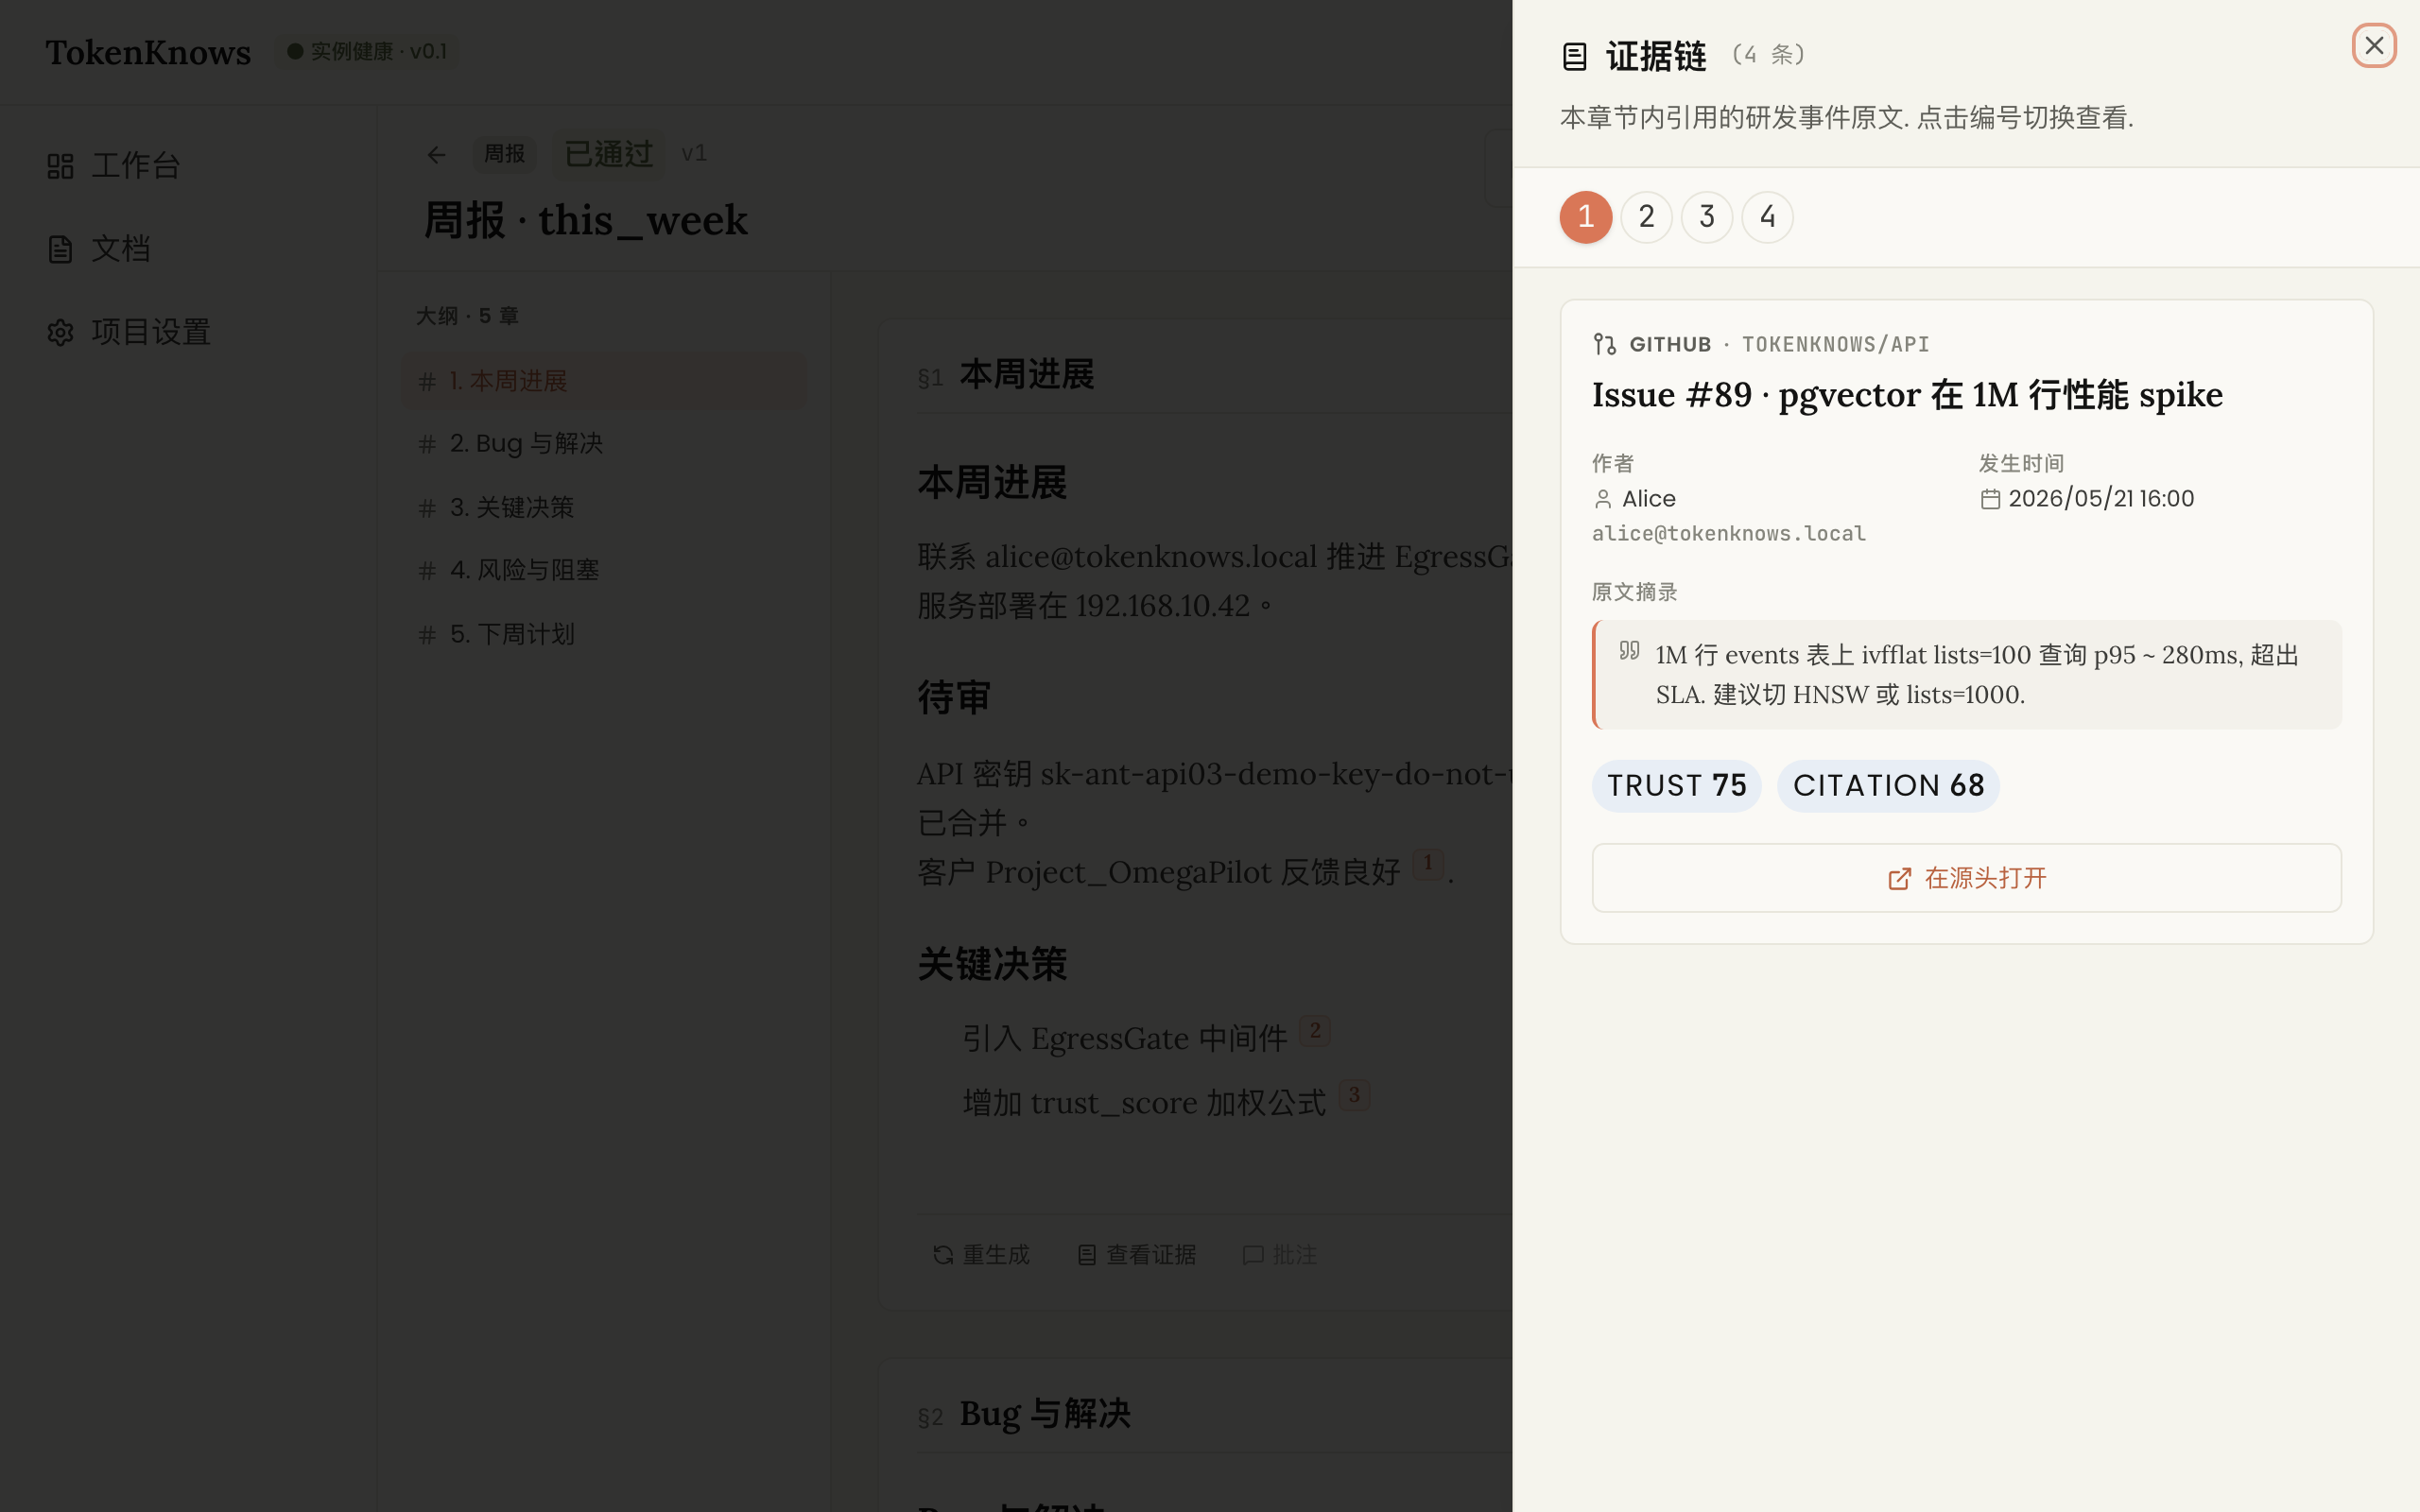 | 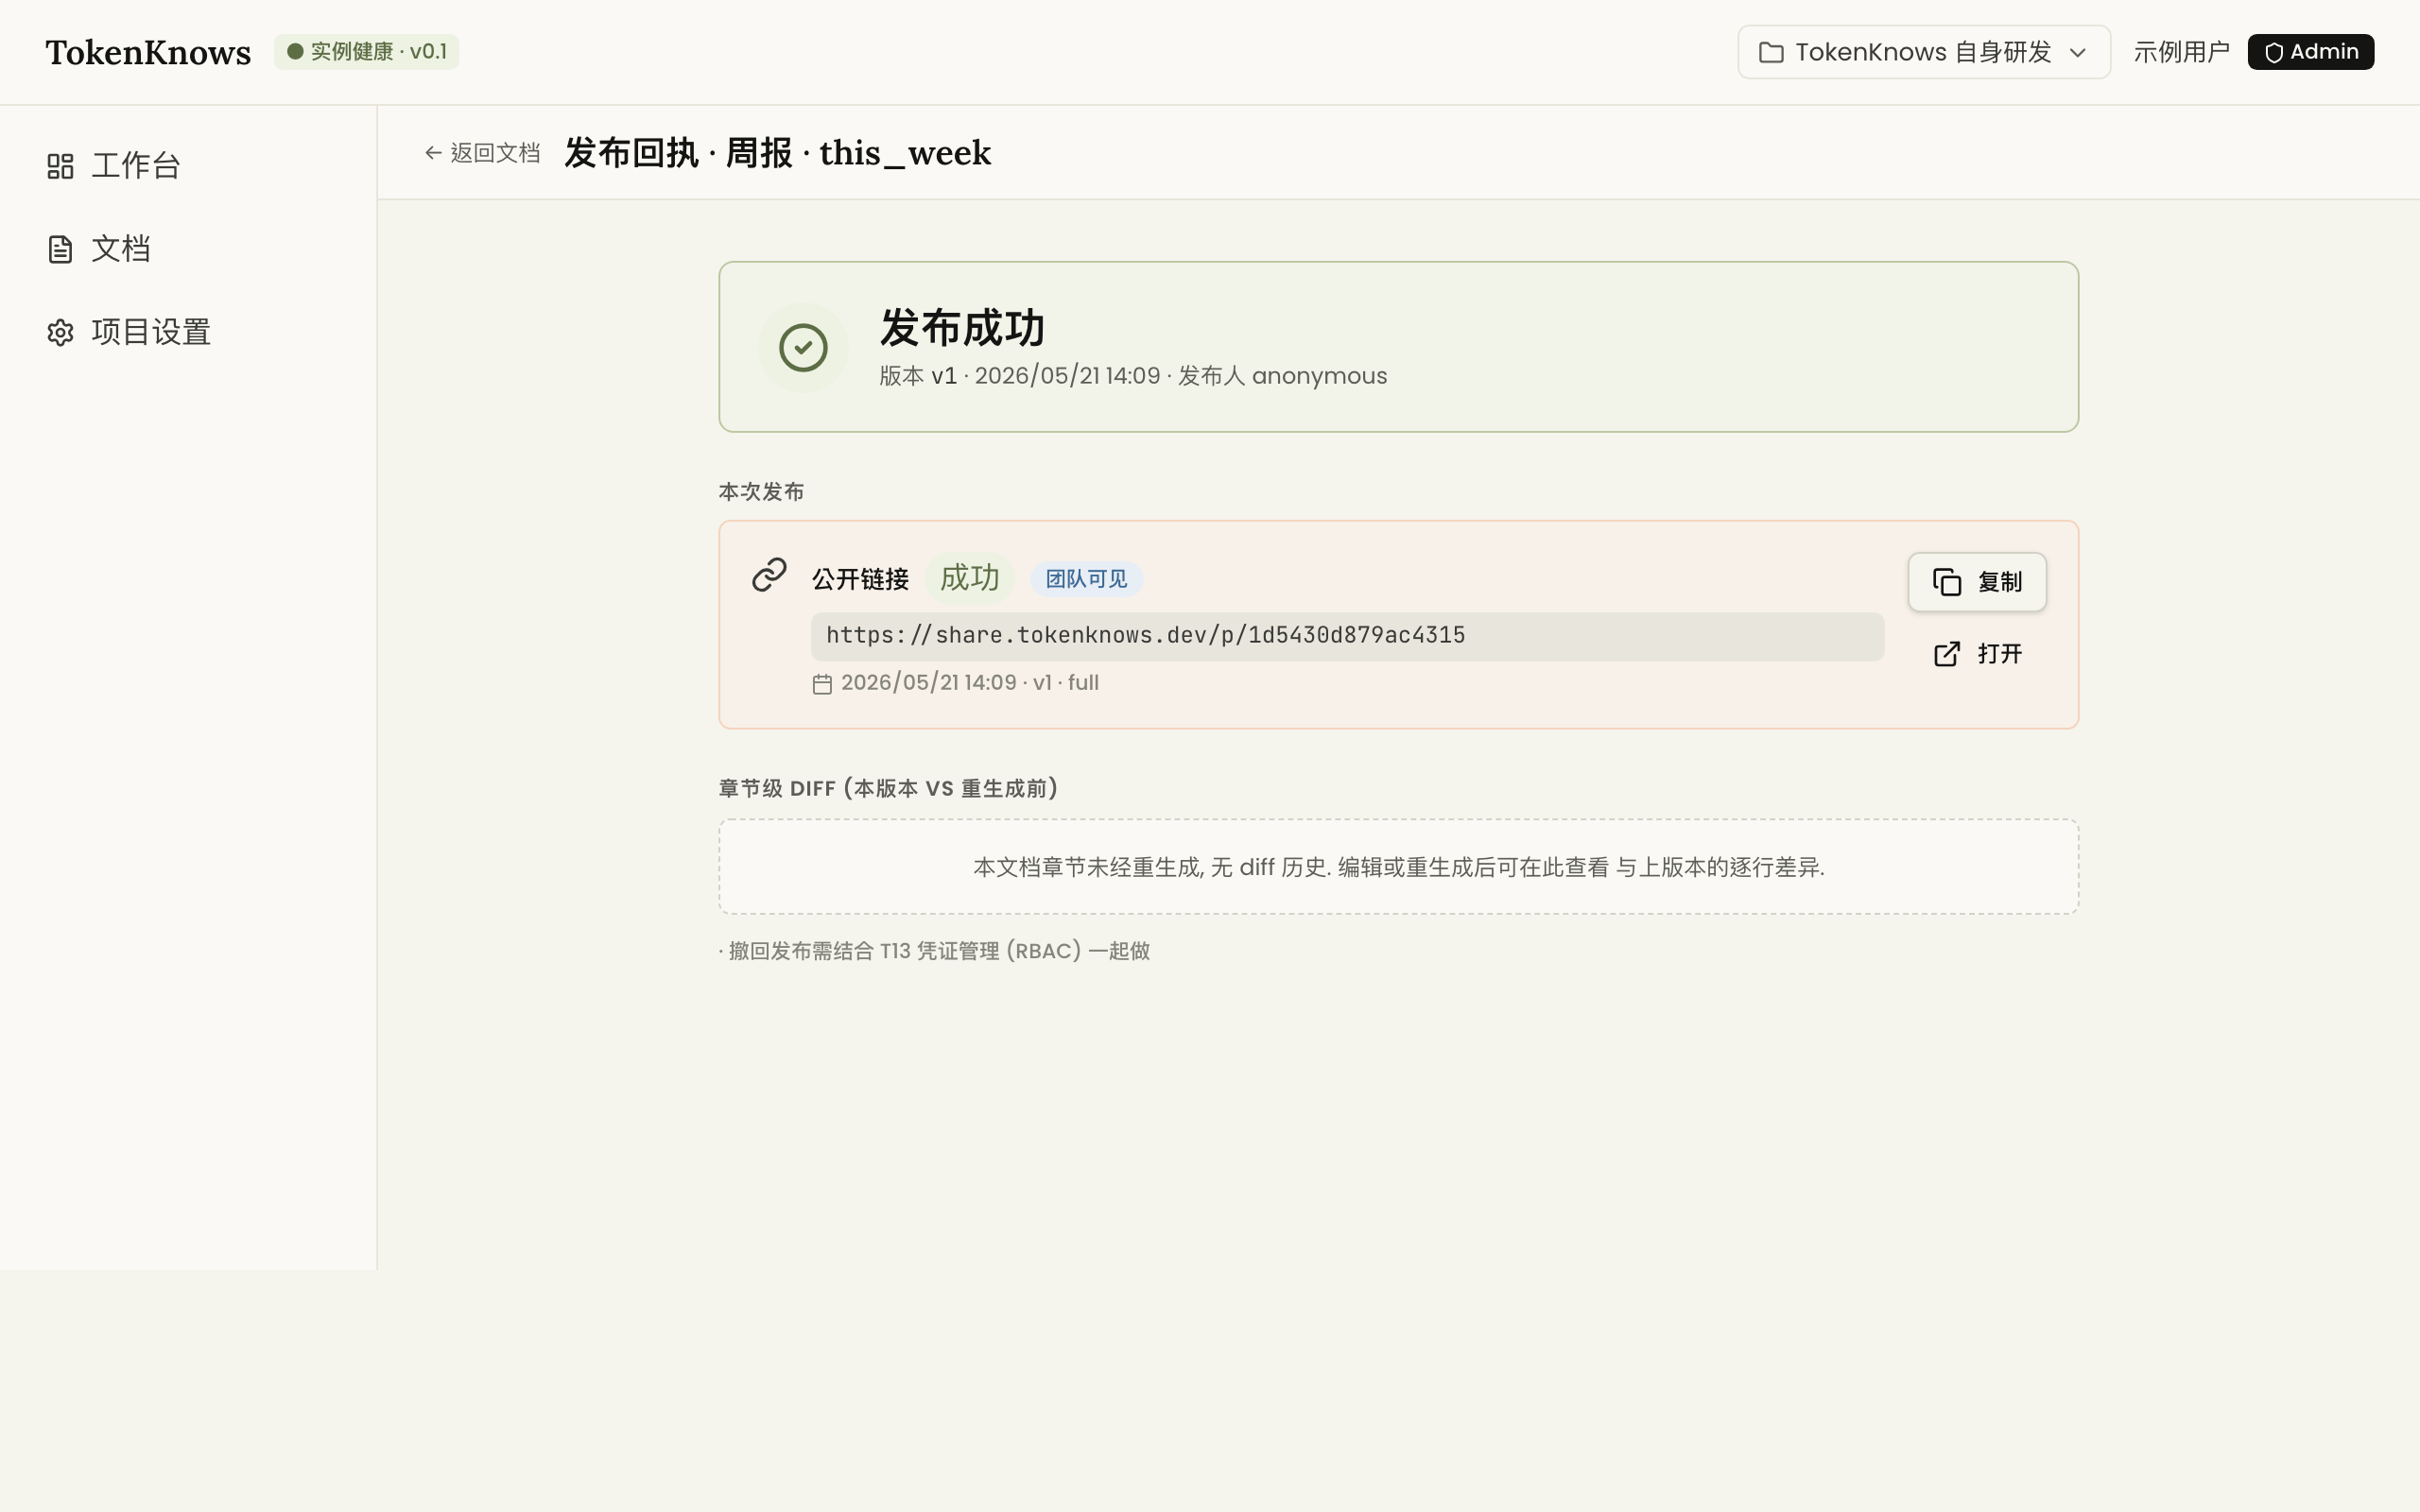 |
▶ Walkthrough completo: engineering_handoff/walkthrough.mp4 (5 min, narração em chinês + legendas)
Todas as 12 telas
| 1 Workbench | 2 Gaveta de eventos | 3 Lista de documentos | 4 Página de documento |
|---|---|---|---|
| 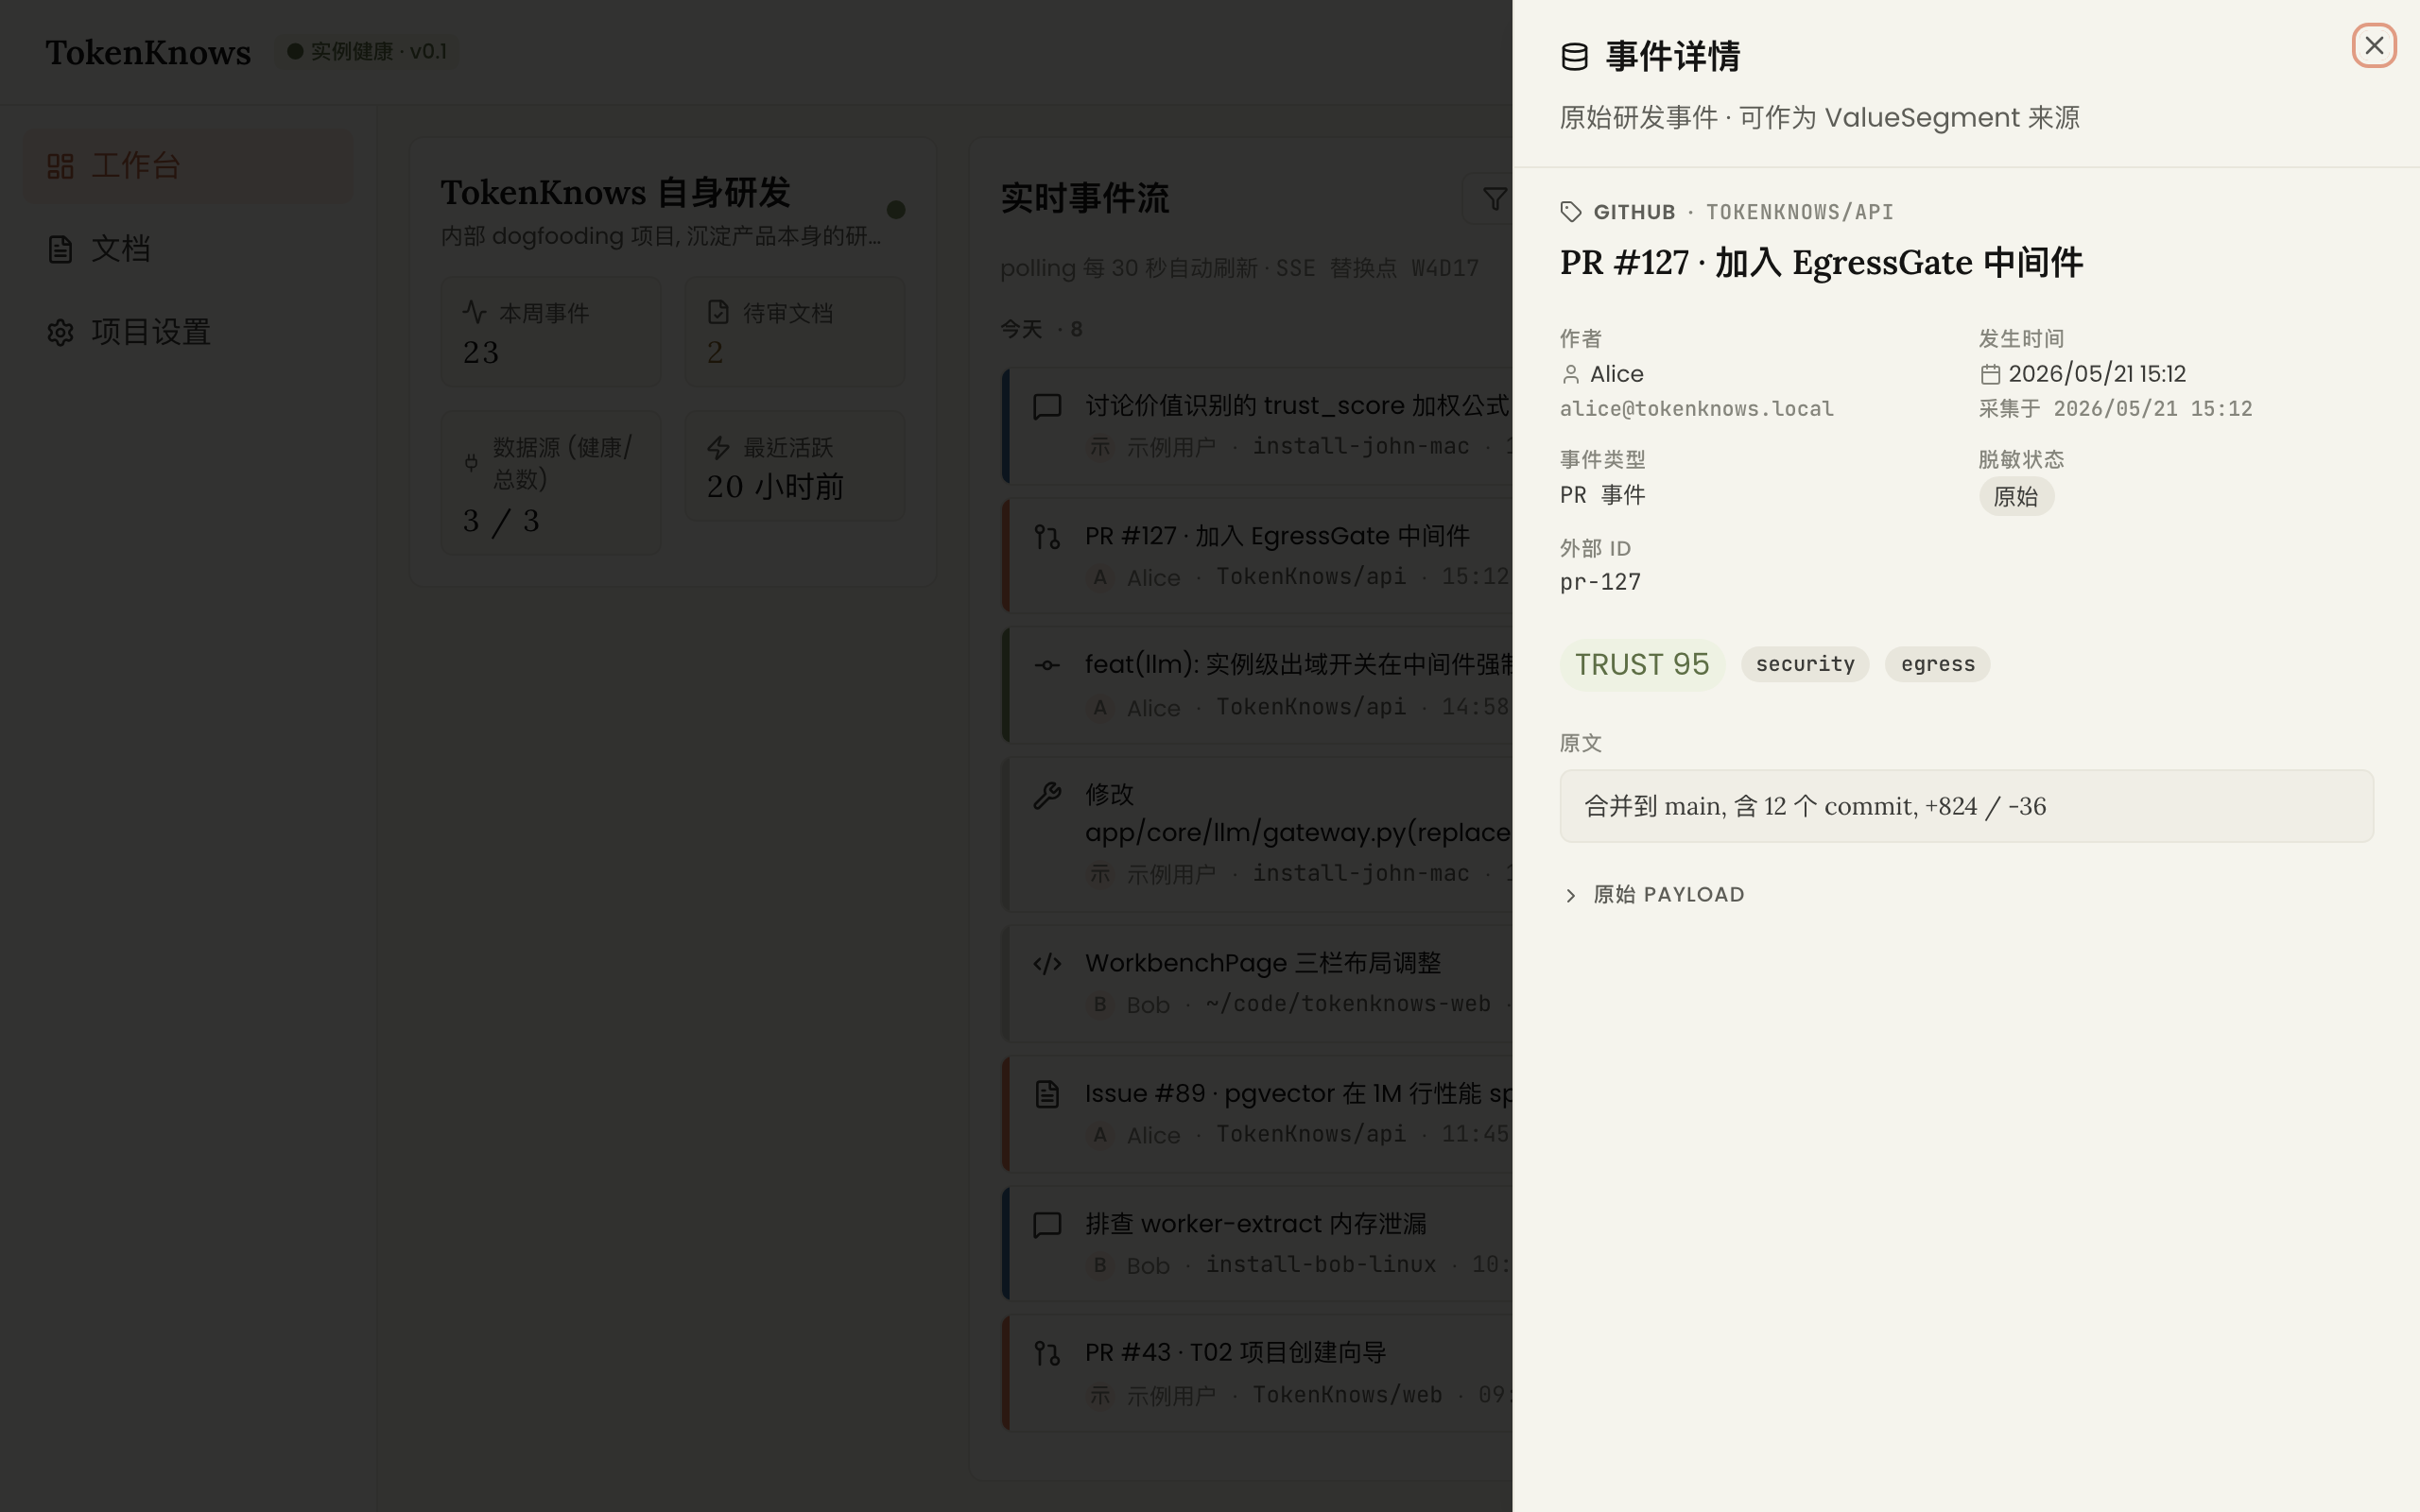 | 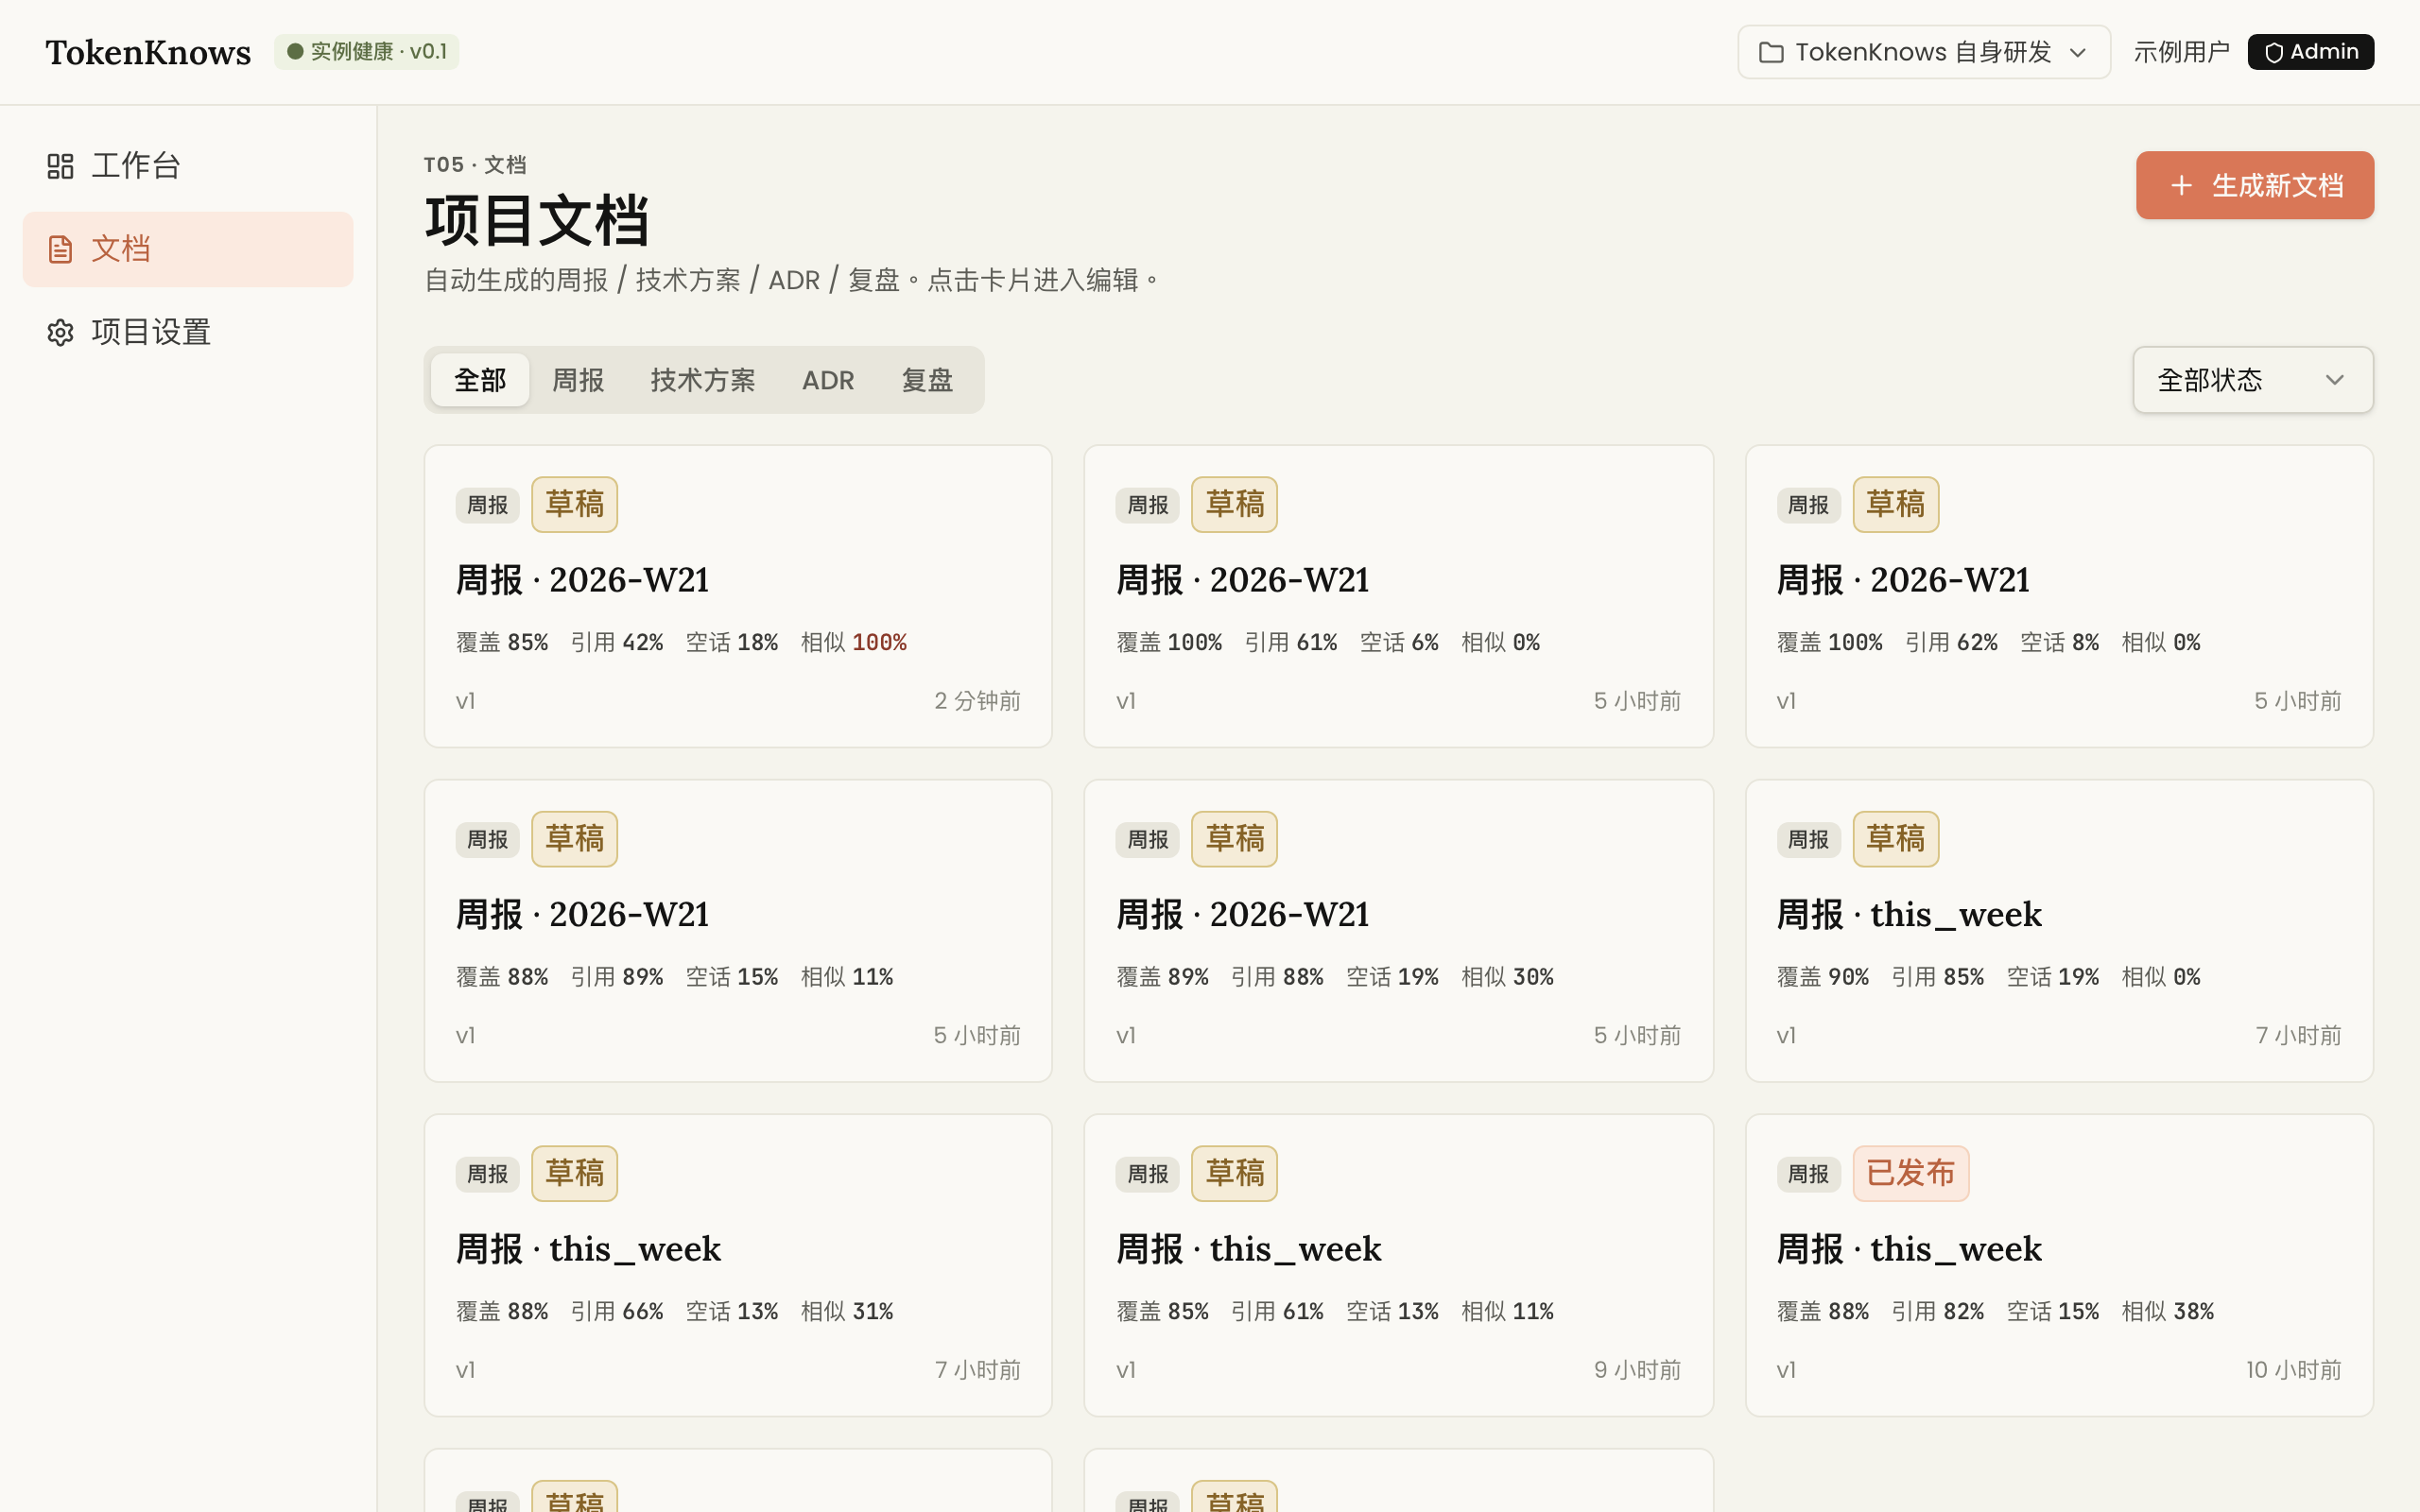 | |
| 5 Gaveta de evidências | 6 Diálogo de regeneração | 7 Revisão | 8 Redação |
| 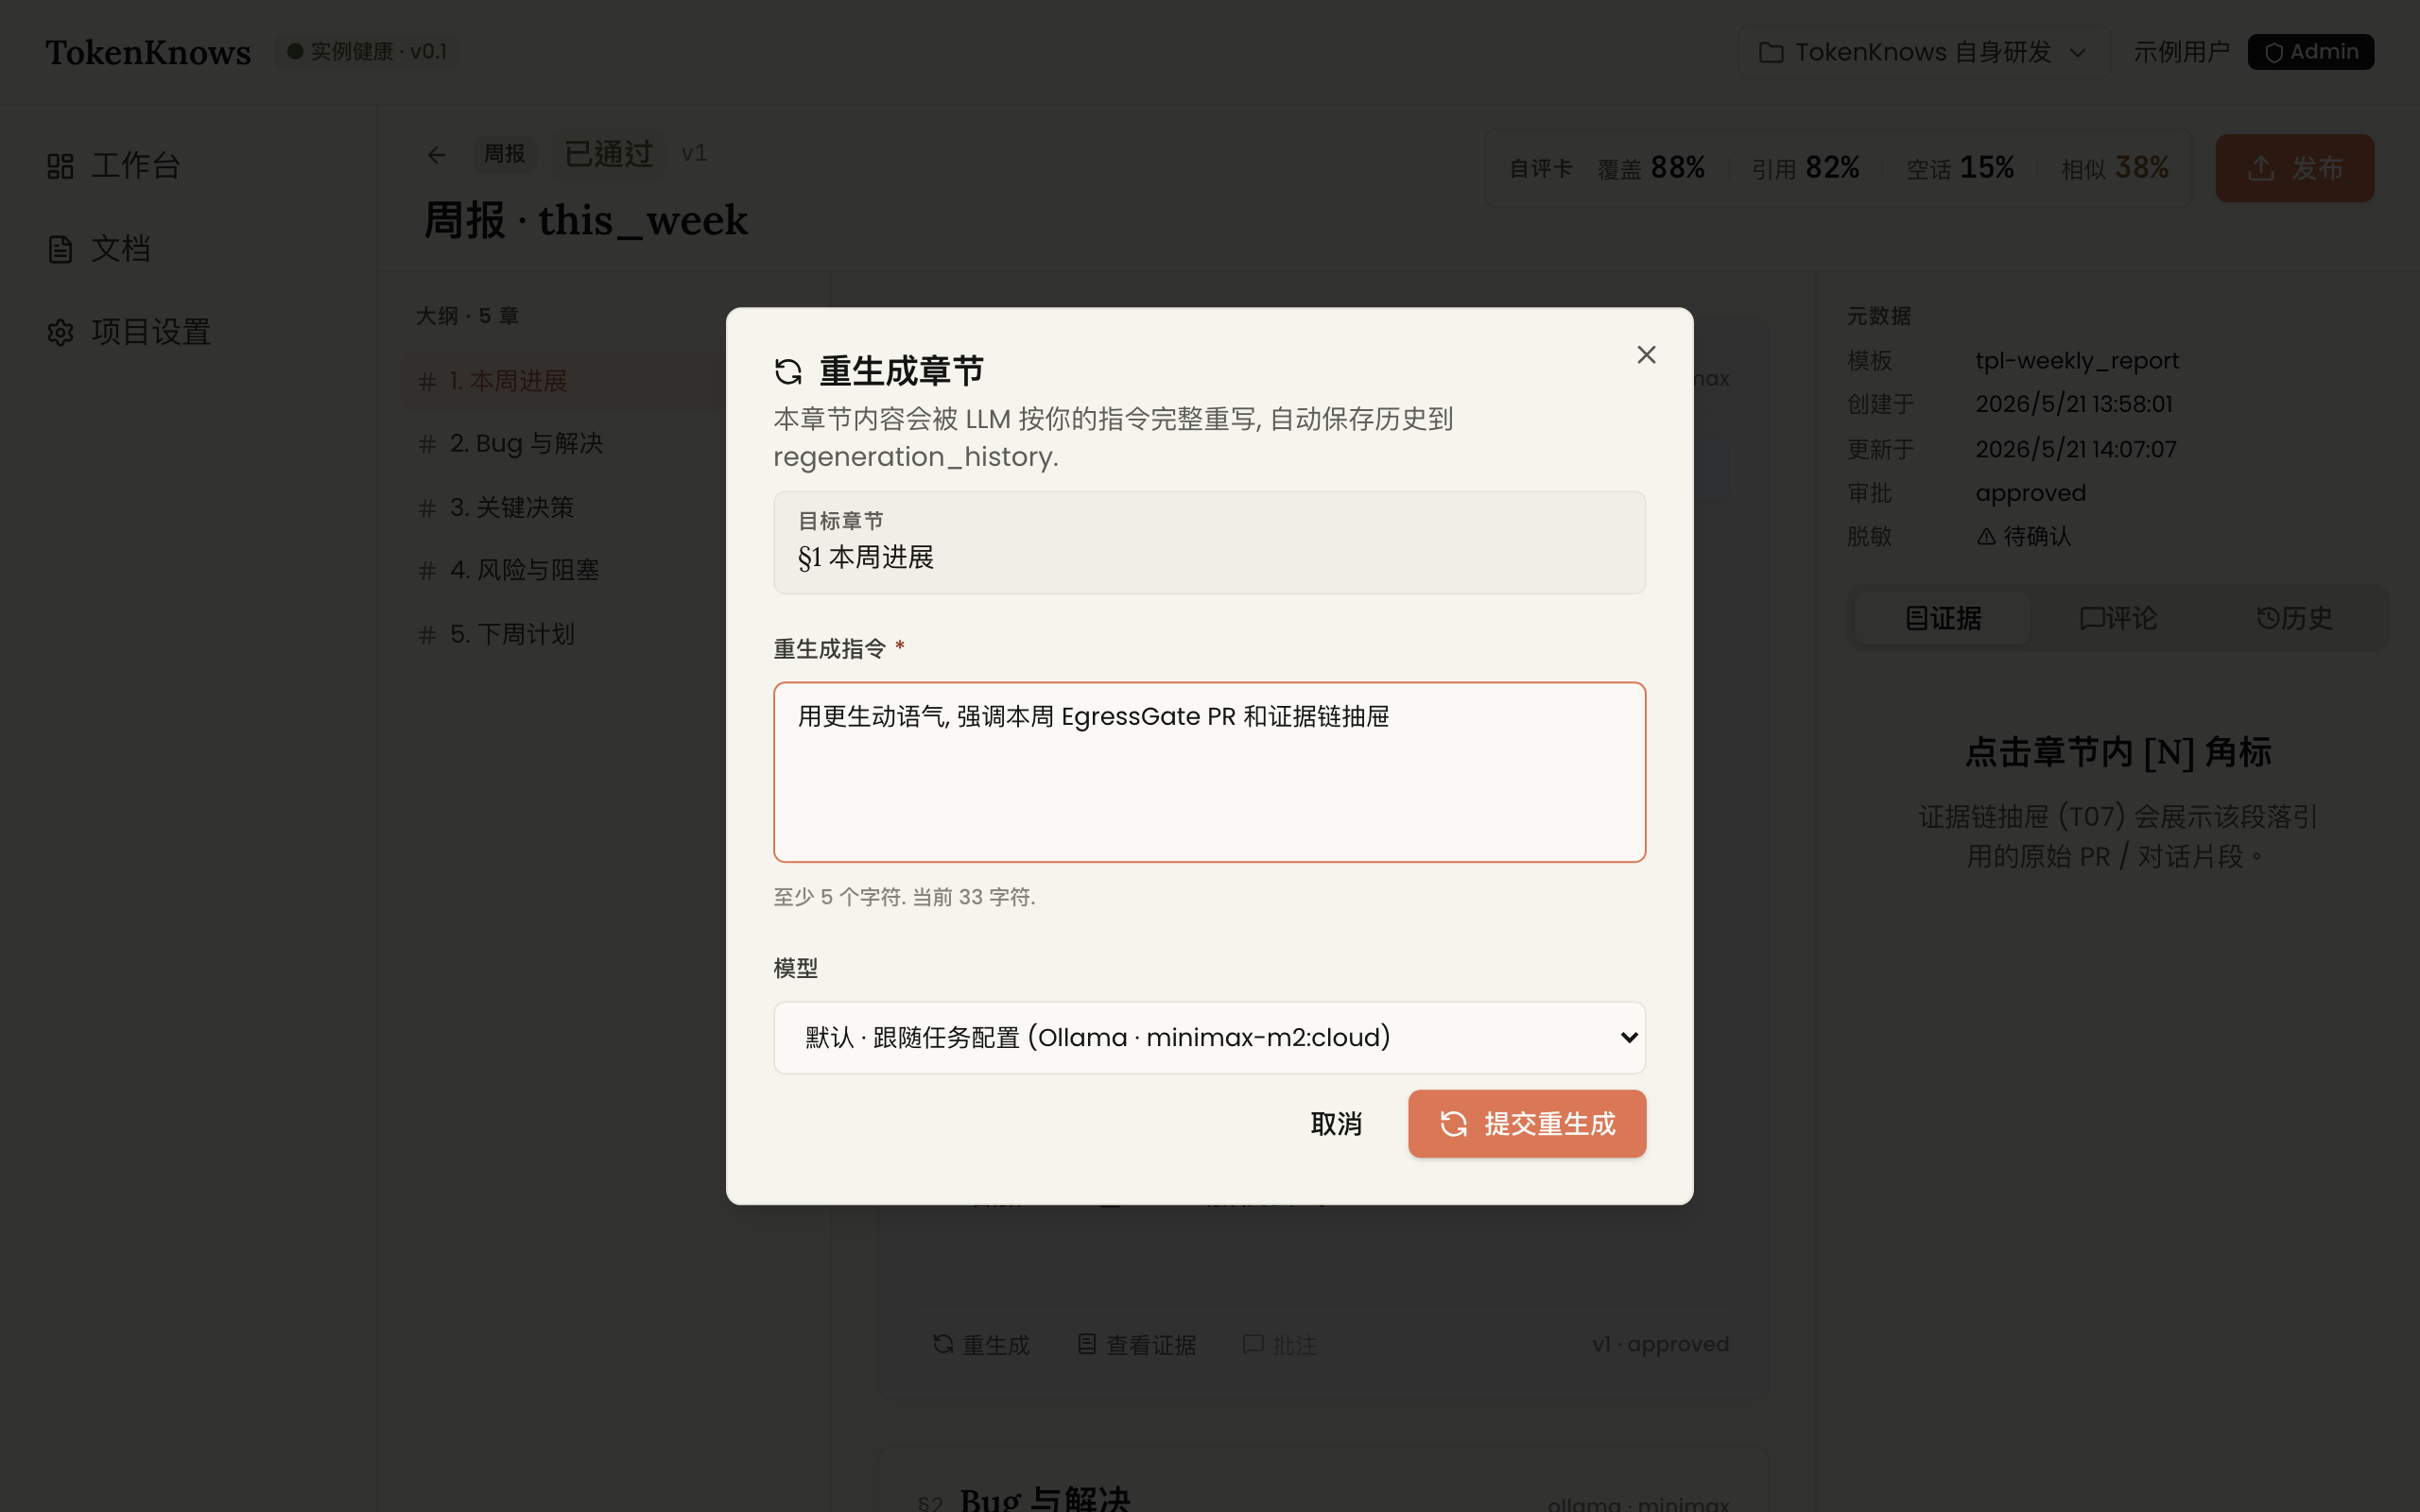 | 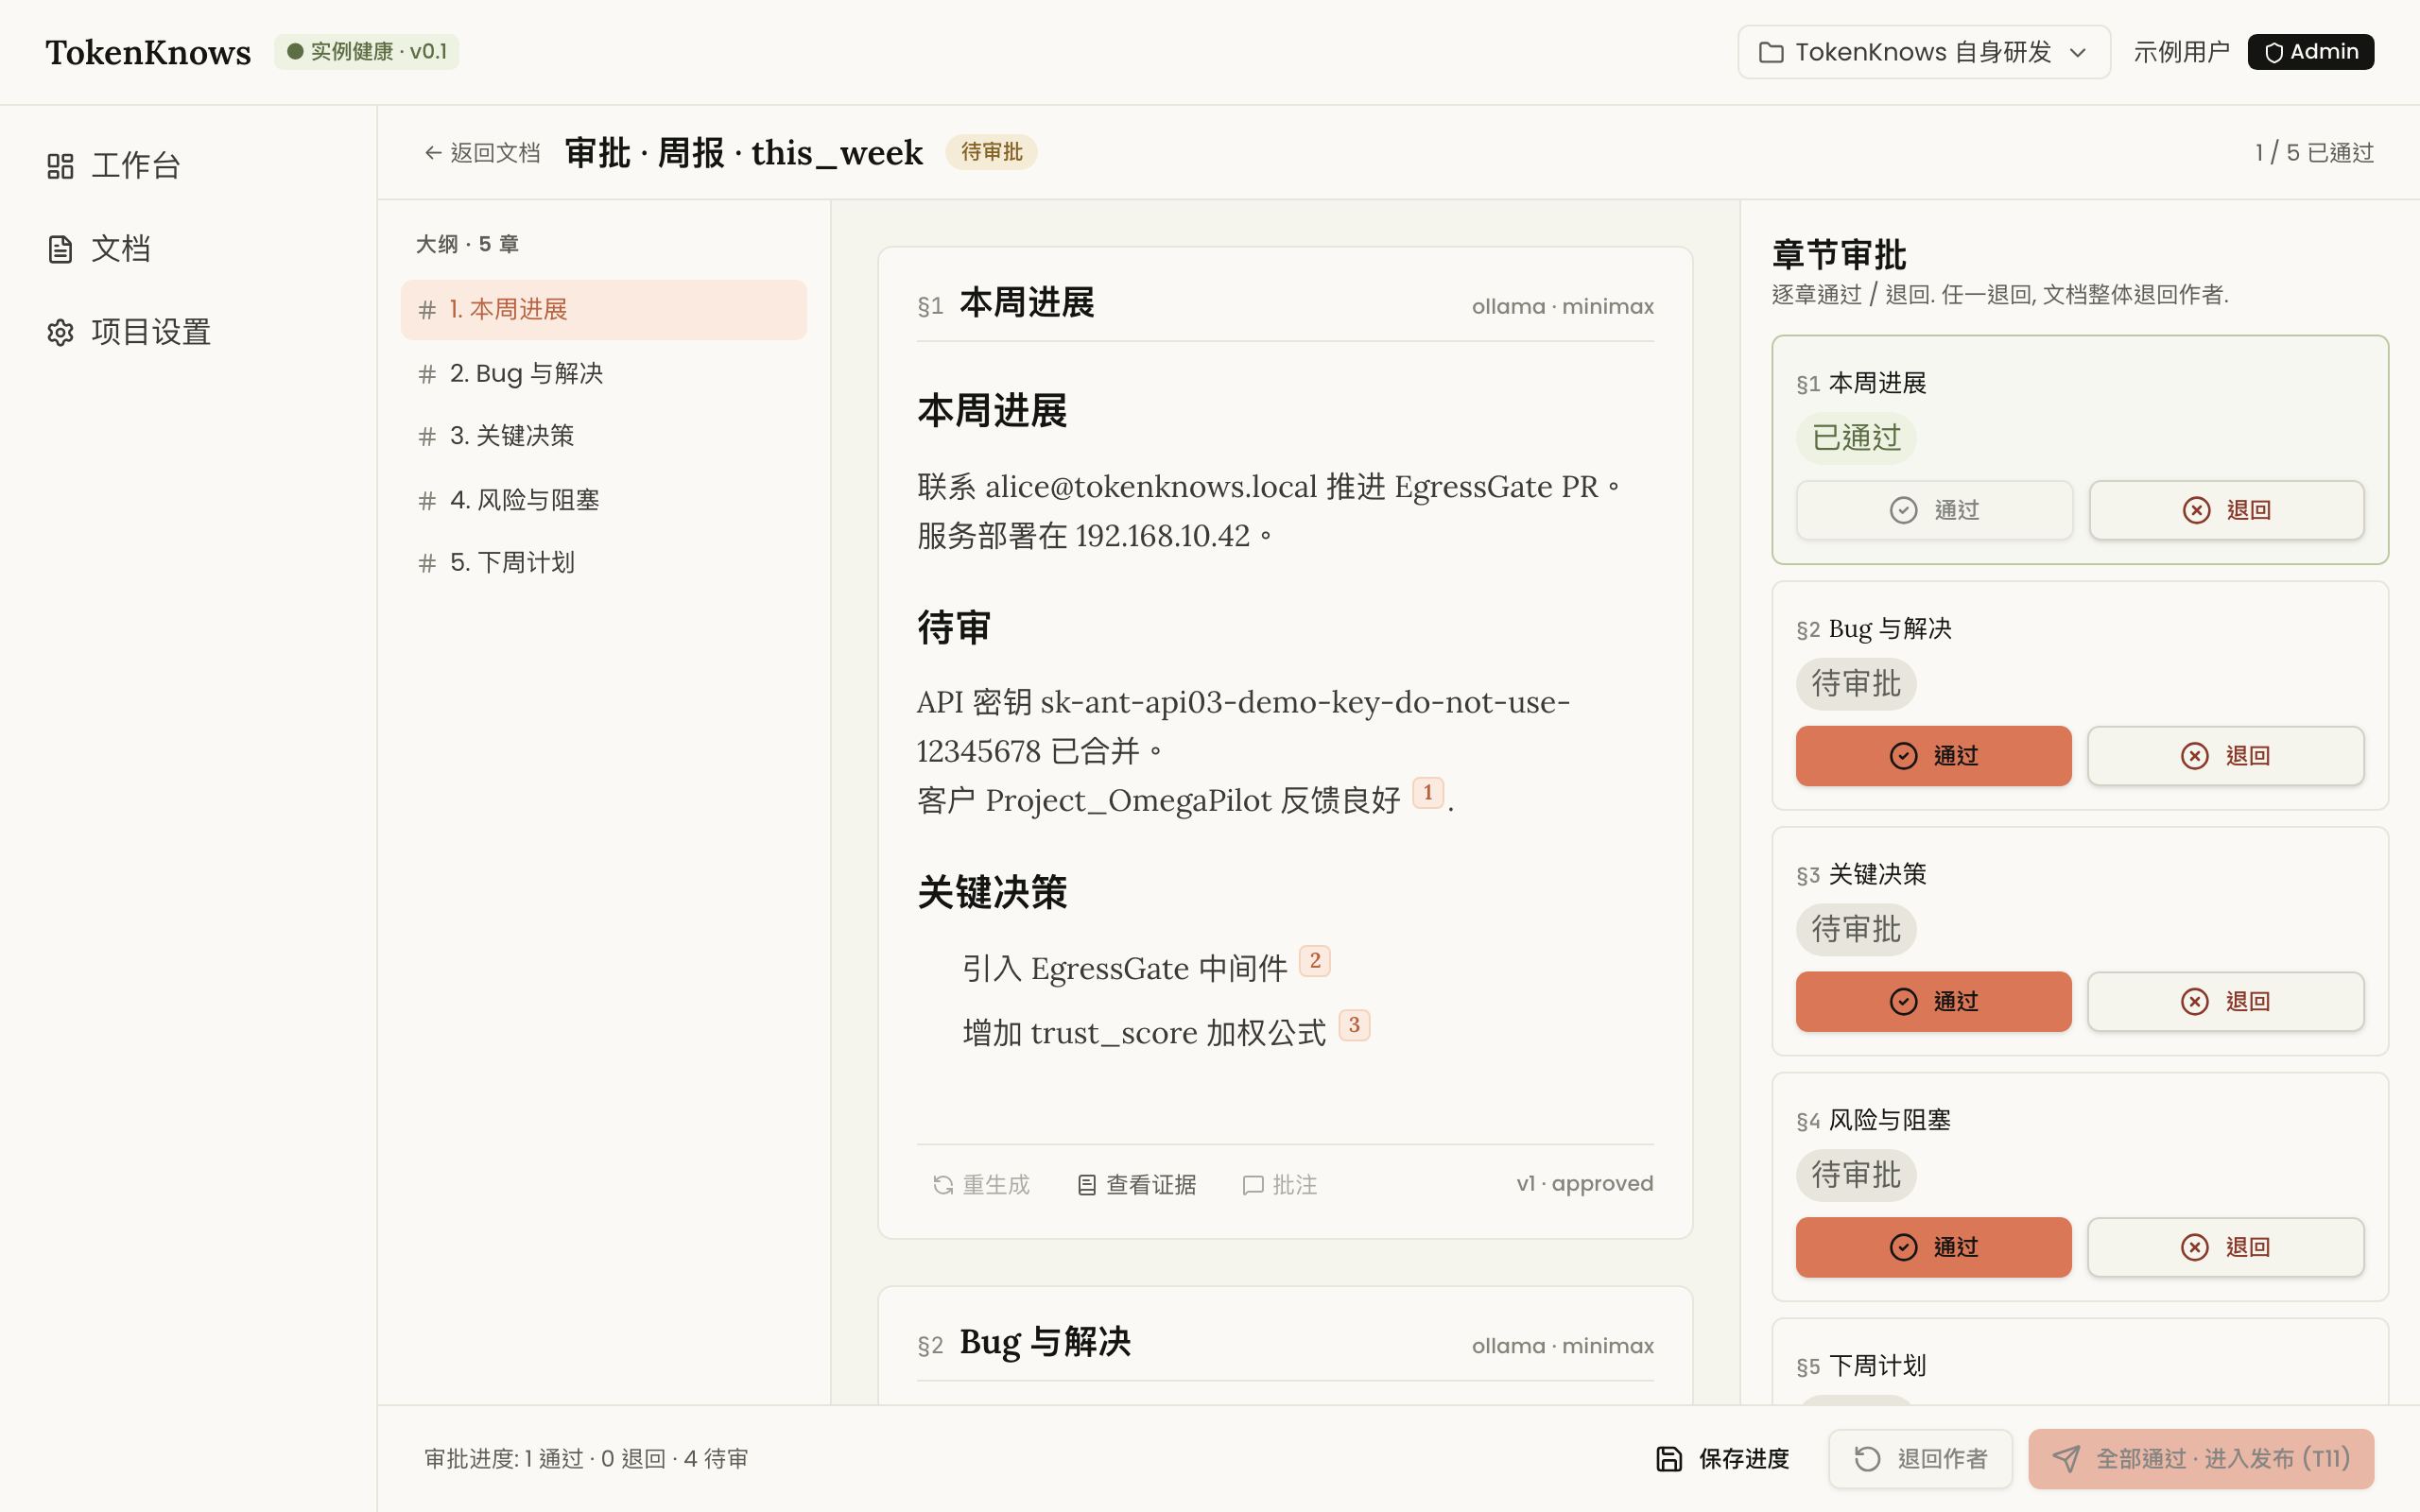 | 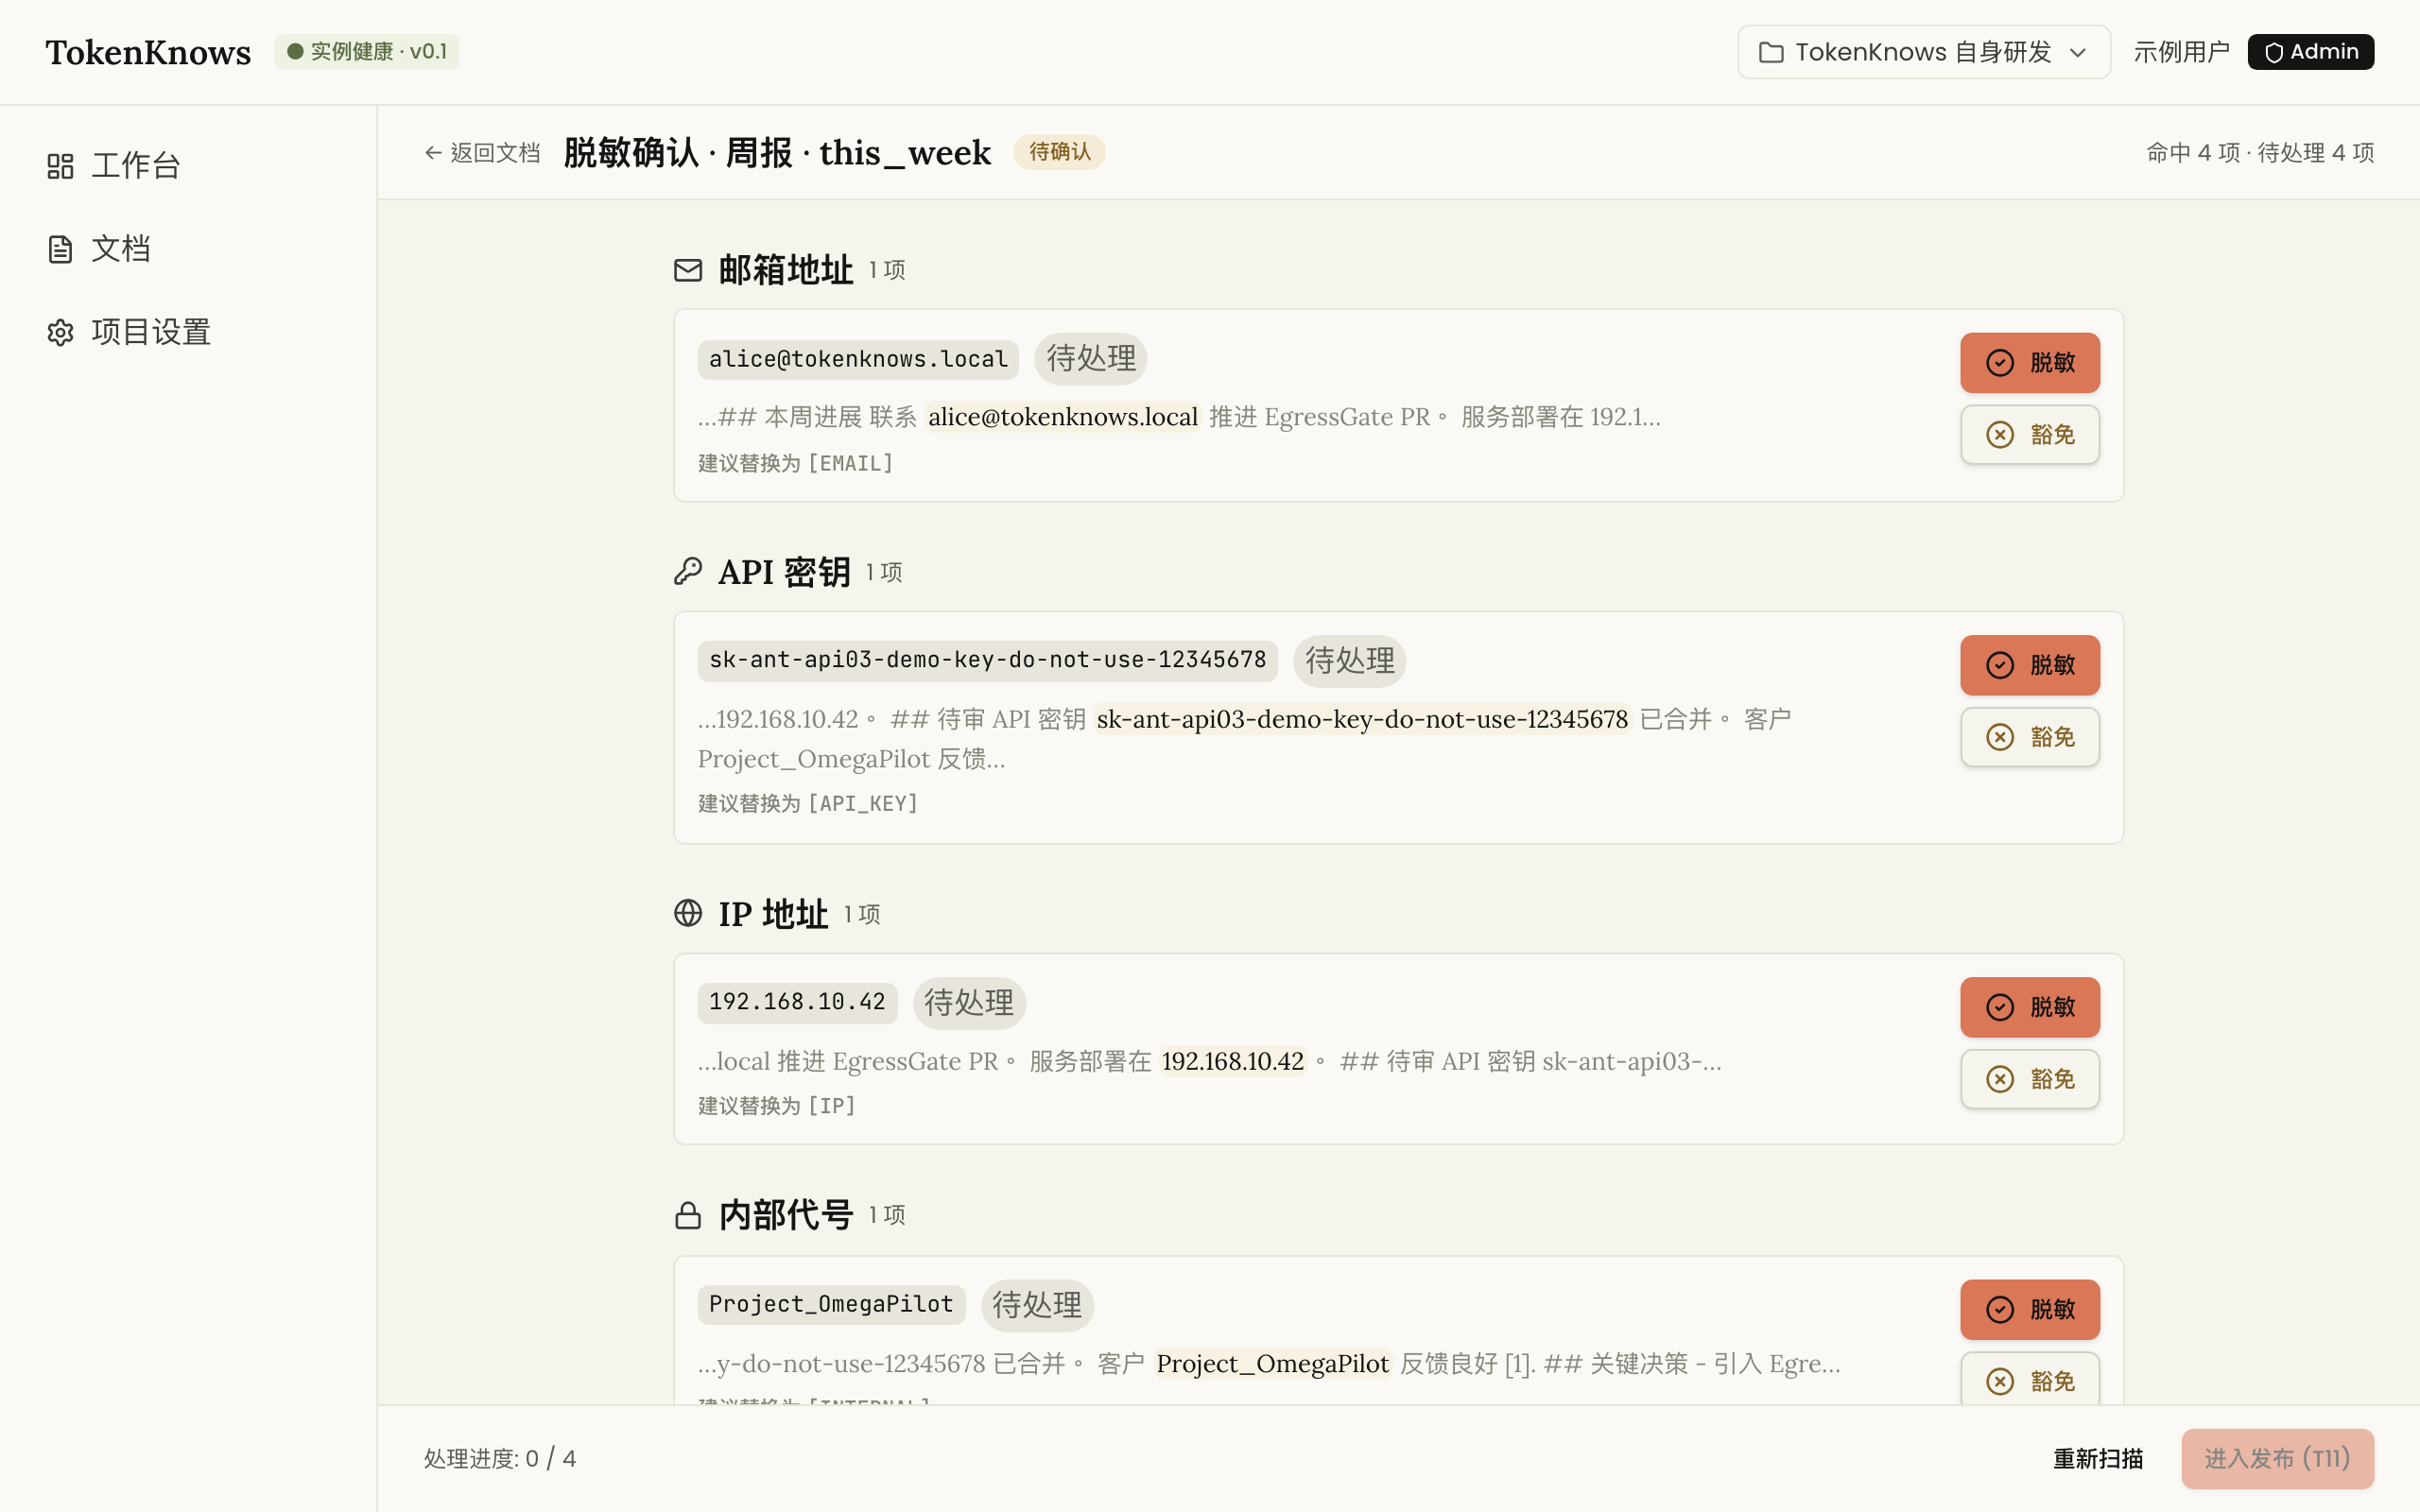 |
| 9 Diálogo de publicação | 10 Recibo de publicação + diff | 11 Egress de LLM | 12 Admin |
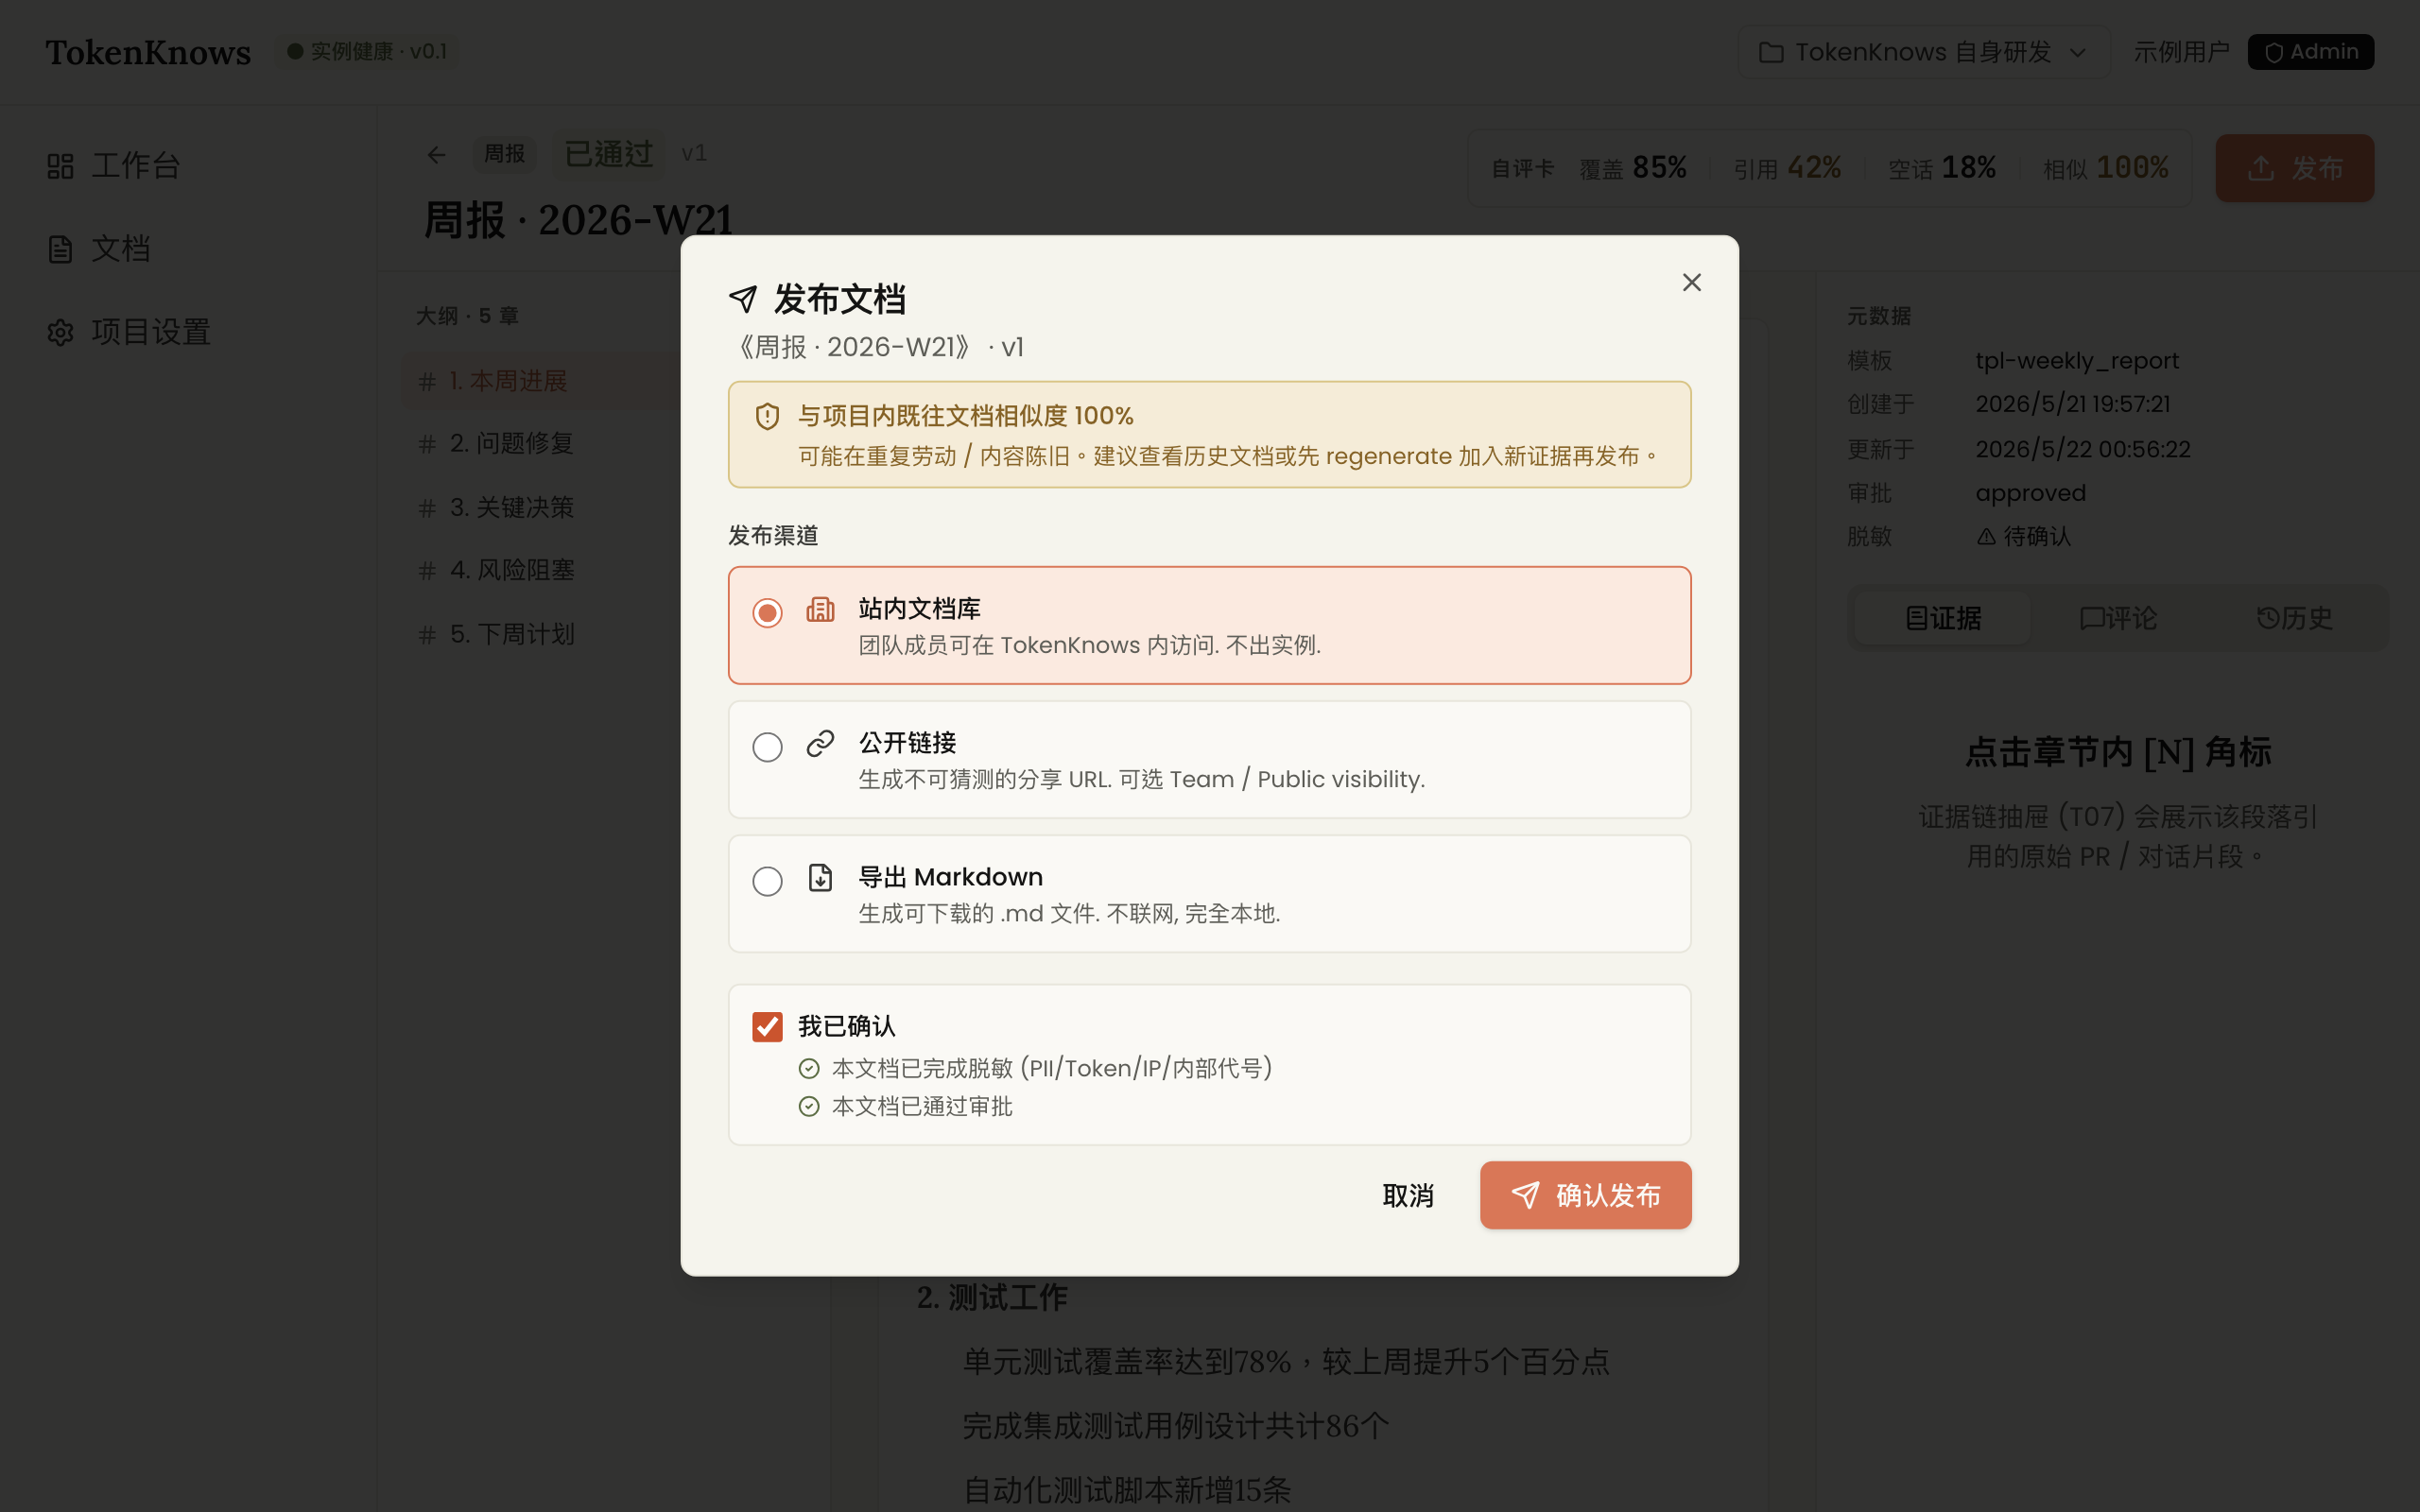 | | 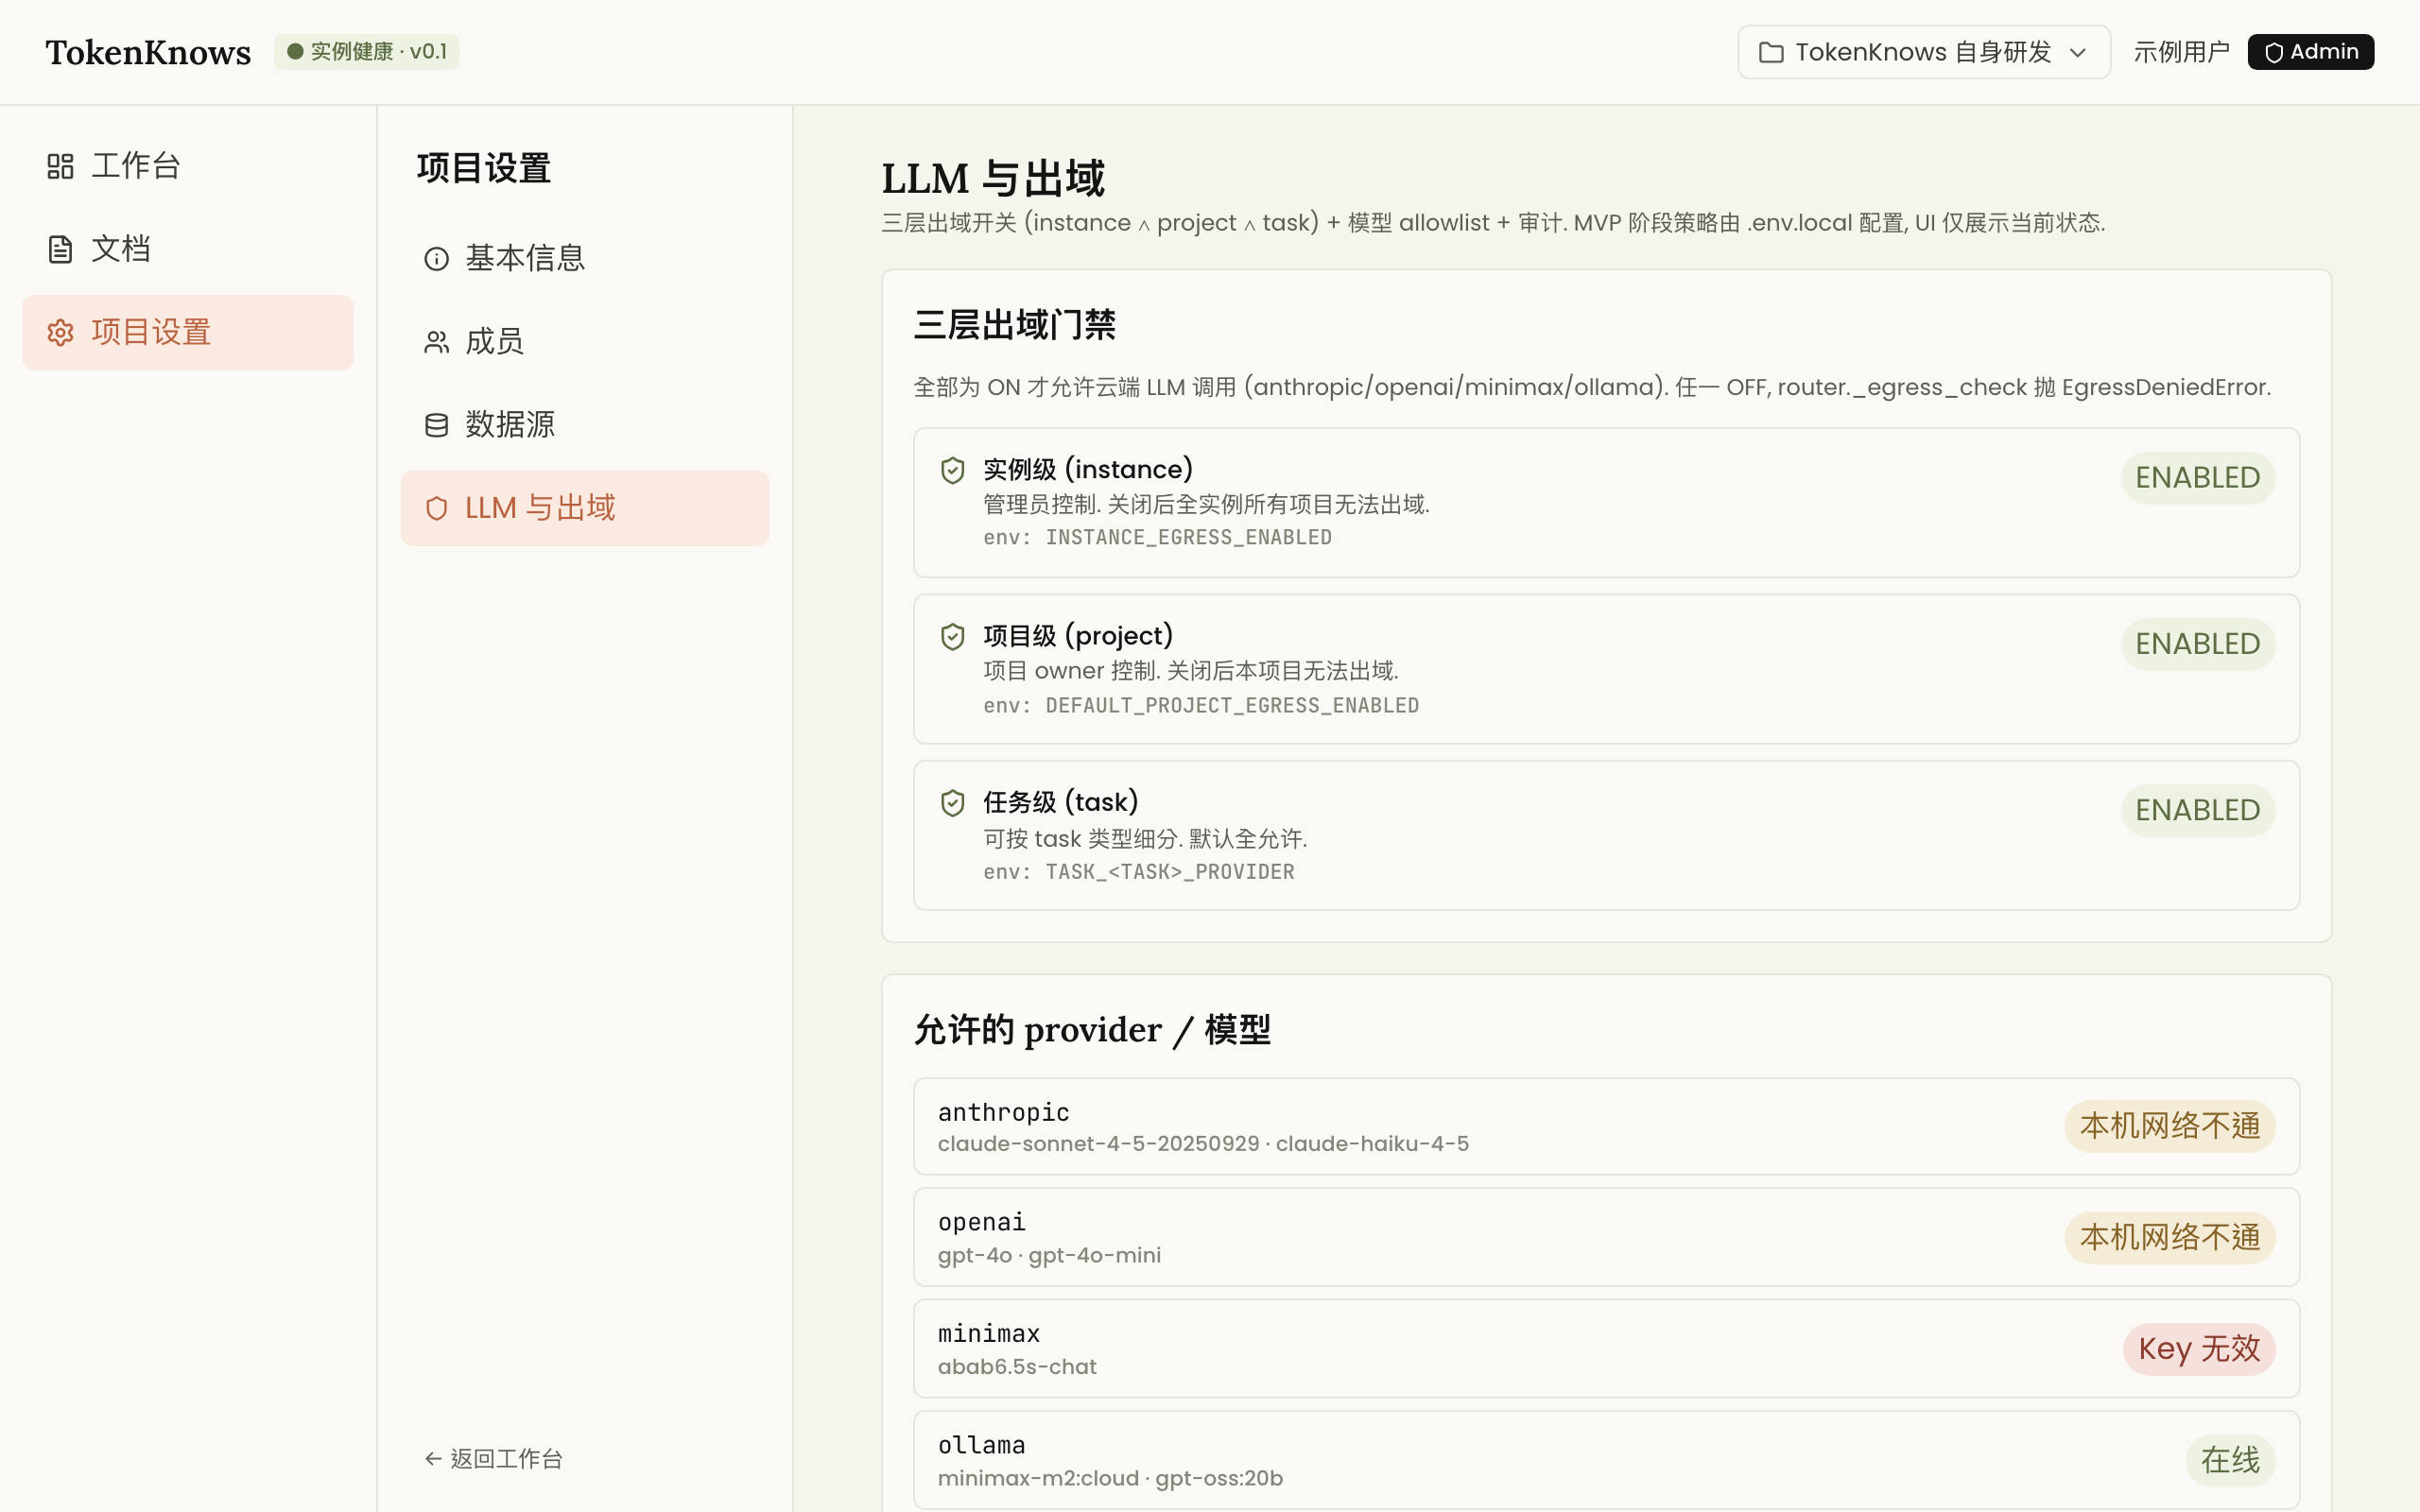 | 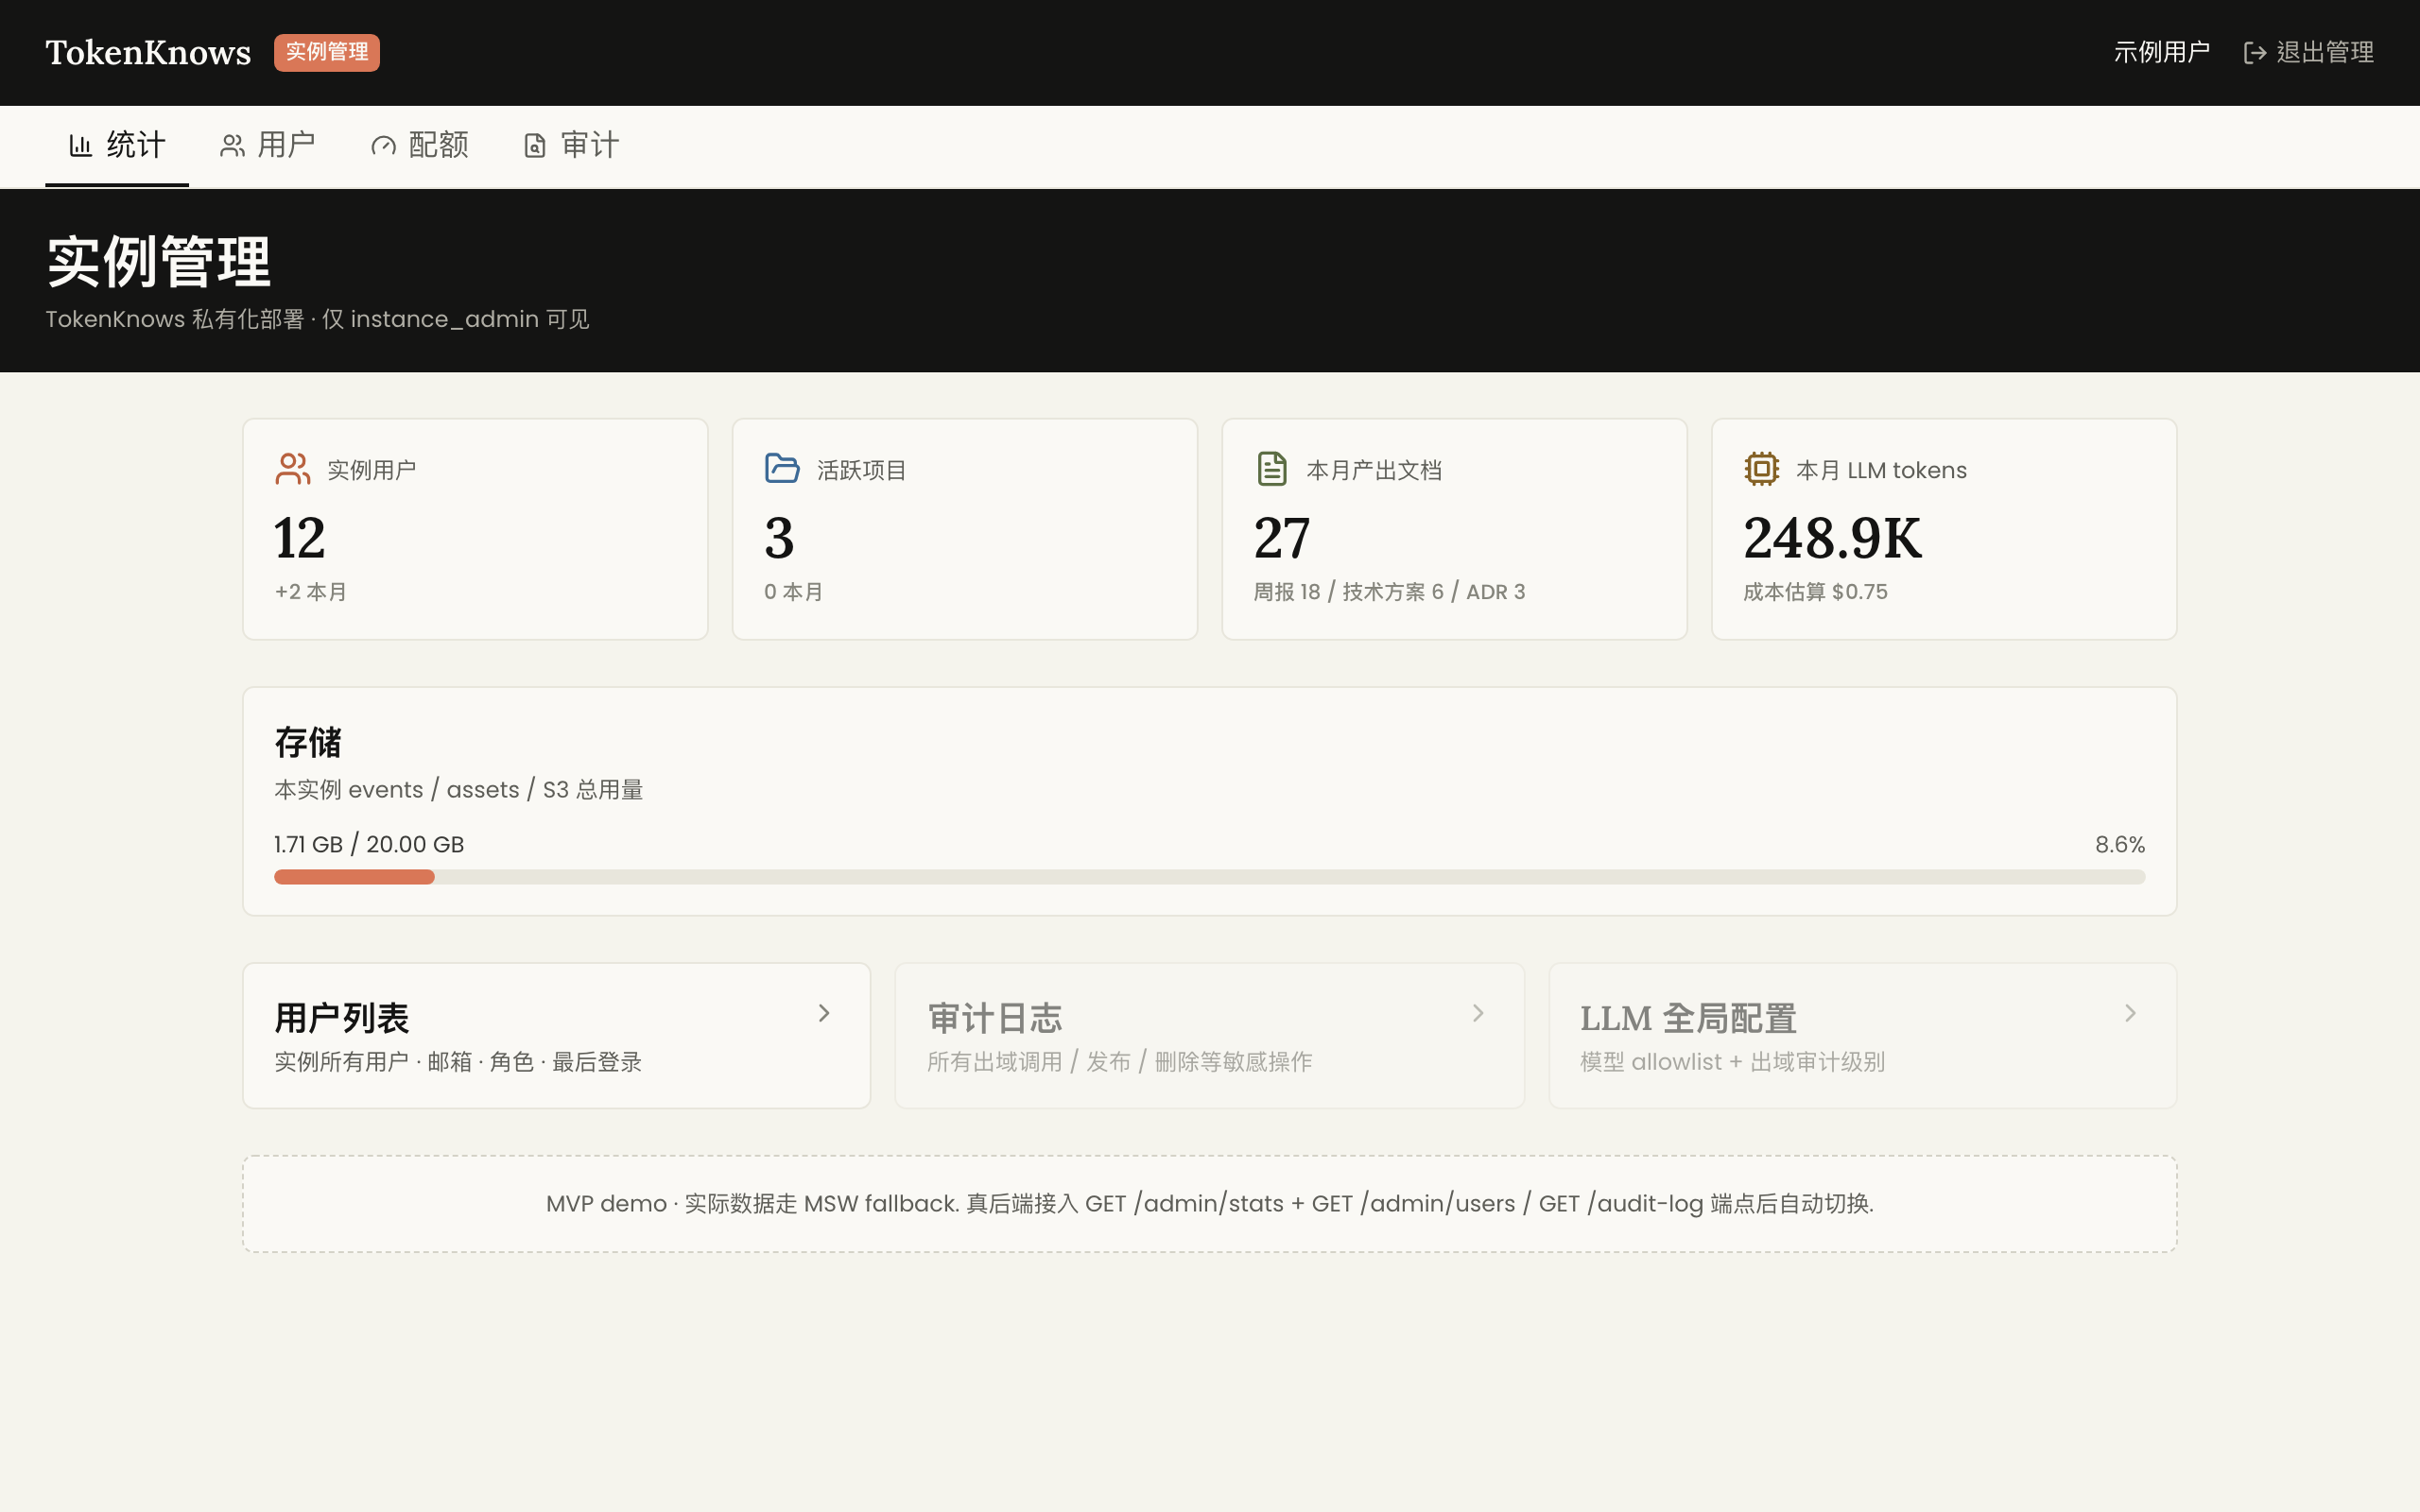 |
Instalar o plugin
Pré-requisito: o backend do TokenKnows em http://localhost:8001 e a interface web em http://localhost:5173 (veja Início rápido), além de uv (o plugin puxa o servidor MCP do PyPI via uvx). Todas as variáveis de ambiente do plugin têm padrões locais funcionais — exporte TOKENKNOWS_API_BASE / TOKENKNOWS_API_TOKEN / TOKENKNOWS_DEFAULT_PROJECT / TOKENKNOWS_WEB_BASE apenas para configurações não padrão. Registre-se/faça login na interface web e crie um token de API em Configurações do Projeto → MCP 接入 quando seu backend exigir autenticação.
| Plataforma | Como |
|---|---|
| Claude Code | /plugin marketplace add johnnywuj81/tokenknows → /plugin install tokenknows@tokenknows — walkthrough completo em tokenknows-plugin/README.md (início rápido de 5 minutos) |
| Codex | codex plugin marketplace add johnnywuj81/tokenknows → codex plugin add tokenknows@tokenknows (carrega habilidades, comandos e o servidor MCP; alternativa de clone local em codex-plugin/README.md) |
| Cursor | Adicione o bloco MCP do tokenknows ao ~/.cursor/mcp.json (exemplo de configuração uvx em code/tokenknows-mcp/README.md) |
| VS Code | Baixe o .vsix de Releases → code --install-extension tokenknows-vscode-*.vsix |
O plugin dá à sua ferramenta de IA ferramentas MCP (submit_session_events, distill_document, list_assets, get_asset, get_asset_chapters, search_entity) além de comandos de barra como /tokenknows:weekly e /tokenknows:adr.
Início rápido
# 1. (Optional but recommended) Ollama — fully local inference, zero cloud keys
ollama serve &
ollama pull minimax-m2:cloud          # or gpt-oss:20b, qwen2.5, ...

# 2. Backend (FastAPI + SQLite persistence + 3-layer LLM egress gate)
cd code/tokenknows-api
python3 -m venv .venv && .venv/bin/pip install -e ".[dev]"
cp .env.local.example .env.local      # defaults to Ollama; edit to add cloud providers
.venv/bin/uvicorn app.main:app --host 127.0.0.1 --port 8001

# 3. Frontend (React 19 + Vite)
cd code/tokenknows-web
npm install
npm run dev
# open http://localhost:5173 — talks to the real backend (mocks are opt-in via ?msw=1)

# (Optional) seed demo data
./engineering_handoff/demo-seed.sh
Suporte de plataforma: macOS — experiência completa (coletores iniciam automaticamente via launchd). Linux — backend, frontend e coletores rodam manualmente (python3 plugins/<x>/sync.py --watch); os scripts launchd não se aplicam. Windows — não testado; WSL2 recomendado.
Coletores de dados
Todos locais — sem ngrok, sem webhooks públicos. No macOS, eles reiniciam em caso de falha e na reinicialização do sistema (launchd).
| Coletor | Fonte | Modo |
|---|---|---|
| claude-code | ~/.claude/projects/*.jsonl | Polling a cada 30s, offsets incrementais |
| codex | ~/.codex/sessions/**/rollout-*.jsonl | Polling a cada 30s, offsets incrementais |
| cursor | state.vscdb do Cursor (SQLite somente leitura) | Polling a cada 60s |
| github | API REST do GitHub · PRs / issues / commits | Polling a cada 5min (token gh auth) |
| vscode | Extensão do VS Code onDidSaveTextDocument | Bufferizado, flush a cada 10s |
| local-docs | ~/Documents .md .txt .pdf (watchdog) | Tempo real, debounce de 2s |
./scripts/launchd/install.sh          # macOS: install all 5 Python collectors as LaunchAgents
launchctl list | grep com.tokenknows
tail -f ~/Library/Logs/tokenknows/*.log
Cada evento carrega uma pontuação de confiança (0.6 × source_authority + 0.4 × extraction_confidence); o estágio de evidências classifica citações por 0.6 × cosine + 0.25 × trust + 0.15 × recency e exige ≥2 fontes distintas.
Arquitetura

Coletores alimentam um armazenamento de eventos (SQLite). Um pipeline de cinco estágios (coletar → esboçar → conteúdo → evidências → avaliar) transforma eventos em ativos. O Gateway de LLM unifica quatro provedores (Anthropic / OpenAI / MiniMax / Ollama) com roteamento por tarefa e cadeias de fallback — e recusa qualquer chamada na nuvem a menos que todos os três interruptores de egress estejam ativados.
CI
| Workflow | Runner | Gatilho |
|---|---|---|
ci.yml | ubuntu-latest (hospedado no GitHub) | push para main + todo PR |
ci-macos.yml | macOS ARM64 auto-hospedado | apenas quando o mantenedor faz push para main — nunca executa código de PR externo |
Privacidade e local-first
- Zero egress por padrão — chamadas de LLM na nuvem exigem que os interruptores de instância e projeto e tarefa estejam todos ativados
- Traga suas próprias chaves; o registro de auditoria nunca sai da sua máquina
- Interruptor de desligamento com um clique coloca a instância em modo totalmente offline
Detalhes: PRD §6.7 residência de dados e controle de egress (chinês).
Documentação
| Tópico | Documento |
|---|---|
| Requisitos de produto, jornadas do usuário | PRD (zh) |
| Design técnico, API, schema | TDD (zh) |
| Arquitetura macro e marcos | Architecture (zh) |
| Decisões de engenharia por tela | TaskTechDesign (zh) |
| Mockups de UI em nível de pixel | mockups/ — abra em um navegador |
A maioria dos documentos detalhados está em chinês (o idioma de trabalho do projeto). Comentários de código são predominantemente em chinês também; issues e PRs em inglês ou chinês são bem-vindos.
Comunidade
CONTRIBUTING · Roadmap · Código de Conduta · Política de segurança · Issues
Licença
MIT © 2026 johnnywuj81