Infino
Infino — recuperação por palavra-chave, vetorial, híbrida e SQL sobre dados em armazenamento de objetos, para agentes de IA.
Documentação
Infino


Infino é uma biblioteca de recuperação embarcada e rápida: busca de texto completo, vetorial, híbrida e SQL sobre uma única tabela, armazenada como Parquet comum em disco local ou armazenamento de objetos. Simples, escalável e otimizada para custo.
pip install infino              # Python
npm install @infino-ai/infino   # Node.js
cargo add infino                # Rust

or in Cargo.toml:

[dependencies]
infino = "0.8"
Nota: o infino instala o alocador global mimalloc por padrão. Se você embutir o infino em um processo que já define um alocador global, desative-o para evitar um segundo:
infino = { version = "0.8", default-features = false }.
Início rápido
import infino
import pyarrow as pa

db = infino.connect("memory://")

schema = pa.schema([
    pa.field("body", pa.large_utf8(), nullable=False),
    pa.field("embedding", pa.list_(pa.float32(), 384), nullable=False),
])
docs = db.create_table(
    "docs", schema,
    infino.IndexSpec().fts("body").vector("embedding", 384, "cosine"),
)

docs.append(rows)   # list of dicts, or an Arrow RecordBatch

# BM25 and vector in one call, fused ranking. `query_vec` is your embedding.
hits = docs.hybrid_search("body", "disk full", "embedding", query_vec, k=10)
Desempenho
p50 em estado quente, tabelas em armazenamento de objetos:
| 1M de documentos | 10M de documentos | |
|---|---|---|
| Vetor top-10 (recall@10 0,992 a 1M) | 591 µs | 5 ms |
| BM25 top-10, incluindo busca de linha | 125 µs | 2 ms |
| SQL, metadados → formatos de tabela cruzada | 186 µs – 7,6 ms | 260 µs – 75 ms |
Todas as tabelas completas registradas de cada bateria — linhas por formato, RSS, contagens de GET a frio, a execução de 1M que estes resumos citam — estão em benches/README.md.
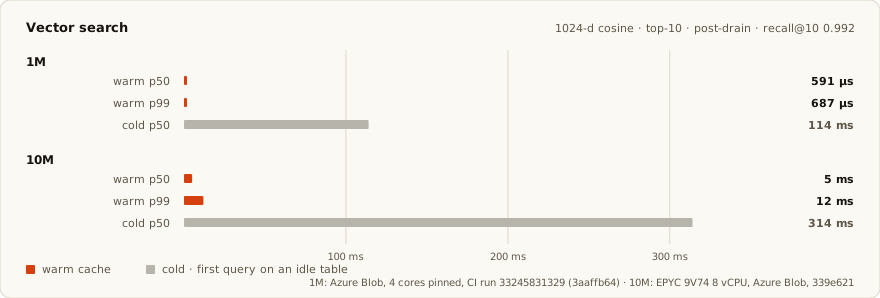
Reproduzir
cargo bench -- supertable vector warm cold
cargo bench puro executa a camada de 10M; as linhas de 1M (o que o CI executa) são prefixadas com INFINO_BENCH_SUPERTABLE_DOCS=1000000 no mesmo comando.
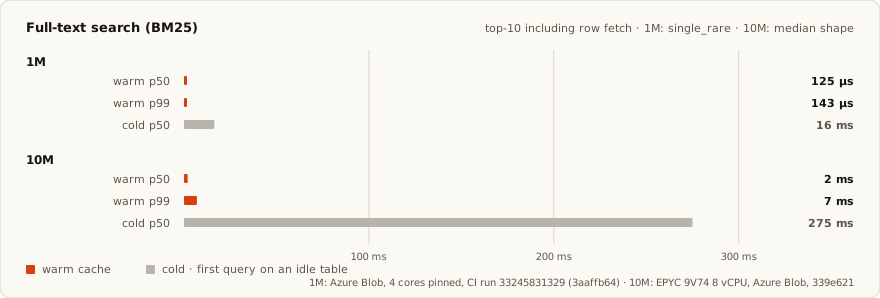
Reproduzir
cargo bench -- supertable fts warm cold
cargo bench puro executa a camada de 10M; as linhas de 1M (o que o CI executa) são prefixadas com INFINO_BENCH_SUPERTABLE_DOCS=1000000 no mesmo comando.
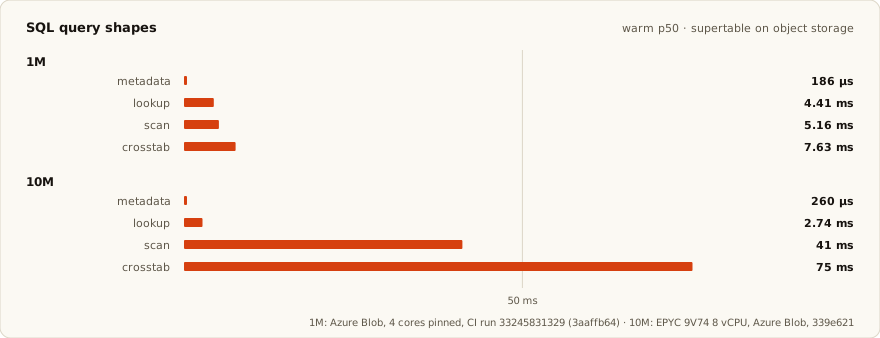
Reproduzir
cargo bench -- supertable sql warm
cargo bench puro executa a camada de 10M; as linhas de 1M (o que o CI executa) são prefixadas com INFINO_BENCH_SUPERTABLE_DOCS=1000000 no mesmo comando.
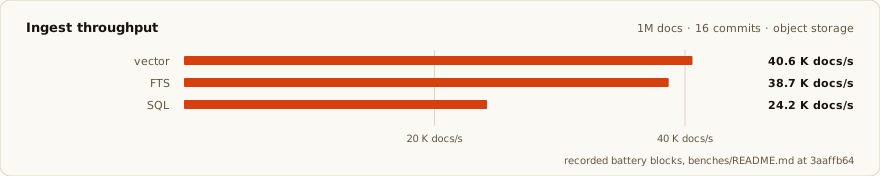
Reproduzir
INFINO_BENCH_SUPERTABLE_DOCS=1000000 cargo bench -- supertable build
Um único comando, todas as células de ingestão das três modalidades.
- Primeira consulta a frio = abertura de arquivos + preenchimento de cache: 114 ms (1M) e 314 ms (10M) para vetor, 16 ms e 275 ms para BM25. Quente e frio ficam ~200× separados; os gráficos usam escala logarítmica.
- 1M: CI — Azure Blob, 4 núcleos fixados, commit
3aaffb64(execução 33245831329). - 10M: mesmo harness em sua escala padrão — 8 vCPUs AMD EPYC 9V74 (AVX-512, 62 GiB), Azure Blob, commit
339e621. Compare cada escala com sua própria linha de base.
Metodologia: configuração, corpora reais, CI correspondente
O comportamento do mecanismo é configurado apenas em YAML; variáveis de ambiente nunca o substituem. Os padrões fornecidos são o que os gráficos medem:
cp src/config/config.yaml infino.yaml # or $XDG_CONFIG_HOME/infino/config.yaml
O bloco vector: contém profundidade de sondagem, codec de reclassificação e contagens de células. O bloco supertable: contém o comportamento de commit e cache. Deixe ambos intactos para reproduzir os gráficos publicados.
O tamanho do corpus é o único ajuste do benchmark que lê uma variável de ambiente, e ele aceita um inteiro simples (1000000, não 1M); a dobra Reproduzir de cada gráfico carrega seu comando exato.
Para executar com um conjunto de dados real em vez do corpus sintético, passe uma especificação corpus=. Ela se aplica a uma célula selecionada, então nomeie uma única camada e modalidade:
# Hugging Face parquet dataset — downloaded once into corpus-dir, reused after
INFINO_BENCH_SUPERTABLE_DOCS=1000000 \
  cargo bench -- supertable vector \
  corpus=hf:KShivendu/dbpedia-entities-openai-1M corpus-dir=./corpora

# Any local parquet shards (e.g. Cohere embeddings you already hold)
cargo bench -- supertable vector corpus=parquet:/path/to/shards
INFINO_BENCH_SUPERTABLE_DOCS limita quantas linhas são ingeridas do conjunto de dados. O recall é avaliado contra a verdade absoluta de força bruta em consultas retidas, corpus real ou sintético.
Isso executa contra um daemon RustFS local, um substituto HTTPS S3, por padrão. Para corresponder ao CI:
INFINO_BENCH_SUPERTABLE_DOCS=1000000 \
INFINO_BENCH_STORE=azure \
INFINO_REAL_AZURE_CONTAINER=$CONTAINER \
AZURE_STORAGE_ACCOUNT_NAME=$ACCOUNT \
AZURE_STORAGE_ACCOUNT_KEY=$KEY \
  cargo bench -- supertable vector warm cold
Lendo a saída: vetor é a linha default pós-dreno; BM25 é single_rare em Supertable FTS; os formatos SQL são agg_max_title (metadados), WHERE key = ? (lookup), AVG(rating) GROUP BY category (scan) e COUNT(*) GROUP BY bucket, category (tabela cruzada). Resultados estruturados ficam em target/infino-bench/*.json. A metodologia está em benches/README.md.
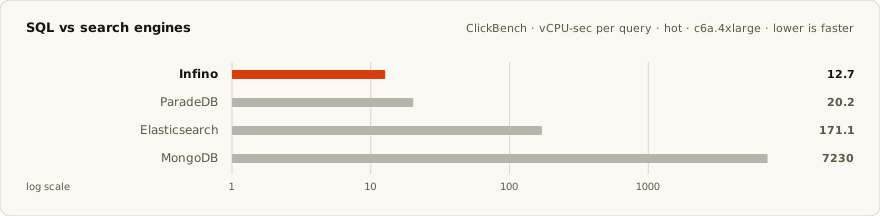
Contra outros mecanismos
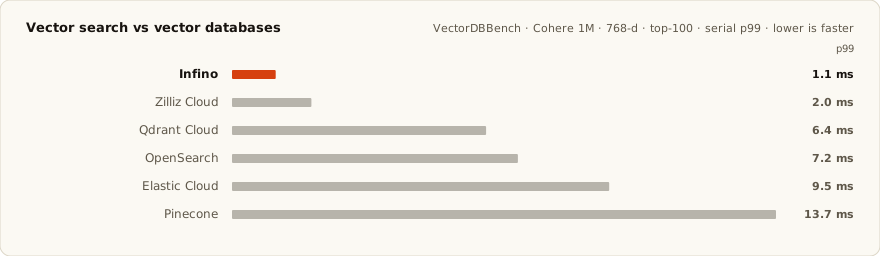
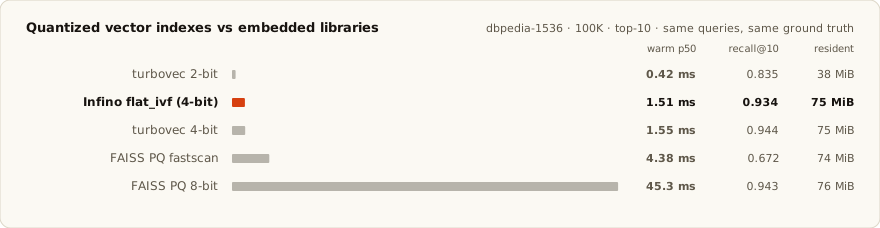
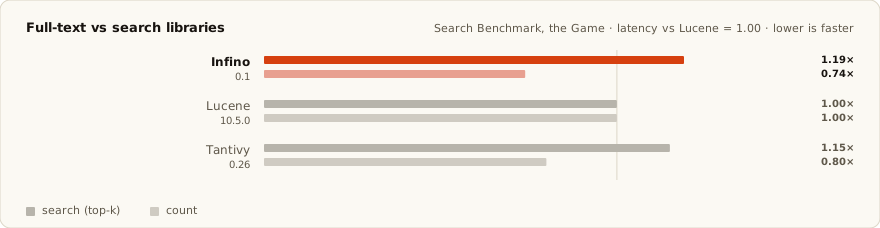
Search Benchmark, the Game (Repro)
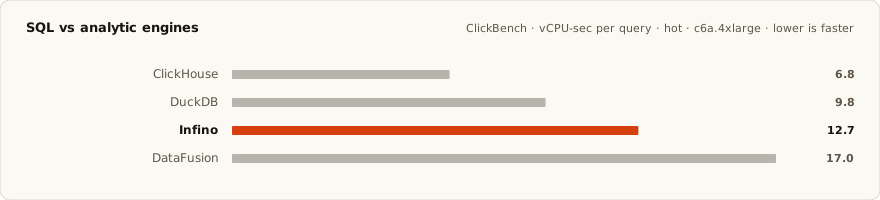
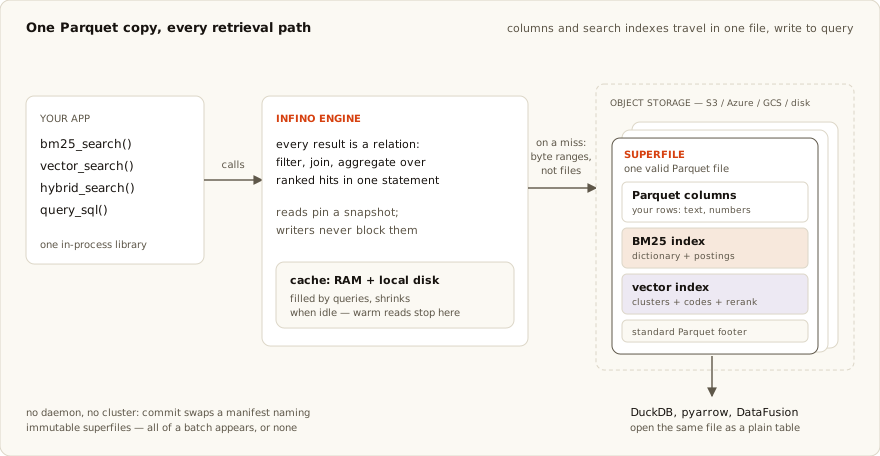
Como funciona
Resumo
- Um arquivo Parquet por lote de dados, com os índices BM25 e vetorial dentro dele. DuckDB, pyarrow e DataFusion abrem o mesmo arquivo como uma tabela normal (exemplo).
- O destino de armazenamento é determinado por uma string de conexão:
memory://, um caminho local, ous3://,gs://, Azure. - Nenhum daemon, cluster ou serviço de bloqueio é necessário. O Infino grava arquivos somente anexação e imutáveis, então os leitores fixam um snapshot e nunca bloqueiam os gravadores.
- Tabelas muito maiores que a RAM funcionam: consultas leem intervalos de bytes.
Os índices vivem dentro do arquivo Parquet
- Cada gravação produz um arquivo Parquet com os índices BM25 e vetorial embutidos nele.
- Qualquer leitor de Parquet — DuckDB, pyarrow, DataFusion — abre esse arquivo e vê uma tabela normal. O Infino abre o mesmo arquivo e também encontra seus índices.
- Não há artefato de índice separado para construir, enviar ou manter em sincronia, e nada para carregar na inicialização.
Uma consulta lê intervalos de bytes, não arquivos
- Os índices são ordenados por termo e por cluster vetorial, então um top-10 se transforma em uma lista curta de deslocamentos de bytes. Em armazenamento de objetos, isso são algumas solicitações HTTP de intervalo, não um download.
- Uma solicitação de armazenamento de objetos leva 20–100 ms.
- Os intervalos buscados são mantidos em um cache de disco local e mapeados em memória. Uma consulta repetida faz zero solicitações de rede e responde em 125 µs.
- O cache encolhe sob pressão de memória e esvazia em uma tabela ociosa. Consultas o reabastecem.
O avaliador de texto é escolhido por consulta
As listas de postagem armazenam, para cada termo, quantos documentos o contêm e a melhor pontuação possível em cada bloco. Com isso em mãos, o mecanismo escolhe o algoritmo correto mais barato para cada consulta:
- Uma consulta que mistura uma palavra rara e uma comum salta pela lista da palavra comum em vez de lê-la (WAND / Block-Max WAND).
- Uma consulta de palavras comparativamente comuns pontua documentos em janelas de tamanho fixo, descartando palavras que não podem mais alcançar o top 10 à medida que o limite aumenta (MaxScore).
- Contar correspondências para uma consulta dominada por uma palavra muito comum lê uma contagem armazenada em vez de percorrer a lista de postagem.
- Consultas muito densas mudam para bitsets. ANDs muito esparsos percorrem a lista mais curta e sondam as outras.
- Os pontos de troca foram definidos por benchmark, e cada algoritmo é testado contra uma implementação BM25 de força bruta. A escolha muda a velocidade, nunca os resultados.
A busca vetorial é um funil de três estágios
- Os vetores são agrupados em clusters. Uma consulta é comparada primeiro aos centros dos clusters, e apenas os clusters mais próximos são lidos — 62 de 255, para um top-10 em uma tabela de 1M de linhas.
- As linhas nesses clusters são pontuadas com códigos de 1 bit por dimensão: 192 bytes por vetor de 1536 dimensões, em vez de 6 KiB como float32.
- Os melhores candidatos — 155 linhas para esse mesmo top-10 — são reavaliados com códigos de 2 bytes por dimensão para obter a ordem exata.
- Quantos clusters ler e quantas linhas reavaliar são medidos por tabela quando o índice é construído, e medidos novamente quando os dados mudam de forma.
- Recall@10 medido a 1M de linhas: 0,992, testado contra vizinhos mais próximos exatos de força bruta.
- Os kernels de distância são despachados em tempo de execução: AVX-512, AVX2, um caminho portátil de 256 bits e um kernel int8 VNNI para navegação em grafos.
Commits trocam um manifesto
- Uma tabela é um conjunto de arquivos imutáveis mais um manifesto que os lista. Um commit grava novos arquivos e então substitui o manifesto em uma única etapa atômica: todas as suas linhas aparecem, ou nenhuma.
- Um leitor mantém o manifesto que abriu e termina nessa versão. Ele nunca espera por um gravador e nunca vê meio commit.
- Sem serviço de bloqueio, sem eleição de líder.
optimize() ajusta o índice aos dados
- Você define um número —
target_recall: 0.99.optimize()mede a tabela e dimensiona todo o resto: quantos clusters, quantos uma consulta lê, quantas linhas são reavaliadas. - Se você selecionar o modo de índice de grafo ou plano, ele é construído e seu recall é medido. Ele serve apenas se atingir o padrão nesses dados; caso contrário, o índice padrão continua servindo e nada muda para o chamador.
- As medições são refeitas sempre que compactação ou uma divisão de cluster altera os dados.
# infino.yaml
vector:
  target_recall: 0.99
  search_mode: ivf         # ivf (default) | hnsw_ivf | flat_ivf
table.optimize() # drain, compact, recalibrate, sweep
Cada ajuste, e a medição por trás de cada padrão, está documentado inline em src/config/config.yaml.
Modos de índice vetorial
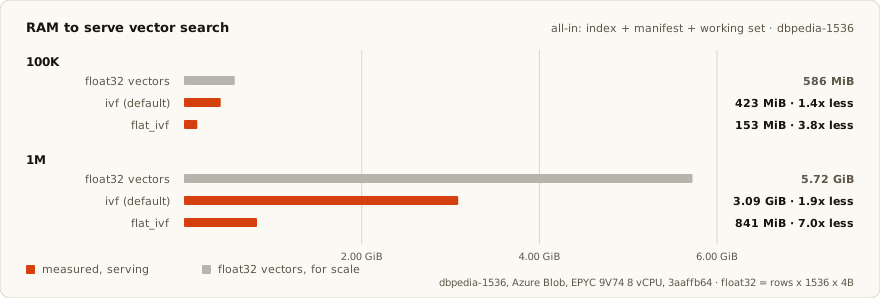
Você pode trocar memória por latência, dependendo da sua carga de trabalho.
Um milhão de vetores de 1536 dimensões são 5,7 GiB de RAM como float32. flat_ivf os serve a partir de 841 MiB, tudo incluído.
Reproduzir
printf 'vector:\n  search_mode: flat_ivf\n' > infino.yaml   # or hnsw_ivf; rm for ivf
INFINO_BENCH_SUPERTABLE_DOCS=1000000 \\
  cargo bench -- supertable vector build warm \\
  corpus=hf:KShivendu/dbpedia-entities-openai-1M corpus-dir=./corpora
Uma execução por modo: a linha de configuração o seleciona, optimize() o constrói, a bateria relata RSS de serviço e latência.
Reproduzir
printf 'vector:\n  search_mode: flat_ivf\n' > infino.yaml   # or hnsw_ivf; rm for ivf
INFINO_BENCH_SUPERTABLE_DOCS=1000000 \\
  cargo bench -- supertable vector build warm \\
  corpus=hf:KShivendu/dbpedia-entities-openai-1M corpus-dir=./corpora
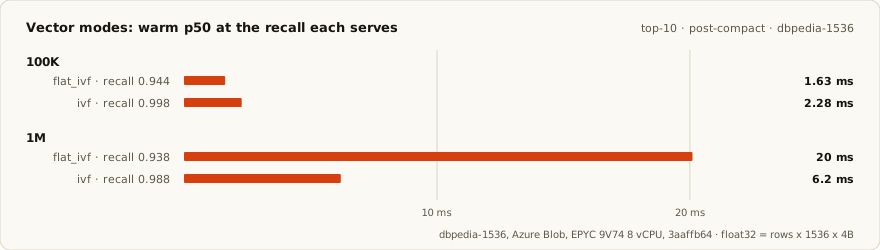
Uma execução por modo: a linha de configuração o seleciona, optimize() o constrói, a bateria relata RSS de serviço e latência.
Figuras de serviço medidas, cada linha em seu próprio corpus:
| Modo | Corpus | RAM para servir | recall@10 | p50 quente |
|---|---|---|---|---|
flat_ivf | dbpedia 1M × 1536d | 841 MiB, fixado | 0,938 | 20 ms |
ivf (padrão) | dbpedia 1M × 1536d | 3,16 GiB de conjunto de trabalho, 109 MiB fixados | 0,988 | 6,2 ms |
hnsw_ivf | Cohere 1M × 768d | 2,5 GiB, fixado | 0,995 | 0,59 ms |
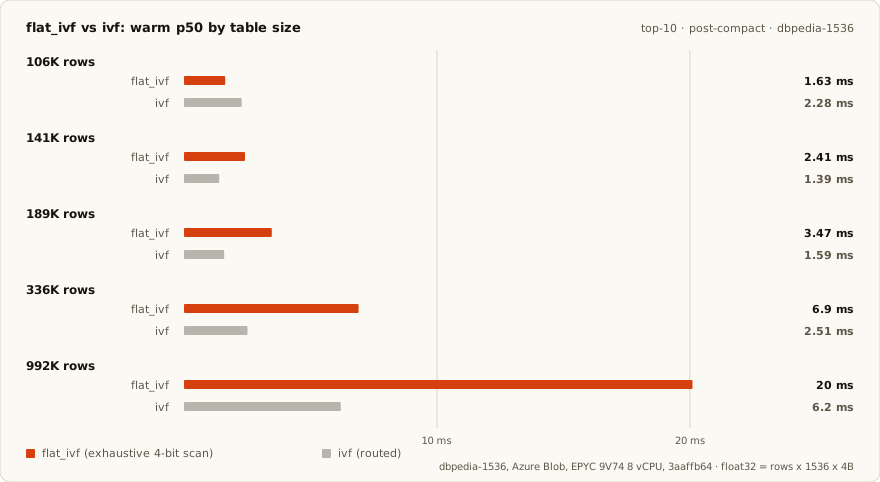
flat_ivf— varredura exaustiva sobre um plano de 4 bits; sem clusters, sem grafo, sem plano de reclassificação. Não busca nada para servir, então frio é igual a quente e a latência citada é um pior caso. Linear em linhas: 1,6 ms a 100K, 20 ms a 1M. O recall é definido pelo codec (~0,94) e não muda com a escala. Mais rápido que o caminho roteado abaixo de ~130K linhas (gráfico acima). Apenas cosseno.ivf(padrão) — o único modo que escala além da RAM. O índice vive no armazenamento de objetos e pagina pelo cache recuperável; a memória fixada permanece perto de 100 MiB em qualquer escala.hnsw_ivf— caminhada em grafo em um plano int8, reclassificação exata no feixe final. Precisa do grafo residente, o que o limita a ~10M de linhas.- Todo modo recai na varredura roteada quando não pode servir uma consulta; mudar o modo pode custar recall ou latência, nunca correção.
SQL
O planejamento e a execução de SQL usam Apache DataFusion. O Infino aproveita os índices que mantém para FTS para acelerar consultas SQL podando bytes que não precisa tocar. Por exemplo, o DataFusion poda colunas numéricas ordenadas via limites min/max, mas o Infino usa Bloomfilters, FSTs, bitmaps e outras estruturas de dados geralmente não disponíveis no DataFusion. Por exemplo, quando uma cláusula WHERE atinge uma coluna que tem um índice de texto completo, o Infino consulta o valor nesse índice primeiro e entrega ao DataFusion os números das linhas correspondentes, então o scan decodifica apenas essas linhas em vez da coluna inteira.
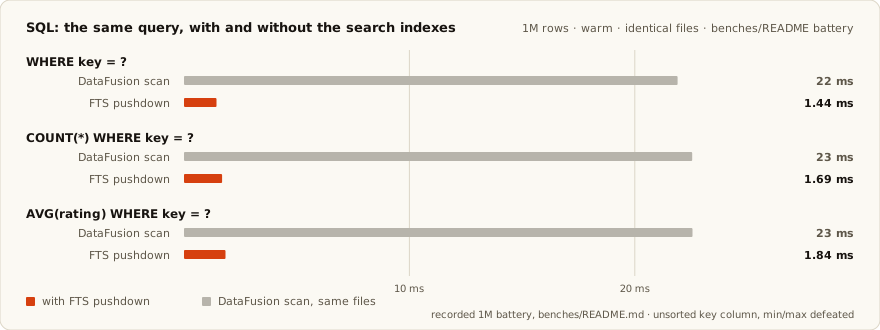
O gráfico mostra esse lookup ligado e desligado — mesma consulta, mesmos arquivos:
Reproduzir
INFINO_BENCH_SUPERTABLE_DOCS=1000000 cargo bench -- supertable sql warm
A bateria emite ambos os braços — a mesma consulta através do lookup de índice e através do scan simples.
- Igualdade em uma coluna não ordenada, onde as estatísticas min/max do Parquet não podem pular nada: 21,9 ms sem o lookup de índice, 1,44 ms com ele. COUNT e AVG sobre o mesmo predicado: ~22,5 ms → ~1,8 ms.
- Antes de tudo isso, min/max por arquivo, Bloom e resumos de termos descartam arquivos inteiros, e um agregado totalmente respondido pelas estatísticas da tabela nunca faz scan.
Busca Híbrida
A combinação de funções SQL e de busca torna mais simples expressar consultas complexas.
bm25_search, vector_search, hybrid_search, token_match e exact_match são funções
de valor de tabela SQL que permitem que resultados de busca se componham como tabelas SQL comuns.
Os conjuntos de resultados classificados são relações, então operações como recuperação, filtros, junções e agregações se compõem em uma única instrução contra um único snapshot fixado.
SELECT   _id, title, score
FROM     hybrid_search(                       -- FTS + vector, fused by RRF
           'logs', 'body', 'disk full',       --   the text side
           'embedding', :q, 50                --   the vector side, top 50
         )
WHERE    level = 'error'                      -- pushed-down filter
  AND    ts > now() - interval '24 hours'     -- on the same pass
ORDER BY score DESC                           -- one fused ranking
LIMIT    10;
Perguntas de acompanhamento podem permanecer em SQL, embutidas na mesma consulta. Ir de "encontrar erros de disco cheio" a "qual time os teve" leva uma única consulta.
SELECT   s.team,
         count(*)      AS hits,
         avg(h.score)  AS relevance
FROM     hybrid_search('logs', 'body', 'disk full', 'embedding', :q, 1000) AS h
JOIN     services s ON s.id = h.service_id
WHERE    h.ts > now() - interval '7 days'
GROUP BY s.team
ORDER BY hits DESC;
Limitações
- As tabelas são somente de acréscimo e ordenadas por tempo. Atualizações são exclusão mais inserção via tombstones, e não há transações entre tabelas. Este não é um armazenamento OLTP.
- Gravações passam por um único slot de escrita, então há um escritor por tabela por vez. Leitores são ilimitados e nunca são bloqueados.
- Esta é uma biblioteca com superfície SQL e Arrow. Não há daemon, endpoint REST ou cluster para operar.
O crate é 0.x e a API ainda pode mudar. A superfície pública é fixada por public-api.txt.
Construindo um agente?
Infino é uma camada de dados poderosa para agentes. Busca híbrida e SQL permitem consultas mais expressivas em formato mais compacto, com menor gasto de tokens em LLMs — por exemplo, em code-context, nosso plugin do Claude Code. Use para exaustão de dados de agentes, armazenamento de corpora para busca ou memória de agentes. Transcrições, embeddings e metadados podem ser armazenados em uma tabela, recuperados por significado, palavra-chave ou SQL — em memória ou sobre armazenamento de objetos, sem serviço para executar:
- infino-mcp — dê a qualquer cliente MCP (Claude Code,
Claude Desktop, Cursor, VS Code) recuperação por palavra-chave, semântica, híbrida e SQL sobre suas
tabelas. Modelo de embedding local, somente leitura por padrão, gravações atrás de uma flag.
npm i @infino-ai/mcp-server, ou direto do Registro MCP. - infino-cli — as mesmas tabelas do seu shell: SQL, busca de texto completo e vetorial contra um caminho ou bucket. Inspecione o que o agente armazenou, escreva scripts para as partes que não precisam de um modelo.
- infino-analytics — um kit de referência para construir produtos de análise sobre Infino: API de visualização e dashboard, além de Fino, uma camada conversacional — um exemplo completo e funcional de um agente sobre tabelas Infino.
Documentação
A documentação completa está em infino.ai/docs. Comece aqui:
- Início rápido — conecte, crie uma tabela, execute sua primeira busca
- Conceitos principais — uma tabela, quatro maneiras de consultá-la
- Guia de busca — recuperação de texto completo, vetorial e híbrida
- Busca híbrida em Parquet — BM25 e vetor em uma única passagem classificada sobre um arquivo Parquet
- Referência SQL — as funções de valor de tabela de busca e como combiná-las
- Memória de agente — recuperação como memória de longo prazo de um agente sobre armazenamento de objetos
- Integração MCP — recuperação híbrida e SQL para Claude, Cursor e VS Code
- Interoperabilidade Parquet — leia o mesmo arquivo com DuckDB, pyarrow e DataFusion
- Embeddings e armazenamento — traga seus próprios vetores; execute em disco local, S3, GCS ou Azure
As mesmas páginas estão disponíveis como fonte Markdown no GitHub: início rápido, conceitos principais, busca, busca híbrida em Parquet, referência SQL, memória de agente, MCP, interoperabilidade Parquet, embeddings, armazenamento.
Neste repositório:
- FAQ — respostas curtas para perguntas comuns
- Como o Infino se compara — como ele se relaciona com bancos de dados vetoriais, mecanismos de busca e mecanismos de consulta
Referências de design (neste repositório):
- Visão geral — o modelo mental e como isso se compara
- Formato Superfile — como os índices se encaixam dentro do Parquet
- Camada Supertable — manifesto, commit, fan-out de consulta
| Linguagem | Pacote | Exemplos |
|---|---|---|
| Python | infino-python/ | examples/ |
| Node.js | infino-node/ | examples/ |
| Rust | docs.rs/infino | examples/ |
Desenvolvimento
git clone git@github.com:infino-ai/infino.git && cd infino
cargo build
cargo run --example demo
make ci                # gates before a PR
make readme-charts     # regenerate the charts above
MSRV 1.95. Versões de Python e Node em suas próprias linhas SemVer (docs/versioning.md). Veja CONTRIBUTING.md. Licenciado sob Apache-2.0.