Code Context
Busca de código local para agentes de codificação de IA — pesquisa híbrida por palavras-chave + semântica com ranqueamento de relevância SQL sobre um índice de arquivos simples. CLI e servidor MCP, sem contas ou chaves.
Documentação




code-context é a camada de recuperação sob seu agente de codificação: um índice local sobre todo o repositório (por palavra-chave, semântico, híbrido e SQL), acessado por meio de um servidor MCP e uma CLI, com o índice armazenado em arquivos simples dentro do seu repositório. Seu agente responde perguntas sobre o código sem lê-lo arquivo por arquivo.
A regra geral: quanto mais uma pergunta abrange o repositório, mais isso economiza, porque a resposta vem de um índice ranqueado em vez de puxar o código-fonte para o contexto um arquivo por vez.
No seu próprio código, ~30-40% menos tokens e ~50% menos chamadas de ferramentas (então as respostas também chegam mais rápido — perguntas de agregação rodam cerca de 2× mais rápido). O harness está no repositório, então você pode reproduzi-lo no seu próprio código.
Experimente ao vivo (prévia antecipada): faça perguntas sobre qualquer repositório público do GitHub em lantern.infino.ai, um agente de demonstração que roda em code-context.
- 🔎 Encontre código por palavras ou significado. Uma única passada ranqueada funde correspondência exata
de palavras-chave com similaridade semântica, e cada resultado carrega o código com
citações
path:line. - 📊 Faça perguntas que o grep não responde. A busca funciona como uma função de tabela
SQL, então "quais arquivos têm mais código sobre X" é uma única consulta:
ranqueado por relevância, contabilizado por
GROUP BY. - ⚡ Busca em segundos, sempre atualizado. O índice de palavras-chave é confirmado antes mesmo do modelo de embedding terminar de baixar, os vetores são preenchidos em segundo plano, e edições são ressincronizadas incrementalmente: apenas arquivos alterados são re-chunked e re-embedados.
- 🔒 Nada sai da sua máquina. Sem contas, sem chaves de API, sem servidor de banco de dados, sem telemetria. O embedding é um pequeno modelo local, baixado uma vez; depois disso tudo funciona offline.
Construído sobre infino, um motor de recuperação rápido que executa SQL, busca de texto completo e busca vetorial sobre uma única cópia dos seus dados. Dados de texto e numéricos são armazenados como Parquet compatível com a especificação, e o mesmo motor lida com logs, documentos e memória de agente.
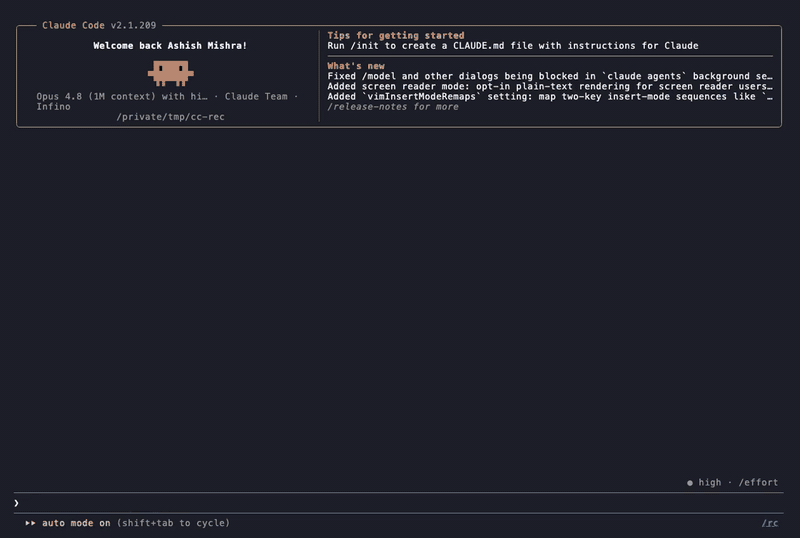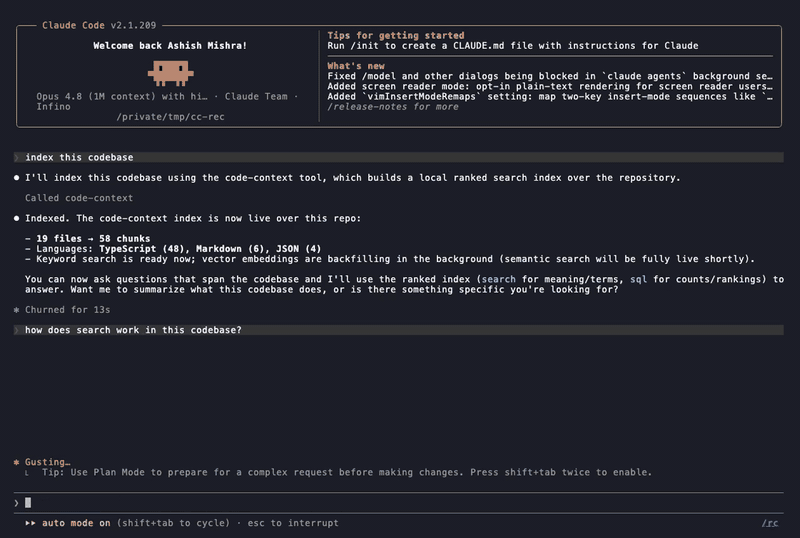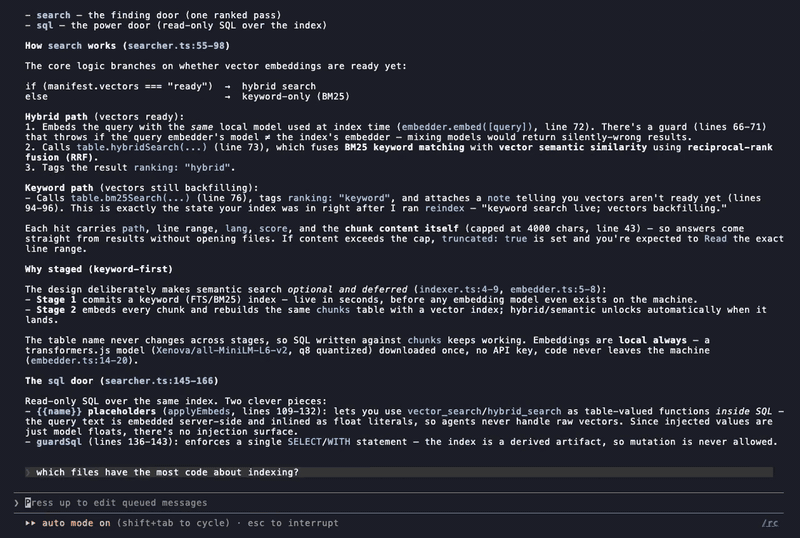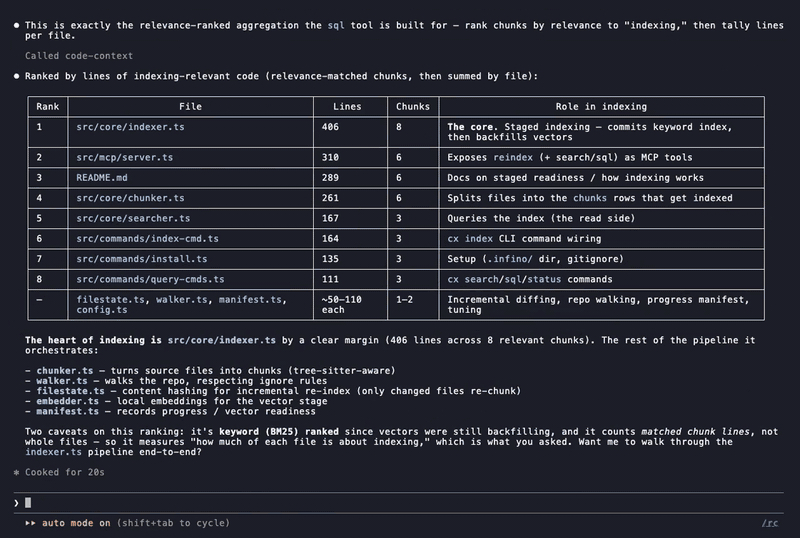
Claude Code respondendo perguntas sobre um repositório através do code-context: indexe-o, depois pergunte, e ele busca e usa SQL por conta própria.
Início rápido
Instale o plugin do Claude Code — nada para colar em uma configuração:
/plugin marketplace add infino-ai/code-context
/plugin install code-context@infino-ai
Ele registra as três ferramentas do code-context com alwaysLoad já definido, então o
agente as mantém à vista e busca diretamente no índice em vez de cair
na busca simples de arquivos.
Não está no Claude Code, ou prefere um comando de uma linha? Adicione-o como servidor MCP:
claude mcp add-json code-context -s user '{"command":"npx","args":["-y","@infino-ai/code-context","mcp"],"alwaysLoad":true}'
A flag alwaysLoad fixa este pequeno conjunto de ferramentas para que, em uma configuração com muitos servidores
MCP — onde clientes adiam definições de ferramentas atrás de uma etapa de busca de ferramentas — o
agente não perca o índice e caia na busca simples de arquivos. (Use ou o plugin
ou este comando, não ambos.)
Depois é só fazer uma pergunta sobre o código. O primeiro search ou sql em um
repositório não indexado constrói o índice inline e responde na mesma chamada: a busca
por palavras-chave fica ativa em segundos, e os vetores são preenchidos em segundo plano. (Prefere
iniciar você mesmo? A ferramenta reindex faz a mesma construção sob demanda.)
Testado em CI no Linux x64 (glibc) e macOS arm64; linux-arm64, musl e Windows-via-WSL devem funcionar através dos bindings pré-compilados do motor, mas não são cobertos pelo CI.
Avaliação
Execuções reais de agentes sobre uma suíte de perguntas e respostas sobre código (claude-sonnet-4-6, o mesmo prompt mínimo para ambas as vias), em um repositório que o modelo não memorizou — infino, o motor sobre o qual isto é construído — porque esse é o caso realista para seu código privado. A linha de base são ferramentas de arquivo padrão incluindo Bash; a via code-context são as mesmas ferramentas mais o servidor MCP. Medido em três eixos:
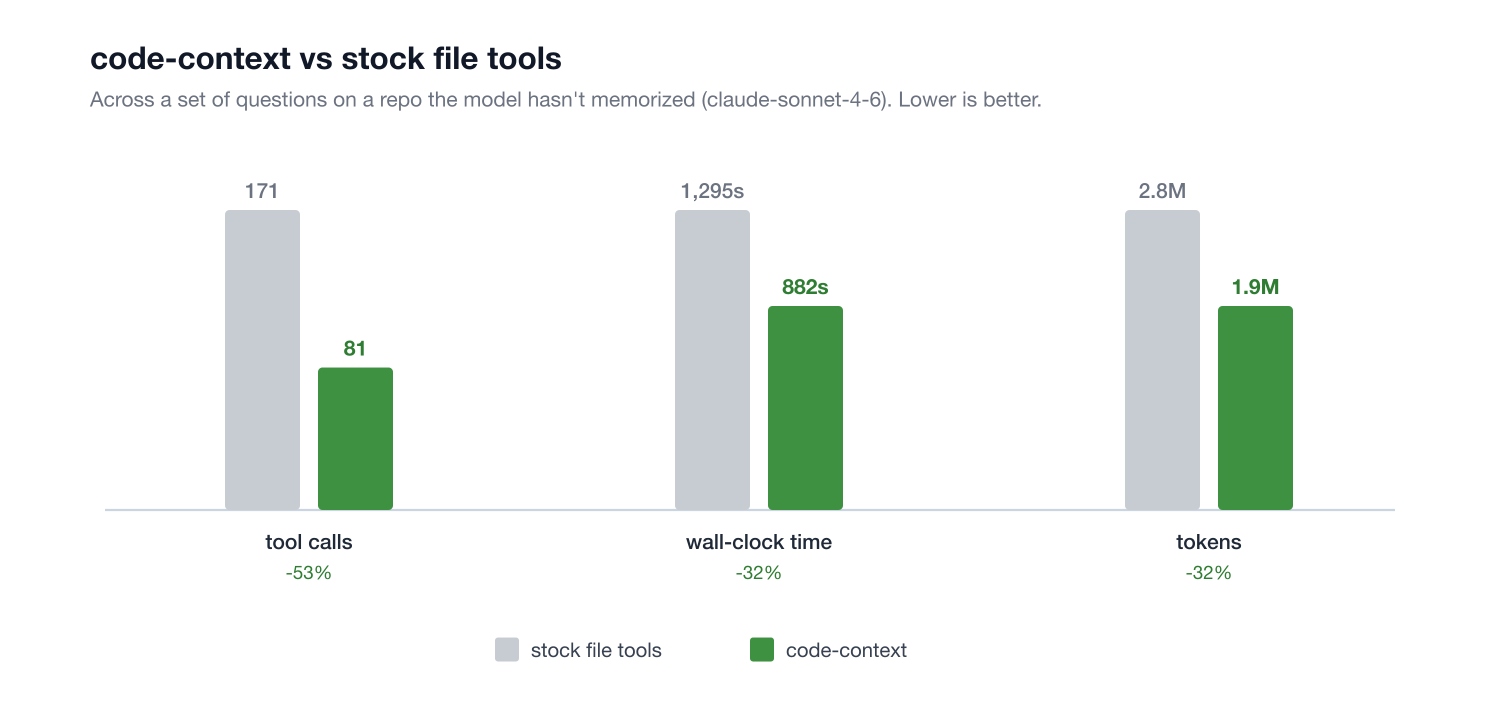
| Categoria | Tokens | Chamadas de ferramentas | Tempo de parede |
|---|---|---|---|
| Agregação ("mais código sobre X") | -43% | -71% | -48% |
| Compreensão ("como X funciona") | -29% | -27% | -13% |
| Combinado | -32% | -53% | -32% |
Agregação é a vitória estrutural — busca ranqueada composta com GROUP BY,
que ferramentas de arquivo não conseguem expressar em nenhum orçamento — e ela reduz aproximadamente pela metade
o tempo de ponta a ponta. Esses números são em um modelo forte; modelos mais fracos e baratos
exploram de forma menos eficiente, então as economias tendem a ser maiores lá. Em
busca pontual de símbolos, onde um único grep já é barato, um índice
iguala as ferramentas de arquivo em vez de superá-las.
Metodologia completa e tabelas por pergunta estão em
docs/benchmark.md, com o harness em
bench/ para que você possa rodar as mesmas vias no seu próprio repositório.
O que você obtém
Um índice e uma superfície de ferramentas deliberadamente pequena para agentes:
| Ferramenta | O que faz | Quando agentes a usam |
|---|---|---|
search | Uma passada ranqueada fundindo correspondência exata de palavras-chave (BM25) com similaridade semântica (fusão de rank recíproco). Os resultados carregam o conteúdo dos chunks, então as respostas vêm direto dos resultados. | Um padrão forte para encontrar e entender código: como um subsistema funciona, código por significado ou termo exato, contexto antes de uma mudança, implementações similares — identificadores exatos e paráfrases na mesma chamada. |
sql | SQL somente leitura sobre o índice, com as funções de busca ranqueada (bm25_search/hybrid_search) utilizáveis como relações de valor de tabela. | Contagens, rankings, agregações sobre todo o repositório em uma única consulta. |
reindex | Sincronização incremental (o servidor também sincroniza automaticamente em segundo plano). | Após edições significativas. |
Três ferramentas é um design deliberado: uma forma de encontrar, uma forma de contar, uma forma de manter atualizado. Cada ferramenta de recuperação quase duplicada adicional piora a seleção de ferramentas de um agente, e a metade de palavras-chave da busca híbrida já ranqueia termos de identificadores exatos no topo, então uma ferramenta léxica separada não tem mais função.
O movimento SQL
Busca-como-tabela compõe com agregação. Ranqueado por relevância, contabilizado por SQL, uma passada do motor:
SELECT path, SUM(end_line - start_line + 1) AS lines, COUNT(*) AS chunks
FROM bm25_search('chunks', 'content', 'vector index quantization', 300)
GROUP BY path ORDER BY lines DESC LIMIT 15
hybrid_search(...) e vector_search(...) funcionam da mesma forma. A CLI e o
servidor MCP incorporam os placeholders {{name}} no lado do servidor, então agentes nunca
lidam com vetores brutos.
Prontidão em etapas
cx index confirma o índice de palavras-chave (BM25) primeiro. Em um repositório de ~3.000 chunks
isso leva menos de um segundo, então a busca funciona antes mesmo de qualquer modelo de embedding
existir na máquina. Os vetores são preenchidos em segundo plano com um modelo local
(baixado uma vez, sem chave; cerca de dois minutos para esse mesmo repositório), e
o ranking híbrido/semântico é desbloqueado automaticamente quando eles chegam. Se a etapa
de vetores falhar, a busca por palavras-chave permanece ativa e o índice diz isso honestamente.
O modelo padrão otimiza qualidade-por-minuto. Veja docs/embedder-eval.md para saber como ele foi escolhido.
Seu índice são apenas arquivos
Tudo vive em .infino/ na raiz do seu repositório (adicionado ao seu
.gitignore automaticamente na primeira indexação): arquivos simples que você pode copiar,
armazenar em cache no CI ou colocar em armazenamento de objetos. É um índice vivo que o motor consulta no lugar, não um snapshot que você
exporta e passa adiante.
Configuração para agentes
code-context é um servidor MCP sobre stdio, então qualquer cliente MCP funciona. Registre-o
uma vez e as ferramentas (search, sql, reindex) ficam disponíveis para o
agente.
Claude Code
Instale como plugin — alwaysLoad já definido, nada para colar em uma
configuração:
/plugin marketplace add infino-ai/code-context
/plugin install code-context@infino-ai
Ou registre-o como servidor MCP diretamente:
claude mcp add-json code-context -s user '{"command":"npx","args":["-y","@infino-ai/code-context","mcp"],"alwaysLoad":true}'
alwaysLoad: true fixa as ferramentas do code-context no contexto para que o agente busque
diretamente no índice. Em sessões com muitos servidores MCP, o Claude Code adia
definições de ferramentas atrás de uma etapa de busca de ferramentas; sem alwaysLoad o agente pode
perder o code-context e cair em grep/read. É um conjunto pequeno, sempre carregado
(três ferramentas). Omita-o (ou use o mais curto claude mcp add code-context -- npx -y @infino-ai/code-context mcp) se preferir deixar as ferramentas adiadas.
Use ou o plugin ou o comando add-json, não ambos. Eles registram o
mesmo servidor code-context, então rodar ambos apenas colide.
Para uma equipe, faça commit de um .mcp.json com escopo de projeto na raiz do repositório para que
todos o obtenham (após a aprovação única do servidor de projeto):
{ "mcpServers": { "code-context": { "command": "npx", "args": ["-y", "@infino-ai/code-context", "mcp"], "alwaysLoad": true } } }
Cursor
Adicione em .cursor/mcp.json:
{ "mcpServers": { "code-context": { "command": "npx", "args": ["-y", "@infino-ai/code-context", "mcp"] } } }
Codex CLI
Em ~/.codex/config.toml (observe que a chave é mcp_servers):
[mcp_servers.code-context]
command = "npx"
args = ["-y", "@infino-ai/code-context", "mcp"]
Gemini CLI
Em ~/.gemini/settings.json:
{ "mcpServers": { "code-context": { "command": "npx", "args": ["-y", "@infino-ai/code-context", "mcp"] } } }
Windsurf, Cline e outros clientes MCP
Configuração MCP stdio padrão:
{ "mcpServers": { "code-context": { "command": "npx", "args": ["-y", "@infino-ai/code-context", "mcp"] } } }
Aponte o servidor para um repositório explicitamente com env: { "CX_ROOT": "/path/to/repo" }
quando o diretório de trabalho do cliente não for o repositório.
Ferramentas: search, sql, reindex (sincronização incremental: um repositório inalterado é
um no-op rápido, e o servidor também sincroniza automaticamente em segundo plano conforme as consultas
chegam, então os resultados acompanham suas edições sem ninguém pedir).
Múltiplos repositórios em uma sessão. Cada ferramenta aceita um path opcional (uma
raiz de repositório absoluta). Omita-o e o servidor usa sua raiz de inicialização; defina-o para
mirar um repositório específico quando uma sessão abrange mais de um. Uma única instância
de servidor atende a todos, cada um com seu próprio índice em seu próprio .infino/ —
sem reiniciar, sem configuração por repositório.
Configuração
| Variável | Padrão | Propósito |
|---|---|---|
CX_INDEX_DIR | <repo>/.infino | onde o índice vive |
CX_SEARCH_K | 10 | número padrão de resultados que search retorna (também definível por chamada e via flag -k da CLI) |
CX_MAX_FILES / CX_MAX_FILE_BYTES | 20000 / 1MB | limites de indexação (arquivos acima do limite de arquivos são deixados de fora; search/sql então marcam o índice como parcial para que uma ausência não seja lida como prova) |
CX_ROOT | diretório atual | raiz de repositório padrão para o servidor MCP / CLI quando não executado a partir do repositório (cada chamada de ferramenta pode sobrescrevê-la com um argumento path) |
CX_AUTO_INDEX | ligado | 0 faz uma consulta em um repositório não indexado gerar erro em vez de construir o índice inline no primeiro search/sql |
CX_AUTO_SYNC | ligado | 0 desativa a sincronização de desatualização em segundo plano do servidor MCP |
CX_SYNC_INTERVAL_SECS | 30 | debounce de sincronização automática entre verificações de desatualização |
CX_NO_EMBED | desligado | modo somente palavras-chave para o servidor MCP (pula a etapa de vetores) |
CX_NO_RECEIPT | desligado | 1 desativa a contabilidade de uso — o recibo por chamada nos resultados e o registro cx usage |
Cada resultado de search / sql carrega um recibo de uso — uma linha local e concisa
mostrando os tokens que retornou, os arquivos que abrangeu e um total de sessão
em andamento (ex.: retornou ~1,2k tokens | 4 chunks / 3 arquivos | sessão ~8,4k em 7 consultas). Every figure is a ~ estimativa, calculada em processo — nada sobre
suas consultas ou código sai da máquina.
CLI
O mesmo índice também é acessível pelo terminal, para scripts, CI ou inspeção de resultados por conta própria. Instale o binário e execute qualquer comando dentro de um repositório:
npm install -g @infino-ai/code-context
cx index [path]           sync the index (incremental; --full rebuilds, --watch follows edits)
cx search <query>         exact terms + meaning, one ranked pass           (-k hits)
cx sql <statement>        read-only SQL; --embed q="text" fills {{q}}
cx status                 what the index holds, how fresh, vector readiness
cx usage                  ledger of queries run and what each returned  (-n, --all, --clear, --json)
cx mcp                    serve the MCP tools over stdio
cx usage lê o ledger local em .infino/usage.jsonl - cada chamada de
search / sql (via CLI ou servidor MCP) adiciona uma linha registrando a consulta e
um resumo compacto do que retornou (caminhos e intervalos de linhas para busca, contagem de
linhas para SQL), além dos números de tokens do recibo. É uma visão determinística e
independente de modelo do que passou pelo índice - não é necessário servidor ou agente em
execução para ler de volta. CX_NO_RECEIPT=1 desativa tanto o recibo inline quanto
este ledger.
Com que frequência o agente realmente o utiliza?
cx usage também pode mostrar, por sessão, em quantos dos seus prompts o code-context
foi usado - ex.: code-context used in 2 of 3 prompts (2 calls). O servidor MCP
só pode contar suas próprias chamadas, não seus prompts, então essa proporção vem de dois
hooks do Claude Code que mantêm uma contagem local (nada é enviado a lugar algum). Adicione-os
às configurações do seu Claude Code (~/.claude/settings.json ou um
.claude/settings.json de projeto):
{
  "hooks": {
    "UserPromptSubmit": [
      { "hooks": [{ "type": "command", "command": "cx usage --hook" }] }
    ],
    "PostToolUse": [
      { "matcher": "mcp__code-context.*", "hooks": [{ "type": "command", "command": "cx usage --hook" }] }
    ]
  }
}
cx usage --hook lê o evento do stdin, atualiza .infino/prompt-stats.json,
e não imprime nada. Se você executar code-context via npx, use
npx -y @infino-ai/code-context usage --hook como comando.
O que é, e o que não é
A área de atuação do code-context é a recuperação de conteúdo ranqueado e a agregação de
relevância de conteúdo: encontrar código por palavras ou significado, ranquear arquivos
inteiros por quanto eles tratam de um tópico, sempre com recibos path:line. Ele
deliberadamente não faz inteligência estrutural de código (rastreamento de grafo de
chamadas, detecção de código morto, resolução de tipos). Ferramentas que fazem isso são
complementares: servidores MCP se empilham, então execute ambos.
Arquitetura
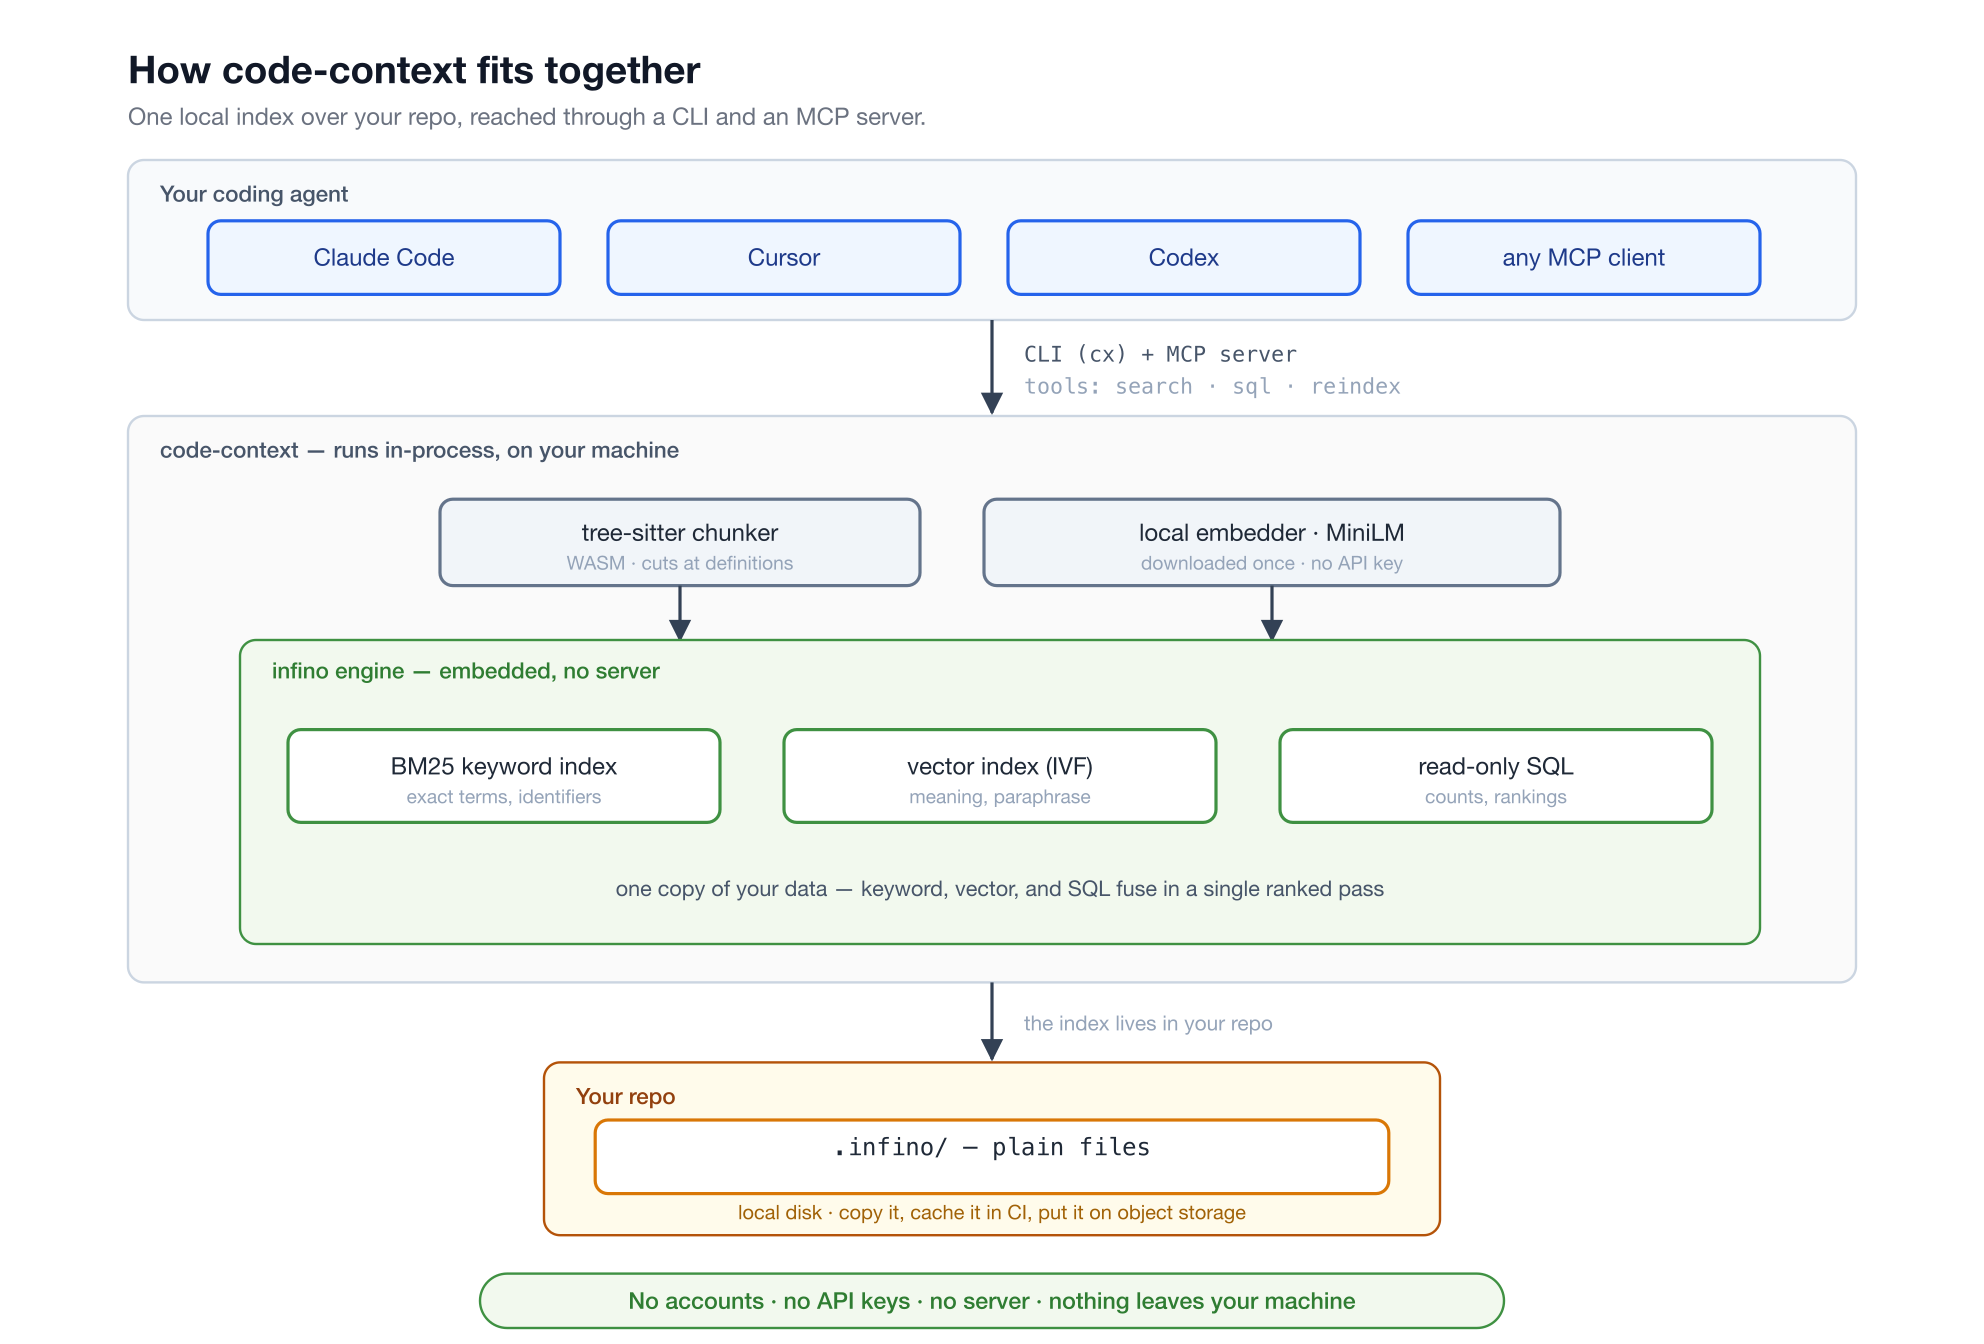
- Fragmentação: tree-sitter (WASM, sem compilações nativas) corta nos limites de
definição para TypeScript/JS, Python, Rust, Go, Java, C/C++, Ruby, C#, PHP;
Markdown divide em cabeçalhos; todo o resto usa janelas fixas como fallback.
Cada fragmento carrega
path, start_line, end_line, lang, content. - Índice: tabelas infino em
.infino/: índices vetoriais BM25 (FTS) e IVF sobre uma única cópia dos dados, consultados em processo via binding Node. Sem servidor. - Embeddings: sempre locais. Um modelo pequeno (escolhido por uma avaliação medida) baixado uma vez; sem chave, sem rede por consulta, o código nunca sai da máquina. Consultas são incorporadas com o mesmo modelo com que o índice foi construído, e uma incompatibilidade é um erro claro, não resultados silenciosamente errados.
- Atualização: incremental por design. Um mapa de estado por arquivo (pré-filtro de
tamanho/mtime, depois hash de conteúdo) significa que uma sincronização re-fragmenta e
re-incorpora apenas os arquivos que mudaram: em um repositório de ~3.000 fragmentos, uma
árvore inalterada é verificada em ~20ms e uma edição de um arquivo sincroniza em ~0,7s com
vetores mantidos atualizados (números para repositórios maiores no
benchmark). O servidor MCP sincroniza automaticamente em segundo
plano conforme as consultas chegam (nunca bloqueando uma consulta),
cx indexé incremental por padrão (--fullpara reconstruir), ecx index --watchsincroniza em eventos de arquivo.
Saiba mais
- Busca de código para agentes de codificação - o modelo de rastreamento vs. recuperação e quando um índice economiza tokens.
- FAQ - o que é, quando usar, garantias de apenas-local, atualização.
- Compensações - os limites honestos.
- Benchmark - resultados medidos, com um harness para reproduzi-los no seu próprio repositório.
Licença
Apache-2.0