jevnav
Verdade da página e decisões reproduzíveis para agentes de navegador: um modelo escolhe o elemento, uma barreira bloqueia ações arriscadas, e cada execução é reproduzida offline no CI.
Documentação
jevnav
Verdade da página para agentes de navegador — e decisões que podem ser reproduzidas, testadas e auditadas.




Um agente de codificação trabalhando em um código frontend recebe duas coisas do jevnav:
- Verdade da página, não pixels. Estrutura, estilos computados e controles voltam
como fatos, e
diffrelatafont-size 32px → 28pxentre um mockup e o aplicativo em execução — a forma que um agente pode corrigir. Sem capturas de tela no loop de decisão. - Evidência, não confiança. Cada ação é uma decisão Jev com uma probabilidade
calibrada, as arriscadas são bloqueadas, e toda a execução é um rastro que
replayverifica novamente offline no CI: uma mudança no site que quebra uma decisão gravada sai com código 1, sem chamada de modelo e sem chave de API.
Testes baseados em seletores quebram no momento em que um rótulo muda, e agentes de navegador com LLM
são confiantes, não auditáveis e ocasionalmente errados. jevnav fica no meio
(a versão mais longa desse argumento: docs/why.md):
- Jev escolhe o elemento. A lista de candidatos da página atual é transformada
em uma pergunta de escolha; o modelo responde com um elemento e uma probabilidade
calibrada. No modo de loop (
jevnav go), uma única solicitação também responde o que fazer, se o objetivo já foi atingido e qual valor de contexto digitar. - Cada decisão é registrada. O rastro contém os candidatos como o modelo os viu, a escolha, a probabilidade e o custo — um arquivo JSONL por execução.
- Ações arriscadas são bloqueadas.
pabaixo do limite, ou uma intenção que pareça destrutiva, vai para um humano em vez de clicar. replayé o teste de regressão. Offline, sem chamada de modelo: re-resolva cada decisão registrada contra a página como ela está agora. Uma mudança no site que quebre um alvo falha no CI; todo o resto é relatado como deriva, não como ruído.
Verdade da página para o seu agente
Os fatos que um agente de codificação precisa sobre uma página renderizada, sem captura de tela:
outline(selector) para a estrutura da região (tags, títulos, texto, caixas),
styles(selector, props) para os valores computados que o navegador resolveu,
page_state() para os controles que o jevnav pode ver.
Mockup vs. aplicativo, como fatos em vez de pixels — jevnav diff relata diferenças de estrutura e
estilo e sai com código 1 em caso de deriva:
| element                 | property      | mockup | app  |
|---|---|---|---|
| h1 [Pricing]            | font-size     | 32px   | 28px |
| button#cta [Start free] | border-radius | 8px    | 4px  |
Um font-size 32px → 28px é algo que um agente pode corrigir; uma diferença de pixel vermelho não
é. Depois que o aplicativo corresponder, fixe o resultado (goal(..., success="<selector>"))
e replay --execute verifica novamente no CI. Passo a passo completo:
Correspondendo um mockup ao aplicativo.
Instalação
uv tool install jevnav          # or: pip install jevnav (the MCP server is included)
playwright install chromium     # one-time browser download
Publicado no PyPI, listado no
registro MCP
como io.github.dtduc-git/jevnav, e a ação de reprodução está no
GitHub Marketplace.
jevnav run precisa de uma chave de API TypeSafe (TYPESAFE_API_KEY, ou
~/.config/typesafe/apikey.txt). jevnav replay não precisa de nenhuma — esse é o ponto.
Início rápido — deixe o Jev dirigir
jevnav go --goal "sign in with the demo account and open the pricing page" \
  --start https://app.example.com/login \
  --context email=demo@example.com --context password="${ACME_PASSWORD}" \
  --success "#pricing.visible" \
  --report goal.md
status: done — outcome verified against the page
steps: 5 — auto 4, review 0, blocked 0
Uma solicitação Jev por etapa, e cada etapa é bloqueada e rastreada. O loop para
quando o modelo diz que o objetivo está concluído, quando nenhum elemento listado pode progredir
(stuck), quando o bloqueio quer um humano (review), quando a página para de mudar
(no_progress), ou em --max-steps. --dry-run decide sem agir.
done é uma afirmação, não evidência. Passe --success <selector> e a afirmação
é verificada contra a página: verified, unverified (o seletor não está
lá — a execução falha), ou "não verificado" quando você não passou nenhum seletor.
Início rápido — um fluxo com script
# flows/acme-login/flow.yaml
id: acme-login
start: https://app.example.com/login
steps:
  - intent: "Sign in to the existing account"
    action: click
  - intent: "Type the password"
    action: fill
    value: "${ACME_PASSWORD}"   # read from the environment, never written to the trace
  - intent: "Submit the login form"
    action: click
    expect: "button[type=submit]"   # optional ground truth, used to score the run
jevnav run flows/acme-login/flow.yaml --report run.md
jevnav replay acme-login.trace.jsonl --report replay.md   # offline, deterministic
jevnav diff new-ui.html http://localhost:3000             # mockup vs app, exit 1 on drift
run percorre o fluxo: extrair candidatos → perguntar ao Jev → bloquear → agir → registrar.
replay verifica novamente o rastro contra o site ao vivo, sem modelo no loop
(e com --execute ele reexecuta as ações registradas e verifica o
seletor --success registrado, então uma execução inteira de agente vira um teste de CI):
steps 3 verdicts: ok 3
Altere Sign in para Log in no site e a mesma reprodução relata:
[01] changed   Sign in to the existing account
      no element now has 'button|sign in' (was 'Sign in' / 'button')
Código de saída 1, com o motivo — esse é o bloqueio do CI.
pytest — intenções em um teste comum
A fixture jev acompanha o pacote, então um teste Playwright normal recebe decisões Jev
sem mudar como você escreve testes — e cada teste grava um rastro
que é reproduzido no CI:
def test_sign_in(jev):
    jev.goto("https://app.example.com/login")
    jev.fill("the email address", "demo@example.com")
    jev.fill("the password field", "${DEMO_PASSWORD}")
    jev.click("the sign-in button")
    jev.expect("#welcome")
DEMO_PASSWORD=... pytest --jev-trace-dir=traces
DEMO_PASSWORD=... jevnav replay --execute traces/test_sign_in.trace.jsonl  # offline, no key
jev.expect é registrado no rastro, então a reprodução verifica o resultado
além de reexecutar as ações. Um veredito review falha o teste antes da
ação ser executada, valores ${VAR} são registrados apenas pelo nome, e jev.page é a
página Playwright real para todo o resto. Exemplo executável, com um rastro
confirmado que qualquer um pode reproduzir: examples/pytest-interop/.
Jogos (a forma Doom)
Um jogo não tem lista de candidatos para extrair, então play assume a outra forma: você
dá a ele uma sonda de estado JS e um pequeno conjunto de ações, e o Jev decide a uma taxa fixa
enquanto o jogo continua rodando — teclas de movimento permanecem pressionadas entre decisões, então a
última resposta se aplica enquanto o modelo pensa. Exatamente como o Jev joga Doom (alimentado
com estado estruturado como texto, ~10 chamadas/segundo, sem imagens).
jevnav play \
  --goal "catch the green blocks, dodge the red ones" \
  --url "examples/game/index.html?seed=7" \
  --state-js examples/game/state.js \
  --actions "left=ArrowLeft" --actions "right=ArrowRight" \
  --rate 4 --seconds 60 --score-js "window.jevnavScore()" \
  --ready-js "() => !!window.jevnavState" \
  --report play.md
Medido no jogo incluído (examples/game/), 60 segundos, três sementes, mesma
taxa de decisão para ambos os lados:
| semente | controle aleatório @3/s | Jev @3/s |
|---|---|---|
| 3 | 0 | 1 |
| 7 | 1 | 6 |
| 11 | 1 | 2 |
| média | 0.67 | 3.0 |
A latência do Jev foi de 312ms p50 do Vietnã, que é o que limita o loop a ~3
decisões/segundo (a demo Doom da TypeSafe rodou ~10/s de uma rede dos EUA). Execute
--policy random para seu próprio controle, e guarde o rastro: é a evidência.
O que funciona onde: um jogo DOM (como o incluído, ou 2048) expõe estado ao
JS, então uma sonda é fácil. Um jogo <canvas>/WebGL — ou Flash — não tem estado no
DOM; ele precisa que o próprio jogo exponha um (Chocolate Doom WASM expõe, que é
como os agentes Doom de navegador o leem). jevnav ainda não tira capturas de tela e
não faz decisões de pixel, deliberadamente: é isso que mantém as decisões reproduzíveis.
Seu próprio Chrome (logins, cookies, extensões)
Três maneiras de obter um navegador:
jevnav go --goal "..."                      # default: fresh headless Chromium, no cookies
jevnav go --goal "..." --user-data-dir ~/.cache/jevnav-profile --headed
jevnav go --goal "..." --cdp http://127.0.0.1:9222
--user-data-diré um perfil Chromium persistente: execute uma vez com--headed, faça login manualmente, e toda execução posterior (headless ou não) já estará logada. O modo com janela precisa do navegador completo:playwright install chromium.--cdpanexa a um Chrome que você já tem aberto — sua sessão, suas extensões, a aba que você está olhando. Inicie-o com--remote-debugging-port=9222(ou usechrome://inspectpara encontrar a porta). jevnav escolhe a última página real que encontra e nunca fecha seu navegador.
Ambas as flags funcionam em run, go, replay e mcp. Um rastro registra o que foi
decidido, nunca qual perfil foi usado: cookies e caminhos de perfil nunca chegam a ele.
Use a mesma liberdade para autenticação: passe credenciais como contexto e deixe o objetivo preencher um formulário de login quando um cookie obsoleto seria pior que um login novo.
Bloqueios
# flows/acme-login/gates.yaml  (optional; sane defaults apply)
min_confidence: 0.9        # scripted flows: one question per step, well calibrated
loop_min_confidence: 0.5   # goal loop: four questions at once, p runs lower
risky:                                  # regular expressions, matched against
  - "\\b(delete|remove|purchase|pay)\\b"   # intent + chosen element name + role
intents:
  "delete the *": { min_confidence: 0.99 }
truncated: review                       # page had more than 255 candidates
Três vereditos, sem ambiguidade:
| veredito | significado |
|---|---|
auto | confiança igual ou acima do limite, nada arriscado — a ação é executada |
review | um humano confirma primeiro (p baixo, intenção arriscada, lista de candidatos truncada) |
blocked | nenhuma decisão foi possível (o modelo respondeu none, ou a chamada falhou) |
n/a | o loop parou sozinho (done) — nenhuma ação para bloquear |
No modo de loop, o limite de confiança é menor de propósito. Medido
em 2026-09-21: decisões corretas de loop caem em p 0.41–0.99 e as erradas em
0.39–0.47, então p não as separa. O que mantém o loop seguro é
determinístico: fill em um botão é recusado antes de ser executado, um campo sem
valor de contexto é bloqueado, duas etapas que não mudam nada param a execução, padrões
arriscados sempre vão para revisão, e o resultado é verificado contra --success.
MCP — para outros LLMs
jevnav executa seu próprio navegador e o expõe como um servidor MCP, então um agente de codificação (Claude Code, Codex, Cursor, qualquer coisa que fale MCP via stdio) pode dirigir uma página através de decisões Jev em vez de escrever seletores:
jevnav mcp # that is the whole setup: no URL, no trace path, no flags
Nenhuma URL é necessária: o agente abre páginas ele mesmo com goto(url), então um servidor
atende a todos os domínios — uma sessão pode visitar vários sites, em várias abas. A
sessão grava jevnav-session.trace.jsonl no diretório de trabalho do cliente por
padrão (sessões anteriores são arquivadas ao lado, --no-trace opta por sair), então
cada sessão é auditável sem configurar nada.
--start <url> existe apenas como conveniência para uma configuração com escopo de projeto que
sempre começa em uma página; coloque-a na configuração desse projeto, não na sua
global. O mesmo para as escolhas por instalação: --browser, --user-data-dir (faça login em
qualquer número de sites uma vez, em um perfil), --cdp, --locale, --timezone.
Ferramentas:
Decidindo — a parte que nenhum outro MCP de navegador tem:
| ferramenta | o que faz |
|---|---|
browse(intent, action, value, min_confidence) | uma etapa: Jev escolhe o elemento, o bloqueio decide, e apenas auto age |
goal(goal, context_json, max_steps, success) | dirige o caminho todo: "entre e abra o faturamento" — success verifica o resultado; retorna done / stuck / review mais a verificação |
goto(url) | abre uma página |
page_state() | URL, título e a lista curta que o jevnav pode ver |
summary() | esta sessão: etapas, auto/revisão/bloqueado, custo, latência |
Agindo — todo o resto que um agente precisa:
| ferramenta | o que faz |
|---|---|
screenshot(path, full_page, selector) | salva um PNG para um humano (nunca usado por uma decisão) |
upload_files(paths, selector, intent) | define arquivos, em um seletor ou em um campo que o Jev escolhe |
drag(source_selector, target_selector) | arrasta um elemento sobre outro |
resize(width, height) | muda o viewport |
emulate(color_scheme, media, geolocation, offline, …) | emula mídia, localização e conectividade |
press_key(key, selector) | uma tecla ou combinação ("Control+A"), opcionalmente em um elemento |
fill_form(fields_json) | preenche vários campos em uma chamada: {seletor|intenção, valor, ação} |
wait_for(text, selector, timeout_ms) | espera algo aparecer |
scroll(direction, amount) | rola o documento |
tabs(), new_page(url), select_page(i), close_page(i) | trabalha com abas |
Inspecionando — os olhos do agente (apenas observação, nunca rastreado):
| ferramenta | o que faz |
|---|---|
console(limit, only_errors) | mensagens recentes do console e erros de página |
network(limit, only_failed) | solicitações recentes, com status |
network_detail(index, url_contains) | cabeçalhos e corpo de uma solicitação |
dialogs() | alert/confirm/prompt, com a política ou regra que os resolveu |
dialog_policy(action, match) | responde a diálogos futuros: o padrão, ou regras por texto de mensagem |
read_js(expression) | avalia JS na página |
outline(selector, limit) | estrutura de uma página ou região (tags, títulos, texto, caixas) |
styles(selector, props, limit) | estilos computados dos elementos correspondentes |
route(pattern, status, body, abort) / unroute(pattern) | simula ou bloqueia solicitações (testes) |
trace_start() / trace_stop(path) | um zip de rastro Playwright para playwright show-trace |
perf_metrics(), heap_snapshot(path) | contadores Chromium e um snapshot de heap (melhor esforço: para perfil real use chrome-devtools) |
emulate(cpu_throttle, network_conditions, …) | limitação de CPU e perfis estilo Slow-3G (chromium, via CDP) |
lighthouse(url, categories) | pontuações Lighthouse, via npx (melhor esforço: precisa de node) |
Conecte-o a um cliente (esta forma JSON é o que Cursor, Claude Desktop e VS
Code usam; Claude Code também aceita
claude mcp add --scope user jevnav -- uvx jevnav mcp):
{
  "mcpServers": {
    "jevnav": {
      "command": "uvx",
      "args": ["jevnav", "mcp"],
      "env": { "TYPESAFE_API_KEY": "..." }
    }
  }
}
Por que um agente usaria: ele não precisa do próprio Playwright MCP, não consegue clicar em um
Delete por acidente (review nunca executa; padrões de ações arriscadas são fornecidos para
nove idiomas, e você os estende em gates.yaml), e toda a sessão dele é um
rastro que jevnav replay --execute pode reexecutar no CI. O custo é de cerca de
US$ 0,00004 e 330ms por etapa; page_state e goto são gratuitos. Cada ferramenta
declara suas anotações MCP — somente leitura, destrutiva, idempotente, mundo aberto —
para que um cliente possa distinguir uma observação de uma ação antes de chamá-la.
Diálogos: respondidos por regra, não estacionados
A API síncrona do Playwright deve responder a um diálogo dentro do seu manipulador. Estacionar um para que um
humano decida depois bloqueia o renderizador e a próxima chamada nunca retorna
(medido neste código-base e depois removido). Então o jevnav responde com base em uma política que você
define antecipadamente — dialog_policy("accept", match="delete") — e registra cada
diálogo com a regra que foi acionada, para que a execução permaneça auditável.
Qual usar
| Playwright (biblioteca) | chrome-devtools-mcp | jevnav | |
|---|---|---|---|
| quem escolhe o elemento | um humano escreve seletores | o LLM, a partir de um snapshot | Jev, com uma probabilidade calibrada |
| escopo | a API completa de autoria de testes | 29 ferramentas, primitivas + criação de perfil | 33 ferramentas, atuação em nível de intenção + observação |
| ações arriscadas | o que o teste disser | o que o LLM disser | nunca executadas até um humano dizer o contrário (padrões arriscados cobrem inglês, vietnamita, alemão, francês, espanhol, português, japonês, chinês e coreano) |
| evidência de regressão | visualizador de rastreamento, reexecutar o teste | nenhuma | rastro de decisão + reprodução offline que sai com código 1 |
| verificação de resultado | expect(...) | nenhuma | seletor --success, verificado ou relatado como não verificado |
| mecanismos | chromium, firefox, webkit | chromium | chromium, firefox, webkit (--browser) |
| limitação de CPU / Slow-3G | ✅ | ✅ | ✅ (chromium, CDP) |
| cabeçalhos/corpo da solicitação | ✅ | ✅ | ✅ network_detail |
| preenchimento de formulário com vários campos | ✅ | ✅ fill_form | ✅ fill_form (seletor ou intenção) |
| combinações de teclas | ✅ | ✅ press_key | ✅ press_key |
| custo por etapa | 0 | uma rodada do LLM por etapa (~38 mil caracteres de snapshot) | US$ 0,00004 |
Este não é um argumento de substituição: os três fazem trabalhos diferentes, e executar mais de um custa uma linha de configuração (o navegador do jevnav inicia em ~20ms e é preguiçoso, então um segundo servidor é quase gratuito). O Playwright é a biblioteca com a qual você escreve uma suíte de testes — o jevnav é construído sobre ele. O chrome-devtools é o que você usa para depurar uma página: capturas de tela, console, rede, desempenho, todos os detalhes brutos no contexto do modelo, o que é exatamente certo para depuração e exatamente errado para automação. O jevnav é a camada de decisão + evidência: uma intenção entra, uma ação bloqueada sai, um rastro que é reproduzido offline. Use-o quando o mesmo fluxo precisar continuar funcionando, e o chrome-devtools quando você precisar descobrir por que ele parou.
Quando a barreira diz review
review é a ferramenta se recusando a adivinhar — e ela devolve o que você precisa para
resolver: os segundos colocados com suas probabilidades e uma dica. Medido na
página principal da Wikipédia (254 candidatos):
goal("search Wikipedia for ...")→reviewcom p=0,33 — a página tem duas maneiras plausíveis de enviar, então nada foi clicado.- O chamador relê a página e chama
browse("Click the Search button that submits the search form in the site header", "click", min_confidence=0.8)→ auto com p=0,95, clicado de verdade. goal(...)novamente →done, verificado: true contra.mw-search-results.
Então: seja específico, e se você conhece a página melhor do que o modelo, defina seu
próprio min_confidence — a barra de confiança é uma decisão do chamador. Padrões arriscados,
validação de função/valor e a verificação de resultado não podem ser substituídos.
O caminho stdio é testado de ponta a ponta no CI: um cliente MCP real se conecta a um
subprocesso jevnav mcp, lista as ferramentas, chama goal e verifica se o navegador
agiu (tests/test_mcp_server.py, sem rede, endpoint Jev falso).
CI — a Action
A Action reproduz um rastro gravado e falha quando uma mudança no site quebra uma decisão gravada. Sem chamada de modelo, sem chave de API, ~30 segundos:
- uses: dtduc-git/jevnav@v0
  with:
    trace: examples/local-demo/demo.trace.jsonl
    execute: "true"          # also re-run the recorded actions
    report: replay.md
Entradas: trace, report, execute, json, version (padrão latest do
PyPI, ou local para executar um checkout). Código de saída 1 quando um alvo mudou, ficou
ambíguo, ou um seletor --success gravado não está mais visível. @v0 é uma
tag flutuante; fixe @v0.1.1 se preferir.
Como funciona
- Candidatos são uma lista curta, não a página. Elementos interativos visíveis
ordenados por quão provável um humano agiria sobre eles — primeiro no viewport, controles
de formulário antes de botões antes de links — limitados a 120 (
--max-candidates, o limite rígido da API é 254). Medido no Hacker News (199 elementos → 40): mesma precisão, 2,8× mais rápido em uma decisão a frio e 3,8× menos tokens de entrada. Cada um carrega função, nome acessível, tipo, href, espaço reservado e um escopo (legenda/cabeçalho mais próximo) para que três campos "Email" permaneçam distinguíveis. - Impressão digital. A identidade de um elemento é
role|name(normalizada por espaços em branco e maiúsculas/minúsculas). Os rastros armazenam a impressão digital de cada candidato como foi mostrada ao modelo, para que a reprodução nunca rederive a identidade com código novo. - Decisões. Uma pergunta de escolha por etapa: o mapa de opções é a lista de candidatos,
mais
none. A decisão é gravada com probabilidades, uso e custo. - Reprodução. Reextraia a página, compare impressões digitais.
--normalize REGEXrelaxa a correspondência para mudanças conhecidas (um contador como "Carrinho (3)" → "Carrinho (4)") em ambos os lados, opcional, então o estrito ainda é o padrão.ok(encontrado),moved(encontrado em outro lugar na página),changed(sumiu),ambiguous(agora duplicado),error.changed,ambiguouseerrorfalham;movede contagens de desvio são relatadas. - Ações.
click,fill,select,check,hover,press,none. A reprodução reexecuta ações apenas com--execute, e as resolve por impressão digital — nunca por posição — para que uma página deslocada não clique na coisa errada.
Correspondendo um mockup ao aplicativo
jevnav diff new-ui.html http://localhost:3000 --report ui-diff.md
- mockup: `new-ui.html` — 'Pricing (new UX)', 7 elements
- app:    `http://localhost:3000` — 'Pricing', 4 elements
- differences: **5** structure, **4** style

## Structure (`body`)
| kind | element | detail |
|---|---|---|
| missing | p 'Three plans for every team.' | not on the other page |
| missing | section 'Enterprise Talk to sales' | not on the other page |
| missing | button 'Talk to sales' | not on the other page |
| new | button#extra 'Book a demo' | only on the other page |
| moved | h1 'Pricing' | x+0 y+0 w+0 h-5px |

## Styles (`h1,#cta`)
| element | property | mockup | app |
|---|---|---|---|
| h1 [Pricing] | font-size | 32px | 28px |
| button#cta [Start free] | border-radius | 8px | 4px |
Código de saída 1 quando algo difere, 0 quando as páginas correspondem — então o mesmo comando
funciona como uma verificação de CI de que o aplicativo não se desviou do design. A
estrutura é correspondida por tag + o próprio texto do elemento (contêineres de fechamento automático não são
"alterados" quando um filho desaparece), as caixas são comparadas com uma tolerância de 4px
(--tolerance), e valores de pixels fracionários são arredondados para que o ruído de layout não
seja lido como uma mudança.
O loop para "aqui está uma nova UX/UI, atualize o código-base": o agente de codificação abre
o mockup e o aplicativo em execução com o jevnav, lê os fatos em vez de
adivinhar — outline("main") para a estrutura, styles("#hero", ["font-size", "gap"]) for the computed values, page_state for the controls, screenshot para
o humano — compara os dois, edita o código ele mesmo (essa parte é o agente de codificação,
não o jevnav), e então relê o aplicativo para confirmar. goal("...", success="<selector>")
fixa o resultado para que a correção possa ser reproduzida no CI mais tarde.
O jevnav relata; ele não edita seu repositório, e não compara pixels.
Arquitetura
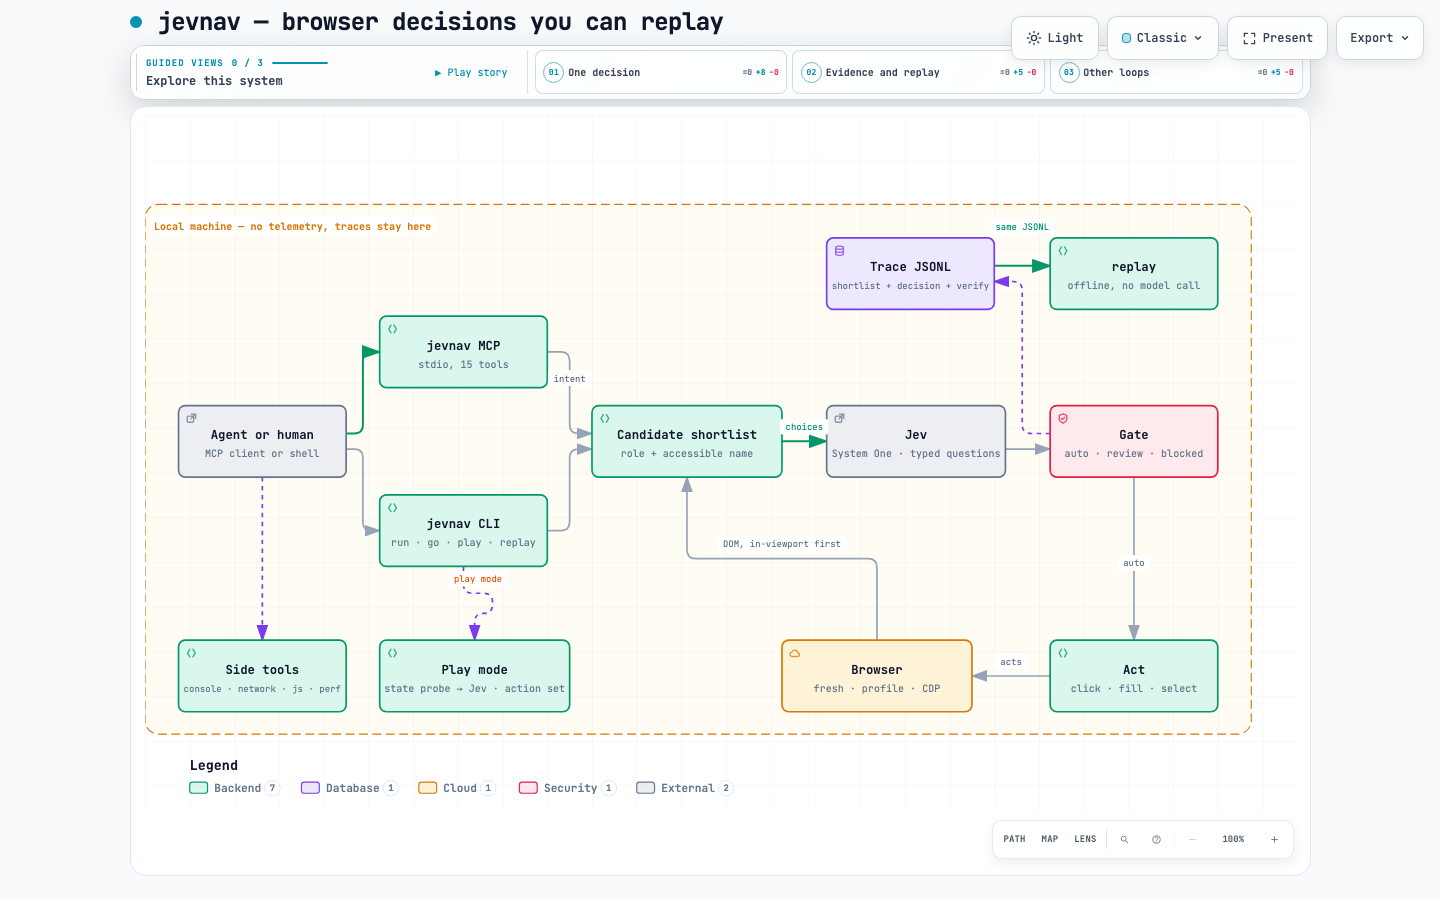
docs/architecture.html é a versão interativa (pan, zoom, temas, três
visualizações guiadas: uma decisão, evidência e reprodução, a outra loops); a especificação
a partir da qual foi construída é docs/architecture.archify.json. Em uma linha: o chamador
dá uma intenção, o jevnav lê uma lista curta classificada do navegador, o Jev escolhe
com uma probabilidade calibrada, a barreira decide se isso pode ser executado sem supervisão,
a ação volta pelo DOM, e cada etapa cai em um rastro que
replay re-resolve offline.
Por que o loop é mais barato: duas sequências
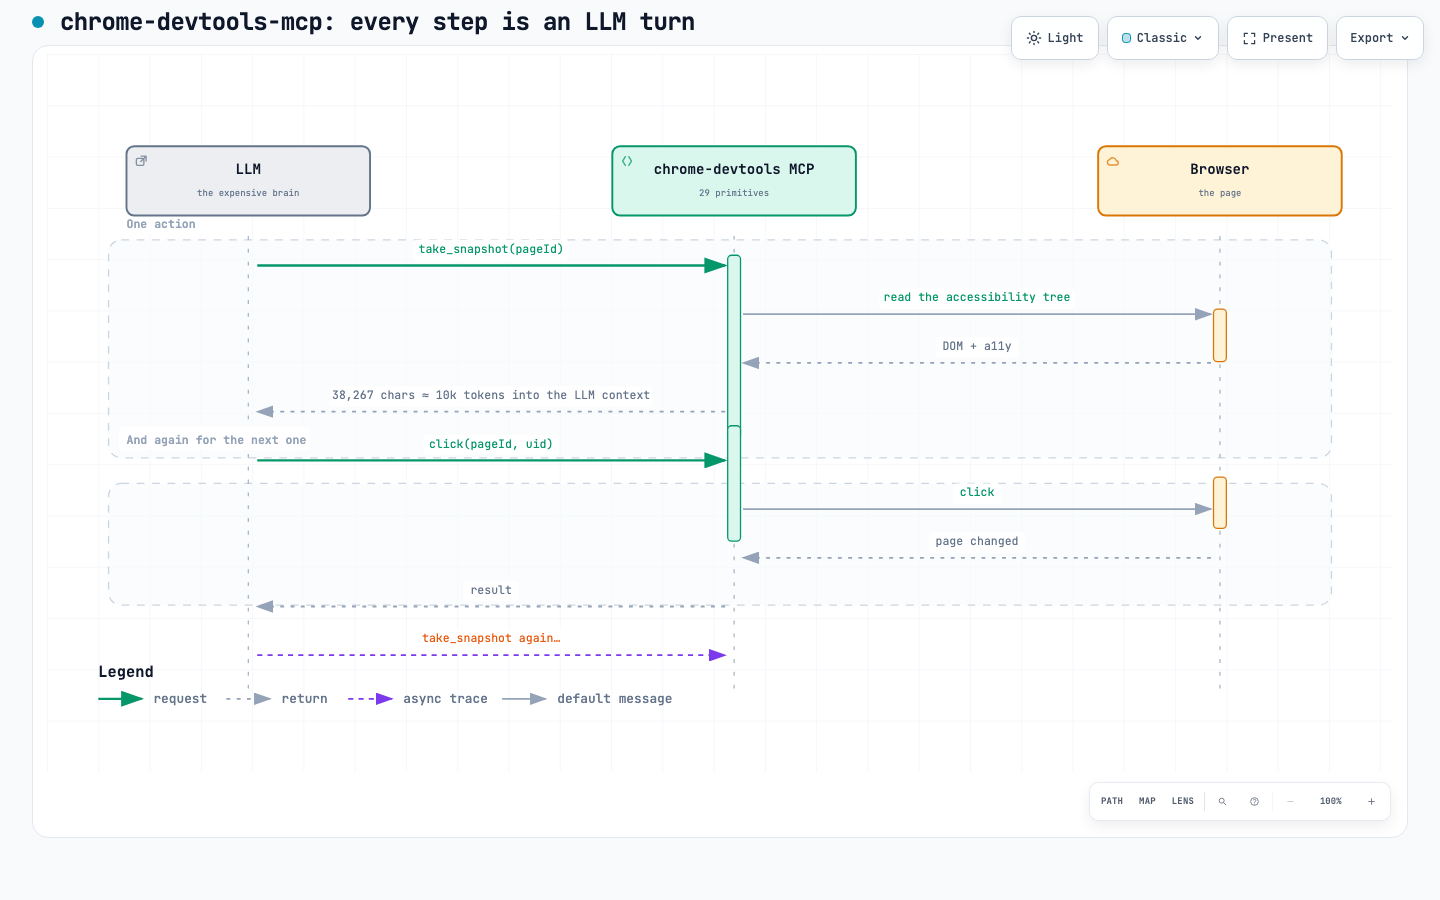
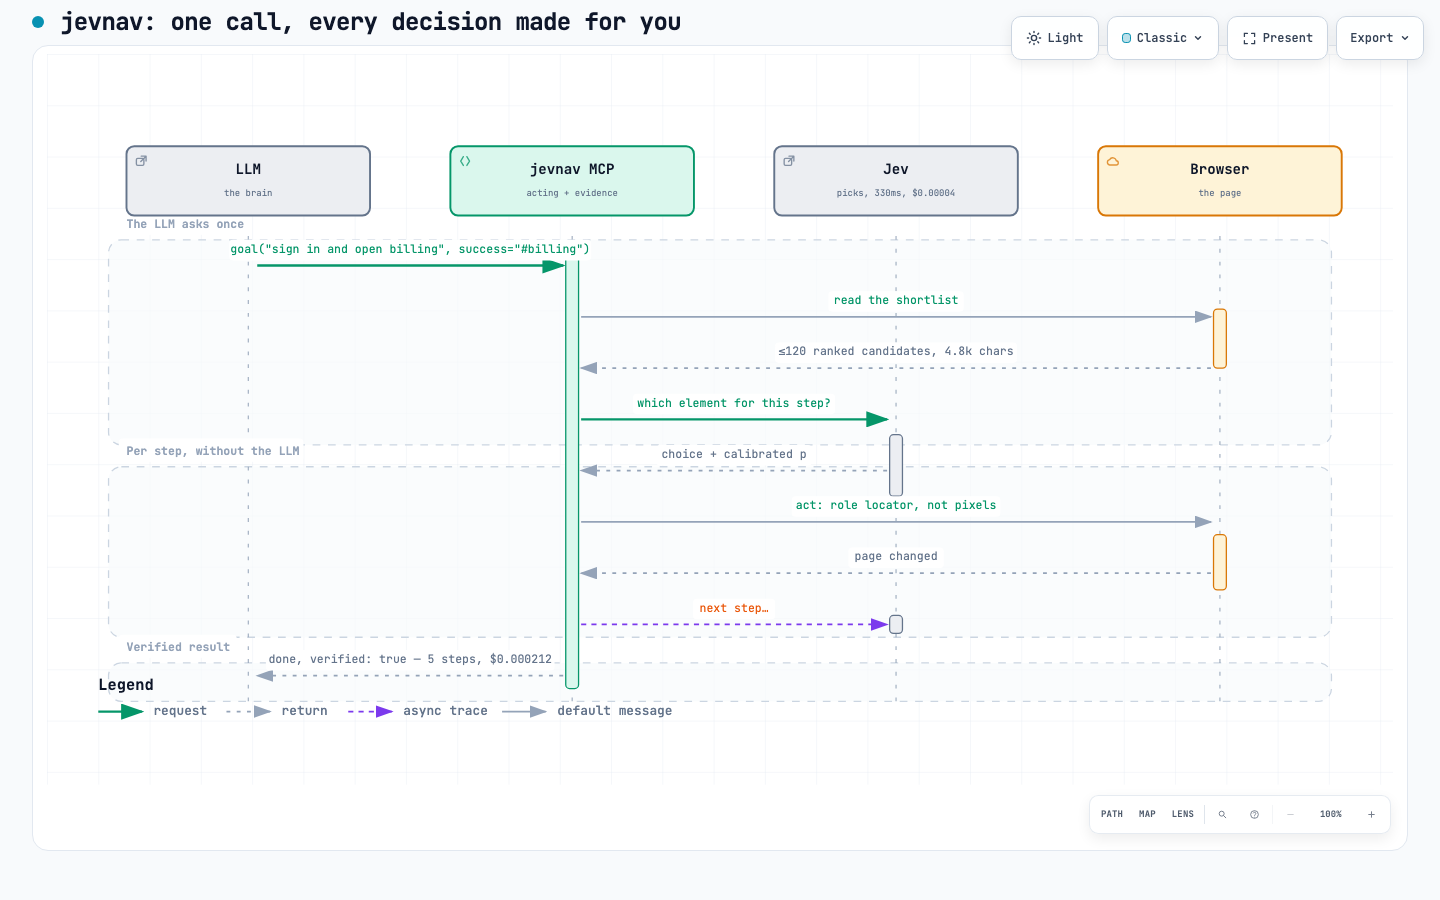
Mesma tarefa, anatomia diferente. Com o chrome-devtools-mcp o LLM é os olhos:
a cada etapa ele lê um snapshot de acessibilidade de ~38 mil caracteres em seu próprio contexto
(~10 mil tokens em um modelo de fronteira), decide o elemento, clica, e paga por uma
rodada completa novamente na próxima etapa. Com o jevnav o LLM pergunta uma vez (goal), e
cada etapa é uma pergunta de ~330ms, US$ 0,00004 ao Jev sobre uma lista curta de ≤120 candidatos
que nunca entra no contexto do LLM — com uma barreira no meio e um rastro escrito
conforme avança. Uma amostra inicial de uma execução com o mesmo LLM (deepseek-v4.1-flash via
opencode) está no histórico do git; não confie nela — n=1 por servidor, e seu
número mais alto veio de um 403 de política de robô, não de arquitetura. A
afirmação determinística é replay, e ela não precisa de benchmark para se defender.
Versões interativas de ambas as sequências: docs/seq-chrome-devtools.html,
docs/seq-jevnav.html.
Benchmarks
Em um conjunto de tarefas de automação (um console de operações local: login, um formulário dentro de uma
shadow root, uma ação de linha de tabela, uma fatura em iframe), mesmo LLM barato para ambos os servidores,
n=2 por tarefa: jevnav 8/8 tarefas, chrome-devtools-mcp 6/8 — e as duas
falhas foram instabilidade do modelo, não capacidade (uma reexecução manual terminou com a
resposta certa através da shadow root). O chrome-devtools foi 2,4x mais rápido
de ponta a ponta (19,3s vs 45,6s de média) com menos chamadas. Essa é a correção
honesta para qualquer afirmação de "mais rápido": a vantagem do jevnav é custo de decisão e
evidência, não tempo de relógio em páginas pequenas. Método completo e ressalvas:
research/driving-benchmark.md.
Mais dois números, e apenas um deles é uma comparação.
Determinístico, e o único pelo qual o jevnav deve ser cobrado: replay é offline, não precisa de
chave de API, e sai com código 1 quando uma decisão gravada não resolve mais. Não há
erro de amostragem nisso; execute-o em seus próprios rastros.
Em nível de ferramenta, e mais fraco por natureza — benchmarks/mcp-compare.py, mesma máquina,
uma tarefa, contra o chrome-devtools-mcp:
| jevnav | chrome-devtools-mcp | |
|---|---|---|
| MCP pronto | 22ms (navegador preguiçoso) | 491ms |
| observação que o agente deve ler | 4,8 mil caracteres | 38,3 mil caracteres |
| chamadas de ferramenta para a tarefa | 2 | 4 |
| custo de decisão (real / modelado) | US$ 0,0008 | US$ 0,057 |
| resultado verificado contra a página | sim (seletor --success) | não existe tal noção |
Uma execução anterior com o mesmo LLM (deepseek-v4.1-flash via opencode) está registrada no histórico do git, mas não confie nela: n=1 por servidor, um modelo, duas tarefas, e o número mais alto (uma busca na Wikipédia onde o chrome-devtools levou 83s e atingiu HTTP 403) é um artefato de política de robô, não uma diferença arquitetural. A versão honesta é a tabela acima — o que o chamador paga por etapa e quanto da página cai no contexto do modelo — e mesmo isso não diz nada sobre como os dois se comportam em muitos sites. O que o jevnav afirma é mais restrito e comprovável em suas próprias páginas: uma decisão em ou acima da barreira é segura para executar, e a execução é reproduzível.
Medido
O loop de objetivo, medido em 2026-09-21 (4 objetivos × 2 formulações × Jev real, fixture
local: fazer login, abrir preços, fazer login e depois preços, um objetivo impossível):
8/8 objetivos corretos, incluindo o impossível (stuck), US$ 0,00004 por
etapa, p50 314ms por etapa. Uma execução real — fazer login e depois abrir preços — levou 5
etapas, US$ 0,000214, e foi reproduzida offline com --execute: 5/5 alvos resolvidos,
resultado verificado.
Em páginas reais (research/browser-element-selection.md, 30 casos rotulados manualmente
em 8 sites públicos, uma decisão cada, modelo jev-1.13.0):
-
41/41 casos pontuados corretos; 30 executados em
p >= 0.9e todos os 30 estavam certos. -
365ms p50, US$ 0,000153 por decisão.
-
71 casos estão escritos, mas apenas 41 pontuados: o executor recusa rótulos cujo seletor corresponde a zero ou vários elementos visíveis, e 30 dos meus fizeram isso. n pequeno, anotador único, páginas bem construídas: uma direção, não uma prova. Os casos, o executor e o log de casos excluídos estão todos no repositório. O spike de decisão de elementos em tempo de build (44 decisões: fixtures locais, Hacker News, PyPI, Wikipedia):
-
44/44 decisões corretas; 28/28 em
p ≥ 0.9(o gate automático). -
A reprodução capturou 4/4 mudanças de DOM injetadas com 0 falsos alarmes nas páginas inalteradas.
-
Latência p50 334ms, p95 834ms; $0,000053 por decisão.
-
Ao solicitar um elemento que não existe, Jev respondeu
noneemp=1.0ep=0.92em vez de inventar um.
Amostra pequena, ground truth autoavaliado, intenções fáceis — trate estes como direção, não como prova. replay é o número que importa no CI, e é determinístico.
Não-objetivos
- Sem planejador e sem loop de agente — você (ou seu agente) decide o que fazer; jevnav decide onde e registra o porquê.
- Sem capturas de tela no loop de decisão, sem geração de texto (
fillpega o texto do seu fluxo ou do seu ambiente). - Sem iframes, shadow DOM, canvas ou seletores de arquivo na v0.1 — cauda longa, rastreada como issues em vez de suporte parcial.
- Sem SaaS, sem runner hospedado, sem telemetria. Local-first: nada sai da máquina exceto a pergunta enviada ao seu endpoint Jev configurado.
Privacidade
Os traces contêm URLs de páginas, nomes de elementos e suas ações — nunca capturas de tela. O modo loop também envia um resumo curto do texto visível da página (é assim que o modelo julga se o objetivo foi concluído) e o valor atual dos campos de formulário (senhas mascaradas) — isso é o que qualquer agente de navegador precisa observar. Fluxos scriptados não enviam nenhum dos dois. values literais do fluxo são registrados (eles já estão no seu repositório); valores de ${ENV} são registrados apenas como nome da variável. Adicione *.trace.jsonl ao .gitignore do seu projeto (o repositório do jevnav faz isso) e audite um trace antes de compartilhá-lo.
Suite
jevnav é a peça de navegador de uma stack de verificação: mcplint (configs MCP), harnessguard (harnesses de agente), jevassert + jev-packs (pacotes de decisão calibrados) e jev-table.
Licença
Apache-2.0.