searxNcrawl
Busca na web via sua própria instância SearXNG e/ou You.com, além de crawling de páginas e sites para Markdown limpo e deduplicado com Crawl4AI e Playwright, incluindo páginas atrás de login. Executa localmente (uvx searxncrawl), licença MIT.
Documentação


Website · Início rápido · Documentação · Desenvolvedores · Cloud (planejado) · Changelog
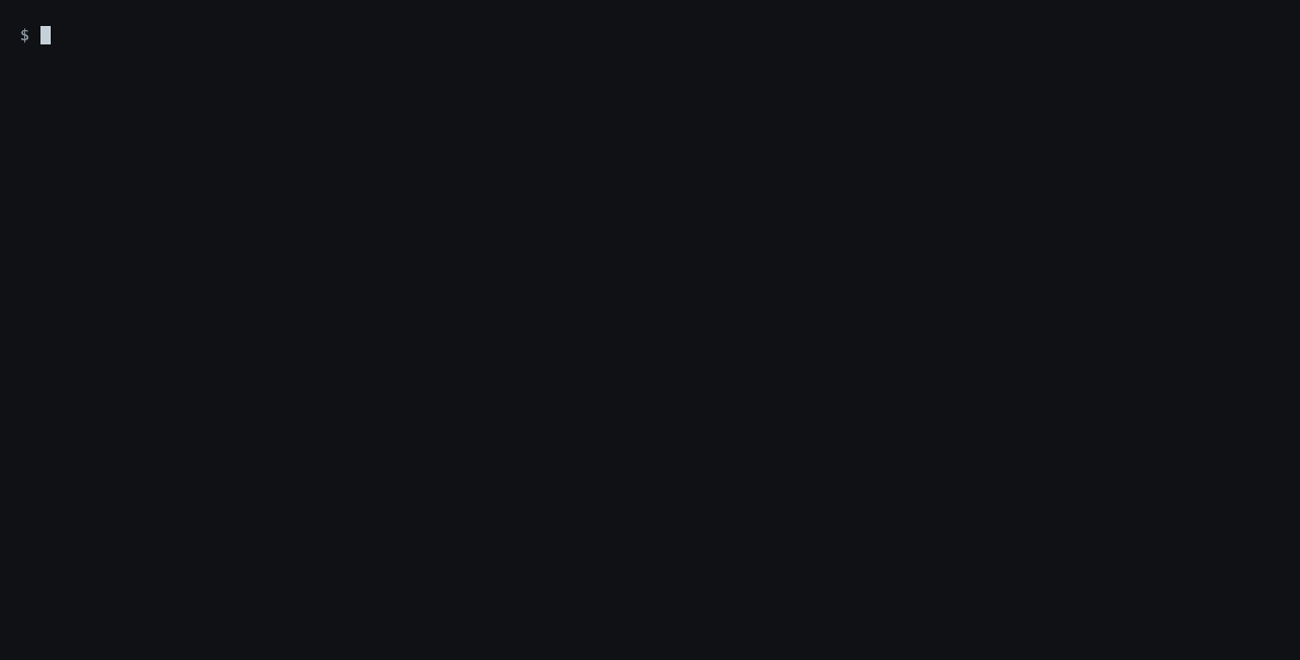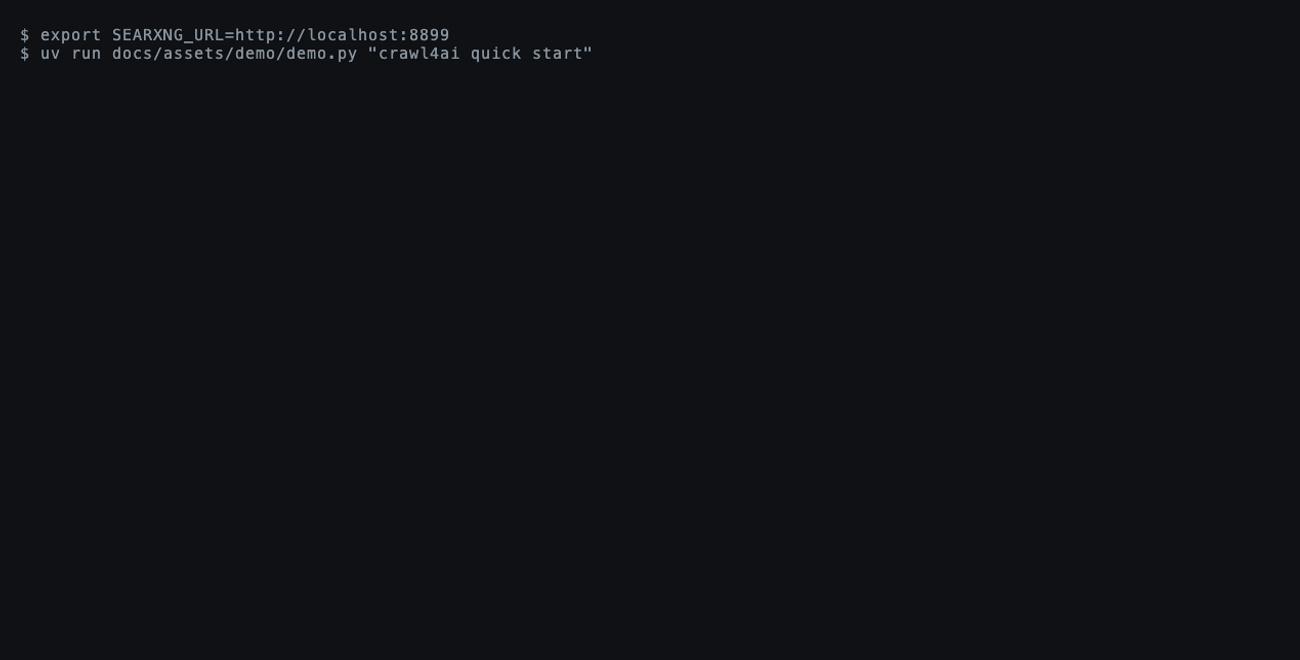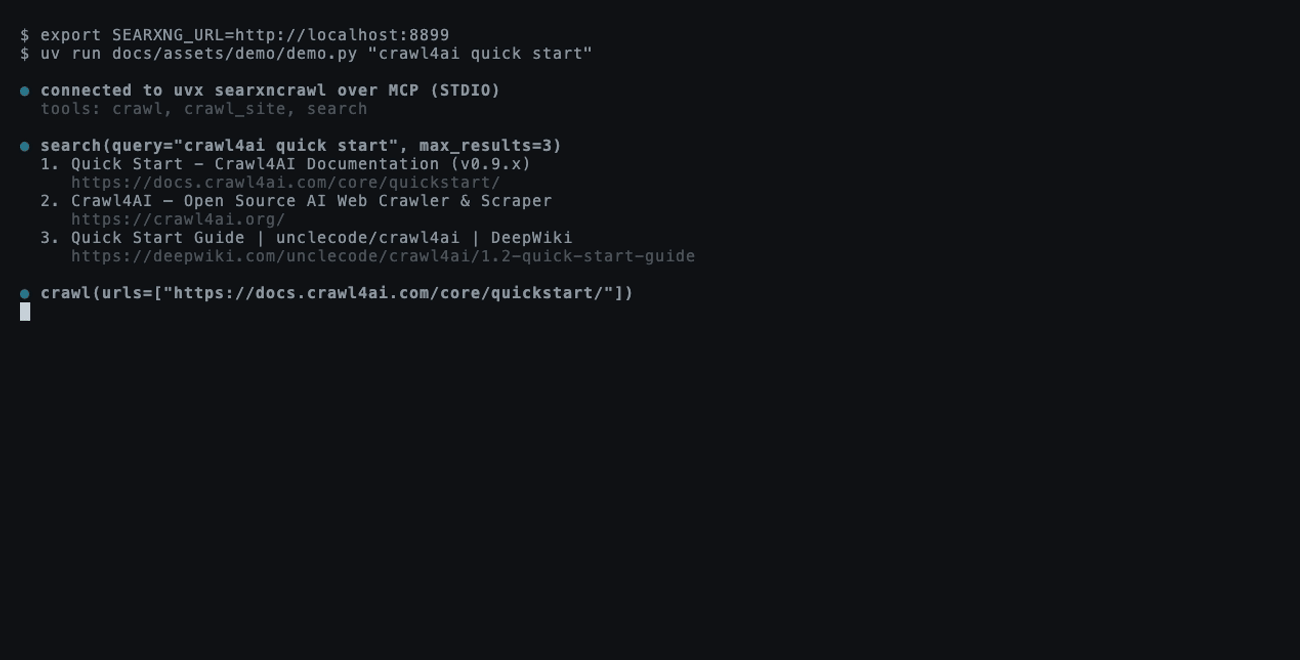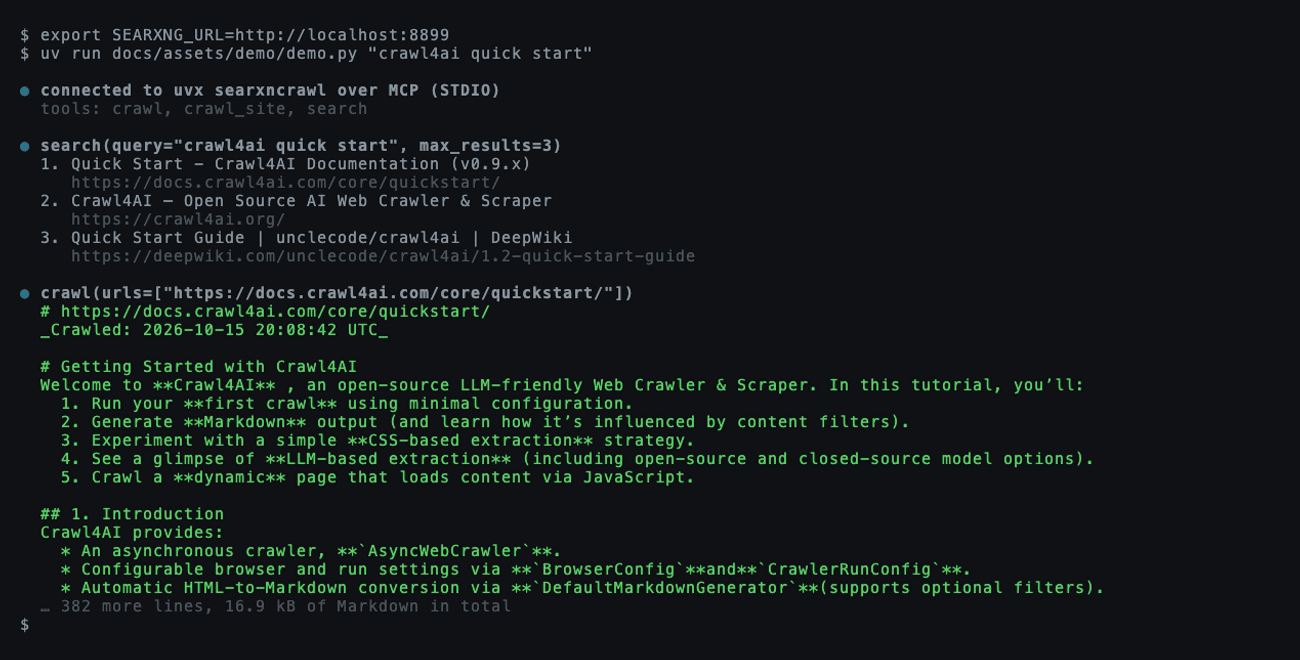
Uma sessão real de cliente MCP (fastmcp) contra uvx searxncrawl 0.31.0 e um SearXNG local: search, depois crawl do primeiro resultado para Markdown. A saída é encurtada para exibição. Reproduza com docs/assets/demo/.
searxNcrawl é um servidor MCP de código aberto e um kit de ferramentas CLI que dá a agentes de IA busca na web e crawling de Markdown limpo, construído sobre Crawl4AI. A busca consulta os provedores configurados, SearXNG e/ou You.com, em paralelo e mescla os resultados. Ele roda no seu próprio hardware, não precisa de chave de API com SearXNG e tem sucesso searxng-mcp.
| Busca na web Sua própria instância SearXNG e/ou a API You.com, consultadas em paralelo; os resultados são mesclados e atribuídos aos seus provedores, filtrados por idioma e intervalo de tempo. | Crawl de página Uma ou muitas URLs para Markdown ou JSON, com blocos repetidos removidos e links opcionalmente removidos. | Crawl de site Sites inteiros com limites de profundidade e páginas, ajustados para documentação. |
| Crawls autenticados Capture uma sessão de login uma vez com crawl-capture, depois faça crawl atrás do login. | STDIO e HTTP Conecte-se a clientes MCP locais, ou exponha um endpoint HTTP com proteções de host e CORS. | CLI e API Pythoncrawl, search e crawl-capture na linha de comando, ou importe-o em Python. |
SEARXNG_URL=http://your-searxng:8888 uvx searxncrawl
Início rápido
Você precisa de uv e, para a ferramenta search, de pelo menos um provedor de busca: uma instância SearXNG com saída JSON habilitada e/ou uma chave de API You.com (YDC_API_KEY). Ainda não tem SearXNG? Inicie um com Docker. O crawling funciona sem nenhum deles.
Adicione ao seu agente
Um passo para cada agente na sua máquina
uvx searxncrawl setup
setup detecta Claude Code, Codex, Gemini CLI, Cursor, VS Code e Claude Desktop, pergunta pela sua URL SearXNG e, opcionalmente, uma chave de API You.com (entrada oculta, nunca impressa), mostra cada mudança de configuração e a aplica somente após sua confirmação. Cada arquivo tocado é copiado antes, e setup --remove desfaz. Mais opções estão em Servidor MCP.
Ou por agente

Os botões e comandos abaixo assumem SearXNG em http://localhost:8888; mude SEARXNG_URL se o seu rodar em outro lugar, ou adicione YDC_API_KEY para You.com.
Claude Code
claude mcp add searxncrawl --env SEARXNG_URL=http://localhost:8888 -- uvx searxncrawl
Codex
codex mcp add searxncrawl --env SEARXNG_URL=http://localhost:8888 -- uvx searxncrawl
VS Code
code --add-mcp '{"name":"searxncrawl","command":"uvx","args":["searxncrawl"],"env":{"SEARXNG_URL":"http://localhost:8888"}}'
Cursor (~/.cursor/mcp.json), Claude Desktop e outros clientes que usam o formato mcpServers
{
  "mcpServers": {
    "searxncrawl": {
      "command": "uvx",
      "args": ["searxncrawl"],
      "env": { "SEARXNG_URL": "http://localhost:8888" }
    }
  }
}
O primeiro crawl baixa o Chromium do Playwright uma vez (cerca de 550 MB). Para Docker, transporte HTTP e outras configurações, veja Instalação e Servidor MCP.
Pergunte ao seu agente
Search for the Crawl4AI quick start, crawl the official page and summarise
how to run a first crawl.
Seu agente chama search, escolhe um resultado e chama crawl. Ele recebe Markdown limpo em vez de HTML bruto.
Use o terminal
uvx --from searxncrawl crawl https://modelcontextprotocol.io/docs/getting-started/intro
SEARXNG_URL=http://localhost:8888 uvx --from searxncrawl search "model context protocol" --max-results 5
Como funciona
flowchart LR
    agent["AI agent<br/>Claude Code · Codex<br/>Cursor · VS Code"]
    server["searxNcrawl<br/>MCP server"]
    searxng["SearXNG (your instance)<br/>and/or You.com API"]
    browser["Crawl4AI +<br/>Playwright Chromium"]
    results["Merged results<br/>attributed per provider"]
    markdown["Deduplicated<br/>Markdown or JSON"]

    agent -- "MCP · STDIO or HTTP" --> server
    server -- "search" --> searxng --> results
    server -- "crawl · crawl_site" --> browser --> markdown
Os resultados retornam ao agente como resposta da ferramenta. Busca e crawling também estão disponíveis como comandos CLI search e crawl, e o crawling também como API Python.
searxNcrawl expõe três ferramentas MCP:
| Ferramenta | O que faz |
|---|---|
search | Consulta os provedores configurados (SearXNG, You.com) em paralelo e retorna uma lista mesclada e deduplicada com a fonte de cada resultado. Filtros: idioma, intervalo de tempo, busca segura, paginação; categorias e mecanismos para SearXNG. |
crawl | Renderiza uma ou muitas URLs no Chromium e retorna Markdown ou JSON com metadados e referências. |
crawl_site | Segue links de uma URL inicial dentro de limites de profundidade, páginas e tempo, ajustado para sites de documentação. |
Ambas as ferramentas de crawl removem seções que se repetem dentro do Markdown de uma página (dedup_mode="exact"), podem remover links para um contexto menor (remove_links) e aceitam um storage_state do Playwright para páginas atrás de login. Parâmetros completos estão na referência de ferramentas MCP.
Por que searxNcrawl
APIs hospedadas de busca e crawl são rápidas para começar, mas cada chamada passa pelo serviço de outra pessoa e é cobrada por requisição ou crédito. searxNcrawl roda na sua própria máquina ou servidor.
| searxNcrawl | Firecrawl | Tavily | Exa | |
|---|---|---|---|---|
| Busca e crawl rodam no seu hardware | ✅ Pacote Python ou Docker; consultas You.com vão para You.com | ✅ Stack auto-hospedada (Docker Compose), ou API hospedada | ❌ API hospedada | ❌ API hospedada |
| Chave de API | Não é necessária com SearXNG; You.com precisa de uma | API hospedada: necessária. Auto-hospedada: não por padrão | Necessária | Opcional, uso anônimo é limitado por taxa |
| Custo por chamada | Nenhum com SearXNG; You.com conforme seus planos | Hospedada: créditos mensais gratuitos, depois créditos pagos. Auto-hospedada: nenhum | Créditos mensais gratuitos, depois créditos pagos | Créditos mensais gratuitos, depois pagamento por requisição |
| Backend de busca | Seu SearXNG (os mecanismos que você habilita) e/ou You.com | Hospedada: busca do Firecrawl. Auto-hospedada: SearXNG se configurado, senão DuckDuckGo | API de busca do Tavily | Índice de busca do Exa |
| Licença | MIT | AGPL-3.0 | Servidor MCP MIT, API proprietária | Servidor MCP MIT, API proprietária |
Firecrawl auto-hospedado também pode buscar via SearXNG; ele roda como uma stack de múltiplos serviços (API, serviço Playwright, Redis, RabbitMQ, PostgreSQL e mais), enquanto searxNcrawl é um único processo Python com Chromium, mais sua instância SearXNG se você usar uma. Uma API compatível com Firecrawl para searxNcrawl está planejada.
Onde os outros são melhores: se você não quer rodar um provedor de busca e um navegador você mesmo, uma API hospedada dá menos trabalho, e o índice de busca semântica do Exa ou os recursos de extração do Firecrawl vão além do que searxNcrawl faz hoje. Comparação baseada no repositório público e documentação de cada projeto em outubro de 2026; correções são bem-vindas. Firecrawl é uma marca registrada de seu proprietário; searxNcrawl não é afiliado a ele.
FAQ
Preciso de SearXNG?
Somente para a ferramenta search, e apenas se você não usar You.com (YDC_API_KEY). crawl e crawl_site funcionam sem nenhum provedor de busca. SearXNG serve HTML apenas por padrão, então a saída JSON deve ser habilitada (search.formats em settings.yml). Instâncias públicas podem não habilitá-la e frequentemente limitam requisições automatizadas, então rode a sua própria. Instalação tem um comando Docker de uma linha.
Ele lida com páginas pesadas em JavaScript?
Sim. As páginas são renderizadas no Chromium do Playwright através do Crawl4AI antes de serem convertidas para Markdown, então o conteúdo do lado do cliente é capturado.
Ele pode fazer crawl de páginas atrás de login?
Sim. Capture uma sessão uma vez com crawl-capture, depois passe o arquivo storage_state salvo para crawl ou crawl_site. Veja Captura de sessão.
Posso rodá-lo remotamente ou compartilhá-lo com um time?
Sim. Inicie com --transport http (porta 8000 por padrão) ou use a stack Docker Compose (porta 9555), depois aponte seus clientes MCP para http://<host>:<port>/mcp. Listas de permissão de Host e Origin protegem o endpoint; veja Servidor MCP.
Por que o primeiro crawl é lento?
O primeiro crawl baixa o Chromium do Playwright (cerca de 550 MB em disco). Execuções posteriores o reutilizam. Defina PLAYWRIGHT_AUTO_INSTALL=false onde navegadores são provisionados separadamente.
Eu usei searxng-mcp. O que mudou?
searxng-mcp está obsoleto em favor de searxNcrawl. Ele só buscava no SearXNG e podia escolher uma instância pública aleatória; searxNcrawl adiciona crawl de páginas e sites, mas precisa do seu próprio SEARXNG_URL (ou uma chave You.com), pois a seleção aleatória de instâncias públicas não está incluída.
Existe uma versão hospedada?
Ainda não. searxNcrawl Cloud está planejado; veja o roteiro.
Roteiro
- API compatível com Firecrawl (planejado): use searxNcrawl como backend substituto para ferramentas construídas contra a API Firecrawl.
- searxNcrawl Cloud (planejado): um endpoint gerenciado para times que não querem rodar SearXNG e um navegador. Detalhes e lista de espera.
Ideias e votos são bem-vindos em Discussões.
Documentação
| Guia | Conteúdo |
|---|---|
| Instalação | uvx, Docker Compose, pip, uv, provedores de busca e variáveis de ambiente |
| Servidor MCP | Transportes STDIO e HTTP, configuração de clientes, proteções de Host e CORS |
| Ferramentas MCP | Parâmetros para crawl, crawl_site e search |
| CLI | crawl, search e crawl-capture |
| API Python | crawl_page, crawl_site e substituições de configuração do crawler |
| Formatos de saída | Estrutura Markdown e JSON, CrawledDocument |
| Captura de sessão | Crawling autenticado com uma sessão de navegador salva |
| Registro MCP | server.json e os passos de publicação |
| Arquitetura | Módulos e recursos para contribuidores |
Contribuindo
Relatos de bugs, ideias de recursos e pull requests são bem-vindos. Leia o guia de contribuição e abra uma issue primeiro para mudanças maiores. Agentes de codificação encontram as convenções do projeto em AGENTS.md. Reporte vulnerabilidades de forma privada, conforme descrito na política de segurança.
Licença
MIT — © 2026 DDM – Das Digitale Momentum GmbH & Co KG
Mantido por DDM – Das Digitale Momentum GmbH & Co. KG, Much, Alemanha · www.searxncrawl.io · Todos os nossos projetos de código aberto