Cluefinch MCP
Infraestrutura de Deep Research para agentes de IA. Pesquise na web, leia páginas incrementalmente, siga links de fontes e colete evidências relevantes em múltiplas fontes.
Documentação
Cluefinch MCP
Infraestrutura de Deep Research para agentes de IA.
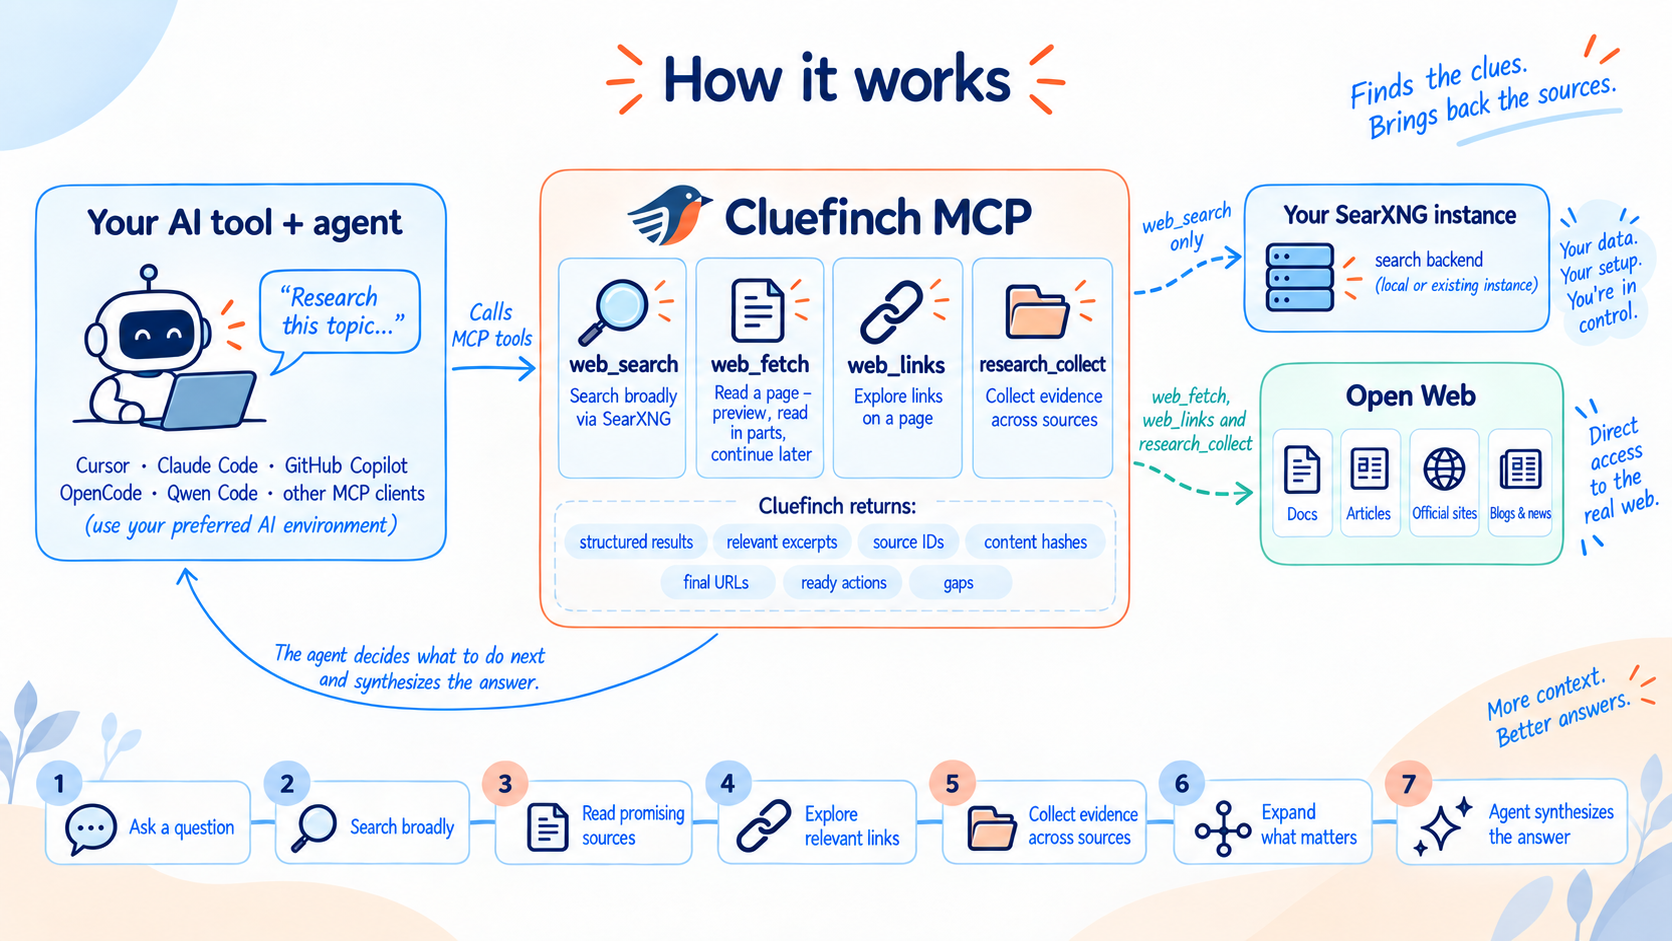
O Cluefinch MCP oferece aos agentes de IA um kit completo de ferramentas para trabalhar com a web por meio do Model Context Protocol (MCP).
Com o Cluefinch, um agente pode pesquisar na web, ler páginas, navegar entre fontes relacionadas e realizar pesquisas aprofundadas.
O Cluefinch MCP pode tornar a internet parte do espaço de trabalho do seu agente de IA — desde encontrar um único fato até realizar pesquisas complexas e de múltiplas etapas em várias fontes.
O Cluefinch MCP é totalmente gratuito e não exige assinatura paga. Ele funciona com agentes de IA, sejam eles alimentados por LLMs locais ou modelos baseados em nuvem, e não requer uma API de busca comercial nem assinatura de um serviço de Deep Research hospedado em nuvem.
O Cluefinch MCP não impõe limites próprios ao número de consultas de pesquisa ou execuções de pesquisa.
Seu agente obtém as ferramentas necessárias para trabalhar eficazmente com a web, enquanto você mantém o controle sobre como essas ferramentas são usadas. O Cluefinch integra-se facilmente a ferramentas de IA compatíveis com MCP e se encaixa no fluxo de trabalho que você já utiliza.
O que o Cluefinch MCP pode fazer
Pesquisa na Web
O Cluefinch MCP permite que um agente pesquise na internet por meio da sua própria instância do SearXNG.
O agente pode formular e refinar consultas de pesquisa, usar diferentes mecanismos de busca, restringir pesquisas por idioma ou domínio e emitir consultas de acompanhamento ou revisadas quando necessário.
Leitura de Páginas Web
Quando um link útil é encontrado, o agente pode abrir a página por meio do Cluefinch MCP e receber texto limpo, pronto para processamento pelo modelo.
Páginas grandes não precisam ser carregadas inteiramente no contexto do modelo de uma só vez. O agente pode lê-las em partes, continuar de uma posição específica e solicitar contexto adicional somente quando for realmente necessário.
Navegação entre Fontes
Após encontrar uma página útil, o agente pode inspecionar seus links HTTP/HTTPS e usar a estrutura da própria fonte para continuar a pesquisa: percorrer seções de documentação e capítulos de relatórios, seguir paginação, abrir páginas relacionadas e alcançar materiais primários — sem retornar a um mecanismo de busca a cada etapa.
Deep Research
O Cluefinch MCP oferece ao agente as ferramentas para executar fluxos de pesquisa com múltiplas fontes.
O agente pode conduzir várias linhas de investigação ao mesmo tempo, trabalhar tanto com resultados de busca quanto com URLs conhecidas, reunir material de diferentes fontes, examinar as partes mais relevantes de documentos longos e aprofundar a investigação à medida que novas perguntas surgem.
O agente permanece no controle do processo de pesquisa: ele decide o que buscar em seguida, quais fontes merecem inspeção mais detalhada, como interpretar o material coletado e quando há evidências suficientes para produzir uma resposta.
A profundidade da pesquisa — desde uma consulta rápida de produto até uma análise complexa e de múltiplas etapas — depende da tarefa, do modelo e das instruções do usuário.
Início Rápido
O Cluefinch MCP requer Python 3.12.4 ou posterior.
1. Instalar o Cluefinch MCP
python -m pip install cluefinch
Após a instalação, certifique-se de que o executável cluefinch esteja disponível por meio da variável de ambiente PATH.
No Windows:
where.exe cluefinch
No macOS e Linux:
command -v cluefinch
Se cluefinch não for encontrado, adicione o diretório que contém o executável instalado a PATH.
2. Iniciar o SearXNG
O Cluefinch usa o SearXNG como backend de busca. Se você ainda não possui sua própria instância do SearXNG, o repositório inclui um exemplo de configuração local pronto para uso:
examples/searxng/compose.yamlexamples/searxng/settings.yml
Para executar o exemplo, você precisa do Docker com suporte ao Docker Compose.
Baixe esses arquivos para um diretório separado e crie um arquivo .env ao lado deles com um SEARXNG_SECRET aleatório.
No macOS e Linux:
printf 'SEARXNG_SECRET=%s\n' "$(openssl rand -hex 32)" > .env
No Windows PowerShell:
$secret = -join ((1..64) | ForEach-Object { '{0:x}' -f (Get-Random -Maximum 16) })
"SEARXNG_SECRET=$secret" | Set-Content -Encoding ascii .env
Em seguida, inicie o SearXNG com o Docker Compose:
docker compose up -d
Por padrão, a instância local do SearXNG estará disponível em:
http://127.0.0.1:8081
3. Conectar o Cluefinch MCP à sua ferramenta de IA
O Cluefinch conecta-se facilmente a ferramentas de IA populares e executa como um servidor MCP local padrão por meio de stdio.
Exemplos de conexão prontos para uso são fornecidos na próxima seção.
Integração com ferramentas de IA
O Cluefinch MCP usa o transporte MCP local padrão stdio, portanto, na maioria dos clientes, você só precisa especificar o comando cluefinch.
Abaixo estão exemplos mínimos de integração do Cluefinch com algumas ferramentas de IA populares. O Cluefinch também pode ser usado com outros clientes que suportam servidores MCP locais por meio de stdio.
Os exemplos abaixo usam o SearXNG em http://127.0.0.1:8081, conforme mostrado na seção Início Rápido acima.
Se sua instância do SearXNG não usar o endereço padrão, passe MCP_SEARCH_SEARXNG_URL por meio do ambiente do servidor MCP na configuração do seu cliente.
Cursor
Adicione o Cluefinch ao .cursor/mcp.json do seu projeto ou à configuração global de MCP do Cursor:
{
  "mcpServers": {
    "cluefinch": {
      "type": "stdio",
      "command": "cluefinch"
    }
  }
}
Após reiniciar a conexão MCP, o Cursor descobrirá as ferramentas do Cluefinch e poderá usá-las em tarefas de agente.
Claude Code
O Cluefinch pode ser adicionado com um único comando:
claude mcp add --scope user cluefinch -- cluefinch
Para verificar a conexão:
claude mcp list
Codex
Adicione o Cluefinch com:
codex mcp add cluefinch -- cluefinch
Para verificar a conexão:
codex mcp list
GitHub Copilot no VS Code
Adicione o servidor MCP local a .vscode/mcp.json:
{
  "servers": {
    "cluefinch": {
      "type": "stdio",
      "command": "cluefinch"
    }
  }
}
O Cluefinch ficará então disponível para o GitHub Copilot no modo agente como um conjunto de ferramentas MCP.
OpenCode
Adicione o Cluefinch a opencode.jsonc:
{
  "$schema": "https://opencode.ai/config.json",
  "mcp": {
    "cluefinch": {
      "type": "local",
      "command": ["cluefinch"],
      "enabled": true
    }
  }
}
Qwen Code
Adicione o Cluefinch a ~/.qwen/settings.json para configuração no nível do usuário, ou a .qwen/settings.json para um projeto específico:
{
  "mcpServers": {
    "cluefinch": {
      "command": "cluefinch",
      "args": []
    }
  }
}
Após reiniciar o Qwen Code, você pode verificar a conexão com o comando /mcp.
OpenClaw
Adicione o Cluefinch com:
openclaw mcp add cluefinch --command cluefinch
Ou configure-o manualmente em openclaw.json:
{
  "mcp": {
    "servers": {
      "cluefinch": {
        "command": "cluefinch",
        "transport": "stdio"
      }
    }
  }
}
Para verificar a conexão:
openclaw mcp probe cluefinch
Hermes Agent
Adicione o Cluefinch ao arquivo config.yaml usado pelo seu perfil Hermes ativo:
mcp_servers:
  cluefinch:
    command: "cluefinch"
    args: []
Reinicie o Hermes após salvar a configuração.
Configurando o comportamento do agente
O agente formula consultas de pesquisa, seleciona fontes e gerencia o processo de pesquisa usando as ferramentas MCP disponíveis do Cluefinch. Você pode definir suas próprias regras para esse processo por meio de instruções em AGENTS.md ou configurações equivalentes na sua ferramenta de IA.
Essas instruções podem reger tanto pesquisas comuns quanto pesquisas profundas e de múltiplas etapas, incluindo como cada ferramenta individual do Cluefinch MCP deve ser usada.
Por exemplo, você pode pedir ao agente para começar com um plano de pesquisa, executar várias consultas de refinamento por meio de web_search, usar web_links para navegar por capítulos e páginas relacionadas, priorizar fontes primárias e ler documentos grandes incrementalmente com web_fetch.
Para coleta de múltiplas fontes e filtragem inicial, o agente pode usar research_collect. Suas instruções também podem definir regras para reutilizar contexto já coletado, verificar fontes conflitantes, limitar iterações adicionais de pesquisa e manter evidências factuais separadas da interpretação.
O repositório inclui um arquivo AGENTS.md com um exemplo pronto desse tipo de fluxo de trabalho de Deep Research. Você pode usá-lo como ponto de partida, simplificá-lo para pesquisas rápidas ou adaptá-lo às suas próprias tarefas, modelo e requisitos de saída.
Ferramentas do Cluefinch MCP
No nível do MCP, o Cluefinch expõe quatro ferramentas complementares que levam um agente da pesquisa na web à leitura de fontes específicas e, em seguida, à pesquisa com múltiplas fontes.
web_search
web_search executa pesquisas por meio da instância configurada do SearXNG e retorna links para fontes potencialmente úteis.
O agente pode controlar o número de resultados, escolher mecanismos de busca e idioma, usar a Busca Segura, restringir a pesquisa a um domínio específico ou excluir domínios indesejados. O Cluefinch também informa quando um ou mais mecanismos do SearXNG falham ao responder, para que o agente não confunda um conjunto de resultados incompleto com um completo.
web_fetch
web_fetch lê páginas da web diretamente. O Cluefinch baixa o HTML da URL especificada, extrai o texto principal, converte-o em Markdown e retorna apenas a parte que o agente precisa.
O agente pode primeiro solicitar uma pequena prévia da página para avaliar se a fonte é útil e, em seguida, continuar a leitura somente se necessário. Um documento longo pode ser lido incrementalmente a partir de uma posição escolhida. O Cluefinch retorna next_start e uma ação continuation pronta para uso, para que o agente não precise calcular a próxima posição manualmente. Junto com o conteúdo, ele recebe os metadados necessários para continuar navegando com segurança na mesma versão retida do texto extraído.
web_links
web_links extrai links de navegação HTTP/HTTPS de uma página HTML e os retorna na ordem do documento. Ele permite que o agente inspecione a estrutura de uma fonte já encontrada: seções de documentação, capítulos de relatórios, paginação, apêndices, referências a fontes primárias e páginas relacionadas.
Isso é especialmente útil no Deep Research. Após encontrar uma fonte forte, o agente pode inspecionar sua estrutura, abrir apenas as seções relevantes com web_fetch e, em seguida, coletar material de várias fontes selecionadas com research_collect. Isso reduz pesquisas desnecessárias, ajuda a preservar o contexto da pesquisa e permite um trabalho mais aprofundado com materiais primários.
Links relativos são resolvidos em URLs absolutas usando a URL base do documento. Os links podem ser filtrados por origem quando necessário, e grandes conjuntos de links podem ser recuperados incrementalmente em várias solicitações.
O Cluefinch também versiona cada conjunto de links retido. Se a navegação da página mudar entre solicitações, o agente não continuará a partir de posições desatualizadas em uma lista antiga.
Extrair links não faz solicitações aos seus destinos. A validação completa de segurança de saída é aplicada somente se o agente decidir posteriormente buscar uma dessas URLs.
research_collect
research_collect foi projetado para trabalhar com várias fontes ao mesmo tempo. Você pode fornecer várias consultas de pesquisa, URLs específicas ou ambos.
O Cluefinch reúne as fontes disponíveis, deduplica documentos por suas URLs finais após redirecionamentos e identifica as passagens mais relevantes em documentos longos. Cada passagem selecionada permanece um trecho exato do texto extraído com coordenadas estáveis, para que o agente possa retornar a ela posteriormente e solicitar contexto adicional quando necessário.
Cada fonte recebe um source_id estável, enquanto problemas de coleta — como uma URL inacessível, uma pesquisa com falha ou um documento final duplicado — são relatados explicitamente em gaps. O agente decide se material suficiente foi coletado e quais fontes merecem inspeção mais aprofundada.
Esquemas completos das ferramentas, parâmetros, limites e semântica de resposta estão documentados em docs/REFERENCE.md.
O que torna o Cluefinch eficiente e seguro
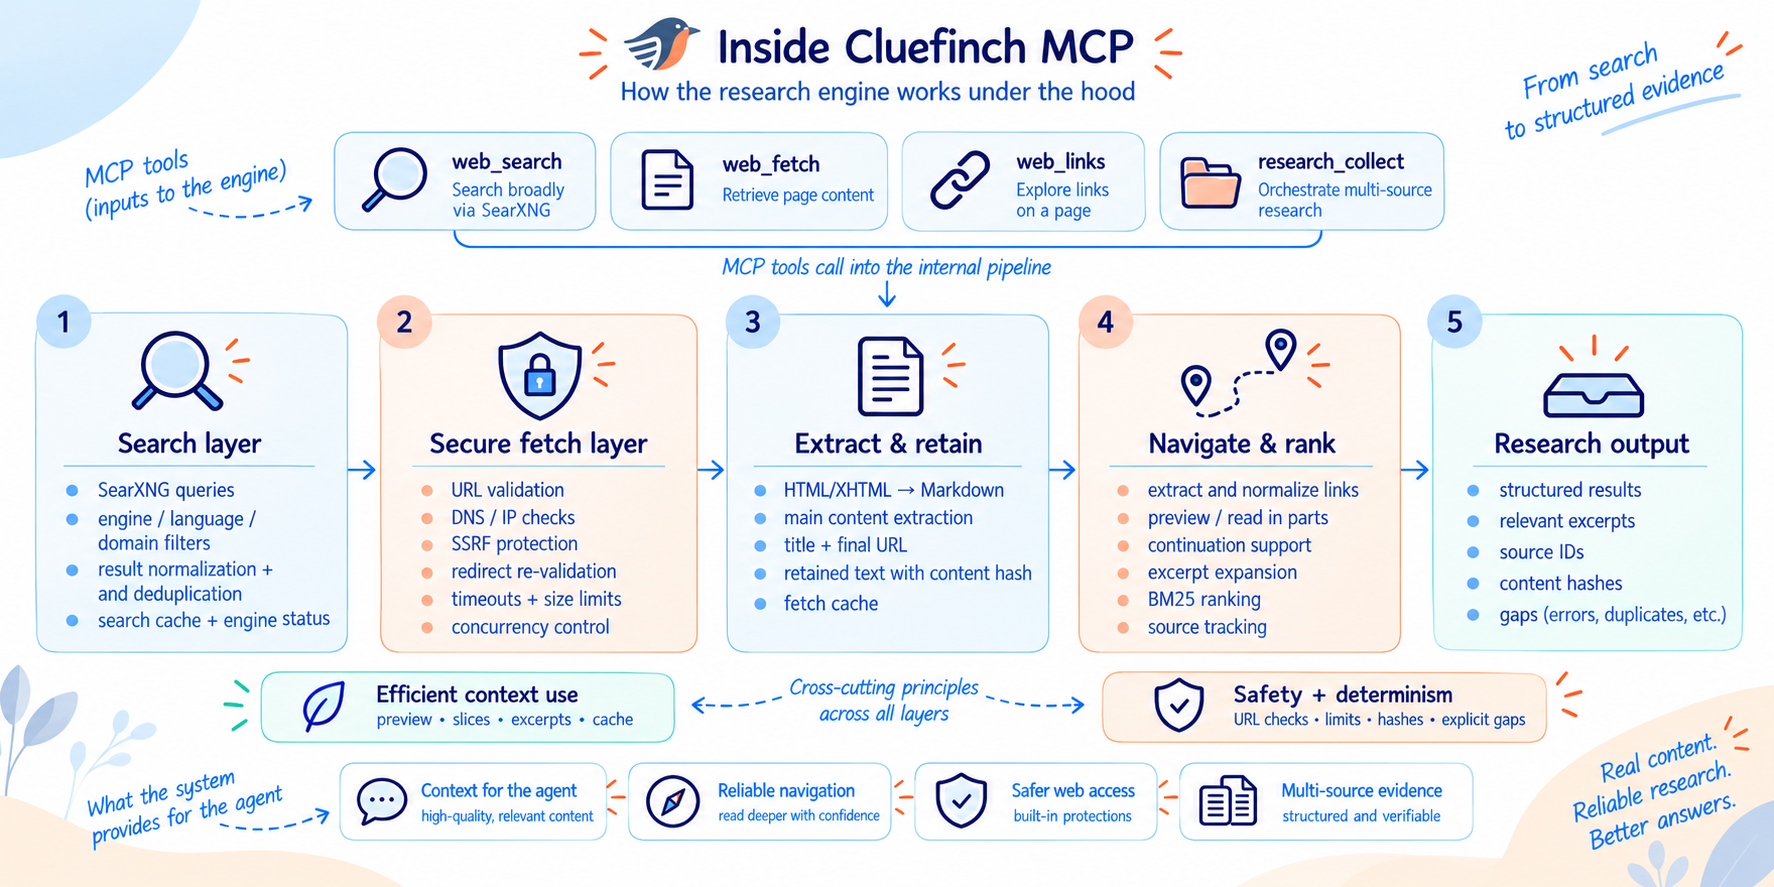
Por trás das quatro ferramentas do Cluefinch MCP, há uma camada de recuperação que lida com documentos longos, solicitações repetidas, restrições de rede e acesso seguro a conteúdo externo.
Uso eficiente de contexto e tokens
O Cluefinch permite que o agente envie apenas a parte de uma página necessária para a tarefa atual ao modelo, em vez de carregar o documento inteiro no contexto.
Um documento extraído pode ser lido incrementalmente. O agente recebe a posição do próximo trecho e continua somente quando mais conteúdo for realmente necessário. Para passagens individuais de pesquisa, ele também pode solicitar mais contexto ao redor sem reler o documento inteiro.
A navegação usa posições no texto extraído retido, permitindo que o agente retorne com precisão a passagens previamente identificadas. Isso ajuda o modelo a usar sua janela de contexto com mais eficiência e gastar tokens apenas nas partes de uma fonte que importam para o estágio atual do trabalho.
Controle de versão para texto extraído
Cada versão retida do texto extraído recebe um content_hash.
Quando o agente continua lendo ou expande uma passagem previamente selecionada usando expected_content_hash, o Cluefinch verifica esse hash. Ações prontas para uso de continuação e expansão passam isso automaticamente. Se o conteúdo da página mudou e as coordenadas antigas não podem mais ser consideradas confiáveis, a ferramenta relata a mudança em vez de retornar uma passagem desatualizada da posição antiga.
Isso torna a leitura continuada de fontes em mudança mais confiável e reduz o risco de misturar silenciosamente passagens de versões diferentes de um documento.
Proveniência e rastreabilidade da fonte
O Cluefinch preserva a URL final após redirecionamentos e deduplica as fontes novamente contra o endereço final do documento. Como resultado, links diferentes que levam ao mesmo material não se tornam fontes independentes separadas.
Cada URL final normalizada recebe um source_id estável, permitindo que a mesma fonte seja identificada de forma consistente em diferentes estágios do processo de pesquisa.
Para documentos longos, o Cluefinch divide o texto extraído em passagens limitadas e as classifica por relevância com BM25. As passagens selecionadas permanecem fatias exatas do texto-fonte extraído com coordenadas, para que o modelo receba material-fonte que possa ser revisitado e expandido posteriormente com contexto adicional.
Limitações explícitas em vez de suposições ocultas
O Cluefinch relata explicitamente condições que podem afetar a completude dos dados recuperados.
research_collect retorna gaps quando algumas fontes não podem ser recuperadas ou processadas. web_search relata separadamente os mecanismos SearXNG que não responderam. Ao ler uma página, o Cluefinch também distingue entre casos em que mais texto retido permanece disponível e casos em que o final do documento extraído foi descartado devido ao limite de retenção configurado.
Isso torna a recuperação incompleta visível para o agente, em vez de apresentar um resultado parcial como se fosse completo. O agente ainda decide se informações suficientes foram coletadas para continuar a análise ou produzir uma resposta.
Cache e reutilização de dados
Resultados de pesquisa e páginas extraídas são temporariamente armazenados em caches locais TTL/LRU por processo. Enquanto uma entrada em cache permanece válida, solicitar o mesmo recurso novamente evita outra requisição HTTP. As URLs das páginas ainda são validadas antes da reutilização do cache, o que pode envolver consultas DNS.
Buscas concorrentes idênticas e buscas da mesma página são coalescidas para que ações paralelas do agente não criem tráfego de rede duplicado.
O cache complementa o gerenciamento de contexto: a leitura incremental ajuda a conservar tokens do modelo, enquanto o cache local evita baixar repetidamente os mesmos dados da internet.
Acesso seguro a páginas externas
Um agente pode receber links de resultados de pesquisa e sites arbitrários, então o Cluefinch trata cada URL como potencialmente não confiável.
Antes de recuperar o conteúdo, o Cluefinch valida o esquema da URL, o nome do host, os resultados DNS e os endereços IP finais. Endereços locais, privados, reservados, multicast e outros endereços inseguros são bloqueados. A validação é repetida após redirecionamentos e novamente imediatamente antes da conexão. O Cluefinch conecta-se a um IP numérico já validado, preservando o nome do host original para HTTP e TLS.
O Cluefinch também limita o tamanho da resposta e dos dados descomprimidos, o número de redirecionamentos, o tempo de download, a atividade de rede concorrente e os recursos usados para extração de texto. Requisições ao mesmo host também são espaçadas ao longo do tempo.
Essas medidas são projetadas principalmente para proteger contra SSRF e consumo descontrolado de recursos. O texto de uma página da web ainda é conteúdo não confiável e não deve ser tratado automaticamente pelo agente como uma instrução.
Separação entre busca e recuperação de páginas da web
O Cluefinch usa o SearXNG apenas como backend de busca. Ele ajuda a descobrir fontes potenciais, mas não é usado como proxy para ler páginas da web.
Quando o agente abre uma URL descoberta, o Cluefinch recupera a página diretamente por meio de sua própria camada de busca protegida. Manter a descoberta e a recuperação separadas permite que segurança, cache, extração de texto e leitura de documentos longos sejam gerenciados de forma independente.
O SearXNG permanece um serviço separado, enquanto o Cluefinch MCP é executado localmente no ambiente do usuário e não requer seu próprio serviço de recuperação em nuvem ou telemetria integrada.
Configurando o Cluefinch MCP
O Cluefinch MCP pode ser ajustado para um ambiente específico e carga de trabalho do agente por meio de variáveis de ambiente prefixadas com MCP_SEARCH_.
Na maioria dos casos, os padrões são suficientes. As principais configurações são:
| Configuração | Padrão | Propósito |
|---|---|---|
MCP_SEARCH_SEARXNG_URL | http://127.0.0.1:8081 | Endereço do SearXNG |
MCP_SEARCH_ENGINES | google,google cse,brave,wikipedia,wikidata | Subconjunto de mecanismos explícitos permitidos; omitir engines usa os padrões do SearXNG |
MCP_SEARCH_MAX_RESULTS | 20 | Número máximo de resultados por busca |
MCP_SEARCH_MAX_SOURCES | 10 | Número máximo de fontes que research_collect pode tentar coletar |
MCP_SEARCH_MAX_QUERIES | 10 | Número máximo de consultas de busca em uma chamada de research_collect |
MCP_SEARCH_MAX_FETCH_CHARS | 20000 | Tamanho máximo de um fragmento de página retornado |
MCP_SEARCH_MAX_TEXT_CHARS | 100000 | Quantidade máxima de texto extraído retido para uma página |
MCP_SEARCH_FETCH_CONCURRENCY | 3 | Número máximo de buscas de página concorrentes |
MCP_SEARCH_FETCH_TTL | 600 | Tempo de vida das páginas buscadas no cache local, em segundos |
MCP_SEARCH_SEARCH_TTL | 300 | Tempo de vida dos resultados de busca no cache local, em segundos |
Por exemplo, se o SearXNG estiver rodando em um endereço diferente:
export MCP_SEARCH_SEARXNG_URL=http://127.0.0.1:8888
As mesmas variáveis também podem ser passadas diretamente pela configuração do servidor do cliente MCP.
A lista completa de configurações, padrões e comportamento exato está documentada em docs/REFERENCE.md.
Limitações atuais
O Cluefinch MCP é projetado para buscar e recuperar páginas da web comuns via HTTP/HTTPS. A versão atual suporta extração de HTML/XHTML e texto sem executar um navegador completo.
O Cluefinch MCP atualmente não inclui:
- Renderização JavaScript ou automação de navegador;
- Extração de texto PDF;
- Sessões autenticadas ou páginas privadas;
- Bypass de CAPTCHA ou paywall;
- Busca vetorial ou recuperação baseada em embeddings;
- SaaS hospedado, API REST ou telemetria integrada.
Se uma página depende quase inteiramente de JavaScript ou não está disponível sem autenticação, o agente deve procurar uma fonte HTML alternativa, documentação pública, um espelho ou outra fonte acessível.
Essas limitações se aplicam à versão atual do Cluefinch MCP e ajudam a manter a arquitetura local, previsível e sob seu controle.
Configuração de desenvolvimento
Para trabalhar com o código-fonte, você precisa de uv e Python 3.12.4 ou posterior.
git clone https://github.com/cluefinch/mcp-server.git
cd mcp-server
uv python install 3.12
uv sync --locked
Você pode então executar o servidor diretamente da árvore de trabalho:
uv run cluefinch
Se você precisar de uma instância local do SearXNG para desenvolvimento, use o exemplo de configuração pronto. Se você já tem sua própria instância do SearXNG, basta definir seu endereço por meio de MCP_SEARCH_SEARXNG_URL.
As principais verificações do projeto são:
uv run ruff check mcp_search tests scripts
uv run ruff format --check mcp_search tests scripts
uv run pytest -q
uvx --from 'pyright==1.1.414' pyright --pythonpath .venv/bin/python mcp_search scripts
uv build
O CI testa as versões suportadas do Python no Ubuntu e Windows e também verifica os limites inferiores das dependências diretas.
Informações detalhadas sobre o ambiente de desenvolvimento local, testes de fumaça, configuração do IDE, avaliação de comportamento do agente e requisitos da árvore publicável estão disponíveis em docs/DEVELOPMENT.md.
Contribuindo, suporte e segurança
Se você quiser propor uma mudança, relatar um problema ou contribuir com o projeto, comece com CONTRIBUTING.md. Ele descreve os requisitos para pull requests, testes e o Developer Certificate of Origin (DCO).
Para dúvidas de uso e suporte, veja SUPPORT.md.
Se você descobrir uma vulnerabilidade ou outro problema relacionado à segurança, não publique os detalhes em uma Issue regular do GitHub. O processo de relato responsável está descrito em SECURITY.md.
Ao criar Issues ou Pull Requests públicos, não publique segredos, URLs privadas, conteúdo de páginas não públicas, arquivos de captura locais ou outros dados sensíveis.
Licença
O código original do Cluefinch MCP é distribuído sob a Apache License 2.0.
O SearXNG é usado como um serviço externo separado e permanece licenciado sob GNU AGPL-3.0. A licença Apache-2.0 do Cluefinch MCP não se aplica ao SearXNG, suas dependências ou ao conteúdo das páginas da web recuperadas pelo agente.
Informações adicionais sobre componentes de terceiros e suas licenças estão disponíveis em THIRD_PARTY_NOTICES.md, enquanto considerações de integração e distribuição do SearXNG estão documentadas em docs/SEARXNG_COMPLIANCE.md.
Veja NOTICE para informações de direitos autorais e atribuição.