local-gpu-imagegen
Geração de imagens local em GPU NVIDIA com confirmação para agentes de IA, via fluxos de trabalho ComfyUI existentes, com identidade de modelo SHA-256, aprovação explícita de licença e sem downloads silenciosos de modelos. Windows 10/11 x64 NVIDIA. MIT.
Documentação
Local GPU Imagegen
Um plano de controle com prioridade MCP, com identidade criptográfica de modelo, aprovações explícitas e evidências duráveis de execução para a configuração ComfyUI que você já utiliza.
Execute um fluxo de trabalho ComfyUI compatível a partir do Codex sem modificar sua configuração.
uvx local-gpu-imagegen verify
uvx local-gpu-imagegen setup codex --apply
A configuração armazena um lançador resolvido e com versão fixada, equivalente a
uvx --from local-gpu-imagegen==0.9.1 local-gpu-imagegen serve; ela não depende de um script de console do ambiente temporário uvx. Se uma entrada mais antiga relatar client_setup_drift, remova apenas essa entrada do cliente e aplique a configuração novamente. Iniciar o ComfyUI não corrige uma falha do lançador MCP; a prontidão do backend é verificada após o cliente carregar o servidor.
Pergunte ao Codex:
Run this supported ComfyUI API workflow from Codex: <path>.
Use this prompt: <prompt>. Preserve every other workflow setting.
Este caminho exige Python 3.11 ou 3.12, Codex, uma instância local do ComfyUI já em execução, um modelo já instalado e um fluxo de trabalho comum de API txt2img usando a topologia integrada compatível. Ele usa seu backend e modelo de imagem local existentes, sem downloads ou trocas silenciosas de modelo. Não instala um backend, não baixa um modelo, não converte JSON no formato de UI nem executa um fluxo de trabalho que exija nós personalizados não compatíveis. Uma opção explícita de início gerenciado para Windows portátil está documentada abaixo.
O escopo de host compatível na v0.9 é Windows 10/11 x64 com NVIDIA. O único wheel py3-none-any descreve empacotamento puramente em Python, não uma edição separada para Linux nem uma afirmação de suporte a geração gerenciada no Linux. O CI do Ubuntu verifica os contratos neutros de plataforma do MCP, empacotamento, backend existente e plataforma não compatível; o Windows executa a suíte completa de bootstrap portátil.
O ComfyUI gera os pixels. O Local GPU Imagegen controla autoridade, reprodutibilidade, revisão e recuperação em torno dessa geração.
Quickstart de cinco minutos | Playbook de lançamento | Alternativas
Traga Seu Próprio Fluxo de Trabalho ComfyUI
A sessão retida de integração de fluxo de trabalho do Codex inspecionou e registrou um grafo compatível e, em seguida, vinculou seus componentes exatos de modelo; ela não enviou um prompt nem usou a GPU. Registros históricos de imagens geradas permanecem disponíveis para auditoria técnica, mas a v0.9 não os utiliza como visuais promocionais nem como evidência de superioridade de qualidade de imagem.
Este caminho exige um backend e modelo de imagem local existentes; não há downloads ou trocas silenciosas de modelo.
Bootstrap Guiado (Windows NVIDIA)
Para um ambiente existente, execute bootstrap status e reutilize apenas uma raiz portátil verificada, checkpoint e endpoint de loopback. Para uma configuração do zero, bootstrap plan mostra o arquivo portátil exato, checkpoint, limite de bytes, URLs de licença, hashes SHA-256, requisitos de disco/VRAM e rollback limitado; bootstrap apply exige a confirmação explícita mostrada. Os downloads são retomáveis e nunca silenciosos. O escopo congelado é Windows 10/11 x64 com NVIDIA RTX 20-series ou mais recente, 10 GiB de VRAM e 30 GiB de disco livre. Docker não é necessário. Este contrato de bootstrap sem modelo não prova geração de imagem nem prontidão para produção.
setup é somente leitura sem --apply. O caminho de aplicação delega ao comando oficial mcp add do cliente; o Local GPU Imagegen não edita arquivos de configuração do cliente diretamente nem baixa um modelo.
Prova de confiança: o resultado retido da rota comum veio de uma sessão instalada do Codex. A descoberta não carregou pesos; a identidade de confiança e rota foi explícita; as rodadas bem-sucedidas foram limitadas; a revisão usou o PNG em resolução original; a finalização foi vinculada aos bytes revisados; e o estado da execução permanece recuperável. A evidência prova este único resultado, não a aceitação completa 9+3, desempenho medido ou prontidão para produção.
Aceitação local da v0.9: uma instalação nova de Windows/NVIDIA construída a partir do arquivo ComfyUI aprovado pelo usuário e do checkpoint SDXL atingiu prontidão gerenciada, serviu exatamente dezessete ferramentas MCP e finalizou uma imagem de ambiente não humana revisada com hashes de origem e final idênticos em bytes. O artefato permanece local até uma exportação sanitizada separada e não é incluído no pacote. Duas tentativas separadas de personagem falharam na revisão estrita de mão, olho ou cauda; portanto, a qualidade de anatomia humana proeminente não está estabelecida.
Início Gerenciado Opcional do ComfyUI
A configuração do Windows pode registrar uma raiz portátil existente para início gerenciado:
uvx local-gpu-imagegen setup codex --apply `
  --auto-start-comfyui `
  --comfyui-root "<ComfyUI_windows_portable>"
O comando opt-in valida o layout portátil fixo e registra python_embeded\python.exe -s ComfyUI\main.py em 127.0.0.1:8188. Ele não instala o ComfyUI nem baixa um modelo. Um endpoint já em execução é reutilizado, mas nunca possuído ou interrompido. Um processo filho iniciado pelo processo MCP é interrompido na saída do MCP somente quando sua fila está vazia; uma fila não vazia é retida e relatada. Ambos os modos usam o backend e modelo existentes, sem downloads ou trocas silenciosas de modelo. A execução do fluxo de trabalho permanece limitada a topologias integradas compatíveis; o início gerenciado não remove nem gerencia nós personalizados já presentes na instalação portátil selecionada.
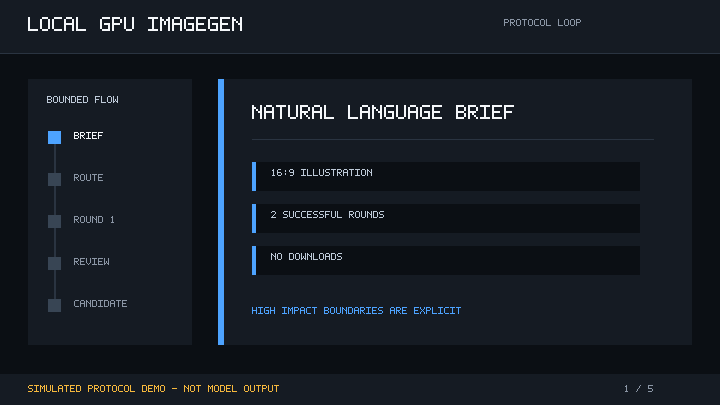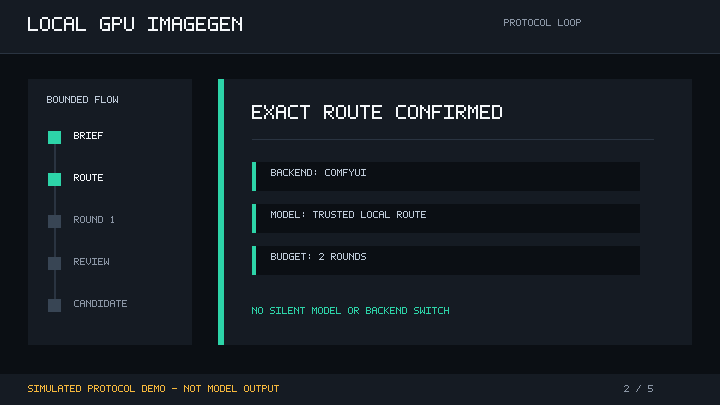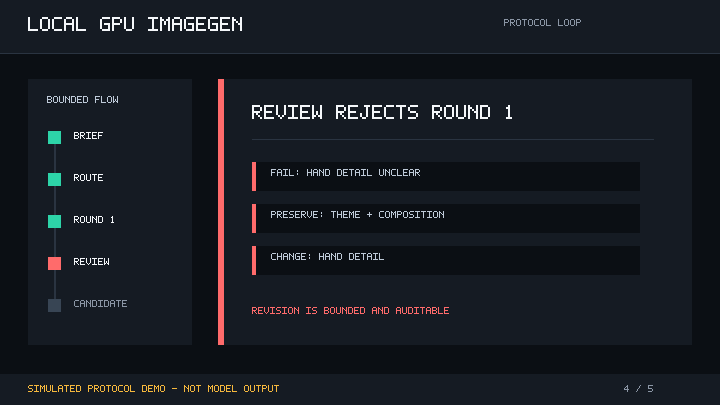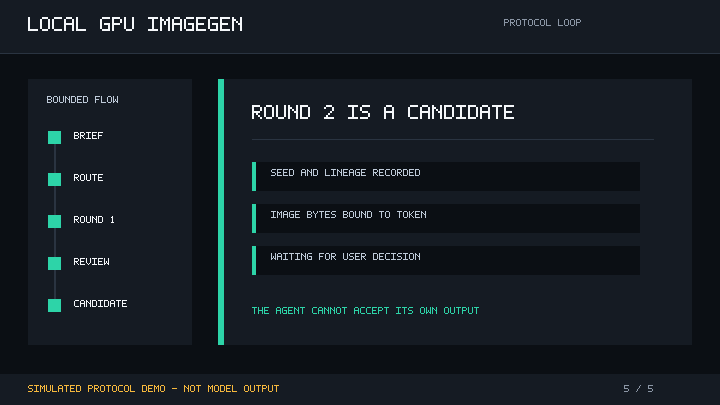
A animação é uma demonstração determinística simulada do protocolo, não saída de modelo nem evidência de qualidade de imagem. Ela permanece secundária ao protocolo e às evidências de teste. Testes sem modelo cobrem o protocolo e os contratos de backend, não qualidade de imagem, geração mais ampla em clientes nomeados, desempenho ou aceitação completa 9+3.
Para Claude Code, use uvx local-gpu-imagegen setup claude-code --apply. Remova as entradas com codex mcp remove local-gpu-imagegen ou claude mcp remove --scope user local-gpu-imagegen. Use uvx local-gpu-imagegen doctor para inspecionar a prontidão do backend local. Os contratos de configuração e lançamentos stdio equivalentes são verificados; uma geração retida com cliente instalado do Codex é mantida, enquanto a geração com Claude Code permanece pendente. Consulte Compatibilidade de clientes.
O DeepSeek Harness (DSH) conecta-se pelo mesmo protocolo MCP stdio padrão, sem comando de configuração: registre o servidor por meio de dsh plugin --profile <name> add ou aponte qualquer cliente compatível com MCP para scripts/mcp_server.py. Uma execução real orientada por DSH completou a sequência completa de discover_models (api_only) → recommend_models → start_run → get_run → generate_round contra um checkpoint ComfyUI ativo e produziu um artefato round-01.png; initialize/tools/list/ping, verify_mcp.py e verify_client_configs.py passam todos.
Antes da publicação no PyPI, instale o wheel verificado ou um checkout da fonte e, em seguida, use os comandos equivalentes local-gpu-imagegen verify e local-gpu-imagegen setup ....
Por Que Este Projeto
- Execute fluxos de trabalho compatíveis a partir do seu Agente: inspecione e registre grafos comuns de API ComfyUI em vez de reconstruí-los como scripts pontuais.
- Reutilize ou gerencie explicitamente seu backend: o ComfyUI é o caminho principal para fluxos de trabalho existentes; um supervisor portátil opt-in para Windows remove a inicialização manual sem assumir a propriedade de um processo existente. AUTOMATIC1111/Forge e Diffusers permanecem como caminhos de compatibilidade.
- Torne as execuções reproduzíveis: congele fluxo de trabalho, identidade de modelo, prompts, configurações, semente, orçamento e hashes de saída em um manifesto durável.
- Use a CLI instalada: verifique a prontidão e delegue a configuração ao comando oficial do Codex ou Claude Code sem exigir um checkout da fonte.
- Mantenha a autoridade do modelo explícita: a descoberta nunca carrega pesos, e a geração não pode baixar ou trocar um modelo silenciosamente.
- Retenha evidências estruturadas: rotas, orçamentos, tentativas, hashes de imagem, revisões e ações de recuperação permanecem legíveis por máquina e duráveis.
- Mantenha a aceitação com o usuário: revisão em resolução original e finalização posterior vinculada a bytes separam uma imagem gerada de um final aceito.
- Fluxo de trabalho guiado por agente: uma Skill de Agente incluída transforma um briefing em linguagem natural em uma execução confirmada e limitada por catálogo.
- Três Perfis de entrega: ilustrações independentes, visuais de apresentação e ativos visuais de UI compartilham um contrato determinístico de execução e revisão.
- Revisão quente auditável: uma execução filha imutável registra um contrato de preservar/alterar e usa refinamento de prompt, img2img ou inpainting explicitamente confirmado.
- Camada MCP leve em dependências: verificações de protocolo e testes usam a biblioteca padrão do Python e não exigem GPU.
- Escopo focado: a geração de imagens é mantida separada de planejamento, memória e recursos não relacionados do agente.
Controles Experimentais de Composição
O caminho dourado usa sdxl-txt2img comum. As rotas sdxl-regional-txt2img e sdxl-two-stage-copy-subject permanecem experimentais, não fazem parte do caminho dourado e não fornecem fallback da rota comum. Suas evidências negativas retidas não estabelecem uma melhoria de qualidade visual.
Limite de Qualidade de Imagem
A qualidade do modelo e do fluxo de trabalho permanece fornecida pelo usuário. O Local GPU Imagegen adiciona execução, revisão, recuperação e evidências explícitas; ele não modifica algoritmos de difusão nem garante que um fluxo de trabalho de prompt melhore uma imagem. A revisão agora trata uma alteração no meio de produto solicitado, assunto, uso prático ou slot de ativo como substituição semântica e uma restrição falha, mesmo quando a substituição parece mais limpa.
Consulte Controle de qualidade de imagem e o portão congelado de não regressão de fluxo de trabalho. O portão retido terminou em FAIL_WORKFLOW_REGRESSION; nenhuma alegação pública de superioridade de qualidade de imagem é suportada.
Checkout da Fonte e Configuração do Backend
1. Verifique o Servidor MCP
Python 3.11 ou 3.12 é suficiente para esta verificação. Nenhuma GPU, modelo ou cliente de IA é necessário.
python .\scripts\verify_mcp.py
Resultado esperado:
{
  "ok": true,
  "transport": "stdio",
  "python": "<current-python>",
  "server": {"name": "local-gpu-imagegen", "version": "0.9.1"},
  "protocolVersion": "2024-11-05",
  "tools": [
    "local_gpu_branch_run",
    "local_gpu_cleanup_run",
    "local_gpu_confirm_mask",
    "local_gpu_discover_models",
    "local_gpu_finalize_run",
    "local_gpu_generate_image",
    "local_gpu_generate_round",
    "local_gpu_get_run",
    "local_gpu_imagegen_check",
    "local_gpu_list_profiles",
    "local_gpu_prepare_mask",
    "local_gpu_recommend_models",
    "local_gpu_record_review",
    "local_gpu_register_workflow",
    "local_gpu_set_model_trust",
    "local_gpu_start_run",
    "local_gpu_inspect_workflow"
  ]
}
2. Escolha um Backend
| Backend | Melhor quando | Configuração | Comportamento de rede |
|---|---|---|---|
| WebUI | AUTOMATIC1111 ou Forge já está instalado | Inicie-o com acesso à API habilitado | Prompts/imagens vão para a URL WebUI configurada |
| ComfyUI | Você já executa o ComfyUI e deseja execução de grafo revisada | Inicie você mesmo ou opte por setup --auto-start-comfyui --comfyui-root <root> para uma instalação portátil existente do Windows | Prompts/imagens vão apenas para o endpoint de loopback ou confirmado separadamente |
| Diffusers | Você deseja um pipeline Python autossuficiente | Crie o projeto .venv com scripts/install.ps1 | Downloads de modelo/LoRA são bloqueados, a menos que explicitamente permitidos |
Verifique a prontidão atual:
python .\scripts\check_gpu.py
O comando retorna JSON. ready: false é um estado de diagnóstico válido, não uma falha de protocolo.
O início gerenciado é explícito e somente para Windows portátil. Ele força o isolamento do Python -s para que pacotes Torch do site do usuário não contaminem o runtime portátil, inicia em segundo plano para que a inicialização do MCP não seja atrasada e permite que a primeira verificação de prontidão gerenciada aguarde até o tempo limite de inicialização configurado. O próprio doctor permanece somente leitura e nunca inicia um backend.
Para verificar o servidor MCP sob um ambiente virtual específico e chamar a prontidão por meio do MCP:
python .\scripts\verify_mcp.py `
  --python .\.venv\Scripts\python.exe `
  --check-readiness
3. Conecte um Cliente MCP
O .mcp.json incluído usa um comando relativo e cwd. Para um cliente com configuração global, substitua <project-root> pelo caminho absoluto deste clone:
{
  "mcpServers": {
    "local-gpu-imagegen": {
      "command": "python",
      "args": ["<project-root>\\scripts\\mcp_server.py"]
    }
  }
}
Reinicie o cliente e, em seguida, chame local_gpu_imagegen_check antes da primeira geração.
4. Peça um Ativo Visual
A Skill de Agente incluída aceita solicitações comuns. Por exemplo:
Crie uma ilustração de personagem de anime independente em 16:9, sem texto gerado. Use até duas rodadas bem-sucedidas, mantenha os downloads desabilitados e pergunte antes de alterar a semente.
A Skill não adivinhará a partir de um nome de arquivo de checkpoint nem selecionará silenciosamente um backend. Ela descobre o inventário local atual, aplica confiança local do usuário, recomenda uma rota exata e aguarda confirmação sem baixar um modelo.
Fluxo de Trabalho da Skill de Agente
- Chame
local_gpu_discover_modelsno modoapi_onlyquando o inventário for desconhecido. Varreduras mais amplas exigem um plano exibido e confirmação exata antes do acesso ao sistema de arquivos. - Use
local_gpu_set_model_trustsomente após exibir uma identidade exata e receber sua confirmação de confiança exata. Uso privado e evidência pública são escopos separados. - Chame
local_gpu_list_profilespara o escopo de autorização pretendido. Reutilize valores breves conhecidos e pergunte apenas por limites de alto impacto ausentes. - Chame
local_gpu_recommend_models. Ele retorna uma rota exata e no máximo duas alternativas sem enfraquecer requisitos rígidos. - Exiba o
model_choiceexato resolvido, backend, força/hash de identidade ou aviso de vinculação, fluxo de trabalho, compilador, dimensões e orçamento. Aguarde uma nova confirmação explícita após essa exibição. - Inicie a rota congelada -> leia a execução congelada persistida -> construa o plano de geração completo -> gaste no máximo o orçamento confirmado de rodadas bem-sucedidas. Copie todos os campos de rota, identidade, fluxo de trabalho, compilador, política e orçamento dessa execução antes de adicionar prompts e parâmetros. Uma imagem retida consome uma rodada; uma falha de backend não.
- Em um host com capacidade de visão, exiba e inspecione a imagem original em resolução total. Registre as verificações exigidas de anatomia, pés/contato, mãos/objetos e texto/marca d'água com a rubrica completa; apenas uma prévia é insuficiente. Verificações falhas ou incertas exigem refine ou explore. Um refine preserva a semente; um explore altera a semente.
- Quando uma revisão elegível retornar o status de qualidade
candidate, exiba suas limitações, o SHA-256 da imagem e o valor exato definalize:<run_id>:<round_number>:<image_sha256>, e então pare. Somente uma mensagem posterior do usuário contendo esse valor exibido pode autorizar a finalização; o Agente não pode aceitar seu próprio candidato. - Em um host somente texto, retenha exatamente uma rodada bem-sucedida, marque
review unavailable, relate o caminho não revisado e pare. Não invente pontuações nem chame ferramentas de revisão/finalização.
Após um candidato revisado ou finalizado, o usuário pode descrever o que manter e o que alterar. A Skill apresenta um contrato auditável de preservar/alterar, pede um orçamento separado de revisão de uma a três rodadas e cria uma execução filha imutável somente após confirmação. Ela escolhe o modo menos destrutivo: refinamento de prompt com a mesma semente, depois img2img de baixa intensidade, depois inpainting com confirmação explícita de sobreposição de máscara. A preservação sem máscara é melhor esforço.
Para a rota opcional copy-subject-v1, o Agente exibe ambas as regiões normalizadas como decimais e porcentagens, ambos os prompts e intensidades regionais, a rota exata de sdxl-regional-txt2img e o orçamento de rodadas bem-sucedidas antes da confirmação. A geometria é congelada para essa execução. O refinamento pode alterar prompts ou intensidades regionais, mas mover uma região exige uma raiz ou filho recém-confirmado; capacidade regional indisponível ou desviada nunca recorre a sdxl-txt2img somente com prompt.
Para a rota opcional sdxl-two-stage-copy-subject, local_gpu_set_model_trust aceita o two_stage_layout exato; chamadores nunca fornecem control_sha256. O servidor normaliza esse layout, inspeciona o fluxo de trabalho enviado, deriva o digest de controle e inclui os digests de fluxo de trabalho, pacote e controle na confirmação de confiança exibida. Aprovação e roteamento posterior exigem o mesmo layout normalizado, fluxo de trabalho, pacote de componentes, endpoint e identidade do modelo. O Agente também exibe geometria de pixels e porcentagens, as sementes base e derivada do assunto, o condicionamento do assunto e o orçamento de dois estágios. Uma rodada custa duas unidades de estágio e retém três PNGs vinculados a papéis: um artefato base, um artefato de máscara e um artefato final. As portas de pixel protegido e máscara salva são executadas antes da revisão; um resultado parcial para sem fallback. Tanto a base quanto o final recebem revisão de estágio em resolução total, e somente o artefato final pode se tornar candidato. A primeira porta GPU ao vivo é exatamente uma rodada de dois estágios.
A rota regional anterior de passagem única copy-subject-v1 permanece como evidência negativa retida e compatibilidade experimental. Seu contrato de controle sem modelo permanece útil, mas a saída observada não estabelece uma melhoria de qualidade visual. Nenhuma rota é apresentada como evidência positiva de qualidade de imagem até que exista aceitação retida em resolução total.
A sequência adaptativa é descoberta -> confiança quando necessário -> catálogo com escopo -> breve -> recomendação de rota exata -> confirmação pós-exibição -> iniciar -> ler execução persistida -> construir plano completo -> gerar -> inspecionar em resolução total -> revisar -> refinar/explorar ou exibir candidato -> aguardar mensagem posterior do usuário -> finalizar. O max_rounds configurado deve ser de 1 até 3, e urgência ou custo irrecuperável nunca o estende.
Perfis Visuais E Escopo
| Perfil | Subtipos suportados | Foco de entrega |
|---|---|---|
standalone-illustration | character, environment, wallpaper | Saída de ilustração autocontida. |
presentation-visual | cover, section, content-background | Ativos de slide somente visuais com restrições de área segura e sobreposição. |
ui-visual-asset | hero, section-illustration, rectangular-background, decorative-texture | Visuais raster que podem ser compostos em uma interface. |
Apresentações PPT completas são excluídas. Código de frontend e componentes são excluídos. Ícones de produção, SVG e PNG transparente são excluídos. Segmentação automática é excluída. Garantias de textura sem emenda são excluídas. O projeto produz ativos raster inspecionáveis, não layouts de slides ou implementações de interface.
Traga Seu Próprio Modelo com Segurança
A descoberta tem quatro níveis: api_only, selected_folders, common_locations e full_drive. A descoberta de sistema de arquivos é em dois estágios: index registra metadados limitados sem abrir payloads de checkpoint; fingerprint calcula SHA-256 somente para candidatos indexados explicitamente selecionados. .ckpt permanece opaco, e varreduras não seguem symlinks, junctions ou reparse points.
A confiança é armazenada fora do repositório, no diretório de estado do usuário do SO, substituível com LOCAL_GPU_IMAGEGEN_STATE_DIR. Uma identidade backend_binding pode ser confiável somente para uso private. Para rotas ComfyUI divididas, a ferramenta de confiança primeiro oferece uma ação de inspeção não mutável que vincula o modelo primário, codificador de texto, VAE e fluxo de trabalho revisado em um único pacote SHA-256 canônico. O digest exato do pacote faz parte da confirmação de confiança e do token de rota posteriores. Um pacote criptográfico pode se tornar um candidato public_evidence somente com metadados exatos de fonte, licença e redistribuição de saída para cada componente; a autoridade de aceitação deve aprovar esse mesmo pacote antes da exportação.
Onboarding Seguro de Fluxo de Trabalho
Fluxos de trabalho existentes no formato de API ComfyUI podem ser inspecionados e registrados sem IDs de nó fornecidos pelo chamador quando são grafos txt2img comuns usando topologia de checkpoint único ou de modelo dividido. A sequência limitada é:
API-only discovery (when current inventory is absent)
-> local_gpu_inspect_workflow
-> display hashes, inferred binding, components, limitations, confirmation
-> later exact user confirmation
-> local_gpu_register_workflow
-> separate local_gpu_set_model_trust with `registered_workflow_id`
A inspeção lê um arquivo JSON local explícito, aceita um grafo de API simples ou um wrapper prompt único, e relata source_sha256, workflow_sha256, topologia, vinculação inferida, saída própria e identidades de componentes. Resultados registráveis incluem register_workflow:<source_sha256>:<proposal_digest>; resultados de diagnóstico não têm confirmação. O formato de UI não é convertido; o registro não concede confiança de modelo nem autoridade pública. Evidência de onboarding de cliente real com zero GPU é retida; evidência de geração permanece separada.
Nenhum peso de modelo é incluído. O catálogo do repositório inclui o ID auditável civitai/anything-v5@30163 para um checkpoint WebUI local já revisado, e downloads permanecem não aprovados. Outros modelos locais podem entrar no catálogo privado somente por descoberta e confiança explícita; a qualidade do modelo ainda vem do modelo do usuário. Este projeto adiciona roteamento mais seguro, revisão durável e revisão rápida, em vez de reivindicar um tradutor de prompts superior.
O ComfyUI inclui arquivos de fluxo de trabalho revisados sd15-txt2img-v1.json, sdxl-txt2img-v1.json, sdxl-regional-txt2img-v1.json, sdxl-two-stage-copy-subject-v1.json, z-image-turbo-txt2img-v1.json e anima-txt2img-v1.json. A descoberta distingue CheckpointLoaderSimple, UNETLoader, CLIPLoader e VAELoader. Uma rota privada vinculada ao backend pode ainda vincular apenas o carregador primário, mas a elegibilidade de evidência pública para um fluxo de trabalho dividido exige identidades de API atuais mais identidades SHA-256 do sistema de arquivos para cada componente congelado. Uma instalação pura de modelo dividido pode não ter opções de checkpoint. Shell, execução de Python/script/processo, nós de rede/download/webhook/fetch, comandos, nós personalizados desconhecidos, parâmetros não vinculados e estouros de recursos são rejeitados.
Os arquivos de fluxo de trabalho não incluem, instalam, confiam ou licenciam pesos de modelo. Z-Image e Anima ainda exigem descoberta local exata, aprovação do usuário e uma rota confirmada. Anima é uma rota de anime opcional e não deve ser apresentada como padrão comercial ou de evidência pública sob suas restrições de peso upstream. Adaptador ComfyUI: testado por contrato; execuções locais do adaptador Z-Image e Anima: observadas; evidência de aceitação pública: não retida.
Referência de Ferramentas
A superfície pública do MCP tem exatamente dezessete ferramentas: duas ferramentas de compatibilidade e quinze ferramentas de alto nível de descoberta/onboarding/execução/revisão.
local_gpu_imagegen_check
Relata pacotes Python, dispositivos CUDA, acessibilidade do WebUI e prontidão agregada. Uma máquina pode não estar pronta enquanto a chamada da ferramenta em si é bem-sucedida.
local_gpu_generate_image
Suporta:
txt2img,img2imge inpainting- sementes fixas
- seleção de checkpoint e sampler do WebUI
- seleção de agendador do Diffusers
- carregamento de LoRA
- tiling de VAE e offload opcional de CPU
- fallback explícito de CPU
- permissão explícita de download de modelo/LoRA
O esquema da ferramenta valida tipos, intervalos, enums, campos desconhecidos, requisitos de modo de imagem e dimensões antes de iniciar o processo de backend.
Essas duas ferramentas de compatibilidade permanecem disponíveis ao lado das quinze ferramentas de alto nível. Em particular, a ferramenta de compatibilidade de baixo nível local_gpu_generate_image permanece inalterada: seu valor de modelo opcional permanece um passthrough direto de compatibilidade e não é o fluxo de trabalho do Agente com catálogo. Suas opções de WebUI/Diffusers e controles explícitos de download de modelo permanecem inalterados.
Ferramentas de Execução de Alto Nível
| Ferramenta | Responsabilidade |
|---|---|
local_gpu_discover_models | Planejar ou executar inventário limitado de API/sistema de arquivos sem carregar pesos de modelo. |
local_gpu_inspect_workflow | Inspecionar um fluxo de trabalho comum de API ComfyUI txt2img e retornar hashes e vinculações de diagnóstico ou registráveis. |
local_gpu_register_workflow | Reverificar uma proposta exata e armazenar sua cópia imutável de fluxo de trabalho registrado após confirmação posterior vinculada a digest. |
local_gpu_set_model_trust | Inspecionar um pacote de componentes revisado sem mutação, ou aprovar/revogar uma identidade exata no estado local do usuário após confirmação. |
local_gpu_recommend_models | Retornar uma rota determinística e no máximo duas alternativas explicadas. |
local_gpu_list_profiles | Listar perfis de caso de uso registrados e as capacidades atuais do backend. |
local_gpu_start_run | Persistir uma intenção confirmada, perfil, restrições, escolha de backend e orçamento de rodadas. |
local_gpu_get_run | Ler o manifesto durável e seu recoverable_next_actions. |
local_gpu_branch_run | Criar uma execução filha imutável a partir de uma rodada pai revisada e contrato de preservar/alterar. |
local_gpu_prepare_mask | Preparar uma máscara de usuário ou retângulo/polígono e retornar uma sobreposição JPEG limitada. |
local_gpu_confirm_mask | Confirmar uma máscara preparada inalterada após aprovação explícita do usuário. |
local_gpu_generate_round | Gerar uma rodada raiz ou filha de modo fixo e opcionalmente retornar uma prévia JPEG limitada. |
local_gpu_record_review | Armazenar pontuações de rubrica, verificações visuais estruturadas exigidas, falhas graves, resultados de restrições e preservação, crítica e próxima ação. |
local_gpu_finalize_run | Verificar a confirmação do usuário vinculada à imagem e publicar a rodada elegível nomeada como o PNG local final. |
local_gpu_cleanup_run | Remover intermediários ou todo o diretório de execução confirmado. |
max_rounds deve ser de 1 até 3. Apenas rodadas de PNG retidas com sucesso consomem esse orçamento; uma falha de backend é registrada como uma tentativa sem consumir uma rodada. Cada nova revisão exige full_resolution_inspected: true, esteja ou não um humano proeminente presente, e observações explícitas para separação de membros, pés/contato, mãos/objetos segurados e texto/marcas d'água. Verificações de anatomia humana não podem ser not_applicable; qualquer resultado de fail ou uncertain obrigatório só pode solicitar refine ou explore. |
Uma revisão elegível expõe o status de qualidade candidate, nunca aceitação, e vincula a execução, a rodada e o SHA-256 da imagem retida. O Agente exibe a imagem original, limitações, hash e o finalize:<run_id>:<round_number>:<image_sha256> exato, e então aguarda uma mensagem posterior do usuário. local_gpu_finalize_run exige essa confirmação exata, além do round_number nomeado e do resumo. Ele revalida o candidato sob o bloqueio da execução e então publica essa rodada revisada nomeada sem substituí-la por uma rodada de pontuação mais alta; apenas o resultado publicado recebe accepted.
Um artefato revisado inelegível nunca é publicado. Refine ou explore enquanto houver orçamento confirmado; caso contrário, retenha-o e solicite uma nova decisão do usuário sem publicação. Manifestos finalizados existentes e o caminho de compatibilidade da camada inferior ainda podem conter needs_user_review, mas uma revisão legada não finalizada sem verificações visuais estruturadas não pode produzir um candidato de engine público.
local_gpu_list_profiles retorna o catálogo mesclado com escopo e as capacidades atuais. local_gpu_start_run exige o route_token exato, o escopo de autorização, modelo, backend, dimensões, fluxo de trabalho e compilador que foram exibidos. Desvio de identidade falha antes da invocação do backend; execuções raiz e filhas nunca trocam de rota silenciosamente.
Arquivos de Execução, Repetição e Recuperação
O layout durável padrão é:
outputs/
  runs/
    <run_id>/
      manifest.json
      parent-source.png
      round-01.png
      round-01-preview.jpg
      final.png
      final-upscaled.png
      masks/
        mask-01.png
        mask-01-overlay.jpg
outputs/runs/<run_id>/manifest.json é a fonte da verdade para entrada confirmada, tentativas, rodadas, revisões, avisos, metadados finais e revisões de estado. Uma primeira rodada bem-sucedida retém round-01.png e pode criar round-01-preview.jpg; rodadas posteriores usam o mesmo padrão de pré-visualização com hífen. Manifestos legados armazenados que referenciam round-01.preview.jpg permanecem legíveis e não são reescritos. A finalização publica final.png. Um arquivo de pré-visualização é opcional: a resposta do MCP pode incluir a pré-visualização JPEG limitada, enquanto full_image_path identifica o PNG local em resolução total. Um aviso de pré-visualização ou falha de codificação não descarta o PNG validado.
Uma execução filha imutável copia o PNG pai selecionado para parent-source.png, registra a linhagem e os hashes do pai e nunca grava o manifesto do pai. Img2img e inpaint usam essa fonte retida. Inpaint adicionalmente exige um masks/mask-01.png confirmado; masks/mask-01-overlay.jpg é retornado para aprovação primeiro. Alterar os bytes da fonte ou da máscara invalida a confirmação.
Cada solicitação de geração precisa de um idempotency_key. Repetir a mesma chave com a mesma solicitação retorna a rodada concluída ou informa que a tentativa está ocupada; reutilizar a chave para entradas diferentes é rejeitado. Após interrupção, chame local_gpu_get_run e siga recoverable_next_actions. O engine pode recuperar tentativas obsoletas e retomar a criação de pré-visualização quando um PNG completo validado já foi retido.
A limpeza é explícita. Para ambos intermediates e all, a confirmação deve ser exatamente igual ao run_id. O escopo intermediates preserva o manifesto e o arquivo final publicado; all remove o diretório de execução confirmado.
Pós-processamento Opcional Anime Real-ESRGAN
O pós-processamento 4x exclusivo para anime é explícito e local. Configure a raiz da ferramenta apenas com LOCAL_GPU_IMAGEGEN_REALESRGAN_DIR; o servidor aceita apenas realesrgan-ncnn-vulkan.exe mais um dos pares de modelos suportados, realesrgan-x4plus-anime ou realesr-animevideov3-x4, sob essa raiz. Ele não aceita caminho executável ou nome de modelo arbitrário e não baixa binário ou modelo.
Nenhum pós-processador é executado automaticamente. Mesmo upscale_policy: auto registra apenas permissão: o chamador deve passar o objeto postprocess exato para local_gpu_finalize_run, e o estilo confirmado deve ser anime. Uma solicitação bem-sucedida preserva o final.png original, retorna final-upscaled.png e registra modelo, escala, caminhos de origem/saída, hashes, dimensões e tipos MIME nos metadados finais de pós-processamento. Pós-processamento indisponível ou com falha recai para o final original com um aviso estruturado. O comportamento real de binário, GPU, qualidade e desempenho permanece não verificado.
Uso Independente
Gere por meio de uma WebUI já em execução:
python .\scripts\generate_image.py `
  --backend webui `
  --prompt "a small robot reading a circuit diagram, clean concept art" `
  --width 1024 --height 1024 --seed 42
Crie um ambiente Diffusers local ao projeto:
powershell -ExecutionPolicy Bypass -File .\scripts\install.ps1
O Diffusers não buscará arquivos de modelo ausentes por padrão. Após revisar a licença do modelo e o requisito de armazenamento, opte por uma execução específica:
.\.venv\Scripts\python.exe .\scripts\generate_image.py `
  --backend diffusers `
  --model stabilityai/sd-turbo `
  --allow-download `
  --prompt "a compact lunar research station, technical concept art" `
  --seed 42
Os arquivos da ferramenta de compatibilidade usam por padrão outputs/. Substitua isso com LOCAL_GPU_IMAGEGEN_OUTPUT_DIR ou --output-dir. Execuções de alto nível usam o layout runs/<run_id>/ sob essa raiz de saída.
Arquitetura
flowchart LR
    A["MCP client"] -->|"stdio JSON-RPC"| B["Thin MCP server"]
    B --> H["Discovery + trust + capability router"]
    H --> C["Frozen route + durable run engine"]
    C --> E["AUTOMATIC1111 / Forge adapter"]
    C --> I["Reviewed ComfyUI workflow adapter"]
    C --> F["Diffusers compatibility runner"]
    E --> G["Full local PNG + bounded preview"]
    I --> G
    F --> G
    G --> C
    C --> B
    B --> A
A camada de transporte é responsável por JSON-RPC, esquemas, validação, despacho, tempos limite e resultados estruturados. O engine de execução é responsável pela orquestração e delega o estado durável a RunStore; carregamento de backend e geração de imagem permanecem em scripts/generate_image.py.
Consulte Arquitetura para o fluxo de controle detalhado e o modelo de erros.
Segurança e Privacidade
- O processo MCP não usa uma API de imagem em nuvem específica do aplicativo.
- Um endpoint LAN WebUI/ComfyUI confirmado envia prompts e imagens de origem para esse servidor. Loopback é local; cada endpoint LAN exige confirmação exata de transmissão, e endpoints de internet pública são rejeitados.
- A descoberta não segue links nem carrega cargas úteis de checkpoints. Varreduras mais amplas do sistema de arquivos exigem um plano inalterado e não expirado e confirmação exata.
- O estado de confiança permanece fora do Git. Confiança privada nunca autoriza evidência pública, e credenciais são rejeitadas recursivamente.
scripts/install.ps1baixa pacotes Python quando o usuário o executa.- Downloads de modelos e LoRAs do Diffusers exigem
--allow-downloadou MCPallow_download: true. - Desativar um verificador de segurança de modelo é explícito e desativado por padrão.
- Imagens de entrada e arquivos gerados permanecem arquivos locais comuns; proteja seus diretórios com permissões de SO apropriadas à sua sensibilidade.
Consulte Segurança antes de expor uma API WebUI além de localhost.
Teste
A suíte não exige GPU e não baixa modelos:
python -m unittest discover -s tests -v
python .\scripts\verify_mcp.py
A cobertura inclui inicialização de protocolo/listagem/ping, o contrato exato de dezessete ferramentas, descoberta limitada/onboarding/confiança/roteamento, contratos de adaptadores WebUI e ComfyUI, transições duráveis raiz/filha, comportamento fixo de rota/condicionamento/exaustão SDXL de duas regiões, confirmação de máscara, idempotência, recuperação de tentativas obsoletas, publicação atômica, tratamento limitado de pré-visualização, o loop de anime simulado/sem modelo, todos os nove briefs fixos e três revisões filhas, pós-processamento com runner falso e política de download.
Status do Projeto
Verificado:
- Inicialização MCP stdio, listagem de ferramentas, ping e contrato de ferramentas
- Resultados estruturados de sucesso/erro de ferramentas
- Quinze ferramentas de alto nível de descoberta/onboarding/execução/revisão e duas ferramentas de compatibilidade sob cobertura simulada/sem modelo
- Briefing adaptativo de Skill do Agente, confirmação exata de modelo, orçamento de rodadas bem-sucedidas e política honesta de parada somente por texto
- Identidade exata de modelo local, confiança local do usuário, rota determinística e contratos de rejeição de desvio
- Comportamento explícito do adaptador Real-ESRGAN exclusivo para anime sob testes com runner falso
- Caminhos de sucesso/falha de adaptadores WebUI e ComfyUI testados por contrato
- Transições duráveis de manifesto, idempotência, recuperação, revisão, finalização e contratos de limpeza
- Três contratos de Profile, além de execuções filhas imutáveis de preservar/alterar e máscaras de geometria/usuário confirmadas
- Geometria fixa de cópia/sujeito, condicionamento regional, rejeição de desvio de rota e uma fatia vertical regional sem modelo de duas rodadas
- Identidade de controle em dois estágios derivada do servidor, confirmação de confiança vinculada ao controle, rejeição de vínculo contraditório e recuperação exata de rota sem modelo
- Uma matriz de contrato com backend falso cobrindo nove briefs fixos e três revisões filhas
- Política de hub Diffusers local somente por padrão
- Contratos de CLI instaláveis
serve,doctor,verify,configesetupsomente leitura por padrão, incluindo um teste de fumaça de wheel isolado - Análise de contrato de configuração oficial do Codex e Claude Code, além de lançamentos stdio equivalentes exatos de dezessete ferramentas; Claude Desktop permanece um modelo legado somente de renderização
Pendente antes de uma alegação de 1.0:
- Uma matriz completa de aceitação real 9+3 de host/visão retida
- Evidência real de execução de binário/GPU Real-ESRGAN
- Evidência adicional de sessão de cliente nomeado gerada além do resultado Codex retido, incluindo Claude Code
- Dados medidos de desempenho ou VRAM
- Qualquer alegação de prontidão para produção
A matriz simulada/sem modelo é evidência determinística de protocolo, não o resultado real retido de Codex/visão/GPU. Ela exercita nove briefs fixos e três revisões filhas com um backend falso; não prova qualidade visual. Chamadas locais Z-Image e Anima por meio do adaptador do projeto foram observadas, mas são validação de desenvolvimento local, não evidência pública de aceitação. Registros históricos de imagens geradas permanecem material de auditoria técnica e não são visuais promocionais v0.9. A suíte de testes não carrega modelo de produção, backend GPU ou binário Real-ESRGAN. Nenhuma alegação de produção, desempenho, VRAM, superioridade de qualidade de imagem, Star garantido ou geração mais ampla de cliente nomeado é feita.
O repositório não tem imagem promocional v0.9 aprovada nem matriz completa real de aceitação de imagens 9+3. Ele não faz alegação generalizada de qualidade de imagem, desempenho ou VRAM. Use os comandos de prontidão acima para inspecionar o ambiente de destino.
Documentação
- Arquitetura e modelo de erros
- Solução de problemas
- Compatibilidade de clientes
- Limite de demonstração de protocolo
- Lista de verificação de lançamento
- Notas de integração com Stable Diffusion
- Contribuindo
- Changelog
Licença
Lançado sob a Licença MIT. Pesos de modelo, aplicações de backend e saídas geradas mantêm suas próprias licenças e termos; nenhum é relicenciado por este repositório.