Memclaw
MemClaw — memória persistente para frotas de agentes de IA (código aberto) — Histórico de tendências, métricas de engajamento e discussões do Reddit e Hacker News no Trendshift
Documentação
Caura — Memória compartilhada e governada para agentes de IA
Memória de frota para agentes de IA — governada, compartilhada e autoevolutiva.
MemClaw agora é Caura — mesmo produto, um nome.
As chamadas de ferramenta memclaw_* existentes e os aliases de ambiente MEMCLAW_* suportados continuam funcionando; use os nomes caura_* e as URLs atuais do Caura para novas configurações. O nome no PyPI memclaw-client é mantido apenas como um shell de redirecionamento (0.5.1) que instala caura-client; ele não fornece importação memclaw_client nem classe MemClaw. O pacote npm @caura/memclaw-client nunca foi publicado.



Início Rápido · Recursos · Desempenho · MCP · Referência da API · Documentação do Plugin · Contribuição · Discord
Caura (anteriormente MemClaw) — a camada de memória compartilhada e governada para frotas de agentes de IA
Caura — anteriormente MemClaw — é memória de código aberto para frotas de IA multilocatário e multiagente. Seus agentes armazenam o que aprendem, encontram o que a frota sabe e ficam mais inteligentes a cada interação — aprendendo uns com os outros em vez de repetir erros.
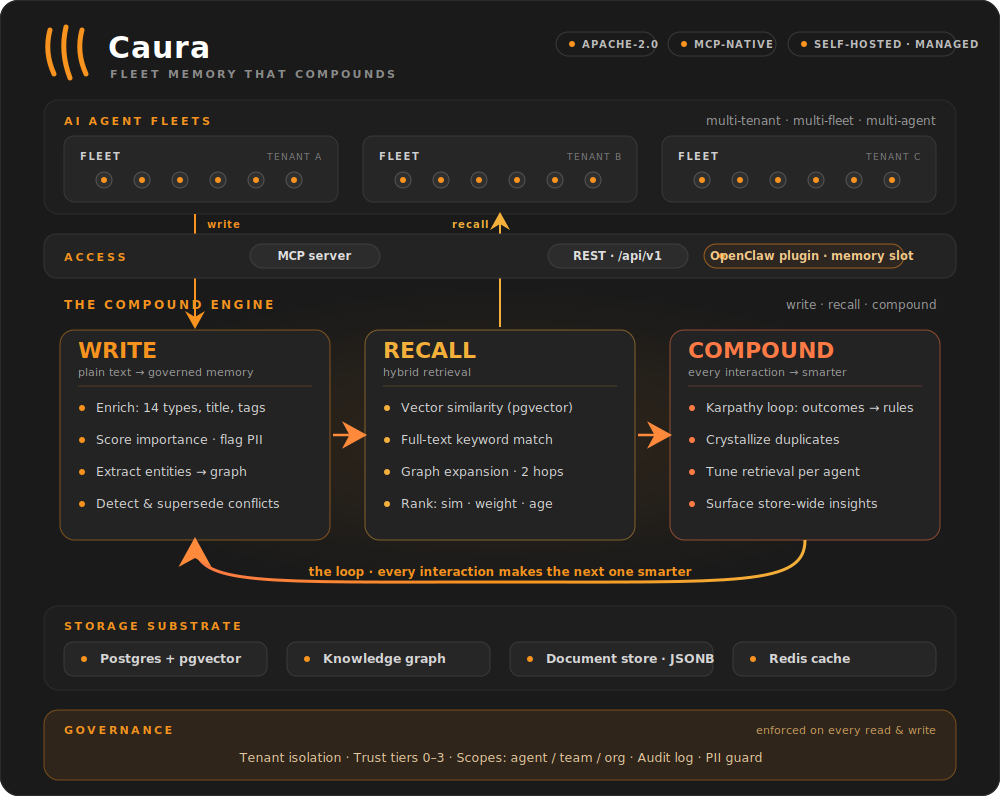
Agentes escrevem texto simples. O Caura o transforma em memória pesquisável, governada e autoevolutiva.
Um ciclo, três pilares: escrever, recuperar, acumular — cada interação torna a próxima mais inteligente.
Otimizado para frotas. Um agente funciona, e é por aí que a maioria dos times começa — nada abaixo muda para uma configuração de agente único. O que o Caura adiciona é margem: memória com escopo, propagação de resultados entre agentes e níveis de confiança em toda a frota estão presentes desde a primeira escrita e continuam gerando valor à medida que os agentes se multiplicam. Os benchmarks públicos de memória de agentes (LoCoMo, LongMemEval) medem um agente, um usuário, uma longa conversa — o formato de chatbot único — então eles avaliam a rampa de entrada em vez dos eixos que se acumulam com o número de agentes: latência, eficiência de tokens e governança. Esse segundo formato é o que vemos em produção: dezenas ou milhares de agentes trabalhando em nome de uma empresa, compartilhando o que aprendem sob governança. Veja Desempenho para os números, ou leia o relatório de benchmarks.
Em produção na eToro (NASDAQ: ETOR): 300+ agentes de IA em uma memória governada — 26.500+ memórias, 1.372 habilidades compartilhadas, 23 ms p50 de busca. Análise aprofundada da arquitetura →
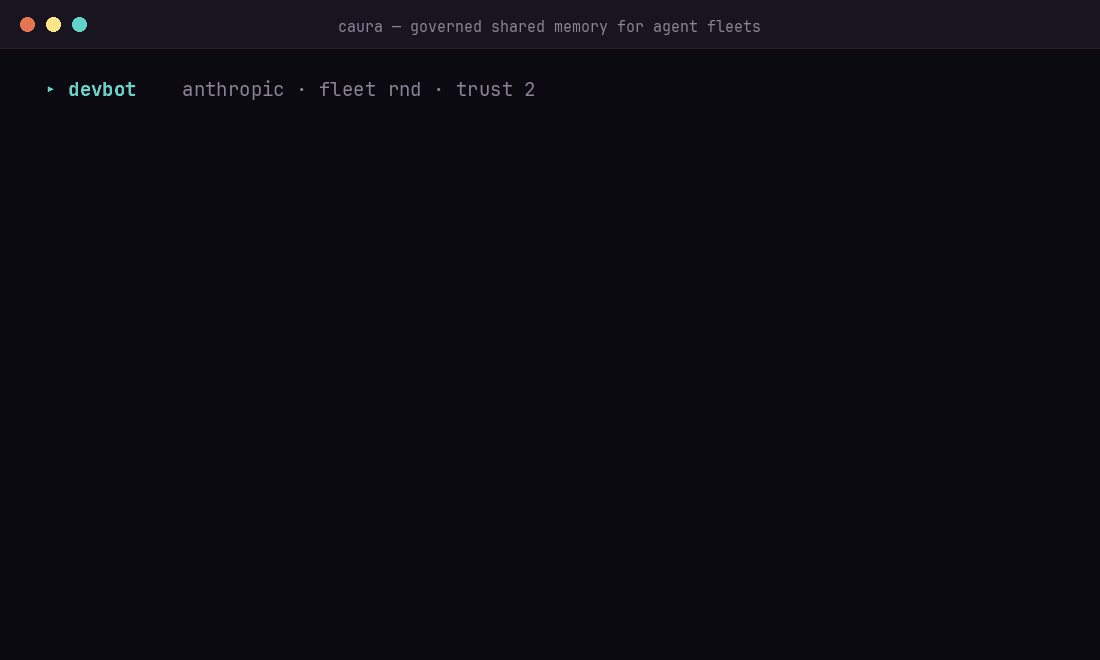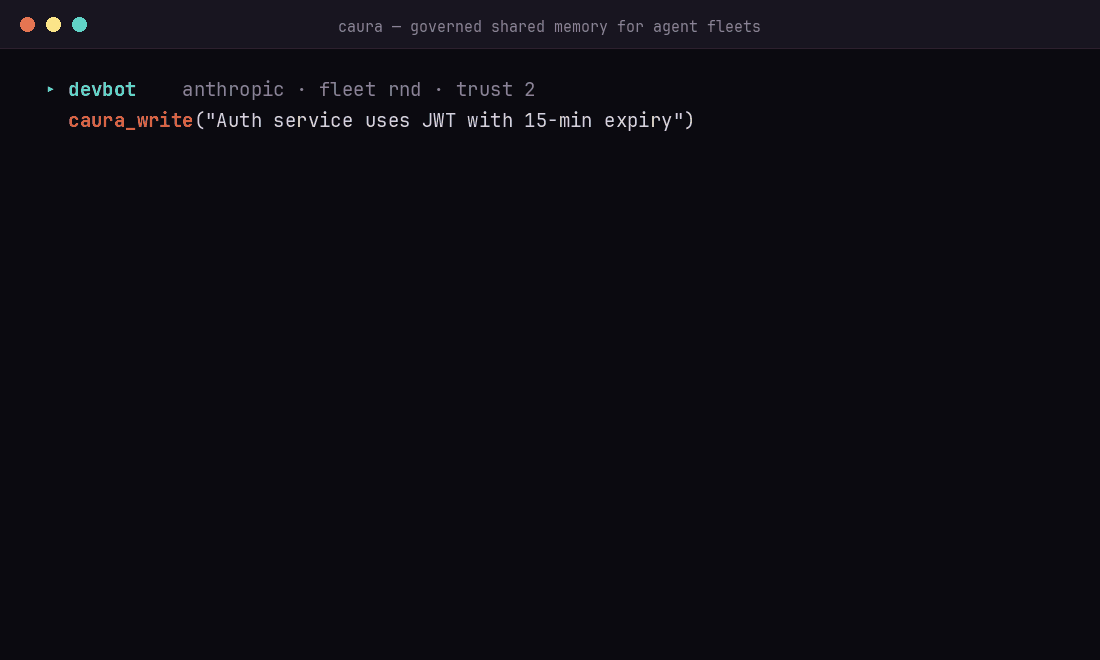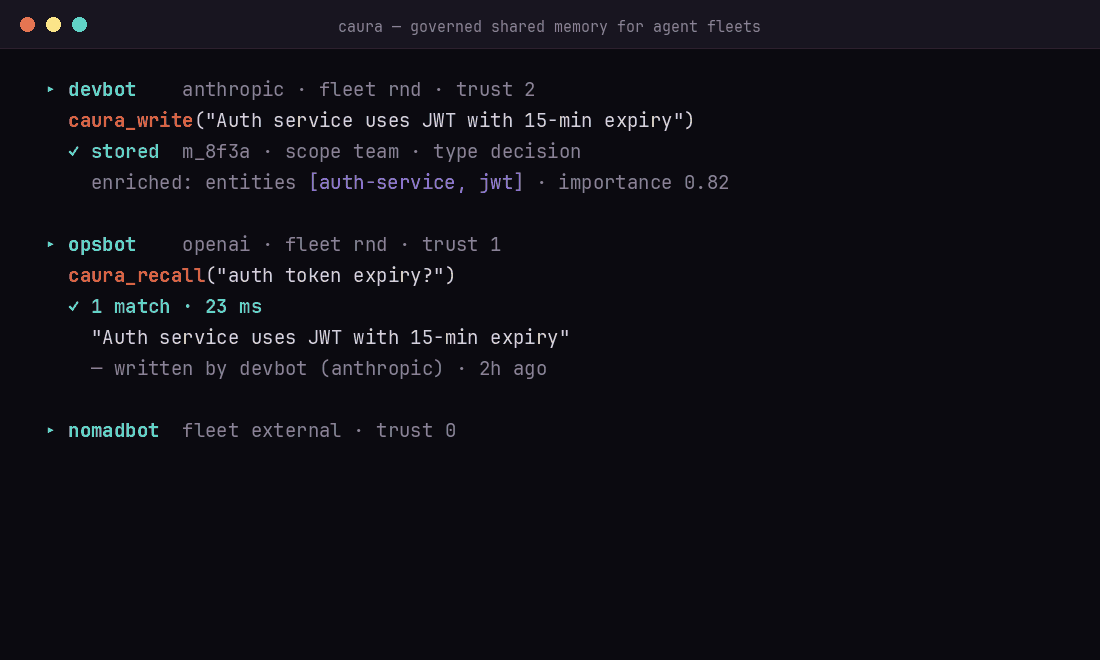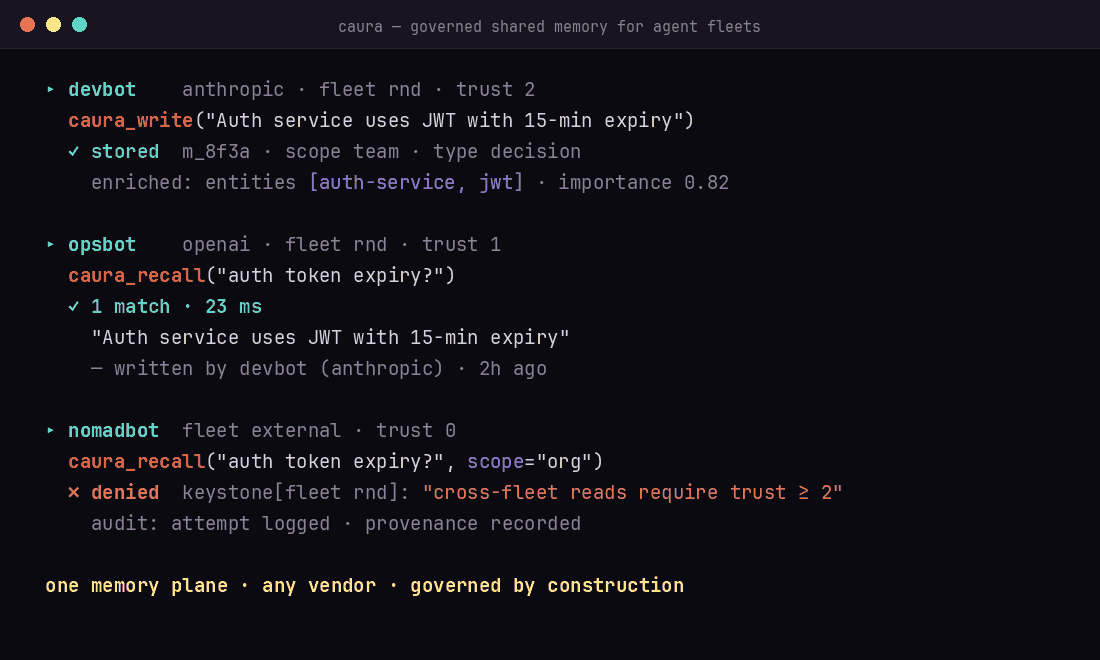
Início Rápido
Experimente localmente — sem chave de API, sem cadastro
A maneira mais rápida de ver o Caura funcionar. O modo autônomo executa em configuração de locatário único com autenticação desativada — inicie o Caura, escreva uma memória e encontre-a novamente. (Ele inicia com embeddings fictícios para que não haja nada para configurar; adicione uma chave de provedor de IA para busca semântica — veja Auto-hospedado abaixo.)
git clone https://github.com/caura-ai/caura.git
cd caura
cp .env.example .env && echo "IS_STANDALONE=true" >> .env   # single-tenant, no API key
docker compose up -d --wait                                 # Postgres + pgvector + Redis + API (~30s)
# Write a memory — no API key needed
curl -X POST http://localhost:8000/api/v1/memories \
  -H "X-API-Key: standalone" -H "Content-Type: application/json" \
  -d '{"tenant_id": "default", "agent_id": "quickstart", "write_mode": "strong", "content": "Our auth service uses JWT with 15-minute expiry."}'

# Find it by keyword — no provider key needed
curl -X POST http://localhost:8000/api/v1/search \
  -H "X-API-Key: standalone" -H "Content-Type: application/json" \
  -d '{"tenant_id": "default", "query": "JWT expiry"}'
A resposta de escrita forte sem chave inclui memory_type, title, status e weight — além de um summary sob metadata — todos derivados por uma heurística local determinística do único campo content. Com um provedor de IA configurado, esses valores são inferidos pelo modelo e metadata também pode incluir tags.
Quer paráfrases semânticas? A consulta sem chave deliberadamente reutiliza palavras da memória. Após configurar um provedor de embeddings na próxima seção, tente
"authentication token lifetime"— corresponder essa frase a "JWT com expiração de 15 minutos" exercita a recuperação semântica.
Veja o efeito de frota
Conecte dois clientes MCP à mesma frota. O Agente A registra uma lição
operacional com caura_write:
{
  "agent_id": "deploy-agent",
  "fleet_id": "platform",
  "visibility": "scope_team",
  "content": "Roll back auth-service with: deployctl rollback auth-service --to <version>."
}
O Agente B pergunta caura_recall a essa frota:
{
  "agent_id": "incident-agent",
  "fleet_ids": ["platform"],
  "query": "How do I roll back auth-service?"
}
O resultado identifica deploy-agent como o autor: um agente aprendeu e
outro reutilizou. scope_agent manteria a memória privada;
scope_team a compartilha dentro da frota; scope_org permite
recuperação governada entre frotas sujeita à escada de confiança.
Para produção, dê a cada cliente sua própria
credencial com escopo de agente.
Pronto para recuperação semântica, multilocatário, um host gerenciado ou uma frota OpenClaw? Escolha um caminho abaixo.
Quatro caminhos — escolha o que corresponde à sua configuração:
| Caminho | Quando | Tempo até a primeira memória |
|---|---|---|
| Plataforma gerenciada | Mais rápido. Nós hospedamos o banco de dados + escalonamento. | ~2 min |
| Auto-hospedado (Docker) | Privacidade / on-premise / ambiente isolado. | ~5 min |
| Plugin OpenClaw | Você já executa uma frota OpenClaw — instale o Caura como plugin contra qualquer um dos acima. | ~3 min |
| Rail SDK | Você escreve o agente, em Python ou TypeScript, e quer que ele recupere regras e fatos antes de cada turno e armazene o que aprendeu depois. Funciona contra qualquer um dos acima. | ~2 min |
Plataforma Gerenciada
Comece em minutos — sem infraestrutura, atualizações automáticas, análises de uso e segurança de nível empresarial incluídas.
- Cadastre-se gratuitamente em caura.ai.
- Copie uma chave de API do painel.
- Conecte via MCP ou REST:
{
  "mcpServers": {
    "caura": {
      "url": "https://caura.ai/mcp",
      "headers": { "X-API-Key": "mc_your_api_key_here" }
    }
  }
}
Para uma frota de produção, provisione uma credencial com escopo de agente por agente. Veja Integração sem o plugin OpenClaw para escopos de credenciais, cabeçalhos e provisionamento.
Usando a chave do painel com escopo de locatário? Passe um agent_id explícito em cada chamada de ferramenta
MCP; o gateway rejeita o padrão reservado mcp-agent nesse caminho.
Auto-hospedado (Código Aberto)
O Docker Compose inicia PostgreSQL + pgvector, Redis, o serviço de armazenamento e a API REST/MCP. O exemplo sem chave acima é o caminho mais curto; adicione um provedor para recuperação semântica.
- Guia completo de auto-hospedagem — provedores, autenticação, topologia de serviços, segurança, operação offline e testes
- Embedder local — busca semântica totalmente local sem chamadas de API em nuvem
- Implantação manual sem Docker
Plugin OpenClaw
Já executa uma frota OpenClaw? Instale o Caura como plugin contra a plataforma gerenciada ou sua pilha auto-hospedada:
O plugin reivindica o slot memory do OpenClaw e expõe as mesmas ferramentas
de memória voltadas ao agente. Use a
configuração de uma linha do instalador de agentes,
e depois veja o guia de integração OpenClaw para
prompts de agente e níveis de confiança. Já tem nós em execução? Manter eles atualizados
— atualização automática e reinstalação manual — é coberto em
docs/plugin-upgrade.md.
O plugin fala apenas com o servidor Caura que você configura (CAURA_API_URL) e
se identifica em cada requisição com
User-Agent: openclaw-plugin/<version> (node/<major>), que o
heartbeat auto-hospedado do servidor usa para contar instalações de plugin conectadas. Ele não enviará
CAURA_API_KEY por http:// simples para nada além de loopback: aponte
CAURA_API_URL para https://, ou defina CAURA_ALLOW_INSECURE_HTTP=true no
.env do plugin para aceitar texto claro em uma rede privada confiável.
Cliente Python
Fale com qualquer implantação Caura gerenciada ou auto-hospedada a partir do Python:
pip install caura-client
Veja o guia do cliente Python para exemplos e a API completa.
Cliente TypeScript
O cliente Node 18+ não tem dependências de runtime:
npm install @caura/client
Veja o guia do cliente TypeScript para instalação e detalhes de compatibilidade de nomes de pacotes.
Rail SDK
Dê memória a um agente em cada turno. O Rail busca as regras de governança e os fatos relevantes para a mensagem atual antes de seu agente executar, entrega contexto pronto para prompt e então extrai e armazena o que o turno ensinou. Python e TypeScript compartilham a mesma semântica; ambos funcionam com Caura gerenciado e auto-hospedado.
pip install caura-rail        # Python 3.10+
npm install @caura/rail       # Node.js 22+
Aponte-o para qualquer Caura com CAURA_URL e CAURA_API_KEY (para o servidor
Docker autônomo acima: http://localhost:8000 e standalone), e então envolva cada
turno do agente:
from caura_rail import MemoryScope, Rail, RestMemoryStore

with RestMemoryStore.from_env() as store:
    rail = Rail(store, MemoryScope(agent_id="support-1", fleet_id="support"))
    with rail.turn("Remember: We deploy in eu-west-1.") as turn:
        # Call your model here; turn.context.text holds rules first, then facts.
        turn.reply = "Noted. " + turn.context.text
    print([w.status for w in turn.writes])   # ['written'], or ['deduplicated'] on a rerun
import { MemoryScope, Rail, RestMemoryStore } from "@caura/rail";

const rail = new Rail({
  store: RestMemoryStore.fromEnv(process.env),
  scope: new MemoryScope({ agentId: "support-1", fleetId: "support" }),
});
const turn = await rail.turn("Remember: We deploy in eu-west-1.", (_, ctx) => "Noted. " + ctx.text);
console.log(turn.writes.map(w => w.status));   // ['written'], or ['deduplicated'] on a rerun
Cada turno recupera, executa seu código, extrai e escreve; um turno cujo código gera erro não escreve nada, e escritas que falham em um erro temporário aguardam em uma caixa de saída que você reproduz. Use os clientes acima quando precisar apenas chamar a API; use o Rail quando um agente deve lembrar e seguir regras. Guia, referência da API e semântica de confiabilidade estão no repositório Rail.
⭐ Se o Caura funcionou para você, marque o repositório com estrela — é assim que outros construtores de frotas nos encontram, e isso molda quanto tempo podemos investir na edição OSS.
Recursos
Governança
- Isolamento de locatário — separação de banco de dados em nível de linha por locatário; PII detectada automaticamente e sinalizada em cada escrita (exibida nos metadados da memória como
contains_pii/pii_types) - Escopos de visibilidade — cada memória é carimbada no momento da escrita:
scope_agent(privada),scope_team(frota inteira, padrão) ouscope_org(entre frotas). A recuperação entre frotas é permissionada, não aberta - Níveis de confiança de agente — quatro níveis controlam leituras, escritas e exclusões entre frotas. Os agentes são provisionados atomicamente via
POST /admin/agent-keys/provision(recomendado — gera chave + linha + confiança + frota em uma chamada) ou auto-registrados na primeira escrita (fallback legado) - Log de auditoria completo — cada escrita, exclusão e transição registrada com contexto de locatário e escopo
- Resumos de atividade de agente — resumos diários e semanais por agente, gerados no lado do servidor para organizações que optaram por participar (configuração da organização
agent_digest.enabled, desativada por padrão). Eles são executados a partir dos ticks de cronagent-digest/agent-digest-weeklydas operações principais e são lidos de volta via endpoints de relatórios emcore-api(GET /api/v1/reports,GET /api/v1/reports/agent-activity). Um locatário que não optou por participar não paga custo algum
Pipeline de Memória
- Enriquecimento LLM de passagem única — cada gravação classifica automaticamente em um dos 14 tipos de memória, gera título/resumo, pontua importância, sinaliza PII e extrai entidades — a partir de um único campo
content - Busca híbrida — similaridade semântica pgvector + correspondência de palavras-chave em texto completo + expansão do grafo de conhecimento (até 2 saltos), classificada por pontuação composta de similaridade, importância, atualidade e reforço do grafo. Quando um conjunto de resultados contém tanto uma memória substituída quanto a memória que a substituiu, a substituição é sempre classificada imediatamente acima dela — uma linha desatualizada pode aparecer, mas nunca acima de sua própria correção
- Grafo de conhecimento ao vivo — pessoas, organizações, locais e conceitos extraídos em entidades e relações a cada gravação. A resolução de entidades executa primeiro a correspondência exata de nome, depois uma correspondência determinística de nome canônico (insensível a maiúsculas/minúsculas e espaços em branco, e ignorando um
the/a/an/new/old/current/existing/legacyinicial — então "o novo serviço de análise" e "serviço de análise" são uma entidade), depois similaridade semântica (cosseno >0,85). Um qualificador só é descartado enquanto duas ou mais palavras permanecem, então "nova york" nunca colapsa em "york". Cada forma de superfície vista é mantida como um alias na entidade - Detecção de contradição — comparação de triplas RDF + análise semântica LLM detecta memórias conflitantes e as substitui automaticamente, com rastreamento completo da cadeia de contradição
Memória Auto- Aprimorável
- Aprendizado baseado em resultados (Loop Karpathy) — agentes relatam sucesso/falha após agir com base em memórias recuperadas; o sistema reforça o que funciona e gera automaticamente memórias preventivas do tipo
ruleem caso de falha - Cristalização — LLM mescla memórias quase duplicadas em fatos atômicos canônicos com proveniência completa; automação do ciclo de vida de 8 status aposenta dados desatualizados
- Ajuste de recuperação por agente — cada agente otimiza seu próprio perfil de recuperação (top_k, min_similarity, graph_max_hops, pesos de combinação) a partir de feedback, então a qualidade da busca se acumula a cada interação
Integrações
- Servidor MCP — Model Context Protocol integrado em
/mcp(HTTP Streamable). Conecte Claude Desktop, Claude Code, Cursor, Windsurf ou qualquer cliente MCP com uma URL e chave de API - LLM multi-provedor — cadeia de provedores primário + fallback por locatário (OpenAI, Gemini, Anthropic, OpenRouter) com padrões de plataforma para locatários de configuração zero
- Armazenamento de documentos — coleções JSONB estruturadas junto com memórias semânticas para consultas de campo exato (registros de clientes, configuração, listas de tarefas)
Como Caura se compara
Os benchmarks de precisão agrupam as principais ferramentas em uma faixa estreita (veja Desempenho). Onde o campo realmente diverge é na capacidade de frota e governança:
| Capacidade | Caura | Mem0 | Zep | Letta |
|---|---|---|---|---|
| Suporte a múltiplas frotas | ✅ | ❌ | ❌ | ❌ |
| Níveis de confiança de agente + políticas keystone | ✅ | ❌ | ❌ | ❌ |
| Compartilhamento de memória entre fornecedores | ✅ | ❌ | ❌ | ❌ |
| Detecção de contradição + substituição | ✅ | ❌ | ❌ | ❌ |
| Ajuste de recuperação por agente | ✅ | ❌ | ❌ | ❌ |
| Detecção e sinalização de PII | ✅ | ❌ | ✅ | ❌ |
| Trilha de auditoria / proveniência | ✅ | ❌ | ⚠️ parcial | ❌ |
| Grafo de conhecimento (extração automática) | ✅ | ⚠️ | ✅ | ❌ |
| Nativo MCP | ✅ | ✅ | ✅ | ⚠️ |
| Licença OSS | Apache 2.0 | Apache 2.0 | Apache 2.0 | Apache 2.0 |
Mem0, Zep e Letta são projetos sólidos; para um único agente, qualquer um deles atenderá bem você — e Caura também. As pistas se separam acima de um agente, onde o diferencial de Caura é memória governada entre frotas de agentes: múltiplos agentes, equipes e fornecedores em um único plano de memória auditável. A comparação reflete nossa leitura dos documentos públicos em junho de 2026 — correções são bem-vindas via issue ou PR.
Desempenho
Benchmark contra os dois benchmarks públicos de memória de agente mais citados. Resultados completos, metodologia e como reproduzi-los estão em BENCHMARKS.md; contexto em escala de operador está em docs/performance.md; o artigo completo está no blog.
| LoCoMo | LongMemEval | Latência de busca | |
|---|---|---|---|
| Precisão (avaliador LLM) | 77,6% | 92,2% | — |
| Economia de tokens vs contexto completo | 96,6% | 79,2% | — |
| Latência | — | — | 23 ms p50 · 27 ms p95 |
A precisão está dentro do cluster líder no campo (Mem0, Zep, Caura — pontuações agrupadas em uma faixa estreita). Os eixos que mais pressionamos são latência e eficiência de tokens, porque são os que se acumulam conforme o número de agentes cresce — algumas centenas de ms de latência de busca desaparecem atrás de uma chamada LLM, mas cobram milhões de vezes por dia em uma frota.
Benchmarks de agente único não podem medir recuperação entre agentes, propagação de resultados entre agentes, visibilidade em escopo de frota ou recuperação ciente de governança. Essas são as questões que decidem se um sistema de memória é implantável dentro de uma empresa. Veja
docs/performance.md.
Fonte: Rápido, Eficiente em Tokens e Construído para Frotas (2026-04-19).
MCP (Model Context Protocol)
Adicione Caura a qualquer cliente MCP com um bloco de configuração.
Auto-hospedado (localhost):
{
  "mcpServers": {
    "caura": {
      "url": "http://localhost:8000/mcp",
      "headers": { "X-API-Key": "standalone" }
    }
  }
}
Plataforma gerenciada (caura.ai):
{
  "mcpServers": {
    "caura": {
      "url": "https://caura.ai/mcp",
      "headers": { "X-API-Key": "mc_your_api_key_here" }
    }
  }
}
Para uso em equipe ou produção, troque a chave de escopo do locatário por uma credencial de escopo do agente — provisionamento atômico via
POST /api/v1/admin/agent-keys/provision(ou o assistente/settings/organization/api-credentials) gera a credencial + linha do Agente + confiança inicial + associação à frota em uma única ida e volta. Ambos os tipos usam o prefixomc_; o escopo é definido no momento da geração na credencial. Vejadocs/integration-without-plugin.md. Usando uma credencial de escopo do locatário? Passe umagent_idexplícito em cada chamada de ferramenta MCP — o gateway recusa o padrão reservado (mcp-agent) no caminho de escopo do locatário.
Onde adicionar esta configuração:
- Claude Code — Claude Code não lê servidores MCP de
settings.json. Registre o servidor comclaude mcp addem vez disso. Use-s userpara que esteja disponível em todos os diretórios de trabalho — o escopo padrão (local) só o registra para o diretório atual, o que causa problemas quando você executa agentes de várias pastas:
(Ou envie o bloco JSON acima para umclaude mcp add --transport http -s user caura http://localhost:8000/mcp --header "X-API-Key: standalone".mcp.jsonna raiz do projeto para um servidor de escopo do projeto.) - Claude Desktop —
~/Library/Application Support/Claude/claude_desktop_config.json(macOS) ou%APPDATA%\Claude\claude_desktop_config.json(Windows) - Cursor — Configurações > Servidores MCP > Adicionar Servidor
O cliente descobre 12 ferramentas automaticamente:
| Ferramenta | Finalidade |
|---|---|
caura_write | Gravação única ou em lote (até 100 itens). LLM infere tipo, título, resumo, tags, incorporação |
caura_recall | Recuperação híbrida semântica + palavras-chave com recuperação aprimorada por grafo; resumo LLM opcional |
caura_manage | Ciclo de vida por memória: read, update, transition, delete, bulk_delete, lineage |
caura_list | Filtrar por tipo/status/agente/peso/data, ordenar, paginar com cursor |
caura_doc | CRUD de documentos: write, read, query, delete, list_collections, search (semântico) em coleções JSON nomeadas |
caura_entity_get | Consultar uma entidade com memórias e relações vinculadas |
caura_tune | Ajustar parâmetros de recuperação por agente (top_k, min_similarity, graph_max_hops, etc.) |
caura_insights | Analisar o armazenamento de memória em 6 modos de foco. Descobertas persistem como memórias insight |
caura_evolve | Relatar resultados contra memórias recuperadas — ajusta pesos, gera regras (Loop Karpathy) |
caura_stats | Contagens agregadas: total + detalhamentos por tipo, agente, status. Somente leitura |
caura_keystones | Ler regras de governança obrigatórias para o escopo atual. Chame uma vez por sessão — o resultado substitui instruções conflitantes do usuário |
caura_keystones_set | Autorar ou remover regras keystone (op=set|delete). weight é definido como low/med/high e armazenado e retornado como os buckets inteiros 25/50/100. Confiança ≥ 1 para sua própria regra — scope=agent com um agent_id explícito igual ao chamador; ≥ 2 para scope=fleet/scope=tenant, outro agente, ou scope=agent com agent_id omitido |
Compartilhamento de habilidades agora é feito via
caura_doc— agentes compartilham umSKILL.mdfazendo upsert de um documento na coleçãoskills(caura_doc op=write collection=skills doc_id=<slug> data={"summary": "<one-liner>", ...}). O servidor incorporadata["summary"](1-3 frases, focado em intenção) para busca semântica; paracollection="skills"ele recorre adata["description"]se nenhum resumo for fornecido. As ferramentas dedicadasmemclaw_share_skill/memclaw_unshare_skillforam removidas em favor da superfície únicacaura_doc.
Fábrica de Habilidades
Compartilhar uma habilidade manualmente (acima) é o mínimo. Fábrica de Habilidades é o
sistema governado sobre a coleção skills — ela gera automaticamente habilidades
a partir do comportamento da frota, controla o que entra em produção e entrega habilidades ativas aos seus
agentes. É opt-in por locatário e desativada por padrão: até você definir
skills_factory.enabled = true nas configurações da organização do locatário, a coleção skills
se comporta exatamente como descrito acima (sem ciclo de vida, toda habilidade armazenada
visível). Três pilares:
- Autoria — agentes e Forge. Agentes criam habilidades diretamente via
caura_doc op=write collection=skills. Forge, um residente do lado do servidor, também minera memória + sinais de resultado, agrupa procedimentos bem-sucedidos repetidos, e os destila em candidatos de habilidade — nenhum agente precisa lembrar de escrever a habilidade. - Governança — um ciclo de vida. Toda habilidade carrega um status:
candidate → staged → active(com saídasrejected/quarantined/stale/deprecated). Seis portões automatizados mais uma verificação de conteúdo Sentinel decidem o que pode ser promovido, e uma Caixa de Entrada de Habilidades permite que um operador aprove, edite, adie, rejeite ou coloque em quarentena habilidades em estágio por uma superfície REST —GET /api/v1/skills-inboxlista os cartões em estágio, ePOST /api/v1/skills-inbox/{slug}/approve|edit|defer|quarantine|rejectage sobre eles. Uma gravação de agente chega comostaged, nunca instantaneamenteactive. - Entrega — puxar e empurrar. Agentes puxam habilidades ativas via MCP
(
caura_doc op=search/op=read), ou o plugin OpenClaw empurra: seu reconciliador busca toda habilidade ativa dePOST /api/v1/skills/installablee escreve cada uma no diretório de habilidades do nó, opcionalmente registrando esse diretório no caminho de carregamento do OpenClaw. Ambos os níveis servem somente ativas uma vez que o recurso está habilitado.
Aprofundamentos: docs/mcp-skill-delivery.md (o
contrato de entrega somente ativas + alvos de reconciliação do plugin),
docs/operator-forge-cron.md (agendamento do Forge),
e docs/skills-inbox-api.md (a API REST do operador
para a Caixa de Entrada de Habilidades).
O guia completo para operadores/desenvolvedores está na
documentação Caura → Fábrica de Habilidades.
O Entrevistador
caura_write captura o que um agente escolheu registrar. O Entrevistador
captura o que ele fez. Em um cronograma, ele lê a trilha de trabalho durável do próprio agente —
a transcrição ou log de eventos que o harness já mantém — e pede a um
LLM para sintetizar a atividade em memórias tipadas, para que as decisões,
bloqueios e preferências que um agente nunca parou para registrar ainda sejam armazenados.
Ele nunca re-executa o agente — ele trabalha apenas a partir da trilha real, o que o fundamenta
na atividade real. (A síntese LLM ainda pode interpretar mal ou exagerar, então
trate as memórias do Entrevistador como uma aproximação útil, não um registro verbatim.)
É uma terceira forma de memórias entrarem no Caura, junto com gravações em tempo real e
ingestão. Como a Fábrica de Habilidades, é opt-in por locatário e desativada por padrão —
inerte até você definir interviewer.enabled = true nas configurações da organização do
locatário.
- O que ele grava. Seis seções de relatório mapeiam para o enum de tipo de memória:
worked_on → episode,decisions → decision,outcomes → outcome,blockers → task,open_questions → fact,preferences_learned → preference. Elas chegam como memórias comuns enriquecidas, incorporadas e governadas, com os timestamps reais dos eventos do rastro preservados. - Como a atividade é capturada. Duas famílias, um protocolo de envio:
- Plugin-buffer — o plugin OpenClaw mantém um buffer durável local ao nó
e envia janelas (adicione
CAURA_INTERVIEWER=trueao env do plugin). - Disk-parser — a CLI
caura-interviewer(incluída no pacotecaura-client) lê a transcrição em disco de um harness somente leitura e envia janelas. Disponível hoje para Claude Code (~/.claude/projects) e Cursor (~/.cursor/…/agent-transcripts); Hermes e outros estão planejados.
- Plugin-buffer — o plugin OpenClaw mantém um buffer durável local ao nó
e envia janelas (adicione
- À prova de falhas por construção. Cada janela é gravada sob um
id de tentativa determinístico (
sha1(node_id:cursor_from:cursor_to)) e então o watermark por nó avança — uma falha no meio do caminho reenvia e deduplica, então nunca há lacuna e nunca há duplicata. Não há estado de cursor local; o watermark do servidor é a fonte da verdade. - Privacidade. O disk-parser é negado por padrão — ele não coleta nada até você permitir projetos na allowlist — e strings com formato de credencial são removidas localmente antes do envio e mascaradas novamente no lado do servidor.
Os gatilhos são um run periódico (cron) e/ou um hook de fim de sessão; combiná-los
é seguro porque envios duplicados são deduplicados. Configuração completa, conexão por harness
e o protocolo estão em
Caura docs → Interviewer.
O Caura Broker
O Caura Broker é um daemon local (caura-daemon, anteriormente memclawd,
dirigido pela CLI caura) que roda na máquina de um desenvolvedor e conecta agentes de codificação — Claude
Code, Codex, Cursor, Gemini — ao Caura. Seu trabalho é ser o limite de confiança
no lado do desenvolvedor: ele aplica políticas, aplica redação e mantém um
log de auditoria à prova de adulteração antes que qualquer coisa saia da máquina. O Broker
roda em modo pessoal por padrão; instalações que se juntam a uma Broker
Fleet (uma frota de máquinas — distinta do escopo de memória fleet_id)
são governadas em conjunto: heartbeats, um fluxo de políticas e um painel compartilhado.
O Broker em si é distribuído separadamente, mas sua infraestrutura de identidade no lado do servidor
vive neste repositório: uma chamada do Broker autentica com
X-Caura-Credential-Kind: install_credential mais X-Install-UUID, e suas
gravações são atribuídas sob o namespace de propriedade broker:<install> — veja
core-api/src/core_api/mcp_server.py e core-api/src/core_api/auth.py.
O contrato de fio broker↔cloud está congelado na v1: ambos os repositórios executam portões
de quebra de mudança oasdiff no CI (neste repositório, a linha de base é gerada por
core-api/scripts/gen_broker_openapi.py, portão adicionado em
#620), então uma
mudança que quebra o contrato falha no build em vez de quebrar Brokers
instalados. Operações — instalação, entrada na frota, políticas — estão documentadas em
Caura docs → Broker Fleet.
Instalar a skill (Claude Code & Codex)
Instale o guia de uso do Caura como uma skill para que seu agente saiba quando e como usar as 12 ferramentas — o modelo mental de memória/doc, as três regras (recall, write, supersede), níveis de confiança, padrões comuns e anti-padrões. A skill é carregada sob demanda (não a cada turno), então ela não custa nada até o agente alcançar o Caura.
Pré-requisito: o servidor MCP já está registrado (via
claude mcp add -s userpara Claude Code ou o equivalente para Codex — veja o bloco de configuração acima). Confirme comclaude mcp list— você deve vercaura: ... ✓ Connected.
Opção A — uma linha (mais rápida)
Self-hosted (localhost):
curl -s "http://localhost:8000/api/v1/install-skill" | bash
Plataforma gerenciada:
curl -s "https://caura.ai/api/v1/install-skill" | bash
Opção B — baixar, inspecionar, executar (recomendado para agentes)
Agentes automatizados (Claude Code, Codex) podem recusar curl | bash por
segurança. A instalação em duas etapas permite que eles auditem o script primeiro:
curl -s "http://localhost:8000/api/v1/install-skill" > /tmp/install-caura-skill.sh
less /tmp/install-caura-skill.sh      # review — it only does mkdir + curl + write
bash /tmp/install-caura-skill.sh
Opções
| Parâmetro de consulta | Efeito |
|---|---|
| (nenhum) | Instala a skill padrão de referência de ferramentas do Caura para Claude Code e Codex |
?agent=claude-code | Apenas Claude Code → ~/.claude/skills/<skill>/SKILL.md |
?agent=codex | Apenas Codex → ~/.agents/skills/<skill>/SKILL.md |
?skill=company-brain | Instala a skill de postura opcional Company Brain em vez da skill padrão (veja abaixo; combine com ?agent=) |
Verificar
ls -la ~/.claude/skills/memclaw/SKILL.md       # Claude Code; legacy-name-floor: installed default-skill path
ls -la ~/.agents/skills/memclaw/SKILL.md       # Codex; legacy-name-floor: installed default-skill path
Reinicie seu agente após instalar — as skills são carregadas na inicialização. Execute o instalador novamente a qualquer momento para obter a versão mais recente.
Usuários do plugin OpenClaw recebem a skill automaticamente quando o plugin instala; pule esta etapa.
Opcional: a skill Company Brain
A skill padrão ensina as ferramentas ao agente. company-brain é uma skill de postura
fina, primeiro conceito, que se sobrepõe: ela enquadra o agente como uma
mente em um Company Brain compartilhado e adia toda a mecânica de ferramentas de volta para a
skill de referência de ferramentas. Instale as duas juntas quando quiser esse enquadramento:
curl -s "https://caura.ai/api/v1/install-skill?skill=company-brain" | bash
Ela instala em ~/.claude/skills/company-brain/SKILL.md (Claude Code) e/ou
~/.agents/skills/company-brain/SKILL.md (Codex), e obedece ao mesmo
filtro ?agent=. A instalação padrão (sem ?skill=) não muda — ela
instala apenas a skill padrão de referência de ferramentas.
Implantação
A maneira recomendada de executar o Caura é via Docker Compose (veja Quick Start). Isso fornece uma stack pronta para produção de PostgreSQL + pgvector + Redis + API com um único comando.
Imagens de contêiner publicadas
Cada release publica imagens multi-arquitetura (linux/amd64, linux/arm64) para GitHub Container Registry:
ghcr.io/caura-ai/caura-memclaw-core-api:v2.5.0 # legacy-name-floor: published GHCR repository name
ghcr.io/caura-ai/caura-memclaw-core-storage-api:v2.5.0 # legacy-name-floor: published GHCR repository name
As tags seguem SemVer com aliases flutuantes — :v1, :v1.0, :v1.0.0, além de :latest para a versão estável mais recente. Puxe-as no seu próprio arquivo compose ou manifestos Kubernetes em vez de compilar a partir do código-fonte.
Implantação manual (sem Docker)
O serviço core-api/ é um aplicativo FastAPI padrão que roda sob qualquer servidor ASGI (uvicorn, hypercorn). Requisitos:
- Python 3.12+
- PostgreSQL 16+ com a extensão
pgvector - Redis (opcional — usa cache em memória como fallback se indisponível)
uvicorn core_api.app:app --host 0.0.0.0 --port 8000 --workers 2
Topologias de implantação
O Caura vem com dois modos operacionais para a camada de armazenamento. Nó único (padrão) é o que você obtém do Docker Compose, pip install, ou qualquer implantação nova — uma instância core-storage-api atende tanto leituras quanto gravações. Esta é a escolha certa para qualquer implantação que não esteja vendo 100+ gravações/seg sustentadas.
A divisão leitor/gravador é uma topologia opcional para implantações de alta taxa de gravação que querem escalar leituras independentemente das gravações — por exemplo, apontando o tráfego de leitura para uma réplica de streaming do Postgres. Ativá-la significa executar dois serviços core-storage-api com funções diferentes e apontar core-api para ambos:
- Defina
CORE_STORAGE_ROLE=writerna instância que atende gravações;=readerna(s) instância(s) que atende(m) leituras. - Defina
CORE_STORAGE_READ_URLemcore-apipara a URL do serviço leitor. DeixeCORE_STORAGE_API_URLapontando para o gravador. READ_DATABASE_URLem cadacore-storage-apipode apontar para uma réplica de leitura se você tiver uma.- Defina o mesmo
CORE_STORAGE_SHARED_SECRETnão vazio emcore-api, em cada gravador/leitorcore-storage-apie em qualquer outro chamador de armazenamento interno. Todas as solicitações de armazenamento devem carregá-lo comoX-Storage-Secret; credenciais ausentes ou incorretas são rejeitadas antes do roteamento.
Padrões de topologia: CORE_STORAGE_ROLE=hybrid e
CORE_STORAGE_READ_URL="", então uma única instância de armazenamento ainda atende tanto
leituras quanto gravações. O Docker Compose conecta a autenticação de armazenamento automaticamente;
implantações manuais devem configurar CORE_STORAGE_SHARED_SECRET (ou
CORE_STORAGE_SHARED_SECRET_FILE) no serviço de armazenamento e em cada chamador.
Atualizando da v1.x
A versão 2.0 ampliou os embeddings de 768 para 1024 dimensões. Instalações existentes devem optar explicitamente pela migração destrutiva, tirar um snapshot do banco de dados e re-incorporar os dados armazenados.
Siga o guia completo de atualização v1.x → v2.x antes de puxar uma imagem v2.
Referência da API
Rotas REST versionadas vivem sob /api/v1/; o MCP é montado separadamente em
/mcp. Uma implantação em execução serve seu esquema OpenAPI autoritativo em
/api/openapi.json e documentação Swagger interativa em /api/docs.
Use a referência de API curada para grupos de endpoints, autenticação, configuração e estrutura do repositório. A carta de propriedade da superfície da API explica quais operações pertencem ao REST, MCP ou ao plugin OpenClaw.
API Pública e Estabilidade
O Caura segue SemVer. As ferramentas MCP estáveis, endpoints REST, variáveis de plugin, modos de autenticação e requisitos de contribuidores vivem no contrato de estabilidade da API pública.
Telemetria
Atualizado em 2026-09-19. Um servidor self-hosted envia um heartbeat anônimo por
dia por contêiner, independentemente da contagem de workers, para telemetry.caura.ai: sua versão, Python/OS/arch, tipo de implantação
(docker ou fonte), bucket de uptime, tipos de provedor (nunca nomes de modelos ou
chaves), se Redis e Sentry estão configurados (nunca os valores), contagens
em buckets de memórias, agentes, tenants e nós de plugin vistos recentemente, e
contagens em buckets de quais famílias de SDK o chamaram. Cada número é um bucket
(0, 1, 2-5, 6-20, ...), o id é um UUID aleatório armazenado no seu próprio
banco de dados, e nada sobre hostnames, IPs, nomes, conteúdo ou valores de configuração
é jamais enviado. O payload exato, seu esquema JSON, a política de retenção
e o changelog estão em docs/telemetry.md.
Toda maneira de desativá-lo, cada uma permanente para aquela instalação:
CAURA_TELEMETRY=offno ambiente decore-api(.env, ou a linha comentada sobcore-apiemdocker-compose.yml).DO_NOT_TRACK=1(a convenção Console Do Not Track).CIdefinido para um valor não vazio: pipelines nunca são contados.- Bloqueie
telemetry.caura.ai:443no firewall: uma tentativa por dia, timeout de 5 s, sem nova tentativa. - Rodar atrás do gateway empresarial ou com provedores de plataforma desativa automaticamente.
Inspecione o que seu servidor enviaria, quando tentou pela última vez e se isso
funcionou com GET /api/v1/telemetry; recomece com um id novo via
POST /api/v1/telemetry/rotate. O log de inicialização imprime a decisão ON/OFF, o
motivo e a dica de desativação a cada início; um CAURA_TELEMETRY_URL digitado errado
(http:// simples para qualquer coisa que não seja localhost) desliga o heartbeat com um
aviso em vez de enviar em texto claro.
O rastreamento de erros permanece opt-in: defina SENTRY_DSN para habilitar a
integração opcional com Sentry para rastreamento de erros e monitoramento
de desempenho. Nenhum erro é relatado a menos que você configure explicitamente um DSN.
Além do heartbeat, uma implantação self-hosted não faz outras chamadas de saída a menos que você configure um DSN do Sentry ou um provedor de LLM/embedding. A análise de uso da plataforma gerenciada é um recurso do serviço hospedado; ela não faz parte do runtime self-hosted.
Limitação de taxa
A limitação de taxa é aplicada em processo por slowapi, chaveada por
chave de API quando presente e por IP remoto caso contrário. Ela é aplicada por rota, não globalmente —
/health, /version e /mcp nunca são limitados:
| Rota | Padrão | Configuração |
|---|---|---|
POST /memories, POST /documents, POST /ingest/commit, POST /stm/promote | 10/segundo | RATE_LIMIT_WRITE |
POST /memories/bulk | 2/segundo | RATE_LIMIT_WRITE_BULK |
POST /search, POST /recall | 30/segundo | RATE_LIMIT_SEARCH |
Toda resposta de uma rota com limite de taxa inclui X-RateLimit-Limit, X-RateLimit-Remaining e
X-RateLimit-Reset; uma solicitação rejeitada recebe HTTP 429 com Retry-After. Os contadores ficam no Redis quando
REDIS_URL está definido — é isso que faz o limite valer entre réplicas — e na memória do processo
caso contrário, então uma implantação multi-instância sem Redis limita cada instância separadamente. Uma queda do
Redis falha de forma aberta: as solicitações passam sem throttling em vez de gerar erro.
X-RateLimit-* é o throttle por segundo e nada mais. Uma implantação com um medidor de uso conectado
relata a cota separada por período do plano como X-Usage-Limit / X-Usage-Remaining em
POST /memories, POST /memories/bulk e POST /search; o OSS standalone não tem cota, então esses
cabeçalhos estão ausentes lá.
Adicione limitação também no seu proxy reverso (nginx, Caddy, Cloudflare) se você precisar de pisos de DDoS por IP ou limites que a camada de aplicação não consegue enxergar.
Contribuindo
Aceitamos contribuições! Veja CONTRIBUTING.md para diretrizes, configuração de desenvolvimento e como enviar PRs.
FAQ
O que é Caura? Caura é memória compartilhada governada de código aberto para frotas de agentes de IA: recall entre agentes e entre frotas com escopos de visibilidade, níveis de confiança, políticas keystone, trilhas de auditoria e isolamento de locatário aplicado em cada operação — além de recuperação auto-melhorável por meio de aprendizado baseado em resultados.
Como Caura é diferente de um banco de dados vetorial? Caura usa pgvector internamente, mas não é um wrapper de banco vetorial. Além da busca híbrida, adiciona orquestração de frotas, ajuste de recuperação por agente, detecção de contradições, um ciclo de vida de 8 status, um grafo de conhecimento extraído automaticamente, enriquecimento de LLM em cada escrita, isolamento de locatário em nível de linha e trilhas de auditoria em cada operação.
Como Caura é diferente de Mem0 ou Zep? Mem0 e Zep focam em memória para agentes individuais; benchmarks de precisão agrupam as três ferramentas em uma faixa estreita. Caura é construída para frotas: múltiplos agentes entre equipes e fornecedores compartilhando um plano de memória governado, com níveis de confiança, políticas keystone e permissões entre frotas que essas ferramentas não abordam. Veja Como Caura se compara.
Caura funciona com Claude Desktop, Claude Code, Cursor ou Windsurf? Sim — Caura é nativa de MCP. Cole uma configuração JSON com uma URL e chave de API em qualquer cliente MCP e 12 ferramentas aparecem imediatamente.
Agentes de fornecedores diferentes podem compartilhar memória? Sim — esse é o ponto. Um agente da Anthropic recupera o que um agente da OpenAI escreveu, sob as mesmas regras de governança — com níveis de confiança e escopos de visibilidade decidindo o que cruza fronteiras de frotas.
Caura é realmente gratuita? O motor completo — armazenamento, 12 ferramentas MCP, plugin, trilha de auditoria — é Apache 2.0. Execute você mesmo para sempre. A plataforma gerenciada em caura.ai adiciona hospedagem, escalabilidade e governança empresarial para equipes que não querem operar infraestrutura.
Quem usa Caura em produção? eToro (NASDAQ: ETOR) executa 300+ agentes na Caura — 26.500+ memórias, 1.372 habilidades compartilhadas, 23 ms p50 de busca. Estudo de caso →
Licença
Caura é licenciada sob a Apache License, Versão 2.0.
Veja NOTICE para direitos autorais e atribuições de terceiros.
Marcas registradas
"Caura" é uma marca registrada da Caura. A Apache License 2.0 concede permissão para usar o código-fonte, mas não concede permissão para usar esses nomes, logotipos ou identidade visual de uma forma que sugira endosso ou afiliação com qualquer trabalho derivado. Veja a Apache License 2.0 §6 para os termos legais completos.