Personal Understanding
Memória de cadeia de evidências para agentes de IA: capturas verbatim-first (imutáveis, com hash SHA-256), auditáveis, antifabricação. Skill local-first + servidor MCP para Claude Code, Codex e qualquer cliente MCP.
Documentação
Personal Understanding
Uma memória que lembra do seu jeito — por cadeias de evidência e associação, não por pontuações de similaridade.
Primeiro o verbatim · Cadeia de evidência · Recordação associativa · Anti-fabricação · Local-first · Uma pasta, zero dependências



中文文档 · Como a recordação funciona · Início rápido · Princípios de design
agent-memory mcp claude codex skills local-first associative-recall personal-knowledge
O problema com todo sistema de memória que você já tentou
A memória típica de agentes tem um segredo sujo: o modelo resume primeiro e armazena o resumo. Suas palavras são parafraseadas, comprimidas e misturadas com as próprias interpretações do modelo desde o primeiro dia. Seis meses depois, "você" é uma pilha de resumos com perdas — e quando o modelo erra sobre você, você nem consegue auditar o porquê, porque a evidência original se foi.
E a recuperação por baixo é similaridade. Aqui está a parte que a maioria dos produtos de memória não diz em voz alta:
Recordação não é similaridade. Quando você reclama "esse jogo é um lixo, os golpes não têm peso", um humano que te conhece pensa: ele já disse que seu padrão para game feel era Red Dead Redemption 2, e The Witcher 3 perdeu para ele. Zero palavras em comum entre a reclamação e essa memória — uma pontuação de similaridade dá zero, e a memória que você mais precisa fica invisível. A recordação humana é direcional e associativa: você pensa no oposto de uma coisa, na razão dela, no mesmo núcleo mental um nível de abstração acima. Isso não é o que um banco vetorial calcula.
Personal Understanding conserta as duas metades:
Salve as palavras exatas primeiro. Recorde por cadeias de evidência e propagação em grafo, não por similaridade. Prove cada caminho.
Cada mensagem pessoal é capturada verbatim e imutavelmente (hash SHA-256, timestamp, tag de sessão) antes de qualquer outra coisa acontecer. A compreensão estruturada é construída em cima da evidência, cada fato derivado ligando de volta à citação de onde veio. E a recordação passa por uma pilha medida em três camadas que pode trazer registros com zero sobreposição lexical — com o caminho de associação mostrado, para que o modelo possa julgá-lo em vez de confiar em uma pontuação nua. Quando o agente lembra errado de você, você audita. Quando ele não sabe, ele diz.
O que torna diferente
| Ferramentas de memória típicas | Personal Understanding | |
|---|---|---|
| O que é armazenado primeiro | o resumo do modelo | suas palavras exatas — imutáveis, com hash |
| Modelo de recordação | similaridade sobre resumos | propagação lexical de três canais + associativa em grafo, caminho de evidência visível |
| Fatos derivados rastreáveis à fonte | raramente | ✓ cada registro liga de volta ao seu verbatim |
| Suposições do modelo marcadas como suposições | não | ✓ camada de hipóteses, candidate por padrão, nunca promovida silenciosamente |
| Resumos antigos com perdas | reutilizados silenciosamente | ✓ sinalizados como dívida de resumo — a recuperação divulga "esta parte vem de um resumo antigo" |
| Diz "salvo" quando a gravação falhou | acontece | ✗ impossível — uma trava rígida (session_check) precisa sair com código 0 antes que "arquivo atualizado" possa ser afirmado |
| Datas inventadas, pessoas mescladas, arestas causais falsas | possível | ✗ proibido por política escrita e aplicado por validadores |
| Runtime | servidor + banco vetorial + embeddings | uma pasta, apenas stdlib do Python |
| Onde seus dados vivem | frequentemente na nuvem deles | sua máquina. Ponto final. |
Veja funcionando — suas palavras entram, prova sai
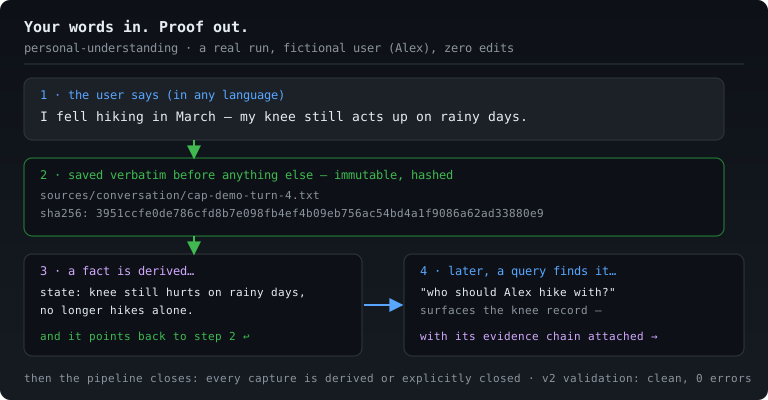
Uma execução real do pipeline (usuária fictícia "Alex", saída real de CLI, zero edições): uma mensagem chega, é capturada verbatim com seu SHA-256, um fato derivado liga de volta àquela citação exata, e uma consulta associativa posterior a traz à tona através da cadeia de evidência.
Por que não usar apenas a memória embutida do seu agente?
Agentes mais novos vêm com "memória" agora — se isso for suficiente para você, use. Este projeto existe para as pessoas que esbarram nas paredes dela:
| Memória embutida do agente | Personal Understanding | |
|---|---|---|
| Propriedade dos dados | presa na conta do fornecedor, raramente exportável, some quando você troca de ferramenta | uma pasta de texto simples na sua máquina — leia, use grep, faça backup, mova |
| Portabilidade | a memória só funciona dentro daquele produto | um arquivo, qualquer cliente MCP — Claude, Codex, ZCode, VS Code, o que vier depois |
| Auditabilidade | caixa-preta — você não vê o que foi armazenado, nem por que respondeu daquele jeito | cada fato derivado liga de volta à citação exata; o rastro de recuperação mostra por que cada registro veio à tona, e o que foi deliberadamente retido |
| Recuperação | recordação difusa por resumo | recordação de três canais + associativa que termina nas suas palavras originais |
| Privacidade | seu histórico pessoal nos servidores deles | apenas local — sem telemetria, sem chamadas de nuvem |
A memória do fornecedor otimiza para uma conversa mais fluida dentro do produto deles. Este projeto otimiza para uma memória que você possui, que se move com você entre ferramentas, e que pode provar de onde veio cada fato. Produtos diferentes — a memória do fornecedor melhorar não torna este redundante.
Por baixo do capô: como a recordação realmente funciona
A maioria dos READMEs de memória para em "usamos embeddings." Aqui está a pilha inteira, porque a mecânica é o produto.
Camada 0 — léxico autotreinado (higiene de consulta). Cada consulta é tokenizada contra um dicionário fornecido (jieba, MIT) mais um léxico que o arquivo treina em si mesmo: qualquer string de 2 a 4 caracteres que ocorra em ≥2 textos do arquivo vira uma palavra, então nomes próprios que nenhum dicionário geral conhece (弦一郎, 艾迪芬奇, 晕3D) são reconhecidos automaticamente. Fatias fora do vocabulário mantêm sua recordação, mas têm peso limitado para que acidentes entre palavras (郎我) não possam mais se sobrepor a termos reais. Causa raiz medida que isso corrigiu: a consulta 巫师3 se divide em 巫师 + 3, e um 3 perdido correspondia a datas dentro de IDs de registros — uma vez entregou a um registro de carteira de motorista a primeira posição para uma consulta sobre The Witcher.
Camada 1 — recordação lexical de três canais. Eventos de linha do tempo, cartões de fato/modelo e cartões de entidade são pontuados separadamente (IDF-ponderado, normalizado por comprimento, com rebaixamento de âncoras) em vez de uma sopa misturada — uma reclamação sobre game feel alcança o cartão de fato mesmo quando nenhum evento corresponde. Cada sonda registra um rastro de decisão: o que foi selecionado, o que foi retido e por quê.
Camada 2 — propagação associativa (a recordação que humanos fazem). Entidades e cartões de conceito (game feel, dinheiro-e-culpa, limites-do-corpo, gosto-de-leitura…) formam um grafo. Uma propagação PageRank personalizada — local, com limite de hubs para que nós populares não possam vestir popularidade como associação — traz à tona registros com os quais a consulta compartilha zero palavras, cada um com seu caminho via visível:
- "os golpes deste jogo parecem papel" →
concept: gameplay-feel→ o registro de ancoragem de feel Witcher-3-vs-RDR2 (nenhuma palavra compartilhada — exatamente a recordação que um amigo faria) - "seca de livros, recomende algo" →
concept: reading-taste→ seu histórico de leitura e âncora de gosto - "me recomende um jogo" →
concept: narrative-games→ a regra rígida de que enjoo 3D é uma exclusão de nível corporal — o lado oposto do desejo, a uma aresta de distância
A pilha é avaliada em uma matriz de uso simulado de 16 rodadas (consultas com tom de usuário real em 8 domínios de vida, avaliadas por modelo); cada versão a reexecuta. Zero regressões esperadas de recordação até 2.6.0, enquanto os dois casos de "todos os canais erraram" acima saíram do nada para serem trazidos à tona.
Por que não embeddings? Eles são a ferramenta certa na escala de arquivos, e o design deixa um espaço para eles. Mas na escala de arquivos pessoais, as falhas medidas são lexicais e estruturais, não semânticas — e uma pontuação de similaridade é inauditável por natureza: ela retorna um número, nunca um caminho. Aqui, quando uma memória vem à tona, por que ela veio é sempre mostrado.
Mesma mensagem, duas memórias muito diferentes
Sem Personal Understanding — uma implementação típica de memória:
Você: Finalmente toquei minha primeira música completa no violão hoje. Três semanas até eu me apresentar no casamento do meu primo — honestamente, menos nervoso do que antes. IA: Que incrível, parabéns! 🎸 Continue assim!
O que foi armazenado:
"user played guitar, feeling positive."Um resumo com perdas. Sem fonte, sem data, sem pessoas, sem como verificar. No mês que vem, sumiu — ou pior, silenciosamente parafraseado em algo que você nunca disse.
Com Personal Understanding — a mesma mensagem:
Você: Finalmente toquei minha primeira música completa no violão hoje. Três semanas até eu me apresentar no casamento do meu primo — honestamente, menos nervoso do que antes. IA: (primeiro: captura sua mensagem completa verbatim — com hash SHA-256, timestamp, tag de sessão — antes de qualquer outra coisa) (depois: deriva e liga —
event"primeira música completa no violão" · saliênciasupporting· ligado aSarae à meta do casamento · atualiza seu estado atual: ansiedade de performance ↓) IA: Primeira música completa é um marco de verdade. Da última vez, se apresentar no casamento te deixou nervoso — como se sente agora que faltam três semanas?Cada afirmação rastreia até suas palavras exatas. Pergunte "de onde vem isso?" e o agente mostra a citação original — não uma paráfrase de uma paráfrase. E quando chega a semana do casamento, o arquivo faz check-in sozinho.
Destaques
- 🗣️ Captura verbatim primeiro — a mensagem completa, palavra por palavra, antes de qualquer resumo, divisão ou interpretação. Correções adicionam novas capturas; nada é jamais sobrescrito silenciosamente.
- 🔁 Fechamento de derivação — uma captura bem-sucedida não é uma atualização concluída. Toda captura deve ser dividida em registros, ligada e fechada — ou explicitamente fechada como "nada de novo" com uma razão declarada. Órfãos não podem escapar.
- 🧠 Recordação progressiva como humana —
survey(mapa de roteamento compacto) →probe(expansão ao longo de entidades, cartões de conceito e vizinhos temporais) →deep(verificar a citação exata). Sem despejos vetoriais, sem busca só por palavras-chave. - 🕸️ Recordação associativa com caminhos visíveis — memórias com zero sobreposição vêm à tona através de um grafo de cartões de conceito com o caminho de associação anexado; o modelo julga a ligação, nada chega como uma pontuação inexplicada.
- 📻 Escada de recordação a frio — para momentos de "esqueci, conversamos sobre algo assim…": sonde a partir de qualquer pista, caminhe por vizinhos temporais, depois navegue por uma janela de tempo como folheando um álbum de fotos antigo.
- 🔬 Camada de hipóteses causais — "por que eu sou assim?" recebe uma resposta estruturada: afirmação, mecanismo, apoios, contraexemplos, explicações concorrentes, escopo, confiança — sempre
candidate, nunca apresentada como fato. - ⏰ Acompanhamentos proativos — "vamos ver em alguns dias" vira um loop rastreado. Quando chega a hora, o agente volta com o contexto original, não um lembrete sem contexto.
- 🚦 Travas rígidas, não vibrações — validação de três estados (
clean/warnings/failed), gravações atômicas em todo lugar,session_checkcomo trava de saída não-zero antes de qualquer afirmação de "o arquivo está atualizado". Leituras que não podem corromper o arquivo têm um caminho degradado auditado; gravações nunca têm. - 📉 Contabilidade de dívida de resumo — material legado que perdeu sua fonte é rotulado, contado e divulgado na recuperação. Nunca pode se passar por verbatim.
- 📊 Linha do tempo do pipeline e painel de auditoria — reproduza a vida inteira de um turno (decisão de trava → captura → fechamento → cada consulta de recuperação, associação e candidato retido) como uma única página somente leitura, ou navegue pelo painel completo.
- 🔌 Plug-and-play para seu cliente — um instalador idempotente auto-detecta e registra um servidor MCP local em clientes Claude, Codex, VS Code / Cursor / Windsurf / Cline / Trae, ZCode e configurações genéricas de
.agents. - 💾 Backups com integridade — snapshots com manifesto SHA-256, suporte a espelhamento para segundo local (qualquer remoto rclone) e uma revisão trimestral de saliência que rebaixa graciosamente pesos importados obsoletos em vez de deixá-los fossilizar.
Arquitetura
flowchart LR
    A["user message"] --> B{"turn preflight<br/>(router)"}
    B -->|"personal content"| C["immutable verbatim capture<br/>+ SHA-256 · session · source"]
    C --> D["derivation ledger<br/>(pending)"]
    D --> E["derive: events · entities · concept cards<br/>context cards · hypotheses · follow-ups"]
    E --> F["finalize:<br/>derived / nothing-new"]
    B --> G["probe: lexicon-hygiened query"]
    G --> H["three-channel lexical recall<br/>timeline · cards · entities"]
    G --> I["associative spread (PPR)<br/>zero-overlap candidates + via path"]
    H --> J["deep = verbatim only<br/>(summary debt disclosed)"]
    F --> K["session_check<br/>hard gate · must exit 0"]
    I --> K
    J --> K
    K --> L["answer"]
    L --> M["feedback loop<br/>helpful / missed / corrected"]
    M -.->|quarterly| N["salience review<br/>+ deep semantic review"]
No disco são arquivos simples que você pode ler, pesquisar e fazer backup: sources/conversation/ (verbatim imutável + hashes) e memory/v2/ (fragmentos, linha do tempo, entidades, cartões de conceito, contextos, follow-ups, hipóteses, rastros de decisão) — com registros legados mantidos como camada de compatibilidade e honestamente marcados como summary_only.
Início rápido
# 1. clone into your client's skills directory
git clone https://github.com/caix84476-netizen/personal-understanding.git \
    ~/.claude/skills/personal-understanding      # or ~/.codex/skills/ , or your client's equivalent

# 2. bootstrap the archive skeleton (directories + generic domain branches; idempotent)
python scripts/init_archive.py

# 3. register the local MCP server (auto-detects clients; idempotent)
python scripts/install_mcp.py --auto            # Windows: just double-click register-mcp.cmd

# 4. restart your client session — the personal_* tools go live

# 5. open the audit dashboard / replay any turn's pipeline any time
python scripts/open_dashboard.py                # Windows: double-click open-dashboard.cmd
python scripts/pipeline_view.py --latest 5
Requisitos: Python 3.10+ · apenas stdlib, zero pip installs · Windows / macOS / Linux.
Prefere pip? O servidor MCP + instalador também estão no PyPI: pip install personal-understanding, depois personal-understanding-install para registrar o servidor MCP local. O pacote pip inclui apenas o lado Python — para o cérebro completo da skill (SKILL.md + dashboard), use os passos de clone acima. A partir da 2.2.1, o wheel não é mais um snapshot desatualizado — cada arquivo empacotado é byte-idêntico à árvore de origem, reverificado a cada release. Uma ressalva permanece: personal-understanding-install registra o servidor, mas não inicializa uma raiz de arquivo, então comece do zero com python -m personal_understanding.init_archive. Os passos de clone acima continuam sendo o caminho recomendado para a skill completa.
Depois é só conversar normalmente: "Eu tenho me sentido…", "lembra daquilo…", "por que eu continuo…" — a descrição da skill dispara em conteúdo pessoal, captura suas palavras e assume a partir daí. Pergunte "o que você lembra sobre…", ou "de onde isso vem?" e siga a cadeia de evidências.
Seus dados continuam seus
- Tudo é processado localmente, na pasta da skill. Sem telemetria, sem chamadas em nuvem, sem embeddings enviados a terceiros.
- O
.gitignoreincluído bloqueiamemory/,sources/ebackups/— para que você possa versionar a pasta da skill e nunca commitar seu arquivo privado por acidente. - Rótulos de sensibilidade (
private/highly-private) controlam relevância, não sigilo-de-você: perguntas não relacionadas nunca vazam material privado não relacionado.
Princípios de design
Estas são políticas escritas, aplicadas por validadores — não aspirações:
- Fidelidade verbatim em primeiro lugar — nenhum resumo se passa pelas palavras do usuário;
summary_onlyé marcado como tal para sempre. - A recuperação deve ser auditável — similaridade sozinha nunca decide; candidatos associativos carregam seu caminho no grafo, e cada sonda registra o que foi selecionado e o que foi deliberadamente retido.
- Sem certeza fabricada — datas incertas permanecem incertas; pronomes vagos não viram pessoas; eventos únicos nunca viram causas; arestas de associação são semântica declarada, nunca inventadas para um grafo mais bonito.
- Palavras mais novas superam arquivos antigos — correções constroem cadeias
supersedes/contradicts; nada é silenciosamente apagado. - Um único eixo de saliência —
pivotal / key / supporting / passingem uma única escala de 0–3; pesos importados admitem que são heurísticas. - Silêncio não é feedback — apenas correções e confirmações explícitas, com evidência citável, alimentam o loop de feedback.
- Estrutura limpa ≠ semanticamente correto — a revisão profunda existe justamente porque validadores não capturam significado.
De onde veio
Não é um framework pensado em uma tarde — um arquivo de trabalho refinado pelo uso diário e uma dúzia de rodadas de endurecimento (veja o CHANGELOG): um bug de decaimento de saliência que uma vez destruiu frontmatter é o motivo de todas as escritas serem agora atômicas e revisadas; a pesquisa costumava carregar ~818 KB de catálogo legado por turno — agora é um mapa de roteamento de ~90 KB (~230 ms); a camada associativa existe porque seu autor continuava batendo na parede de que "recuperação não é similaridade" — o changelog 2.6.0 documenta as causas raiz medidas, os designs tentados e rejeitados, e a regressão que provou que a exclusão estava errada antes de a rebaixamento ser escolhido.
Status
- Release atual: v2.8.0 — release de emagrecimento: SKILL.md 44KB→20KB contrato central com referências indexadas sob demanda, ferramentas MCP 13→11 (derivation_status absorvido em validate, add_hypothesis absorvido em add_record kind=causal_hypothesis; ambos mantêm ponteiros de migração), session_check padrão em modo leve (gate de turno em ms, validação completa da biblioteca via light=false). Schema estável; contratos de comportamento inalterados.: escritas não reconstroem mais inline (isError responde exatamente "essa escrita foi gravada", views reconstroem lazy na leitura), views/recuperações limitadas com metadados de truncamento determinísticos, finalize flip-guard + visibilidade pendente, paridade de schema no caminho de escrita com o auditor, gate de sessão para governança obsoleta, e três defeitos reais capturados pelos novos papers de aceitação (deadlock de reconstrução no caminho de leitura, engolir falsy stale_days=0, curto-circuito de rebaixamento no structure-gate). Schema estável (
memory/v2/v2.0.0); mantido ativamente. Também no PyPI. - Funciona com qualquer cliente compatível com MCP. O cérebro da skill (
SKILL.md) é escrito em chinês e funciona com arquivos em qualquer idioma; a recuperação é ajustada para texto misto chinês/latim e degrada graciosamente em outros casos. - Roadmap: páginas de dashboard editáveis, ranking de recall a frio mais rico, canal vetorial opcional para arquivos muito grandes (plugável por design), arquivo criptografado em repouso opcional.
Contribuindo
Issues e PRs são bem-vindos — especialmente: instaladores de novos clientes para install_mcp.py, melhorias no dashboard e matrizes de avaliação para idiomas além do chinês.
Licença
MIT © 2026 caix84476-netizen
Se o Personal Understanding te salva de se reexplicar para sua IA pela enésima vez, uma estrela ⭐ ajuda outros a encontrá-lo.