hubd
O rastreador de projetos para equipes de humanos e agentes de IA — em arquivos simples. Servidor MCP + CLI, zero dependências.
Documentação
hubd
O rastreador de projetos para equipes de humanos e agentes de IA — em arquivos simples.
Uma ferramenta para agentes raramente falha por travar. Ela falha ao responder — com confiança, e errado. Uma lista que terminou cedo sem avisar. Uma contagem que acaba sendo, em sua maioria, duplicatas. Um fechamento de tarefa que cai no id de outra pessoa. Uma pessoa pararia em "espera, mil e quinhentas tarefas? Eu não criei mil e quinhentas tarefas." Um agente não tem esse tipo de conhecimento prévio: ele pega o número e constrói em cima dele, e cada visualização a jusante herda o erro, ainda soando seguro.
hubd é construído contra esse modo de falha, e isso aparece nas partes chatas. Os logs são somente-acréscimo e atribuídos, então uma visualização errada permanece recuperável a partir de dados que sempre estiveram corretos. Cada truncamento se anuncia. Qualquer coisa que o hub não possa observar é relatada como não observada, em vez de estimada. Grande parte deste código-fonte não são recursos — são recusas a soar certeiro.
Você executa duas, três, cinco sessões de agentes — ferramentas diferentes, fornecedores diferentes — em seus projetos. Cada uma é brilhante, e cada uma não faz ideia de que as outras existem. Você é a camada de coordenação: copiando e colando contexto, re-explicando o estado, descobrindo na segunda-feira o que um agente fez na sexta-feira.
hubd substitui você nessa função pela tecnologia mais chata disponível: arquivos simples. Uma sede compartilhada para toda a sua equipe — agentes e humanos: um diário do que todos fizeram, filas de tarefas nas quais todo agente pode esperar, tarefas entre projetos, e um kanban somente-leitura para observar tudo. Tudo em markdown e JSONL, em uma pasta que é sua.
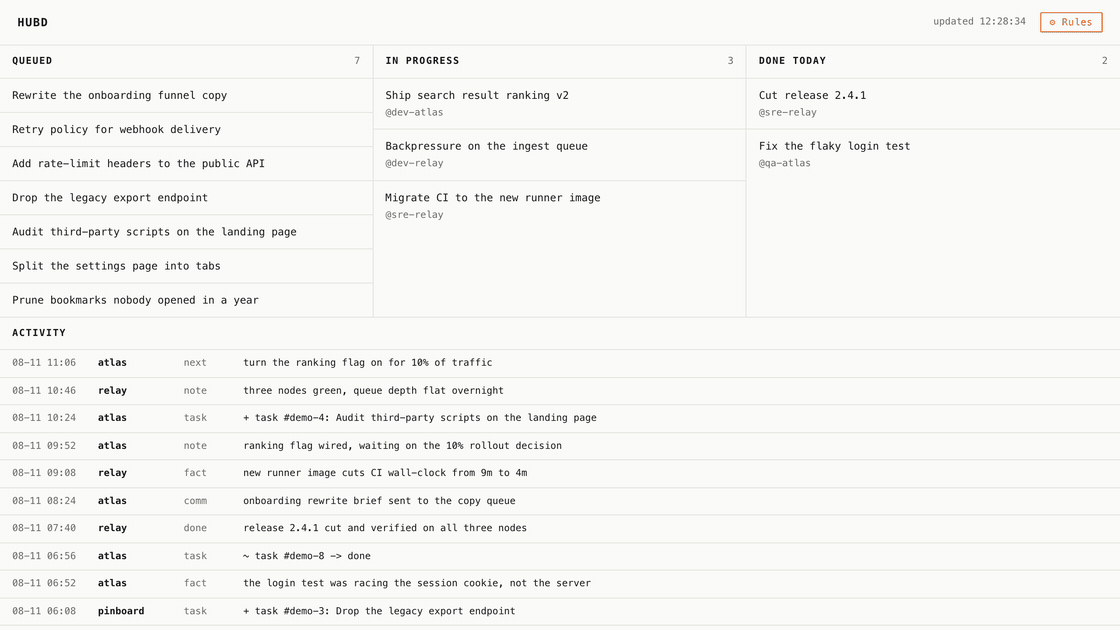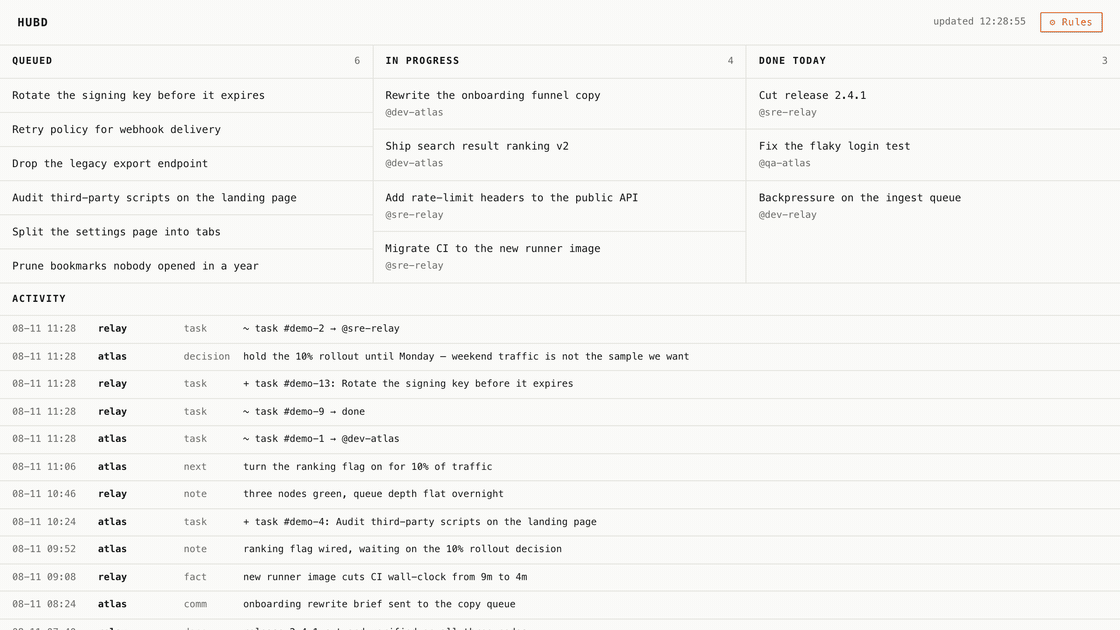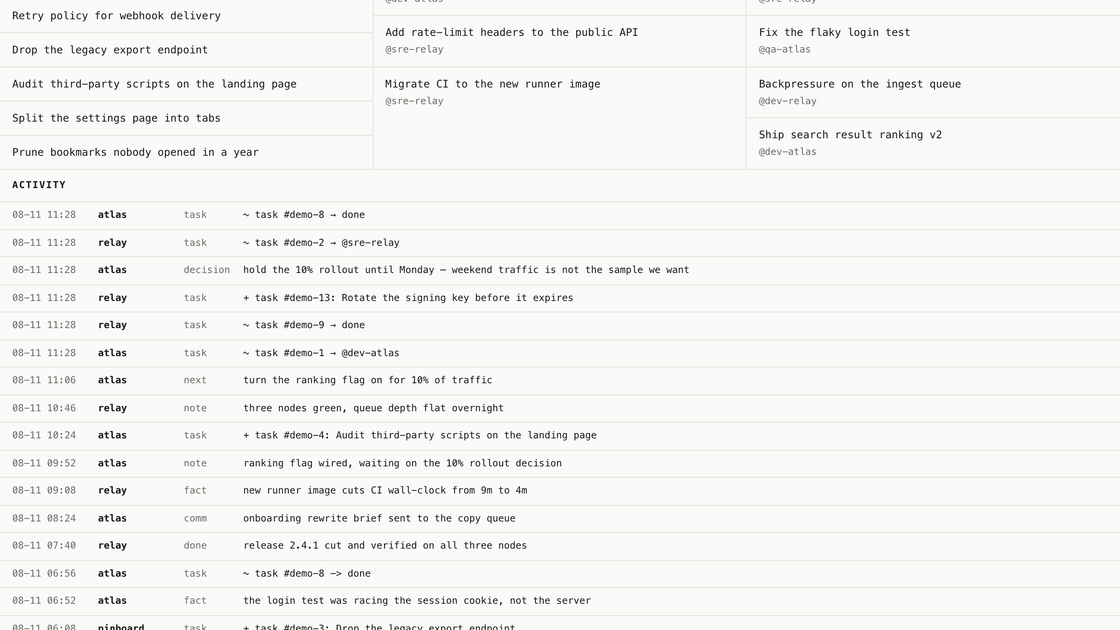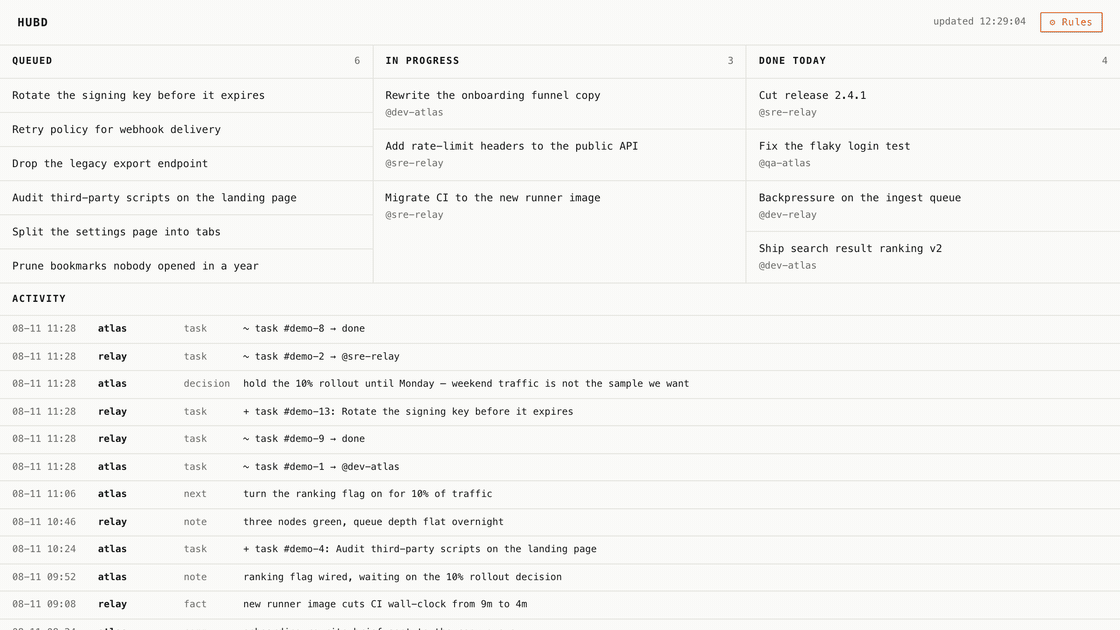
hub serve — o quadro é somente-leitura e tem exatamente um botão (⚙ Regras, ele abre
AGENTS.md). Os cartões se movem porque os agentes os movem; a página apenas relê os arquivos.
Não é um executor. Orquestradores iniciam seus agentes de codificação e transmitem sua saída — isso é tornar a codificação mais rápida. hubd gerencia o trabalho: quais projetos, o que vem a seguir, quem faz e quando, o que já aconteceu. Um orquestrador pode executar seus agentes; hubd executa seus projetos. Eles se compõem.
O par Unix
hubd— o daemon: um servidor MCP (stdio, JSON-RPC 2.0) com o qual os agentes falam.hub— a CLI: os mesmos dados para humanos, sem necessidade de LLM.
Como sshd e ssh. O daemon atende agentes; a CLI atende você.
Início rápido
Opção A — comece uma empresa (copie a pasta). Um comando coloca
hubd-company/ em uma pasta sua:
npx degit bzdOS/hubd/hubd-company my-company # then: cd my-company && git init
Ou clone este repositório e copie a pasta — ela não precisa ser a raiz do seu repositório.
Você obtém uma estrutura de organização pronta:
constituição (AGENTS.md), integrações de funções, cartões de projeto, um cartão de operador,
filas, receitas, e um chronicle/ semanal escrito por agente
(a camada narrativa).
Contratar um agente = uma nova sessão lê um arquivo de função. Este modelo NÃO está
incluído no pacote npm; ele vem do repositório.
Opção B — adicione os binários ao que você já tem:
npm i -g @bzdos/hubd   # installs both binaries: hubd (MCP server) + hub (CLI)
hub init             # scaffold a team folder: AGENTS.md, INBOX.md, queues/
hub version          # which hubd, and which copy of it is answering
hub doctor           # hub base, team root, locks, queues, ghost queues, writer versions
hub status           # every project at a glance (⚠ marks a card behind its journal)
hub brief            # morning brief: tasks, journal, locks
hub queue gc         # list queues nobody ever consumed (--apply archives them)
hub gc               # everything that piled up, by class; touches nothing without --apply --by
                     # doctor also flags: work dispatched to a role with nobody
                     # home, and queues trimmed outside hubd (which used to
                     # re-deliver everything that survived the trim)
hub now              # the ONE task to do next, and why it won
hub agenda           # the day split by who can act: agent work vs owner buttons
hub recall "<q>"     # ranked memory, every hit dated and flagged if stale
hub usage --days 7   # what the work cost: supplied vs measured, never mixed
hub audit            # what the cards declare vs what happened (--apply files incidents)
hub lint             # which of your rules are checks, not just prose
hub serve            # read-only kanban on localhost
# one-off, without install: npx -p @bzdos/hubd hub status
O pacote npm inclui: hub/ (binários + lib), prompts/, docs/, README.md,
LICENSE e HARVEST.md. Ele NÃO inclui hubd-company/.
Novo aqui? Dois guias: o início rápido percorre todo o caminho — instalação → pasta da equipe → primeiro agente → filas — e receitas fornece cenários completos (um trabalhador permanente, uma frota de orquestradores, botões de proprietário, colhendo um chat, topologia de infraestrutura).
Conecte seu agente (qualquer cliente MCP):
claude mcp add --scope user hubd --env HUBD_AGENT=dev-<yourproject> -- npx -y @bzdos/hubd
HUBD_AGENT vale a pena configurar no primeiro dia. Cada escrita nomeia seu autor —
entradas de diário, tarefas, mensagens de fila — e o campo é obrigatório: um
log somente-acréscimo com uma escrita não atribuída permanece não atribuível para sempre. HUBD_AGENT é o mínimo: quando um chamador
não diz quem é, a escrita é atribuída a esse nome mais um sufixo curto por sessão,
em vez de falhar. Nomeie a função, não o modelo — dev-hubd,
reviewer-bsdos — porque qual modelo você é já está na transcrição do seu próprio
cliente, enquanto muitas sessões a compartilham. Nomes de modelo e cliente (claude,
gpt, cursor) e espaços reservados (unknown, cli, root) são recusados por
esse motivo. Um chamador que conhece sua própria função sempre pode ser mais específico
do que o mínimo.
Sem MCP? Sem problema — todo modelo que pode ler e escrever arquivos pode participar:
cole o bloco correspondente de prompts/ (Claude Code, Cursor,
Codex/AGENTS.md, ou um chat MCP) — ele conecta o hubd e aponta para HUBD.md,
o protocolo sempre atual.
Executando para uma equipe? hubd também fala MCP sobre HTTP — um hub compartilhado para o qual todos os seus agentes apontam, protegido por token e multi-inquilino. Veja self-hosting.
Atualizando, e onde seus dados vivem
hubd é uma ferramenta, como git ou node: você instala o código, e seus dados
são uma pasta que é sua. São duas coisas separadas — e esse é exatamente o ponto.
- Código — o pacote npm. Atualize como qualquer CLI global:
npm i -g @bzdos/hubd@latest(ou execute uma vez comnpx -y @bzdos/hubd). Uma nova versão entrega o mecanismo (changelog); ela nunca toca nos seus dados. - Dados —
HUBD_DIR(padrão~/.hubd): markdown simples + JSONL, seus para manter.HUBD_TEAM_DIRdefinido sozinho significa o mesmo diretório único para tudo; defina ambos apenas quando as filas realmente moram em outro lugar.hub doctordiz qual venceu. - Quem escreveu —
HUBD_AGENT: o autor padrão para chamadas que omitem um, por configuração do servidor. Defina-o em cada cliente e em cada host; um campo obrigatório sem piso transforma um argumento esquecido em uma chamada falha. - A malha está realmente sincronizando?
hub doctorconta quantos commits este hub está atrás deorigin, porque um loop de sincronização que continua tentando parece exatamente com um que funciona: um nó aqui foi 228 commits sem receber o trabalho de ninguém enquanto cada relatório chamava o hub de saudável. Ele também nomeia caminhos rastreados que diferem apenas por maiúsculas/minúsculas — no macOS ou Windows esses são um arquivo para duas entradas de índice, o que nenhum commit pode limpar, e eles param um merge permanentemente. Desde 0.9.6 o hubd não criará tal par em primeiro lugar, e o doctor sinaliza qualquer cartão que ainda contenha marcadores de conflito, já que um leitor os serve como conteúdo em vez de como um erro. - Uma fila que responde "nada novo" mas não está vazia. A entrega avança um cursor por arquivo,
então um cursor que este usuário não pode escrever interrompe a entrega completamente — e costumava parecer exatamente como uma
fila ociosa, em ambos os lados: a espera dizia nada novo, o envio dizia enviado. Quatro funções ativas seguraram
um dia de pedidos dessa forma. Agora a espera falha com o arquivo e a correção,
hub doctorlista tais cursores, e um envio relata a profundidade agora em espera para que um backlog crescente seja visível ao remetente. - Um cartão que virou um log. O resumo é anunciado como algumas linhas do estado atual, e
nada o mantinha lá: um hub alcançou três cartões além de 72 KB, e ler o maior foi
recusado pelo orçamento de contexto do chamador. O hubd agora recusa um resumo longo demais e um
appendLinedatado (isso é um evento —hub reporto aceita), e move as entradas mais antigas de uma seção longa demais paraprojects/history/<slug>.md. Movido, nunca descartado: fatos escritos porhub_reportvivem apenas no cartão.hub cards compactatualiza um hub que cresceu primeiro. - Um par que ficou quieto. Um nó cujo pull continua abortando sabe disso, e ninguém executa o
hub doctorde outra máquina — então ele escreve localmente, não alcança ninguém, e parece bem de todos os lados.hub doctoragora nomeia os nós que pararam de aparecer na própria história da malha. - Antes de reescrever a pasta do hub —
hub freeze "<why>" --by <you>interrompe a sincronização de malha deste nó, seja qual for o agendamento,hub unfreezea libera, ehub doctornão deixará você esquecer que está ativado. - Quando uma fila conflita — somente anexação por contrato, mas sem merge de união, dois
lados que ambos anexaram colidem.
hub queue resolvemantém o nosso no lugar e anexa o deles no final, o que deixa cada cursor de byte no hub válido. - Quando um cartão conflita — o único arquivo compartilhado que pode, sendo o único
mutável —
hub card resolveune os trechos de lista com marcadores (dois nós anexando fatos não discordaram) e deixa trechos de prosa para você, nomeados por seção. Ele sai com código não zero enquanto algo permanecer. - Várias máquinas? Torne
HUBD_DIRum repositório git e sincronize-o como quiser — um remoto privado via SSH funciona, sem necessidade de GitHub. Cada máquina instala o código do npm; seus dados viajam no seu próprio git. Duas trilhas separadas: código do pacote, dados na sua pasta. Atualizar o código nunca migra ou exclui seus dados — os logs de eventos são somente anexação e mais ricos que o esquema de qualquer versão única. - Um hub que foi escrito isoladamente — uma variável de ambiente mal roteada, um
~/.hubdprivado, um laptop que nunca se juntou — é incorporado comhub absorb <dir> --as <label>: seus logs tornam-se os arquivos por nó desse rótulo aqui, seus ids de tarefa são renomeados<label>-<n>em cada campo e cada texto para que parem de colidir com os seus, seu histórico de fila é mantido de lado e nunca reentregue, e o plano (mapa de ids, blocos não lidos, cartões mantidos para um humano) é impresso antes que qualquer coisa seja escrita. Nada já no seu hub é reescrito. - Qual versão está realmente rodando —
hub versionimprime o número e o caminho da cópia que o imprimiu, porque em uma máquina real essas são uma pergunta: uma instalação global desatualizada e um checkout de código-fonte ativo são ambos chamadoshub. Desde 0.9.4 cada linha de diário também carrega a versão que a anexou, entãohub doctorrelata toda a malha — qual nó está atrasado, se esta cópia é a desatualizada, e se dois hubds estão escrevendo em um nó ao mesmo tempo, nomeando os agentes em cada versão. Esse último detalhe é o 0.9.12 pagando por um palpite errado de si mesmo: o aviso costumava dizer "duas instalações em um nó", e neste hub havia uma instalação — um servidor MCP residente continuava escrevendo a versão que havia importado enquanto um CLI novo escrevia a atual a partir do mesmo arquivo. Atualizar um pacote no disco não alcança um processo que já o importou. Este bloco inteiro existe porque a máquina que desenvolve o hubd rodou um CLI nove versões antigo por semanas e nada em lugar algum poderia ter dito isso. - Retomando após uma compactação de contexto — uma compactação entrega a um agente um resumo do que
aconteceu; o trabalho retoma do que existe.
hub whereami(shell) ehub_context(MCP) respondem a partir do estado: o projeto, seu resumo com idade e um vereditodigestStale, tarefas abertas, quem mais está com heartbeat neste checkout, o final do diário — além, no shell, do inventário git (assuntos de commit, estatística de diff, arquivos não rastreados com sua primeira linha, arquivos alterados na última meia hora).hub_whatsnew({since:"session"})retorna o que a própria sessão escreveu, o que o checkpoint padrão "desde minha última chamada" não pode. Hooks de editor que executamhub whereamino início da sessão e após uma compactação: prompts/client-hooks.md. - Reivindicações que avisam antes da edição — o
areade uma reivindicação é um glob de caminho relativo à raiz do projeto (src/**/*.ts,docs/{a,b}.md, um diretório).hub claim check <path>/hub_claim_checkdiz de quem é a zona de um arquivo antes de você escrevê-lo, ehub_contextrelataclaimsTouchedquando um arquivo recém-alterado está na zona de alguém. O bloqueio permanece suave: ele informa, nunca proíbe. Áreas de prosa ainda são aceitas, sinalizadasmatchable:false. - Corrigindo um resumo —
hub card <slug> --replace "<old>" --with "<new>"(ouhub_card_set({replace:[{from,to}], appendLine})) corrige uma linha desatualizada sem reescrever o enquadramento do dono; umfromque não está lá é um erro, nunca um no-op silencioso.hub_reportinforma a idade do resumo em cada resposta e dá um toque quando ele fica atrás do diário que você acabou de mover. - O que uma atualização exige de você — às vezes uma nova versão quer algo fora
do código: uma variável na configuração de um cliente, uma função declarada no hub, uma seção de
protocolo que vale reler. O hubd resolve isso e informa os próprios agentes:
hub_whatsnewretorna uma listaenvironment, cada item dizendo o que está errado, o que corrige, e quem pode — o agente, o agente mais um reinício do cliente, ou você. Uma mudança de protocolo nomeia as seções que realmente se moveram, para que ninguém releia o manual inteiro.hub doctormostra a mesma lista a um humano. Nada bloqueia uma chamada, nada precisa de confirmação: um item desaparece quando a condição desaparece. Estado por nó em.env-state.json, nunca sincronizado na malha — três máquinas têm três ambientes.
Como funciona
- Diário & relatórios estruturados — registro de equipe somente em anexo (INBOX.md) que você lê
com seus olhos. Ao final da sessão, um agente arquiva um
hub reportde linhas com prefixo de tags (DECIDE: … | why,FACT:,COMM:,NEXT:,DONE: ids) que se distribuem nas seções do cartão do projeto — estrutura em campos, não em um bloco de prosa. "O que mudou" é lido do git, não redigitado. Os títulos das seções do cartão (em qualquer idioma) vêm de um único arquivo,HUB/sections.json, que alimenta tanto o esqueleto do cartão quanto o roteador de relatórios — para que nunca divergirem. Uma escrita alcança a seção que um cartão já possui sob qualquer um de seus títulos, então re-localizar um hub nunca gera uma segunda cópia;hub cards merge-sectionsmescla duplicatas antigas. - Filas — filas de mensagens por função. Envie trabalho; um agente bloqueia em
waitaté algo chegar, depois volta a esperar. Sem consultas suas, sem cutucadas neles. Uma fila tem um consumidor ativo por padrão — execute uma única sessão em espera por função. Funções listadas em<team>/subscriber-roles.jsonse distribuem em vez disso: cada sessão em espera recebe seu próprio cursor e vê cada mensagem, identificada por um nome que sobrevive a uma reinicialização (HUBD_SUBSCRIBER/HUBD_SESSION/HUBD_AGENT), então um leitor reiniciado retoma de onde parou. Atravessar máquinas é uma preocupação separada e substituível:scripts/mesh-sync.shmove a pasta via git+ssh, e mrgd pode carregar as mesmas filas como tráfego de sala Matrix — simultaneamente, no mesmo diretório. Veja docs/interop.md → Transport, incluindo como verificar qual dos dois está realmente habilitado em um nó específico. No modo de trabalho (hub queue wait <role> --tasks), a fila é o conjunto de tarefas abertas e prontas da própria função: ler não consome nada, iniciar é uma reivindicação com TTL, e cancelar é fechar a tarefa — um pedido lido por uma rodada que não fez nada nunca é perdido, e um pedido para uma tarefa cancelada nunca é executado. - Projetos & tarefas — um cartão por projeto; tarefas entre projetos com responsáveis (agente ou humano) e reivindicações como bloqueios suaves, para que dois agentes não se atropelem.
- Funções, trilhas, supervisão — uma função é um cartão de recurso do tipo
role(rankhead / worker / fleet, um linkhead, seu repositório). Um projeto com um head é uma trilha.hub boardcoloca cada trilha em uma tela para o responsável — o estado de cada função, o que foi feito esta semana e por que foi aceito, o que vem a seguir, o que espera por você.hub sense <head>mede os workers e branches do head sem um modelo e acorda o head apenas em um evento; sem padrões privados declarados, ele não passa nenhum branch. Um loop relata seu estado como campos de heartbeat (--state,--turn,--empty...), então nada interpreta sua redação. - Recursos & relacionamentos — infraestrutura também é um cartão: hosts, vms, serviços,
endpoints, provedores sob
resources/, com frontmatter estruturado (tipo, endereço, os, provedor, status) e arestas[[wikilink]]tipadas (runs_on,depends_on,deploys_to,exposes,part_of, ...). O mesmo mecanismo de arestas lê cartões de projeto, entãohub graphrenderiza uma topologia entre projetos ↔ recursos; uma tarefa se conecta ao que toca com--resource. Fatos vão em campos, não em prosa. - Quadro (somente leitura) —
hub serve: Trilhas, um kanban ao vivo e um Histórico do diário para reproduzir. Cartões se movem porque agentes os movem. O único botão é ⚙ Regras, e ele abre AGENTS.md. Você não gerencia os agentes — você gerencia as regras. - Colheita — um prompt transforma qualquer diálogo de trabalho em resumos de projeto, tarefas
e decisões registradas. Servido como um prompt MCP (
harvest) ehub harvest, então você o invoca diretamente do seu cliente — sem buscar o arquivo. Veja HARVEST.md. - MCP + arquivos, dois níveis de compatibilidade — clientes inteligentes se conectam via MCP; todo o resto usa os arquivos diretamente. Se hubd estiver fora do ar, seus dados ainda são apenas markdown.
- Instruções que permanecem atuais — suas regras de equipe vivem em
AGENTS.md(suas para escrever); a mecânica do próprio hubd vive emHUBD.md, regenerada por nó a partir da versão instalada (ignorada pelo git, nunca sincronizada). Atualize o código → o próximo comandohubque escreve (ouhub upgrade) atualizaHUBD.md, então até agentes que apenas leem os arquivos nunca seguem instruções desatualizadas. Um comando que apenas lê não escreve nada no hub.
Princípios (violar estes = não é este produto)
Arquivos primeiro. Servidor burro, agentes inteligentes — sem IA dentro: hubd armazena e
serve, a inteligência vem dos seus agentes. Nunca soe mais certo do que os
dados: uma ferramenta que engana seu leitor está quebrada mesmo quando nada errou, então
uma resposta truncada diz que foi truncada e um número que o hub não pode observar nunca é
estimado. Tudo legível por humanos. Zero dependências. Somente leitura para o
humano; acesso de escrita flui através das regras.
Degradação graciosa: sem MCP → arquivos; sem hubd → arquivos ainda legíveis como estão — em
qualquer editor, grep, ou um aplicativo Markdown como Obsidian. Veja
Lendo seu hub com qualquer ferramenta.
Sobre essa gravação
O quadro no topo é a coisa real em dados inventados:
node scripts/capture-kanban.mjs --gif monta um hub descartável em um diretório
temporário, o serve e depois o edita durante a captura — atribui um cartão, fecha um,
arquiva uma tarefa, registra uma decisão — e deixa a página perceber por conta própria. Nada é
encenado e o hub real de ninguém é filmado. Seis atualizações no quadro, e apenas uma delas
é um cartão deslizando para a direita: agentes também adicionam trabalho, e a maior parte do que chega em um
registro de coordenação não move cartão algum.
O que hubd não é
Não é um orquestrador (não lança agentes nem transmite saída). Não é memória vetorial (o diário armazena fatos que você pode ler, não embeddings). Não é um Jira para humanos (o humano aqui é um espectador e um legislador, não um designado). Não é outro chat (fale com hubd através do seu agente; mãos — CLI; olhos — kanban).
Construído pela equipe que coordena
O desenvolvimento do próprio hubd passa pelo hubd: um humano e alguns agentes em modelos de diferentes fornecedores, coordenando através de nada além dos arquivos acima. É nosso dogfood diário — e a ilustração mais honesta que podemos oferecer do protocolo em uso real, incluindo a noite em que uma falha de ferramenta forçou tudo de volta para arquivos simples e o trabalho simplesmente continuou. A história de uma equipe, levemente anonimizada e autorrelatada, não um benchmark: doze semanas disso em notas de campo — cada mecanismo que quebrou, e o bug que fez cada painel concordar confiantemente em um número que era 72% inventado — e uma noite hora a hora em o estudo de caso.
O principal trabalho do humano era editar as regras.
Preços
O núcleo é MIT, para sempre. Uso pessoal é gratuito, para sempre. Se um plano de equipe hospedado existir, a linha é simples: agentes são gratuitos, humanos são cobrados.
Roteiro
Enviado: sincronização multi-máquina (logs somente em anexo por host, sem conflitos); acesso
remoto via HTTP (com token, multi-tenant, veja auto-hospedagem);
um grafo de relacionamentos tipado ([[wikilink]] arestas entre projetos e recursos,
hub graph); recursos como cartões de primeira classe (hosts / serviços / endpoints);
relatórios estruturados que se distribuem nas seções do cartão; i18n de seções em um arquivo
(sections.json); um protocolo HUBD.md por nó que se regenera para corresponder à
versão instalada; colheita como um prompt MCP; auto-bootstrap cwd → projeto
(hub_context: arquivo marcador / caminho de sincronização gravado / palpite de nome de pasta, sem
hub_get manual necessário); um registro de presença (hub_heartbeat/hub_presence,
frescor TTL como reivindicações) para que agentes MCP/headless apareçam ao lado dos
raspados de tela, com profundidade de fila exibida em hub_brief — e, a partir de 0.9.13, uma visão de frota que
admite seus pontos cegos: presence/ é local ao nó, então cada nó publica um pequeno
presence.<node>.json e hub_presence relata qual nó observou cada linha, além de uma
lista coverage nomeando qualquer membro que não está reportando nada. Uma função que ninguém reporta é
invisível, não morta — distinguir esses dois vale 92 horas, que é o que confundi-los
custou uma vez; e botões — itens de fila de decisão do proprietário resumidos
em hub_brief como "N botões esperando (mais antigo X dias)"
(HUB/owner-roles.json nomeia as funções humanas).
Próximo: tipos de tarefa com seus próprios ciclos de vida (uma tarefa comunicativa sabe que está
esperando uma resposta); um modo remoto de ponta a ponta (o servidor nunca lê seu
trabalho); um gateway que faz proxy de seus servidores MCP pessoais; e a
camada narrativa promovida ao servidor — hub_chronicle / hub_probe
mais tipos de diário de humor/check-in, uma vez que a versão arquivo-primeiro se prove
(design, modelos em hubd-company/). O formato de
arquivo é o contrato estável; todo o resto é negociável.
Onde isso foi usado e o que realmente preveniu
O caso contra o qual hubd foi construído, e o único que vale descrever porque é a forma estranha que o trabalho real tem:
Levantando um hipervisor EL2 do zero em um Banana Pi M64 — um hipervisor tipo-1 bare-metal rodando FreeBSD 15.1 arm64 como convidado, além de um driver de GPU Mali-400 portado para FreeBSD no caminho. Três repositórios separados saíram disso: bzdk (o hipervisor), lima-freebsd (o driver de GPU, extraído para ser útil sem o resto), e bsdos (o sistema operacional para o qual tudo isso é).
A máquina de build e o quadro nunca foram a mesma máquina. O cross-compilador, as árvores de fonte do FreeBSD e do drm-kmod e o build do Mesa viviam em um host. O quadro chegou em outro, em uma rede diferente, com o console serial e a Ethernet de depuração fisicamente conectados lá. Então o trabalho foi dividido: compilar em um lugar, gravar e observar em outro. Vários agentes trabalharam em paralelo — um em clocks, um perseguindo coerência de DMA, um escrevendo testes.
O que isso custa sem um diário compartilhado é específico, não abstrato:
- Dois agentes dirigindo um quadro. A porta serial aceita um leitor; dois fazem um canal saudável parecer morto. "Quem tem o quadro" tem que ser um fato que alguém anotou, não uma suposição.
- Redescobrindo o mesmo achado. Um bug de hardware diagnosticado na terça é re-diagnosticado na quinta por alguém que nunca viu a primeira conclusão. Vários dos dez patches upstream que saíram deste projeto levaram um dia inteiro para encontrar; encontrar um duas vezes é um dia jogado fora.
- Reivindicações sem número por trás. "A correção funciona" não é portável entre máquinas. "512 MiB de leituras, zero erros, antes morria após 27 MiB" é. Os relatórios do hubd são onde esses números foram, por isso as notas de versão puderam ser escritas a partir de registros em vez de memória.
- Conclusões desatualizadas sobrevivendo à sua evidência. Meio dia deste projeto foi gasto encontrando documentos que afirmavam confiantemente coisas que o código desde então refutou. Um diário somente em anexo não impede isso, mas permite que você veja quando uma afirmação foi feita e o que era verdade na época.
Nada disso precisa de um servidor, e nada disso saiu das máquinas envolvidas: os dados são markdown e JSONL em uma pasta, sincronizados através de um remoto git privado via SSH. Essa é toda a razão pela qual foi construído assim.
Licença
MIT.