stella-mcp
Servidor MCP para criar e manipular modelos de dinâmica de sistemas Stella (arquivos .stmx no formato XMILE)
Documentação
Servidor Stella MCP
Um servidor Model Context Protocol (MCP) neutro em relação a fornecedores
para criar e manipular modelos de dinâmica de sistemas Stella.
Qualquer cliente MCP compatível pode construir, ler, validar e
salvar arquivos .stmx no formato XMILE; recursos opcionais do host ainda variam.
Para que serve?
Stella é uma ferramenta de modelagem de dinâmica de sistemas usada para simular sistemas complexos em áreas como ecologia, biogeoquímica, economia e engenharia. Este servidor MCP permite que assistentes de IA possam:
- Criar modelos do zero - Construir diagramas de estoque-e-fluxo programaticamente
- Ler modelos existentes - Analisar e compreender arquivos .stmx
- Validar modelos - Verificar erros como variáveis indefinidas ou conexões ausentes
- Modificar modelos - Adicionar estoques, fluxos, auxiliares e conectores
- Salvar modelos - Exportar arquivos XMILE válidos que abrem no Stella Professional
Isso é particularmente útil para:
- Ensinar modelagem de dinâmica de sistemas
- Prototipagem rápida de modelos por meio de linguagem natural
- Criação ou modificação em lote de modelos
- Documentar e explicar modelos existentes
Instalação
Via PyPI
pip install stella-mcp
Via código-fonte
git clone https://github.com/bradleylab/stella-mcp.git
cd stella-mcp
pip install -e .
Requisitos
- Python 3.10+
mcp>=2.0.0,<3
Configuração
Via uvx (sem necessidade de instalação)
Se você tiver o uv instalado, a configuração de menor atrito executa o pacote publicado diretamente:
{
  "mcpServers": {
    "stella": {
      "command": "uvx",
      "args": ["stella-mcp"]
    }
  }
}
Claude Desktop
Adicione ao seu claude_desktop_config.json:
{
  "mcpServers": {
    "stella": {
      "command": "stella-mcp"
    }
  }
}
Claude Code
Adicione ao seu .claude/settings.json:
{
  "mcpServers": {
    "stella": {
      "command": "stella-mcp"
    }
  }
}
Modo de desenvolvimento
Se estiver executando a partir do código-fonte:
{
  "mcpServers": {
    "stella": {
      "command": "python",
      "args": ["-m", "stella_mcp.server"],
      "cwd": "/path/to/stella-mcp"
    }
  }
}
Fluxo de Trabalho Recomendado para Agentes
Para um novo modelo:
- Em MCP 2026-07-28, chame
create_workspacee carregue oworkspace_idretornado nas chamadas com estado. Clientes stdio legados podem omiti-lo. build_modelcom ummodel_idestável e o conjunto completo de estoques, auxiliares e fluxos em uma única chamada (sincronização de conectores e validação são executadas por padrão, então a resposta serve também como inspeção).- Corrija erros de validação com
update_*,rename_variableoudelete_variable. - Estenda incrementalmente com
add_variables(em lote) ou as ferramentas de adição individual. simulatepara verificar o comportamento (requer o extrasim).- Salve com
save_model.
Para modelos importados:
read_modelcomcompat_mode="permissive"para inspecionar avisos.- Execute
inspect_modelpara entender a estrutura do modelo. - Use
compat_mode="strict"antes do salvamento final quando a fidelidade de ida-e-volta for importante.
Ferramentas Disponíveis
Criação de Modelos e E/S
| Ferramenta | Descrição |
|---|---|
create_model | Criar um novo modelo com nome e configurações de tempo (início, fim, dt, método) |
set_sim_specs | Atualizar configurações de tempo de simulação em um modelo existente |
read_model | Carregar um arquivo .stmx existente |
save_model | Salvar modelo em um arquivo .stmx |
delete_model | Remover um modelo do espaço de trabalho (arquivos salvos não são alterados) |
Modelos Prontos (Templates)
| Ferramenta | Descrição |
|---|---|
list_templates | Listar modelos prontos integrados e definidos pelo usuário (suporta filtros de origem/consulta/tag) |
get_template_info | Obter metadados detalhados de um modelo pronto |
load_template | Carregar um modelo pronto como modelo no espaço de trabalho atual |
save_as_template | Salvar o modelo atual como um modelo pronto reutilizável do usuário (descrição/tags opcionais) |
Construção de Modelos
| Ferramenta | Descrição |
|---|---|
build_model | Criar e popular um modelo em uma única chamada (lote atômico) |
add_variables | Adicionar múltiplas variáveis/conectores/módulos a um modelo existente (lote atômico) |
add_stock | Adicionar um estoque (reservatório) com valor inicial e unidades |
add_flow | Adicionar um fluxo entre estoques com uma equação |
add_aux | Adicionar uma variável auxiliar (parâmetro ou cálculo) |
update_stock | Atualizar campos de estoque preservando relacionamentos |
update_flow | Atualizar campos de fluxo preservando vínculos de estoque |
update_aux | Atualizar campos de variável auxiliar |
add_connector | Adicionar um conector de dependência entre variáveis |
sync_connectors_from_equations | Adicionar conectores de dependência ausentes inferidos de equações |
set_connector_routing | Definir ângulo do conector e metadados explícitos de roteamento de waypoint |
rename_variable | Renomear um estoque/fluxo/auxiliar e atualizar referências em equações/conectores/módulos |
delete_variable | Excluir um estoque/fluxo/auxiliar com verificações de consistência e limpeza |
create_module | Criar um módulo/grupo lógico de variáveis |
add_to_module | Adicionar variáveis a um módulo/grupo existente |
remove_from_module | Remover variáveis de um módulo/grupo |
rename_module | Renomear um módulo/grupo |
delete_module | Excluir um módulo/grupo |
set_module_view | Definir posição/tamanho explícito da caixa do módulo no diagrama |
set_module_style | Definir estilo da caixa do módulo (borda/fundo/fonte/lado do rótulo) no diagrama |
auto_place_module_boxes | Posicionar automaticamente as caixas dos módulos ao redor de seus membros |
Notas:
- Clientes MCP 2026-07-28 chamam
create_workspaceuma vez e incluem seuworkspace_idretornado nas chamadas com estado. A descoberta moderna de ferramentas marca esse campo como obrigatório nas ferramentas com estado. O ID roteia o estado da aplicação; não é uma credencial de autorização. - Clientes stdio legados suportados podem omitir
workspace_ide usar um espaço de trabalho de compatibilidade local ao processo; a descoberta legada mantém o campo opcional. - As ferramentas aceitam
model_idopcional para que um espaço de trabalho possa gerenciar múltiplos modelos com segurança. create_modeleread_modeldefinem omodel_idatual do espaço de trabalho e o retornam.add_floweadd_auxsuportam cargasgraphical_functionopcionais (yptsmais exatamente um dexscaleouxpts).add_stock/add_flow/add_auxrejeitam nomes de variáveis duplicados entre tipos de variáveis;add_connectorexige que ambas as variáveis existam.set_connector_routingpode direcionar um conector porconnector_uidou porfrom_var+to_var.save_modeleget_model_xmlaceitamauto_layout(padrãotrue) eresolve_layout_violations(padrãofalse).save_model,get_model_xmlerender_diagramretornam o viewport de layout mais recente, métricas e avisos em conteúdo estruturado. Seus resultados em texto nomeiam quaisquer códigos de aviso de layout não limpos.read_model,save_modeleget_model_xmlaceitamcompat_mode:permissive(padrão): continuar com avisosstrict: falhar em problemas de compatibilidade
set_module_styleatualiza o estilo da visualização do módulo e persiste esses atributos nos elementos<group .../>da visualização XMILE.save_as_templategrava modelos prontos do usuário em~/.stella-mcp/templatespor padrão (substituível viaSTELLA_MCP_TEMPLATE_DIR) e armazena metadados em um sidecar.meta.json.- Falhas de ferramentas retornam erros MCP estruturados com
error.code,error.categoryeerror.message. - Todo resultado bem-sucedido de ferramenta mantém texto legível e fornece
structuredContentvalidado por esquema, descrito pelo seuoutputSchemaJSON Schema 2020-12.
Ciclo de Vida do Espaço de Trabalho
| Ferramenta | Descrição |
|---|---|
create_workspace | Criar um espaço de trabalho isolado, opcionalmente com tempo de vida selecionado pelo chamador |
revoke_workspace | Revogar um espaço de trabalho e descartar seus modelos em memória |
Inspeção de Modelos
| Ferramenta | Descrição |
|---|---|
list_models | Listar IDs de modelos disponíveis no espaço de trabalho e indicar o modelo atual |
inspect_model | Retornar um resumo estruturado do modelo para inspeção do agente |
list_modules | Listar módulos/grupos no modelo atual |
list_connectors | Listar IDs de conectores, endpoints, ângulos e metadados de roteamento |
list_variables | Listar todos os estoques, fluxos e auxiliares |
validate_model | Verificar erros (variáveis indefinidas, conexões ausentes, etc.) |
get_model_xml | Visualizar a saída XML XMILE |
render_diagram | Renderizar o modelo como um diagrama SVG de estoque-e-fluxo |
simulate | Executar o modelo via PySD e retornar séries temporais + resumos (extra sim) |
compare_scenarios | Executar conjuntos nomeados de overrides "e se" contra uma linha de base e relatar deltas (extra sim) |
sensitivity_analysis | Varrer parâmetros um por vez e classificar seu efeito em uma métrica de saída (extra sim) |
calibrate | Ajustar parâmetros constantes a uma série temporal observada (inverso de simular) (extra sim) |
Construção em Lote
build_model cria e popula um modelo em uma única chamada. Os itens são aplicados na
ordem estoques → auxiliares → fluxos → conectores → módulos; todo o lote é
tudo-ou-nada, e em caso de falha o erro nomeia o item com falha
(error.stage + error.index). Os mesmos arrays de itens funcionam em um modelo
existente via add_variables.
{
  "name": "build_model",
  "arguments": {
    "name": "SIR",
    "model_id": "sir",
    "sim_specs": {"start": 0, "stop": 100, "dt": 0.125, "time_units": "Days"},
    "stocks": [
      {"name": "Susceptible", "initial_value": "9999", "units": "people"},
      {"name": "Infected", "initial_value": "1", "units": "people"},
      {"name": "Recovered", "initial_value": "0", "units": "people"}
    ],
    "auxs": [
      {"name": "contact_rate", "equation": "6"},
      {"name": "infectivity", "equation": "0.25"},
      {"name": "recovery_time", "equation": "2", "units": "days"},
      {"name": "total_population", "equation": "Susceptible + Infected + Recovered"}
    ],
    "flows": [
      {"name": "infection", "equation": "Susceptible * contact_rate * infectivity * Infected / total_population", "from_stock": "Susceptible", "to_stock": "Infected"},
      {"name": "recovery", "equation": "Infected / recovery_time", "from_stock": "Infected", "to_stock": "Recovered"}
    ],
    "modules": [
      {"name": "Disease Dynamics", "members": ["Susceptible", "Infected", "Recovered"]}
    ]
  }
}
Sincronização de conectores e validação são executadas por padrão (desative com
"sync_connectors": false / "validate": false); a resposta inclui o
resumo estruturado completo do modelo, então nenhuma chamada de acompanhamento inspect_model é necessária.
Exemplos de Cargas de Ferramentas
Criar e alternar entre modelos no espaço de trabalho:
{"name":"create_model","arguments":{"name":"Population","model_id":"pop_v1"}}
{"name":"create_model","arguments":{"name":"Carbon","model_id":"carbon_v1"}}
{"name":"list_models","arguments":{}}
{"name":"delete_model","arguments":{"model_id":"pop_v1"}}
{"name":"inspect_model","arguments":{"model_id":"sir_baseline","include_validation":true}}
Listar e carregar modelos prontos:
{"name":"list_templates","arguments":{}}
{"name":"list_templates","arguments":{"source":"builtin","query":"epidem","tags":["epidemiology"]}}
{"name":"get_template_info","arguments":{"template_name":"sir"}}
{"name":"load_template","arguments":{"template_name":"sir","model_id":"sir_baseline"}}
Salvar o modelo atual como um modelo pronto do usuário:
{"name":"save_as_template","arguments":{"model_id":"pop_v1","template_name":"my_population_template","description":"Baseline single-stock growth starter","tags":["intro","population"]}}
Criar e gerenciar módulos:
{"name":"create_module","arguments":{"model_id":"sir_baseline","name":"Disease Dynamics","members":["Susceptible","Infected","Recovered"]}}
{"name":"add_to_module","arguments":{"model_id":"sir_baseline","module_name":"Disease Dynamics","members":["infection","recovery"]}}
{"name":"list_modules","arguments":{"model_id":"sir_baseline"}}
{"name":"remove_from_module","arguments":{"model_id":"sir_baseline","module_name":"Disease Dynamics","members":["recovery"]}}
{"name":"rename_module","arguments":{"model_id":"sir_baseline","module_name":"Disease Dynamics","new_name":"Disease Core"}}
{"name":"delete_module","arguments":{"model_id":"sir_baseline","module_name":"Disease Core"}}
Renomear e excluir variáveis com segurança:
{"name":"rename_variable","arguments":{"model_id":"sir_baseline","old_name":"population_total","new_name":"total_population"}}
{"name":"delete_variable","arguments":{"model_id":"sir_baseline","name":"recovery"}}
{"name":"delete_variable","arguments":{"model_id":"sir_baseline","name":"Susceptible","force":true}}
Atualizar uma variável existente:
{"name":"update_flow","arguments":{"model_id":"pop_v1","name":"growth","equation":"Population * growth_rate * stress_modifier"}}
Inferir conectores ausentes de equações:
{"name":"sync_connectors_from_equations","arguments":{"model_id":"pop_v1"}}
Definir geometria da visualização do módulo diretamente:
{"name":"set_module_view","arguments":{"model_id":"sir_baseline","module_name":"Disease Dynamics","x":420,"y":280,"width":420,"height":240}}
Definir estilo da visualização do módulo:
{"name":"set_module_style","arguments":{"model_id":"sir_baseline","module_name":"Disease Dynamics","border_color":"#666666","background":"#FFF7E6","font_color":"#333333","font_size":"10pt","label_side":"top"}}
Posicionar automaticamente caixas de módulos a partir das posições atuais dos membros:
{"name":"auto_place_module_boxes","arguments":{"model_id":"sir_baseline","padding":40,"only_missing":true}}
Direcionar um modelo específico em chamadas posteriores:
{"name":"add_stock","arguments":{"model_id":"pop_v1","name":"Population","initial_value":"100"}}
Ler com verificações estritas de compatibilidade:
{"name":"read_model","arguments":{"filepath":"./external_model.stmx","model_id":"imported","compat_mode":"strict"}}
Visualizar XML em modo permissivo (padrão) e retornar avisos de compatibilidade quando presentes:
{"name":"get_model_xml","arguments":{"model_id":"imported","compat_mode":"permissive"}}
Carga válida de função gráfica:
{
  "name": "add_aux",
  "arguments": {
    "model_id": "pop_v1",
    "name": "lookup_rate",
    "equation": "GRAPH(Time)",
    "graphical_function": {
      "xscale": {"min": 0, "max": 100},
      "ypts": [0.1, 0.2, 0.4, 0.6],
      "type": "continuous"
    }
  }
}
Carga inválida de função gráfica (rejeitada):
{
  "name": "add_aux",
  "arguments": {
    "name": "bad_lookup",
    "equation": "GRAPH(Time)",
    "graphical_function": {
      "xscale": {"min": 0, "max": 100},
      "xpts": [0, 10, 20, 30],
      "ypts": [0.1, 0.2, 0.4, 0.6]
    }
  }
}
Exemplo de Uso
Criando um modelo populacional simples
User: Create a simple exponential growth model with a population starting at 100
      and a growth rate of 0.1 per year

Claude: [Uses create_model, add_stock, add_aux, add_flow, add_connector, save_model]
        Creates population_growth.stmx with:
        - Stock: Population (initial=100)
        - Aux: growth_rate (0.1)
        - Flow: growth (Population * growth_rate) into Population
Lendo e analisando um modelo existente
User: Read the carbon cycle model and explain what it does

Claude: [Uses read_model, list_variables]
        This model has 3 stocks (Atmosphere, Land Biota, Soil) and 6 flows
        representing carbon exchange through photosynthesis, respiration...
Construindo um modelo biogeoquímico
User: Create a two-box ocean model with surface and deep nutrients

Claude: [Uses create_model, add_stock (x4), add_aux (x8), add_flow (x6), save_model]
        Creates a model with nutrient cycling between surface and deep ocean
        including upwelling, downwelling, biological uptake, and remineralization
Visualização do Diagrama
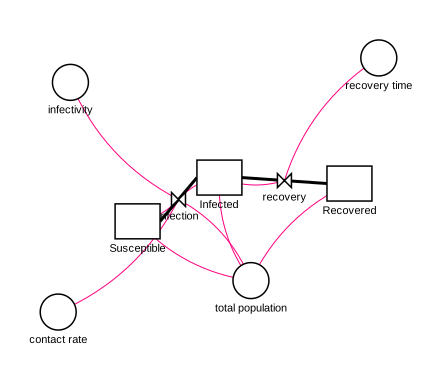
A ferramenta render_diagram renderiza o modelo como um diagrama SVG de estoque-e-fluxo
— estoques como retângulos, auxiliares como círculos, fluxos como tubos com válvulas
(nuvens marcam fontes/destinos) e conectores de dependência como polilinhas roteadas. O SVG é
retornado inline para que um agente possa inspecionar o layout e, opcionalmente, gravado
em um arquivo que você pode abrir em qualquer navegador. Ele executa auto-layout primeiro por padrão,
então um modelo recém-construído é renderizado sem posicionamento manual.
{"name":"render_diagram","arguments":{"model_id":"sir_baseline","filepath":"./sir.svg"}}
O diagrama abaixo é o modelo pronto integrado sir renderizado por render_diagram
(sem posicionamento manual):
Simulação
A ferramenta simulate executa o modelo atual e retorna séries temporais
reduzidas por amostragem, além de resumos por variável (inicial/final/mín/máx), fechando o
ciclo construir→verificar sem abrir o Stella. Ela requer a dependência opcional
PySD:
pip install 'stella-mcp[sim]'
{"name":"simulate","arguments":{"model_id":"pop_v1","overrides":{"growth_rate":0.05},"include":["Population"],"max_points":50}}
Notas e ressalvas:
- O PySD integra-se somente com Euler — modelos cujo
methodé RK4 simulam com Euler e a resposta carrega um aviso. Toda resposta apoiada pelo PySD identifica a versão instalada do PySD, o método real, o método declarado, a pré-verificação de recursos não suportados e avisos. - Arrays, instâncias de módulos composicionais e modelos adicionais de nível superior são
apenas preservados na versão 0.14. Eles falham antes do PySD com um erro estruturado
unsupported_model_featureem vez de serem silenciosamente escalarizados ou achatados. - PySD e Stella não têm semântica de saída idêntica em todos os casos escalares suportados. No fixture Lotka-Volterra mantido, Stella limita uma saída para impor um estoque não negativo, enquanto o PySD relata a equação de fluxo sem limite. As trajetórias de estoque ainda chegam a zero juntas no próximo tempo do modelo.
overridesaceita nomes de variáveis na forma de exibição ("growth rate") ou sublinhado (growth_rate) e substitui a variável por uma constante.save_results_csvescreve a tabela de resultados em resolução completa com uma colunatime.- O modelo do workspace nunca é modificado pela simulação (a execução usa uma cópia descartável).
Comparação de Cenários
A ferramenta compare_scenarios responde "o que acontece sob estas suposições
alternativas?" — ela executa vários conjuntos de substituições nomeadas contra uma linha de base (o
modelo não modificado por padrão) e relata como cada uma diverge. Também requer o
extra sim.
{"name":"compare_scenarios","arguments":{"model_id":"pop_v1","include":["Population"],"scenarios":[{"name":"low growth","overrides":{"growth_rate":0.02}},{"name":"high growth","overrides":{"growth_rate":0.08}}]}}
Cada cenário relata sua própria série reduzida, além de delta_vs_baseline por
variável: final_abs, final_pct (mudança percentual do valor final) e
max_abs. Notas:
- Cada nome de substituição em todos os cenários é validado antes de qualquer execução, então um erro de digitação falha rapidamente e atomicamente — nenhum cenário é executado pela metade.
- Um cenário cuja execução produz NaN/inf relata o aviso no
warningsdesse cenário sem abortar os outros;final_pcténullquando o final da linha de base é zero (sem divisão por zero). baselineé opcional — passe um conjunto de substituições para medir deltas contra, ou omita-o para comparar com o modelo não modificado.save_comparison_csvescreve uma tabela larga com uma coluna porvariable__scenario(evariable__baseline).- O modelo compilado é reutilizado em todos os cenários em uma única chamada, então uma comparação é aproximadamente tão barata quanto uma única simulação mais uma execução por cenário.
Análise de Sensibilidade
A ferramenta sensitivity_analysis responde "quais parâmetros realmente movem o
resultado?" — ela varre cada parâmetro um de cada vez em um intervalo (mantendo os
outros em sua linha de base) e relata como uma única métrica de saída escolhida
responde. Também requer o extra sim.
{"name":"sensitivity_analysis","arguments":{"model_id":"pop_v1","parameters":[{"name":"growth_rate","start":0.02,"stop":0.08,"steps":7}],"output":{"variable":"Population","metric":"final"}}}
Para cada parâmetro, ela retorna a métrica em cada valor varrido, um
range_sensitivity (a inclinação média da métrica no intervalo varrido) e um
elasticity normalizado pela linha de base (≈ Δsaída% / Δparâmetro%) para que os parâmetros possam ser
classificados por influência. Notas:
- Somente um de cada vez.
modeaceita"oat"; fatorial completo (grid) e amostragem Monte-Carlo são reservados para uma versão futura. metricé um definal,max,min,meanoutime_to_threshold(que precisa de umoutput.thresholde relata o primeiro momento em que a série o cruza). max/min/média cobrem apenas valores finitos; uma execução não finita ou que nunca cruza relatanullpara esse ponto com um aviso.- Uma especificação de parâmetro é
start/stop/steps(espaçado uniformemente,steps≥ 2) ou uma lista explícita devalues(≥ 2 entradas). max_runs(padrão 200) limita o total de execuções varridas; uma varredura superdimensionada gera erro em vez de truncar silenciosamente. Execuções OAT são uma soma entre parâmetros, não um produto, então o limite só é atingido em varreduras realmente grandes.elasticityénullquando não pode ser definido (um parâmetro não constante, ou uma métrica/parâmetro de linha de base zero);range_sensitivityainda é relatado.save_sweep_csvescreve uma tabela longaparameter, value, metric.- Como na comparação de cenários, o modelo é compilado uma vez e reutilizado em toda a varredura.
Calibração
A ferramenta calibrate é o inverso de simulate: dado uma série temporal
observada, ela ajusta parâmetros constantes para que o modelo reproduza os dados. Também
requer o extra sim.
{"name":"calibrate","arguments":{"model_id":"pop_v1","observations":{"time":[0,2,4,6,8,10],"targets":{"Population":[100,122,149,182,222,271]}},"parameters":[{"name":"growth_rate","initial":0.05,"min":0,"max":0.3}]}}
Ela retorna os parâmetros ajustados (cada um com seus limites, um sinalizador at_bound e um
std_error linearizado), a trajetória do objetivo ponderado
(initial/final weighted_sse e weighted_rmse), métricas de erro em unidades nativas para
cada alvo, status/configuração do otimizador e avisos. Notas:
- Somente auxiliares e fluxos constantes são calibráveis. Estoques são rejeitados: a substituição de parâmetro do PySD fixa um estoque a uma constante para toda a execução em vez de definir seu valor inicial, o que achataria silenciosamente um modelo dinâmico. Ajustar condições iniciais de estoque não é suportado.
- Dois otimizadores.
least_squares(padrão) é local e rápido e relata umstd_error;differential_evolutioné global, estocástico, com semente para reprodutibilidade, e requer limitesmin/maxem cada parâmetro. Seu limite de geraçõesmaxiteré 100 por padrão. - O
initialde cada parâmetro é o valor constante atual do modelo por padrão. Limites são opcionais paraleast_squares, obrigatórios paradifferential_evolution. std_erroré uma aproximação linearizada, não uma posterior: é a covariânciaσ²·(JᵀJ)⁻¹e é relatada somente quando há mais observações do que parâmetros, o Jacobiano é bem condicionado e nenhum parâmetro está em um limite; caso contrário, énullcom um aviso.differential_evolutionretornanull(sem Jacobiano). Sobweightsnão padrão, a interpretação do erro padrão vale somente para pesos inversos de σ.- Alinhamento. O modelo executa em sua janela nativa
[start, stop]e a simulação é linearmente interpolada nos tempos de observação. Tempos de observação fora da janela são rejeitados (sem extrapolação). Todos os alvos compartilham uma grade de tempo estritamente crescente; observações são carregadas inline ou de umcsv_path(primeira coluna tempo, o restante alvos). weightsopcionais por alvo são multiplicadores de resíduo: o otimizador usaweight * (simulated - observed). Valores inversos do desvio padrão de medição dão resíduos normalizados. Como erros ponderados podem misturar unidades,target_metricsrelata um SSE e RMSE não ponderados nas unidades nativas de cada alvo; nenhum RMSE agregado em unidades nativas é relatado.save_fit_csvescreve uma tabela longatime, target, observed, fitted;return_fit_seriesanexa a série de melhor ajuste. O modelo é compilado uma vez e reutilizado em todo o ajuste.
Recursos e Prompts MCP
Além das ferramentas, o servidor expõe capacidades nativas do MCP:
- Anotações de ferramentas. Cada ferramenta carrega dicas (
readOnlyHint,destructiveHint,idempotentHint) para que os clientes possam gerenciar permissões e paralelizar chamadas somente leitura. Ferramentas de inspeção (inspect_model,validate_model,list_*,get_model_xml) são somente leitura;delete_*são marcadas como destrutivas. - Recursos. Modelos de template e workspace são legíveis como recursos:
stella://templates/{name}— o.stmxde um template embutido ou do usuáriostella://workspaces/{workspace_id}/models/{model_id}— a exportação XMILE atual de um modelo de workspace explícitostella://models/{model_id}— somente o workspace legado de compatibilidade stdio
- Prompt. Um prompt
build-stella-model(argumento:description) codifica o fluxo de trabalho recomendado construir → validar → simular → renderizar → salvar, então é descobrível dentro de clientes MCP.
Validação
A ferramenta validate_model verifica:
- Variáveis indefinidas - Referências a variáveis que não existem
- Problemas de balanço de massa - Estoques sem fluxos, fluxos referenciando estoques inexistentes
- Conexões ausentes - Equações usando variáveis sem conectores (aviso)
- Integridade dos pontos finais dos conectores - Conectores apontando para variáveis ausentes (erro)
- Fluxos órfãos - Fluxos não conectados a nenhum estoque
- Dependências circulares - Loops infinitos em cálculos auxiliares
- Integridade do módulo - Módulos vazios (aviso) e módulos referenciando membros ausentes (erro)
- Unidades presentes - Um estoque ou fluxo sem unidades enquanto outros as definem (aviso)
- Consistência de unidades - Um fluxo cujas unidades não leem como
stock-units/time-unitquando todos os estoques anexados compartilham as mesmas unidades (aviso; conservador — permanece silencioso em fluxos de conversão e qualquer coisa que não possa analisar com confiança) - Auxiliares não utilizados - Um auxiliar referenciado por nenhuma equação ou conector (aviso); estoques e fluxos nunca são sinalizados
Compatibilidade XMILE
- Arquivos de saída usam o padrão XMILE
- Compatível com Stella Professional 1.9+ e Stella Architect
- Importação/exportação
permissivepreserva conteúdo suportado e os fragmentos XML não suportados selecionados quando prático, retornando avisos explícitos. Editar variáveis suportadas não garante que referências dentro de fragmentos apenas preservados sejam atualizadas. - Importação/exportação
strictrejeita arrays, instâncias de módulos composicionais, modelos adicionais de nível superior e identificadores reservados confirmados de Stella/XMILE. Arrays e modelos aninhados não são recursos implementados na versão 0.14. - Nomes reservados como
betaegammasão preservados com avisos no modo permissivo e rejeitados no modo estrito. O template SIR embutido usatransmission_rateerecovery_ratepara que Stella não os renomeie ao salvar. - Auto-layout usa uma espinha dorsal determinística direcionada de estoque-fluxo, portas de estoque distintas, rotas de fluxo e conector cientes de obstáculos, verificações de colisão de rótulos e dimensionamento de grade de página a partir de limites visuais completos.
- Coordenadas autorais, incluindo coordenadas fornecidas por ferramentas de atualização, e pontos de rota bloqueados permanecem fixos. Coordenadas geradas automaticamente são recalculadas em exportações posteriores para que modelos estendidos incrementalmente possam ser classificados novamente em vez de congelarem após o primeiro salvamento.
- Caminhos bloqueados são reservados antes de rotas desbloqueadas, rótulos são selecionados em ordem de nome normalizado, e tamanhos de fonte de visualização importados controlam a geometria dos rótulos em visualizações de análise e SVG.
- Conectores de informação usam segmentos diretos de limite a limite sempre que o diagrama completo os deixa desobstruídos e não compartilhados. Tubos de estoque-fluxo permanecem ortogonais porque Stella reescreve segmentos de fluxo diagonais ao salvar.
- Layouts de referência planares limpos não têm cruzamentos de glifos, rótulos ou rotas. Um
grafo que não pode ser desenhado limpo ainda é exportado e relata um aviso estável
layout.*; zero cruzamentos não são prometidos para grafos não planares arbitrários. - Nomes de variáveis com espaços são convertidos para sublinhados internamente
- O parser normaliza referências de pontos finais de entrada/saída de estoque e conectores importados
- Exportação de passo de tempo evita arredondamento recíproco com perda (recíprocos não exatos são exportados como
dtsimples) - Importação/exportação preserva atributos/elementos desconhecidos em seções suportadas (cabeçalho, sim_specs, variáveis, visualizações/extras de modelo) para reduzir perda de dados em ida e volta
- Testes de regressão do corpus de compatibilidade vivem em
tests/fixtures/compat_corpus/. Um subconjunto fixado e atribuído de modelos de teste SDXorg vive emtests/fixtures/external_corpus/; ambos rodam offline no CI. - Auxiliar de manutenção:
python scripts/sync_compat_corpus_manifest.py --checkvalida a sincronização do manifesto do corpus
Testes
A suíte de testes do repositório cobre o protocolo MCP stdio, isolamento de workspace, construção de modelo, validação, renderização SVG, importação/exportação XMILE, simulação, análise de cenários, análise de sensibilidade, calibração e instalação de pacotes. Execute-a a partir de um checkout da fonte com:
uv sync --locked --extra dev --extra sim
uv run python -m pytest
Pinned Stella-saved and external XMILE fixtures live under tests/fixtures/ and
run offline in CI. Generated reports, local planning files, and manual review
artifacts are intentionally not committed to the source tree.
Estrutura do Projeto
Consulte docs/architecture.md para limites de dependência,
propriedade de módulos, ciclo de vida do workspace e contratos de compatibilidade.
stella-mcp/
├── CHANGELOG.md
├── CITATION.cff
├── README.md
├── LICENSE
├── pyproject.toml
└── stella_mcp/
    ├── __init__.py
    ├── server.py         # MCP server lifecycle and protocol wiring
    ├── tool_handlers.py  # Compatibility facade for domain handlers
    ├── tool_schemas.py   # Compatibility facade for the tool catalog
    ├── tools/            # Domain schemas and handlers
    ├── mcp_resources.py  # MCP resources and prompts
    ├── session_store.py  # Explicit application workspace state
    ├── simulate.py       # PySD-backed simulation
    ├── analysis.py       # Scenario comparison and sensitivity analysis
    ├── calibrate.py      # Parameter fitting and native-unit error metrics
    ├── render_svg.py     # Stock-and-flow SVG rendering
    ├── model_types.py     # Model records and XMILE constants
    ├── model.py           # StellaModel lifecycle and compatibility delegates
    ├── model_layout.py    # Layout compatibility delegates and stock sizing
    ├── layout_graph.py    # Directed graph ranking and component packing
    ├── layout_router.py   # Boundary ports and obstacle-aware routing
    ├── layout_quality.py  # Geometry analysis, metrics, and warnings
    ├── layout_pipeline.py # Staged deterministic layout orchestration
    ├── xmile.py           # Public model compatibility facade
    ├── xmile_io.py        # XMILE I/O compatibility facade
    ├── xmile_features.py  # XMILE feature classification and typed errors
    ├── xmile_parse.py     # XMILE parser and compatibility warnings
    ├── xmile_export.py    # XMILE serialization and fragment retention
    └── validator.py      # Model validation logic
Contribuindo
Contribuições são bem-vindas! Sinta-se à vontade para enviar issues ou pull requests.
Lançamento pelo Mantenedor
A publicação no PyPI é gerenciada por .github/workflows/publish.yml usando PyPI Trusted
Publishing. Para lançar uma nova versão:
- Sincronize a versão em
pyproject.toml,stella_mcp/__init__.py,CITATION.cffeCHANGELOG.md; mantenha as datas de lançamento da citação e do changelog idênticas. - Execute
uv lock --check, as suítes de teste de núcleo e simulação, a suíte MCP-floor e o job de pacote. Prepare o rascunho das notas de lançamento do GitHub a partir da entrada correspondente emCHANGELOG.md. - Antes de enviar o branch de lançamento, verifique as regras protegidas de tag
mainev*, a política de tag protegida do ambientepypie o PyPI Trusted Publisher configurado. - Abra um pull request de rascunho para que todas as verificações críticas de lançamento sejam executadas, exija exatamente essas verificações, obtenha revisão e aprove o merge separadamente.
- Aguarde uma nova execução de CI
mainno commit de merge exato. Se a data de lançamento de Chicago tiver mudado, corrija os metadados por meio de outro pull request revisado antes de continuar. - Com aprovação separada, crie a tag de versão leve nesse commit de merge auditado. Com outra aprovação, crie e inspecione o rascunho do GitHub release a partir do arquivo de notas correspondente.
- Com aprovação final de publicação, publique o rascunho. O evento de release compila
e valida a distribuição de código-fonte e a wheel sem autoridade OIDC; a
política de implantação configurada do job
pypiaceita apenas tags que correspondam à política de tag de release protegidav*antes que o Trusted Publishing possa enviar os artefatos verificados.
Criação de tag, criação de rascunho e publicação são portões de aprovação distintos. Não mova ou substitua uma tag pública ou distribuição enviada para reparar um lançamento.
Licença
Licença MIT - consulte LICENSE para detalhes.
Agradecimentos
- Model Context Protocol por Anthropic
- ISEE Systems por Stella e o formato XMILE