Telebrief
Resumos auto-hospedados dos seus canais do Telegram via MCP: resumos com IA, o último resumo e mensagens brutas por canal, com OpenAI, Anthropic ou Ollama.
Documentação
Telebrief
Gerador Automatizado de Resumos do Telegram com IA



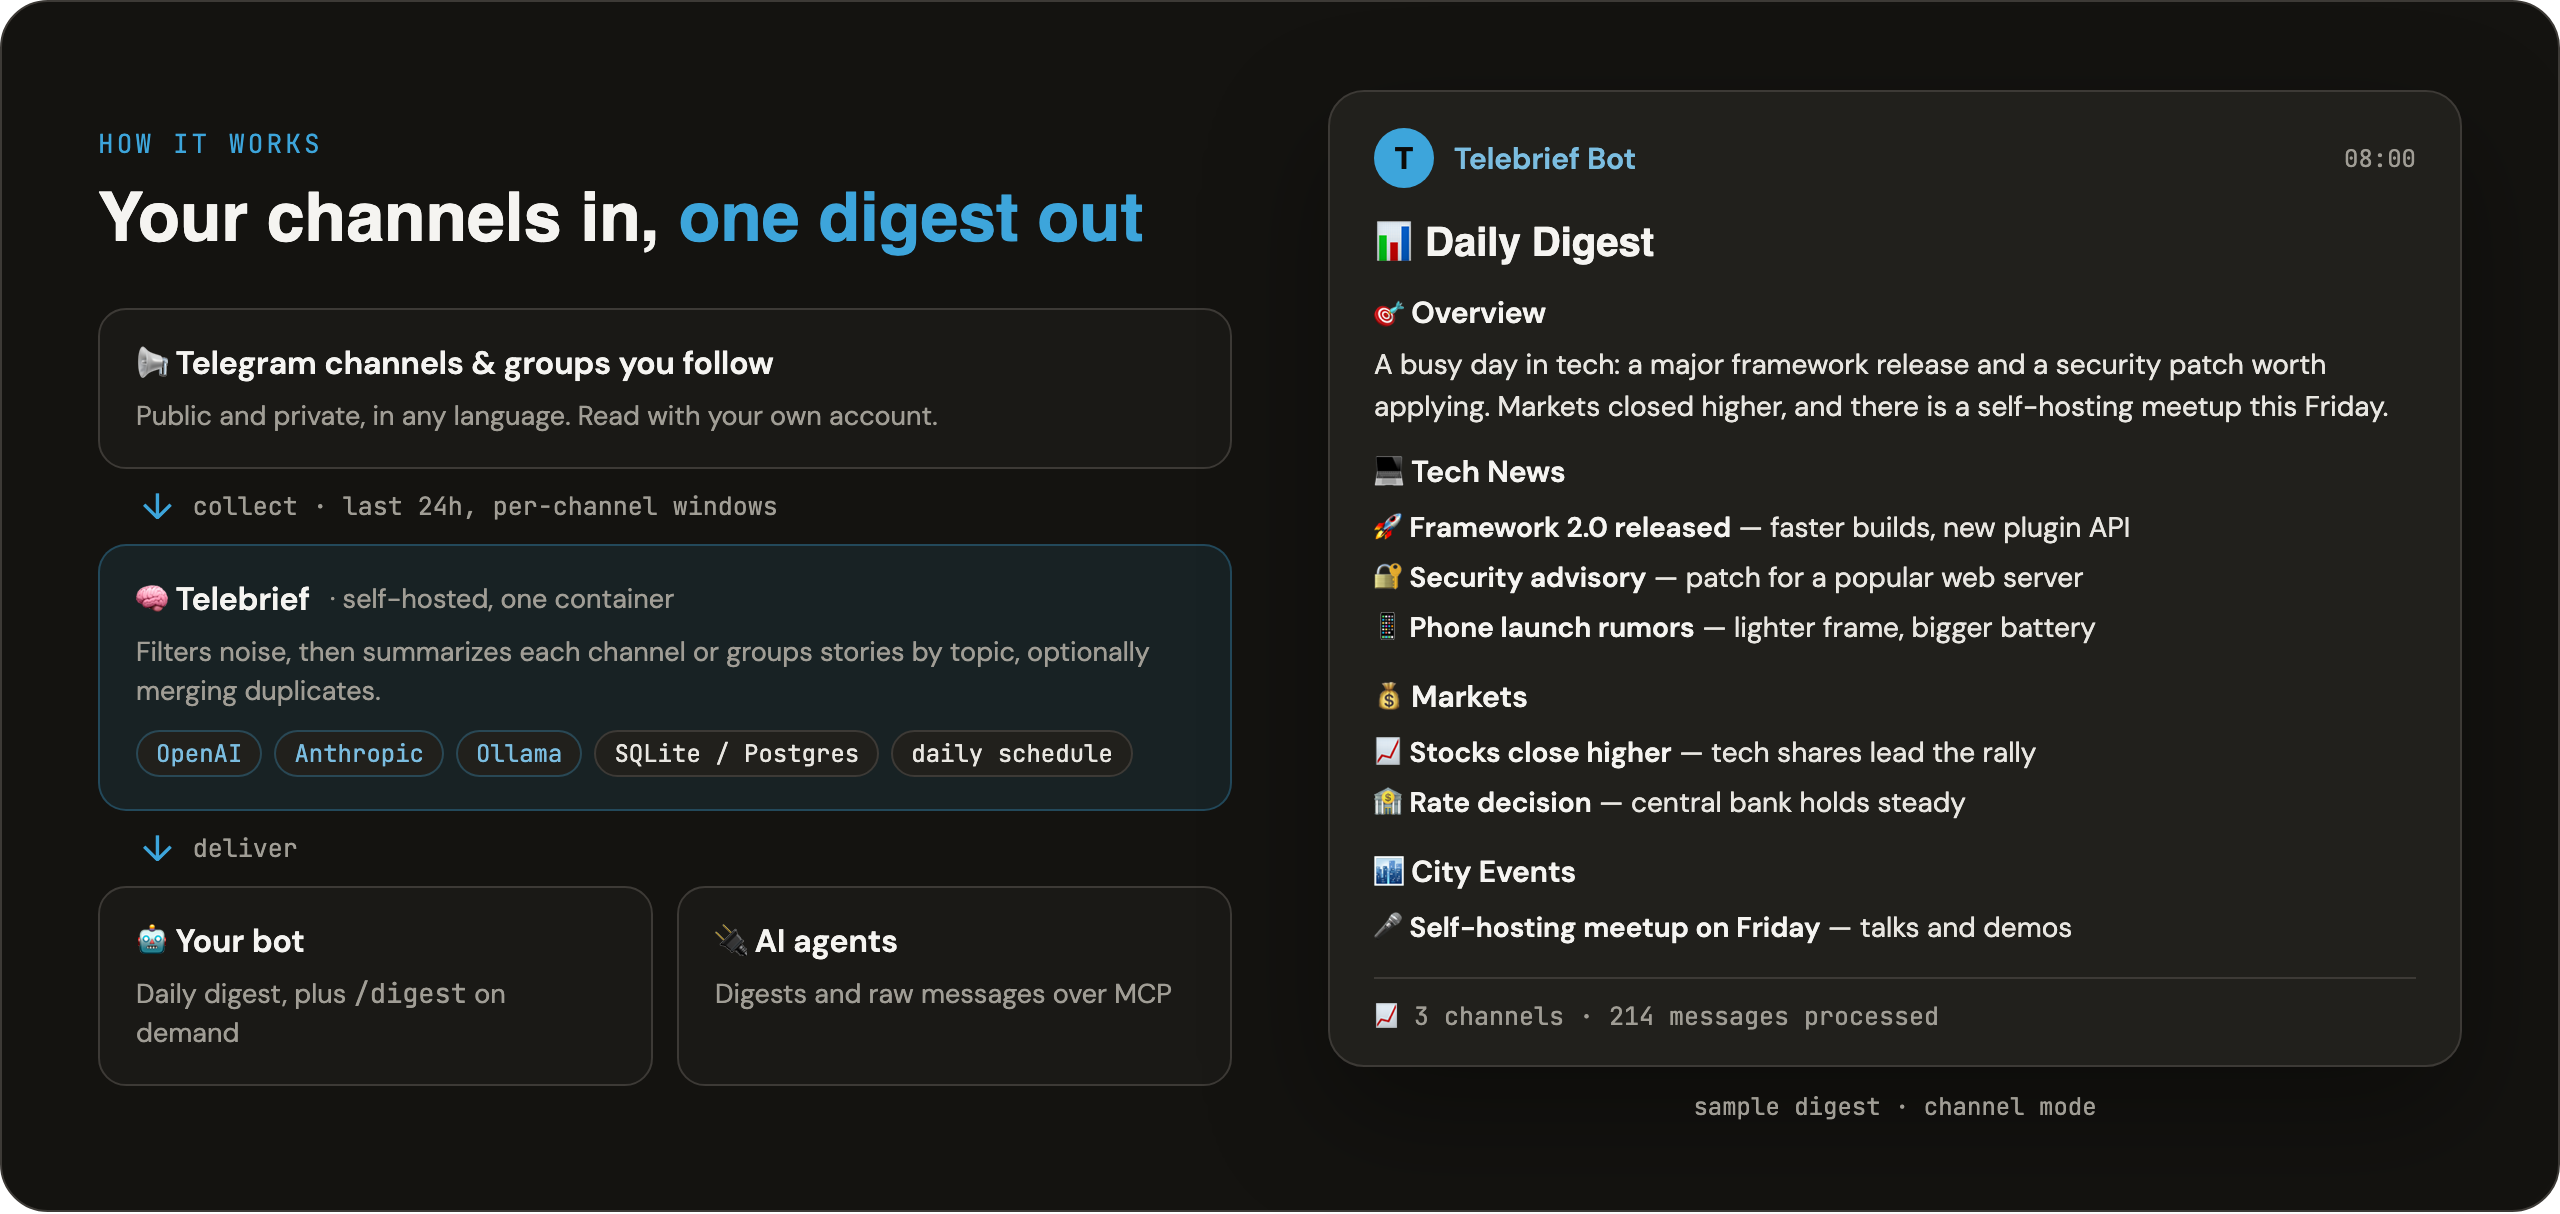
O Telebrief coleta mensagens dos seus canais do Telegram (em qualquer idioma), gera resumos com IA e entrega um resumo diário através do seu próprio bot do Telegram. Agrupe resumos por canal ou por tópicos detectados por IA. Suporta vários provedores de IA: OpenAI, Ollama (local) e Anthropic. Os resumos são gerados em inglês, russo, espanhol, alemão ou francês (padrão: russo).
📑 Conteúdo
- Recursos
- Pré-requisitos
- Início Rápido
- Comandos do Bot
- Exemplo de Saída — modo canal, modo tópico, deduplicação
- Configuração por Canal — janela de retrospectiva, instruções de IA
- Armazenamento Persistente — SQLite, PostgreSQL, esquema
- Extensibilidade — filtros, prompts, vínculo de grupo, consultas de armazenamento
- Servidor MCP — ativação, modo stdio, ferramentas, canal único, segurança
- Desenvolvimento e Testes
- FAQ
- Contribuição · Licença · Créditos
✨ Recursos
- 🌐 Suporte a Múltiplos Idiomas - Lê canais em QUALQUER idioma (inglês, russo, ucraniano, chinês, etc.)
- 🌍 Idioma de Saída Configurável - Resumos, rótulos e mensagens do bot em inglês, russo, espanhol, alemão ou francês (padrão: russo)
- 🤖 IA Multi-Provedor - Suporta OpenAI (incluindo GPT-6 Luna, Sol, Astra), Ollama (local) e Anthropic para sumarização
- ⏰ Agendado e Sob Demanda - Resumos automáticos diários + geração instantânea via comandos do bot
- 🔒 Suporte a Canais Privados - Acesse seus chats e canais privados
- 📑 Modos de Resumo - Agrupe por canal (padrão) ou por tópicos detectados por IA como Notícias, Eventos, Esportes
- 🎨 Formatação Inteligente - Markdown com emojis, marcadores e links clicáveis para canais
- 📨 Divisão de Mensagens Longas - Resumos que excedem o limite de 4096 caracteres do Telegram são automaticamente divididos em mensagens sequenciais em vez de truncados
- 🔐 Auto-hospedado - Usuário único; sua sessão, chaves de API e mensagens permanecem no seu servidor
- 🧹 Limpeza Automática - Remove automaticamente mensagens de resumo antigas
- 🔌 Servidor MCP - Endpoint MCP integrado opcional para que agentes de IA possam obter resumos em vez de ler o Telegram
📋 Pré-requisitos
Antes de começar, você precisará de:
-
Docker - Instalar Docker
-
Credenciais do Aplicativo Telegram - Obter em my.telegram.org
api_ideapi_hash- Se o formulário em my.telegram.org/apps mostrar apenas
ERROR, a rejeição vem do Telegram, não do Telebrief. Soluções que geralmente ajudam:- Use um título de aplicativo e nome curto alfanuméricos únicos e aleatórios (Nome curto: 5–32 letras/dígitos, sem espaços)
- Desative VPN, proxy e extensões de bloqueio de anúncios; tente uma janela privada ou outro navegador
- Alterne de rede, por exemplo, dados móveis em vez de Wi-Fi
- Envie novamente algumas vezes; a verificação é intermitente
- Se nada funcionar, entre em contato com o suporte do Telegram. Nunca insira seu código de login em sites de terceiros que oferecem criar um aplicativo para você.
-
Token do Bot do Telegram - Crie via @BotFather
- Envie
/newbotpara criar um novo bot - Salve o token do bot
- Envie
-
Chave de API do Provedor de IA (uma das seguintes):
- OpenAI: Obter em platform.openai.com
- Anthropic: Obter em console.anthropic.com
- Ollama: Nenhuma chave de API necessária - instalar localmente
🚀 Início Rápido
Sem clone e sem Python necessário. Em um diretório vazio, execute o assistente de configuração:
mkdir telebrief && cd telebrief
docker run --rm -it --user "$(id -u):$(id -g)" -v "$PWD":/setup \
  ghcr.io/belaytzev/telebrief python main.py init /setup
O assistente faz login na sua conta do Telegram (telefone, código, 2FA), verifica o token do bot, permite escolher canais dos seus diálogos por número e escreve .env, config.yaml, docker-compose.yml e sessions/user.session. Seu ID de usuário é obtido do login.
Em seguida, pressione Iniciar no chat do seu bot e inicie o serviço:
docker compose up -d
docker compose logs -f telebrief
Envie /digest para o bot para obter o primeiro resumo imediatamente. Execute o assistente novamente a qualquer momento: ele reutiliza a sessão existente e pergunta antes de sobrescrever arquivos.
Para atualizar para a versão mais recente:
docker compose pull && docker compose up -d
As imagens são publicadas no GitHub Container Registry a cada versão com tags latest, X.Y (menor), X.Y.Z (correção). Para compilar a partir do código-fonte, substitua a linha image: em docker-compose.yml por build: .. Para todas as opções além do assistente, consulte config.yaml.example.
🤖 Comandos do Bot
Abra o Telegram e envie mensagem para o seu bot:
| Comando | Descrição |
|---|---|
/start | Igual a /help |
/help | Exibir mensagem de ajuda com todos os comandos |
/digest | Gerar e enviar resumo das últimas 24 horas (usa o digest_mode configurado) |
/status | Mostrar provedor e modelo de IA, número de canais, limpeza automática e a próxima execução agendada |
/cleanup | Excluir manualmente mensagens de resumo antigas |
📊 Exemplo de Saída
O Telebrief suporta dois modos de resumo configurados via digest_mode em config.yaml.
Modo canal (digest_mode: "channel" — padrão)
Agrupa resumos por canal de origem com links clicáveis para canais:
# 📊 Daily Digest - 02 May 2026

## 🎯 Brief Overview

A busy day in tech: a major framework release and a security patch worth
applying. Markets closed higher, and there is a self-hosting meetup this Friday.

---

## 💻 Tech News · [Open channel →](https://t.me/technews)

- 🚀 **Framework 2.0 released**: faster builds, new plugin API
- 🔐 **Security advisory**: patch for a popular web server

## 💰 Markets · [Open channel →](https://t.me/markets)

- 📈 **Stocks close higher**: tech shares lead the rally
- 🏦 **Rate decision**: central bank holds steady

---
📈 **Statistics**: 3 channels, 214 messages processed
O layout dos marcadores de cada canal vem da IA, guiado pelo prompt, então varia ligeiramente entre provedores e modelos.
Modo tópico (digest_mode: "digest")
Agrupa resumos por tópicos detectados por IA. Você define grupos de tópicos em config.yaml:
digest_mode: "digest"
digest_groups:
  - name: "Events"
    description: "Conferences, meetups, releases, launches, announcements"
  - name: "News"
    description: "Politics, economy, world affairs, breaking news"
  - name: "Sport"
    description: "Sports results, transfers, tournaments, matches"
Mensagens que não correspondem a nenhum grupo definido são colocadas em uma categoria automática "Outros".
Todos os rótulos (cabeçalho, estatísticas, comandos do bot) seguem o
output_languageconfigurado. O exemplo acima usaEnglish; os outros valores suportados sãoRussian(padrão),Spanish,GermaneFrench.
dedup_topics — deduplicação entre canais
Quando vários canais cobrem o mesmo evento, o agrupador normalmente produz um marcador por canal. Ative dedup_topics para instruir a IA a manter apenas a descrição mais informativa e mesclar as atribuições de origem:
settings:
  digest_mode: "digest"
  dedup_topics: true        # default: false
  digest_groups:
    - name: "Tech"
      description: "Technology news and releases"
Com a deduplicação ativada, se TechCrunch e HackerNews ambos relatarem o mesmo lançamento de produto, o resumo conterá um único marcador com source: "TechCrunch, HackerNews" em vez de duas entradas separadas.
Nota:
dedup_topicsnão tem efeito emdigest_mode: "channel"— a deduplicação só se aplica durante o agrupamento baseado em tópicos.
⚙️ Configuração por Canal
Cada entrada de canal suporta duas substituições opcionais além dos campos obrigatórios id e name.
lookback_hours — janela de retrospectiva por canal
Substitua o settings.lookback_hours global para um canal específico. Útil quando alguns canais publicam com pouca frequência e precisam de uma janela de coleta mais ampla, ou quando você deseja uma janela mais restrita para canais de alto volume.
channels:
  - id: "@breaking_news"
    name: "Breaking News"
    # no lookback_hours — uses the global settings.lookback_hours

  - id: "@weekly_digest"
    name: "Weekly Newsletter"
    lookback_hours: 168   # look back 7 days for this channel only

  - id: -1001234567890
    name: "High Volume Channel"
    lookback_hours: 6     # only last 6 hours for this channel
lookback_hours deve ser um inteiro positivo. Se omitido ou definido como null, o valor global é usado.
prompt_extra — instruções de IA por canal
Anexe instruções extras ao prompt do sistema de IA ao resumir um canal específico. Use isso para orientar tom, foco ou formato para canais que precisam de tratamento especial.
channels:
  - id: "@cryptonews"
    name: "Crypto News"
    prompt_extra: "Focus only on price movements and regulatory news. Ignore opinion pieces."

  - id: "@jobboard"
    name: "Job Board"
    prompt_extra: "Extract only senior engineering roles. Format as a list: Role — Company — Link."
prompt_extra é anexado literalmente ao prompt do sistema de sumarização do canal. Deixe vazio (ou omita o campo) para comportamento padrão.
🗄️ Armazenamento Persistente
Por padrão, o Telebrief gera resumos sob demanda sem armazenar mensagens brutas. Você pode ativar uma camada de armazenamento persistente que salva cada mensagem coletada em um banco de dados para acesso histórico ou fluxos de trabalho externos com LLM.
O armazenamento está desativado por padrão e é opcional via config.yaml.
SQLite (backend padrão)
Nenhuma configuração extra necessária. As mensagens são salvas em um arquivo SQLite local.
storage:
  enabled: true
  backend: sqlite
  path: data/messages.db   # relative to project root
Ao executar no Docker, o diretório data/ já está montado como volume em docker-compose.yml, então o banco de dados persiste entre reinicializações do contêiner.
PostgreSQL (backend opcional)
Use PostgreSQL para implantações multi-host ou quando precisar de acesso de leitura concorrente ao armazenamento de mensagens.
storage:
  enabled: true
  backend: postgres
  url: "postgresql://user:pass@host:5432/dbname"
asyncpg está incluído na imagem Docker e nas dependências padrão (uv sync), então nenhuma etapa extra de instalação é necessária.
Esquema
Ambos os backends criam o mesmo esquema lógico na primeira execução (tabela e índice são criados automaticamente — nenhuma migração manual necessária):
| Coluna | Tipo | Descrição |
|---|---|---|
channel_name | texto | Nome do canal da sua configuração |
sender | texto | Autor da mensagem |
text | texto | Corpo da mensagem |
timestamp | texto / timestamptz | Carimbo de data/hora da mensagem |
link | texto | Link da mensagem do Telegram |
has_media | bool / inteiro | Se a mensagem tem mídia |
media_type | texto | String do tipo de mídia |
collected_at | texto / timestamptz | Quando a linha foi inserida |
Nota: O armazenamento é somente anexação. Janelas lookback_hours sobrepostas entre execuções produzirão linhas duplicadas para mensagens coletadas em ambas as janelas.
🔌 Extensibilidade
O Telebrief expõe quatro superfícies de gancho que permitem personalizar o comportamento via config.yaml sem modificar a lógica central. Todos os novos campos são opcionais — configurações existentes funcionam sem alterações.
Filtros
Uma cadeia de filtros é executada após a coleta de mensagens e antes do armazenamento e sumarização. Mensagens descartadas nunca chegam à IA ou ao banco de dados.
Filtros integrados estão em src/extensions/filters.py:
| Filtro | Propósito |
|---|---|
KeywordFilter | Manter/descartar mensagens por substring de palavra-chave (sem diferenciar maiúsculas/minúsculas) |
RegexFilter | Manter ou descartar mensagens que correspondem a um padrão regex |
MinLengthFilter | Descartar mensagens mais curtas que um limite de caracteres |
Configure uma cadeia de filtros global sob settings.filters. Cada entrada precisa de um class_path (caminho de importação com pontos) e um dict config opcional passado como argumentos de palavra-chave ao construtor:
settings:
  filters:
    - class_path: src.extensions.filters.KeywordFilter
      config:
        include: ["job", "hiring", "remote"]
        exclude: ["nsfw"]
    - class_path: src.extensions.filters.MinLengthFilter
      config:
        min_chars: 30
Substitua a cadeia global para um único canal adicionando filters: sob essa entrada de canal. Defina filters: [] para desativar a filtragem para esse canal completamente, ou forneça uma lista diferente para substituir a cadeia global apenas para esse canal:
channels:
  - id: "@jobboard"
    name: "Job Board"
    filters:
      - class_path: src.extensions.filters.RegexFilter
        config:
          pattern: "senior|staff|principal"
          mode: "include"
Escreva seu próprio filtro implementando o Protocolo MessageFilter:
from __future__ import annotations
from src.extensions.filters import MessageFilter
from src.config_loader import ChannelConfig
from src.collector import Message

class MyFilter:
    name = "my_filter"

    def __init__(self, custom_param: str = "") -> None:
        self.custom_param = custom_param

    async def filter(self, channel: ChannelConfig, messages: list[Message]) -> list[Message]:
        return [m for m in messages if self.custom_param in (m.text or "")]
Em seguida, referencie-o em config.yaml:
settings:
  filters:
    - class_path: mypackage.mymodule.MyFilter
      config:
        custom_param: "important"
Prompts
O modelo de prompt base está em src/prompts/base_summary.txt. Você pode apontar para um arquivo de modelo personalizado ou conectar uma classe PromptComposer personalizada.
prompts:
  base_template: src/prompts/base_summary.txt  # path to template file
  composer: ""                                  # empty = built-in DefaultComposer
O DefaultComposer integrado monta o prompt final do sistema nesta ordem (partes vazias são ignoradas):
base template (with {language} substituted)
  + group.prompt_extra  (if channel belongs to a group with prompt_extra set)
  + channel.prompt_extra  (if non-empty)
Para usar um compositor personalizado, implemente o Protocolo PromptComposer e defina composer para seu caminho com pontos:
from src.config_loader import ChannelConfig, DigestGroupConfig
from src.extensions.prompts import PromptComposer

class MyComposer:
    def __init__(self, base_template: str, language: str) -> None:
        self._base = base_template
        self._language = language

    def compose(self, channel: ChannelConfig, group: DigestGroupConfig | None) -> str:
        return f"{self._base}\nRespond in {self._language}."
Nota: O construtor deve aceitar
(base_template: str, language: str)como seus dois primeiros argumentos posicionais. Uma assinatura incompatível gera umTypeErrorna inicialização com uma mensagem descritiva.
prompts:
  composer: mypackage.mymodule.MyComposer
Vínculo de grupo
Canais podem ser vinculados a uma entrada digest_groups. O prompt_extra do grupo é então injetado em todos os canais daquele grupo, antes do prompt_extra do próprio canal.
settings:
  digest_groups:
    - name: "Jobs"
      description: "Job listings and hiring announcements"
      prompt_extra: "Extract only role title, company, and link. Format as a list."

channels:
  - id: "@techleads_jobs"
    name: "Tech Jobs"
    group: Jobs          # must match a digest_groups name or "Other"
    prompt_extra: "Focus on senior and staff-level positions only."
Canais sem um campo group (ou group: null) usam o modelo base e apenas o próprio prompt_extra.
Consultas de armazenamento
Quando o armazenamento está habilitado (storage.enabled: true), o StorageBackend expõe uma API de leitura query_messages para ferramentas externas:
from src.storage import SQLiteBackend
from datetime import datetime, timezone

backend = SQLiteBackend("data/messages.db")
await backend.initialize()

messages = await backend.query_messages(
    channel_name="TechCrunch",  # the configured channels[*].name (NOT the @id)
    since=datetime(2026, 4, 1, tzinfo=timezone.utc),
    until=datetime(2026, 4, 30, tzinfo=timezone.utc),
    limit=500,
)
Todos os parâmetros são opcionais. channel_name corresponde ao valor legível por humanos de channels[*].name de config.yaml (este é o valor persistido na coluna channel_name no momento da coleta); omita-o para consultar todos os canais. Renomear um canal na configuração alterará o valor armazenado para novas linhas — linhas históricas mantêm o nome antigo. Os resultados são ordenados por timestamp decrescente e limitados a limit (padrão 1000, deve ser ≥ 1).
🔗 Servidor MCP
O Telebrief pode expor seus resumos através do Model Context Protocol, permitindo que um cliente MCP (Claude Code, por exemplo) solicite um resumo diretamente, em vez de lê-lo no Telegram.
O servidor roda dentro do processo do Telebrief, compartilhando a sessão do Telegram, a configuração e o bloqueio de geração com o agendador e o bot. Os resumos retornados são byte a byte o que o Telegram recebe, incluindo agrupamento por tópico e deduplicação.
Como habilitar
mcp:
  enabled: true
  host: "127.0.0.1"
  port: 8765
  path: "/mcp"
Em seguida, registre-o no seu cliente:
claude mcp add --transport http telebrief http://127.0.0.1:8765/mcp
Modo Stdio
python main.py mcp serve as mesmas ferramentas via stdio sem o bot e o agendador, para clientes que iniciam o servidor por conta própria. Ele lê o mesmo config.yaml, .env e sessão, e conecta-se ao Telegram apenas quando uma ferramenta é chamada. Não o execute junto com o serviço principal no mesmo arquivo de sessão: prefira o endpoint HTTP acima quando o Telebrief já estiver em execução.
Ferramentas
| Ferramenta | Argumentos | Comportamento |
|---|---|---|
get_digest | hours (1–168, padrão 24) | Gera um resumo novo. Leva de 20 a 90 segundos e consome tokens do provedor de IA. |
get_last_digest | — | Retorna o resumo mais recente do cache, com o horário de geração. Instantâneo e gratuito. |
get_channel_messages | channel, hours (1–168, padrão 24), limit (1–500, padrão 200) | Retorna as mensagens individuais de um canal, sem resumo. Não gasta tokens de IA. |
Todo resumo bem-sucedido — agendado, acionado pelo bot ou acionado via MCP — é armazenado em cache em data/last_digest.json, então get_last_digest serve o mesmo resumo que foi entregue ao Telegram.
A geração de resumos é serializada: se o agendador já estiver construindo um resumo, uma chamada MCP aguarda a conclusão em vez de abrir uma segunda sessão do Telegram.
Lendo um único canal
get_channel_messages responde "o que foi realmente publicado neste canal", em oposição ao resumo de IA que um digest fornece.
channel aceita qualquer uma das formas de config.yaml — o channels[*].name legível por humanos ou o channels[*].id (@username ou numérico) — com correspondência sem diferenciar maiúsculas de minúsculas. Um valor desconhecido falha com a lista de nomes de canais configurados, então não é necessária uma chamada separada de descoberta.
A ferramenta lê do armazenamento persistente quando ele está habilitado e contém mensagens para a janela solicitada, e recorre a uma leitura ao vivo do Telegram caso contrário. O cabeçalho da resposta indica qual caminho foi usado:
channel: AI News (from storage, 42 msgs, last 24h)

[2026-08-07T09:12:04+00:00] Alice
OpenAI released a new model...
https://t.me/ainews/1234

[2026-08-07T10:30:11+00:00] Bob
[photo] Benchmark chart
https://t.me/ainews/1235
As mensagens retornam em ordem cronológica; limit mantém as mais recentes e descarta as mais antigas. O fallback ao vivo roda sob o mesmo bloqueio de geração dos resumos e aplica os filtros configurados do canal, para que ambos os caminhos retornem o mesmo conjunto de mensagens.
Duas diferenças deliberadas em relação à geração de resumos:
channels[*].lookback_hoursnão é aplicado — a ferramenta respeita ohoursque o chamador solicitou.- Mensagens apenas de mídia chegam como seu texto de espaço reservado (
[photo],[video]), exatamente como são armazenadas.
Segurança
O servidor MCP não possui autenticação. Ele depende do vínculo ao loopback, onde o SDK também ativa a proteção contra rebinding de DNS. Qualquer pessoa que consiga alcançar a porta pode acionar a geração de resumos e ler os resumos dos seus canais.
Mantenha host em 127.0.0.1. O Telebrief registra um aviso na inicialização se você vincular a qualquer outro lugar. No Docker, publique a porta como 127.0.0.1:8765:8765 em vez de expô-la em todas as interfaces, e coloque-a atrás de um firewall ou proxy reverso com autenticação se você realmente precisar de acesso remoto.
🛠️ Desenvolvimento e Testes
Este projeto usa uv e Python 3.14+. Configuração, suíte completa de verificações, estilo de código e o processo de PR estão no Guia de Contribuição.
Executando Testes
uv sync --extra dev
uv run pytest tests/ -v
uv run mypy src/
❓ FAQ
P: Quais idiomas de saída são suportados?
R: Inglês, Russo (padrão), Espanhol, Alemão e Francês, definidos via output_language. Os canais em si podem estar em qualquer idioma.
P: Quantos canais posso monitorar?
R: Não há limite rígido. Cada resumo lê até max_messages_per_channel mensagens por canal (500 por padrão), então o tempo de execução e o custo de IA crescem com o número de canais ativos.
P: Vários usuários podem receber resumos? R: Não, o Telebrief é de usuário único por design: uma conta do Telegram, um destinatário.
P: Funciona com conversas em grupo?
R: Sim. O assistente de configuração lista seus grupos ao lado dos canais, ou adicione o ID de um grupo a config.yaml da mesma forma que um canal.
P: Minha conta do Telegram está em risco?
R: O Telebrief faz login como você através da API de usuário do Telegram (Telethon) e apenas lê mensagens, mas esta é uma sessão de usuário, não um bot, então as regras usuais do Telegram para clientes de terceiros se aplicam. O arquivo de sessão em sessions/ concede acesso total à sua conta: mantenha-o privado.
P: Quanto custa para executar? R: Apenas o uso de tokens do seu provedor de IA, que depende do modelo e de quanto seus canais publicam. Um modelo de nível nano/mini mantém o custo baixo; com Ollama é gratuito.
P: Posso usar um modelo de IA local?
R: Sim. Defina ai_provider: "ollama" em config.yaml e execute Ollama. Do Docker, aponte ollama_base_url para http://host.docker.internal:11434; no Linux, isso também requer extra_hosts: ["host.docker.internal:host-gateway"] em docker-compose.yml.
P: Posso personalizar o formato do resumo?
R: O layout do resumo está em src/formatter.py; alterá-lo significa compilar a imagem a partir do código-fonte. prompt_extra por canal e prompts personalizados mudam o que a IA escreve sem tocar no código.
🤝 Contribuindo
Contribuições são bem-vindas! Relatórios de bugs, solicitações de recursos, correções de documentação, novos filtros, provedores de IA, backends de armazenamento e traduções são todos apreciados.
- Leia o Guia de Contribuição para configuração de desenvolvimento, estilo de código e o processo de PR
- Este projeto segue o Código de Conduta do Contributor Covenant
- Encontrou um problema de segurança? Por favor, reporte-o de forma privada — veja a Política de Segurança
📄 Licença
Este projeto é licenciado sob a Licença MIT.
🙏 Créditos
Construído com:
- Telethon - API de Usuário do Telegram
- python-telegram-bot - API de Bot
- OpenAI API - Resumo com IA (provedor OpenAI)
- Ollama - Resumo com IA Local
- Anthropic API - Resumo com IA (provedor Anthropic)
- APScheduler - Agendamento de Tarefas
- MCP Python SDK - Servidor MCP