vidlizer
Extraia JSON estruturado de vídeos, imagens e PDFs usando LLMs locais (Ollama, LM Studio, oMLX) ou via OpenRouter. Funciona completamente offline.
Documentação
vidlizer
Aponte para um vídeo, imagem ou PDF. Receba JSON estruturado — cena por cena.


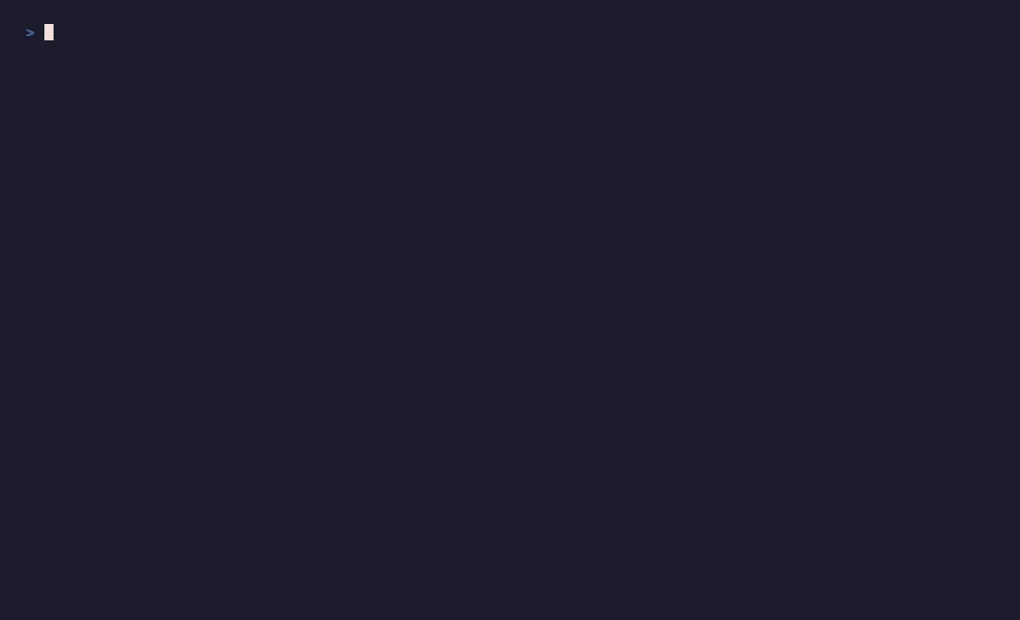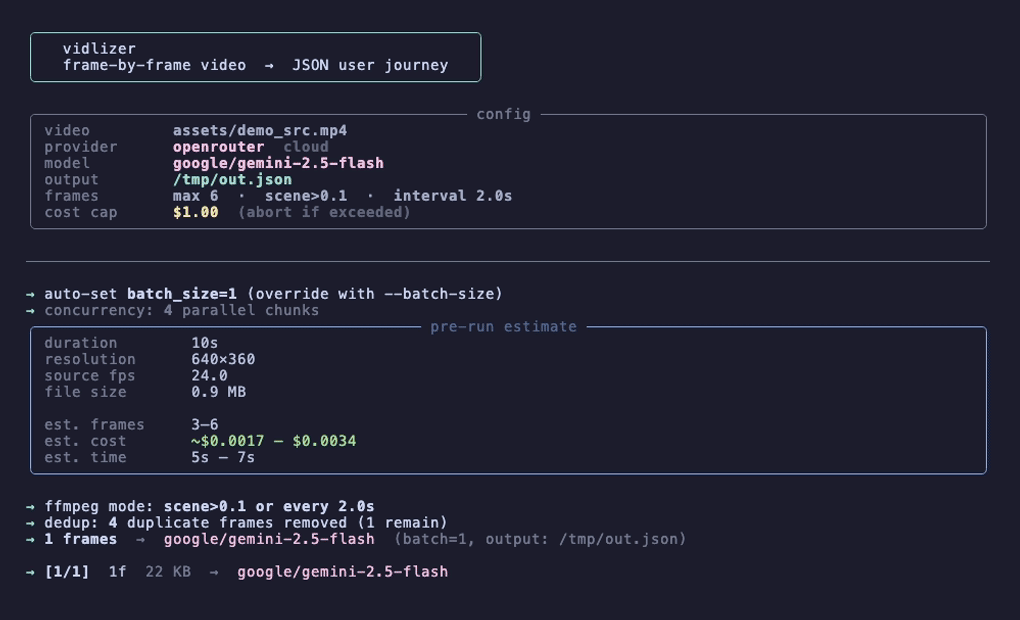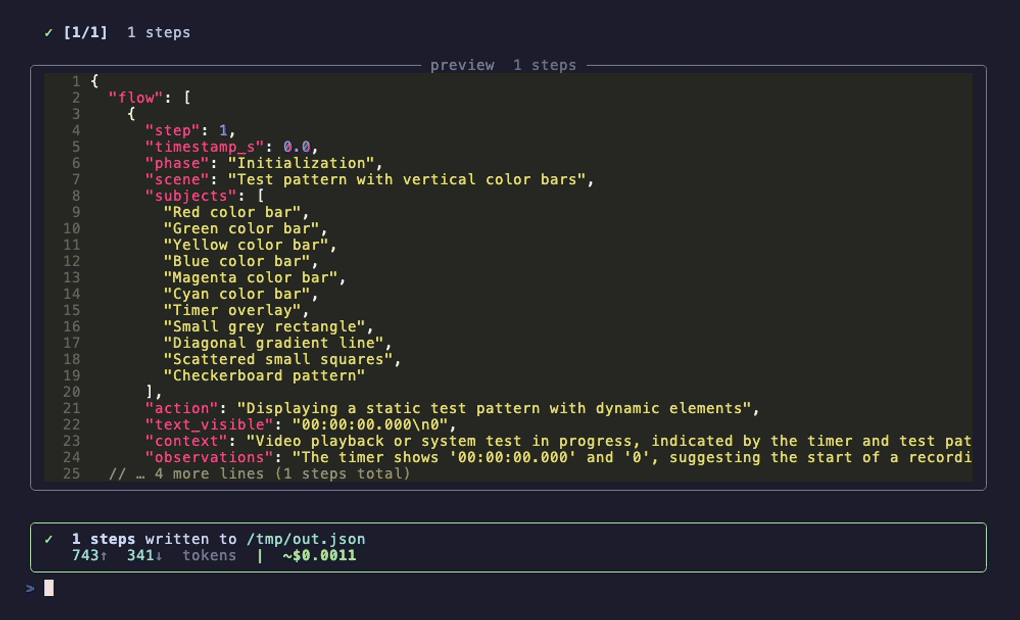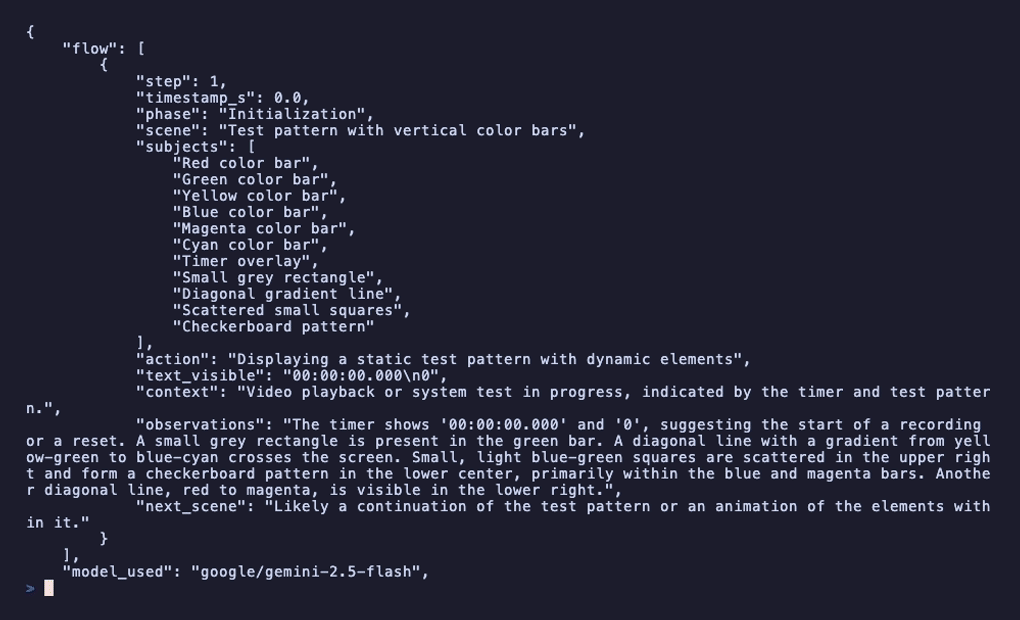
O vidlizer extrai quadros de qualquer vídeo, imagem ou PDF usando ffmpeg, envia-os para um LLM de visão e retorna um array flow — uma entrada por cena. Cada entrada informa o que aconteceu, quem estava na tela, qual texto estava visível e o que mudou. Se o vídeo tiver áudio, ele transcreve com Apple MLX Whisper e mescla a fala em cada etapa.
Funciona totalmente local via Ollama ou qualquer servidor compatível com OpenAI (LM Studio, vLLM, oMLX) — sem chave de API, sem dados saindo da sua máquina. Ou conecte OpenRouter para modelos em nuvem. vidlizer setup detecta o que você tem instalado e escreve sua configuração em menos de um minuto.
vidlizer demo.mp4
vidlizer "https://youtube.com/watch?v=..."
vidlizer screenshot.png
vidlizer document.pdf
✨ Recursos
- Qualquer entrada — vídeo local, imagem (jpg/png/webp/…), PDF ou URL (YouTube, Loom, Vimeo, Twitter)
- 4 provedores — Ollama (totalmente offline), LM Studio (porta 1234), oMLX (Apple Silicon, porta 8000), OpenRouter (nuvem) — detectados automaticamente nessa ordem
- Fallback entre provedores — modelo primário falha → alterna automaticamente de provedor (ex.: oMLX → OpenRouter)
- Reparo de JSON — saída malformada do modelo é reenviada ao modelo para correção antes de pular; recupera de JSON parcial
- Proteção de modelos gratuitos —
:freemodelos OpenRouter forçam automaticamenteconcurrency=1para permanecer dentro dos limites de taxa - 3 formatos de saída —
--format json(padrão),summary(texto simples por fase),markdown(documento com etapa por seção) - Rastreamento de uso —
--statsmostra detalhamento de tokens + custo por modelo em todas as execuções; ferramenta MCPget_usage_stats() - Transcrição automática — detecta áudio, transcreve com Apple MLX Whisper (Neural Engine), mescla a fala em cada etapa do fluxo
- Dedup perceptual — remove quadros quase duplicados antes do envio (economiza tokens)
- analyze_moment — sinalizadores
--start/--endpara focar em um intervalo de tempo - Cache em memória — execuções repetidas no mesmo arquivo pulam a chamada de API
- Proteção de custo — aborta se o gasto exceder
MAX_COST_USD(padrão $1,00) - Progresso ao vivo — indicador de streaming Rich mostra tempo decorrido e contagem de tokens por lote
- Servidor MCP — use no Claude Code, Cursor, Claude Desktop; provedor/modelo bloqueados via variáveis de ambiente; resultado inclui
model_used+provider_used - Instalação automática —
ffmpegausente é instalado via brew;mlx-whisperincluído na instalação padrão (macOS) doctor --fix— assistente interativo de reparo: instala ffmpeg/Ollama/LM Studio ausentes via Homebrew, reexecutavidlizer setuppara.env, atualiza mlx-whispermcp-setup— assistente de configuração MCP em um comando: detectavidlizer-mcp, lê.env, escreve a configuração do editor ou mostra um one-linerclaude mcp add-json- Nativo para Mac — diálogo de seleção de arquivo, transcrição Apple MLX, lida com nomes de arquivo Unicode do macOS (ex.: "11:26 AM")
📦 Requisitos
- macOS (Apple Silicon recomendado para velocidade de transcrição)
- Python 3.10+
- Modo Ollama: Ollama instalado + um modelo de visão baixado (5 GB+ de RAM)
- Modo LM Studio: LM Studio 0.3.16+ com um modelo de visão carregado
- Modo nuvem: Uma chave de API OpenRouter
ffmpeg é instalado automaticamente via Homebrew na primeira execução se estiver ausente.
🚀 Instalação
Opção 1 — uvx (sem instalação, execute diretamente)
uvx vidlizer setup
Opção 2 — pipx (isolado, disponível globalmente)
pipx install vidlizer
vidlizer setup    # interactive wizard: detects providers, writes .env
Opção 3 — pip / virtualenv
pip install vidlizer
vidlizer setup
Opção 4 — a partir do código-fonte
git clone https://github.com/arizawan/vidlizer.git
cd vidlizer
python -m venv .venv && source .venv/bin/activate
pip install -e .
vidlizer setup    # or: cp env.sample .env
Assistente de primeira execução
vidlizer setup detecta todos os provedores instalados, permite escolher primário + fallback e escreve um .env para você. Também oferece baixar um modelo de visão para Ollama se nenhum estiver instalado.
$ vidlizer setup
  Detected providers:
    1.  Ollama        → qwen2.5vl:3b
    2.  OpenRouter    → google/gemma-3-27b-it:free

  Primary provider (1–2): 1
  Fallback (1–1, Enter to skip): 2

✓  .env written → /your/project/.env
Verificação de saúde
vidlizer doctor          # shows ffmpeg, .env, provider, mlx-whisper status
vidlizer doctor --fix    # interactive repair: brew-installs ffmpeg/Ollama/LM Studio, re-runs setup
Configuração manual do provedor
Ollama (totalmente offline, sem chave de API):
# Install Ollama from https://ollama.com, then:
ollama pull qwen2.5vl:3b   # ~3.2 GB, requires 5 GB+ RAM (recommended)
ollama pull qwen2.5vl:7b   # ~6.0 GB, requires 10 GB+ RAM (best quality)
LM Studio (inferência local acelerada por GPU):
# In LM Studio: load a vision model (e.g. Qwen2.5-VL 7B), enable the local server
# Set PROVIDER=openai and OPENAI_BASE_URL=http://localhost:1234/v1 in .env
OpenRouter (nuvem):
# Paste your OpenRouter key in .env:
# OPENROUTER_API_KEY=sk-or-v1-...
⚡ Início rápido
# Ollama — fully local, no API key
vidlizer demo.mp4 --provider ollama --model qwen2.5vl:3b

# LM Studio (or any OpenAI-compat server)
vidlizer demo.mp4 --provider openai --model qwen/qwen2.5-vl-7b-instruct

# OpenRouter (cloud)
vidlizer demo.mp4 --provider openrouter --model google/gemini-2.5-flash

# Analyze a YouTube video
vidlizer "https://www.youtube.com/watch?v=dQw4w9WgXcQ"

# Analyze a single image or PDF
vidlizer screenshot.png
vidlizer report.pdf

# Focus on a time range
vidlizer demo.mp4 --start 30 --end 90

# Output as Markdown or plain-text summary
vidlizer demo.mp4 --format markdown -o result.md
vidlizer demo.mp4 --format summary -o result.txt
Execute sem argumentos para um seletor interativo de arquivo + seletor de provedor/modelo.
📄 Saída
Três formatos via --format:
| Formato | Flag | Extensão padrão | Descrição |
|---|---|---|---|
| JSON | --format json | .analysis.json | Array de fluxo estruturado completo (padrão) |
| Markdown | --format markdown | .analysis.md | Documento com etapa por seção com cena/ação/fala |
| Resumo | --format summary | .analysis.txt | Texto simples agrupado por fase |
O caminho de saída padrão é <normalized-name>.analysis.json (ou extensão correspondente), ou passe -o path.
{
  "flow": [
    {
      "step": 1,
      "timestamp_s": 0.0,
      "phase": "Introduction",
      "scene": "Title card with product logo on dark background.",
      "subjects": ["Logo", "Text overlay"],
      "action": "Static title card displayed.",
      "text_visible": "vidlizer — analyze any video",
      "context": "Opening of a product demo.",
      "observations": "Clean minimal design.",
      "next_scene": "Screen recording of the CLI.",
      "speech": "Welcome to the vidlizer demo."
    }
  ],
  "transcript": [
    { "start": 0.0, "end": 2.4, "text": "Welcome to the vidlizer demo." }
  ],
  "model_used": "gemma-4-E2B-it-MLX-4bit",
  "provider_used": "openai"
}
model_used e provider_used refletem o modelo que realmente produziu o resultado — inclusive após fallback. Exibidos na resposta MCP analyze_video para que agentes saibam qual provedor executou.
Campos das etapas do fluxo
| Campo | Descrição |
|---|---|
step | Inteiro sequencial |
timestamp_s | Tempo aproximado em segundos (do rótulo do quadro) |
phase | Seção lógica — Introdução, Demonstração, Ação, Conclusão… |
scene | O que está visível atualmente |
subjects | Pessoas, objetos, elementos de interface principais presentes |
action | O que está acontecendo — interação, movimento, narração, evento |
text_visible | Todo texto legível na tela |
context | Estado persistente — cronômetro, pontuação, tópico, marca… |
observations | Erros, anomalias, emoções, fatos-chave |
next_scene | Breve descrição do que vem a seguir |
speech | Texto da transcrição falado durante esta etapa (apenas vídeos com áudio) |
🤖 Modelos
Todos os provedores enviam um quadro por requisição (batch_size=1) para máxima compatibilidade com modelos de contexto limitado. Saída em modo de pensamento (tags <think>) é removida automaticamente.
Local — Ollama
Totalmente offline, sem chave de API. Instale com ollama pull <name>:
| Modelo | Disco | RAM | Notas |
|---|---|---|---|
qwen2.5vl:3b ★ | 3,2 GB | ~5 GB | Recomendado — 128K ctx, JSON forte, multi-imagem |
qwen2.5vl:7b ★ | 6,0 GB | ~9 GB | Melhor qualidade Ollama — 128K ctx, precisa de 10+ GB de RAM |
minicpm-v:8b | 5,5 GB | ~8 GB | OCR forte + raciocínio visual, 32K ctx |
llava-onevision:7b | 5,5 GB | ~8 GB | Multi-imagem + quadros de vídeo fortes, JSON confiável |
Ordem de fallback (se o modelo configurado estiver indisponível): qwen2.5vl:7b → qwen2.5vl:3b → minicpm-v:8b → llava-onevision:7b → llava:13b → llava:7b
Usa o /api/chat nativo do Ollama com format: json para saída estruturada confiável.
Local — LM Studio / oMLX / vLLM / LocalAI (compatível com OpenAI)
Inferência acelerada por GPU via qualquer servidor compatível com OpenAI. Defina PROVIDER=openai e aponte OPENAI_BASE_URL para o seu servidor.
| Modelo | VRAM | Notas |
|---|---|---|
qwen/qwen2.5-vl-7b-instruct ★ | ~8 GB | Recomendado — 128K ctx, JSON confiável, multi-imagem |
qwen/qwen3-vl-8b ★ | ~10 GB | Visão Qwen mais recente — tags de pensamento removidas automaticamente |
qwen/qwen2.5-vl-3b-instruct | ~5 GB | Leve — rápido, 5–6 GB de VRAM |
google/gemma-4-e4b-it | ~6 GB | Google MoE — suporte nativo LM Studio 0.3.16+ |
google/gemma-4-9b-it | ~10 GB | Gemma 4 mais forte — 128K ctx, melhor seguimento de instruções |
zai-org/glm-4.6v-flash | ~8 GB | ZhipuAI MoE — 128K ctx, JSON forte, baixa latência |
openbmb/minicpm-v-4.5 | ~8 GB | Baseado em Qwen3 8B — OCR forte, multi-imagem, pronto para vLLM |
oMLX (nativo Apple Silicon, omlx.ai) — modelos em formato MLX do HuggingFace, auto-detectado na porta 8000 (distinto do LM Studio). IDs de modelo são caminhos do HuggingFace:
| Modelo oMLX | RAM unificada | Notas |
|---|---|---|
mlx-community/Qwen2.5-VL-7B-Instruct-8bit ★ | ~8 GB | Melhor escolha Apple Silicon — rápido, JSON forte |
mlx-community/Qwen2.5-VL-3B-Instruct-8bit | ~4 GB | Leve — 4–5 GB de RAM |
mlx-community/Qwen3-VL-8B-8bit | ~9 GB | Visão Qwen mais recente — tags de pensamento removidas |
mlx-community/MiniCPM-V-2_6-8bit | ~8 GB | OCR forte + raciocínio |
Os IDs de modelo são como mostrados no navegador de modelos do LM Studio, no painel administrativo do oMLX ou na sua configuração vLLM. LM Studio / oMLX servem um modelo por vez (sem necessidade de fallback). vLLM com vários modelos carregados usa a mesma sequência de fallback.
Ordem do fragmento de fallback (vLLM / oMLX com vários modelos): qwen2.5-vl-7b → qwen2.5-vl-3b → qwen3-vl → gemma-4 → glm-4 → minicpm-v → llava-onevision → llava
Nuvem — OpenRouter
Modelos buscados ao vivo com preços atuais. Execute vidlizer --list-models para ver a lista ao vivo.
| Modelo | Entrada / 1M tokens | Notas |
|---|---|---|
google/gemini-2.5-flash ★ | $0,15 | Recomendado — 1M ctx, rápido, preciso |
google/gemini-2.5-flash-lite | $0,075 | Mais barato — ligeiramente menos preciso |
google/gemini-2.5-pro | $1,25 | Melhor qualidade, custo maior |
openai/gpt-4o | $2,50 | Principal da OpenAI |
openai/gpt-4o-mini | $0,15 | Opção econômica da OpenAI |
nvidia/nemotron-nano-12b-v2-vl:free | grátis ⚡ | Limitado por taxa (8K/req), 128K ctx |
google/gemma-4-31b-it:free | grátis ⚡ | Limitado por taxa, 128K ctx |
Modelos gratuitos fazem fallback automático para o modelo pago mais barato disponível em caso de falha.
🎙️ Transcrição
Para vídeos com trilha de áudio, o vidlizer automaticamente:
- Extrai um WAV mono de 16kHz com ffmpeg
- Transcreve com Apple MLX Whisper (Neural Engine + GPU em chips M-series)
- Mescla cada segmento de transcrição na etapa de fluxo mais próxima como
speech
mlx-whisper está incluído na instalação padrão no macOS. O modelo base Whisper (~150 MB) é baixado na primeira transcrição.
Para optar por não participar: --no-transcript
🛠️ Referência da CLI
Subcomandos
vidlizer setup              # interactive wizard: detects providers, writes .env
vidlizer doctor             # health check: ffmpeg, .env, providers, mlx-whisper
vidlizer doctor --fix       # auto-repair: brew-installs missing deps, re-runs setup
vidlizer mcp-setup          # generate MCP config for Claude Code / Cursor / Claude Desktop
Opções de análise
vidlizer [video] [options]

positional:
  video                 Path to file or URL (YouTube/Loom/Vimeo/Twitter)

options:
  -o, --output PATH     Output path (default: <name>.analysis.json/.md/.txt)
  --format FORMAT       Output format: json (default), summary, markdown
  --provider PROVIDER   ollama | openai | openrouter  (openai covers LM Studio + oMLX + vLLM)
  --model MODEL         Model slug — Ollama name, OpenAI-compat ID, or OpenRouter slug
  --max-frames N        Max frames to send (default 60, hard cap 200)
  --start SECONDS       Analyze from this timestamp
  --end SECONDS         Analyze up to this timestamp
  --scene THRESHOLD     Scene-change sensitivity 0–1 (default 0.1)
  --min-interval SECS   Minimum seconds between frames (default 2)
  --fps FPS             Extract at fixed FPS instead of scene-change
  --scale PX            Frame width in pixels (default 512)
  --batch-size N        Frames per API call (0 = auto, default 1 for all providers)
  --concurrency N       Parallel batch workers (default: 4 for OpenRouter, 1 for local)
  --dedup-threshold N   Perceptual dedup Hamming distance (default 8, 0 = off)
  --no-transcript       Skip audio transcription
  --max-cost USD        Abort if spend exceeds this (default 1.00)
  --timeout SECS        Per-request timeout (default 600)
  -v, --verbose         Debug output
  --stats               Show token + cost usage stats by model, then exit
  --clear-stats         Reset usage log, then exit
🔧 Variáveis de ambiente
Copie env.sample para .env:
# ── Provider ────────────────────────────────────────────────────────────────
# ollama    — local Ollama server (no API key, no cost)
# openai    — any OpenAI-compatible server (LM Studio, oMLX, vLLM, LocalAI, real OpenAI)
# openrouter — cloud inference via OpenRouter
PROVIDER=ollama

# ── Ollama (local, no API key) ──────────────────────────────────────────────
OLLAMA_HOST=http://localhost:11434
OLLAMA_MODEL=qwen2.5vl:3b

# ── OpenAI-compatible (LM Studio, oMLX, vLLM, LocalAI, real OpenAI) ─────────
#   LM Studio default port: 1234  |  oMLX default port: 8000  |  vLLM: 8000
OPENAI_BASE_URL=http://localhost:1234/v1
OPENAI_API_KEY=lm-studio        # "not-needed" for oMLX/vLLM, real key for OpenAI
OPENAI_MODEL=                   # exact model ID as shown in server (required)

# ── OpenRouter (cloud) ──────────────────────────────────────────────────────
OPENROUTER_API_KEY=sk-or-v1-...
OPENROUTER_MODEL=google/gemini-2.5-flash

# ── Frame extraction ────────────────────────────────────────────────────────
SCENE_THRESHOLD=0.1     # lower = more frames
MIN_INTERVAL=2          # seconds between forced frames
MAX_FRAMES=60
FRAME_WIDTH=512
MAX_COST_USD=1.00
BATCH_SIZE=0            # 0 = auto (defaults to 1 per request for all providers)
REQUEST_TIMEOUT=600

# ── Fallback ────────────────────────────────────────────────────────────────
# Same-provider fallback: set FALLBACK_MODEL only.
#   Blank = auto-detect installed models (Ollama) or available models (OpenAI-compat).
# Cross-provider fallback: set FALLBACK_PROVIDER + FALLBACK_MODEL.
#   FALLBACK_BASE_URL and FALLBACK_API_KEY default to the primary provider's values
#   if not set — override only when the fallback uses a different server/key.
FALLBACK_PROVIDER=      # ollama | openai | openrouter  (blank = same as PROVIDER)
FALLBACK_MODEL=         # model ID for fallback  (blank = auto-detect same-provider)
FALLBACK_BASE_URL=      # base URL for fallback openai/ollama server (optional)
FALLBACK_API_KEY=       # API key for fallback provider (optional)
📊 Rastreamento de uso
Toda execução bem-sucedida anexa um registro a ~/.cache/vidlizer/usage.jsonl. Execuções de teste (pytest) são excluídas.
vidlizer --stats          # print per-model breakdown
vidlizer --clear-stats    # reset log
Exemplo de saída:
Usage statistics  (/Users/you/.cache/vidlizer/usage.jsonl)

  Total runs:       12
  Total tokens in:  58,240
  Total tokens out: 6,102
  Total cost:       ~$0.0312
  Total steps:      94

  Model                               Provider     Runs   Tokens in  Tokens out  Cost USD
  gemma-4-E2B-it-MLX-4bit             openai          9      45,800       4,900      free
  google/gemini-2.5-flash             openrouter       3      12,440       1,202  ~$0.0312
Também disponível como ferramenta MCP: get_usage_stats() → mesmos dados como JSON. clear_usage_stats() redefine o log.
🔌 Servidor MCP
Use o vidlizer de qualquer agente compatível com MCP — Claude Code, Cursor, Claude Desktop, Gemini CLI.
Modelo e provedor são definidos via variáveis de ambiente e não podem ser sobrescritos pelo agente de IA. Isso impede que agentes alternem para modelos inesperados ou caros no meio da sessão.
Instalação
# uvx (no install — run directly)
uvx "vidlizer[mcp]" vidlizer-mcp

# pipx (isolated, globally available)
pipx install "vidlizer[mcp]"

# If vidlizer is already installed via pipx — inject mcp into the same venv
pipx inject vidlizer mcp

# pip / virtualenv
pip install "vidlizer[mcp]"
vidlizer-mcp é adicionado ao seu PATH automaticamente. Verifique com which vidlizer-mcp.
Nota sobre pipx:
pipx install vidlizercria o ponto de entradavidlizer-mcpmas o pacotemcpnão está instalado. Executepipx inject vidlizer mcppara adicioná-lo, ou usepipx install "vidlizer[mcp]"antecipadamente.
Configuração MCP em um comando
vidlizer mcp-setup
Assistente interativo — detecta vidlizer-mcp, lê seu .env e escreve a configuração no arquivo de configuração do seu editor ou mostra um one-liner para copiar e colar. Suporta Claude Code, Cursor, Claude Desktop, Windsurf.
Configuração manual
Início rápido — uvx (sem instalação necessária)
Sem necessidade de pip install ou pipx. O uvx baixa e executa o vidlizer em tempo real:
{
  "mcpServers": {
    "vidlizer": {
      "type": "stdio",
      "command": "uvx",
      "args": ["--from", "vidlizer[mcp]", "vidlizer-mcp"],
      "env": {
        "PROVIDER": "ollama",
        "OLLAMA_HOST": "http://localhost:11434",
        "OLLAMA_MODEL": "gemma4:2b"
      }
    }
  }
}
Troque o bloco env por qualquer provedor (OpenRouter, LM Studio, oMLX) — os command/args permanecem os mesmos.
Use o caminho absoluto para o binário — which vidlizer-mcp fornece isso. Todas as configurações abaixo usam JSON (funciona no Claude Code, Cursor, Claude Desktop, Gemini CLI).
Para Claude Code via CLI:
claude mcp add-json vidlizer '{"type":"stdio","command":"/path/to/vidlizer-mcp","env":{"PROVIDER":"openrouter","OPENROUTER_API_KEY":"sk-or-v1-...","OPENROUTER_MODEL":"google/gemini-2.5-flash"}}'
# Add --scope project for per-project config instead of global
Provedor único — OpenRouter (nuvem)
{
  "mcpServers": {
    "vidlizer": {
      "type": "stdio",
      "command": "/absolute/path/to/.venv/bin/vidlizer-mcp",
      "env": {
        "PROVIDER": "openrouter",
        "OPENROUTER_API_KEY": "sk-or-v1-...",
        "OPENROUTER_MODEL": "google/gemini-2.5-flash"
      }
    }
  }
}
Modelos gratuitos (sufixo
:free) fazem fallback automaticamente para o modelo pago mais barato se houver limite de taxa — sem configuração extra necessária.
Provedor único — Ollama (local, sem chave de API)
{
  "mcpServers": {
    "vidlizer": {
      "type": "stdio",
      "command": "/absolute/path/to/.venv/bin/vidlizer-mcp",
      "env": {
        "PROVIDER": "ollama",
        "OLLAMA_HOST": "http://localhost:11434",
        "OLLAMA_MODEL": "gemma4:2b"
      }
    }
  }
}
FALLBACK_MODELé opcional — omiti-lo detecta automaticamente os modelos instalados e tenta usá-los na ordem preferida.
Provedor único — LM Studio (compatível com OpenAI, porta 1234)
{
  "mcpServers": {
    "vidlizer": {
      "type": "stdio",
      "command": "/absolute/path/to/.venv/bin/vidlizer-mcp",
      "env": {
        "PROVIDER": "openai",
        "OPENAI_BASE_URL": "http://localhost:1234/v1",
        "OPENAI_API_KEY": "lm-studio",
        "OPENAI_MODEL": "qwen/qwen2.5-vl-7b-instruct"
      }
    }
  }
}
Provedor único — oMLX (Apple Silicon, porta 8000)
{
  "mcpServers": {
    "vidlizer": {
      "type": "stdio",
      "command": "/absolute/path/to/.venv/bin/vidlizer-mcp",
      "env": {
        "PROVIDER": "openai",
        "OPENAI_BASE_URL": "http://localhost:8000/v1",
        "OPENAI_API_KEY": "not-needed",
        "OPENAI_MODEL": "mlx-community/Qwen2.5-VL-7B-Instruct-8bit"
      }
    }
  }
}
Fallback entre provedores — oMLX → OpenRouter
O provedor principal roda no oMLX local; se falhar, alterna automaticamente para a nuvem OpenRouter.
{
  "mcpServers": {
    "vidlizer": {
      "type": "stdio",
      "command": "/absolute/path/to/.venv/bin/vidlizer-mcp",
      "env": {
        "PROVIDER": "openai",
        "OPENAI_BASE_URL": "http://localhost:8000/v1",
        "OPENAI_API_KEY": "not-needed",
        "OPENAI_MODEL": "mlx-community/Qwen2.5-VL-7B-Instruct-8bit",
        "FALLBACK_PROVIDER": "openrouter",
        "FALLBACK_MODEL": "google/gemini-2.5-flash",
        "FALLBACK_API_KEY": "sk-or-v1-..."
      }
    }
  }
}
Fallback entre provedores — oMLX → Ollama
Ambos locais; se o oMLX falhar (modelo ausente / servidor fora do ar) → Ollama assume.
{
  "mcpServers": {
    "vidlizer": {
      "type": "stdio",
      "command": "/absolute/path/to/.venv/bin/vidlizer-mcp",
      "env": {
        "PROVIDER": "openai",
        "OPENAI_BASE_URL": "http://localhost:8000/v1",
        "OPENAI_API_KEY": "not-needed",
        "OPENAI_MODEL": "mlx-community/Qwen2.5-VL-7B-Instruct-8bit",
        "FALLBACK_PROVIDER": "ollama",
        "FALLBACK_MODEL": "qwen2.5vl:7b"
      }
    }
  }
}
FALLBACK_BASE_URLtem como padrãoOLLAMA_HOST(ouhttp://localhost:11434) — defina-o apenas se o Ollama estiver em um host não padrão.
Fallback entre provedores — Ollama → OpenRouter
Prioridade local; a nuvem entra em ação se nenhum modelo estiver instalado ou se a inferência falhar.
{
  "mcpServers": {
    "vidlizer": {
      "type": "stdio",
      "command": "/absolute/path/to/.venv/bin/vidlizer-mcp",
      "env": {
        "PROVIDER": "ollama",
        "OLLAMA_HOST": "http://localhost:11434",
        "OLLAMA_MODEL": "qwen2.5vl:7b",
        "FALLBACK_PROVIDER": "openrouter",
        "FALLBACK_MODEL": "google/gemini-2.5-flash",
        "FALLBACK_API_KEY": "sk-or-v1-..."
      }
    }
  }
}
Fallback no mesmo provedor — fixar modelo de fallback explícito
Quando a detecção automática não é desejada; ambos os modelos usam o mesmo provedor.
{
  "mcpServers": {
    "vidlizer": {
      "type": "stdio",
      "command": "/absolute/path/to/.venv/bin/vidlizer-mcp",
      "env": {
        "PROVIDER": "ollama",
        "OLLAMA_MODEL": "qwen2.5vl:7b",
        "FALLBACK_MODEL": "qwen2.5vl:3b"
      }
    }
  }
}
Referência de variáveis de ambiente para fallback:
| Variável | Finalidade | Padrão |
|---|---|---|
FALLBACK_PROVIDER | Provedor para fallback (ollama/openai/openrouter) | igual a PROVIDER |
FALLBACK_MODEL | ID do modelo para fallback | detecção automática (mesmo provedor) |
FALLBACK_BASE_URL | URL base para servidor de fallback openai/ollama | OPENAI_BASE_URL ou OLLAMA_HOST |
FALLBACK_API_KEY | Chave de API para o provedor de fallback | OPENAI_API_KEY ou OPENROUTER_API_KEY |
Logs
Toda a atividade (extração de quadros, chamadas de API, erros) é gravada em:
tail -f ~/.cache/vidlizer/mcp.log
Ferramentas
| Ferramenta | Retorna | Tokens de saída |
|---|---|---|
analyze_video(path, **opts) | analysis_id + metadados | ~100 |
list_analyses() | todas as análises armazenadas (apenas metadados) | ~50/entrada |
get_summary(id, level) | resumo de texto breve/médio/completo | ~200–2K |
get_step(id, step) | etapa única do fluxo | ~150 |
get_steps(id, start, end) | intervalo de etapas | escalado |
get_phase(id, phase) | todas as etapas na fase nomeada | escalado |
search_analysis(id, query) | etapas correspondentes ao texto (query ou keyword) | apenas correspondências |
get_transcript(id, start_s, end_s) | trecho da transcrição | escalado |
get_full_analysis(id) | fluxo completo + transcrição | completo |
delete_analysis(id) | confirmação | ~10 |
get_usage_stats() | detalhamento de tokens e custo por modelo | ~50/modelo |
clear_usage_stats() | redefinir registro de uso | ~10 |
Fluxo de trabalho eficiente em tokens
analyze_video armazena o resultado completo em disco e retorna apenas analysis_id + metadados (~100 tokens). O LLM busca partes específicas sob demanda — um vídeo de 60 etapas custa ~100 tokens para registrar, mas carrega apenas o necessário por consulta.
agent: analyze_video("demo.mp4")
→ { "analysis_id": "abc123", "step_count": 42, "phases": ["Intro", "Demo", "Outro"] }

agent: get_summary("abc123", level="brief")
→ "Intro: Title card displayed | Demo: CLI recording | Outro: Results shown"

agent: get_phase("abc123", "Demo")
→ [ { step, timestamp_s, action, scene }, … ]

agent: search_analysis("abc123", "error")
→ [ { step: 17, matched_field: "observations", matched_value: "Stack trace visible" } ]
Recursos MCP
| URI | Conteúdo |
|---|---|
vidlizer://analyses | Todas as análises (JSON de metadados) |
vidlizer://analyses/{id} | JSON completo da análise |
vidlizer://analyses/{id}/summary | Resumo de texto médio |
🧪 Testes
Suíte de testes totalmente automatizada — 248 testes de unidade + integração, 3 testes e2e.
make install-dev    # installs pytest, pytest-html, pytest-mock
make test           # runs unit + integration (no network) → reports/test-report.html
make test-e2e       # also runs YouTube download + full pipeline e2e
make smoke          # real-provider smoke test against all detected providers
Relatório de unidade/integração: reports/test-report.html. Os testes cobrem:
- Extração de quadros (ffmpeg), deduplicação perceptual, TTL de cache
- Detecção de áudio, mesclagem de transcrição (sem duplicatas)
- PDF → quadros, codificação de imagem, detecção de URL
- Formatador de saída: correção de json/resumo/markdown
- Pipeline completo com OpenRouter simulado (servidor HTTP falso)
- Camada HTTP: parsing de SSE, tratamento de 429, limite de custo, streaming Ollama
- Lote: nova tentativa de reparo JSON, proteção de concorrência para modelos gratuitos
- Modelos: consulta de preços, sequências de fallback, auxiliares de formato
- Rastreamento de uso: ciclo de vida de registro/estatísticas/limpeza
- Invocações reais de subprocessos CLI com mídia real
- Download real do YouTube + análise completa (opt-in
-m e2e)
Teste de fumaça
make smoke executa o pipeline completo com provedores reais contra cada provedor detectado em ordem (Ollama → LM Studio → oMLX → OpenRouter). Antes de os testes começarem, ele solicita interativamente para cada provedor local:
- Modelo de visão encontrado →
"Test ollama with qwen2.5vl:3b? [Y/n]" - Sem modelo de visão (Ollama) →
"Download qwen2.5vl:3b (~2.3 GB)? [y/N]" - Sem modelo de visão (LM Studio/oMLX) → instruções para carregar um + prompt de nova tentativa
Cada provedor é testado isoladamente com seu próprio diretório de saída (evita contaminação de cache). Modelos locais são descarregados da VRAM após os testes de cada provedor. Os resultados ficam em reports/smoke-TIMESTAMP.html com placares de aprovação/reprovação por provedor.
make smoke                                  # auto-detect all providers
make smoke ARGS="--provider ollama"         # force single provider
make smoke ARGS="--provider openrouter"     # OpenRouter only (no local needed)
🤝 Contribuições
Contribuições são bem-vindas! Veja CONTRIBUTING.md para configuração, estilo de código e diretrizes de PR.
- Relatório de bug: abra uma issue — inclua provedor, modelo, versão do macOS, erro completo
- Solicitação de recurso: abra uma issue descrevendo o caso de uso
- PR: crie uma branch a partir de
main, adicione testes,make testpassa,ruff check vidlizer/limpo
❤️ Suporte
vidlizer é gratuito e de código aberto. Se ele economizar seu tempo:

📝 Licença
MIT — veja LICENSE.