mathlas
Matemática hermética para agentes de IA: busca de 3,7 milhões de teoremas, identificação de constantes PSLQ, OEIS, verificações reais do kernel Lean 4. Sem LLM interno, sem chave de API.
Documentação
mathlas


Disponível em mcp.so · Glama · listado em awesome-mcp-servers e best-of-lean4.
Uma ferramenta matemática à prova de falhas que uma IA usa — sem LLM, sem chave de API, gratuita. Conecte-a ao Claude Code, Cursor ou qualquer cliente MCP. A IA é o cérebro; mathlas é o braço — ela dá à IA as capacidades que faltam e retorna dados (candidatos, veredictos, listas de verificação, esqueletos) para a IA raciocinar. Apache-2.0. O código é livre para qualquer uso; artefatos publicados de corpus/índice possuem seus próprios termos por fonte (CC-BY/CC0).
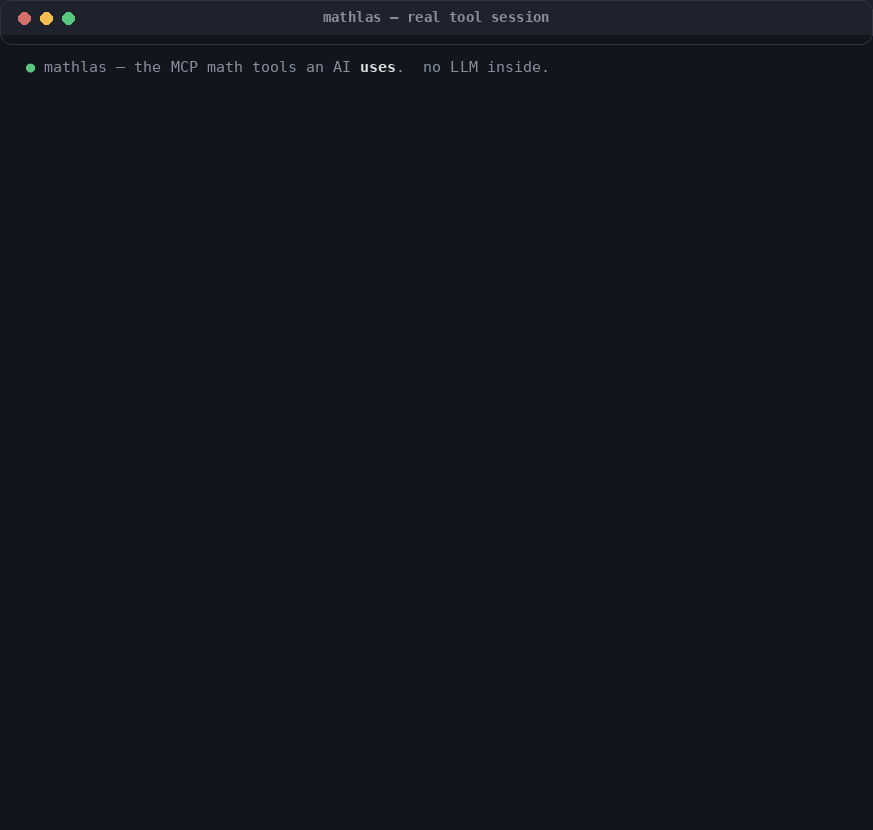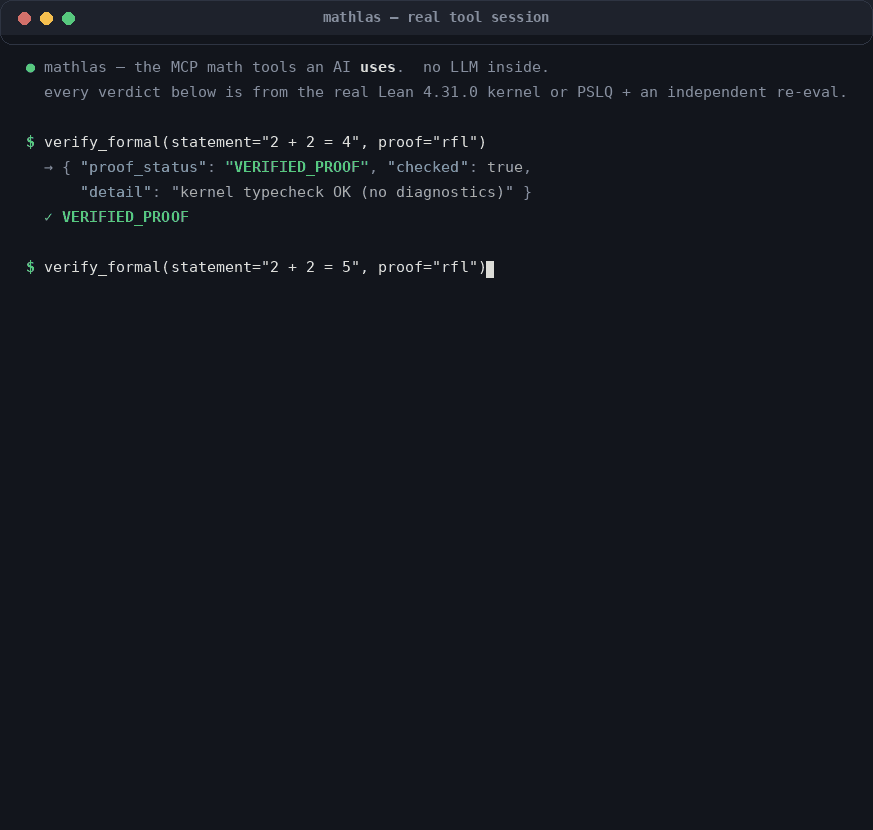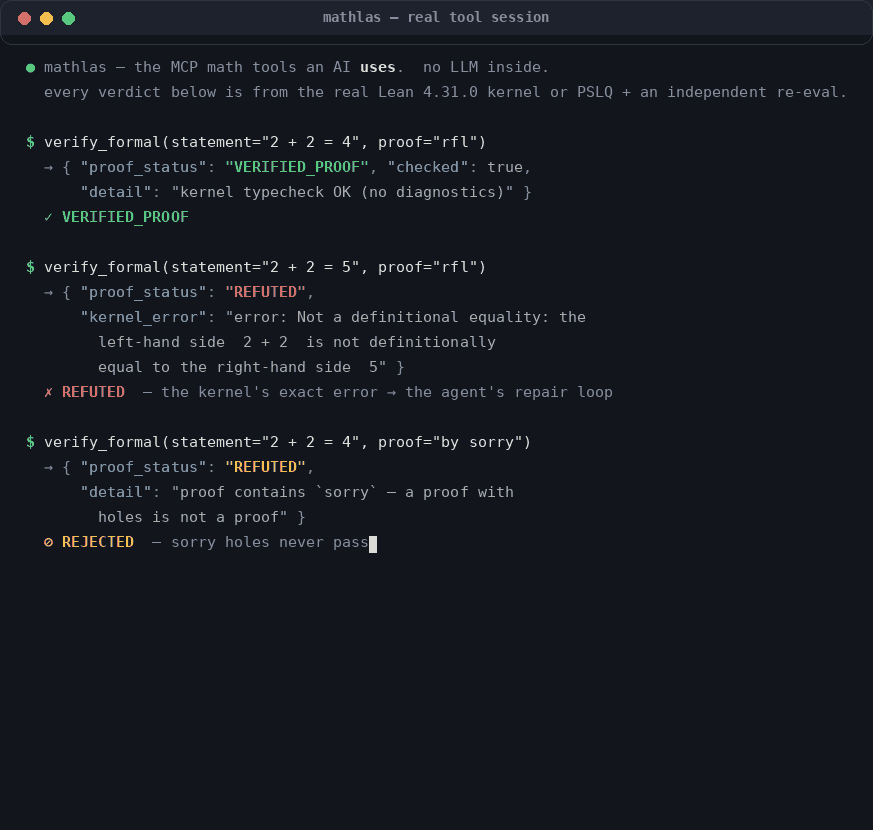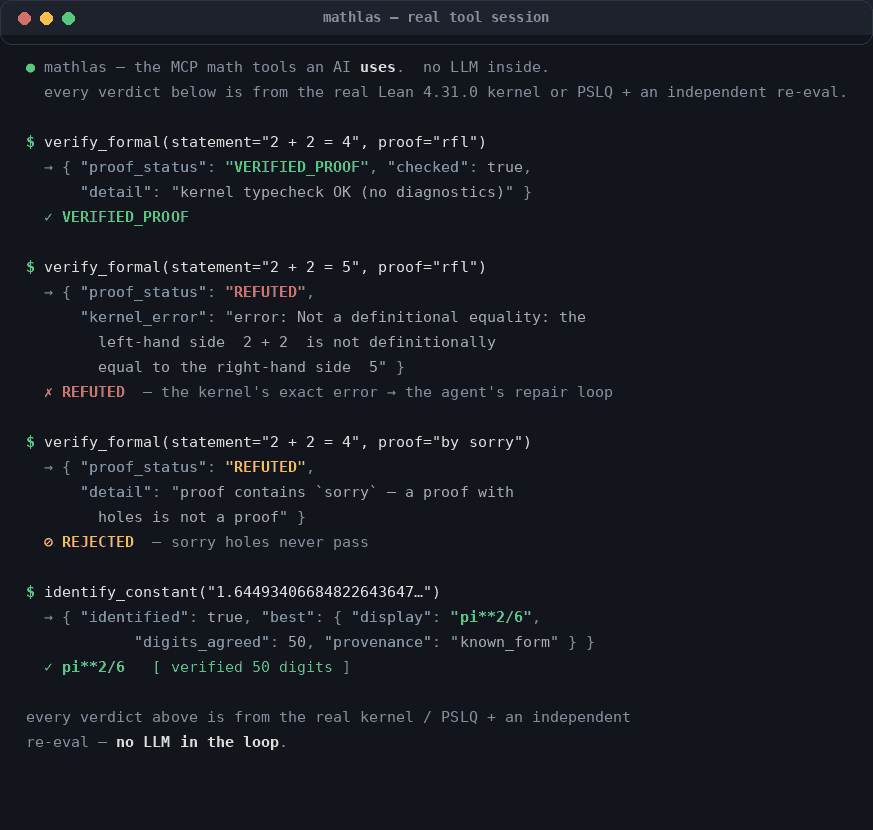
Cada veredicto vem do kernel real do Lean 4.31.0 / PSLQ + uma reavaliação independente — sem LLM interno. Saídas reais de ferramentas em processo, capturadas por assets/gen/capture_outputs.py.
Isso é para você?
- Você usa Claude Code / Cursor e quer que sua IA pare de alucinar matemática —
search_existing_mathencontra o teorema real em um índice de 3,68M de documentos;verify_numericeverify_formalverificam afirmações com risco zero de alucinação. - Você tem uma constante numérica ou sequência inteira que não consegue identificar —
identify_constantexecuta PSLQ + correspondência de forma fechada (precisão de 50 dígitos);identify_sequencefaz uma correspondência exata de termos no OEIS. - Você precisa do nome formal (Lean/mathlib) de um resultado —
search_formal_mathfaz proxy dos serviços públicos Loogle e LeanSearch e retorna nomes de declarações + tipos, com rótulo de proveniência. - Você está construindo um pipeline de agentes que precisa de matemática à prova de falhas no loop — todas as 12 ferramentas são ferramentas MCP puras que retornam dados, sem LLM interno, compostas com qualquer framework.
Instalação e registro com Claude Code (sem chave de API)
Uma linha, nada para instalar antes (precisa de uv):
claude mcp add mathlas -- uvx mathlas-mcp
uvx mathlas-mcp busca + executa o servidor em um ambiente isolado no primeiro uso. Prefere pip?
pip install mathlas-mcp              # core: numeric + retrieval + verify + scaffolds
pip install 'mathlas-mcp[mcp]'       # + official MCP SDK
pip install 'mathlas-mcp[retrieve]'  # + pyarrow, to read the real index
pip install 'mathlas-mcp[embed]'     # + sentence-transformers/torch, for the Qwen3 embedder

claude mcp add mathlas -- python -m mathlas.server
mathlas agora aparece como doze ferramentas que o agente pode chamar. O servidor prefere o SDK oficial mcp e recorre a um servidor JSON-RPC stdio sem dependências se mcp não estiver instalado — ele sempre executa. (Cursor / qualquer cliente MCP: aponte-o para o mesmo comando stdio uvx mathlas-mcp ou python -m mathlas.server.)
Dados locais opcionais (degradação honesta):
identify_sequencequer uma cópia local do OEIS;verify_formalquer um toolchain Lean. Sem eles, as ferramentas retornam um claro "dados/toolchain não disponíveis" — nunca uma resposta falsa. Vejadocs/methods.mdpara a configuração de uma linha de cada um.
Um exemplo prático — uma IA usando as ferramentas
User:  "Does x = cos(x) have a unique solution I can reach by iterating?"

AI →   search_existing_math("contraction mapping unique fixed point complete metric space")
       ← [{name:"Banach Fixed-Point Theorem", statement:"Let (X,d) be a complete metric
            space and T a contraction. Then T has a unique fixed point ...", ...}, ...]
AI →   applicability_checklist(banach.statement)
       ← preconditions: ["(X,d) is a complete metric space", "T: X→X is a contraction"]
          conclusion:    "T has a unique fixed point"
AI  (reasons): [0,1] is complete; cos is a contraction there (|cos'|=|sin|≤sin 1<1).
       Every precondition holds ⇒ Banach applies ⇒ unique fixed point, reachable by iteration.
AI →   verify_numeric("0.7390851332151607", "<the Dottie-number closed form, if claimed>")
mathlas forneceu a busca, a lista de verificação e a verificação numérica à prova de falhas. A IA fez o julgamento. Nenhum LLM foi chamado dentro do mathlas.
Resultados
A disciplina é à prova de falhas ou nada: um resultado é um fato verificável de forma independente ou um honesto "nada." A taxa de falsos positivos é 0 em todos os níveis (tabelas completas + comandos em RESULTS.md):
| Nível | Recuperação@conhecidos | Falso-positivo | Por que é à prova de falhas | Benchmark |
|---|---|---|---|---|
Numérico (identify_constant) | 8/8 | 0/3 | reavaliação independente de alta precisão (50–51 dígitos) | benchmarks/numeric_bench.py |
Sequência (identify_sequence) | 8/8 (7 top-1) | 0/3 | correspondência exata de termos vs OEIS local (~400k sequências) | benchmarks/tier_bench.py |
Formal (verify_formal) | 7/7 veredictos | — | verificação de tipos no kernel real do Lean 4.31.0 | benchmarks/tier_bench.py |
Ramanujan (conjecture_relation) | 6/6 | 0/2 | PSLQ + CF, cada acerto reverificado ≥25 dígitos | benchmarks/tier_bench.py |
| Fosso de aplicabilidade | 15/15 decomposição + 6/6 captura | — | pré-condições atômicas, armadilhas de uso incorreto | benchmarks/moat_bench.py |
| FunSearch + web-aug | 14/14 | — | contenção em sandbox (rede / timeout / memória) | benchmarks/tools_bench.py |
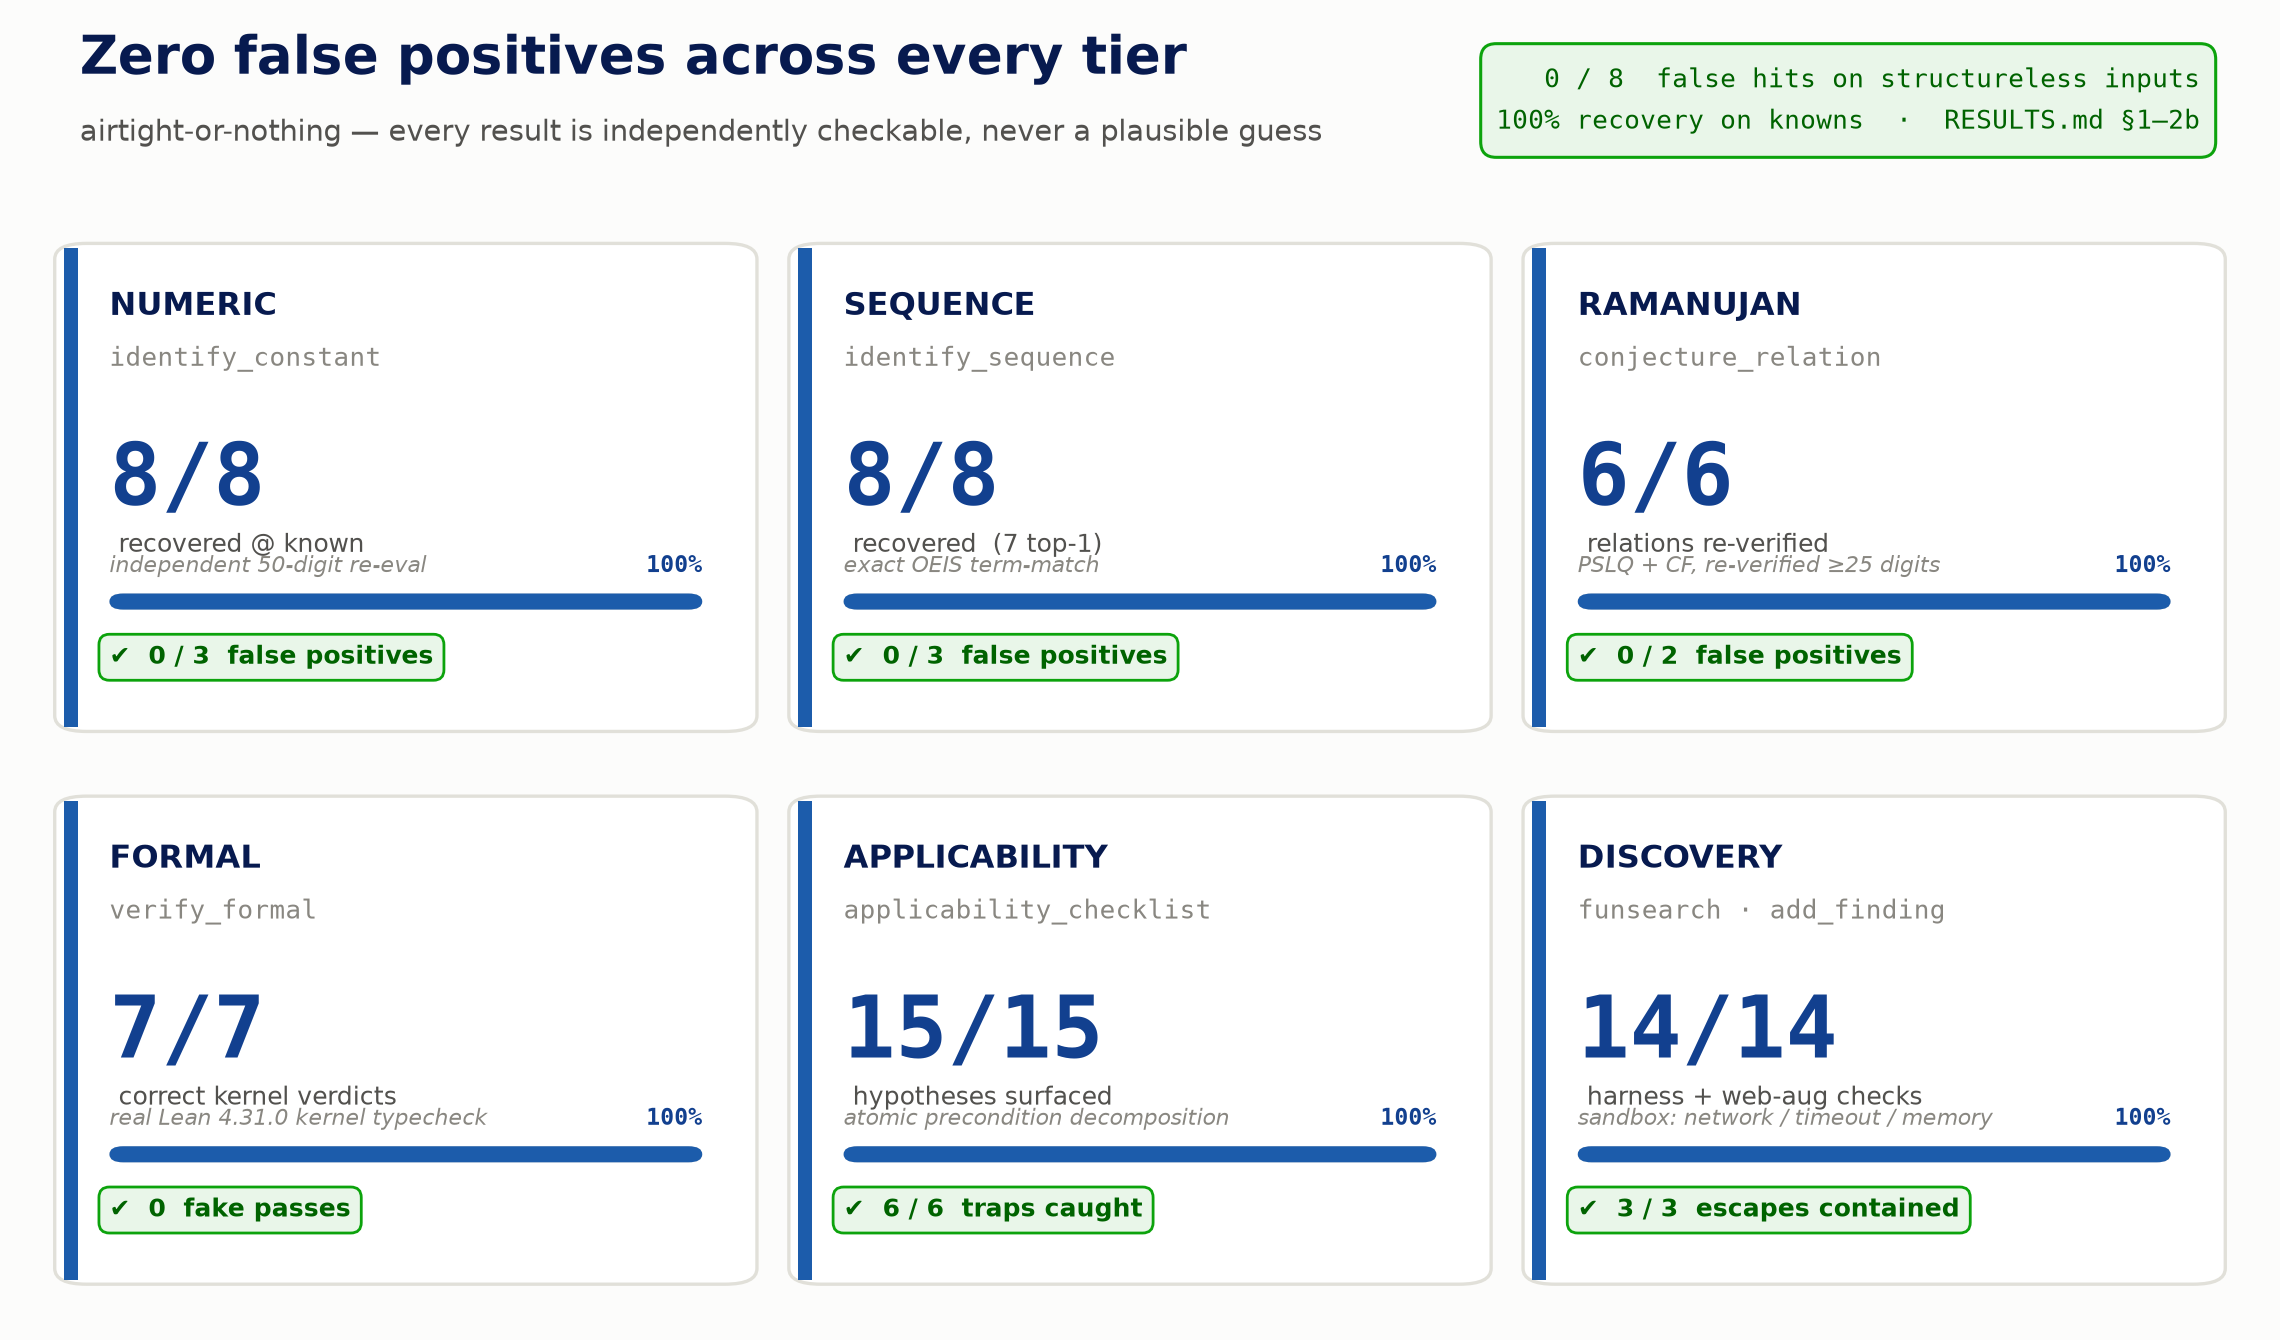
A tabela acima, de relance — 0 falsos positivos em todos os níveis (0/8 entradas sem estrutura produziram um acerto falso), 100% de recuperação em conhecidos. Números: RESULTS.md §1–2b.
Agente no loop, relatado honestamente (2026-06-10, Claude Fable 5): o mesmo agente sem cabeça recebeu 18 tarefas matemáticas COM o servidor MCP mathlas ao vivo como sua única ferramenta vs SEM quaisquer ferramentas, marcando 18/18 vs 15/18. O conjunto original de 10 tarefas está saturado (10/10 em ambos os casos: um modelo de fronteira passa apenas com conhecimento paramétrico, e dizemos isso claramente), então um conjunto difícil de 8 tarefas foi adicionado onde a verificação, não a recuperação, é o gargalo: esse conjunto vai 8/8 COM vs 5/8 SEM. O modelo puro expira em detecção de relação de inteiros de 50 dígitos (PSLQ) e não consegue nomear sequências OEIS obscuras que sombreiam prefixos de Catalan/Fibonacci e só divergem em profundidade. Os acertos que o modelo puro conquista são notáveis e os relatamos: ele avaliou uma relação de constante de 6 termos até 45 dígitos manualmente (resíduo 1.475e-27, correto), simulou arredondamento IEEE-754 bit a bit em sua cabeça (com um expoente errado em prosa), e provou uma fórmula tipo Machin exatamente via inteiros gaussianos, tudo em contexto com 3-9x a latência de uma chamada de ferramenta. Cada verdade fundamental é uma computação determinística registrada no benchmark; tabela completa e proveniência: RESULTS.md §2c. Execução: benchmarks/agent_bench.py.
O índice de 3,68M de documentos. search_existing_math é servido a partir de um índice denso de 3.683.428 documentos (Qwen3-Embedding-8B, 4096-d): o subconjunto 1,34M permissivo CC-BY/CC0 TheoremSearch + 2,34M documentos arXiv-math com slogans incorporados do Dolma, denso + Okapi-BM25 + RRF. Recuperação honesta de destaque na escala completa de 3,68M: R@1 0,614 / R@10 0,832 consultando pelo corpo bruto de um documento contra sua entrada com slogan incorporado — o regime difícil de auto-recuperação entre representações. (Na construção anterior de 1,635M, a auto-recuperação mais fácil de slogan→slogan na mesma representação era R@1 0,977 / R@10 0,998 em sua divisão retida de 81.833 documentos.)
Corpus aberto no Hugging Face. O lado de texto + metadados desse índice é publicado em kattri15/mathlas-corpus: 3.683.428 documentos em nível de teorema mais a pequena configuração findings, divididos em configurações theoremsearch, dolma e findings. Inclui slogans, declarações LaTeX, URLs de origem, títulos, rótulos, categorias, contagens de citações quando conhecidas e chaves de proveniência. Não inclui as matrizes de incorporação de 30 GB ou fatias locais de benchmark. Licenças são por configuração: subconjunto TheoremSearch CC BY-SA 4.0, declarações Dolma ODC-BY 1.0 com nossos slogans CC BY 4.0, e descobertas CC BY 4.0. Auditoria completa: docs/HF_DATASET_LICENSING.md.
from datasets import load_dataset

ts = load_dataset("kattri15/mathlas-corpus", "theoremsearch", split="train")
dolma = load_dataset("kattri15/mathlas-corpus", "dolma", split="train")
Nível laptop quantizado (opt-in). A matriz fp16 tem 30 GB em disco (~60 GB fp32 residentes) — ok na máquina de build, não em um laptop. MATHLAS_QUANTIZED=binary (ou quantized="binary" em HybridRetriever.from_index) serve o MESMO índice a partir de sidecars quantizados com memmap: Hamming de bit de sinal sobre 1,9 GB seleciona 1000 candidatos, reclassificação exata escolhe o top-k — medido no índice completo de 3,68M com o mesmo protocolo n=3000 do destaque, é sem perda de recuperação (R@1 0,6143 vs 0,6140 fp16, R@10 igual em 0,8323; modo int8: R@1 0,6147, 15 GB) a 2,4 s/consulta em 4 threads de CPU. Advertência honesta: isso encolhe apenas o lado do documento — consultas ainda devem ser incorporadas pelo mesmo Qwen3-Embedding-8B (um pequeno codificador de 0,6B vive em um espaço vetorial diferente). O verdadeiro nível ponta-a-ponta de codificador pequeno é o nível 0,6B abaixo. Números, comando de build e a advertência completa: docs/QUANTIZED_TIER.md.
Nível laptop ponta-a-ponta 0,6B (opt-in). O MESMO corpus de 3.683.428 documentos re-incorporado uma vez com Qwen3-Embedding-0.6B (1024-d, alinhado por linha com os metadados servidos), então o codificador de consulta em si roda em CPU de laptop: MATHLAS_ENCODER=0.6b (compõe com MATHLAS_QUANTIZED=binary). Medido com o protocolo idêntico n=3000 entre representações, consultas re-codificadas pelo modelo 0,6B: R@1 0,545 / R@10 0,745 (binário + reclassificação int8; a varredura exata fp16 0,6B é 0,544 / 0,745, então a quantização é novamente sem perda dentro do nível). O preço honesto vs o nível 8B (0,614 / 0,832) é cerca de 7-9pp de recuperação; a configuração dual-channel 8B (0,965 / 0,999) permanece o teto de qualidade da caixa grande. O destaque do laptop: ponta-a-ponta 0,67 s/consulta em 4 threads de CPU (0,88 s em 2), codificação de consulta incluída, sobre todos os 3,68M de documentos. Pegada do canal denso: sidecar binário 0,47 GB + codificador 0,6B ~1,2 GB (~1,7 GB; fonte de reclassificação int8 recomendada 3,77 GB; índice irmão fp16 completo 7,54 GB). No probe somente corpus TheoremSearch-110, o nível marca Hit@20 8,2% / 10,0% teorema/artigo vs o nível 8B de 10,0% / 11,8% (ambos pisos limitados por licenciamento). Tabelas completas, pegadas e advertências: docs/QUANTIZED_TIER.md; build: scripts/build_06b_index.py; avaliação: scripts/eval_06b_tier.py.
Recuperação dual-channel (opt-in). O destaque 0,614 é uma lacuna entre representações: consultas em forma de declaração LaTeX pesquisadas contra documentos com slogans incorporados. Um segundo canal denso incorpora os mesmos 3.683.428 documentos por sua declaração LaTeX limpa (Qwen3-Embedding-8B, alinhado por linha, construído por scripts/build_statement_channel.py) e se dobra na classificação densa por max-sim por documento. Medido na mesma amostra n=3000 na escala completa do corpus: R@1 0,614 para 0,965, R@10 0,832 para 0,999. Advertências honestas: essa avaliação é um proxy de auto-recuperação no qual o canal de declaração indexa exatamente o texto do qual as consultas são extraídas (uma vantagem de texto exato, como o BM25); no benchmark de 110 consultas humanas sem vazamento, o ganho é real mas parcial (Hit@20 de artigo 11,8% para 12,7%). E a segunda matriz aproximadamente dobra a RAM de serviço (medida na escala completa: pico de processo de 150 GB para o servidor dual vs ~95 GB canal único; ~2,75 s/consulta de varredura densa dual em 2 threads de CPU), então ela é estritamente opt-in (MATHLAS_STATEMENT_INDEX=/path/index_full_statement.npz, nunca auto-detectada) e não é combinável com o nível quantizado. Números completos e a tabela de níveis de serviço: docs/RETRIEVAL_UPGRADE_NOTES.md. O padrão híbrido de produção rrf_k é 10 (medido como melhor em cada k testado), mais um blend de reclassificação cross-encoder opt-in (MATHLAS_RERANK=1, Qwen3-Reranker-0.6B, +1,7pp de ganho honesto em R@1). O backend de reclassificação é selecionável com MATHLAS_RERANK_MODEL: qwen3 (padrão, Qwen3-Reranker-0.6B, inalterado) ou jina-v3 (jinaai/jina-reranker-v3, arXiv:2509.25085 — um reclassificador 0,6B "último mas não tardio" que lidera BEIR na escala 0,6B). Ambos carregam pesos preguiçosamente no primeiro uso e recorrem à fusão sem reclassificação (nota honesta em stderr) se torch/transformers ou os pesos estiverem ausentes; um nome de modelo com erro de digitação gera erro em vez de servir silenciosamente o reclassificador errado. Entregamos a fiação, não um número de benchmark jina — traga seus próprios pesos.
O loop auto-aumentador — vencendo o TheoremSearch
Nas próprias 110 consultas escritas por humanos do TheoremSearch, o mathlas de linha de base atinge um piso de cobertura — o TheoremSearch reteve 85% de seu corpus privado de 9,2M, então 95 artigos-alvo são inalcançáveis para qualquer sistema aberto. A IA então executa o loop: para cada teorema ausente, ela encontra a declaração real na web, a incorpora com o mesmo Qwen3-Embedding-8B, e add_finding(dense_vec=…) a funde através do canal denso em tempo de execução (re-medido em 2026-06-10 no índice servido de 3,68M — o destaque pós-loop reproduzido exatamente; a linha de base somente corpus caiu 13,6% → 11,8% em nível de artigo devido aos distratores Dolma adicionados, relatado como está):
| Método | Teorema Hit@20 | Paper Hit@20 |
|---|---|---|
Google (site:arxiv.org) | — | 37,8% |
| ChatGPT 5.2 com Busca | 19,8% | — |
| Gemini 3 Pro | 27,0% | — |
| TheoremSearch (Qwen3-8B, corpus privado completo de 9,2M) | 45,0% | 56,8% |
| mathlas — linha de base (somente corpus) | 10,0% | 11,8% |
| mathlas — após loop web de auto-aumento | 59,1% (65/110) | 70,0% (77/110) |
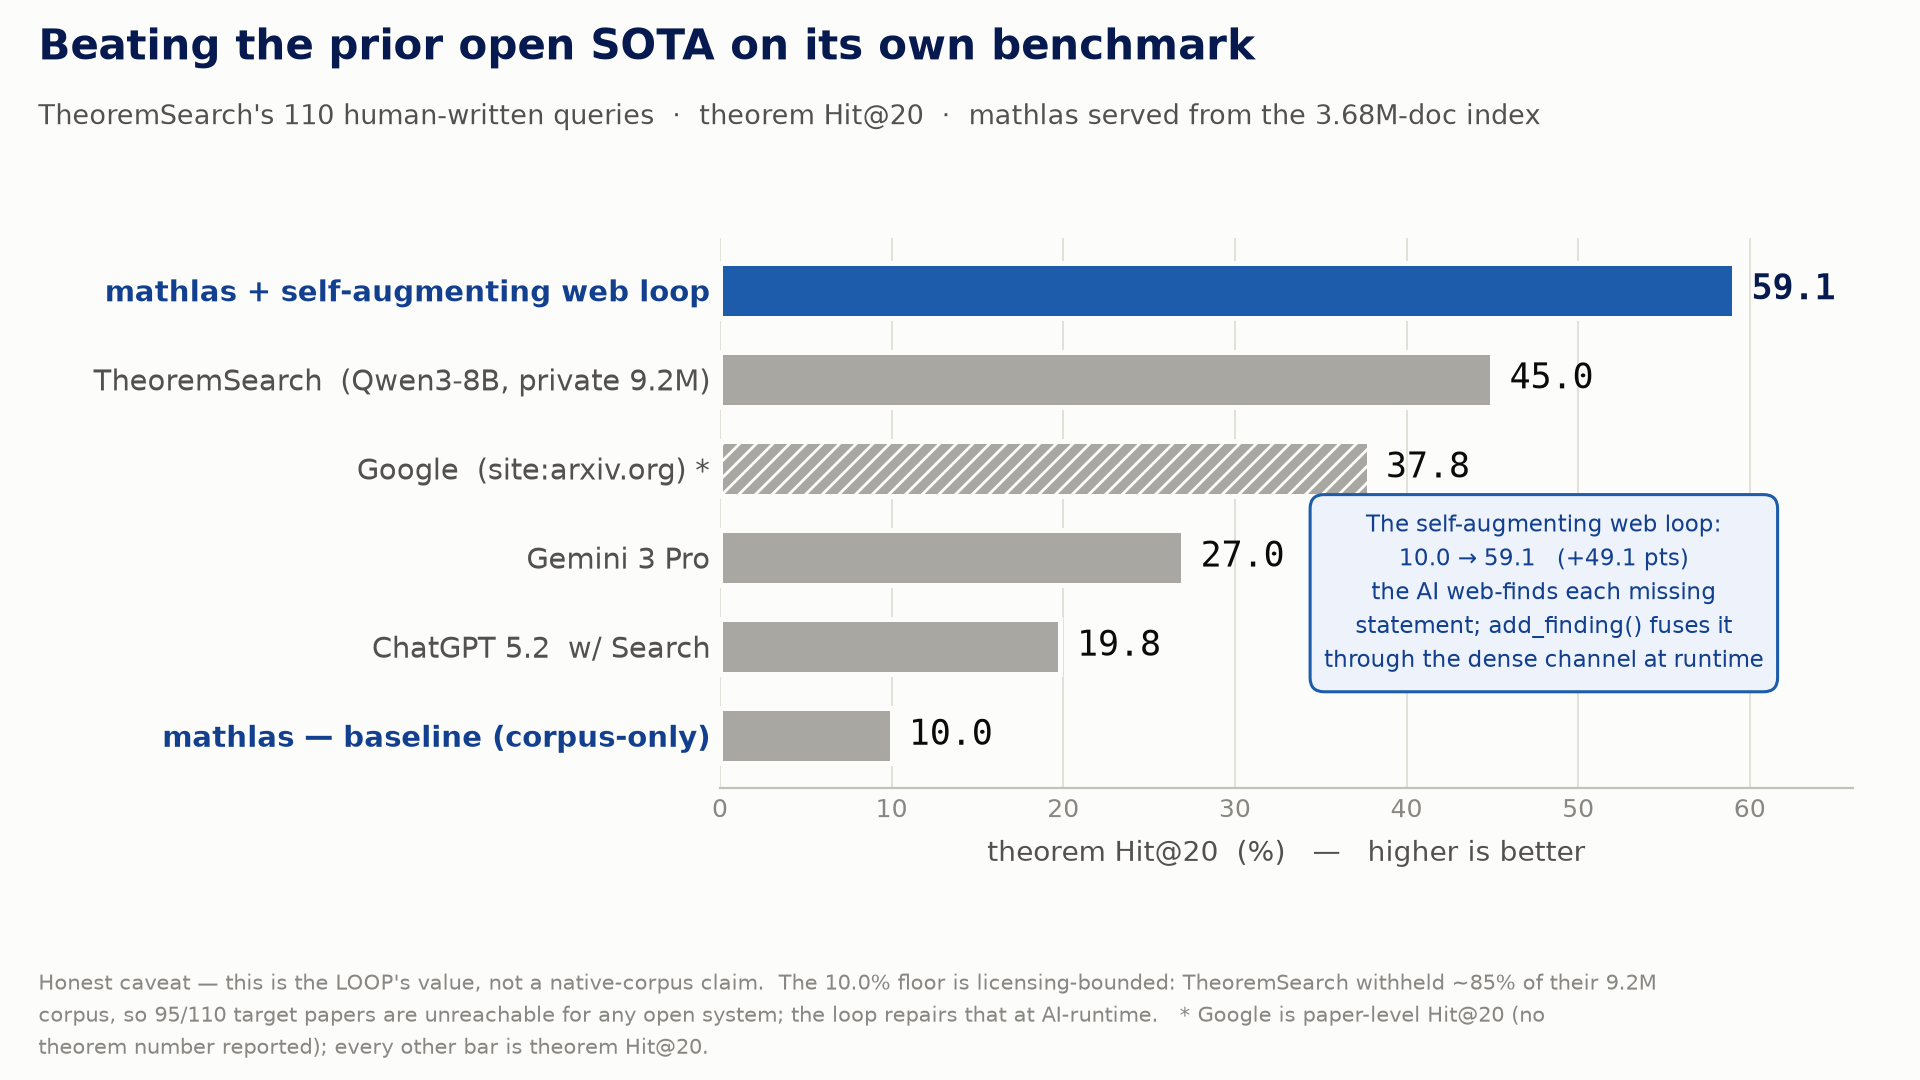
Este é o valor do loop, não uma afirmação sobre o corpus nativo. A linha de base de 10,0% é limitada por licenciamento — o TheoremSearch reteve ~85% do seu corpus de 9,2M, então 95/110 papers-alvo são inalcançáveis para qualquer sistema aberto; o loop web de auto-aumento corrige essa lacuna de cobertura em tempo de execução da IA. A referência do Google é Hit@20 em nível de paper (nenhum número de teorema relatado); todas as outras referências são Hit@20 em nível de teorema.
Reproduza com benchmarks/webaug_110_bench.py (use a lista de trabalho completa de 82 descobertas _findings_worklist_full.json).
Recuperação ciente da fonte (opt-in). Aumentar o índice de 1,34M → 3,68M teve um custo medido: os 2,34M de documentos Dolma minerados da web empurram os papers canônicos para fora do top-20 (nível de paper somente corpus 13,6% → 11,8% nessas mesmas 110 consultas). search_existing_math agora aceita source_filter / source_weights opcionais — por exemplo, source_filter={"exclude": ["dolma"]} quando você quer apenas declarações de teoremas canônicos — e excluir dolma recupera totalmente os 13,6% pré-crescimento em nível de paper (15/110; paper-alcançável-15 15/15 = 100%) com nível de teorema acima do índice antigo (11,8% vs 10,9%). A classificação padrão permanece byte-idêntica (fixada por teste). É um ajuste por intenção de consulta, não uma vitória gratuita: na auto-recuperação n=3000, 65% dos alvos SÃO documentos Dolma, reduzir o peso de dolma é catastrófico para essas consultas (R@10 de alvo-dolma 0,999 → 0,884 no peso 0,5, → 0 quando excluído) — exatamente por isso é enviado como opt-in, desligado por padrão. Também testamos se o canal duplo corrige essa regressão estruturalmente, sem o ajuste: ele recupera parte dela (paper 11,8% para 12,7%, teorema 10,0% para 10,9% nas configurações padrão), mas não os 13,6% completos, então o ajuste permanece como a mitigação documentada neste benchmark. Matriz completa: docs/02_eval_vs_theoremsearch.md.
As 12 ferramentas
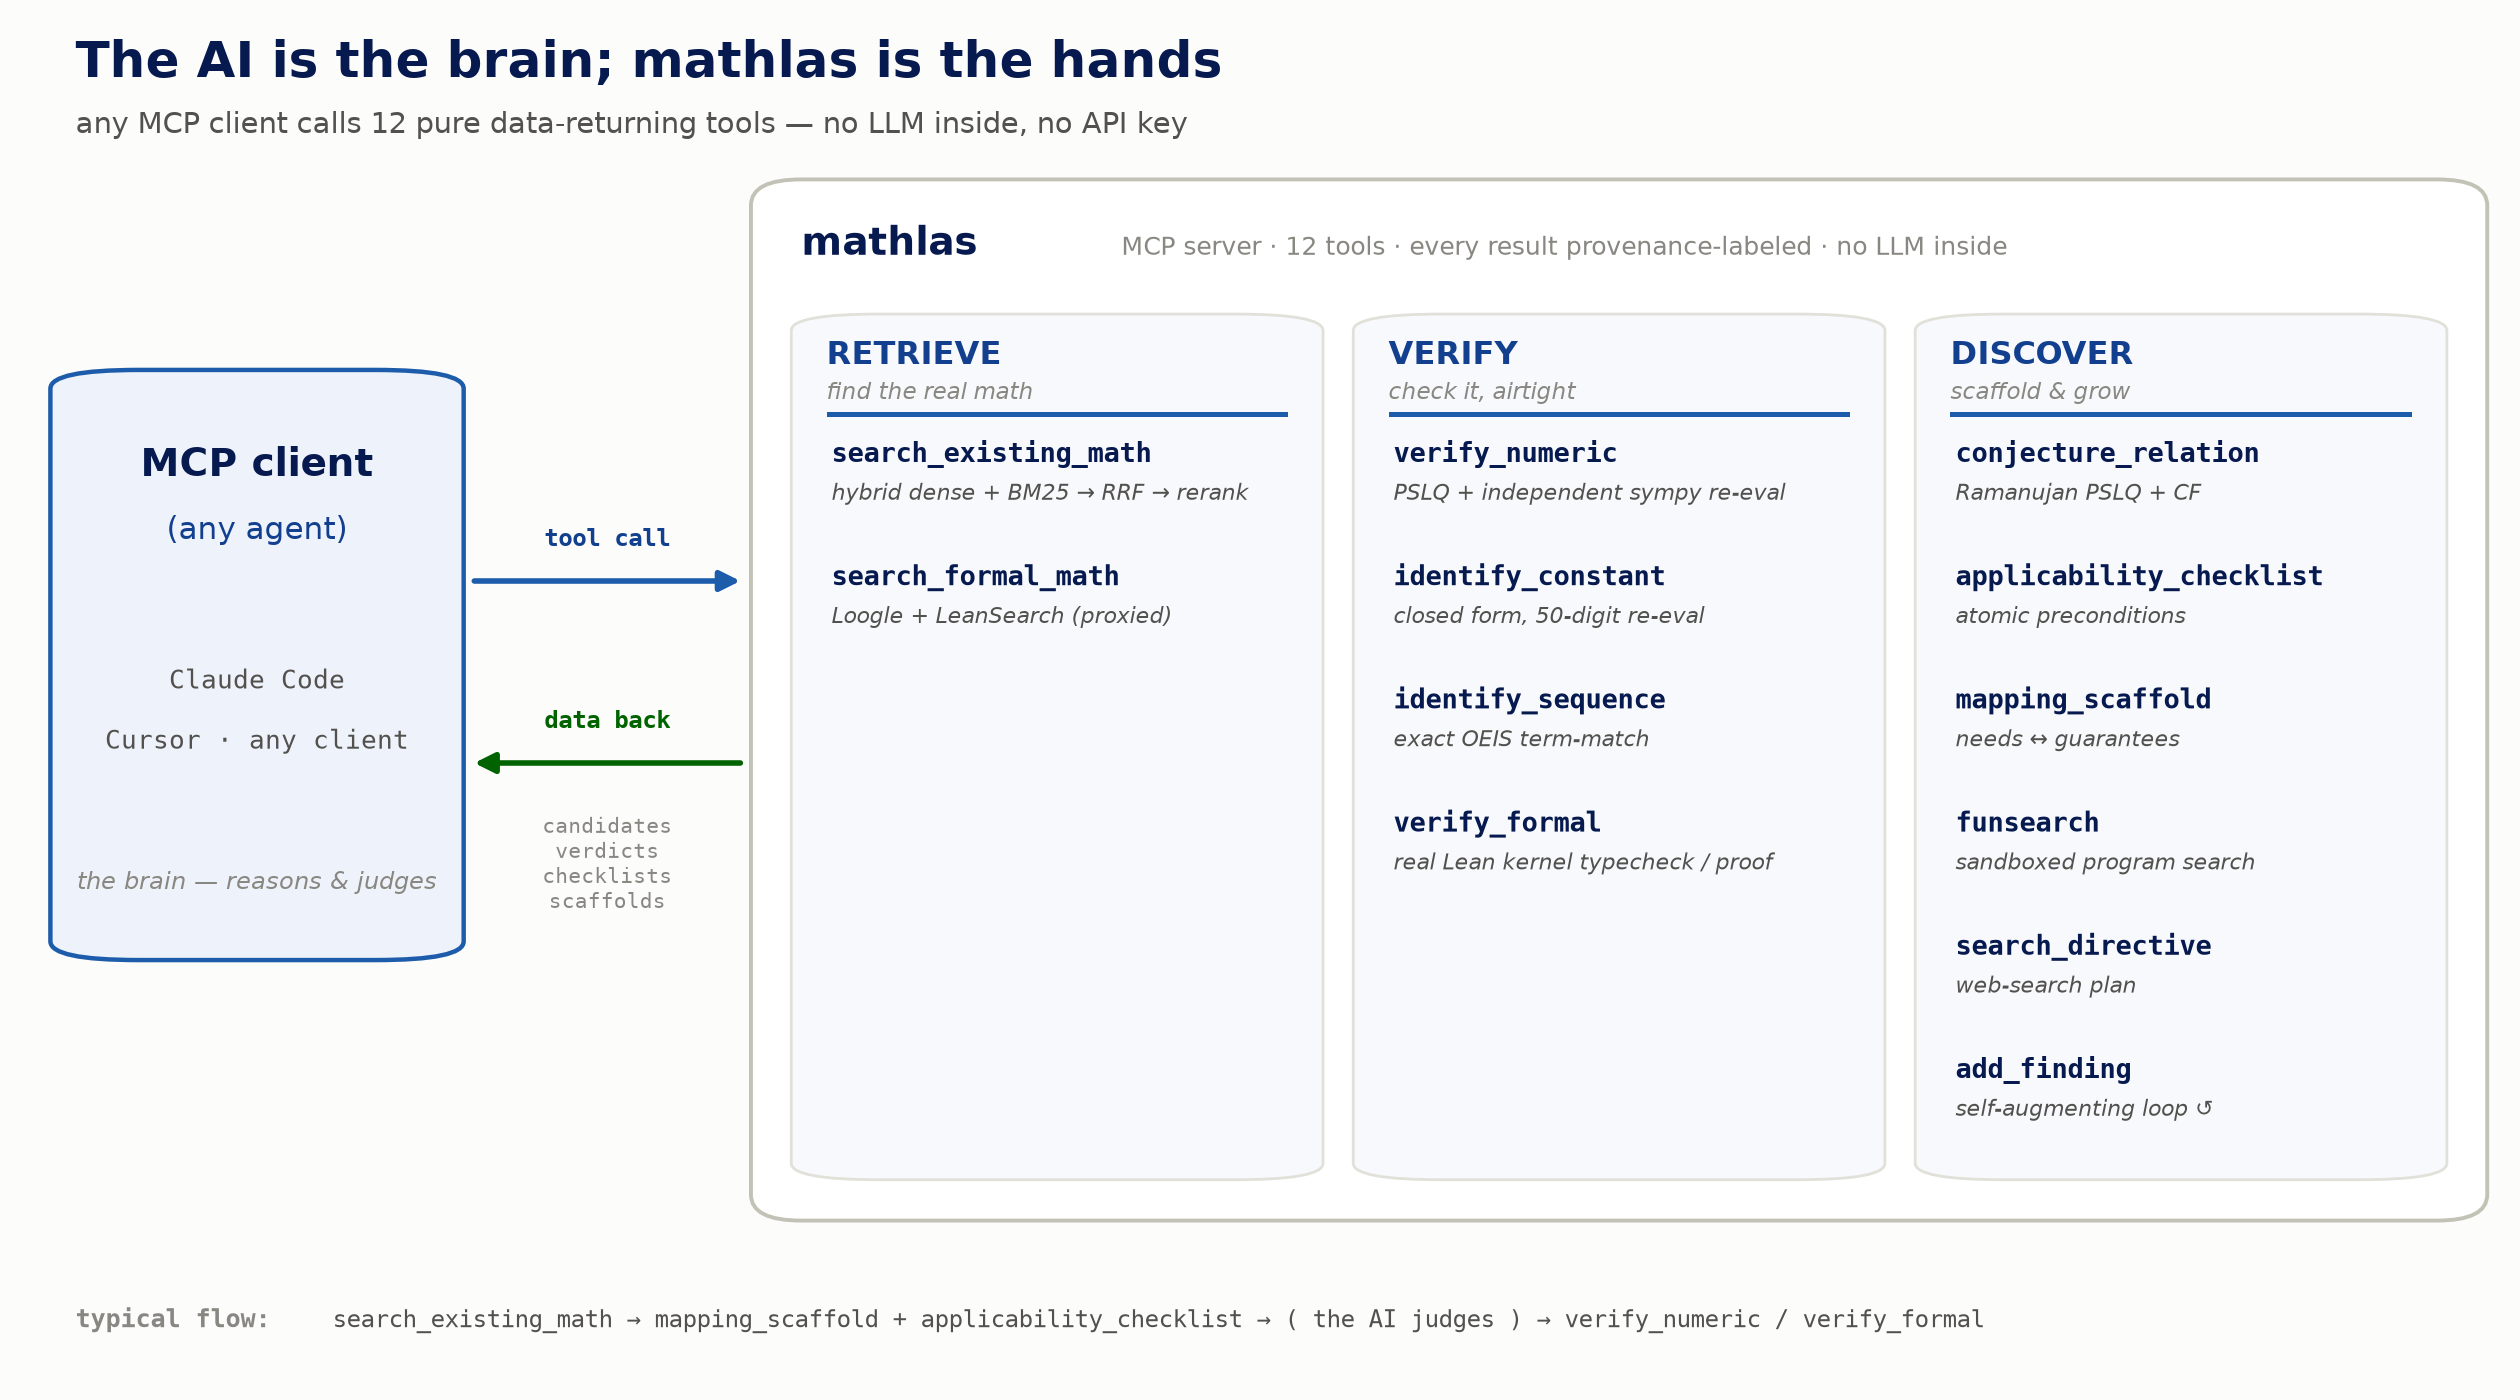
search_existing_math ─▶ mapping_scaffold + applicability_checklist ─▶ (AI judges) ─▶ verify_numeric / verify_formal
   (own index)            (needs↔guarantees, no LLM)                                  (airtight)
Quatro principais — o que a maioria dos agentes usa:
| Ferramenta | O que faz |
|---|---|
search_existing_math(query, k) | consulta → resultados classificados do índice denso + BM25 + RRF de 3,68M de documentos |
identify_constant(value) | um valor real → forma fechada conhecida + proveniência (reavaliação de 50 dígitos) |
verify_numeric(value, closed_form) | veredito de concordância de dígitos — motor diferente, maior precisão |
verify_formal(statement, lean?, proof?) | executa o kernel Lean real — verifica tipos de um trecho, ou passe proof para verificar pelo kernel uma prova Lean 4 completa: VERIFIED_PROOF / REFUTED (o erro exato do kernel, para o loop de reparo) / UNDETERMINED honesto |
Kit de ferramentas completo:
| Ferramenta | O que faz |
|---|---|
search_formal_math(query, backend) | nomes e tipos de declarações mathlib via serviços públicos Loogle (padrão/tipo) + LeanSearch (linguagem natural), com rótulo de proveniência; "serviço indisponível" honesto — com um cache em disco de 7 dias que serve a última resposta boa quando um serviço está fora, claramente rotulado (cached, <age> old) |
identify_sequence(terms) | sequência de inteiros → entradas OEIS correspondentes (correspondência exata de termos) |
applicability_checklist(statement) | hipóteses do resultado como uma lista de verificação atômica para a IA marcar |
mapping_scaffold(problem, statement) | perguntas de necessidades↔garantias + modelo de preenchimento |
conjecture_relation(value) | Ramanujan Machine: PSLQ sobre base rica + conjecturas de CF/recorrência |
funsearch(action, problem_id, …) | harness FunSearch em uma ferramenta — action=evaluate (pontua programa escrito por IA em sandbox), register (banco de dados MAP-Elites), status (melhor + few-shot) |
search_directive(problem) | plano de busca na web: consultas arXiv + subcampos + quais ferramentas executar |
add_finding(statement, slogan, source) | ingere um resultado encontrado na web no corpus ativo |
Todas as ferramentas retornam dados. Nenhuma ferramenta chama um LLM. search_formal_math é a única ferramenta que faz uma chamada web (aos serviços públicos Loogle/LeanSearch); todo o resto é totalmente local.
Verificação de provas — o loop de reparo
verify_formal não apenas verifica tipos de declarações: dê a ele uma proposição e sua prova Lean 4, e o kernel real verifica a declaração completa. mathlas nunca escreve uma prova (a divisão gerador/verificador é absoluta) — mas quando sua prova está errada, o kernel diz exatamente por quê, verbatim, em kernel_error. Isso transforma a escrita de provas em um loop apertado: o agente escreve uma prova → o kernel do mathlas diz exatamente o que está errado → o agente repara e chama novamente.
verify_formal(statement="∀ n : Nat, n + 0 = n", proof="by\n  intro n\n  rfl")
// → {"proof_status": "VERIFIED_PROOF", "checked": true, ...}
verify_formal(statement="2 + 2 = 5", proof="rfl")
// → {"proof_status": "REFUTED", "kernel_error": "error: Not a definitional equality:
//     the left-hand side 2 + 2 is not definitionally equal to the right-hand side 5 ...", ...}
Sem passes falsos, por construção: buracos sorry/admit são REJEITADOS (o próprio Lean sai com 0 em uma prova sorried — mathlas escaneia a fonte e os diagnósticos sorryAx do kernel); um toolchain ausente, um timeout (limite de 60 s) ou um import que este toolchain básico não consegue resolver retornam um UNDETERMINED honesto, nunca um veredito. tests/test_proof_check.py retém apenas as verificações de integração do kernel real; casos de unidade de declaração/parser puros e de superfície de API não estão incluídos neste branch de revisão. CI também executa as verificações de integração sintéticas de build/carga do Parquet do Hugging Face em tests/test_hf_upload_corpus.py.
Execute o pipeline de dados de CPU e as verificações de integração opcionais do kernel Lean com
python -m pip install -e ".[retrieve]" pytest datasets seguido por
python -m pytest -q tests/test_hf_upload_corpus.py tests/test_proof_check.py.
Os casos Lean são pulados quando nenhum executável Lean está disponível.
CLI / Python
mathlas 1.6449340668482264364724151666460251892   # -> pi**2/6  [verified 51 digits]
mathlas 1,1,2,3,5,8,13,21                          # -> A000045 Fibonacci  https://oeis.org/A000045
mathlas "a bounded sequence has a convergent subsequence" --k 5   # search + scaffold
mathlas mcp                                                        # run the MCP server
import mpmath
from mathlas import identify, identify_sequence, mapping_scaffold, applicability_checklist
print(identify(mpmath.zeta(2)))            # -> pi**2/6 [verified 51 digits]
print(identify_sequence([1,1,2,3,5,8,13,21]).matches[1].a_number)  # -> 'A000045'
Documentação
RESULTS.md— validação de cada ferramenta, reproduzida, com comandos.docs/methods.md— arquitetura, decisões de design, citações.docs/05_open_dataset.md— o conjunto de dados aberto e o índice.docs/QUANTIZED_TIER.md— o nível de laptop quantizado: recall/tamanho/latência medidos.docs/02_eval_vs_theoremsearch.md— o confronto direto de recuperação.docs/REGISTRY_PUBLISH.md— publicação no registro oficial do MCP.
Posicionamento — recuperação é o básico; verificação é o fosso
Crédito onde é devido: o sistema mais próximo, TheoremSearch (UW Math AI Lab), agora oferece uma API REST de produção e seu próprio endpoint MCP (api.theoremsearch.com/mcp) sobre um corpus de 9,2M de documentos — em recall bruto sobre literatura matemática, é o sistema a ser batido, e "somos nativos de MCP, eles são uma ferramenta de laboratório" não é mais um diferencial. Reutilizamos apenas o subconjunto de dados abertamente licenciado (CC-BY/CC0) deles como dados brutos para nosso próprio índice — não a API, MCP, índice ou código deles.
O sinal da DeepMind, e por que um verificador aberto ainda importa. O AlphaProof Nexus da DeepMind (arXiv:2605.22763) valida precisamente a arquitetura do mathlas — um agente LLM orquestrando um kernel Lean e recursos matemáticos estruturados como OEIS como o oráculo de verdade fundamental — mas é somente interno: o artefato público é um despejo de resultados (google-deepmind/alphaproof-nexus-results), não um sistema executável, sem API e sem superfície MCP. Gemini Deep Think e seus pares apenas aumentam a necessidade: à medida que os agentes raciocinam mais, um verificador local e determinístico do lado do agente que ele possa chamar de forma barata e offline se torna o gargalo, não o modelo. mathlas continua sendo a única camada de verificação aberta, sem chave de API, componível com MCP que qualquer agente pode integrar hoje — e agora também ingere o corpus Lean formal-conjectures abertamente licenciado da própria DeepMind (arXiv:2605.13171) como fonte de índice (scripts/fetch_formal_conjectures.py, 3.941 declarações de conjectura Lean, tag de fonte formal_conjectures, incluindo os subconjuntos de avaliação congelados FC100SolvedSet1/FC100OpenSet1).
Nota de nomenclatura: mathlas não está relacionado ao Matlas (matlas.ai, busca de teoremas da Universidade de Pequim, arXiv:2604.17484) — projeto diferente, autores diferentes; o quase-homófono é coincidência.
O que nenhum concorrente tem é tudo o que acontece após a recuperação:
- Camadas de verificação —
verify_numeric(reavaliação independente de 50 dígitos) everify_formal(uma verificação de tipos real do kernel Lean — incluindo verificação completa de provas com o erro do kernel retornado verbatim para loops de reparo do agente — ou um UNDETERMINED honesto). A recuperação entrega um candidato; mathlas também pode verificar a afirmação e verificar sua prova dela. applicability_checklist— decompõe um teorema candidato em pré-condições atômicas que a IA verifica uma a uma, capturando aplicações incorretas (intervalo aberto vs fechado, grupo infinito vs finito). Nenhum concorrente tem um.- O loop
add_findingde auto-aumento — a IA encontra na web uma declaração ausente, a incorpora e a funde no índice ativo em tempo de execução: 59,1% vs 45,0% do TheoremSearch em Hit@20 de teorema no benchmark de 110 consultas deles (veja acima). Isso é, até onde sabemos, a primeira instanciação no domínio matemático de um loop RAG com writeback validado — a família de sistemas de recuperação bidirecional que escreve inferência verificada de volta no armazenamento recuperável (RAG Bidirecional, arXiv:2512.22199), em vez de tratar a recuperação como somente leitura (Self-RAG, arXiv:2310.11511; CRAG, arXiv:2401.15884). O que torna o domínio matemático o lugar certo para isso: o candidato de writeback pode ser verificado deterministicamente (verify_numeric/verify_formal) antes de ser confiável, então o loop cresce o corpus sem o risco de amplificação de alucinação que um loop de writeback genérico carrega. - Disciplina de zero falso positivo — cada camada retorna um fato verificável independentemente ou um "nada" honesto; a taxa de falsos positivos medida é 0 em todas as camadas (
RESULTS.md). - Grátis, sem chave de API, com rótulo de proveniência — cada resultado carrega de onde veio (
known_constant,conjectured_relation,web_added,external:loogle, …), e o índice é construído 100% a partir de dados abertamente licenciados.
| mathlas | TheoremSearch | LeanSearch / Loogle | Wolfram MCP | sympy-mcp | |
|---|---|---|---|---|---|
| Recuperação matemática informal | ✅ 3,68M docs, aberto | ✅ 9,2M docs (~85% privado) | ❌ (apenas declarações mathlib) | ❌ | ❌ |
| Busca formal (mathlib) | ✅ proxy de ambos → uma ferramenta MCP | ❌ | ✅ (é exatamente isso) | ❌ | ❌ |
| Verificação numérica | ✅ reavaliação airtight de 50 dígitos | ❌ | ❌ | ⚠️ avaliação CAS | ⚠️ CAS (sem enquadramento de verificação de afirmação) |
| Verificação formal | ✅ kernel Lean real (declarações e provas completas, erros de loop de reparo) | ❌ | ❌ (busca, não verificação) | ❌ | ❌ |
| Lista de verificação de aplicabilidade | ✅ único | ❌ | ❌ | ❌ | ❌ |
| Corpus de auto-aumento | ✅ add_finding (59,1 vs 45,0 Hit@20) | ❌ | ❌ | ❌ | ❌ |
| ID de constante/sequência | ✅ PSLQ + OEIS + Ramanujan-Machine | ❌ | ❌ | ⚠️ alguns | ❌ |
| Rótulos de proveniência | ✅ cada resultado | ❌ | n/a | ❌ | n/a |
| Custo / chave | grátis, sem chave | endpoint grátis | grátis | chave paga da API Wolfram | grátis |
| MCP | ✅ stdio, one-liner uvx | ✅ endpoint remoto | ❌ (mathlas faz proxy deles) | ✅ | ✅ |
(sympy-mcp é um servidor de manipulação CAS fino — seu escopo mal se sobrepõe: ele reescreve expressões que você dá; mathlas encontra, escopa e verifica matemática existente.)
Registro oficial do MCP
mathlas é publicado como io.github.Archerkattri/mathlas (veja docs/REGISTRY_PUBLISH.md e server.json).
mcp-name: io.github.Archerkattri/mathlas