codearia-sieve
Transforma uma página web em um estado pronto para decisão para agentes de IA: datas como campos ISO, números com unidades como fatos, blocos com orçamento de tokens e âncoras de volta à página, e a conta de tokens (página mediana 53.718 → 1.106 tokens). Determinístico, sem modelo, sem chave de API; combina com modelos de decisão como Jev. Instalação: npx -y codearia-sieve.
Documentação
codearia-sieve
Analisa uma página web no formato exato que um modelo de decisão precisa.
Datas como datas. Números com unidades. Texto em blocos que cabem na janela do modelo, cada um apontando para sua origem.
Uma chamada — e a conta de tokens, antes e depois.




npx codearia-sieve          # MCP server for Claude Code, Cursor and any agent
npm i codearia-sieve        # or the library
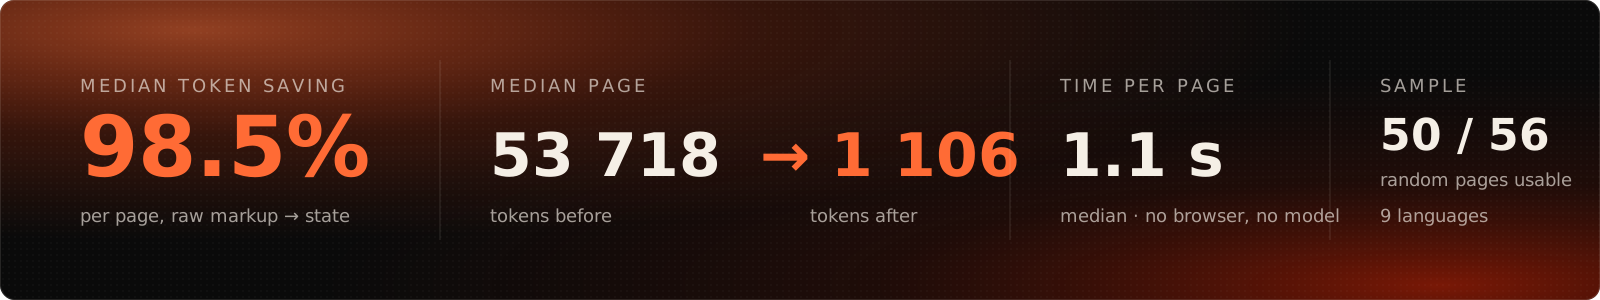
Medido, não prometido. Uma execução ao vivo sobre páginas aleatórias escolhidas no mesmo dia — notícias frescas de feeds RSS em vários idiomas, artigos aleatórios da Wikipédia, documentações, blogs, sites governamentais, receitas, lojas. Cada linha está em bench/analytics/, e npm run analytics reexecuta tudo. O resultado foi então colocado diante de um modelo de decisão: veja Verificado por um juiz.
O que faz
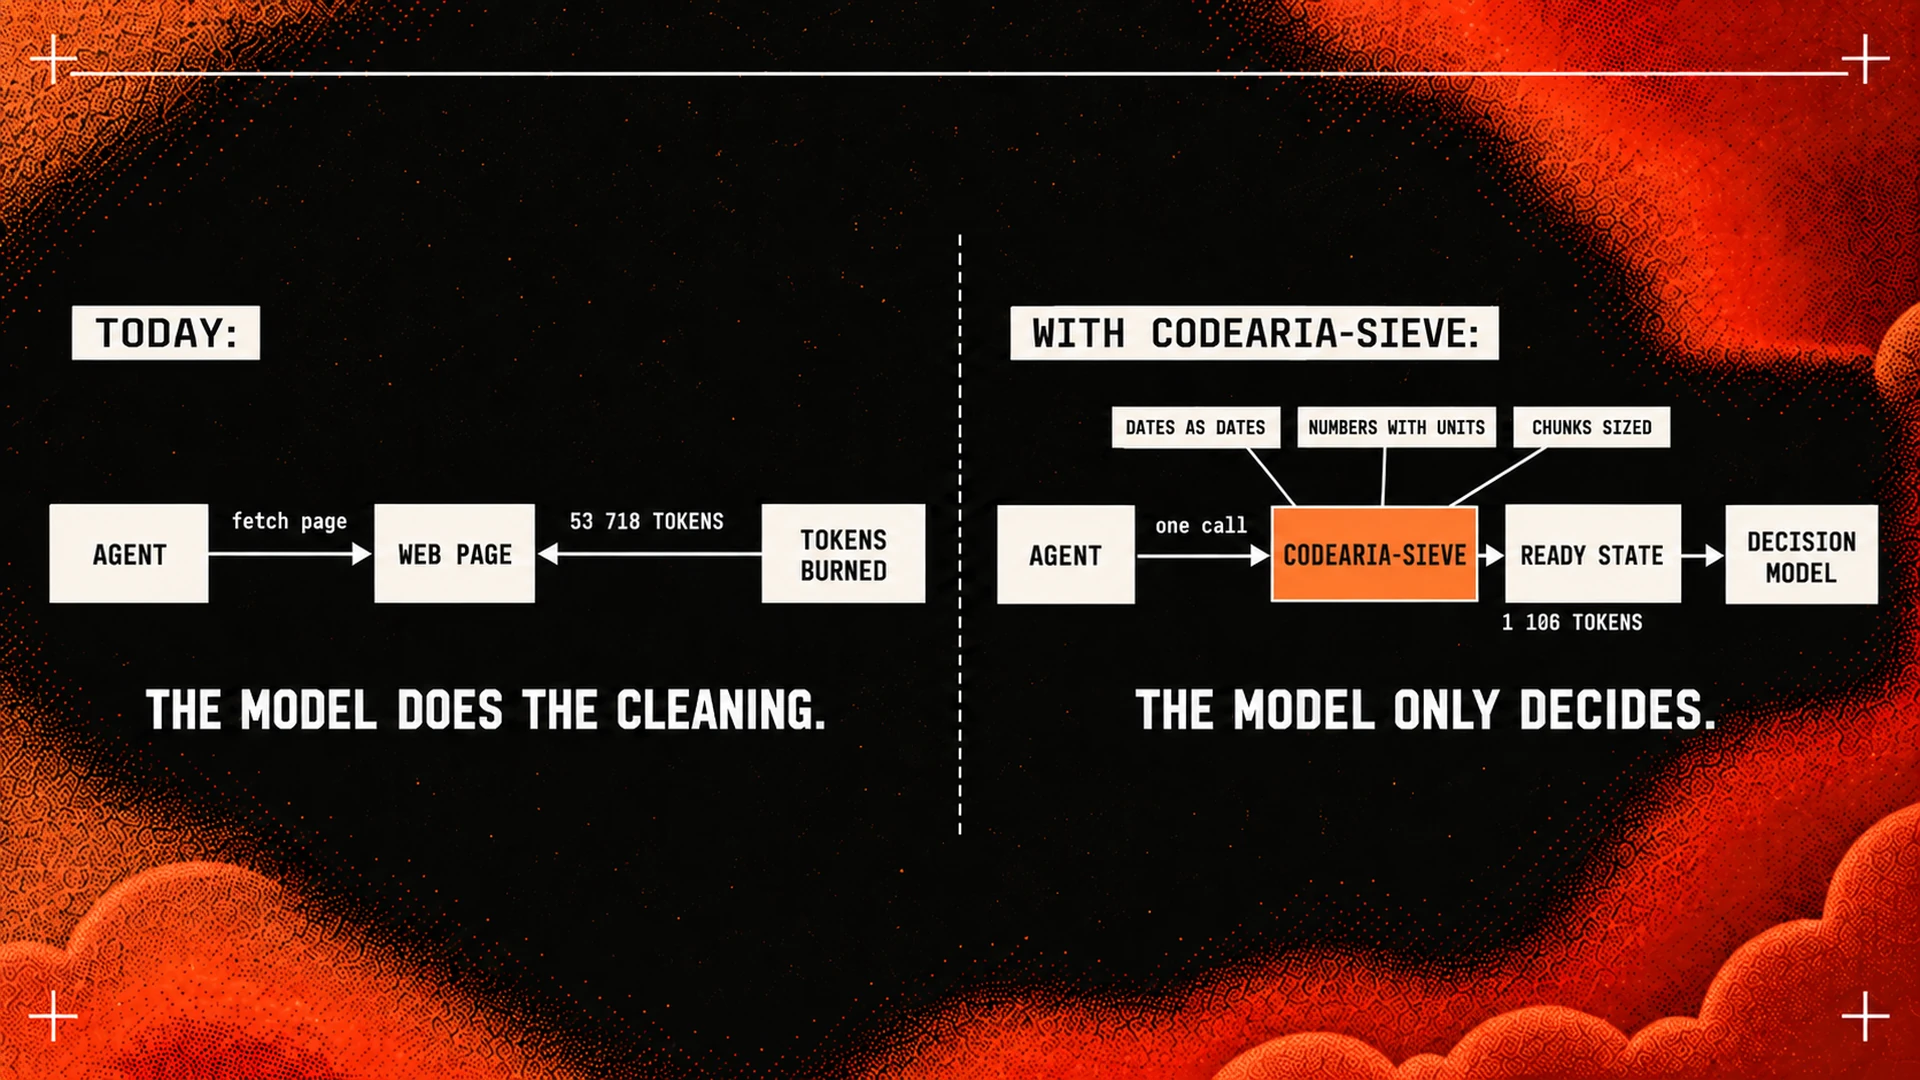
Um agente que precisa de uma página web baixa tudo: navegação, banner de cookies, rodapé, espaços de anúncio, um megabyte de marcação de framework. Depois, um modelo pago por token vasculha a pilha em busca de um parágrafo.
codearia-sieve faz a triagem antes que o modelo veja qualquer coisa — e retorna a página como estado, não como prosa:
|
Datas viram datas
|
Números viram fatos
|
Texto vira blocos que cabem Cada bloco sabe seu tamanho em tokens e caracteres, os blocos dos quais foi construído e o |
Todo o resto — menus, rodapés, banners, linhas de tags, "leia mais" — é removido, e com trace: true você obtém a lista do que foi removido e por quê.
Para quem é
Pessoas que constroem agentes e viram a conta. Cada página buscada custa dezenas de milhares de tokens antes que o agente leia uma palavra dela. Mediana de páginas na amostra: 53 718 tokens de entrada, 1 106 de saída.
Pessoas que rodam modelos de decisão baratos. Classificadores, ranqueadores, modelos do Sistema Um como Jev que julgam em vez de escrever. Eles são quase gratuitos e muito rápidos, e têm arestas duras: não sabem contar, leem datas como texto, e sua precisão cai conforme material irrelevante preenche o contexto. Toda ferramenta de "página para markdown" prepara entrada para um leitor. Esta prepara entrada para um juiz.
Pessoas que precisam de respostas verificáveis. Um veredito de texto raspado é improvável a menos que cada peça aponte para sua fonte. Aqui, cada fato nomeia seu bloco e cada bloco carrega uma âncora.
Como funciona
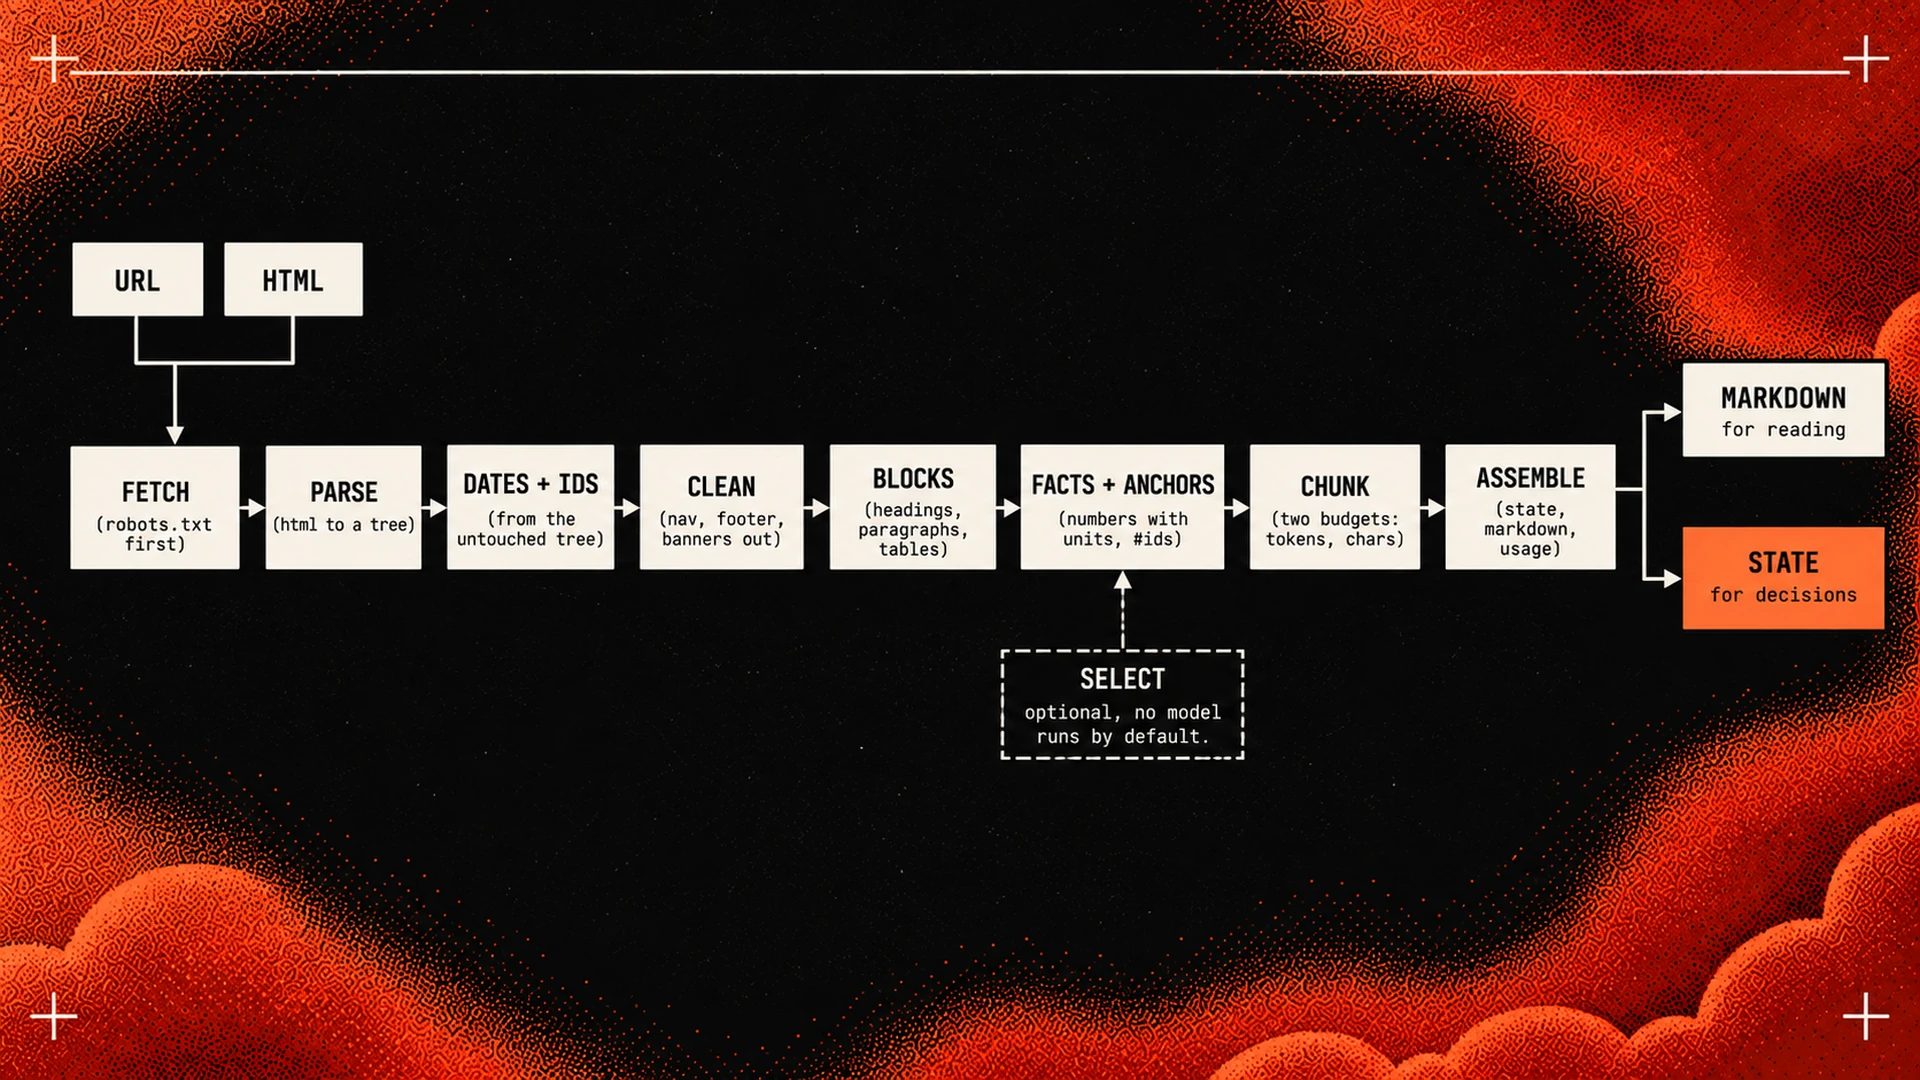
Oito etapas de código comum. Nenhum modelo roda a menos que você conecte um. O mesmo HTML gera o mesmo JSON, byte por byte.
- Busca —
robots.txtprimeiro; uma recusa é relatada, não contornada. HTTP simples, user agent honesto. - Análise — HTML em um DOM com
linkedom. Sem navegador. - Datas e ids da árvore intocada — a limpeza remove
<head>, linhas de autoria e atributos, então ambos são lidos antes que ela rode. - Limpeza — Defuddle remove o chrome; Readability assume se vier vazio. Elementos inline ganham um espaço primeiro, então
<span>20 Sept</span><span>10 min</span>nunca vira202610 min. - Blocos — títulos, parágrafos, listas, tabelas, código, citações, em ordem, com ids posicionais. Páginas antigas configuradas com
<br><br>viram parágrafos também; linhas de tabela mantêm seus cabeçalhos de coluna. - Fatos e âncoras — ids restaurados; números viram fatos apenas ao lado de uma unidade; intervalos mantêm ambas as extremidades.
- Blocagem — guloso, em ordem, sob dois orçamentos ao mesmo tempo: 20 000 tokens e 50 000 caracteres por padrão.
- Montagem —
state,markdown,usage,warningse o rastreamento sob solicitação.
Como é o resultado
const r = await sieve({ kind: 'url', url: 'https://docs.typesafe.ai/models' });

r.state.title         // "Models"
r.state.facts[0]      // { value: 42, unit: "USD_per_billion", label: "price_btok_mtok",
                      //   context: "Price (per Btok / per Mtok) | jev-1.13.0: $42 / $0.042", from: "b3" }
r.state.facts[1]      // { value: 0.042, unit: "USD_per_million", … }   — paired by position
r.state.chunks[0]     // { id: "c1", tokens: 1210, chars: 5357, anchor: "Current models",
                      //   headings: ["Current models", "Pricing", …], blocks: ["b1", …, "b36"], text: "…" }
r.usage               // { rawTokens: 127413, stateTokens: 1211,
                      //   visibleChars: 4939, stateChars: 5357, chunks: 1, ms: 1503 }
r.warnings            // []
r.markdown            // the same article, for a human or a generative model
Resultados esperados nunca lançam exceções. Eles voltam como avisos, cada um nomeado:
| Aviso | Significado |
|---|---|
robots-disallowed | o site pede que rastreadores fiquem de fora; não buscamos |
blocked | um desafio de bot ou uma recusa (403, 405, 429, "Só um momento…"), com o status |
http-error | um 404 ou 500 que ainda renderizou uma página de erro; não é a página que você pediu |
paywall | a página marca seu artigo como não gratuito; você recebeu o teaser |
empty-without-js | o contêiner do artigo está vazio e um script o preencheria |
thin-content | uma página grande que rendeu pouca prosa — uma página inicial, uma listagem |
block-split | um bloco excedeu o orçamento e foi cortado em limites de frase |
facts-capped | a página tem mais fatos do que os 500 listados — uma longa tabela de tarifas, por exemplo |
Use a partir de um agente
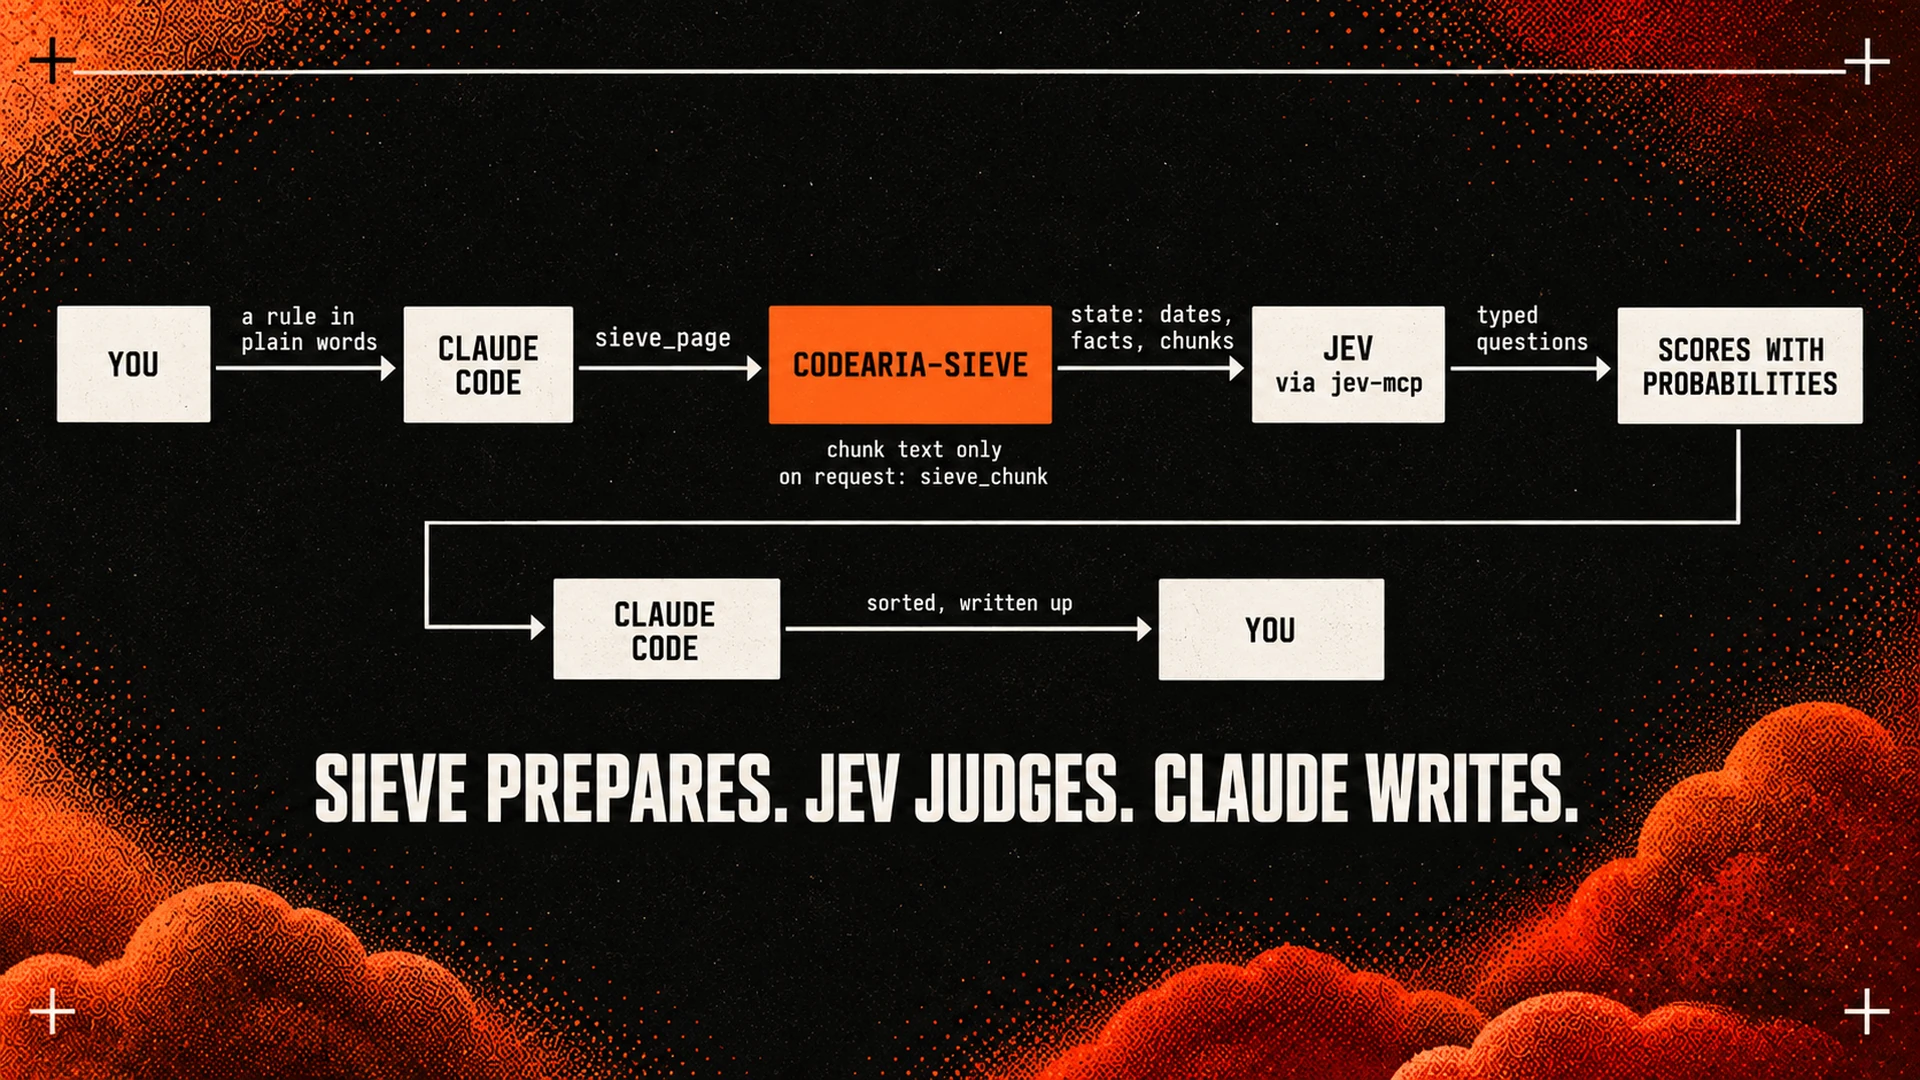
Você diz o que quer em palavras simples. O agente encontra as páginas, chama sieve_page para cada uma, entrega o estado a um modelo de decisão com uma pergunta tipada e escreve o resultado. Sieve prepara. O juiz julga. O agente escreve.
{ "mcpServers": { "sieve": { "command": "npx", "args": ["-y", "codearia-sieve"] } } }
Listado no Registro Oficial de MCP como io.github.AntonG87/codearia-sieve; clientes que leem o registro podem instalá-lo pelo nome.
|
Retorna |
O texto de um bloco do último resultado para aquela URL, sem nova busca. Visão geral primeiro, depois apenas o necessário — a ferramenta aplica sua própria ideia a si mesma. |
Combina com jev-mcp: os blocos são dimensionados para caber em seus campos, então o estado vai direto para uma pergunta tipada.
Verificado por um juiz
A afirmação é que um modelo de decisão recebe entrada melhor do Sieve do que de texto bruto. Então o resultado foi entregue a um. examples/jev.ts dirige ambos os servidores MCP com o cliente oficial — codearia-sieve prepara seis páginas (documentação de API, uma nota de lançamento, dois artigos da Wikipédia em dois idiomas, duas páginas de preços), Jev as julga através de jev-mcp. Mesma execução, 21 de setembro de 2026:
| Pergunta ao Jev | Entrada do Sieve | Resultado |
|---|---|---|
jev_classify — que tipo de página é esta? | título + cabeçalho do primeiro bloco, sob o limite de 2 000 caracteres da ferramenta | 6 de 6 corretos; 5 automáticos, 1 sinalizado para revisão — uma página que é tanto documentação quanto tabela de tarifas |
jev_verify — cada fato extraído está realmente na página? | cada fato como uma afirmação, seus blocos como evidência | 11 de 11 verificados, todos automáticos, confiança 0,86–1,0 |
jev_extract — quando foi publicado? | primeiro bloco, um regex de data, uma descrição | concorda com o Sieve onde a página declara uma data; o Sieve também lê JSON-LD e <meta>, que o Jev nunca vê |
A primeira passada deste teste fez seu trabalho ao contrário: o Jev enviou três fatos para revisão e contradisse um. Todos os quatro rastrearam até o Sieve — uma linha de tabela rotulada pelo cabeçalho de coluna em vez do cabeçalho de linha, duas tarifas em um cabeçalho deixadas sem par, e uma referência bibliográfica russa "256 с." lida como segundos. Corrigido, testado, reexecutado: 11 de 11. Um juiz que pode dizer quando seu parser está errado é o ponto de todo o emparelhamento.
TYPESAFE_API_KEY=… node --experimental-strip-types examples/jev.ts
Use como biblioteca
import { sieve } from 'codearia-sieve';

await sieve({ kind: 'url', url });                    // fetch it
await sieve({ kind: 'html', html, url });             // already have it; url only for anchors

await sieve(input, {
  budget:    { maxTokens: 8000, maxChars: 30000 },    // chunk limits
  trace:     true,                                    // everything discarded, and why
  tokenizer: myTokenizer,                             // o200k by default; swap for your model's
  fetcher:   myFetcher,                               // your transport, or a file reader in tests
  now:       () => fixedDate,                         // injected clock: identical output on identical input
  selector:  mySelector, task: 'is this about pricing?', // relevance judge; nothing runs without one
});
parseDate, findDates e os limites do fornecedor (JEV, JEV_MCP, DEFAULT_BUDGET) também são exportados.
Onde para
- Páginas iniciais, listagens e páginas de produto não têm artigo para encontrar. Você recebe os títulos e um aviso
thin-content, não uma vitória falsa. - Artigos renderizados por JavaScript voltam como
empty-without-jsquando o contêiner está vazio. Um site que envia um teaser e transmite o resto não pode ser diferenciado sem um navegador; você recebe o teaser. - Páginas com muito texto economizam menos. Um romance inteiro economiza 22 %, um RFC 84 %: não há embrulho para remover e o texto é mantido por completo. Isso é a ferramenta funcionando.
- Uma grade de preços não é uma tabela. Um fato sabe o bloco de onde veio, não a coluna de plano sob a qual está; o Sieve não adivinha o emparelhamento. Envie o bloco — uma página de preços tem cerca de mil tokens após a limpeza — e deixe o juiz ler:
examples/pricing-watch.ts. - Tokens são contados com o200k como aproximação. Páginas acima de um megabyte recebem uma contagem amostrada e
usage.rawTokensEstimated: true.
Desenvolva
npm install
npm test                    # 71 tests, offline, a few seconds
npm run demo -- <url>       # the token bill for one page
npm run bench               # the 20-page benchmark set
npm run analytics           # the 56-page random sample: rows, CSV, summary
Notas de design — visão e arquitetura — estão em docs/.
MIT © 2026 Anton Evelson · Codearia Academy