NeoCoder
Permite que assistentes de IA utilizem um grafo de conhecimento Neo4j para fluxos de trabalho de codificação padronizados, atuando como um manual de instruções dinâmico e memória de projeto.
Documentação
NeoCoder: Fluxo de Trabalho de Codificação com IA Guiado por Neo4j
Uma implementação de servidor MCP que permite que assistentes de IA como Claude usem um grafo de conhecimento Neo4j como seu "manual de instruções" dinâmico e memória de projeto para fluxos de trabalho de codificação padronizados.
NeoCoder: Sistema Híbrido de Raciocínio e Fluxo de Trabalho com IA
Uma implementação avançada de servidor MCP que combina grafos de conhecimento Neo4j, bancos de dados vetoriais Qdrant e orquestração sofisticada de IA para criar um sistema de raciocínio híbrido para gerenciamento de conhecimento, análise de pesquisa e fluxos de trabalho padronizados.
Visão Geral
O NeoCoder implementa um sistema revolucionário de Raciocínio Aumentado por Contexto que vai muito além do RAG tradicional (Geração Aumentada por Recuperação) ao combinar:
Arquitetura Principal:
- Grafos de Conhecimento Neo4j - Fatos estruturados autoritativos, relacionamentos e fluxos de trabalho
- Bancos de Dados Vetoriais Qdrant - Busca semântica, detecção de similaridade e compreensão contextual
- Orquestração MCP - Roteamento inteligente entre fontes de dados com síntese e citação
- Síntese por F-Contração - Mesclagem dinâmica de conhecimento que preserva a atribuição de origem
Principais Capacidades:
- Raciocínio Híbrido de Conhecimento: Combine perfeitamente fatos estruturados com contexto semântico
- Extração Dinâmica de Conhecimento: Processe documentos, código e conversas em estruturas de conhecimento interconectadas
- Análise Baseada em Citações: Cada afirmação rastreada até sua origem em múltiplos bancos de dados
- Sistema de Múltiplas Encarnações: Modos especializados para codificação, pesquisa, suporte a decisões e gerenciamento de conhecimento
- Modelos de Fluxo de Trabalho Inteligentes: Procedimentos guiados por Neo4j com etapas de verificação obrigatórias
Recursos Revolucionários:
🧠 Roteamento Inteligente de Consultas: A IA determina automaticamente a fonte de dados ideal (grafo, vetor ou híbrido) 🔬 Mecanismo de Análise de Pesquisa: Processe artigos acadêmicos com grafos de citação e conteúdo semântico ⚡ Processamento por F-Contração: Mescle dinamicamente conceitos semelhantes preservando a proveniência 🎯 Raciocínio Aumentado por Contexto: Gere insights impossíveis com fontes de dados únicas 📊 Trilhas de Auditoria Completas: Rastreamento completo da síntese de conhecimento e execução de fluxos de trabalho 🛡️ Gerenciamento de Processos Pronto para Produção: Limpeza automática, tratamento de sinais e rastreamento de recursos para evitar vazamentos de processos 🔧 Tratamento Aprimorado de Ferramentas: Inicialização assíncrona robusta com gerenciamento adequado de tarefas em segundo plano
Novo a partir de uma ideia que tive- Estrutura Ecológica Lotka-Volterra integrada à Encarnação de Grafo de Conhecimento
Gerenciamento de Processos e Confiabilidade
O NeoCoder implementa gerenciamento abrangente de processos seguindo as melhores práticas do MCP:
- Manipuladores de Sinais: Tratamento adequado de SIGTERM/SIGINT para desligamentos graciosos
- Rastreamento de Recursos: Rastreamento automático de processos, conexões Neo4j e tarefas em segundo plano
- Limpeza de Zumbis: Detecção ativa e limpeza de instâncias de servidor órfãs
- Gerenciamento de Memória: Prevenção de vazamentos de recursos por meio de padrões de limpeza adequados
- Gerenciamento de Tarefas em Segundo Plano: Tratamento seguro de inicialização assíncrona e operações concorrentes
- Pooling de Conexões: Gerenciamento eficiente do driver Neo4j com limpeza automática
Comandos de Monitoramento
Use estas ferramentas para monitorar a saúde do servidor:
get_cleanup_status()- Visualize o uso de recursos e o status de limpezacheck_connection()- Verifique a conectividade e as permissões do Neo4j
Início Rápido
Pré-requisitos
-
Neo4j: Executando localmente ou instância remota (para grafos de conhecimento estruturados)
-
Qdrant: Banco de dados vetorial para busca semântica e embeddings (para raciocínio híbrido)
-
Python 3.10+: Para executar o servidor MCP
-
uv: O gerenciador de pacotes Python para servidores MCP
-
Claude Desktop: Para usar com a IA Claude
-
MCP-Desktop-Commander: Inestimável para operações de CLI e sistema de arquivos
-
Para o Ecossistema Lotka-Volterra e capacidades geralmente aprimoradas-
-
wolframalpha-llm-mcp: muito bom!
-
mcp-server-qdrant-enhanced: Meu servidor MCP qdrant-enhanced
-
Opcional para mais utilidade
Esta encarnação ainda está em desenvolvimento
-
Para Encarnação de Análise de Código: AST/ASG: Atualmente precisa de desenvolvimento e uma reescrita da encarnação
-
Obtenha uma chave de API gratuita do WolframAlpha:
Para obter uma chave de API gratuita (AppID) para Wolfram|Alpha, você precisa se cadastrar com um Wolfram ID e depois registrar um aplicativo no Portal de Desenvolvedores Wolfram|Alpha.
Crie um Wolfram ID: Se você ainda não tem um, crie um Wolfram ID em https://account.wolfram.com/login/create
Navegue até o Portal de Desenvolvedores: Depois de ter um Wolfram ID, faça login no Portal de Desenvolvedores Wolfram|Alpha https://developer.wolframalpha.com/portal/myapps
Cadastre-se para seu primeiro AppID: Clique no botão "Sign up to get your first AppID".
Preencha o diálogo de criação do AppID: Forneça um nome e uma descrição simples para seu aplicativo.
Receba seu AppID: Após preencher as informações necessárias, você receberá sua chave de API, também chamada de AppID.
A API Wolfram|Alpha é gratuita para uso não comercial, e você obtém até 2.000 solicitações por mês.
Cada aplicativo requer seu próprio AppID exclusivo.
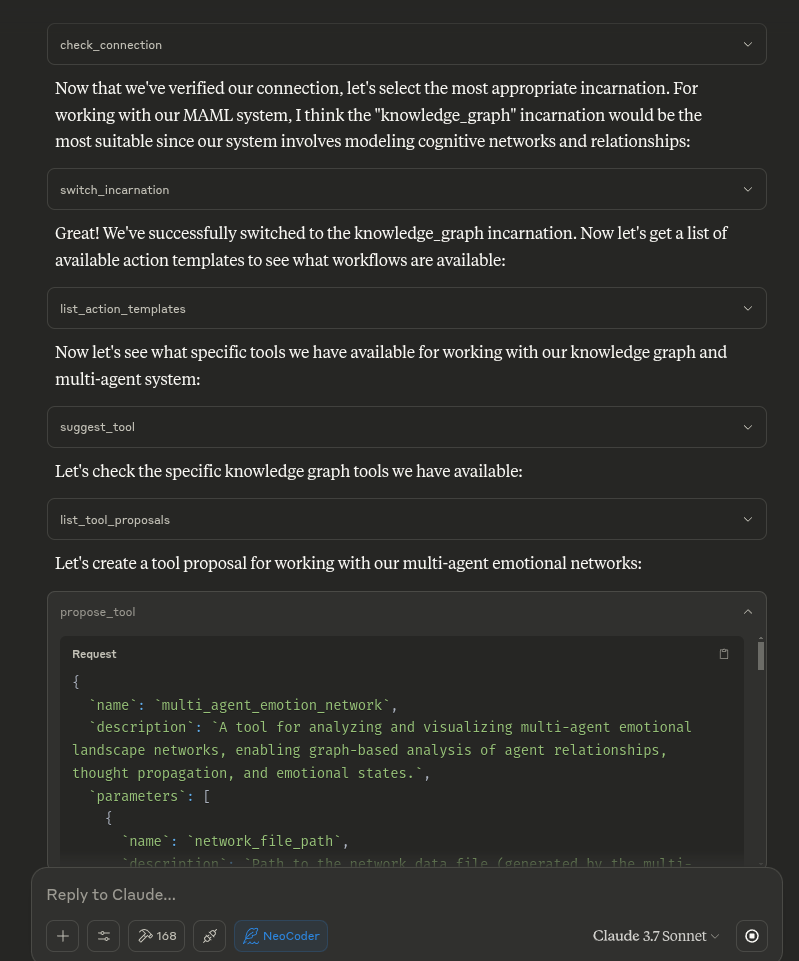
O servidor MCP executa o código Python, preenchendo a lacuna entre o grafo Neo4j e o assistente de IA (por exemplo, Claude)
Instalação
1. Clone o repositório
git clone https://github.com/angrysky56/NeoCoder-neo4j-ai-workflow.git
cd NeoCoder-neo4j-ai-workflow
2. Configure o Python e o ambiente virtual
Certifique-se de ter pyenv e uv instalados.
pyenv install 3.11.12  # if not already installed
pyenv local 3.11.12
uv venv
source .venv/bin/activate
3. Instale as dependências
uv pip install -e '.[dev,docs,gpu]'
4. Inicie o Neo4j e o Qdrant
- Neo4j:
Inicie seu servidor Neo4j (local ou remoto).
Conexão padrão:
bolt://localhost:7687
Parâmetros de conexão do Neo4j:
-
URL:
bolt://localhost:7687(padrão) -
Usuário:
neo4j(padrão) -
Senha: Sua senha do banco de dados Neo4j
-
Banco de dados:
neo4j(padrão)Defina as credenciais por meio de variáveis de ambiente, se necessário:
NEO4J_URLNEO4J_USERNAMENEO4J_PASSWORDNEO4J_DATABASE
-
Qdrant: Para armazenamento persistente do Qdrant, use este comando Docker (recomendado):
docker run -p 6333:6333 -p 6334:6334 \
  -v "$(pwd)/qdrant_storage:/qdrant/storage:z" \
  qdrant/qdrant
Isso armazenará os dados do Qdrant em uma pasta
qdrant_storageno diretório do seu projeto.
5. (Opcional) Usuários do VS Code
- Abra a Paleta de Comandos (
Ctrl+Shift+P), selecione Python: Selecionar Interpretador e escolha.venv/bin/python.
- Deve instalar automaticamente ao usar a configuração - não tenho mais certeza, não tentei isso e algumas dependências são bastante grandes.
Possível início rápido - desculpe
Recomendado: Integração com Claude Desktop:
Configure o Claude Desktop adicionando o seguinte ao seu
claude-app-config.json:
{
  "mcpServers": {
    "neocoder": {
      "command": "uv",
      "args": [
        "--directory",
        "/your-path-to/NeoCoder-neo4j-ai-workflow",
        "run",
        "mcp_neocoder"
      ],
      "env": {
        "NEO4J_URL": "bolt://localhost:7687",
        "NEO4J_USERNAME": "neo4j",
        "NEO4J_PASSWORD": "your-neo4j-password-here",
        "NEO4J_DATABASE": "neo4j",
        "LOG_LEVEL": "INFO",
        "MCP_TRANSPORT": "stdio",
        "PYTHONUNBUFFERED": "1"
      }
    }
  }
}
Importante: A senha nesta configuração deve corresponder à senha do seu banco de dados Neo4j.
Caso contrário - Instale as dependências: Solução rápida de problemas:
- Se você vir erros sobre pacotes ausentes, verifique se seu
.venvestá ativado e se você está usando a versão correta do Python. - Se precisar redefinir seu ambiente, você pode remover
.venve repetir as etapas acima. - Não consegue conectar ao banco de dados? Instale o Neo4j Desktop e o QDRANT. Certifique-se de que eles estejam em execução. O NEO4J requer uma senha definida.
docker pull qdrant/qdrant

docker run -p 6333:6333 -p 6334:6334 \
    -v "$(pwd)/qdrant_storage:/qdrant/storage:z" \
    qdrant/qdrant
Agora você está pronto para usar o NeoCoder com raciocínio híbrido completo do Ecossistema Lotka-Volterra com Neo4j e Qdrant!
Prompt de sistema sugerido
> **System Instruction:** You are an AI assistant integrated with a Neo4j knowledge graph that defines our standard procedures and tracks project changes.
>
> **Your Core Interaction Loop:**
> 1.  **Identify Task & Keyword:** Determine the action required (e.g., fix a bug -> `FIX`).
> 2.  **Consult the Hub:** If unsure about keywords or process, start by querying `:AiGuidanceHub {id: 'main_hub'}` for guidance and links to best practices or other guides.
> 3.  **Retrieve Instructions:** Formulate a Cypher query to fetch the `steps` from the current `:ActionTemplate` matching the keyword (e.g., `MATCH (t:ActionTemplate {keyword: 'FIX', isCurrent: true}) RETURN t.steps`). Execute this query.
> 4.  **Execute Guided Workflow:** Follow the retrieved `steps` meticulously. This includes reviewing project READMEs, implementing changes, and critically:
> 5.  **Perform Verification:** Execute the testing steps defined in the template. **ALL required tests MUST pass before you consider the task complete.**
> 6.  **Record Completion (Post-Testing):** Only if tests pass, formulate and execute the Cypher query specified in the template to create a `:WorkflowExecution` node, linking it appropriately. Do NOT record if tests failed.
> 7.  **Finalize Updates:** Update the project's README content (in Neo4j or the file) as per the template's instructions.
>
> **Strict Rule:** Always prioritize instructions retrieved from the Neo4j graph over your general knowledge for workflow procedures. Use the graph as your single source of truth for *how* tasks are done here.

---

> **knowledge_graph_incarnation with integrated Lotka Volterra Special System Instruction:** You are an AI assistant integrated with a sophisticated hybrid reasoning system that combines Neo4j knowledge graphs, Qdrant vector databases, and MCP orchestration for advanced knowledge management and workflow execution.
>
> **Your Core Capabilities:**
> 1. **Standard Coding Workflows:** Use Neo4j-guided templates for structured development tasks
> 2. **Hybrid Knowledge Reasoning:** Combine structured facts (Neo4j) with semantic search (Qdrant) for comprehensive analysis
> 3. **Dynamic Knowledge Synthesis:** Apply F-Contraction principles to merge and consolidate knowledge from multiple sources
> 4. **Multi-Modal Analysis:** Process research papers, code, documentation, and conversations into interconnected knowledge structures
> 5. **Citation-Based Reasoning:** Provide fully attributed answers with source tracking across databases
>
> **Your Core Interaction Loop:**
> 1.  **Identify Task & Context:** Determine the required action and select appropriate incarnation/workflow
> 2.  **Consult Guidance Hubs:** Query incarnation-specific guidance hubs for specialized capabilities and procedures
> 3.  **Execute Hybrid Workflows:** For knowledge tasks, use KNOWLEDGE_QUERY template for intelligent routing between graph and vector search
> 4.  **Apply Dynamic Synthesis:** Use KNOWLEDGE_EXTRACT template to process documents into both structured (Neo4j) and semantic (Qdrant) representations
> 5.  **Ensure Quality & Citations:** All knowledge claims must be properly cited with source attribution
> 6.  **Record & Learn:** Log successful executions for system optimization and learning
>
> **Hybrid Reasoning Protocol:**
> - **Graph-First**: Use Neo4j for authoritative facts, relationships, and structured data
> - **Vector-Enhanced**: Use Qdrant for semantic context, opinions, and nuanced information
> - **Intelligent Synthesis**: Combine both sources with conflict detection and full citation tracking
> - **F-Contraction Merging**: Dynamically merge similar concepts while preserving source attribution
>
> **Strict Rules:**
> - Always prioritize structured facts from Neo4j over semantic information
> - Every claim must include proper source citations
> - Use incarnation-specific tools and templates as single source of truth for procedures
> - Apply F-Contraction principles when processing multi-source information

---

Instructions for WolframAlpha use
- WolframAlpha understands natural language queries about entities in chemistry, physics, geography, history, art, astronomy, and more.
- WolframAlpha performs mathematical calculations, date and unit conversions, formula solving, etc.
- Convert inputs to simplified keyword queries whenever possible (e.g. convert "how many people live in France" to "France population").
- Send queries in English only; translate non-English queries before sending, then respond in the original language.
- Display image URLs with Markdown syntax: ![URL]
- ALWAYS use this exponent notation: `6*10^14`, NEVER `6e14`.
- ALWAYS use {"input": query} structure for queries to Wolfram endpoints; `query` must ONLY be a single-line string.
- ALWAYS use proper Markdown formatting for all math, scientific, and chemical formulas, symbols, etc.:  '$$\n[expression]\n$$' for standalone cases and '\( [expression] \)' when inline.
- Never mention your knowledge cutoff date; Wolfram may return more recent data.
- Use ONLY single-letter variable names, with or without integer subscript (e.g., n, n1, n_1).
- Use named physical constants (e.g., 'speed of light') without numerical substitution.
- Include a space between compound units (e.g., "Ω m" for "ohm*meter").
- To solve for a variable in an equation with units, consider solving a corresponding equation without units; exclude counting units (e.g., books), include genuine units (e.g., kg).
- If data for multiple properties is needed, make separate calls for each property.
- If a WolframAlpha result is not relevant to the query:
 -- If Wolfram provides multiple 'Assumptions' for a query, choose the more relevant one(s) without explaining the initial result. If you are unsure, ask the user to choose.
 -- Re-send the exact same 'input' with NO modifications, and add the 'assumption' parameter, formatted as a list, with the relevant values.
 -- ONLY simplify or rephrase the initial query if a more relevant 'Assumption' or other input suggestions are not provided.
 -- Do not explain each step unless user input is needed. Proceed directly to making a better API call based on the available assumptions.
Múltiplas Encarnações
O NeoCoder suporta múltiplas "encarnações" - diferentes modos operacionais que adaptam o sistema para casos de uso especializados, preservando a estrutura central do grafo Neo4j. Em uma pilha nativa de grafos, o mesmo núcleo Neo4j pode se manifestar como "cérebros" muito diferentes simplesmente trocando modelos e políticas de execução.
Princípios Arquiteturais Chave
A divisão do NeoCoder é altamente adaptável porque:
- O Neo4j armazena fatos como objetos de grafo de primeira classe
- Os fluxos de trabalho vivem em nós de modelo
- Os mecanismos de execução simplesmente percorrem o grafo
Como esses três níveis são ortogonais, você pode congelar uma camada enquanto transforma as outras—transformando um depurador de código hoje em um caderno de laboratório ou um sistema de gerenciamento de aprendizado amanhã. Este design ecoa o próprio caminho de maturação do Neo4j "do grafo ao grafo de conhecimento", onde esquema, semântica e operações são deliberadamente desacoplados.
Motivos Comuns de Esquema de Grafo
Todas as encarnações compartilham estes elementos centrais:
| Elemento | Sempre presente | Rótulos / relacionamentos típicos |
|---|---|---|
| Ator | humano / agente / ferramenta | (:Agent)-[:PLAYS_ROLE]->(:Role) |
| Intenção | hipótese, decisão, lição, cenário | (:Intent {type}) |
| Evidência | documento, métrica, observação | (:Evidence)-[:SUPPORTS]->(:Intent) |
| Resultado | aprovação/reprovação, retorno, nota, vetor de estado | (:Outcome)-[:RESULT_OF]->(:Intent) |
Encarnações Disponíveis:
- base_incarnation (padrão) - Gerenciamento de fluxo de trabalho original do NeoCoder, Ferramentas, Modelos e Encarnações
- research_incarnation - Plataforma de pesquisa científica para rastreamento de hipóteses e experimentos
- Registre hipóteses, projete experimentos, capture execuções e publique resultados
- O Neo4j sustenta pilotos de proveniência para fluxos de trabalho de laboratório com consultas de linhagem
- decision_incarnation - Sistema de análise de decisão e rastreamento de evidências
- Crie alternativas de decisão com métricas de valor esperado
- Agentes atualizadores bayesianos recalculam os posteriores das métricas quando novas evidências chegam
- Pipelines de raciocínio transparentes e explicáveis
- data_analysis_incarnation - Modelagem e simulação de sistemas complexos
- Modele componentes com vetores de estado e acoplamentos físicos
- Simule propagação de falhas usando consultas de caminho
- Agendador opcional inspirado em quântica para teste de parâmetros
- knowledge_graph_incarnation - Sistema Avançado de Raciocínio Híbrido
- Consultas Híbridas de Conhecimento: Combine dados estruturados do Neo4j com busca semântica do Qdrant
- Extração Dinâmica de Conhecimento: Processe documentos em representações de grafo e vetor
- Síntese por F-Contração: Mescle inteligentemente conceitos semelhantes preservando a atribuição de origem
- Raciocínio Baseado em Citações: Rastreamento completo de fontes em múltiplos bancos de dados
- Mecanismo de Análise de Pesquisa: Fluxos de trabalho especializados para processamento de artigos acadêmicos
- Roteamento Inteligente de Consultas: A IA determina automaticamente a estratégia ideal de fonte de dados
- Navegação entre Bancos de Dados: Conexão perfeita entre fatos estruturados e conteúdo semântico
- Detecção de Conflitos: Identifique e sinalize inconsistências entre fontes
- Síntese de Conhecimento em Tempo Real: Construção dinâmica de grafos a partir de conversas e documentos
- code_analysis_incarnation - Análise de código usando Árvores Sintáticas Abstratas
- Analise e analise a estrutura do código usando ferramentas AST e ASG
- Rastreie métricas de complexidade e qualidade do código
- Compare diferentes versões do código
- Gere documentação a partir da análise de código
- Identifique code smells e problemas potenciais
Cada encarnação fornece seu próprio conjunto de ferramentas especializadas que são registradas automaticamente quando o servidor inicia. Essas ferramentas estão disponíveis para uso no Claude ou em outros assistentes de IA que se conectam ao servidor MCP.
Roteiro de Implementação
O NeoCoder apresenta um roteiro de implementação que inclui:
- Adaptador LevelEnv ↔ Neo4j: Mapeia eventos para estruturas de grafo e lida com operações em lote
- Registro de Amplitude (Camada Quântica): Camada opcional inspirada em quântica para estados de superposição
- Agendador: Prioriza tarefas com base em entropia e pontuações de impacto
- Reutilização de ativos TAG: Aproveita abstrações existentes para ocultação vertical de informações
Iniciando com uma Encarnação Específica
# List all available incarnations
python -m mcp_neocoder.server --list-incarnations

# Start with a specific incarnation
python -m mcp_neocoder.server --incarnation continuous_learning
As encarnações também podem ser alternadas em tempo de execução usando a ferramenta switch_incarnation():
switch_incarnation(incarnation_type="complex_system")
Carregamento Dinâmico de Encarnações
O NeoCoder apresenta um sistema de carregamento totalmente dinâmico de encarnações, que descobre e carrega automaticamente encarnações do diretório incarnations. Isso significa:
- Sem imports fixos no código: Novas encarnações podem ser adicionadas sem modificar o server.py
- Descoberta automática: Basta adicionar um novo arquivo com o formato
*_incarnation.pyao diretório de encarnações - Todas as ferramentas disponíveis: Ferramentas de todas as encarnações são registradas e disponibilizadas, mesmo que a encarnação não esteja ativa
- Extensão fácil: Crie novas encarnações com o modelo fornecido
Criando uma Nova Encarnação
Para criar uma nova encarnação:
- Crie um novo arquivo no diretório
src/mcp_neocoder/incarnations/com o padrão de nomenclaturayour_incarnation_name_incarnation.py - Use esta estrutura de modelo:
"""
Your incarnation name and description
"""

import json
import logging
import uuid
from typing import Dict, Any, List, Optional, Union

import mcp.types as types
from pydantic import Field
from neo4j import AsyncTransaction

from .polymorphic_adapter import BaseIncarnation, IncarnationType

logger = logging.getLogger("mcp_neocoder.incarnations.your_incarnation_name")


class YourIncarnationNameIncarnation(BaseIncarnation):
    """
    Your detailed incarnation description here
    """

    # Define the incarnation type - must match an entry in IncarnationType enum
    incarnation_type = IncarnationType.YOUR_INCARNATION_TYPE

    # Metadata for display in the UI
    description = "Your incarnation short description"
    version = "0.1.0"

    # Initialize schema and add tools here
    async def initialize_schema(self):
        """Initialize the schema for your incarnation."""
        # Implementation...

    # Add more tool methods below
    async def your_tool_name(self, param1: str, param2: Optional[int] = None) -> List[types.TextContent]:
        """Tool description."""
        # Implementation...
- Adicione seu tipo de encarnação ao enum
IncarnationTypeempolymorphic_adapter.py - Reinicie o servidor, e sua nova encarnação será descoberta automaticamente
Consulte incarnations.md para documentação detalhada sobre como usar e criar encarnações.
Modelos Disponíveis
O NeoCoder vem com estes modelos padrão:
- FIX - Orientação para corrigir um bug relatado, incluindo testes e registro de logs obrigatórios
- REFACTOR - Abordagem estruturada para refatorar código mantendo a funcionalidade
- DEPLOY - Orientação para implantar código em ambientes de produção com verificações de segurança
- FEATURE - Abordagem estruturada para implementar novos recursos com testes e documentação adequados
- TOOL_ADD - Processo para adicionar novas funcionalidades de ferramentas ao servidor MCP NeoCoder
- CYPHER_SNIPPETS - Gerenciar e usar snippets de Cypher para consultas Neo4j
- CODE_ANALYZE - Fluxo de trabalho estruturado para analisar código usando ferramentas AST e ASG
- KNOWLEDGE_QUERY - Sistema Híbrido de Consulta de Conhecimento para raciocínio inteligente multi-fonte
- KNOWLEDGE_EXTRACT - Extração Dinâmica de Conhecimento e Síntese com mesclagem F-Contraction
Sistema Avançado de Raciocínio Híbrido
O NeoCoder apresenta uma arquitetura revolucionária de Raciocínio Aumentado por Contexto que combina múltiplas fontes de dados para capacidades de síntese de conhecimento sem precedentes.
Arquitetura de Consulta Híbrida
O modelo KNOWLEDGE_QUERY implementa um sofisticado processo de raciocínio em 3 etapas:
Etapa 1: Roteador Inteligente de Consultas
- Classificação de Intenção: A IA analisa consultas para determinar a estratégia ideal de fonte de dados
- Tipos de Consulta:
- Centrada em Grafo: "Quem trabalha com quem?", "Mostrar cadeia de dependências"
- Centrada em Vetores: "Quais são as opiniões sobre X?", "Encontrar discussões sobre Y"
- Híbrida: "O que [pessoa do grafo] disse sobre [tópico semântico]?"
- Planejamento de Execução: Projeta planos de múltiplas etapas para consultas híbridas complexas
Etapa 2: Recuperação de Dados em Paralelo
- Consultas Neo4j: Executa consultas Cypher para fatos estruturados e relacionamentos
- Buscas Qdrant: Realiza buscas semânticas em coleções de documentos
- Otimização Sequencial: Para consultas híbridas, usa resultados do grafo para refinar buscas vetoriais
Etapa 3: Sintetizador Entre Bancos de Dados
- Síntese Inteligente: Combina fatos estruturados com contexto semântico
- Priorização de Fontes: Fatos do Neo4j como autoritativos, Qdrant para nuances e opiniões
- Citações Obrigatórias: Cada afirmação atribuída a fontes específicas
- Detecção de Conflitos: Identifica e sinaliza inconsistências entre fontes de dados
Extração Dinâmica de Conhecimento (F-Contraction)
O modelo KNOWLEDGE_EXTRACT implementa síntese dinâmica de conhecimento inspirada em princípios de contração de grafos:
Conceitos Centrais de F-Contraction:
- Vértices como Conceitos: Cada conceito distinto torna-se uma entidade de grafo
- Arestas como Relacionamentos: Rastreia co-ocorrência e conexões explícitas
- Mesclagem Dinâmica: Detecção impulsionada por LLM de conceitos duplicados/semelhantes
- Preservação de Fontes: Mantém ponteiros para todas as fontes originais após a mesclagem
Pipeline de Processamento de Conhecimento:
- Ingestão de Documentos: Analisa PDFs, texto, código, conversas
- Armazenamento Duplo: Divide texto para Qdrant, extrai entidades para Neo4j
- Extração de Entidades: Identifica Artigos, Autores, Conceitos, Métodos, etc.
- Descoberta de Relacionamentos: Encontra citações, dependências, conexões semânticas
- Mesclagem F-Contraction: Consolida inteligentemente entidades semelhantes
- Mapeamento de Referências Cruzadas: Vincula entidades do grafo a blocos de documentos vetoriais
- Validação de Qualidade: Garante consistência e completude
Mecanismo de Análise de Pesquisa
Capacidades especializadas para processamento de documentos acadêmicos e técnicos:
- Construção de Grafo de Citações: Cria redes de relacionamentos entre artigos
- Raciocínio Multi-Salto: "Rastrear evolução da arquitetura transformer através de links de citação"
- Análise de Conflitos: "Como a definição de X no Artigo A difere do Artigo B?"
- Síntese Temporal: Rastreia evolução de conceitos ao longo do tempo e fontes
- Integração Entre Domínios: Combina descobertas de múltiplos domínios de pesquisa
Benefícios do Raciocínio Híbrido
- Síntese Sem Precedentes: Respostas impossíveis com fontes de dados únicas
- Transparência de Fontes: Trilha de auditoria completa de dados brutos a conclusões
- Consciência de Conflitos: Tratamento explícito de informações contraditórias
- Enriquecimento Semântico: Fatos estruturados aprimorados com compreensão contextual
- Aprendizado Dinâmico: Base de conhecimento melhora através da mesclagem F-Contraction
- Aceleração de Pesquisa: Análise rápida de literatura acadêmica complexa
Arquitetura
Estrutura do Grafo de Conhecimento
- :AiGuidanceHub: Hub central de navegação para a IA
- :ActionTemplate: Modelos para fluxos de trabalho padrão (FIX, REFACTOR, etc.)
- :Project: Dados do projeto incluindo README e estrutura
- :File/Directory: Representação da estrutura de arquivos do projeto
- :WorkflowExecution: Trilha de auditoria de fluxos de trabalho concluídos
- :BestPracticesGuide: Padrões e diretrizes de codificação
- :TemplatingGuide: Como criar/modificar modelos
- :SystemUsageGuide: Como usar o sistema de grafo
Ferramentas do Servidor MCP
O servidor MCP fornece as seguintes ferramentas para assistentes de IA:
Ferramentas Principais
- check_connection: Verifica o status da conexão Neo4j
- get_guidance_hub: Ponto de entrada para navegação da IA
- get_action_template: Obtém um modelo de fluxo de trabalho específico
- list_action_templates: Vê todos os modelos disponíveis
- get_best_practices: Visualiza padrões de codificação
- get_project: Visualiza detalhes do projeto incluindo README
- list_projects: Lista todos os projetos no sistema
- log_workflow_execution: Registra uma conclusão bem-sucedida de fluxo de trabalho
- get_workflow_history: Visualiza trilha de auditoria do trabalho realizado
- add_template_feedback: Fornece feedback sobre modelos
- run_custom_query: Executa consultas Cypher diretas
- write_neo4j_cypher: Executa operações de escrita no grafo
Ferramentas de Gerenciamento de Encarnações
- get_current_incarnation: Obtém a encarnação atualmente ativa
- list_incarnations: Lista todas as encarnações disponíveis
- switch_incarnation: Alterna para uma encarnação diferente
- suggest_tool: Obtém sugestões de ferramentas com base na descrição da tarefa
Cada encarnação fornece ferramentas especializadas adicionais que são registradas automaticamente quando a encarnação é ativada.
Ferramentas de Grafo de Conhecimento e Raciocínio Híbrido
A encarnação de Grafo de Conhecimento fornece capacidades avançadas de raciocínio híbrido que combinam dados estruturados de grafo com busca semântica vetorial:
Gerenciamento Principal de Conhecimento:
- create_entities: Cria múltiplas entidades com observações e rotulagem Neo4j adequada
- create_relations: Conecta entidades com relacionamentos tipados e carimbos de tempo
- add_observations: Adiciona observações com carimbo de tempo a entidades existentes
- delete_entities: Remove entidades com exclusão em cascata de relacionamentos
- delete_observations: Remoção direcionada de conteúdo específico de observações
- delete_relations: Remove relacionamentos específicos preservando entidades
- read_graph: Visualiza todo o grafo de conhecimento com entidades, observações e relacionamentos
- search_nodes: Busca em texto completo por nomes de entidades, tipos e conteúdo de observações
- open_nodes: Obtém informações detalhadas de entidades com relacionamentos de entrada/saída
Ferramentas Avançadas de Raciocínio Híbrido:
-
Fluxo de Trabalho KNOWLEDGE_QUERY: Sistema inteligente de consulta híbrida
- Roteamento inteligente de consultas (centrado em grafo, vetor ou híbrido)
- Recuperação de dados em paralelo do Neo4j e Qdrant
- Síntese entre bancos de dados com rastreamento obrigatório de citações
- Detecção de conflitos e priorização de fontes
-
Fluxo de Trabalho KNOWLEDGE_EXTRACT: Extração dinâmica de conhecimento com F-Contraction
- Ingestão de documentos com extração de metadados
- Armazenamento duplo: blocos de texto no Qdrant, entidades no Neo4j
- Extração de entidades e descoberta de relacionamentos impulsionadas por LLM
- Mesclagem F-Contraction de conceitos semelhantes com preservação de fontes
- Mapeamento de referências cruzadas entre dados de grafo e vetoriais
- Validação de qualidade e relatório de extração
Capacidades de Análise de Pesquisa:
- Construção de Grafo de Citações: Cria redes artigo-autor-instituição
- Síntese Multi-Salto: Rastreia evolução de conceitos através de fontes conectadas
- Análise Temporal: Rastreia mudanças e desenvolvimentos ao longo do tempo
- Resolução de Conflitos: Lida com informações contraditórias de múltiplas fontes
- Atribuição de Fontes: Rastreamento completo de proveniência de dados brutos a conclusões
Recursos de Integração:
- Coleções Qdrant: Integração perfeita com bancos de dados vetoriais para busca semântica
- Navegação Entre Bancos de Dados: Vinculação bidirecional entre dados estruturados e semânticos
- Integração de Memória: Conecta-se a sistemas de memória de longo prazo para continuidade
- Orquestração MCP: Coordenação avançada de ferramentas e gerenciamento de fluxos de trabalho
Kit de Ferramentas de Snippets Cypher
O servidor MCP inclui um kit de ferramentas para gerenciar e pesquisar snippets de consultas Cypher:
- list_cypher_snippets: Lista todos os snippets Cypher disponíveis com filtragem opcional
- get_cypher_snippet: Obtém um snippet Cypher específico por ID
- search_cypher_snippets: Pesquisa snippets Cypher por palavra-chave, tag ou padrão
- create_cypher_snippet: Adiciona um novo snippet Cypher ao banco de dados
- update_cypher_snippet: Atualiza um snippet Cypher existente
- delete_cypher_snippet: Exclui um snippet Cypher do banco de dados
- get_cypher_tags: Obtém todas as tags usadas para snippets Cypher
Este kit de ferramentas fornece um repositório pesquisável de padrões e exemplos de consultas Cypher que podem ser usados como referência e ferramenta de aprendizado.
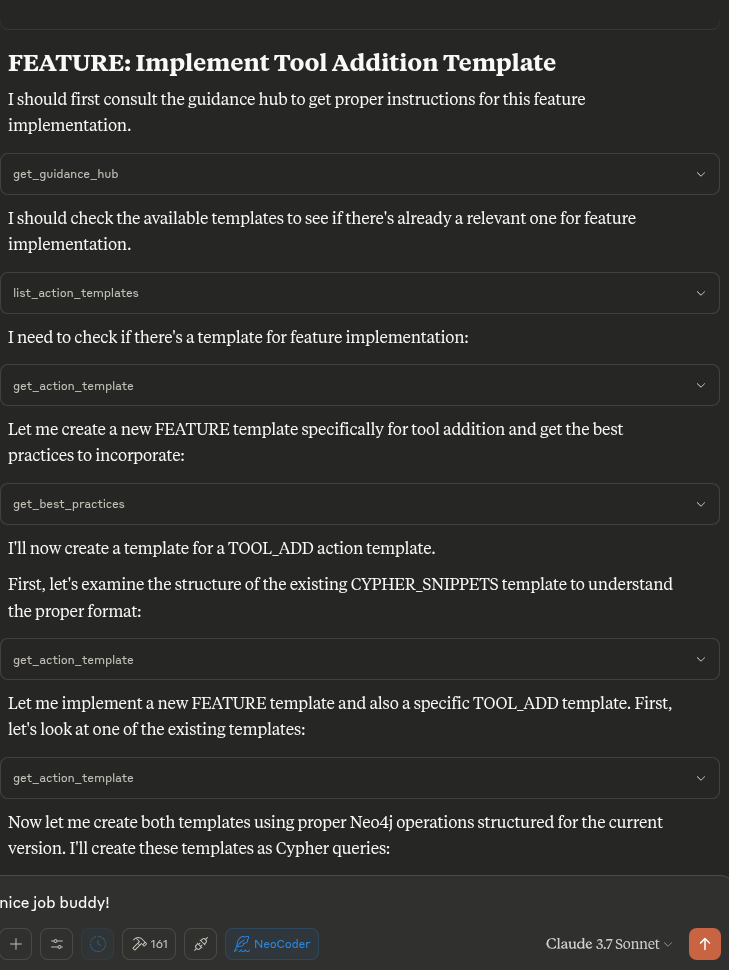
Sistema de Proposta de Ferramentas
O servidor MCP inclui um sistema para propor e solicitar novas ferramentas:
- propose_tool: Propõe uma nova ferramenta para o sistema NeoCoder
- request_tool: Solicita um novo recurso de ferramenta como usuário
- get_tool_proposal: Obtém detalhes de uma proposta de ferramenta específica
- get_tool_request: Obtém detalhes de uma solicitação de ferramenta específica
- list_tool_proposals: Lista todas as propostas de ferramentas com filtragem opcional
- list_tool_requests: Lista todas as solicitações de ferramentas com filtragem opcional
Este sistema permite que assistentes de IA sugiram novas ferramentas e que usuários solicitem novas funcionalidades, fornecendo uma maneira estruturada de gerenciar e rastrear solicitações de recursos.
Personalizando Modelos
Os modelos são armazenados no diretório templates como arquivos .cypher. Você pode editar modelos existentes ou criar novos.
Para adicionar um novo modelo:
- Crie um novo arquivo no diretório
templates(por exemplo,custom_template.cypher) - Siga o formato dos modelos existentes
- Inicialize o banco de dados para carregar o modelo no Neo4j
As ferramentas do 'Kit de Ferramentas de Snippets Cypher' operam na estrutura de grafo definida abaixo
Abaixo está um kit de ferramentas consolidado, pronto para a série Neo4j 5, que você pode colar diretamente no Neo4j Browser, shell Cypher ou qualquer driver.
Ele cria um grafo de mini-documentação onde cada nó (:CypherSnippet) armazena um trecho de sintaxe Cypher, um exemplo e metadados; índices de texto e (opcionalmente) vetoriais tornam os snippets instantaneamente pesquisáveis por palavras-chave simples ou embeddings.
1 · Esquema e restrições de segurança
// 1-A Uniqueness for internal IDs
CREATE CONSTRAINT cypher_snippet_id IF NOT EXISTS
FOR   (c:CypherSnippet)
REQUIRE c.id IS UNIQUE;            // Neo4j 5 syntax

// 1-B Optional tag helper (one Tag node per word/phrase)
CREATE CONSTRAINT tag_name_unique IF NOT EXISTS
FOR   (t:Tag)
REQUIRE t.name IS UNIQUE;
2 · Índices que alimentam a busca
// 2-A Quick label/property look-ups
CREATE LOOKUP INDEX snippetLabelLookup IF NOT EXISTS
FOR (n) ON EACH labels(n);

// 2-B Plain-text index (fast prefix / CONTAINS / = queries)
CREATE TEXT INDEX snippet_text_syntax IF NOT EXISTS
FOR (c:CypherSnippet) ON (c.syntax);

CREATE TEXT INDEX snippet_text_description IF NOT EXISTS
FOR (c:CypherSnippet) ON (c.description);

// 2-C Full-text scoring index (tokenised, ranked search)
CREATE FULLTEXT INDEX snippet_fulltext IF NOT EXISTS
FOR (c:CypherSnippet) ON EACH [c.syntax, c.example];

// 2-D (OPTIONAL) Vector index for embeddings ≥Neo4j 5.15
CREATE VECTOR INDEX snippet_vec IF NOT EXISTS
FOR (c:CypherSnippet) ON (c.embedding)
OPTIONS {indexConfig: {
  `vector.dimensions`: 384,
  `vector.similarity_function`: 'cosine'
}};
Se sua versão for ≤5.14, chame db.index.vector.createNodeIndex em vez disso.
3 · Modelo para armazenar um snippet
:params {
  snippet: {
    id:         'create-node-basic',
    name:       'CREATE node (basic)',
    syntax:     'CREATE (n:Label {prop: $value})',
    description:'Creates a single node with one label and properties.',
    example:    'CREATE (p:Person {name:$name, age:$age})',
    since:      5.0,
    tags:       ['create','insert','node']
  }
}

// 3-A MERGE guarantees idempotence
MERGE (c:CypherSnippet {id:$snippet.id})
SET   c += $snippet
WITH  c, $snippet.tags AS tags
UNWIND tags AS tag
  MERGE (t:Tag {name:tag})
  MERGE (c)-[:TAGGED_AS]->(t);
Mapas de parâmetros mantêm o código reutilizável e evitam a recompilação do plano de consulta.
4 · Como pesquisar
4-A Correspondência exata / por prefixo via índice TEXT
MATCH (c:CypherSnippet)
WHERE c.name STARTS WITH $term      // fast TEXT index hit
RETURN c.name, c.syntax, c.example
ORDER BY c.name;
4-B Pesquisa de texto completo classificada
CALL db.index.fulltext.queryNodes(
  'snippet_fulltext',               // index name
  $q                                // raw search string
) YIELD node, score
RETURN node.name, node.syntax, score
ORDER BY score DESC
LIMIT 10;
4-C Similaridade de embeddings (pesquisa vetorial)
WITH $queryEmbedding AS vec
CALL db.index.vector.queryNodes(
  'snippet_vec', 5, vec            // top-5 cosine hits
) YIELD node, similarity
RETURN node.name, node.syntax, similarity
ORDER BY similarity DESC;
5 · Atualizando ou excluindo trechos
// 5-A Edit description
MATCH (c:CypherSnippet {id:$id})
SET   c.description = $newText,
      c.lastUpdated = date()
RETURN c;

// 5-B Remove a snippet cleanly
MATCH (c:CypherSnippet {id:$id})
DETACH DELETE c;
Ambas as operações mantêm automaticamente a consistência do índice – nenhum trabalho extra é necessário.
6 · Exportação / importação em massa (APOC)
CALL apoc.export.cypher.all(
  'cypher_snippets.cypher',
  {useOptimizations:true, format:'cypher-shell'}
);
Isso grava Cypher pronto para compartilhamento que pode ser reproduzido com cypher-shell < cypher_snippets.cypher.
Resumo rápido de início
- Execute as Seções 1 e 2 uma vez por banco de dados para configurar restrições e índices.
- Use a Seção 3 (orientada por parâmetros) para adicionar novas entradas de documentação.
- Consulte com a Seção 4 e, opcionalmente, adicione pesquisa vetorial se você armazenar embeddings.
- Faça backup ou publique com a Seção 6.
Com esses blocos de construção, você agora tem uma "cola de Cypher dentro do Cypher" viva e pesquisável, que permanece sempre local, versionável e extensível. Aproveite a recuperação sem atrito à medida que seu repertório de consultas cresce!
Nota: Uma versão de referência completa desta documentação, que preserva toda a formatação original, está disponível no arquivo /docs/cypher_snippets_reference.md.
Criado por angrysky56 Claude 3.7 Sonnet Gemini 2.5 Pro Preview 3-25 ChatGPT o3
Análise de Código
Uma análise abrangente do codebase do NeoCoder está disponível no diretório /analysis. Isso inclui:
- Visão geral da arquitetura
- Análise do sistema de encarnação
- Métricas de código e estrutura
- Análise de modelos de fluxo de trabalho
- Pontos de integração
- Recomendações para desenvolvimento futuro
Atualizações Recentes
2025-06-24: Sistema Revolucionário de Raciocínio Híbrido (v2.0.0)
- AVANÇO: Implementada arquitetura de Raciocínio Aumentado por Contexto combinando Neo4j + Qdrant + síntese por LLM
- NOVO: Modelo de ação
KNOWLEDGE_QUERY- sistema de raciocínio híbrido em 3 etapas:- Roteador Inteligente de Consultas: IA classifica a intenção e planeja a estratégia de execução
- Recuperação de Dados Paralelizada: Consulta perfeitamente tanto o Neo4j quanto o Qdrant
- Sintetizador entre Bancos de Dados: Síntese inteligente com rastreamento obrigatório de citações
- NOVO: Modelo de ação
KNOWLEDGE_EXTRACT- síntese de conhecimento por F-Contração:- Processamento dinâmico de documentos em representações de grafo e vetoriais
- Extração de entidades e descoberta de relacionamentos com tecnologia LLM
- Mesclagem inteligente de conceitos preservando a atribuição de origem
- Mapeamento de referências cruzadas entre dados estruturados e semânticos
- MELHORADO: Encarnação do Knowledge Graph com capacidades híbridas avançadas:
- Corrigidos erros de transação do hub de orientação para uma experiência de usuário perfeita
- Implementados fluxos de trabalho sofisticados de análise de pesquisa
- Adicionada detecção de conflitos e priorização de fontes
- Integração completa com bancos de dados vetoriais Qdrant para pesquisa semântica
- ARQUITETURA: Estabelecida a base para o Raciocínio Aumentado por Contexto que vai muito além do RAG tradicional
- VALIDAÇÃO: Testado com sucesso com um corpus real de artigos de pesquisa demonstrando grafos de citação + análise semântica
- IMPACTO: Permite síntese de conhecimento sem precedentes, impossível com fontes de dados únicas
2025-06-14: Corrigidos Problemas Críticos de Async/Gerenciamento do Event Loop (v1.4.1)
- CORREÇÃO CRÍTICA: Resolvidos erros de protocolo do gerenciador de contexto assíncrono na função
safe_neo4j_session - Causa Raiz: AsyncMock em testes e algumas configurações de driver retornavam corrotinas em vez de gerenciadores de contexto assíncronos
- Solução: Adicionada função auxiliar
_handle_session_creationpara detectar e tratar corretamente tanto corrotinas quanto gerenciadores de contexto - Impacto: Elimina erros "TypeError: 'coroutine' object does not support the asynchronous context manager protocol"
- Testes: Adicionada suíte de testes abrangente (
test_event_loop_fix.py) para prevenir regressões - Compatibilidade: Mantém total compatibilidade retroativa com o uso existente do driver Neo4j
- Arquivos Modificados:
src/mcp_neocoder/event_loop_manager.py,tests/test_event_loop_fix.py
2025-04-27: Adicionada Encarnação de Análise de Código com Suporte AST/ASG (v1.4.0)
- Adicionado novo
code_analysis_incarnation.pypara análise profunda de código usando ferramentas AST e ASG - Implementado esquema Neo4j para armazenar estrutura de código e resultados de análise
- Adicionado modelo de ação CODE_ANALYZE com fluxo de trabalho passo a passo
- Criadas ferramentas especializadas para análise de código:
analyze_codebase: Analisar estruturas de diretórios inteirasanalyze_file: Análise profunda de arquivos individuaiscompare_versions: Comparar diferentes versões de códigofind_code_smells: Identificar possíveis problemas de códigogenerate_documentation: Gerar automaticamente documentação de códigoexplore_code_structure: Navegar pela estrutura do códigosearch_code_constructs: Encontrar padrões específicos no código
- Integrado com ferramentas externas AST/ASG
- Adicionada documentação adequada no hub de orientação
- Atualizado o enum IncarnationType para incluir o tipo CODE_ANALYSIS
2025-04-27: Eliminadas Mensagens de Erro de Transação do Knowledge Graph (v1.3.2)
- Eliminadas completamente as mensagens de erro relacionadas a problemas de escopo de transação nas funções do knowledge graph
- Implementada interceptação e substituição de mensagens de erro no lado do servidor para uma experiência de usuário mais suave
- Adicionado um novo padrão de execução mais seguro para todas as operações de banco de dados:
- Criado método
_safe_execute_writepara eliminar erros de escopo de transação em operações de escrita - Criado método
_safe_read_querypara garantir o tratamento adequado de transações em operações de leitura - Melhorado o rastreamento de contagem de entidades para feedback preciso das operações
- Criado método
- Melhorada a recuperação de erros para continuar operações mesmo quando a análise JSON falha
- Simplificadas e melhoradas todas as implementações de ferramentas do knowledge graph
- Mantida total compatibilidade retroativa com dados existentes do knowledge graph
- Aprimorado o hub de orientação com exemplos de uso mais claros
2025-04-27: Corrigidos Problemas de Escopo de Transação do Knowledge Graph (v1.3.1)
- Corrigido problema crítico com funções do knowledge graph retornando erros "transaction out of scope"
- Implementada abordagem segura para transações em todas as operações do knowledge graph
- Atualizadas todas as ferramentas do knowledge graph para tratar adequadamente os contextos de transação:
- Corrigido
create_entitiespara retornar resultados adequadamente - Corrigido
create_relationscom abordagem simplificada - Corrigido
add_observationspara garantir que os dados sejam confirmados - Corrigidas as funções
delete_entities,delete_observationsedelete_relations - Corrigido
read_graphpara buscar dados em múltiplas transações seguras - Corrigido
search_nodescom abordagem de consulta mais robusta - Corrigido
open_nodespara consultar detalhes de entidades com segurança
- Corrigido
- Aprimorado o hub de orientação com exemplos claros de uso das ferramentas do knowledge graph
- Melhorado o tratamento de erros em todas as operações do knowledge graph
- Mantida compatibilidade retroativa com dados existentes do knowledge graph
2025-04-26: Corrigidas Funções da API do Knowledge Graph (v1.3.0)
- Corrigido o problema das funções da API do Knowledge Graph não se integrarem adequadamente ao sistema de rotulagem de nós do Neo4j
- Implementadas entidades devidamente rotuladas com o rótulo :Entity em vez do genérico :KnowledgeNode
- Adicionado conjunto completo de funções de gerenciamento do knowledge graph:
create_entities: Criar entidades com rotulagem e observações adequadascreate_relations: Conectar entidades com relacionamentos tipadosadd_observations: Adicionar observações a entidades existentesdelete_entities: Remover entidades e suas conexõesdelete_observations: Remover observações específicas de entidadesdelete_relations: Remover relacionamentos entre entidadesread_graph: Visualizar toda a estrutura do knowledge graphsearch_nodes: Encontrar entidades por nome, tipo ou conteúdo de observaçãoopen_nodes: Obter informações detalhadas sobre entidades específicas
- Adicionado suporte a pesquisa fulltext com fallback para ambientes sem fulltext
- Adicionada inicialização adequada de esquema com restrições e índices para o knowledge graph
- Atualizado o conteúdo do hub de orientação com instruções de uso para as novas funções da API
2025-04-25: Documentação Expandida de Encarnação (v1.2.0)
- Adicionada documentação detalhada sobre os princípios arquiteturais por trás de múltiplas encarnações
- Aprimorada a descrição de cada tipo de encarnação com padrões operacionais e casos de uso
- Adicionadas informações sobre motivos comuns de esquema de grafo entre encarnações
- Incluído roteiro de implementação para integrar abordagens inspiradas em computação quântica
2025-04-24: Corrigido Registro de Ferramentas de Encarnação (v1.1.0)
- Corrigido o problema em que as ferramentas de encarnação não eram registradas adequadamente na inicialização do servidor
- Corrigidos problemas de dependência circular com definições de classe duplicadas
- Adicionado suporte a declaração explícita de métodos de ferramenta via atributo de classe
_tool_methods - Melhorado o mecanismo de descoberta de ferramentas para garantir que todas as ferramentas de cada encarnação sejam detectadas adequadamente
- Aprimorado o tratamento do event loop para prevenir problemas durante a inicialização do servidor
- Adicionado registro abrangente para auxiliar na solução de problemas
- Corrigida a inicialização do esquema para adiar adequadamente até ser necessário
Consulte o arquivo CHANGELOG.md para notas detalhadas de implementação.
Licença
Licença MIT