MCP Context Server
Servidor que fornece armazenamento persistente de contexto multimodal para agentes LLM.
Documentação
MCP Context Server
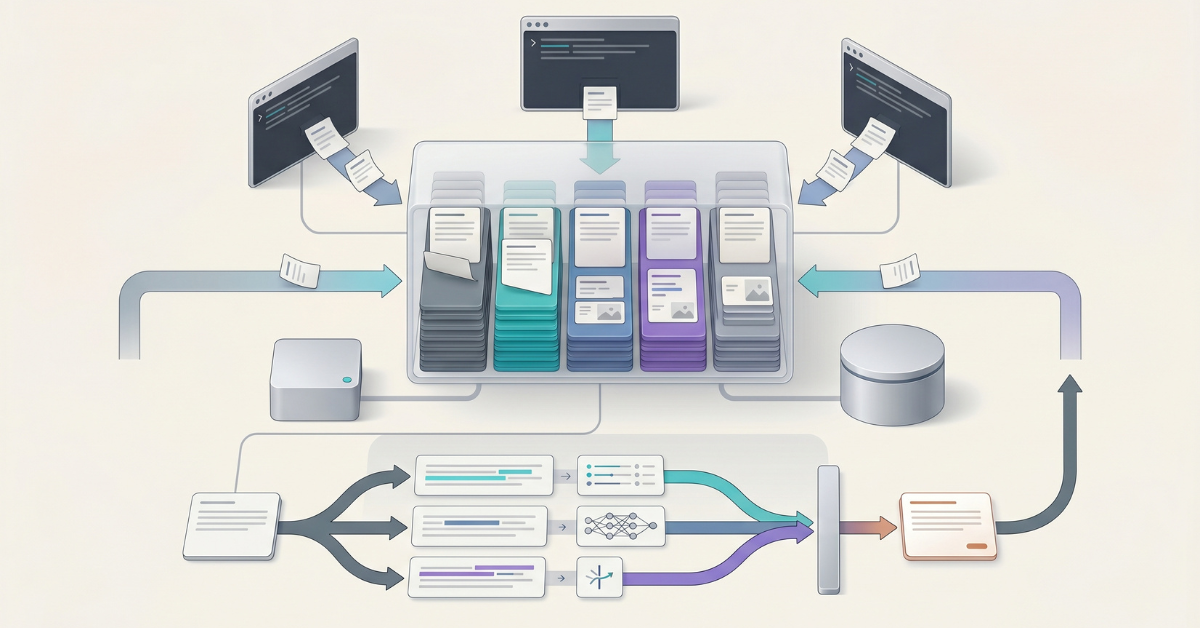



Um servidor MCP (Model Context Protocol) de alta performance que fornece armazenamento persistente de contexto multimodal para agentes LLM. Construído com FastMCP, este servidor permite o compartilhamento contínuo de contexto entre múltiplos agentes trabalhando na mesma tarefa por meio de escopo baseado em threads.
[!WARNING] Atualizando da v2.x? A versão 3.x.x usa um novo esquema de banco de dados com chaves primárias UUIDv7. Bancos de dados v2.x existentes exigem uma migração de dados única antes de poderem ser usados com a v3.x.x. A CLI opcional
mcp-context-server-migrateacompanha o servidor.Consulte o Guia de Migração antes de atualizar. Instalações novas não são afetadas.
Principais Recursos
- Armazenamento de Contexto Multimodal: Armazene e recupere texto e imagens
- Identificadores de Contexto UUIDv7: Cada entrada de contexto é identificada por um valor UUIDv7 hexadecimal de 32 caracteres em minúsculas, fornecendo IDs ordenados por tempo e globalmente únicos, com ordenação lexicográfica estável
- Escopo Baseado em Threads: Agentes trabalhando na mesma tarefa compartilham contexto por meio de IDs de thread
- Filtragem Flexível de Metadados: Armazene dados estruturados personalizados com qualquer campo serializável em JSON e filtre usando 16 operadores poderosos
- Filtragem por Intervalo de Datas: Filtre entradas de contexto pelo carimbo de data/hora de criação usando o formato ISO 8601
- Organização por Tags: Recuperação eficiente de contexto com tags normalizadas e indexadas
- Geração de Resumos: Geração automática opcional de resumos baseados em LLM retornados junto com
text_contenttruncados em todos os resultados das ferramentas de busca para melhor eficiência de contexto do agente (habilitada por padrão com Ollama) - Busca de Texto Completo: Busca linguística com stemming, ranqueamento, consultas booleanas (FTS5/tsvector) e re-ranqueamento com cross-encoder. Habilitada automaticamente por padrão (
ENABLE_FTS=auto); não requer dependências extras - Busca Semântica: Busca por similaridade vetorial para recuperação baseada em significado com re-ranqueamento por cross-encoder. Habilitada automaticamente por padrão (
ENABLE_SEMANTIC_SEARCH=auto) sempre que um provedor de embeddings estiver disponível (a geração de embeddings está ativada por padrão) - Busca Híbrida: Busca combinada FTS + semântica usando Fusão de Ranqueamento Recíproco (RRF) com re-ranqueamento por cross-encoder. Habilitada automaticamente por padrão (
ENABLE_HYBRID_SEARCH=auto) sempre que pelo menos uma das buscas (texto completo ou semântica) estiver disponível - Grep no Servidor: Correspondência de padrões literal/regex, orientada a linhas, sem ranqueamento, sobre registros armazenados (
grep_context) — o complemento de localização precisa para busca de texto completo/semântica, com modos de saída estilo ripgrep e resultados limitados. Habilitado automaticamente por padrão (ENABLE_GREP_CONTEXT=auto), 100% Python, comportando-se de forma idêntica em SQLite e PostgreSQL - Navegação de Registros (index_tree):
navigate_contextconstrói um sumário de títulos em Markdown sob demanda por registro, com o resumo da entrada como nó raiz; resumos LLM opcionais por nó (ativados por padrão) enriquecem cada seção. Combine comread_context_rangepara extrair qualquer seção - Leituras Parciais:
read_context_rangeretorna um trecho de um registro por intervalo de caracteres, intervalo de linhas ou esboçonode_id— permitindo que um agente leia apenas o trecho relevante de um registro longo em vez de tudo - Re-ranqueamento com Cross-Encoder: Refinamento automático de resultados usando modelos cross-encoder FlashRank para melhorar a precisão da busca (habilitado por padrão)
- Compressão de Embeddings (padrão ATIVADO): Reduz o armazenamento de embeddings em aproximadamente 8x imediatamente na v3.0.0. Vetores compactados com bits preservam a busca semântica e híbrida sem alterações na superfície das ferramentas, e o caminho de leitura contorna o limite HNSW de >2000 dimensões do pgvector. Defina
ENABLE_EMBEDDING_COMPRESSION=falsepara optar por sair e manter o armazenamento fp32. Consulte o Guia de Compressão de Embeddings - Múltiplos Backends de Banco de Dados: Escolha entre SQLite (padrão, sem configuração) ou PostgreSQL (alta concorrência, nível de produção)
- Alta Performance: Modo WAL (SQLite) / MVCC (PostgreSQL), indexação estratégica e operações assíncronas
- Conformidade com o Padrão MCP: Funciona com Claude Code, LangGraph e qualquer cliente compatível com MCP
- Pronto para Produção: Cobertura abrangente de testes, segurança de tipos e tratamento robusto de erros
Conectando ao Seu Assistente de IA
A maneira mais rápida de conectar o MCP Context Server ao Claude Code é o bootstrap Docker de um comando.
Para instruções passo a passo, pré-requisitos, solução de problemas e comandos de atualização/desinstalação, consulte o Guia de Conexão ao Seu Assistente de IA.
Configuração de Ambiente
O servidor é totalmente configurado por meio de variáveis de ambiente, com suporte a configurações principais, transporte, autenticação, provedores de embeddings, geração de resumos, recursos de busca, ajuste de banco de dados e muito mais. As variáveis podem ser definidas na configuração do seu cliente MCP, em um arquivo .env ou diretamente no shell.
Para a referência completa de todas as variáveis de ambiente com tipos, padrões, restrições e descrições, consulte a Referência de Variáveis de Ambiente.
Geração de Resumos
A geração de resumos cria automaticamente resumos concisos baseados em LLM para cada entrada de contexto armazenada. Os resumos são retornados no campo summary de todos os resultados das ferramentas de busca, juntamente com text_content truncados, fornecendo resumos densos e informativos que ajudam os agentes a determinar a relevância sem buscar entradas completas.
Para instruções detalhadas, incluindo todos os provedores (Ollama, OpenAI, Anthropic), seleção de modelos e configuração de prompts personalizados, consulte o Guia de Geração de Resumos.
Busca Semântica
A busca semântica é habilitada automaticamente por padrão (ENABLE_SEMANTIC_SEARCH=auto): a ferramenta semantic_search_context é registrada automaticamente sempre que um provedor de embeddings estiver disponível (a geração de embeddings está ativada por padrão) e é ignorada silenciosamente caso contrário. Para instruções detalhadas sobre os múltiplos provedores de embeddings (Ollama, OpenAI, Azure, HuggingFace, Voyage) e como controlar a alternância explicitamente, consulte o Guia de Busca Semântica.
Busca de Texto Completo
A busca de texto completo é habilitada automaticamente por padrão (ENABLE_FTS=auto) e não requer dependências extras, usando o mecanismo FTS integrado do banco de dados (FTS5 no SQLite, tsvector no PostgreSQL). Para processamento linguístico, stemming, ranqueamento e consultas booleanas, consulte o Guia de Busca de Texto Completo.
Busca Híbrida
A busca híbrida é habilitada automaticamente por padrão (ENABLE_HYBRID_SEARCH=auto): a ferramenta hybrid_search_context é registrada automaticamente sempre que pelo menos uma das buscas (texto completo ou semântica) estiver disponível. Para busca combinada FTS + semântica usando Fusão de Ranqueamento Recíproco (RRF), consulte o Guia de Busca Híbrida.
Filtragem de Metadados
Para filtragem abrangente de metadados, incluindo 16 operadores, caminhos JSON aninhados e otimização de performance, consulte o Guia de Metadados.
Backends de Banco de Dados
O servidor suporta múltiplos backends de banco de dados, selecionáveis por meio da variável de ambiente STORAGE_BACKEND. O SQLite (padrão) fornece armazenamento local sem configuração, perfeito para implantações de usuário único. O PostgreSQL oferece capacidades de alta performance com throughput de escrita 10x+ para implantações multiusuário e de alto tráfego.
Para instruções detalhadas de configuração, incluindo configuração do PostgreSQL com Docker, integração com Supabase, métodos de conexão e solução de problemas, consulte o Guia de Backends de Banco de Dados.
Referência da API
O MCP Context Server expõe 16 ferramentas MCP para gerenciamento de contexto:
Operações Principais: store_context, search_context, get_context_by_ids, delete_context, update_context, list_threads, get_statistics
Ferramentas de Busca: semantic_search_context, fts_search_context, hybrid_search_context
Ferramentas de Navegação (localizar / navegar / extrair): grep_context, navigate_context, read_context_range
Operações em Lote: store_context_batch, update_context_batch, delete_context_batch
Para documentação completa das ferramentas, incluindo parâmetros, valores de retorno, opções de filtragem e exemplos, consulte a Referência da API. Para saber quando usar grep vs. busca de texto completo vs. semântica, o index_tree e leituras parciais, consulte Grep, Navegação e Leituras Parciais.
Implantação com Docker
Para implantações de produção com transporte HTTP e orquestração de contêineres, configurações do Docker Compose estão disponíveis para SQLite, PostgreSQL e PostgreSQL externo (Supabase). Consulte o Guia de Implantação com Docker para instruções de configuração e detalhes de conexão do cliente.
Implantação com Kubernetes
Para implantações com Kubernetes, um chart Helm é fornecido com valores configuráveis para diferentes ambientes. Consulte o Guia de Implantação com Helm para instruções de instalação, ou o Guia de Implantação com Kubernetes para conceitos gerais de Kubernetes.
Autenticação
Para implantações com transporte HTTP que exigem autenticação, consulte o Guia de Autenticação para configuração de token bearer e JWT emitido por IdP.
Obtendo Ajuda
- Relatórios de bugs: Relatar um bug
- Solicitações de recursos: Sugerir um recurso
- Problemas de documentação: Relatar um problema de documentação
- Perguntas: Fazer uma pergunta
Licença
O MCP Context Server é licenciado sob a Elastic License 2.0 (ELv2).
Em resumo: você pode usar, copiar, modificar, distribuir e executar o software livremente e sem custo — para projetos pessoais, dentro de empresas de qualquer porte e como parte de trabalho comercial. A única coisa que você não pode fazer sem um acordo comercial é fornecer o software a terceiros como um serviço hospedado ou gerenciado que dê aos usuários acesso a qualquer conjunto substancial de seus recursos ou funcionalidades (por exemplo, uma oferta em nuvem de "memória para agentes" construída sobre ele).
Consulte Licenciamento Comercial para exemplos em linguagem simples do que é e do que não é permitido, e entre em contato com alexfeel@protonmail.com para licenciamento comercial, incluindo direitos de serviço hospedado ou gerenciado.
As versões até e incluindo a v2.2.2 foram publicadas sob a Licença MIT e permanecem disponíveis sob ela; a Elastic License 2.0 se aplica a partir da v3.0.0.