AiCore Project
Um framework unificado para integrar vários modelos de linguagem e provedores de embeddings para gerar conclusões de texto e embeddings.
Documentação
Projeto AiCore




✨ AiCore é um framework abrangente para integrar diversos provedores de modelos de linguagem e embeddings com uma interface unificada. Ele suporta operações síncronas e assíncronas para gerar conclusões de texto e embeddings, apresentando:
🔌 Suporte a múltiplos provedores: OpenAI, Mistral, Groq, Gemini, NVIDIA e outros 🤖 Aumento de raciocínio: Aprimore LLMs tradicionais com capacidades de raciocínio 📊 Observabilidade: Monitoramento e análise integrados 💰 Rastreamento de tokens: Métricas detalhadas de uso e rastreamento de custos ⚡ Implantação flexível: Suporte a Chainlit, FastAPI e scripts independentes 🛠️ Integração MCP: Conecte-se a servidores Model Control Protocol via chamada de ferramentas 🖥️ Provedor Claude Code: Use sua assinatura Claude localmente ou remotamente via Claude Agents Python SDK — sem necessidade de chave de API
Início Rápido
pip install git+https://github.com/BrunoV21/AiCore
ou
pip install git+https://github.com/BrunoV21/AiCore.git#egg=core-for-ai[all]
ou
pip install core-for-ai[all]
Faça sua Primeira Solicitação
Síncrono
from aicore.llm import Llm
from aicore.llm.config import LlmConfig
import os

llm_config = LlmConfig(
  provider="openai",
  model="gpt-4o",
  api_key="super_secret_openai_key"
)

llm = Llm.from_config(llm_config)

# Generate completion
response = llm.complete("Hello, how are you?")
print(response)
Assíncrono
from aicore.llm import Llm
from aicore.llm.config import LlmConfig
import os

async def main():
  llm_config = LlmConfig(
    provider="openai",
    model="gpt-4o",
    api_key="super_secret_openai_key"
  )

  llm = Llm.from_config(llm_config)

  # Generate completion
  response = await llm.acomplete("Hello, how are you?")
  print(response)

if __name__ == "__main__":
  asyncio.run(main())
mais exemplos disponíveis em examples/ e docs/exampes/
Principais Recursos
Suporte a Múltiplos Provedores
Provedores de LLM:
- Anthropic
- OpenAI
- Mistral
- Groq
- Gemini
- NVIDIA
- OpenRouter
- DeepSeek
- Claude Code (local — via Claude Agents Python SDK, sem necessidade de chave de API)
- Claude Code Remoto (remoto — conecta-se a um
aicore-proxy-servervia HTTP)
Provedores de Embeddings:
- OpenAI
- Mistral
- Groq
- Gemini
- NVIDIA
Ferramentas de Observabilidade:
- Rastreamento de operações e coleta de métricas
- Painel interativo para visualização
- Monitoramento de uso de tokens e latência
- Rastreamento de custos
Integração MCP:
- Conecte-se a múltiplos servidores MCP simultaneamente
- Descoberta e chamada automática de ferramentas
- Suporte a transportes WebSocket, SSE e stdio
Para configurar o aplicativo para testes, você precisa configurar um arquivo config.yml com as chaves de API e nomes de modelos necessários para cada provedor que pretende usar. A variável de ambiente CONFIG_PATH deve apontar para a localização deste arquivo. Aqui está um exemplo de como configurar o arquivo config.yml:
# config.yml
embeddings:
  provider: "openai" # or "mistral", "groq", "gemini", "nvidia"
  api_key: "your_openai_api_key"
  model: "text-embedding-3-small" # Optional

llm:
  provider: "openai" # or "mistral", "groq", "gemini", "nvidia"
  api_key: "your_openai_api_key"
  model: "gpt-o4" # Optional
  temperature: 0.1
  max_tokens: 1028
  reasonning_effort: "high"
  mcp_config: "./mcp_config.json" # Path to MCP configuration
  max_tool_calls_per_response: 3 # Optional limit on tool calls
exemplos de configuração para os múltiplos provedores estão incluídos no diretório config
Exemplo de Integração MCP
from aicore.llm import Llm
from aicore.config import Config
import asyncio

async def main():
    # Load configuration with MCP settings
    config = Config.from_yaml("./config/config_example_mcp.yml")

    # Initialize LLM with MCP capabilities
    llm = Llm.from_config(config.llm)

    # Make async request that can use MCP-connected tools
    response = await llm.acomplete(
        "Search for latest news about AI advancements",
        system_prompt="Use available tools to gather information"
    )
    print(response)

asyncio.run(main())
Exemplo de configuração MCP (mcp_config.json):
{
  "mcpServers": {
    "search-server": {
      "transport_type": "ws",
      "url": "ws://localhost:8080",
      "description": "WebSocket server for search functionality"
    },
    "data-server": {
      "transport_type": "stdio",
      "command": "python",
      "args": ["data_server.py"],
      "description": "Local data processing server"
    },
    "brave-search": {
      "command": "npx",
      "args": [
        "-y",
        "@modelcontextprotocol/server-brave-search"
      ],
      "env": {
        "BRAVE_API_KEY": "SUPER-SECRET-BRAVE-SEARCH-API-KEY"
      }
    }
  }
}
Provedor Claude Code
O AiCore suporta roteamento de conclusões através da sua assinatura Claude via Claude Agents Python SDK. Nenhuma chave de API Anthropic é necessária — a autenticação é tratada inteiramente pelo CLI do Claude Code. Isso é exposto através de dois provedores e um servidor proxy opcional:
| Componente | Descrição |
|---|---|
claude_code | Provedor local — executa o CLI do Claude Code na mesma máquina que o AiCore |
remote_claude_code | Provedor remoto — conecta-se via HTTP a uma instância aicore-proxy-server |
aicore-proxy-server | Servidor proxy — encapsula o CLI local como um serviço FastAPI SSE, compartilhável em uma rede |
Ambos os provedores compartilham a mesma interface acomplete() / complete() e emitem eventos idênticos de streaming de chamadas de ferramentas — você pode alternar entre eles com uma única alteração de configuração.
Provedor Local (claude_code)
Executa claude-agent-sdk diretamente na máquina onde o AiCore está sendo executado.
Pré-requisitos
# 1. Install the Claude Code CLI (requires Node.js 18+)
npm install -g @anthropic-ai/claude-code

# 2. Authenticate once
claude login

# 3. Install AiCore (the Python SDK is included automatically)
pip install core-for-ai
Início Rápido
from aicore.llm import Llm
from aicore.llm.config import LlmConfig

config = LlmConfig(
    provider="claude_code",
    model="claude-sonnet-4-5-20250929",
    # No api_key needed — auth is handled by the CLI
)

llm = Llm.from_config(config)
response = await llm.acomplete("List all Python files in this project")
print(response)
Arquivo de Configuração
# config/config_example_claude_code.yml
llm:
  provider: "claude_code"
  model: "claude-sonnet-4-5-20250929"

  # Optional
  permission_mode: "bypassPermissions"   # default — all tools allowed
  cwd: "/path/to/your/project"           # working directory for the CLI
  max_turns: 10                           # limit agentic turns
  mcp_config: "./mcp_config.json"   # pass through an MCP config file
  cli_path: "/usr/local/bin/claude"      # override if CLI is not on PATH
  allowed_tools:
    - "Read"
    - "Write"
    - "Bash"
Servidor Proxy (aicore-proxy-server)
O servidor proxy encapsula claude-agent-sdk em um serviço FastAPI SSE para que o Claude Code possa ser acessado remotamente via HTTP. Útil quando:
- O CLI do Claude Code está autenticado em uma máquina diferente (ex.: uma máquina de desenvolvimento, um servidor ou WSL)
- Você deseja compartilhar uma única assinatura Claude entre múltiplos clientes AiCore
- Sua carga de trabalho AiCore é executada em um ambiente de contêiner ou nuvem que não pode executar o CLI diretamente
Instalação (somente no lado do servidor)
# Install AiCore with the claude-server extras
pip install core-for-ai[claude-server]

# Also install the Claude Code CLI and authenticate
npm install -g @anthropic-ai/claude-code
claude login
O extra [claude-server] instala fastapi, uvicorn[standard] e python-dotenv. pyngrok é opcional e necessário apenas para o modo de túnel ngrok.
Iniciando o Servidor
# Minimal — binds to 127.0.0.1:8080, prompts for tunnel choice interactively
aicore-proxy-server

# Fully configured
aicore-proxy-server \
  --host 0.0.0.0 \
  --port 8080 \
  --token my-secret-token \
  --tunnel none \
  --cwd /path/to/project \
  --log-level INFO

# Or via Python module
python -m aicore.scripts.claude_code_proxy_server --port 8080 --tunnel none
Na primeira execução, o token de portador é gerado automaticamente e exibido. Defina CLAUDE_PROXY_TOKEN no seu ambiente ou arquivo .env para reutilizá-lo entre reinicializações, ou passe --token explicitamente.
Referência do CLI
| Flag | Padrão | Descrição |
|---|---|---|
--host | 127.0.0.1 | Endereço de vinculação |
--port | 8080 | Porta TCP |
--token | (gerado automaticamente) | Token de portador; também lê a variável de ambiente CLAUDE_PROXY_TOKEN |
--tunnel | (prompt) | none / ngrok / cloudflare / ssh |
--tunnel-port | igual a --port | Porta remota para túneis SSH |
--cwd | (sem restrições) | Força um diretório de trabalho para todas as sessões Claude |
--allowed-cwd-paths | (qualquer) | Lista de permissões de valores cwd que os clientes podem solicitar |
--log-level | INFO | DEBUG / INFO / WARNING / ERROR |
--cors-origins | * | Origens CORS permitidas |
Suporte a Túneis
Quando --tunnel é omitido, o servidor solicita interativamente na inicialização.
| Modo | Requisito | Notas |
|---|---|---|
none | — | Somente rede local |
ngrok | pip install pyngrok | O token de autenticação é armazenado no armazenamento de credenciais do SO na primeira execução e carregado automaticamente em execuções subsequentes |
cloudflare | binário cloudflared no PATH | Túnel rápido, URL efêmera |
ssh | Acesso SSH a um VPS | Exibe o comando ssh -R; nenhum software adicional necessário |
Endpoints da API
| Método | Caminho | Autenticação | Descrição |
|---|---|---|---|
GET | /health | Nenhuma | Status do servidor, tempo de atividade, versão do CLI Claude, contagem de streams ativos |
GET | /capabilities | Bearer | Opções suportadas e padrões impostos pelo servidor |
POST | /query | Bearer | Transmitir uma consulta claude-agent-sdk como SSE |
DELETE | /query/{session_id} | Bearer | (stub 501 — reservado para cancelamento futuro baseado em WebSocket) |
Provedor Remoto (remote_claude_code)
Conecta o AiCore a um aicore-proxy-server em execução via HTTP SSE. O provedor remoto reconstrói o fluxo de mensagens do SDK localmente, fornecendo a mesma interface acomplete() / complete() que o provedor local — sem necessidade de CLI do Claude Code no lado do cliente.
Pré-requisitos (lado do cliente)
pip install core-for-ai # no CLI or claude-server extras required
O servidor proxy deve estar em execução e acessível antes de instanciar o provedor (uma verificação GET /health é realizada automaticamente na inicialização, controlável via skip_health_check).
Início Rápido
from aicore.llm import Llm
from aicore.llm.config import LlmConfig

config = LlmConfig(
    provider="remote_claude_code",
    model="claude-sonnet-4-5-20250929",
    base_url="http://your-proxy-host:8080",   # or a tunnel URL
    api_key="your_proxy_token",               # CLAUDE_PROXY_TOKEN from server startup
)

llm = Llm.from_config(config)
response = await llm.acomplete("Summarise this codebase")
print(response)
Arquivo de Configuração
# config/config_example_remote_claude_code.yml
llm:
  provider: "remote_claude_code"
  model: "claude-sonnet-4-5-20250929"
  base_url: "http://your-proxy-host:8080"   # or the ngrok / cloudflare tunnel URL
  api_key: "your_proxy_token"               # CLAUDE_PROXY_TOKEN printed at server startup

  # Optional — forwarded to the proxy server
  permission_mode: "bypassPermissions"
  cwd: "/path/to/project"                   # must be in server's --allowed-cwd-paths
  max_turns: 10
  allowed_tools:
    - "Bash"
    - "Read"
    - "Write"

  # Skip the GET /health connectivity check at startup
  skip_health_check: false
Streaming de Chamadas de Ferramentas e Callbacks
Tanto claude_code quanto remote_claude_code emitem eventos idênticos de chamadas de ferramentas:
def on_tool_event(event: dict):
    if event["stage"] == "started":
        print(f"→ Calling tool: {event['tool_name']}")
    elif event["stage"] == "concluded":
        status = "✗" if event["is_error"] else "✓"
        print(f"{status} Tool finished: {event['tool_name']}")

llm.tool_callback = on_tool_event

response = await llm.acomplete("Find all TODO comments in the codebase")
TOOL_CALL_START_TOKEN / TOOL_CALL_END_TOKEN também são emitidos via stream_handler, portanto, qualquer consumidor de stream existente funciona sem alterações.
Modelos Suportados
| Modelo | Máx. Tokens | Janela de Contexto |
|---|---|---|
claude-sonnet-4-5-20250929 | 64 000 | 200 000 |
claude-opus-4-6 | 32 000 | 200 000 |
claude-haiku-4-5-20251001 | 64 000 | 200 000 |
claude-3-7-sonnet-latest | 64 000 | 200 000 |
claude-3-5-sonnet-latest | 8 192 | 200 000 |
Nota:
temperature,max_tokenseapi_keysão ignorados por ambos os provedores — o CLI do Claude Code controla os parâmetros do modelo internamente. O custo é relatado a partir deResultMessage.total_cost_usdem vez de calculado a partir de uma tabela de preços.
Uso
Modelos de Linguagem
Você pode usar os modelos de linguagem para gerar conclusões de texto. Abaixo está um exemplo de como usar o provedor MistralLlm:
from aicore.llm.config import LlmConfig
from aicore.llm.providers import MistralLlm

config = LlmConfig(
    api_key="your_api_key",
    model="your_model_name",
    temperature=0.7,
    max_tokens=100
)

mistral_llm = MistralLlm.from_config(config)
response = mistral_llm.complete(prompt="Hello, how are you?")
print(response)
Carregando de um Arquivo de Configuração
Para carregar configurações de um arquivo YAML, defina a variável de ambiente CONFIG_PATH e use a classe Config para carregar as configurações. Aqui está um exemplo:
from aicore.config import Config
from aicore.llm import Llm
import os

if __name__ == "__main__":
    os.environ["CONFIG_PATH"] = "./config/config.yml"
    config = Config.from_yaml()
    llm = Llm.from_config(config.llm)
    llm.complete("Once upon a time, there was a")
Certifique-se de que seu arquivo config.yml esteja configurado corretamente com as configurações necessárias.
Observabilidade
O AiCore inclui um módulo abrangente de observabilidade que rastreia:
- Metadados de solicitação/resposta
- Uso de tokens (prompt, conclusão, total)
- Métricas de latência (tempo de resposta, tempo até o primeiro token)
- Estimativas de custo (com base nos preços do provedor)
- Estatísticas de chamadas de ferramentas (para integrações MCP)
Recursos do Painel
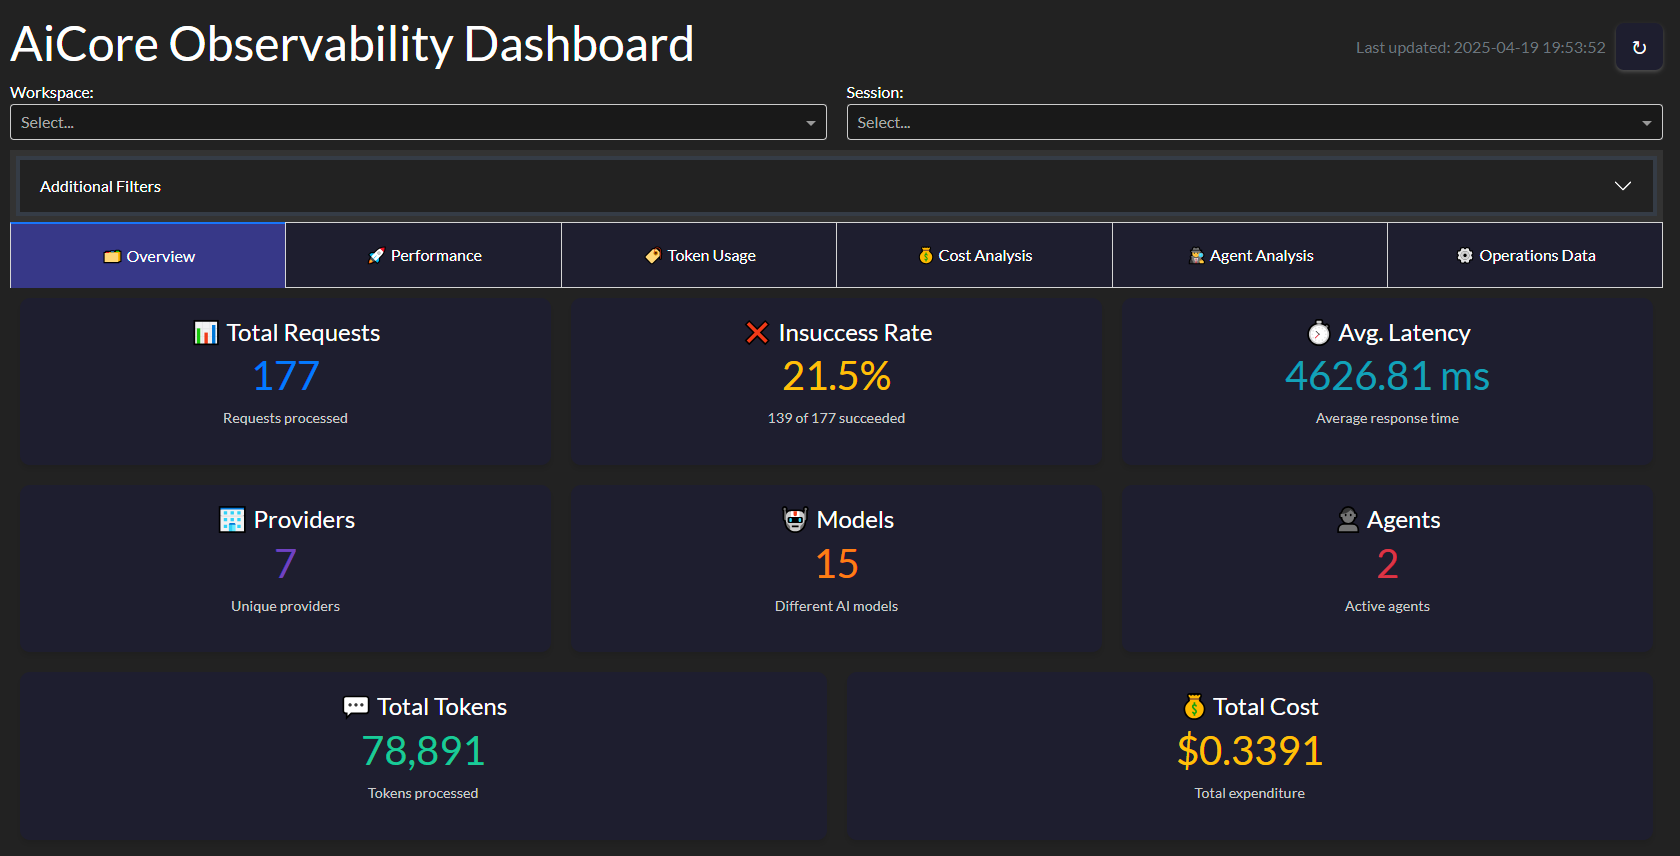
Principais métricas rastreadas:
- Solicitações por minuto
- Tempo médio de resposta
- Tendências de uso de tokens
- Taxas de erro
- Projeções de custo
from aicore.observability import ObservabilityDashboard

dashboard = ObservabilityDashboard(storage="observability_data.json")
dashboard.run_server(port=8050)
Uso Avançado
Configuração Aumentada com Raciocinador
O AiCore também contém suporte nativo para aumentar LLMs tradicionais com capacidades de raciocínio, fornecendo-lhes as etapas de pensamento geradas por um modelo de raciocínio de código aberto, permitindo que ele gere suas respostas de forma Aumentada por Raciocínio.
Isso pode ser útil em vários cenários, como:
- garantir que seus sistemas agênticos ainda funcionem com os prompts que você criou para seus LLMs favoritos, enquanto os aumenta com etapas de raciocínio
- controle direto de quanto tempo você deseja que seu raciocinador raciocine (via parâmetro max_tokens) e quão criativo ele pode ser (temperatura de raciocínio desacoplada da temperatura de geração) sem comprometer as configurações de geração
Para aproveitar o aumento de raciocínio, basta introduzir uma das configurações de LLM suportadas no campo raciocinador e o AiCore cuida do resto
# config.yml
embeddings:
  provider: "openai" # or "mistral", "groq", "gemini", "nvidia"
  api_key: "your_openai_api_key"
  model: "your_openai_embedding_model" # Optional

llm:
  provider: "mistral" # or "openai", "groq", "gemini", "nvidia"
  api_key: "your_mistral_api_key"
  model: "mistral-small-latest" # Optional
  temperature: 0.6
  max_tokens: 2048
  reasoner:
    provider: "groq" # or openrouter or nvidia
    api_key: "your_groq_api_key"
    model: "deepseek-r1-distill-llama-70b" # or "deepseek/deepseek-r1:free" or "deepseek/deepseek-r1"
    temperature: 0.5
    max_tokens: 1024
Construído com AiCore
Reasoner4All
Um espaço Hugging Face que apresenta modelos aumentados por raciocínio

⏮ GitRecap
Resumos instantâneos da atividade Git
🌐 Aplicativo ao Vivo
📦 Repositório GitHub
🌀 Integração CodeTide e AgentTide
CodeTide é uma ferramenta totalmente local, priorizando privacidade, para analisar e entender bases de código Python usando análise simbólica e estrutural — sem LLMs, sem embeddings, apenas inteligência de código rápida e determinística. Ele permite que desenvolvedores e agentes de IA recuperem contexto preciso do código, visualizem a estrutura do projeto e gerem alterações atômicas de código com confiança.
AgentTide é um agente de engenharia de software de próxima geração, orientado por precisão, construído sobre o CodeTide. O AgentTide aproveita a compreensão simbólica de código do CodeTide para planejar, gerar e aplicar patches de código de alta qualidade — sempre com fidelidade total ao contexto e aos requisitos. Você pode interagir com o AgentTide via um CLI conversacional ou uma bela interface web.
Demonstração ao Vivo: Experimente o AgentTide no Hugging Face Spaces: https://mclovinittt-agenttidedemo.hf.space/
AiCore foi usado para fazer chamadas de LLM dentro do AgentTide, permitindo integração perfeita entre análise de código local e modelos de linguagem avançados. Essa combinação capacita o AgentTide a entregar alterações de código prontas para produção e conscientes do contexto — sempre sob seu controle.
Planos Futuros
- Suporte Estendido a Provedores: Provedores adicionais de LLM e embeddings
- Adicionar suporte a Fala: Integrar objetos de texto para fala e fala para texto com uso e observabilidade
Documentação
Para documentação completa, incluindo referências de API, exemplos de uso avançado e guias de configuração, visite:
📖 Site Oficial de Documentação
Licença
Este projeto é licenciado sob a Licença Apache 2.0.