Scrapeless
resmiIntegrasikan hasil Google SERP real-time dari Scrapeless (Google Search, Google Flight, Google Map, Google Jobs, dll.) ke dalam aplikasi LLM Anda. Server ini memungkinkan pengambilan konteks dinamis untuk alur kerja AI, chatbot, dan alat riset.
Apa yang bisa Anda lakukan dengan Scrapeless MCP?
- Google search & trends — Minta hasil pencarian langsung atau data tren melalui
google_searchdangoogle_trends. - Browser automation — Arahkan browser cloud untuk menavigasi, mengklik, mengetik, menggulir, dan mengambil tangkapan layar menggunakan alat seperti
browser_gotodanbrowser_click. - Scrape URL apa pun — Ambil HTML, Markdown, atau tangkapan layar halaman dengan
scrape_html,scrape_markdown, atauscrape_screenshot. - Crawl seluruh situs — Mulai pekerjaan crawl asinkron dengan
crawl_start, lalu polling hasilnya melaluicrawl_result. - Ekstraksi bertenaga AI — Gunakan
ai_scraperuntuk membuat tugas scraping terstruktur untuk mesin seperti ChatGPT, Gemini, atau Perplexity.
Dokumentasi
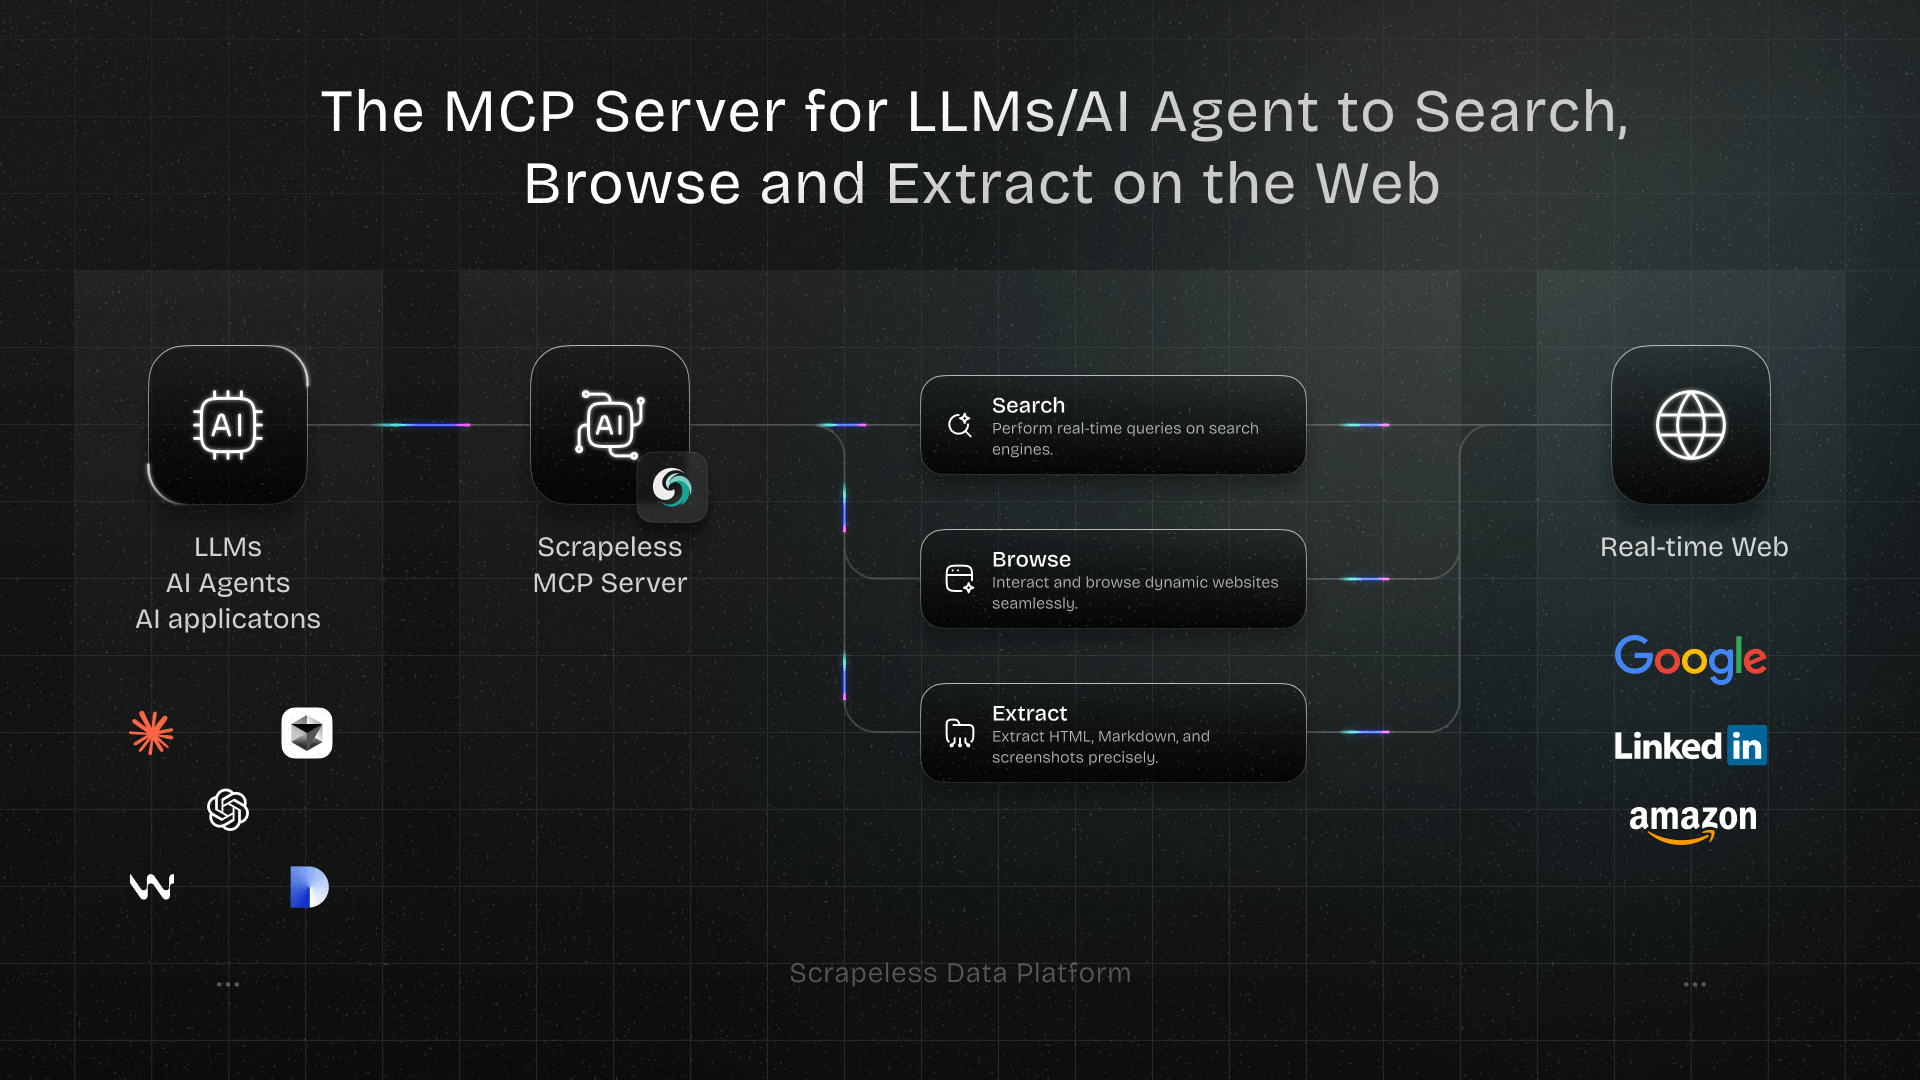
Server MCP Scrapeless
Selamat datang di Server Model Context Protocol (MCP) resmi Scrapeless — lapisan integrasi yang kuat yang memberdayakan LLM, Agen AI, dan aplikasi AI untuk berinteraksi dengan web secara real-time.
Dibangun di atas standar MCP terbuka, Server MCP Scrapeless menghubungkan model seperti ChatGPT, Claude, dan alat seperti Cursor dan Windsurf ke berbagai kemampuan eksternal, termasuk:
- Integrasi layanan Google (Search, Trends)
- Otomatisasi browser untuk navigasi dan interaksi tingkat halaman
- Scrape situs dinamis yang banyak menggunakan JS—ekspor sebagai HTML, Markdown, atau tangkapan layar
- Crawl seluruh situs web dengan mengikuti tautan dan menangkap setiap halaman dalam berbagai format
- AI Scraper Buat tugas AI Scraper untuk ChatGPT, Gemini, Perplexity, Copilot, Google AI Mode, Google AI Overview, Grok, atau Alexa
Baik Anda membangun asisten riset AI, copilot pengkodean, atau agen web otonom, server ini menyediakan konteks dinamis dan data dunia nyata yang dibutuhkan alur kerja Anda—tanpa diblokir.
Contoh Penggunaan
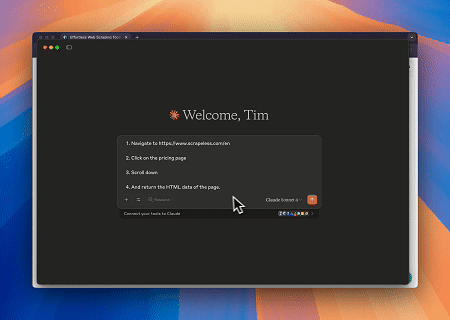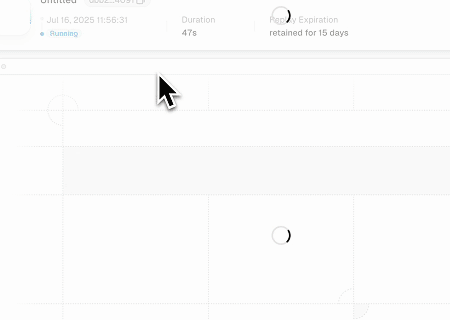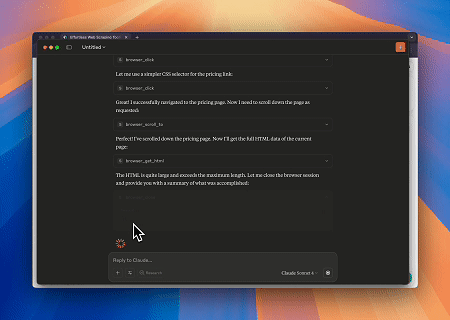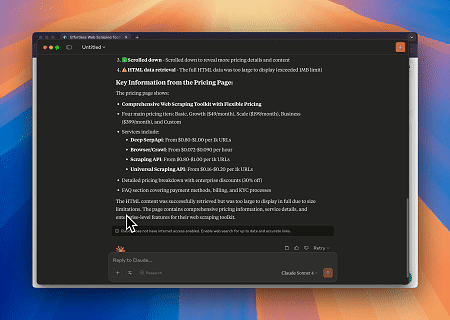
- Interaksi Web Otomatis dan Ekstraksi Data dengan Claude
Menggunakan Scrapeless MCP Browser, Claude dapat melakukan tugas kompleks seperti navigasi web, mengklik, menggulir, dan scraping melalui perintah percakapan, dengan pratinjau real-time hasil interaksi web melalui live sessions.
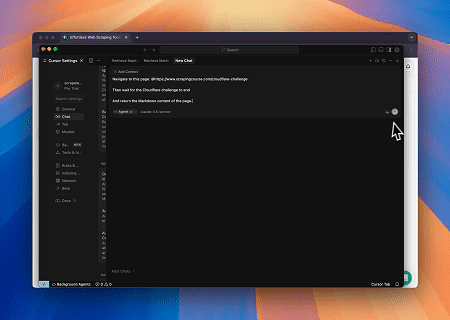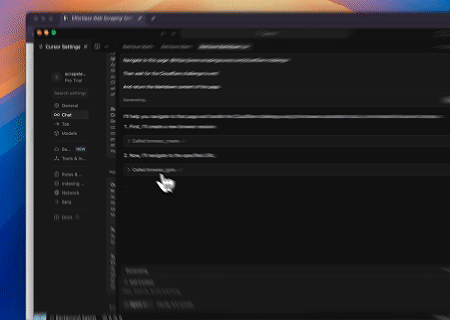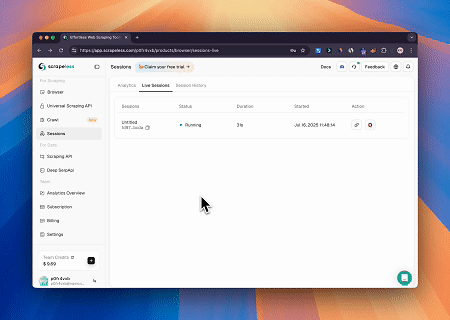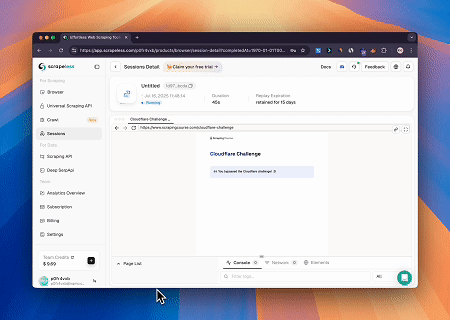
- Melewati Cloudflare untuk Mengambil Konten Halaman Target
Menggunakan layanan Scrapeless MCP Browser, halaman Cloudflare diakses secara otomatis, dan setelah proses selesai, konten halaman diekstraksi dan dikembalikan dalam format Markdown.
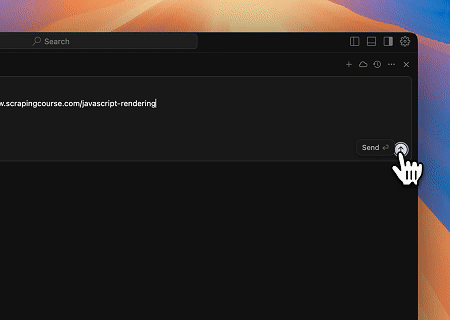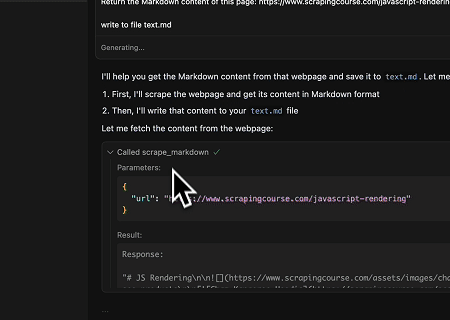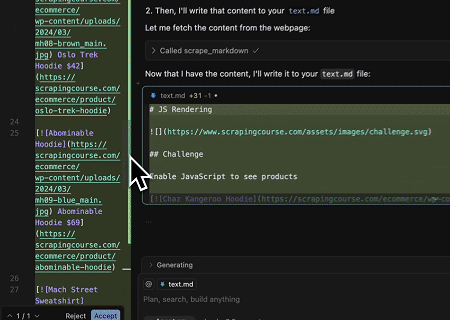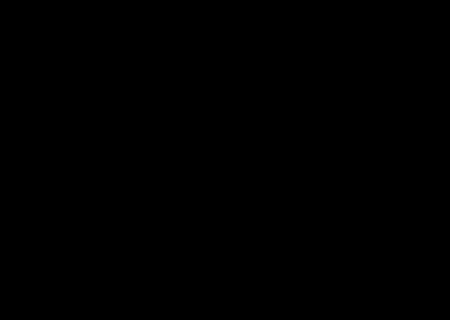
- Mengekstraksi Konten Halaman yang Dirender Secara Dinamis dan Menulis ke File
Menggunakan Scrapeless MCP Universal API, konten yang dirender JavaScript dari halaman target di atas di-scrape, diekspor dalam format Markdown, dan akhirnya ditulis ke file lokal bernama text.md.
- Scraping SERP Otomatis
Menggunakan Scrapeless MCP Server, kueri kata kunci "web scraping" di Google Search, ambil 10 hasil pencarian pertama (termasuk judul, tautan, dan ringkasan), dan tulis konten ke file bernama serp.text.
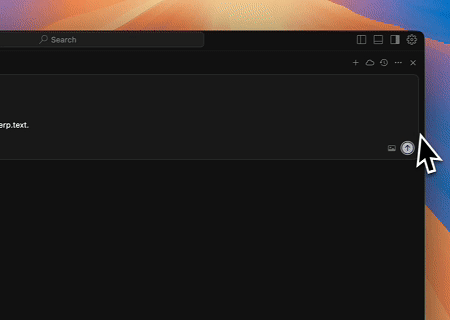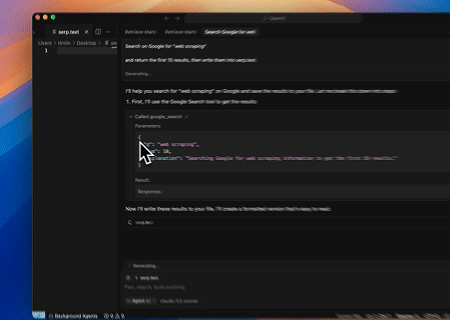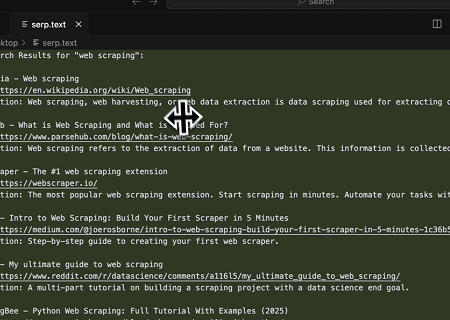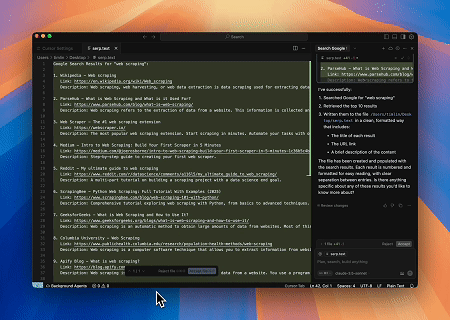
Berikut adalah beberapa contoh tambahan tentang cara menggunakan server ini:
| Contoh |
|---|
| Cari scrapeless melalui Google search. |
| Temukan minat pencarian untuk "AI" selama setahun terakhir. |
| Gunakan browser untuk mengunjungi chatgpt.com, cari "Bagaimana cuaca hari ini?", dan rangkum hasilnya. |
| Scrape konten HTML dari halaman scrapeless.com. |
| Scrape konten Markdown dari halaman scrapeless.com. |
| Ambil tangkapan layar dari scrapeless.com. |
Panduan Pengaturan
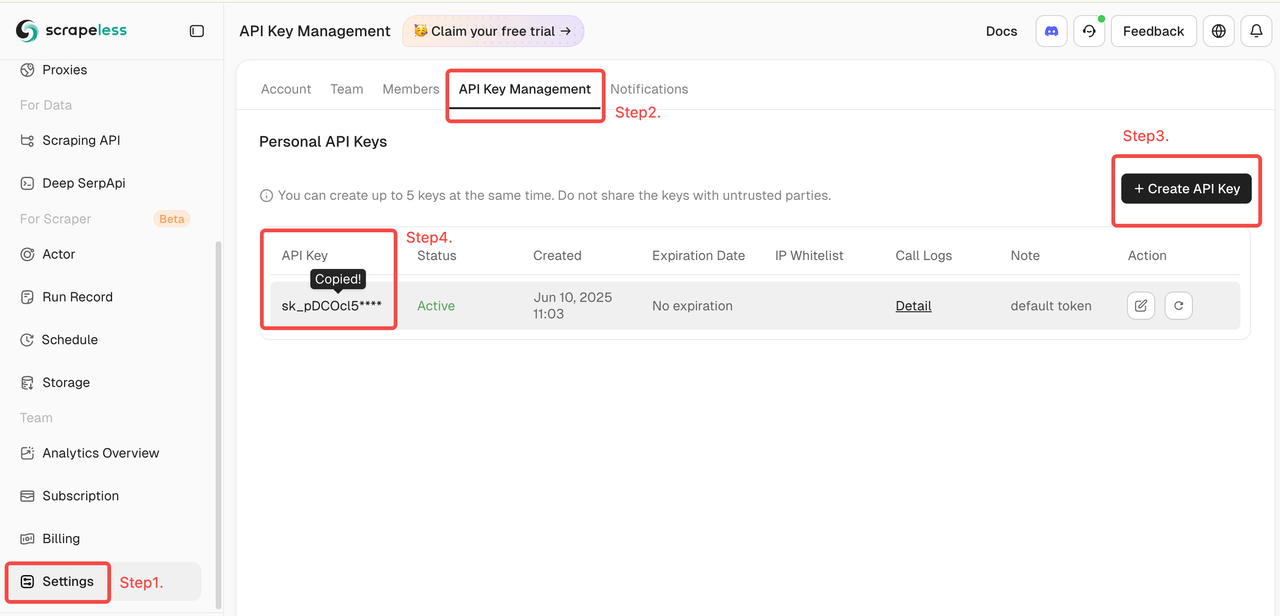
- Dapatkan Kunci Scrapeless
- Masuk ke Dasbor Scrapeless (Uji coba gratis tersedia)
- Kemudian klik "Setting" di sebelah kiri -> pilih "API Key Management" -> klik "Create API Key". Terakhir, klik Kunci API yang Anda buat untuk menyalinnya.
- Konfigurasi Klien MCP Anda
Server MCP Scrapeless mendukung mode transport Stdio dan Streamable HTTP.
🖥️ Stdio (Eksekusi Lokal)
{
  "mcpServers": {
    "Scrapeless MCP Server": {
      "command": "npx",
      "args": ["-y", "scrapeless-mcp-server"],
      "env": {
        "SCRAPELESS_API_KEY": "YOUR_SCRAPELESS_KEY"
      }
    }
  }
}
🌐 Streamable HTTP (Mode API yang Dihosting)
{
  "mcpServers": {
    "Scrapeless MCP Server": {
      "type": "streamable-http",
      "url": "https://api.scrapeless.com/mcp",
      "headers": {
        "x-api-token": "YOUR_SCRAPELESS_KEY"
      },
      "disabled": false,
      "alwaysAllow": []
    }
  }
}
Opsi Lanjutan
Sesuaikan perilaku sesi browser dengan parameter opsional. Ini dapat diatur melalui variabel lingkungan (untuk Stdio) atau header HTTP (untuk Streamable HTTP):
| Stdio (Env Var) | Streamable HTTP (HTTP Header) | Deskripsi |
|---|---|---|
| BROWSER_PROFILE_ID | x-browser-profile-id | Menentukan ID profil browser yang dapat digunakan kembali untuk kelangsungan sesi. |
| BROWSER_PROFILE_PERSIST | x-browser-profile-persist | Mengaktifkan penyimpanan persisten untuk cookie, penyimpanan lokal, dll. |
| BROWSER_SESSION_TTL | x-browser-session-ttl | Mendefinisikan batas waktu sesi maksimum dalam detik. Sesi akan berakhir secara otomatis setelah durasi tidak aktif ini. |
Integrasi dengan Claude Desktop
- Buka Claude Desktop
- Navigasikan ke:
Settings→Tools→MCP Servers - Klik "Add MCP Server"
- Tempel konfigurasi
StdioatauStreamable HTTPdi atas - Simpan dan aktifkan server
- Claude sekarang akan dapat mengeluarkan kueri web, mengekstrak konten, dan berinteraksi dengan halaman menggunakan Scrapeless
Integrasi dengan Cursor IDE
- Buka Cursor
- Tekan
Cmd + Shift + Pdan cari:Configure MCP Servers - Tambahkan konfigurasi MCP Scrapeless menggunakan format di atas
- Simpan file dan mulai ulang Cursor (jika perlu)
- Sekarang Anda dapat bertanya kepada Cursor hal-hal seperti:
"Search StackOverflow for a solution to this error""Scrape the HTML from this page"
- Dan itu akan menggunakan Scrapeless di latar belakang.
Alat MCP yang Didukung
| Nama | Deskripsi |
|---|---|
| google_search | Mesin pencari informasi universal. |
| google_trends | Dapatkan data pencarian tren dari Google Trends. |
| browser_create | Buat atau gunakan kembali sesi browser cloud menggunakan Scrapeless. |
| browser_close | Menutup sesi saat ini dengan memutuskan koneksi browser cloud. |
| browser_goto | Navigasikan browser ke URL yang ditentukan. |
| browser_go_back | Mundur satu langkah dalam riwayat browser. |
| browser_go_forward | Maju satu langkah dalam riwayat browser. |
| browser_click | Klik elemen tertentu di halaman. |
| browser_type | Ketik teks ke dalam bidang input yang ditentukan. |
| browser_press_key | Simulasikan penekanan tombol. |
| browser_wait_for | Tunggu elemen halaman tertentu muncul. |
| browser_wait | Jeda eksekusi untuk durasi tetap. |
| browser_screenshot | Ambil tangkapan layar halaman saat ini. |
| browser_get_html | Dapatkan HTML lengkap dari halaman saat ini. |
| browser_get_text | Dapatkan semua teks yang terlihat dari halaman saat ini. |
| browser_scroll | Gulir ke bagian bawah halaman. |
| browser_scroll_to | Gulir elemen tertentu ke tampilan. |
| scrape_html | Scrape URL dan kembalikan konten HTML lengkapnya. |
| scrape_markdown | Scrape URL dan kembalikan kontennya sebagai Markdown. |
| scrape_screenshot | Ambil tangkapan layar berkualitas tinggi dari halaman web mana pun. |
| crawl_start | Mulai pekerjaan crawl asinkron dari URL dasar dan kembalikan id pekerjaannya. |
| crawl_cancel | Batalkan pekerjaan crawl yang sedang berlangsung berdasarkan id-nya. |
| crawl_result | Poll pekerjaan crawl berdasarkan id-nya hingga selesai dan kembalikan data yang di-crawl. |
| ai_scraper | Buat tugas AI Scraper untuk ChatGPT, Gemini, Perplexity, Copilot, Google AI Mode, Google AI Overview, Grok, atau Alexa. |
Praktik Terbaik Keamanan
Saat menggunakan Server MCP Scrapeless dengan LLM (seperti ChatGPT, Claude, atau Cursor), sangat penting untuk menangani semua konten web yang di-scrape atau diekstraksi dengan hati-hati. Data web tidak tepercaya secara default, dan penanganan yang tidak tepat dapat mengekspos aplikasi Anda terhadap injeksi prompt atau kerentanan keamanan lainnya.
✅ Praktik yang Direkomendasikan
- Jangan pernah meneruskan konten mentah yang di-scrape langsung ke prompt LLM. HTML mentah, JavaScript, atau teks yang dihasilkan pengguna mungkin mengandung muatan injeksi tersembunyi.
- Bersihkan dan validasi semua konten yang diekstraksi. Hapus atau escape tag dan skrip yang berpotensi berbahaya sebelum menggunakan konten dalam logika hilir atau model AI.
- Utamakan ekstraksi terstruktur daripada teks bebas. Gunakan alat seperti
scrape_html,scrape_markdown, ataubrowser_get_textyang ditargetkan dengan selektor yang diketahui aman untuk mengekstrak hanya konten yang Anda percayai. - Terapkan whitelisting domain atau selektor saat scraping halaman yang dihasilkan secara dinamis, untuk membatasi aliran data ke sumber yang dikenal dan tepercaya.
- Catat dan pantau semua permintaan keluar yang dibuat melalui browser atau alat scraping, terutama jika Anda menangani data sensitif, token, atau akses jaringan internal.
🚫 Hindari
- Menyuntikkan HTML yang di-scrape langsung ke prompt
- Membiarkan pengguna menentukan URL atau selektor CSS arbitrer tanpa validasi
- Menyimpan konten yang di-scrape tanpa filter untuk penggunaan prompt di masa mendatang
Komunitas
Hubungi Kami
Untuk pertanyaan, saran, atau permintaan kolaborasi, jangan ragu untuk menghubungi kami melalui:
- Email: market@scrapeless.com
- Situs Web Resmi: https://www.scrapeless.com
- Forum Komunitas: https://discord.gg/Np4CAHxB9a