New Term Radar
Detecta los nombres de nuevos modelos de IA, productos y repositorios en X, Hugging Face, GitHub y sitemaps antes de que las herramientas de palabras clave los listeen, y dimensiona los términos de búsqueda detrás de cada nombre.
Documentación
new-term-radar
Un informe diario de los nombres que están empezando a despuntar en IA: nuevos modelos, productos, herramientas y repositorios, captados donde se mencionan por primera vez, antes de que aparezcan en las herramientas de palabras clave.
Creado para quienes hacen páginas, publicaciones o productos en torno a nuevos términos: SEO para sitios de herramientas de IA, boletines, directorios, cualquiera que quiera saber sobre "Strata" o "Seedance" el día que aparece y no dos semanas después.
Por qué
Un nombre nuevo deja un rastro, en este orden:
- Un laboratorio o una cuenta muy seguida lo menciona en X; un modelo entra en la lista de tendencias de Hugging Face.
- Un repositorio de GitHub despega por sí solo.
- Los directorios y competidores le añaden páginas; alguien registra un dominio para ello y el sitio empieza a posicionarse.
- Tu propio sitio recibe sus primeras impresiones de búsqueda para ese nombre.
- Google Trends muestra la curva, días o semanas después.
Las herramientas de palabras clave leen el paso 5. Este radar lee los pasos 1 a 4 cada día y usa el paso 5 solo para comprobarse a sí mismo.
Un ejemplo en torno al que se construyó: Niko1221/Strata se creó el 2026-09-24 y tenía 7.700 estrellas nueve días después. La gente buscaba "niko strata" desde el 26/9, mientras que ningún otro repositorio llevaba ese nombre y ninguna herramienta de palabras clave lo listaba. Un solo repositorio ganando 800 estrellas al día es toda la señal, y es público.
Qué lee
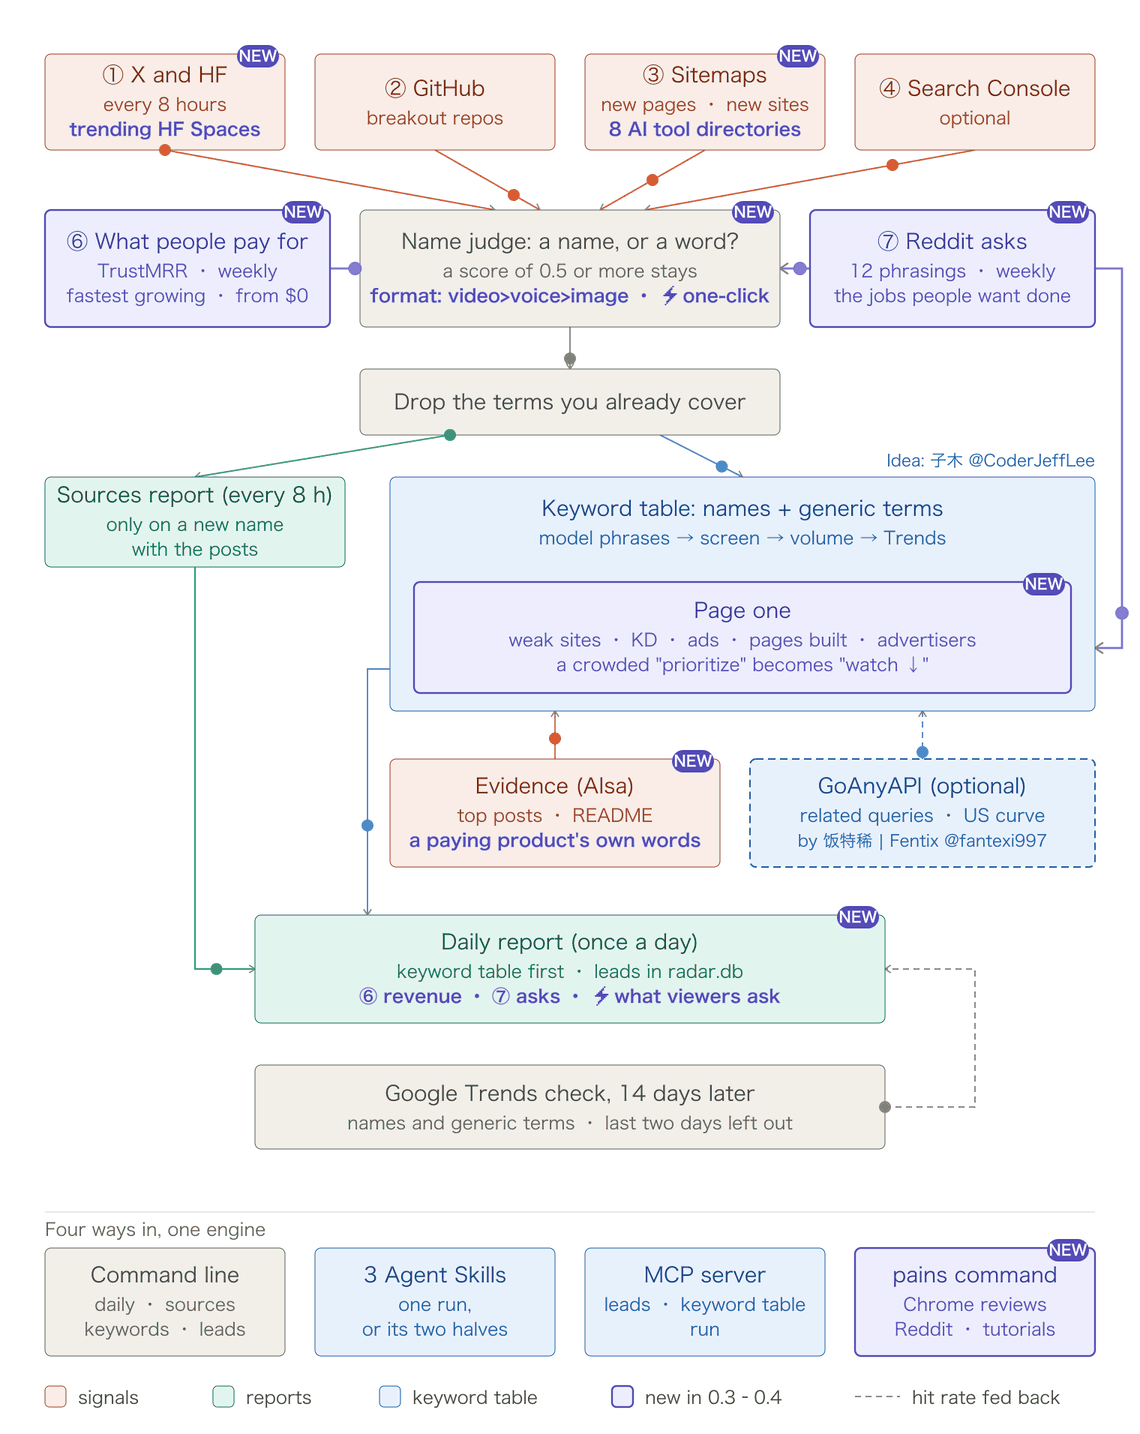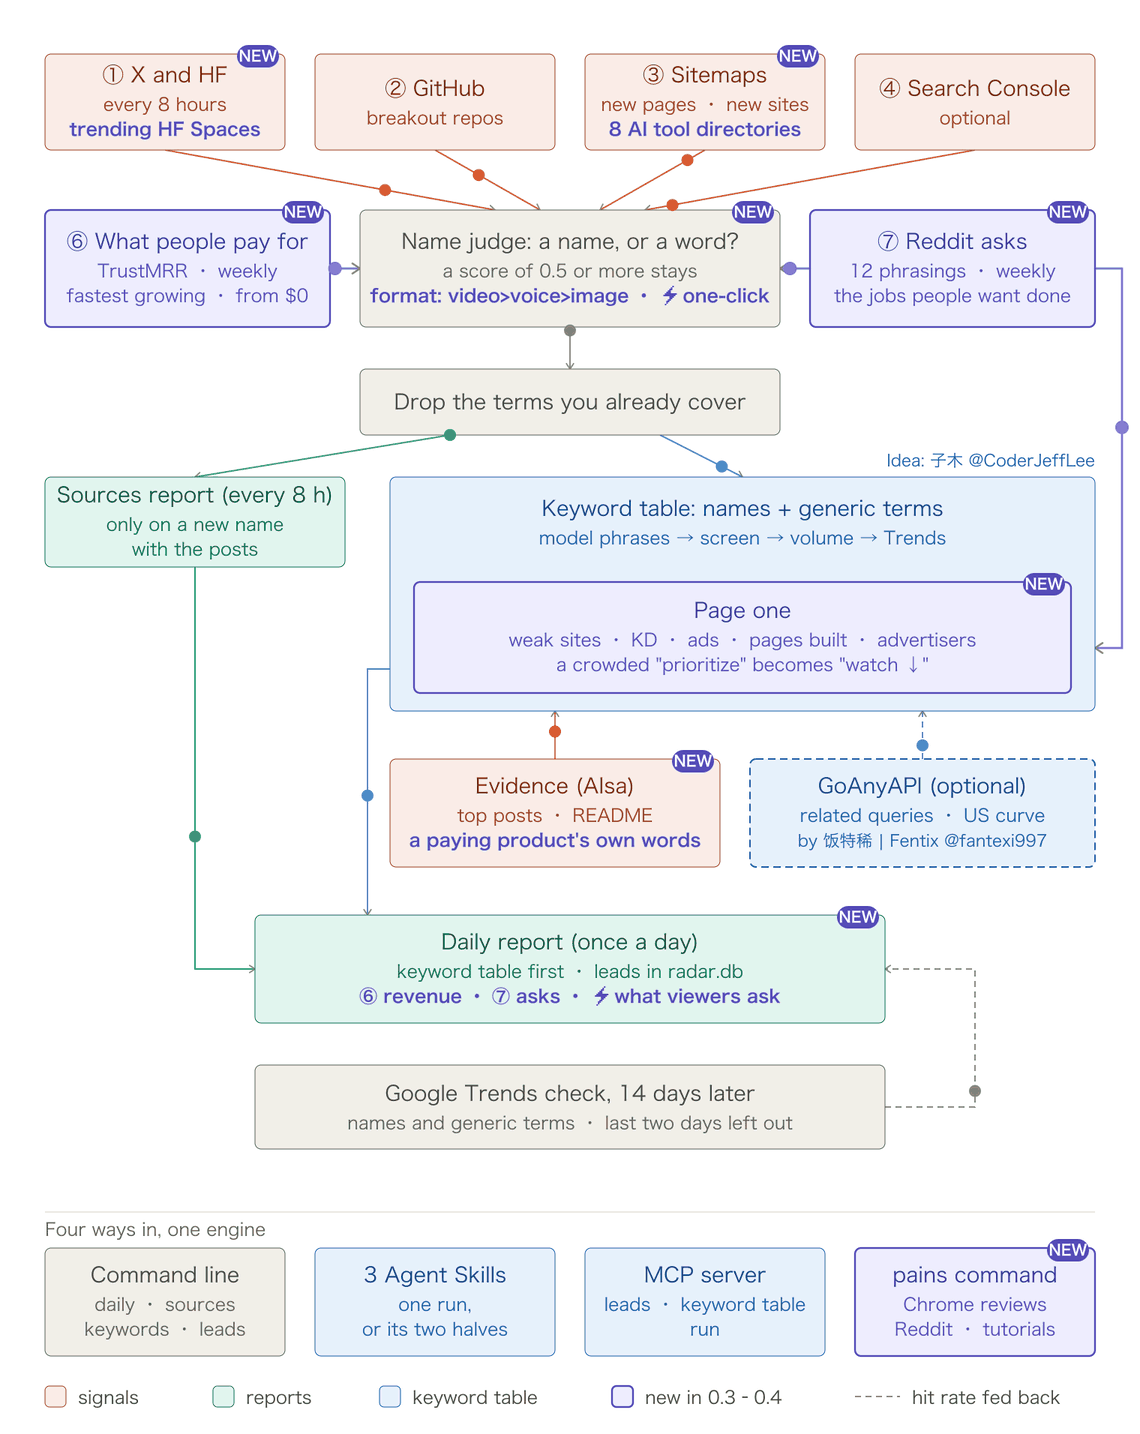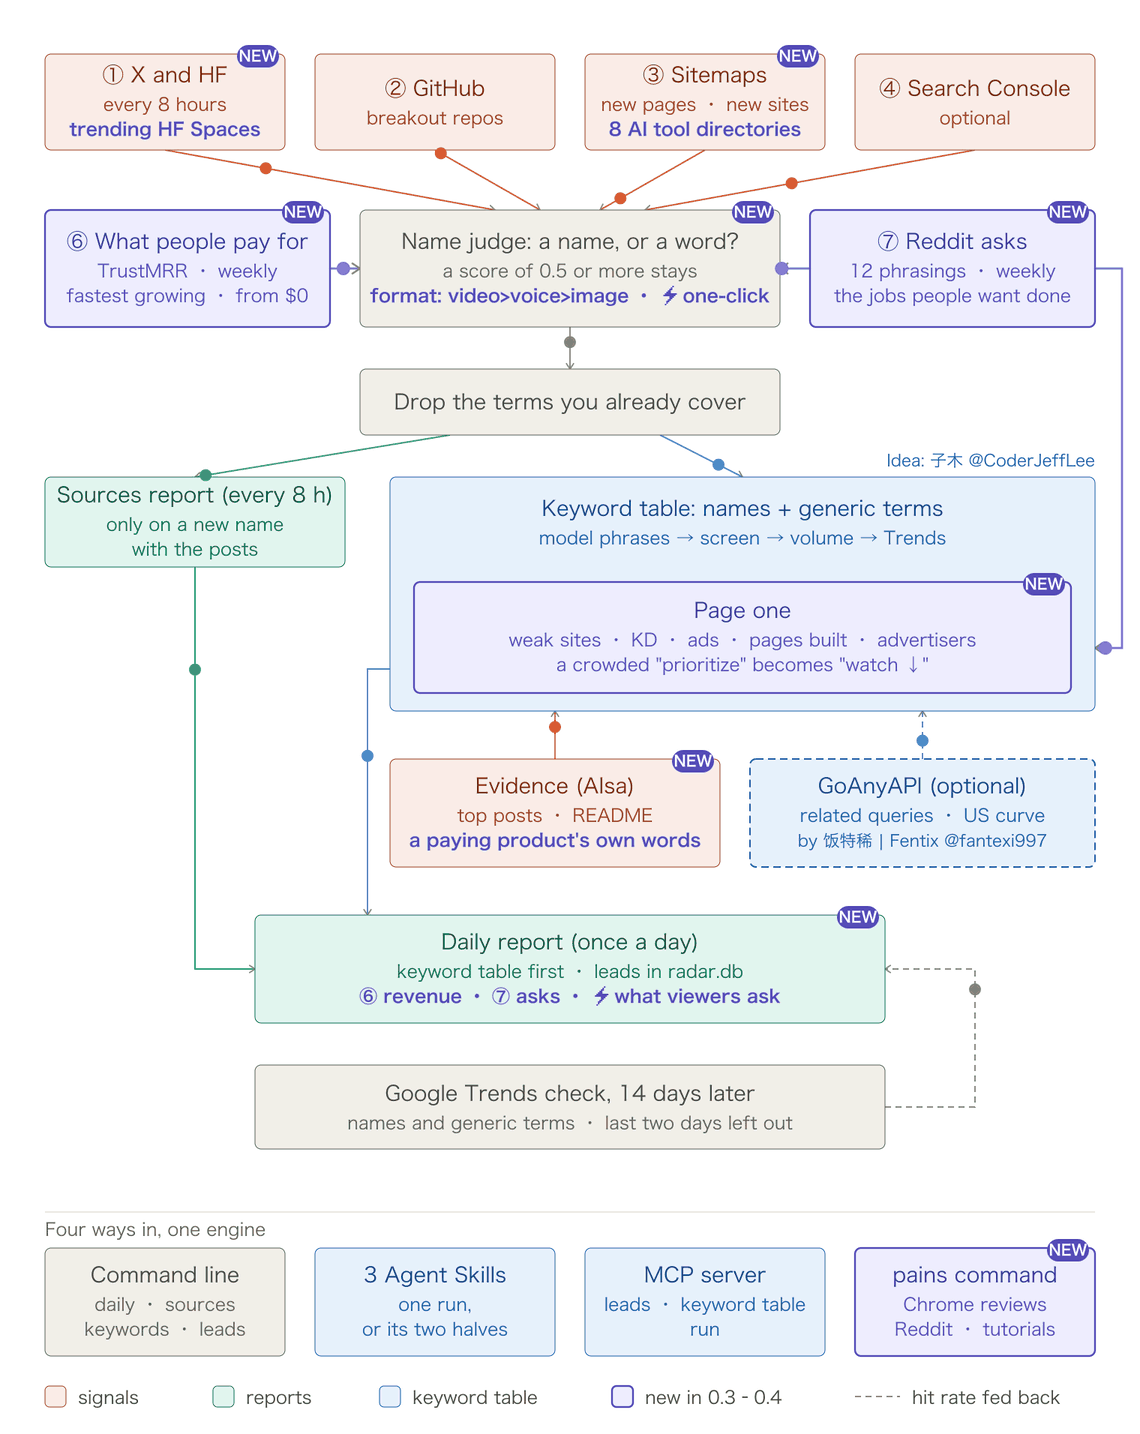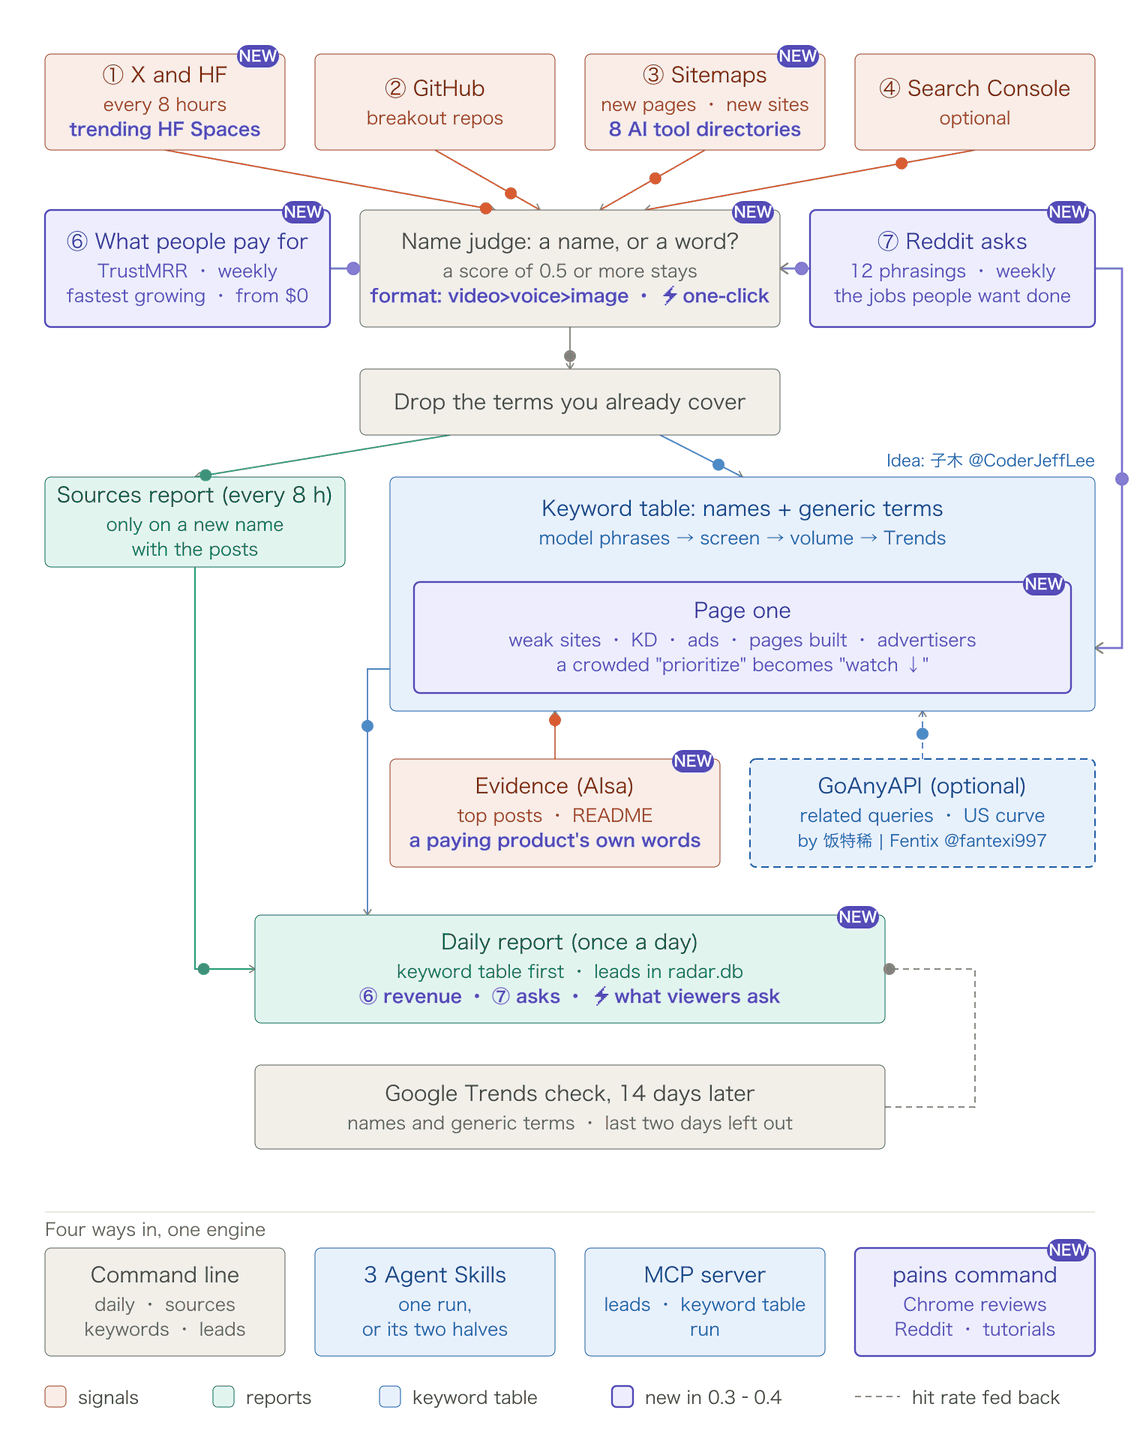
Púrpura, etiquetado NUEVO: lo que añadieron 0.3 y 0.4 (⑥ ingresos, ⑦ preguntas de Reddit, el chequeo de la primera página, el formato y las marcas ⚡, el comando pains).
| Señal | Qué captura | Necesita | Coste |
|---|---|---|---|
| ① X | Nombres que las cuentas de tu lista usaron por primera vez en 60 días | Clave de AIsa | $0,003 por cuenta y ejecución |
| ① Hugging Face | Modelos y Spaces (las demos que la gente prueba) nuevos en el top 50 de tendencias; copias cuantizadas y la demo propia de un modelo agrupadas bajo el nombre base | nada | gratis |
| ② GitHub breakout | Un repositorio de menos de 14 días con una media de 200+ estrellas al día, o +400 desde ayer; añade las variantes de búsqueda que usa la gente ("niko strata") | nada (un token de GitHub sube el límite de peticiones) | gratis |
| ③ Sitemaps | Palabras que varias URLs nuevas de un sitio comparten y que sus URLs antiguas rara vez tenían. La configuración de ejemplo vigila ocho directorios de herramientas de IA (toolify, aixploria, ai-bot.cn, opentools, dang.ai, clipfly, aitoptools, futurepedia) y cuatro directorios de MCP y habilidades | los sitemaps que listes | gratis |
| ③ Sitios nuevos | Dominios registrados e indexados por primera vez en los últimos 90 días que ya posicionan para 20+ palabras clave | Clave de AIsa | unos $0,13 por consulta, semanal |
| ⑦ Preguntas | Lo que la gente pide en Reddit ("¿hay una herramienta de IA que…", doce formulaciones): un modelo conserva las peticiones y quejas que una herramienta de IA podría responder y escribe cada tarea como la buscaría la gente; las tareas con búsquedas reciben el chequeo de la primera página | Clave de AIsa | unos $0,12 a la semana |
| ⑥ Ingresos | Productos por los que la gente paga, de los ingresos verificados de TrustMRR: los de crecimiento más rápido ($500+ en 30 días) y los listados más nuevos; uno que estaba a $0 la última vez y ahora genera ingresos se destaca primero. Su propia descripción va a la tabla de palabras clave como evidencia | Clave de TrustMRR | gratis, 6 peticiones, semanal |
| ④ Search Console | Consultas por las que tu sitio recibió impresiones, por primera vez (datos frescos) | tu propio token de Google | gratis |
| ⑤ Revisión | Cada candidato se comprueba en Google Trends 14 días después, contra su propia línea base; tasa de aciertos y días de adelanto por señal | Clave de AIsa | $0,0012 por variante de búsqueda |
| Tabla de palabras clave | Para los nombres nuevos del día: los términos de búsqueda genéricos detrás de ellos (qué hace la gente con lo nuevo), cada uno dimensionado, comprobado si hay hueco en la primera página, y con una decisión | Clave de AIsa; clave de GoAnyAPI opcional | unos $0,18 al día por 5 nombres, $0,30 con GoAnyAPI |
| Juez de nombres | Un modelo pequeño puntúa cada término: ¿el nombre de una cosa concreta, o una palabra común? | Clave de AIsa | una fracción de céntimo por ejecución |
Los precios son lo que AIsa cobró en octubre de 2026. Con la configuración de ejemplo (35 cuentas de X leídas tres veces al día, la tabla de palabras clave para 5 nombres al día) un mes cuesta unos $15: $10 por las lecturas de X, $5 por la tabla de palabras clave. Lee menos cuentas, o léelas una vez al día, y baja en proporción.
La tabla de palabras clave
Un nombre es la mitad de lo que necesitas. "SynthID Detector" tiene una vida corta como palabra clave y pertenece a Google; la tarea que hace, "ai image detector", es lo que la gente sigue buscando, y nadie la posee. Cada día el radar lee los nombres nuevos una vez más y escribe una tabla con ambos:
| Keyword | Type | Behind | New? | Est. searches/day | Started rising | Peak vs gpts | Peak day | Last 7 days vs the 7 before | Now | Page one | Decision |
| **photocraft** 🖼 | name | — | yes | 12747 | 2026-10-05 | 97 vs 3.1 | 2026-10-09 | — | still rising | — | **prioritize** |
| **claude haiku 5.5** | name | — | yes | 1863 | 2026-10-07 | 100 vs 23.7 | 2026-10-08 | ×6.0 | still rising | — | **prioritize** |
| **ai image detector** 🖼 | generic | synthid detector | no | 2537 | — | 87 vs 31.6 | 2026-10-04 | ×1.2 | flat | — | watch |
| **photoshop alternative** ⚠ | generic | photocraft | no | 244 | — | 61 vs 61.7 | 2026-10-08 | ×1.8 | flat | — | skip |
(una ejecución real, 2026-10-12, abreviada; la columna de Primera página llegó después, ver abajo)
Cómo se hace (radar/usecases.py):
- Evidencia: las publicaciones con más me gusta que mencionan el nombre (búsqueda avanzada de X) y, para un repositorio, su README.
- Frases: un modelo lee la evidencia y escribe la palabra clave que una persona normal teclearía para cada tarea que ve hacer a la gente, con una cita que la respalde. Una frase construida sobre el nombre de otro producto ("photoshop alternative") se conserva y se marca ⚠: la demanda suele depender del líder del mercado, y usar la marca de alguien es tu decisión. Con una clave de GoAnyAPI (opcional, abajo) el radar también toma las consultas relacionadas de Google Trends para el nombre: qué buscó realmente la gente junto a él. Para SynthID Detector eso dio "ai photo detector", "google ai detector" y "ai detector"; estas filas llevan 🔎. Las consultas que contienen el nombre se listan como sus colas largas ("photocraft download", "nano banana 2.1 vs pro"). Las consultas que son a su vez nombres de otras cosas en auge ("gpt image 2.5" junto a "nano banana 2.1") se conservan como candidatos propios.
- Filtro: una segunda llamada puntúa lo bien que el nombre responde a cada frase, marca marcas, y detecta los nombres de otras cosas; las relacionadas de forma vaga se descartan. Para Claude Haiku 5.5 descartó las seis propuestas ("ai coding assistant", "github copilot alternative"); para SynthID Detector conservó las cinco.
- Volumen: búsquedas mensuales de Google Ads para el resto, una llamada por lotes. Las frases por debajo de
min_volumese descartan; la mayoría lo son. - Tendencias, dos veces por fila: el término solo da la forma (nuevo o no, el día que empezó a subir, el pico, la última semana contra la anterior, qué está haciendo ahora); el término junto a una palabra clave de referencia (
gptspor defecto) da el tamaño. - Primera página, para las filas sobre las que se actuaría (ocho como máximo): la primera página de Google (unos $0,002 por palabra clave), la puntuación de cada sitio en ella (GoAnyAPI, $0,002 por sitio, conservada 30 días) y la dificultad de la palabra clave ($0,012 por llamada). Con una clave de GoAnyAPI también quién construye ya para el término y quién paga por él: las páginas que Google mantiene con él en el título del último mes (
pages built) y los dominios que ejecutan anuncios de Google sobre él (advertisers, de la transparencia de Ads), $0,008 por fila.open= tres o más de los diez resultados están en sitios puntuados por debajo de 30, o dificultad por debajo de 20;crowded= ninguno lo está y la dificultad es 40 o más;mixeden medio. Bajo la tabla nombra el sitio más débil de la primera página, donde una página nueva puede colarse, y qué tipos de páginas la ocupan (herramientas, listas, artículos, vídeos, foros). Anuncios en la página significan que alguien paga por ese clic.
Las búsquedas al día son estimaciones. Las de un término genérico vienen de su propio volumen de Google Ads, movido a hoy a lo largo de su propia curva de Trends. El punto de referencia se dimensiona entonces a partir de esos términos, y un nombre, que aún no tiene datos de volumen, se dimensiona contra el punto de referencia.
Decisión: priorizar = subió en los últimos 30 días, sigue arriba, al menos min_daily búsquedas al día. vigilar = subió pero es menor, demasiado pronto para leerlo, o plano con demanda constante de ese tamaño. saltar = en declive, o plano y pequeño. Un prioritize cuya primera página es crowded se convierte en watch ↓: sigue subiendo, pero la primera página pertenece a sitios fuertes. En la primera semana de un nombre la primera página aún se está formando (noticias, las páginas propias del creador); la segunda lectura tres días después es en la que confiar.
Marcas: 🎬 vídeo, 🎙 voz, 🖼 imagen dice qué hace la cosa, el orden habitual de lo que los visitantes pagan (vídeo > voz > imagen > texto); los candidatos de igual rango se ordenan por ello. ⚡ = una publicación con 1.000 o más me gusta recorre un flujo de trabajo manual o aprovecha una tendencia: una herramienta de un clic que nadie ha construido aún. Ambas vienen de reglas de palabras clave sobre las propias palabras y publicaciones del candidato; en seis nombres conocidos (Nano Banana, Veo 3.1, Seedance 2.5, Claude Opus 5.5, ElevenLabs v4, Qwen Image 2.1) el formato salió bien en los seis y ⚡ se disparó una vez, en un tutorial ampliamente compartido de Opus 5.5 + Blender + Unreal. Lee las publicaciones antes de actuar sobre una marca.
Cada nombre se lee dos veces, el día que aparece y tres días después, porque el día del anuncio las publicaciones son anuncios y aún no se ve ningún uso. Los términos genéricos se conservan como candidatos y se revisan después de 14 días como los nombres.
Qué esperar de ello, de los primeros ocho nombres con los que lo probamos:
- Los nombres subieron; la mayoría de los términos genéricos no, en cinco días. PhotoCraft, Claude Haiku 5.5 y SynthID Detector subieron claramente. De los términos genéricos detrás de ellos, uno se movió: "photoshop alternative" corrió alrededor de un 80% por encima de su nivel en EE. UU. durante cinco días después de que apareciera PhotoCraft. La serie diaria mundial que lee la tabla no mostró casi nada de ello (2, 1, 1, 2, 4, 2); una serie diaria de EE. UU. de otra fuente lo mostró claramente. Así que una lectura plana de la serie mundial no prueba que un término no se moviera. Con una clave de GoAnyAPI las filas más grandes se leen de la serie de un solo país en su lugar, donde una subida es 1,5 veces el nivel anterior mantenido durante tres días; la misma ejecución muestra entonces "photoshop alternative" como
still rising (US). - El uso fiable de la tabla hoy es decirte a qué demanda existente sirve una cosa nueva y cuán grande es ("ai image detector", unas 2.500 búsquedas al día). Si los términos genéricos siguen a los nombres es lo que mostrará la revisión de 14 días, y aún no tenemos resultado.
- Para lanzamientos de modelos puros (Claude Haiku 5.5, Nano Banana 2.1) la evidencia eran anuncios y puntos de referencia, y las frases propuestas eran débiles ("ai coding assistant"). Funciona mejor para productos y repositorios que hacen una sola tarea.
- Los últimos dos días de Google Trends no están asentados. Para términos no relacionados volvieron como 0 y luego 100, lo que se lee como un pico. Nuestra primera pasada se dejó engañar exactamente por esto; cada lector en el código ahora descarta esos dos días, y una subida debe durar dos días para contar.
- Los volúmenes de Google Ads van unos dos meses por detrás. Trends no lee nada fiable para términos por debajo de unos cientos de búsquedas al mes.
Cuando una fuente falta o está caída
La tabla se escribe igualmente, pero se vuelve más fina, y dice qué parte falta:
| Qué pasa | Qué pierde la tabla | La línea que imprime |
|---|---|---|
Sin GOANYAPI_API_KEY (el valor por defecto) | Las filas 🔎, las colas largas de cada nombre, los otros nombres buscados junto a él, y las lecturas de (US). Las frases vienen solo del modelo y cada curva de la serie mundial, donde un movimiento real puede leerse plano | "Related queries are off: set GOANYAPI_API_KEY…" |
| Trends de GoAnyAPI está caído (visto en su primer día de uso, 2026-10-12) | Lo mismo que no tener clave, para esa ejecución | "Related queries failed for: …" y "Country series failed, worldwide data used instead: …" |
| La búsqueda de publicaciones de AIsa falla para un nombre (tiempos de espera vistos dos veces el 2026-10-13) | Las publicaciones de ese nombre. Un repositorio aún tiene su README; un modelo o producto sin él se queda solo con las consultas relacionadas, y sin clave de GoAnyAPI no recibe términos genéricos ese día | "The post search failed; this run used READMEs and related queries only: …" |
| Ni publicaciones ni README para un nombre | Sus términos genéricos; la fila propia del nombre se mantiene | "No posts or README found for: …" |
| Ningún candidato ese día es una cosa con una puntuación de nombre de 0,8 o más | Toda la tabla | "Nothing to read today…" |
| La búsqueda de volumen o de Trends de AIsa falla | Toda la tabla: estas dos no son reemplazables | el error, en lugar de la tabla |
Una tabla fina no es un día tranquilo. Lee las líneas debajo de ella antes de concluir que nada se movió.
Establece "usecases": {"per_day": 0} o pasa --skip usecases para desactivarlo.
⑥ Ingresos: lo que la gente ya paga
Un producto que genera dinero demuestra la demanda que hay detrás. Con TRUSTMRR_API_KEY configurado (desde el panel de desarrollador de TrustMRR), el radar lee una vez por semana (revenue.weekday, lunes por defecto) los 30 productos de más rápido crecimiento con al menos min_revenue_usd ($500) en los últimos 30 días y los 30 listados más nuevos, y guarda lo que ve. Los listados más nuevos casi no ganan nada todavía; se leen para registrar desde dónde empiezan, de modo que un producto que estaba en $0 la última vez y ahora supera el umbral se destaca primero. Los listados ocultos ("Anonymous startup") se omiten, y el nombre legal de una empresa cede ante el nombre de su sitio ("Talent Tech Global Limited" se lee como gptproto). La descripción de cada producto va a la tabla de palabras clave como evidencia, de modo que la tabla lee el trabajo por el que la gente paga, no solo la marca. Un crecimiento superior al 1,000% se lee como "subió desde casi $0": en la primera ejecución, la mayoría de los que más crecieron habían empezado desde casi nada.
Los términos de la API de TrustMRR prohíben republicar sus datos y crear páginas SEO públicas a partir de ellos. Usa los clientes potenciales para tu propia investigación; no publiques la lista.
⑦ Peticiones: la demanda expresada en voz alta
Una vez por semana, el radar busca en Reddit una docena de formas en que la gente pide una herramienta ("is there an AI tool", "I wish there was a tool", "how do I automate", en asks.patterns), conserva las publicaciones de la última semana con una puntuación de 2 o más, y un modelo pequeño las clasifica: una solicitud, una queja, una solución compartida u otro. Para solicitudes y quejas, una herramienta de IA podría responder escribiendo el trabajo como una persona lo buscaría ("add b roll automatically", "convert slides to notes"). Los trabajos con al menos 50 búsquedas al mes se listan con sus publicaciones y reciben la verificación de la primera página; cada uno se convierte en un cliente potencial. La mayoría de las peticiones son demasiado específicas para tener búsquedas todavía: en la primera semana real, 84 publicaciones contenían 43 peticiones y solo dos tenían 50 búsquedas al mes ("best ai tool for research", de un hilo de r/PhD con 1,034 puntos, y "best ai tool for coding"). Así que las mejor puntuadas de las demás también se listan, como ideas más que como palabras clave. Un mes de publicaciones leídas en una prueba contenía una solicitud de "an AI tool to convert PowerPoint lecture slides into notes", el mismo trabajo que un curso de un sitio de herramientas usa como ejemplo práctico.
Las publicaciones son para tu propia investigación: cítalas, no las republices.
⚡ Lo que piden los espectadores de tutoriales
Para hasta tres clientes potenciales al día marcados con ⚡ (un tutorial ampliamente compartido de un flujo de trabajo manual), el radar encuentra los mejores videos tutoriales para el cliente potencial (GoAnyAPI), lee sus comentarios (AIsa, $0.001 por página) y hace que el modelo extraiga lo que piden los espectadores: los pasos que les resultan demasiado difíciles, el "¿se puede hacer esto con un clic?". Esa lista es la herramienta de un clic. Necesita una clave de GoAnyAPI para encontrar los videos.
Puntos de dolor: python -m radar pains "ai headshot"
Lo que la gente se queja sobre un tipo de herramienta, agrupado en las brechas que una nueva herramienta puede llenar:
- Reseñas de Chrome Web Store con pocas estrellas (1 a 3 estrellas) de las extensiones que Google muestra para la palabra clave, o de las que nombres con
--extension ID(GoAnyAPI: 2 créditos para encontrarlas, 3 por página de reseñas); - Publicaciones de Reddit que se quejan del trabajo o sus herramientas ("{keyword} alternative", "{keyword} frustrating", ...; AIsa);
- Comentarios bajo los mejores videos tutoriales para la palabra clave (AIsa).
Un modelo las agrupa en brechas (falta, demasiado difícil, calidad, precio, quiere una herramienta), cada una con un recuento, un ejemplo y la frase que alguien con ese problema buscaría. Alrededor de $0.05 por palabra clave. Los recuentos son de lo leído, no del mercado.
Lo que no puede leer: reseñas de App Store, Google Play y Trustpilot (DataForSEO las sirve como tareas para publicar y recuperar después, y AIsa solo ejecuta llamadas síncronas); el tablón de solicitudes de There's An AI For That (un desafío de Cloudflare frente a cada página; superarlo sería superar su protección contra bots, así que el radar no lo hace); grupos de Facebook (Meta cerró la API de Grupos en abril de 2024, y su biblioteca de investigación está abierta solo a investigadores académicos y sin fines de lucro aprobados).
Una clave, y una segunda opcional
Todo lo que el radar necesita pasa por AIsa: publicaciones de X, datos de Google Trends y dominios (DataForSEO detrás) y los modelos que juzgan nombres y proponen frases. Una clave, pago por llamada, sin suscripciones a la API de X ni a DataForSEO.
Ese enlace es un enlace de referencia: registrarse a través de él apoya este proyecto. El radar funciona igual con una clave de cualquier lugar en aisa.one.
Opcional: GOANYAPI_API_KEY (goanyapi.com) mejora la tabla de palabras clave de dos maneras, por alrededor de $0.07 al día: añade las consultas relacionadas de Google Trends para cada nombre, y lee la curva de los nombres y los términos genéricos más grandes (1,000 búsquedas al mes o más, ocho filas como máximo) de 30 días de datos diarios para un país, ajustados a ayer. Esas filas muestran el país después de "Now", como en still rising (US). Sin la clave, la tabla se construye solo con las frases del modelo y la serie mundial. El servicio es joven (lanzado por primera vez en agosto de 2026); en nuestras pruebas, las llamadas tardaron de 20 a 55 segundos y aproximadamente una de cada diez falló, así que el radar lo intenta dos veces, informa de un fallo en la tabla y continúa. Ese enlace también es un enlace de referencia.
Sin una clave de AIsa, las señales gratuitas siguen funcionando (Hugging Face, GitHub, sitemaps, Search Console); el informe entonces lista cada término sin ordenar, porque nada juzga cuáles son nombres.
Inicio rápido
Python 3.10 o más reciente. El radar usa solo la biblioteca estándar.
git clone https://github.com/zhuyansen/new-term-radar
cd new-term-radar
cp config.example.json config.json      # then edit: your X accounts, sitemaps, topics
export AISA_API_KEY=...                 # from https://go.aisa.one/yansen-zhu; or `aisa login` with the AIsa CLI
python -m radar daily --out report.md
La primera ejecución construye sus instantáneas: el vocabulario de X de ayer, los recuentos de estrellas y las URL de sitemap aún no existen, así que solo se informan los desgloses de GitHub (que no necesitan ayer). Desde la segunda ejecución en adelante, cada señal informa qué cambió.
Dos comandos:
python -m radar sources --out sources.md           # ① only: X and Hugging Face. Run every few hours.
python -m radar daily --skip x,hf --out report.md  # everything else, once a day
sources escribe un informe solo cuando hay un nombre nuevo. daily con --skip x,hf lista lo que sources guardó en las últimas 24 horas. Si ejecutas solo una vez al día, usa python -m radar daily y no te saltes nada.
Otras banderas: --skip toma cualquiera de x,hf,breakout,sitemaps,newsites,gsc,review,judge,usecases; --new-sites ejecuta la señal semanal hoy; --mail envía el informe (abajo); --state DIR mueve la base de datos y las instantáneas.
Cómo se ve un informe
De una ejecución real el 2026-10-12 (acortado):
### Candidate new terms (names first; terms you already cover are marked)

| Term | Signals | Name score | Known | Search variants | Examples |
| **gridcraft** | GitHub breakout storytold/gridcraft ★3178 (626/day) | 0.95 | none | storytold gridcraft | GridCraft: an open-source, cl… |
| **artex** | GitHub breakout mhtsec/ARTEX ★3353 (825/day) | 0.85 | none | mhtsec artex, mht artex | AI 自主渗透测试系统 … |

Other rising terms (judged common words): anatomy, math, iphone use

### ⑤ Review (terms reported 14 days ago: did they rise in Google Trends?)

| Term | First reported | Verdict | Days ahead |
| strata | 2026-09-25 | hit | 3 |
y de sources:
| **qwen image 2.1** | Hugging Face: new at #4, 2 versions | 1.00 | none | Qwen/Qwen-Image-2.1-Turbo (text-to-image, ♥569) |
| **ltx 2.5** | Hugging Face: new at #6 | 0.90 | none | Lightricks/LTX-2.5 (image-to-video, ♥7347) |
daily también escribe report.json junto al Markdown, con todo lo que se usó para construir el informe.
config.json
| Clave | Qué es |
|---|---|
lang | "en" o "zh": el idioma del informe |
x_accounts | labs y bloggers: cuentas de X para leer. Los laboratorios dicen nombres primero; elige a los blogueros por los que se difunden los nuevos términos de tu campo |
sitemaps | Sitios cuyas páginas nuevas quieres ver. index es un sitemap, o un índice de sitemap cuando shards (una regex) elige qué sub-sitemaps leer. pause son los segundos entre solicitudes a ese sitio. strip_locale elimina /en/, /zh-CN/ prefijos para que una entrada en muchos idiomas cuente una vez |
topics | Nombre y regex: cada tema tiene su propia sección que lista los clientes potenciales, repos y consultas que coinciden |
known_terms | Términos para los que ya tienes una página, o que nunca quieres que se informen. Un cliente potencial que contenga uno, o esté contenido en uno, se marca y no se guarda para revisión |
stop_words | Palabras cotidianas de tu campo, añadidas a la lista integrada (que está ajustada para herramientas de IA) |
judge | model (cualquier modelo de chat en AIsa) y min_score (0.5) |
breakout | window_days, min_stars, velocity_min (estrellas al día), delta_min (estrellas desde ayer) |
new_sites | queries: un nombre y un patrón SQL LIKE en el dominio ("%ai%"), una consulta pagada cada uno; weekday (0 = lunes) |
review | after_days (14) y per_day (5 clientes potenciales al día) |
usecases | La tabla de palabras clave. per_day (nombres leídos al día, 0 = desactivado), model, benchmark (con qué se comparan los tamaños de palabras clave), min_volume (búsquedas mensuales que necesita una frase), min_daily (búsquedas al día para "prioritize"), recheck_days (3), related (usar consultas relacionadas cuando GOANYAPI_API_KEY está configurado), related_geo (US), country_trends (leer las curvas de las filas más grandes de ese país), country_min_volume (1000) y country_max (8) |
gsc | site (sc-domain:example.com) y token_file. Deja {} para desactivar la señal |
Por favor, lee el robots.txt de cada sitio antes de añadir su sitemap, y mantén pause en o por encima de su crawl-delay. El config de ejemplo hace unas pocas docenas de solicitudes al día en total, espaciadas por pause.
Search Console (opcional)
pip install google-auth-oauthlib
python scripts/gsc_auth.py gsc_client.json   # opens a browser once, writes gsc_token.json
gsc_client.json es un cliente OAuth de tipo "Desktop app" de Google Cloud Console, en un proyecto con la API de Search Console habilitada. Luego configura "gsc": {"site": "sc-domain:your-site.com"}. El token es de solo lectura y permanece en tu máquina; .gitignore ya lo lista.
Correo (opcional)
--mail envía el informe a través de Resend. Configura RESEND_API_KEY, EMAIL_FROM (una dirección en un dominio que verificaste allí) y RADAR_EMAIL_TO (separadas por comas). pip install markdown para la versión HTML.
Úsalo desde un agente: habilidades y un servidor MCP
Habilidades
Tres Agent Skills viven en skills/: una que hace todo el trabajo, y las dos mitades para quienes las quieren por separado.
| Habilidad | Qué hace |
|---|---|
new-term-radar | La ejecución completa: los nuevos nombres de hoy, luego la tabla de prioridad de palabras clave para ellos. También toma nombres que ya tienes. Empieza aquí |
ai-listening | Recopila lo nuevo en las últimas 24 horas en todas las señales, deduplicado, como un informe de nombres |
seo-new-keywords-research | Toma nombres, o texto bruto que los mencione, y devuelve la tabla de prioridad de palabras clave: los términos genéricos detrás de cada nombre, filtrados, dimensionados y con una decisión |
npx skills add zhuyansen/new-term-radar
En Claude Code, las tres habilidades también se instalan como un plugin:
/plugin marketplace add zhuyansen/new-term-radar
/plugin install new-term-radar@new-term-radar
Luego pídele a tu agente "today's new AI keywords", "an AI listening report" o "keyword research on PhotoCraft and SynthID Detector". Las habilidades clonan este repositorio a ~/new-term-radar si no está allí, te dicen el costo antes de cualquier ejecución pagada y avisan cuando una tabla está incompleta.
Servidor MCP
Para clientes que hablan MCP (Claude Code, Cursor, Claude Desktop):
pip install "new-term-radar[mcp]"
{
  "mcpServers": {
    "new-term-radar": {
      "command": "new-term-radar-mcp",
      "env": {
        "AISA_API_KEY": "...",
        "RADAR_CONFIG": "/absolute/path/to/config.json",
        "RADAR_STATE": "/absolute/path/to/state"
      }
    }
  }
}
| Herramienta | Qué devuelve | Costo y tiempo |
|---|---|---|
recent_leads | Lo que el radar guardó, con veredictos de revisión y la tasa de aciertos por señal | gratis, instantáneo |
keyword_table | La tabla de palabras clave para los nombres que le des | alrededor de $0.05 por nombre más $0.09 por llamada; 40 a 90 segundos por nombre |
run_radar | Una ejecución de sources o daily y su informe | pagado; minutos. Para un primer intento: el horario pertenece a cron o Actions |
Apunta RADAR_STATE al directorio donde tus ejecuciones programadas escriben y recent_leads muestra sus clientes potenciales. Los mismos dos comandos existen en la línea de comandos: python -m radar keywords "name" … y python -m radar leads.
Ejecútalo en GitHub Actions
.github/workflows/radar.yml ejecuta sources cada 8 horas y daily una vez al día, mantiene el estado en la caché de Actions y escribe cada informe en el resumen de la ejecución. Está desactivado hasta que optes por participar:
- Haz un fork del repositorio (un fork privado está bien).
- Elimina
config.jsonde.gitignorey confirma tu config. No contiene secretos. - Añade el secreto
AISA_API_KEY; opcionalmenteGOANYAPI_API_KEY,RESEND_API_KEY,EMAIL_FROM,RADAR_EMAIL_TO,GSC_TOKEN_JSON. - Configura la variable del repositorio
RADAR_ENABLEDatrue.
Cómo deciden las piezas
- Nombres en publicaciones (
radar/terms.py): palabras capitalizadas, palabras con un dígito (Qwen3.8) o mayúsculas internas (HyperFrames); un número después de un nombre se une a él (Opus 5.5). Un nombre usado por dos cuentas cuenta; un nombre usado por una sola cuenta necesita 100 me gusta y debe ser inconfundiblemente un nombre, ya que una palabra capitalizada suele ser solo el comienzo de una oración. - Aumentos en sitemaps: se cuentan por URL distinta frente a la línea base del propio sitio, por lo que una página con un slug largo no puede simular una ola.
- El juez (
radar/judge.py): una llamada de chat por cada 25 términos, cada uno con hasta tres lugares donde apareció. Si la llamada falla, el informe aún se envía, sin ordenar. - La revisión (
radar/review.py): una variante "sube" cuando su pico después del día en que la informamos supera su propia línea base anterior por 2x y por 10 puntos. Una palabra con un significado más antiguo ("strata": capas de roca, derecho de propiedad) tiene una línea base alta y no cuenta; "niko1221 strata" pasando de 0 a algo sí cuenta. Los últimos dos días no resueltos de las tendencias se omiten.
Lo que medimos, y lo que no hemos medido
- El juez de nombres (
gpt-4.1-mini) se ejecutó en 170 términos que un juez anterior había aprobado como nombres en nuestro uso diario. Coincidió en 149. De los 21 que rechazó, la mayoría eran ruido que el juez anterior dejó pasar (fragmentos de rutas de sitemap comoio.github.wxt invoice,asd); unos tres eran nombres reales que omitió (synthid detector,veo,v4.1 flash), en una prueba que le dio menos contexto que una ejecución real. No aprobó ninguno de 40 palabras comunes (dashboard,pricing,today). - Tasas de aciertos por señal: aún no. La revisión necesita 14 días por pista y la nuestra solo ha comenzado. La única verificación sembrada, Strata, resultó un acierto, tres días antes de su aumento en Trends. Tu propio informe muestra tus números a medida que se acumulan; trata cualquier señal como no probada hasta entonces.
- La señal X es tan buena como la lista de cuentas. No verá un nombre que ninguna de tus cuentas mencione.
Problemas conocidos
- Sitios nuevos (2026-10-12): la validación de AIsa para
post_dataforseo_domains_whois_overview_liveactualmente rechaza el formato de filtro que DataForSEO requiere, por lo que esta señal informa un error y el resto del informe no se ve afectado. Funcionó hasta 2026-10-06. Usa--skip newsitespara silenciarlo hasta que se solucione en el origen. - Las palabras vacías integradas y la limpieza de nombres de Hugging Face están ajustadas para modelos de IA y herramientas de agentes. Para otro campo, agrega
stop_words. - Los volúmenes de búsqueda no están en el informe. El radar te dice que un nombre es nuevo; verifica el volumen y los resultados principales antes de crear una página para él.
Desarrollo
pip install pytest markdown
python -m pytest -q tests
Las pruebas cubren la lógica (extracción de nombres, puntuación, el almacén, los informes) y no llaman a la red.
Agradecimientos
- 子木 @CoderJeffLee por la idea detrás de la tabla de palabras clave: un nombre nuevo y los términos genéricos posteriores pertenecen a una sola tabla, cada uno con una decisión.
- 饭特稀 | Fentix @fantexi997 por GoAnyAPI, la fuente opcional de consultas relacionadas y series de Trends de un solo país.
El diagrama está dibujado por docs/make_diagram.py (necesita rsvg-convert y ffmpeg).
Licencia
MIT. Extraído del radar que se ejecuta diariamente detrás de agentskillshub.top.