LLM Usage & Cost Tracker
Un medidor de costos local y multiproveedor para el uso de LLM, expuesto como herramientas MCP. Captura cada llamada en un libro contable local de SQLite y permite que cualquier agente de codificación consulte el gasto, compare proveedores y obtenga recomendaciones, sin necesidad de nube ni cuenta. Compatibilidad de primera clase con proveedores chinos (Qwen, DeepSeek) junto con Anthropic y OpenAI.
Documentación
llm-usage-mcp
LLM Usage & Cost Tracker — tu vigilante de gastos local-first


English | 中文
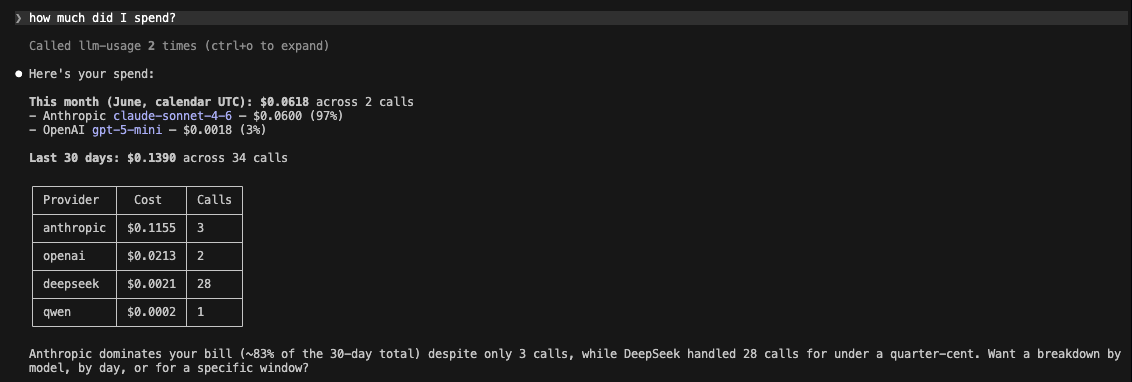
Deja de tratar tus facturas de API de LLM como una película de terror que solo miras entre los dedos a fin de mes. Descubre cuánto cuestan realmente tus llamadas a LLM — en todos los proveedores, en un solo lugar, en tu propia máquina. Pregunta a tu agente de codificación (MCP) o escribe un comando (CLI).
Es un medidor de costos, no un enrutador: te dice cuánto gastaste y qué proveedor se ajusta a una carga de trabajo — nunca modifica tus llamadas. Funciona perfectamente junto a un enrutador o una herramienta de ranking de modelos.
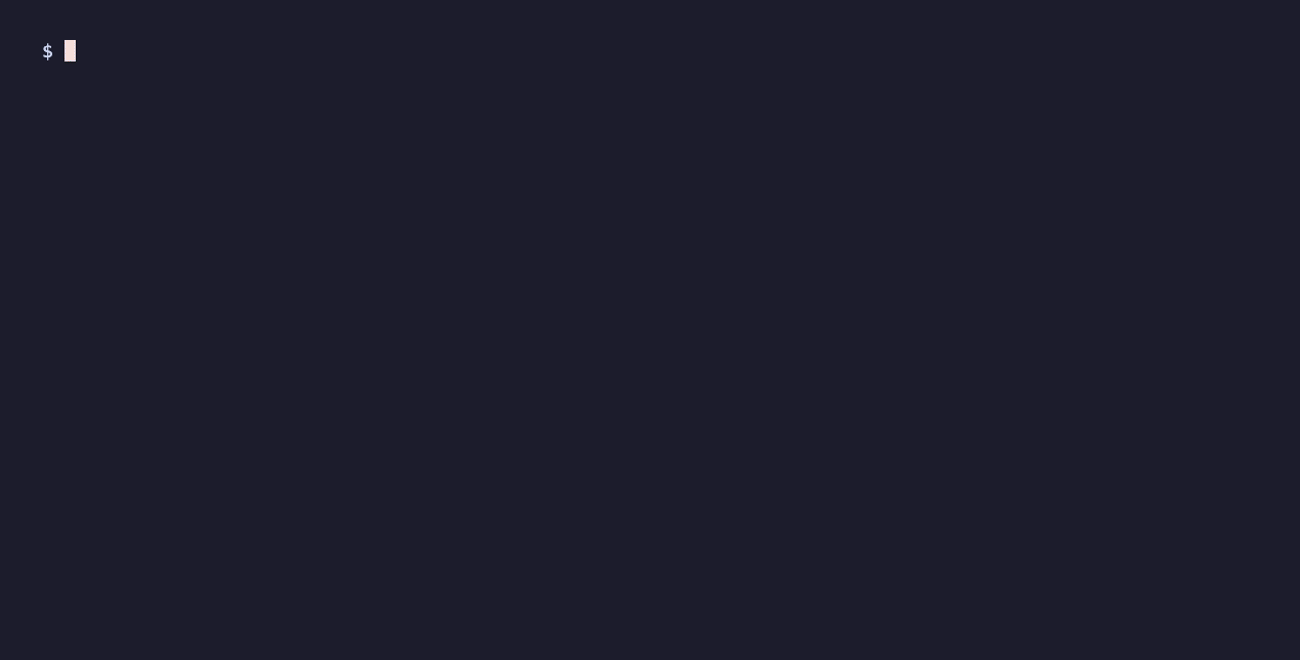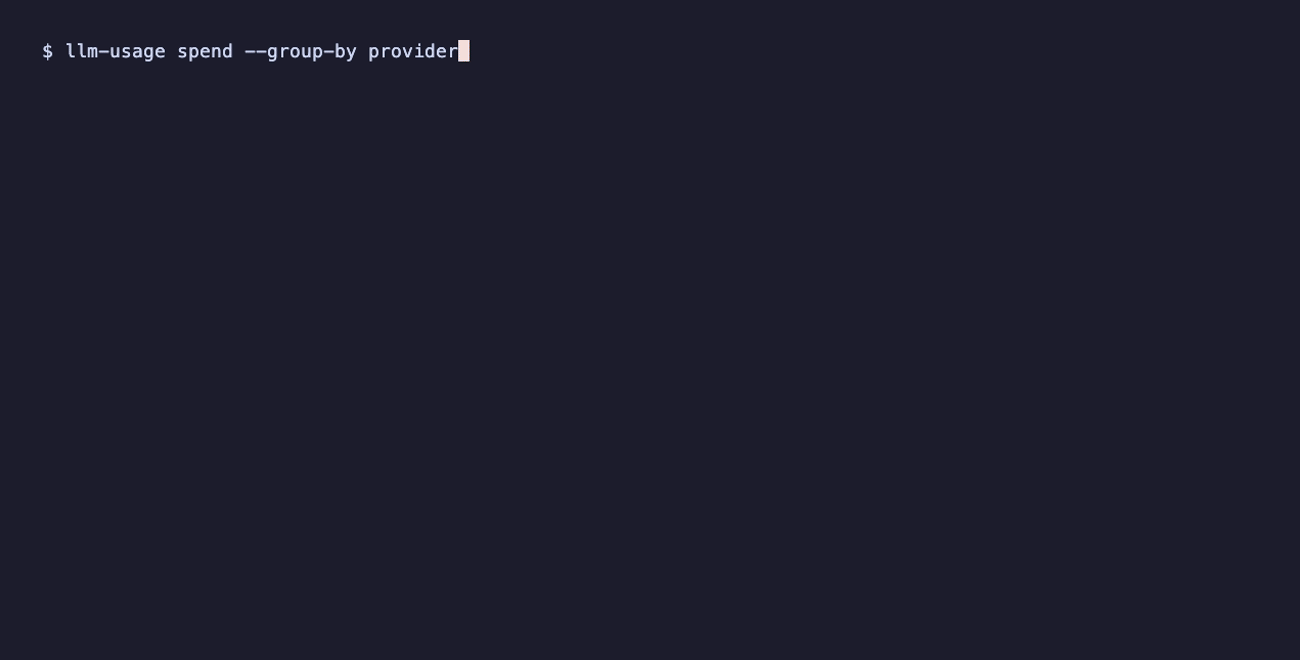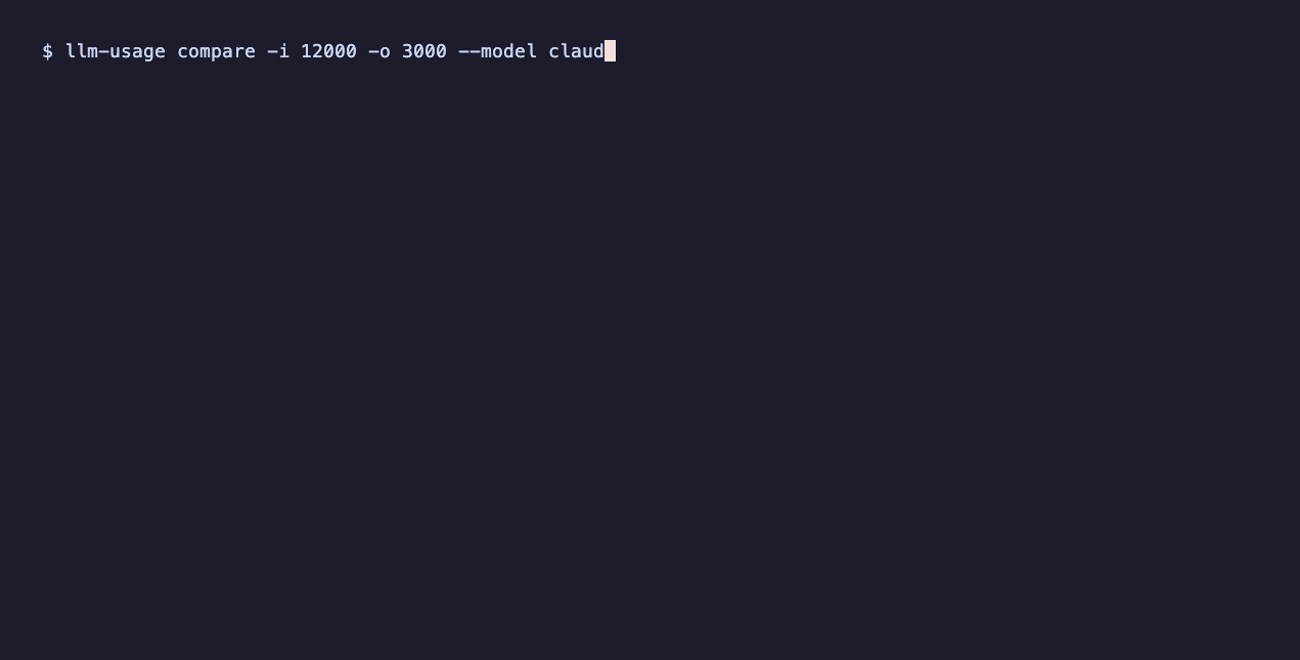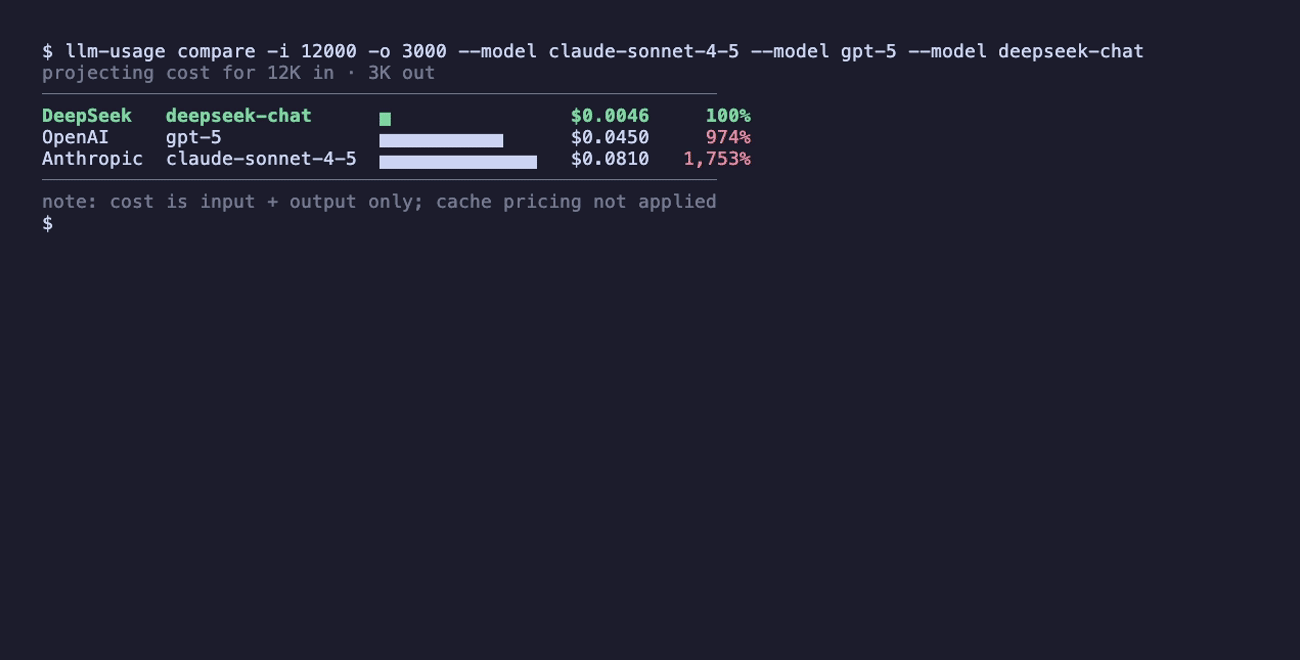
O directamente desde la terminal — el gasto de tu semana, desglosado por proveedor, y una comparación de costos entre proveedores antes de comprometerte con un modelo:
Por qué querrías esto
Estás llamando a LLMs de varios proveedores — Claude, GPT, además de modelos chinos como Qwen y DeepSeek. Cada uno factura en su propio panel, en su propia moneda, con sus propias reglas sobre cuánto cuesta un "token en caché". Así que la pregunta más simple posible — ¿cuánto estoy gastando y en qué? — se convierte en cuatro inicios de sesión en el navegador, buscar tipos de cambio de RMB a USD, e intentar descifrar qué significa realmente un "descuento por token de contexto en caché" en matemáticas de medianoche. La mayoría solo cruza los dedos y deja que la factura sea una sorpresa a fin de mes.
llm-usage-mcp captura cada llamada que haces en un almacén local, calcula su costo correctamente por proveedor en el momento en que ocurre, y devuelve la respuesta de dos maneras:
- Pregunta a tu agente de codificación. Es un servidor MCP, así que Claude Code, Cursor o cualquier cliente MCP puede responder "¿cuánto gasté en Claude esta semana?" o "¿qué proveedor es más barato para una llamada de 10k de entrada / 2k de salida?" en inglés sencillo.
- O escribe un comando. También es una CLI —
llm-usage spend,llm-usage compare,llm-usage recommend— para cuando prefieres no hacer el viaje de ida y vuelta a través de un agente.
Y se mantiene fuera de tu camino:
- Local-first. Sin SaaS, sin registro, sin telemetría. Solo un archivo SQLite en
~/.llm-usage/usage.db. La privacidad es una característica, no un ajuste. - Multi-proveedor, incluye modelos chinos. Anthropic, OpenAI, DeepSeek, Qwen — streaming y no streaming para los cuatro. DeepSeek y Qwen usan el mismo camino de captura que Anthropic y OpenAI, no un complemento añadido a posteriori. Más proveedores (Gemini, Bedrock, Moonshot, …) están en camino.
Inicio rápido
Dos minutos desde git clone hasta tu primera llamada capturada. Esta parte trata sobre la captura — registrar llamadas. Leer los datos viene después.
1. Instalar
Instala desde PyPI con uv (o pipx) — esto coloca los tres scripts de consola en tu PATH:
uv tool install llm-usage-mcp # or: pipx install llm-usage-mcp
¿Prefieres modificarlo? Clona y sincroniza desde el código fuente:
git clone https://github.com/zhaoyue722/llm-usage-mcp.git
cd llm-usage-mcp
uv sync
De cualquier manera obtienes tres scripts de consola:
llm-usage— la CLI de múltiples comandos. Consulta Desde la línea de comandos (CLI) más abajo.llm-usage-mcp— el servidor MCP stdio.llm-usage-proxy— un alias de compatibilidad; idéntico allm-usage proxy.
El Inicio rápido a continuación usa
uv run …(el flujo desde el código fuente). Si instalaste desde PyPI, los scripts ya están en tuPATH— omite el prefijouv runy registra el servidor MCP conclaude mcp add llm-usage -- llm-usage-mcp.
2. Configura al menos una clave de API
Solo necesitas una clave para los proveedores que realmente usas; el proxy se inicia de todos modos y las solicitudes por ruta devuelven 503 configuration_error para cualquier proveedor cuya clave falte.
export ANTHROPIC_API_KEY=sk-ant-...
# and/or:
export OPENAI_API_KEY=sk-...
export DEEPSEEK_API_KEY=sk-...
export DASHSCOPE_API_KEY=sk-...   # Qwen
Referencia completa de variables de entorno: docs/configuration.md (o copia .env.example a .env y complétalo).
3. Ejecuta el proxy de captura
uv run llm-usage-proxy
Se vincula solo a loopback (127.0.0.1:5525) — nunca accesible desde la red. El proxy guarda tus claves de API en el lado del servidor; los clientes nunca las necesitan.
4. Apunta tu agente de codificación al proxy
El proxy expone una ruta por proveedor. Configura la variable de entorno *_BASE_URL correspondiente en el lado del cliente:
| Proveedor | Variable de entorno del cliente | Valor |
|---|---|---|
| Anthropic | ANTHROPIC_BASE_URL | http://127.0.0.1:5525 |
| OpenAI | OPENAI_BASE_URL | http://127.0.0.1:5525/openai/v1 |
| DeepSeek | DEEPSEEK_BASE_URL (o cualquier anulación de URL base del SDK de OpenAI) | http://127.0.0.1:5525/deepseek/v1 |
| Qwen | Base compatible con OpenAI de DashScope | http://127.0.0.1:5525/qwen/v1 |
Ejemplo — lanza Claude Code con llamadas enrutadas a través del proxy:
ANTHROPIC_BASE_URL=http://127.0.0.1:5525 claude
5. Confirma que está capturando
Haz una llamada a través de tu agente (o cualquier cliente apuntado al proxy), luego verifica que llegó:
uv run llm-usage spend
Cada llamada llega a ~/.llm-usage/usage.db con tokens, costo, latencia y un request_id para idempotencia — y aparece en ese titular. Ese es el ciclo completo: captura en un lado, respuestas en el otro.
Consultando tu gasto
Una vez que las llamadas se capturan, las lees de dos maneras. Mismos datos, mismos números — elige la que se ajuste al momento.
Pregunta a tu agente de codificación (MCP)
Registra el servidor MCP con Claude Code:
claude mcp add llm-usage -- uv --directory $(pwd) run llm-usage-mcp
Luego simplemente pregunta, en inglés sencillo, dentro de esa sesión:
¿Cuánto gasté en Anthropic hoy? ¿Qué proveedor es más barato para una llamada de 10k de entrada / 2k de salida?
Claude elige la herramienta correcta y lee los números. Se exponen siete herramientas a través de stdio; las formas completas de parámetros/retornos están en docs/spec.md.
| Herramienta | Propósito |
|---|---|
query_spend | Totales + resúmenes por grupo en una ventana de tiempo (agrupar por proveedor / modelo / proyecto / etiqueta / día). |
usage_summary | Resumen principal para today / week / month / year — totales, top-N proveedores + modelos, llamada más grande. |
compare_providers | Dada una carga de trabajo hipotética (tokens de entrada / salida), clasifica cada modelo con precio por costo. |
recommend_provider | Elige el modelo con precio más barato que se ajuste a un presupuesto indicado. |
get_pricing | Inspecciona la instantánea de precios incluida. |
list_providers | Lista proveedores + sus modelos + indicador de compatibilidad con OpenAI. |
record_usage | Ruta de escritura manual — registra una llamada cuando el proxy de captura no está en juego. |
query_spend y usage_summary por defecto usan include_failed=false para que las filas de flujo parcial no contaminen los totales; se activan mediante el parámetro.
Desde la línea de comandos (CLI)
Las mismas preguntas, como CLI — ocho subcomandos bajo una consola llm-usage, para cuando escribir es más rápido que preguntar a tu agente.
Los ejemplos a continuación asumen que
llm-usageestá en tuPATH— ya seasource .venv/bin/activateouv tool install .. De lo contrario, anteponeuv runa cada comando (p. ej.,uv run llm-usage spend).
$ llm-usage
 Local-first LLM spend capture + query, exposed over MCP.

 Commands
   proxy      Run the local LLM capture proxy on 127.0.0.1.
   compare    Project the cost of a hypothetical workload across every priced model.
   models     Browse the local pricing catalog.
   recommend  Recommend the cheapest priced model for a workload + budget.
   spend      Show recorded spend over a calendar period.
   status     Snapshot of the local install: DB, proxy, providers, pricing.
   providers  List configured providers with key state, wire-format, model count.
   about      Show version, author, license, and the project homepage.
| Comando | La pregunta que responde |
|---|---|
compare | Dada una carga de trabajo, ¿quién es el más barato? |
models | ¿Cuánto cobran realmente por millón de tokens? |
recommend | Me quedan $0.04 — ¿qué modelo no me arruinará? |
spend | ¿Cuánto acabo de gastar? |
status | ¿Está todo funcionando realmente? |
providers | ¿Qué está configurado localmente? |
about | ¿Qué es esto y dónde reporto un error? |
proxy | Ejecuta el proxy de captura (igual que llm-usage-proxy). |
Convenciones que se mantienen en todos los comandos:
--jsonemite la misma forma Pydantic que devuelve la herramienta MCP correspondiente. Conéctalo directamente ajq.--color {auto,always,never}respetaNO_COLORy la detección de TTY. La paleta es un tema oscuro cálido y de bajo contraste — fácil para los ojos a las 11pm.- Los indicadores de filtro (
--provider,--model) no distinguen mayúsculas en proveedores, sí en modelos, y son repetibles cuando actúan como listas blancas. --version/-Vimprime la versión y sale.--install-completion {bash|zsh|fish|powershell}instala un script de autocompletado con tabulación — un reinicio de shell después, cada indicador es<Tab>-able.
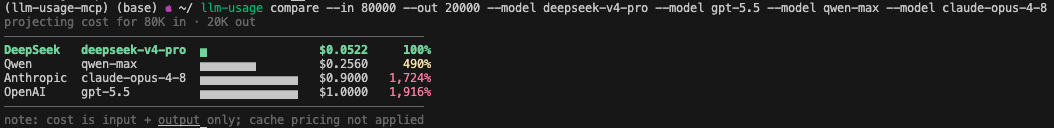
compare
Clasifica cada modelo con precio por costo proyectado para una llamada de n de entrada / m de salida. El más barato primero, porcentaje respecto al más barato. La vista predeterminada deduplica filas que comparten tanto la raíz de la familia del modelo como un precio idéntico — así que gpt-5-mini y gpt-5-mini-2025-08-07 se colapsan en una fila con ×2. Pasa --all para ver cada fila del catálogo.
# How does an 8k-in / 2k-out call price out today?
$ llm-usage compare --in 8000 --out 2000

# Just OpenAI's models:
$ llm-usage compare --in 8000 --out 2000 --model gpt-5-mini --model gpt-5-nano

# Same projection, JSON for a script:
$ llm-usage compare --in 8000 --out 2000 --json | jq '.ranked[0]'
models
Explorador de catálogo. Hermano de compare, pero responde "¿cuánto cobra este modelo?" en lugar de "¿cuánto costaría mi carga de trabajo?". Tarifas por millón de tokens, ordenadas alfabéticamente por proveedor por defecto; cambia con --sort input o --sort output para encontrar el más barato en cualquiera de los ejes. Las tarifas de caché están ocultas hasta que preguntes (--cache) porque la mayoría de los modelos no las tienen y las columnas vacías desperdician ancho.
# Full catalog, deduped.
$ llm-usage models

# OpenAI's nano models only, with cache rates:
$ llm-usage models --provider openai --match nano --cache

# Cheapest input rate first — quick "what's the floor right now?":
$ llm-usage models --sort input
recommend
Elige uno. Filtra por --provider, --model y --budget, luego devuelve la coincidencia más barata más dos subcampeones. La cadena de razonamiento explica qué se asumió y qué se eligió, para que puedas verificar en lugar de confiar a ciegas.
# Cheapest priced model, full stop.
$ llm-usage recommend

# Anything Anthropic that fits under one cent for a 1k/1k call:
$ llm-usage recommend --provider anthropic --budget 0.01

# Of these three specific candidates, which wins?
$ llm-usage recommend --model gpt-5-mini --model claude-sonnet-4-6 --model qwen-max
v1 clasifica solo por costo. --task es opcional y aparece en el texto de razonamiento; no impulsa la selección (la herramienta no es un LLM y no puede interpretar texto libre).
spend
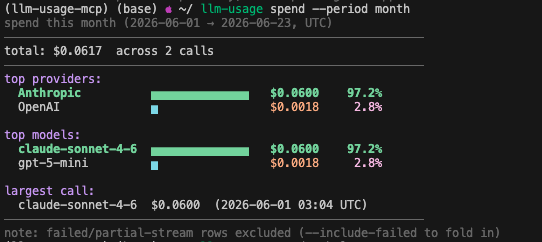
Lee el SQLite. La vista predeterminada es un titular usage_summary — dólares totales, top-3 proveedores, top-3 modelos, llamada individual más grande. Pasa --group-by para cambiar al modo de resumen.
# Headline for this week.
$ llm-usage spend

# This month grouped by model, JSON for a dashboard:
$ llm-usage spend --period month --group-by model --json | jq

# Spend on a specific project tag, day-by-day:
$ llm-usage spend --group-by day --project my-side-thing
Los límites de período son calendario UTC: today = desde las 00:00 UTC, week = desde el lunes, month = desde el día 1, year = desde el 1 de enero. Las filas fallidas / de flujo parcial se excluyen por defecto; actívalas con --include-failed.
status
Una pantalla, cuatro secciones: Base de datos, Proxy de captura, Proveedores, Precios. El comando "¿está todo funcionando realmente?". Solo lectura — ejecutarlo en una instalación nueva antes de haber iniciado el proxy o el servidor MCP imprime database not initialized en lugar de crear silenciosamente el archivo.
$ llm-usage status

# Skip the network probe (offline, CI, slow link):
$ llm-usage status --no-net

# Machine-readable for a healthcheck script:
$ llm-usage status --json
providers
Vista de configuración por proveedor. Más amplia que el bloque de Proveedores de status: añade el indicador de formato de cable (openai-compat: yes/no) y una expansión opcional --models que lista cada modelo con precio bajo cada proveedor.
$ llm-usage providers
$ llm-usage providers --models   # expand each provider with its model list
about
El panel de entrada: versión, autor, licencia y la página de inicio del proyecto. El compañero orientado a humanos de --version — los campos se leen de los metadatos del paquete instalado, por lo que coinciden con lo que muestra PyPI.
$ llm-usage about

# Machine-readable, for a script or an issue template:
$ llm-usage about --json
Proveedores compatibles
| Proveedor | Autenticación | No streaming | Streaming | Precios de caché |
|---|---|---|---|---|
| Anthropic | x-api-key | sí | sí | cache_creation + cache_read |
| OpenAI | Bearer | sí | sí | prompt_tokens_details.cached_tokens anidado |
| DeepSeek | Bearer | sí | sí | prompt_cache_hit_tokens / _miss_tokens |
| Qwen (DashScope) | Bearer | sí | sí | generalmente omitido en el endpoint compatible con OpenAI |
Más en camino. Google Gemini, AWS Bedrock, Moonshot (Kimi), Zhipu GLM, MiniMax y otros están planificados en docs/post_v1_providers.md.
De dónde provienen los precios. Los precios son una instantánea recortada y propia del JSON de precios de LiteLLM, actualizada semanalmente mediante una GitHub Action (refresh-pricing.yml). Los modelos que LiteLLM aún no incluye se completan localmente a través de pricing_overrides.json.
Configuración
Todo se maneja mediante variables de entorno (o un archivo .env en la raíz del repositorio). Los valores predeterminados son razonables: no se requiere nada para iniciar el proxy. Referencia completa: docs/configuration.md. Las tres variables que probablemente modificarás:
| Variable | Predeterminado | Propósito |
|---|---|---|
LLM_USAGE_DB_URL | sqlite:///$HOME/.llm-usage/usage.db | Ubicación de la base de datos local. |
LLM_USAGE_PROXY_PORT | 5525 | Puerto de captura del proxy (solo loopback). |
LLM_USAGE_<PROVIDER>_BASE_URL | endpoint oficial de cada proveedor | Apuntar un proveedor a un proxy inverso / puerta de enlace — útil en regiones con restricciones de red. |
Docker
Se incluye un Dockerfile mínimo solo para la validación automatizada del registro MCP (p. ej., Glama), que verifica que el servidor empaquetado arranque y responda a la introspección MCP. La forma recomendada de ejecutar el servidor sigue siendo uvx llm-usage-mcp localmente: esta es una herramienta local-first, no un servicio alojado.
Licencia
MIT.