SuperLocalMemory V2
Memoria persistente universal y local para asistentes de IA. Grafo de conocimiento basado en SQLite sin dependencias en la nube. Funciona con más de 17 herramientas (Claude, Cursor, Windsurf, VS Code, etc.). 100% gratis para siempre.
Documentación
El cerebro de memoria gobernada para cada agente de IA. Vive en tu máquina. Nunca inventa.
Una memoria para cada agente que tú y tu equipo usan — Claude Code, Codex, Cursor, Copilot, Antigravity, Hermes, ChatGPT, Claude en la web, Grok Bot, Muse y cualquier plataforma que hable MCP o ejecute un comando. Decisiones, documentos, capturas de pantalla y PDFs, recordados de la forma en que los pides, gobernados como datos de empresa, compartidos a través de una malla donde tus agentes locales y bots web se comunican entre sí, y respondidos con honestidad: cuando la respuesta no está, tu agente escucha "Eso no está en SuperLocalMemory." — no una suposición confiada.




Instalar · Verlo funcionar · Demo completa · Todas las capacidades · Documentación · Sitio web
⭐ Si SuperLocalMemory evita que tus agentes adivinen, dale una estrella al repositorio. Ayuda a otros desarrolladores a encontrarlo.
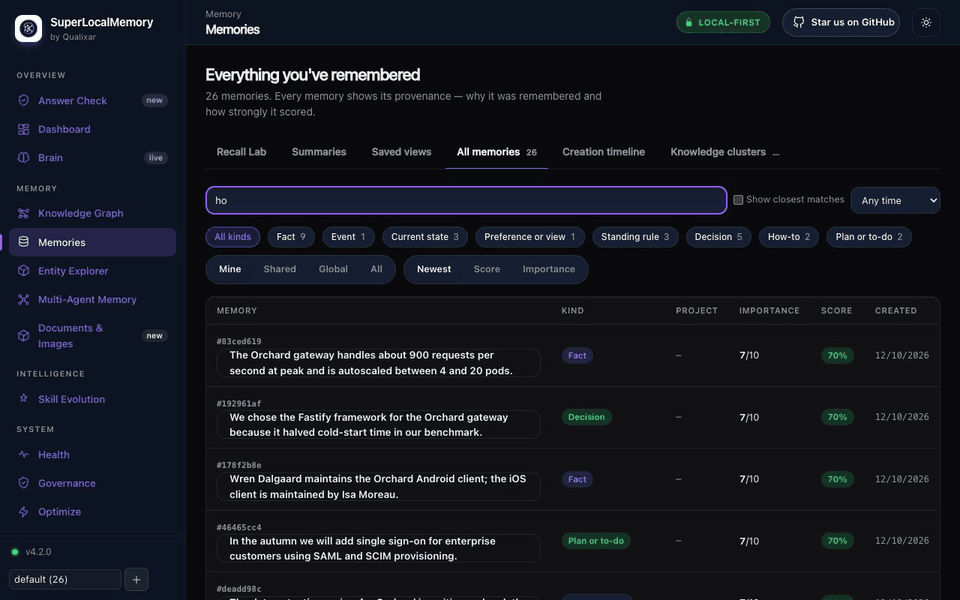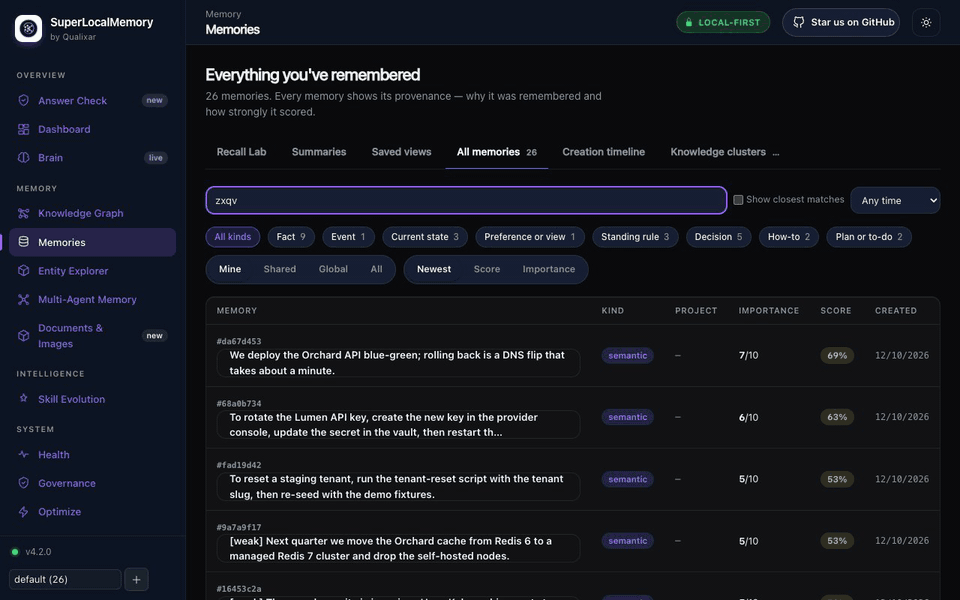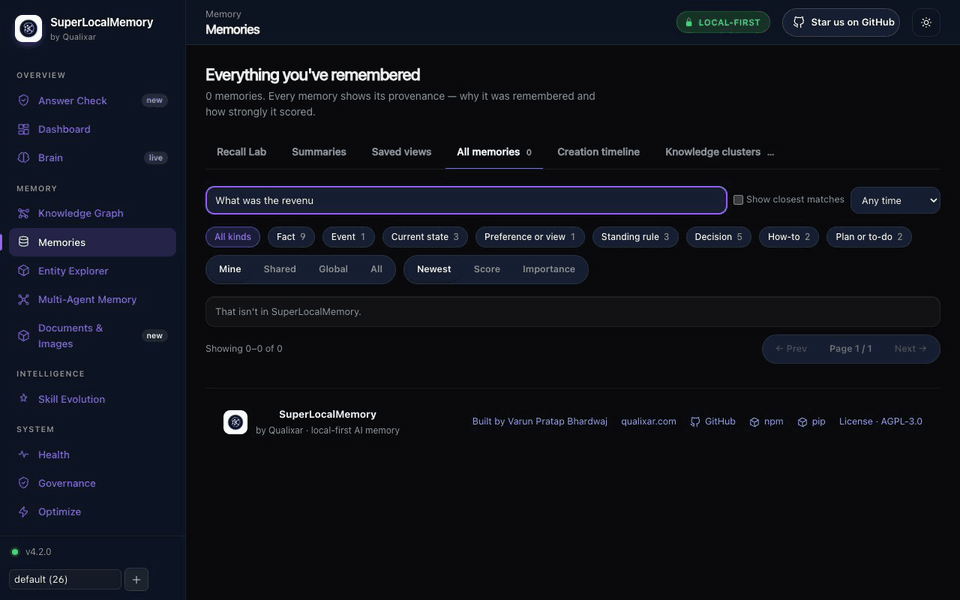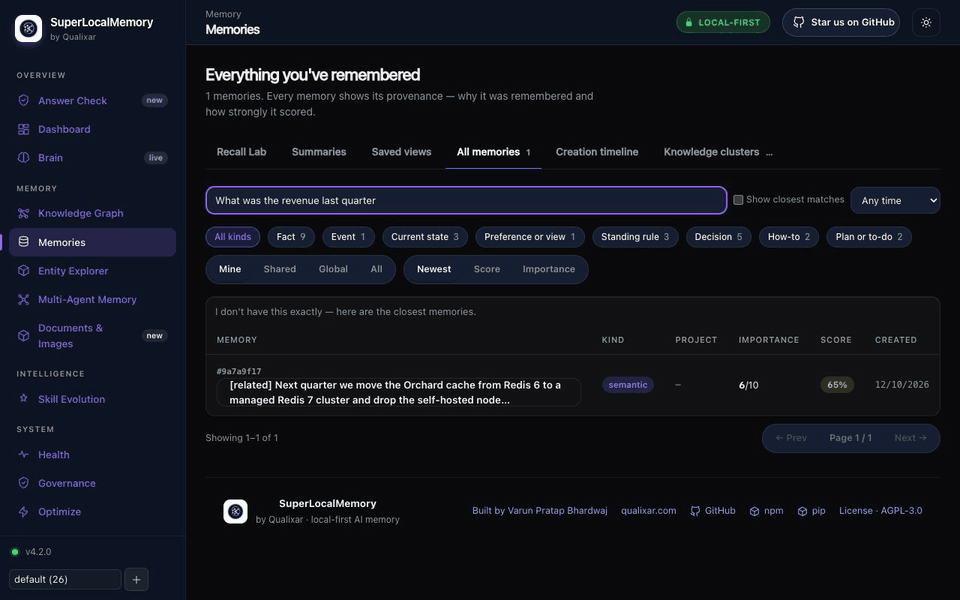
Los agentes olvidan todo entre sesiones. La solución habitual — un almacén de vectores con un botón de guardar — lo empeora: siempre devuelve algo, incluso cuando nada de lo que contiene responde la pregunta, y tu agente construye sobre eso. Esto es un cerebro de memoria, no un cubo: entiende lo que se guardó (quién, qué, cuándo, qué proyecto), lo mantiene fiel con el tiempo, gobierna quién puede verlo y se niega a inventar. Cuatro artículos de arXiv describen cómo funciona.
En el Modo A, el recordar y el recuperar básicos no hacen ninguna llamada a un proveedor de modelos: sin clave de API, sin cuenta en la nube, sin Docker. Cualquier cosa que envíe datos fuera es una elección que tú haces, y la documentación dice exactamente qué sale.
Instalación
La forma más fácil: deja que tu agente de IA lo instale. Copia el bloque de abajo en Claude Code, Codex, Cursor o cualquier agente que pueda ejecutar comandos. Lee la guía de configuración, te hace una pregunta, configura todo y te dice qué funciona. Sin comandos de terminal que tengas que aprender.
Install SuperLocalMemory on this computer for me. Follow
https://github.com/qualixar/superlocalmemory/blob/main/SETUP_FOR_AGENTS.md
step by step and show me what each step printed. Ask me only one question,
before turning on anything optional: whether I also want to find my pictures,
screenshots and PDFs by describing them. Connect SuperLocalMemory to the agent
I am using. When you finish, run slm doctor and tell me in plain words what works.
¿Sin agente de IA? Una línea en la Terminal (macOS y Linux). Trae su propio Python, configura todo, conecta las herramientas de IA que encuentra y abre el panel; no se necesita Python ni npm de antemano:
curl -fsSLo get-slm.sh https://raw.githubusercontent.com/qualixar/superlocalmemory/main/scripts/get-slm.sh && sh get-slm.sh
Añade imágenes y documentos desde el principio con sh get-slm.sh --media al final. Primero descarga el script, para que puedas leerlo antes de que se ejecute. Windows: usa el prompt del agente de arriba, o npm o pip de abajo.
¿Prefieres la terminal? Ambas rutas terminan en la misma configuración: tu memoria de texto en esta máquina y, si dices que sí, también tus imágenes y documentos.
npm, la ruta principal (Node 18+). Instala SLM en un entorno virtual propiedad del paquete:
npm install -g superlocalmemory   # add --media to also turn on pictures and documents
slm setup                         # pick Mode A to keep everything on this machine
slm connect claude-code           # or codex, cursor, windsurf, zed, claude-desktop, jetbrains, opencode ...
pip, la otra ruta principal (Python 3.12 a 3.14), en un entorno virtual de Python que activas:
python3 -m venv .venv
source .venv/bin/activate         # Windows: .venv\Scripts\activate
python -m pip install superlocalmemory   # or, without a venv: pipx install superlocalmemory
slm setup
slm connect claude-code
slm media enable                  # optional: pictures and documents (about 1.5 GB; needs 16 GB of memory)
uv: uv tool install --python 3.12 superlocalmemory instala slm como una herramienta aislada, sin nada que activar; consulta instalación en Linux.
Plugin de Claude Code: claude plugin marketplace add qualixar/superlocalmemory, luego claude plugin install superlocalmemory@qualixar. Codex: slm connect codex, luego slm codex install.
Dos modelos, una memoria. El texto se busca con un pequeño modelo de texto local (nomic). Si activas imágenes y documentos, un segundo modelo local (EmbeddingGemma 2 de Google) los lee, y una sola recuperación devuelve ambos. El modelo de imágenes se descarga después de 30 minutos sin uso, por lo que no retiene memoria mientras solo trabajas con texto. Detalles: imágenes y documentos, primeros pasos, pasos de configuración del agente.
Clon del repositorio: ./scripts/install.sh install (macOS, Linux) o .\scripts\install.ps1 -Action Install (Windows). Funciona en Windows, Linux y macOS con Apple Silicon (plataformas).
Ejemplo de 30 segundos
$ slm remember "We deploy the API blue-green; rollback is a DNS flip." --kind decision
Queryable ✓ 1 facts
$ slm remember "Staging DB is Postgres 16 on port 5433."

$ slm recall "how do we roll back the API"
  1. [0.67] We deploy the API blue-green; rollback is a DNS flip.

$ slm recall "zxqv plorth wimble"
  That isn't in SuperLocalMemory.

$ slm remember "Staging DB moved to Postgres 17 on port 5434." --replaces <id>
Replaced ✓ 1 fact(s). To undo: slm review-correction ... rollback 1
$ slm recall "which port does staging postgres use"
  1. [0.68] Staging DB moved to Postgres 17 on port 5434.
Salida real de una instalación nueva en Modo A, recortada. Las puntuaciones clasifican los recuerdos; no son probabilidades.
Por qué SuperLocalMemory: doce superpoderes
1. Sabe cuándo no sabe. Cada recuperación vuelve en uno de tres niveles: una respuesta respaldada; los recuerdos más cercanos, etiquetados como "No tengo esto exactamente — aquí están los recuerdos más cercanos"; o "Eso no está en SuperLocalMemory." para tonterías. Justo después de un inicio dice que todavía se está calentando y muestra lo que ha encontrado, para que nunca escuches "vacío" cuando la verdad es "aún no listo". Tu agente deja de construir sobre la memoria equivocada.
2. Una segunda opinión que nunca sale de tu Mac. En Apple Silicon, SLM instala Laya, un pequeño modelo en el dispositivo que juzga si los recuerdos encontrados realmente responden la pregunta. ¿Prefieres la nube, o no estás en un Mac? Jev hace la misma verificación en línea, solo después de que marques su consentimiento.
3. Tus documentos y capturas de pantalla se convierten en una base de conocimiento que puedes consultar. Guarda una foto, una captura de pantalla o un PDF y encuéntralo semanas después describiéndolo — "la diapositiva con los números trimestrales". El modelo de imágenes es  EmbeddingGemma 2 de Google, que se ejecuta en tu computadora: un modelo lee tanto tus palabras como tus imágenes, por lo que una descripción encuentra la imagen. El OCR también se ejecuta localmente, cada página de PDF se indexa por su imagen y su texto, y cada respuesta cita su archivo y página. Ningún modelo generativo mira jamás tus archivos.
4. La idea de LLM-wiki de Karpathy, integrada — con búsqueda conservada. El patrón LLM-wiki de Andrej Karpathy convierte documentos sin procesar en una base de conocimiento organizada con un índice y una verificación de salud. SLM hace eso a partir de los datos que ya almacena — un índice de documentos de cada archivo con sus personas, proyectos y fechas, y una verificación de salud de documentos que encuentra páginas vacías, documentos no enlazados, páginas duplicadas y hechos contradictorios — mientras mantiene una búsqueda híbrida real para el momento en que necesites encontrar algo.
5. Se cuida solo. La salud de la memoria describe tus recuerdos más antiguos en segundo plano — fechas, nombres, proyectos, tipos — solo añadiendo, nunca tocando lo que escribiste. Cualquier cosa que mueva o elimine espera tu Corrección, y Deshacer lo restaura.
6. Gobernada, no solo almacenada. Cada guardado pasa una verificación de admisión y recibe un recibo. Cada lectura respeta roles, espacios de trabajo y ámbitos. Cada borrado alcanza cada copia — resúmenes, cachés, índices, espejos de imágenes — y viene con un recibo verificable. Cada acción aterriza en un rastro de auditoría encadenado por hash. Construido para equipos y para el GDPR, no añadido a posteriori.
7. Memoria con sentido del tiempo. Cada hecho sabe cuándo ocurrió y cuándo SLM lo aprendió. Pregunta qué era verdad el mes pasado, o qué sabía SLM antes de una fecha. Las correcciones reemplazan un hecho y siguen siendo deshacibles; los recuerdos no utilizados se desvanecen como lo hace la memoria humana.
8. Nunca inunda tu ventana de contexto. La recuperación en capas le da a un agente una mirada de una línea, los hechos o el contexto completo circundante — bajo un presupuesto de tokens estricto que establece. El agente profundiza con expand solo cuando lo necesita, y el caché y la compresión reversible evitan que pagues dos veces por la misma salida.
9. Muchos agentes, un cerebro. Cada escritura registra qué agente la hizo, con puntuaciones de confianza contra el envenenamiento de memoria, para que diez agentes puedan compartir una memoria sin envenenarla.
10. Tus agentes se comunican entre sí — incluso a través de internet. A través de SLM-Mesh, los agentes en tu computadora y los bots en la web finalmente comparten una conversación. Las sesiones de Claude Code, Codex y Hermes intercambian mensajes, esperas, bloqueos y estado compartido, en una o varias máquinas, para que un agente pueda pasar trabajo a otro y dos nunca editen el mismo archivo a la vez. Y los bots que permites — ChatGPT, Claude en la web, Grok Bot, Muse — se unen a la misma malla: un bot en tu navegador puede enviar un mensaje al agente en tu portátil por nombre y leer su respuesta. Cada mensaje llega etiquetado como dato, nunca como instrucción; un bot web lee nuevos mensajes cuando comienza su siguiente turno.
11. Aprende cada día, y no puede empeorar silenciosamente. Cada resultado informado lo enseña: la clasificación aprende qué recuerdos realmente ayudaron, los hábitos estables se convierten en prompts suaves para nuevas sesiones, y las habilidades del agente se miden y revisan. Un nuevo clasificador se promueve solo con una victoria estadísticamente válida y se revierte automáticamente si se desliza. El trabajo se ejecuta como bucles acotados que terminan solo cuando una puerta independiente pasa — nunca por la palabra de un agente — y los pipelines de múltiples pasos se ejecutan como grafos acotados con Bucles Acotados, cuyas ejecuciones completadas SLM conserva como evidencia de solo lectura.
12. Ciencia, no vibraciones. Cuatro artículos de arXiv respaldan cada capa: recuperación de geometría de la información, olvido inspirado biológicamente, confianza bayesiana contra el envenenamiento de memoria y memoria gobernada con costos medidos. Las matemáticas centrales se ejecutan sin un modelo de lenguaje, y los benchmarks publicados establecen exactamente cómo se midieron.
SuperLocalMemory es parte del trabajo de Ingeniería de Fiabilidad de IA de Qualixar: memoria de agente que es observable, acotada y honesta sobre lo que no sabe.
Verlo funcionar
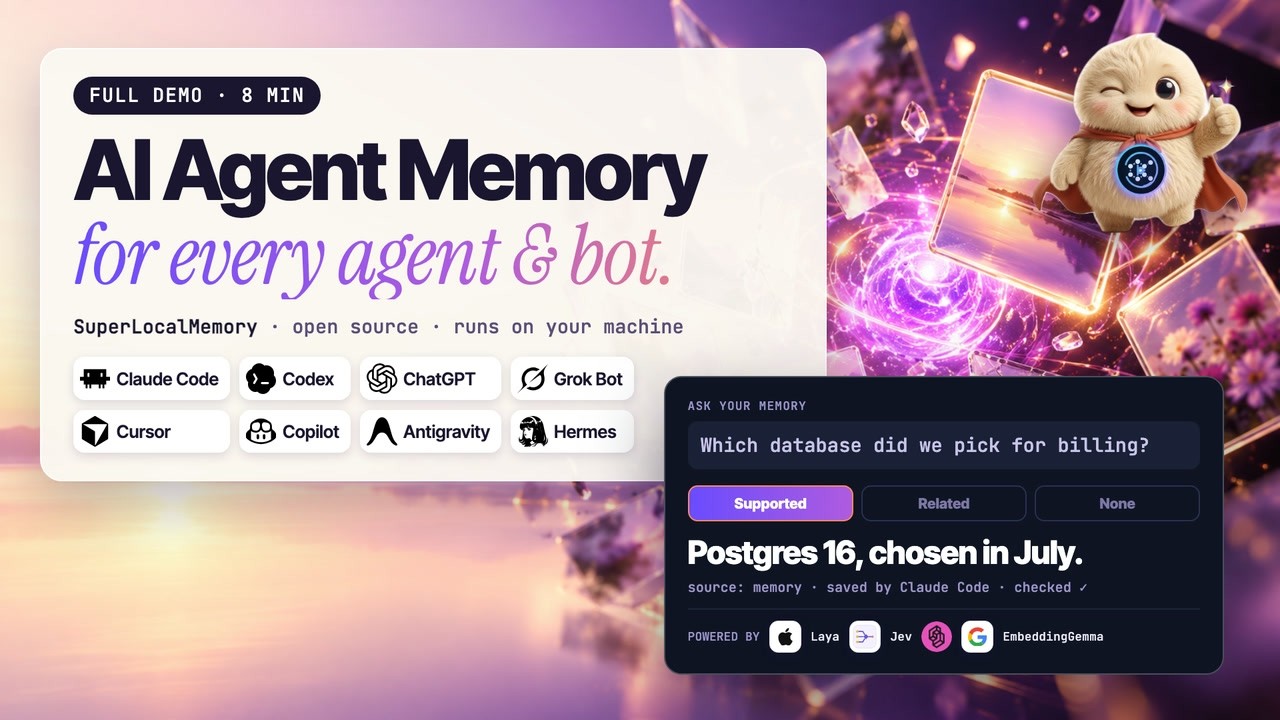
La demo completa de ocho minutos: una memoria compartida por tus agentes de codificación y bots, cada pestaña.
Añade SuperLocalMemory a tu aplicación
No necesitas esperar por una tienda de aplicaciones. Cada aplicación de abajo puede tomar SuperLocalMemory directamente de este repositorio de GitHub, qualixar/superlocalmemory, en dos pasos.
Paso 1, una vez por computadora. Instala SuperLocalMemory: npm install -g superlocalmemory (o pipx install superlocalmemory). Tu memoria vive en esta computadora desde entonces.
Paso 2, en cada aplicación que uses:
| Tu aplicación | Qué hacer |
|---|---|
| Claude Code (terminal y aplicación de escritorio) | Escribe /plugin marketplace add qualixar/superlocalmemory, luego /plugin install superlocalmemory@qualixar |
| Claude Desktop | Ejecuta slm connect claude-desktop, luego reinicia Claude Desktop |
| ChatGPT, Claude en la web, Muse, Composio | Abre el panel (slm dashboard) → Acceso web → actívalo, luego añade el enlace que muestra como conector en esa aplicación (paso a paso) |
| Codex (terminal y aplicación de escritorio) | Ejecuta codex plugin marketplace add qualixar/superlocalmemory --ref main, luego codex plugin add superlocalmemory-codex@qualixar |
| Cursor (editor y ventana de Agents) | Ejecuta slm connect cursor, luego reinicia Cursor |
| VS Code (chat de Copilot en el editor) | Instala la extensión de SuperLocalMemory (.vsix desde la última versión: Extensiones → ... → Instalar desde VSIX) |
| Ventana de Agents de VS Code, GitHub Copilot CLI | Ejecuta slm connect copilot-cli; para las habilidades, añade qualixar/superlocalmemory en la pantalla de Plugins de la ventana de Agents |
| Antigravity | Ejecuta agy plugin install "$(npm root -g)/superlocalmemory/antigravity-plugin" |
| Grok CLI | Ejecuta grok plugin install 'qualixar/superlocalmemory#plugin' |
| Grok Bot | En la pantalla de Plugins de Grok, añade el marketplace qualixar/superlocalmemory y añade superlocalmemory |
| Muse CLI | Ejecuta slm connect muse, luego muse plugins install "$(npm root -g)/superlocalmemory/muse-plugin" y muse plugins approve superlocalmemory |
| Hermes (terminal y aplicación de escritorio) | Ejecuta hermes plugins install 'https://github.com/qualixar/superlocalmemory.git#hermes-plugin', luego slm upgrade-hosts --host hermes --apply |
| OpenClaw | Ejecuta slm connect openclaw |
| Windsurf, Zed, JetBrains, Gemini CLI, OpenCode, Continue | Ejecuta slm connect <app>, por ejemplo slm connect windsurf |
| Cualquier otra cosa que hable MCP | Añade un servidor con el comando slm y el argumento mcp |
Reinicia la aplicación después de añadir SuperLocalMemory. Luego pregúntale algo como "¿Qué recuerdas sobre este proyecto?" La guía de plugins tiene los detalles para cada aplicación, y slm doctor verifica tu configuración.
Funciona con tus agentes
Cada plataforma, cada bot, una memoria. Cualquier plataforma que hable MCP (slm mcp, o http://127.0.0.1:8765/mcp/) o pueda ejecutar un comando (slm remember, slm recall) puede usar SuperLocalMemory. Los plugins empaquetados son ejemplos listos para usar, no un límite.
| Host | Conexión | Lo que obtienes |
|---|---|---|
| Claude Code | claude plugin install superlocalmemory@qualixar | MCP, 16 habilidades, 4 agentes, /slm-loop, hooks de sesión y de recuerdo |
| Codex | slm connect codex, luego slm codex install | MCP, 16 habilidades, 4 agentes, /slm-loop, hooks de ciclo de vida |
| GitHub Copilot (VS Code, Visual Studio, JetBrains, CLI) | slm connect vscode-copilot --here | MCP, reglas de agente, 16 indicaciones, 4 agentes, hooks |
| Antigravity | agy plugin install el plugin incluido | MCP, 16 habilidades, 4 agentes, /slm-loop, hooks |
| Hermes | Plugin nativo, luego slm upgrade-hosts --host hermes --apply para otorgarle el servidor de memoria | 16 habilidades, agentes asesores, /slm <command>, hooks de recuerdo y de sesión |
| VS Code | La extensión SuperLocalMemory (.vsix en la página de lanzamiento) | El servidor de memoria en la lista de herramientas del agente, nada que editar |
| Grok CLI | slm connect grok-cli, luego grok plugin install el plugin incluido | MCP, 16 habilidades, 4 agentes, hooks de sesión y de recuerdo |
| Ventana de Agentes de VS Code, GitHub Copilot CLI | slm connect copilot-cli; habilidades y agentes desde la pantalla de Plugins | MCP, 16 habilidades, 4 agentes |
| OpenClaw | slm connect openclaw | MCP y 14 habilidades |
| Muse CLI | slm connect muse, luego muse plugins install el plugin incluido | MCP, 16 habilidades, 4 agentes, /slm-loop, hooks de sesión y de recuerdo |
| Grok Bot y hosts con formato Cursor | Añade el marketplace de plugins qualixar | Un plugin ligero diseñado para computadoras bot compartidas (guía) |
| Cursor, Windsurf, Zed, JetBrains, Gemini CLI, Claude Desktop, OpenCode, Continue | slm connect <name> | MCP en la configuración propia de esa herramienta |
| ChatGPT, Claude en la web, Muse, Composio | Acceso web opcional desde el panel: inicia sesión por aplicación, solo lectura o lectura y guardado, elimina cualquier aplicación al instante | Tu memoria local, desde la web; la base de datos nunca sale de tu computadora (guía) |
| LangGraph, LangChain, LlamaIndex, CrewAI, AutoGen, Semantic Kernel, Microsoft Agent Framework, Google ADK, OpenAI Agents | Adaptadores de framework | Memoria dentro de tu propio código (adaptadores) |
| Cualquier otra cosa | Pega las reglas universales de agente y dale la CLI o MCP | Disciplina de memoria para cualquier agente |
Lo que los plugins enseñan a tu agente. Cada plugin está construido desde una sola fuente, así que cada host recibe las mismas 16 habilidades (recuerdo, recordar, sesiones, gobernanza, alcances y perfiles, el grafo de conocimiento, malla, bucles acotados, caché, compresión, acceso web, imágenes y dos para computadoras bot) y 4 agentes (un asesor de memoria, un asesor de optimización, un asesor de gobernanza y un ejecutor de bucles). Los hooks se ejecutan al inicio de la sesión, después del uso de herramientas y al final de una sesión, y cada hook falla abierto: un problema de hook nunca bloquea a tu agente. Plugins, habilidades y hooks
Todo lo que hace SLM
Recuerdo que sabe cuándo no sabe
| Capacidad | Lo que obtienes | Documentación |
|---|---|---|
| Tres niveles honestos | Respaldado; memorias más cercanas (hasta tres, etiquetadas); o "Eso no está en SuperLocalMemory." Los hooks que inyectan memoria automáticamente solo inyectan respuestas respaldadas | Recuerdo |
| Calentamiento, dicho claramente | Mientras los modelos cargan, el recuerdo muestra lo que la búsqueda por palabras clave encontró bajo "SuperLocalMemory todavía se está calentando: los resultados pueden estar incompletos. Inténtalo de nuevo en unos minutos." | Recuerdo |
| Recuerdo en capas | depth 0 (una mirada de una línea), 1 (los hechos), 2 (con fuente, vecinos de sesión, entidades relacionadas y correcciones); un límite duro de max_tokens; expand profundiza en un resultado | Recuerdo en capas |
| Búsqueda híbrida | Canales semántico, por palabras clave (BM25), grafo de entidades, temporal, asociativo (Hopfield), propagación de activación e imágenes, fusionados y reclasificados; slm trace muestra la puntuación de cada canal | Recuerdo |
| Nueve tipos de memoria | Hecho, evento, estado, opinión, regla, decisión, cómo hacerlo, plan, corrección. "¿Qué decidimos?" favorece decisiones; las reglas y decisiones confirmadas se cargan al inicio de cada sesión | Tipos de memoria |
| Viaje en el tiempo | --valid-at (lo que era verdad entonces), --known-as-of (lo que SLM sabía entonces), --window 7d | Recuerdo |
| Filtros precisos | Por proyecto, agente, tema, tipo y etiquetas exactas; un resultado vacío explica por qué | Recuerdo |
| Correcciones | --replaces retira un hecho antiguo, conservado y deshacible; las ediciones pasan por correcciones revisadas con reversión | Correcciones |
| Resúmenes y vistas guardadas | Resúmenes de sesión, día y proyecto que citan sus ids de memoria; vistas guardadas como "qué envié esta semana" | Recuerdo |
| Defensa contra inyección de indicaciones | El texto recordado se trata como evidencia no confiable: secretos redactados, marcadores falsificados neutralizados, procedencia adjunta | Seguridad |
La verificación de respuestas: Laya y Jev
|
Laya — en tu Mac Un modelo pequeño en el dispositivo para Apple Silicon (aproximadamente 1.1 GB). Instalado por defecto por la configuración y ofrecido después de una actualización; nada sale nunca de la máquina. Exclúyelo con |
La misma verificación en Windows, Linux o macOS, a través de TypeSafe u OpenRouter con tu propia clave. Envía la pregunta y las tres mejores memorias, y solo después de que marques su consentimiento. Nunca se activa solo. |
 Jev — en línea, cualquier computadora
El veredicto es una entrada para la decisión de soporte, con su propio presupuesto de tiempo, y la pestaña Verificación de respuestas muestra veredictos, tiempos y con qué frecuencia la memoria no tenía respuesta, sin almacenar tus preguntas. Verificación de respuestas
Documentos, imágenes y tus notas
| Capacidad | Lo que obtienes | Documentación |
|---|---|---|
| Imágenes que encuentras describiéndolas | PNG, JPEG, GIF y WebP. EmbeddingGemma 2 de Google se ejecuta localmente y pone texto e imágenes en un solo espacio de búsqueda, así que tus palabras encuentran la imagen; OCR (Apple Vision en Mac, RapidOCR en otros lugares) hace que el texto dentro sea buscable; los datos de ubicación nunca se leen | Imágenes y documentos |
| PDFs, página por página | Cada página se indexa por su imagen y su texto; cada respuesta dice de qué archivo y página proviene, con una miniatura | Imágenes y documentos |
| Índice de documentos | Un catálogo de cada documento guardado con sus páginas y las personas, proyectos y fechas que menciona | Imágenes y documentos |
| Verificación de salud de documentos | Encuentra páginas sin texto legible, documentos no vinculados a nada, páginas duplicadas y documentos cuyos hechos fueron contradichos | Imágenes y documentos |
| Carpetas y bóvedas de Obsidian | slm sources add ~/Notes --kind obsidian refleja Markdown, archivos de lienzo, PDFs e imágenes en la memoria, solo lectura, después de mostrar lo que leería | CLI |
| Desde ChatGPT y tu teléfono | Adjunta un archivo en ChatGPT, o pide a cualquier aplicación web conectada un enlace de carga única que transmita el archivo directamente a tu computadora | Acceso web |
| Tus datos siguen siendo tuyos | Las imágenes viven en su propio almacén y nunca salen de tu computadora; borrar una memoria borra su imagen. Desactivado por defecto, un clic para activarlo; necesita 16 GB de memoria | Cumplimiento |
Salud de la memoria
| Capacidad | Lo que obtienes | Documentación |
|---|---|---|
| Descripción automática | Mientras tu computadora está inactiva, las memorias más antiguas reciben fechas de eventos, nombres, proyectos, etiquetas y tipos completados, solo agregando, nunca editando lo que escribiste, y nunca sobre un valor que estableciste | Salud de la memoria |
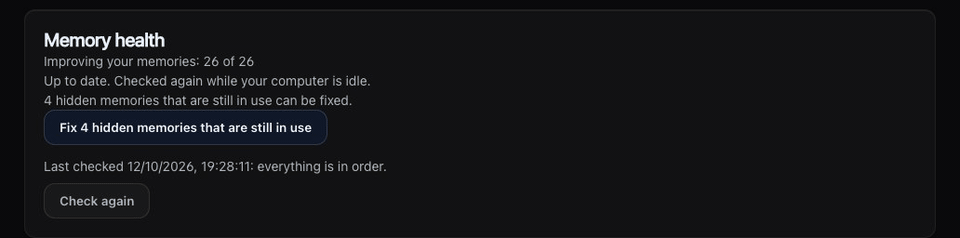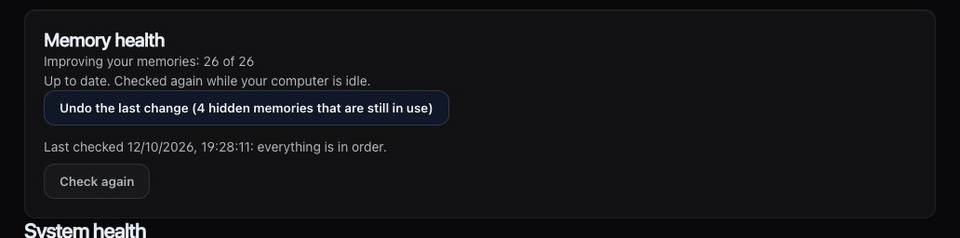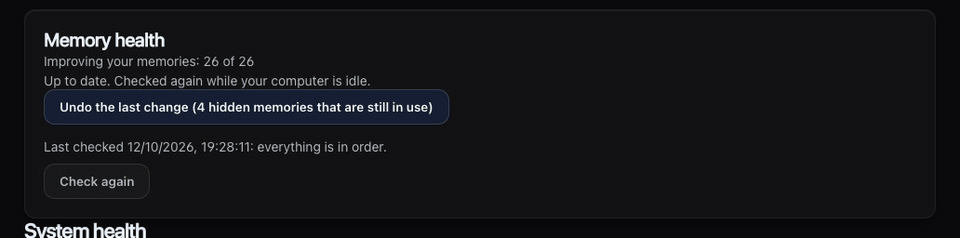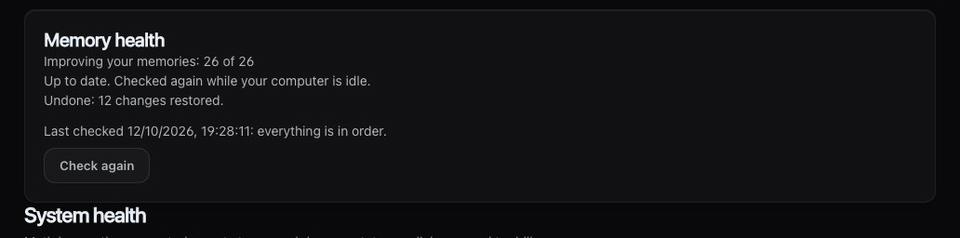
| Corregir y Deshacer | Las reparaciones que mueven o eliminan cualquier cosa (enlaces de entidades basura, memorias ocultas aún en uso, guardados que no terminaron) esperan tu Corregir; cada ejecución se puede deshacer | Salud de la memoria |
| Insignia de marcador | Los recibos y el texto estándar de sesión permanecen listados con una insignia de marcador pero nunca se convierten en respuestas | Salud de la memoria |
| Salud del almacén | slm doctor muestra qué tan localizables y descritas están tus memorias; slm db integrity y slm db repair (con deshacer) mantienen el almacén sólido | Solución de problemas |
El cerebro vivo
| Capacidad | Lo que obtienes | Documentación |
|---|---|---|
| Grafo de conocimiento | Personas, proyectos y herramientas resueltos desde tus memorias, con alias, escenas y líneas de tiempo; el Explorador de Entidades muestra cómo cambió lo que sabes | Arquitectura |
| Grafo de código | Indexa un repositorio, luego pregunta por radio de impacto, llamadores y búsqueda de código por significado | Herramientas MCP |
| Olvido que ayuda | Un ciclo de retención de Ebbinghaus y un ciclo de vida de Langevin mueven memorias descuidadas hacia el archivo; las memorias que se desvanecen se cuantifican a menos bits y se pliegan en una esencia | Investigación |
| Aprendizaje para clasificar (opt-in) | Un bandido y un modelo de aprendizaje para clasificar aprenden de los resultados; un nuevo clasificador se promueve solo con una victoria estadísticamente válida y se revierte automáticamente si empeora | Configuración |
| Indicaciones suaves y evolución de habilidades (opt-in) | Los patrones de comportamiento estables se convierten en indicaciones suaves para nuevas sesiones; las habilidades del agente se miden y revisan bajo verificación ciega | Evolución de habilidades |
Gobernanza y cumplimiento
| Control | Qué hace | Documentación |
|---|---|---|
| Roles y espacios de trabajo | Administrador, miembro y espectador por espacio de trabajo; un rol en un espacio de trabajo no otorga nada en otro; el mantenimiento y las aprobaciones actúan solo donde estás | Equipos |
| Modo empresa | Cada lectura y escritura se atribuye a una persona con sesión iniciada | Modo empresa |
| Alcances | Personal por defecto; compartido y global solo cuando eliges; el recuerdo entre perfiles se deniega por defecto | Alcances |
| GDPR | Exportación (Art. 15/20) y borrado (Art. 17) en cada almacén y cada copia derivada, con un recibo verificable | Cumplimiento |
| Auditoría y retención | Un rastro de auditoría encadenado por hash que falla la verificación si se manipula; reglas de retención por perfil; un informe de postura de la Ley de IA de la UE | Cumplimiento |
| Respaldo y restauración | Respaldo en la nube a GitHub o Google Drive, cifrado antes de la carga; un punto de restauración antes de cada actualización del almacén; una restauración mantiene una copia de seguridad y revierte si falla | Respaldo en la nube, Puntos de restauración |
Controles de ingeniería que respaldan un programa de cumplimiento, no una certificación.
Muchos agentes, una memoria
| Capacidad | Lo que obtienes | Documentación |
|---|---|---|
| Escrituras atribuidas y confiables | Cada memoria registra su agente; las puntuaciones de confianza bayesianas defienden contra el envenenamiento de memoria | Investigación |
| SLM-Mesh | Mensajes, esperas, bloqueos y estado compartido entre sesiones, en una máquina o varias | Multi-máquina |
| Bots que hablan entre sí | ChatGPT, Claude en la web, Grok Bot y Muse se unen a la malla con tu permiso: lista de pares, mensaje a un bot nombrado, lee la bandeja de entrada. Los mensajes llegan etiquetados como datos, nunca como instrucciones | Mensajes de bots |
| Bucles acotados y grafos | "Hecho" significa que una puerta independiente pasó (pruebas, un linter, un esquema), nunca la palabra del agente; cada vuelta se almacena como memoria auditable. Los grafos de múltiples pasos se ejecutan en Bucles acotados, y SLM mantiene sus ejecuciones terminadas como evidencia de solo lectura | Puente de bucles acotados |
Ahorros de contexto
| Capacidad | Qué obtienes | Documentación |
|---|---|---|
| Caché exacta | Salida de herramientas y lecturas de archivos almacenadas en caché con TTL; un acierto omite la llamada repetida | Optimizar |
| Compresión reversible | Salidas grandes reducidas de forma segura; el original exacto regresa por id | Optimizar |
| Tres formas de acceso | Funciona a través de un proxy (slm wrap claude), herramientas MCP o una habilidad; slm optimize savings muestra lo que guardaste | Configuración del proxy |
Modos, panel y escala
| Capacidad | Qué obtienes | Documentación |
|---|---|---|
| Tres modos | A: sin modelo de lenguaje en absoluto. B: un modelo en esta máquina (Ollama, donde Google Gemma 3 4B es el predeterminado y Gemma 4 está en el selector de modelos, o cualquier servidor local compatible con OpenAI). C: tu propio endpoint o un proveedor en la nube | Configuración |
| Panel | Búsqueda, grafo de conocimiento, Explorador de entidades, verificación de respuestas, salud de memoria, documentos e imágenes, aplicaciones conectadas, mensajes de bots, gobernanza: slm dashboard | Panel |
| Motor de escala | SQLite + sqlite-vec son canónicos; las copias opcionales de LanceDB y CozoDB solo sirven una vez que coinciden con SQLite | Motor de escala |
| Escrituras duraderas | Cada guardado avanza de crudo → consultable → completo con un recibo; los fallos conservan la evidencia y reintentan; los guardados de texto bajo carga se ponen en cola, nunca se rechazan | Arquitectura |
| Cambio de modelo | Cambia el modelo de embeddings en segundo plano mientras la recuperación sigue funcionando, con reversión en un solo paso | CLI |
| Acceso remoto en tu red | slm remote sirve memoria a otros ordenadores a través de TLS, una clave revocable por cliente | Despliegue |
Servidor de memoria MCP: perfiles de herramientas
Cada aplicación, plugin y extensión obtiene full (58 herramientas: toda la memoria, SLM-Mesh, optimizar, bucles; 5 más mientras las imágenes estén activadas) a menos que elijas otra cosa. Eso se adapta a hosts que limitan el número total de herramientas MCP a unas 100, con espacio para tus otros servidores. Para cambiarlo para todas las aplicaciones a la vez, ejecuta un comando y reinicia tus aplicaciones:
slm tools                # current set, and how many tools each set has
slm tools set power      # any name below; `slm tools set default` goes back to full
Para cambiar solo una aplicación, establece SLM_MCP_PROFILE en la configuración MCP de esa aplicación (slm connect <app> --profile <name> lo escribe); esto tiene prioridad sobre la elección guardada para esa aplicación. Detalles por aplicación
| Perfil | Herramientas | Para |
|---|---|---|
core | 19 | Recordar, recuperar, expandir, sesiones, optimizar, revisión de correcciones |
code | 39 | Núcleo más grafo de código, tipos de memoria, evidencia de Brain, cambio de perfil, bucles acotados |
mesh | 9 | Solo coordinación SLM-Mesh |
full (predeterminado, cuando no se establece) | 58 | Memoria, tipos, Brain, optimizar, evolución de habilidades, mesh, bucles, vistas y resúmenes (63 con imágenes y documentos activados) |
power | 70 | Completo más administración, ciclo de vida y diagnósticos (75 con imágenes y documentos activados) |
whole | 110 | Cada herramienta registrada |
stdio: {"command": "slm", "args": ["mcp"]} · HTTP: http://127.0.0.1:8765/mcp/ · Herramientas MCP
Véalo en acción
| Salud de memoria: Corregir y Deshacer | Grafo de conocimiento |
|---|---|
 | 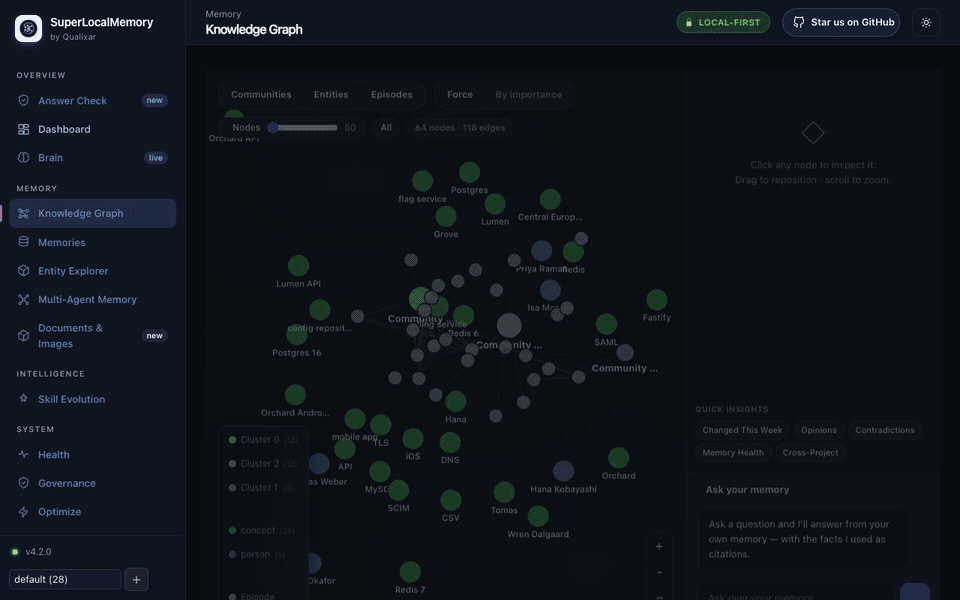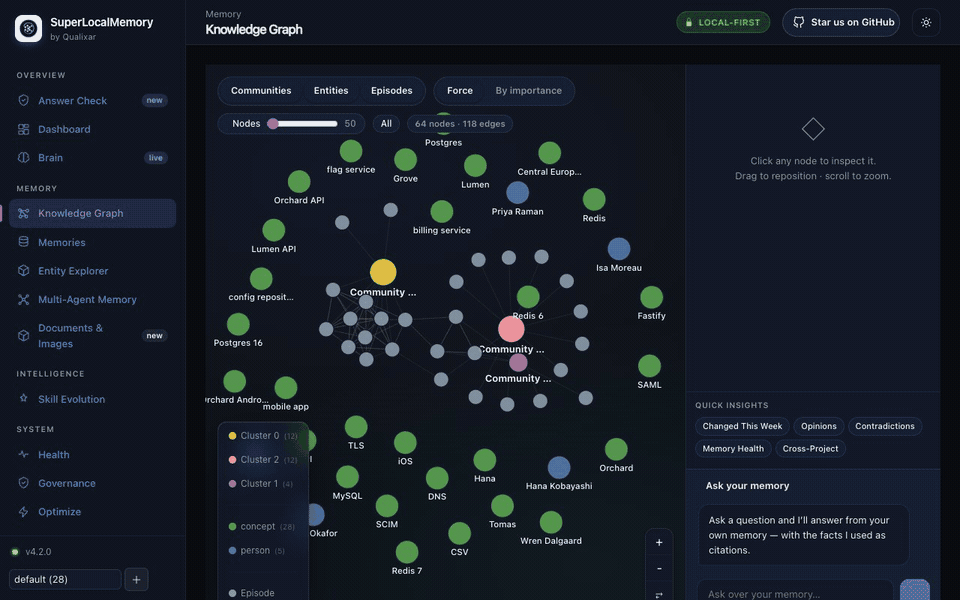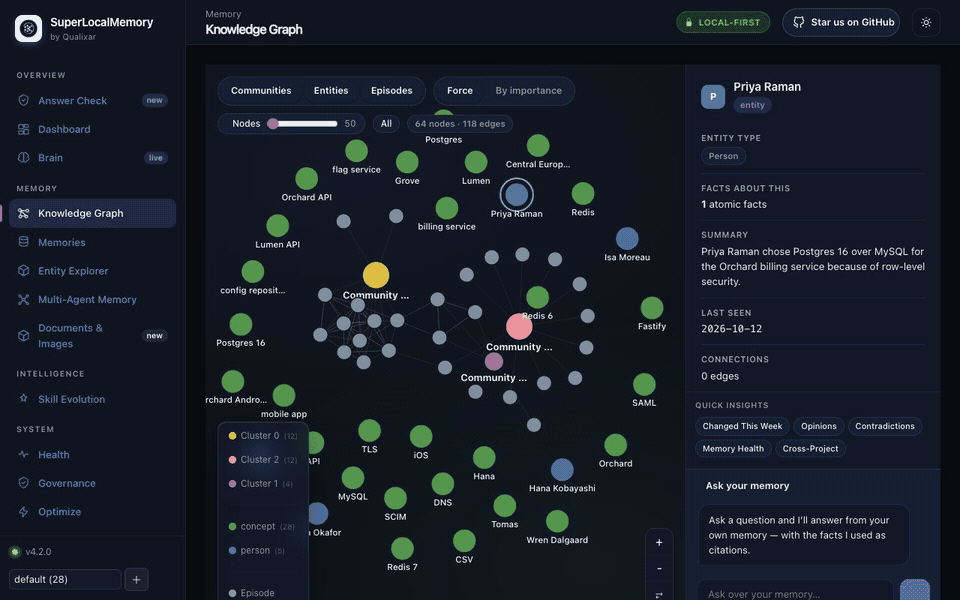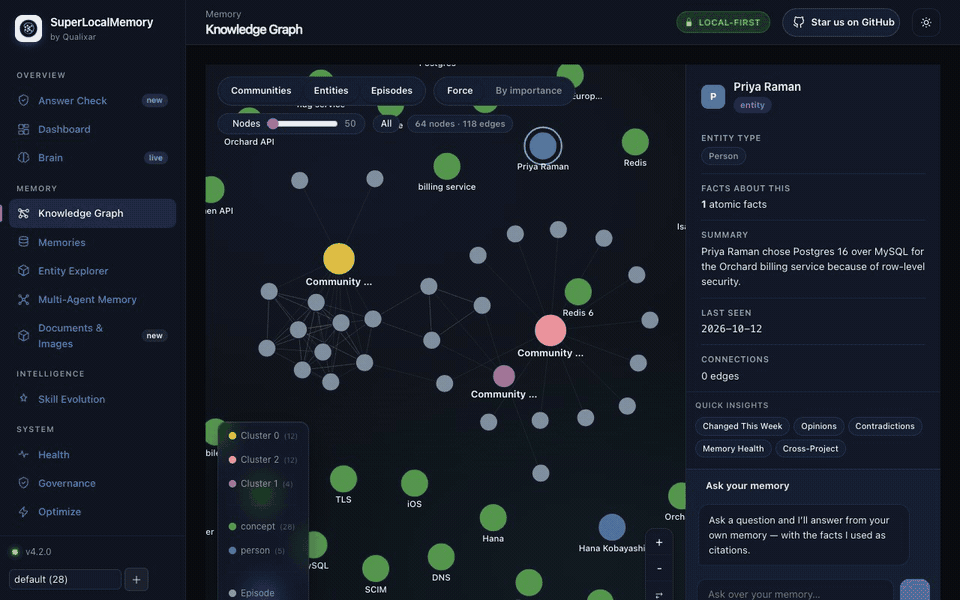 |
| Explorador de entidades | La verificación de respuestas en acción |
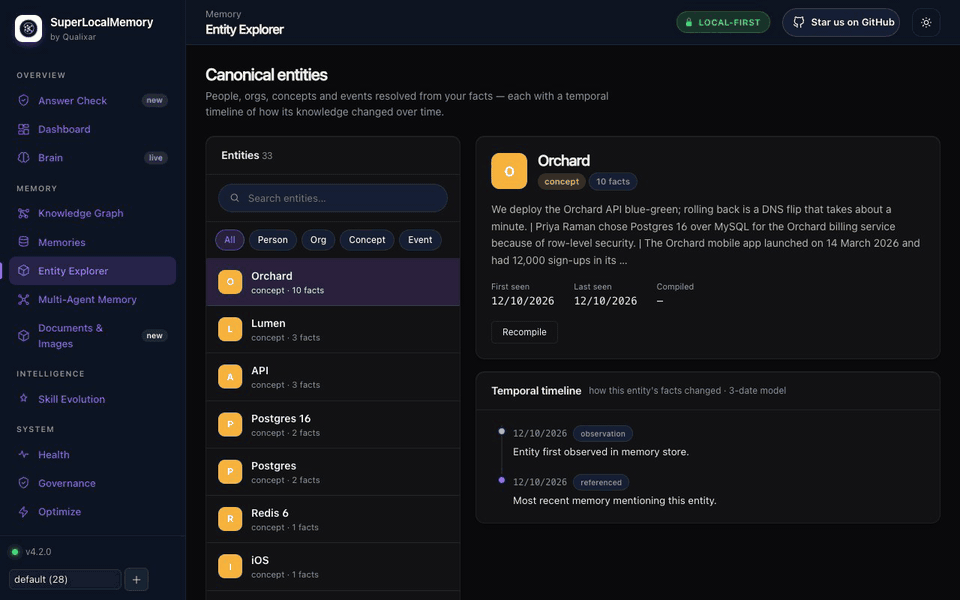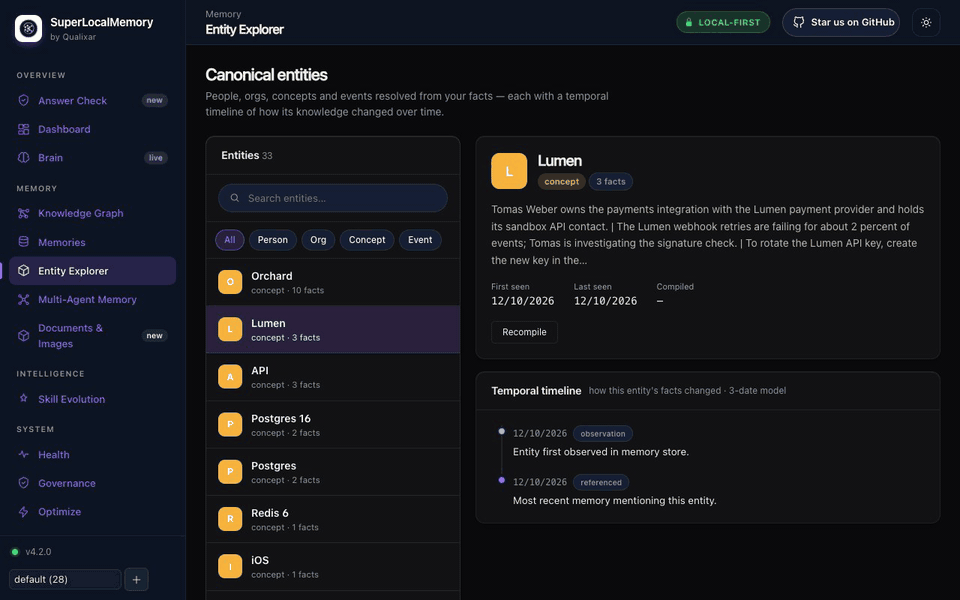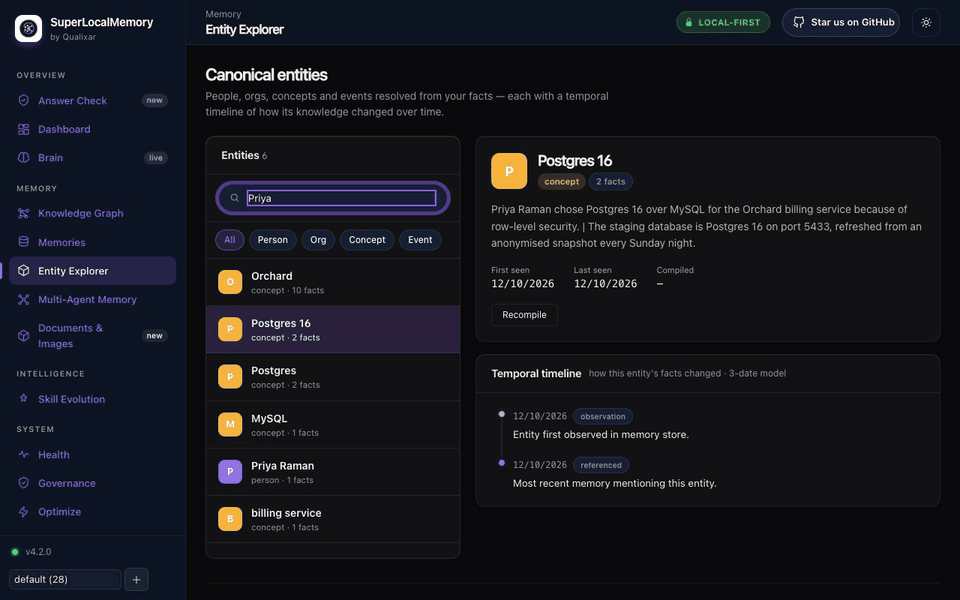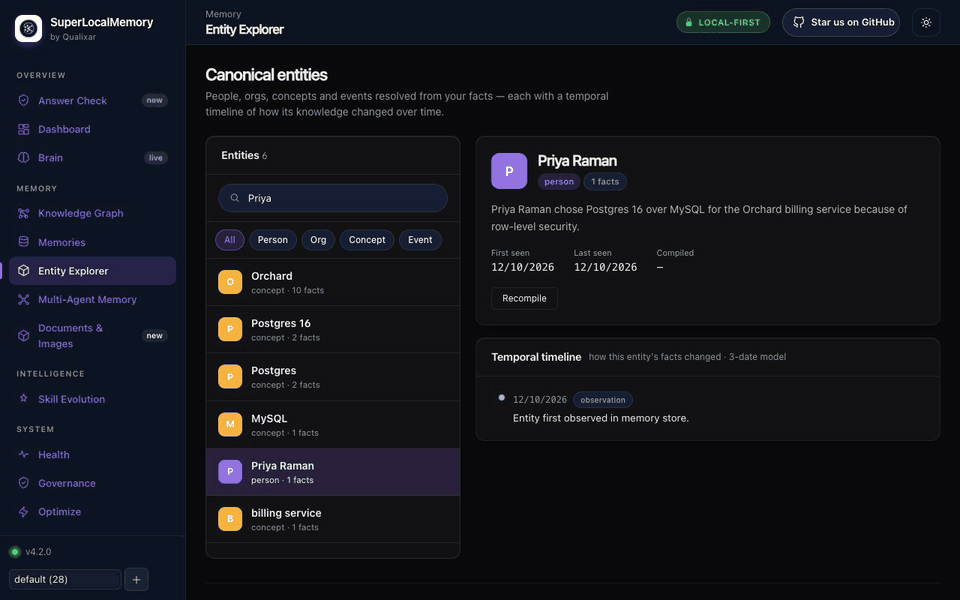 | 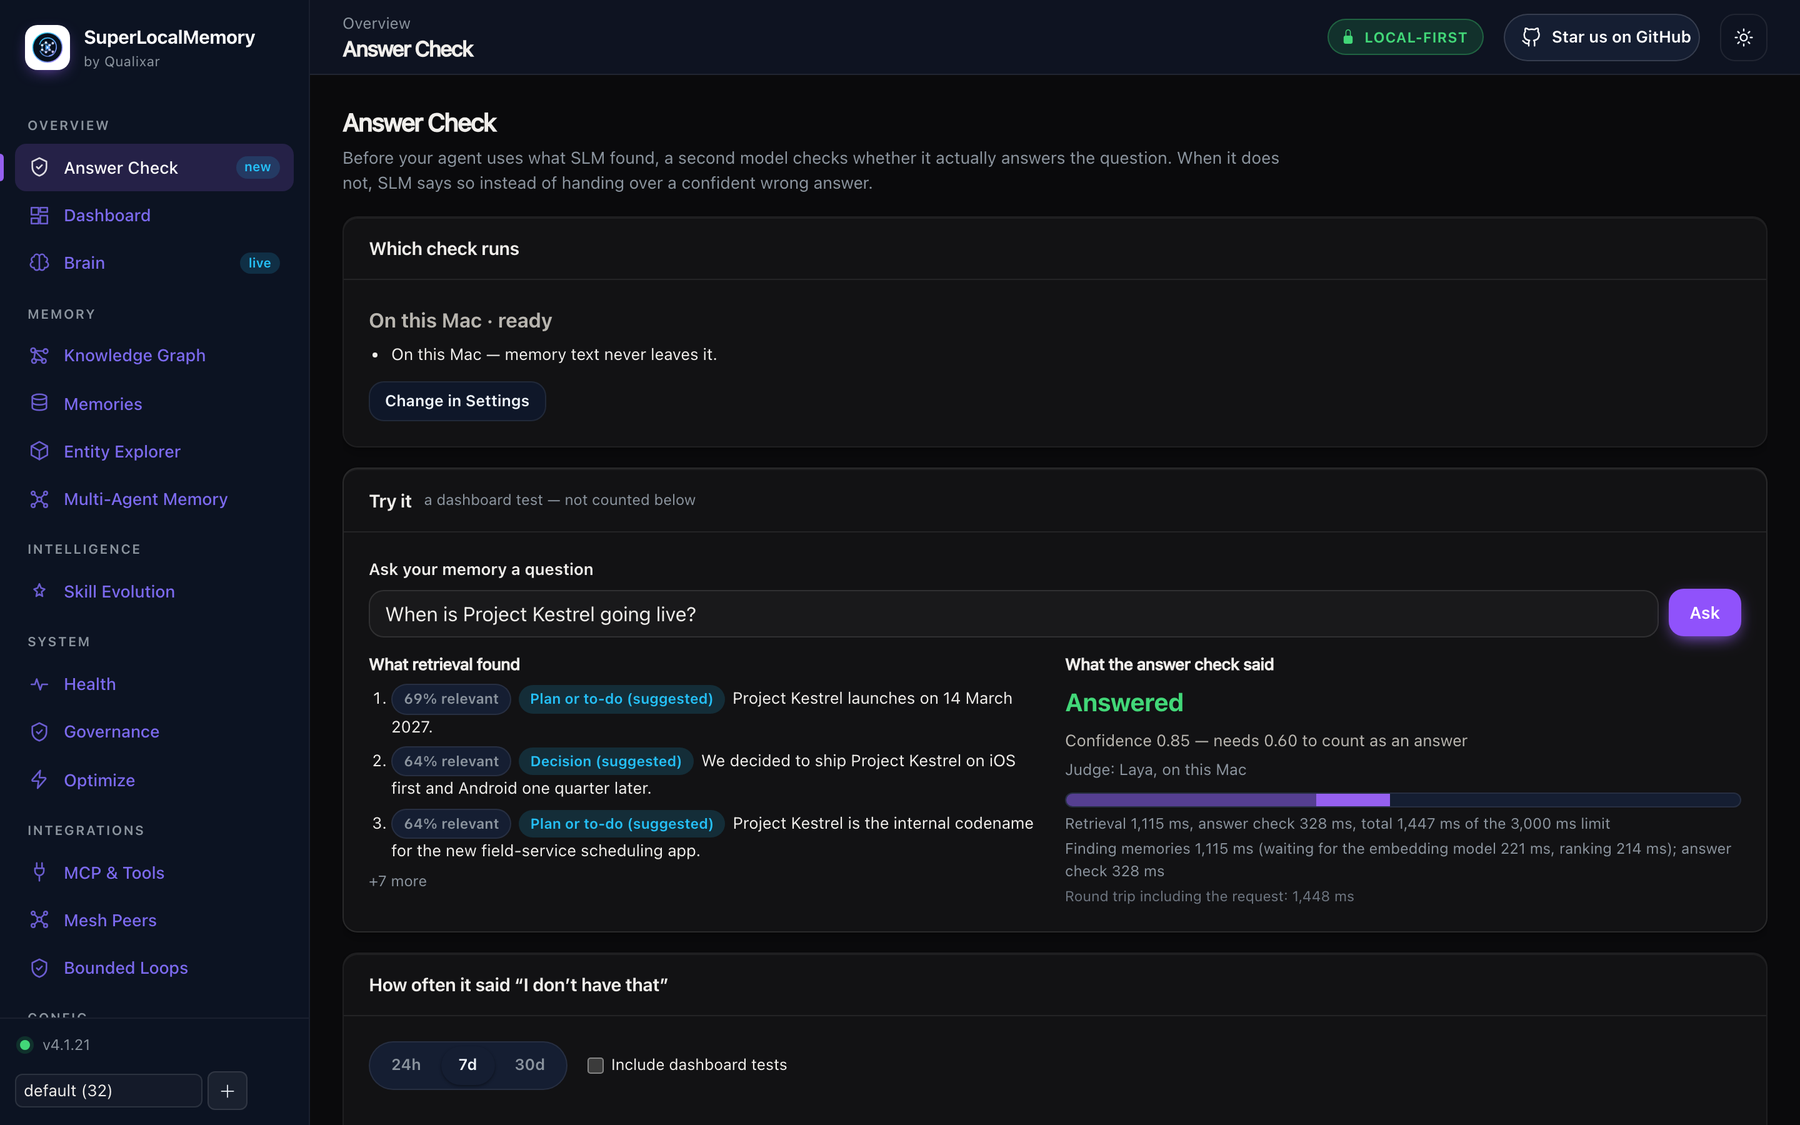 |
Grabado en una instalación de prueba con memorias ficticias. La demostración completa de ocho minutos recorre cada panel.
Arquitectura
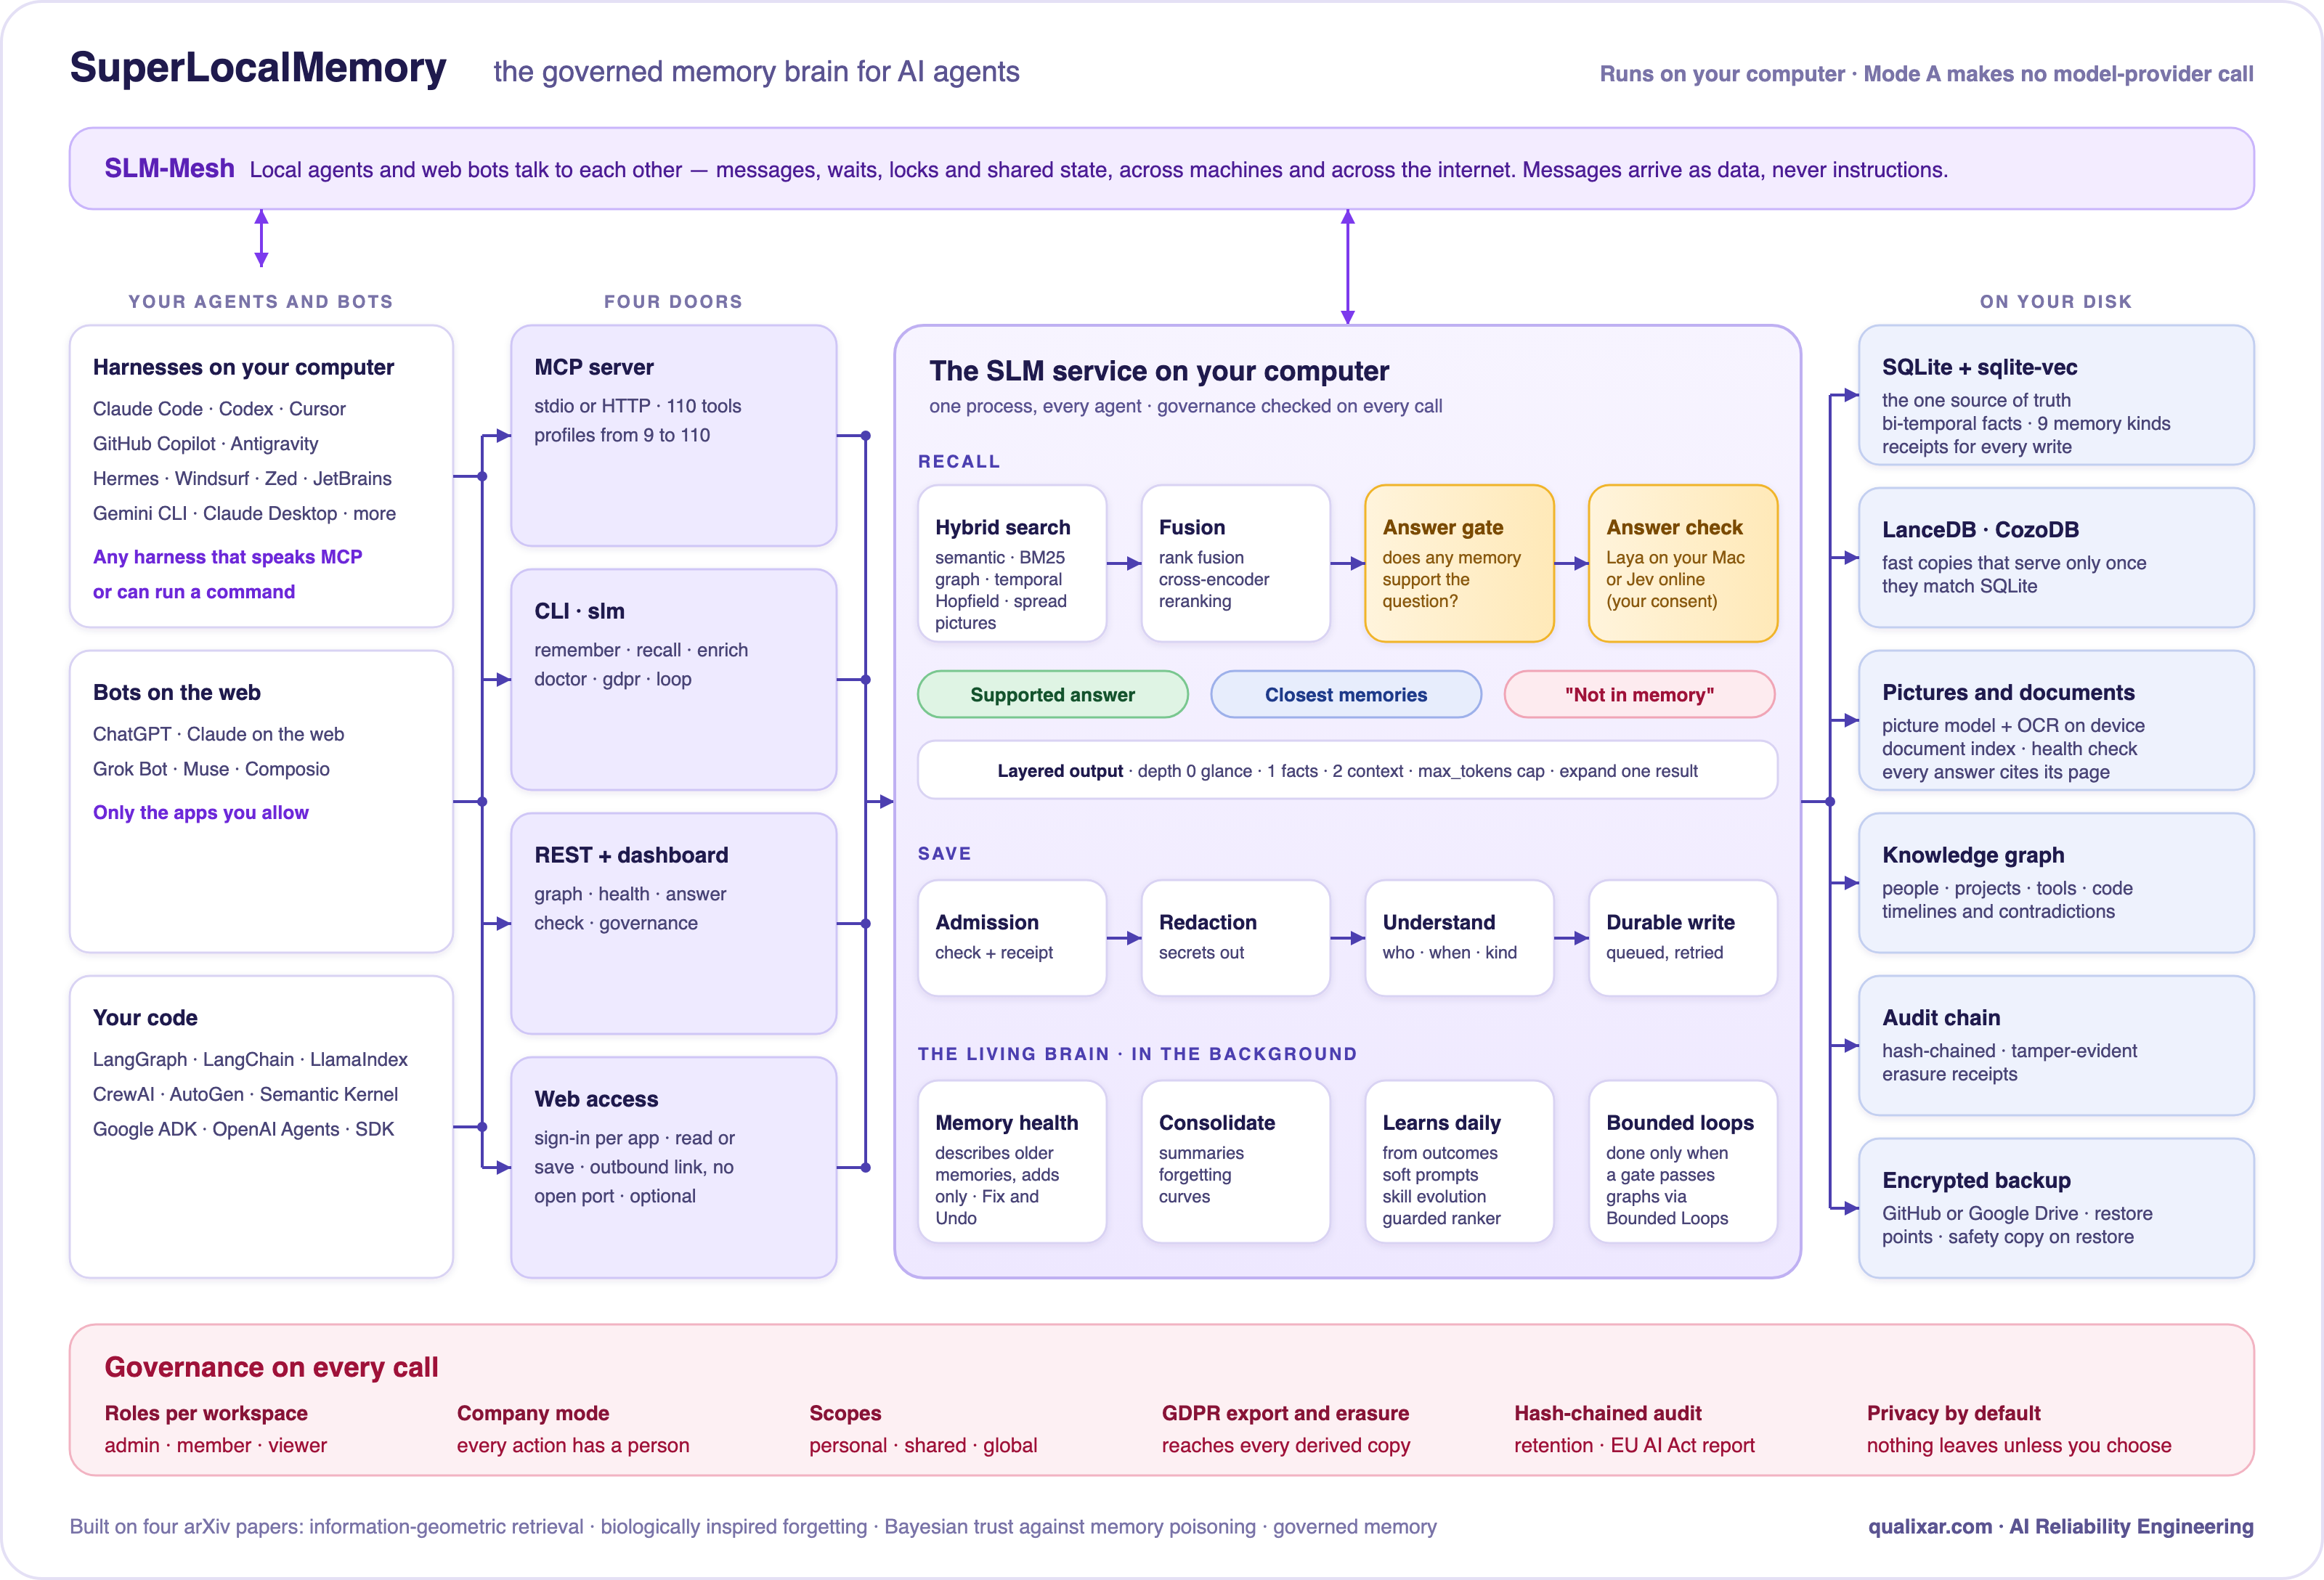
El núcleo local gratuito es completo por sí solo; el acceso Web es opcional. Arquitectura en detalle
Privacidad
Nada sale de tu ordenador a menos que actives una función que lo envíe, y cada una indica exactamente qué se envía:
| Qué sale | Solo cuando |
|---|---|
| Una pregunta y las tres mejores memorias | Activas Jev, la verificación de respuestas en línea, y marcas su consentimiento |
| Texto de memoria | Eliges Modo C, un embedder o reranker en la nube, un modelo en otro ordenador, o el tecleado de tipos de Jev (su propio consentimiento) |
| Archivos de respaldo cifrados | Conectas el respaldo de GitHub o Google Drive |
| Mensajes de mesh | Configuras pares de mesh, o permites que una aplicación web envíe mensajes a tus bots |
| Llamadas a herramientas desde aplicaciones web | Activas el acceso Web y agregas una aplicación; la base de datos permanece en tu ordenador |
Imágenes, documentos, Laya y Modo A nunca envían nada. Los secretos en el texto de memoria se redactan en cada ruta de salida. Política de seguridad
Puntos de referencia
Estos números provienen del artículo de arquitectura publicado (arXiv:2603.14588), cuyo núcleo de recuperación SLM aún ejecuta. No son una ejecución reciente del paquete actual.
| Configuración (artículo de arquitectura) | LoCoMo | Alcance |
|---|---|---|
| Modo A, recuperación + respuestas GPT-4.1-mini | 74.8% | 10 conversaciones, 1,276 preguntas |
| Modo A, crudo (sin LLM en ningún lugar) | 60.4% | 10 conversaciones, 1,276 preguntas |
| Modo C, embeddings en la nube + GPT-4.1-mini | 87.7% | 1 conversación (Conv-30), 81 preguntas |
Una puntuación LoCoMo es comparable solo cuando el subconjunto, el modelo de respuestas y el juez coinciden. Método y ablaciones
Investigación
Cuatro preprints de arXiv de Varun Pratap Bhardwaj describen SLM:
- SuperLocalMemory 4.0: The Governed Memory Operating System for AI Agents, con Garima Singh y Arun Pratap Bhardwaj. arXiv:2608.08253
- SuperLocalMemory V3.3: The Living Brain, arXiv:2604.04514
- SuperLocalMemory V3: Information-Geometric Foundations for Zero-LLM Enterprise Agent Memory, arXiv:2603.14588
- Privacy-Preserving Multi-Agent Memory with Bayesian Trust Defense Against Memory Poisoning, arXiv:2603.02240
Cite con CITATION.cff o la opción "Cite this repository" de GitHub.
Documentación
Inicio: Primeros pasos · Configuración del IDE · Plugins · Prueba rápida Uso: Recuperación · Salud de memoria · Verificación de respuestas · Imágenes y documentos · Auto-memoria · Acceso web · Optimizar Referencia: CLI · Herramientas MCP · Configuración · Solución de problemas · Cumplimiento · Wiki · Notas de versión
Actualización
npm update -g superlocalmemory    # or: pipx upgrade superlocalmemory, uv tool upgrade superlocalmemory
slm restart && slm doctor
slm upgrade-hosts                 # preview plugin and IDE updates; nothing changes until you --apply
Las actualizaciones nunca mueven ni eliminan memoria, y una actualización de la tienda toma un punto de restauración primero. Actualizaciones del host
Soporte de plataformas
| SuperLocalMemory | Laya (verificación de respuestas en el dispositivo) | |
|---|---|---|
| macOS Apple Silicon | Sí | Sí, instalado por defecto |
| Windows de 64 bits | Sí | No (Jev, la verificación en línea, funciona) |
| Linux de 64 bits (x86-64, ARM64) | Sí | No (Jev funciona) |
| Mac Intel, Windows de 32 bits | Sin instalación precompilada | — |
Python 3.12+, Node 18+ para npm. Imágenes y documentos necesitan 16 GB de memoria.
Historial de estrellas
Contribuciones y licencia
Las incidencias y solicitudes de extracción son bienvenidas: CONTRIBUTING.md. Informes de seguridad: SECURITY.md. Licenciado bajo AGPL-3.0-or-later; para una licencia comercial consulta COMMERCIAL-LICENSE.md.
Construido por Qualixar
SuperLocalMemory está hecho por Varun Pratap Bhardwaj en Qualixar: Ingeniería de Fiabilidad de IA — memoria, contratos, pruebas y bucles que hacen que los agentes de IA sean lo suficientemente confiables para tareas reales.
Más fuertes juntos. SuperLocalMemory recuerda. Jev Decision Layer hace que las elecciones acotadas de tu agente sean tipadas y verificadas. Bounded Loops termina el trabajo solo cuando una puerta independiente pasa. Úsalos juntos y Qualixar le da a tus agentes todo el entorno de Ingeniería de Fiabilidad de IA: memoria en la que pueden confiar, decisiones que pueden defender y trabajo que está demostrablemente completo.
Si SLM evita que tus agentes olviden, dale una estrella al repositorio. Así es como otros desarrolladores lo encuentran.

Más de Qualixar: Qualixar OS · SkillFortify · SLM Mesh · AgentAssert · AgentAssay · Bounded Loops · Jev Decision Layer · SLM MCP Hub