hypotree
Memoria que olvida. Un estado de creencias persistente y auto-revisable para I+D agéntico. Poda ramas muertas y deduce respuestas sin gastar sondas.
Documentación
Memoria Que Olvida


Un DAG de hipótesis persistente y auto-revisable para I+D agéntico — expuesto como un servidor MCP y una API de Python.
La memoria del agente actual es pasiva: los almacenes vectoriales y los borradores acumulan hechos pero nunca los revisan. Hypotree estructura el conocimiento de trabajo del agente como un grafo acíclico dirigido de hipótesis respaldado por SQLite-WAL. Cuando un experimento falla, el motor recorre las aristas de dependencia y retracta lo que se apoyaba en él. Cuando una premisa colapsa, cada subárbol dependiente se poda automáticamente.
Qué hace
- Revisión de creencias con escritura — un motor estilo ATMS (de Kleer, 1986) que propaga fallos de evidencia hacia arriba a través del grafo de dependencias.
- Poda en cascada — invalidar una hipótesis padre transiciona instantáneamente todo su subárbol a
PRUNED. No se gastan tokens en ramas muertas. - Inferencia de grupos de exclusión — confirmar un miembro de un grupo mutuamente excluyente retira al resto como
EXHAUSTEDsin sondearlos. - Deducción por eliminación — el último en pie: cuando todas menos una alternativa en un grupo de exclusión son refutadas, el superviviente es
VERIFIEDsin una sonda. - Poda hacia atrás sobre una pregunta completa — el dual de lo anterior: cuando cada respuesta candidata a una pregunta es descartada por su propia evidencia, nada que asuma una de ellas puede satisfacerse, por lo que esas ramas son
PRUNEDy el navegador nombra la pregunta que se agotó. - La suposición de mundo cerrado se declara, no se asume. Ambas inferencias anteriores son sólidas solo si las respuestas listadas son todas las respuestas.
exclusion_closed=Falsedice que no lo son — "¿qué tasa de aprendizaje?" siempre admite otra — y el motor entonces retiene ambas. Y cuando una deducción que sí extrajo resulta basarse en una lista incompleta, es retirada en lugar de defendida: el nodo vuelve a la frontera y una sonda resuelve qué premisa era incorrecta. - Navegación por muestreo de Thompson — muestreo de distribución Beta sobre la frontera abierta, dando un arrepentimiento acotado en el peor caso (sin bloqueo catastrófico).
- Resolución de conflictos mediante ablación diferencial — cuando una prueba de integración falla pero cada componente pasa solo, el motor reconstruye la combinación fallida un intercambio a la vez para identificar al culpable.
- Un rastro de derivación, no solo un estado —
generate_learning_pathnarra lo que se resolvió, en orden, separando lo que un experimento pagó de lo que el motor infirió gratis, y señalando creencias que luego fueron retiradas. - Persistente entre sesiones, modelos, agentes, usuarios y proyectos — el estado de creencias es una base de datos SQLite, no una ventana de contexto.
Características
Características clave
Todo aquí está activado por defecto y cubierto por el benchmark pre-registrado.
| Característica | Para qué sirve |
|---|---|
| Revisión de creencias con escritura | Un experimento que falla no solo se registra — el motor recorre las aristas de dependencia y retracta lo que se apoyaba en él. Esto es lo que la memoria pasiva no puede hacer. |
| Poda en cascada | Invalidar una premisa transiciona todo su subárbol a PRUNED en una transacción. Nunca se gastan tokens releyendo una rama muerta. |
| Inferencia de grupos de exclusión | Declara respuestas competidoras a una pregunta; confirmar una retira al resto sin sondearlas. En el benchmark aquí es donde viene la mayor parte del ahorro — 342 preguntas cerradas gratis en la última ejecución. |
| Deducción por eliminación | Descarta todas menos una candidata y el superviviente se confirma sin ninguna sonda. |
| Poda hacia atrás sobre una pregunta muerta | El dual: cuando cada respuesta candidata es descartada por su propia evidencia, nada que asuma una de ellas puede satisfacerse, y el navegador nombra la pregunta que se agotó en lugar de reportar una frontera vacía. |
| Una suposición de mundo cerrado declarada | Ambas inferencias anteriores son sólidas solo si tu lista de respuestas es completa. exclusion_closed=False dice que no lo es — "¿qué tasa de aprendizaje?" siempre admite otra — y el motor las retiene. Una deducción que luego se encuentra basada en una lista incompleta es retirada, no defendida. |
| Conjuntos de conflicto y ablación diferencial | Cuando los componentes pasan solos pero fallan juntos, el motor registra lo que no puede sostenerse simultáneamente y lo reduce reconstruyendo la combinación un intercambio a la vez. Cada intercambio es decisivo; m suposiciones cuestan como máximo m sondas. |
| Profundidad de confirmación | "Pasó la prueba unitaria" y "funciona en producción" son afirmaciones diferentes. Una confirmación no apoya nada probado más profundo que ella misma, y la culpa recae solo en suposiciones confirmadas más superficiales que el fallo. |
| Qué cambiaría mi opinión | Para cualquier objetivo, los experimentos más baratos que voltearían su conclusión actual, evidencia más débil primero. Una creencia confirmada por eliminación ocupa el primer lugar sin importar cuán alta sea la posterior — nada la midió nunca. Disponible como herramienta y como panel del tablero. |
| Diff de ruta de aprendizaje | generate_learning_path(since=…) reporta lo que cambió en una ventana — confirmado, retirado, recién cuestionado — que es la frase que una reunión diaria o una descripción de PR quiere. as_of reconstruye cualquier instante pasado; pasa ambos para una ventana cerrada. |
| Navegación por muestreo de Thompson | Muestreo Beta sobre la frontera abierta: arrepentimiento acotado en el peor caso y sin bloqueo catastrófico. Sembrado, para que una ejecución sea reproducible. |
| Alcance de objetivos | goal_id en despacho, estado y narrativa restringe todo a un objetivo, su ascendencia de dependencias y las respuestas competidoras a esas preguntas. |
| Historial bi-temporal | Cada cambio de estado y posterior se almacena como un intervalo, por lo que "qué creíamos el martes" es una cláusula WHERE — y el deslizador del tablero es esa consulta con un mango. |
| Tablero en vivo de solo lectura | Se ejecuta junto al servidor MCP por defecto. Observa crecer el grafo, reproduce cualquier instante, lee la narrativa tipografiada. Nada en él escribe evidencia. |
| Arrendamientos para trabajo de larga duración | Un nodo despachado se reserva hasta que lo reportas. renew_claim para un experimento de varios días, release_claims para devolver el trabajo en lugar de fabricar un resultado. |
| Nativo por lotes en todas partes | create_hypotheses, get_next_targets, record_evidence y update_status aceptan listas, y la grabación puede fusionar el próximo despacho en el mismo viaje de ida y vuelta. |
Características experimentales
Desactivadas por defecto, y permanecerán así hasta que una evaluación completa con un modelo en vivo las haya puntuado. El comportamiento con la bandera ausente es bit-idéntico a una compilación que nunca ha oído hablar de la característica.
| Característica | Estado |
|---|---|
Selección consciente de costos (--experimental-cost-aware) | Clasifica candidatos por valor esperado por unidad de costo en lugar de solo por promesa, usando el duration_s que tus resultados reportan y el estimated_cost que declaras. En un benchmark ponderado por costo reduce el costo total hasta el objetivo en 77% por 1.5% más sondas, resolviendo cada semilla — pero eso se midió contra un llamador con script en una tarifa sintética, lo que justifica el mecanismo y no el valor por defecto. Se espera que se convierta en el valor por defecto en una versión menor posterior (0.7.0 o superior) una vez que una ejecución con un modelo en vivo lo haya puntuado; la bandera desaparece en ese punto. Grabar duration_s y estimated_cost es siempre seguro y siempre útil — ambos se almacenan y muestran esté o no activada la bandera. |
Por qué existe el ahorro, ya que no es obvio: la última respuesta superviviente a una pregunta cerrada se deduce en lugar de sondearse, por lo que la respuesta a la que nunca llegas nunca se paga. Ordenar primero lo más barato coloca la respuesta cara en ese espacio gratuito. El número de sondas apenas se mueve — la posición del ganador es uniforme, por lo que cualquier orden resuelve una pregunta en el mismo número esperado de sondas — mientras que el costo de las sondas cae mucho.
Obsérvalo pensar
Un estado de creencias que se revisa a sí mismo es difícil de apreciar desde una columna de estado. El tablero se ejecuta por defecto, junto al servidor MCP, por lo que el grafo ya está allí la primera vez que lo buscas:
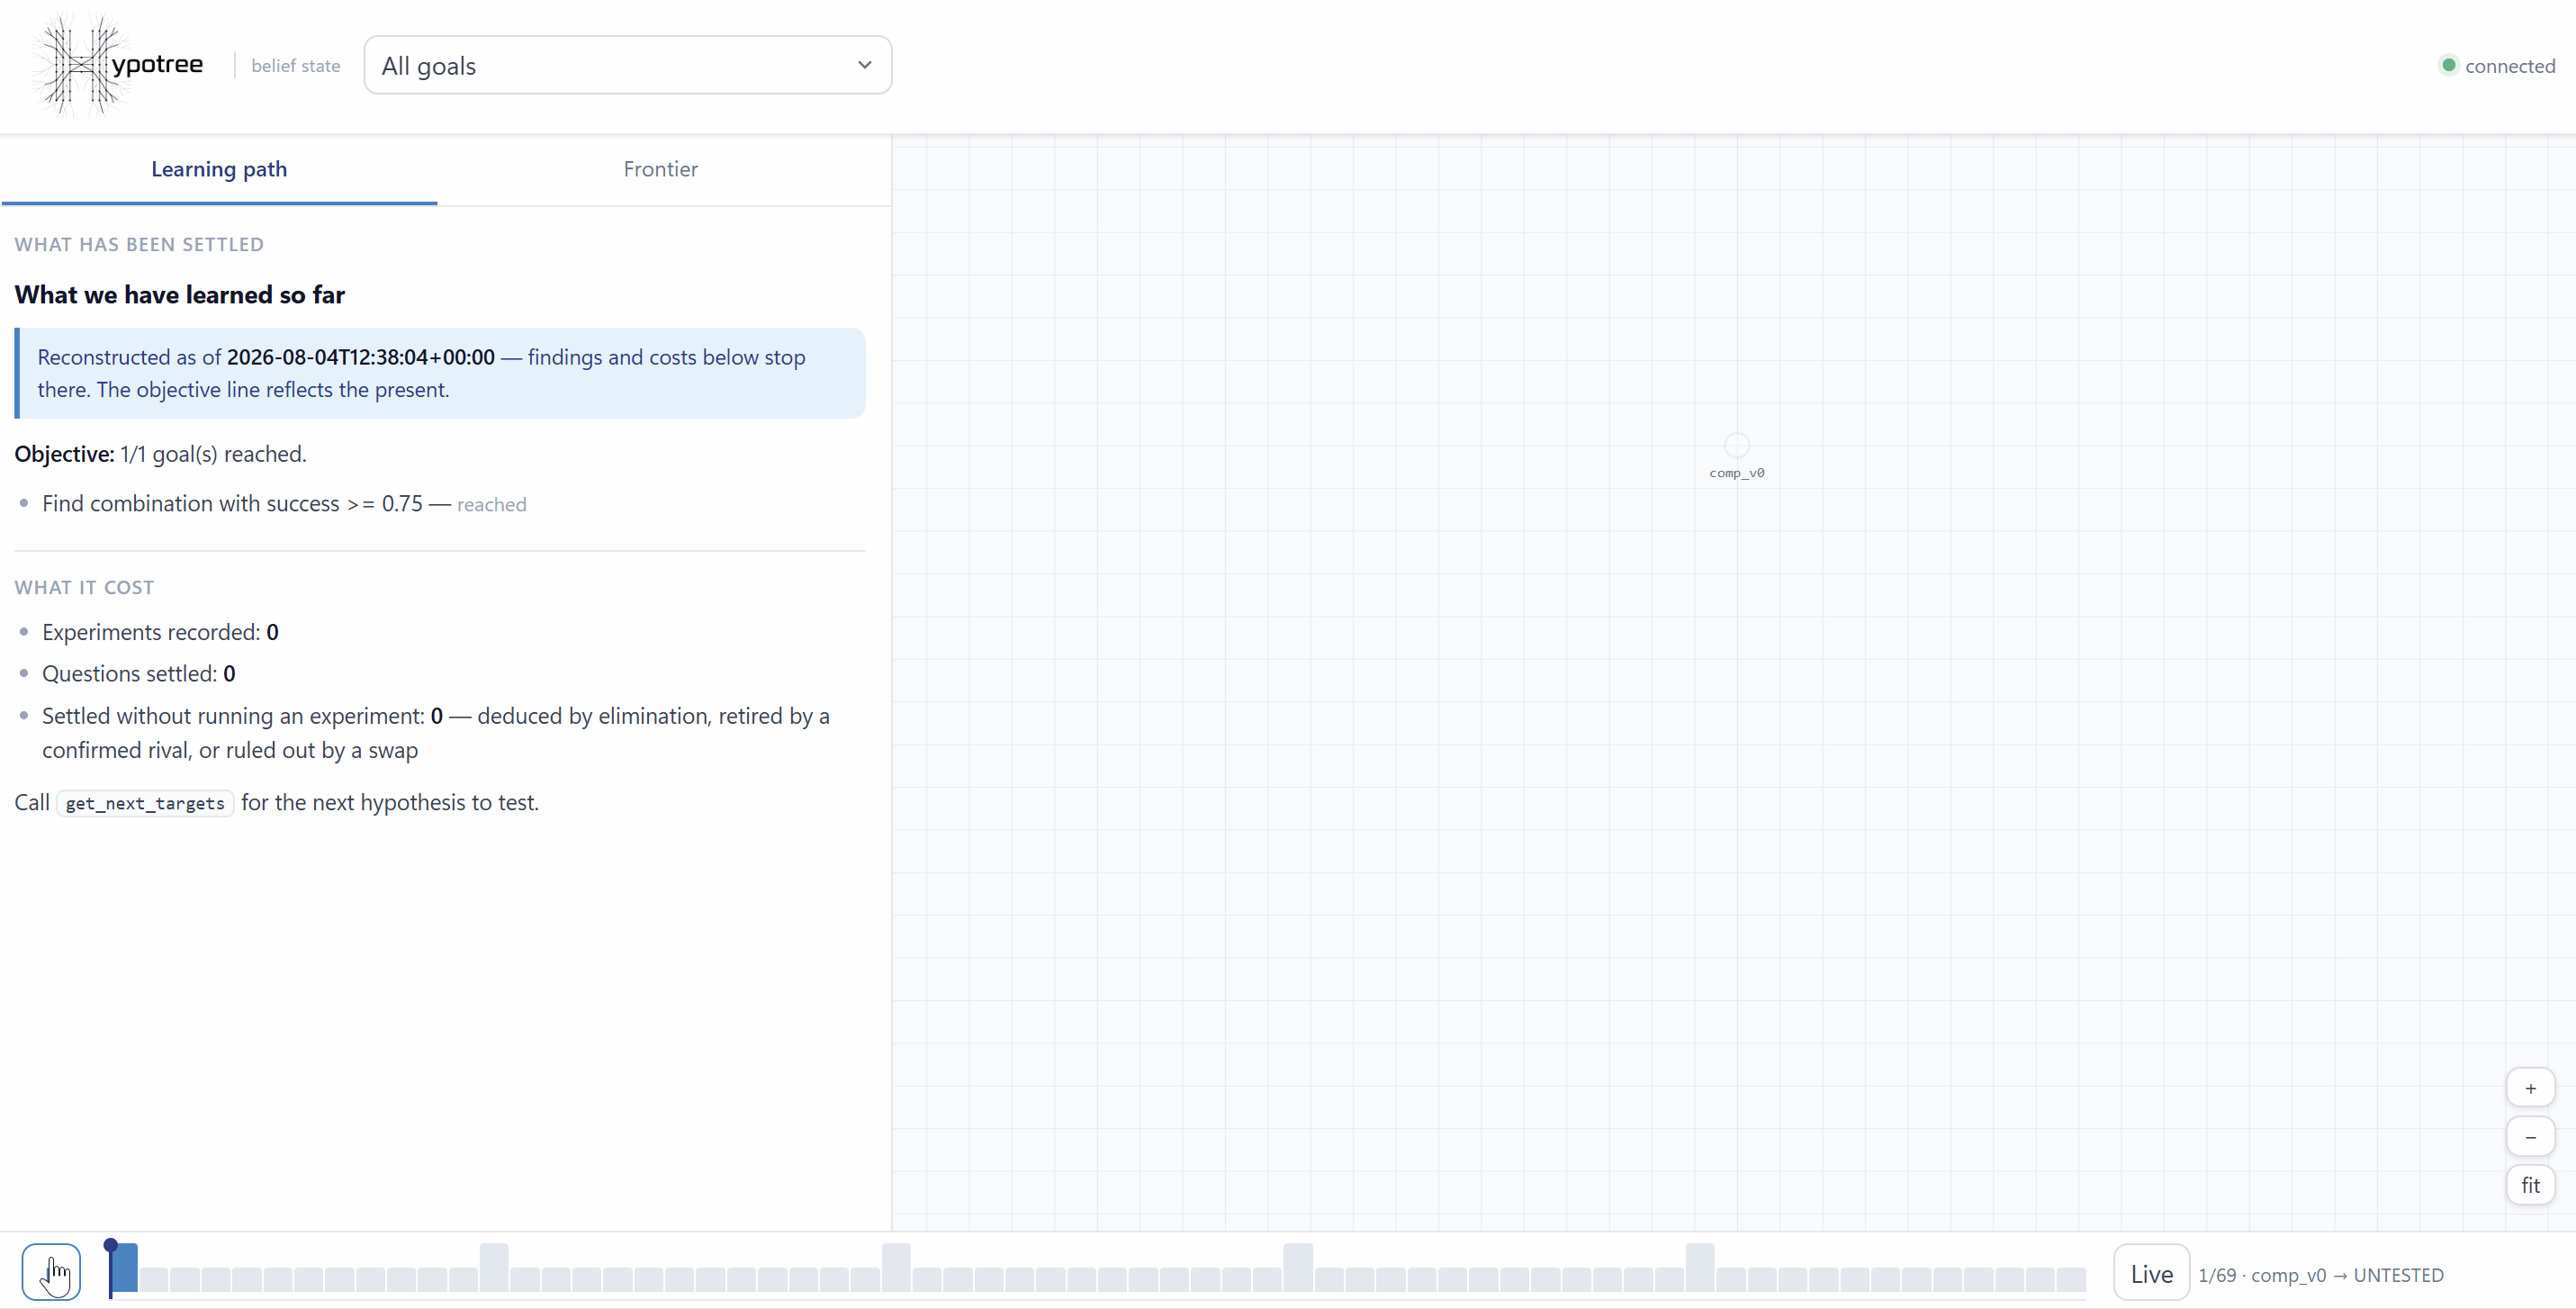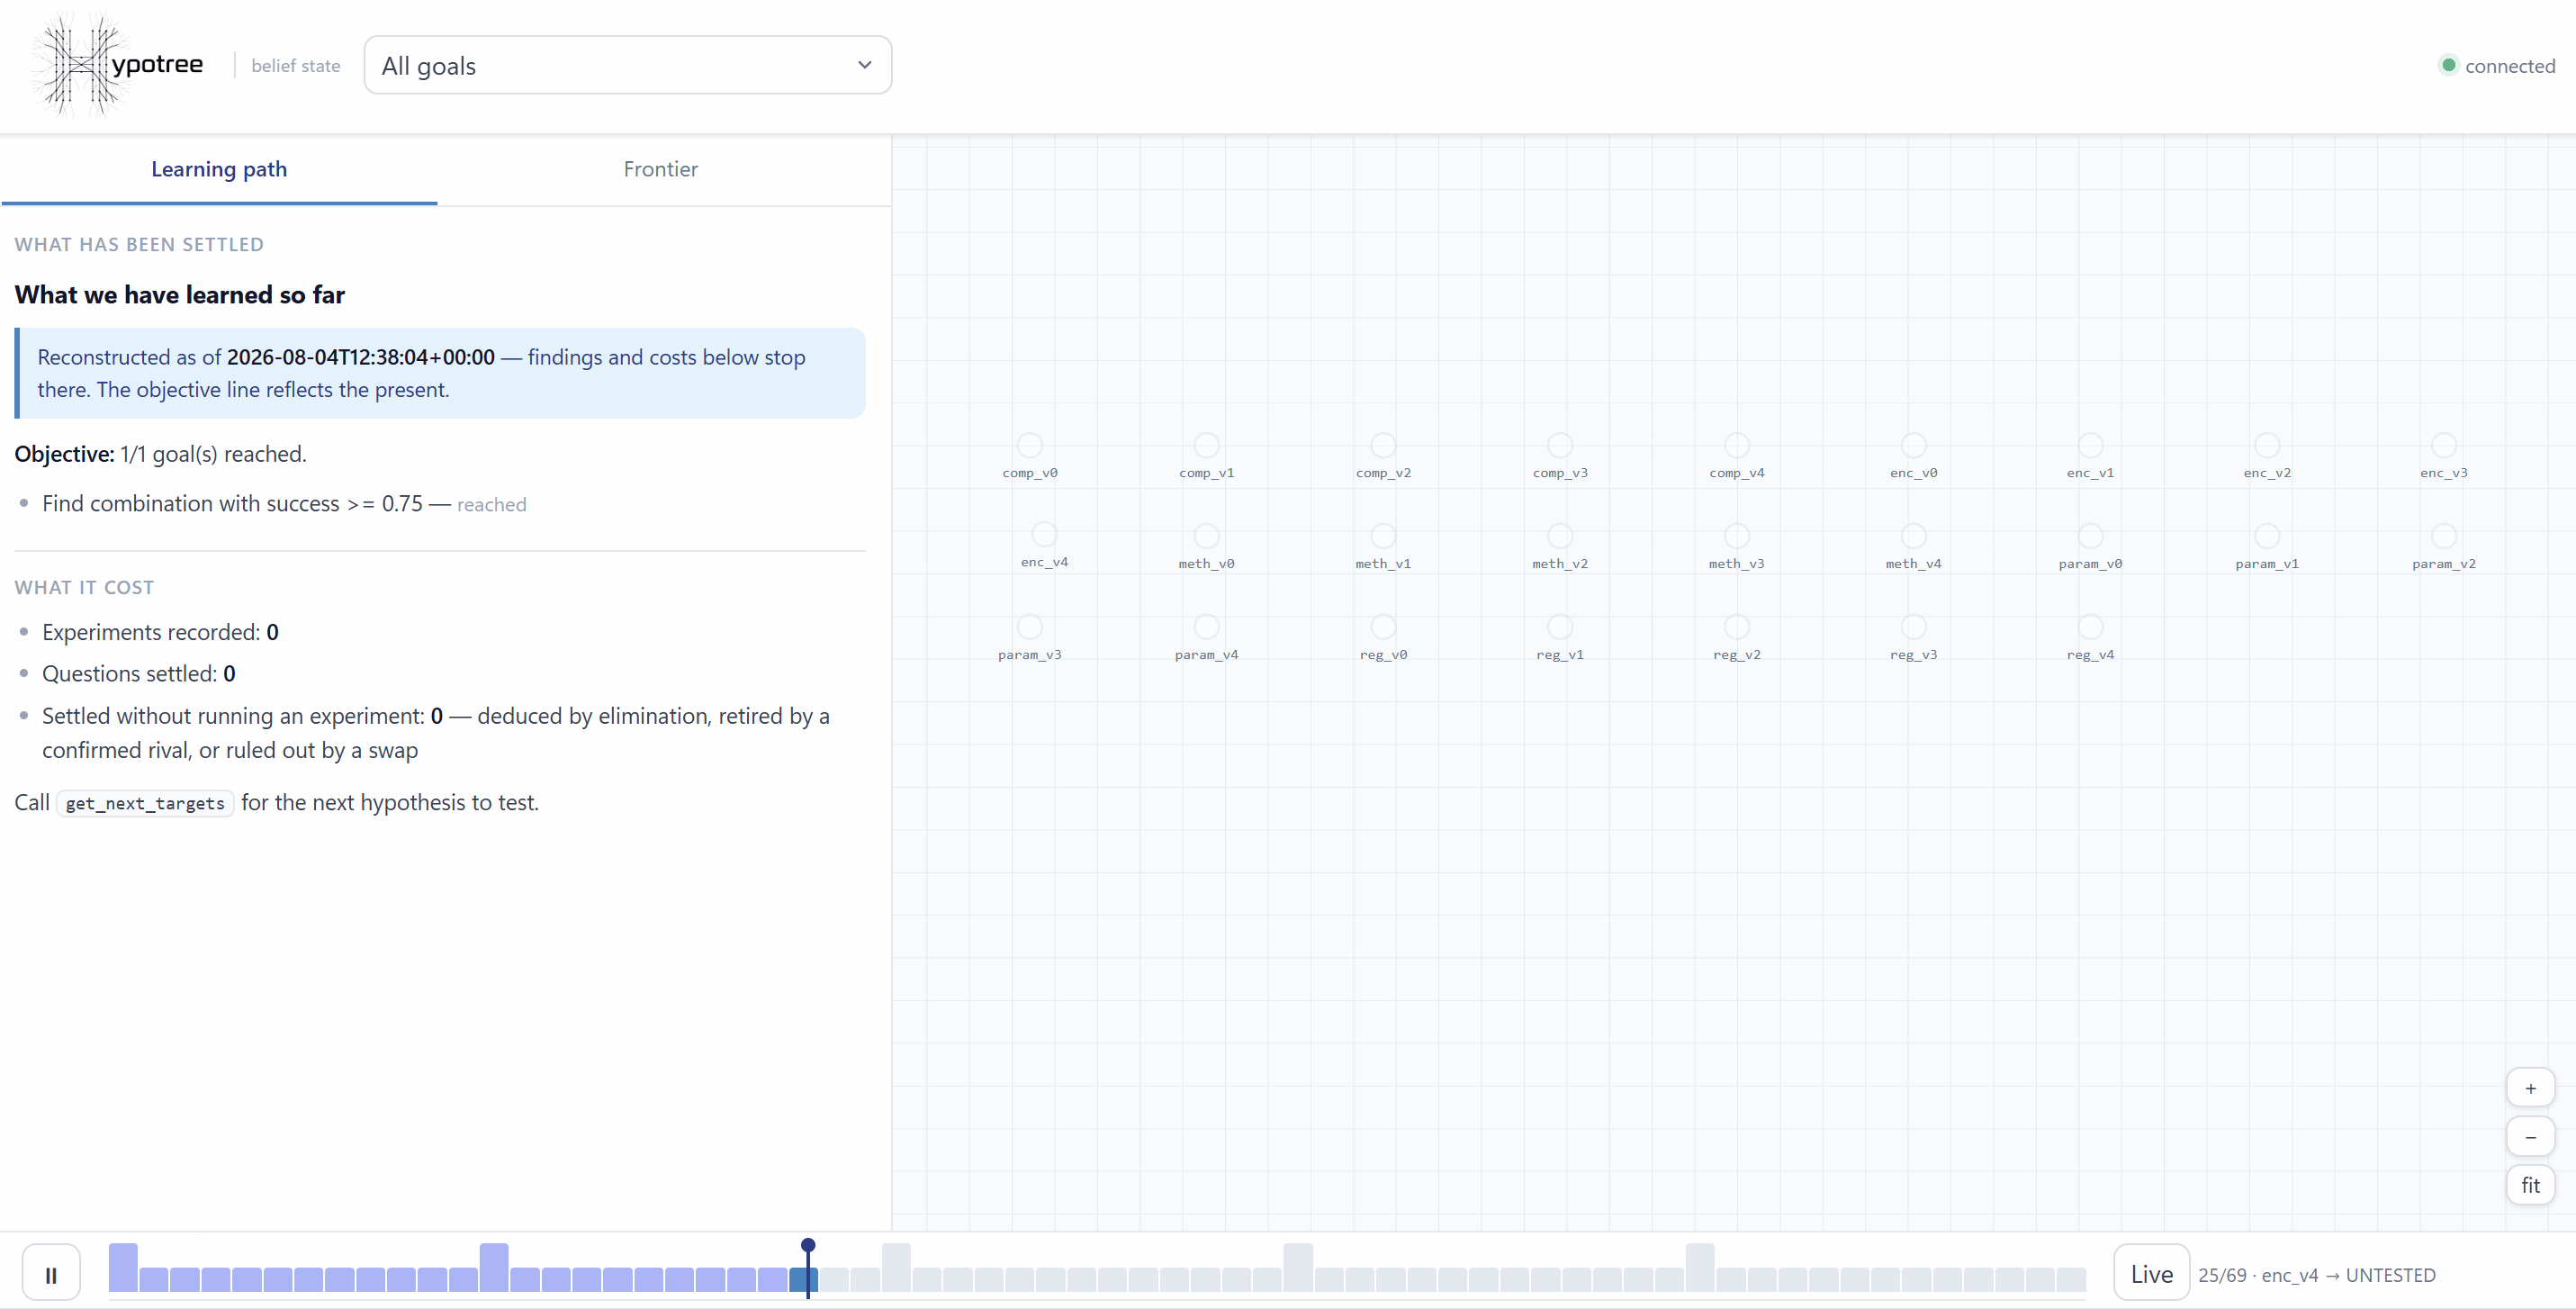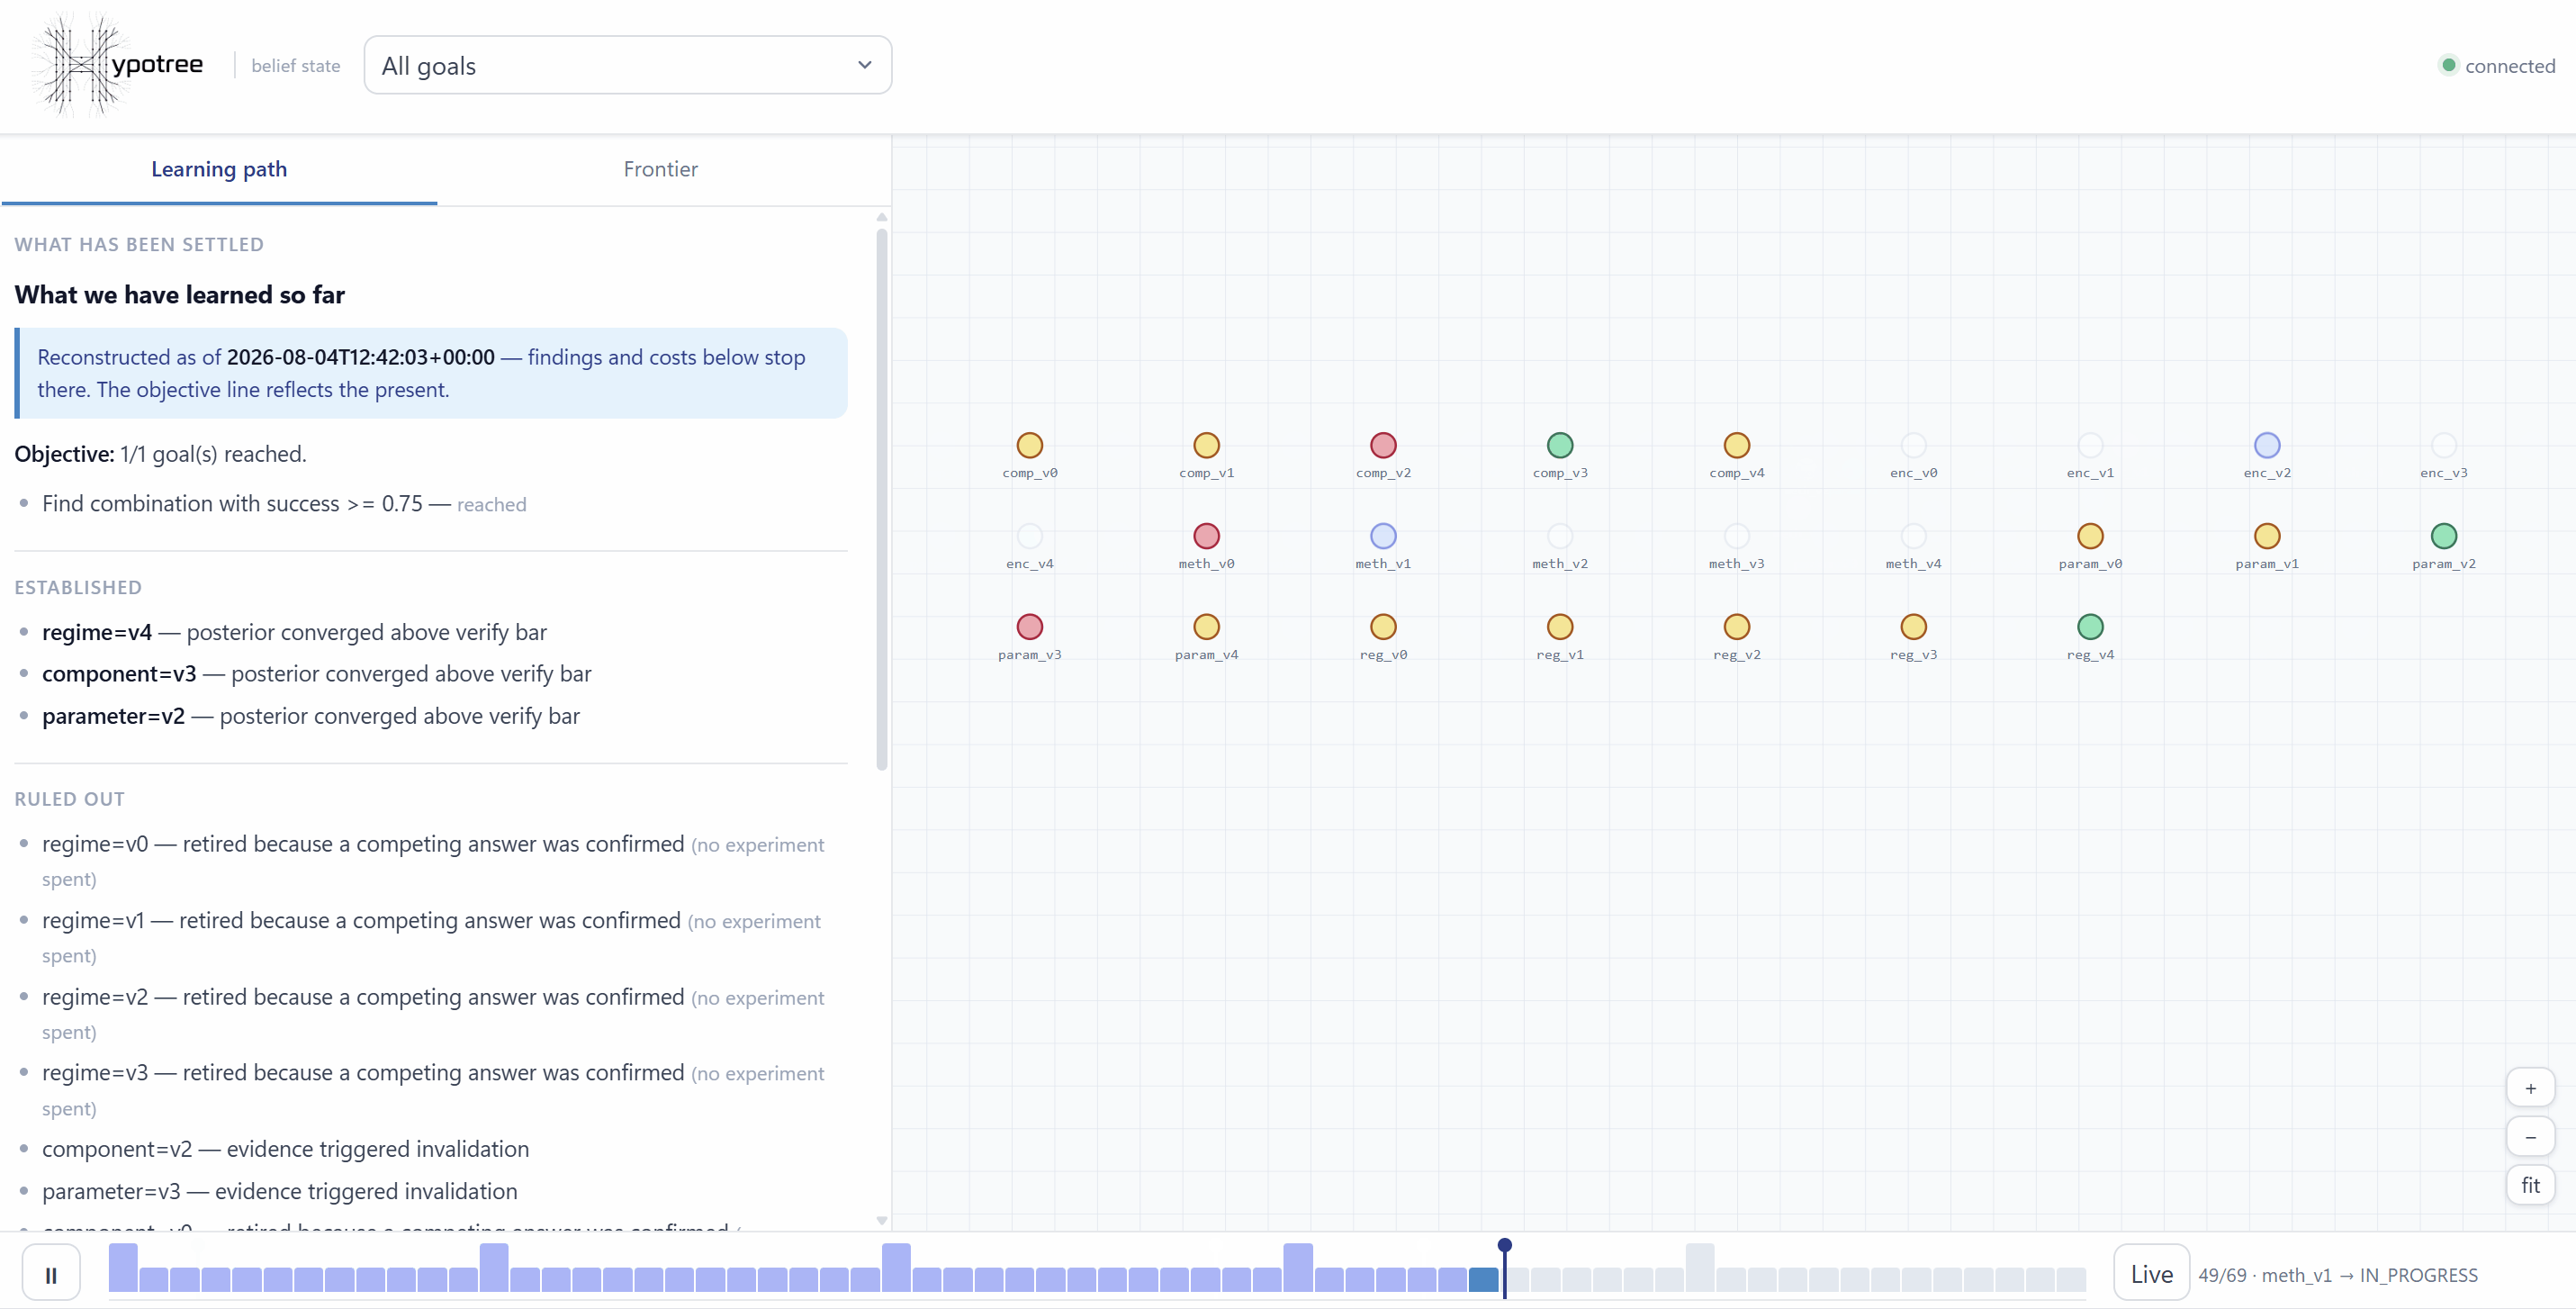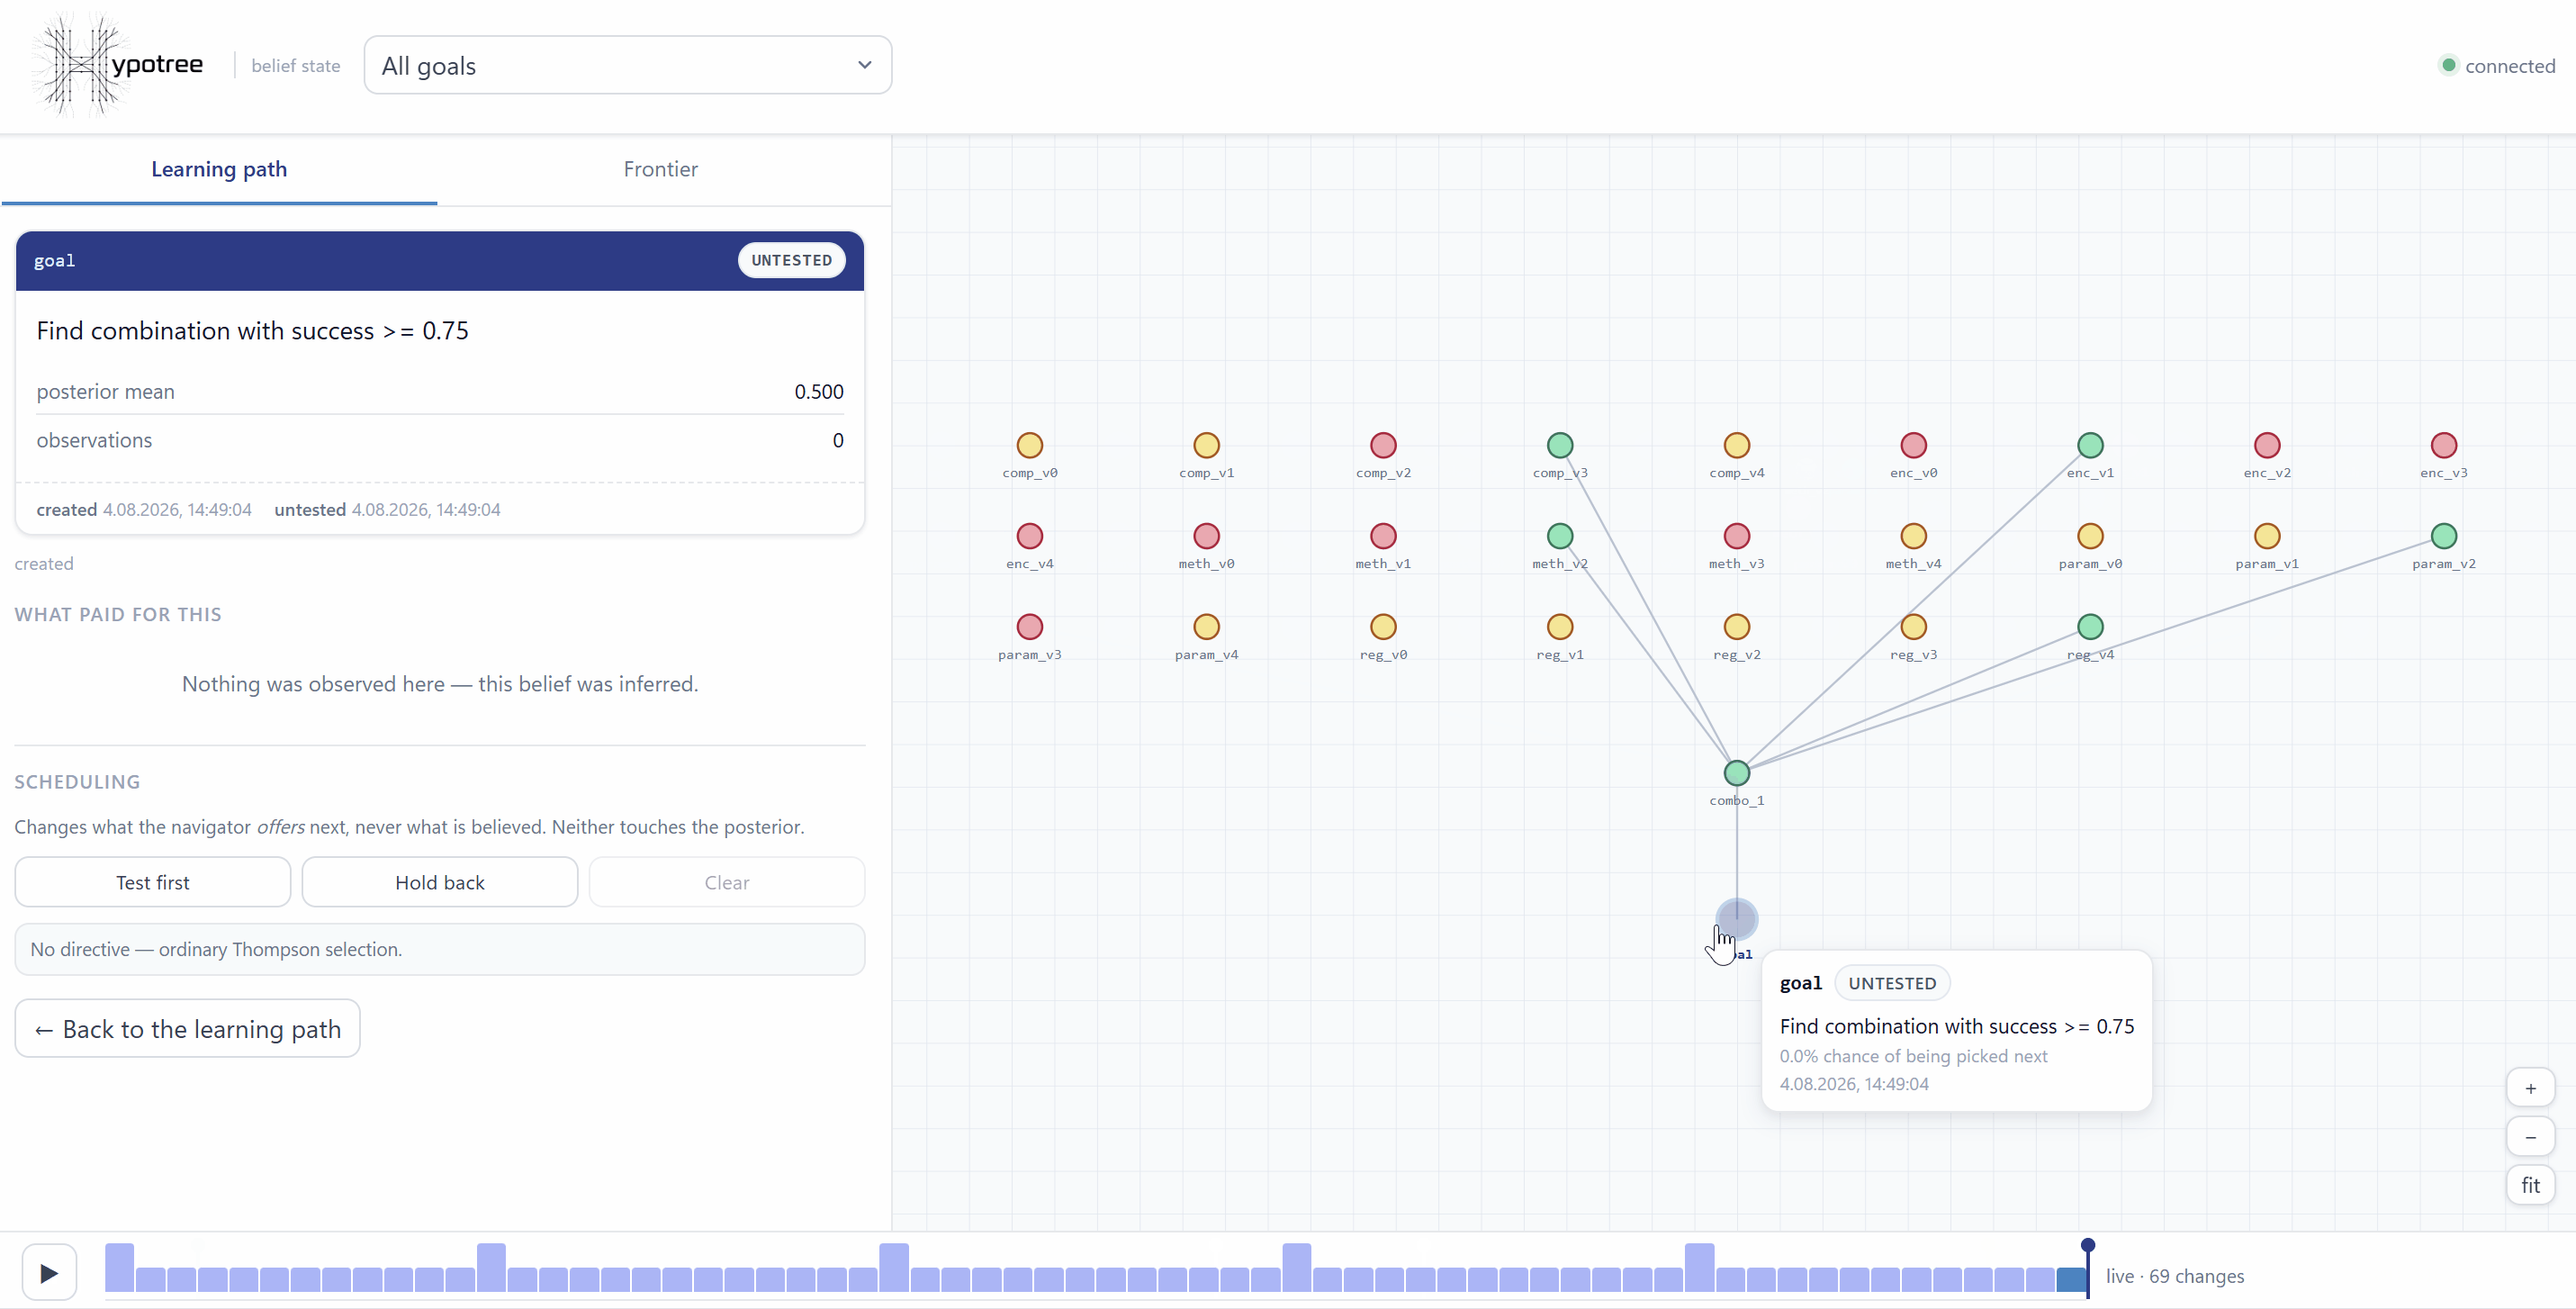
Esa es una ejecución real. Los nodos llegan a medida que el agente los crea y brillan con su probabilidad real de ser despachados a continuación; las respuestas confirmadas se vuelven verdes y sus rivales se retiran sin ser sondeados; una premisa refutada se lleva su subárbol consigo. Títulos opcionales de 128 caracteres mantienen legibles los grafos grandes mientras preservan ids estables en los detalles. El progreso del objetivo nombra dependencias pendientes, la evidencia se puede filtrar y paginar con contexto de atestación y tendencia, y vistas dedicadas de conflicto y reclamo en vivo exponen por qué el trabajo está bloqueado o arrendado. El diseño sigue siendo utilizable en pantallas compactas apilando la narrativa y el grafo. La barra en la parte inferior es la actividad de la propia ejecución — arrástrala y todo el grafo retrocede a lo que se creía en ese momento, narrativa incluida.
Nada en esa página escribe evidencia. Si una creencia se movió, un experimento la movió.
Instalación
# From PyPI
uvx hypotree
# or
pip install hypotree

# From source
git clone https://github.com/tygryso/hypotree.git
cd hypotree
uv sync
Requiere: Python 3.10+ · Se ejecuta en: Linux, macOS, Windows
Verifica la instalación sin conectar un cliente — el servidor habla JSON-RPC en stdin, por lo que iniciarlo en una terminal de otro modo parece un cuelgue:
hypotree --version   # or: uvx hypotree --version
hypotree --info      # which belief state am I connected to, and where is it?
Inicio rápido
1a. Conéctate a un cliente MCP
Agrega hypotree a la configuración de tu cliente MCP (Cursor, Cline, Claude Desktop, etc.):
{
  "mcpServers": {
    "hypotree": {
      "command": "uvx",
      "args": ["hypotree"],
      "env": {
        "HYPOTREE_WORKSPACE_ID": "my-project"
      }
    }
  }
}
O ejecútalo directamente:
uvx hypotree
Para ver una base de datos propiedad de un host de incrustación sin resolución de espacio de trabajo ni servidor MCP:
uv run hypotree --no-mcp --db-path /path/to/state.db
HYPOTREE_DB_PATH proporciona la misma anulación.
1b. O intégralo en un agente Python — sin cliente MCP
Si tu agente es Python, no necesita un transporte para alcanzar el estado de creencias. HypoTreeToolset te entrega esquemas de llamada a funciones de OpenAI y ejecuta llamadas por nombre:
from hypotree import HypoTreeToolset

with HypoTreeToolset("beliefs.db", preset="essential") as ht:
    tools = ht.tools()                  # drop straight into your `tools=` argument
    result = ht.call("get_next_targets", {"count": 1})   # returns a JSON string
Ambos caminos proyectan los mismos esquemas a través del mismo despacho, por lo que la superficie integrada y la superficie MCP no pueden divergir.
Tres cosas que vale la pena saber:
preset="essential"expone las seis herramientas que ejecutan el bucle en lugar de las veinte. La mayoría de los clientes reenvían cada esquema en cada turno, y un agente que ya lleva sus propias cuarenta herramientas no puede llevar también veinte de las nuestras.ht.mutating_tool_nameses el conjunto que cambia el estado de creencias — qué poner detrás de una puerta de aprobación o razonamiento.get_next_targetsestá en él: se lee como una consulta y emite arrendamientos, por lo que escribe.ht.callnunca lanza una excepción. Un id de nodo incorrecto o un dict de argumentos malformado regresa como{"error": ...}, porque eso es recuperable por el modelo que lo causó y matar la sesión por uno no lo es.
Pasa read_only=True para un revisor o un sub-agente no confiable: expone los once sensores y rechaza cada escritura, incluso por nombre si el modelo pide una que no se le dio.
Los hosts integrados pueden mantener estado en su propio espacio de almacenamiento aislado y luego lanzar
hypotree --no-mcp --db-path .../state.dbsin copiarlo en el resolutor de espacio de trabajo global de hypotree.
2. Crea hipótesis
El agente crea un árbol con parent_ids conectando combinaciones a sus premisas y exclusion_group declarando respuestas competidoras a una pregunta:
# Agent calls over MCP:
create_hypotheses(hypotheses=[
    {"node_id": "catalyst_A", "statement": "Pd/C catalyst works", "exclusion_group": "catalyst"},
    {"node_id": "catalyst_B", "statement": "Pt catalyst works",   "exclusion_group": "catalyst"},
    {"node_id": "catalyst_C", "statement": "Ni catalyst works",   "exclusion_group": "catalyst"},
    # Enumerable question → closed by default, so eliminating two confirms the third.
    # For "which learning rate?" pass exclusion_closed=False: there is always another,
    # and the engine then refuses to deduce a survivor it cannot justify.
    {"node_id": "yield_target", "statement": "reach 90% yield",
     "is_goal": True, "target_metric": 0.9, "parent_ids": ["catalyst_A"]},
])
3. Registra evidencia y deja que el motor infiera
# Probe catalyst_A → fails outright, catalyst_B → fails outright.
# Two experiments, one call:
record_evidence(results=[
    {"node_id": "catalyst_A", "success": 0.0},
    {"node_id": "catalyst_B", "success": 0.0},
])
# Engine: catalyst_A, catalyst_B → INVALIDATED; anything depending on them → PRUNED
#         catalyst_C → VERIFIED by elimination — no probe spent
4. Pregunta qué aprendiste
generate_learning_path()
# → markdown briefing + counters:
#   probes_spent = 2, conclusions = 3, conclusions_without_a_probe = 1
MCP con tablero
Además, puedes iniciar el servidor con estas banderas:
hypotree                            # MCP server + dashboard on 127.0.0.1:7331
hypotree --dashboard-port 8080      # start probing from a port you choose
hypotree --no-dashboard             # MCP server only, no socket opened
hypotree --no-mcp                   # dashboard alone, against an existing belief state
hypotree --experimental-cost-aware  # rank by value per unit of probe cost (see Experimental features)
Se vincula únicamente a 127.0.0.1 y genera un token de sesión al inicio; la URL, con el token incluido, va a stderr (stdout es el canal JSON-RPC). Pídeselo al agente en su lugar — get_workspace_info devuelve dashboard_url, y también lo hace el recurso hypotree://dashboard. Si ningún puerto del rango está libre, el servidor MCP igualmente arranca y lo indica: un visor nunca debe poder tumbar el servidor.
--no-mcp abre la base de datos en modo solo lectura, así que es seguro apuntarlo a un espacio de trabajo que un agente esté escribiendo activamente — y no necesita ningún cliente configurado para intentarlo.
Lo que obtienes:
- Un grafo en vivo. Los nodos se distribuyen del lado del servidor con
networkxy se renderizan como SVG cond3-zoompara un paneo y zoom acelerados por hardware. Los nodos no probados brillan con su probabilidad real de ser despachados a continuación; los nodos en curso pulsan; las ramas podadas se desaturan en lugar de desaparecer, porque el punto que se muestra es que fueron consideradas y cortadas. - Los nodos nuevos aparecen con fundido. Cuando el agente crea una hipótesis, llega como un fantasma y se resuelve — observas crecer la búsqueda sin tocar la página.
- Una línea de tiempo de actividad.
status_historyes bi-temporal, así que cualquier instante pasado es una cláusulaWHERE. El gráfico de barras es la forma de la ejecución — dónde hubo ráfagas, dónde se estancó — y el control se desplaza a lo largo de él. Arrastra hacia atrás para ver lo que se creía entonces, o pulsa reproducir y observa toda la investigación repetirse. - Procedencia en cada tarjeta. Lo que costó cada creencia: la puntuación, la profundidad, el commit, el
source_ref, cualquier archivo que el experimento dejara atrás, cuándo se creó y cuándo se asentó. El grafo es un libro de contabilidad, no un dibujo. - La ruta de aprendizaje como markdown tipografiado, listo para pegar en un informe — y retrocede con el grafo, así que una imagen rebobinada nunca se subtitula con conclusiones que aún no ha alcanzado.
- Fijar y suspender. Redirige la búsqueda sin falsear evidencia — las directivas cambian lo que se ofrece, nunca lo que se cree.
Todo está incluido localmente (Vue 3, micromódulos d3, marked — 276 KB en total). Sin CDN, sin npm, sin paso de compilación: funciona en un avión y en una red aislada.
La API es JSON y cada llamada a /api/* necesita el token. Todo es una lectura excepto una ruta — fijar y suspender son instrucciones de programación, y nunca tocan una posterior:
| Ruta | Lo que devuelve |
|---|---|
GET /api/meta | identidad del espacio de trabajo y la lista de objetivos |
GET /api/graph?goal_id=&at= | nodos y aristas con diseño calculado en el servidor; at reconstruye cualquier instante pasado |
GET /api/node/<id> | la evidencia, procedencia e intervalos de estado de un nodo |
GET /api/frontier?goal_id=&k= | los candidatos principales y la probabilidad de que el navegador elija cada uno a continuación |
GET /api/counterfactual?goal_id=&k= | las creencias que sostienen una conclusión con la menor evidencia, y qué las derribaría |
GET /api/learning-path?goal_id=&at=&since= | la narrativa, igual que la herramienta MCP; since la convierte en un diff sobre un rango |
GET /api/timeline?goal_id= | cada cambio de estado en orden |
GET /api/events | números de revisión enviados por el servidor — el cliente vuelve a buscar lo que está mostrando |
POST /api/directive | fijar / suspender / limpiar (la única escritura, y solo cuando hay un motor adjunto) |
p_select es lo real, no un proxy: Thompson Sampling elige el argmax de una extracción por candidato, así que el número es con qué frecuencia gana cada candidato esa extracción.
Herramientas (20)
Expuestas a través de MCP, y en forma de llamada a funciones de OpenAI mediante hypotree.openai_tools() — un conjunto de esquemas, dos proyecciones. Las seis marcadas con · componen preset="essential", la superficie más pequeña que aún puede ejecutar el bucle.
| Herramienta | Lo que hace |
|---|---|
create_hypotheses · | Crear uno o muchos nodos con parent_ids, exclusion_group, exclusion_closed, is_goal |
add_edges · | Conectar hipótesis que ya existen, sin recrear ninguna. Toma edges, una lista de {src, dst, type} |
get_next_targets · | Thompson Sampling — devuelve la siguiente hipótesis a probar, bajo un arrendamiento. goal_id reduce la búsqueda a un objetivo |
record_evidence · | Registrar un resultado — o todos los resultados de un turno a la vez con results=[…] — y disparar la propagación de escritura. El duration_s opcional alimenta la clasificación consciente de costos |
generate_learning_path · | Lo que aprendimos, en orden, y lo que costó — separa las conclusiones que un experimento pagó de las que el motor infirió gratis. goal_id narra un objetivo |
get_workspace_info | A qué estado de creencia estás conectado y qué capa lo eligió — empieza aquí cuando el grafo está inesperadamente vacío |
update_status | Establecer manualmente el estado de un nodo (rara vez necesario — lo hace el motor) |
get_dag_context | Obtener una vista de subgrafo para la ventana de contexto del agente |
render_dag_map | Diagrama Mermaid.js del estado de creencia actual |
get_goal_status · | Comprobar si el nodo objetivo está cumplido. goal_id limita los conteos al subgrafo de un objetivo |
get_conflicts | Listar conflictos sin resolver (fallos de integración) |
suggest_discriminating_experiment | Para un conflicto, sugerir el intercambio que separa a los culpables |
what_would_change_my_mind | Nombrar los experimentos más baratos que derribarían la conclusión actual de un objetivo, con la evidencia más débil primero |
list_nodes | Listar/filtrar nodos por estado, profundidad o grupo de exclusión |
get_evidence_history | Rastro de evidencia completo para un nodo |
get_active_claims | Listar nodos con arrendamientos activos |
renew_claim | Extender un arrendamiento en un nodo |
release_claims | Liberar uno o todos los arrendamientos |
invalidate_upstream | Revertir el estado VERIFIED de los padres según fallos de los hijos |
verify_upstream | Propagar la confirmación hacia arriba en la cadena de dependencias |
Comandos de barra
El servidor incluye tres prompts de MCP. Los clientes que los soportan (Cursor, Claude Desktop, Cline) los muestran como comandos de barra, para que un humano pueda dirigir el bucle sin volver a escribir el protocolo — y, más útil aún, sin que el agente lo parafrasee.
| Comando | Lo que hace |
|---|---|
/hypotree-init | Crear el nodo objetivo y las primeras 3–5 hipótesis debajo, con grupos de exclusión donde las hipótesis son respuestas competidoras a una misma pregunta |
/hypotree-next | Obtener el siguiente objetivo, probarlo de verdad y registrar el resultado contra ese mismo nodo — incluyendo qué hacer para cada motivo de DONE |
/hypotree-status | Informarte sobre lo establecido, lo descartado, lo que cambió y cuántas conclusiones no costaron ningún experimento |
/hypotree-init toma un argumento opcional task. La invocación exacta depende del cliente (Cursor y Claude Desktop colocan los prompts bajo el servidor, p. ej. /hypotree:hypotree-init).
Recursos
Tres recursos de MCP, obtenidos bajo demanda en lugar de llevarse en el contexto:
| URI | Qué es |
|---|---|
hypotree://guide | El contrato completo del agente — cada herramienta, el ciclo de vida de estados, grupos de exclusión, arrendamientos, profundidad de confirmación, conjuntos de conflictos y las reglas. ~23 KB, así que no pertenece a ningún prompt de sistema |
hypotree://state | El estado de creencia actual como narrativa: qué se estableció, cómo y qué costó |
hypotree://dashboard | Dónde un humano puede ver moverse este estado de creencia, con el token incluido — para que el agente pueda responder "mándame el enlace" sin que te acerques a una terminal |
API de Python
Para agentes escritos en Python, MCP es un límite de proceso y un viaje de ida y vuelta JSON entre dos objetos en el mismo intérprete. Impórtalos en su lugar:
from hypotree import HypoTreeToolset, HypoTreeEngine, openai_tools
| Qué | Por qué lo usarías |
|---|---|
HypoTreeToolset(db_path, …) | Toda la superficie: .tools() para esquemas, .call(name, args) para ejecución, ciclo de vida con gestor de contexto |
HypoTreeToolset.from_engine(engine) | Añadir la superficie de herramientas a un motor que ya tienes. No se hace cargo de su ciclo de vida |
openai_tools(preset=…, include=…, exclude=…, read_only=…) | Solo los esquemas, si enrutas las llamadas tú mismo |
HypoTreeEngine(db_path, …) | Resultados Pydantic tipados en lugar de cadenas JSON |
La selección es componible — empieza desde un ajuste predefinido y reduce:
openai_tools(preset="essential")                 # the 6 that run the loop
openai_tools(read_only=True)                      # the 11 sensors, no writes
openai_tools(preset="essential", exclude=["add_edges"])
Cada herramienta también lleva los metadatos que un host necesita y que ningún esquema JSON puede expresar:
from hypotree import TOOL_SPECS

{s.name for s in TOOL_SPECS if s.mutates}     # gate these
{s.name for s in TOOL_SPECS if s.essential}   # ship these when context is tight
Integrarlo en un bucle de agente
Toda la integración son tres puntos de contacto: construir la lista de herramientas una vez, ejecutar por nombre y cerrar al salir. Todo lo demás tu bucle ya lo hace.
from hypotree import HypoTreeToolset

belief = HypoTreeToolset(session_dir / "beliefs.db", preset="essential")
try:
    tools = my_own_tools() + belief.tools()

    while not done:
        reply = llm.chat(messages, tools=tools)
        for call in reply.tool_calls:
            if call.name in belief.tool_names:
                # Your gate, your policy — hypotree only tells you which calls
                # are consequential.
                if belief.is_mutation(call.name) and not gate.open:
                    result = "Belief writes are gated; think first."
                else:
                    result = belief.call(call.name, call.arguments)
            else:
                result = my_dispatch(call)
            messages.append(tool_result(call, result))
finally:
    belief.close()
Cuatro cosas fáciles de hacer mal y baratas de hacer bien:
- Apunta la base de datos a un almacenamiento que sobreviva a la sesión, no al directorio de trabajo. Que el estado de creencia sobreviva a la ejecución es toda la característica; una ruta bajo un árbol de trabajo de git lo bifurca la primera vez que cambias de rama.
- Abre la sesión leyendo lo que ya se sabe.
generate_learning_pathestá en el ajuste predefinido esencial por una razón medida: en tres ejecuciones completas de evaluación, el agente lo llamó tras un reinicio de contexto exactamente cero veces, y cada sonda redundante en esas ejecuciones siguió a un reinicio. - No cargues las escrituras de creencias contra un presupuesto de mutación de código. Registrar lo que aprendiste no es el trabajo. Un agente que se queda sin presupuesto y deja de anotar sus hallazgos pierde la memoria justo cuando más vale.
callnunca lanza una excepción. Un id de nodo malo vuelve como{"error": …}, así que el bucle puede pasárselo directamente al modelo y dejar que se corrija en lugar de morir por un error tipográfico.
Pasa read_only=True para cualquier cosa que deba observar sin escribir — un revisor, una pasada de monitoreo, un subagente no confiable. Expone los once sensores y rechaza toda escritura, incluso por nombre si el modelo pide una que nunca se le dio.
Probar una integración no cuesta nada: el motor se ejecuta contra un archivo SQLite temporal en milisegundos, así que el bucle completo crear → despachar → registrar → concluir es una prueba unitaria, no una factura de inferencia.
Reglas del agente — cómo aprende tu agente a usar esto
El contrato operativo llega al modelo a través de cuatro canales. No tienes que conectar ninguno; se listan para que sepas qué ya está en contexto y qué no.
- Instrucciones del servidor. MCP entrega un bloque
instructionsa nivel de servidor al cliente duranteinitialize, y cada cliente importante lo pone frente al modelo. Hypotree lo usa para cuatro reglas: una hipótesis por nodo, marca el objetivo conis_goal=Truey conéctalo al trabajo, registra contra el nodo que realmente probaste e informa lo que se te arrendó. Nada que configurar. - Descripciones de herramientas. Cada descripción de herramienta lleva la única regla sin la cual esa herramienta se usa mal — que un objetivo nunca acepta evidencia, que un arrendamiento reserva un nodo hasta que lo informas, que confirmar un miembro de un grupo de exclusión retira al resto. Estos son los únicos textos garantizados en contexto en el momento en que se elige una herramienta.
- Recursos. La guía completa es
hypotree://guide. Un agente que encuentre algo sorprendente puede leerla sin que pegues 23 KB en un prompt de sistema.hypotree://dashboardentrega el enlace en vivo. - Tu archivo de reglas del proyecto — opcional, y la única parte que tocas. Si quieres que el agente recurra a hypotree sin que se lo pidas en trabajos de varios días, añade el bloque siguiente.
Opcional: .cursorrules / AGENTS.md / CLAUDE.md
## Long-running R&D: use hypotree

For any task that spans more than one session, branches into competing
approaches, or where an early assumption could turn out wrong later, keep the
belief state in hypotree rather than in the conversation.

- Before starting, call `generate_learning_path`. Something may already be
  settled, and re-deriving it costs an experiment you do not have to run.
- Create the objective with `is_goal=True` and wire hypotheses to it with
  `parent_ids`. Progress is then derived, not asserted.
- Competing answers to one question share an `exclusion_group`. Confirming one
  retires the rest without testing them — this is where most of the saving is.
  If the list could always grow ("which learning rate?"), add
  `exclusion_closed: false` so the engine does not deduce a survivor it cannot
  justify.
- Ask `get_next_targets` for work and record every result you were handed. A
  target is leased to you; anything you hold and never report is work nobody
  can do. Probed several things in one turn? Report them in one call with
  `record_evidence(results=[...])`.
- Record against the node whose statement you actually tested. A composition's
  failure filed against a premise destroys a confirmation that is still true.
- When `get_next_targets` returns DONE, read the reason. Only `all_goals_met`
  and `empty_frontier` mean stop; the rest are instructions. `dead_question`
  means one of your questions ran out of candidate answers — add the one you
  have not thought of to the same `exclusion_group`.
Arquitectura
┌──────────────────────────┐   ┌──────────────────────────┐
│     MCP Client (agent)   │   │   Python agent (in-proc) │
│  Cursor / Cline / Claude │   │   HypoTreeToolset        │
└────────────┬─────────────┘   └────────────┬─────────────┘
             │ MCP (stdio/HTTP)             │ direct call
┌────────────▼─────────────┐                │
│    hypotree MCP server   │                │
└────────────┬─────────────┘                │
             │                              │
┌────────────▼──────────────────────────────▼─────────────┐
│  toolkit — 20 tool specs + dispatch (no transport)      │
│  one description of the contract; both paths project it │
└────────────────────────┬────────────────────────────────┘
┌────────────────────────▼────────────────────────────────┐
│  Engine                                                 │
│  • Write-back propagation    • Cascading prune          │
│  • Exclusion-group inference • Differential ablation    │
│  • Thompson Sampling navigator                          │
└────────────────────────┬────────────────────────────────┘
┌────────────────────────▼────────────────────────────────┐
│  SQLite-WAL                                             │
│  • Bi-temporal history                                  │
│  • Belief state + evidence + conflicts                  │
│  • Keyed by workspace_id                                │
└─────────────────────────────────────────────────────────┘
La capa de herramientas es la razón por la que los dos puntos de entrada no pueden divergir: ninguno es dueño de los esquemas, y ninguno es dueño del enrutamiento.
Evaluación
Hypotree se valida con un benchmark adversarial preregistrado usando qwen3.6:27b-q8_0 y gemma4:31b-it-q4_K_M. El benchmark es un conjunto de 30 problemas combinatorios de I+D sembrados, cada uno con 3125 combinaciones (5 ejes × 5 valores). Cada brazo se ejecuta en todas las semillas, y los criterios de puerta se puntúan contra los umbrales preregistrados.
Tres brazos en 30 problemas combinatorios de I+D sembrados:
- Brazo A — agente LLM con bloc de notas Markdown manual (piso ergonómico)
- Brazo F — agente LLM con transcripción automática de recuerdo perfecto (línea base de acero)
- Brazo B — agente LLM sobre el estado de creencia completo del DAG de hypotree El foso es inferencial, no mnemotécnico. El brazo F recordó cada dato crudo que jamás vio — cero sondas duplicadas en toda la ejecución — y aun así perdió 30/0/0, porque hypotree cierra preguntas que nunca tiene que hacer: 329 inferencias de exclusión, 37 respuestas deducidas sin una sonda, 12 valores eliminados por un intercambio que se quedó corto. Ninguna de esas es algo que puedas buscar.
Ejecutar la evaluación
# Pre-flight: confirm the engine solves every seed (no GPU)
uv run python -m eval.runner.engine_selfplay

# Pre-flight: score the cost-aware falsifier on a cost-weighted tariff (no GPU)
uv run python -m eval.cost_gate

# Full gate: 30 seeds × 3 arms
./eval.sh --run-iteration <X> --llm-model <model>
El arnés de evaluación vive en eval/ e incluye los generadores de paisajes congelados, el ejecutor de agentes y el puntuador de compuertas. Los artefactos de ejecución están en gitignore (eval/runs/).
eval.sh es bash — en Windows, ejecútalo bajo WSL o Git Bash. Las partes de Python del arnés (engine_selfplay, runner, analyse_gate, seed_reader) son multiplataforma y pueden manejarse directamente.
Configuración
Identidad del espacio de trabajo
La base de datos del estado de creencias está aislada por espacio de trabajo. Cuatro capas de resolución, prioridad más alta primero:
- Variable de entorno
HYPOTREE_WORKSPACE_ID— un nombre explícito. Úsalo para configuraciones MCP globales, donde el directorio de trabajo del servidor no es tu proyecto. hypotree.yaml— copiahypotree.yaml.templatea la raíz de tu proyecto:workspace_id: my-project-name- Hash del remoto Git — las grafías SSH y HTTPS de un remoto se resuelven al mismo id.
- Hash de la ruta del proyecto — el respaldo, y el más débil: cambia si el proyecto se mueve o se monta de manera diferente.
La capa 4 es de donde provienen casi todos los informes de "mi estado de creencias está vacío". Ejecuta hypotree --info, o haz que el agente llame a get_workspace_info, para ver qué capa se activó realmente:
$ hypotree --info
{
  "workspace_id": "d94da5f61c664f94",
  "resolved_from": "git_remote",
  "database": "/home/you/.local/share/mcp_hypotree/d94da5f61c664f94/state.db",
  "database_exists": true,
  "warnings": []
}
Los nombres de espacios de trabajo son [a-z0-9._~-] en minúsculas, hasta 128 caracteres.
Dónde se almacena el estado
| Plataforma | Ubicación |
|---|---|
| Linux / macOS | $XDG_DATA_HOME/mcp_hypotree/<workspace_id>/ — por defecto en ~/.local/share |
| Windows | %LOCALAPPDATA%\mcp_hypotree\<workspace_id>\ |
XDG_DATA_HOME anula en todas las plataformas, incluida Windows — así es como ejecutas instancias aisladas una al lado de la otra.
Mantenlo en un disco local. SQLite se ejecuta en modo WAL, que necesita memoria compartida que los recursos compartidos de red y la mayoría de las unidades asignadas no proporcionan. Apuntar
XDG_DATA_HOMEa una ruta UNC o a un recurso compartido montado fallará o corromperá la base de datos.hypotree --infoadvierte cuando detecta uno.
Notas para Windows
- Todo excepto
eval.shse ejecuta de forma nativa; el arnés de evaluación es un script bash y necesita WSL o Git Bash. - Git es opcional. Sin él en
PATH, las capas 3 y 4 caen ambas al hash de ruta — fija el espacio de trabajo con la capa 1 o 2 en su lugar.
Desarrollo
# Install in dev mode
uv sync

# Run tests
uv run pytest tests/ -x -q

# Lint + format
uv run ruff check src/ tests/ eval/
uv run ruff format src/ tests/ eval/

# Type check
uv run mypy src/hypotree/
Licencia
MIT — Copyright © 2026 Damian Borowski
Enlaces
- GitHub: github.com/tygryso/hypotree
- Registro de cambios:
CHANGELOG.md— historial de versiones con resultados de compuertas - Guía del agente:
src/hypotree/AGENT_GUIDE.md— el contrato completo, también servido en vivo como el recurso MCPhypotree://guide