PDF2Text — Local PDF & Image OCR MCP
Servidor MCP local para extraer texto y Markdown de PDFs, escaneos e imágenes. Utiliza texto nativo de PDF primero y OCR de Apple Vision en macOS. Informa páginas omitidas y advertencias. No se requiere clave de API de OCR.
Documentación
PDF2Text
Servidor MCP local para agentes de IA y aplicación para macOS: texto desde PDF, escaneos y fotografías.
Conecta PDF2Text a un agente compatible con servidores MCP locales: el agente podrá leer el documento indicado y obtener texto o Markdown para buscar, analizar y trabajar con tus materiales. El texto listo de un PDF se extrae directamente; el OCR solo se ejecuta en las páginas que lo necesitan. Si se omiten páginas, el agente recibe una advertencia explícita.
Conectar MCP · Descargar la aplicación para macOS · Usar CLI
El reconocimiento se realiza en tu computadora. Al trabajar mediante MCP, el texto extraído se envía al cliente; si el cliente usa un modelo en la nube, el texto podría llegar al proveedor de ese modelo.
Inicio rápido: MCP
La primera versión de MCP está disponible desde el código fuente. Se necesitan Git, Python 3.11+; para el Apple Vision integrado, macOS 13+. Instalación en Mac:
git clone https://github.com/Timur99/PDF2Text.git
cd PDF2Text
python3 -m venv .venv
.venv/bin/python -m pip install ".[mcp,vision]"
.venv/bin/pdf2text-mcp --help
En la configuración del cliente MCP, indica el comando y los argumentos (reemplaza las rutas absolutas):
{
  "mcpServers": {
    "pdf2text": {
      "command": "/absolute/path/to/PDF2Text/.venv/bin/pdf2text-mcp",
      "args": ["--allow-dir", "/absolute/path/to/documents"]
    }
  }
}
Este es un ejemplo para clientes con configuración mcpServers. En clientes con formulario
de conexión, usa los mismos command y args. El cliente inicia el servidor por sí mismo;
no es necesario abrir la aplicación macOS para esto.
Ejemplo de solicitud al agente: «Usa PDF2Text, lee
/absolute/path/to/documents/report.pdf y destaca las conclusiones principales».
extract_textdevuelve texto, información de páginas y advertencias.list_enginesmuestra los motores disponibles.- Solo están disponibles los directorios indicados mediante
--allow-dir. - En modo
auto, el OCR está limitado a 12 páginas. Para el reconocimiento completo de un escaneo, eligevisiono pídeselo al agente. Los límites generales son 200 páginas de PDF y 80 MB.
Otros sistemas operativos, parámetros de herramientas y detalles de conexión están en MCP.md.
Diferencia principal
El OCR no es el primer paso. La mayoría de las herramientas procesan todo el PDF con reconocimiento, incluso si ya contiene una capa de texto: es lento, calienta el procesador y estropea lo que ya era perfecto.
PDF2Text primero hace un triage: la biblioteca local pdf-inspector determina
el tipo de documento en milisegundos y extrae el texto directamente de las páginas donde
es legible. El reconocimiento solo se ejecuta en el resto.

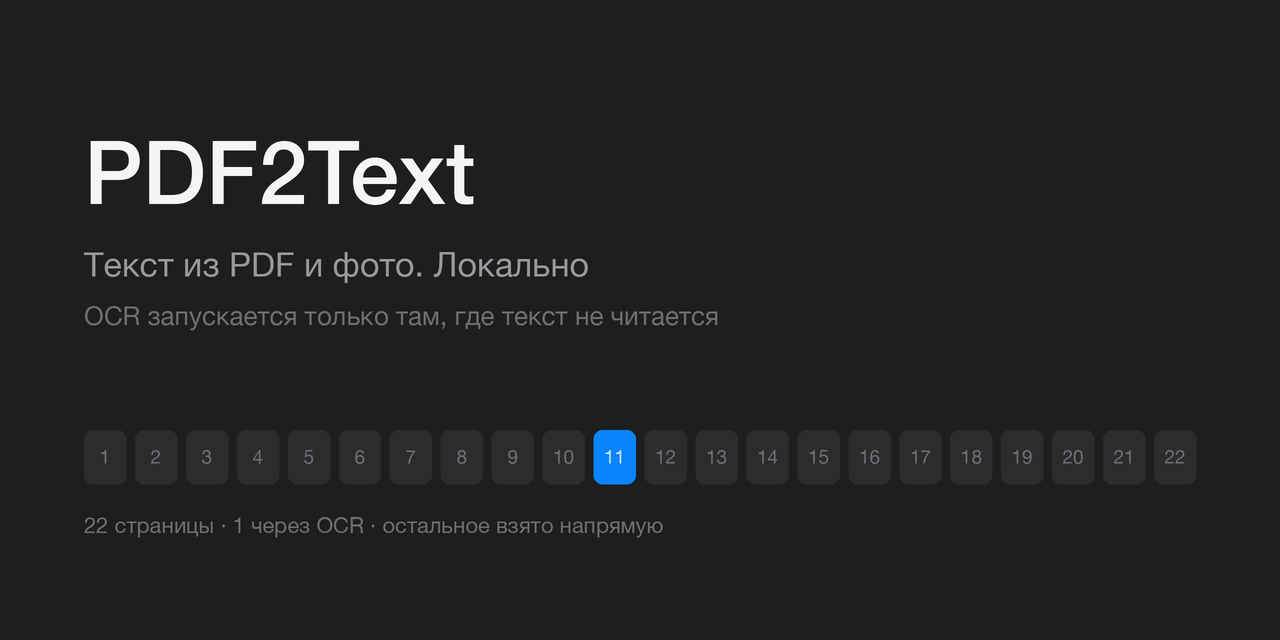
En este documento de 22 páginas, el reconocimiento fue necesario solo para una. Las demás se tomaron directamente; el triage tomó 8 ms. La celda azul en el mapa de páginas es esa página; puedes hacer clic en ella para verla por separado.
La interfaz siempre muestra cómo se obtuvo el resultado — native, ocr
o hybrid — y cuántas páginas se enviaron a reconocimiento. Si el sistema simplificó
o recortó algo, se indica en pantalla, no solo en los registros.
Instalación de la aplicación desde el código fuente
Se necesitan Python 3.11+ y macOS.
python3 -m venv .venv
source .venv/bin/activate
pip install -e ".[vision]"
PaddleOCR es el motor de respaldo: pesa cientos de megabytes y no todos lo necesitan:
pip install -e ".[ocr]"
Aplicación
local-ocr
# http://127.0.0.1:8765
Arrastra un PDF o una fotografía a la ventana. A la izquierda está el historial de tareas; a la derecha, el resultado con el mapa de páginas, los datos de triage y el texto. Exportación a Markdown y TXT, eliminación de la tarea junto con el archivo original.
Línea de comandos
pdf2text scan.pdf > out.md
El progreso va a stderr; el resultado, a stdout, por lo que la salida se puede redirigir y pasar por tuberías. El documento se procesa en un directorio temporal que se elimina al salir.
| Indicador | Qué hace |
|---|---|
-o, --output FILE | escribir en un archivo en lugar de stdout |
-e, --engine auto|native|vision|paddleocr | modo de procesamiento (por defecto auto) |
-l, --lang ru | idioma de reconocimiento |
-f, --format md|txt|json | formato de salida (por defecto md) |
-q, --quiet | no mostrar el progreso |
Códigos de retorno: 0 — éxito, 1 — error de procesamiento, 2 — archivo no encontrado.
Modos
| Modo | Cuándo se necesita |
|---|---|
| Auto | Para todo. El texto se toma directamente; el reconocimiento, solo donde no hay texto |
| Solo native | Para PDF con capa de texto lista: instantáneo y preciso. En escaneos se negará a funcionar |
| Apple Vision | Para escaneos, fotos y páginas multicolumna. Forzado para todas las páginas |
| PaddleOCR | De respaldo. Si Vision falla en un archivo concreto, o el sistema no es macOS |
El motor de reconocimiento predeterminado es Apple Vision. Está integrado en macOS, no ocupa espacio en la compilación y, en una medición de ocho páginas, resultó 16 veces más rápido que PaddleOCR con mejor orden de lectura en páginas multicolumna: 4,3 s frente a 68,4 s. La metodología y las cifras completas están en DECISIONS.md.
Cómo está organizado el recorrido del documento
файл → проверка → triage (pdf-inspector)
                    ├── страницы с текстом  → берём напрямую
                    └── остальные страницы  → OCR (Vision или PaddleOCR)
                                              ↓
                              сборка → Markdown / TXT / JSON
El dominio no conoce los SDK de los motores: el enrutamiento son funciones puras en
backend/domain/routing.py; los motores viven tras un protocolo común en
backend/engines/. Un motor nuevo se añade con un adaptador, sin tocar la API ni la interfaz.
Privacidad
- El servidor web solo escucha en
127.0.0.1; MCP usa stdio y no abre ningún puerto. - El triage y el OCR funcionan localmente; el servidor no sube el archivo original a ningún sitio.
- MCP envía el texto extraído al cliente. El envío posterior a un modelo en la nube depende del cliente y de su configuración.
- El contenido de los documentos no se escribe en los registros.
- No hay telemetría.
Compilación de la aplicación para macOS
.venv/bin/pyinstaller desktop/pdf2text.spec --noconfirm \
    --distpath desktop/dist --workpath desktop/build
./desktop/build_app.sh
Se obtienen desktop/dist/PDF2Text.app y PDF2Text-<версия>.dmg. Los detalles y los
identificadores de compilación están en desktop/README.md.
Documentación
| Documento | De qué trata |
|---|---|
| ARCHITECTURE.md | Componentes, capas, contratos de motores |
| DESIGN.md | Interfaz: tokens, componentes, estados |
| DECISIONS.md | Registro de decisiones con justificaciones y mediciones |
| PROJECT_PLAN.md | Etapas y criterios de finalización |
| MCP.md | Instalación del servidor MCP, conexión y contrato de herramientas |
| SPEC-stage-1.5.md | Especificación de la etapa actual |
Pruebas
pip install -e ".[dev,vision]"
pytest