observability-mcp
Un servidor MCP que se conecta a cualquier backend de observabilidad mediante conectores conectables, normaliza los datos, añade análisis inteligente y proporciona una interfaz web para la configuración.
Documentación
observability-mcp
La puerta de enlace unificada de observabilidad para agentes de IA.
Un servidor MCP que se conecta a cualquier backend de observabilidad mediante conectores conectables, normaliza los datos, añade un análisis robusto de anomalías y proporciona una interfaz web para la configuración.
Un endpoint MCP, todos los backends — así, un agente que triaje un incidente hace una pregunta normalizada en lugar de lidiar con N servidores de proveedores y sus lenguajes de consulta.
0/10 → 10/10: el mismo modelo local de 8B pasa de alucinar respuestas sobre el radio de explosión a respuestas exactamente correctas cuando recibe las herramientas de topología de esta puerta de enlace — medido, no afirmado.
npx @thotischner/observability-mcp                                    # start (UI on :3000)
claude mcp add observability --transport http http://localhost:3000/mcp   # wire into Claude
Doce herramientas de solo lectura (readOnlyHint: true en cada una) · filtrado/agregación en el servidor
para que los agentes obtengan números, no montones de datos · Guía para agentes





Todas las insignias — CI, Helm, cadena de suministro (cosign / SBOM / SLSA / procedencia)


📖 Sitio de documentación completo: https://thotischner.github.io/observability-mcp/
🔌 Abrir en MCP Inspector — explorador interactivo de una línea:
npx --yes @modelcontextprotocol/inspector \
  --config <(npx --yes @thotischner/observability-mcp inspector-config)
Por qué importa — medido, no afirmado
En una pregunta real de un equipo de plataforma Kubernetes ("¿qué otros pods comparten un nodo con
payment-service para saber qué más se cae si ese nodo se va abajo?"), el mismo
modelo local produce respuestas muy diferentes según las herramientas que le des:
| Herramientas disponibles para el agente (llama3.1:8b, n=10) | Precisión del radio de explosión entre namespaces |
|---|---|
| Herramientas genéricas de métricas + logs + servicios | 0 / 10 — alucina el tipo de entidad incorrecto (prometheus, loki, kubernetes) |
Mismo modelo + get_topology + get_blast_radius | 10 / 10 — lista exacta y correcta de co-inquilinos, en cada iteración |
El JSON crudo de ambos brazos, más tres escenarios adicionales (RCA de un solo servicio, radio de explosión
dentro del namespace, escenarios donde la topología no ayuda), están en
docs/benchmark-astronomy-shop.md. El arnés está en
scripts/benchmark-rca.mjs; vuelve a ejecutarlo con make benchmark-up && make benchmark-run.
No afirmamos una aceleración universal — el documento detalla exactamente dónde ayudan las herramientas de topología (preguntas con forma de grafo) y dónde no (perforaciones de una sola métrica).
Pruébalo en 10 segundos
npx @thotischner/observability-mcp
# then open http://localhost:3000
Conéctalo a Claude Code con una sola llamada de CLI:
claude mcp add observability --transport http http://localhost:3000/mcp
…o confígalo en tu repositorio como .mcp.json (funciona igual en Claude Desktop / Cursor):
{
  "mcpServers": {
    "observability": {
      "transport": { "type": "http", "url": "http://localhost:3000/mcp" }
    }
  }
}
El servidor arranca con cero fuentes. Añade Prometheus/Loki mediante la interfaz web o las variables de entorno PROMETHEUS_URL / LOKI_URL.
Si prefieres que los fragmentos anteriores los imprima un objetivo de Make — incluyendo sustitución de host/puerto personalizados — usa
make connect-claude-codeomake connect-cursor.make doctorhace un handshake MCP real contra un servidor en ejecución, informa de la postura de gobernanza en vivo (modo de autenticación, redacción, persistencia del registro de auditoría, límite de tasa por identidad) y te dice qué corregir si no puede.
¿Multiusuario / producción? Consulta docs/access-control.md para la configuración opcional de inicio de sesión en modo básico + RBAC + registro de auditoría + límite de tasa por identidad. Todo desactivado por defecto; la demo anterior no cambia.
¿SSO mediante OIDC?
make demo-oidcarranca un Keycloak + un servidor mcp con sabor OIDC en el puerto 3001 con tres usuarios aprovisionados previamente (admin/operator/viewer, contraseña = nombre de usuario, SOLO DEMO). Consulta docs/auth-oidc.md para configuraciones de producción con Keycloak / Authentik / Auth0 / Azure AD.¿RBAC externo mediante OPA?
make demo-opaarranca un Open Policy Agent con una política Rego de ejemplo + un servidor mcp respaldado por OPA en el puerto 3002. Consulta docs/policy-engines.md para conocer las ventajas e inconvenientes de los backends integrado / archivo / OPA y las rutas de migración.¿Productos MCP seleccionados? Establece
OMCP_PRODUCTS_FILEa un catálogo YAML (config/products.yaml.example) y entrega paquetes de herramientas por inquilino/agente en lugar de "todo, todo el tiempo". Con control RBAC, auditado, editable en caliente. Detalles en docs/products.md.
¿Quieres la demo completa de ingeniería del caos (Prometheus + Loki + 3 servicios de ejemplo + el agente autónomo)? Clona y ejecuta:
make demo # equivalent to: docker compose --profile demo up --build --wait
O ejecuta el inicio rápido soberano — un comando, totalmente local, cero llamadas externas: arranca la pila, inyecta un incidente real y muestra lado a lado lo que obtiene un agente sin vs con la capa de análisis (una pared de números crudos vs un veredicto puntuado que señala al culpable). El agente opcional razona sobre ello con un modelo local (Ollama):
make demo-sovereign
Consulta make help para todos los flujos de trabajo canónicos.
¿Por qué?
Cada proveedor de observabilidad ofrece su propio servidor MCP — Prometheus, Grafana, Datadog, Elastic, cada uno aislado. Un agente de IA que triaje un incidente entre sistemas debe lidiar con N servidores separados y aprender cada lenguaje de consulta (PromQL, LogQL, …). No existe una capa de abstracción unificada.
observability-mcp es esa capa: un endpoint MCP que normaliza cada backend y responde en términos simples de servicio/métrica/log, más un motor de análisis que señala anomalías que el agente tendría que reconstruir por sí mismo a partir de consultas crudas.
Para quién es: equipos de SRE / plataforma que ejecutan Prometheus + Loki y usan un agente de IA (Claude, LLMs locales, …) para el triaje de incidentes. El apalancamiento de la puerta de enlace es mayor cuando el agente no es un modelo frontera — un modelo más pequeño o local que no puede escribir PromQL/LogQL de forma fiable se beneficia más de herramientas normalizadas y análisis precalculados. Un modelo frontera fuerte puede consultar backends crudos con competencia por sí solo; ahí el valor está en la consistencia y el motor de análisis, no en la comodidad de consulta. Lo decimos con honestidad en lugar de afirmar una aceleración universal.
Características
- 🔍 Inspeccionar — ver, aprender y hacer cumplir el comportamiento del agente — un grafo en vivo estilo service-mesh de cada llamada a herramienta MCP, un flujo de aprendizaje estilo AppArmor que deriva un perfil de comportamiento del tráfico real, y un modo de cumplimiento que bloquea llamadas fuera de la línea base aceptada. Ir a Inspeccionar ↓
- Puerta de enlace unificada — Un único endpoint MCP para todos tus backends de observabilidad.
- Análisis entre señales — Correlaciona métricas y logs automáticamente. Detección robusta de anomalías (línea base mediana/MAD, detección de tendencias para rampas lentas, calentamiento + permanencia para suprimir el aleteo) y puntuación de salud ponderada.
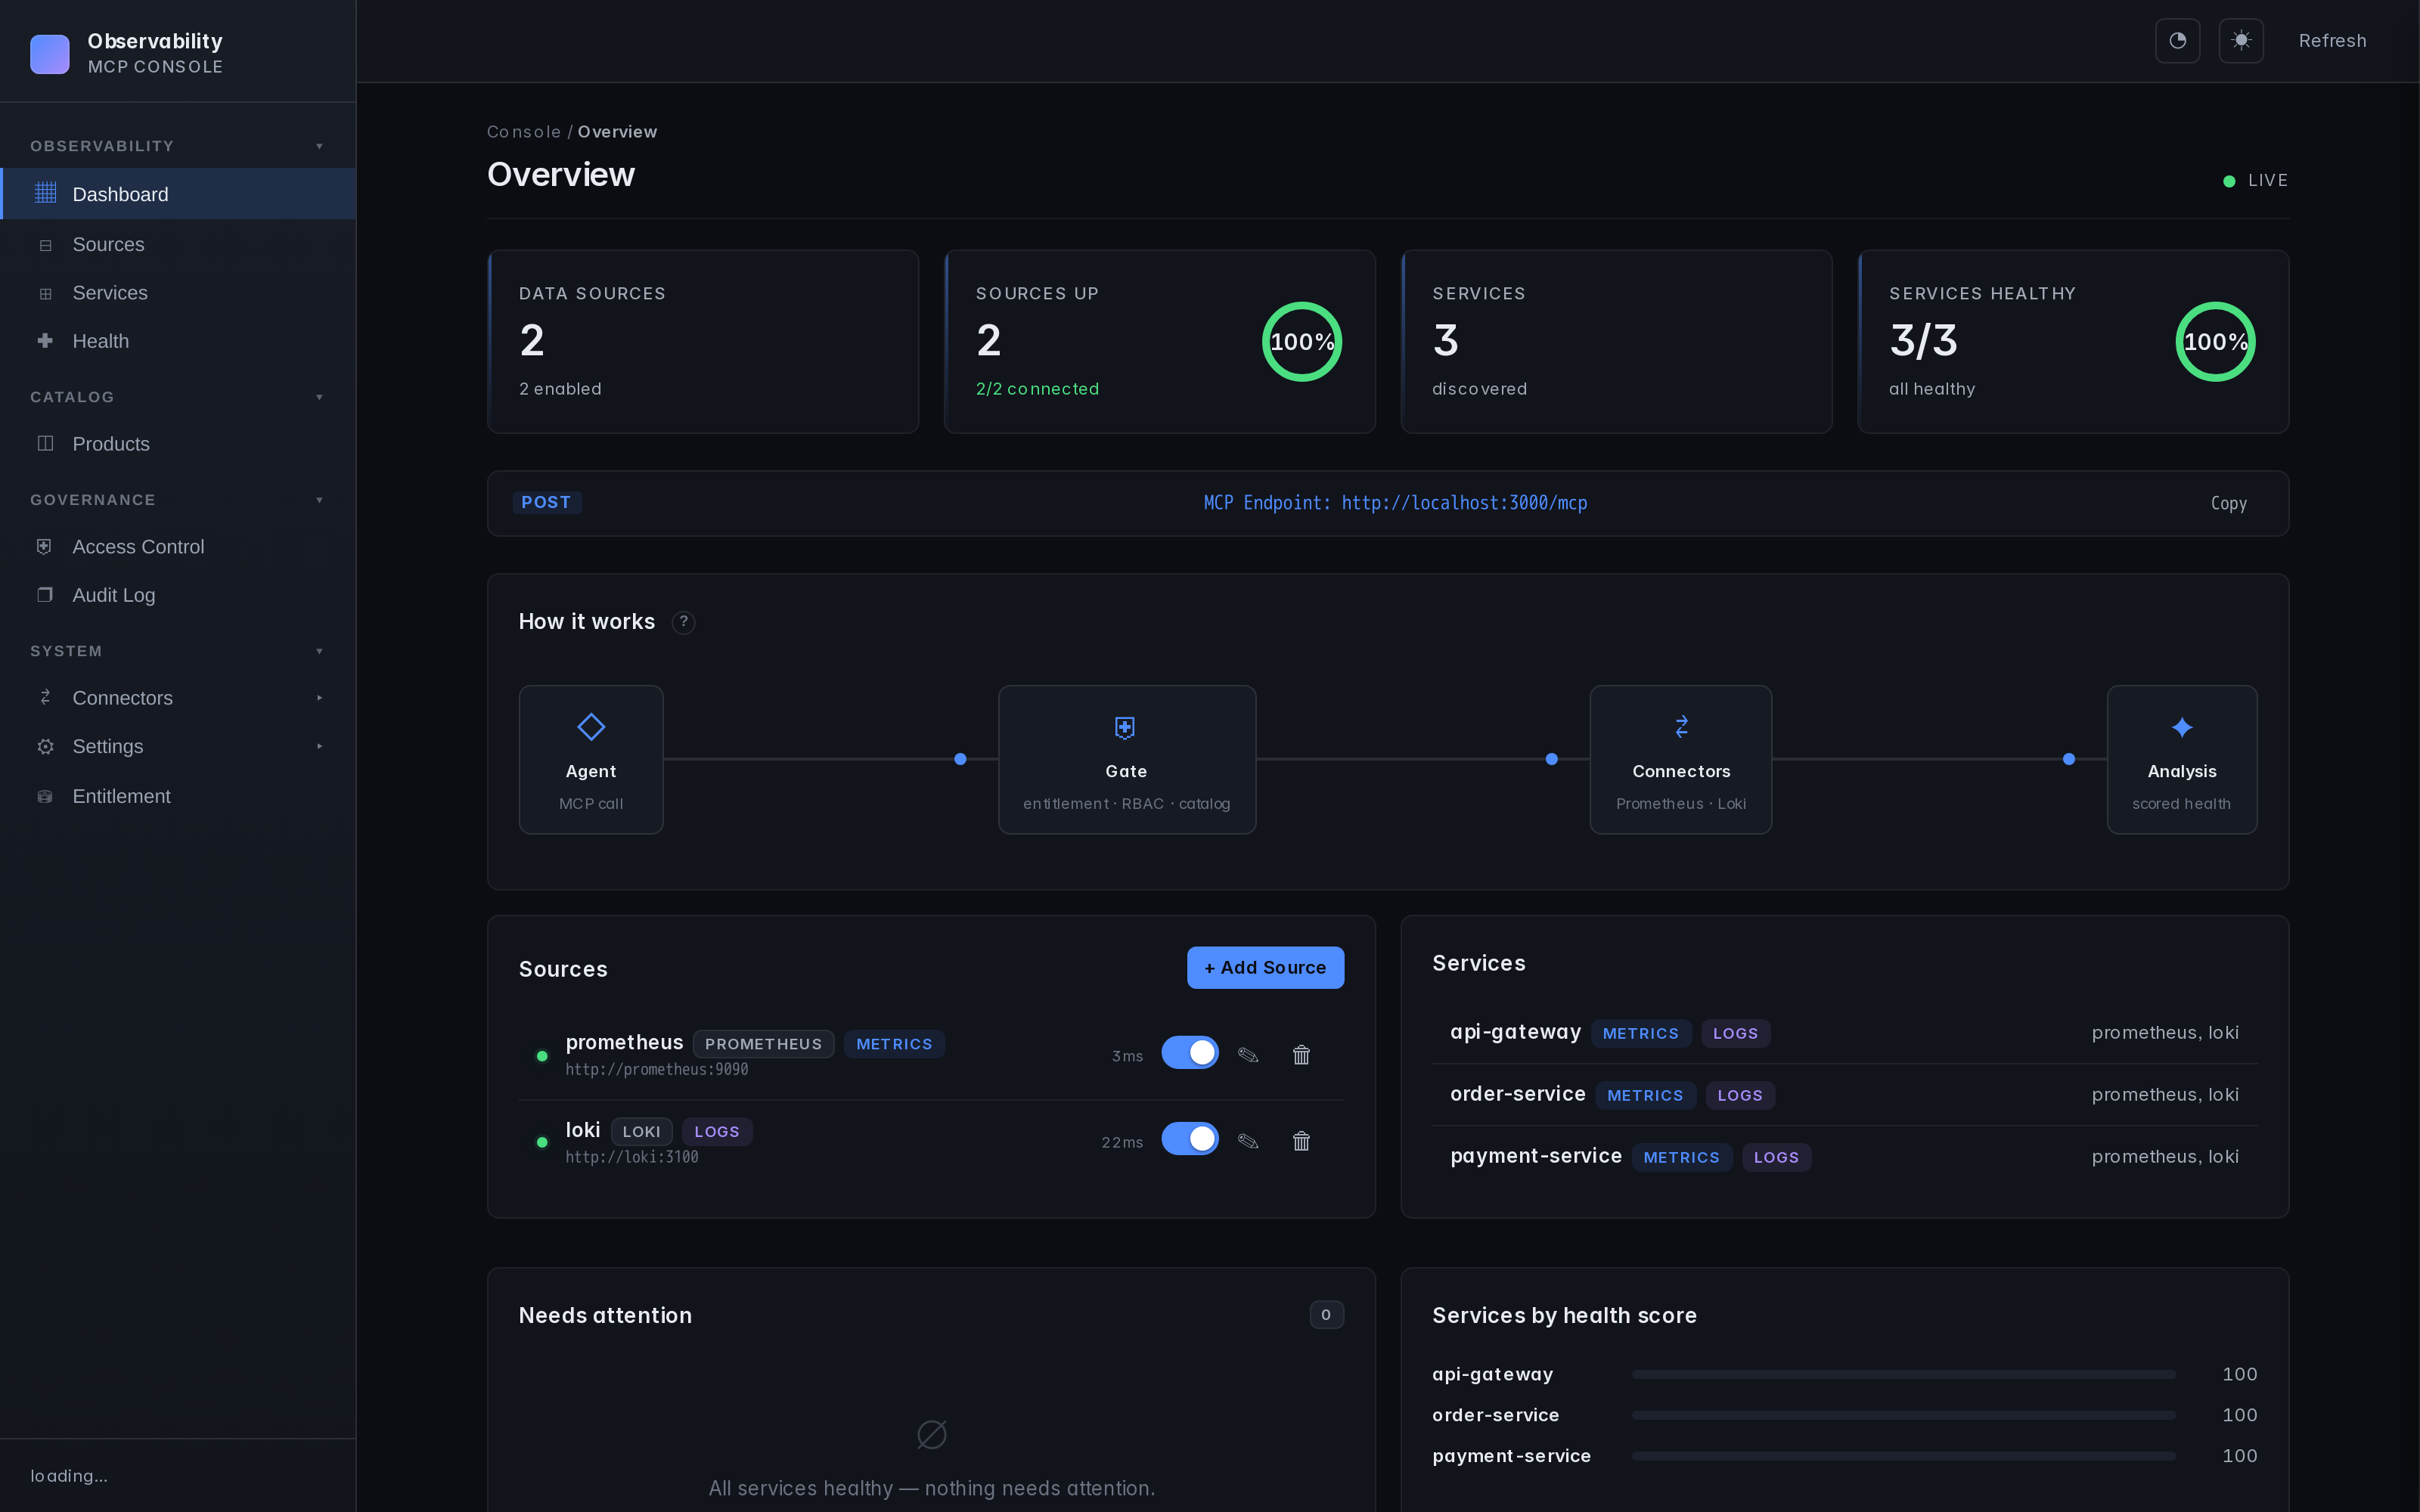
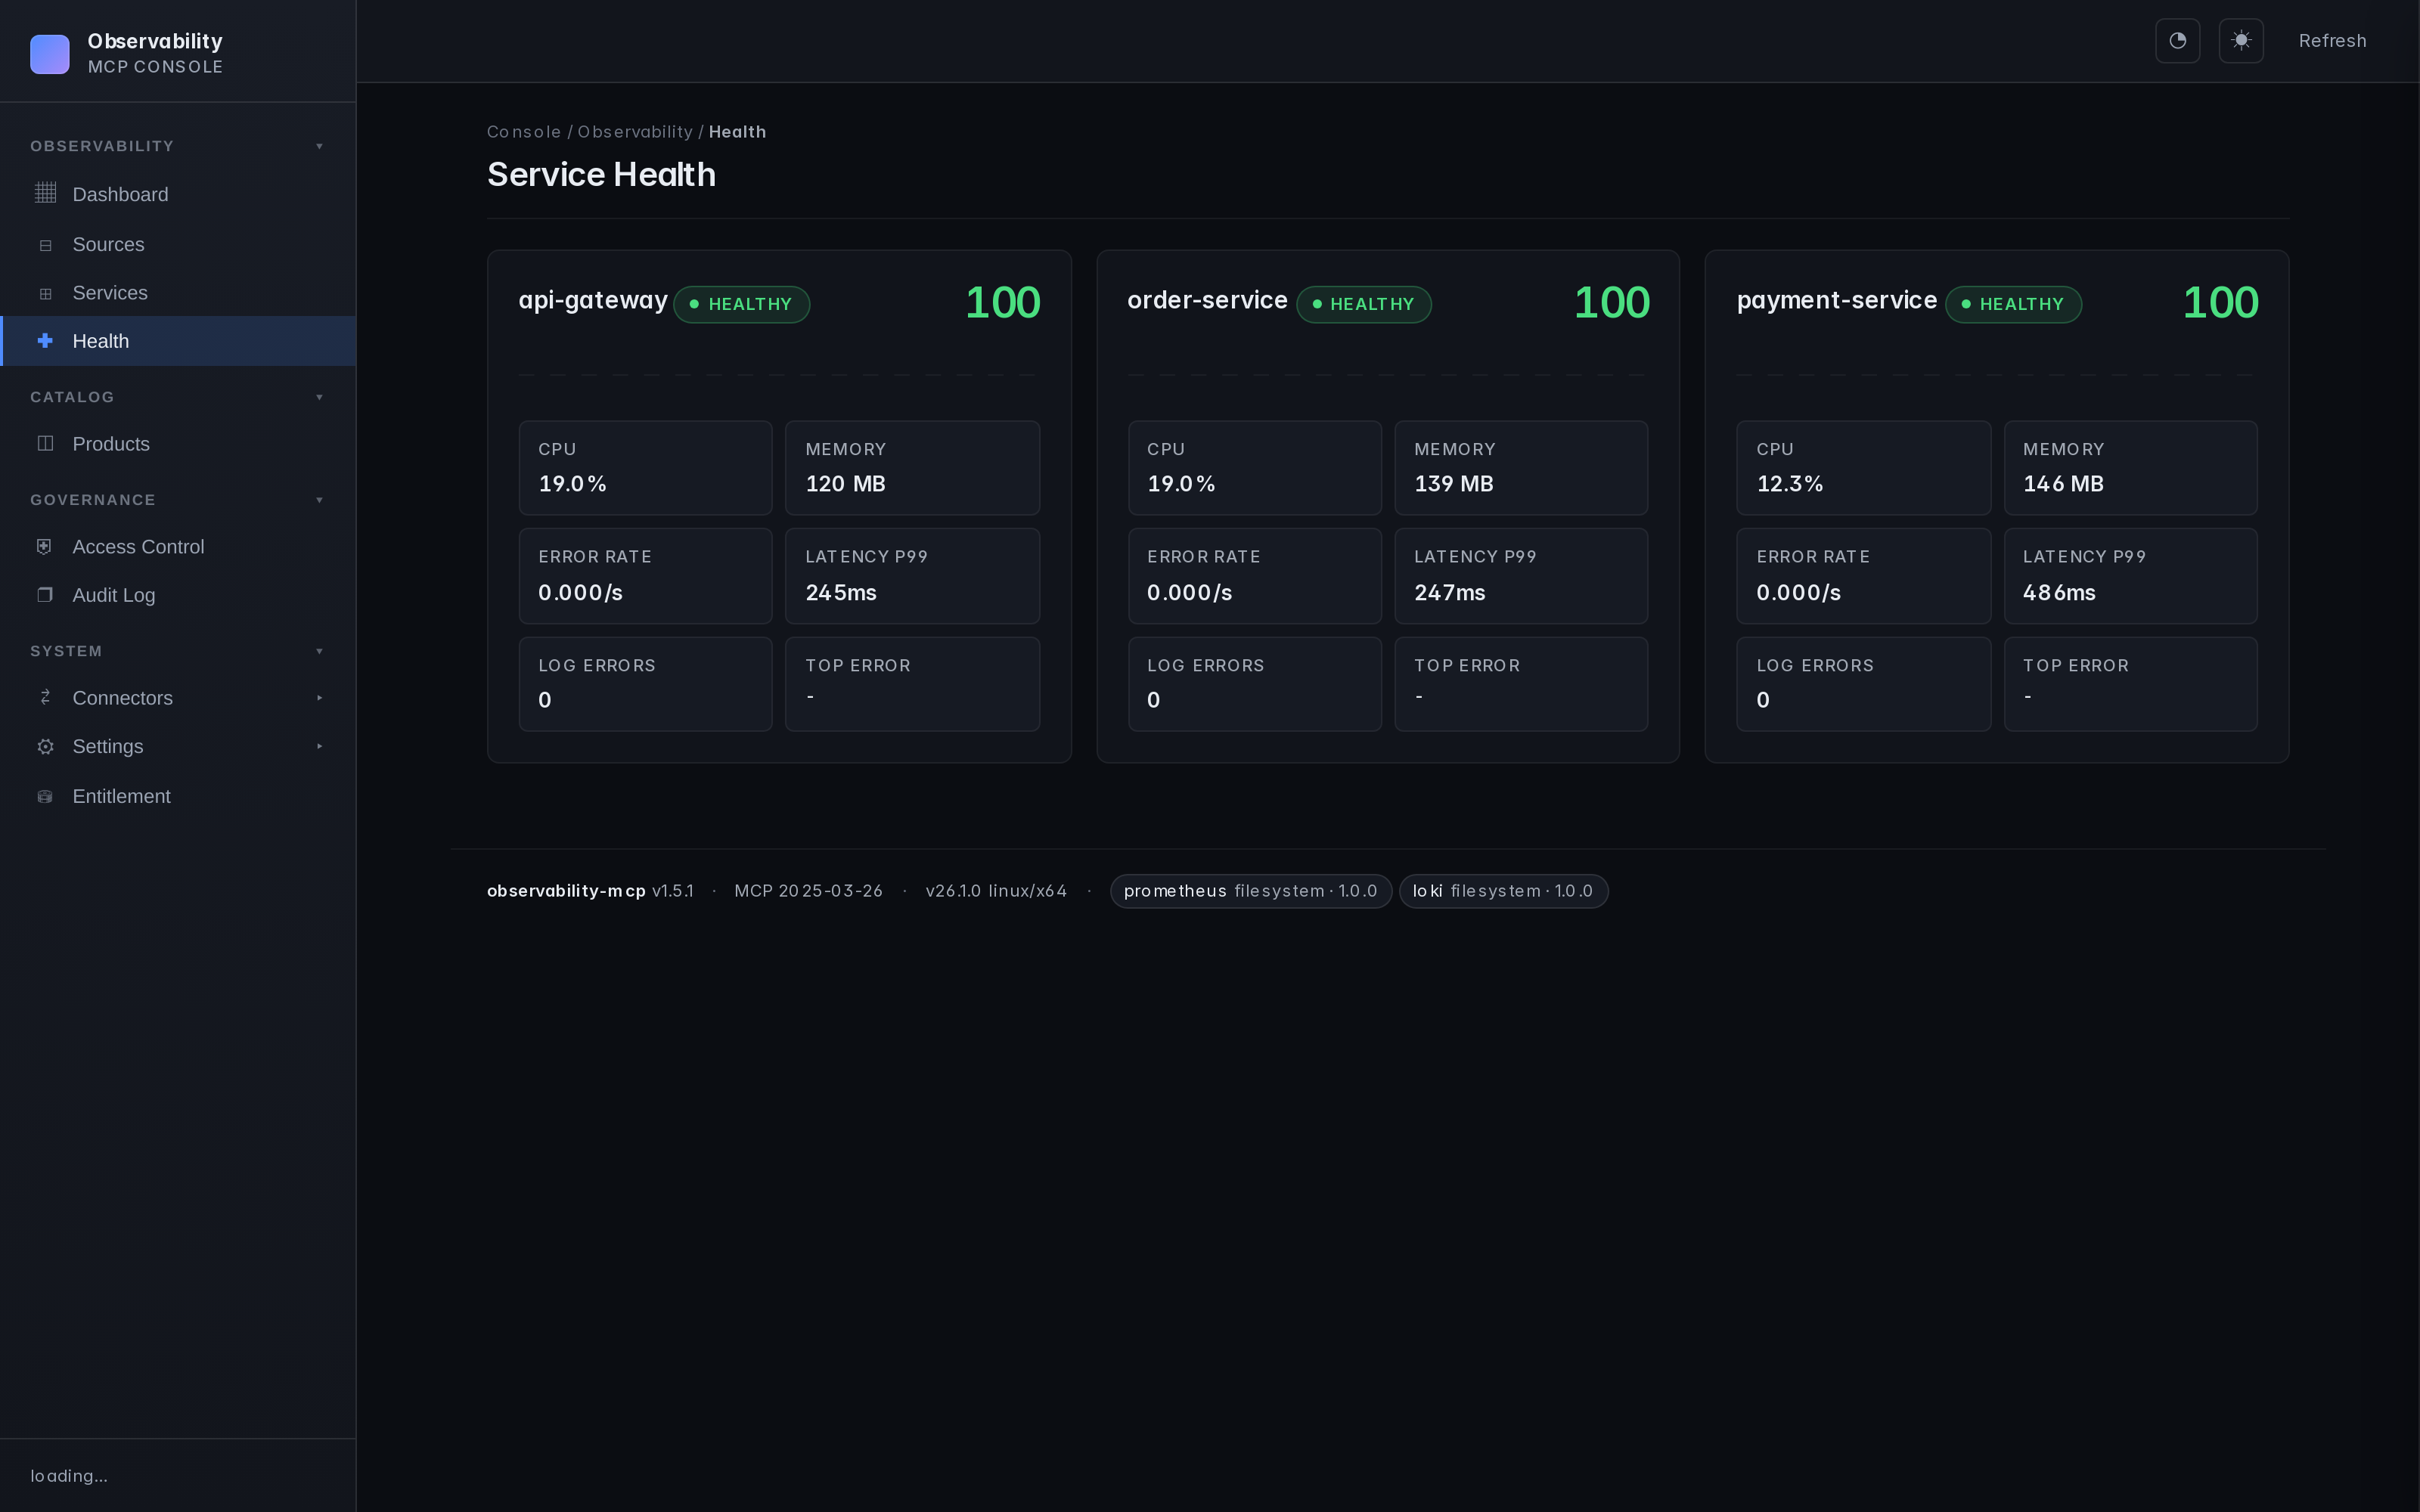
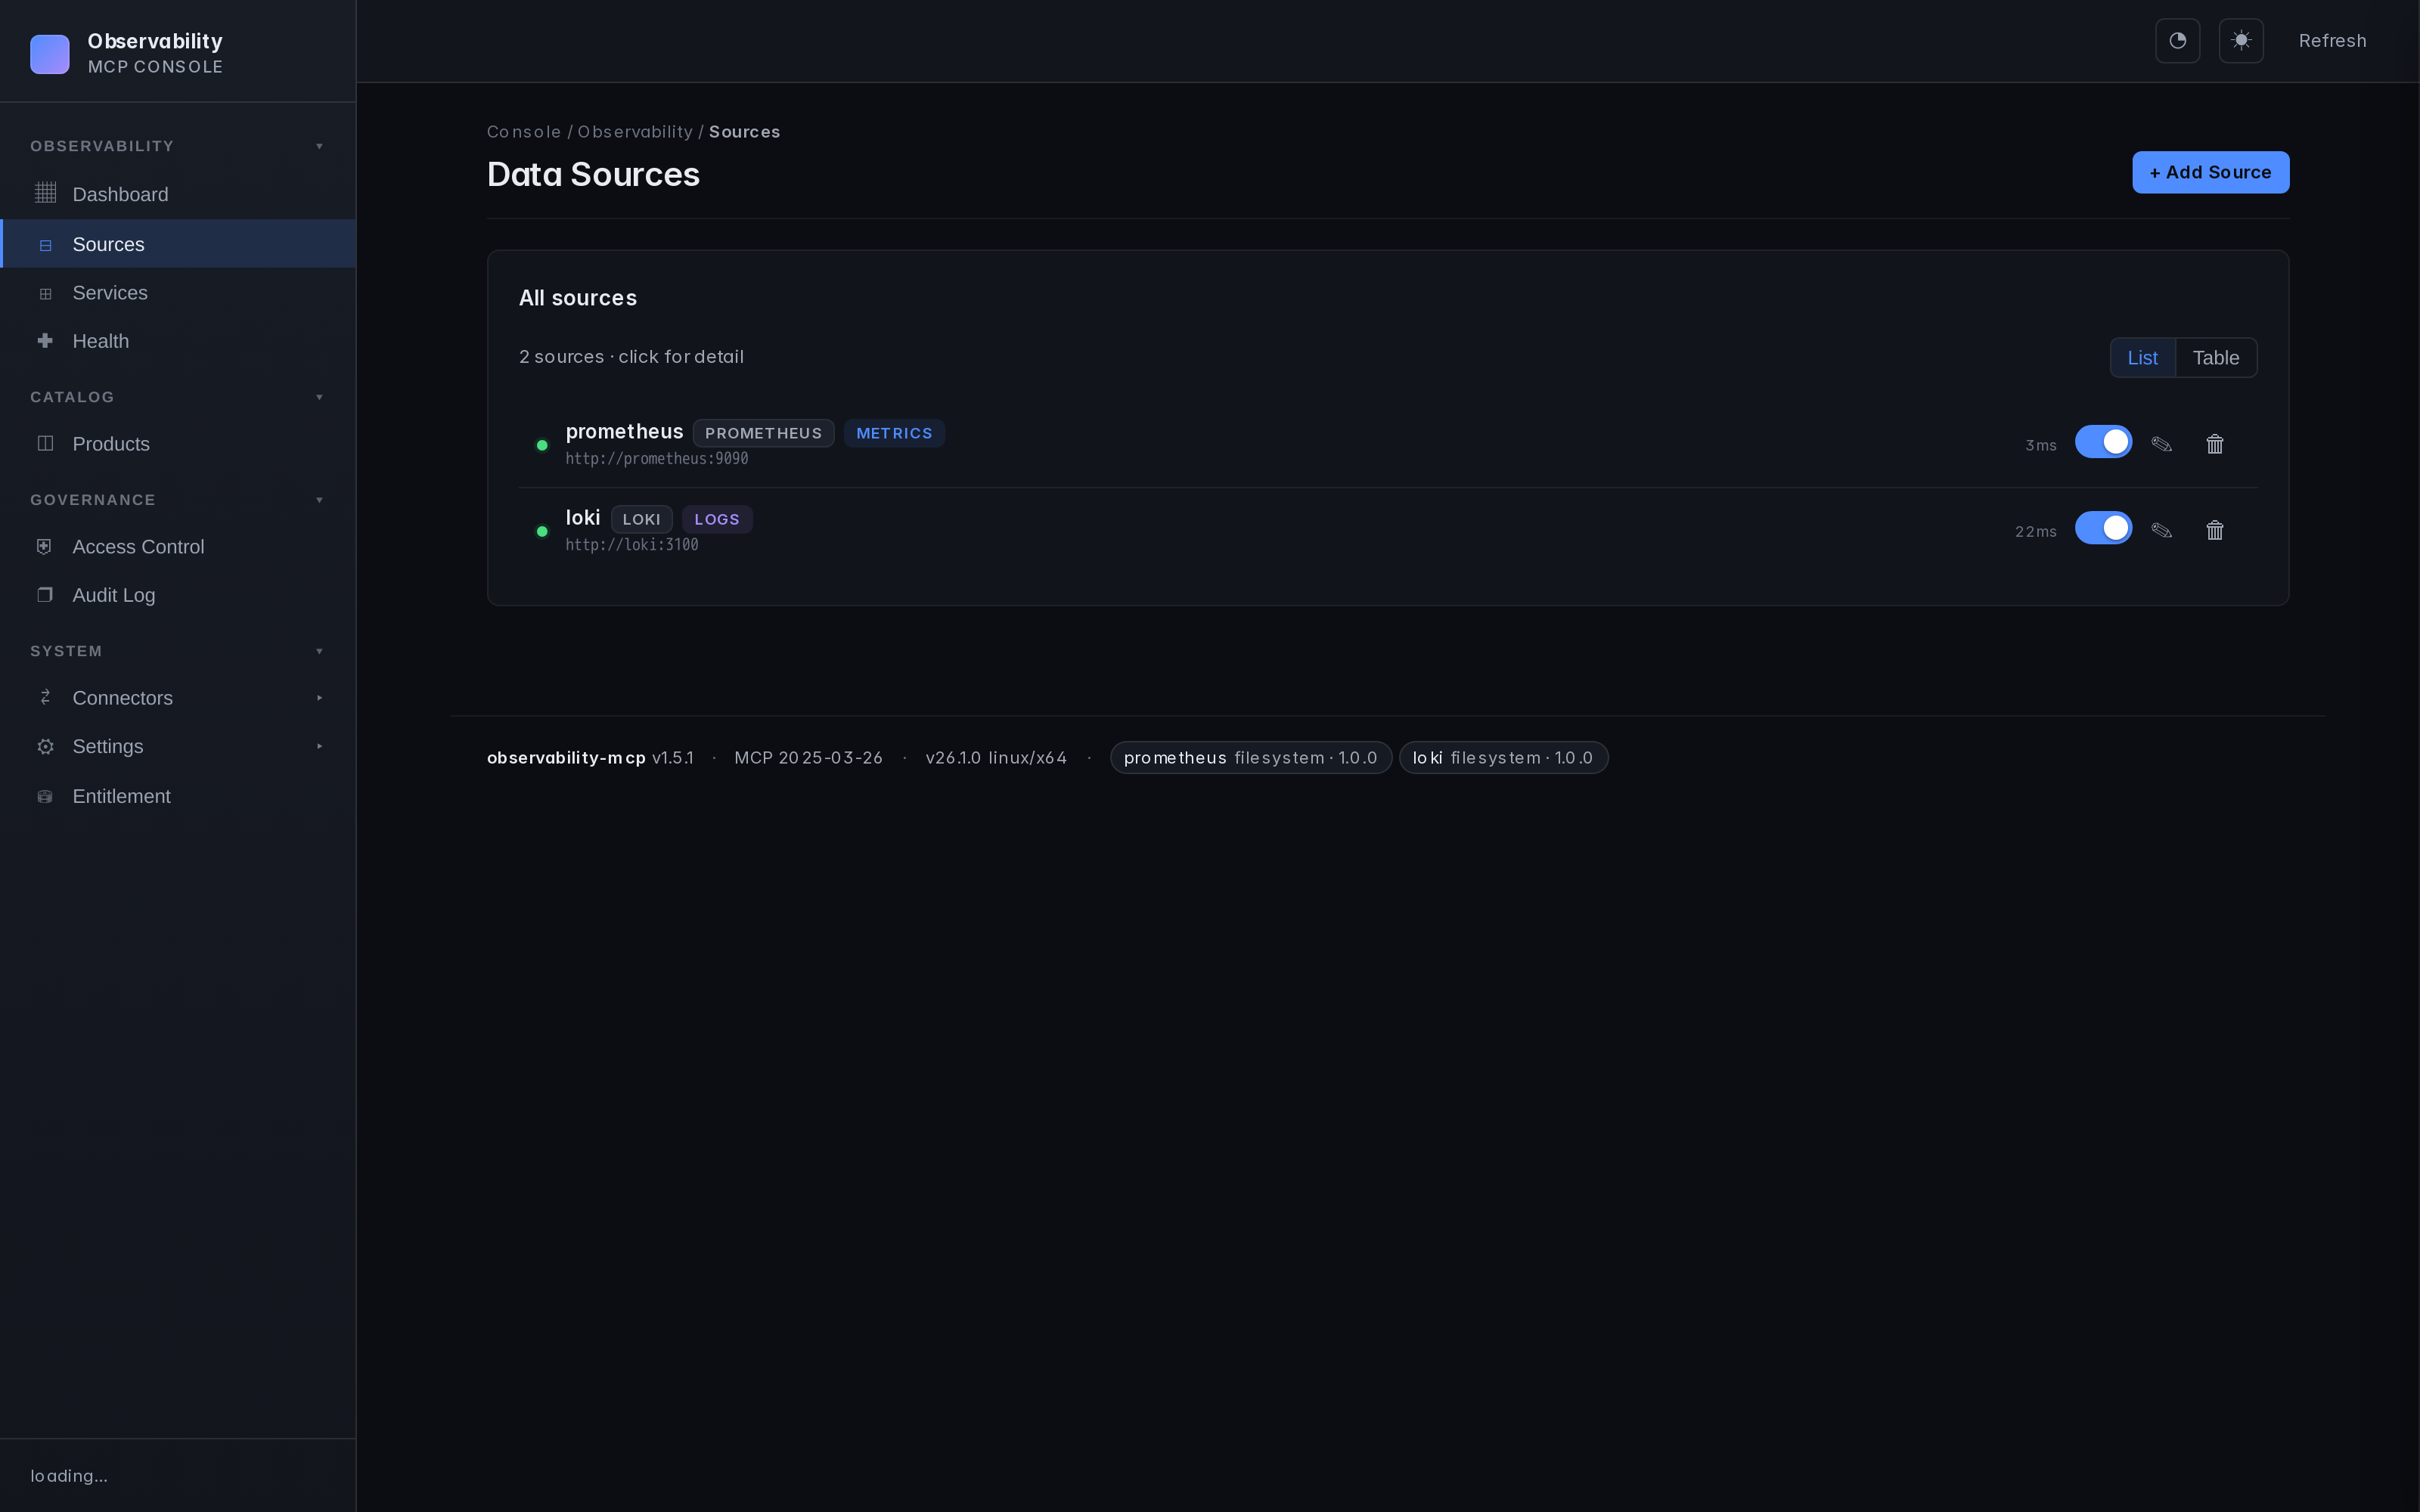
- Interfaz web — Fuentes, servicios, monitoreo de salud, configuración. En tiempo real, tema oscuro.
- Valores predeterminados de prom-client — Funciona de serie con la instrumentación estándar de Prometheus para Node.js. La resolución dinámica de etiquetas sondea
job/service/app/service_namepara que el filtrado de servicios funcione sin más. - Respaldo de etiquetas Loki — Descubre servicios mediante
service_name/service/job/app/container, incluidos flujos enviados por Docker con barras iniciales. - Conectores conectables — Una interfaz, cualquier lenguaje de consulta (PromQL, LogQL, Flux, KQL...). Consulta docs/connectors.md.
- Autenticación y TLS — Básica, Bearer, CA personalizado, mTLS. Consulta docs/auth-and-tls.md.
- Multi-backend — Múltiples instancias del mismo tipo, sin problema.
Inspeccionar — ver, aprender y hacer cumplir el comportamiento del agente
Le entregaste a un agente (o a un bot de CI, o a una credencial filtrada) una llave a tus backends de observabilidad. Inspeccionar responde la pregunta que RBAC no puede: ¿es esta llamada normal para esta identidad, en comparación con lo que realmente ha estado haciendo?
Toma prestado el flujo de aprendizaje de AppArmor y una vista de tráfico estilo service-mesh (piensa en Kiali, para llamadas a herramientas de agentes):
   OFF  ──▶  OBSERVE  ──▶  DRY-RUN (complain)  ──▶  ENFORCE
              │              │                        │
        record calls    compute what WOULD be     block calls that
        only (zero      blocked, but still allow   fall outside the
        risk, default)  — review before enforcing   accepted profile
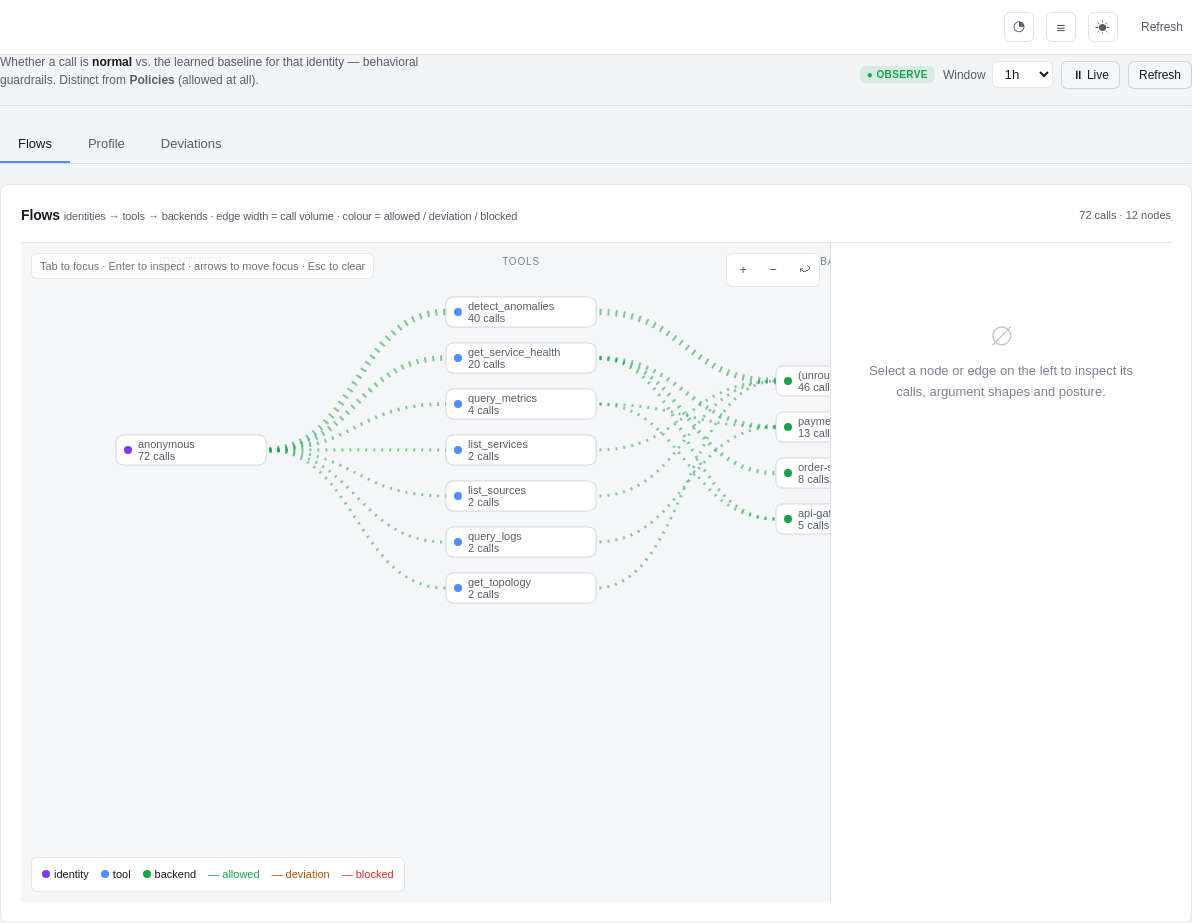
- Flujos — un grafo en vivo Identidades → Herramientas → Backends. El grosor de las aristas es volumen de llamadas; el color es permitido / desviación / bloqueado. Haz clic en cualquier nodo para profundizar en las llamadas reales, la distribución de formas de argumentos y convertir una arista observada directamente en una regla.
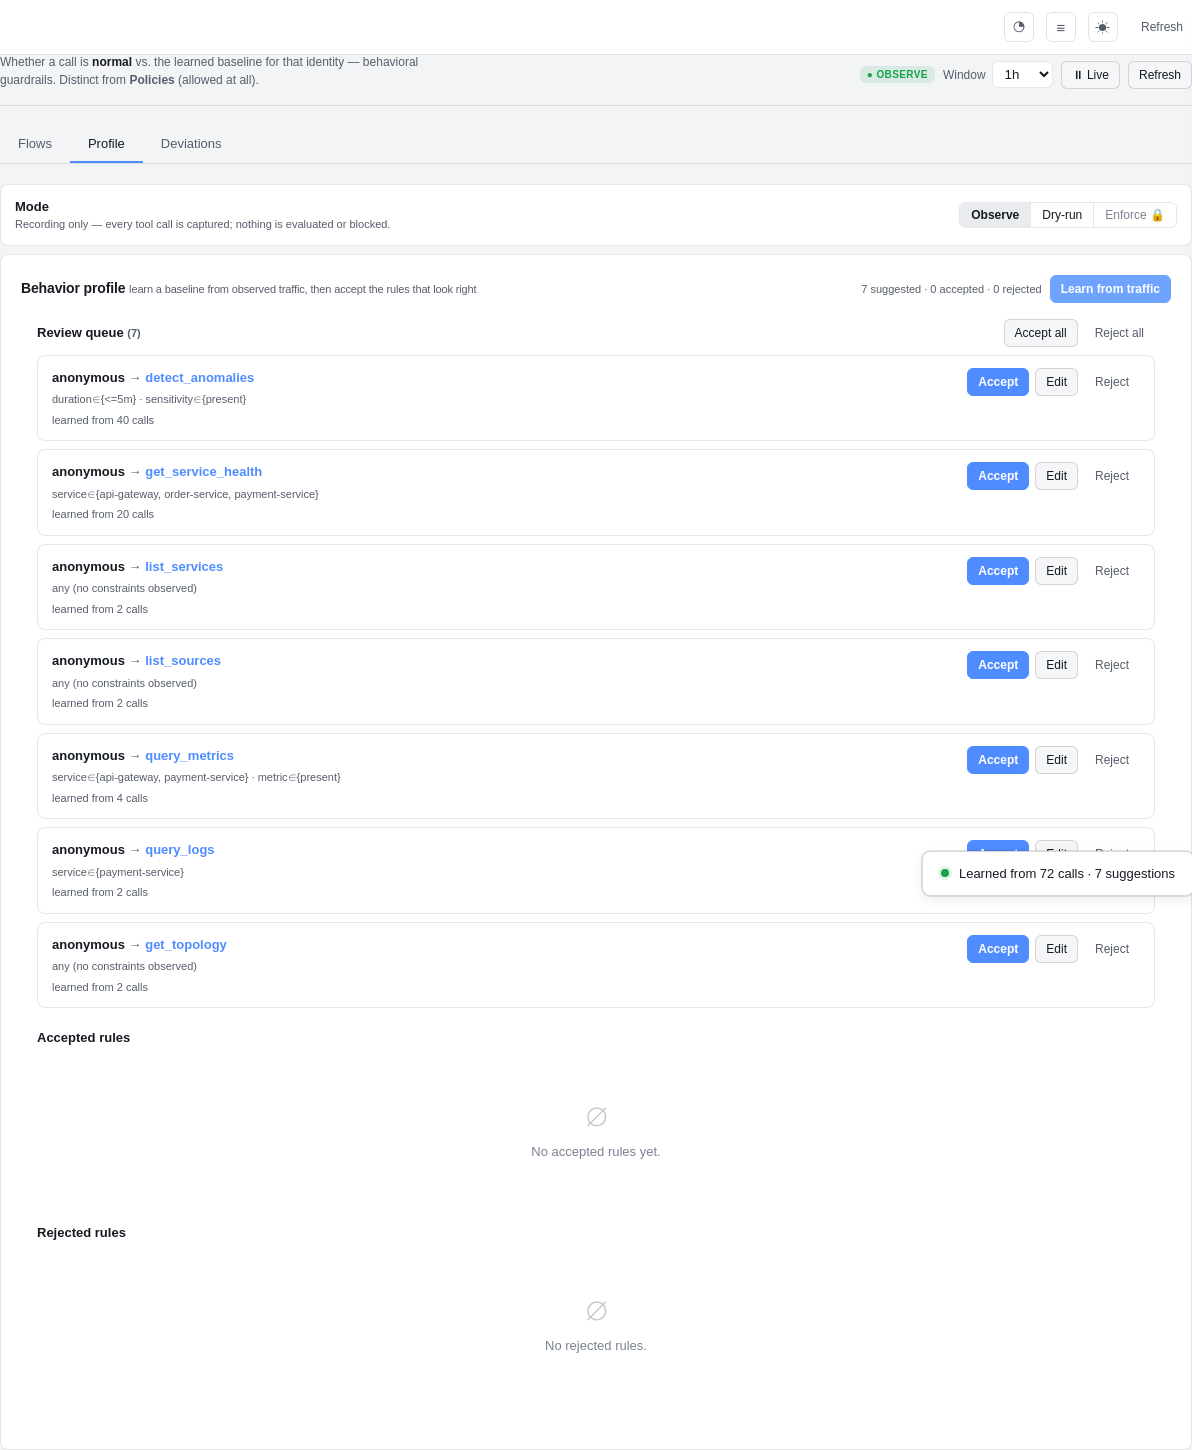
- Perfil — el bucle de aprendizaje: pulsa "Aprender del tráfico", revisa las
reglas sugeridas (
anonymous → query_logs · service ∈ {payment-service}— aprendidas de N llamadas) y acepta / edita / rechaza cada una. Solo las reglas aceptadas controlan el tráfico. - Desviaciones — cada llamada que quedó fuera del perfil: quién, qué herramienta, qué fue inusual — un clic para aceptarla en el perfil o confirmar una anomalía.
Privacidad por diseño: Inspeccionar almacena formas de argumentos, nunca cargas útiles crudas, y ejecuta todo a través de la capa de redacción de la puerta de enlace primero. No realiza llamadas salientes — la garantía de aislamiento no cambia.
OSS vs. con licencia: observe y dry-run — el grafo en vivo, aprender un
perfil, ver desviaciones que se bloquearían — son gratuitos. El bloqueo activo enforce
es un control con licencia (mostrado con 🔒 en la interfaz). La visibilidad es gratuita;
el cumplimiento es la capacidad con licencia. Diseño completo:
docs/inspect.md.
Calidad de detección
El motor de anomalías se evalúa retrospectivamente contra una suite sintética etiquetada que cubre
rampas lentas (fuga de memoria hacia OOM), picos, cambios de paso, ruido estable,
parpadeos transitorios, recuperaciones unilaterales, patrones diarios estacionales y un
nivel "difícil" de baja SNR deliberadamente ambiguo. Puntuado como una puerta de CI
(backtest.test.ts) — estos
números se regeneran a partir de esa suite, no están escritos a mano:
| Casos | Precisión | Recuperación | F1 |
|---|---|---|---|
| 64 | 100.0% | 87.5% | 93.3% |
La precisión es del 100% (sin alertas espurias); los fallos de recuperación son por diseño en el piso de ruido del nivel difícil. La suite es determinista y una regresión del detector hace fallar la CI. Reproduce localmente:
docker run --rm -w /app -v "$(pwd)/mcp-server:/app" node:20-alpine \
  sh -c "npm i --silent && npx tsx --test src/analysis/backtest.test.ts"
Capturas de pantalla
| Inspeccionar — grafo de flujos | Inspeccionar — aprender un perfil |
|---|---|
|  |
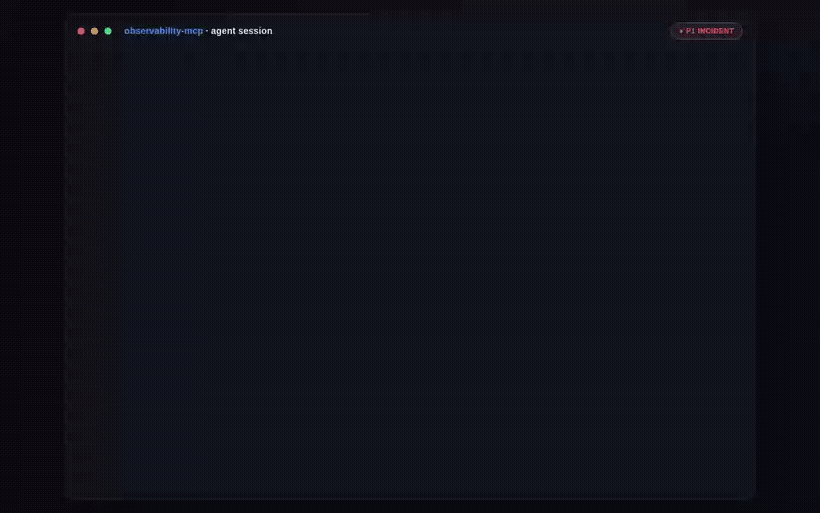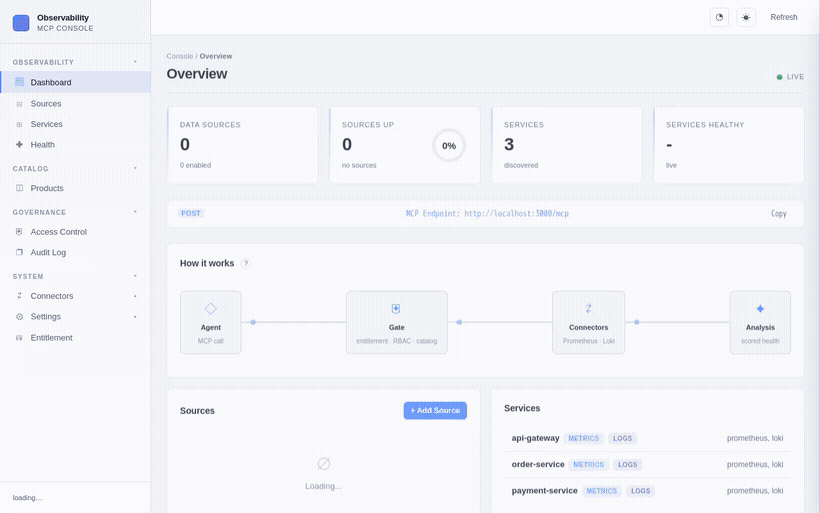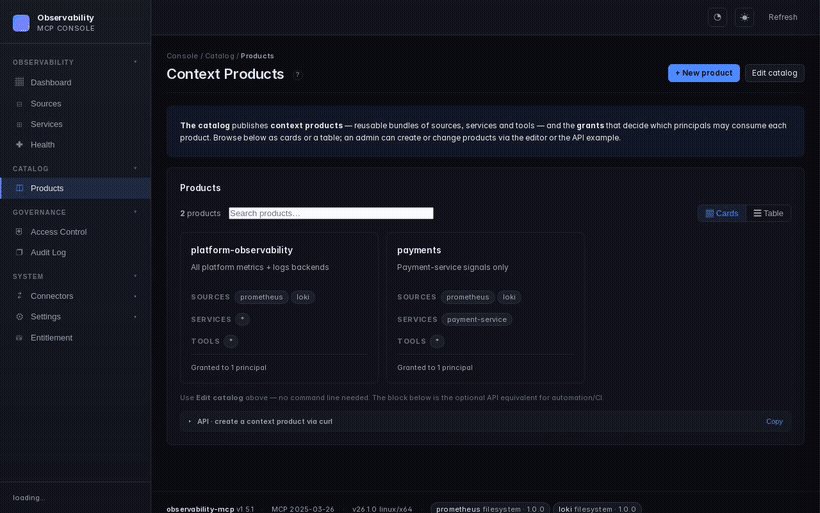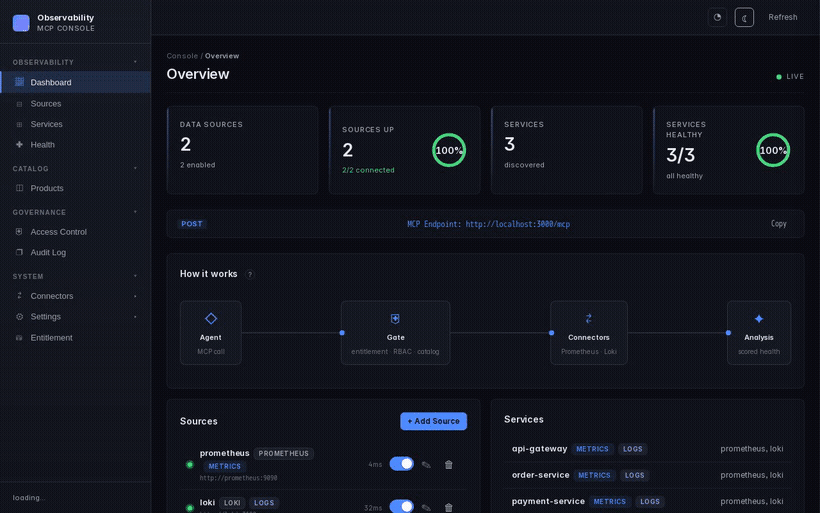
| Panel de control | Salud del servicio | Centro de conectores |
|---|---|---|
 |  |  |
Arquitectura
graph TB
    Agent["AI Agent<br/><small>Claude, Ollama, etc.</small>"]

    subgraph MCP ["observability-mcp :3000"]
        Tools["12 MCP Tools"]
        Analysis["Analysis Engine<br/><small>Robust stats, Health Scoring, Correlation</small>"]
        UI["Web UI"]
    end

    subgraph Connectors ["Pluggable Connectors"]
        Prom["Prometheus<br/><small>PromQL — metrics</small>"]
        Loki["Loki<br/><small>LogQL — logs</small>"]
        K8s["Kubernetes<br/><small>watch — topology</small>"]
        Next["Your Backend<br/><small>Any query language</small>"]
    end

    Agent <-->|"MCP<br/>Streamable HTTP"| Tools
    Tools --- Analysis
    Tools --- UI
    MCP --> Prom & Loki & K8s & Next

    style MCP fill:#1a1a2e,stroke:#58a6ff,color:#fff
    style Connectors fill:#0d1117,stroke:#3fb950,color:#fff
    style Agent fill:#58a6ff,stroke:#58a6ff,color:#000
    style Next fill:#0d1117,stroke:#3fb950,color:#8b949e,stroke-dasharray: 5 5
Estructura del repositorio
mcp-server/   # the product — server, Web UI, analysis engine, built-in plugins
helm/         # ArtifactHub-grade Helm chart
docs/         # configuration, auth, plugin architecture, airgapped deployment, ...
examples/     # demo material — agent, example services, Prometheus+Loki configs
mcp-server/ es lo que instalas. Todo bajo examples/ es opcional mediante docker compose --profile demo — es como el repositorio demuestra la detección de caos de extremo a extremo, pero los despliegues de producción no necesitan nada de eso.
Instalación
| Método | Comando | Mejor para |
|---|---|---|
| npm | npx @thotischner/observability-mcp | Desarrollo local, cadenas de herramientas Node, instalación cero |
| Docker (GHCR) | docker run -p 3000:3000 ghcr.io/thotischner/observability-mcp:latest | Hosts de producción, aislamiento |
| Helm | helm repo add observability-mcp https://thotischner.github.io/observability-mcp/helm install observability-mcp observability-mcp/observability-mcp | Kubernetes |
| Desde el código fuente | git clone … && make demo | POC completo con servicios de ejemplo y caos |
CLI (omcp) | npm i -g @thotischner/observability-mcp | Gestión de conectores, la pila de demo y Helm desde la terminal — consulta CLI |
GHCR es multi-arquitectura (amd64 + arm64). Etiquetas disponibles: latest, main, X.Y.Z, X.Y, X, sha-<commit>. Nota: la v inicial se elimina de las etiquetas semver.
Gráfico de Helm
El chart incluye Deployment, Service, Ingress/PVC/HPA opcionales, NetworkPolicy, ServiceMonitor (activado automáticamente según el CRD de Prometheus Operator), helm test sonda de conexión y values.schema.json validación. Anotaciones de nivel ArtifactHub. Consulta helm/observability-mcp/ para la referencia completa de valores, o la guía de despliegue airgapped para un ejemplo de producción endurecido.
helm repo add observability-mcp https://thotischner.github.io/observability-mcp/
helm repo update
helm install observability-mcp observability-mcp/observability-mcp \
  --set sources.prometheusUrl=http://prometheus.monitoring.svc.cluster.local:9090 \
  --set sources.lokiUrl=http://loki.logging.svc.cluster.local:3100
# docker-compose snippet
services:
  observability-mcp:
    image: ghcr.io/thotischner/observability-mcp:latest
    ports: ["3000:3000"]
    environment:
      PROMETHEUS_URL: http://prometheus:9090
      LOKI_URL: http://loki:3100
    volumes:
      - ./mcp-config:/home/node/.observability-mcp
    restart: unless-stopped
Para la configuración completa — rutas, variables de entorno, sustitución de ${VAR}, referencia completa de sources.yaml — consulta docs/configuration.md.
Inicio Rápido
Opción A: Standalone (tus propios backends)
npx @thotischner/observability-mcp
Luego abre la interfaz web en http://localhost:3000, haz clic en Sources → + Add Source, y apunta a tus URLs de Prometheus/Loki. O salta la interfaz:
PROMETHEUS_URL=http://localhost:9090 LOKI_URL=http://localhost:3100 \
  npx @thotischner/observability-mcp
Opción B: Grafana Cloud
Grafana Cloud usa autenticación básica con tu ID de instancia numérico como nombre de usuario y un token de API como contraseña. El ID de instancia para Prometheus y Loki es diferente — encuentra ambos en Connections → Data sources.
# ~/.observability-mcp/sources.yaml
sources:
  - name: grafana-cloud-prom
    type: prometheus
    url: https://prometheus-prod-XX-prod-eu-west-X.grafana.net/api/prom
    enabled: true
    auth:
      type: basic
      username: "${GRAFANA_PROM_USER}"   # numeric instance ID
      password: "${GRAFANA_TOKEN}"
  - name: grafana-cloud-loki
    type: loki
    url: https://logs-prod-XXX.grafana.net
    enabled: true
    auth:
      type: basic
      username: "${GRAFANA_LOKI_USER}"   # different from Prom!
      password: "${GRAFANA_TOKEN}"
GRAFANA_PROM_USER=… GRAFANA_LOKI_USER=… GRAFANA_TOKEN=glc_… \
  npx @thotischner/observability-mcp
Opción C: Demo completa (Docker Compose con servicios de ejemplo)
git clone https://github.com/ThoTischner/observability-mcp.git
cd observability-mcp
docker compose --profile demo up --build
Inicia un clúster k3s de un solo nodo, compila los tres servicios de ejemplo y los ejecuta como Deployments de Kubernetes dentro de k3s, además de Prometheus, Loki, Promtail, el servidor MCP y el agente en el lado de docker-compose. Abre http://localhost:3000.
Los mismos Deployments que Prometheus monitorea y de los que Loki recibe logs son los que muestra el grafo de topología — así el agente puede correlacionar una anomalía de métricas/logs con su host subyacente usando get_blast_radius. Los endpoints de caos permanecen en localhost:8080/8081/8082 (mapeados a los NodePorts de k3s) para que los scripts existentes y los vídeos de demo sigan funcionando sin cambios.
Sin --profile demo, solo se inicia mcp-server — útil cuando ya ejecutas Prometheus/Loki en otro lugar y solo quieres exponerlos vía MCP.
Opción D: Modo benchmark (OpenTelemetry Demo / Astronomy Shop)
Para producir números de RCA creíbles contra una carga de trabajo real de microservicios (~23 servicios, instrumentación OTel nativa):
make benchmark-up         # clones upstream Astronomy Shop, brings up both stacks
make benchmark-run        # runs the harness baseline vs topology, writes JSON
make benchmark-down       # tears down
make benchmark-up añade Tempo + un puente de collector OTel bajo nuestro --profile benchmark y orquesta el stack upstream en un proyecto compose separado, uniendo su red a la nuestra para que los servicios de Astronomy Shop envíen trazas a nuestro Tempo. Consulta docs/benchmark-astronomy-shop.md y examples/benchmark/README.md. La primera descarga es de ~4 GB.
Herramientas MCP
| Herramienta | Señal | Propósito |
|---|---|---|
list_sources | meta | Descubre los backends configurados y el estado de conexión |
list_services | meta | Descubre los servicios monitorizados en todos los backends |
query_metrics | metrics | Consulta métricas con estadísticas resumidas precalculadas |
query_logs | logs | Consulta logs con conteos de errores/advertencias y patrones principales |
get_service_health | unified | Puntuación de salud que combina métricas + logs (0–100) |
detect_anomalies | unified | Detección de anomalías entre señales con análisis robusto (mediana/MAD + tendencia) |
get_topology | topology | Devuelve el grafo de infraestructura fusionado (recursos + aristas) de cada conector compatible con topología, filtrable por fuente/tipo/ámbito |
get_blast_radius | topology | Pivota sobre la relación universal RUNS_ON — «si falla el host de este recurso, ¿quién más falla?». Funciona para pod→node, vm→hypervisor, container→host |
Las dos herramientas de topología requieren un conector compatible con topología. El conector de Kubernetes incluido es el primero; los futuros conectores (vCenter, NetBox, …) se conectan mediante la misma interfaz isTopologyProvider y emiten valores kind/relation del vocabulario de topología canónico.
Uso con Claude Code
Conecta Claude Code directamente — no se necesita agente.
CLI:
claude mcp add observability --transport http http://localhost:3000/mcp
O .mcp.json en la raíz de tu proyecto (compatible con commits):
{
  "mcpServers": {
    "observability": {
      "transport": { "type": "http", "url": "http://localhost:3000/mcp" }
    }
  }
}
Luego pregunta a Claude en lenguaje natural. Por ejemplo, después de activar el caos en la demo (curl -X POST http://localhost:8081/chaos/error-spike):
«¿Hay alguna anomalía ahora mismo?»
Claude llama a detect_anomalies y encuentra:
{
  "anomalies": [
    { "metric": "cpu", "severity": "high", "service": "payment-service",
      "description": "cpu is 3.4σ above baseline (18.36 → 37.31)" },
    { "metric": "request_rate", "severity": "low", "service": "payment-service",
      "description": "request_rate is -1.8σ below baseline (0.08 → 0.04)" }
  ]
}
«Muéstrame los logs de error de payment-service.»
Claude llama a query_logs:
{
  "summary": {
    "total": 11, "errorCount": 11,
    "topPatterns": [
      "Request failed: internal error during POST /payments (6x)",
      "Request failed: internal error during POST /refunds (4x)"
    ]
  }
}
Claude correlaciona las señales — pico de CPU, logs de error inundando, tasa de peticiones reducida a la mitad — y explica el incidente en lenguaje sencillo. Sin PromQL, sin LogQL.
Demo: Ingeniería del Caos
Tres microservicios de ejemplo generan tráfico y soportan inyección de caos:
curl -X POST http://localhost:8081/chaos/high-cpu        # CPU spike
curl -X POST http://localhost:8081/chaos/error-spike     # CPU + latency + errors
curl -X POST http://localhost:8081/chaos/slow-responses  # Latency
curl -X POST http://localhost:8081/chaos/memory-leak     # OOM logs
curl -X POST http://localhost:8081/chaos/reset
El agente (docs/agent.md) detecta anomalías en menos de 30 segundos y produce un análisis de incidentes con LLM si Ollama está en ejecución.
CLI (omcp)
Una CLI de control se incluye en el mismo paquete npm (bin omcp) — gestiona conectores, el stack de demo e instalaciones de Helm.
Instálala (o ejecútala ad-hoc sin instalar):
npm i -g @thotischner/observability-mcp   # puts `omcp` on your PATH
omcp --help

# or, no install:
npx -p @thotischner/observability-mcp omcp doctor
Luego:
omcp doctor                       # check docker / compose / helm / node
omcp demo up                      # full demo stack (auto-picks free host ports)
omcp plugin list                  # browse the connector hub catalog
omcp plugin install tempo@1.2.0 --trust-root key.pem    # download + verify + extract
omcp plugin verify ./plugins/tempo --trust-root key.pem # offline audit
omcp helm upgrade obs -- -n monitoring --set sources.prometheusUrl=http://prom:9090
La instalación/verificación de plugins reutiliza las comprobaciones de firma + integridad fail-closed del servidor (compatible con modo offline; --offline-dir para airgapped). Los flags adicionales de helm se pasan después de un -- literal.
Documentación
- Configuración — rutas, variables de entorno, sustitución de
${VAR}, referencia completa desources.yaml - Autenticación y TLS — Basic, Bearer, CA personalizada, mTLS
- Autenticación del plano de gestión (modo básico) — pantalla de inicio de sesión opcional + cookies de sesión firmadas para la interfaz web / plano
/api/* - Redacción de logs — patrones de PII / secretos enmascarados automáticamente en la salida de
query_logsantes de que llegue al agente; exclusión voluntaria víaOMCP_REDACTION=off - Visión general del control de acceso + runbook — roles RBAC, cadena de auditoría, límites de tasa por identidad, enriquecimiento del catálogo de servicios y un runbook de investigación para las preguntas más comunes de «quién / por qué»
- Prometheus — valores predeterminados, resolución de etiquetas,
resolvedSeries, compatibilidad con prom-client - Loki — respaldo de etiquetas, barra de contenedor Docker, Loki gestionado
- Conectores — escribe tu propio backend
- Agente — configuración de Ollama, comportamiento del bucle
- Solución de problemas — errores comunes y soluciones
- Seguridad — pipeline de automatización, reporte de vulnerabilidades, protecciones integradas
- Despliegue airgapped — duplicación de imágenes, plugins privados, configuración compatible con GitOps
- Vocabulario de topología — el contrato canónico
kind/relationque emite cada conector compatible con topología, además del validador de solo advertencia - Benchmark RCA — banco de pruebas A/B reproducible; en una pregunta de radio de explosión entre namespaces (llama3.1:8b, n=10) el conjunto de herramientas base puntúa 0/10 y alucina el tipo de entidad incorrecto, el mismo modelo con herramientas de topología puntúa 10/10 de forma determinista — consulta la tabla de tres escenarios para el panorama completo y honesto
- Cómo se compara con herramientas similares — tabla con fuentes citadas vs. Datadog Bits AI, HolmesGPT, Robusta — en qué destaca cada una y dónde encaja esta
- Puerta de control de acceso de gobernanza — RBAC / catálogo / auditoría opcionales detrás de un token de derecho firmado (desactivado por defecto)
- Connector Hub — explora conectores versionados y firmados (catálogo:
hub/) - Casos de uso — cinco escenarios con los prompts que los impulsan
Endpoints
| Servicio | URL |
|---|---|
| Servidor MCP (Streamable HTTP) | http://localhost:3000/mcp |
| Interfaz web | http://localhost:3000 |
| API de salud | http://localhost:3000/api/health |
En la demo de docker-compose: Prometheus en :9090, Loki en :3100. Los tres servicios de ejemplo se ejecutan como Deployments de Kubernetes dentro del k3s del compose y son accesibles en el host mediante el mapeo NodePort :8080–:8082 — las mismas URLs que antes de la migración a k8s, así que los comandos de caos existentes siguen funcionando.
Transportes: Streamable HTTP por defecto (/mcp). Para clientes/catálogos basados en stdio (Claude Desktop, mcp-proxy de Glama, etc.) ejecuta con --stdio (o MCP_TRANSPORT=stdio) — un servidor MCP sobre stdin/stdout, todos los logs en stderr para que el flujo del protocolo se mantenga limpio.
Stack Tecnológico
TypeScript + Node 20, @modelcontextprotocol/sdk (Streamable HTTP), Express, Zod, js-yaml, prom-client (servicios de ejemplo), Prometheus, Loki, Promtail, Docker Compose, Ollama opcional.
Requisitos
- Standalone: Node 20+ (o solo
npx) - Demo Docker: Docker + Compose, 4 GB+ de RAM (8 GB+ con Ollama)
- Opcional: Ollama en el host para el análisis LLM del agente
Contribuciones
- Haz fork del repositorio y
docker-compose up --build. - Elige un issue o abre uno para discutir tu idea.
- Envía un PR — todo el código se ejecuta en Docker, sin dependencias locales.
Ideas: nuevos conectores (InfluxDB, Elasticsearch, Datadog), algoritmos de análisis adicionales, mejoras de la interfaz.
Licencia
Apache License 2.0 — consulta también NOTICE.
Las versiones hasta la última con licencia MIT inclusive permanecen disponibles bajo MIT; las versiones posteriores son Apache-2.0. Las contribuciones requieren un Acuerdo de Licencia de Contribuyente.
Si te resulta útil, considera darle una estrella — ayuda a que otros descubran el proyecto.