PDF MCP
Combina, divide, rellena y lee PDFs desde el chat: formularios, extracción de páginas, metadatos. Todo permanece en tu máquina.
Documentación
Combinar, dividir y rellenar formularios PDF desde Claude
Servidor MCP para herramientas PDF que combinan, dividen, sellan y leen archivos PDF; combina y divide páginas en tu propia máquina. Combina, divide, sella y lee PDFs, JavaScript puro.
Funciona con Claude Desktop, Claude Code, Cursor y cualquier cliente del Protocolo de Contexto de Modelo. Se ejecuta en tu propia máquina, o alojado sin instalación.
Página del producto: https://mcp.zovo.one/s/pdf — qué hace, las herramientas que expone y un endpoint de token en vivo.
Instalación
Alojado, nada que instalar. Obtén un token de https://mcp.zovo.one/mcp/connect (la página de conexión) o https://mcp.zovo.one/mcp/token (el mismo token como JSON); se emite uno anónimo gratuito al instante y una clave Pro funciona igual. Luego apunta un cliente MCP a https://mcp.zovo.one/mcp/pdf a través de streamable-http y envía el token como Authorization: Bearer <token>.
Si tu cliente no puede configurar encabezados, coloca el token en la ruta en su lugar: https://mcp.zovo.one/mcp/pdf/t/<token>. Ambas formas funcionan. La URL desnuda sin token responde 401 en tools/call, por lo que el token no es opcional.
Claude Desktop, un clic. Descarga pdf.mcpb desde la última versión y haz doble clic en él.
Desde el código fuente. El espejo es autónomo: cada dependencia de @theluckystrike/* está incluida, por lo que un clon nuevo se compila sin configuración adicional.
git clone https://github.com/theluckystrike/mcp-pdf.git
cd mcp-pdf
npm install && npm run build
Luego apunta tu cliente al punto de entrada compilado:
{
  "mcpServers": {
    "pdf": {
      "command": "node",
      "args": ["/absolute/path/to/mcp-pdf/dist/index.js"]
    }
  }
}
@theluckystrike/mcp-pdfaún no está publicado en npm, por lo que un comandonpx -y @theluckystrike/mcp-pdffallará. Las tres rutas anteriores son las que funcionan y cada una es verificada por CI.
Espejo de solo lectura de mcp-servers/servers/pdf. Consulta MIRROR.md.
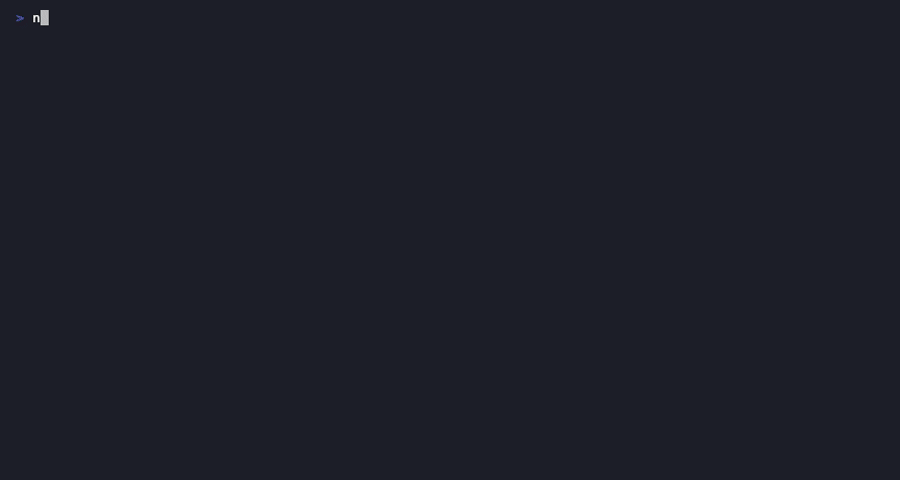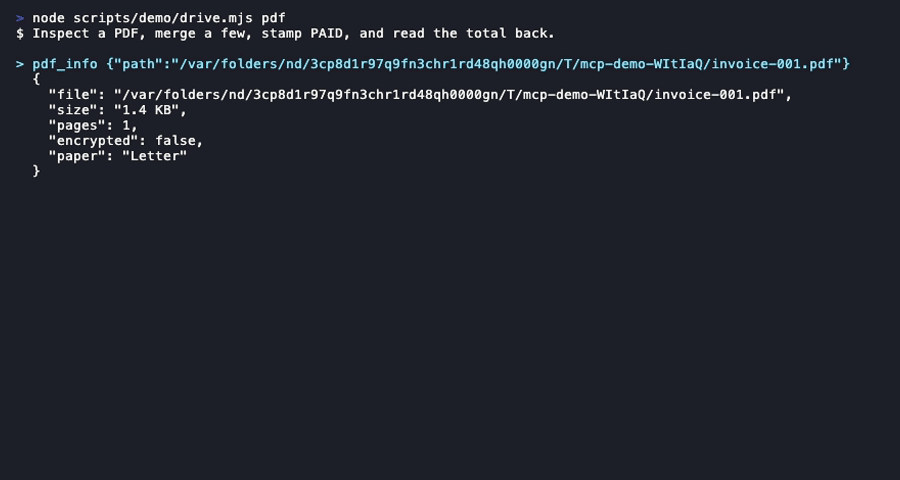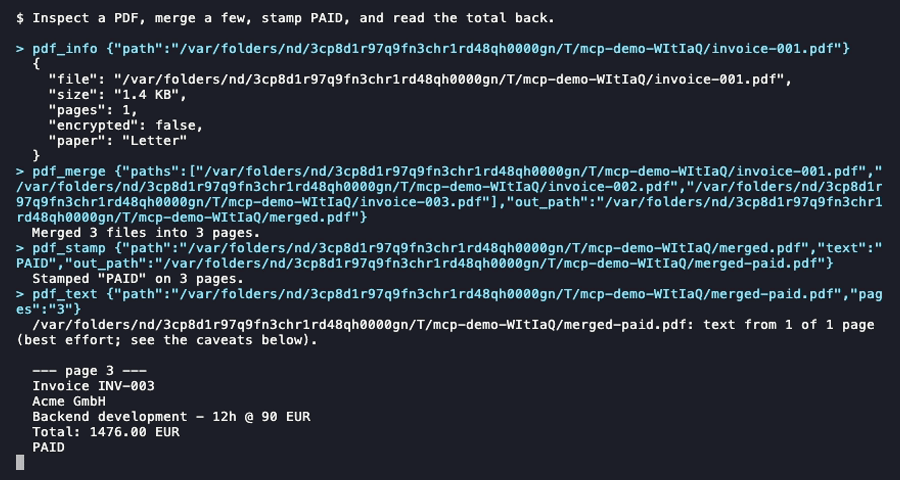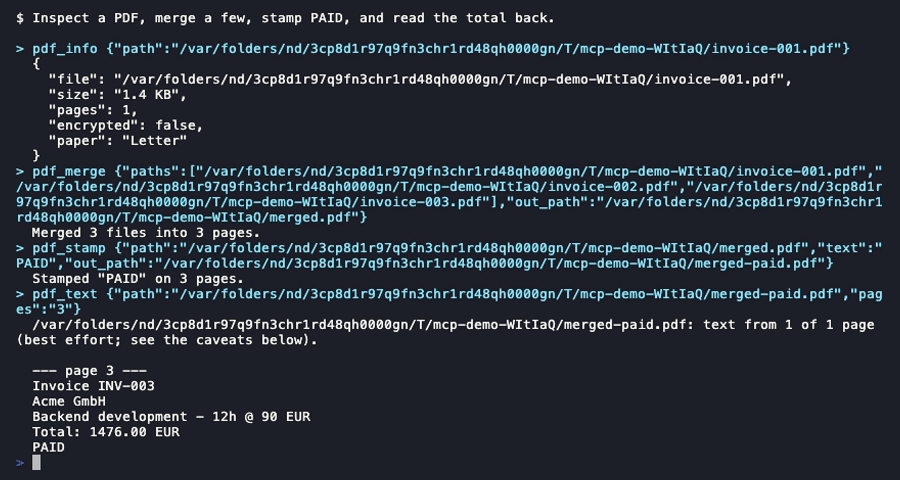
Di "sella PAGADO en esa factura y guarda una copia" o "saca las páginas 2 a 6 de este escaneo y combínalas con el contrato" y sucede, en tu máquina, en un segundo. Este servidor MCP hace los trabajos PDF pequeños que de otro modo te envían a un cargador web: combinar, dividir por rango de páginas, extraer o reordenar páginas, rotar un escaneo lateral, sellar PAID o DRAFT o cualquier texto que quieras, poner tu nombre comercial e ID de IVA en el pie de página, contar páginas en una carpeta de archivos y leer el texto de un PDF como texto. Sin carga, sin cuenta, sin dependencia nativa, sin instalación de office.
En el Registro oficial de MCP (io.github.theluckystrike/pdf-merge-split-stamp-extract-pages).
Listado en el Índice de Productos de IA — endpoint remoto en vivo en mcp.zovo.one/s/pdf, nivel gratuito, sin registro.
Las tareas PDF de un negocio independiente, hechas desde el chat en lugar de desde una pestaña del navegador en la que no confías con una factura.
Instalación en 60 segundos
La publicación en npm para @theluckystrike/mcp-pdf está pendiente. Hasta entonces, el paquete de un clic .mcpb o un clon+compilación
es la ruta que funciona, ambas verificadas abajo.
Un clic (.mcpb): descarga pdf.mcpb desde la última versión y haz doble clic en él en Claude Desktop:
https://github.com/theluckystrike/mcp-servers/releases/latest
(claude_desktop_config.json):
{
  "mcpServers": {
    "pdf": {
      "command": "npx",
      "args": ["-y", "@theluckystrike/mcp-pdf"]
    }
  }
}
Claude Code:
claude mcp add pdf -- npx -y @theluckystrike/mcp-pdf
(.cursor/mcp.json):
{
  "mcpServers": {
    "pdf": {
      "command": "npx",
      "args": ["-y", "@theluckystrike/mcp-pdf"]
    }
  }
}
La forma npx anterior comienza a funcionar en el momento en que se publica el paquete. Hasta entonces, usa el paquete .mcpb anterior, o
compila desde el código fuente con exactamente estos tres comandos:
git clone https://github.com/theluckystrike/mcp-servers.git && cd mcp-servers
npm install
npm run build -w packages/mcp-license -w servers/pdf
Luego apunta el command de tu cliente a node con un argumento: la ruta absoluta a servers/pdf/dist/index.js.
Para ejecutar en modo Pro, configura MCP_LICENSE_KEY en el mismo bloque de configuración, o llama a license_activate una vez con tu clave.
Herramientas
| Herramienta | Qué hace |
|---|---|
pdf_info | Recuento de páginas, tamaño de cada página en puntos y milímetros, nombre del papel (A4, Carta, personalizado), la rotación ya presente en cada página, los metadatos (título, autor, productor, fechas) y si el archivo está cifrado |
pdf_count | Recuento de páginas por archivo más el total, para cualquier número de PDFs. Un archivo que no puede leer se informa por archivo; el resto aún se cuenta |
pdf_merge | Unir PDFs en uno, en el orden dado. Los tamaños de página se mantienen como están, y un archivo combinado con tamaños mixtos lo indica |
pdf_split | Un archivo nuevo por rango. "1-3,5,7-" da las páginas 1-3, la página 5 y la página 7 hasta el final. out_path_pattern toma {n}, {range} y {name} |
pdf_pages | Extraer páginas seleccionadas en un nuevo PDF, en el orden en que las escribes. "5,1,1" pone la página 5 primero y la página 1 dos veces |
pdf_rotate | Girar páginas por un múltiplo de 90 grados, sumado a la rotación que la página ya tenía, que es lo que necesita un escaneo lateral |
pdf_stamp | Dibujar texto en las páginas: ajustes preestablecidos PAID y DRAFT, o cualquier texto, color, posición, opacidad y tamaño. Los sellos centrados van en la diagonal de 45 grados |
pdf_watermark_business | Tu nombre comercial e ID de IVA en el pie de página de cada página, desde el perfil compartido mcp-invoice y mcp-docx escriben |
pdf_text | Extracción de texto de mejor esfuerzo desde los flujos de contenido de la página. Consulta las advertencias honestas abajo |
pdf_reorder | Escribir un nuevo PDF con las páginas en un nuevo orden. El orden debe nombrar cada página exactamente una vez, para que nada se omita por accidente |
license_status | Mostrar modo gratuito o Pro |
license_activate | Activar una clave Pro (verificada sin conexión) |
Recurso: pdf://recent devuelve las últimas 25 operaciones, de más reciente a más antigua, con las entradas, los archivos escritos y cuándo.
Prompt: mark_invoice_paid encadena el invoice_get de mcp-invoice en pdf_stamp PAID y guarda la copia sellada junto al original.
Lo que puedes decir
| Tú dices | Herramienta |
|---|---|
| "Marca la factura INV-2026-0007 como pagada." | prompt mark_invoice_paid, luego pdf_stamp |
| "Sella BORRADOR en este contrato antes de enviarlo." | pdf_stamp |
| "Une estos tres PDFs en un solo archivo." | pdf_merge |
| "Divide el escaneo: las páginas 1-3 son la factura, de 4 en adelante es el recibo." | pdf_split |
| "Saca las páginas 2 a 6 de esto y guárdalas por separado." | pdf_pages |
| "Este escaneo está lateral, gíralo." | pdf_rotate |
| "¿Cuántas páginas hay en todos estos?" | pdf_count |
| "¿Qué dice la página 1 de este PDF?" | pdf_text |
| "Pon mi nombre de empresa y número de IVA en el pie de página." | pdf_watermark_business |
| "Mueve la portada al frente." | pdf_reorder |
Ejemplo práctico
You: Stamp PAID on ~/invoices/INV-2026-0007.pdf and save a copy.

  pdf_stamp {
    path: "~/invoices/INV-2026-0007.pdf",
    text: "PAID",
    position: "center",
    out_path: "~/invoices/INV-2026-0007-paid.pdf"
  }
  -> Stamped "PAID" on 1 page
  -> ~/invoices/INV-2026-0007-paid.pdf, 0.9 MB
El sello es texto dibujado, no una imagen aplanada: se puede seleccionar y buscar, se dibuja en la diagonal de 45 grados en el verde preestablecido, y el archivo original queda sin cambios byte por byte.
Gratis vs Pro
| Gratis | Pro | |
|---|---|---|
pdf_info, pdf_count, pdf_text | Ilimitado | Ilimitado |
pdf_merge | Hasta 5 archivos por llamada | Cualquier número de archivos |
pdf_split, pdf_pages, pdf_rotate | Archivos de hasta 30 páginas | Cualquier longitud |
pdf_stamp | Los ajustes preestablecidos PAID y DRAFT en sus colores preestablecidos | Cualquier texto, cualquier color, cualquier tamaño |
pdf_watermark_business | - | Tu nombre comercial e ID de IVA en el pie de página |
pdf_reorder | - | Sí |
Un límite de nivel es una respuesta, no un error, y nada se escribe cuando uno rechaza una llamada.
Pro es un pago único de $19, o $39 por cada servidor en la colección, de por vida.
pdf_text es de mejor esfuerzo, y aquí está exactamente lo que eso significa
Un PDF no almacena texto. Almacena operadores de dibujo, y el texto que ves son bytes entregados a una fuente. Este servidor
descomprime el flujo de contenido FlateDecode de cada página con node:zlib y lee los cuatro operadores de mostrar texto --
Tj, TJ, ' y ", más los operadores de posicionamiento que terminan una línea. Eso es un analizador escrito aquí, en aproximadamente
doscientas líneas, sin pdfjs y sin módulo nativo, y tiene tres límites reales que la herramienta indica en su propia
respuesta cada vez:
- Un escaneo no tiene texto. Una página solo de imágenes no lleva operadores de texto, por lo que no vuelve nada. No hay OCR aquí y no lo habrá; la respuesta dice que la página probablemente es un escaneo en lugar de devolver una cadena vacía sin explicación.
- Una codificación personalizada o CID devuelve índices de glifos, no letras. Las fuentes incrustadas por subconjunto y CJK mapean bytes a números de glifos a través de una tabla que este analizador no lee. Cuando la salida no tiene caracteres legibles, la respuesta dice que la fuente es la razón.
- El orden de lectura es el orden de dibujo. No hay detección de columnas ni reconstrucción de diseño. Los espacios entre palabras se
recuperan de los grandes kerns negativos que un array
TJusa para ellos, por lo que un PDF que posiciona cada palabra por separado puede volver con palabras unidas.
Los PDFs escritos por procesadores de texto, herramientas de facturación y generadores de informes, todo con una fuente estándar o completamente incrustada, se leen limpiamente. Cualquier otra cosa te dice por qué no lo hizo.
Los PDFs cifrados se rechazan, no se adivinan
pdf-lib no puede descifrar, y cargar un archivo cifrado ignorando el cifrado produce páginas de basura que
se escribirían directamente en la salida. Entonces, un archivo cuyo trailer nombra un diccionario /Encrypt es rechazado por cada
herramienta que escribe, con la razón y la solución en el mensaje: ábrelo en un lector con la contraseña, exporta o imprime
a un nuevo PDF, y usa ese archivo. pdf_info aún responde, con encrypted: true, porque informar es todo su trabajo,
y pdf_count lo informa como un archivo ilegible mientras aún cuenta el resto.
Los archivos existentes nunca se sobrescriben, y las entradas nunca se modifican
Cada herramienta escribe un archivo nuevo y deja sus entradas byte por byte intactas, no hay modo en el lugar, a propósito.
Un out_path que ya existe es rechazado:
Error: /path/merged.pdf already exists and nothing was written.
Pass overwrite: true to replace it, or give a different out_path.
La ruta se reserva con una creación exclusiva, no con una verificación de existencia, por lo que dos procesos escribiendo el mismo out_path
al mismo tiempo no pueden pisarse entre sí: uno gana, el otro es rechazado y no escribe nada. pdf_split reserva
cada una de sus rutas de salida antes de escribir cualquiera de ellas, por lo que una colisión en la parte 3 no deja las partes 1 y 2
atrás como una división a medias, y las reservas se liberan, por lo que tampoco queda nada vacío en el disco.
Pasa overwrite: true cuando reemplazar el archivo es lo que quieres.
overwrite: true aún no permite que una salida sea una entrada. Escribir el resultado de una operación de vuelta sobre una de sus
propias fuentes destruye esa fuente, las páginas ya están en memoria y se escriben sobre el archivo del que vinieron,
lo que lleva un archivo de tres páginas a la única página que extrajiste, y cada lectura posterior de esa ruta es entonces silenciosamente
incorrecta. Entonces, un out_path que resuelve a (o comparte un inodo con) cualquier entrada de la misma llamada es rechazado antes de que
ocurra cualquier trabajo:
Error: out_path /path/scan.pdf is also an input of this operation, so writing it would destroy the source.
Nothing was written. Write beside it instead - /path/scan-out.pdf - and, if the result really is meant to
take the original's place, rename it yourself once you have checked it.
Límites
- Se rechazan entradas de más de 100 MB: reescribir un PDF necesita varias veces su tamaño en memoria.
- Un archivo que no comienza con
%PDF-se rechaza antes de que se lea nada. - La rotación se registra como metadatos de página, en múltiplos de 90 grados, que es todo lo que permite el formato. No se redibuja nada.
- El texto del sello pasa por una fuente PDF integrada, que incluye WinAnsi y sus 256 puntos de código. Un carácter fuera de ella
se translitera cuando tiene un cuerpo latino obvio, el polaco
OPŁACONEse sella comoOPLACONE, y la respuesta lo indica e imprime lo que realmente se dibujó, y se elimina y cuenta cuando no lo tiene, por lo que no hay sello CJK. Un salto de línea es un separador de palabras, nunca una eliminación. font_sizedebe estar entre 1 y 1600 puntos. Un sello demasiado largo para caber incluso en el tamaño más pequeño que este servidor usará se dibuja igualmente, y la respuesta indica cuánto sobresale del borde, para que puedas acortarlo.pdf_textlimita una respuesta a 200 000 caracteres y nombra el argumentopagesque continúa desde donde se detuvo. Nada falta en el archivo; el corte está en la respuesta, no en la lectura.- Sin numeración de páginas, sin firmas, sin redacción, sin compresión. Este servidor hace los trabajos a nivel de página; no es un
editor de PDF. No escribe PDF/A:
pdf_infoinforma elpdfa_claimpropio del archivo, y cada herramienta que escribe dice claramente que su salida ya no mantiene esa afirmación. - Los formularios se leen, no se rellenan:
pdf_textimprime los valores de los campos AcroForm, que viven en los campos en lugar de en el flujo de contenido de la página y, por lo tanto, no forman parte del texto de la página. - Sin OCR. Consulta la sección
pdf_text.
Cómo almacena datos
Solo un registro de lo que hizo: ${XDG_DATA_HOME:-~/.local/share}/mcp-servers/pdf/operations.json, las últimas 500
operaciones, como JSON plano. Tus PDFs permanecen donde los colocas. Cada escritura en el registro se ejecuta dentro de un bloqueo
de asesoramiento sobre .../pdf/.lock, por lo que dos clientes en un mismo directorio de datos no pueden perder un registro, y los guardados van a un archivo temporal
y se renombran en su lugar.
Si el registro no es legible o no es JSON válido, nunca se trata como "vacío": se mueve a un lado byte por byte como
operations.json.corrupt-<timestamp> con un marcador junto a él. El PDF que solicitaste aún se escribe, el archivo está
en disco antes de que se toque el registro, y la respuesta te indica que el historial no pudo actualizarse.
El pie de página comercial lee el único perfil compartido que usa todo el conjunto,
${XDG_DATA_HOME:-~/.local/share}/mcp-servers/profile/business.json, escrito por business_set en mcp-invoice o
mcp-docx. Nada se inventa: sin nombre almacenado, pdf_watermark_business se niega y dice qué herramienta ejecutar.
Privacidad
Todos los datos permanecen locales. El servidor lee y escribe archivos en tu máquina y no realiza ninguna solicitud de red de ningún tipo: ni para licencias (las claves se verifican sin conexión), ni para fuentes, ni para telemetría. Un PDF que sellas nunca se sube a ningún lugar, que es la razón completa de que esto exista.
Se combina con
- mcp-invoice, la factura que enviaste, sellada como PAGADA: el prompt
mark_invoice_paidencadenainvoice_getenpdf_stamp. - mcp-docx, escribe la propuesta como
.docx, imprímela a PDF, luego sella, combina o divide aquí. - mcp-resume, une un CV, una carta de presentación y un portafolio en el único archivo que acepta un formulario de solicitud.
- office-suite, varios servidores detrás de una sola instalación, una entrada de configuración.
Solución de problemas
npxse cuelga o no encuentra el paquete: la publicación npm de este paquete está pendiente. Usa el paquete.mcpbo la ruta de clonar y compilar anterior hasta que llegue.- "está cifrado y fue rechazado": el archivo está protegido por contraseña o permisos. Ábrelo en un lector de PDF, exporta o imprime a un nuevo PDF, y ejecuta la herramienta en esa copia. Este servidor nunca adivina ni elimina una contraseña.
pdf_textno devolvió nada: la página es un escaneo, o su fuente usa una codificación personalizada. La respuesta indica cuál. No hay OCR aquí.- El sello es demasiado pequeño o demasiado grande: por defecto, se dimensiona para caber en el ancho de la página. Pasa
font_sizepara un tamaño de punto exacto, yopacityentre 0 y 1. - "ya existe y no se escribió nada": pasa
overwrite: true, o unout_pathdiferente. - Versión de Node: requiere Node >= 18. Verifica con
node -v.
Licencia MIT. Soporte: support@zovo.one
Creado por theluckystrike.
Preguntas frecuentes
¿Hay un servidor MCP para combinar y dividir PDFs?
Sí. El servidor pdf en mcp.zovo.one combina, divide, rota y rellena formularios PDF mientras preserva los campos de formulario. Nivel gratuito de 30 páginas por archivo en operaciones de división/páginas/rotación, endpoint remoto alojado, sin instalación.
¿Puede Claude rellenar formularios PDF con un servidor MCP?
Sí: conecta https://mcp.zovo.one/mcp/pdf y pide a Claude que rellene los campos de un formulario o combine varios PDFs. La salida preserva los formularios, por lo que los campos rellenados siguen siendo editables.
Usa estos documentos como servidor MCP
Cualquier cliente MCP (Claude, Cursor, Windsurf, VS Code) puede leer la documentación de este repositorio directamente a través de GitMCP, sin instalación:
- URL MCP de documentos: https://gitmcp.io/theluckystrike/mcp-pdf