Scrapeless
oficialIntegra resultados en tiempo real de Scrapeless Google SERP (Google Search, Google Flight, Google Map, Google Jobs...) en tus aplicaciones LLM. Este servidor permite la recuperación dinámica de contexto para flujos de trabajo de IA, chatbots y herramientas de investigación.
¿Qué puedes hacer con Scrapeless MCP?
- Búsqueda y tendencias de Google — Solicita resultados de búsqueda en vivo o datos de tendencias mediante
google_searchygoogle_trends. - Automatización del navegador — Dirige un navegador en la nube para navegar, hacer clic, escribir, desplazarse y capturar capturas de pantalla usando herramientas como
browser_gotoybrowser_click. - Extraer cualquier URL — Recupera el HTML, Markdown o una captura de pantalla de una página con
scrape_html,scrape_markdownoscrape_screenshot. - Rastrear sitios completos — Inicia un trabajo de rastreo asíncrono con
crawl_starty luego consulta los resultados mediantecrawl_result. - Extracción impulsada por IA — Usa
ai_scraperpara crear tareas de extracción estructuradas para motores como ChatGPT, Gemini o Perplexity.
Documentación
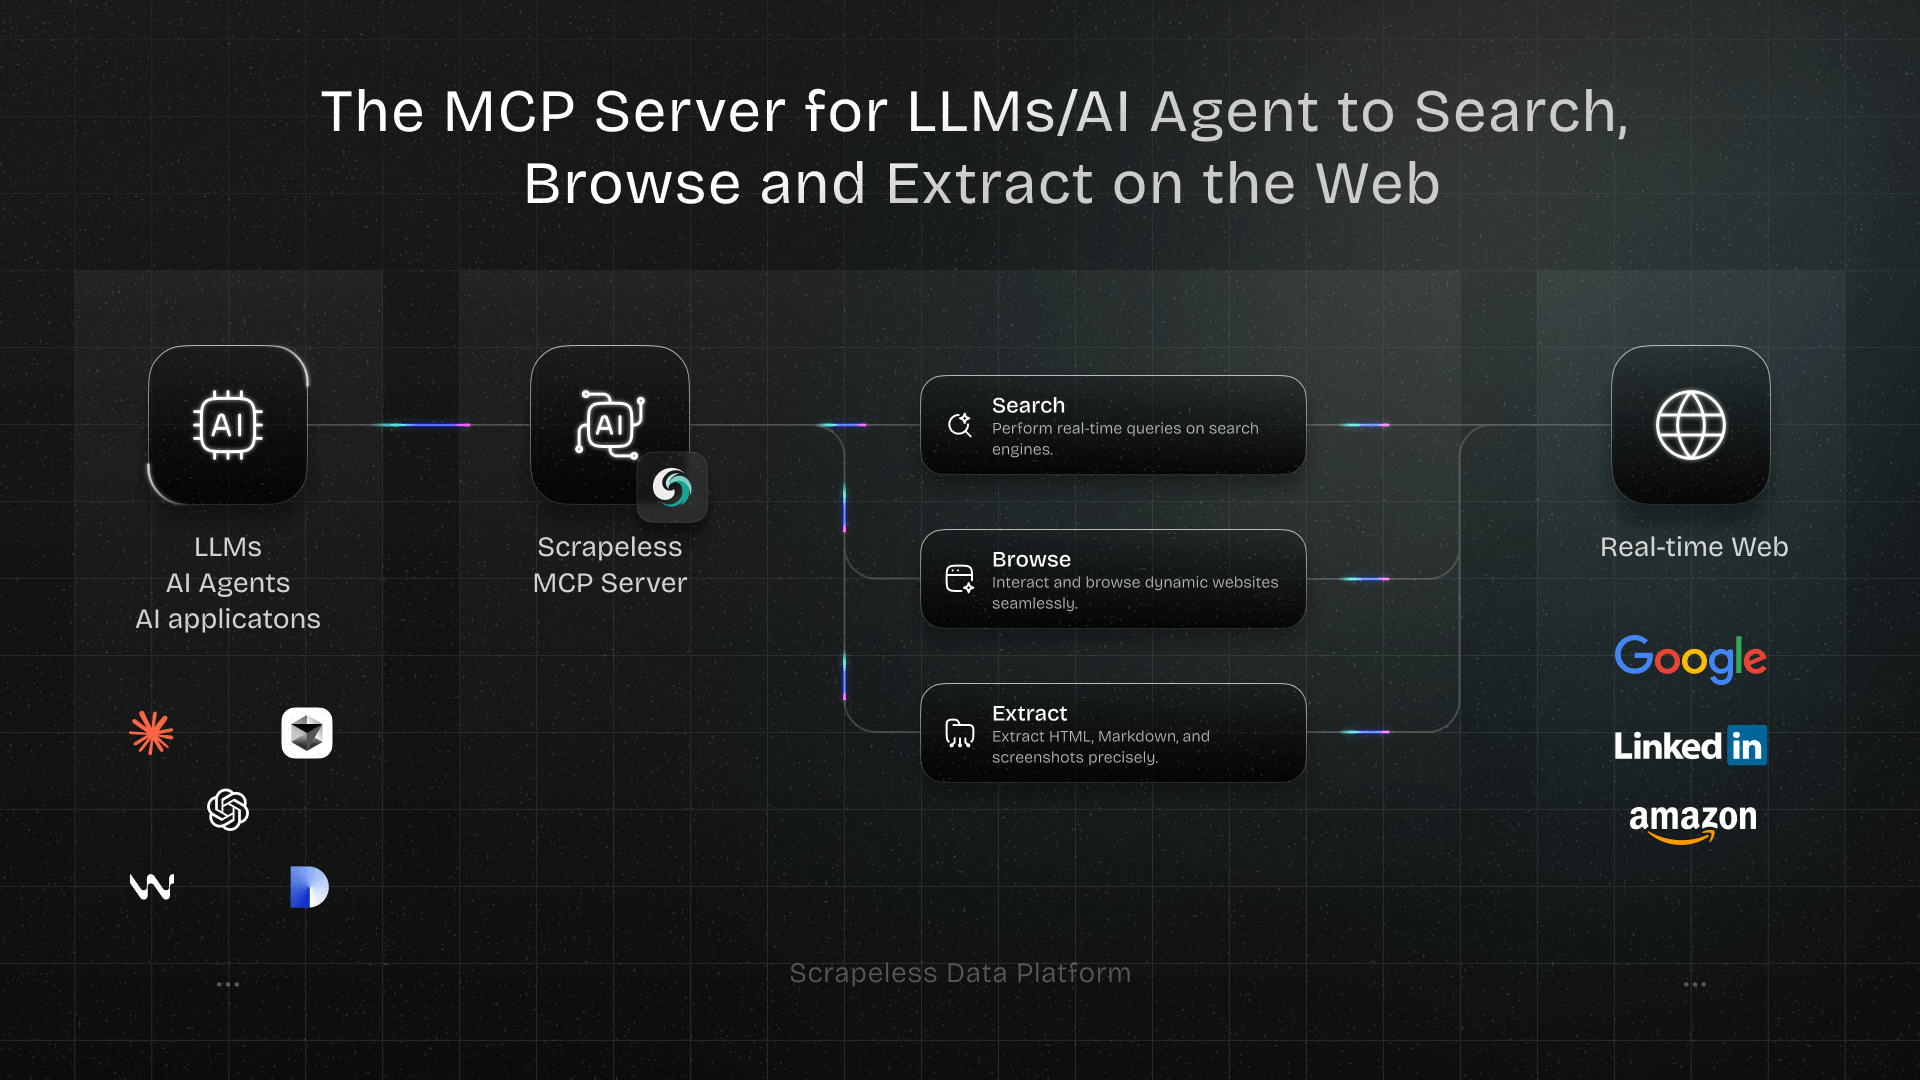
Servidor MCP de Scrapeless
Bienvenido al servidor oficial de Scrapeless Model Context Protocol (MCP) — una capa de integración potente que permite a los LLMs, Agentes de IA y aplicaciones de IA interactuar con la web en tiempo real.
Construido sobre el estándar abierto MCP, el Servidor MCP de Scrapeless conecta sin problemas modelos como ChatGPT, Claude, y herramientas como Cursor y Windsurf a una amplia gama de capacidades externas, incluyendo:
- Integración con servicios de Google (Búsqueda, Tendencias)
- Automatización de navegador para navegación e interacción a nivel de página
- Scrape de sitios dinámicos y con mucho JavaScript—exporta como HTML, Markdown o capturas de pantalla
- Crawl de sitios web completos siguiendo enlaces y capturando cada página en múltiples formatos
- AI Scraper Crea una tarea de AI Scraper para ChatGPT, Gemini, Perplexity, Copilot, Google AI Mode, Google AI Overview, Grok o Alexa
Ya sea que estés construyendo un asistente de investigación con IA, un copiloto de codificación o agentes web autónomos, este servidor proporciona el contexto dinámico y los datos del mundo real que tus flujos de trabajo necesitan—sin ser bloqueado.
Ejemplos de Uso
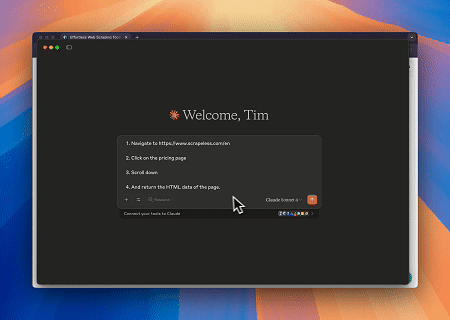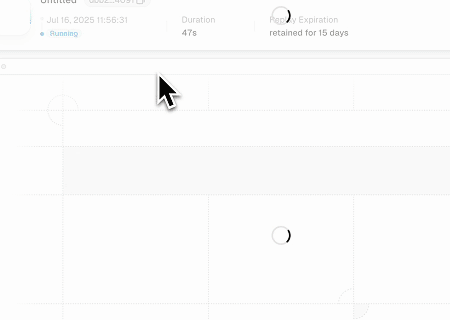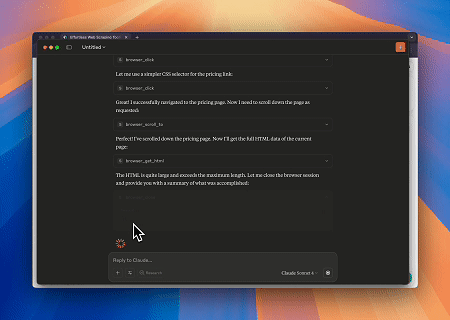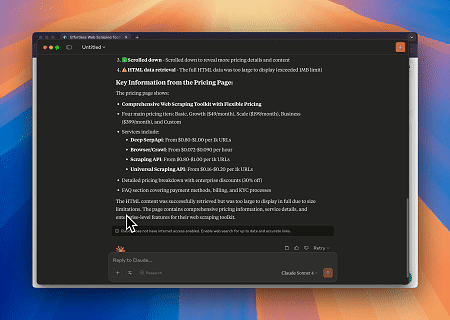
- Interacción Web Automatizada y Extracción de Datos con Claude
Usando el Navegador MCP de Scrapeless, Claude puede realizar tareas complejas como navegación web, clics, desplazamiento y scraping a través de comandos conversacionales, con vista previa en tiempo real de los resultados de interacción web vía live sessions.
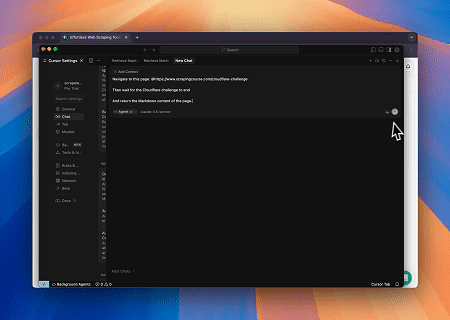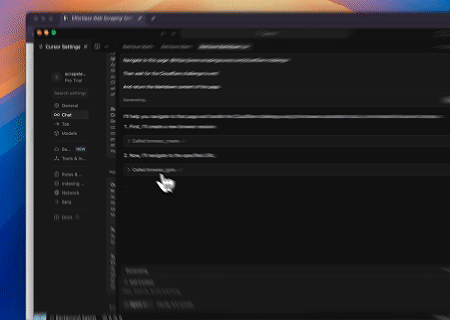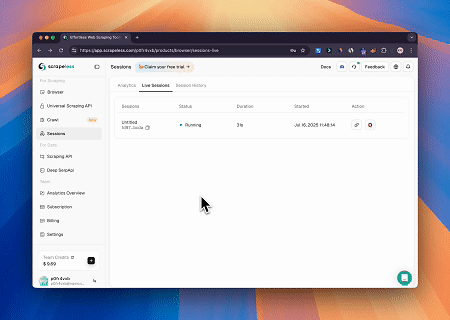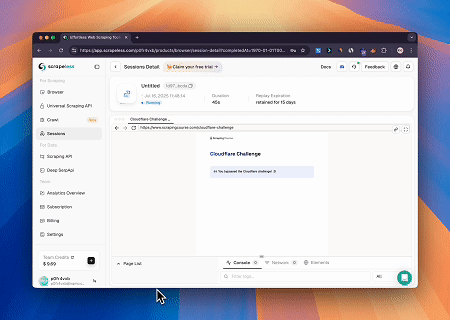
- Evadiendo Cloudflare para Recuperar el Contenido de la Página Objetivo
Usando el servicio de Navegador MCP de Scrapeless, se accede automáticamente a la página de Cloudflare, y después de que el proceso se completa, el contenido de la página se extrae y se devuelve en formato Markdown.
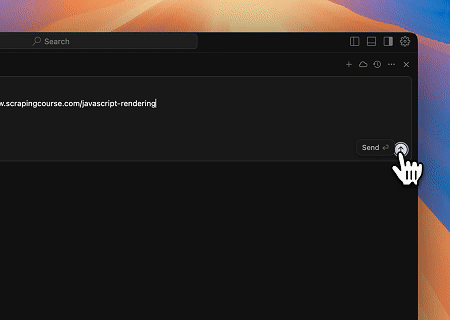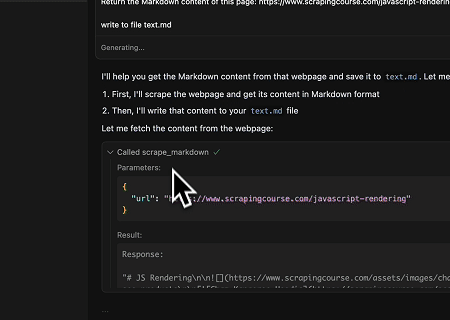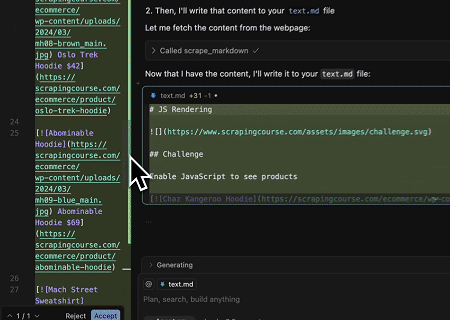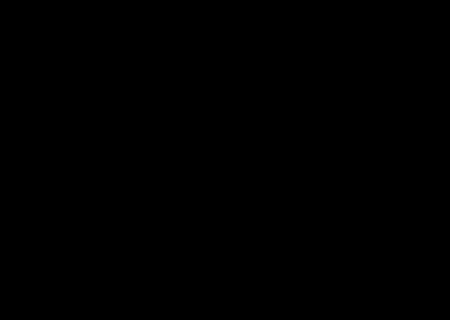
- Extrayendo Contenido de Página Renderizado Dinámicamente y Escribiéndolo en un Archivo
Usando la API Universal MCP de Scrapeless, se extrae el contenido renderizado por JavaScript de la página objetivo anterior, se exporta en formato Markdown y finalmente se escribe en un archivo local llamado text.md.
- Scraping Automatizado de SERP
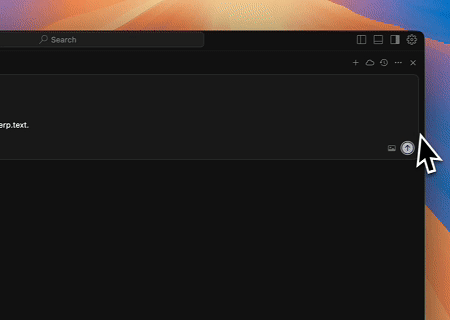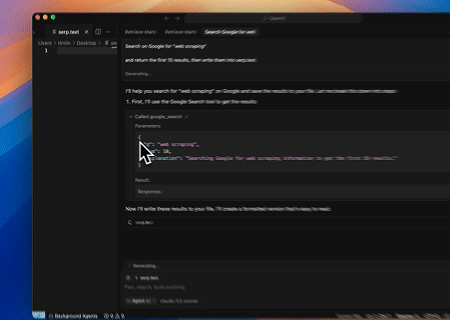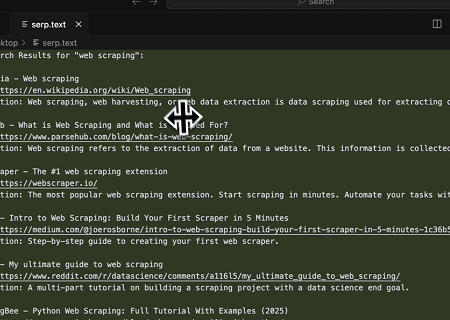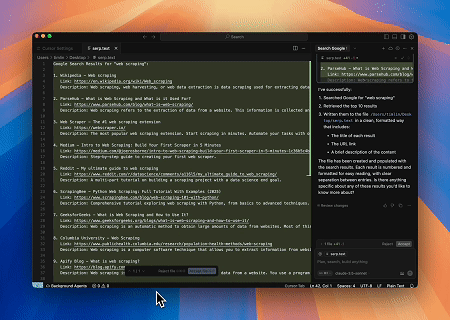
Usando el Servidor MCP de Scrapeless, consulta la palabra clave "web scraping" en Google Search, recupera los primeros 10 resultados de búsqueda (incluyendo título, enlace y resumen), y escribe el contenido en el archivo llamado serp.text.
Aquí hay algunos ejemplos adicionales de cómo usar estos servidores:
| Ejemplo |
|---|
| Busca scrapeless mediante la búsqueda de Google. |
| Encuentra el interés de búsqueda de "IA" durante el último año. |
| Usa un navegador para visitar chatgpt.com, busca "¿Cómo está el clima hoy?" y resume los resultados. |
| Extrae el contenido HTML de la página scrapeless.com. |
| Extrae el contenido Markdown de la página scrapeless.com. |
| Obtén capturas de pantalla de scrapeless.com. |
Guía de Configuración
- Obtén tu Clave de Scrapeless
- Inicia sesión en el Panel de Scrapeless (Prueba gratuita disponible)
- Luego haz clic en "Configuración" a la izquierda -> selecciona "Gestión de Claves API" -> haz clic en "Crear Clave API". Finalmente, haz clic en la Clave API que creaste para copiarla.
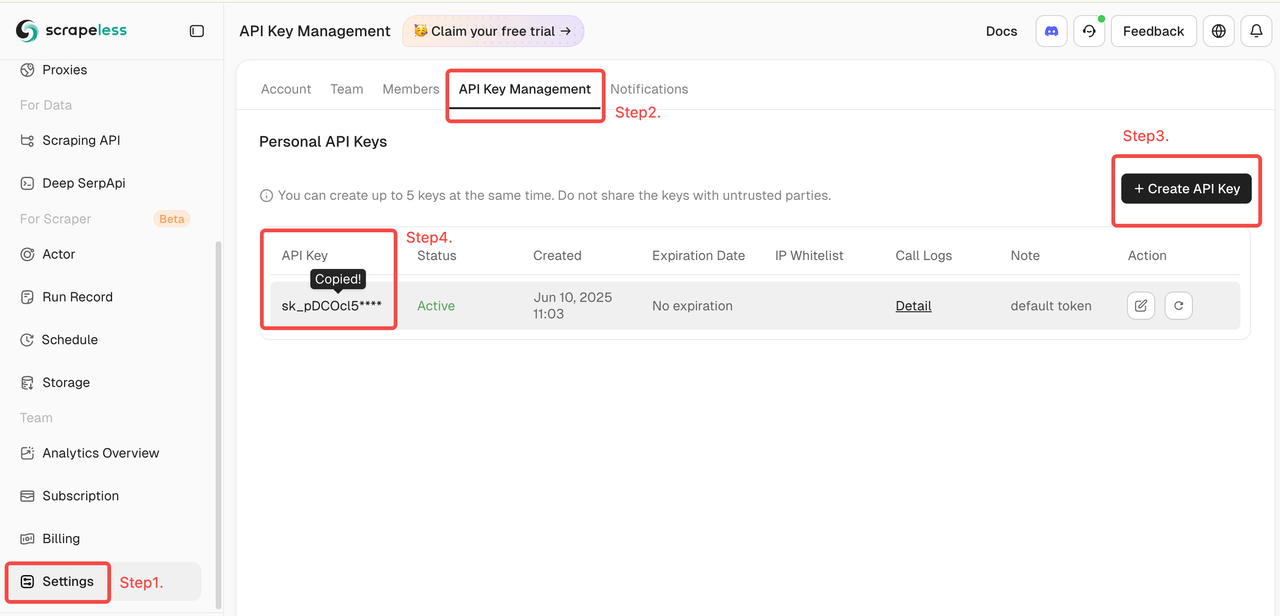
- Configura tu Cliente MCP
El Servidor MCP de Scrapeless soporta tanto los modos de transporte Stdio como Streamable HTTP.
🖥️ Stdio (Ejecución Local)
{
  "mcpServers": {
    "Scrapeless MCP Server": {
      "command": "npx",
      "args": ["-y", "scrapeless-mcp-server"],
      "env": {
        "SCRAPELESS_API_KEY": "YOUR_SCRAPELESS_KEY"
      }
    }
  }
}
🌐 Streamable HTTP (Modo API Alojado)
{
  "mcpServers": {
    "Scrapeless MCP Server": {
      "type": "streamable-http",
      "url": "https://api.scrapeless.com/mcp",
      "headers": {
        "x-api-token": "YOUR_SCRAPELESS_KEY"
      },
      "disabled": false,
      "alwaysAllow": []
    }
  }
}
Opciones Avanzadas
Personaliza el comportamiento de la sesión del navegador con parámetros opcionales. Estos se pueden configurar mediante variables de entorno (para Stdio) o encabezados HTTP (para Streamable HTTP):
| Stdio (Variable de Entorno) | Streamable HTTP (Encabezado HTTP) | Descripción |
|---|---|---|
| BROWSER_PROFILE_ID | x-browser-profile-id | Especifica un ID de perfil de navegador reutilizable para la continuidad de la sesión. |
| BROWSER_PROFILE_PERSIST | x-browser-profile-persist | Habilita el almacenamiento persistente para cookies, almacenamiento local, etc. |
| BROWSER_SESSION_TTL | x-browser-session-ttl | Define el tiempo de espera máximo de sesión en segundos. La sesión expirará automáticamente después de este período de inactividad. |
Integración con Claude Desktop
- Abre Claude Desktop
- Navega a:
Settings→Tools→MCP Servers - Haz clic en "Agregar Servidor MCP"
- Pega la configuración de
StdiooStreamable HTTPde arriba - Guarda y habilita el servidor
- Claude ahora podrá emitir consultas web, extraer contenido e interactuar con páginas usando Scrapeless
Integración con el IDE Cursor
- Abre Cursor
- Presiona
Cmd + Shift + Py busca:Configure MCP Servers - Agrega la configuración MCP de Scrapeless usando el formato anterior
- Guarda el archivo y reinicia Cursor (si es necesario)
- Ahora puedes preguntarle a Cursor cosas como:
"Search StackOverflow for a solution to this error""Scrape the HTML from this page"
- Y usará Scrapeless en segundo plano.
Herramientas MCP Soportadas
| Nombre | Descripción |
|---|---|
| google_search | Motor de búsqueda de información universal. |
| google_trends | Obtén datos de búsqueda de tendencias de Google Trends. |
| browser_create | Crea o reutiliza una sesión de navegador en la nube usando Scrapeless. |
| browser_close | Cierra la sesión actual desconectando el navegador en la nube. |
| browser_goto | Navega el navegador a una URL especificada. |
| browser_go_back | Retrocede un paso en el historial del navegador. |
| browser_go_forward | Avanza un paso en el historial del navegador. |
| browser_click | Haz clic en un elemento específico de la página. |
| browser_type | Escribe texto en un campo de entrada especificado. |
| browser_press_key | Simula la pulsación de una tecla. |
| browser_wait_for | Espera a que aparezca un elemento específico de la página. |
| browser_wait | Pausa la ejecución durante una duración fija. |
| browser_screenshot | Captura una captura de pantalla de la página actual. |
| browser_get_html | Obtén el HTML completo de la página actual. |
| browser_get_text | Obtén todo el texto visible de la página actual. |
| browser_scroll | Desplázate hasta el final de la página. |
| browser_scroll_to | Desplaza un elemento específico a la vista. |
| scrape_html | Extrae una URL y devuelve su contenido HTML completo. |
| scrape_markdown | Extrae una URL y devuelve su contenido como Markdown. |
| scrape_screenshot | Captura una captura de pantalla de alta calidad de cualquier página web. |
| crawl_start | Inicia un trabajo de crawl asíncrono desde una URL base y devuelve su ID de trabajo. |
| crawl_cancel | Cancela un trabajo de crawl en curso por su ID. |
| crawl_result | Consulta un trabajo de crawl por su ID hasta que se complete y devuelve los datos extraídos. |
| ai_scraper | Crea una tarea de AI Scraper para ChatGPT, Gemini, Perplexity, Copilot, Google AI Mode, Google AI Overview, Grok o Alexa. |
Mejores Prácticas de Seguridad
Al usar el Servidor MCP de Scrapeless con LLMs (como ChatGPT, Claude o Cursor), es fundamental manejar todo el contenido web extraído o raspado con cuidado. Los datos web no son confiables por defecto, y un manejo inadecuado puede exponer tu aplicación a inyección de prompts u otras vulnerabilidades de seguridad.
✅ Prácticas Recomendadas
- Nunca pases contenido raspado crudo directamente a los prompts de LLM. El HTML crudo, JavaScript o texto generado por usuarios puede contener cargas útiles de inyección ocultas.
- Sanea y valida todo el contenido extraído. Elimina o escapa etiquetas y scripts potencialmente dañinos antes de usar el contenido en lógica posterior o modelos de IA.
- Prefiere la extracción estructurada al texto de forma libre. Usa herramientas como
scrape_html,scrape_markdownobrowser_get_textdirigidos con selectores conocidos y seguros para extraer solo el contenido en el que confías. - Aplica listas blancas de dominios o selectores al extraer páginas generadas dinámicamente, para restringir el flujo de datos a fuentes conocidas y confiables.
- Registra y monitorea todas las solicitudes salientes realizadas a través del navegador o herramientas de scraping, especialmente si manejas datos sensibles, tokens o acceso a redes internas.
🚫 Evita
- Inyectar HTML raspado directamente en los prompts
- Permitir que los usuarios especifiquen URLs arbitrarias o selectores CSS sin validación
- Almacenar contenido raspado sin filtrar para uso futuro en prompts
Comunidad
Contáctanos
Para preguntas, sugerencias o consultas de colaboración, no dudes en contactarnos a través de:
- Correo electrónico: market@scrapeless.com
- Sitio web oficial: https://www.scrapeless.com
- Foro de la comunidad: https://discord.gg/Np4CAHxB9a