WorkloadTruth
Clasifica cargas de trabajo de GPU como inferencia o entrenamiento únicamente a partir de telemetría mediante herramientas MCP.
Documentación
WorkloadTruth


Instalación • Inicio rápido • Referencia de CLI • Comparación • Preguntas frecuentes
Clasifica una carga de trabajo de GPU como TRAINING, INFERENCE o IDLE solo a partir de telemetría. Sin cambios de código en la carga de trabajo, sin etiquetas de trabajo autoinformadas.
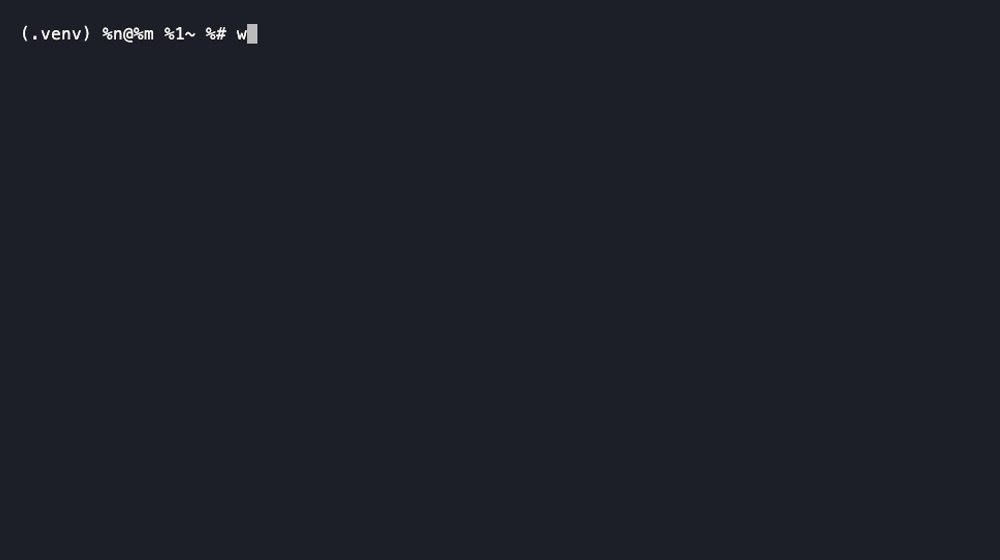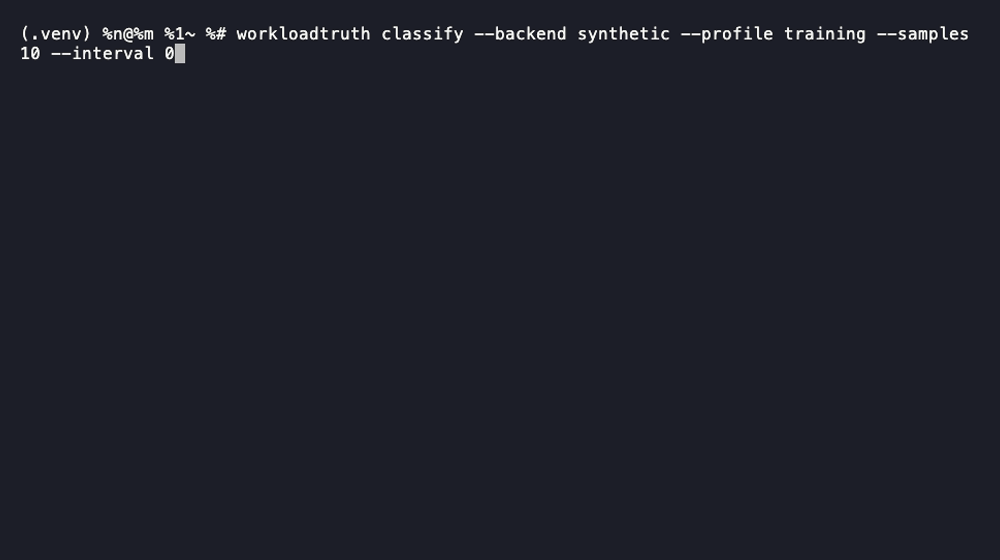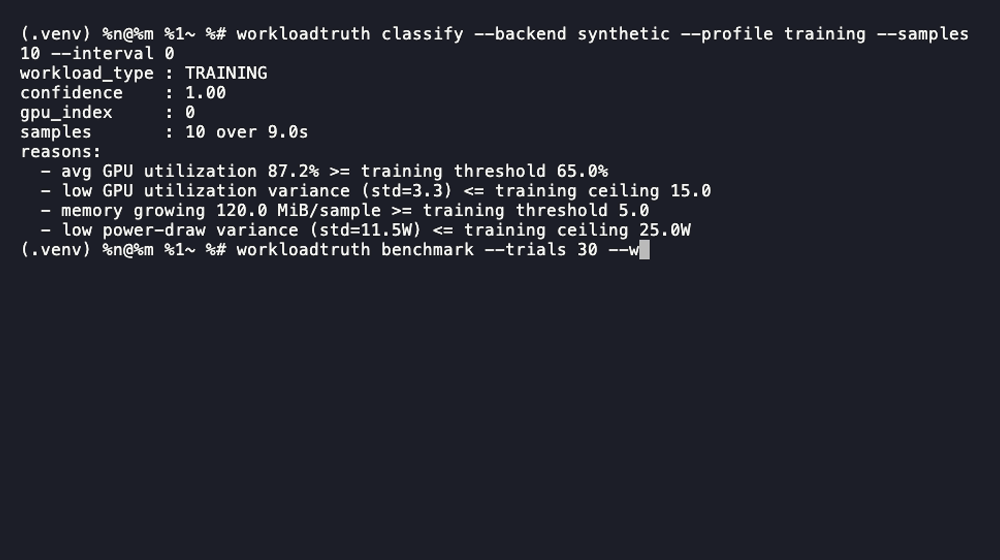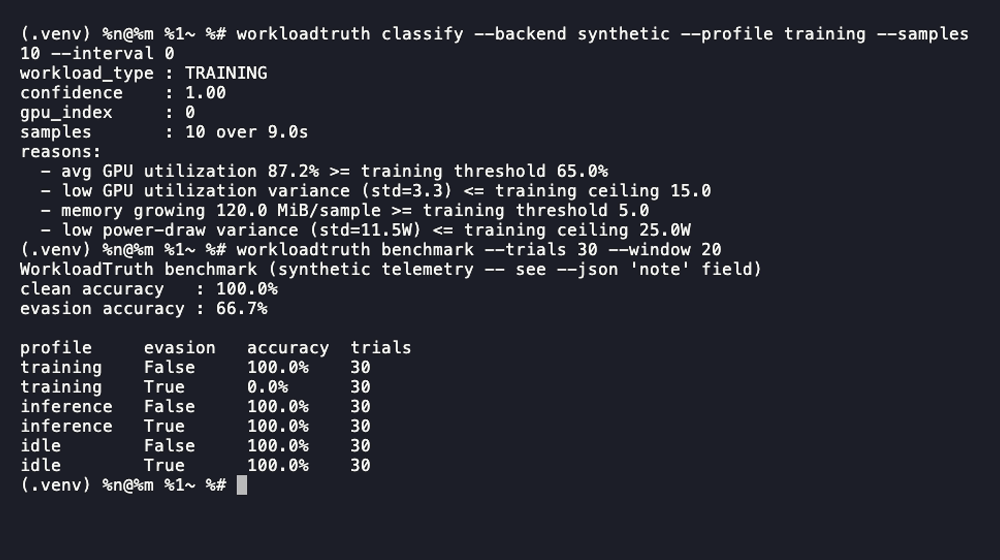
Todo programador de GPU en uso común hoy en día, incluidos run:ai, Slurm y los operadores de GPU de Kubernetes, te pide que declares si un trabajo es de entrenamiento o de inferencia al momento de la presentación. Ninguno lo verifica. WorkloadTruth lee la telemetría de la GPU (utilización, patrón de memoria, consumo de energía) y responde la pregunta de forma independiente, para que un trabajo mal etiquetado o con mal comportamiento no pase desapercibido.
Instalación
# Real NVIDIA GPU telemetry (requires an NVIDIA driver on the host)
pip install "workloadtruth-cli[nvml]"

# Try it without a GPU, using the synthetic backend
pip install workloadtruth-cli

# npm launcher (thin wrapper around the PyPI package, see "Why two registries")
npx workloadtruth-cli --help
[!NOTA] El paquete npm es un lanzador, no una instalación independiente.
npx workloadtruth-cliejecuta el binario real deworkloadtruthdesde PATH, por lo que el paquete PyPI (pip install workloadtruth-cli) debe estar instalado primero.
Inicio rápido
# No GPU required. Classify a synthetic "training" telemetry trace.
$ workloadtruth classify --backend synthetic --profile training --samples 10 --interval 0
workload_type : TRAINING
confidence    : 1.00
gpu_index     : 0
samples       : 10 over 9.0s
reasons:
  - avg GPU utilization 87.8% >= training threshold 65.0%
  - low GPU utilization variance (std=3.4) <= training ceiling 15.0
  - memory growing 120.0 MiB/sample >= training threshold 5.0
  - low power-draw variance (std=9.4W) <= training ceiling 25.0W

# Real hardware
$ workloadtruth classify --backend nvml --samples 10 --interval 1 --json
--json en cada comando cambia a salida legible por máquina para scripts y agentes.
Resumen rápido
- Úsalo para: detectar trabajos de GPU con costos mal asignados (un trabajo facturado como "inferencia" de baja prioridad que en realidad ejecuta entrenamiento completo) y cambios no autorizados en la carga de trabajo (un endpoint de inferencia que comienza a entrenar con tráfico en vivo sin aprobación)
- Lo que no es: una herramienta de cumplimiento o auditoría regulatoria. Ninguna regulación actualmente requiere este tipo de monitoreo; consulta Qué no es WorkloadTruth a continuación
- Trabajo previo: se basa y cita arXiv:2606.19262 (ICML 2026); consulta Relación con investigaciones previas
Cómo funciona la clasificación
WorkloadTruth actualmente incluye solo un clasificador basado en reglas: un conjunto de umbrales documentados e inspeccionables sobre cuatro características extraídas de una ventana de telemetría (promedio y varianza de utilización de GPU, pendiente de crecimiento de memoria, promedio y varianza de consumo de energía). Cada umbral vive como una constante nombrada en src/workloadtruth/classifier/rules.py con un comentario que explica su intuición. Nada es una caja negra.
--experimental (un clasificador basado en ML) está presente como una bandera, pero falla ruidosamente con una explicación en lugar de enviar un resultado falso. El modelo entrenado y el conjunto de datos de arXiv:2606.19262 nunca se publicaron, y este proyecto no tiene una GPU NVIDIA en su entorno de compilación para recopilar datos de entrenamiento reales. Un clasificador de ML se incluye aquí solo una vez que se entrene con un conjunto de datos real y divulgado y se demuestre de forma independiente que supera la línea base basada en reglas, no antes.
Benchmark
workloadtruth benchmark mide la precisión del clasificador contra trazas de telemetría de GPU sintéticas documentadas (consulta synthetic_backend.py para los parámetros exactos del perfil), tanto limpias como bajo una transformación de evasión deliberada que imita a un operador que disfraza un trabajo de entrenamiento como inferencia (limitando las oscilaciones de utilización, aplanando el crecimiento de memoria, inyectando brechas inactivas artificiales).
Esto se ejecuta con datos sintéticos, no con hardware NVIDIA en vivo, por lo que no es directamente comparable con los números de hardware real de arXiv:2606.19262. Ambos se informan a continuación, lado a lado, nunca combinados en una sola cifra.
| arXiv:2606.19262 (hardware real, NVML) | WorkloadTruth (trazas sintéticas, 300 pruebas/celda) | |
|---|---|---|
| Precisión limpia | 98.2% | 100.0% |
| Precisión con evasión | 43-87% | 66.7% en general |
El número general de evasión oculta el hallazgo real. Desglosado por tipo de carga de trabajo, el clasificador basado en reglas de WorkloadTruth actualmente está completamente engañado en cargas de trabajo de entrenamiento evasivas (0% de precisión), mientras que sigue siendo preciso en trazas de inferencia e inactividad evasivas (100% cada una). Limitar la utilización de GPU por sí solo es suficiente para hacer que un trabajo de entrenamiento se lea como inferencia para este clasificador hoy.
| Perfil | Precisión limpia | Precisión con evasión |
|---|---|---|
| Entrenamiento | 100.0% | 0.0% |
| Inferencia | 100.0% | 100.0% |
| Inactividad | 100.0% | 100.0% |
Esta es la brecha concreta y divulgada que el conjunto de benchmarks existe para sacar a la luz y rastrear, no una nota al pie. Un clasificador basado en reglas que solo mira la varianza de utilización es trivialmente evadible. Cerrar esta brecha, mediante fusión de múltiples señales o un clasificador entrenado real una vez que existan datos, es la hoja de ruta, no un problema resuelto. Reprodúcelo tú mismo:
workloadtruth benchmark --trials 300 --window 30 --json
Referencia de CLI

$ workloadtruth --help
Usage: workloadtruth [OPTIONS] COMMAND [ARGS]...

  Classify a GPU workload as INFERENCE, TRAINING, or IDLE from telemetry
  alone.

Options:
  --version  Show the version and exit.
  --help     Show this message and exit.

Commands:
  benchmark   Run the evasion-robustness benchmark against synthetic...
  classify    One-shot classification of the current GPU workload.
  mcp         Start an MCP server exposing classify/benchmark/verify-log...
  verify-log  Verify the hash chain of a local audit log has not been...
  watch       Continuously classify and append hash-chained entries to...
| Comando | Propósito |
|---|---|
classify | Clasificación de una sola vez. --backend synthetic|nvml, --profile (solo sintético), --gpu-index, --samples, --interval, --experimental (aún no disponible), --json. |
watch | Clasificación continua; agrega una entrada encadenada por hash a un registro de auditoría local en cada ventana. --window (muestras por ventana), --iterations (0 = ejecutar para siempre), --log-file, --json. |
benchmark | Ejecuta el benchmark de robustez contra evasión (ver arriba). --trials, --window, --json. |
verify-log | Recalcula el hash de cada entrada del registro de auditoría y confirma que la cadena no ha sido manipulada. --log-file, --json. |
mcp | Inicia un servidor MCP (stdio) que expone classify_workload, run_benchmark, verify_audit_log como herramientas invocables por agentes. --backend. Requiere pip install "workloadtruth-cli[mcp]" en Python 3.10+ (ver abajo). |
Cada comando admite --json. Referencia completa de banderas: workloadtruth <command> --help.
Servidor MCP
WorkloadTruth incluye un servidor de Protocolo de Contexto de Modelo para que un agente de IA (Claude, Cursor o cualquier cliente compatible con MCP) pueda clasificar cargas de trabajo de GPU, ejecutar el benchmark de robustez contra evasión y verificar el registro de auditoría directamente, sin que un humano invoque la CLI manualmente.
Instala el extra:
pip install "workloadtruth-cli[mcp]"
Agrégalo a la configuración de tu cliente MCP (para Claude Desktop, claude_desktop_config.json). El servidor se inicia mediante el subcomando workloadtruth mcp, no un script de consola separado:
{
  "mcpServers": {
    "workloadtruth": {
      "command": "uvx",
      "args": ["--from", "workloadtruth-cli", "workloadtruth", "mcp"]
    }
  }
}
El servidor expone tres herramientas a través de stdio:
classify_workload(backend="nvml", profile="training", gpu_index=0, samples=10, interval_seconds=1.0, write_to_audit_log=False): muestrea la telemetría de GPU y la clasifica comoTRAINING,INFERENCEoIDLE.backendes"nvml"(hardware real) o"synthetic"(trazas sintéticas documentadas, sin GPU requerida). Opcionalmente agrega el resultado al registro de auditoría encadenado por hash.run_benchmark(trials=50, window=30): ejecuta el benchmark de robustez contra evasión con telemetría sintética y devuelve la precisión por perfil en condiciones limpias y con ofuscación por evasión.verify_audit_log(log_file="workloadtruth.log.jsonl"): recalcula la cadena de hash de un registro de auditoría local e informa si ha sido manipulada.
Ejemplo de llamada, clasificando una traza de entrenamiento sintética sin GPU requerida:
classify_workload(backend="synthetic", profile="training", samples=10, interval_seconds=0)
-> {"workload_type": "TRAINING", "confidence": 1.0, "gpu_index": 0, ...}
El transporte es stdio, por lo que no hay nada que alojar: el cliente MCP genera workloadtruth mcp como un subproceso local. También se incluye un manifiesto .well-known/agent.json en la raíz del repositorio para descubrimiento estilo A2A, que enumera tanto las interfaces CLI y MCP como los paquetes que las proporcionan. Fuente: src/workloadtruth/mcp_server.py.
Registro de auditoría
workloadtruth watch agrega una entrada encadenada por hash a workloadtruth.log.jsonl en cada ventana de clasificación. El hash de cada entrada cubre su propio contenido más el hash de la entrada anterior, por lo que cualquier edición, reordenamiento o eliminación posterior rompe la cadena desde ese punto en adelante. workloadtruth verify-log recalcula cada hash e informa el primer enlace roto, si lo hay.
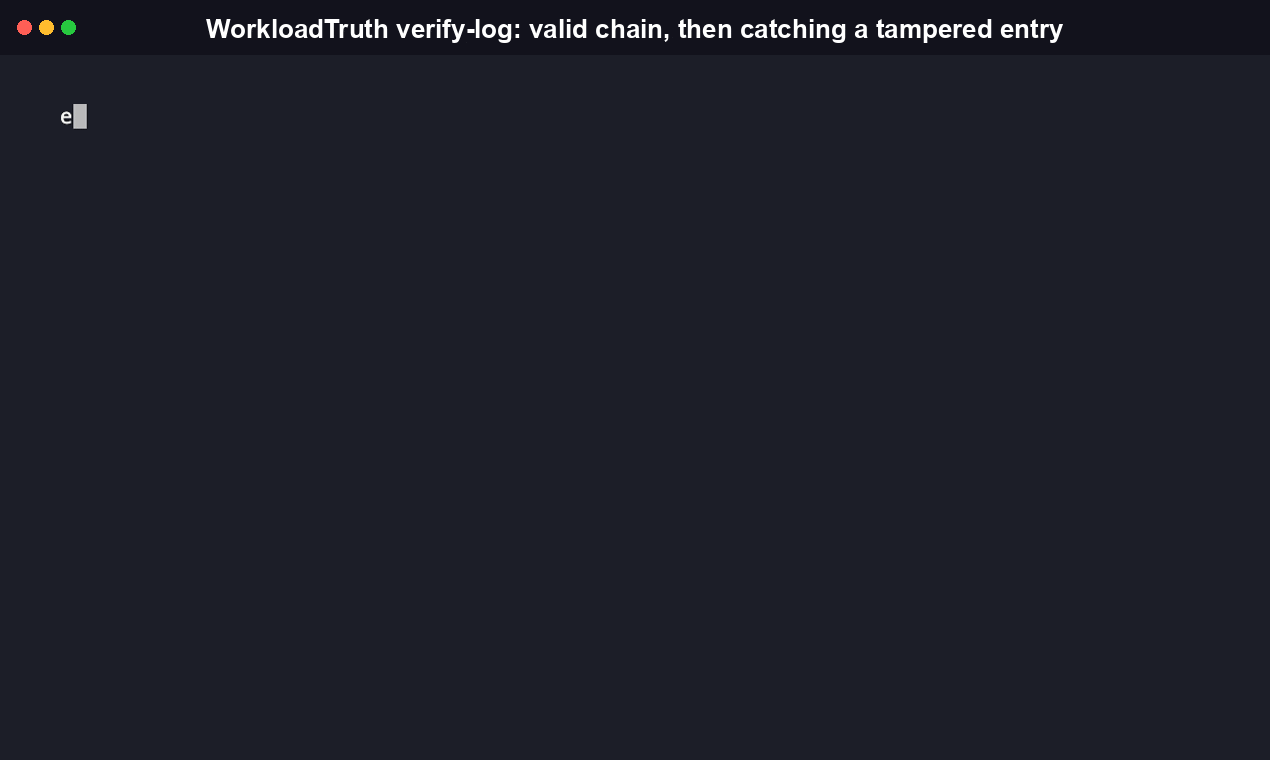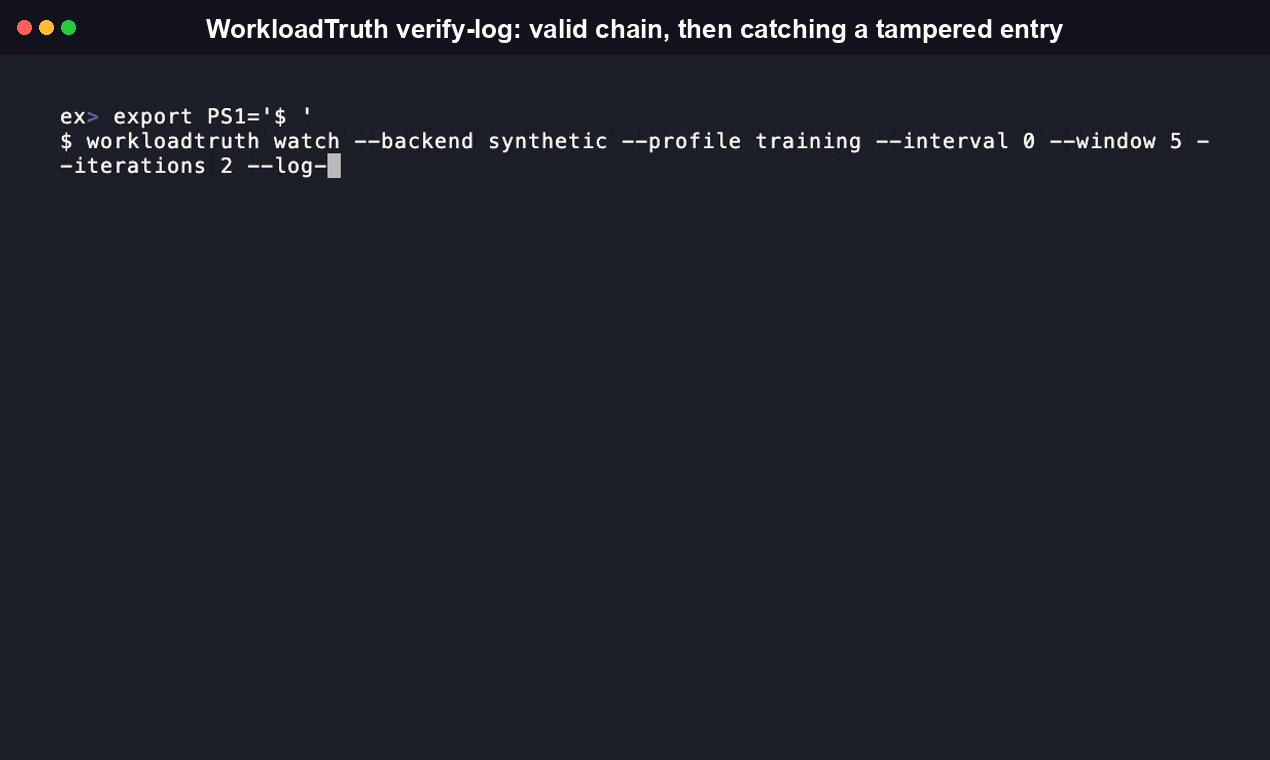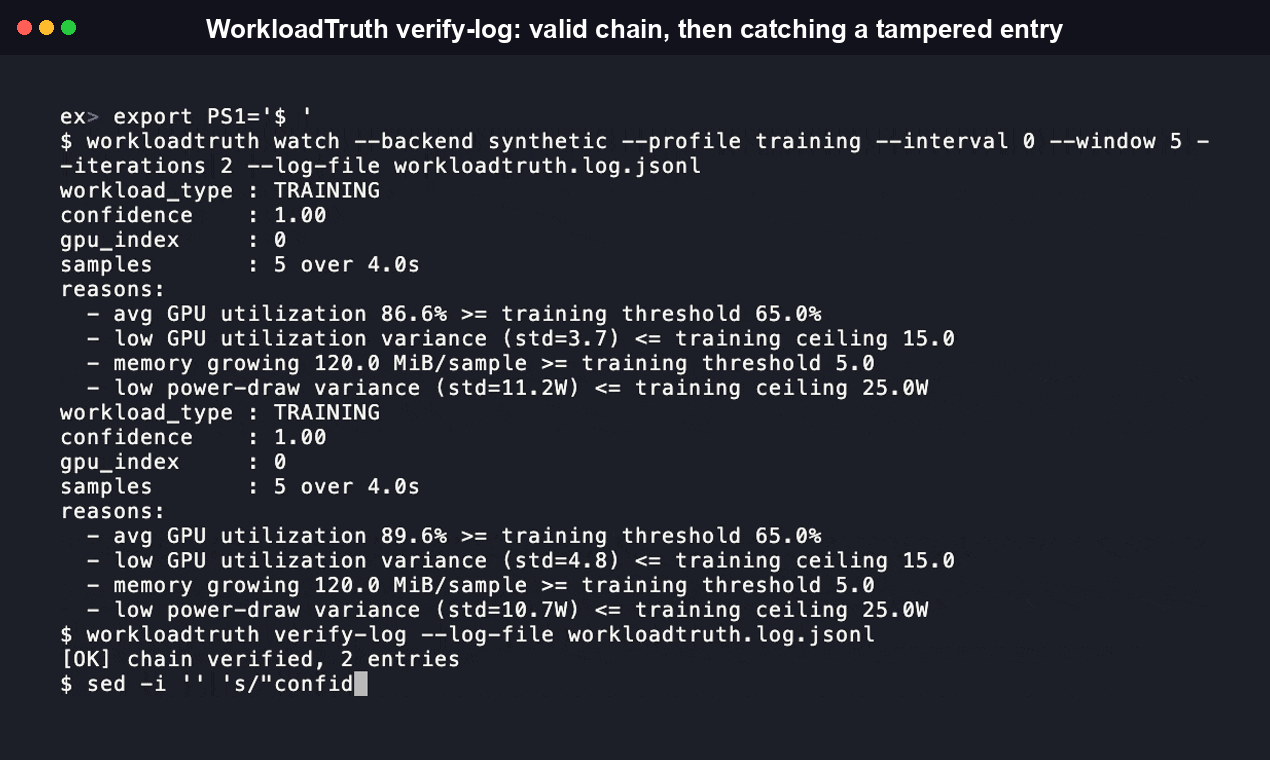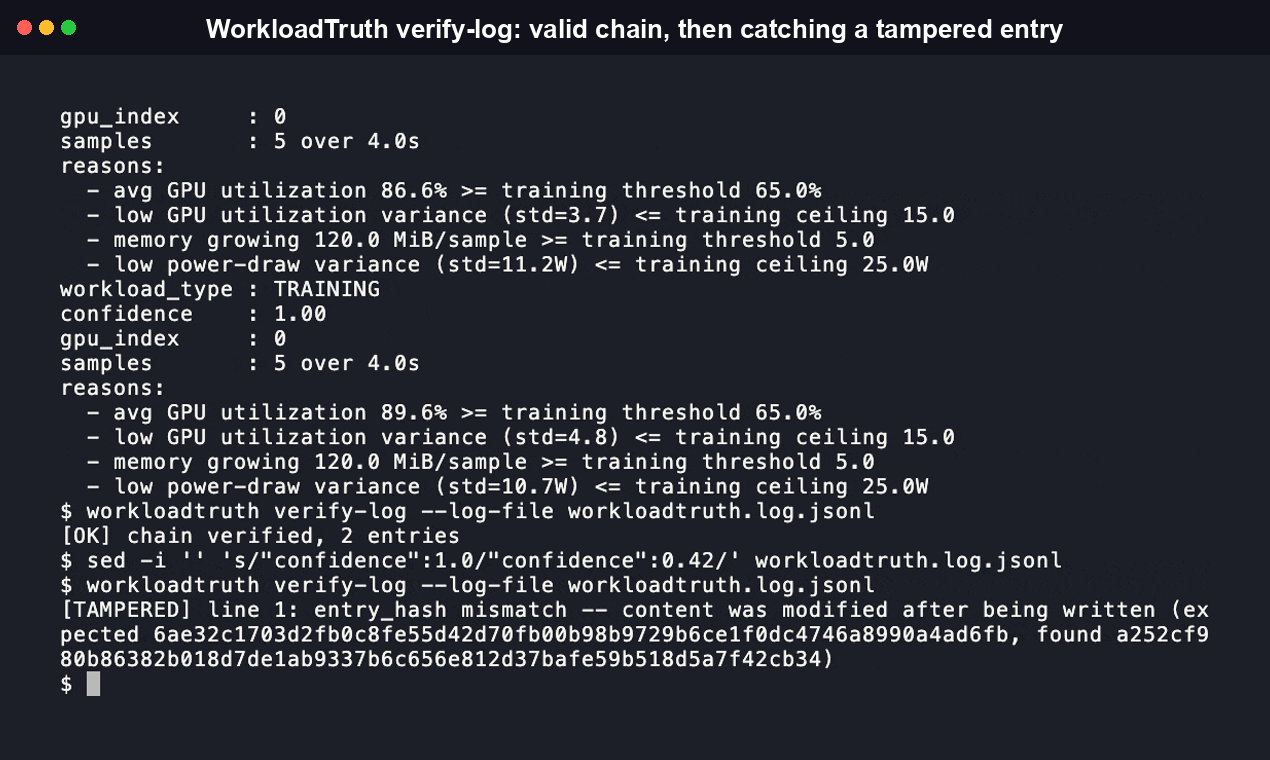
Esto prueba qué se clasificó, cuándo, y que el registro local no ha sido alterado silenciosamente después. No prueba que la clasificación en sí fuera correcta, y no es evidencia de cumplimiento regulatorio. Ver abajo.
Por qué dos registros
La implementación de WorkloadTruth es en Python. El acceso a NVML (pynvml/nvidia-ml-py) es la forma madura y oficial de leer la telemetría de GPU de NVIDIA, y también es lo que usa el trabajo previo más cercano (arXiv:2606.19262). El paquete npm (workloadtruth-cli) es un lanzador delgado, no una reimplementación. Localiza y ejecuta el binario real de workloadtruth instalado desde PyPI, por lo que npx workloadtruth-cli funciona para herramientas de agentes que priorizan npm sin duplicar el clasificador en dos lenguajes. El paquete npm tiene versiones independientes del paquete PyPI, ya que solo incluye un script de lanzador, no el clasificador en sí.
Comparación
| WorkloadTruth | NVIDIA DCGM / dcgm-exporter | run:ai | Weights & Biases | |
|---|---|---|---|---|
| Lee telemetría de GPU | Sí (vía NVML) | Sí (fuente) | Sí | Sí |
| Clasifica el tipo de carga de trabajo automáticamente | Sí | No, expone solo métricas crudas | No, el tipo de carga de trabajo lo declara el usuario al enviar el trabajo | No, limitado al alcance de ejecuciones de entrenamiento por diseño, sin clasificación |
| Registro de auditoría local encadenado por hash | Sí | No | No | No |
| Benchmark de robustez contra evasión | Sí (documentado, reproducible) | N/A | N/A | N/A |
| Requiere una GPU NVIDIA | Solo para el backend nvml; el backend synthetic funciona sin una | Sí | Sí | No (métricas generales del sistema) |
Verificado directamente contra la documentación de cada proyecto: documentos del exportador DCGM, descripción general de inferencia de run:ai, documentos de métricas del sistema de W&B. Ninguno clasifica el tipo de carga de trabajo solo con telemetría. Esa brecha es lo que WorkloadTruth llena.
Qué es WorkloadTruth y por qué existe
WorkloadTruth es una herramienta de línea de comandos de código abierto y un servidor MCP que clasifica una carga de trabajo de GPU en ejecución como TRAINING, INFERENCE o IDLE usando solo telemetría a nivel de GPU (utilización, patrón de memoria, consumo de energía), sin cambios en el código de la carga de trabajo y sin depender de una etiqueta de trabajo autoinformada.
Existe porque cada programador de GPU convencional le pide al propietario del trabajo que declare su tipo al momento de la presentación y nunca verifica esa declaración contra lo que el hardware está haciendo realmente. Esa brecha tiene dos consecuencias reales: mala asignación de costos (un trabajo programado con precios de "inferencia" de baja prioridad que en realidad ejecuta entrenamiento completo) y cambios no autorizados en la carga de trabajo (un endpoint de inferencia que silenciosamente comienza a entrenar con tráfico en vivo). WorkloadTruth cierra esa brecha de verificación hoy, y además sirve como la primera implementación abierta e instalable de una línea de investigación académica real sobre verificación de ejecuciones de entrenamiento de IA desde telemetría de hardware (ver abajo).
Relación con investigaciones previas
La técnica central de WorkloadTruth, clasificar actividad de GPU de entrenamiento vs. no entrenamiento desde telemetría, no es novedosa. Es la aplicación directa de una línea de investigación real y activa:
- Yonadav Shavit (Harvard), "¿Qué se necesita para atrapar a una Chinchilla?" (2023): propuso "transcripciones de entrenamiento" a nivel de hardware para verificar ejecuciones de entrenamiento a gran escala.
- GovAI, "Poder de cómputo y la gobernanza de la IA" (2024): encuestó mecanismos de gobernanza de cómputo, enmarcados explícitamente como exploratorios, no como política respaldada.
- "Mecanismos habilitados por hardware para verificar el desarrollo responsable de IA" (2025): investigadores de seguridad de hardware que proponen atestación en chip.
- Rahman y Tajdari, "Detección de entrenamiento de ML oculto con telemetría de sobrecarga cero" (Taller técnico de gobernanza de IA de ICML 2026): un clasificador de telemetría NVML funcional, 98.2% preciso en cargas de trabajo sin ofuscar, el trabajo previo directo para la técnica central de clasificación de este proyecto. Lo que añade WorkloadTruth: a fecha de la investigación de este proyecto (2026-07-19), no existía ninguna implementación open-source e instalable de esta línea de investigación, solo prototipos académicos. WorkloadTruth es ese empaquetado: una CLI real, un servidor MCP, un registro de auditoría encadenado por hash y un benchmark reproducible de robustez frente a evasión, construido en abierto. No pretende mejorar la técnica de clasificación del artículo. Consulta la sección de benchmark anterior: el clasificador actual basado en reglas es considerablemente más evadible que el enfoque de ML del artículo en el único eje que mide.
Lo que WorkloadTruth no es
- No es una herramienta de cumplimiento o auditoría regulatoria. Ninguna ley exige actualmente la clasificación o el reporte de inferencia/entrenamiento. Cualquier afirmación futura en contrario nombrará la regulación promulgada específica; ninguna existe a fecha de este escrito.
- No es un inspector de contenido. WorkloadTruth lee únicamente señales a nivel de GPU (utilización, memoria, potencia). Nunca inspecciona pesos de modelos, datos de entrenamiento, prompts o completaciones.
- No es prueba de operación "cumplida" o "segura". El registro de auditoría prueba qué se clasificó y cuándo, y que el registro no fue alterado después, no que la clasificación fuera correcta o que se siguiera alguna política.
FAQ
¿Esto necesita una GPU NVIDIA?
Solo para el backend nvml. --backend synthetic ejecuta el clasificador completo y la CLI contra trazas sintéticas documentadas, sin necesidad de GPU. Útil para probar la herramienta o para CI.
¿Puede clasificar cargas de trabajo en GPU AMD o Intel?
Aún no. La capa de telemetría es una interfaz conectable (TelemetryBackend) específicamente para que se pueda añadir un nuevo backend de proveedor (AMD ROCm, Intel Level Zero) sin tocar el clasificador. Consulta CONTRIBUTING.md.
¿Es el clasificador lo bastante preciso como para facturar o penalizar a alguien según su salida?
Aún no, y la sección de benchmark anterior es la razón honesta: 0% de precisión en cargas de entrenamiento evasivas hoy. Trata workload_type como una señal para investigar, no como un veredicto.
¿Por qué no usar simplemente el clasificador ML del artículo? Sus pesos entrenados y su dataset nunca fueron publicados. Reimplementar un clasificador ML sin datos de entrenamiento reales produciría una afirmación de precisión no validada, no una medida. Consulta Cómo funciona la clasificación.
¿En qué se diferencia de run:ai o NVIDIA DCGM? run:ai y DCGM exponen o usan telemetría de GPU, pero ninguno clasifica el tipo de carga de trabajo a partir de esa telemetría. run:ai depende completamente de la etiqueta que el propietario del trabajo declara al enviarlo; DCGM solo expone métricas crudas de utilización y memoria para que algo más las interprete. WorkloadTruth es la capa que realmente observa la telemetría y responde la pregunta. Consulta la tabla comparativa.
¿Funciona en Windows, macOS y Linux?
El backend synthetic funciona en cualquier lugar donde se ejecute Python 3.10+, incluido el entorno de compilación macOS de este proyecto (que no tiene GPU NVIDIA). El backend nvml requiere una GPU NVIDIA y su driver, lo que en la práctica significa Linux o Windows con hardware NVIDIA; NVML no está disponible en macOS.
¿Bajo qué licencia está esto y puedo usarlo comercialmente? Apache 2.0. El uso comercial, la modificación y la redistribución están permitidos bajo sus términos; consulta LICENSE.
Contribuciones
Consulta CONTRIBUTING.md. Problemas de seguridad: consulta SECURITY.md.