OrionBelt Semantic Layer
Motor API-first y servidor MCP que transforma definiciones de modelos YAML declarativos en SQL optimizado para Postgres, Snowflake, ClickHouse, Dremio y Databricks
Documentación
OrionBelt® Capa Semántica y de Contexto, Motor de Reglas y Sidecar Semántico
Define tus métricas una vez en YAML. Deja que los agentes y las herramientas de BI las consulten sin tocar nunca tu esquema.
Un sidecar semántico: viaja junto a los sistemas que ya ejecutas en lugar de reemplazarlos.


Pídele a un LLM que escriba SQL contra un esquema de estrella en bruto y, tarde o temprano, unirá dos tablas de hechos y te dará una cifra de ingresos inflada por un factor de ocho. Parece correcta. Nadie lo detecta.
OrionBelt es una capa semántica y de contexto con un motor de reglas, y se ejecuta como un sidecar semántico. Declaras dimensiones, medidas, métricas y uniones en YAML controlado por versiones. OrionBelt las compila en SQL específico de cada dialecto a través de un AST real, y enruta consultas de múltiples hechos a través de un planificador de Capa de Hechos Compuestos que bloquea las rutas de unión que producen trampas de abanico. Los agentes y las herramientas de BI piden "Total Revenue" by "Country". Nunca ven un nombre de tabla.
Sin herramienta de BI en el medio. Sin bloqueo de tiempo de ejecución. Apúntalo a lo que ya tienes.
Cuatro formas de entrada
El mismo modelo sirve a cada superficie que ya usas. Cuatro de ellas, y un solo modelo detrás de las cuatro:
| Superficie | Puerto | Habla | Conéctate con |
|---|---|---|---|
| Cable PostgreSQL | 5432 | Protocolo Postgres | DuckDB vía ATTACH, Tableau, Dremio como fuente federada, Power BI, Superset, DBeaver, Metabase, psql |
| Arrow Flight SQL | 8815 | gRPC + Arrow | DuckDB vía adbc_scanner, Tableau y Power BI a través de los controladores JDBC/ODBC de Flight SQL, ADBC clientes (Python, Go, Java) |
| REST | 8000 | HTTP + JSON | tu código, cuadernos, curl, y los 8 controladores PEP 249 (que compilan aquí y luego ejecutan directamente en el almacén) |
| MCP | stdio / HTTP | Protocolo de Contexto de Modelo | Agentes de IA: Claude, Cursor, Copilot, Windsurf |
Ambas superficies SQL hablan OBSQL, por lo que SELECT "Region", "Total Sales" FROM sales_model es la misma consulta sin importar por cuál entres. ADBC es cómo usas la superficie Flight SQL en lugar de ser una quinta superficie propia, y DuckDB es un cliente que puede tomar cualquiera de las dos superficies SQL.
Ocho formas de salida
Compila a BigQuery, ClickHouse, Databricks, Dremio, DuckDB/MotherDuck, MySQL, PostgreSQL y Snowflake. El almacén detrás del modelo es independiente de la superficie que tiene delante: cualquiera de las cuatro superficies, contra cualquiera de los ocho dialectos.
Aquí está la consulta 98 de TPC-DS. Dos medidas sobre la misma columna, idénticas salvo por una línea: Class Revenue está fijada a un grano más grueso de lo que pide la consulta.
measures:
  Store Sales Amount:
    columns: [{dataObject: Store Sales, column: Ext Sales Price}]
    aggregation: sum

  Class Revenue:
    columns: [{dataObject: Store Sales, column: Ext Sales Price}]
    aggregation: sum
    grain: {mode: FIXED, keepOnly: [Class]}   # <- pin to Class, ignore query grain

metrics:
  Revenue Ratio:
    expression: "{[Store Sales Amount]} * 100.0 / {[Class Revenue]}"
Esa única línea grain es lo que se convierte en SUM(...) OVER (PARTITION BY "Class") a continuación.
La consulta nombra conceptos de negocio. Sin tablas, sin uniones, sin SQL:
select:
  dimensions: [Item ID, Item Description, Category, Class, Current Price]
  measures: [Store Sales Amount, Revenue Ratio]
where:
  - {field: Category, op: inlist, value: [Sports, Books, Home]}
  - {field: Order Date, op: between, value: ["1999-02-22", "1999-03-24"]}
pip install orionbelt-semantic-layer
obsl compile tpcds.obml.yml -q Q98.yml -d duckdb
WITH "base" AS (
  SELECT
    "Item"."i_item_id" AS "Item ID",
    "Item"."i_item_desc" AS "Item Description",
    "Item"."i_category" AS "Category",
    "Item"."i_class" AS "Class",
    "Item"."i_current_price" AS "Current Price",
    CAST(SUM("Store Sales"."ss_ext_sales_price") AS DECIMAL(18, 2)) AS "Store Sales Amount",
    SUM("Store Sales"."ss_ext_sales_price") AS "Class Revenue"
  FROM "main"."store_sales" AS "Store Sales"
  LEFT JOIN "main"."item" AS "Item"
    ON "Store Sales"."ss_item_sk" = "Item"."i_item_sk"
  LEFT JOIN "main"."date_dim" AS "Date"
    ON "Store Sales"."ss_sold_date_sk" = "Date"."d_date_sk"
  WHERE
    "Item"."i_category" IN ('Sports', 'Books', 'Home')
    AND "Date"."d_date" BETWEEN '1999-02-22' AND '1999-03-24'
  GROUP BY ALL
)
SELECT
  "Item ID" AS "Item ID",
  "Item Description" AS "Item Description",
  "Category" AS "Category",
  "Class" AS "Class",
  "Current Price" AS "Current Price",
  "Store Sales Amount" AS "Store Sales Amount",
  "Store Sales Amount" * 100.0 / NULLIF(SUM("Class Revenue") OVER (PARTITION BY "Class"), 0) AS "Revenue Ratio"
FROM "base" AS "base"
ORDER BY
  "Category" ASC,
  "Class" ASC,
  "Item ID" ASC,
  "Item Description" ASC,
  "Revenue Ratio" ASC
No escribiste la ruta de unión, la función de ventana sobre un agregado, la protección NULLIF, ni un solo nombre de tabla. Cambia -d duckdb a -d snowflake y los mismos dos archivos compilan para Snowflake, o para cualquiera de los ocho dialectos.
Esto está verificado, no afirmado. 40 consultas TPC-DS se construyen contra un único modelo OBML y se comparan fila por fila con el SQL de referencia de cada motor: 39 de 40 coinciden en DuckDB en sf=1, 37 de 40 en ClickHouse en sf=10. Cada una de las diferencias restantes se remonta a una variante de referencia en lugar de un error de compilación, y cada una está documentada. Consulta el barrido, o las consultas en examples/tpcds_queries/.
Dónde encaja OrionBelt
OrionBelt es un sidecar, no una plataforma. Compila un modelo YAML en SQL correcto y lo expone a través de los protocolos que ya usas. No ejecuta un clúster, no posee tu caché, ni te pide que adoptes una nube.
Usa OrionBelt cuando:
- Los agentes consulten tus datos y un número incorrecto en silencio sea inaceptable. Las consultas de múltiples hechos se enrutan a través de un planificador de Capa de Hechos Compuestos que bloquea las rutas de unión con trampas de abanico en lugar de sumar silenciosamente a través de ellas.
- Quieras tus definiciones de métricas en YAML revisable, sin JavaScript ni Python en la capa del modelo.
- Tu herramienta de BI deba conectarse a través del controlador Postgres que ya incluye, sin instalar un nuevo conector y sin tiempo de ejecución de proveedor en el camino.
- Te autoalojes, en más de un motor, y quieras un solo modelo que compile para todos ellos.
Usa otra cosa cuando:
- Necesites pre-agregación y caché afinadas para paneles de alta concurrencia a escala. Cube tiene años de endurecimiento en producción que OrionBelt no tiene.
- Tus métricas ya vivan en dbt y tu equipo esté contento allí. MetricFlow las mantiene donde están.
- Quieras un lenguaje de análisis exploratorio en lugar de una capa de servicio. Malloy es una mejor opción.
Prueba la demo en vivo con un modelo de ejemplo precargado, o abre el cuaderno de Colab y ejecútalo contra datos TPC-H.
¿Qué es una Capa de Contexto?
Una capa semántica le dice a un consumidor cómo calcular un número: qué tabla, qué unión, qué agregado. Una capa de contexto también le dice qué significa el número y qué espera el negocio de él, en una forma que un agente pueda consultar en lugar de adivinar. En OrionBelt ese contexto vive en el mismo modelo que las métricas:
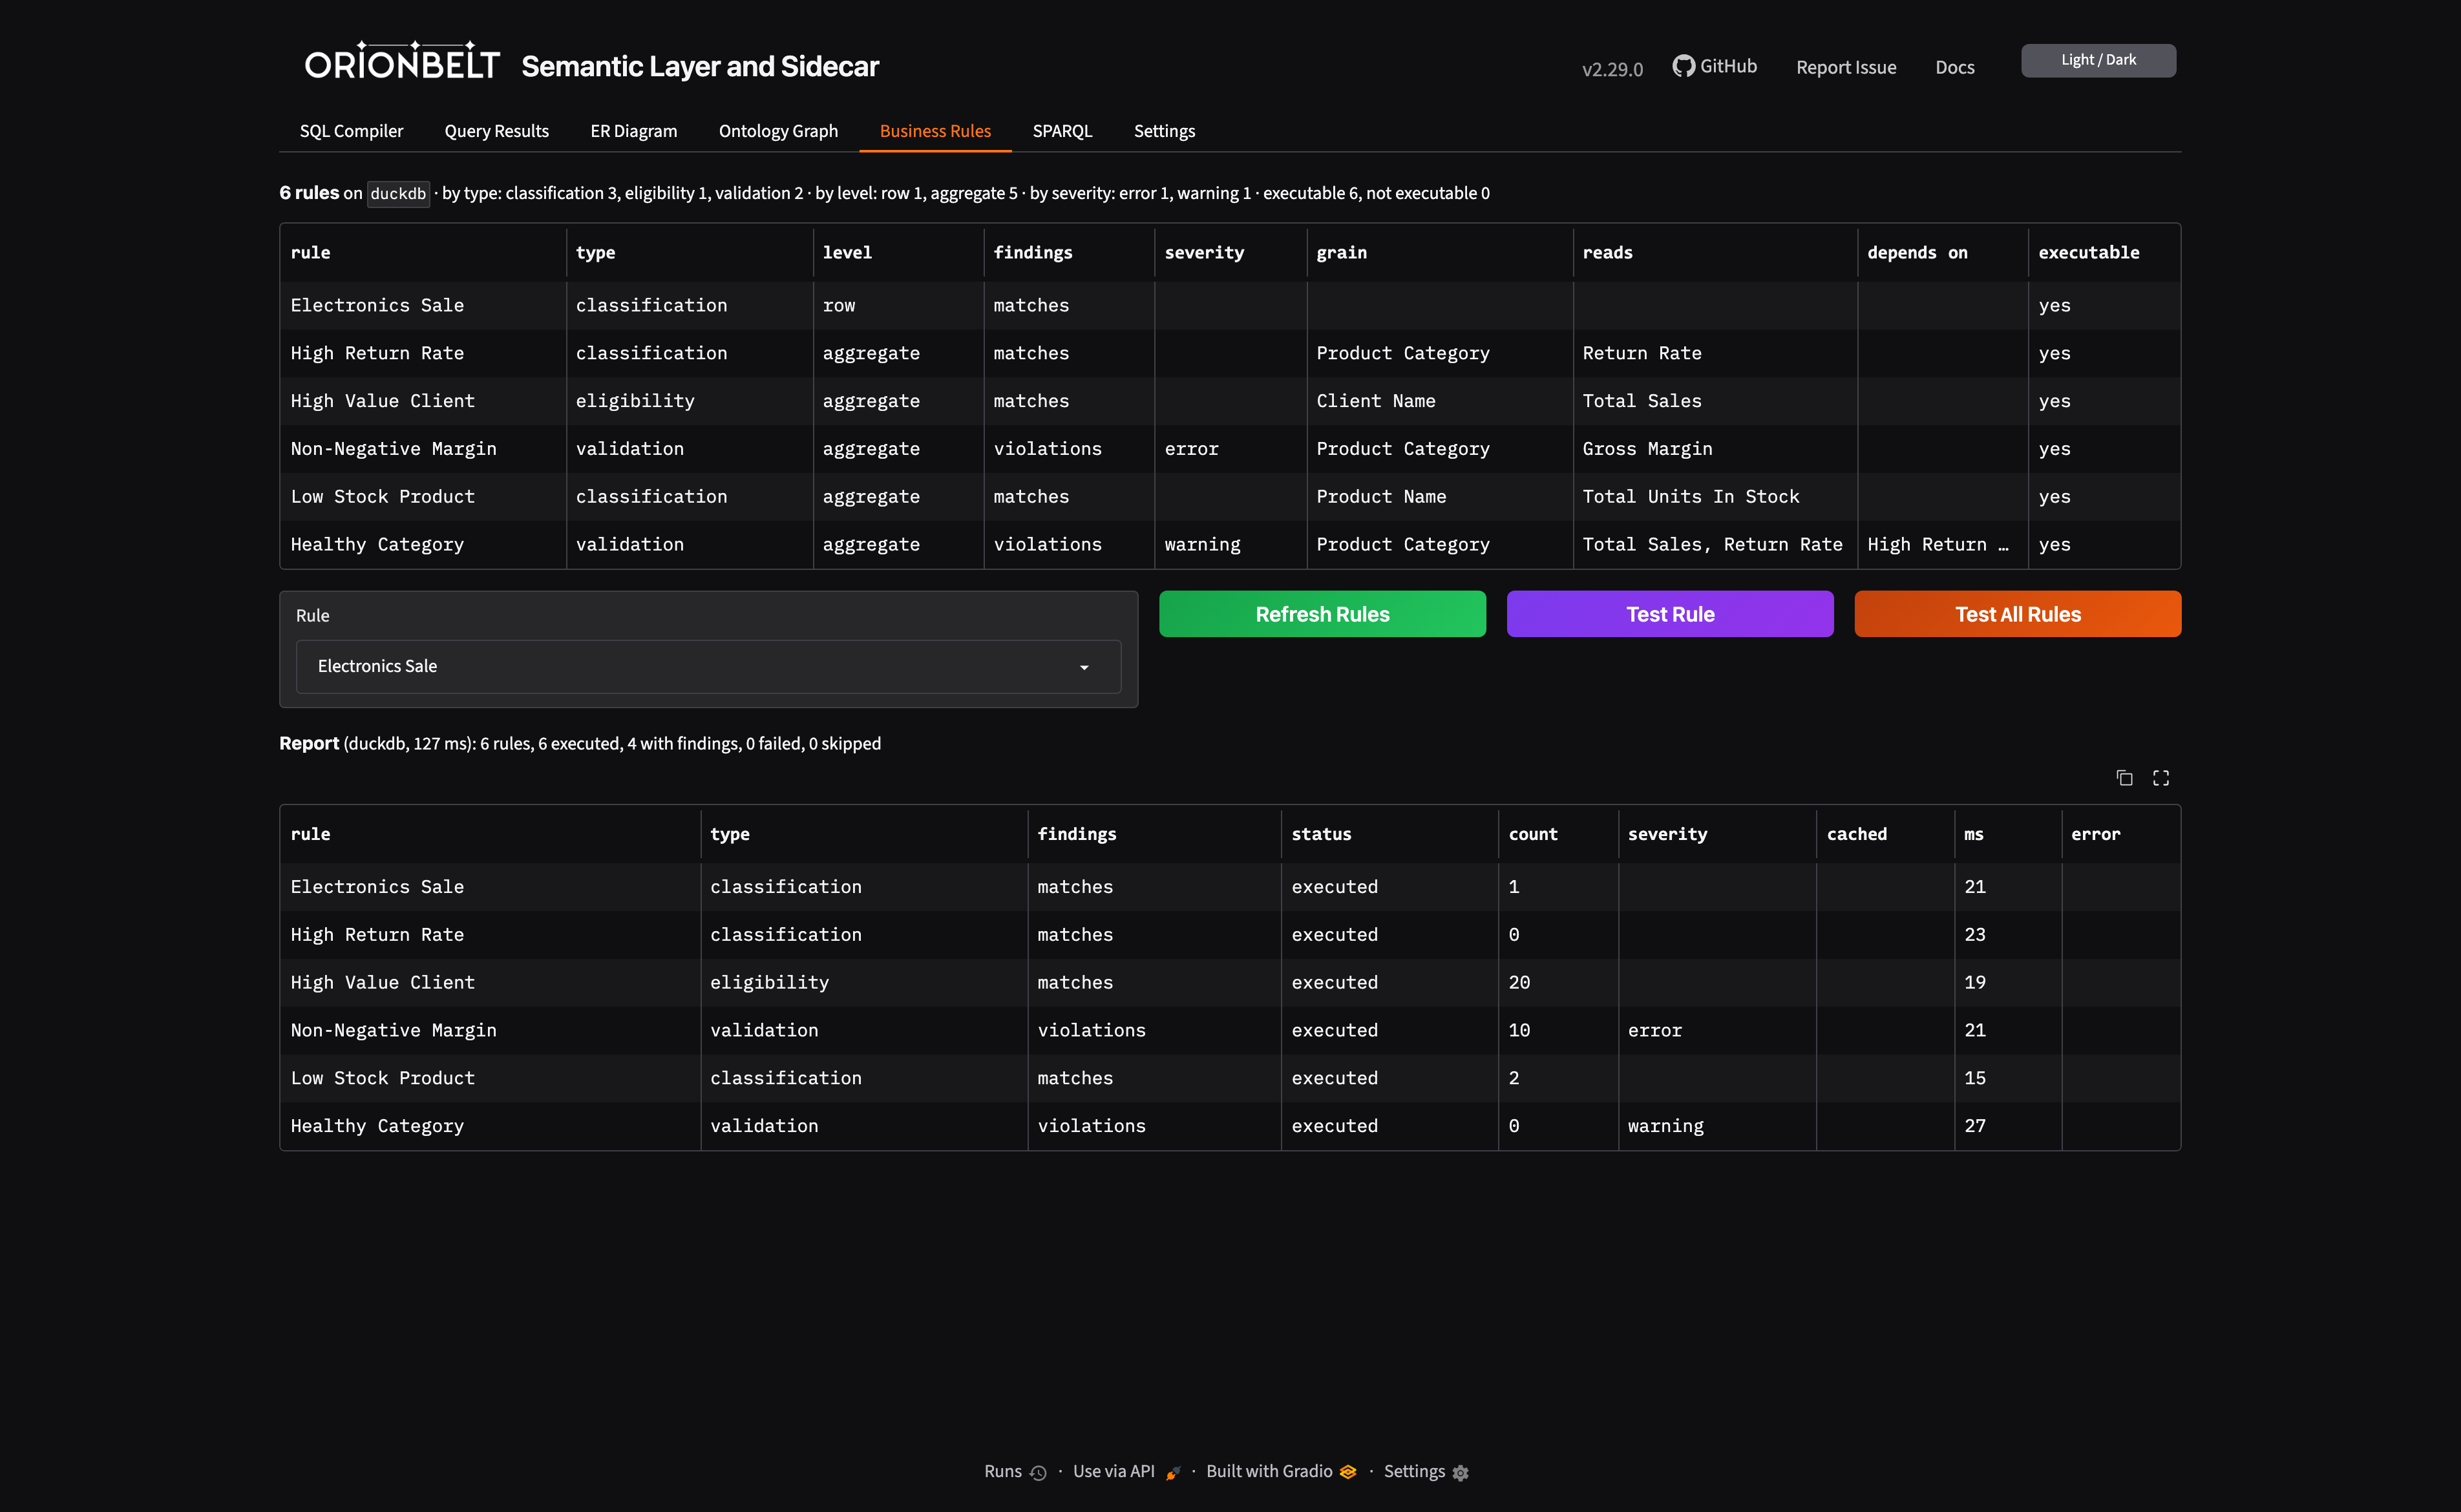
- Reglas de negocio establecen condiciones sobre las dimensiones, medidas y métricas del modelo: quién cuenta como cliente de alto valor, qué categorías no deben venderse con pérdida. El motor de reglas compila cada regla a la consulta que reporta sus miembros o violaciones, y evalúa una regla o todas a través de REST, MCP, la CLI (
obsl rules evaluate) y la interfaz de usuario. - Mapeos de conceptos externos vinculan objetos de datos, dimensiones, medidas, métricas y reglas a los conceptos que tu organización ya gobierna (schema.org, FIBO, un vocabulario interno), con procedencia.
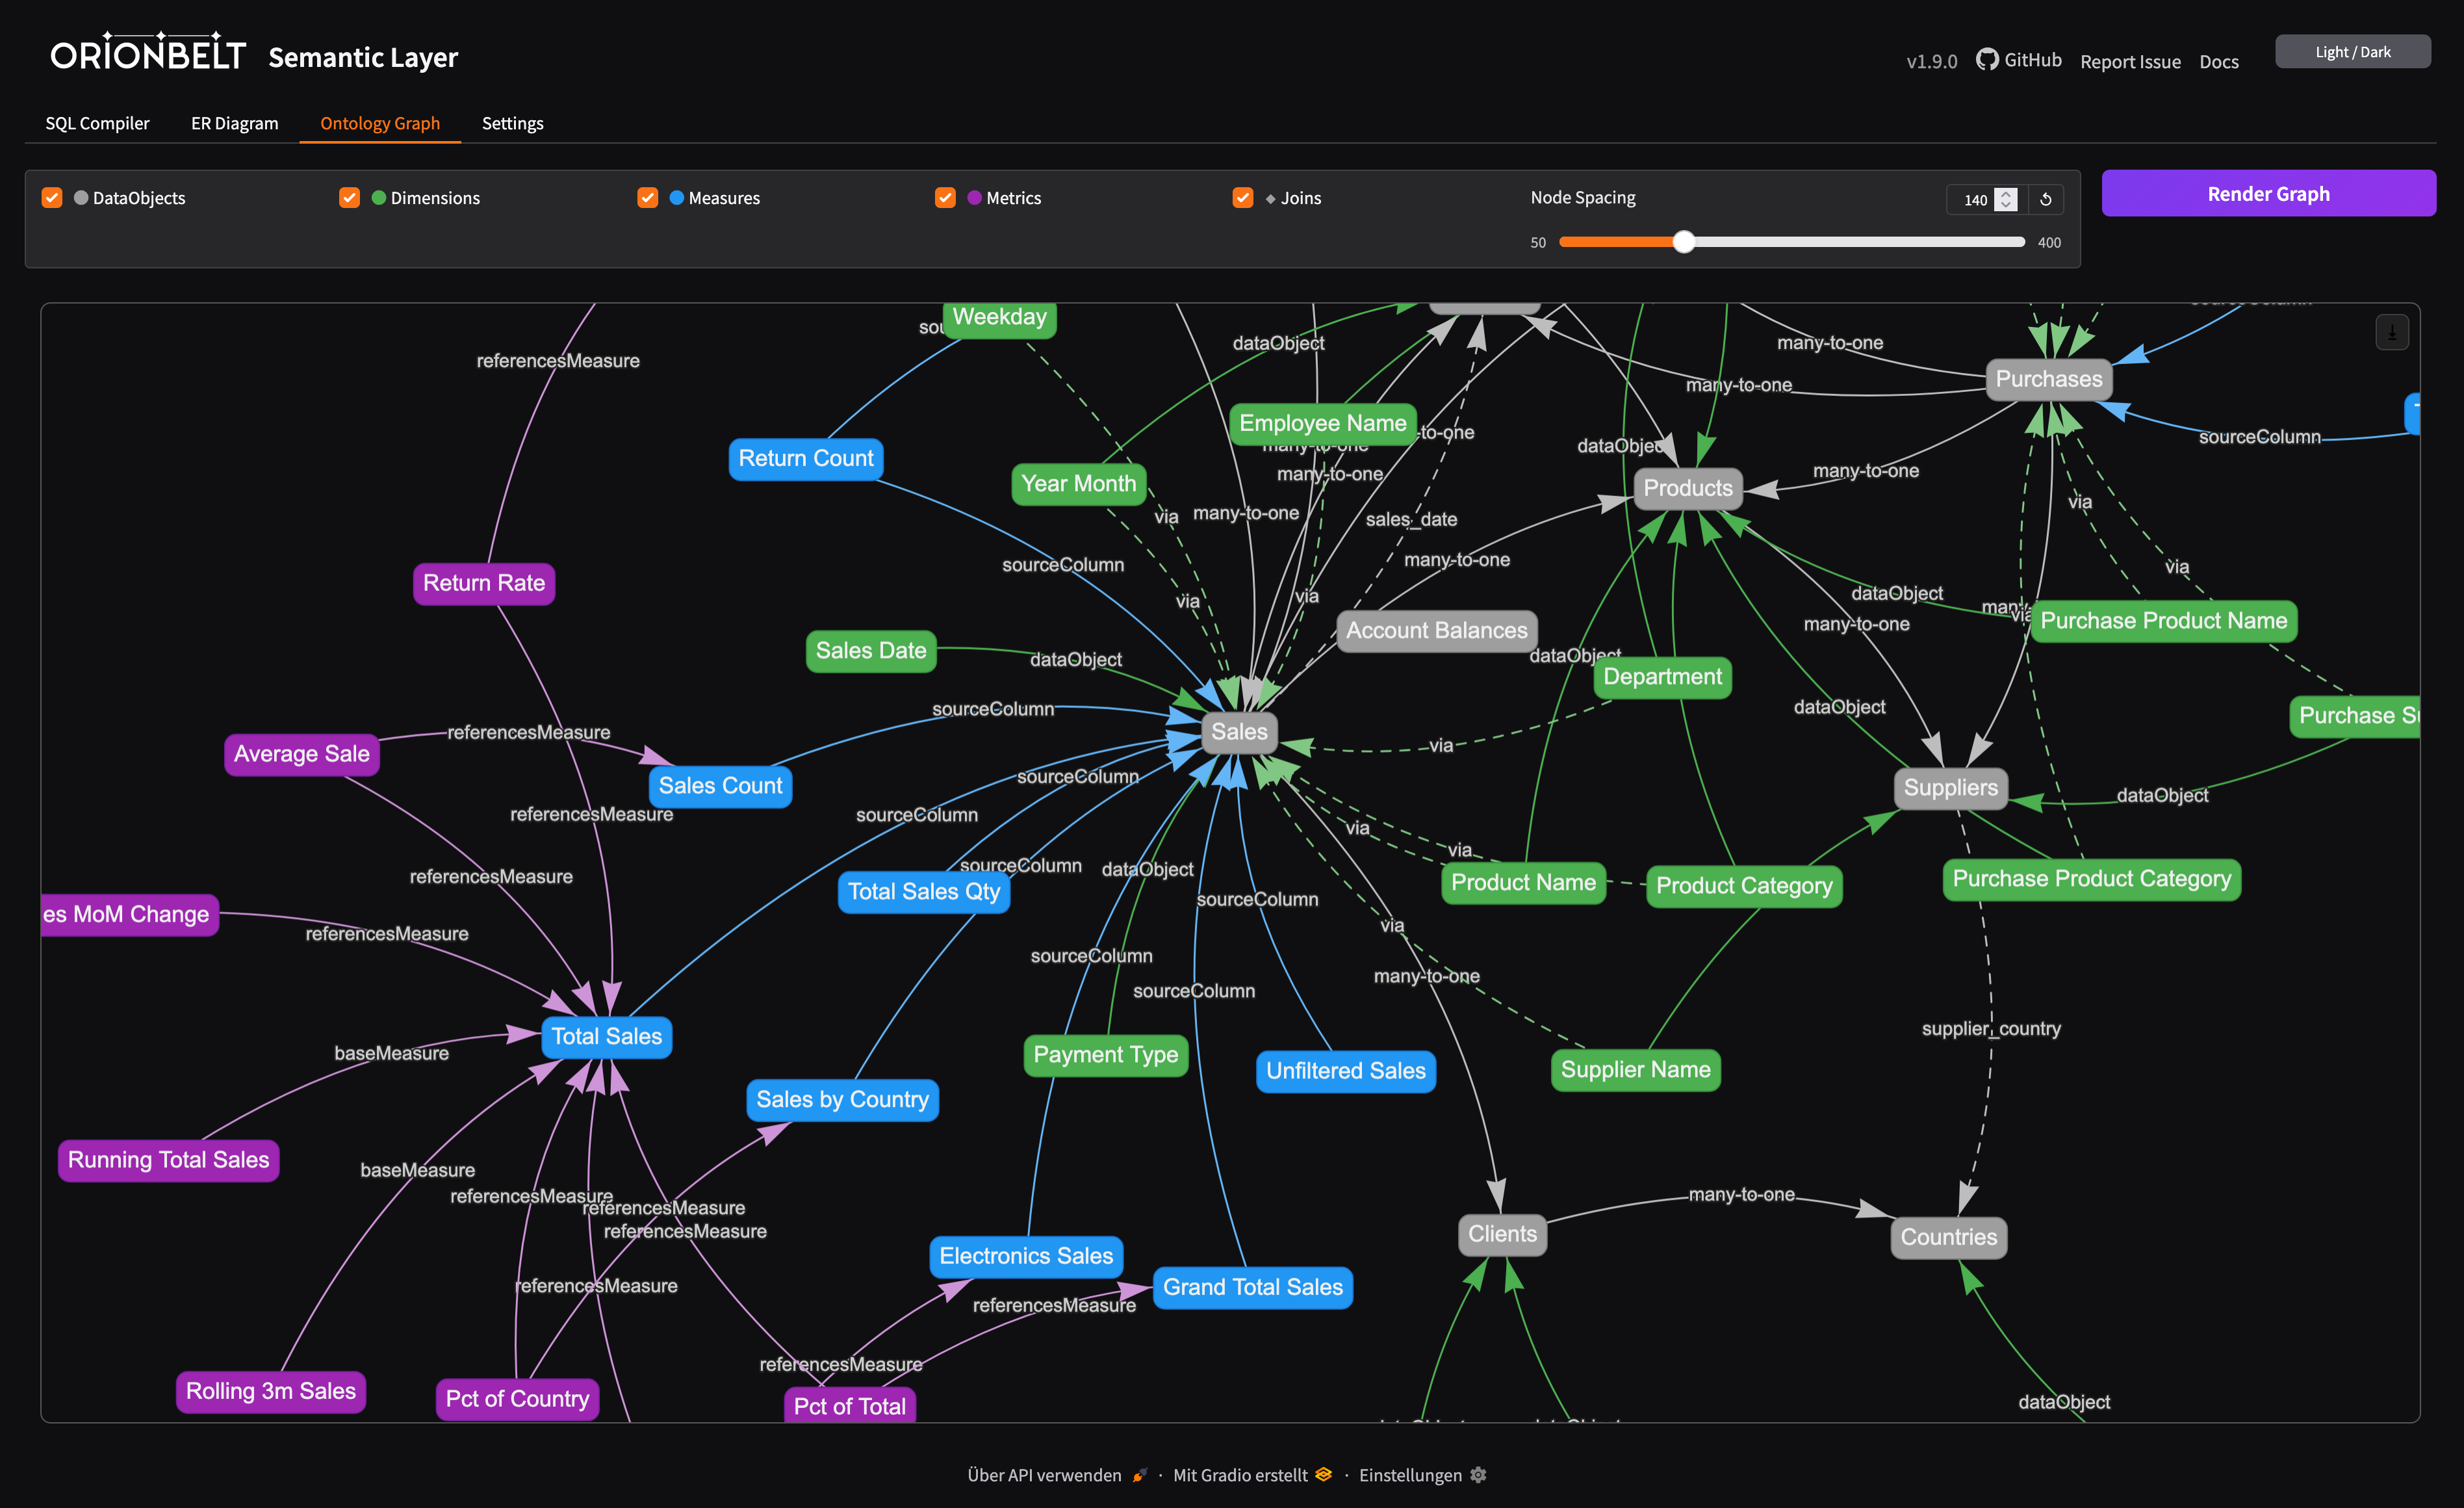
- El grafo OBSL expone cada modelo cargado como RDF, para que sus artefactos, uniones, reglas y enlaces de conceptos puedan consultarse con SPARQL.
- Linaje muestra de qué está construida una dimensión, medida, métrica, regla o consulta, hasta las tablas y las uniones que eligió el planificador, como JSON, Mermaid o Turtle enlazado al grafo OBSL, en la API, la CLI (
obsl lineage) y la interfaz de usuario. - Descripciones, sinónimos y propietarios en cada artefacto dan a los agentes el vocabulario que los usuarios realmente hablan.
Los agentes acceden a todo ello a través de MCP y REST, junto a las herramientas de consulta, para que el mismo modelo que calcula un número también pueda explicarlo. La siguiente sección muestra reglas y enlaces de conceptos en un modelo.
Significado, no solo métricas
Un modelo que solo sabe que Ventas Totales es una suma aún deja al agente adivinando qué es un cliente de alto valor, o si una categoría que vende con pérdida es un error o un hecho. Desde 2.30 el modelo también lleva eso, y es lo que hace de OrionBelt una capa de contexto además de una capa semántica: reglas de negocio, enlaces a las ontologías que tu organización gobierna, y el propio modelo como grafo RDF dan a un agente el significado detrás de los números, no solo los números.
Las reglas de negocio son condiciones sobre las propias dimensiones, medidas y métricas del modelo, sin SQL. El motor de reglas compila cada una a la consulta que reporta sus hallazgos: los miembros de una regla de clasificación o elegibilidad, las violaciones de una regla de validación o restricción.
rules:
  Non-Negative Margin:
    type: validation
    severity: error
    description: Every product category must sell for at least what it cost
    grain: [Product Category]
    condition: {field: Gross Margin, op: ">=", value: 0}
Esta regla lee una métrica, por lo que es agregada: se convierte en un HAVING a nivel de categoría a través del mismo planificador que cualquier consulta, incluida la de múltiples hechos. POST /v1/rules/{name}/evaluate devuelve las categorías infractoras para esta regla, y POST /v1/rules/evaluate ejecuta todas las reglas en un solo informe.
Los enlaces de ontología atan los artefactos a los conceptos que tu organización ya gobierna, como relaciones de mapeo SKOS con procedencia:
ontology:
  prefixes:
    schema: "https://schema.org/"

dataObjects:
  Products:
    externalConceptMappings:
      - concept: schema:Product
        relation: exact
        justification: curated
Los enlaces nunca cambian el SQL. Cambian lo que se puede preguntar: cada modelo cargado es también un grafo RDF, por lo que "qué artefactos significan un Producto de schema.org" es una consulta SPARQL, y la API de descubrimiento responde lo mismo a través de REST (/concept-mappings, su /namespaces, y la lista de brechas /unmapped).
Para un agente, esta es la diferencia entre adivinar y buscarlo. A través de MCP, list_rules, evaluate_rule y find_concept_mappings se sitúan junto a execute_query como herramientas.
Guías: Reglas de Negocio, Mapeos de Conceptos Externos, Grafo OBSL y SPARQL.
Contenido
Cuatro formas de entrada · ¿Qué es una Capa de Contexto? · Significado, no solo métricas · Pruébalo en 30 segundos · Claude Desktop / MCP · ¿Por qué OrionBelt? · Características · Ejemplo · Documentación · Hoja de ruta · Comercial · Desarrollo
Pruébalo en 30 segundos
Opción A: Demo en vivo (sin instalación)
Abre la Demo en Vivo — Interfaz Gradio con un modelo de ejemplo precargado. Pega una consulta, elige un dialecto, ve el SQL al instante.
Explorador de API: Swagger UI | ReDoc
¿Quieres probar la superficie de cable PostgreSQL? Cloud Run es solo HTTPS, por lo que la demo pública no puede exponer los puertos 5432 (pgwire) o 8815 (Flight SQL). Levanta la misma demo localmente en dos comandos: incluye el conjunto de datos DuckDB
orionbelt_1_commerceintegrado y la superficie OBSQL completa:docker run --rm -d --name orionbelt-demo \ -p 8080:8080 -p 5432:5432 -p 8815:8815 \ -e PGWIRE_ENABLED=true \ -e FLIGHT_ENABLED=true \ ralforion/orionbelt-semantic-layer-api:latest # REST + Interfaz Gradio: http://localhost:8080/ui # pgwire (cualquier psql / DBeaver / Tableau / Power BI): psql "host=localhost port=5432 user=obsl dbname=orionbelt_1_commerce sslmode=disable" \ -c 'SELECT "Client Name", "Total Sales" LIMIT 5' # Prueba de humo de Flight SQL: uv run python examples/obsql.py 'SELECT "Client Name", "Total Sales" LIMIT 5' docker stop orionbelt-demoEl contenedor incluye
PGWIRE_AUTH_MODE=trust(por defecto), por lo que es seguro paralocalhostpero no es seguro exponerlo a la internet pública. Para implementaciones expuestas, estableceAUTH_MODE=api_key(incluido en v2.12.0): pgwire entonces negocia SCRAM-SHA-256 (o texto claro sobre TLS) contra el almacén de claves compartido.
Opción B: Google Colab (sin instalación)
 — Cuaderno interactivo con datos TPC-H: explora el modelo, compila consultas entre dialectos, ejecuta contra DuckDB y ve los resultados. Requiere tiempo de ejecución de Python 3.12.
Opción C: Instalar desde PyPI
pip install orionbelt-semantic-layer
Luego pega en un REPL de Python:
from orionbelt.parser import ReferenceResolver, TrackedLoader
from orionbelt.compiler.pipeline import CompilationPipeline
from orionbelt.models.query import QueryObject, QuerySelect

model_yaml = """
version: 1.0
dataObjects:
  Orders:
    code: ORDERS
    columns:
      Price: { code: PRICE, abstractType: float }
      Country: { code: COUNTRY, abstractType: string }
dimensions:
  Country:
    dataObject: Orders
    column: Country
    resultType: string
measures:
  Total Revenue:
    resultType: float
    aggregation: sum
    expression: "{[Orders].[Price]}"
"""

loader = TrackedLoader()
raw, source_map = loader.load_string(model_yaml)
resolver = ReferenceResolver()
model, result = resolver.resolve(raw, source_map)

query = QueryObject(select=QuerySelect(dimensions=["Country"], measures=["Total Revenue"]))
pipeline = CompilationPipeline()
output = pipeline.compile(query, model, "postgres")
print(output.sql)
Salida:
SELECT
  "Orders"."COUNTRY" AS "Country",
  CAST(SUM("Orders"."PRICE") AS NUMERIC(18, 2)) AS "Total Revenue"
FROM ORDERS AS "Orders"
GROUP BY "Orders"."COUNTRY"
No se necesita archivo de entorno: la canalización de compilación no tiene estado.
Inicia los servidores:
orionbelt-api                              # REST API on :8000 (Swagger UI at /docs, Gradio UI at /ui)
orionbelt-ui                               # standalone Gradio UI on :7860 (connects to API on :8000)
FLIGHT_ENABLED=true orionbelt-api          # API + Arrow Flight SQL on :8815 (DBeaver, Tableau, Power BI)
PGWIRE_ENABLED=true orionbelt-api          # API + PostgreSQL wire on :5432 (Tableau, DBeaver, Superset, psql, Dremio source)
Opción C2: Instalar con uv
uv pip install orionbelt-semantic-layer
uv run orionbelt-api                       # REST API on :8000 (Swagger UI at /docs, Gradio UI at /ui)
uv run orionbelt-ui                        # standalone Gradio UI on :7860 (connects to API on :8000)
FLIGHT_ENABLED=true uv run orionbelt-api   # API + Arrow Flight SQL on :8815 (DBeaver, Tableau, Power BI)
PGWIRE_ENABLED=true uv run orionbelt-api   # API + PostgreSQL wire on :5432 (Tableau, DBeaver, Superset, psql, Dremio source)
Usa la CLI obsl (no se necesita servidor: compila en proceso):
obsl validate model.yaml                                  # lint a model (exit 1 on error, CI-friendly)
obsl compile model.yaml -q query.json -d snowflake        # print the generated SQL
obsl compile model.yaml --sql 'SELECT "Region", "Sales" FROM model'  # ... or from an OBSQL string
obsl describe model.yaml                                   # overview of data objects + artefacts
obsl diagram model.yaml                                    # Mermaid ER diagram
obsl convert obml-to-osi model.yaml                        # OBML -> OSI (and osi-to-obml)
obsl execute -q query.json --server http://host           # run against a deployed model (omit MODEL)
Consulta la guía de CLI para todos los comandos.
Prueba de humo de la superficie Flight SQL sin herramienta de BI:
uv run python examples/obsql.py 'SELECT version()'
uv run python examples/obsql.py 'SHOW TABLES'
uv run python examples/obsql.py 'SELECT "Region", "Total Sales" FROM sales LIMIT 5'

# Multi-model deployment? Pick the model with -m:
uv run python examples/obsql.py -m sales 'SHOW TABLES'
uv run python examples/obsql.py --list   # discover loaded models via REST
Prueba OBSQL en 30 segundos
OBSQL — OrionBelt Semantic QL — es la superficie SQL que las herramientas de BI y los humanos realmente escriben. Etiquetas simples, marcadores MEASURE(), o envoltorios de agregación coincidentes; validación de coincidencia de agregación; WITH ROLLUP / WITH CUBE; sin vía de escape al SQL crudo del almacén. El mismo lenguaje sobre Arrow Flight SQL (v2.4+) y PostgreSQL wire (v2.5+):
PGWIRE_ENABLED=true uv run orionbelt-api &

# Every BI tool already ships a Postgres ODBC/JDBC driver — point yours at :5432
psql "host=localhost port=5432 user=obsl dbname=sales sslmode=disable" \
  -c 'SELECT "Region", "Total Sales" LIMIT 5'

# All three measure forms compile to the same vendor SQL:
psql "..." -c 'SELECT "Region", "Total Sales"        FROM sales LIMIT 5'  -- bare
psql "..." -c 'SELECT "Region", MEASURE("Total Sales") FROM sales LIMIT 5'  -- explicit marker
psql "..." -c 'SELECT "Region", SUM("Total Sales")   FROM sales LIMIT 5'  -- matching aggregate
Consulta la referencia de OBSQL para la gramática completa.
Opción D: Docker
Etapa 1 — Inicio sin configuración (los modelos se cargan más tarde vía API o interfaz):
docker run -p 8080:8080 ralforion/orionbelt-semantic-layer-api
Abre http://localhost:8080/docs para explorar la API.
Etapa 2 — Configuración realista con docker compose:
# docker-compose.yml
services:
  api:
    image: ralforion/orionbelt-semantic-layer-api:2.32.0
    ports: ["8080:8080"]
    env_file: .env
    volumes:
      - ./models:/app/models:ro
    environment:
      MODEL_FILES: /app/models/my-model.obml.yml

  ui:
    image: ralforion/orionbelt-semantic-layer-ui:2.32.0
    ports: ["7860:7860"]
    environment:
      API_BASE_URL: http://api:8080
docker compose up -d
Consulta .env.template para la referencia completa de variables de entorno.
Notas de Docker:
API_SERVER_HOSTya está0.0.0.0dentro del contenedor — no se necesita anulación.- MCP vía stdio no funciona en Docker. Usa el cliente MCP HTTP para despliegues contenedorizados.
- Monta los modelos en
/app/models(o cualquier ruta) y estableceMODEL_FILES(rutas separadas por comas) para precargarlos al inicio.- Para producción, fija una etiqueta de versión (
:2.32.0) en lugar de:latest.
Claude Desktop / MCP
El servidor MCP es un cliente ligero separado que delega en la API REST:
Añádelo a tu claude_desktop_config.json de Claude Desktop:
{
  "mcpServers": {
    "orionbelt": {
      "command": "uvx",
      "args": ["orionbelt-semantic-layer-mcp"]
    }
  }
}
También funciona con Copilot, Cursor y Windsurf. Consulta el repositorio MCP para las opciones completas de configuración.
¿Por qué OrionBelt?
| OrionBelt | dbt Semantic Layer | Cube | Malloy | |
|---|---|---|---|---|
| Formato de modelo | Solo YAML (OBML) | Python + YAML | JavaScript | DSL personalizado |
| Generación de SQL | Basada en AST (segura contra inyección) | Plantillas de cadenas | Plantillas de cadenas | Compilador |
| Multi-dialecto | 8 dialectos, sin bloqueo en tiempo de ejecución | Requiere dbt Cloud | Cube Cloud o autoalojado | Enfocado en BigQuery |
| Consultas multi-hecho | Star Schema + planificador CFL (prevención de fan-trap) | Limitado | Pre-agregaciones | Uniones automáticas |
| Superficie de integración | API REST + MCP + interfaz Gradio | API de dbt Cloud | REST + GraphQL | Extensión de VS Code |
| Despliegue | Autoalojado en cualquier lugar, binario único | SaaS (Cloud) | SaaS o autoalojado | Biblioteca |
| Licencia | BUSL-1.1 (convierte a Apache 2.0) | Apache 2.0 | AGPL / propietaria | MIT |
| Significado de negocio en el modelo | Reglas compiladas en la consulta que informa sus hallazgos; enlaces SKOS a una ontología externa | Pruebas de datos a nivel de columna; meta de forma libre | meta de forma libre (ai_context) | Anotaciones, sin interpretar |
Características
Modelado Semántico
- Formato OBML — modelos semánticos basados en YAML con objetos de datos, dimensiones, medidas, métricas y uniones
- Consultas entre esquemas — modela objetos de datos en múltiples bases de datos y esquemas en un solo modelo
- Filtros estáticos de modelo — condiciones WHERE obligatorias integradas en el modelo, aplicadas automáticamente con extensión de unión
- Reglas de negocio —
rulesdeclarativos sobre dimensiones, medidas y métricas (clasificación, elegibilidad, validación, restricción) sin SQL; compilados en la consulta que informa sus hallazgos, probados uno a la vez o todos a la vez en un informe, listados y evaluados desde la pestaña de Reglas de negocio de la interfaz - Grafo OBSL y SPARQL — exportación de grafo RDF y consultas SPARQL de solo lectura para cada modelo cargado; los mapeos de conceptos externos vinculan objetos de datos, dimensiones, medidas y métricas a una ontología de negocio (FIBO, schema.org, un glosario corporativo) como coincidencias SKOS
- Interoperabilidad OSI — conversión bidireccional entre OBML y el formato Open Semantic Interchange, ahora desarrollado como Apache Ossie (incubando)
Compilación SQL
- 8 dialectos SQL — BigQuery, ClickHouse, Databricks, Dremio, DuckDB/MotherDuck, MySQL, Postgres, Snowflake
- Generación basada en AST — AST SQL personalizado garantiza SQL correcto y seguro contra inyección (no plantillas de cadenas)
- Star Schema y CFL — resolución automática de uniones con Composite Fact Layer para consultas multi-hecho
- Tipos de datos y precisión — envoltura automática de CAST con renderizado de tipos específico por dialecto y limitación de precisión
- Formato de visualización — patrones de formato numérico (
#,##0.00,0.00%) en medidas/métricas con renderizado sensible a la configuración regional - Configuración de zona horaria — detección automática de la zona horaria de la sesión de base de datos con respaldo
defaultTimezoney serialización ISO 8601 - Validación con sqlglot — verificación de sintaxis posterior a la generación en todos los dialectos compatibles
Superficie de integración
- API REST — endpoints FastAPI para gestión de modelos, validación, compilación y ejecución
- Servidor MCP — cliente ligero separado para Claude, Copilot, Cursor, Windsurf
- Integraciones de IA — LangChain, OpenAI Agents SDK, CrewAI, Google ADK, Vercel AI SDK, n8n, ChatGPT
- Interfaz Gradio — interfaz web interactiva para edición de modelos, pruebas de consultas y diagramas ER
- DB-API 2.0 + Flight SQL — controladores PEP 249 y servidor Arrow Flight SQL para DBeaver, Tableau, Power BI; incluye
examples/obsql.py, una pequeña CLI de terminal para probar la superficie Flight sin una herramienta de BI - DuckDB como cliente (v2.27.1+) — un shell DuckDB simple consulta la capa, sobre cualquiera de las dos superficies.
ATTACH ... (TYPE postgres)monta el modelo como una tabla (SELECT ... FROM obsl.sales.model, unSET pg_use_text_protocol = trueprimero); la extensión comunitariaadbc_scannerlo hace sobre Flight SQL con Arrow en todo el camino. Las medidas gobernadas se unen a tablas locales y llegan aCREATE TABLE AS. Guía - Protocolo PostgreSQL Wire (v2.5.0+) — superficie nativa de protocolo Postgres en
:5432. Cada herramienta de BI ya incluye un controlador ODBC/JDBC de Postgres, así que el lado del usuario es "apunta tu conexión existente a OBSL y listo" — Tableau, DBeaver, Superset, Power BI,psqlsimple, y Dremio como fuente Postgres federada (Dremio → OBSL → opcionalmente de vuelta al lakehouse de Dremio, círculo completo)
API orientada a agentes
- Salud del modelo al cargar — cada carga de modelo devuelve un bloque
healthcon objetos de datos huérfanos, riesgos de fan-trap y dimensiones inalcanzables — los agentes omiten el segundo viaje de ida y vuelta defensivo - Endpoint de plan de consulta —
POST /query/plandevuelve la comprensión del planificador (elección de planificador, tablas físicas, ruta de unión,would_compile) sin compilar SQL ni ejecutar;include_database_explainopcional añade el EXPLAIN crudo del almacén - Advertencias estructuradas — cada lista
warningsen toda la API usa una forma estable{code, severity, message, path, hint, context}con una taxonomía de códigos documentada; los agentes ramifican según códigos en lugar de analizar mensajes - Recuperación difusa de
/find— cuando una búsqueda no produce coincidencias exactas o de sinónimos, el respaldo determinista de Levenshtein + trigramas devuelve candidatos cercanos con puntuaciones y razones - Ejemplos de modelo — bloque OBML opcional
examples:de consultas canónicas;GET /examples(con filtrado?intent=) da a los agentes descubrimiento en un solo viaje de ida y vuelta de lo que un modelo está diseñado para responder
Caché de resultados basada en frescura
- Contratos de frescura a nivel de fuente — declara bloques
refresh:en entradasdataObject(intervalo / latido / estático); el caché deriva los TTL de consulta de los contratos de las tablas físicas que una consulta tocó, no de suposiciones del llamador - Invalidación por latido — un
POST /v1/heartbeata una tabla física invalida cada consulta en caché que depende de ella, en cada objeto de datos y sesión - Metadatos DuckDB + resultados Parquet — caché respaldado por archivos con serialización precisa de tipos, expiración perezosa, barrido de capacidad LRU; opcional vía
CACHE_BACKEND=file - Invierte el patrón de Cube/dbt/Looker — los contratos viven en la fuente, no en la abstracción semántica; una sola fuente de verdad en cada cubo/exploración/consulta guardada que lee la tabla
Experiencia de desarrollo
- Errores con posición de origen — los errores de validación informan la línea y columna exactas del YAML
- Diagramas ER — diagramas Mermaid interactivos con zoom y descarga (MD/PNG/Turtle)
- Gestión de sesiones — sesiones con alcance TTL y aislamiento de modelos seguro para hilos
- JSON Schema — esquema completo de OBML y consultas para autocompletado en IDE (
yaml-language-server)
Ejemplo
Definir un modelo semántico (OBML)
# yaml-language-server: $schema=https://raw.githubusercontent.com/ralforion/orionbelt-semantic-layer/main/schema/obml-schema.json
version: 1.0
dataObjects:
  Customers:
    code: CUSTOMERS
    database: WAREHOUSE
    schema: PUBLIC
    columns:
      Customer ID: { code: CUSTOMER_ID, abstractType: string }
      Country:     { code: COUNTRY, abstractType: string }

  Orders:
    code: ORDERS
    database: WAREHOUSE
    schema: PUBLIC
    columns:
      Order Customer ID: { code: CUSTOMER_ID, abstractType: string }
      Price:             { code: PRICE, abstractType: float }
      Quantity:          { code: QUANTITY, abstractType: int }
    joins:
      - joinType: many-to-one
        joinTo: Customers
        columnsFrom: [Order Customer ID]
        columnsTo: [Customer ID]

dimensions:
  Country:
    dataObject: Customers
    column: Country
    resultType: string

measures:
  Revenue:
    resultType: float
    aggregation: sum
    expression: "{[Orders].[Price]} * {[Orders].[Quantity]}"
    dataType: "decimal(18, 2)"
Compilar vía API REST
# Create a session
curl -s -X POST http://localhost:8080/v1/sessions | jq .session_id
# -> "a1b2c3d4"

# Load the model
curl -s -X POST http://localhost:8080/v1/sessions/a1b2c3d4/models \
  -H "Content-Type: application/json" \
  -d '{"model_yaml": "..."}' | jq .model_id
# -> "abcd1234"

# Compile a query
curl -s -X POST http://localhost:8080/v1/sessions/a1b2c3d4/query/sql \
  -H "Content-Type: application/json" \
  -d '{"model_id":"abcd1234","query":{"select":{"dimensions":["Country"],"measures":["Revenue"]}},"dialect":"postgres"}' \
  | jq -r .sql
SQL generado (Postgres)
SELECT
  "Customers"."COUNTRY" AS "Country",
  CAST(SUM("Orders"."PRICE" * "Orders"."QUANTITY") AS NUMERIC(18, 2)) AS "Revenue"
FROM WAREHOUSE.PUBLIC.ORDERS AS "Orders"
LEFT JOIN WAREHOUSE.PUBLIC.CUSTOMERS AS "Customers"
  ON "Orders"."CUSTOMER_ID" = "Customers"."CUSTOMER_ID"
GROUP BY "Customers"."COUNTRY"
Cambia dialect a bigquery, clickhouse, databricks, dremio, duckdb, mysql, o snowflake para SQL específico por dialecto.
Interfaz Gradio
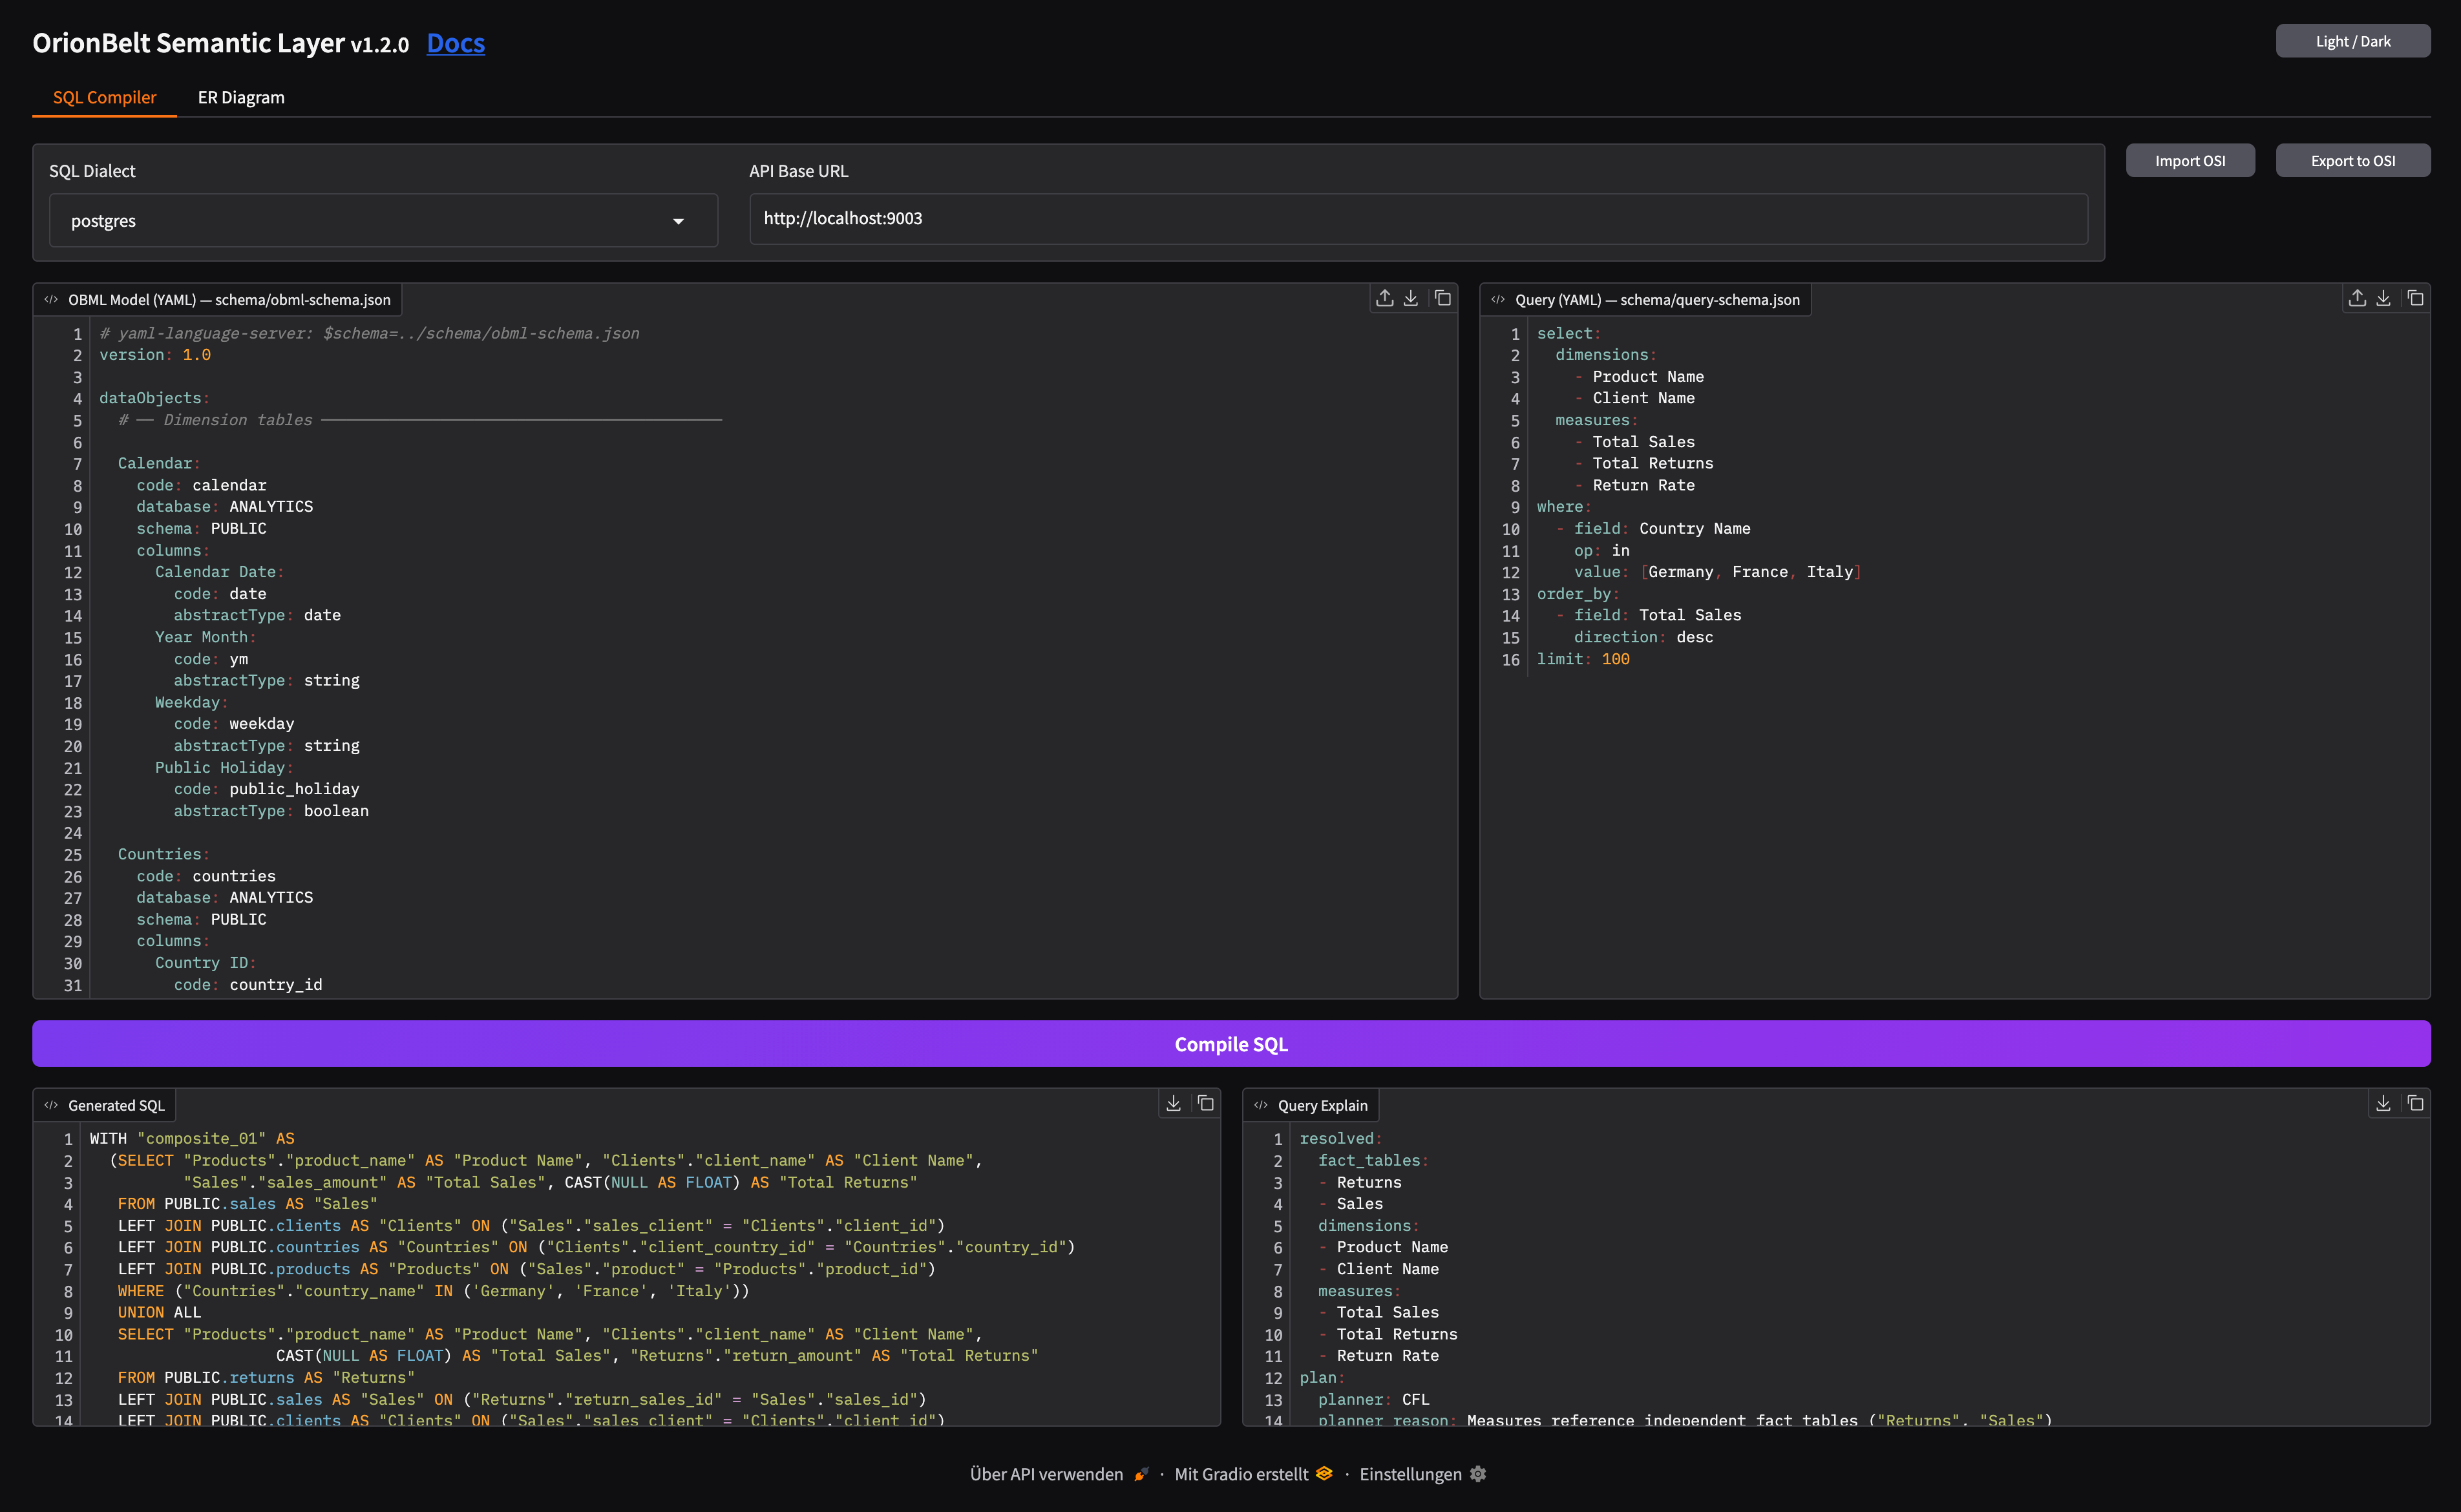
- Compilador SQL — editores de modelo OBML y consulta lado a lado con resaltado de sintaxis, selector de 8 dialectos, compilación con un clic con salida SQL formateada y explicación de consulta
- Ejecución de consultas — ejecuta consultas compiladas contra una base de datos conectada, visualiza resultados con formato numérico sensible a la configuración regional, panel de metadatos de respuesta, descarga TSV y copia al portapapeles (requiere
QUERY_EXECUTE=true) - Diagrama ER — diagrama ER Mermaid interactivo con zoom, alternancia de columnas y descarga (MD/PNG/Turtle)
- Grafo de ontología — visualización interactiva vis-network del grafo OBML (objetos de datos, dimensiones, medidas, métricas, uniones) con capas alternables y espaciado de nodos ajustable
- Reglas de negocio: las reglas del modelo con estadísticas; haz clic en una fila para seleccionarla, muestra su definición OBML, pruébala o prueba todas las reglas en un informe
- SPARQL: SELECT / ASK de solo lectura sobre el grafo OBSL del modelo, en un editor con resaltado de sintaxis SPARQL y una galería de ejemplos listos para ejecutar
- Barra de herramientas del editor — botones de limpiar, deshacer, rehacer, subir, descargar y copiar en todos los editores de código
- Importar/Exportar OSI — convierte entre formatos OBML y OSI
- Modo oscuro/claro — alterna mediante el botón del encabezado, estado persistente entre sesiones
Modo integrado — la interfaz está montada en /ui en el servidor API:
pip install orionbelt-semantic-layer && orionbelt-api
# -> UI at http://localhost:8000/ui
Modo independiente — ejecuta API e interfaz como procesos separados:
orionbelt-api                                              # API on :8000
orionbelt-ui                                               # UI on :7860 (connects to API on :8000)
API_BASE_URL=http://remote-api:8080 orionbelt-ui           # point UI to a remote API
Documentación
| Tema | Enlace |
|---|---|
| Sitio completo de documentación | ralforion.com/orionbelt-semantic-layer |
| Instalación | getting-started/installation |
| Inicio rápido | getting-started/quickstart |
| Docker e implementación | getting-started/docker |
| Desarrollo | getting-started/development |
| Formato de modelo OBML | guide/model-format |
| Lenguaje de consulta | guide/query-language |
| Dialectos SQL | guide/dialects |
| Métricas período a período | guide/period-over-period |
| Análisis de tendencias (rank / lag / lead / ntile, medias móviles particionadas, agregados estadísticos) | guide/trend-analysis |
| Canal de compilación | guide/compilation |
| Grafo OBSL y SPARQL | guide/obsl |
| Reglas de negocio | guide/business-rules |
| Mapeos de conceptos externos | guide/concept-mappings |
| Interfaz Gradio | guide/ui |
| Integraciones de IA | guide/integrations |
| Interoperabilidad OSI | guide/osi |
| Endpoints de la API REST | api/endpoints |
| Controladores DB-API y Flight SQL | drivers |
| Arquitectura | reference/architecture |
| Configuración | reference/configuration |
| Recorrido por el modelo de ventas | examples/sales-model |
| Salida multi-dialecto | examples/multi-dialect |
| Multi-hecho: ventas y devoluciones | examples/multi-fact |
| Benchmark TPC-DS | examples/tpcds |
| Cuaderno de inicio rápido | examples/quickstart.ipynb |
| Comparación: visión general | comparison/ |
| Comparación: vs. dbt Semantic Layer | comparison/dbt |
| Comparación: vs. Malloy | comparison/malloy |
| Comparación: vs. LookML / Looker | comparison/lookml |
| Comparación: vs. Cube | comparison/cube |
| Comparación: vs. AtScale | comparison/atscale |
Estado y hoja de ruta
| Estado | Área |
|---|---|
| Publicado | 8 dialectos SQL, API REST, servidor MCP, interfaz Gradio, controladores DB-API, Flight SQL, protocolo wire de PostgreSQL (v2.5.0+) — Tableau / DBeaver / Superset / Power BI / psql / Dremio como fuente Postgres federada, OBSL/SPARQL, interoperabilidad OSI v0.2 con validación de esquemas bidireccional, integraciones de IA (LangChain, CrewAI, ADK, etc.), herencia y extensión de modelos, tipos de datos y precisión numérica, ajustes de zona horaria, anulaciones de contexto de grano y filtro, Análisis de tendencias — ventanas móviles particionadas, MetricType.WINDOW para rank/lag/lead/ntile, 9 agregados estadísticos (CORR, COVAR_, REGR_, STDDEV_, VAR_), Autenticación unificada (v2.12.0) en REST / Flight / pgwire / UI — AUTH_MODE=api_key con almacén de claves compartido, pgwire SCRAM-SHA-256 + texto claro, Resolución de componibilidad de artefactos (ACR, v2.14.0): un endpoint composables que, dada la consulta hasta el momento, devuelve qué dimensiones / medidas / métricas aún se pueden añadir (incluidos candidatos CFL), lo que permite la construcción guiada de consultas |
| Planificado | Autenticación OIDC / SSO y ámbitos de autorización por token, CLI para automatización y CI/CD, generación de vistas DDL (CREATE VIEW a partir de consultas), dialectos adicionales, integraciones adicionales de herramientas de BI, capa de preagregación / materialización |
Ofertas comerciales
OrionBelt Semantic Layer está disponible con código fuente bajo BUSL-1.1 hasta su conversión a Apache-2.0: la distribución gratuita tiene plena paridad en la superficie publicada v2.6 y es de grado de producción para uso autoalojado. Para equipos que deseen soporte de producción, un runtime gestionado o condiciones de analítica integrada, RALFORION ofrece:
- Licencia de analítica integrada — condiciones de relicencia para distribuir OBSL dentro de un producto comercial
- Oferta de nube comercial — runtime gestionado de OrionBelt con SLA
- Funciones empresariales — capacidades adaptadas para implementaciones empresariales
- Consultoría y soporte — implementación, modelado y soporte de producción
Contacte con RALFORION d.o.o. para más detalles.
Proyecto complementario
OrionBelt Analytics
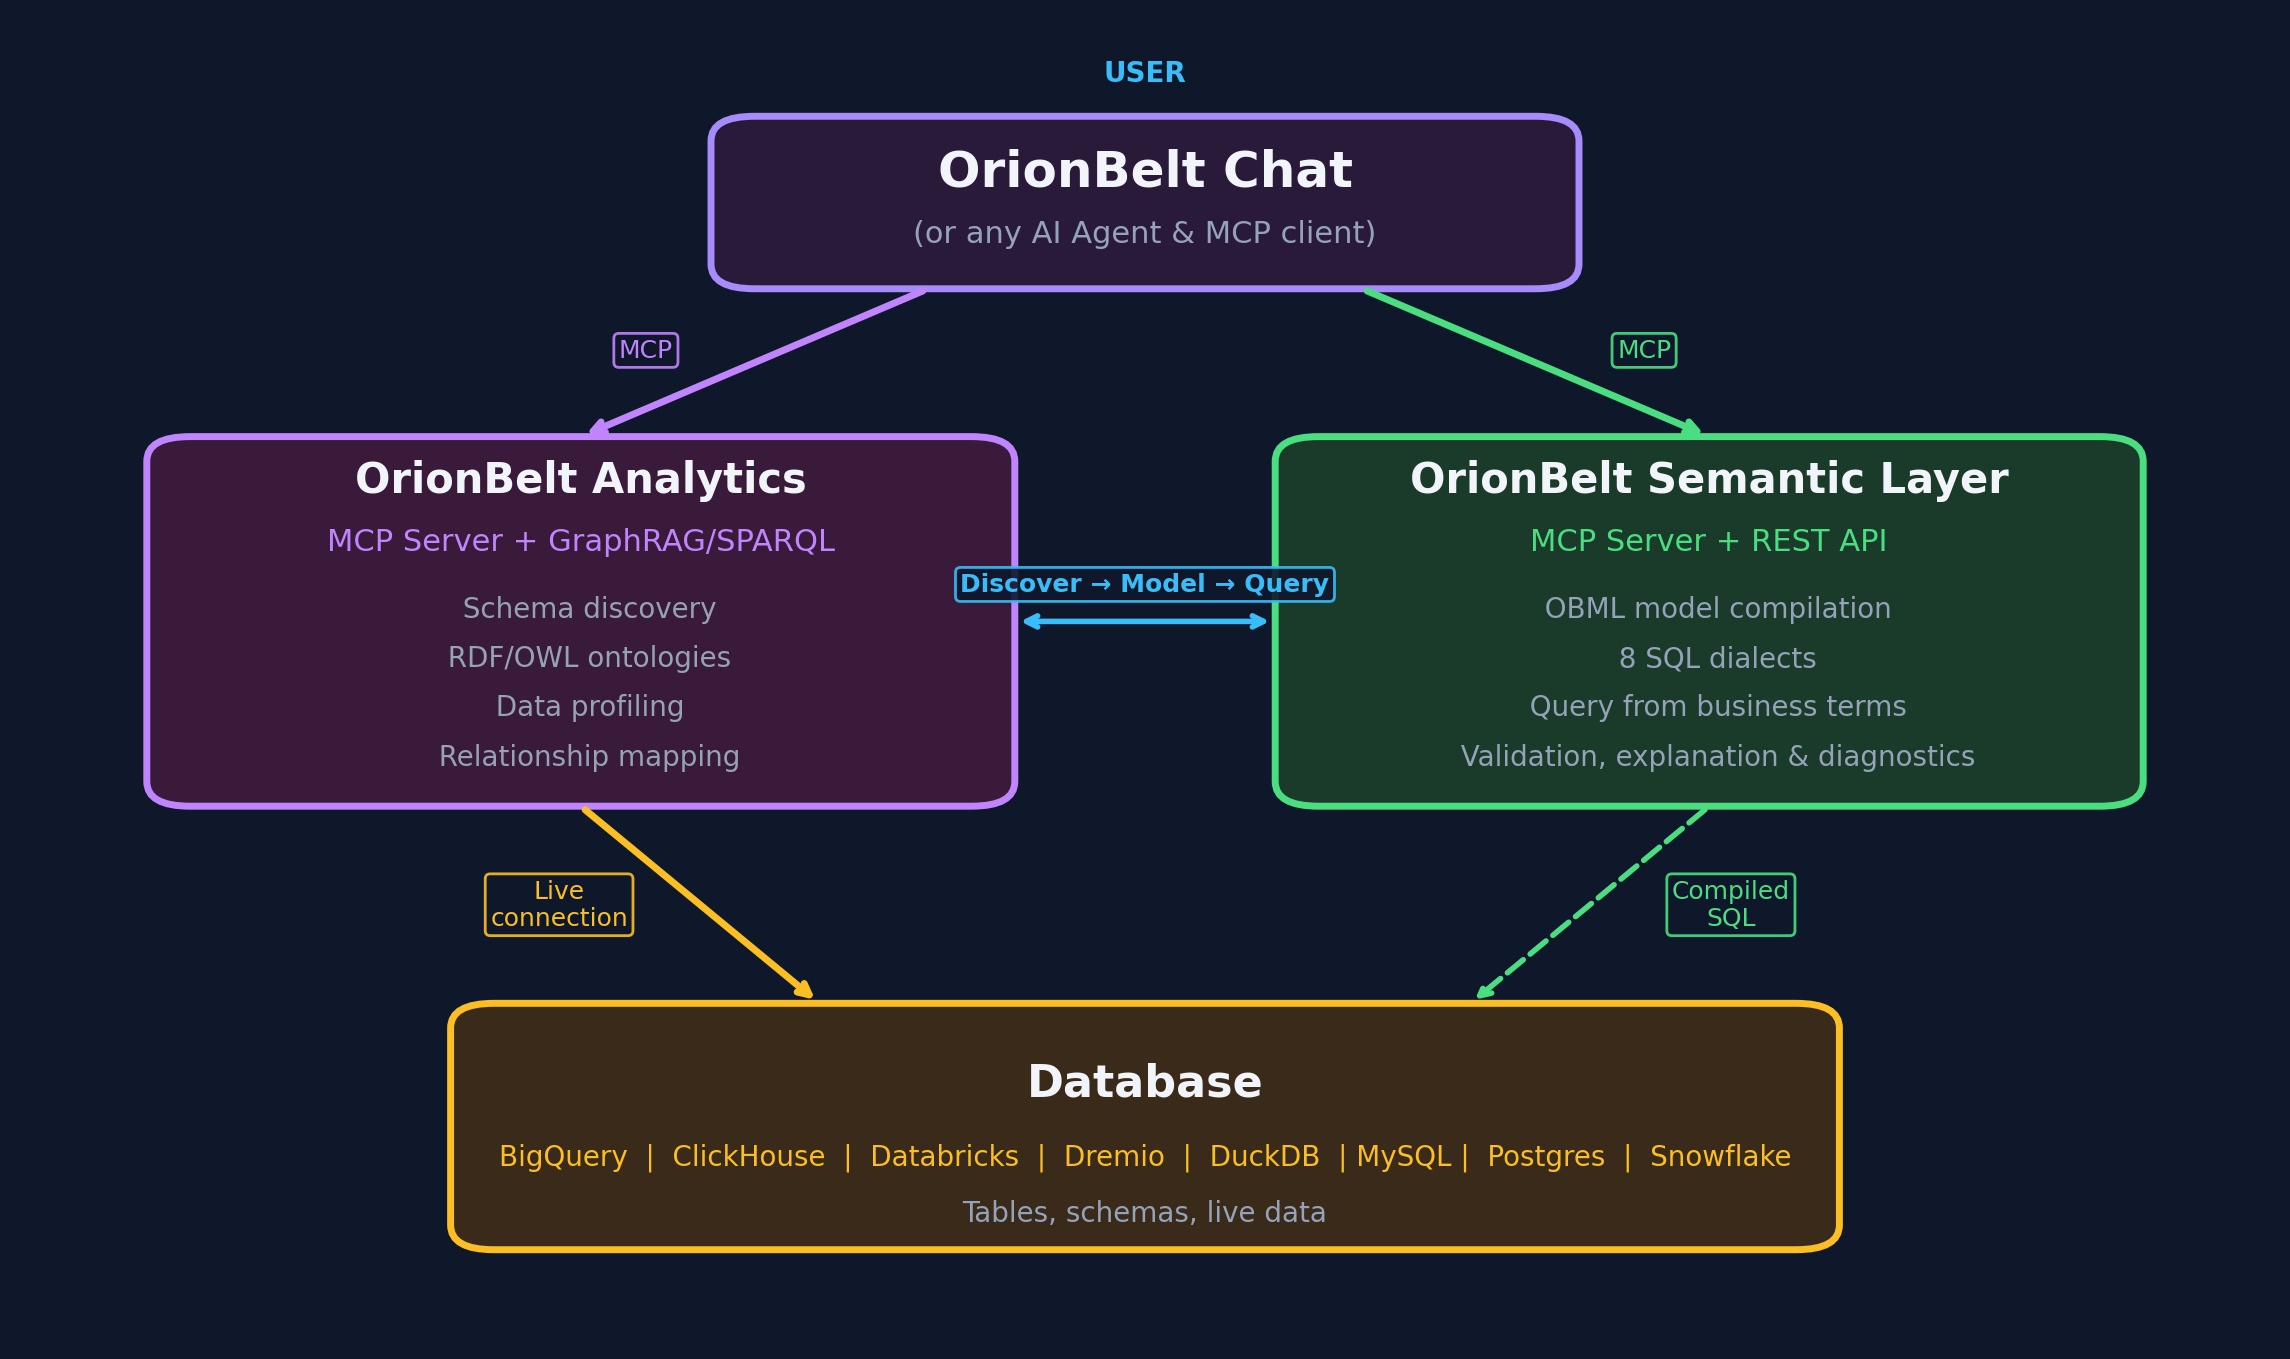
Un servidor MCP basado en ontologías que analiza esquemas de bases de datos relacionales y genera ontologías RDF/OWL. Junto con OrionBelt Semantic Layer, permite a los asistentes de IA navegar por su panorama de datos mediante ontologías y compilar SQL analítico seguro y consciente del dialecto.
Desarrollo
Contribuir a OrionBelt o ejecutarlo desde el código fuente:
git clone https://github.com/ralforion/orionbelt-semantic-layer.git
cd orionbelt-semantic-layer
uv sync                           # install all deps (dev, docs, ui, flight, drivers)
uv run orionbelt-api              # start API on :8000
# Quality
uv run pytest                     # run tests
uv run ruff check src/            # lint
uv run ruff format src/ tests/    # format
uv run mypy src/                  # type check

# Docs
uv sync --extra docs && uv run mkdocs serve  # docs on :8080

# CI workflows
./scripts/check-action-pins.sh              # verify every Action pin
./scripts/check-action-pins.sh --offline    # skip the upstream tag lookups
Fijación de GitHub Actions
Cada uses: en .github/workflows está fijado a un SHA de commit de 40 caracteres
en lugar de una etiqueta, porque una etiqueta como v7 es una etiqueta móvil: ejecuta
el commit al que su propietario la haya apuntado cuando el trabajo comienza. El
comentario # vX.Y.Z junto a cada SHA nombra la versión de parche exacta de la que se
extrajo ese SHA, y debe ser una versión de parche, ya que una etiqueta mayor se mueve con cada
actualización ascendente.
Fijar determina qué código se ejecuta, pero hace que la referencia sea ilegible, por lo que
scripts/check-action-pins.sh mantiene el SHA y su comentario honestos. Recorre
cada línea uses: y exige un SHA de commit, un propietario de su lista de permitidos ALLOWED_OWNERS
y un comentario de versión de parche exacta, luego resuelve esa etiqueta ascendente
con git ls-remote y falla cuando el commit que nombra no es el fijado.
Las acciones de contenedor deben fijarse por digest; las acciones locales ./ se omiten.
--offline comprueba solo el formato del SHA y el comentario, sin llamadas de red.
La comprobación se ejecuta como el trabajo pins en CI, y como el primer paso después del checkout en
los flujos de trabajo que publican (Docker, PyPI, docs), de modo que una etiqueta nunca pueda distribuir
artefactos construidos por pasos cuyas fijaciones nunca se verificaron. Añadir un propietario a
ALLOWED_OWNERS es una decisión deliberada: un SHA que coincide con su propia etiqueta no
dice nada sobre si esa acción pertenece a este repositorio en absoluto.
Licencia
Copyright © 2026 RALFORION d.o.o.
OrionBelt® es una marca registrada de RALFORION d.o.o.
Licenciado bajo la Business Source License 1.1 (SPDX: BUSL-1.1). La Obra Licenciada se convertirá a Apache License 2.0 el 2030-03-16.
Los trabajos de terceros redistribuidos por OrionBelt, y sus condiciones, se enumeran en THIRD_PARTY_NOTICES.md.
Al contribuir a este proyecto, acepta el Acuerdo de Licencia de Colaborador.
Para consultas de licencias comerciales, contacte: licensing@ralforion.com