trace-mcp
Servidor de inteligencia de código con conocimiento de frameworks que construye un grafo de dependencias entre lenguajes a partir del código fuente: 53 integraciones de frameworks en 68 lenguajes, más de 100 herramientas para navegación, análisis de impacto, refactorización y memoria de sesión con hasta un 97% de reducción de tokens.
Documentación


FUNCIONA CON · Claude Code · Cursor · Codex · Windsurf · Zed · cualquier cliente MCP
trace-mcp indexa lo que tu agente sigue releyendo, y sirve la respuesta en su lugar.
72,7% menos tokens de entrada para revisar una pull request — mediana sobre 60 pull requests fusionadas en repositorios de código abierto que no son nuestros.
Cambiamos configuración que tú mismo podrías cambiar. No parcheamos el binario de tu cliente, no interceptamos su tráfico ni reescribimos sus archivos. Una excepción declinable: el nivel Max usa emparejamiento tweakcc que ejecuta un parcheador de terceros por ti.


npm install -g trace-mcp   # MCP server, no app
trace init                 # wire it into your agent, once per machine
trace add                  # index the repo you are in
72,7% menos tokens de entrada para revisar una pull request — mediana sobre 60 PRs fusionadas en seis repositorios que no son nuestros, 13.595 → 3.291 por pull request. Método y reproducción →
Medido en trace-mcp 3.23.2 (cb8ab30c) el 7 de septiembre de 2026 — un resultado de esa compilación, no una afirmación sobre la actual. Lo que se propuso medir, el umbral que debía superar y el veredicto: prerregistro.
Más barato no es lo mismo que mejor, así que las mismas 60 pull requests se revisaron dos veces y se puntuaron a ciegas. El brazo de trace-mcp entendió el cambio en el 67% de ellas frente al 65% de la carga ingenua de archivos, con 0,80 falsos positivos por PR frente a 0,58. Mitad de calidad del benchmark →
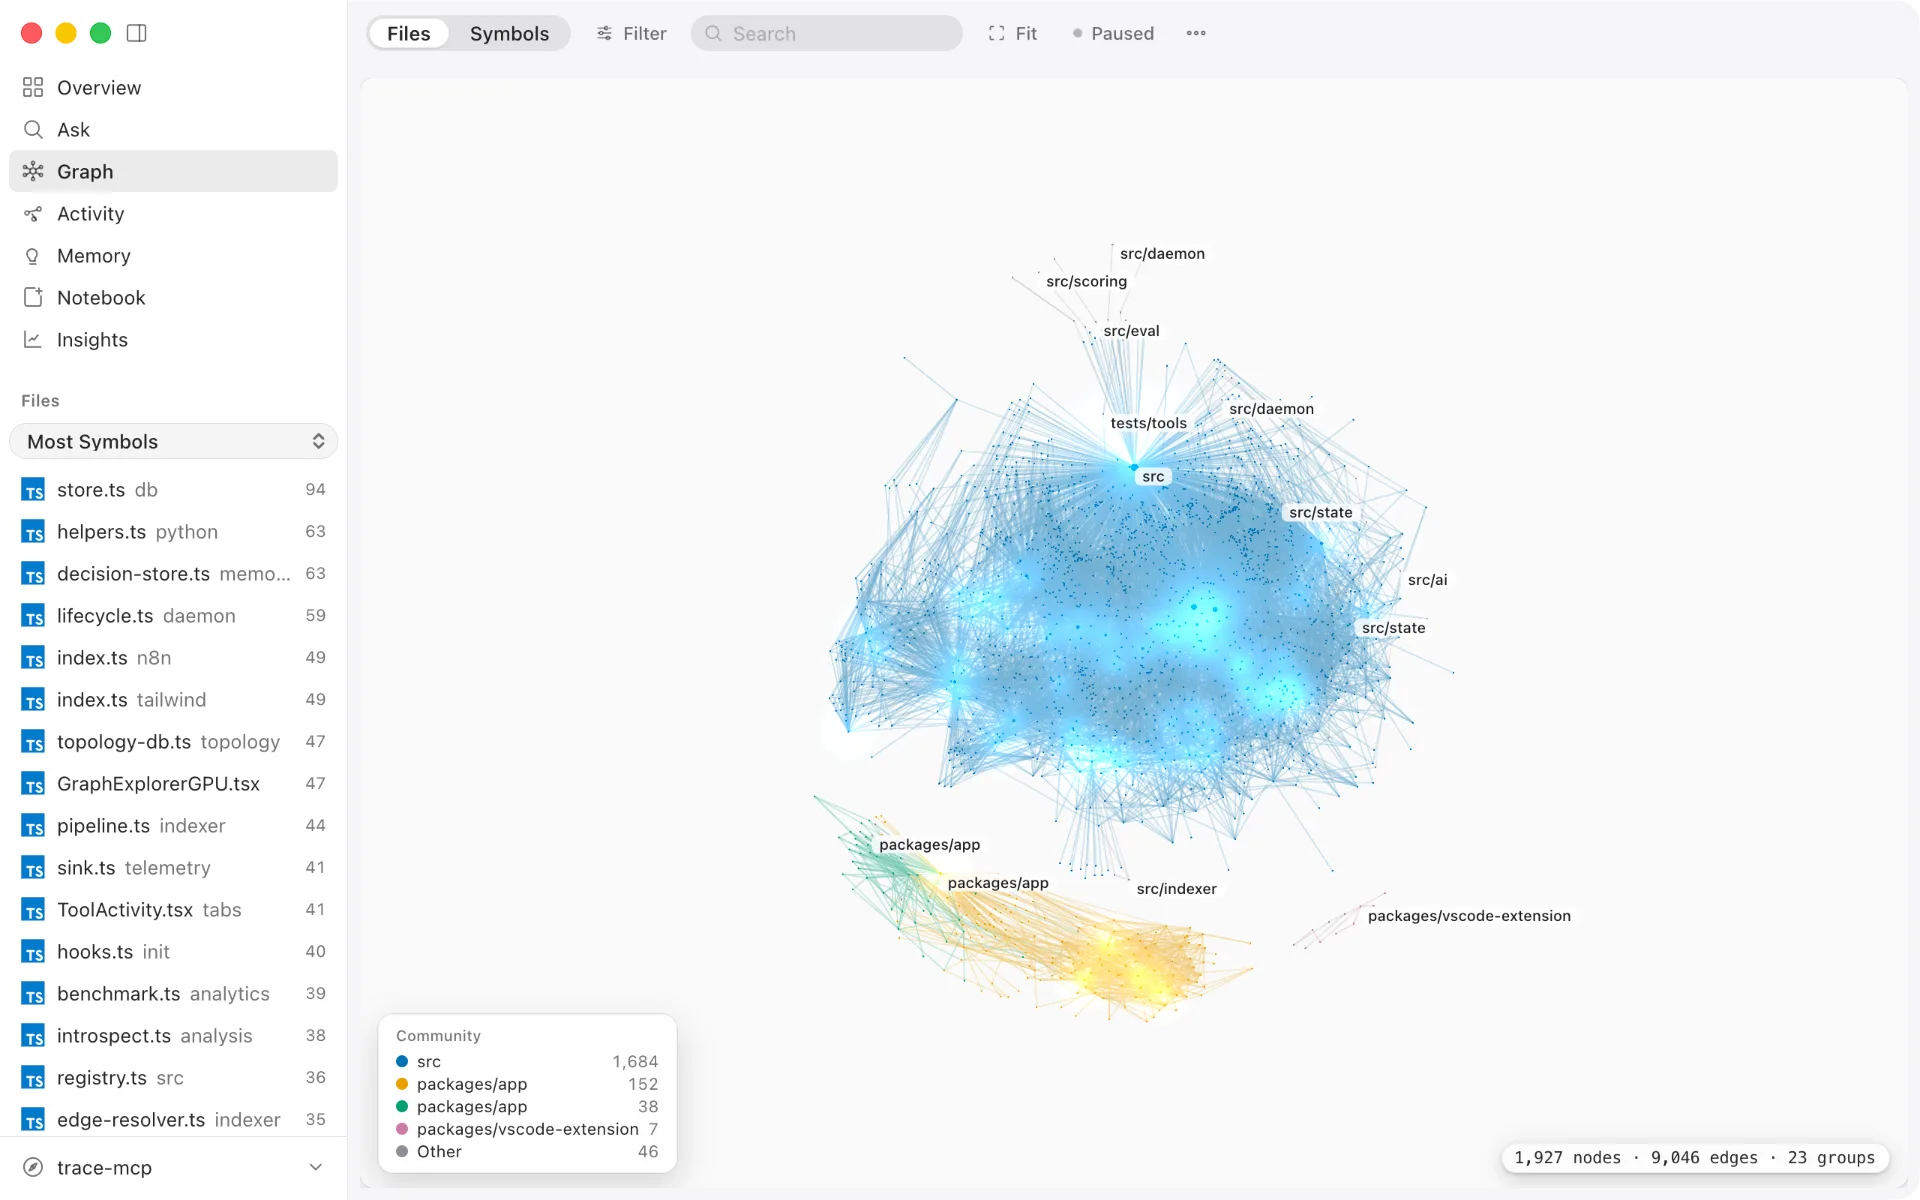
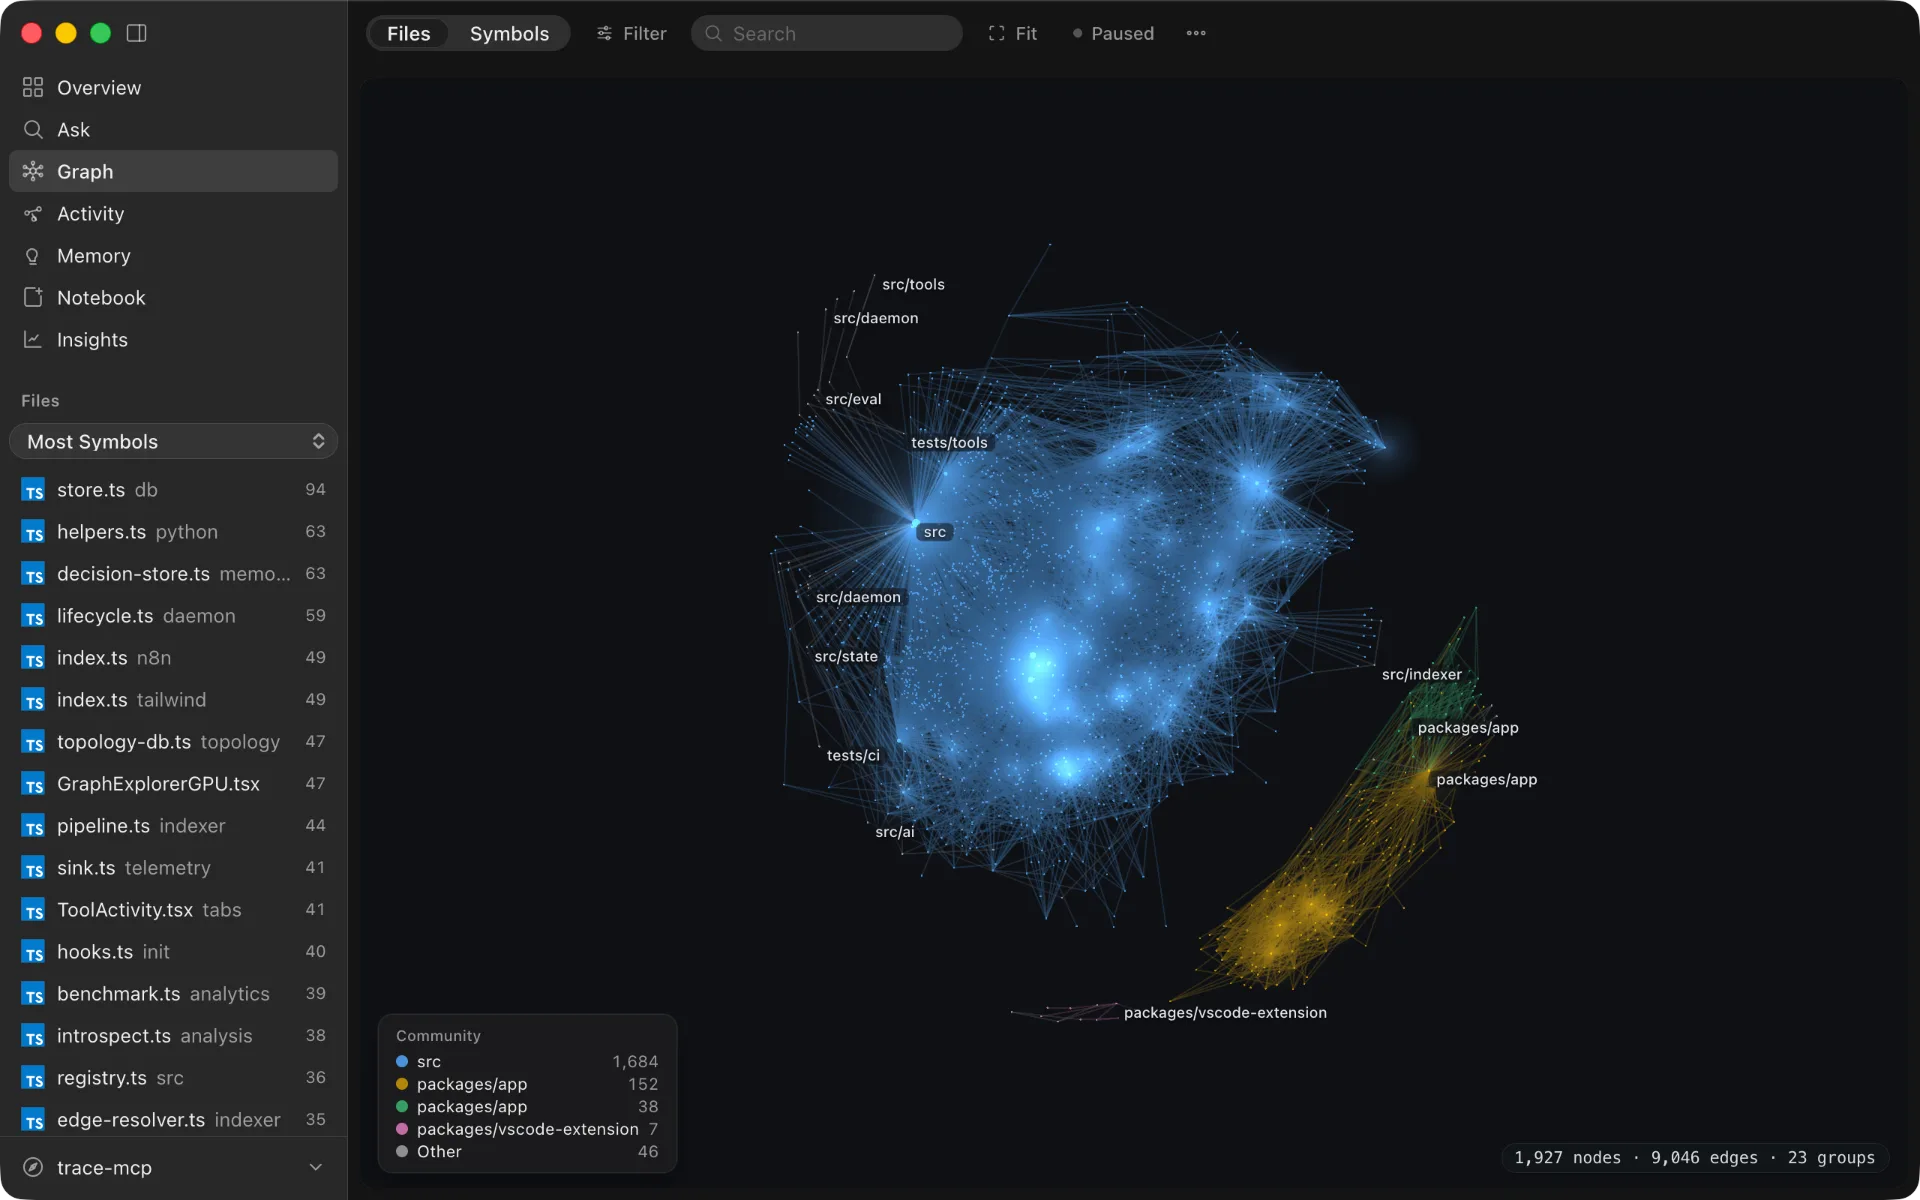
La app de escritorio: un explorador de grafos con GPU sobre el mismo índice que sirve el servidor MCP.
El problema
Los agentes de IA pagan repetidamente por trabajo que ya han hecho. En cada turno, el agente relee los mismos archivos, vuelve a recorrer las mismas dependencias y vuelve a inflar la ventana de contexto con estructura que descubrió hace cinco pasos. Ese trabajo repetido es la mayor parte de lo que cuesta una sesión larga en tokens y latencia.
trace-mcp construye un grafo de tu código base una vez, consciente del framework, y luego lo sirve a través de MCP para que el agente razone a partir de una estructura precomputada en lugar de leer el repositorio a ciegas. Pregunta "¿qué se rompe si cambio este modelo?" — en lugar de 80 llamadas Grep y 190 lecturas de archivos, el agente llama a get_change_impact una vez y obtiene el radio de impacto en PHP, Vue, migraciones y DI. 88 integraciones de frameworks en 81 lenguajes, 182 herramientas.
La restricción vinculante es la recomputación, no la capacidad del modelo: las facturas de tokens, la latencia y las alucinaciones crecen con el tamaño del proyecto en lugar de con la complejidad de la tarea. trace-mcp cierra la fuga de recomputación. El grafo se construye una vez, se mantiene incrementalmente fresco y se sirve a cada agente que lo pida — para que el mismo trabajo no se pague una y otra vez.
- Menor costo — menos tokens por respuesta exitosa, en promedio y en picos
- Menor latencia — menos llamadas secuenciales a herramientas, menos viajes de ida y vuelta al modelo
- Mayor precisión — menos ruido en el contexto significa menos alucinaciones y una mejor corrección en la primera respuesta
- Estabilidad de producción — el crecimiento del contexto sigue la complejidad de la tarea en lugar del tamaño del repositorio
Empezamos con inteligencia de código, donde la repetición es más costosa, y el mismo motor ahora indexa bóvedas de conocimiento en markdown (Obsidian, Logseq, MD plano) como dominio paralelo. Los wikilinks, las etiquetas, el frontmatter y los embeds se convierten en aristas del grafo y metadatos de símbolos; search, find_usages, get_change_impact y apply_rename funcionan de forma idéntica sobre ambos.
Lo que trace-mcp hace por ti
| Preguntas | trace-mcp responde | Cómo |
|---|---|---|
| "¿Qué se rompe si cambio este modelo?" | Radio de impacto entre lenguajes + puntuación de riesgo + decisiones arquitectónicas vinculadas | get_change_impact — grafo de dependencias inversas + memoria de decisiones |
| "¿Por qué se implementó auth así?" | El registro real de la decisión con razonamiento y compensaciones | query_decisions — busca en el grafo de conocimiento de decisiones vinculado al código |
| "Estoy empezando una tarea nueva" | Subgrafo de código óptimo + decisiones pasadas relevantes + advertencias de callejones sin salida | plan_turn — enrutador de apertura con enriquecimiento de decisiones |
| "¿Qué discutimos sobre GraphQL el mes pasado?" | Fragmentos verbatim de conversaciones con referencias a archivos | search_sessions — búsqueda FTS5 en todo el contenido de sesiones pasadas |
| "Muéstrame el flujo de solicitud desde la URL hasta la página renderizada" | Ruta → Middleware → Controlador → Servicio → Vista con mapeo de props | get_request_flow — recorrido de aristas consciente del framework |
| "Encuentra todo el código sin probar en este módulo" | Símbolos clasificados como "no alcanzados" o "importados pero nunca llamados en pruebas" | get_untested_symbols — mapeo de prueba a fuente |
| "¿Cuál es el impacto de este cambio de API en otros servicios?" | Llamadas de cliente entre subproyectos con puntuaciones de confianza | get_subproject_impact — recorrido del grafo de topología |
| "¿Qué notas enlazan a este concepto?" | Backlinks en toda la bóveda, con contexto de sección y alias | find_usages sobre un símbolo note:<basename> |
| "¿Qué se rompe si renombro esta nota?" | Cada [[wikilink]] y [text](path.md) que la referencia | get_change_impact — grafo inverso consciente de wikilinks |
Cuatro capacidades que son raras entre herramientas similares:
-
Aristas conscientes del framework — trace-mcp entiende que
Inertia::render('Users/Show')conecta PHP con Vue, que@Injectable()crea una dependencia DI, que$user->posts()significa una tablapostsde migraciones. 88 integraciones de frameworks. -
Memoria de decisiones vinculada al código — cuando registras "elegimos PostgreSQL por soporte JSONB", se vincula a
src/db/connection.ts::Pool#class. Cuando alguien ejecutaget_change_impactsobre ese símbolo, ve la decisión. MemPalace almacena decisiones como texto; trace-mcp las ata al grafo de dependencias. -
Inteligencia entre sesiones — las sesiones pasadas se extraen en busca de decisiones y se indexan para búsqueda. Cuando inicias una sesión nueva,
get_wake_upte da orientación en ~300 tokens;plan_turnmuestra decisiones pasadas relevantes para tu tarea;get_wake_up { scope: "resume" }traslada el contexto estructural de sesiones anteriores. -
Código y conocimiento en un solo grafo — apunta trace-mcp a una bóveda de markdown (Obsidian, Logseq, MD plano) y el mismo motor la indexa: cada nota se convierte en un símbolo
note:<basename>, los encabezados en secciones anidadas,[[wikilinks]]y![[embeds]]en aristas del grafo, el frontmatter y#tagsviajan en los metadatos. PageRank, clasificación por fusión de señales, embeddings y refactorización de renombrado se aplican sin cambios. El agente no aprende una segunda herramienta: es el mismo grafo, que contiene tanto el código base como las notas.
Por qué los agentes siguen releyendo
Los agentes de IA de codificación recomputan el mismo trabajo en cada turno — y son ciegos al framework mientras lo hacen.
Releen UserController.php, y luego lo releen de nuevo en el siguiente turno. No saben que Inertia::render('Users/Show', $data) conecta un controlador de Laravel con resources/js/Pages/Users/Show.vue. No saben que $user->posts() significa que la tabla posts se definió hace tres migraciones. No pueden rastrear una solicitud desde la URL hasta el píxel renderizado — así que la rastrean de nuevo, y otra vez, en cada sesión.
El resultado: 5–15× lecturas repetidas de archivos calientes en una sola tarea, ventanas de contexto usadas como bases de datos de trabajo, y agentes que se vuelven más caros cuanto más grande es el proyecto — en lugar de más capaces.
La solución
trace-mcp construye un grafo de dependencias entre lenguajes a partir de tu código fuente y lo expone a través del Model Context Protocol — el formato de plugin que hablan Claude Code, Cursor, Windsurf y otros agentes de IA de codificación. Cualquier agente compatible con MCP obtiene comprensión a nivel de framework de serie.
| Sin trace-mcp | Con trace-mcp |
|---|---|
| El agente lee 15 archivos para entender una funcionalidad | get_task_context — subgrafo de código óptimo de una sola vez |
| El agente no sabe qué página Vue renderiza un controlador | Aristas routes_to → renders_component → uses_prop |
| "¿Qué se rompe si cambio este modelo?" — el agente adivina | get_change_impact recorre dependencias inversas entre lenguajes |
| ¿Esquema? El agente necesita una base de datos en ejecución | Migraciones analizadas — esquema reconstruido desde el código |
| ¿Desajuste de props entre PHP y Vue? Descubierto en producción | Detectado en tiempo de indexación — datos PHP vs. defineProps |
App de escritorio
trace-mcp incluye una app de escritorio Electron opcional (packages/app) que te da una superficie visual sobre el mismo índice que usa el servidor MCP. Gestiona múltiples proyectos, conecta clientes MCP y proporciona un explorador de grafos acelerado por GPU — todo sin abrir una terminal.
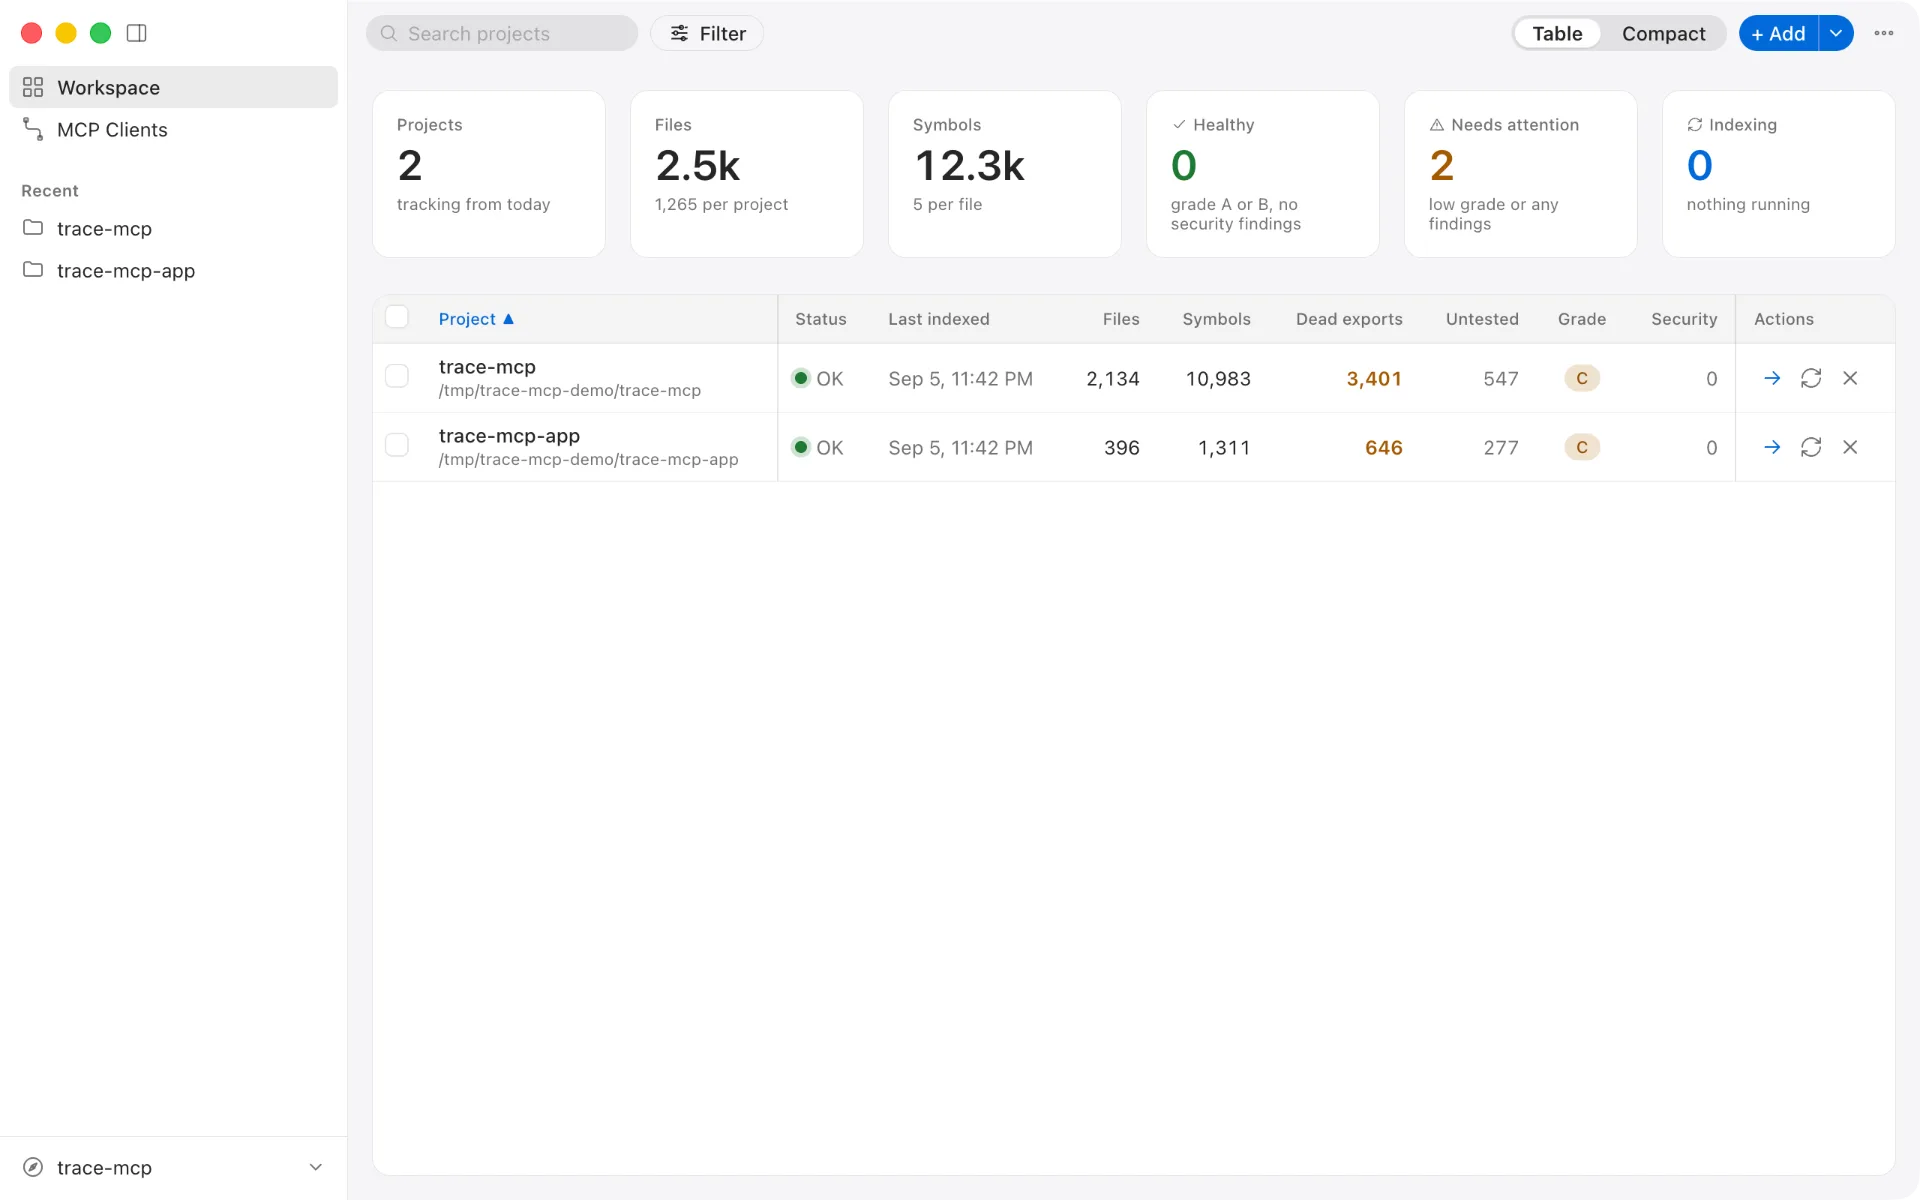
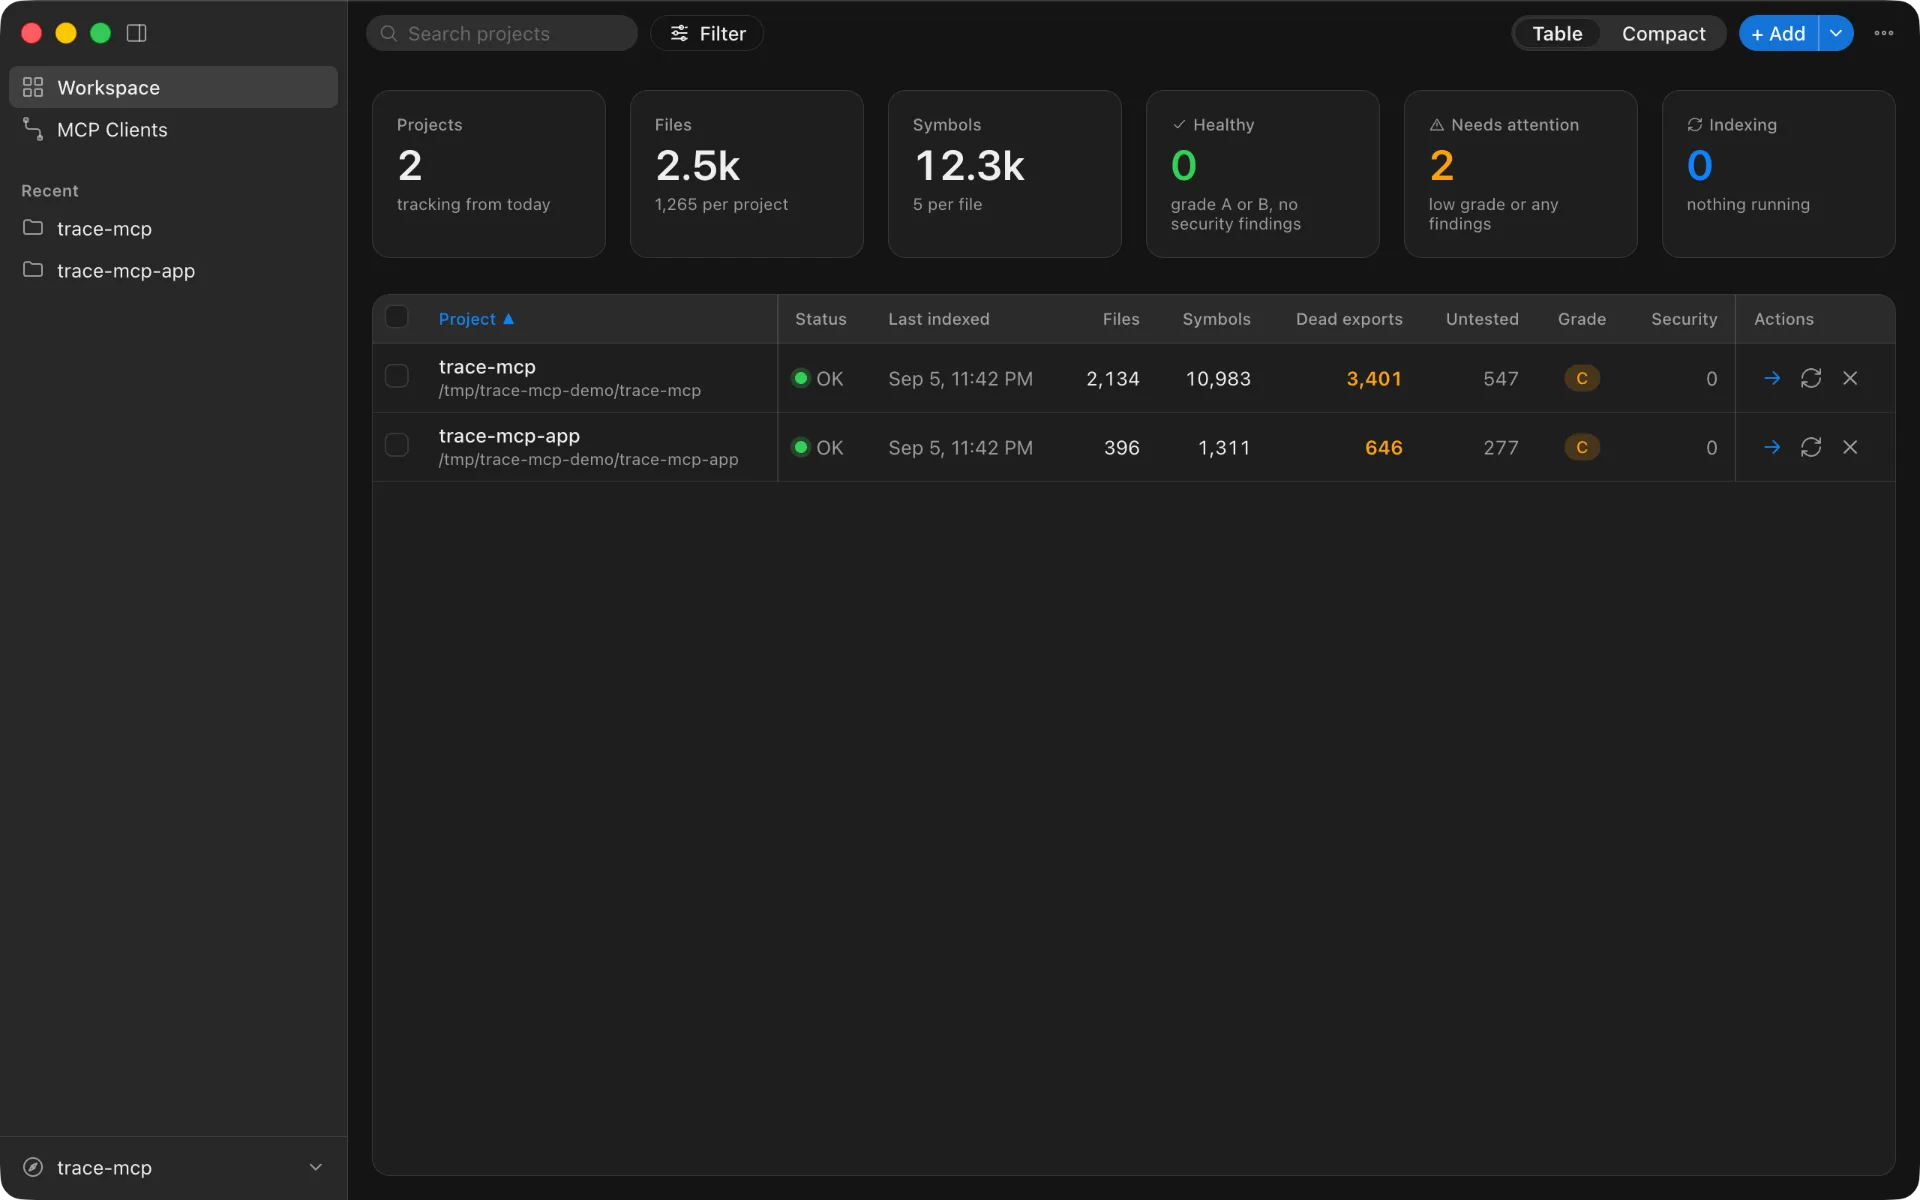
Proyectos y clientes. La ventana de menú lista los proyectos indexados con estado en vivo (Ready / indexando / error) y controles de re-indexar / eliminar. La pestaña Clientes MCP detecta clientes instalados (Claude Code, Claw Code, Claude Desktop, Cursor, Windsurf, Continue, Junie, JetBrains AI, Codex, AMP, Warp, Factory Droid) y conecta trace-mcp a ellos con un clic, incluido el nivel de aplicación (Base / Estándar / Max — solo CLAUDE.md, + hooks, + tweakcc y reglas de comportamiento del agente; las funciones del nivel Max son específicas de Claude Code). Warp y JetBrains AI requieren pegado manual en el IDE porque su almacenamiento de configuración es solo de GUI.
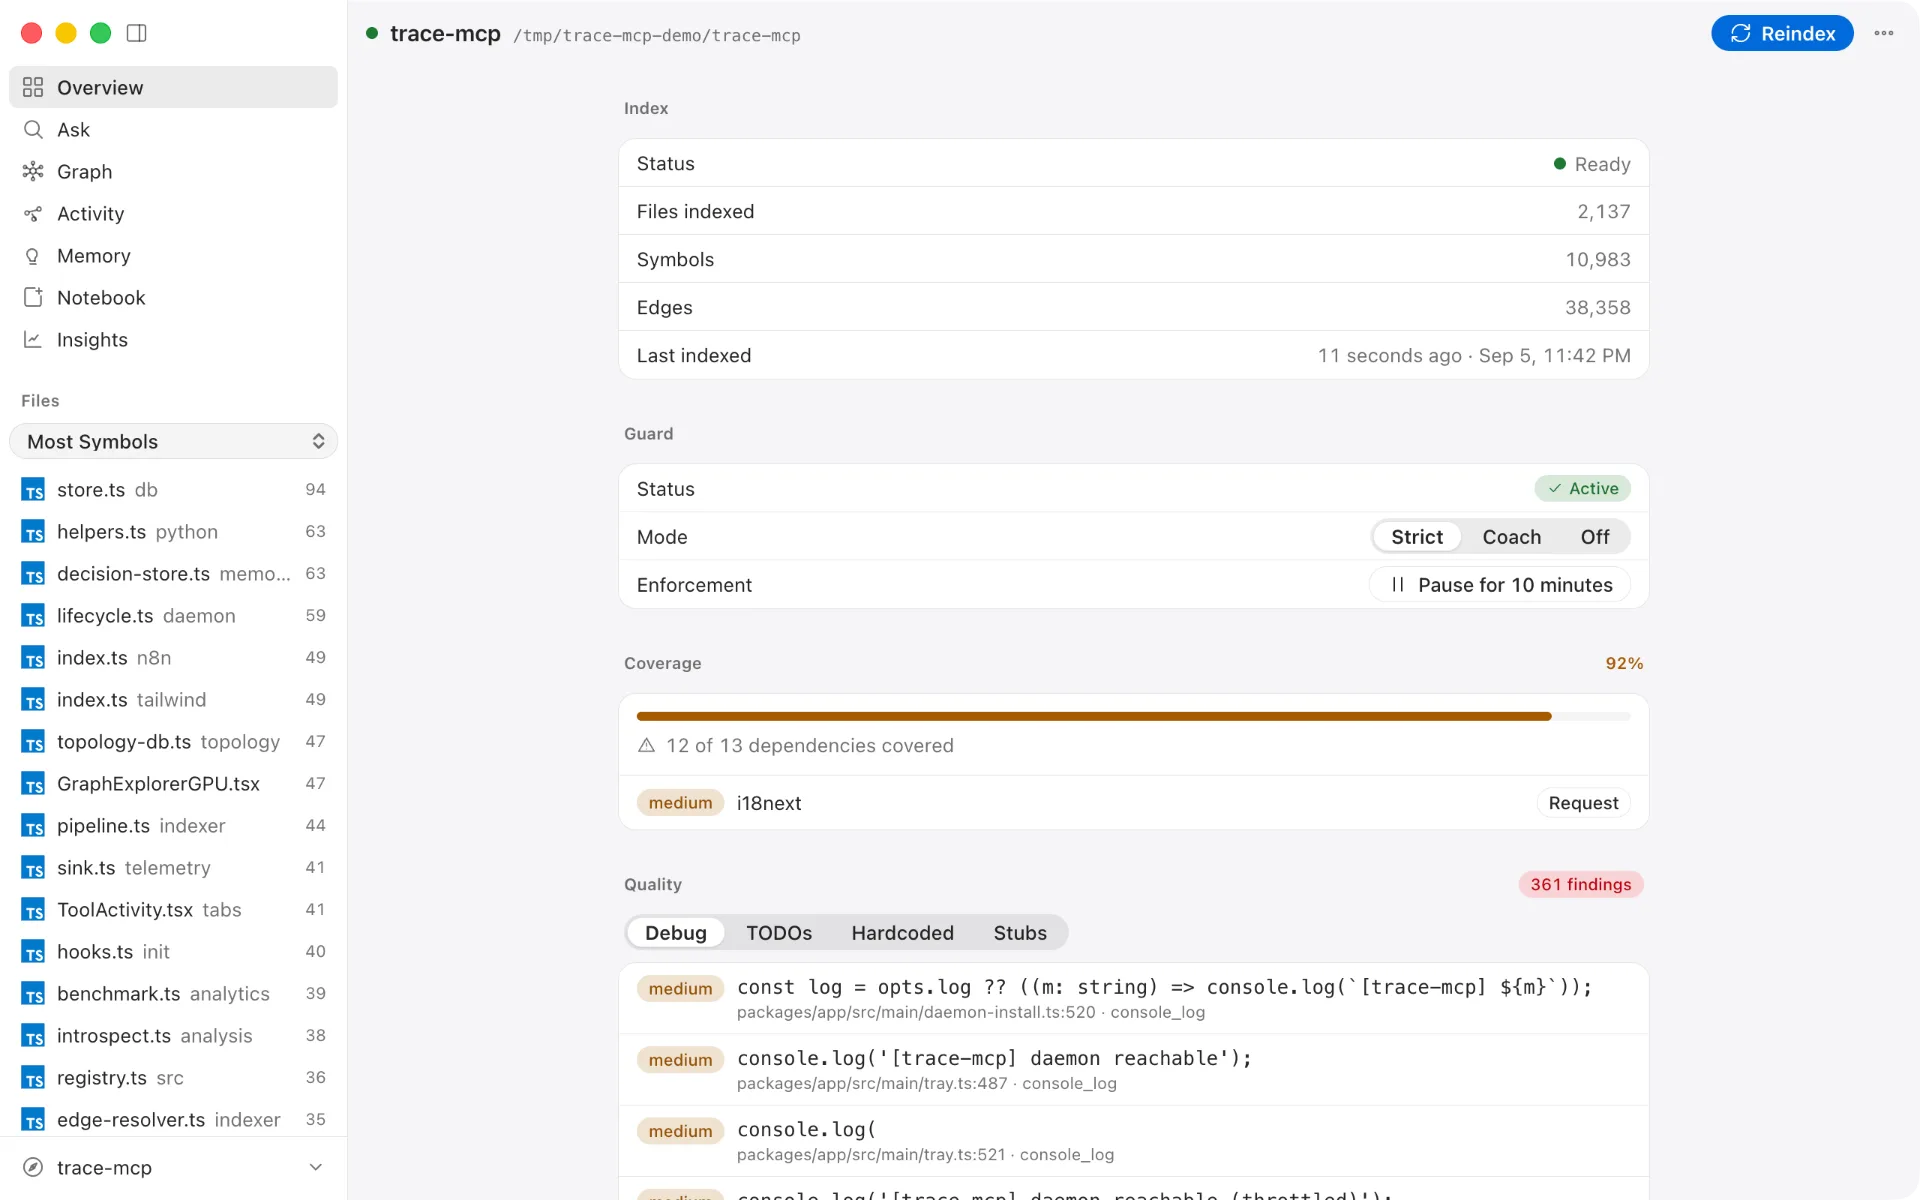
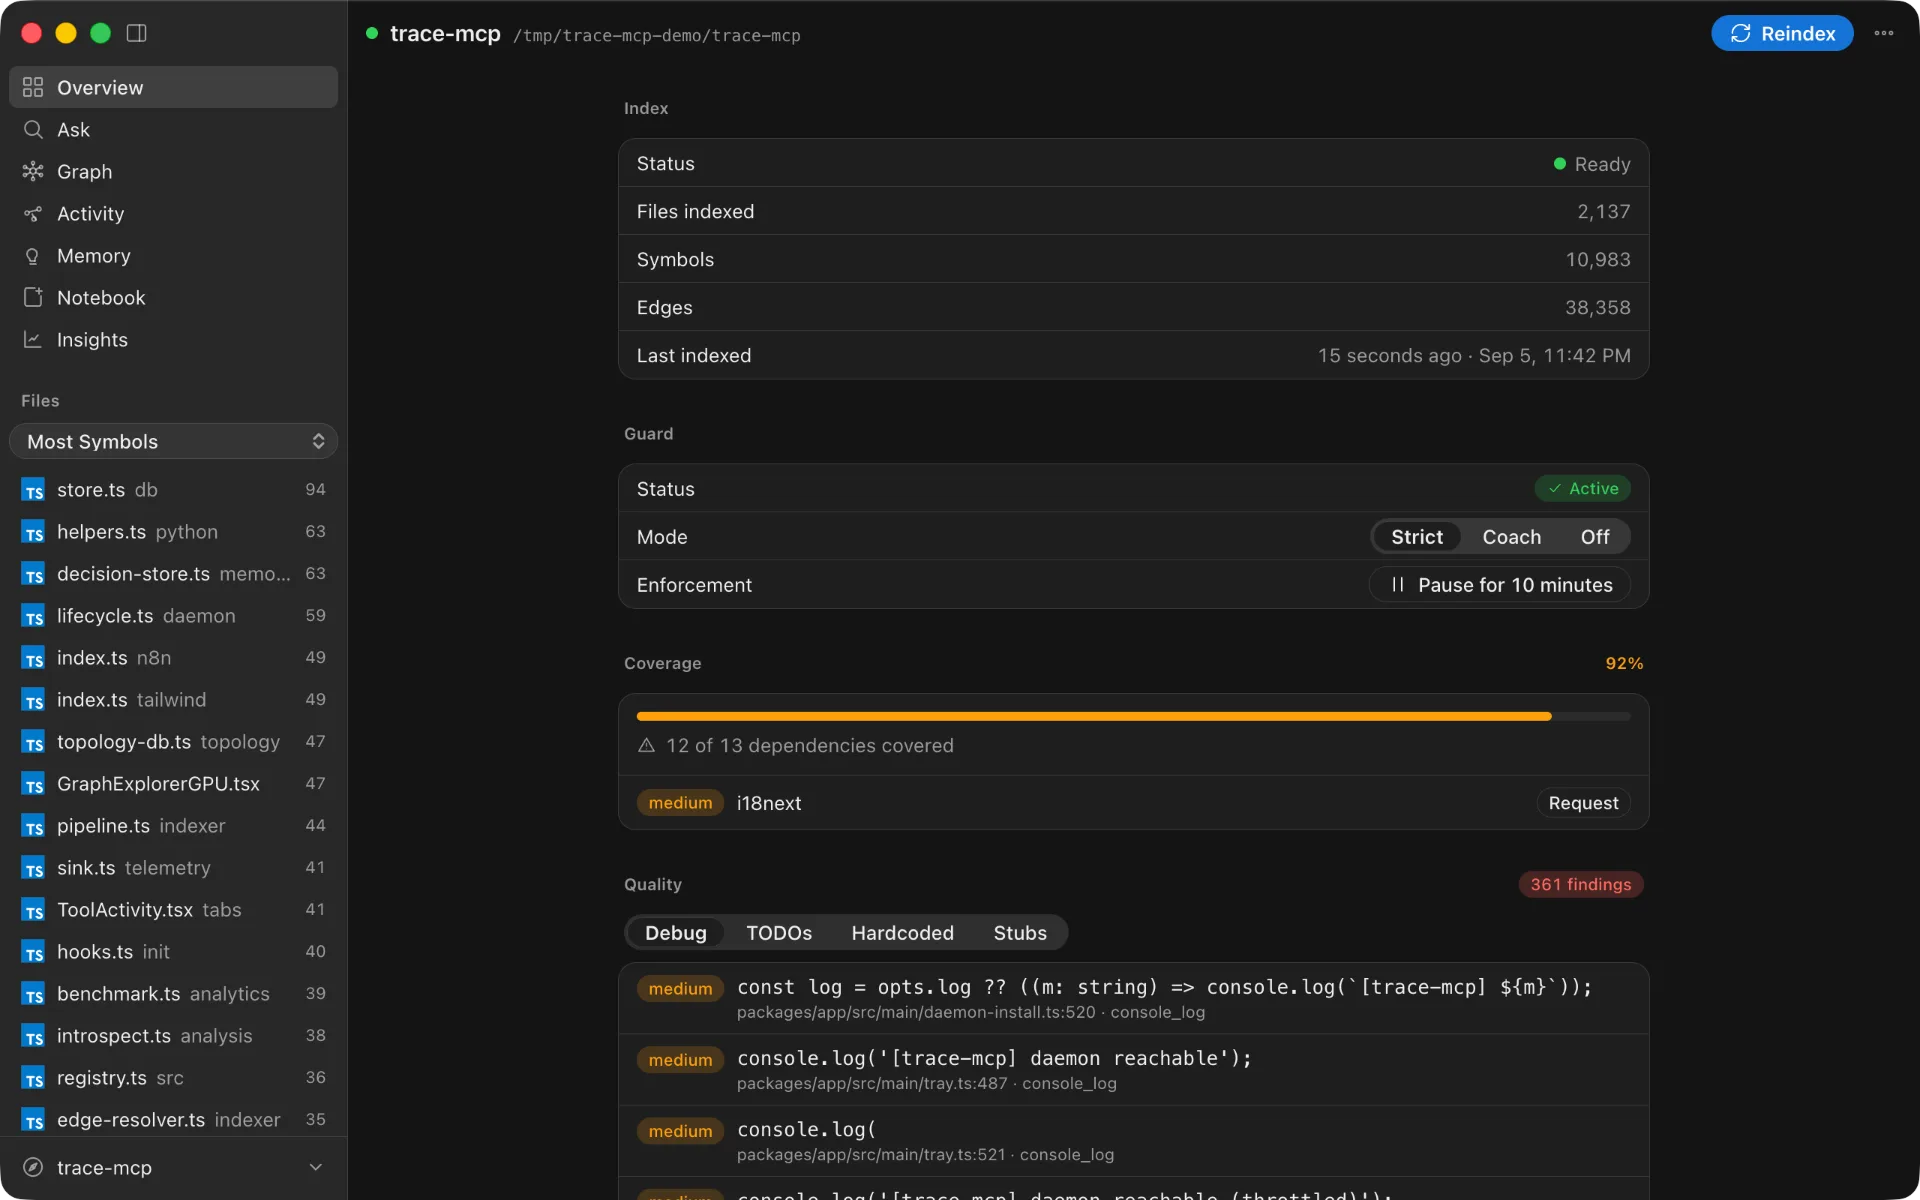
Resumen por proyecto. Cada proyecto se abre en su propia ventana con pestañas: Resumen (archivos, símbolos, aristas, cobertura, servicios vinculados, re-indexar), Preguntar (consulta en lenguaje natural sobre el índice) y Grafo. El Resumen también muestra archivos Most Symbols, la marca de tiempo de la última indexación y el medidor de cobertura de dependencias.
Explorador de grafos con GPU. La pestaña Grafo renderiza el grafo de dependencias completo en la GPU mediante cosmos.gl — decenas de miles de nodos/aristas a velocidades de fotograma interactivas. Filtra por Archivos / Símbolos, superpone comunidades detectadas, resalta grupos, alterna etiquetas/FPS y recorre la profundidad del grafo. Bueno para hacerte una idea del acoplamiento, los puntos calientes y cómo está realmente formado un código base antes de sumergirte en las herramientas.
Instalación en macOS: Descargar el .dmg — ábrelo y arrastra trace-mcp a Aplicaciones. El botón del sitio elige Apple Silicon o Intel por ti; si prefieres elegir tú mismo, ambas compilaciones están en la página de Releases. La app está firmada con un Developer ID y notarizada por Apple, por lo que se abre sin advertencia — si macOS alguna vez te advierte sobre una compilación de trace-mcp, esa advertencia es real y la descarga no debe confiarse.
Instalación en Windows: ejecuta trace-mcp.Setup.<version>.exe desde Releases.
¿El actualizador integrado se queda atascado en una versión antigua? Las versiones 3.10.0 y anteriores de la app en macOS/Windows no pueden actualizarse solas — "Buscar actualizaciones…" muestra Cannot set properties of undefined (setting 'autoDownload') y no hace nada, un error corregido en 3.11.0 que las versiones afectadas no pueden resolver por sí mismas. Reinstala manualmente: descarga el .dmg (macOS) o toma la última trace-mcp.Setup.<version>.exe de Releases (Windows) — o, si tienes el CLI instalado, ejecuta trace-mcp install-app.
La app habla con el mismo daemon trace-mcp (http://127.0.0.1:3741) que usan los clientes MCP, así que cualquier cosa que indexes desde la app está disponible de inmediato para Claude Code / Cursor / etc. Si solo quieres el servidor MCP y el CLI, no necesitas la app en absoluto — npm install -g trace-mcp es la instalación completa.
Cómo se compara trace-mcp
trace-mcp combina navegación por grafo de código, memoria entre sesiones y comprensión de código en tiempo real en una sola herramienta. La mayoría de los proyectos adyacentes resuelven una de estas cosas — trace-mcp unifica las tres y es el único con aristas entre lenguajes conscientes de frameworks (88 integraciones de frameworks) y memoria de decisiones vinculada al código.
- vs. exploración eficiente en tokens (Repomix, jCodeMunch, cymbal) — trace-mcp añade aristas de frameworks, refactorización, seguridad y subproyectos sobre la búsqueda de símbolos.
- vs. herramientas de memoria de sesión (MemPalace, claude-mem, ConPort) — trace-mcp vincula decisiones a símbolos/archivos específicos, para que aparezcan automáticamente en el análisis de impacto.
- vs. RAG / generación de documentación (DeepContext, smart-coding-mcp) — trace-mcp responde "muéstrame la ruta de ejecución, dependencias y pruebas", no "encuentra código similar a esta consulta".
- vs. servidores MCP de grafo de código (Serena, Roam-Code) — trace-mcp tiene la cobertura de lenguajes más amplia (81 lenguajes) y es el único con aristas entre lenguajes conscientes de frameworks.
Tablas comparativas completas con estrellas de GitHub, lenguajes y cobertura por capacidad: trace-mcp vs. otros servidores MCP de inteligencia de código.
Cara a cara: vs Repomix · vs Serena · vs codegraph · vs codebase-memory-mcp · vs modo de contexto de Claude Code · vs code-review-graph · Repomix vs codegraph.
Reducción de tokens — lo que medimos
Los agentes de IA queman tokens recalculando lo que ya descubrieron en el turno anterior — releyendo archivos, recorriendo dependencias de nuevo, reinflando el contexto. trace-mcp reemplaza eso con contexto de precisión: solo los símbolos, aristas y firmas relevantes para la consulta, servidos desde un grafo que se calculó una vez.
Empieza con la medición que no es nuestra. Todo lo demás en esta sección es trace-mcp medido sobre el propio repositorio de trace-mcp — la primera fila de la tabla contra respuestas reales, todo lo demás por los estimadores sintéticos propios de trace-mcp. El benchmark de contexto de revisión de PR es la excepción: ensamblar contexto de revisión para 60 pull requests fusionadas en seis repositorios de código abierto — hono, axios, express, requests, flask, got — costó una mediana de 3.291 tokens de entrada frente a 13.595 para cargar el diff más cada archivo que toca, 72,7% menos, contado con gpt-tokenizer en lugar de estimado. Los SHAs base y head están fijados en benchmarks/pr-context/dataset.json, npx tsx scripts/bench-pr-context.ts lo re-ejecuta, y los 56 pull requests donde el índice no dio resultado se publican junto con los aciertos — 13 que costaron más que leer los archivos directamente, y 42 donde el presupuesto de tokens del paquete no entregó el cuerpo de cada símbolo cambiado, una deficiencia que el benchmark no podía ver hasta que esta ejecución lo hizo puntuar la entrega en lugar de listar.
Qué esperar — por carga de trabajo:
| Carga de trabajo | Reducción típica |
|---|---|
| Producción mixta del mundo real (respuestas de herramientas medidas vs. las lecturas de archivos que reemplazan) | 67,4% menos tokens |
| Tareas estructuradas de navegación de código (búsqueda de símbolos, análisis de impacto, jerarquía de tipos, grafo de llamadas) | hasta 99% menos procesamiento redundante — estimación sintética |
| Consultas de investigación/planificación dirigidas (tareas compuestas que reemplazan ~10 operaciones secuenciales) | hasta ~40× en llamadas individuales — estimación sintética |
| Cargas de trabajo no relacionadas con código (texto plano, datos no estructurados) | Fuera de alcance hoy |
El 67,4% es el número honesto para planificar, y la razón por la que cambió no es que el producto se volviera más rápido. Solíamos imprimir "~40–50% en promedio". Esa cifra descendía de un contador que puntuaba cada llamada antes de que la herramienta se ejecutara — RAW_COST_ESTIMATES[tool] × 0.15, una constante sin varianza — que encontramos y corregimos nosotros mismos en #915. Los reemplazos honestos leyeron 29,3%, luego 21,1%, luego 21,0% a medida que la cobertura creció hasta 97,2% de las llamadas registradas. Luego descubrimos que tres herramientas que soportaban el 76% del peso estaban cada una valoradas a partir de una muestra, y que cuatro formas defendibles de elegir esas muestras valoran la misma compilación en 21,0%, 30,7%, 56,0% y 67,4%. Así que el marco de muestreo ahora se genera, congela y confirma antes de la ejecución que lo usa, con cada afirmación sobre cómo se construyó re-verificada contra el repositorio en CI (prerregistro). 67,4% es lo que mide el marco registrado; lee el salto del 21% como un cambio de marco, no un cambio de producto. Pondera recuentos reales de o200k_base de respuestas reales por 18.329 llamadas registradas desde una máquina (tabla por herramienta, generada en docs/_data/response_tokens.json). Tres advertencias lo acompañan: la mitad de la línea base — lo que un Read/Grep habría costado en su lugar — sigue siendo una estimación escrita a mano; cuatro de las veintitrés herramientas medidas devuelven más tokens de los que reemplazan, y el contador antiguo registraba un ahorro para ellas de todos modos; y dos herramientas más (register_edit, reindex) no reemplazan ninguna lectura de archivo, así que ahora se les acredita cero y se cuentan como gasto general — con ellas en el lado del gasto, la cifra total es 66,5%. Los picos a continuación (hasta 99% en llamadas estructuradas individuales) son una estimación sintética, por llamada, no por sesión.
Medido en trace-mcp 3.31.0 (76996eb9) el 21 de septiembre de 2026. Su prerregistro lo publica como el primer pase de la barra del 25% que declaramos antes de medir — y dice en el mismo párrafo que el pase vino de registrar un marco de muestreo, no de enviar un producto más rápido. La predicción escrita antes de esa ejecución nombró un intervalo en el que el resultado quedó por encima; estaba equivocada y permanece en la página.
Benchmark Lab — la misma pregunta, hecha por la app. La pestaña Benchmark Lab de la app de escritorio ejecuta una batería fija de 8 fixtures de recuperación en tres brazos y guarda cada ejecución en ~/.trace/benchmark-runs. Medido en trace-mcp 3.33.0 (4e1ac4fd) el 26 de septiembre de 2026: el control de lectura de archivos gastó 82.412 tokens en 13 llamadas (8/8 respondidas); el brazo mínimo respondió 7 de 8 por 512 tokens (−99,4%); el brazo estándar respondió 8 de 8 por 13.657 tokens (−83,4%). El fallo mínimo es una medición real — el search_text crudo no clasifica src/indexer/pipeline.ts en su top 10 — publicado en lugar de re-ejecutado hasta que pase. Método, hash de la batería y re-ejecución →
Benchmark: el propio código base de trace-mcp (694 archivos, 3.831 símbolos → 929 archivos, 5.197 símbolos en v1.30):
Task                    Without trace-mcp    With trace-mcp    Reduction
───────────────────────────────────────────────────────────────────────────
Symbol lookup                42,518 tokens       1,162 tokens       97.3%
File exploration             27,486 tokens         855 tokens       96.9%
Search                       22,860 tokens       8,000 tokens       65.0%
Find usages                  11,430 tokens       1,720 tokens       85.0%
Context bundle               12,847 tokens       3,485 tokens       72.9%
Batch overhead               16,831 tokens       8,299 tokens       50.7%
Impact analysis              49,141 tokens       1,856 tokens       96.2%
Call graph                  178,345 tokens       9,285 tokens       94.8%
Type hierarchy               94,762 tokens         855 tokens       99.1%
Tests for                    22,590 tokens       1,150 tokens       94.9%
Composite task              223,721 tokens      14,245 tokens       93.6%
───────────────────────────────────────────────────────────────────────────
Total                       702,532 tokens      50,812 tokens       92.8%
En 11 categorías de tareas estructuradas, la recomputación cae hasta ~99% por llamada cuando el agente reutiliza el grafo en lugar de releer archivos. Léelo como un resultado pico de tareas estructuradas en un código base TS/Vue bien soportado, no un número que debas esperar en cada proyecto. En producción, con cargas de trabajo mixtas, espera 67,4% — la cifra medida arriba, no esta sintética. Menos ruido en el contexto también significa menos alucinaciones y mejor precisión en la primera respuesta — un beneficio de calidad que no ves en los recuentos de tokens.
Los ahorros escalan con el tamaño del proyecto — argumentado, no medido. Sin trace-mcp el agente lee más archivos equivocados antes de encontrar el correcto, mientras que el recorrido del grafo se mantiene en O(aristas relevantes) en lugar de O(total de archivos). No tenemos una medición por tamaño de proyecto para respaldar eso, así que este README ya no cita una; la cifra de tokens por sesión que solía estar aquí venía del mismo estimador pre-#915 que el "40–50%".
Las tareas compuestas ofrecen las mayores ganancias. Una sola llamada a get_task_context reemplaza una cadena de ~10 operaciones secuenciales (búsqueda → get_symbol × 5 → Read × 3 → Grep × 2). Eso es un viaje de ida y vuelta en lugar de diez, que es de donde viene la mayor parte del ahorro de latencia.
Pruébalo tú mismo
npx trace-mcp benchmark .
Ahorros de tokens por categoría contra tu repositorio real en ~5 minutos — sin instalación, sin registro, todo local. Lee un índice existente, así que ejecuta trace-mcp index . primero si el proyecto aún no está registrado. Los números anteriores son del propio código base TypeScript/Vue de trace-mcp (929 archivos, 5.197 símbolos) bajo benchmarks estructurados; la reducción en producción con cargas de trabajo mixtas es menor (67,4% medido, ver arriba), pero los patrones por tarea se mantienen para cualquier stack bien soportado.
Esto es una estimación sintética, no ahorros medidos: el lado "sin trace-mcp" se calcula a partir de los tamaños de archivo en el índice, y el lado "con trace-mcp" a partir de multiplicadores por escenario — no de llamadas reales a herramientas. Muestra el techo teórico. Para medir ahorros reales de tu propio uso, ejecuta trace-mcp durante un tiempo y luego:
trace-mcp analytics savings   # real sessions: reads vs. what trace-mcp would have cost
trace-mcp analytics optimize  # recommendations based on your actual usage
Consulta Analíticas de sesión y seguimiento de ahorro de tokens para más detalles.
Metodología
Estimado usando benchmark_project — recorre once categorías de tareas (búsqueda de símbolos, exploración de archivos, búsqueda de texto, encontrar usos, paquete de contexto, gasto general por lote, análisis de impacto, recorrido de grafo de llamadas, jerarquía de tipos, pruebas-para, contexto de tareas compuestas) sobre el proyecto indexado. No se invoca ninguna herramienta de trace-mcp. Cada cifra en ambos lados es una heurística sintética específica del escenario, y las heurísticas difieren por escenario. Se basan en tres tipos de entrada, mezclados de manera diferente en cada uno:
- Valores reales del índice —
byte_lengthde archivo, tamaños de fuente de símbolos y firmas. Estos soportan la línea base para búsqueda de símbolos, exploración de archivos, análisis de impacto y recorrido de grafo de llamadas. - Formas de resultado asumidas para operaciones sin equivalente indexado — p. ej., las líneas base de búsqueda de texto y encontrar usos asumen un rendimiento fijo de grep (coincidencias × líneas de contexto × 80 caracteres), se asume que
get_tests_forresponde en ~400 caracteres, y el escenario de gasto general por lote añade constantes fijas de tokens de marco / pista / metadatos de MCP por llamada. - Una fracción fija de la línea base, entre 0,05 y 0,45, donde ninguna de las anteriores aplica.
Los recuentos de caracteres se convierten a tokens mediante un estimador calibrado contra cl100k_base cuando gpt-tokenizer está instalado, y por una proporción fija de caracteres por token de 4,0 en caso contrario. El resultado es un límite superior de la reducción, no una medición de ella — las mismas advertencias se imprimen en la salida de la herramienta y se documentan al principio de src/analytics/benchmark.ts.
Reprodúcelo tú mismo:
# Via CLI (no install)
npx trace-mcp benchmark /path/to/project

# Or via MCP tool
benchmark_project  # runs against the current project
Capacidades clave
- Seguimiento del flujo de solicitudes — URL → Ruta → Middleware → Controlador → Servicio, en todos los frameworks backend
- Árboles de componentes — jerarquía de renderizado con props / emits / slots (Vue, React, Blade)
- Esquema desde migraciones — sin necesidad de conexión a BD
- Cadenas de eventos — Evento → Listener → Job fan-out (Laravel, Django, NestJS, Celery, Socket.io)
- Análisis de impacto de cambios — recorrido inverso de dependencias entre lenguajes, enriquecido con decisiones arquitectónicas vinculadas
- Contexto de tareas consciente del grafo — describe una tarea de desarrollo → obtén el subgrafo de código óptimo (rutas de ejecución, pruebas, tipos) + decisiones pasadas relevantes, adaptado a la intención de corrección de errores/funcionalidad/refactorización
- Grafo de llamadas y árbol de DI — grafos de llamadas bidireccionales con confianza de resolución de 4 niveles, enriquecimiento opcional con LSP para precisión de nivel compilador, inyección de dependencias de NestJS
- Contexto del modelo ORM — relaciones, esquema, metadatos para 7 ORMs
- Detección de código muerto y brechas de pruebas — encuentra exports/símbolos sin probar (con clasificación "no alcanzado" vs "importado_no_llamado"), código muerto, alcance de pruebas por símbolo en el análisis de impacto
- Escaneo de seguridad — escaneo de patrones OWASP Top-10 y análisis de flujo de datos (flujo de datos fuente→sumidero). Contexto de seguridad del servidor MCP exportable para skill-scan
- Búsqueda semántica, offline por defecto — los embeddings ONNX incluidos funcionan de inmediato, sin claves API; cambia a Ollama/OpenAI para resúmenes impulsados por LLM
- Memoria de decisiones — extrae decisiones de las sesiones, vincúlalas a símbolos/archivos, muéstralas automáticamente en el análisis de impacto
- Subproyectos multi-servicio — vincula grafos entre servicios mediante contratos API; impacto entre servicios + decisiones con alcance de servicio
- Informes de impacto de cambios en CI/PR — radio de explosión automatizado, puntuación de riesgo, detección de brechas de pruebas, violaciones de arquitectura en cada PR
Stack compatible
Lenguajes: PHP, TypeScript, JavaScript, Python, Go, Java, Kotlin, Ruby, Rust, C, C++, C#, Swift, Objective-C, Objective-C++, Dart, Scala, Groovy, Elixir, Erlang, Haskell, Gleam, Bash, Lua, Perl, GDScript, R, Julia, Nix, SQL, PL/SQL, HCL/Terraform, Protocol Buffers, GraphQL, Prisma, Vue SFC, HTML, CSS/SCSS/SASS/LESS, XML/XUL/XSD, YAML, JSON, TOML, Assembly, Fortran, AutoHotkey, Verse, AL, Blade, EJS, Zig, OCaml, Clojure, F#, Elm, CUDA, COBOL, Verilog/SystemVerilog, GLSL, Meson, Vim Script, Common Lisp, Emacs Lisp, Dockerfile, Makefile, CMake, INI, Svelte, Astro, Markdown, MATLAB, Lean 4, FORM, Magma, Wolfram/Mathematica, Ada, Apex, D, Nim, Pascal, PowerShell, Solidity, Tcl
Frameworks: Laravel (+ Livewire, Nova, Filament, Pennant), Django (+ DRF), FastAPI, Flask, Express, NestJS, Fastify, Hono, Next.js, Nuxt, Rails, Spring, tRPC
ORMs: Eloquent, Prisma, TypeORM, Drizzle, Sequelize, Mongoose, SQLAlchemy
Frontend: Vue, React, React Native, Blade, Inertia, shadcn/ui, Nuxt UI, MUI, Ant Design, Headless UI
Otros: GraphQL, Socket.io, Celery, Zustand, Pydantic, Zod, n8n, React Query/SWR, Playwright/Cypress/Jest/Vitest/Mocha
Bóvedas de conocimiento: Obsidian, Logseq, markdown plano — [[wikilinks]], ![[embeds]], [text](path.md), frontmatter (YAML), #tags, encabezados ATX. Cada nota se convierte en un símbolo note:<basename> con secciones anidadas en su interior; los wikilinks se resuelven a bordes references / embeds entre notas. Mezcla bóveda y código en un solo proyecto — apunta root a un directorio que contenga ambos y ejecuta un único find_usages sobre ellos.
Detalles completos: Frameworks compatibles · Todas las herramientas
Inicio rápido
Ve tu desperdicio primero — 5 minutos, sin configuración, sin registro:
npx trace-mcp benchmark .
Indexa el proyecto, ejecuta 11 benchmarks de tareas estructuradas (búsqueda de símbolos, análisis de impacto, grafo de llamadas, jerarquía de tipos, …) e imprime el costo estimado de tokens por tarea — sin trace vs. con. Verás exactamente dónde tu agente recalcula trabajo que podría reutilizar. Es una estimación sintética calculada desde tu índice, no un registro de llamadas reales a herramientas (consulta el bloque de Metodología en "Reducción de tokens" arriba); para ahorros medidos de tus propias sesiones usa trace-mcp analytics savings.
Luego conéctalo a tu agente de IA:
npm install -g trace-mcp
trace init        # one-time global setup (MCP clients, hooks, CLAUDE.md)
trace add         # register current project for indexing
init— configura tu cliente MCP (Claude Code, Cursor, Windsurf, Claude Desktop, …), instala el hook de protección, agrega reglas de enrutamiento a~/.claude/CLAUDE.md.add— detecta frameworks, crea el índice por proyecto, registra el proyecto. Vuelve a ejecutarlo en cada proyecto que quieras que trace entienda.
(El paquete npm todavía se llama trace-mcp — solo se acorta el comando que instala. trace-mcp init, trace-mcp add y cualquier otra invocación de trace-mcp … siguen funcionando.)
Todo el estado vive en ~/.trace/ (con respaldo automático desde ~/.trace-mcp/) — tu directorio de proyecto se mantiene limpio a menos que optes por .traceignore o .trace/.config.json.
¿Usas Claude Code o Codex CLI? Después de npm install -g trace-mcp, omite el paso de conexión del cliente de trace init e instala el plugin directamente — no necesitas git clone de ninguna manera:
# Claude Code
claude plugin install @nikolai-vysotskyi/trace-mcp

# Codex CLI
codex plugin marketplace add nikolai-vysotskyi/trace-mcp
codex plugin install trace-mcp@nikolai-vysotskyi-trace-mcp
Ambos registran el servidor MCP trace-mcp más el hook de protección Bash en un solo paso. Detalles: .claude-plugin/README.md · .codex-plugin/README.md.
Luego en tu cliente MCP:
> get_project_map to see what frameworks are detected
> get_task_context("fix the login bug") to get full execution context for a task
> get_change_impact on app/Models/User.php to see what depends on it
Indexación de una bóveda de markdown (Obsidian / Logseq / MD plano). Apunta trace add a la raíz de la bóveda — .md/.mdx/.markdown se detectan por defecto. Cada nota se convierte en un símbolo note:<basename>, los encabezados se anidan como secciones, [[wikilinks]] y ![[embeds]] se resuelven a bordes del grafo, los aliases: del frontmatter hacen que los nombres alternativos sean resolubles, y #tags se agregan para que cada nota que lleve #sgr esté a un find_usages de distancia.
> find_usages on note:my-concept     // backlinks across the vault
> find_usages on tag:sgr             // every note tagged #sgr
> get_change_impact on note:legacy   // what breaks if I rename or delete it
> search "schema-guided reasoning"   // PageRank + embeddings over the vault
¿Prefieres una GUI? La aplicación de escritorio maneja la instalación, la indexación, la conexión del cliente MCP y la re-indexación sin tocar una terminal.
Para ir más allá: agregar más proyectos / actualizar / configuración manual · configuración stdio vs HTTP (por repositorio o equipo) · búsqueda semántica (ONNX local) · indexación y observador de archivos · .traceignore.
Migración de trace-mcp a trace
El proyecto sigue siendo trace-mcp. El comando ahora es trace. El cambio de nombre vive exactamente en ese límite y en ningún otro lugar — el paquete npm, este repositorio, el dominio y la entrada del registro mantienen el nombre trace-mcp. La razón es la ergonomía, con la misma forma que rg para ripgrep o kubectl para kubernetes — no es ahorro de tokens: el ahorro medido del prefijo de herramienta MCP más corto es real pero pequeño, 66–366 tokens por turno según el tokenizador y el preset, 0.74–1.23% de una lista de herramientas que ya cuesta 8k–45k tokens.
El nombre del paquete npm no cambia. Sigue siendo trace-mcp, y siempre lo será — trace en npm es un paquete no relacionado de otro autor. Instala con npm install -g trace-mcp o npx -y trace-mcp@latest.
Lo que cambia, y lo que se mantiene:
- Nombre del comando —
trace <cmd>es la nueva ortografía.trace-mcp <cmd>se mantiene como alias permanentemente — en macOS,/usr/bin/tracees el propiotrace(1)de Apple, así que sigue usandotrace-mcpen scripts, CI o cualquier PATH que no controles tú mismo. - Entradas del cliente MCP —
trace initytrace upgraderenombran una entrada existente demcpServers["trace-mcp"]amcpServers["trace"]y la apuntan al nuevo comando. Nada se elimina; una entrada dejada comotrace-mcpsigue funcionando, solo cuesta más tokens. - Directorio de estado —
~/.trace/, con respaldo a~/.trace-mcp/cuando existe el antiguo y no el nuevo. Los índices no se reconstruyen. - Configuración del proyecto —
.trace.jsonse lee primero,.trace-mcp.jsondespués. Los archivos existentes siguen funcionando donde están. - Identificadores de plugin y registro — sin cambios:
@nikolai-vysotskyi/trace-mcppara el plugin de Claude Code,io.github.nikolai-vysotskyi/trace-mcpen el registro MCP.
Una cosa que init no puede hacer por ti. El prefijo de herramienta MCP también se mueve — mcp__trace-mcp__search se convierte en mcp__trace__search. init migra la entrada de mcpServers que posee, pero no el texto que escribiste tú mismo: listas de permisos de Claude Code, matchers de hooks, o tus propias menciones de mcp__trace-mcp__* en prosa de CLAUDE.md/AGENTS.md. Si un hook deja de coincidir o una herramienta en la lista de permisos comienza a volver a preguntar después de actualizar, busca en tu propia configuración mcp__trace-mcp__ y reemplázalo con mcp__trace__. Todo lo demás arriba ocurre automáticamente la próxima vez que ejecutes trace init o trace upgrade — detalles: Configuración.
Local-first por diseño
trace-mcp se ejecuta completamente en tu máquina. Nada de tu código fuente se sube, y no hay cuenta que crear.
- La indexación ocurre localmente. El servidor MCP es un proceso de Node que ejecutas tú mismo — stdio o
http://127.0.0.1:3741. - El índice vive en
~/.trace/(con respaldo a~/.trace-mcp/si eso es lo que ya tienes), nunca dentro de tu proyecto y nunca se sube. El directorio de tu repositorio se mantiene limpio a menos que optes por.traceignoreo.trace/.config.json. - La búsqueda semántica es offline por defecto — embeddings ONNX incluidos, sin claves API, sin llamadas salientes. Cambia a Ollama (local) u OpenAI (opt-in) mediante configuración.
- Sin telemetría sobre tu código, consultas o uso. Lo único que sale de tu máquina se describe abajo y en la página de privacidad — nada más se envía a casa.
- Lo que ve tu cliente de IA lo gobierna tu cliente de IA. trace-mcp devuelve resultados de grafos a través de MCP; cómo Claude Code / Cursor / Codex / Windsurf los reenvían a un modelo depende del modelo de privacidad de ese cliente.
- El daemon confía en loopback y nada más.
serve-httpno está autenticado por diseño: un llamador en127.0.0.1ya eres tú. Por lo tanto, un--hostque no sea loopback se rechaza a menos que pases--allow-remotey protejas el puerto con tu propia autenticación — consulta Configuración. - Para borrar todo, elimina
~/.trace/(o~/.trace-mcp/en una instalación que aún no haya migrado) — ese directorio es toda la huella.
Telemetría de uso
trace-mcp envía como máximo un ping anónimo por día, por instalación, para que podamos contar instalaciones activas: versión, SO, cliente MCP y conteos agregados. Sin código, sin rutas, sin dirección IP y sin identificador por instalación más allá de un UUID generado localmente en tu máquina. Se suprime en CI, y sus credenciales de GA4 viajan como texto plano en el paquete publicado para que puedas verificar a dónde va el ping.
Desactívalo con TRACE_MCP_TELEMETRY=off, o con "telemetry": { "usage_ping": false } en ~/.trace/.config.json.
La lista completa de campos, ambas opciones de exclusión y cómo eliminar el estado local están en la página de privacidad. Fuente: src/telemetry/usage-ping.ts.
Para entornos sensibles a la seguridad, revisa SECURITY.md antes de usar.
Cómo sacar el máximo provecho de trace-mcp
trace-mcp funciona en tres niveles para hacer que los agentes de IA usen sus herramientas en lugar de la lectura directa de archivos:
Nivel 1: Automático (funciona de inmediato)
El servidor MCP proporciona instrucciones y descripciones de herramientas con sugerencias de enrutamiento que indican a los agentes de IA cuándo preferir trace-mcp sobre Read/Grep/Glob nativos. Esto funciona con cualquier cliente compatible con MCP — sin necesidad de configuración.
Nivel 2: CLAUDE.md (recomendado)
trace-mcp init agrega un bloque de Política de Navegación de Código a ~/.claude/CLAUDE.md (o al CLAUDE.md de tu proyecto) que indica al agente qué herramienta de trace-mcp preferir sobre Read/Grep/Glob para cada tipo de tarea. Si omitiste init, consulta Enrutamiento de prompt del sistema para ver el bloque completo y cómo ajustar la aplicación.
Nivel 3: Aplicación mediante hooks (solo Claude Code)
Para la aplicación estricta, trace-mcp init instala un hook de guardia PreToolUse que bloquea Read/Grep/Glob en archivos fuente y redirige al agente hacia las herramientas de trace-mcp (archivos que no son código, Read-before-Edit y comandos Bash seguros pasan). Gestiona manualmente con trace-mcp setup-hooks --global / --uninstall. Detalles: Enrutamiento de prompt del sistema.
Nivel 4: Nivel máximo — reescrituras del prompt del sistema + reglas de comportamiento del agente
Elegir Max durante trace-mcp init (el valor predeterminado) añade dos amplificadores más:
- Las reescrituras del prompt del sistema de tweakcc parchean las descripciones de las herramientas principales de Claude Code para que el modelo internalice "usar búsqueda de trace-mcp" en lugar de "usar Grep" desde el principio. Solo Claude Code.
agent_behavior: "strict"incluye un conjunto compacto de reglas de disciplina a través de instrucciones MCP: sin halagos, discrepar con premisas incorrectas, nunca inventar, ejecución orientada a objetivos, higiene de sesión de 2 strikes, sin refactorizaciones de paso. Multi-cliente (Claude Code, Cursor, Codex, Windsurf) y se actualiza automáticamente ennpm upgrade trace-mcpsin volver a ejecutarinit.
Esta es la configuración para que las mismas reglas de disciplina se apliquen al agente de cada compañero sin pedirle a nadie que lo configure. Ajusta o desactiva mediante tools.agent_behavior en ~/.trace/.config.json — consulta Exposición de herramientas y comportamiento del agente.
Memoria de decisiones
Las decisiones, compensaciones y descubrimientos de las conversaciones con agentes de IA suelen desaparecer cuando termina la sesión. trace-mcp las captura y vincula cada decisión al código al que se refiere — de modo que cuando alguien ejecute get_change_impact en src/db/connection.ts::Pool#class, la decisión "elegimos PostgreSQL por JSONB" aparezca automáticamente.
- Minería —
mine_sessionsescanea los registros JSONL de Claude Code / Claw Code y extrae decisiones mediante coincidencia de patrones (0 llamadas LLM). Tipos: arquitectura, elección tecnológica, causa raíz de errores, compensaciones, convenciones. - Vinculación — cada decisión se adjunta a un símbolo o archivo; admite decisiones con alcance de servicio para subproyectos.
- Superficie — las decisiones enriquecen automáticamente
get_change_impact,plan_turnyget_wake_up. La validez temporal (valid_from/valid_until) permite consultas como "¿qué era cierto el 15/01/2025?". - Búsqueda —
query_decisions(FTS5 + filtros) para decisiones;search_sessionspara contenido de conversación sin procesar en todas las sesiones pasadas.
trace memory mine                           # extract decisions from sessions
trace memory search "GraphQL migration"     # search past conversations
trace memory timeline --file src/auth.ts    # decision history for a file
Lista completa de herramientas, CLI, validez temporal, alcance de servicios: Memoria de decisiones.
Subproyectos
Un subproyecto es cualquier repositorio en el ecosistema de tu proyecto: microservicio, frontend, biblioteca compartida, herramienta CLI. trace vincula los grafos de dependencias entre subproyectos: si el servicio A llama a un endpoint en el servicio B, cambiar el endpoint en B se muestra como un cambio que rompe A.
La detección es automática. En cada indexación, trace detecta subproyectos (Docker Compose, espacios de trabajo planos/agrupados, respaldo monolítico), analiza contratos de API (OpenAPI, GraphQL SDL, Protobuf/gRPC), escanea el código en busca de llamadas de clientes HTTP (fetch, axios, Http::, requests, http.Get, stubs gRPC, operaciones GraphQL) y vincula las llamadas a endpoints conocidos.
cd ~/projects/my-app && trace add
# → auto-detects user-service (openapi.yaml) and order-service
# → links order-service → user-service via /api/users/{id}

trace subproject impact --endpoint=/api/users
# → [order-service] src/services/user-client.ts:42 (axios, confidence: 85%)
Los subproyectos externos se pueden añadir manualmente con trace subproject add --repo=... --project=.... Herramientas MCP: get_subproject_graph, get_subproject_impact, get_subproject_clients, subproject_add_repo, subproject_sync.
CLI completa, modos de detección, referencia de herramientas MCP, configuración de topología: Configuración — topología y subproyectos.
Informes de impacto de cambios en CI/PR
trace ci-report --base main --head HEAD produce un informe en markdown o JSON por solicitud de extracción: resumen, radio de explosión (recorrido inverso de dependencias de profundidad 2), brechas de cobertura de pruebas (hasTestReach por símbolo), análisis de riesgo (30% complejidad + 25% cambios + 25% acoplamiento + 20% radio de explosión), violaciones de arquitectura (detecta automáticamente presets limpios/hexagonales) y nuevas exportaciones muertas.
Usa --fail-on high para bloquear fusiones en cambios de alto riesgo. Consulta .github/workflows/ci.yml para una GitHub Action lista para usar que ejecuta build → test → impact-report y publica un comentario fijo de PR en cada push.
Programa piloto — para equipos que ejecutan LLM en producción
Si estás lanzando funciones de IA en producción — copilotos internos, asistentes orientados al cliente, RAG sobre una base de código o conocimiento — y estás alcanzando límites de costo, latencia o calidad, ejecutaremos un piloto enfocado contigo.
Formato: 2–4 semanas. Integración mínima. Uno o dos casos de uso reales de producción, no una demostración.
Lo que medimos (antes / después):
- Tokens por respuesta exitosa
- Precisión de primera respuesta (% de consultas resueltas sin reintento)
- Reintentos y llamadas de respaldo
- Latencia de extremo a extremo
- Tasa de éxito del usuario en un conjunto de evaluación fijo
Lo que obtienes: un informe claro de antes/después sobre si la optimización del contexto mueve las métricas que importan para tu stack — y un camino para escalar el uso con confianza en lugar de limitarlo por costo.
El objetivo es un sistema que se mantenga predecible a medida que crece el uso, no un recorte de costos único: los equipos suelen querer llegar primero a una producción confiable y expandir su huella de LLM después.
Ponte en contacto: abre un issue en github.com/nikolai-vysotskyi/trace-mcp/issues etiquetado pilot, o contacta a @nikolai-vysotskyi.
Cómo funciona
Source files (PHP, TS, Vue, Python, Go, Java, Kotlin, Ruby, HTML, CSS, Blade)
    │
    ▼
┌──────────────────────────────────────────┐
│  Pass 1 — Per-file extraction            │
│  tree-sitter → symbols                   │
│  integration plugins → routes,           │
│    components, migrations, events,       │
│    models, schemas, variants, tests      │
└────────────────────┬─────────────────────┘
                     │
                     ▼
┌──────────────────────────────────────────┐
│  Pass 2 — Cross-file resolution          │
│  PSR-4 · ES modules · Python modules    │
│  Vue components · Inertia bridge         │
│  Blade inheritance · ORM relations       │
│  → unified directed edge graph           │
└────────────────────┬─────────────────────┘
                     │
                     ▼
┌──────────────────────────────────────────┐
│  Pass 3 — LSP enrichment (opt-in)       │
│  tsserver · pyright · gopls ·           │
│  rust-analyzer → compiler-grade         │
│  call resolution, 4-tier confidence     │
└────────────────────┬─────────────────────┘
                     │
                     ▼
┌──────────────────────────────────────────┐
│  SQLite (WAL mode) + FTS5               │
│  nodes · edges · symbols · routes       │
│  + embeddings (local ONNX by default)   │
│  + optional: LLM summaries              │
└────────────────────┬─────────────────────┘
                     │
                     ▼
┌──────────────────────────────────────────┐
│  Decision Memory (decisions.db)         │
│  decisions · session chunks · FTS5      │
│  temporal validity · code linkage       │
│  auto-mined from session logs           │
└────────────────────┬─────────────────────┘
                     │
                     ▼
          MCP server (stdio or HTTP/SSE)
          182 tools · 10 resources
Incremental por defecto — los archivos se someten a hash de contenido; los archivos sin cambios se omiten en la reindexación.
Arquitectura de plugins — los plugins de lenguaje (extracción de símbolos) y los plugins de integración (bordes semánticos) se cargan según la detección del proyecto, organizados en categorías: framework, ORM, vista, API, validación, estado, tiempo real, pruebas, herramientas.
Detalles: Arquitectura y sistema de plugins — cómo funciona la indexación
Documentación
La documentación completa está en trace-mcp.com (mismo contenido que docs/ en este repositorio).
| Documento | Descripción |
|---|---|
| Frameworks compatibles | Lista completa de lenguajes, frameworks, ORMs, bibliotecas de UI y qué extrae cada uno |
| Referencia de herramientas | Las 182 herramientas MCP con descripciones y ejemplos de uso |
| Migración desde 1.x | Las siete herramientas retiradas en 2.0 (get_dead_exports, get_session_resume, …) y la llamada que reemplaza a cada una |
| Configuración | Opciones de configuración, configuración de IA, variables de entorno, ajustes de seguridad |
| Arquitectura | Cómo funciona la indexación, sistema de plugins, estructura del proyecto, stack tecnológico |
| Memoria de decisiones | Grafo de conocimiento de decisiones, minería de sesiones, búsqueda entre sesiones, contexto de activación |
| Analítica | Analítica de sesiones, seguimiento de ahorro de tokens, informes de optimización, puntos de referencia |
| Puertas de calidad | Umbrales de complejidad, seguridad y acoplamiento, y cómo quality_gates.rules anula los valores predeterminados de la CLI |
| Ahorros TOON | Ahorro de tokens medido del formato de salida TOON en llamadas de herramientas reales |
| Telemetría | Spans compatibles con OpenTelemetry para cada llamada de proveedor de IA y llamada de herramienta MCP |
| Enrutamiento de prompt del sistema | Integración opcional de tweakcc para máxima aplicación del enrutamiento de herramientas |
| Comparaciones | Tablas comparativas completas frente a otras herramientas de inteligencia de código / memoria / RAG |
| Desarrollo | Compilación, pruebas, contribución, adición de nuevos plugins |
| Sistema de diseño | El sistema de diseño macOS 26 de la aplicación de escritorio — tokens, tipografía, geometría, materiales, primitivas, pisos de accesibilidad |
Historial de estrellas
Salud del proyecto



Licencia
Construido por Nikolai Vysotskyi