mnemon-mcp
Memoria persistente en capas para agentes de IA — modelo de 4 capas, búsqueda FTS5, versionado de hechos, derivación EN+RU. Prioridad local, cero nube, archivo SQLite único.
Documentación
mnemon-mcp


Memoria persistente en capas para agentes de IA. Local primero. Sin nube. Un único archivo SQLite.
Página de inicio · npm · GitHub
Tu agente de IA lo olvida todo después de cada sesión. Mnemon lo soluciona.
Le da a cualquier cliente compatible con MCP — OpenClaw, Claude Code, Cursor, Windsurf, o el tuyo propio — una memoria estructurada a largo plazo respaldada por una única base de datos SQLite en tu máquina. Sin claves API, sin nube, sin telemetría. Solo npm install y tu agente recuerda.
¿Por qué memoria en capas?
Los almacenes planos de clave-valor tratan "lo que pasó ayer" igual que "nunca hagas commit sin pruebas". Eso está mal — diferentes tipos de conocimiento tienen diferentes ciclos de vida y patrones de acceso.
Mnemon organiza los recuerdos en cuatro capas:
| Capa | Qué almacena | Cómo se accede | Ciclo de vida |
|---|---|---|---|
| Episódica | Eventos, sesiones, entradas de diario | Por fecha o período | Decae (vida media de 30 días) |
| Semántica | Hechos, preferencias, relaciones | Por tema o entidad | Estable |
| Procedimental | Reglas, flujos de trabajo, convenciones | Se carga al inicio | Rara vez cambia |
| Recurso | Material de referencia, notas de libros | Bajo demanda | Decae lentamente (90 días) |
Una entrada de diario del martes pasado y una regla de codificación que nunca cambia viven en capas diferentes — porque así debe ser.
Calidad de recuperación
La recuperación se mide contra un conjunto dorado de 50 casos en un corpus bilingüe real (RU/EN) de 797 memorias, a través del servidor MCP real — no una reimplementación. Números actuales (metodología e historial):
| Métrica | Solo FTS | Solo vector | Híbrido (RRF) |
|---|---|---|---|
| Puntuación compuesta | 88.9 | 89.2 | 91.7 |
| Recall@5 | 0.907 | 0.898 | 0.919 |
| MRR | 0.817 | 0.832 | 0.878 |
| nDCG@5 | 0.816 | 0.828 | 0.869 |
| Precisión negativa | 1.000 | 1.000 | 1.000 |
El híbrido supera a ambas partes individualmente, que es todo el argumento para fusionarlas: la búsqueda léxica tiene mejor recall bruto, la búsqueda vectorial mejor ranking, y RRF conserva ambas en lugar de promediarlas.
El documento de evaluación también rastrea los fallos — deriva de puntuación bajo crecimiento del corpus, el error de ponderación de campos BM25 que la evaluación detectó, los dos casos donde la fusión aún pierde frente a la búsqueda léxica pura, y lo que el conjunto dorado no cubre. Los números que no se pueden auditar son marketing; lee cómo se producen.
Arquitectura
flowchart LR
    C["MCP client<br/>Claude Code · Cursor · …"] -- "stdio / HTTP" --> T["10 tools · 4 resources · 3 prompts"]
    T --> R["retrieval pipeline<br/>FTS5 · vector · RRF fusion"]
    T --> M["memories + supersede chains"]
    I["KB import pipeline<br/>markdown → memories"] --> M
    M -- triggers --> F["FTS5 index (stemmed EN+RU)"]
    R --> F
    R --> V["sqlite-vec (optional, BYOK)"]
Un único archivo SQLite contiene las memorias, el índice FTS5 y el índice vectorial opcional. Las escrituras pasan por transacciones que mantienen el invariante de la cadena de sustitución; las lecturas ejecutan el pipeline de recuperación escalonado descrito en Búsqueda.
El panorama completo — límites de módulos, rutas de escritura/lectura, invariantes y limitaciones conocidas — está en docs/ARCHITECTURE.md. Las decisiones de diseño se registran como ADR: núcleo SQLite+FTS5, recuperación híbrida RRF, controlador síncrono, modelo de memoria en capas.
Inicio rápido
Instalación
npm install -g mnemon-mcp
O desde el código fuente:
git clone https://github.com/nikitacometa/mnemon-memory-mcp.git
cd mnemon-memory-mcp && npm install && npm run build
Configura tu cliente MCP
OpenClaw
openclaw mcp register mnemon-mcp --command="mnemon-mcp"
O añade a ~/.openclaw/mcp_config.json:
{
  "mnemon-mcp": {
    "command": "mnemon-mcp"
  }
}
Claude Code
Añade a ~/.claude/mcp.json:
{
  "mcpServers": {
    "mnemon-mcp": {
      "command": "mnemon-mcp"
    }
  }
}
Cursor / Windsurf / Otros clientes MCP
Añade a la configuración MCP de tu cliente:
{
  "mcpServers": {
    "mnemon-mcp": {
      "command": "mnemon-mcp"
    }
  }
}
¿Ejecutando desde el código fuente?
Usa la ruta completa al punto de entrada compilado:
{
  "mnemon-mcp": {
    "command": "node",
    "args": ["/absolute/path/to/mnemon-mcp/dist/index.js"]
  }
}
Verificación
echo '{"jsonrpc":"2.0","method":"tools/list","id":1}' | mnemon-mcp
Deberías ver 10 herramientas en la respuesta. La base de datos (~/.mnemon-mcp/memory.db) se crea automáticamente en la primera ejecución.
Eso es todo. Tu agente ahora tiene memoria persistente.
Qué puede hacer
10 herramientas MCP
| Herramienta | Qué hace |
|---|---|
memory_add | Almacena una memoria con capa, entidad, confianza, importancia y TTL opcional |
memory_search | Búsqueda de texto completo o exacta con filtros por capa, entidad, fecha, alcance, confianza |
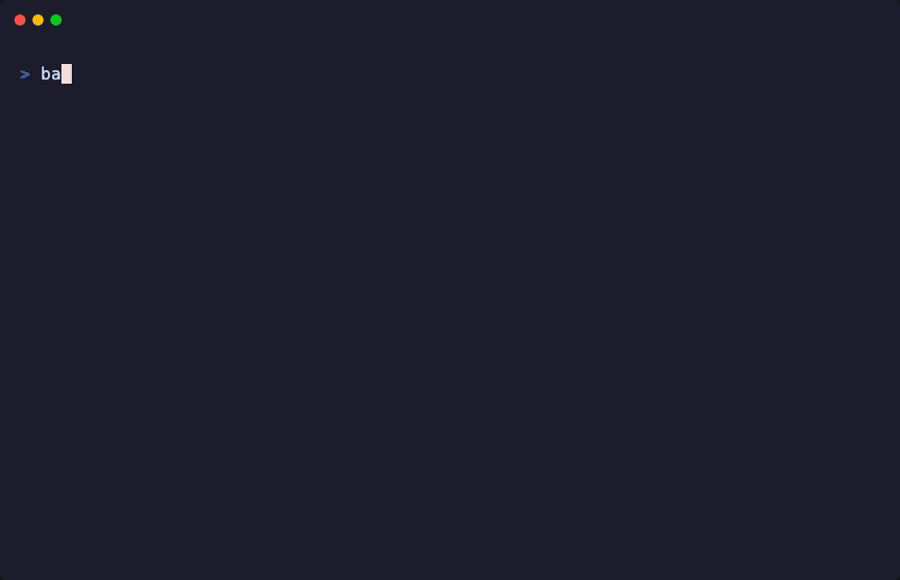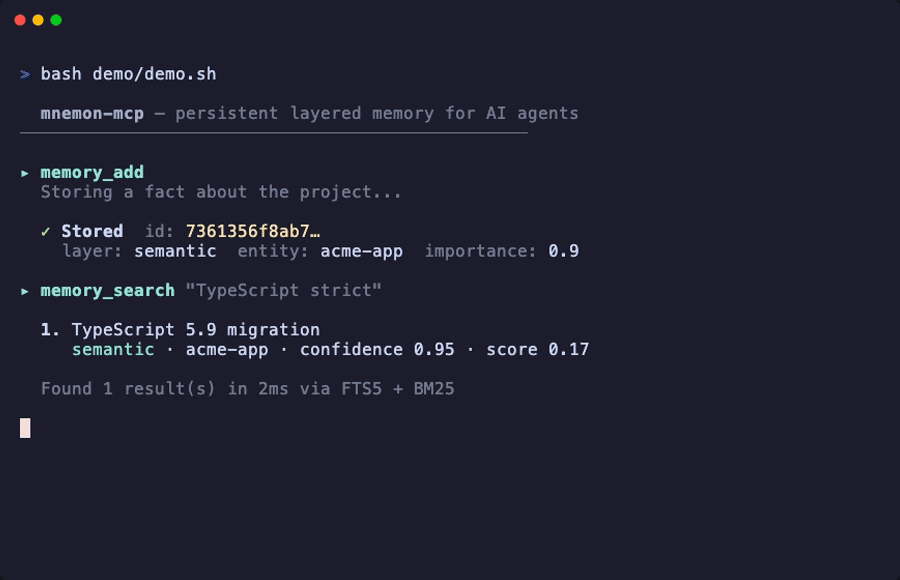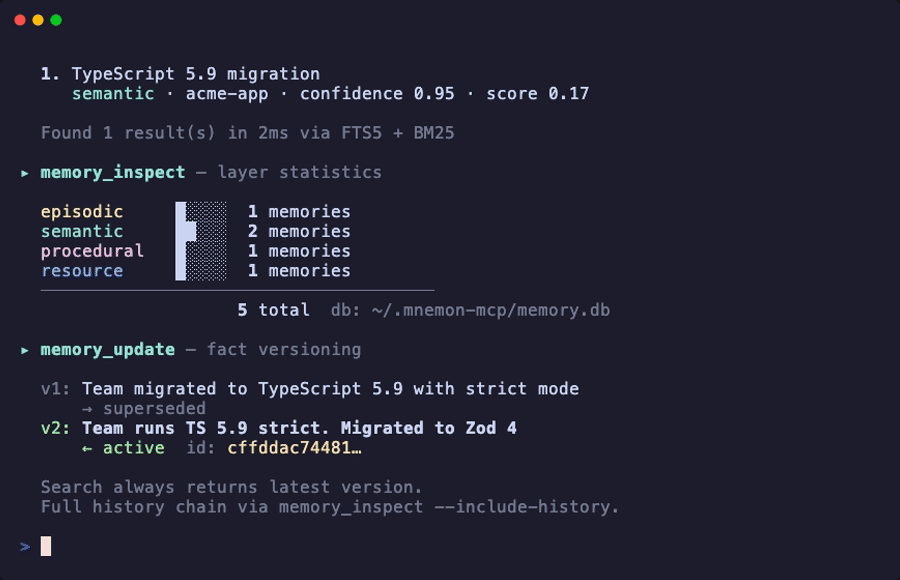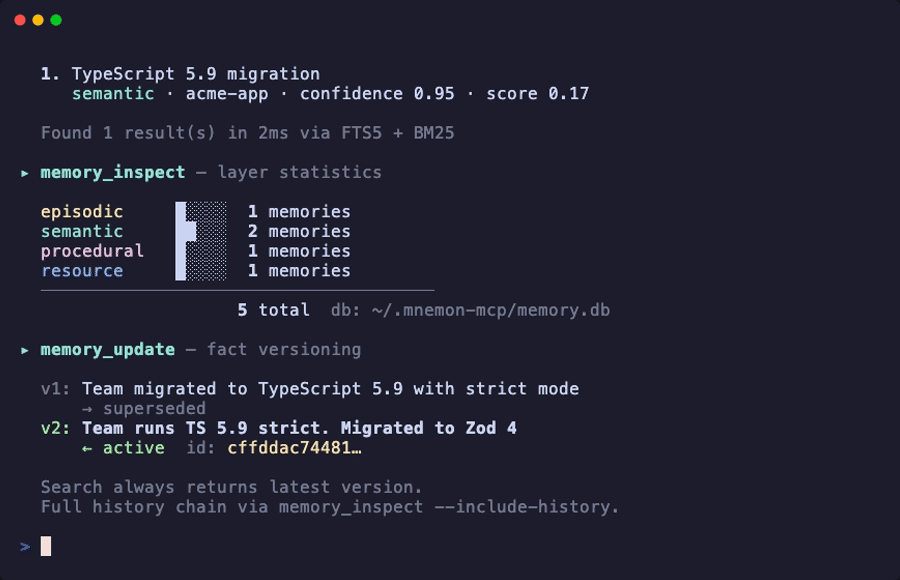
memory_update | Actualiza en el lugar o crea un reemplazo versionado (cadena de sustitución) |
memory_delete | Elimina una memoria; reactiva su predecesora si existe |
memory_inspect | Obtiene estadísticas de capa o rastrea el historial de versiones de una sola memoria |
memory_export | Exporta a JSON, Markdown o formato Claude-md con filtros |
memory_health | Ejecuta diagnósticos: entradas expiradas, cadenas huérfanas, memorias obsoletas; GC opcional |
memory_session_start | Inicia una sesión de agente — devuelve ID de sesión para agrupar memorias |
memory_session_end | Termina una sesión con resumen opcional; devuelve duración y recuento de memorias |
memory_session_list | Lista sesiones con filtros por cliente, proyecto o estado activo |
Recursos y prompts MCP
Recursos — datos en vivo que tu agente puede leer:
| URI | Devuelve |
|---|---|
memory://stats | Estadísticas agregadas por capa |
memory://recent | Memorias creadas/actualizadas en las últimas 24h |
memory://layer/{layer} | Todas las memorias activas en una capa |
memory://entity/{name} | Todas las memorias activas sobre una entidad |
Prompts — flujos de trabajo preconstruidos:
| Prompt | Propósito |
|---|---|
recall | "Cuéntame todo lo que sabes sobre X" |
context-load | Carga contexto relevante antes de comenzar una tarea |
journal | Crea una entrada de diario estructurada |
Búsqueda
Cuatro modos, todos con soporte de filtros por capa / entidad / alcance / fecha / confianza:
Modo FTS (predeterminado sin embeddings) — búsqueda de texto completo tokenizada con ranking BM25. Las consultas de varias palabras usan AND; si hay muy pocos resultados, OR complementa con una penalización de puntuación. La relajación progresiva de AND prueba los 3 términos más específicos antes de recurrir a OR completo.
Modo híbrido (predeterminado cuando hay embeddings configurados) — combina FTS5 + búsqueda vectorial mediante Fusión de Ranking Recíproco. Detecta entidades entre comillas en las consultas (p. ej., 'Essentialism') y ejecuta subconsultas ponderadas para recuperación de referencias cruzadas.
Modo vectorial — búsqueda pura de similitud coseno sobre embeddings.
Modo exacto — coincidencia de subcadena LIKE para búsquedas precisas de frases.
Puntuaciones: bm25 × (0.3 + 0.7 × importance) × decay(layer) × recency
Impulso de actualidad: 1 / (1 + daysSince / 365) — recompensa suavemente las memorias creadas recientemente sin penalizar las antiguas.
Derivación (Stemming)
Se aplica el derivador Snowball tanto en tiempo de indexación como en tiempo de consulta para inglés y ruso. Esto significa que "running" coincide con "runs", y "книги" coincide con "книга". Las palabras vacías se filtran de las consultas para mejorar la precisión.
Versionado de hechos
El conocimiento evoluciona. Mnemon no elimina hechos antiguos — los encadena:
v1: "Team uses React 17"  →  superseded_by: v2
v2: "Team uses React 19"  →  supersedes: v1 (active)
La búsqueda devuelve solo la versión más reciente. memory_inspect con include_history: true revela la cadena completa. memory_delete reactiva la predecesora — nada se pierde.
Búsqueda vectorial (Opcional, BYOK)
Habilita la búsqueda de similitud semántica proporcionando tu propia API de embeddings:
# OpenAI
MNEMON_EMBEDDING_PROVIDER=openai MNEMON_EMBEDDING_API_KEY=sk-... mnemon-mcp

# Ollama (local, free)
MNEMON_EMBEDDING_PROVIDER=ollama mnemon-mcp
Esto desbloquea dos modos de búsqueda adicionales:
mode: "vector"— búsqueda pura de similitud cosenomode: "hybrid"— FTS5 + vectorial combinados mediante Fusión de Ranking Recíproco
Requiere sqlite-vec (instalado como dependencia opcional). Las nuevas memorias se incrustan al añadirse; las existentes se pueden rellenar retroactivamente.
Configuración de embeddings
| Variable | Predeterminado | Descripción |
|---|---|---|
MNEMON_EMBEDDING_PROVIDER | — | openai o ollama (sin definir = deshabilitado) |
MNEMON_EMBEDDING_API_KEY | — | Clave API (requerida para OpenAI) |
MNEMON_EMBEDDING_MODEL | text-embedding-3-small / nomic-embed-text | Nombre del modelo |
MNEMON_EMBEDDING_DIMENSIONS | 1024 / 768 | Dimensiones del vector |
MNEMON_OLLAMA_URL | http://localhost:11434 | Endpoint de Ollama |
Importar una base de conocimiento
¿Tienes una carpeta de archivos Markdown? Impórtalos en lote:
cp config.example.json ~/.mnemon-mcp/config.json   # edit this first
npm run import:kb -- --kb-path /path/to/your/kb     # incremental (skips unchanged files)
La configuración asigna patrones glob a capas de memoria:
{
  "owner_name": "your-name",
  "extra_stop_words": [],
  "mappings": [
    {
      "glob": "journal/*.md",
      "layer": "episodic",
      "entity_type": "user",
      "entity_name": "$owner",
      "importance": 0.6,
      "split": "h2"
    },
    {
      "glob": "people/*.md",
      "layer": "semantic",
      "entity_type": "person",
      "entity_name": "from-heading",
      "importance": 0.8,
      "split": "h3"
    }
  ]
}
Campos de configuración
| Campo | Tipo | Descripción |
|---|---|---|
owner_name | string | Tu nombre — se usa para la sustitución de $owner en entity_name |
extra_stop_words | string[] | Palabras a filtrar de las consultas FTS (p. ej., formas de tu nombre) |
glob | string | Patrón de archivo a coincidir |
layer | string | Capa de memoria de destino |
entity_type | string | user / person / project / concept / file / rule / tool |
entity_name | string | Nombre literal, "$owner", o "from-heading" (extraer de H2/H3) |
split | string | "whole" (una memoria por archivo), "h2", o "h3" (dividir por encabezados) |
importance | number | 0.0–1.0, afecta el ranking de búsqueda |
confidence | number | 0.0–1.0, filtrable en búsqueda |
scope | string | Espacio de nombres opcional |
Transporte HTTP
Para configuraciones remotas o de múltiples clientes:
MNEMON_AUTH_TOKEN=your-secret MNEMON_HOST=0.0.0.0 MNEMON_PORT=3000 npm run start:http
| Endpoint | Descripción |
|---|---|
POST /mcp | MCP JSON-RPC (autenticación Bearer si hay token configurado) |
GET /health | {"status":"ok","version":"..."} |
Se vincula a 127.0.0.1 por defecto. Vincular a cualquier otro host requiere MNEMON_AUTH_TOKEN — el servidor se niega a exponer el almacén de memoria a la red sin autenticación (anular con MNEMON_ALLOW_INSECURE_HTTP=1 en una red de confianza). Limitación de velocidad (100 req/min/IP por defecto), CORS opcional, límite de cuerpo de 1MB, autenticación a prueba de temporización, apagado elegante en SIGTERM.
Referencia de configuración
| Variable | Predeterminado | Descripción |
|---|---|---|
MNEMON_DB_PATH | ~/.mnemon-mcp/memory.db | Ruta de la base de datos |
MNEMON_KB_PATH | . | Raíz de la base de conocimiento para importación |
MNEMON_CONFIG_PATH | ~/.mnemon-mcp/config.json | Ruta de configuración de importación |
MNEMON_AUTH_TOKEN | — | Token Bearer para transporte HTTP |
MNEMON_HOST | 127.0.0.1 | Dirección de vinculación del transporte HTTP |
MNEMON_PORT | 3000 | Puerto del transporte HTTP |
MNEMON_CORS_ORIGIN | — | CORS Access-Control-Allow-Origin (sin encabezados CORS a menos que se configure) |
MNEMON_RATE_LIMIT | 100 | Máximo de solicitudes por minuto por IP (0 = desactivado) |
Referencia de herramientas
memory_add — lista completa de parámetros
| Parámetro | Tipo | Requerido | Descripción |
|---|---|---|---|
content | string | Sí | Texto de la memoria (máx. 100K caracteres) |
layer | string | Sí | episodic / semantic / procedural / resource |
title | string | No | Título corto (máx. 500 caracteres) |
entity_type | string | No | user / project / person / concept / file / rule / tool |
entity_name | string | No | Nombre de entidad para filtrado |
confidence | number | No | 0.0–1.0 (predeterminado 0.8) |
importance | number | No | 0.0–1.0 (predeterminado 0.5) |
scope | string | No | Espacio de nombres (predeterminado global) |
source_file | string | No | Ruta del archivo fuente — activa auto-sustitución de entradas coincidentes |
ttl_days | number | No | Auto-expiración después de N días |
valid_from / valid_until | string | No | Ventana de hecho temporal (ISO 8601) |
memory_search — lista completa de parámetros
| Parámetro | Tipo | Obligatorio | Descripción |
|---|---|---|---|
query | string | Sí | Texto de búsqueda |
mode | string | No | fts (predeterminado), exact, vector, hybrid |
layers | string[] | No | Filtrar por capas |
entity_name | string | No | Filtrar por entidad (admite alias) |
scope | string | No | Filtrar por ámbito |
date_from / date_to | string | No | Rango de fechas (ISO 8601) |
as_of | string | No | Filtro de hechos temporales — hechos válidos en esta fecha |
min_confidence | number | No | Confianza mínima |
min_importance | number | No | Importancia mínima |
limit | number | No | Máximo de resultados (predeterminado 10, máximo 100) |
offset | number | No | Desplazamiento de paginación |
memory_update — lista completa de parámetros
| Parámetro | Tipo | Obligatorio | Descripción |
|---|---|---|---|
id | string | Sí | ID de memoria |
content | string | No | Nuevo contenido |
title | string | No | Nuevo título |
confidence | number | No | Nueva confianza |
importance | number | No | Nueva importancia |
supersede | boolean | No | true = reemplazo versionado; false (predeterminado) = en el lugar |
new_content | string | No | Contenido para la entrada que sustituye |
memory_delete
| Parámetro | Tipo | Obligatorio | Descripción |
|---|---|---|---|
id | string | Sí | ID de memoria. Reactiva el predecesor si forma parte de una cadena de sustitución |
memory_inspect
| Parámetro | Tipo | Obligatorio | Descripción |
|---|---|---|---|
id | string | No | ID de memoria (omitir para estadísticas agregadas) |
layer | string | No | Filtrar estadísticas por capa |
entity_name | string | No | Filtrar estadísticas por entidad |
include_history | boolean | No | Mostrar cadena de sustitución |
memory_export
| Parámetro | Tipo | Obligatorio | Descripción |
|---|---|---|---|
format | string | Sí | json / markdown / claude-md |
layers | string[] | No | Filtrar por capas |
scope | string | No | Filtrar por ámbito |
date_from / date_to | string | No | Rango de fechas |
limit | number | No | Máximo de entradas (predeterminado todas, máximo 10K) |
memory_health
| Parámetro | Tipo | Obligatorio | Descripción |
|---|---|---|---|
cleanup | boolean | No | true = recolectar basura de entradas expiradas (predeterminado: solo informe) |
Devuelve: estado (healthy / warning / degraded), estadísticas por capa, entradas expiradas, cadenas huérfanas, recuentos obsoletos/de baja confianza, recuento limpiado cuando cleanup=true.
memory_session_start
| Parámetro | Tipo | Obligatorio | Descripción |
|---|---|---|---|
client | string | Sí | Identificador del cliente (p. ej. claude-code, cursor, api) |
project | string | No | Ámbito del proyecto para esta sesión |
meta | object | No | Metadatos adicionales de la sesión |
Devuelve: id (UUID de sesión), started_at (ISO 8601).
memory_session_end
| Parámetro | Tipo | Obligatorio | Descripción |
|---|---|---|---|
id | string | Sí | ID de sesión a finalizar |
summary | string | No | Resumen de lo logrado (máximo 10K caracteres) |
Devuelve: id, ended_at, duration_minutes, memories_count.
memory_session_list
| Parámetro | Tipo | Obligatorio | Descripción |
|---|---|---|---|
limit | number | No | Máximo de sesiones (predeterminado 20, máximo 100) |
client | string | No | Filtrar por cliente |
project | string | No | Filtrar por proyecto |
active_only | boolean | No | Devolver solo sesiones que no han finalizado (predeterminado false) |
Devuelve: matriz de sesiones con id, client, project, started_at, ended_at, summary, memories_count.
Cómo se compara
| mnemon-mcp | mem0 | basic-memory | Engram | Anthropic KG | |
|---|---|---|---|---|---|
| Arquitectura | SQLite FTS5 + vector | Cloud API + Qdrant | Markdown + vector | SQLite FTS5 | Archivo JSON |
| Estructura de memoria | 4 capas tipadas | Plana | Plana | Plana + sesiones | Grafo |
| Búsqueda | FTS5 + híbrida RRF | Semántica | Híbrida | FTS5 | Exacta |
| Versionado de hechos | Cadenas de sustitución | Parcial | No | No | No |
| Derivación (stemming) | EN + RU (Snowball) | Solo EN | Solo EN | Ninguna | Ninguna |
| Embeddings | BYOK (OpenAI / Ollama) | Integrado | FastEmbed | Ninguno | Ninguno |
| Dependencias | 0 obligatorias | Qdrant, Neo4j | Python 3.12 | Binario Go | Ninguna |
| Nube obligatoria | No | Sí | No | No | No |
| Costo | Gratis | $19–249/mes | Gratis | Gratis | Gratis |
| Configuración | npm install -g | Docker + claves API | pip + dependencias | Instalación Go | Integrada |
| Licencia | MIT | Apache 2.0 | AGPL | MIT | MIT |
Análisis competitivo extendido con fuentes: docs/COMPETITORS.md.
Desarrollo
npm run dev        # run via tsx (no build step)
npm run build      # TypeScript → dist/
npm run lint       # eslint (flat config)
npm test           # vitest — unit + integration + MCP dispatch + HTTP transport + hybrid RRF
npm run bench      # performance benchmarks
npm run db:backup  # backup database
CI ejecuta compilación + lint + pruebas en Node 20 y 22, luego pruebas de humo del servidor compilado sobre JSON-RPC real (tools/list debe coincidir con el conjunto exacto de herramientas).
Stack: TypeScript 5.9 (modo estricto), better-sqlite3, @modelcontextprotocol/sdk, derivador Snowball, Zod, vitest.
Consulta CONTRIBUTING.md para las pautas de código.
Principios de diseño
- Aislado por defecto — cero telemetría, siempre. De fábrica nada sale de la máquina; el único componente que habla con la red es el embedder opcional, y solo con el proveedor que configures (incluido un Ollama local).
- Archivo único — una base de datos SQLite, cero operaciones, copia de seguridad instantánea mediante copia de archivo.
- Búsqueda determinista — FTS5, no embeddings, es el predeterminado. Interpretable, reproducible, sin necesidad de GPU.
- Estructurado sobre plano — las capas codifican patrones de acceso; las cadenas de sustitución codifican el tiempo.
- Mínimo — 4 dependencias de producción. Funciona en cualquier lugar donde Node funcione.
- Medido, no afirmado — los cambios en la recuperación se evalúan contra un conjunto dorado, regresiones incluidas.