StudyDiff
Explica por qué dos artículos científicos discrepan: extrae el diseño de cada estudio, muestra en qué se diferencian y fundamenta cada afirmación en una cita textual de la fuente. Los ejemplos resueltos integrados funcionan sin clave de API.
Documentación
StudyDiff
Comprende por qué dos estudios científicos llegan a conclusiones diferentes —
con cada afirmación verificada contra la fuente.









Demo en vivo · Inicio rápido · Cómo funciona · Ejemplos · Servidor MCP · Hoja de ruta · Contribuciones
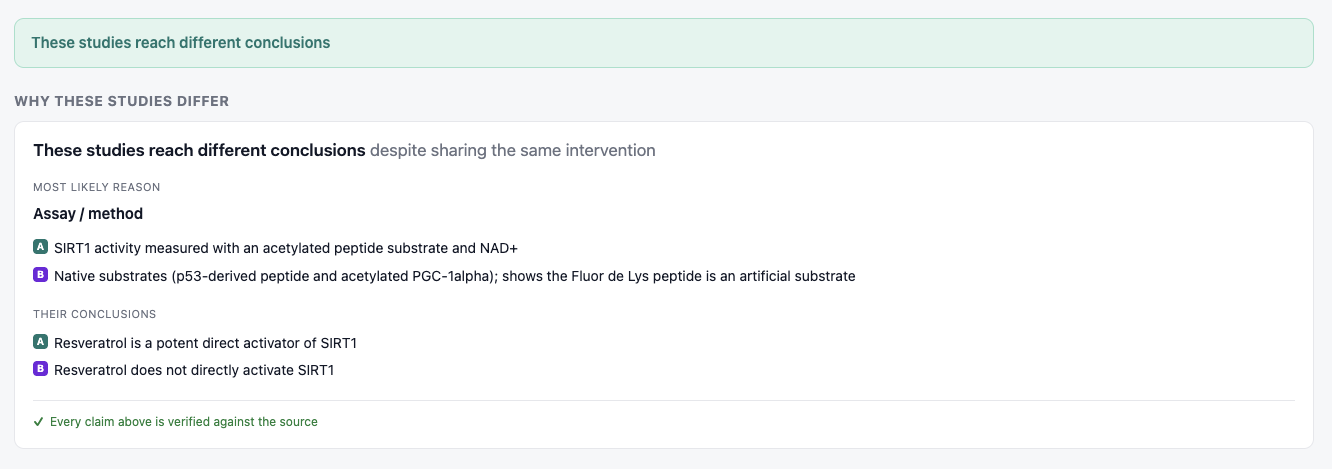
Dos artículos bien realizados a menudo llegan a conclusiones opuestas. Normalmente la razón no es que uno esté equivocado — es una diferencia metodológica (un tipo celular, una dosis, una ventana de seguimiento, una elección de análisis) que el lector tiene que extraer manualmente de las secciones de métodos. StudyDiff hace esa extracción. Dale dos estudios y extrae el diseño de cada uno, saca a la superficie las diferencias que podrían explicar el desacuerdo y — crucialmente — fundamenta cada afirmación en el texto fuente, de modo que nunca inventa un hallazgo.
Está construido para un científico de laboratorio que decide cuál de dos artículos en conflicto merece confianza antes de planificar un experimento.
Por qué es diferente
La mayoría de las herramientas de "literatura con IA" generan una respuesta fluida y te piden que confíes en ella. StudyDiff invierte eso:
- Muestra la evidencia y luego se aparta. Las diferencias de diseño arriba; cada valor con la frase textual que lo respalda debajo — y haz clic en cualquier valor verificado para ver esa frase exacta resaltada en el texto del propio artículo.
- Se niega a adivinar. Cualquier campo que la fuente no indique se muestra como no reportado, nunca inferido.
- Se verifica a sí mismo. Una comprobación determinista de fundamentación (sin un segundo LLM actuando como juez) confirma que cada valor extraído y cada explicación están respaldados por una cita textual y números trazables. Cualquier cosa que falle se degrada antes de que pueda usarse como razón.
- Sabe lo que no puede hacer, porque fue medido — en dos conjuntos de referencia independientes, el segundo reservado y puntuado una sola vez. Ver más abajo.
¿Funciona? Una respuesta medida
StudyDiff solía clasificar las dimensiones de diseño divergentes y presentar la principal como el probable impulsor de un desacuerdo. Construimos un punto de referencia para probar eso, y no funciona.
15 contradicciones documentadas donde la literatura ha establecido desde entonces por qué los artículos discrepaban — cada etiqueta con su propia cita, el conjunto construido a ciegas antes de que existiera cualquier cifra de precisión. Puntuado contra el impulsor principal de StudyDiff:
Top-1 accuracy (strict)      13.3%  (95% CI 3.7-37.9%)   [2/15]
Baseline "always say assay"  13.3%  (95% CI 3.7-37.9%)   [2/15]
                             → discordant on 0 of 15 cases
Oracle ceiling (reachable)   66.7%  (95% CI 41.7-84.8%)  [10/15]
Non-assay-labelled cases      0.0%  (95% CI 0.0-22.8%)   [0/13]
La clasificación era un prior fijo (DRIVER_RANK en src/compare.mjs) en el que assay
supera a todo lo demás. Dos artículos casi siempre usan métodos algo diferentes, por lo que assay
casi siempre diverge, así que fue elegido 13 veces de 15 — y los dos aciertos son exactamente
los dos casos etiquetados como ensayo. No es meramente tan bueno como adivinar una constante; es
conductualmente idéntico a ello en cada caso del conjunto.
Arreglar primero la fundamentación (Fase 2) eliminó esa excusa. Recuperar 20 de 26 rechazos falsos positivos duplicó el techo de oráculo del 33% al 67% — la causa establecida es ahora un candidato disponible en 10 de 15 casos en lugar de 5 — y la precisión top-1 no se movió en absoluto. Al clasificador se le entregó la respuesta correcta cinco veces más y no tomó ninguna.
Lo que cambió como resultado: la aplicación ya no nombra un impulsor principal. Presenta las dimensiones divergentes como una lista sin clasificar, porque esa lista es informativa (contiene la causa establecida 10 veces de 15) mientras que el orden no lo es. Elegir entre ellas requiere conocimiento de dominio que la herramienta no tiene.
Lo que sigue siendo válido: qué dimensiones difieren, cuáles son idénticas (descartadas), y la frase textual detrás de cada valor. Nada de eso depende de la clasificación.
Confirmado a ciegas, en un segundo conjunto
Esos 15 casos habían sido leídos para entonces en dos fases — fallos analizados, tramos reauditados — por lo que cada cifra posterior al arreglo derivada de ellos es precisión de conjunto de desarrollo, no una medición a ciegas. Así que construimos un segundo conjunto y lo medimos una vez.
eval/cases-heldout.json son 15 contradicciones documentadas adicionales, curadas según un protocolo escrito
y comprometido antes de que se seleccionara cualquier caso (eval/HELDOUT-PROTOCOL.md),
por un curador mantenido a ciegas respecto a los fallos por caso del conjunto de desarrollo, en campos deliberadamente diferentes:
microbioma, ecología marina, toxicología, psicología, cuidados críticos, oncología, enfermedades infecciosas.
Ningún artículo y ninguna contradicción se comparte con el conjunto de desarrollo — selftest lo aplica mecánicamente.
Top-1 accuracy (strict)      13.3%  (95% CI 3.7-37.9%)   [2/15]
Baseline "always say assay"  20.0%  (95% CI 7.0-45.2%)   [3/15]
                             → discordant on 1 of 15 cases
Oracle ceiling (reachable)   73.3%  (95% CI 48.0-89.1%)  [11/15]
Non-assay-labelled cases      0.0%  (95% CI 0.0-24.3%)   [0/12]
En datos no vistos, el prior puntúa por debajo de la conjetura constante — por exactamente un caso. Los intervalos
se superponen casi por completo y las dos estrategias discrepan en 1 de 15, por lo que la afirmación honesta es
que sigue siendo indistinguible de adivinar assay cada vez, no que sea peor.
La línea que no se mueve es la última. En ambos conjuntos, 25 casos donde la causa establecida
era algo distinto de assay, el prior no identificó ninguno. Y el techo aquí es
más alto que en el conjunto de desarrollo — 73.3% frente a 66.7% — por lo que la extracción puso la respuesta correcta
frente al clasificador más a menudo, y fue tomada con la misma frecuencia. Esa es la conclusión de las Fases 1–2
reproducida en datos que el bucle de desarrollo nunca vio, que es la única forma en que podría haberse
reforzado.
El número se reporta tal cual, y nunca se combina con el número del conjunto de desarrollo: sumarlos en una
cifra de "n=30" volvería a blanquear datos leídos como datos a ciegas. Nada en src/ se cambió sobre la base
de ello. El conjunto se obtuvo una vez en un solo brazo preregistrado, pero la puntuación no fue una pasada
limpia — la primera ejecución reportó n=14 después de que un artículo no se obtuviera, y el conjunto completo se puntuó
tras recuperarlo. Ambas cifras, los dieciséis defectos que una pasada de verificación adversarial encontró y
corrigió antes de cualquier puntuación, y el razonamiento detrás de cada etiqueta están registrados en el bloque de
procedencia del propio archivo en lugar de resumirse.
npm run eval:heldout            # the blind number, offline and free
npm run eval:selftest:heldout   # set integrity, incl. zero overlap with the dev set
Método completo, las decisiones preregistradas y cada predicción que resultó incorrecta:
eval/README.md y eval/PHASE2.md. Los conjuntos
de referencia son eval/cases.json (desarrollo) y
eval/cases-heldout.json (reservado).
npm run eval            # offline, free, no API key — regenerates the numbers above
npm run eval:selftest   # validates the harness maths and set integrity
eval/cache/ y eval/cache-heldout/ están comprometidos a propósito. No son salida de compilación,
son evidencia: los números publicados son reproducibles a partir de artefactos en el repositorio en lugar de
tomarse por fe.
Inicio rápido
En menos de 60 segundos, sin clave API, sin red:
git clone https://github.com/nickjlamb/studydiff && cd studydiff
npm install
npm run demo                        # explains a real, famous contradiction
npm run demo -- resveratrol-sirt1   # a second worked example
npm run demo -- treg-stability      # a third: Treg lineage stability
Ejecuta la aplicación web:
cp .env.example .env    # add ANTHROPIC_API_KEY for live comparisons
npm run serve           # http://localhost:4173
Los ejemplos integrados se ejecutan con datos en caché y no necesitan clave. Para comparar en vivo, añade tu clave y usa las entradas PMID / DOI, Subir PDF o Pegar.
Cómo funciona
flowchart LR
  IN["Two papers<br/>PMID · DOI · PDF · text"] --> R["Retrieve<br/>PubMed / PMC / PDF"]
  R --> E["Extract<br/>Claude → structured study cards"]
  E --> V["Verify<br/>deterministic grounding"]
  V -- "ungrounded → not reported" --> E
  V --> C["Compare<br/>divergent vs. shared design"]
  C --> X["Present<br/>divergent dimensions + ruled out"]
- Recuperar — un cliente de PubMed/PMC con un respaldo de texto completo a resumen que etiqueta cuán profundo leyó (
fulltext/abstract/pasted); los PDF subidos se extraen como texto en el servidor. - Extraer — Claude convierte cada artículo en una tarjeta de estudio fija (especie, modelo, ensayo, dosis, tiempo, punto final, tamaño de muestra, estadística, hallazgo, limitaciones). Cada campo lleva una cita textual de respaldo; los campos ausentes se establecen por defecto en no reportado.
- Verificar — la fundamentación se ejecuta primero: cualquier valor cuya cita no esté en la fuente, o cuyos números no se tracen, se degrada a no reportado. StudyDiff no puede citar un hecho que no ha verificado.
- Comparar — determinista: qué dimensiones de diseño reportan ambos artículos, cuáles de esas divergen y cuáles son idénticas. La divergencia es una prueba de solapamiento de tokens en las dimensiones de diseño y una desigualdad estricta en la conclusión misma, porque la polaridad de una conclusión importa donde el contenido de una lista de métodos no.
- Presentar — las dimensiones divergentes sin clasificar, cada una con los valores de ambos artículos y la frase textual detrás de ellos, y las idénticas explícitamente descartadas. StudyDiff no nombra una como la causa: fue medido y no funciona.
Dos cosas sostienen la garantía: la clave API nunca sale del servidor, y la verificación es determinista — la fundamentación y la comparación no implican ningún juicio de modelo, por lo que la misma evidencia verificada siempre produce las mismas dimensiones divergentes.
¿Por qué Claude?
La fiabilidad de StudyDiff proviene de cómo usa Claude, no solo de que lo usa:
- Extracción estructurada mediante uso de herramientas. Cada artículo se convierte en una tarjeta de estudio a través de un esquema de herramienta forzado de Claude (Sonnet), por lo que cada campo se devuelve validado y lleva una cita textual de respaldo — sin análisis de texto libre, sin fallos de "casi-JSON".
- Razonamiento que mapea afirmaciones a evidencia. Claude lee la prosa de métodos/resumen e identifica tanto el valor de diseño como la frase exacta que lo respalda — la parte difícil de convertir artículos no estructurados en tarjetas comparables y auditables.
- Claude propone, la fundamentación dispone. StudyDiff nunca usa un LLM como juez. Una comprobación determinista verifica la salida de Claude contra la fuente y degrada cualquier cosa no respaldada antes de que se muestre. Combinar la extracción con uso de herramientas de Claude con verificación no-LLM es lo que permite a la herramienta confiar en su propia salida y evita las trampas habituales de LLM-como-evaluador.
- Construido con Claude Code. Toda la aplicación — pipeline, interfaz, endurecimiento, despliegue — se construyó iterativamente con Claude Code en un solo bucle agéntico.
Ejemplos
| Pregunta | Artículos | Lo que StudyDiff encuentra |
|---|---|---|
| ¿Los modelos de ratón imitan la inflamación humana? | Seok 2013 vs Takao & Miyakawa 2015 | Mismos conjuntos de datos, conclusiones opuestas — impulsado por la estrategia de selección de genes. |
| ¿El resveratrol activa SIRT1? | Howitz 2003 vs Beher 2009 | Un artefacto de ensayo — el sustrato peptídico Fluor de Lys vs. sustratos nativos. |
| ¿Es estable el linaje Treg in vivo? | Zhou 2009 vs Rubtsov 2010 | Una controversia emblemática de células T — estable vs. inestable, impulsada por el método de mapeo de destino. |
Los tres se incluyen como demos sin conexión (npm run demo / npm run demo -- resveratrol-sirt1 / npm run demo -- treg-stability).
Uso
- Aplicación web (
npm run serve) — ejemplos, búsqueda PMID/DOI, subida de PDF o pegado; transmite cada paso del pipeline en vivo, te permite hacer clic en cualquier valor fundamentado para verlo resaltado en la fuente y exporta un informe Markdown reproducible con la frase textual de respaldo de cada valor. - Servidor MCP (
npm run mcp) — permite a Claude, o a cualquier agente, llamar al motor de contradicciones directamente. Ver Servidor MCP. - CLI —
node src/cli.mjs --q "Does resveratrol activate SIRT1?" 12939617 19843076 - Despliegue — ver DEPLOY.md (Railway + dominio personalizado).
Servidor MCP
El motor de StudyDiff también es un servidor Model Context Protocol, por lo que un agente puede preguntar por qué dos artículos discrepan como una llamada de herramienta — el mismo pipeline fundamentado, sin navegador.
Publicado en el Registro oficial de MCP como io.github.nickjlamb/studydiff, y en npm como studydiff-mcp.
| Herramienta | Qué hace |
|---|---|
compare_studies(paperA, paperB, question?) | El pipeline completo sobre dos artículos. Cada artículo es {id} (PMID o DOI) o {citation, text}. Requiere ANTHROPIC_API_KEY. |
compare_example(example) | Ejecuta un ejemplo trabajado en caché — sin clave de API, sin red. La forma más rápida de ver la salida fundamentada. |
list_examples() | Lista los ejemplos trabajados integrados. |
Devuelve el mismo informe auditable que exporta la aplicación web: el veredicto, las dimensiones de diseño divergentes (sin clasificar) y las idénticas (descartadas), cada valor con la frase textual que lo respalda, los recuentos de verificación y qué evidencia resolvería el desacuerdo. Los campos no fundamentados se devuelven como no reportado — nunca se adivinan — y la herramienta nunca elige un ganador, nunca nombra un impulsor principal y nunca reporta una confianza que no haya calculado.
Añádelo a Claude Code:
claude mcp add studydiff -- npx -y studydiff-mcp
…o a Claude Desktop (claude_desktop_config.json):
{
  "mcpServers": {
    "studydiff": {
      "command": "npx",
      "args": ["-y", "studydiff-mcp"],
      "env": { "ANTHROPIC_API_KEY": "sk-ant-..." }
    }
  }
}
ANTHROPIC_API_KEY solo se necesita para compare_studies. Déjalo fuera y list_examples / compare_example seguirán funcionando — los ejemplos en caché se ejecutan sin clave y sin red. (Para ejecutar desde un clon local, cambia el comando por node /absolute/path/to/studydiff/src/mcp.mjs).
Luego solo pregunta:
Usa studydiff para comparar PMID 19633673 y 20929851 — ¿por qué no están de acuerdo?
¿No tienes clave a mano? list_examples, luego compare_example("treg-stability") se ejecuta completamente sin conexión.
Estructura del proyecto
src/ncbi.mjs        PubMed / PMC retrieval (+ DOI resolution, source-depth tagging)
src/pdf.mjs         PDF text extraction (pure JS)
src/extract.mjs     Claude tool-use → structured study cards
src/grounding.mjs   deterministic verification (OpenGATE)
src/compare.mjs     divergence detection (divergent vs. shared design dimensions)
eval/               driver-ranking benchmark: two sets of 15 cited contradictions (dev + held-out) + scorer
src/gaps.mjs        bounded "observed across these papers"
src/pipeline.mjs    orchestration: retrieve → extract → verify → compare
src/report.mjs      shared Markdown report (answer, drivers, quotes, verification)
src/server.mjs      web server + streaming API (+ rate limiting, caching)
src/mcp.mjs         MCP server: compare_studies / compare_example / list_examples
public/index.html   single-file dashboard UI
fixtures/           cached real papers for the offline demos
Hoja de ruta
La búsqueda por palabras clave con un selector de resultados, la comparación por lotes y la comparación de más de dos artículos son las direcciones abiertas. El benchmark está completo y el resultado se mantuvo a ciegas, así que el próximo trabajo es precisión, no funciones: mejor extracción para elevar el techo medido, y una verificación de implicación para detectar exageraciones en prosa que el fundamento determinista no puede ver. Lista completa — incluyendo lo que se ha probado y retirado — en ROADMAP.md.
Contribuciones
Las contribuciones son bienvenidas — consulta CONTRIBUTING.md para la configuración y los invariantes que mantienen intacta la garantía de confianza.
Procedencia
StudyDiff fue construido para el hackathon Built with Claude: Life Sciences de Anthropic (pista Builder). Todo el código de aplicación en este repositorio fue escrito desde cero durante el evento. La fundamentación usa OpenGATE y la extracción de PDF usa unpdf, ambos como dependencias publicadas. La recuperación usa las utilidades E públicas de NCBI; la extracción usa la API de Claude.
Licencia
MIT © Nick Lamb