Schema Search
Búsqueda de esquemas en lenguaje natural en memoria sobre esquemas de bases de datos.
Documentación
Schema Search
Nota: El proyecto se ha trasladado a un nuevo repositorio y ahora es mantenido por SignalPilot Labs. El código en el repositorio actual solo está disponible como referencia.
Un servidor MCP para búsqueda en lenguaje natural sobre esquemas de bases de datos relacionales (RDBMS). Encuentra las tablas exactas que necesitas, con todas sus relaciones mapeadas, en milisegundos. No se requiere configuración de base de datos vectorial.
Por qué
Tienes 200 tablas en tu base de datos. Alguien pregunta "¿dónde se almacenan los reembolsos de usuarios?"
Podrías:
- Buscar en archivos SQL durante 20 minutos
- Pasar el esquema completo a un LLM y ver cómo lucha con 200 tablas
O construir embeddings esquemáticos de tus tablas, almacenarlos en memoria y consultarlos en lenguaje natural en un servidor MCP.
Beneficios
- No se requiere configuración de base de datos vectorial
- Pequeña huella de memoria: escala fácilmente hasta 1000 tablas y más de 10,000 columnas.
- Latencia de consulta en milisegundos
Instalación
Rápido por defecto - La instalación base utiliza solo búsqueda BM25/difusa (sin PyTorch):
# Minimal install (BM25 + fuzzy only, ~10MB)
pip install "schema-search[postgres]"

# With semantic/hybrid search support (~500MB with PyTorch)
pip install "schema-search[postgres,semantic]"

# With LLM chunking
pip install "schema-search[postgres,semantic,llm]"

# With MCP server
pip install "schema-search[postgres,semantic,mcp]"

# Other databases
pip install "schema-search[mysql,semantic]"      # MySQL
pip install "schema-search[snowflake,semantic]"  # Snowflake
pip install "schema-search[bigquery,semantic]"   # BigQuery
pip install "schema-search[databricks,semantic]" # Databricks
Extras:
[semantic]: Habilita búsqueda semántica/híbrida y reordenamiento CrossEncoder (añade sentence-transformers)[llm]: Habilita fragmentación de esquemas basada en LLM (añade openai)[mcp]: Soporte de servidor MCP (añade fastmcp)
Configuración
Edita config.yml:
logging:
  level: "WARNING"

embedding:
  location: "memory" # Options: "memory", "vectordb" (coming soon)
  model: "multi-qa-MiniLM-L6-cos-v1"
  metric: "cosine" # Options: "cosine", "euclidean", "manhattan", "dot"
  batch_size: 32
  show_progress: false
  cache_dir: "/tmp/.schema_search_cache"

chunking:
  strategy: "raw" # Options: "raw", "llm"
  max_tokens: 256
  overlap_tokens: 50
  model: "gpt-4o-mini"

search:
  # Search strategy: "semantic" (embeddings), "bm25" (BM25 lexical), "fuzzy" (fuzzy string matching), "hybrid" (semantic + bm25)
  strategy: "bm25"
  initial_top_k: 20
  rerank_top_k: 5
  semantic_weight: 0.67 # For hybrid search (bm25_weight = 1 - semantic_weight)
  hops: 1 # Number of foreign key hops for graph expansion (0-2 recommended)

reranker:
  # CrossEncoder model for reranking. Set to null to disable reranking
  model: null # "Alibaba-NLP/gte-reranker-modernbert-base"

schema:
  include_columns: true
  include_indices: true
  include_foreign_keys: true
  include_constraints: true

output:
  format: "markdown" # Options: "json", "markdown"
  limit: 5 # Default number of results to return
Servidor MCP
Integra con Claude Desktop o cualquier cliente MCP.
Configuración
Añade a tu configuración MCP (por ejemplo, ~/.cursor/mcp.json o la configuración de Claude Desktop):
Usando uv (Recomendado):
{
  "mcpServers": {
    "schema-search": {
      "command": "uvx",
      "args": [
        "schema-search[postgres,mcp]",
        "postgresql://user:pass@localhost/db",
        "optional/path/to/config.yml",
        "optional llm_api_key",
        "optional llm_base_url"
      ]
    }
  }
}
Usando pip:
{
  "mcpServers": {
    "schema-search": {
      // conda: /Users/<username>/opt/miniconda3/envs/<your env>/bin/schema-search",
      "command": "path/to/schema-search",
      "args": [
        "postgresql://user:pass@localhost/db",
        "optional/path/to/config.yml",
        "optional llm_api_key",
        "optional llm_base_url"
      ]
    }
  }
}
La clave de API del LLM y la URL base solo son necesarias si usas resúmenes de esquema generados por LLM (config.chunking.strategy = 'llm').
Uso desde CLI
schema-search "postgresql://user:pass@localhost/db" "optional/path/to/config.yml"
Argumentos opcionales: [config_path] [llm_api_key] [llm_base_url]
El servidor expone schema_search(query, hops, limit) para consultas de esquema en lenguaje natural.
Uso en Python
from sqlalchemy import create_engine
from schema_search import SchemaSearch

# PostgreSQL
engine = create_engine("postgresql://user:pass@localhost/db")


sc = SchemaSearch(
  engine=engine,
  config_path="optional/path/to/config.yml", # default: config.yml
  llm_api_key="optional llm api key",
  llm_base_url="optional llm base url"
  )

sc.index(force=False) # default is False
results = sc.search("where are user refunds stored?")

# Default output is markdown - render with str()
print(results)  # Formatted markdown with schemas, relationships, and scores

# Access underlying data as dictionary
result_dict = results.to_dict()
for result in result_dict['results']:
    print(result['table'])           # "refund_transactions"
    print(result['schema'])           # Full column info, types, constraints
    print(result['related_tables'])   # ["users", "payments", "transactions"]

# Override output format explicitly
json_results = sc.search("where are user refunds stored?", output_format="json")
print(json_results)  # JSON formatted string

# Override hops, limit, search strategy, and output format
results = sc.search("user_table", hops=1, limit=5, search_type="hybrid", output_format="markdown")
sc.index() detecta automáticamente cambios en el esquema y actualiza los metadatos en caché, por lo que rara vez necesitarás forzar un reindexado manualmente.
Cadenas de conexión a bases de datos
Schema Search utiliza cadenas de conexión SQLAlchemy:
# PostgreSQL
engine = create_engine("postgresql://postgres:mypass@localhost:5432/mydb")

# MySQL
engine = create_engine("mysql+pymysql://root:mypass@localhost:3306/mydb")

# Snowflake
engine = create_engine("snowflake://myuser:mypass@xy12345.us-east-1/MYDB/PUBLIC?warehouse=COMPUTE_WH&role=ANALYST")

# BigQuery
engine = create_engine("bigquery://my-project/my-dataset")

# Databricks
token = "dapi..."
host = "dbc-xyz.cloud.databricks.com"
http_path = "/sql/1.0/warehouses/abc123"
catalog = "main"
schema = "default"  # Optional

# Without schema (queries across all schemas in catalog)
engine = create_engine(
    f"databricks://token:{token}@{host}?http_path={http_path}&catalog={catalog}",
    connect_args={"user_agent_entry": "schema-search"}
)

# With schema (limits to specific schema)
engine = create_engine(
    f"databricks://token:{token}@{host}?http_path={http_path}&catalog={catalog}&schema={schema}",
    connect_args={"user_agent_entry": "schema-search"}
)
Estrategias de búsqueda
Schema Search admite cuatro estrategias de búsqueda:
- bm25: Búsqueda léxica usando el algoritmo de ranking BM25 (sin dependencias de ML)
- fuzzy: Coincidencia de cadenas en nombres de tablas/columnas usando coincidencia difusa (sin dependencias de ML)
- semantic: Búsqueda de similitud basada en embeddings usando sentence transformers (requiere
[semantic]) - hybrid: Combina puntuaciones semánticas y bm25 (por defecto: 67% semántico, 33% bm25) (requiere
[semantic])
Cada estrategia realiza su propio ranking inicial y, opcionalmente, aplica reordenamiento CrossEncoder si reranker.model está configurado (requiere [semantic]). Establece reranker.model a null para deshabilitar el reordenamiento.
Comparación de rendimiento
Hemos comparado en el conjunto de datos Spider (1,234 consultas de entrenamiento en 18 bases de datos) usando el config.yml por defecto.
Memoria: El modelo de embeddings requiere ~90 MB y el reordenador opcional añade ~155 MB. La memoria real del proceso depende de tu runtime de Python.
Sin reordenador (reranker.model: null)
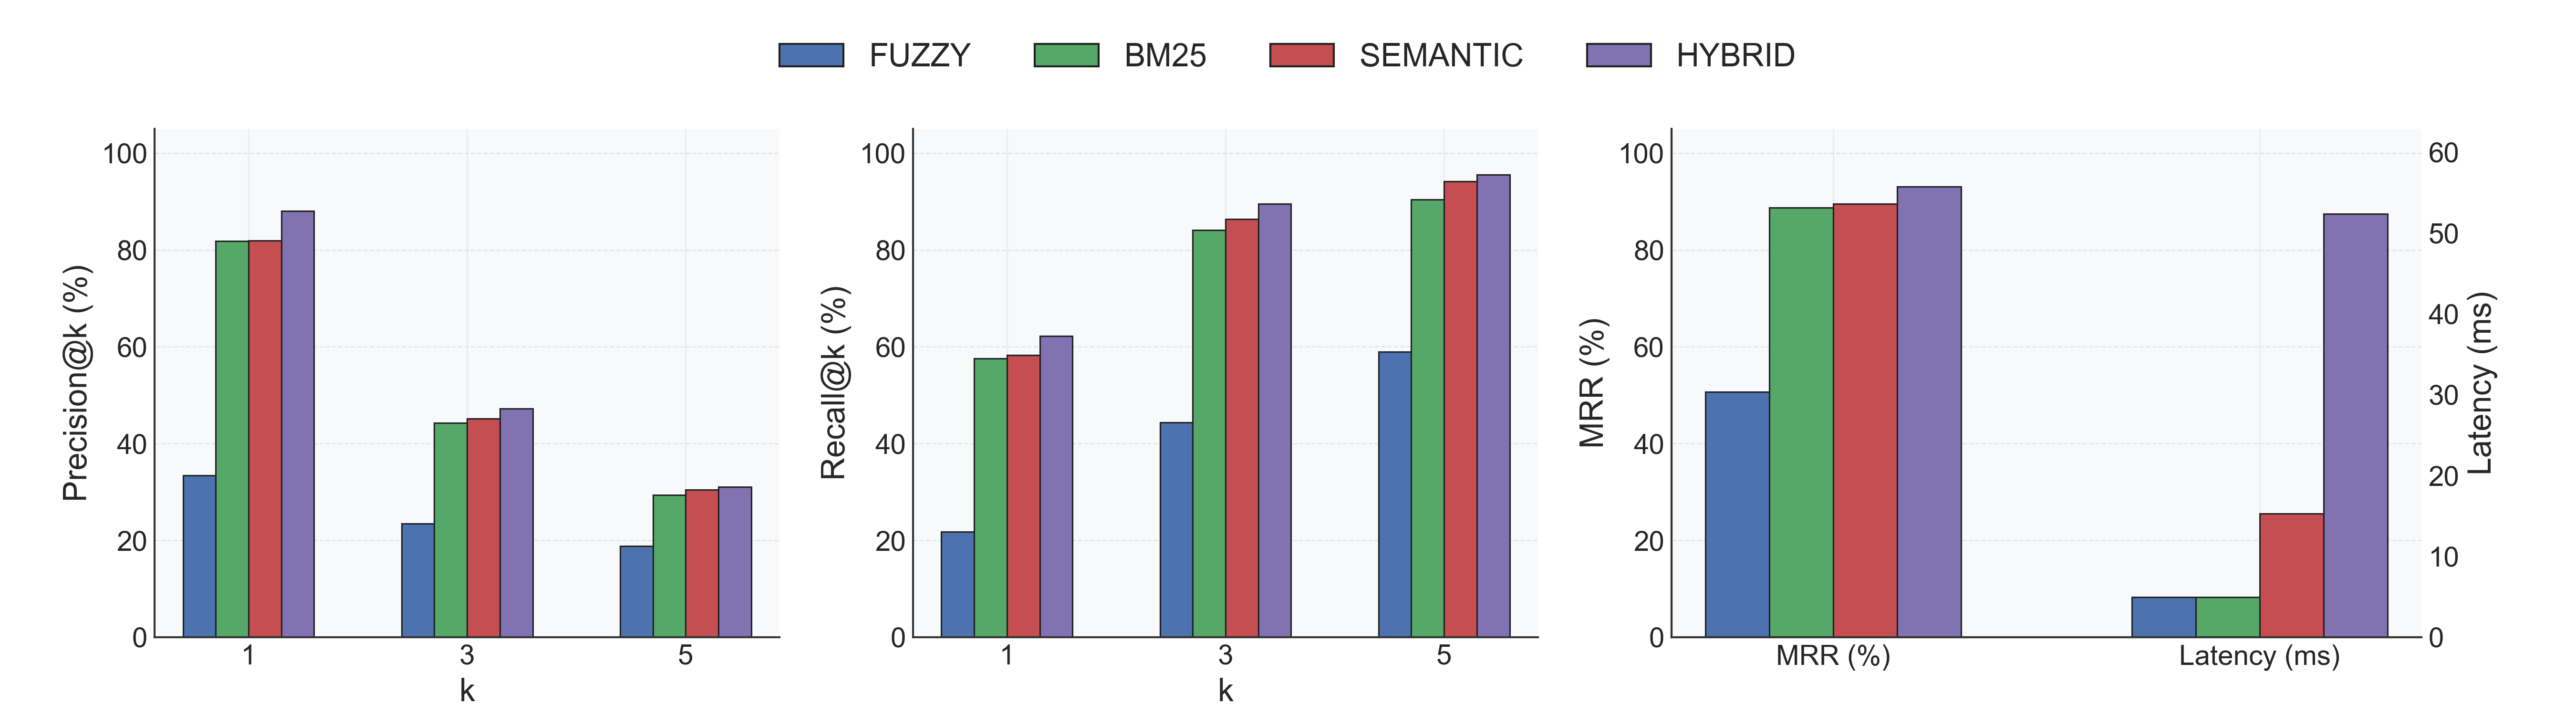
- Indexación: 0.22s ± 0.08s por base de datos (18 en total).
- Precisión: Hybrid lidera con Recall@1 62% / MRR 0.93; Semantic le sigue con Recall@1 58% / MRR 0.89.
- Latencia: BM25 y Fuzzy responden en ~5ms; Semantic tarda ~15ms; Hybrid (semántico + difuso) promedia 52ms.
- Línea base difusa: Recall@1 22%, lo que resalta la necesidad de señales semánticas en consultas en lenguaje natural.
Con reordenador (Alibaba-NLP/gte-reranker-modernbert-base)
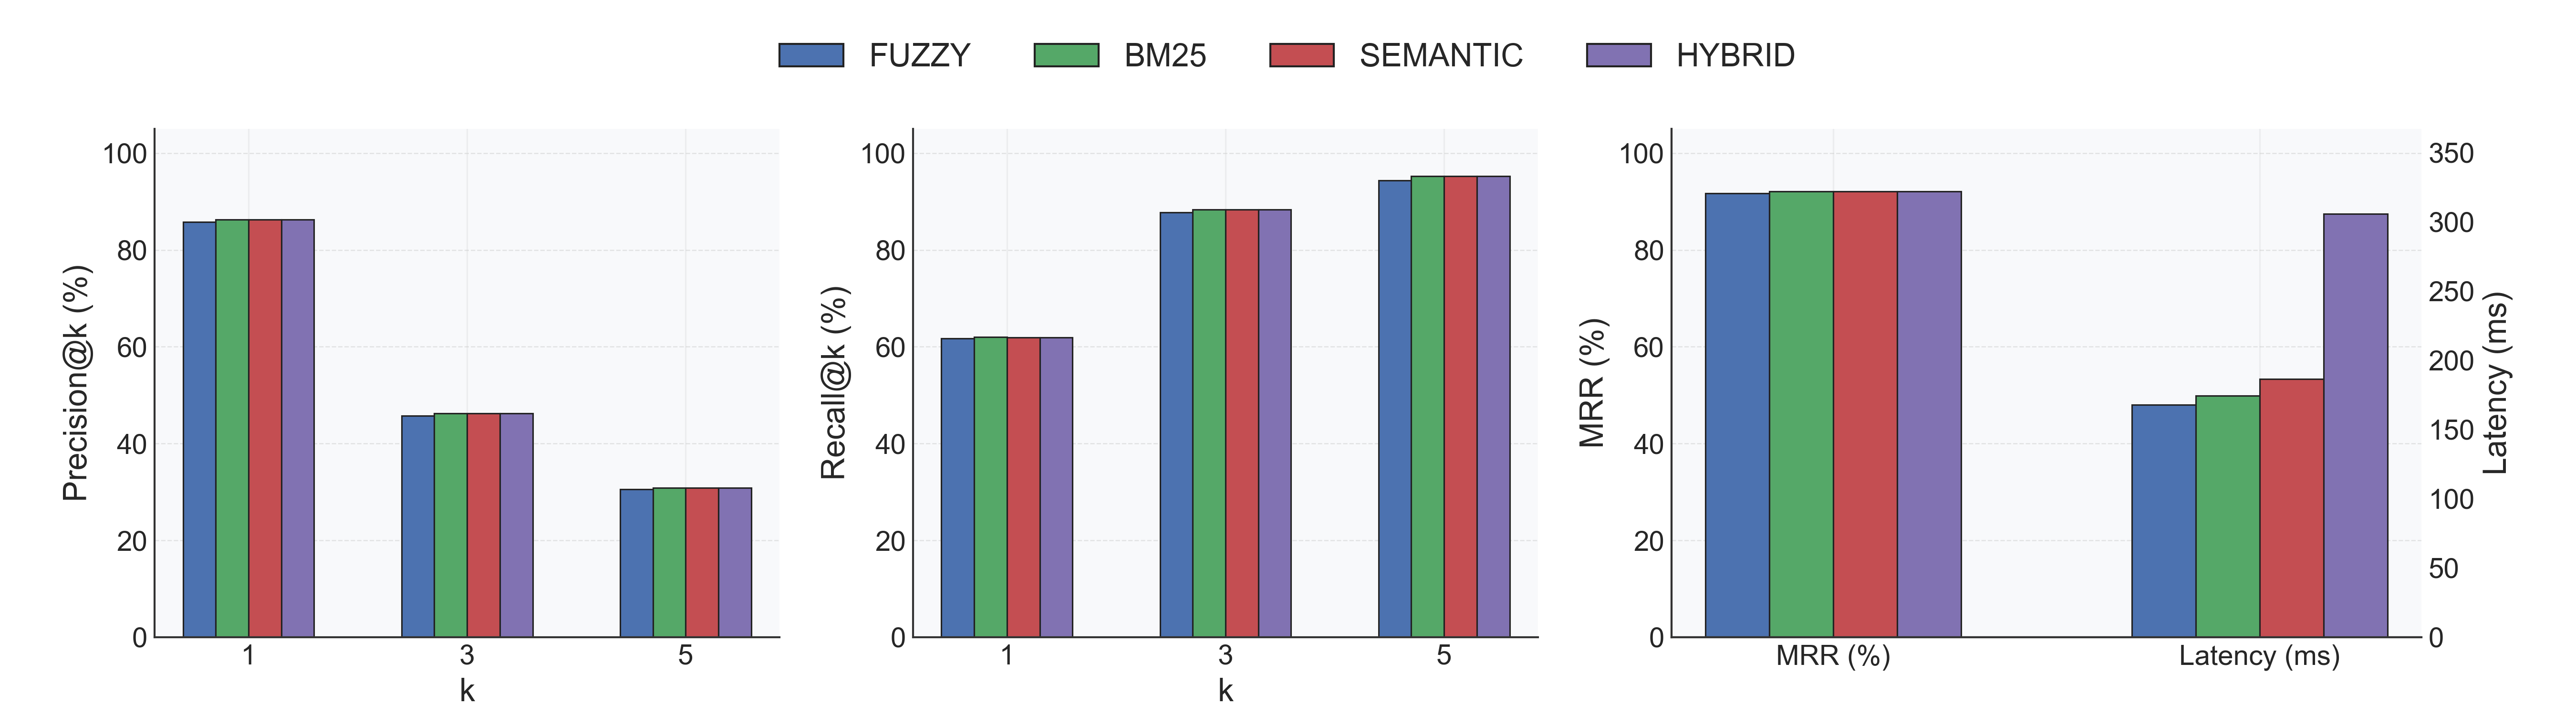
- Indexación: 0.25s ± 0.05s por base de datos (las mismas 18 BD).
- Precisión: Todas las estrategias convergen alrededor de Recall@1 62% y MRR ≈ 0.92; Fuzzy salta de 51% → 92% MRR.
- Compensación de latencia: El paso adicional de CrossEncoder eleva la latencia por consulta a ~0.18–0.29s según la estrategia.
- Recomendación: Habilita el reordenador cuando la precisión sea lo más importante; deshabilítalo para búsquedas de latencia ultrabaja.
Puedes anular la estrategia de búsqueda, los saltos y el límite en el momento de la consulta:
# Use fuzzy search instead of default
results = sc.search("user_table", search_type="fuzzy")

# Use BM25 for keyword-based search
results = sc.search("transactions payments", search_type="bm25")

# Use hybrid for best of both worlds
results = sc.search("where are user refunds?", search_type="hybrid")

# Override hops and limit
results = sc.search("user refunds", hops=2, limit=10)  # Expand 2 hops, return 10 tables

# Disable graph expansion
results = sc.search("user_table", hops=0)  # Only direct matches, no foreign key traversal
Formatos de salida
Schema Search devuelve un objeto SearchResult que se puede renderizar en múltiples formatos:
- markdown (por defecto): Markdown formateado con esquemas de tablas jerárquicos
- json: Salida JSON estructurada
El objeto SearchResult tiene:
- Método
__str__(): Renderiza usando el formato configurado (markdown o json) - Método
.to_dict(): Devuelve un diccionario crudo para acceso programático
Configura el formato por defecto en config.yml:
output:
  format: "markdown"  # or "json"
  limit: 5            # Default number of results
Anula en el momento de la consulta:
# Default markdown output - just print the object
results = sc.search("user payments")
print(results)  # Formatted markdown

# Access underlying data as dictionary
data = results.to_dict()
print(data['results'][0]['table'])  # "users"

# Override to JSON format
json_results = sc.search("user payments", output_format="json")
print(json_results)  # JSON formatted string
La salida en Markdown incluye:
- Nombre de la tabla y puntuación de relevancia
- Claves primarias y columnas con tipos/restricciones
- Relaciones de claves foráneas
- Índices y restricciones
- Tablas relacionadas de la expansión del grafo
- Fragmentos de contenido coincidentes
Fragmentación con LLM
Usa LLM para generar resúmenes semánticos en lugar de texto de esquema crudo (requiere el extra [llm]):
- Instala:
pip install "schema-search[postgres,llm]" - Establece
strategy: "llm"enconfig.yml - Pasa las credenciales de la API:
sc = SchemaSearch(
    engine,
    llm_api_key="sk-...",
    llm_base_url="https://api.openai.com/v1/"  # optional
)
Cómo funciona
- Extrae esquemas de la base de datos usando el inspector de SQLAlchemy
- Fragmenta esquemas en piezas digeribles (markdown o resúmenes generados por LLM)
- Búsqueda inicial usando la estrategia seleccionada (semántica/BM25/difusa)
- Expande mediante claves foráneas para encontrar tablas relacionadas (saltos configurables)
- Reordenamiento opcional con CrossEncoder para refinar resultados
- Devuelve las tablas principales con el esquema completo y las relaciones
Caché almacenada en /tmp/.schema_search_cache/ (configurable en config.yml)
Licencia
MIT