Fagan
Canalización de codificación autónoma: un modelo de frontera planifica y revisa, los modelos de peso abierto escriben el código, controlado por TDD y revisión.
Documentación
Fagan


Gasta tokens en criterio, no en escribir.
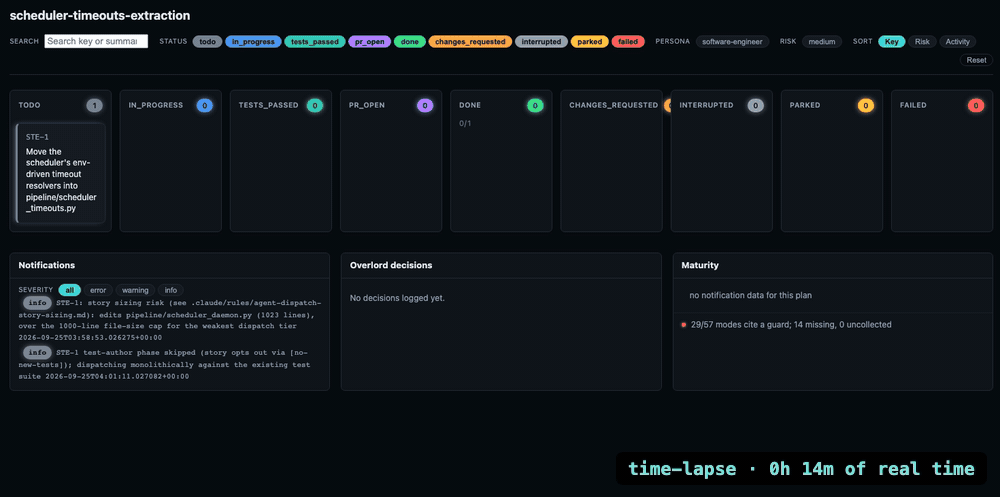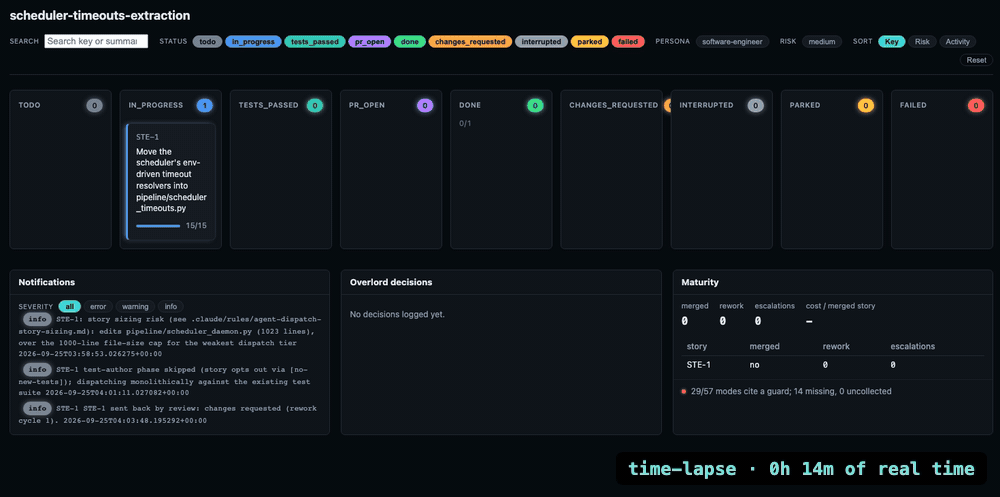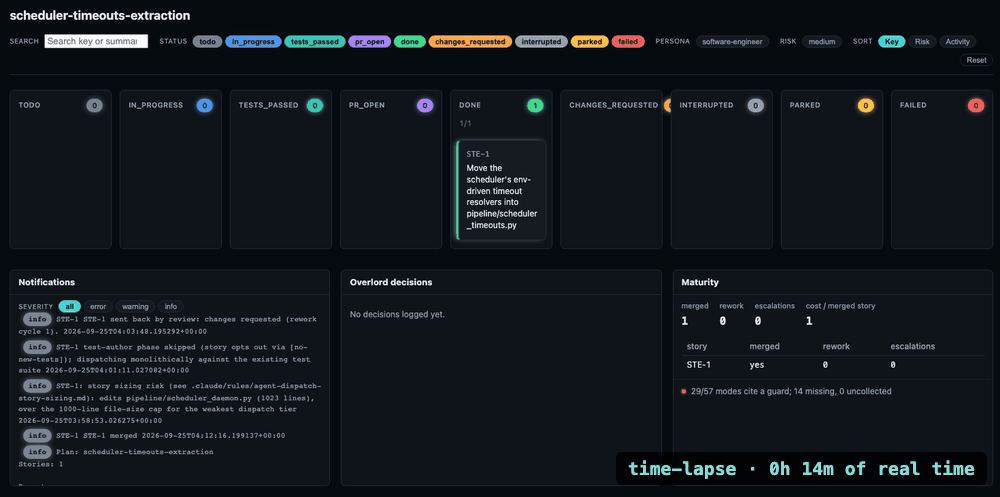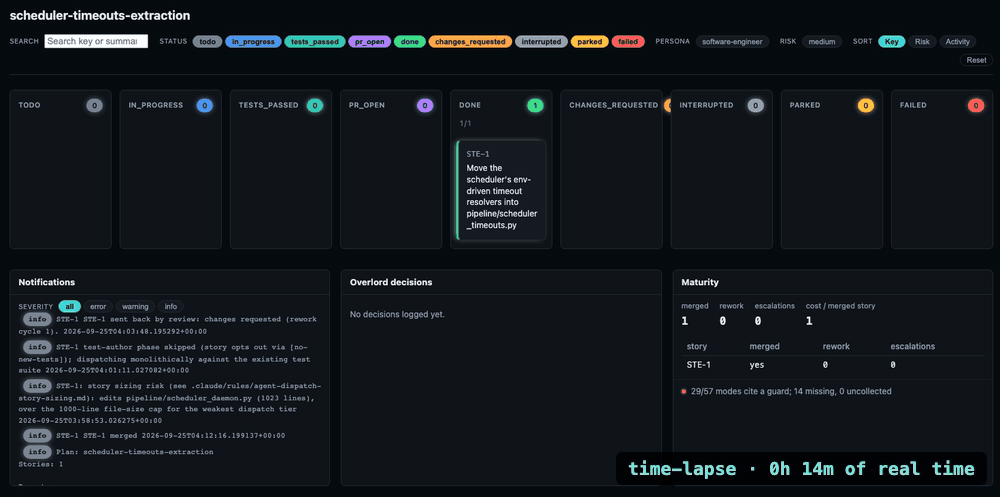
Una historia real (STE-1, PR #986) que cruzó el tablero: implementada por un modelo de peso abierto, devuelta una vez por revisión, fusionada. 14 minutos, en time-lapse.
Pruébalo (macOS; Linux vía Ollama o LM Studio), luego consulta la Guía de inicio rápido:
curl -fsSL https://raw.githubusercontent.com/motock/fagan/master/scripts/remote-install.sh | bash
Los modelos de frontera cuestan dinero por token y son excelentes en criterio. Los modelos locales se ejecutan gratis y son adecuados para escribir. Este pipeline divide la ingeniería de software exactamente en esa línea: un modelo de frontera descompone el trabajo, lo planifica, revisa el diff y arbitra cualquier cosa riesgosa — mientras que un modelo local escribe la implementación sin costo marginal.
Lo que hace confiable la mitad barata es la inspección. En el estudio de IBM de 1976 de Michael Fagan, la inspección formal encontró el 82% de los defectos en el producto publicado — 38 por KLOC, frente a 8 por KLOC para pruebas unitarias. La calidad vive en la compuerta, no en el autor. Por eso este proyecto gasta su presupuesto en compuertas: TDD aplicado antes de la implementación, una pasada de revisión independiente, calificación con oráculo de aceptación, un supervisor por niveles de riesgo que se detiene para un humano ante cualquier cosa irreversible, y una compuerta de fusión que vuelve a ejecutar la suite contra la rama rebasada antes de que algo aterrice.
El objetivo es estrecho y específico: disciplina de ingeniería de nivel empresarial — descomposición, TDD, revisión de código, entrega ordenada por dependencias — con un presupuesto de $20/mes.
Para material de referencia detallado, consulta REFERENCE.md.
Antes de comenzar: lee Confiabilidad y limitaciones a continuación. Este es un pipeline de codificación autónomo con modos de fallo reales y documentados — aún no es una herramienta de "describe una función, obtén un PR" sin intervención.
Soporte de plataformas
Desarrollado y ejecutado a diario en macOS. El núcleo (servidor MCP, panel, despacho/revisión con backend Claude, la suite completa de pruebas) es Python puro y CI lo prueba en Ubuntu en Python 3.12–3.14 en cada push. Dos piezas son solo para macOS:
launchd/*.plist— el programador/supervisor MLX/encuestador de uso están empaquetados como trabajos launchd en macOS. En Linux, genera el equivalente systemd conscripts/generate_systemd_units.sh(consulta Programador a continuación) en lugar de crear archivos init a mano, o ejecuta los puntos de entrada directamente en una sesión de terminal/tmuxen primer plano.- MLX (
PIPELINE_LOCAL_PROVIDER=mlx) — solo Apple Silicon. El despacho local funciona bien en Linux vía Ollama o LM Studio en su lugar (PIPELINE_LOCAL_PROVIDER=ollama/lmstudio).
Windows no está probado.
Guía de inicio rápido
Instalación en una línea
curl -fsSL https://raw.githubusercontent.com/motock/fagan/master/scripts/remote-install.sh | bash
Esto clona el repositorio a ~/.fagan (anula la ubicación con
FAGAN_INSTALL_DIR, y la URL de origen con FAGAN_REPO_URL) y ejecuta
scripts/install.sh dentro de él — equivalente a los pasos manuales de clonar y ejecutar
a continuación, sin escribir. Volver a ejecutarlo más tarde actualiza el checkout
existente (git pull --ff-only) en lugar de re-clonar.
Enviar un script remoto a bash significa confiar en lo que esa URL sirve
en el momento de la descarga. Si prefieres leerlo primero:
curl -fsSL https://raw.githubusercontent.com/motock/fagan/master/scripts/remote-install.sh -o remote-install.sh
less remote-install.sh   # or open it in an editor
bash remote-install.sh
De cualquier manera, cd al directorio de instalación que reporta (~/.fagan por
defecto); ya ha hecho los pasos 1–3 a continuación, así que reinicia Claude Code (paso 5). ¿Prefieres un clon manual? Usa los
pasos a continuación en su lugar.
Esto registra el servidor MCP y ejecuta un primer plan de principio a fin.
Un primer ejecución no necesita ningún modelo local: sin nada configurado, el despacho
y la revisión recurren al backend claude, que invoca la CLI de Claude
Code. Ese recurso es la configuración inicial, no la prevista
— la división de costos descrita arriba solo ocurre una vez que enrutes deliberadamente
el rol de implementación a un modelo local, por eso el registro incluido
no trae ningún bloque roles propio: consulta Selección de proveedor y autorización
a continuación para saber cómo tomar esa decisión cuando estés listo.
# 1. Clone and install the Python environment
git clone https://github.com/motock/fagan.git
cd fagan
scripts/install.sh          # creates .venv, installs requirements.txt

# 2. Register the MCP server with Claude Code (adjust the path to where you cloned it)
claude mcp add -s user pipeline "$(pwd)/.venv/bin/python3" "$(pwd)/app/pipeline_mcp_server.py"

# 3. Copy the persona subagents and decision policy into place
#    (cp -n skips any file you already have — e.g. a customized code-reviewer.md —
#    instead of silently overwriting it; diff before removing -n if you do want the update)
mkdir -p ~/.claude/agents
cp -n agents/*.md ~/.claude/agents/
cp -n overlord-policy.md ~/.claude/overlord-policy.md

# 4. (Optional) Install the global rules bundle for your agent CLIs
#    scripts/install_global_rules.py --tools=claude,codex,opencode
#    Opt-in: nothing is written unless --tools is passed. It writes the bundle into
#    ~/.claude/CLAUDE.md, ~/.codex/AGENTS.md and ~/.config/opencode/AGENTS.md, copies
#    the rule files into the sibling fagan-rules/ directory, and backs up an existing
#    file as <name>.fagan-bak-<UTC timestamp>. Re-running refreshes only the fenced
#    block between the fagan:begin and fagan:end markers.

# 5. Restart Claude Code (or start a new session) so it picks up the MCP server
scripts/install.sh crea el .venv, instala requirements.txt y
requirements-dashboard.txt (las dependencias fastapi/uvicorn del panel, instaladas
en cada ejecución; una instalación --dev usa requirements-dev.txt, que ya
incluye las dependencias del panel), y reporta sobre las herramientas a las que el pipeline
invoca — requeridas: git, gh y la CLI claude; opcionales: ollama y
docker — con mensajes de degradación elegante, y es seguro volver a ejecutarlo. No registra el servidor MCP, establece variables de entorno
ni instala los subagentes de persona — los pasos 2–3 arriba cubren eso. Con
nada más que el backend claude configurado, que ollama/docker estén ausentes es
esperado, no un error.
Desde una sesión de Claude Code en el proyecto en el que quieres que trabaje el pipeline:
- Pide al subagente
product-analystque convierta un objetivo en épicas/historias, o escribe un plan a mano según el esquema. mcp__pipeline__save_plan(oingest_plan) con ese plan y unrepo_rootapuntando al proyecto objetivo — no este repositorio del pipeline.mcp__pipeline__list_ready_storiespara ver qué está desbloqueado, luegomcp__pipeline__dispatch_storypara reclamar y comenzar uno.- Observa el progreso con el panel:
scripts/dashboard.sh start, luego abrehttp://localhost:8000. - Para operación desatendida, ejecuta el programador para que las historias listas avancen
sin que llames a
advance_pipelinea mano:.venv/bin/python3 -m pipeline.scheduler_daemon(en primer plano, o bajo launchd/systemd/tmux — consulta Programador a continuación).
Comienza con PIPELINE_AUTONOMY=dry-run (solo planes y registros, nada se
despacha o fusiona) hasta que hayas visto correr un plan y confíes en las compuertas —
consulta Niveles de autonomía.
¿Solo usas el backend claude? Las variables PIPELINE_LOCAL_* y
PIPELINE_BACKEND_*=ollama/lmstudio/mlx, y la configuración de Ollama/MLX/LM Studio,
solo importan si optas por un rol en el despacho con modelo local — pero la selección
de proveedor en sí sigue siendo un paso de configuración requerido (el registro incluido
no enruta nada; consulta Selección de proveedor y autorización a continuación), e incluso el
camino claude necesita dos credenciales antes del primer despacho: gh auth login
(el pipeline abre y fusiona PRs a través de la CLI de GitHub) y el inicio de sesión propio de la CLI de Claude Code. Consulta
Configuración mínima para el puñado de
variables que realmente valen la pena configurar el primer día, frente a las ~100 que existen puramente
para ajuste.
Selección de proveedor y autorización
La selección de proveedor es un paso de configuración requerido. El
model_registry.json incluido declara deliberadamente qué modelos existen por proveedor
pero no incluye ningún enrutamiento roles: este proyecto se desacopla de cualquier
proveedor único, así que el operador elige. Hay dos formas compatibles de seleccionar un
proveedor por rol, verificadas en este orden por resolve_role:
- Configuración de rol del plan — el
provider/modelpor rol de un plan supera todo lo demás. - Un bloque
rolesen un archivo de registro — la única fuente de verdad para el enrutamiento de roles; consulta a continuación. - Variables de entorno
PIPELINE_BACKEND_<ROLE>— consultadas solo cuando el registro no tiene entrada para el rol (el camino de estado vacío, para que un clon nuevo aún arranque); p. ej.,PIPELINE_BACKEND_DISPATCH=ollamaopta el rol de despacho en Ollama. - El recurso propio del llamador — para despacho/revisión este es el backend
claude.
Para una alternativa interactiva a editar el JSON del registro a mano, ejecuta el
selector: .venv/bin/python scripts/choose_providers.py. Recorre los nueve
roles uno a la vez, mostrando el proveedor/modelo actual de cada rol y de dónde
vino esa configuración, y te permite cambiarlo escribiendo un número de opción —
cada uno de los nueve roles se configura de forma independiente, y cada cambio se
valida contra el registro antes de escribirse. Es seguro volver a ejecutarlo en
cualquier momento: volver a ejecutarlo solo relee el enrutamiento actual, y presionar Enter mantiene la
configuración existente de un rol.
Los mismos dos archivos de registro funcionan para ambos estilos de selección:
PIPELINE_MODEL_REGISTRY_PATHapunta el pipeline a cualquier registro JSON que quieras.model_registry.local.json(raíz del repositorio) es la convención para un registro personal: está en gitignore, así que tu enrutamiento por rol se mantiene fuera del repositorio. ApuntaPIPELINE_MODEL_REGISTRY_PATHa él, o cópialo sobremodel_registry.jsonlocalmente si prefieres no configurar la variable.
Un bloque roles nombra un proveedor y un nombre amigable de modelo por rol; el
nombre amigable debe existir bajo el models de ese proveedor en el mismo archivo, y
la etiqueta concreta se resuelve desde allí. Un error tipográfico genera un error en lugar de
recurrir silenciosamente.
Matriz de autorización. Seleccionar un proveedor también selecciona qué credenciales
debes establecer primero — scripts/install_checks.py sondea estas y
reporta unauthorized (remedio: un inicio de sesión, no una instalación) donde puede:
| Proveedor / herramienta | Credencial necesaria | Cómo establecerla |
|---|---|---|
git / gh | Autenticación de GitHub (el pipeline abre y fusiona PRs a través de gh) | gh auth login |
Backend claude | Inicio de sesión propio de la CLI de Claude Code | claude auth login (verifica: claude auth status) |
cualquier etiqueta ollama :cloud | Una cuenta de ollama.com, iniciada sesión en el daemon local | ollama signin |
Backend litellm | Claves API por proveedor | Consulta docs/specs/LITELLM_PROVIDER.md |
| etiqueta ollama / lmstudio / mlx en el dispositivo | Nada extra | — |
En las filas :cloud: esas llamadas se proxían a través de https://ollama.com por
el daemon local de ollama, que envía su propia credencial — el pipeline envía
ninguna credencial propia. Las etiquetas :cloud son las únicas etiquetas de ollama que necesitan
un inicio de sesión; las etiquetas puramente en el dispositivo no necesitan nada más allá del daemon en ejecución.
Recorrido de inicio
El recorrido funciona con cualquier proveedor de despacho que tengas configurado —
PIPELINE_BACKEND_DISPATCH (configúralo explícitamente, o agrega un bloque roles a un
registro local — el registro incluido no enruta nada; consulta Selección de proveedor
y autorización arriba). Con claude configurado, el despacho y la revisión invocan
la CLI de Claude Code; con un proveedor local como ollama configurado,
se ejecutan en ese modelo local en su lugar.
- Instalar — un comando:
scripts/install.sh(consulta el inicio rápido anterior para saber qué hace y qué no hace). - Registrar el servidor MCP y las personas — pasos 2–3 del inicio rápido anterior
(
claude mcp add ...más copiaragents/*.mdy la política del overlord), luego reinicia Claude Code. - Iniciar el panel —
scripts/dashboard.sh start, luego abrehttp://localhost:8000y elige tu proyecto objetivo en el selector de espacio de trabajo. - Descomponer un objetivo pequeño — pide al subagente
product-analyst(o a la acción de descomposición del panel) que convierta un objetivo de una línea en épicas/historias, luegomcp__pipeline__save_planel resultado con su camporepo_rootapuntando a tu proyecto objetivo — no a este repositorio de pipeline. - Despachar la primera historia lista —
mcp__pipeline__list_ready_stories, luegomcp__pipeline__dispatch_storyen la primera, y observa cómo la historia avanza por el tablero kanban en el panel. - Observar cómo se fusiona — con
PIPELINE_AUTONOMY=gated(el valor predeterminado), una historia de riesgolowque pase la revisión se fusiona sin supervisión. Comienza conPIPELINE_AUTONOMY=dry-runprimero, según el consejo del inicio rápido anterior. - ¿Prefieres la ruta con script? —
.venv/bin/python scripts/smoke_getting_started.pyejecuta el mismo flujo de principio a fin sin el panel, en unPLAN_DIRtemporal que nunca toca tus planes reales. La prueba de humo es neutral respecto al proveedor: se ejecuta en tu proveedor de despacho configurado (PIPELINE_BACKEND_DISPATCH, predeterminadoclaude) y anuncia el proveedor, modelo y fuente resueltos de antemano, para que siempre sepas qué backend validó. Códigos de salida:0ÉXITO (la historia llegó atests_passed),1el proveedor resuelto esclaudey falta el CLIclaude, el código 2 significa que el proveedor configurado está vacío o no es reconocido — un error de configuración, no un rechazo de un proveedor local —3el sondeo acotado agotó el tiempo,4la historia falló. Advertencia honesta: ÉXITO depende de que el modelo configurado realmente complete la historia, por lo que un fallo en un modelo local débil refleja ese modelo, no un pipeline roto.
Para saber qué puede salir mal aún, consulta Confiabilidad y limitaciones.
Servidor MCP complementario (solo overlord + oráculo de aceptación)
¿No estás listo para adoptar todo el orquestador? pipeline/companion_server.py es un
segundo servidor MCP más pequeño (pipeline-companion) que expone dos ideas que
se sostienen por sí solas sin adoptar el resto del pipeline:
escalate_decision (la ruta de decisión del overlord) y los ayudantes del oráculo
de aceptación classify_oracle_outcome / acceptance_digests. Importa los módulos reales pipeline.overlord y
pipeline.oracle_gate en lugar de duplicarlos, por lo que se mantiene
sincronizado con el servidor principal. Añádelo junto al servidor principal como una segunda
entrada mcpServers:
{
  "mcpServers": {
    "pipeline": {
      "command": ".venv/bin/python3",
      "args": ["app/pipeline_mcp_server.py"]
    },
    "pipeline-companion": {
      "command": ".venv/bin/python3",
      "args": ["-m", "pipeline.companion_server"]
    }
  }
}
Las especificaciones adoptables que este servidor exporta viven en docs/specs/:
OVERLORD_POLICY_SPEC.md (la ruta de decisión del overlord),
ACCEPTANCE_ORACLE_PATTERN.md (el patrón de calificación del oráculo de aceptación) y
DOCKER_SANDBOX.md (el comportamiento de sandboxing Docker opcional).
Ejecución independiente (panel + programador, sin servidor MCP)
El panel expone las mismas operaciones que las herramientas MCP — guardar/ingerir un plan,
descomponer un objetivo, despachar una historia, avanzar, revisar, aprobar fusión — por lo que
el pipeline puede ejecutarse sin registrar un servidor MCP en absoluto. Esa paridad vive en
la API HTTP, no en la interfaz: la interfaz del panel muestra directamente el chat (incluido
redactar un plan), navegar por planes, historias, diarios y registros, el selector
de espacio de trabajo, el flujo de revisión/aplicación de parches de worktree, la configuración de roles e ingerir un
plan guardado. Despachar, avanzar, revisar y aprobar fusión tienen rutas API sin interfaz
(/api/plans/{plan_name}/stories/{story_key}/dispatch y similares) disponibles para
scripting, y para el flujo independiente el programador es el controlador previsto:
redacta e ingiere un plan desde el panel, luego deja que el programador despache,
avance, revise y fusione historias listas por sí solo. La
ruta compatible es un comando:
scripts/standalone-setup.sh up
up aprovisiona un directorio de datos temporal (predeterminado ~/pipeline-standalone), escribe
el archivo de entorno del operador compartido con rutas absolutas, inicia el panel y el
programador a través de sus scripts auxiliares existentes, y luego se niega a informar
éxito hasta que GET /api/health responda con un config_mismatch vacío y
el plan_dir previsto. Opciones principales: --data-dir DIR (predeterminado
~/pipeline-standalone), --target-repo DIR (predeterminado: un repositorio temporal bajo
el directorio de datos), --port PORT (predeterminado 8001), --autonomy MODE (predeterminado
dry-run), más --repo-root y --force. down detiene ambos procesos y
deja los datos temporales en su lugar; status imprime las rutas resueltas y el estado de ambos
procesos.
Ambos procesos de larga duración leen el mismo archivo de entorno del operador:
scripts/dashboard.sh y scripts/scheduler.sh ambos obtienen
.pipeline.env (ignorado por git; consulta .pipeline.env.example) primero, luego
.dashboard.env (ignorado por git; consulta .dashboard.env.example) en segundo lugar, por lo que
las instalaciones existentes solo con panel mantienen su precedencia de última escritura actual —
.dashboard.env sigue funcionando y simplemente anula .pipeline.env donde se
superponen.
Debido a que el panel y el programador son procesos separados, PLAN_DIR
debe coincidir entre ambos: el programador escribe una huella de configuración en
<plan_dir>/.scheduler_health.json, y /api/health informa
config_mismatch enumerando los campos donde la configuración resuelta del panel
difiere de esa huella. Un config_mismatch no vacío significa que la interfaz y
el programador están trabajando con almacenes de planes diferentes — verifica que ambos se
iniciaron con el mismo PLAN_DIR (el script independiente escribe un archivo de entorno
precisamente por esta razón, y falla de forma contundente ante un config_mismatch no vacío).
Los requisitos previos normales siguen aplicándose en modo independiente: gh auth login para
la ruta de PR/fusión (el pipeline abre y fusiona PRs a través del CLI de GitHub),
y la autorización del proveedor para el backend que esté configurado — consulta
Selección y autorización de proveedor anterior.
Componentes de un vistazo
| Pieza | Ubicación | Rol |
|---|---|---|
| Subagentes de persona | ~/.claude/agents/*.md | Los roles de SDLC que los agentes interpretan |
| Política de decisión | ~/.claude/overlord-policy.md | Cómo decide el overlord |
| Servidor MCP del pipeline | app/pipeline_mcp_server.py (shim de lanzamiento) → paquete pipeline/ | Todas las herramientas del pipeline + orquestación; pipeline/server.py es el módulo de entrada, dividido en pipeline/*.py (despacho, revisión, CI, avance, almacenamiento, etc.) |
| Costura de backend | app/backend.py | Enrutamiento de controladores por rol (claude / ollama / lmstudio / mlx / local); de un solo disparo, revisión, despacho, puerta de recursos |
| Bucle de agente local | scripts/local_agent.py | Bucle de escritura con llamada a herramientas nativas para despacho local (subproceso) |
| Panel de monitoreo | app/dashboard.py, static/ | Visor de estado/ciclo de vida FastAPI; en modo independiente (consulta "Ejecución independiente" más abajo) también impulsa guardar/ingerir/despachar/revisar/fusionar directamente |
| Instalación / dependencias | scripts/install.sh, requirements*.txt | Configuración de venv + dependencias |
| Pruebas | tests/unit/ (más de 10 500 pruebas) | pytest, ejecutadas a través del venv |
| Planes / manifiestos / registros | ~/.claude/plans/ | Plan, manifiesto, decisiones, notificaciones |
| Worktrees | ~/.claude/worktrees/ | Ramas aisladas por historia |
| Rastreador de incidencias | Plane (externo, opcional) | Espejo del estado de la historia; se omite por completo cuando no está configurado (el manifiesto es la fuente de verdad) |
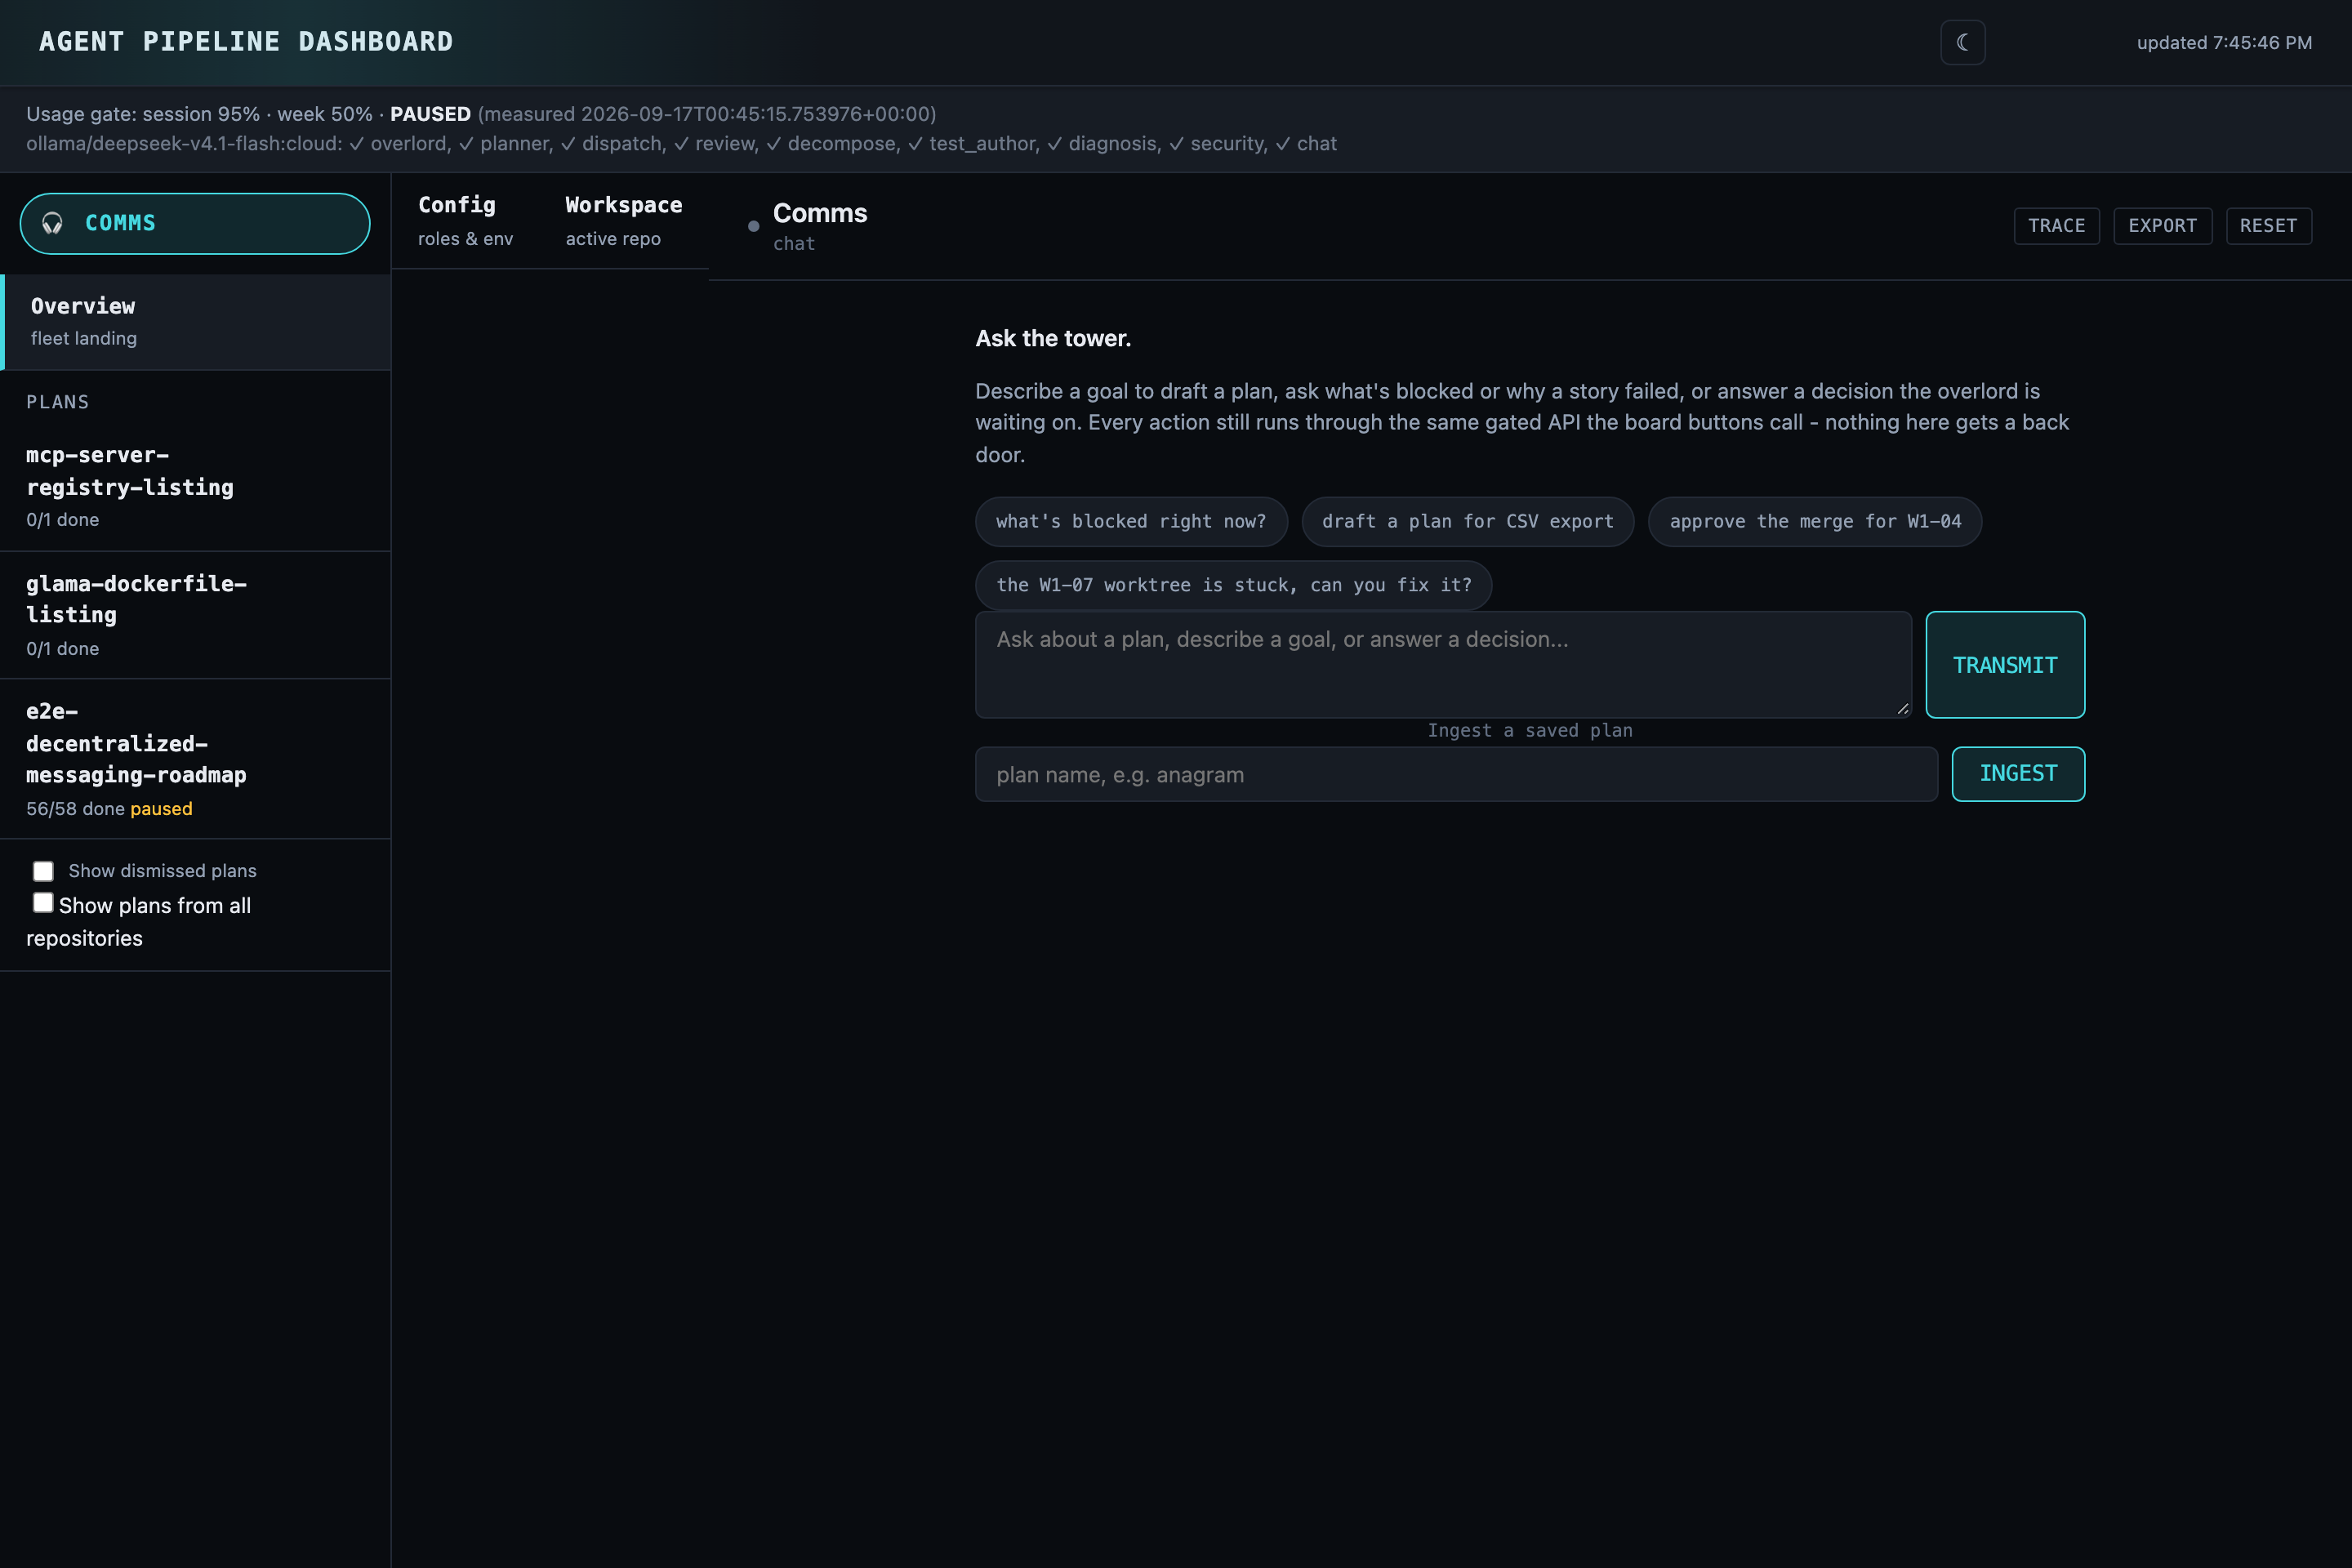
La vista de Comunicaciones del panel — pregunta qué está bloqueado, redacta un plan o aprueba una fusión, todo enrutado a través de la misma API con puerta que los propios botones del tablero kanban llaman. Más capturas de pantalla (el tablero kanban en vivo y el selector de espacio de trabajo) están en docs/DEMO.md.
Arquitectura
 ┌───────────────────────────────────────────────────────────┐
 │ Orchestrator loop (cron / /loop skill)                     │
 │ advance_pipeline(plan) — one idempotent tick               │
 └───────────────────────────┬───────────────────────────────┘
                              │ ready stories (deps satisfied)
                              ▼
 ┌───────────────┐  resolve backend +    ┌───────────────────────────────┐
 │ Plan/Manifest │  persona/model        │ Dispatch                      │
 │ (JSON, Plane) │──────────────────────►│  claude -p  OR  local loop    │
 └───────────────┘                       │  (tech-lead plans for local → │
                                          │   .agent_plan.md)             │
                                          └───────────────┬───────────────┘
                                                           ▼
                                          ┌───────────────────────────────┐
                                          │ Headless story agent, TDD-    │
                                          │ first, in an isolated git     │
                                          │ worktree                      │
                                          └───────────────┬───────────────┘
                                    local fail → escalate  │ tests +
                                    to claude (`auto`)     │ acceptance oracle
                                                           ▼
                                          ┌───────────────────────────────┐
                                          │ code-reviewer: VERDICT,       │
                                          │ opens a PR                    │
                                          └───────────────┬───────────────┘
                                                           ▼
      low    → decide silently            ┌───────────────────────────────┐
      medium → decide, notify the user    │ Overlord adjudicates risk     │──► decisions log
      high   → park, wait for a human     │ (blocked decisions, merge,    │    (audit trail)
                                           │  scope disputes)              │
                                           └───────────────┬───────────────┘
                                                            ▼ approved
                                           ┌───────────────────────────────┐
                                           │ Merge gate: rebase on master, │
                                           │ force-push, poll CI, re-run   │
                                           │ the suite on the rebased      │
                                           │ branch                        │
                                           └───────────────┬───────────────┘
                                                            ▼
                                                         master
Personas (~/.claude/agents/)
Cada persona es un subagente de Claude Code: un archivo markdown con frontmatter YAML
(name, description, model y opcionalmente memory: user) y un
cuerpo de prompt de sistema. El pipeline lee el cuerpo y despacha un agente sin interfaz
con ese cuerpo como rol.
memory: user inyecta el directorio de memoria de usuario en el prompt de sistema en
cada llamada de Claude — contexto de alto impacto pero costoso en tokens. Las
personas de revisión (code-reviewer, security-engineer) lo omiten deliberadamente:
su trabajo es una verificación mecánica (ejecutar pruebas, leer el diff, emitir VERDICT),
las reglas de CLAUDE.md que necesitan están en el cuerpo de la persona, y omitir la
inyección de memoria de ~132 KB reduce ~30-40% de los tokens de entrada de cada llamada de revisión.
Las personas de despacho y overlord lo mantienen porque se benefician del contexto del proyecto
y son de menor volumen.
| Persona | Modelo predeterminado | Responsabilidad |
|---|---|---|
product-analyst | opus | Descomponer un objetivo en épicas/historias con criterios de aceptación, dependencias y persona/model/risk por historia |
solution-architect | opus | Diseño general del sistema, selección de tecnología, diseño de API (delega móvil a mobile-architect) |
software-engineer | sonnet | Implementador TDD predeterminado para trabajo no móvil |
security-engineer | opus | Modelado de amenazas y revisión de seguridad (OWASP, Secure by Design) |
devops-release-engineer | sonnet | Build/CI, higiene de ramas y worktrees, lanzamientos |
code-reviewer | sonnet | Revisa una rama, emite un VERDICT, abre un PR |
tech-writer | haiku | Documentación para cambios visibles externamente |
overlord | opus | La autoridad de decisión (consulta más abajo) |
Los especialistas móviles existentes (mobile-architect, mobile-engineer,
ux-mobile-principal, qa-test-engineer) no cambian y se usan para trabajo móvil.
Para cambiar el comportamiento o el modelo predeterminado de una persona, edita su archivo .md. La
línea model: del frontmatter es el modelo de respaldo cuando una historia no especifica uno.
El overlord y la política de decisión
El overlord (~/.claude/agents/overlord.md) decide en nombre del usuario cuando
un agente de historia está bloqueado, dos personas no están de acuerdo o una puerta necesita arbitraje. Sigue
~/.claude/overlord-policy.md (más una anulación opcional <repo>/.overlord-policy.md por repositorio).
Niveles de decisión:
- Rutinario / reversible → decide en silencio (nombres, estructura interna, una biblioteca dentro del stack aprobado, refactorizaciones).
- Notificar-asincrónicamente (
risk: medium) → decide, continúa, avisa al usuario (nueva dependencia, cambio de esquema, cambio de API aditivo). - Estacionar-y-avisar (
risk: high) → no actuar sin supervisión; mantener para revisión humana y notificar. Cualquier cosa irreversible, seguridad/autenticación, dinero, configuración de producción o cambios disruptivos. Siempre estacionado independientemente del nivel de autonomía.
El overlord devuelve un dictamen estructurado (RULING / TIER / RISK /
RATIONALE / NOTIFY_USER) que se analiza y se escribe en el registro de decisiones del plan
como un registro de auditoría.
Referencia
Consulta REFERENCE.md para la referencia completa de herramientas MCP, el esquema JSON de plan/historia, la configuración de proveedor/modelo por rol, la descomposición guiada y los detalles de división TDD, cada variable de entorno PIPELINE_*/LOCAL_AGENT_*, el flujo de trabajo de extremo a extremo, los controles de seguridad, la puerta de uso y las instrucciones de desarrollo/pruebas.
Para un ejemplo de extremo a extremo trabajado del pipeline desarrollando este propio repositorio — el comando de instalación, los pull requests reales que produjo y un relato honesto de lo que aún no puede hacer — consulta docs/DEMO.md.
Para saber cómo se corta un lanzamiento, consulta docs/RELEASING.md.
Requisitos previos
- Python 3.10+ y el venv del proyecto. CI prueba 3.12–3.14 en Ubuntu y macOS en cada push; 3.10/3.11 no forman parte de la matriz de CI, así que trátalos como probablemente correctos pero no verificados.
- git en PATH.
- GitHub CLI (
gh). - Claude Code CLI (
claude).
Programador
El programador de avance se ejecuta como un daemon de larga duración en lugar de un
tick periódico de launchd. El rol de launchd se limita a reiniciarlo ante fallos a través de KeepAlive.
Variables de entorno
- PIPELINE_SCHEDULER_INTERVAL_S – intervalo de reconciliación predeterminado (60 segundos por defecto).
- PIPELINE_SCHEDULER_HEALTH_PATH – ruta opcional donde el daemon escribe su JSON de salud en cada iteración.
Generando los archivos launchd para tu máquina
Los archivos launchd/*.plist y launchd/pipeline-logs.newsyslog.conf incluidos
son una copia de referencia: contienen las rutas absolutas del mantenedor (un
directorio home de /Users/<name>/..., una ruta específica de caché de modelos) y no
funcionarán sin editar en otra máquina. En una instalación nueva, regenéralos tú mismo
con scripts/generate_launchd_plists.sh (install.sh no ejecuta esto por
ti) — rellena las plantillas en launchd/
(launchd/com.fagan.pipeline.*.plist.template) a partir de tres banderas:
--repo-root— el checkout del pipeline al que deben apuntar los archivos generados (por defecto: el repositorio que contiene el script).--out-dir— dónde se escriben los archivos generados (por defecto:<repo-root>/launchd).--mlx-model-path— el directorio local de modelos MLX incrustado en el plist de mlx-supervisor. Como alternativa a la bandera, puedes establecer la variable de entornoMLX_MODEL_PATH; la bandera tiene prioridad cuando se proporcionan ambas. El script falla de forma segura — sale con un error — cuando no se proporciona ninguna.
El mismo script también genera launchd/pipeline-logs.newsyslog.conf a partir de
launchd/pipeline-logs.newsyslog.conf.template, sustituyendo solo la raíz del repositorio.
scripts/generate_launchd_plists.sh \
  --repo-root "$HOME/.claude/mcp-servers/pipeline" \
  --out-dir "$HOME/.claude/mcp-servers/pipeline/launchd" \
  --mlx-model-path "$HOME/.cache/qwen2.5_coder_14b_manual"
Estos archivos launchd son solo para macOS - consulta Soporte de plataformas.
Generando las unidades systemd para Linux
scripts/generate_systemd_units.sh genera las unidades de usuario systemd equivalentes
y los archivos logrotate a partir de systemd/*.template, de la misma manera
que scripts/generate_launchd_plists.sh lo hace para launchd – excepto MLX, que es
solo para Apple Silicon:
scripts/generate_systemd_units.sh \
  --repo-root "$HOME/fagan" \
  --out-dir "$HOME/fagan/systemd"
Instala como unidades systemd por usuario (no se requiere root):
mkdir -p ~/.config/systemd/user
cp systemd/com.fagan.pipeline.advance-scheduler.service ~/.config/systemd/user/
cp systemd/com.fagan.pipeline.usage-poller.service ~/.config/systemd/user/
cp systemd/com.fagan.pipeline.usage-poller.timer ~/.config/systemd/user/
systemctl --user daemon-reload
systemctl --user enable --now com.fagan.pipeline.advance-scheduler.service
systemctl --user enable --now com.fagan.pipeline.usage-poller.timer
  # Optional: let these run even when you are not logged in
loginctl enable-linger "$USER"
Rotación de logs (requiere root, una sola vez):
sudo cp systemd/pipeline-logs.logrotate.conf /etc/logrotate.d/com.fagan.pipeline
Fiabilidad y limitaciones
Este pipeline ejecuta bucles de codificación autónomos reales, y fallan de maneras específicas y documentadas — lee esto antes de apuntarlo a algo que te importe.
- El envío de modelos locales (no Claude) es el punto débil. Funciona bien para
historias pequeñas y mecánicamente acotadas (un tema, ≤2 archivos de producción) y
se degrada bruscamente en cualquier cosa más grande: ediciones de archivos grandes, historias
con múltiples funciones e inserciones ancladas en funciones largas existentes causan de forma
fiable tiempos de espera por límite de pasos, bloqueos o corrupción de archivos por ediciones
con números de línea obsoletos.
docs/plans/*.mdyretros/*.mden este repositorio son el registro real de incidentes del que proviene esta conclusión, no una afirmación de marketing — lee algunos antes de confiar en el envío local para algo no trivial.PIPELINE_BACKEND_DISPATCH=autoexiste específicamente para escalar un intento local con dificultades a Claude en lugar de dejarlo en bucle. - El marco de "$20/mes" es el objetivo de diseño en torno al cual se construyen las puertas,
no un resultado comparado aún. La única ejecución completa de comparación de modelos
registrada (
tests/benchmark/FINDINGS.md) se contaminó a mitad de ejecución por límites de tasa y agotamiento de crédito, por lo que no hay una comparación limpia de manzanas con manzanas de tasa de éxito/costo entre backends publicada aún. El número más limpio allí es limitado —gpt-oss:20ben el dispositivo, 2 tareas T1, 2/2 éxito con el oráculo independiente aprobando el código fusionado, un ensayo cada una — y es direccional, no una comparación de calidad. Lee ese archivo para saber exactamente qué se sabe y qué no antes de citar un número de él. - Una suite de pruebas en verde no es prueba de un cambio correcto o completo. Un
ejecutor (local o Claude) converge al diff mínimo que pone sus propias
pruebas en verde, y puede escribir una prueba incorrecta pero autoconsistente que codifica
el mismo error que su implementación. Consulta la sección
"Merge-gate and AI-review lessons" de
.claude/rules/code-review.md— cada lección allí proviene de una regresión fusionada real, no de una hipótesis. - Una historia marcada como
doneno es prueba de que todo el alcance de su título se haya enviado. Una historia de "migrar todo" o "eliminar todo X" puede pasar la revisión y fusionarse habiendo hecho solo parte del trabajo, porque la revisión califica las pruebas de la propia historia, no la afirmación del título. Consulta.claude/rules/agent-dispatch-story-sizing.md. - El nivel
park-and-pingdel overlord es un piso de seguridad real, no una sugerencia — las decisiones de alto riesgo (acciones irreversibles, autenticación/seguridad, dinero, configuración de producción, cambios disruptivos) siempre se detienen para un humano, independientemente del nivel de autonomía. Inicia cualquier nuevo despliegue enPIPELINE_AUTONOMY=dry-runy lee el registro de decisiones antes de confiar engatedofull. - Este es un proyecto de investigación de un solo mantenedor, no un producto mantenido con un SLA. La suite de pruebas y el CI son puertas reales, pero espera bordes ásperos, y espera que el catálogo de modos de fallo siga creciendo a medida que se encuentren nuevos.
Si encuentras un nuevo modo de fallo, vale la pena documentarlo (consulta retros/ para el
formato existente) en lugar de solucionarlo silenciosamente — todo el valor del
diseño de este proyecto es que los modos de fallo se nombran y se retroalimentan en cómo
se dimensionan y revisan las historias.
Licencia
Licenciado bajo la Apache License, Versión 2.0 — consulta LICENSE y NOTICE.