Obsidian MCP Server
Servidor MCP autoalojado para Obsidian: búsqueda semántica y de texto completo, grafo de wikilinks, CRUD de notas, OAuth y una guía de bóveda autodescriptiva.
Documentación
Servidor MCP de Obsidian

Un sistema de memoria para tus agentes de IA — almacenado como markdown plano que puedes abrir en Obsidian.
Un servidor Model Context Protocol autohospedado que brinda a cada agente que conectes un lugar duradero y compartido para recordar cosas. El almacenamiento no es una base de datos vectorial que no puedes ver: es una carpeta de archivos markdown en tu bóveda de Obsidian, respaldada por búsqueda de texto completo y semántica y por tu propio grafo de wikilinks. Obsidian es la ventana humana hacia ello — abre una nota, lee exactamente lo que un agente escribió sobre ti, corrígelo, elimínalo o lleva la carpeta completa a otro lugar. También es autodescriptivo: los agentes leen lo que tú lees, enlazan lo que tú enlazas y captan la estructura de tu carpeta, el esquema de frontmatter y tus convenciones de etiquetas en la primera llamada, en lugar de recibir instrucciones desde cero en cada sesión.
Para ser precisos sobre el alcance: lo que el servidor proporciona es almacenamiento accesible vía MCP, búsqueda por palabras clave y semántica, y operaciones de grafo sobre notas markdown, para cualquier cliente MCP que conectes. Los agentes dirigen sus propias lecturas y escrituras. No hay un pipeline automático de extracción, consolidación o decaimiento ejecutándose detrás de ellos — un agente recuerda algo porque escribió una nota, y lo olvida porque alguien eliminó una.
Stack: Python 3.12, FastAPI, PostgreSQL con pgvector. Incrustaciones
conectables (Ollama bge-m3, o OpenAI text-embedding-3-{small,large}).
Contenido
- Por qué existe esto
- Una sesión frente al teclado
- Una sesión lejos del teclado
- Qué incluye
- Comparación con otros servidores MCP de Obsidian
- Para quién es esto
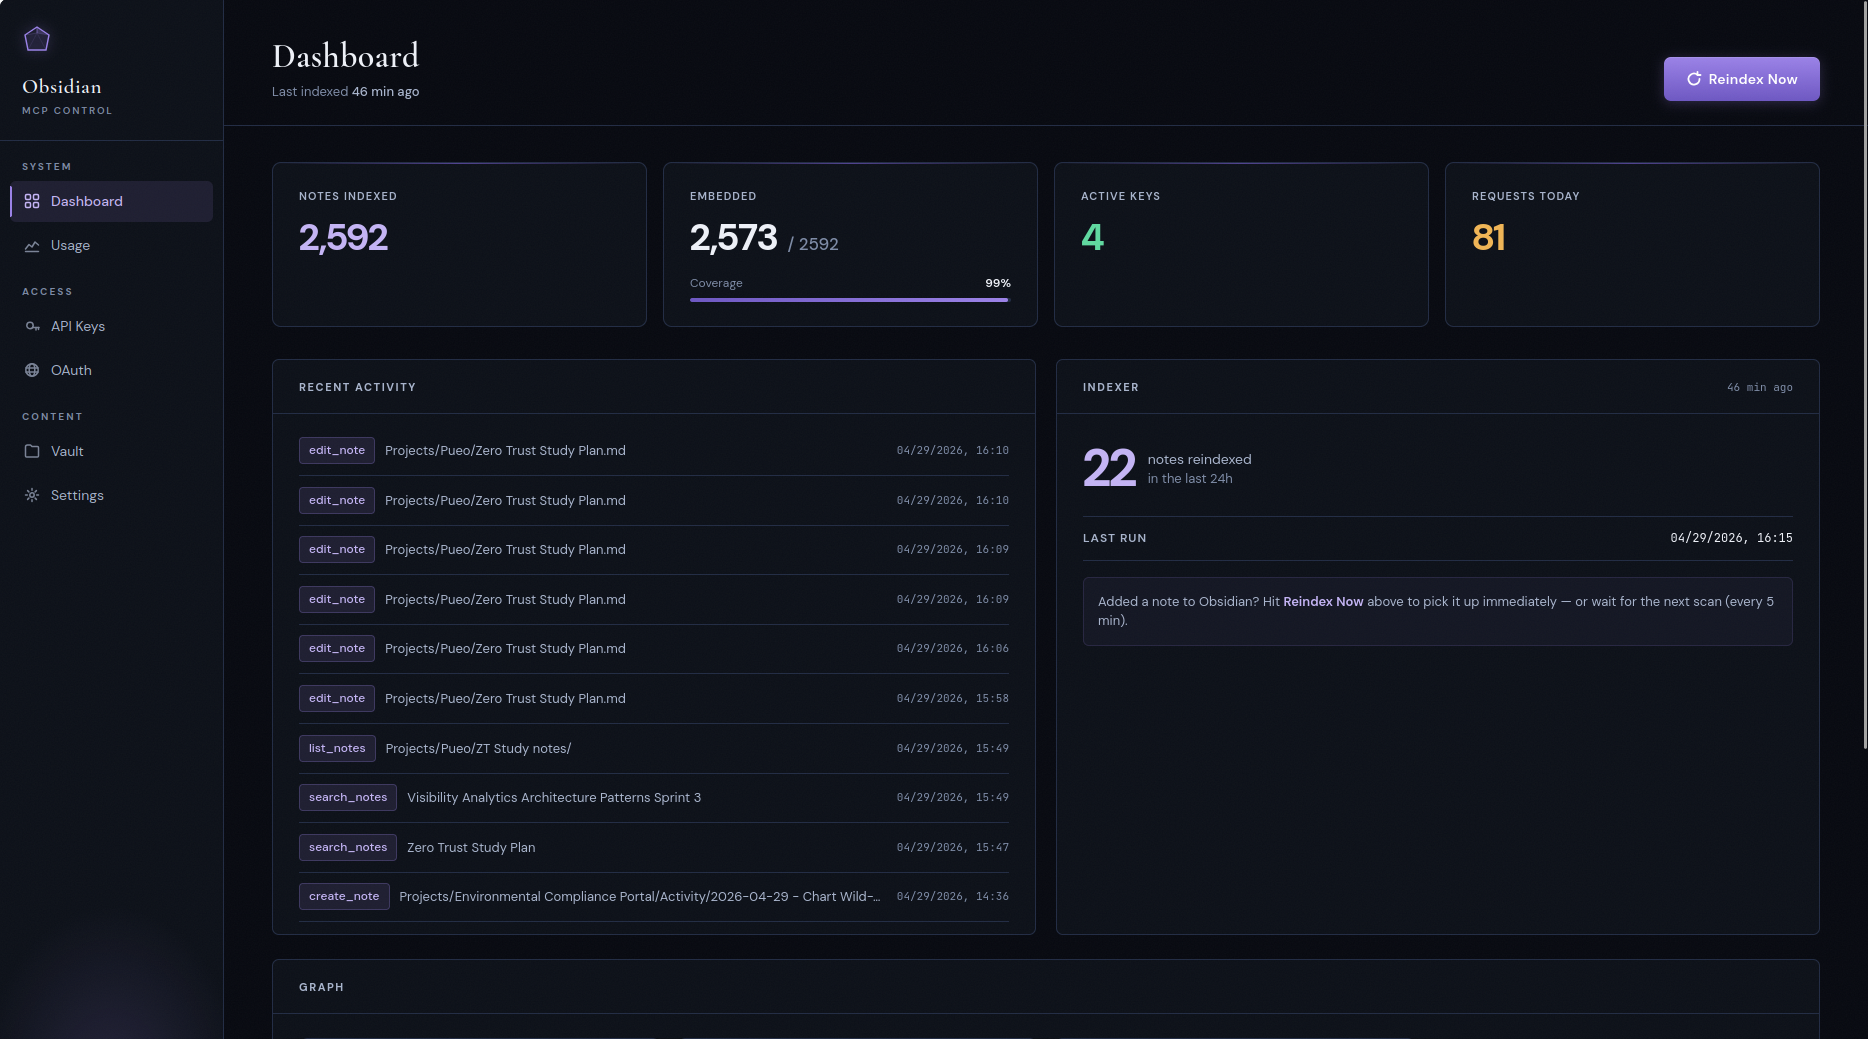
- Panel de control
- Inicio rápido
- Actualización
- Expectativas de costos
- La bóveda autodescriptiva
- Modo multiusuario
- Configuración
- Arquitectura
- Estructura del proyecto
- Desarrollo
- Notas de seguridad
Por qué existe esto
Hay tres cosas en juego aquí, y son más interesantes juntas que por separado.
1. Memoria de agente que realmente puedes leer
Si dejas que un agente funcione por un tiempo, necesita memoria. La mayoría de las configuraciones lo resuelven con un almacén vectorial opaco, un blob de SQLite o un servicio de "memoria" administrado que no puedes ver. Eso funciona hasta que quieres saber qué cree el agente que sabe sobre ti, o necesitas corregir algo, o quieres entender por qué acaba de hacer una sugerencia extraña.
Este servidor te ofrece un trato diferente. La memoria del agente vive como archivos markdown en tu bóveda. Estructura de carpetas, nombres de archivos, frontmatter, todo visible. Puedes abrir el archivo en Obsidian y leerlo. Puedes editarlo. Puedes eliminarlo. Puedes hacer grep. La "memoria" del agente es un artefacto auditable por humanos que se encuentra en el mismo lugar que tus propias notas, con las mismas herramientas disponibles.
El laboratorio doméstico es el caso de uso que me convenció de esto. Mi bóveda tiene notas sobre el rack, la red y cada integración de Home Assistant. Puedo decir "configura un modo de luz nocturna en el baño principal, al 1% después de las 11 p. m." y un agente administrador de sistemas encuentra la configuración correcta, hace el cambio y actualiza el documento en la misma pasada. Seis meses después, cuando he olvidado cómo funciona, la respuesta está en la bóveda, no enterrada en algún historial de chat que no puedo buscar.
La búsqueda semántica y el grafo de wikilinks siguen funcionando sobre ese material, por lo que la recuperación es rápida y conceptual. Pero el sustrato son archivos que tú posees, no una caja negra.
2. Una capa de memoria compartida entre tú y tus agentes
La otra mitad funciona en la dirección opuesta: la bóveda no es solo la memoria de los agentes, también es la mía. Pienso en mi bóveda de Obsidian como mi exocórtex. El "yo grande" que incluye notas, calendarios, scripts, búsqueda y asistentes de IA es sustancialmente más capaz que el "yo pequeño" del cerebro biológico solo. También es donde hago la mayor parte de mi pensamiento, porque escribir algo es en sí mismo una forma de pensamiento.
El problema es que hasta hace poco, la bóveda era pasiva. Tenía que ir a buscar las cosas. Los agentes que querían ayudarme tenían que recibir instrucciones desde cero en cada sesión, y no tenían forma de ver lo que ya había escrito sobre un tema.
Este servidor soluciona eso. Ahora la misma bóveda alimenta mi escritura diaria y cualquier agente que conecte a ella. El agente lee lo que yo leo, enlaza lo que yo enlazo, sigue los mismos wikilinks, ve el mismo frontmatter. Cuando escribo una nota de proyecto el domingo, mi agente de resumen del lunes por la mañana ya lo sabe. Cuando el agente deja notas de una sesión de investigación, aparecen en mi búsqueda normal de Obsidian.
Una versión concreta de esto: paso una sesión en Claude Code en un proyecto, termino, hago push de los commits y luego simplemente digo "actualiza Obsidian". El agente lee la guía de la bóveda, descubre dónde viven las notas de proyecto en mi estructura, elige el formato y frontmatter correctos y deja un registro de sesión que luego puedo convertir en un informe de estado. Sin pasar rutas, sin decirle qué escribir: las convenciones ya están en la bóveda, y él las sigue.
Esa es la idea del exocórtex hecha concreta: un solo lugar que contiene contexto, y tanto el humano como los agentes leyendo y escribiendo en él en los mismos términos.
3. La bóveda te sigue
Lo que todavía me sorprende es que esto está orientado a internet. La misma bóveda, las mismas notas, accesibles desde cualquier lugar donde esté hablando con un agente — Claude en una pestaña del navegador, Claude en mi teléfono en el tren, un flujo de trabajo de n8n ejecutándose en un horario, una sesión de Claude Code en cualquier laptop que tenga enfrente. Todo detrás de OAuth o una clave bearer, todo apuntando a la misma fuente de verdad.
Así que cuando escucho un podcast interesante en un viaje y quiero pensar en voz alta sobre ello con Claude en mi teléfono, el agente no comienza en frío. Puede recuperar lo que ya he escrito sobre temas adyacentes, mostrar una nota que dejé a medias hace seis meses y, al final de la conversación, sugerir actualizaciones y escribirlas. La bóveda no tiene que estar cerca de mí para ser el lugar donde estoy trabajando. (Una sesión lejos del teclado recorre exactamente una de estas.)
Una sesión frente al teclado
Para hacer lo abstracto concreto, una breve transcripción de una sesión real. Llamadas a herramientas en línea; el usuario escribe en inglés simple y el agente elige la herramienta correcta.
you  > find anything I've written about why retrieval-augmented
       chat is hard

claude
  → semantic_search(query="why retrieval-augmented chat is hard")
    • 2025-12-03 - RAG failure modes.md
    • 2025-10-18 - Chunking tradeoffs.md
    • 2024-06-22 - Vector recall vs precision.md

  the closest hit is your December note on RAG failure modes. let
  me see what it's connected to.

  → get_neighborhood(path="2025-12-03 - RAG failure modes.md",
                     depth=1)
    8 connected notes. notable ones:
    • "Hybrid search" — a re-ranking design you sketched but
      didn't ship
    • "Out-of-distribution queries" — a half-finished draft from
      October
    • "Embedding model choice" — links to bge-m3, your current
      model

  you have three connected pieces here: a failure-modes catalog,
  an unshipped hybrid-search sketch, and an abandoned O-O-D draft.
  want me to summarize all three together, or pull up the draft
  so you can decide whether to finish it?

you  > pull up the draft, and tag it #revisit-2026 in frontmatter
       while you're there

claude
  → read_note(path="2025-10-18 - OOD queries (draft).md")
  → set_frontmatter(
      path="2025-10-18 - OOD queries (draft).md",
      updates={"tags": ["draft", "rag", "revisit-2026"]}
    )

  here's the draft, and the tag is on. you stopped right before
  the section on confidence thresholds; the open question you
  left yourself was…
Dos cosas para notar. Primero, el agente no necesitó que le dijeran en qué
carpeta buscar o qué herramientas usar — las eligió. Segundo, la
escritura al final está estructurada (set_frontmatter mutando YAML, no
una regex sobre el cuerpo del archivo), por lo que la nota hace un viaje de ida y vuelta limpio. La
bóveda autodescriptiva y el grafo de wikilinks están haciendo el trabajo que
hace que esto se sienta natural.
Una sesión lejos del teclado
La transcripción anterior es el caso fácil: estoy en un escritorio, puedo ver lo que el agente está haciendo, y Obsidian está a un alt-tab de distancia. La sesión que realmente cambió cómo pienso sobre este servidor no tenía nada de eso.
Estaba caminando con un podcast de salud en mis oídos — uno largo, dos personas que claramente no estaban de acuerdo entre sí, una hora de eso. Tenía mi teléfono y ninguna intención de volver a casa a una laptop. Así que descargué la transcripción del episodio, se la di a Claude en mi teléfono, y lo hablamos mientras seguía caminando: cuál era la afirmación real, qué partes ya tenía en notas, dónde contradecía algo que había decidido hace meses y escrito en ese momento.
El agente tuvo la bóveda todo el camino. Mostró lo que ya había escrito sobre el tema, señaló que dos fechas en una nota más antigua estaban mal, y preguntó si una decisión que había registrado el año pasado seguía en pie dado lo que el episodio argumentaba. Para cuando volví, había escrito todo: las decisiones de salud que realmente había tomado durante la caminata, las correcciones de fechas en la nota antigua, un par de notas nuevas sobre el episodio en sí — y, porque la conversación seguía volviendo a eso, una nota duradera sobre cómo decido a qué expertos confiar en cuestiones médicas en primer lugar. Esa última es el artefacto al que sigo volviendo. No se trataba del episodio en absoluto; era el razonamiento detrás de toda una clase de decisiones, y ahora está en la bóveda donde el próximo agente lo encontrará.
Nunca abrí Obsidian. Ni en la caminata, ni cuando llegué a casa. Toda la sesión — recuperación, argumento, corrección y la escritura que surgió de ella — pasó a través de un agente, y la bóveda es simplemente donde aterrizó. Obsidian es cómo reviso el trabajo después, no cómo se hace el trabajo. Esa inversión es la mayor parte de la razón por la que este proyecto se ve como se ve.
Qué incluye
El servidor expone 25 herramientas MCP en cinco familias, más la capa de autenticación y operaciones que las rodea.
Búsqueda y descubrimiento
keyword_search(query, folder?, tags?, frontmatter?, limit=20), texto completo vía PostgreSQLtsvector; las configuraciones de búsqueda de texto son configurables víaFTS_CONFIGS(ver Idioma(s) de búsqueda de texto completo)semantic_search(query, folder?, tags?, frontmatter?, limit=15), similitud vectorial vía pgvector, un fragmento de vista previa por notalist_notes(folder?, limit=50), ordenado por tiempo de modificaciónget_recent(folder?, limit=20), cambiados recientementeget_tags(limit=50), etiqueta y recuentoget_vault_guide(), la guía básica de Obsidian más elCLAUDE.mdde esta bóveda, servido en vivo
Lectura y escritura
read_note(path, section?, offset=0, limit?)devuelve un resultado estructurado —path,title,tags,frontmatter_yamly una vista JSONfrontmatter,heading(lecturas de secciones),contenty truncamiento como datos (truncated,offset,next_offset,total_chars,outline,notice). Limitado porMAX_READ_RESPONSE_CHARS(predeterminado 40,000) — ver Límites de tamaño de respuesta.section=<heading>devuelve el cuerpo de una sección en lugar de la nota completa;offsetcontinúa una lectura truncada.create_note(path, content), escritura atómica, rechaza sobrescrituraedit_note(path, …)con cuatro modos mutuamente excluyentes: reemplazo completo (predeterminado),append=True,find=…(con opcionalreplace_all), osection=<heading>(encabezados ATX, admiteParent/Childestilo ruta y#Ndesambiguación ordinal).dry_run=Truedevuelve un diff unificado sin escribir. Los clientes heredados pueden usaroperation="append";operation="replace"selecciona explícitamente reemplazo completo.move_note(from_path, to_path, rewrite_links=False), reubica y opcionalmente reescribe las referencias entrantes[[Old]],[[Old|alias]],[[Old#anchor]],![[Old]]y[[folder/Old]]en las notas de origendelete_note(path, permanent=False), eliminación suave hacia.trash/<YYYYMMDD-HHMMSS>-<basename>-<8 hex>por defecto, mediante un único renombrado sin reemplazo, por lo que nunca sobrescribe una entrada de papelera existente (un sistema de archivos que no puede hacer ese renombrado hace que la eliminación suave se rechace con un error nombrado en lugar de recurrir a otra opción).permanent=Truedesvincula.set_frontmatter(path, updates, remove?), mutación YAML estructurada. El cuerpo es byte-idéntico cuando solo cambia el frontmatter.
Acceso a archivos (no Markdown)
Lectura/escritura/exploración en bruto de archivos arbitrarios de la bóveda (PDFs, imágenes, recursos de habilidades, archivos de datos) — pares distintos de las herramientas de notas, que permanecen solo en Markdown. Transporte de bytes puro: sin extracción de PDF/texto en el servidor, sin incrustación ni indexación de archivos que no sean Markdown.
read_file(path, encoding="auto", offset=0, limit?), devuelve archivos similares a texto como texto, imágenes como un bloque de imagen en línea que se renderiza en el cliente, y otros binarios como una cadena base64.text/base64fuerzan la forma. Rechaza archivos de más deMAX_FILE_READ_BYTES(por defecto 10 MB); los resultados de texto están además limitados porMAX_READ_RESPONSE_CHARSy continúan víaoffset.hash_only=Truedevuelve elcontent_hashde todo el archivo sin contenido; los resultados base64 incluyen ese hash en su cabecera. Los resultados de texto permanecen como texto plano.write_file(path, content, encoding="base64", overwrite=False), coloca un archivo en la bóveda; base64 para binarios,textpara UTF-8. Sin sobrescritura por defecto, crea automáticamente los directorios padre, escritura atómica. Limitado aMAX_FILE_WRITE_BYTES(por defecto 25 MB).list_files(folder=".", pattern="*", recursive=False, limit=200), exploración de estilolsde archivos y subdirectorios con tamaño y mtime, filtrable por glob y con límite de resultados.delete_file(path, permanent=False), elimina de forma suave un archivo que no sea Markdown a.trash/<YYYYMMDD-HHMMSS>-<basename>-<8 hex>con un único renombrado atómico. Rechaza Markdown (eso esdelete_note), directorios y enlaces simbólicos.
Los cuatro reutilizan la protección contra el recorrido de rutas y excluyen cualquier ruta con un componente que comience con . (directorios y archivos ocultos) (.obsidian, .git, .trash, …), coincidiendo con la regla de visibilidad del indexador.
Proteger las ediciones contra lecturas obsoletas
Pasa el content_hash de una lectura como expected_hash al editar, actualizar el frontmatter, mover o eliminar una nota, sobrescribir un archivo en bruto o eliminar un archivo en bruto. El token canónico es sha256:<64 lowercase hex>, calculado sobre los bytes completos del archivo en bruto; un read_note de sección o truncado aún devuelve el hash de todo el archivo. Para archivos en bruto, usa read_file(hash_only=True) o la cabecera base64. No calcules el hash del texto devuelto tú mismo.
Un token obsoleto rechaza la operación antes de la mutación, con una línea JSON final MCP-REFUSAL que nombra stale_precondition y el hash actual. Relee y reconsidera la edición antes de reintentar. Los movimientos vinculan solo la nota de origen; los movimientos y eliminaciones aún permiten una edición en el lugar después de su comparación previa. Las sobrescrituras conservan su verificación de bytes separada dentro de la llamada. Las escrituras de publicación exitosas informan un nuevo hash cuando está disponible.
El argumento es opcional por defecto. WRITE_PRECONDITION_REQUIRED=true lo requiere en las llamadas destructivas compatibles; habilita esto solo después de que los clientes proporcionen tokens. La creación está exenta y rechaza un token proporcionado como no_incumbent. Los archivos por encima de su límite de lectura no pueden protegerse.
Transferencia de archivos
Ningún cliente MCP puede entregar a una herramienta los bytes de un archivo que el usuario está viendo, por lo que write_file solo es utilizable cuando el agente ya tiene el contenido. Estas herramientas cierran esa brecha con enlaces de capacidad de corta duración, canjeados a través de las rutas públicas /transfer/*.
request_upload(path, overwrite=False, expires_in?), acuña un enlace de un solo uso vinculado exactamente a una ruta de destino. El humano lo abre, elige un archivo, y aterriza enpath— nada más puede escribirse con él.check_upload(upload_id), informapending/uploading/completed(con ruta, tamaño, sha256 y MIME) /unknown(una transmisión iniciada y el servidor nunca registró cómo terminó — lee la ruta antes de volver a acuñar) /revoked(la credencial o la raíz de la bóveda cambiaron bajo el enlace) /expired, limitado a la identidad que lo acuñó.request_download(path, expires_in?), acuña un enlace que el humano puede usar para guardar un archivo de la bóveda. Utilizable más de una vez hasta que expire, y vinculado a los bytes exactos del archivo en el momento de la acuñación.import_from_url(url, path, overwrite=False), obtiene un recurso https público directamente en la bóveda bajo una política explícita de denegación de salida (sin direcciones privadas, de bucle local, de enlace local, de metadatos o tunelizadas, en cualquier ortografía, re-verificada en cada redirección).
El token viaja en el fragmento de la URL, que los navegadores nunca envían, por lo que ningún objetivo de solicitud generado por el servidor o registro de acceso lo contiene. Las subidas se reclaman antes de que se lea un byte del cuerpo, se publican atómicamente con semántica de no sobrescritura, y se vinculan en el momento de la acuñación al estado del archivo contra el que se acuñaron — un enlace no puede deshacer silenciosamente una edición hecha mientras esperaba. MCP_HOSTNAME o BASE_URL deben estar configurados; sin un origen público, las herramientas de acuñación se niegan en lugar de emitir un enlace de localhost.
Grafo de wikilinks
get_backlinks(path, limit=50), notas que enlazan Apathget_links(path), enlaces salientes, tanto resueltos como colgantesget_neighborhood(path, depth=1, limit=50), BFS no dirigido sobre el grafo de enlaces resueltos, limitado a profundidad ≤ 5 y límite ≤ 200find_related(path, limit=10), vecinos semánticos mediante incrustaciones de fragmentos promediadas y distancia coseno de pgvector, deduplicados por notafind_orphans(folder?, limit=50), notas con cero enlaces resueltos entrantes o salientes
Autenticación y operaciones
- Claves API con el prefijo
omcp_, almacenadas como hashes SHA-256, con ámbitos de permisoreadyreadwrite. Las herramientas de escritura se niegan en claves de solo lectura. - Flujo OAuth 2.0 PKCE (S256) para clientes públicos y confidenciales, incluidos ChatGPT, Claude Desktop y claude.ai. El registro dinámico se establece por defecto en ambos niveles de permiso de la bóveda; el usuario elige la concesión real en la pantalla de consentimiento.
- Panel de control (Jinja2, CSS escrito a mano, Chart.js incluido, CSP basado en nonce) para claves, registros de uso, estado del indexador, información del proveedor de incrustaciones y un reinicio de zona de peligro.
- Cada llamada de herramienta se registra en
usage_logscon nombre, parámetros (truncados a 200 caracteres), duración, tamaño de respuesta y el nombre de la credencial que llama — registrado en el momento de la llamada, por lo que el rastro de auditoría sobrevive a la eliminación de la clave o cliente OAuth que describe. /healthno está autenticado y devuelvestatusmás dos campos de capacidad:transfer_mount_check_available(el kernel admite la verificación de montaje que las escrituras de transferencia necesitan) yvault_named_staging_fallback_active(una escritura se ha preparado realmente bajo un nombre en este proceso)./healthtambién lleva un objetoindexer(status,task_running,failing_scopes,embedding_failing_scopes,max_consecutive_failures,quarantined_notes,last_success_at), y elstatusde nivel superior se convierte en"degraded"cuando la tarea del indexador ha muerto, cualquier contador de fallos de índice, incrustación o enumeración — o la ejecución de re-derivaciones incompletas de un ámbito — alcanzaINDEXER_DEGRADED_AFTER_FAILURES, o una nota es puesta en cuarentena. El código HTTP permanece en 200 — un reinicio no puede reparar el contenido de la bóveda o una interrupción del proveedor, y Kubernetes usa/healthpara la vivacidad — así que monitorea el campostatus(una verificación de palabra clave o JSON para"status":"ok"), no el código de estado. Solo conteos: sin ruta, texto de error o id de usuario.
Cada escritura — herramientas de notas, write_file, subidas e importaciones — prepara los nuevos bytes en un inodo temporal, los fsync, y solo entonces publica. La creación publica con un enlace duro atómico del kernel que se niega a sobrescribir; move_note y la eliminación suave publican con un único renombrado no reemplazante; una sobrescritura es un renombrado en el mismo directorio sobre el destino. El directorio de destino (y cualquier directorio que la llamada haya creado) se fsync después, por lo que un fallo a mitad de escritura no puede truncar una nota ni perder una que el servidor informó como escrita.
La preparación ocurre en un inodo sin nombre donde el sistema de archivos lo admita, por lo que ningún nombre temporal es visible en la bóveda. En un montaje que lo rechace (algunas exportaciones NFS lo hacen), esas escrituras se niegan con un error que nombra VAULT_ALLOW_NAMED_STAGING_FALLBACK; establecer esa bandera devuelve la preparación con nombre en ambas rutas de escritura como una garantía declarada y más débil. Ver Requisitos del sistema.
vs. otros servidores MCP de Obsidian
Existen varios servidores MCP para Obsidian, y la mayoría resuelve un problema diferente al de este. Los ligeros son pegamento sobre el plugin de API REST Local de Obsidian o el sistema de archivos: permiten que un agente alcance los archivos, pero no construyen infraestructura propia. Son geniales si "solo quiero que Claude lea mis notas" es el objetivo y mantienes Obsidian ejecutándose localmente.
Este servidor está en el otro extremo del espectro: un backend real con un índice persistente, recuperación semántica, un grafo de wikilinks, OAuth y una interfaz de administración. El costo es Postgres y Docker. El beneficio es todo lo que puedes construir sobre eso.
| Este servidor | MarkusPfundstein/mcp-obsidian | StevenStavrakis/obsidian-mcp | jacksteamdev/obsidian-mcp-tools | |
|---|---|---|---|---|
| Índice persistente (Postgres) | ✅ | — | — | — |
| Búsqueda semántica (vectores) | ✅ | — | — | — |
| Consultas de grafo de wikilinks | ✅ | — | — | parcial |
| Funciona sin Obsidian abierto | ✅ | — | ✅ | — |
| Flujo de cliente OAuth 2.0 | ✅ | — | — | — |
| Bóvedas multiusuario / por usuario | ✅ | — | — | — |
| Interfaz de administración + registros de uso | ✅ | — | — | — |
| Escrituras atómicas + diferencias de prueba | ✅ | — | — | — |
| Costo de configuración | Postgres + Docker | Obsidian + plugin REST | Solo Python | Plugin de Obsidian |
La comparación refleja las características documentadas de cada proyecto en el momento de escribir; verifica los detalles específicos antes de apostar por ellos.
vs. sistemas de memoria alojados
La comparación que importa más, ahora que la mayor parte de mi tráfico de bóveda son agentes en lugar de mí, es contra la memoria como servicio: tu agente llama a una API, el servicio almacena lo que se le dice, y devuelve lo que juzga relevante más tarde. mem0, Zep y Letta son los nombres que la gente suele usar. Lo que sigue trata sobre esa arquitectura — memoria detrás de un límite de servicio — no sobre la lista de características actual de ningún producto, que se mueve más rápido de lo que un README puede rastrear.
La diferencia está en dónde vive la memoria y quién puede abrirla.
- Legibilidad. Cuando la memoria reside detrás de una API de servicio, leerla significa el endpoint o consola que el servicio expone, en la forma que almacene. Aquí la memoria es el artefacto:
Health/2026-08 - Trusting expertise.md, en una carpeta, en tu editor, engrep. No hay brecha entre lo que el agente almacenó y lo que puedes mirar. - Compartida contigo y entre agentes. Un servicio de memoria generalmente está limitado a una aplicación y sus usuarios; la escritura propia del humano es un sistema diferente. Aquí es un solo corpus. Escribo en él a mano, y cada cliente conectado — Claude Desktop, Claude Code, Claude en el teléfono, un flujo de trabajo n8n — lee y escribe los mismos archivos en los mismos términos. Una nota que escribo el domingo es contexto para un agente el lunes sin paso de importación.
- Portabilidad. La ruta de salida de una carpeta de Markdown es
cp -r. Sin formato de exportación, sin script de migración, sin pregunta sobre qué te quedarías si un proyecto dejara de mantenerse. Esa es una propiedad de los archivos, no algo que este servidor haga por ti. - Autodescripción. Las reglas viven en el corpus en lugar de en la configuración del cliente.
CLAUDE.mden la raíz de la bóveda le dice a cada agente, en su primera llamada, dónde van las cosas y qué frontmatter llevan, por lo que las convenciones se versionan junto a las notas que gobiernan.
Lo que la forma alojada te compra a cambio es real, y vale la pena decirlo claramente. No hay Postgres que ejecutar, no hay versión de pgvector que mantener actualizada, no hay contenedor que cuidar — obtienes una capa de memoria añadiendo una dependencia, que es un mejor trato genuinamente para la mayoría de las personas. Y los sistemas de esa clase típicamente hacen trabajo que este servidor deliberadamente no intenta: extraer hechos de una conversación automáticamente, reconciliar los que se contradicen, y puntuar relevancia o decaer memorias antiguas para que no desplacen a las nuevas. Aquí un agente recuerda algo porque decidió escribir una nota, y el juicio sobre lo que vale la pena conservar es del agente, no del servidor. Si quieres memoria que se cure a sí misma, esa es una razón justa para elegir la otra forma.
vs. un agente con acceso a archivos en bruto
La otra línea base no es un servidor MCP en absoluto: apunta Claude Code, un MCP de sistema de archivos genérico, o cualquier agente con herramientas de archivos directamente a la carpeta de la bóveda. Eso funciona — hasta que una escritura sale mal. Un agente que reescribe un archivo completo desde su memoria de una lectura anterior eventualmente sobrescribirá una nota, seguirá un enlace simbólico a donde no debería, o "ordenará" tu configuración de .obsidian. Nada en una API de archivos cruda ofrece resistencia. La ruta de escritura de este servidor está moldeada precisamente por ese tipo de incidente, y asume que el llamador eventualmente hará algo mal:
- Ediciones dirigidas en lugar de reescrituras.
edit_notepuede abordar una cadena de búsqueda o una sección individual en lugar de reemplazar el archivo, ydry_run=Truedevuelve el diff unificado antes de que algo se aplique.set_frontmattermuta YAML estructuralmente y deja el cuerpo byte-idéntico. - Valores predeterminados sin sobrescritura.
create_noteywrite_filese niegan a sobrescribir un archivo existente; reemplazar uno es una opción explícita. - Escrituras atómicas. El contenido se prepara y se renombra en su lugar contra un descriptor abierto en el momento de la validación — una nota nunca queda a medio escribir, y el archivo que se reemplaza es el archivo que se verificó.
- Eliminaciones reversibles.
delete_noteydelete_fileeliminan suavemente en.trash/con un renombrado que no reemplaza;permanent=Truees la vía de escape explícita, no el valor predeterminado. - Contención probada por el kernel. Las rutas se resuelven bajo la raíz de la bóveda mediante
openat2(RESOLVE_BENEATH | RESOLVE_NO_SYMLINKS | RESOLVE_NO_MAGICLINKS), las escrituras rechazan un enlace simbólico como componente final, y los directorios de puntos (.obsidian,.git,.trash) están fuera del alcance de cada herramienta. - Respuestas limitadas. Las lecturas están limitadas y la truncación es datos (
truncated,next_offset, un esquema) en lugar de pérdida silenciosa, para que una nota enorme no pueda inundar el contexto de un agente hacia una mala edición. - Un rastro de auditoría. Cada llamada se atribuye a una clave y se registra; el panel de control muestra quién tocó qué, y cuándo.
Cuando un agente se comporta mal a través de este servidor, obtienes una llamada rechazada, un diff, una entrada de papelera y una línea de registro de uso. Cuando se comporta mal con acceso crudo a archivos, obtienes lo que git diff pueda recuperar — si la bóveda estaba en git en absoluto.
Para quién es esto
- Gente de homelab que ya ejecuta Postgres y Docker, o está feliz de ponerlos en marcha. El impuesto de configuración es el precio de entrada para las capas semánticas y de grafos.
- Personas que mantienen una bóveda con opiniones — lógica de colocación de tareas, esquemas de frontmatter, taxonomía de etiquetas — y quieren que los agentes sigan esas convenciones en la primera llamada en lugar de ser informados cada sesión.
- Cualquiera que ejecute más de un cliente MCP (Claude Desktop, Claude Code, Claude en un navegador, n8n) contra las mismas notas y esté cansado de reexplicar la bóveda a cada uno.
- Personas que quieren que la memoria del agente viva como archivos markdown planos que puedan leer, editar, buscar con grep y controlar versiones, no en un almacén de vectores opaco o un servicio de memoria gestionado.
Para quién no es esto
- "Solo quiero que Claude lea mis notas" con la configuración más ligera posible. Usa uno de los proyectos de pegamento de sistema de archivos anteriores; no necesitas esto.
- Cualquiera que no esté dispuesto a ejecutar una base de datos. No hay alternativa SQLite; pgvector está haciendo trabajo real, y un Postgres gestionado con soporte pgvector es parte de la pila.
- Personas que quieren un producto alojado llave en mano. Este es un servidor autoalojado que tú mismo ejecutas.
Panel de control
El servidor incluye una interfaz de administración integrada para las partes de las operaciones que son más fáciles de ver que de consultar: acuñar claves, vigilar el indexador, revisar el tráfico de llamadas de herramientas y restablecer incrustaciones cuando cambias de proveedor.
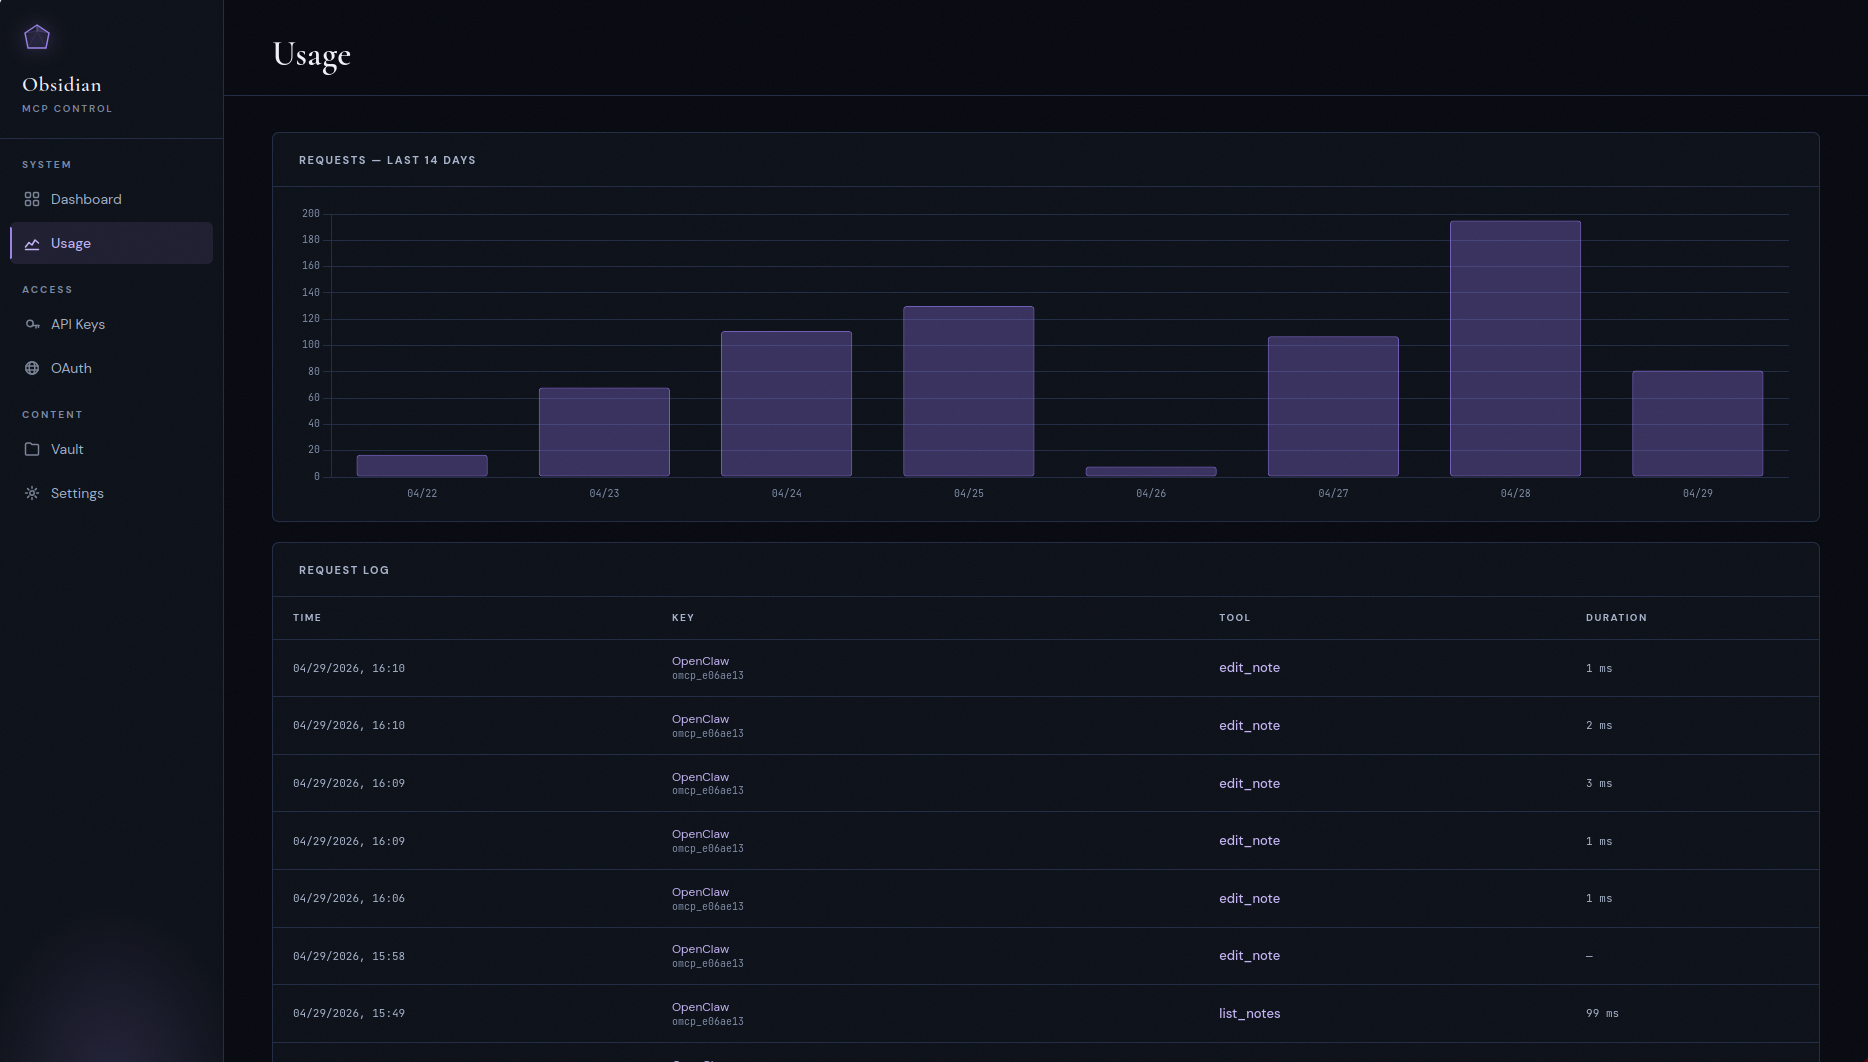
Uso
Registro de auditoría por llamada de herramienta con un histograma de solicitudes de 14 días. Cada llamada MCP se registra con la clave llamante, el nombre de la herramienta, la duración y el tamaño de la respuesta — útil para notar un agente que se comporta mal quemando tokens en algo que no debería.
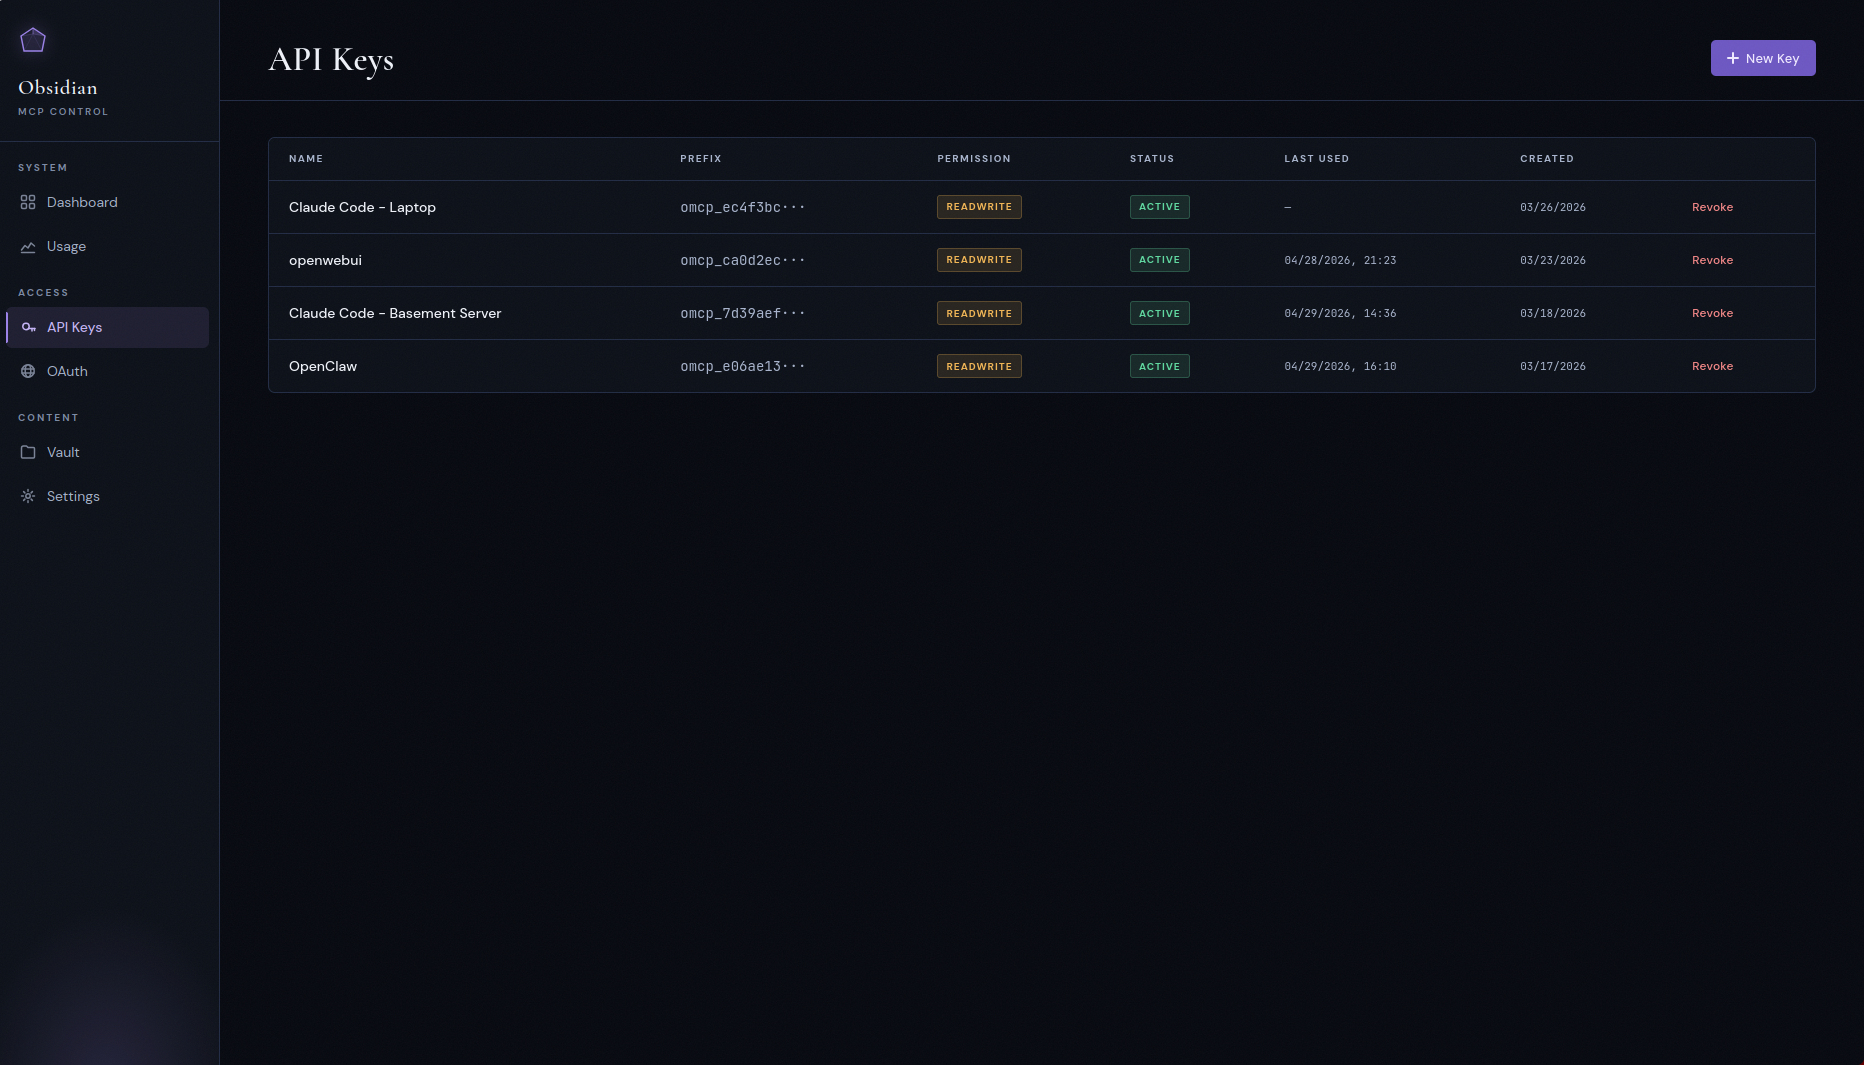
Claves API y clientes OAuth
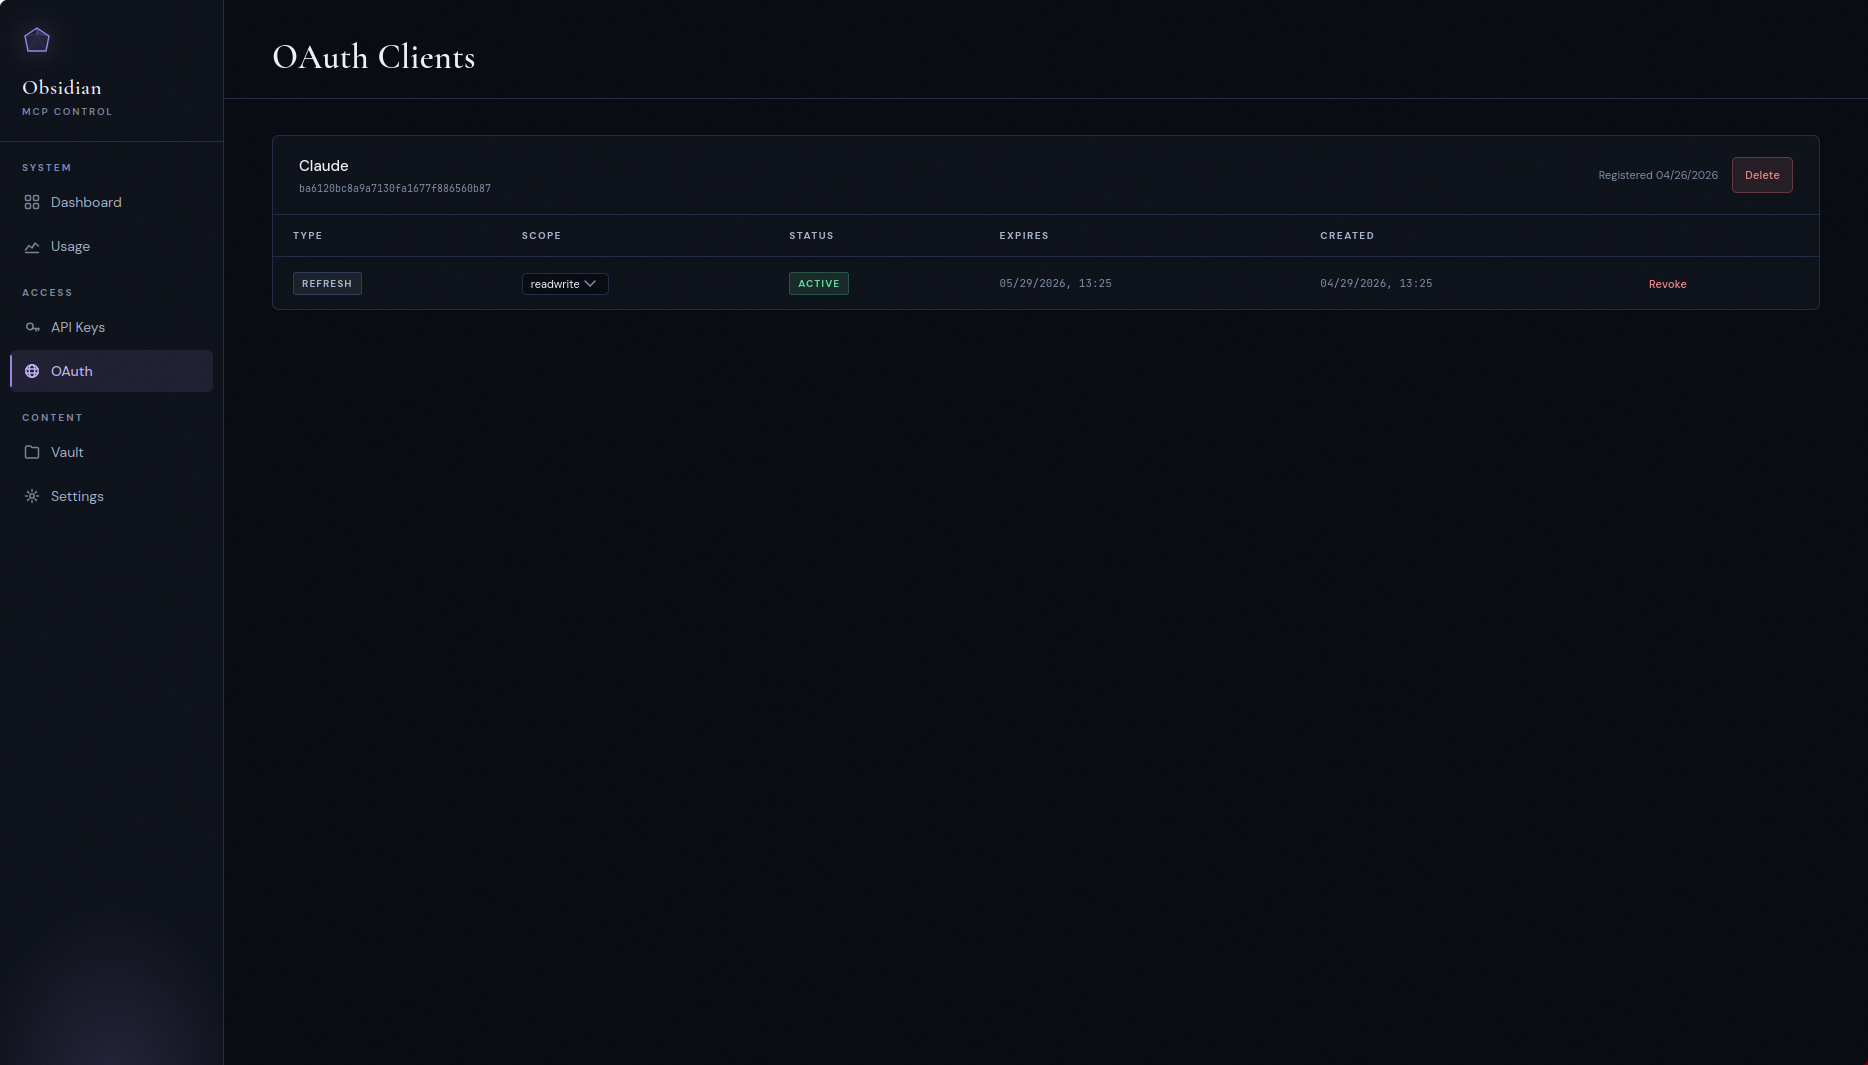
Claves Bearer con ámbitos read / readwrite para clientes API, y un flujo OAuth 2.0 PKCE separado para clientes como ChatGPT, Claude Desktop y claude.ai que esperan un baile de código de autorización adecuado. El servidor OAuth admite autenticación de punto final de token pública (none) y confidencial (client_secret_post) además de tokens de actualización.
La página de cada cliente enumera sus concesiones — una fila por aprobación de /authorize, no por token — con un control de Revocar y un selector de permisos por concesión, de modo que revocar realmente termina la sesión en lugar de dejar un token de actualización para acuñar un reemplazo. Las filas revocadas y expiradas permanecen listadas, atenuadas, durante una semana.
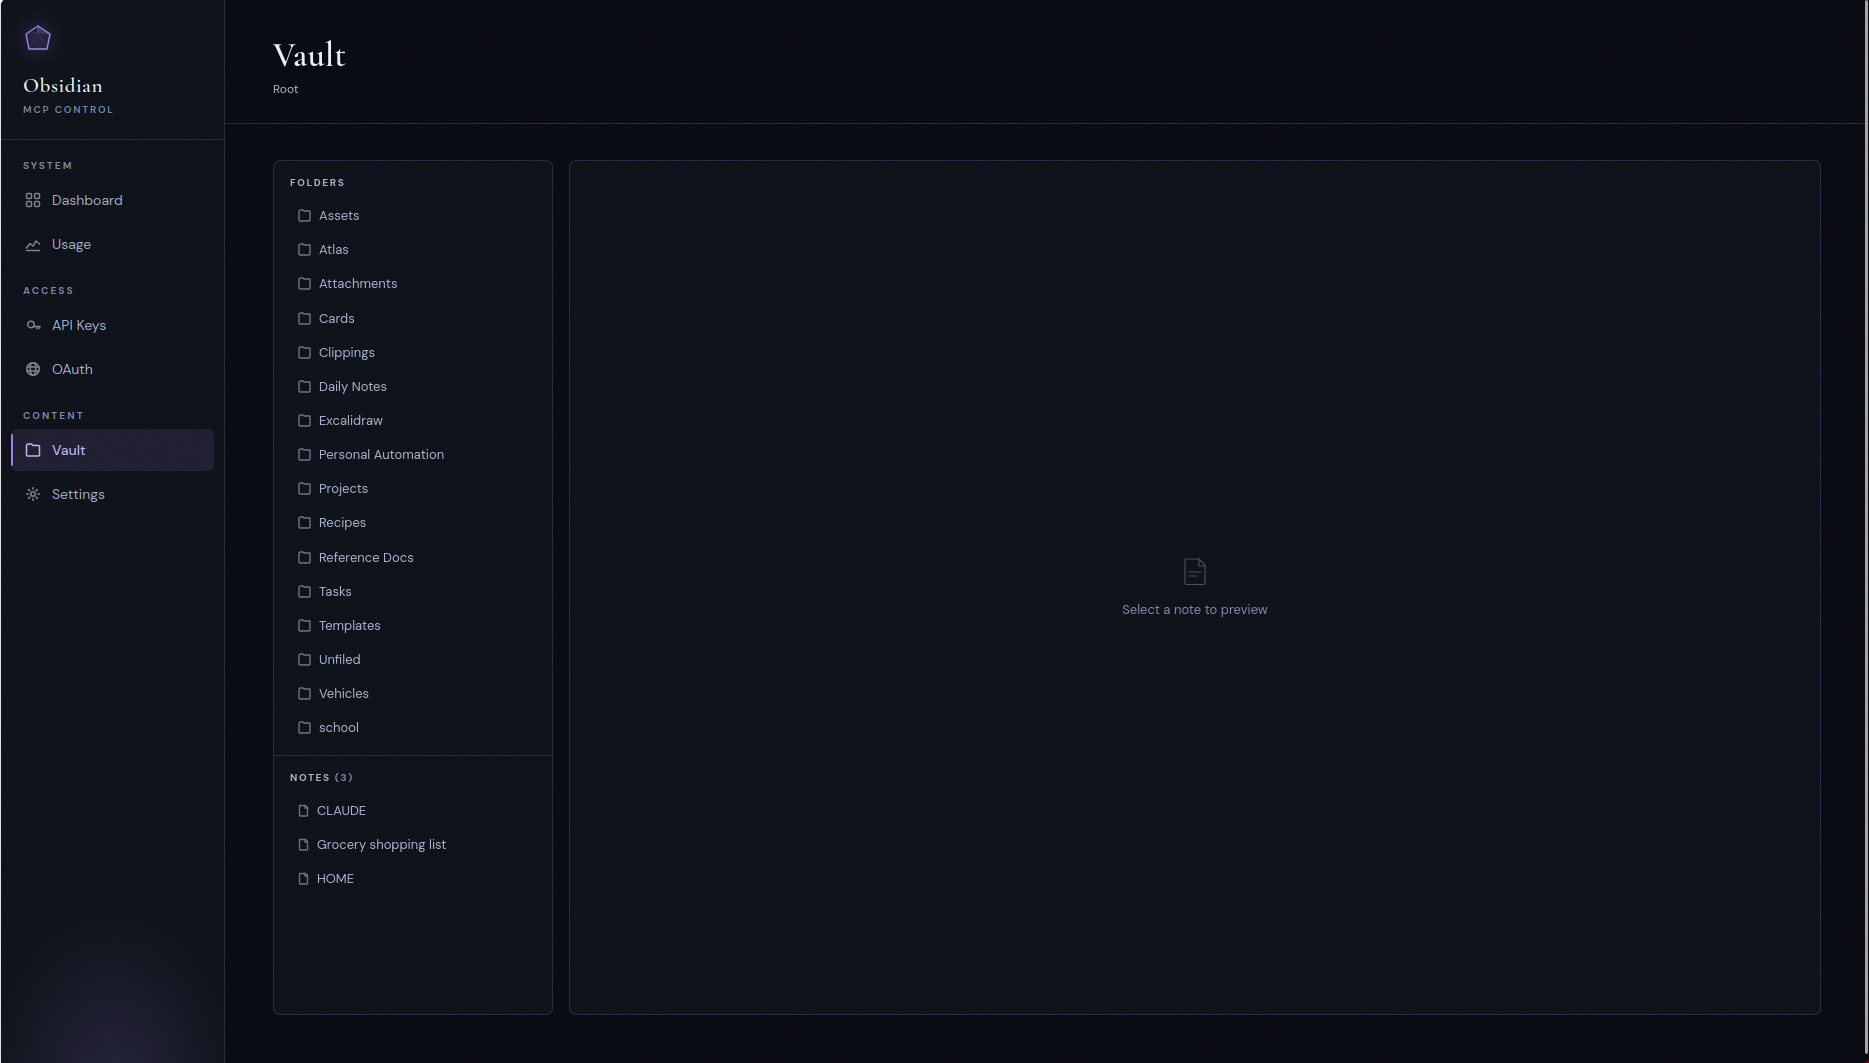
Explorador de bóveda
Un árbol de archivos de solo lectura de la bóveda montada, principalmente para verificar que el contenedor ve lo que crees que ve.
Configuración
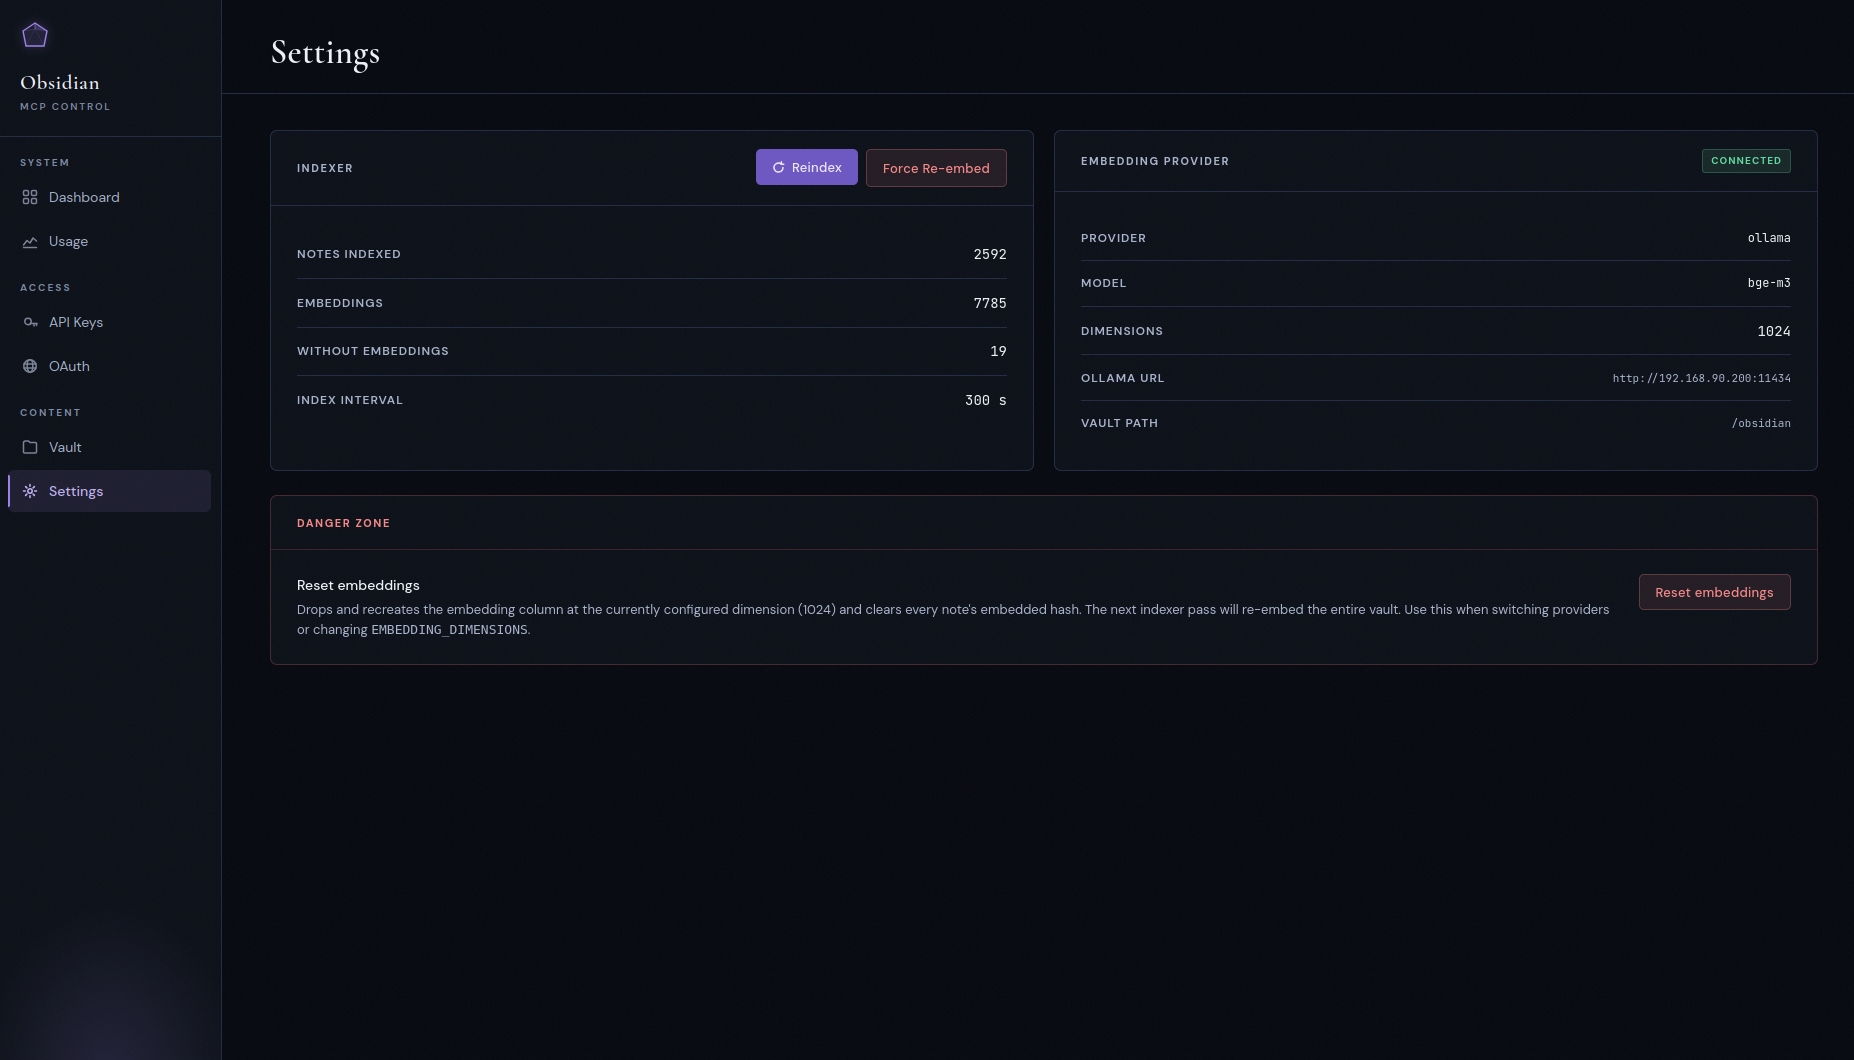
Estado del indexador, proveedor y modelo de incrustación actual, ruta de la bóveda, y la zona de peligro: Restablecer incrustaciones (elimina y recrea la columna de incrustaciones en la dimensión configurada — úsalo al cambiar de proveedor) y Forzar re-incrustación (mantiene la columna, limpia el hash de contenido incrustado de cada nota para que la siguiente pasada re-incruste la bóveda). Ambos pausan el indexador mientras se ejecutan.
El panel separa dos cosas que solían estar confundidas: Última ejecución es el latido del propio indexador — la última pasada que se completó, haya cambiado algo o no — y Último cambio detectado es el indexed_at más reciente en cualquier nota. Una bóveda tranquila hace que el segundo sea antiguo mientras el indexador está perfectamente sano.
Inicio rápido
¿Desplegando en un VPS desde cero? Consulta
DEPLOYMENT.mdpara el tutorial completo: configuración de Postgres, Caddy y TLS, sincronización de bóveda vía Nextcloud, y los problemas que muerden los primeros despliegues. ¿Ejecutando Kubernetes? Consultadocs/deployment-kubernetes.mdy los manifiestos kustomize endeploy/kubernetes/.
La configuración de Caddy incluida falla cerrada en /admin, /api y /authorize; reemplaza su hash de autenticación básica de marcador de posición antes de iniciarlo.
Requisitos previos
- Docker y Docker Compose
- Una instancia de PostgreSQL 16 alcanzable desde el contenedor, con
pgvector0.8.0 o más reciente instalado - O una instancia de Ollama ejecutando
bge-m3, o una clave API de OpenAI. Cualquier cosa que hable el protocolo de incrustaciones de OpenAI funciona (Azure OpenAI, OpenRouter, Together, etc.). - Linux, kernel 5.6 o más reciente (ver abajo)
Requisitos del sistema
El servidor verifica estos al inicio y te dice cuál falló en lugar de comportarse mal más tarde.
Kernel Linux ≥ 5.6. Cada directorio bajo la raíz de la bóveda se abre con un solo openat2(RESOLVE_BENEATH | RESOLVE_NO_SYMLINKS | RESOLVE_NO_MAGICLINKS), que es lo que hace que el kernel — no la aplicación — pruebe que una escritura permaneció dentro de la bóveda. No hay alternativa: en un kernel más antiguo, o bajo un perfil seccomp de contenedor que bloquee openat2, el servidor registra la razón y sale con código no cero.
Kernel ≥ 5.8 para transferencia de archivos. El STATX_MNT_ID de statx() es cómo una publicación rechaza un destino que está en un montaje diferente al directorio de preparación (un montaje bind anidado bajo la raíz de la bóveda fallaría de otro modo solo después de que todo el cuerpo de subida hubiera fluido). Por debajo de 5.8 el servidor registra una advertencia y arranca: request_upload, import_from_url y PUT /transfer/upload se niegan, y todo lo demás — lecturas, escrituras de notas, búsqueda, descargas, el panel, OAuth — no se ve afectado. /health lo reporta como transfer_mount_check_available.
pgvector ≥ 0.8.0. La búsqueda semántica filtrada necesita hnsw.iterative_scan, que llegó en 0.8.0. Una extensión más antigua acepta la configuración como un marcador de posición desconocido y ejecuta silenciosamente un plan que descarta candidatos post-filtro — resultados de búsqueda silenciosamente peores — así que el servidor sale en su lugar. Arréglalo con ALTER EXTENSION vector UPDATE o una imagen de base de datos más nueva.
Sistema de archivos. Sensible a mayúsculas y no normalizador (ext4, xfs, y los montajes bind habituales). Debe admitir enlaces duros dentro de la raíz de la bóveda y renameat2(RENAME_NOREPLACE); sin ellos, la creación de notas, move_note y la eliminación suave se niegan con un error nombrado en lugar de degradarse a una publicación que puede sobrescribir. O_TMPFILE se desea pero es opcional: donde no esté disponible, establece VAULT_ALLOW_NAMED_STAGING_FALLBACK=true para aceptar preparación nombrada en su lugar (ver Configuración). Los hosts macOS y Windows están fuera de alcance; ejecuta el contenedor en una VM Linux.
1. Clonar, configurar, apuntar a tu bóveda
git clone https://github.com/maxkuminov/obsidian-mcp.git
cd obsidian-mcp
cp .env.example .env
$EDITOR .env
En docker-compose.yml, apunta el volumen /obsidian a tu bóveda:
volumes:
  - /path/to/your/vault:/obsidian
2. Elegir un backend de incrustación
Opción A, OpenAI (cero infraestructura local):
EMBEDDING_PROVIDER=openai
OPENAI_API_KEY=sk-...
EMBEDDING_DIMENSIONS=1024
OPENAI_EMBEDDING_MODEL=text-embedding-3-small
El servidor valida OPENAI_API_KEY al inicio y se niega a arrancar si falta.
Opción B, Ollama (autoalojado, GPU recomendada):
EMBEDDING_PROVIDER=ollama
OLLAMA_URL=http://your-ollama-host:11434
EMBEDDING_ALLOW_PLAINTEXT=true
EMBEDDING_MODEL=bge-m3
EMBEDDING_DIMENSIONS=1024
Este es el valor predeterminado. Omitir EMBEDDING_PROVIDER vuelve a Ollama.
La URL de incrustación debe ser https, o http a un host de loopback (localhost, 127.x, ::1). http en texto plano a cualquier otro host — otro contenedor como http://ollama:11434 incluido — se niega a arrancar a menos que EMBEDDING_ALLOW_PLAINTEXT=true reconozca que los fragmentos y las consultas cruzan ese salto sin cifrar. .env.example viene con eso establecido por esa razón; elimínalo una vez que el punto final sea https (usa EMBEDDING_CA_FILE para una CA interna). Dentro de un contenedor, localhost es el propio contenedor, así que un Ollama en el host Docker todavía necesita la anulación.
3. Desplegar
make init       # data dirs and .env from template (skip if you've already edited)
make db-init    # create database, user, and pgvector extension
make deploy     # build, push to local registry, run migrations, recreate container
El primer despliegue rellena el índice, el grafo de wikilinks y las incrustaciones. Para una bóveda de 2 a 3k notas en Ollama con GPU, esto toma unos minutos. En text-embedding-3-small son segundos.
4. Conectar un cliente
Acuña una clave API en el panel de control, luego apunta tu cliente MCP a:
URL:  https://obsidian-mcp.<your-domain>/mcp
Auth: Bearer omcp_...
Para Claude Desktop, agrega a claude_desktop_config.json:
{
  "mcpServers": {
    "obsidian": {
      "url": "https://obsidian-mcp.<your-domain>/mcp",
      "headers": { "Authorization": "Bearer omcp_..." }
    }
  }
}
Para Claude Code:
claude mcp add obsidian --transport http \
  --url "https://obsidian-mcp.<your-domain>/mcp" \
  --header "Authorization: Bearer omcp_..."
Lo primero que cualquier agente debería hacer en una nueva sesión es llamar a get_vault_guide(). Así es como aprende tu estructura de carpetas, convenciones de nombres y esquema YAML antes de escribir nada.
Actualización
Haz pull, luego make deploy (o reconstruye tu pila compose); las migraciones se ejecutan al inicio. Lee esto primero al actualizar a través del lanzamiento de transporte interno y panel-CSP:
- Rompiendo: los puntos finales de incrustación en texto plano deben ser reconocidos. Si la URL de incrustación activa (
OLLAMA_URL, oOPENAI_BASE_URLcon el proveedor OpenAI) eshttp://a un host no loopback — el valor predeterminado dehttp://ollama:11434incluido — agregaEMBEDDING_ALLOW_PLAINTEXT=truea.envantes de desplegar, o el servidor se niega a arrancar con un mensaje que nombra la configuración. - El TLS de la base de datos tiene una sola fuente. Un parámetro TLS en
DATABASE_URL(?ssl=…,?sslmode=…) o cualquier variable de entornoPGSSL*se rechaza al inicio; muévelo aDATABASE_SSL_MODE. El valor predeterminado,prefer, es el comportamiento que tenías antes. - Los clientes de incrustación ignoran la configuración de red del entorno.
HTTP(S)_PROXY,SSL_CERT_FILE/SSL_CERT_DIRy.netrcya no se aplican al salto de incrustación. UsaEMBEDDING_CA_FILEpara una CA interna. - El panel ahora envía una Política de Seguridad de Contenido basada en nonce (
PANEL_CSP=enforce), y htmx ha desaparecido de él. Si un control del panel se comporta mal, establecePANEL_CSP=report-only(ooff) y recrea el contenedor; sin reconstrucción. - Nuevas configuraciones opcionales:
DATABASE_SSL_MODE,DATABASE_SSL_CA_FILE,DATABASE_SSL_CERT_FILE,DATABASE_SSL_KEY_FILE,EMBEDDING_ALLOW_PLAINTEXT,EMBEDDING_CA_FILE,PANEL_CSP. Consulta Configuración, yDEPLOYMENT.mdpara mover ambos saltos a TLS verificado.
Expectativas de costos
Si optas por la vía de OpenAI (el camino realista en un VPS solo con CPU), el gasto del primer índice es pequeño y el estado estable es casi gratis. Cifras aproximadas asumiendo una nota promedio de alrededor de 1.500 tokens (tres fragmentos de 512 tokens), a la tarifa publicada de OpenAI al momento de escribir:
| Modelo | $/1M tokens | 1k notas | 10k notas | 100k notas |
|---|---|---|---|---|
text-embedding-3-small | $0.02 | ~$0.05 | ~$0.50 | ~$5.00 |
text-embedding-3-large | $0.13 | ~$0.30 | ~$3.00 | ~$30.00 |
Después del primer índice, solo las notas modificadas se vuelven a incrustar. El costo continuo es proporcional a las ediciones: centavos al mes para una bóveda típica.
Si autoalojas Ollama con una GPU, el costo de incrustación es lo que sea tu factura de electricidad. Ollama en CPU funciona pero es demasiado lento para ser utilizable en una bóveda de más de unos pocos cientos de notas.
La bóveda autodescriptiva
Esta es la parte que la mayoría de los proyectos "MCP para Obsidian" pasan por alto. Se detienen en leer, escribir y listar. La pregunta interesante no es "¿puede el agente acceder a los archivos?", sino "¿conoce el agente las reglas?"
Si tienes una bóveda con opiniones definidas — lógica de colocación de tareas, convenciones de carpetas, frontmatter requerido, taxonomía de etiquetas — un agente con acceso de escritura puede causar daños reales sin ese contexto. Las tareas terminan en la carpeta equivocada. Los nombres de archivo con fecha desnuda chocan con las plantillas. Las etiquetas incorrectas rompen las consultas de Dataview. La capa de datos funciona bien; la capa de contexto es donde aparecen los fallos.
La solución es pequeña. Mantén un archivo de instrucciones legible por máquina
(CLAUDE.md en la raíz de la bóveda) que describa las reglas del propio sistema.
Exponlo como una herramienta dedicada. Cada agente conectado lo llama una vez al
inicio de una sesión e inmediatamente sabe cómo funciona la bóveda.
Actualiza el archivo, cada agente ve el cambio en la siguiente llamada. Sin
configuración del lado del cliente. Sin inyección en el prompt del sistema. La bóveda es
autoritativa sobre sus propias reglas.
get_vault_guide() hace exactamente esto. Devuelve una introducción genérica a Obsidian
(sintaxis de wikilinks, sintaxis de incrustación, convenciones de etiquetas, literales comunes
de plugins) más el CLAUDE.md de la bóveda en vivo. La sugerencia de llamarlo primero
está integrada en las descripciones de las herramientas de escritura para que el agente se vea
llevado al comportamiento correcto incluso sin indicaciones.
Modo multiusuario
El modo de usuario único es el predeterminado y funciona exactamente como se describió anteriormente: una bóveda, un conjunto de claves API, sin concepto de usuario en la aplicación. El modo multiusuario es una bandera opcional que convierte el mismo contenedor en una pequeña implementación multiinquilino: inicio de sesión con nombre de usuario/contraseña en la aplicación, alcance de bóveda por usuario, un rol de administrador para solución de problemas y un rol de usuario regular que ve solo sus propias claves/clientes OAuth/uso. Un contenedor, un Postgres, aislamiento estricto entre usuarios.
Actívalo en una implementación existente sin pérdida de datos: tu bóveda actual y tus claves se transfieren al administrador de arranque.
Habilitación
- Establece
MULTI_USER_MODE=truey unaSECRET_KEYfuerte en.env(openssl rand -hex 32está bien). La aplicación se niega a iniciar con unSECRET_KEYde marcador de posición incondicionalmente — incluido el modo de usuario único — así que esto no es algo que la bandera active. make deploy(odocker compose up -d --force-recreate).- Visita el panel. Debido a que la tabla
usersestá vacía, se te enruta a/admin/register— el formulario de arranque de una sola vez. Sigue detrás del middlewarechain-oauth@filede Traefik, por lo que solo las personas que Traefik ya confía pueden reclamar la administración. - Regístrate con un nombre de usuario y contraseña elegidos. El formulario de arranque
pre-rellena
vault_pathcon lo queVAULT_PATHse haya establecido, por lo que tus notas existentes pertenecen inmediatamente a este nuevo administrador. Sin re-indexación, sin re-incrustación, sin pérdida de datos: cada nota previamente indexada, clave API, cliente OAuth y fila de registro de uso se rellena al usuario de arranque en una sola transacción.
Invitando usuarios
-
Edita
docker-compose.ymlpara agregar un montaje de volumen para la bóveda del nuevo usuario bajo/vaults/<username>. Las rutas de host con espacios deben citarse como una sola cadena YAML:volumes: - "/storage/vaults/alice:/vaults/alice" - "/storage/shared/bob/Obsidian:/vaults/bob"make deploypara aplicar. -
En el panel,
/admin/users/create— elige un nombre de usuario y establece una contraseña inicial. -
/admin/users/{id}/edit— establece elvault_pathdel usuario a la ruta del contenedor que acabas de montar (por ejemplo,/vaults/bob). El formulario muestra un menú desplegable de directorios/vaults/*no asignados que existen en el disco. -
Comparte las credenciales fuera de banda. El usuario inicia sesión en
/admin/auth/login, obtiene sus propias vistas de claves/OAuth/uso, y no puede ver las notas de otros usuarios.
Lo que ven los administradores
Los administradores ven claves API, clientes OAuth y registros de uso de todos los usuarios; ellos
poseen la página de Configuración (proveedor de incrustación, disparador del indexador, zona
de peligro) y la página de Usuarios. Los administradores no navegan por el contenido de las bóvedas
de otros usuarios a través del panel — eso es intencional. Solucionar problemas
de la bóveda de otro usuario significa inspeccionarla a través de docker exec o
reasignar temporalmente su vault_path, no espiar a través de la interfaz.
Reversión
Establece MULTI_USER_MODE=false, reinicia. Las claves API existentes siguen funcionando
(los filtros por usuario se omiten cuando no se establece contexto de usuario), la interfaz de inicio de
sesión y las cookies de sesión desaparecen, y el panel vuelve a su
modo solo-OAuth de Traefik. El esquema permanece en su lugar, por lo que volver
al modo multiusuario más tarde se reanuda donde lo dejaste sin re-arrancar
(la tabla users no está vacía, por lo que /admin/register está cerrado).
Restricciones y límites conocidos
- El indexador itera sobre los usuarios activos secuencialmente en cada ciclo. Está bien para decenas de usuarios; cientos necesitarían paralelización.
- La recuperación de contraseña es impulsada por el administrador — no hay restablecimiento
basado en correo electrónico. Un usuario con sesión iniciada puede rotar su propia contraseña en
/admin/account(contraseña actual, nueva contraseña, confirmación; mínimo 12 caracteres), lo que cierra sesión en sus otros navegadores y mantiene el que usó para cambiarla con sesión iniciada. El restablecimiento del administrador sigue siendo la ruta de recuperación para alguien que no puede iniciar sesión en absoluto, y también termina cada sesión en vivo de la cuenta que restablece. /admin/auth/loginy/admin/account/passwordtienen límite de velocidad de 5 solicitudes por minuto; el límite de inicio de sesión está vinculado a la dirección del cliente, y el cambio de contraseña lleva dos límites independientes: uno por cuenta, uno por dirección. El almacenamiento del limitador está en memoria y es por proceso, por lo que los contadores se restablecen al reiniciar. La puerta OAuth de Traefik frente al panel sigue siendo la principal defensa contra fuerza bruta; si expones/admin/auth/logina internet abierto, coloca un middleware de límite de velocidad frente a él también.- Las sesiones del panel son filas del lado del servidor (
user_sessions), por lo que cerrar sesión, cambiar una contraseña, una desactivación o una eliminación realmente las termina. La compensación: el primer despliegue de la compilación que introdujo el registro cierra sesión una vez a cada sesión de panel en vivo, porque una cookie emitida antes no lleva ID de sesión y se rechaza en lugar de heredarse. Todos inician sesión de nuevo; nada más cambia. - El validador
vault_pathno resuelve enlaces simbólicos, por lo que un administrador técnicamente puede apuntar a un usuario a archivos del host a través de un/vaults/<name>con enlace simbólico. Trata/vaults/como un límite de confianza del administrador. Lo que sí se verifica, desde la protección de superposición de raíces de bóveda: las raíces de dos usuarios activos no pueden nombrar directorios superpuestos. Cada raíz se abre una vez y se compara por identidad de inodo —(st_dev, st_ino), que detecta un alias de enlace simbólico o un montaje bind que nombra un directorio dos veces — y por una prueba de contención componente a componente sobre las dos rutas reales canónicas en ambas direcciones, que detecta un par ancestro/descendiente como/vaults/teamy/vaults/team/private. Una asignación conflictiva se rechaza en el panel nombrando al otro usuario, y las mismas verificaciones se vuelven a ejecutar antes de cada pasada de indexación, por lo que un alias creado después de la asignación pone en cuarentena ambas cuentas: sus herramientas MCP, pasadas de indexación y canjes de transferencia se rechazan hasta que un administrador lo corrija, y no se eliminan filas de índice. Una raíz que no se puede abrir en absoluto pone en cuarentena solo su propia cuenta. Lo que aún no se detecta, y la consecuencia: un montaje bind que injerta la bóveda de un usuario — o cualquier montaje anidado dentro de ella — a una ruta dentro de la raíz de otro usuario.mount --bind /vaults/b /vaults/a/innerdeja ambos inodos de raíz distintos y ambas rutas canónicas fuera de cada uno, por lo que ninguna verificación lo ve, y el usuario A puede entonces leer, sobrescribir y eliminar cada nota en la bóveda del usuario B a través de las herramientas de escritura ordinarias, mientras que la pasada de indexación de A archiva las notas de B bajo la cuenta de A, por lo que las búsquedas de A devuelven el contenido de B. La misma brecha cubre un alias accesible de una raíz que no pudo examinarse: ese par sigue sirviendo. Ninguna condición se informa en ningún lugar. Ambas requieren que un administrador escriba un montaje bind en la configuración de despliegue — por eso/vaults/y los montajes del archivo compose son el límite de confianza del administrador, no solo las cadenas de ruta. Este es un límite permanente y declarado en lugar de una corrección pendiente: la detección de montajes se especificó, falló en una nueva topología en cada una de las tres rondas de revisión, y se descartó. La regla del operador: nunca montes el directorio de un usuario, ni nada anidado en él, dentro de la raíz de otro usuario.
Configuración
| Variable | Predeterminado | Propósito |
|---|---|---|
DATABASE_URL | — | postgresql+asyncpg://user:pass@host/db. No hay parámetros TLS aquí — se rechazan; use DATABASE_SSL_MODE. |
DATABASE_SSL_MODE | prefer | TLS de base de datos: disable, prefer (intenta TLS, retrocede a texto plano), require (cifrar, sin verificación), verify-ca, verify-full. Los modos estrictos salen si la sesión no está cifrada. Cualquier variable PGSSL* se rechaza. |
DATABASE_SSL_CA_FILE | — | Paquete de CA (PEM) para verify-ca / verify-full; requerido por ambos, rechazado con cualquier otro modo. Sin respaldo del almacén del sistema. |
DATABASE_SSL_CERT_FILE | — | Certificado de cliente (PEM). Solo modos estrictos (require, verify-ca, verify-full); configúrelo junto con DATABASE_SSL_KEY_FILE o no lo configure. |
DATABASE_SSL_KEY_FILE | — | Clave privada del cliente para DATABASE_SSL_CERT_FILE. Ambos o ninguno. |
VAULT_PATH | /obsidian | Montaje de la bóveda dentro del contenedor |
SECRET_KEY | — | Clave de firmante de itsdangerous |
INDEX_INTERVAL_SECONDS | 300 | Cadencia de reindexación periódica |
INDEXER_DEGRADED_AFTER_FAILURES | 3 | Fallos consecutivos de cualquier contador de indexador (el índice de un ámbito pasa, su inserción pasa, su re-derivación incompleta, o la enumeración de usuarios del propio tick) en los que /health informa degraded y se registra una línea CRITICAL de "se requiere intervención manual". |
INDEXER_QUARANTINE_RETRIES_PER_TICK | 5 | Cuántas veces una pasada de índice puede retroceder y volver a ejecutar un ámbito después de poner en cuarentena una nota que la base de datos rechaza (un error de excepción de datos o límite de programa en su fila, vector de palabras clave, movimiento o enlaces). Más allá de eso, la pasada falla como un fallo ordinario; las notas ya encontradas permanecen en cuarentena para el siguiente tick. |
MULTI_USER_MODE | false | Inicio de sesión en la aplicación, bóvedas por usuario. Ver Modo multiusuario. |
VAULT_ROOT_OBSERVE_TIMEOUT_SECONDS | 10 | Cuánto tiempo espera la verificación de superposición de raíz de bóveda en una raíz antes de abandonarla. La expiración pone en cuarentena esa única cuenta (root unexaminable) y la verificación continúa, por lo que un montaje colgado no puede retener el inicio. Solo modo multiusuario. |
MCP_HOSTNAME | — | Nombre de host público. Deriva BASE_URL, ALLOWED_ORIGINS y ALLOWED_HOSTS como https://<host>. Requerido (o BASE_URL) para las herramientas de transferencia. |
BASE_URL | derivado | Origen público explícito. HTTPS excepto en loopback. |
ALLOWED_ORIGINS | derivado | Orígenes CORS, lista JSON |
ALLOWED_HOSTS | derivado | Cabeceras Host aceptadas, lista JSON. localhost siempre se añade. |
SESSION_MAX_AGE | 604800 | Vida útil de la sesión del panel, segundos (modo multiusuario). Absoluta — la fila del lado del servidor nunca se extiende, por lo que una sesión usada a diario aún expira |
SESSION_COOKIE_NAME | omcp_session | Nombre de la cookie de sesión del panel |
PANEL_CSP | enforce | Content-Security-Policy en el panel, páginas de inicio de sesión y consentimiento: enforce, report-only (misma política, solo informes), o off. Una palanca de reversión — cámbiela y recree el contenedor, sin reconstrucción. Cualquier cosa que no sea enforce registra un WARNING en cada inicio. |
SESSION_TOUCH_INTERVAL_SECONDS | 60 | Cuán obsoleto puede estar el last_seen_at de una sesión antes de que un GET/HEAD validado lo reescriba. Solo telemetría — nada se autoriza con él. Debe ser ≥ 1. |
SESSION_PURGE_RETAIN_DAYS | 7 | Cuánto tiempo se conserva una fila de sesión de panel muerta, medido desde el posterior de su expiración y su revocación, para que una revocación permanezca visible durante toda la ventana. Debe ser ≥ 1. |
OAUTH_KNOWN_REDIRECT_HOSTS | claude.ai,chatgpt.com | Hosts de redirección que la pantalla de consentimiento muestra como destinos de conector conocidos. JSON o CSV. Coincidencia por igualdad exacta de host — sin comodines, sin sufijos; las entradas que contengan *, /, @ o espacios internos se rechazan al inicio. Una lista vacía significa que cada cliente se muestra como no verificado. |
MAX_FILE_READ_BYTES | 10485760 | Límite de read_file (10 MB); limita lo que el servidor lee del disco |
MAX_FILE_WRITE_BYTES | 26214400 | Límite de write_file (25 MB), longitud de bytes decodificada |
MAX_READ_RESPONSE_CHARS | 40000 | Límite de read_note / read_file en lo que se devuelve al llamador (≈10K tokens). Ver Límites de tamaño de respuesta. |
FTS_CONFIGS | english | Configuración(es) de búsqueda de texto para búsqueda de palabras clave. JSON o CSV. Ver Idioma(s) de búsqueda de texto completo. |
TRANSFER_TOKEN_TTL_SECONDS | 600 | Vida útil predeterminada de un enlace de transferencia. El expires_in por llamada se limita a 60–3600. |
TRANSFER_MAX_UPLOAD_SECONDS | 600 | Cuánto tiempo puede transmitir una subida reclamada antes de que el token se gaste |
TRANSFER_MAX_CONCURRENT_UPLOADS | 4 | Transmisiones de subida simultáneas |
IMPORT_ALLOW_HTTP | false | Permitir que import_from_url obtenga http plano. Desactivado por defecto. |
VAULT_ALLOW_NAMED_STAGING_FALLBACK | false | Aceptar staging nombrado en sistemas de archivos sin O_TMPFILE. Una bandera, ambas rutas de escritura. Ver Requisitos del sistema. |
WRITE_PRECONDITION_REQUIRED | false | Requerir expected_hash en llamadas destructivas compatibles. La creación está exenta; habilite después de que los clientes adopten hashes de lectura. |
EMBEDDING_PROVIDER | ollama | ollama o openai |
EMBEDDING_DIMENSIONS | 1024 | Ancho de columna pgvector |
OLLAMA_URL | http://ollama:11434 | Usado cuando el proveedor es Ollama. Debe ser https, loopback http, o cubierto por EMBEDDING_ALLOW_PLAINTEXT. |
EMBEDDING_MODEL | bge-m3 | Nombre del modelo Ollama. Cambiarlo después del despliegue requiere make reset-embeddings; el servidor se niega a iniciar hasta que los vectores almacenados coincidan. Ver Cambiar proveedores o modelos. |
OLLAMA_KEEP_ALIVE | -1 | Cuánto tiempo mantiene Ollama el modelo residente. -1 lo fija; una duración Go (30m) libera VRAM cuando está inactivo. Solo Ollama. |
OPENAI_API_KEY | — | Requerido cuando el proveedor es OpenAI |
OPENAI_BASE_URL | https://api.openai.com/v1 | Anulación para Azure o proxies. Misma regla de transporte que OLLAMA_URL cuando este proveedor está activo. |
EMBEDDING_ALLOW_PLAINTEXT | false | Permitir http a un host de inserción no loopback. Sin él, tal URL se niega a iniciar. .env.example lo establece true para coincidir con su http://ollama:11434 predeterminado. |
EMBEDDING_CA_FILE | — | Ancla de confianza (PEM) para un endpoint de inserción https detrás de una CA interna; reemplaza el paquete certifi predeterminado. Rechazado con una URL http. Los clientes de inserción ignoran HTTP(S)_PROXY, SSL_CERT_* y .netrc. |
OPENAI_EMBEDDING_MODEL | text-embedding-3-small | Modelo OpenAI. Cambiarlo después del despliegue requiere make reset-embeddings; el servidor se niega a iniciar hasta que los vectores almacenados coincidan. Ver Cambiar proveedores o modelos. |
CHUNK_SIZE | 512 | Aprox. tokens por fragmento (heurística de 4 caracteres) |
CHUNK_OVERLAP | 0 | Superposición de tokens entre fragmentos |
EMBEDDING_EXCLUDE_PATTERNS | ["*.excalidraw.md","Excalidraw/*"] | Globs omitidos por el insertador. Los archivos excluidos permanecen buscables por palabras clave. |
MCP_AUTH_FAILURE_LIMIT | 60 | Autenticaciones /mcp fallidas que una dirección de cliente puede hacer por ventana antes de un 429. Verificado antes de la búsqueda de credenciales, por lo que una sonda rechazada no cuesta consulta. Null lo desactiva. Ver Límites de tasa. |
MCP_AUTH_FAILURE_WINDOW_SECONDS | 300 | La ventana sobre la que se cuenta ese presupuesto. |
MCP_AUTH_FAILURE_TABLE_SIZE | 4096 | Ranuras de contador en la tabla de direcciones de tamaño fijo, salada por proceso. La memoria es O(tamaño); las colisiones solo hacen el control más estricto. |
MCP_RATE_LIMIT_PER_MINUTE | 120 | Llamadas de herramienta sostenidas por minuto por principal (una clave API, o una concesión OAuth). Null — con la ráfaga — desactiva el cubo general. |
MCP_RATE_LIMIT_BURST | 30 | Capacidad del cubo general. Debe configurarse junto con su tasa o anularse junto con ella. |
MCP_WRITE_RATE_LIMIT_PER_MINUTE | 60 | Llamadas sostenidas de mutación de bóveda por minuto por principal — las ocho herramientas de escritura, más PUT /transfer/upload cargado al principal que acuñó la capacidad. |
MCP_WRITE_RATE_LIMIT_BURST | 15 | Capacidad del cubo de escritura. |
MCP_LIMITER_MAX_TRACKED_PRINCIPALS | 10000 | Principales que mantienen su propia entrada de limitador antes de que más compartan una entrada de desbordamiento. |
MCP_REFUSAL_LOG_INTERVAL_SECONDS | 10 | Cuánto tiempo permanece abierta una ventana de coalescencia de rechazo de tasa/ranura. Dentro de ella un rechazo no escribe nada; la fila que aterriza representa 1 + suppressed rechazos. |
MCP_CONCURRENCY_MODE | shadow | off, shadow, o enforce. Shadow observa presión sin rechazar o esperar. Ver Admisión de concurrencia. |
MCP_CONCURRENCY_WAIT_SECONDS | 0 | Espera de admisión de herramienta en modo enforce, 0–5 segundos. Shadow requiere cero. |
MCP_CONCURRENCY_TOOLS | 4 | Techo global de herramientas en modo enforce, también sujeto a techos de clase, tenant (3) y principal (2). |
MCP_CONCURRENCY_REQUESTS | 32 | Techo de solicitud MCP completo, incluyendo flujos abiertos; el techo por huella de portador predeterminado es 4. |
MCP_CONCURRENCY_AUTH | 2 | Techo de sesión de base de datos de autenticación. Liberado antes de la entrega de respuesta o trabajo posterior. |
MCP_CONCURRENCY_WRITERS | 1 | Techo de escritor de registro de uso; incluye inserciones de respaldo. Predeterminados: 64 escritores pendientes y una espera de modo enforce de 0.25 segundos. |
DEFAULT_DAILY_REQUEST_LIMIT | 5000 | Cuota diaria que una clave API recién creada recibe cuando el llamador no dice lo contrario. Las claves existentes no se tocan; un null explícito (o un campo de panel en blanco) aún significa ilimitado. |
MCP_REJECT_UNKNOWN_ARGUMENTS | true | Rechazar una llamada de herramienta que lleva un argumento que la herramienta no declara (un error de herramienta nombrándolo), y publicar additionalProperties: false en cada esquema de entrada. false restaura la ignorancia silenciosa del SDK — una reversión para un cliente que envía extras; cámbielo y recree el contenedor. false registra un WARNING en cada inicio. |
MCP_SANDBOX_MODE | false | Solo evaluación de registro. Omite DB, indexador, proveedor de inserción y autenticación /mcp para que la introspección funcione sin dependencias externas. No lo habilite en producción. |
Ver .env.example para el conjunto completo con comentarios. Para el
gasto del primer índice en OpenAI, ver Expectativas de costo arriba.
El límite del cuerpo de solicitud del transporte MCP es derivado, no configurado:
max(2 × MAX_FILE_WRITE_BYTES, 6 × 10 MB) + 1 MiB, que es 61 MiB con
los predeterminados. Tiene que rastrear los límites de escritura para que cada
escritura compatible sea rechazada por la herramienta — con un mensaje accionable — en lugar de
por el transporte con un HTTP 413 desnudo. Aumente MAX_FILE_WRITE_BYTES y
el límite del transporte lo sigue.
Cambiar proveedores o modelos
Diferentes modelos producen vectores en diferentes espacios, y la distancia coseno entre dos espacios no tiene sentido. Así que cualquier cambio en lo que produjo los vectores almacenados requiere una re-inserción completa — no solo un cambio de proveedor. Eso es cada uno de:
EMBEDDING_PROVIDEREMBEDDING_MODEL(Ollama) oOPENAI_EMBEDDING_MODEL(OpenAI) — incluyendo un intercambio entre dos modelos de la misma dimensión, que la guardia de dimensión no puede verEMBEDDING_DIMENSIONSCHUNK_SIZEyCHUNK_OVERLAP
El servidor almacena una huella de esa configuración y la compara en el inicio. En un desajuste registra ambas huellas y los campos que difieren, nombra la reparación y sale con código no cero — por lo que un intercambio de modelo que solía mezclar dos espacios vectoriales en una columna silenciosamente, para siempre, ahora detiene el proceso en su lugar.
Los pasos, en este orden:
- Actualiza
.env. make deploy(odocker compose up -d --force-recreate). El nuevo contenedor se negará a iniciar — en la guarda de huella digital, o en la guarda de dimensiones si el ancho cambió — y esa negativa es el punto: un contenedor que no inicia no incrusta nada mientras se ejecuta el reinicio.make reset-embeddingsmientras está detenido. El objetivo esdocker compose run --rm, por lo que inicia un contenedor único que lee tu.enveditado: recrea la columna en la nueva dimensión, limpia cadaembedded_content_hash, y registra la nueva huella digital en la misma transacción.- Reinicia el servicio. Inicia silenciosamente, porque las filas almacenadas realmente se produjeron bajo la configuración con la que ahora se ejecuta, y el siguiente paso del indexador vuelve a incrustar la bóveda.
Esto invierte el consejo anterior de reiniciar antes de recrear. Ese orden
era seguro solo mientras nada dependiera de una afirmación almacenada sobre la
configuración; ahora el reinicio es lo que escribe esa afirmación, por lo que
debe ejecutarse con el nuevo .env en su lugar y sin que un contenedor
de configuración antigua pueda incrustar contra él. Omitir un paso cuesta tiempo
en lugar de corrección — un bloqueo de generación a nivel de base de datos hace
que las certificaciones de un contenedor de configuración antigua se rechacen en
lugar de aterrizar — pero el orden anterior es el que nunca tiene que depender de ello.
El mantenimiento espera a que pase un paso de indexación en curso. Ese mismo
bloqueo de generación se toma al inicio de la transacción del paso de indexación y
se mantiene hasta que se confirma, por lo que make reset-embeddings y make rebuild-tsvectors se
bloquean hasta que el paso termine — hasta unos minutos en una bóveda grande — en
lugar de intercalarse con él. Esa espera es el comportamiento requerido, no un
estancamiento que haya que evitar: un reinicio que aterriza a mitad del paso es
precisamente la intercalación que almacena vectores de una configuración bajo una
huella digital que nombra otra. Ningún comando establece un tiempo de espera de
bloqueo corto, y a ninguno se le debe dar uno — y debido a que el servidor
establece un statement_timeout de 60 segundos en cada conexión, ambos comandos (y
los reinicios de la Zona de peligro del panel) elevan ese tiempo de espera para la
adquisición en sí y lo restauran una vez que el bloqueo es suyo. Sin eso, un
comando iniciado contra un servicio en vivo se cancelaba después de un minuto en
lugar de esperar, lo que se lee como un comando roto en lugar de un índice ocupado.
También puedes usar Configuración → Zona de peligro → Reiniciar incrustaciones en el panel de control, que realiza el mismo SQL — incluido el registro de huella digital — mientras el servidor está en ejecución (pausa el indexador, ejecuta el SQL, reanuda).
La huella digital registra la configuración, no el artefacto del modelo.
bge-m3es una etiqueta mutable de Ollama, por lo queollama pullpuede reemplazar los pesos detrás de ella, yOLLAMA_URL/OPENAI_BASE_URLestán deliberadamente excluidos de la huella digital — apuntar a otro host o proxy suele ser un movimiento de infraestructura que sirve el artefacto idéntico, e incluirlo exigiría una reincrustación completa para uno. La consecuencia es una limitación aceptada: reemplazar el artefacto detrás de un nombre de modelo sin cambios — volver a extraer una etiqueta, o apuntar a un host que sirve pesos diferentes bajo el mismo nombre — mezcla espacios vectoriales sin detectar. Requieremake reset-embeddings, y ninguna verificación de inicio lo detectará si lo omites. Ningún valor disponible para el servidor distingue los dos casos, y una sonda tendría que confiar en el endpoint que está verificando.
Idioma(s) de búsqueda de texto completo
keyword_search se ejecuta sobre un tsvector de PostgreSQL. La configuración
de búsqueda de texto que utiliza — el derivador y el diccionario de palabras vacías — está
controlada por FTS_CONFIGS. Su valor predeterminado es english, que reproduce
el comportamiento histórico exactamente, por lo que las implementaciones existentes no necesitan ninguna acción.
FTS_CONFIGS es una lista, configurable como JSON
(FTS_CONFIGS=["simple","norwegian"]) o separada por comas
(FTS_CONFIGS=simple,norwegian). Cada nota se indexa bajo cada
configuración listada, y una consulta coincide si el análisis de cualquier configuración
listada acierta. Esto es lo que hace que funcione una bóveda de idiomas mixtos:
FTS_CONFIGS | Comportamiento |
|---|---|
english | Derivador Snowball en inglés (predeterminado; running ↔ run). |
simple | Agnóstico al idioma. Sin derivación ni palabras vacías — coincide con formas exactas de palabras. Un valor predeterminado con principios para bóvedas de idiomas mixtos: la búsqueda por palabras clave es el brazo de coincidencia exacta, mientras que semantic_search (bge-m3 es multilingüe) maneja el recuerdo morfológico. |
english,norwegian | Ambos derivadores aplicados — morfología del lado de palabras clave para dos idiomas a la vez. |
simple,norwegian | Lexemas literales más derivaciones en noruego. |
La configuración es global — se aplica a cada bóveda (coherente con
EMBEDDING_MODEL, CHUNK_SIZE, etc., que también son globales). Para una
instancia multiusuario de idiomas mixtos, establece un superconjunto (p. ej.
["english","norwegian"], o ["simple"]). La configuración de FTS por usuario es una
extensión futura limpia pero no está implementada.
Un nombre de configuración mal escrito o no instalado falla rápidamente al inicio con un mensaje que enumera las configuraciones disponibles en tu instancia de Postgres, en lugar de producir búsquedas silenciosas con cero resultados.
Cambiar FTS_CONFIGS requiere una reconstrucción, y el servidor se niega a
iniciar hasta que se haya ejecutado. Los tsvectors almacenados se calculan en el
momento de la indexación, por lo que se vuelven obsoletos cuando cambia la lista de
configuraciones — y un derivador obsoleto no es meramente incompleto. Bajo
english el token running se almacena como
el lexema run, por lo que una consulta bajo simple para run coincide con una nota
que no contiene la palabra — un falso positivo, indistinguible
de un acierto real. Por lo tanto, los vectores de palabras clave fallan de forma
cerrada exactamente como lo hacen las incrustaciones: el servidor almacena una
huella digital de FTS_CONFIGS, la compara
al inicio, y en un cambio de membresía registra ambas listas y las
entradas diferentes, nombra la reconstrucción y sale con código distinto de cero.
(Reordenar los mismos nombres no es un cambio: una nota se indexa bajo cada
configuración y una consulta coincide si alguna acierta, por lo que el orden no
cambia nada y no se compara.)
El manual:
- Edita
FTS_CONFIGSen.env. make deploy. El nuevo contenedor se niega en la guarda de huella digital de palabras clave y permanece detenido.make rebuild-tsvectors. Reconstruye cada ámbito que contiene filas — cada propietario, incluidas las filas sin propietario en modo de usuario único — en una transacción, y registra la nueva huella digital solo si cada uno de ellos informó una reconstrucción completada. Es todo o nada: un ámbito que no puede reconstruir revierte todo, nombra el ámbito y la razón, y no escribe ninguna huella digital, porque la huella digital es una única afirmación sobre cada fila retenida.- Reinicia. Inicia silenciosamente.
Si el paso 3 nombra un ámbito que no pudo reconstruir — un usuario cuya bóveda no está asignada, un inquilino que aún está rederivando su procedencia, o filas sin propietario en modo multiusuario — hay tres recursos, en orden de preferencia:
- Resuelve el ámbito: asigna o elimina al usuario, o deja que la rederivación termine, luego vuelve a ejecutar la reconstrucción.
- Elimina o reasigna las filas sin propietario, luego vuelve a ejecutar la reconstrucción.
- Vuelve a poner
FTS_CONFIGSa su valor anterior. Eso elimina la negativa inmediatamente, sin ninguna reconstrucción — una edición de configuración siempre es reversible, que es lo que evita que esta negativa sea una interrupción.
La reconstrucción vuelve a leer cada nota y recalcula su content_tsvector
bajo la(s) nueva(s) configuración(es). Reconstruye solo el índice de palabras clave — no
toca las incrustaciones/vectores y no hace llamadas API, por lo que
termina en segundos para unos pocos miles de notas. (No lo confundas con el
costoso flujo de make reset-embeddings.)
Advertencia de tokenización: el analizador de tsvector todavía divide en puntuación y guiones independientemente de la configuración, por lo que
bge-m3se tokeniza enbge+m3.simplepreserva formas de palabras, no cadenas con puntuación; la coincidencia exacta de cadenas con puntuación necesitaría un índice de trigramas y está fuera de alcance.
Límites de tamaño de respuesta
Un resultado de herramienta es entrada del modelo. Lo que read_note devuelve se alimenta
directamente de vuelta a la siguiente solicitud del llamador, por lo que una lectura
sin límite es un prompt sin límite — y el llamador generalmente se entera solo cuando su
proveedor de inferencia rechaza la solicitud.
MAX_READ_RESPONSE_CHARS (predeterminado 40,000, aproximadamente 10K tokens) limita
lo que read_note y los resultados de texto de read_file devuelven. Es un
límite diferente de MAX_FILE_READ_BYTES, que limita lo que el
servidor lee del disco. Una nota de 3 MB está cómodamente dentro del límite de lectura
de 10 MB y aun así destruirá una ventana de contexto; ambos límites son necesarios y
tienen valores correctos diferentes.
Se aplica por componente, no una vez a toda la respuesta: la
ventana de content recibe el límite, el encabezado outline lo recibe
de forma independiente, y los campos de metadatos (title, tags,
frontmatter_yaml y su vista JSON, heading) comparten un tercero. Una
lectura truncada puede llevar los tres, así que presupuesta para un peor caso de
aproximadamente 3 × MAX_READ_RESPONSE_CHARS más prosa fija — duplicado de nuevo
porque el resultado de MCP lleva tanto contenido estructurado como un bloque de
texto JSON, y multiplicado por el escape JSON para contenido que es mayormente
caracteres de control.
Cuando una nota excede el límite, obtienes la primera ventana más la truncación como
datos — truncated, el next_offset para continuar desde, total_chars —
y, para una lectura de nota completa, un outline de las secciones de la nota:
{"entries": [
  {"ordinal": 1, "depth": 1, "text": "Client Records",
   "size": 2855343, "exceeds_cap": true,  "duplicate": false},
  {"ordinal": 2, "depth": 2, "text": "Balance Sheet.xlsx",
   "size": 391199,  "exceeds_cap": true,  "duplicate": false},
  {"ordinal": 3, "depth": 2, "text": "Lease Agreement.pdf",
   "size": 464,     "exceeds_cap": false, "duplicate": false},
  {"ordinal": 4, "depth": 2, "text": "Invoice 2025-044.pdf",
   "size": 1075,    "exceeds_cap": false, "duplicate": true}
 ], "truncated": false}
Paginar una nota de varios megabytes de 40K a la vez es técnicamente posible y
prácticamente inútil, así que prefiere el esquema: lee la única sección que
quieres con read_note(path, section="Lease Agreement.pdf"). Las secciones son
direccionables de tres maneras — el ordinal de #N que se muestra en el esquema, la
forma de estilo de ruta de Parent/Child, y el texto exacto del encabezado. El ordinal es
la única forma que separa los encabezados duplicados hermanos, que comparten
cada ancestro y por lo tanto no pueden desambiguarse por ruta; las notas
generadas por extracción masiva tienden a estar llenas de ellos.
Un #N simple siempre selecciona por posición, por lo que un ordinal que te damos en
un esquema nunca puede ser ensombrecido por un encabezado que casualmente se titula
#2. Tal encabezado sigue siendo accesible a través de la forma de ruta (Parent/#2) o
a través de su propio ordinal.
El esquema está a su vez limitado por el tope: una nota con miles de
encabezados obtiene un listado truncado que informa cuántas secciones fueron
omitidas (omitted) y el rango ordinal completo (first_ordinal,
last_ordinal), en lugar de un esquema más grande que la ventana de contenido
que lo acompaña. Los metadatos que no caben en su presupuesto se eliminan completos
y se informan en metadata_omissions — nunca se cortan y nunca se marcan
dentro del campo mismo, por lo que nada en un campo controlado por la nota es nunca
un prefijo o prosa del servidor. frontmatter_yaml es la fuente YAML del bloque
frontmatter con las líneas de valla eliminadas, normalizado a LF (el mismo
residual de terminador declarado que content lleva); es la copia
autoritativa, y la vista JSON de frontmatter junto a ella es una conveniencia que se
omite, con una razón, cuando YAML contiene algo que JSON no puede expresar.
limit puede reducir el límite para una sola llamada pero nunca aumentarlo. Si tus
clientes realmente quieren lecturas más grandes, aumenta MAX_READ_RESPONSE_CHARS —
esa es una decisión del operador, tomada una vez, por alguien que conoce la
implementación.
Actualización: tres cambios visibles en el contrato.
read_noteen una nota grande solía devolver todo el contenido; ahora lo trunca. La respuesta se autodescribe, por lo que un agente no necesita conocimiento previo para continuar, pero un script que asumía lecturas completas de notas debería pasarsection=o aumentar el límite.Y
read_notesolía devolver una cadena renderizada — un encabezado# <title>/**Path:**, un separador\n---\n, y luego el contenido. Ahora devuelve campos, porque cada componente de ese encabezado estaba controlado por la nota: una nota podía falsificar el separador, por lo que un agente que recuperaba el cuerpo de la sección dividiendo la respuesta podía recuperar una cadena manipulada y escribirla de vuelta sobre la sección. Un cliente que analizaba el formato anterior debe leercontent(y, para lecturas de sección,heading) en su lugar; los clientes que ignoranstructuredContentaún obtienen un bloque de texto JSON inequívoco.Las sesiones de panel ahora son filas del lado del servidor, por lo que todos se desconectan una vez en esa actualización. Una cookie emitida antes no lleva identificador de sesión, y dicha cookie se rechaza en lugar de heredarse — aceptarla mantendría la ventana de reproducción anterior abierta por otros siete días después de que se envió la corrección. Inicie sesión nuevamente; no hay nada que migrar.
Límites de velocidad
El consumidor de este servidor es un agente, y un agente con tormenta de reintentos o inyectado por prompt es una entrada ordinaria. Tres controles limitan la rapidez con la que una credencial puede crear trabajo.
- Un bucket general —
MCP_RATE_LIMIT_PER_MINUTE(120) sostenido,MCP_RATE_LIMIT_BURST(30) de capacidad — en cada llamada de herramienta. - Un bucket de escritura — 60/min, ráfaga 15 — que las ocho herramientas
que mutan el vault deben pasar además, y que
PUT /transfer/uploadconsume también, cargado al principal que emitió la capacidad para que la velocidad de escritura no pueda eludirse emitiendo enlaces y canjeándolos. - Un presupuesto por dirección en autenticación
/mcpfallida — 60 fallos por 5 minutos — verificado antes de la búsqueda de credenciales, por lo que una sonda rechazada no cuesta ninguna consulta de base de datos.
El bucket es por principal: una clave API o una concesión OAuth.
Refrescar un token de acceso continúa la misma asignación en lugar de
emitir una nueva, y dos aprobaciones /authorize separadas para el mismo
cliente mantienen asignaciones independientes.
Lo que un agente realmente ve. Un rechazo es un resultado de herramienta ordinario — nunca un error de protocolo, nunca un conjunto de resultados vacío silencioso — y termina con una línea legible por máquina:
Error: this credential exceeded its general rate limit of 120 calls per minute, so the call was refused before it ran. Nothing was read, written, or counted against the daily quota. Retry in 3 seconds, or slow the calling loop down.
MCP-REFUSAL {"code":"rate_limited","scope":"principal","limit":120,"limit_unit":"calls_per_minute","retry_after_seconds":3}
El centinela MCP-REFUSAL está al inicio de línea y el JSON es de una
sola línea, por lo que sobrevive al ser citado en una transcripción. Una
herramienta estructurada devuelve el texto idéntico en su campo de error
declarado. retry_after_seconds está presente solo donde esperar puede
realmente ayudar — un rechazo por un vault no asignado o un argumento no
codificable lo omite en lugar de invitar a un bucle que no puede terminar.
La misma forma cubre la cuota diaria (over_quota), el límite de
longitud de consulta (argument_too_long) y rechazos de cuerpo de herramienta
como not_found, already_exists y invalid_path. Una escritura
parcial también lleva un resultado tipado: lea su explicación antes de
reintentar, porque algunos bytes pueden ya haber cambiado. Los resultados de
búsqueda vacíos y las llamadas no operativas exitosas siguen siendo éxitos.
Los rechazos de transporte están fuera de ese contrato, porque no hay
llamada de herramienta que responder: una solicitud no autenticada por
encima del presupuesto o un rechazo de concurrencia MCP de
solicitud/autenticación aplicado recibe un HTTP 429 con Retry-After, y
también un PUT /transfer/upload por encima de la velocidad — que
libera su reclamo en lugar de consumirlo, por lo que el mismo enlace
sigue siendo canjeable una vez que el bucket se rellena.
Notas operativas.
- El estado del limitador está en proceso y no se persiste, por lo que un
reinicio comienza con cada bucket lleno. Eso es sólido solo porque el
contenedor ejecuta
--workers 1; aumentar el número de trabajadores multiplica cada velocidad anterior por el número de trabajadores. - Los rechazos aparecen en
/admin/performancecomo conteos de rechazo, no en los percentiles de latencia. Los rechazos repetidos por velocidad y por ranura aplicada están coalescidos — una fila por credencial/herramienta/ alcance porMCP_REFUSAL_LOG_INTERVAL_SECONDS, cada una representando1 + suppressedrechazos — para que un bucle de rechazo no pueda hacer que escribir el registro sea la carga. - Los valores predeterminados de velocidad son estimaciones contra una
muestra pequeña. Lea
/admin/performancedurante una semana antes de tratar cualquiera como definitivo, y desactive uno configurándolo vacío,nullonone(cero se rechaza al inicio). - La cuota diaria es el techo duradero y es separada: las claves creadas
desde ahora obtienen
DEFAULT_DAILY_REQUEST_LIMIT(5,000), las claves que ya existían mantienen lo que tenían, y las concesiones OAuth no tienen techo diario en absoluto — solo límites de velocidad.
La justificación vive en
docs/architecture/rate-limits.md.
Admisión de concurrencia
La admisión de concurrencia se envía con MCP_CONCURRENCY_MODE=shadow. Registra
presión bajo concurrency_shadow en filas de uso existentes y emite eventos de
seguridad limitados para presión de solicitud/autenticación. Las llamadas
mantienen su resultado real, contabilidad de cuota y duración. El modo
sombra observa la ocupación actual con cero espera; no predice cómo se
comportaría el tráfico bajo aplicación.
En modo enforce, el servidor limita solicitudes MCP completas
(incluyendo flujos SSE abiertos), sesiones de base de datos de
autenticación, herramientas y escritores de registro de uso. Las
herramientas pasan velocidad, vault y verificaciones de argumentos antes de
adquirir ranuras; la cuota diaria se verifica después. Una herramienta
rechazada recibe slot_timeout sin gastar cuota diaria. Cero espera
significa admisión o rechazo inmediato; una espera positiva usa una cola
limitada y un plazo. Una pista de reintento no es una promesa de que una
llamada en ejecución terminará para ese momento.
Las cuatro clases de herramientas tienen cada una un valor predeterminado de
una llamada concurrente: semantic_search usa incrustación,
find_related usa vector, las ocho herramientas que mutan el vault usan
escritura, y las herramientas restantes usan otro. Los techos global, de
inquilino y de principal tienen valores predeterminados de 4, 3 y 2. El
refresco OAuth mantiene el mismo principal. Los techos de solicitud completa
y por portador tienen valores predeterminados de 32 y 4, autenticación de 2,
y escritores de uso de 1. Todos los ajustes y límites de cola se enumeran en
.env.example.
El inicio valida el presupuesto del pool como auth + 2 × tools + writers + 4 ≤ 15.
Las cuatro conexiones de margen se comparten con el panel, OAuth, indexación
y trabajo de transferencia; esta aritmética no puede garantizar
disponibilidad cuando esos otros consumidores lo agotan. El modo sombra no
aplica ese presupuesto. El controlador está en proceso y requiere la
implementación existente de un solo trabajador.
Revise las observaciones de presión y la ocupación de flujos de larga
duración antes de habilitar enforce. Elija off para
deshabilitar la admisión de concurrencia; los límites de velocidad existentes
y las cuotas diarias aún se aplican. Sombra requiere una espera de
herramienta cero y nunca agrega una espera de escritor ni descarta una fila
de uso debido a su presión observada.
Arquitectura
┌──────────────┐                       ┌──────────────────────┐
│ MCP clients  │   HTTP + Bearer key   │   FastAPI app        │
│  Claude Desk │ ────────────────────▶ │  ┌────────────────┐  │
│  Claude Code │                       │  │  MCP server    │  │
│  n8n agents  │                       │  │  (25 tools)    │  │
│  OpenWebUI   │                       │  └─────┬──────────┘  │
└──────────────┘                       │        ▼             │
                                       │  ┌────────────────┐  │
                                       │  │  Services:     │  │
                                       │  │  - vault       │  │
                                       │  │  - search      │  │
                                       │  │  - embeddings  │  │
                                       │  │  - links       │  │
                                       │  │  - indexer     │  │
                                       │  └─────┬──────────┘  │
                                       │        ▼             │
                                       │  ┌────────────────┐  │
                                       │  │ Postgres +     │  │
                                       │  │ pgvector       │  │
                                       │  └────────────────┘  │
                                       └──────────┬───────────┘
                                                  ▼
                                       ┌────────────────────┐
                                       │  Embedding         │
                                       │  provider          │
                                       │  (Ollama / OpenAI) │
                                       └────────────────────┘
Pipeline de indexación
.md files in vault
    ↓ skip dot-dirs
parse frontmatter, extract tags (YAML + inline #hashtags)
    ↓ SHA-256 hash
skip if unchanged
    ↓
UPSERT notes_metadata (path, title, tags[], frontmatter JSONB,
                       content_hash, tsvector, modified_at)
    ↓
extract wikilinks/embeds/markdown-links → resolve targets →
note_links (source_id, target_id or NULL for dangling)
    ↓
chunk content (512 tokens, no overlap) → embed via provider →
note_embeddings (note_id, chunk_index, chunk_text, embedding[N])
    ↓
set embedded_content_hash = content_hash
El indexador se ejecuta al inicio y cada INDEX_INTERVAL_SECONDS (5
minutos por defecto). Los hashes son solo de contenido, por lo que el
detector de cambios ignora la fluctuación de mtime. Las incrustaciones
obsoletas se detectan por la discrepancia de embedded_content_hash != content_hash.
Esquema de base de datos
| Tabla | Propósito |
|---|---|
notes_metadata | Ruta, título, etiquetas, frontmatter, hash de contenido, hash incrustado, tsvector, tiempo modificado |
note_embeddings | Una fila por fragmento. embedding es vector(EMBEDDING_DIMENSIONS). |
note_links | Grafo de wikilinks: IDs de origen/destino, target_path, tipo (link, embed, markdown) |
api_keys | Tokens portadores con hash, prefijo para visualización, permiso, expiración |
usage_logs | Auditoría por llamada de herramienta |
oauth_clients, oauth_codes, oauth_tokens | Estado PKCE OAuth 2.0, incluido el id de concesión que une los tokens de un consentimiento |
transfer_tokens | Filas de capacidad detrás de los enlaces /transfer/*: dirección, ruta de destino, estado, huella, expiración |
users | Modo multiusuario: inicio de sesión, rol, vault_path por usuario, y el vault bajo el cual se construyó el índice por última vez |
user_sessions | Una fila revocable por sesión de navegador de panel activa, claveada en el SHA-256 del id de sesión de la cookie. Se elimina en cascada con el usuario. |
Índices GIN en content_tsvector y tags[]. Índices B-tree en las
claves foráneas calientes. Índice de expresión HNSW de pgvector
(embedding::halfvec(N)) halfvec_cosine_ops (m=16, ef_construction=64),
construido cuando la dimensión es ≤ 2000; los resultados se reordenan por la
distancia de precisión completa. Las consultas establecen
hnsw.ef_search=80 y deduplican por nota en Python después de una
sobreexplotación de 5x.
Estructura del proyecto
src/
  main.py             FastAPI app, lifespan, MCP mount
  config.py           pydantic-settings
  database.py         async SQLAlchemy engine/session
  models/db.py        ORM models
  mcp_server/         MCP server, tools, auth middleware
  services/           vault ops, anchored filesystem, search, FTS,
                      embeddings, links, indexer, transfer
  transfer/           public /transfer/* capability-redemption routes
  auth/               login, sessions, per-request identity context
  api/                control-panel REST endpoints
  control_panel/      Jinja2 templates and static assets
  oauth/              OAuth 2.0 authorization-code flow
alembic/              database migrations
scripts/              one-off ops scripts (e.g. reset_embeddings.py)
tests/                pytest suite + smoke-test docs
openspec/             change proposals (spec-driven workflow)
Desarrollo
pip install -r requirements-dev.txt
pytest
La suite de pruebas unitarias cubre la abstracción del proveedor de
incrustación, el comportamiento de agrupación y reintento de OpenAI, la
validación de configuración y la verificación de inicio de discrepancia de
dimensión. Las pruebas vinculadas a la red usan respx para
simular httpx, por lo que no se requiere acceso real a la red.
Para ejecutar el servidor fuera de Docker:
DATABASE_URL=... SECRET_KEY=... VAULT_PATH=... uvicorn src.main:app --reload --no-proxy-headers
Objetivos de Make
make init             First-time setup (data dirs, .env)
make build            Build Docker image (no cache)
make build-cached     Build Docker image (with cache)
make push             Push the image to the configured registry
make image            Build and push
make deploy           Build, scan, push, backup, migrate, recreate container
make up / down / restart / shell   Container lifecycle
make logs             Tail container logs
make db-init          Create database, user, and pgvector extension
make db-migrate       Run alembic migrations
make db-check         alembic check — schema vs. ORM models (must be clean)
make test-schema      Schema gate: migrations vs. models on a throwaway pgvector container
make db-backup        Dump database to backups dir
make db-restore FILE=<path>   Restore from a backup
make reindex          Explain how to trigger a reindex (panel only; there is no headless trigger)
make reset-embeddings Drop and recreate embedding column at configured dim
make rebuild-tsvectors Recompute keyword index for FTS_CONFIGS (no embeddings, no API calls)
make status           Show container and health status
make audit            Audit Python dependencies (pip-audit)
make trivy            Scan the local image for HIGH/CRITICAL CVEs (SCAN_IMAGE=obsidian-mcp:local for the bundled stacks)
make clean            Remove containers and images (data preserved)
make deploy ejecuta todo el pipeline: compilación, escaneo de imagen,
push, copia de seguridad de base de datos, alembic upgrade head, y luego recrea
el contenedor. Ejecute make test-schema antes de cualquier implementación
que lleve una migración, y make db-check después de una.
Notas de seguridad
- Las claves API usan el prefijo
omcp_y se almacenan como hashes SHA-256. La clave sin procesar se muestra exactamente una vez al crearla. - El panel de control está diseñado para ubicarse detrás de una puerta de enlace de autenticación externa. El
docker-compose.ymlincluido usa Traefik con una cadena OAuth. No expongas/admindirectamente a internet. - Las sesiones del panel son filas del lado del servidor. La cookie firmada lleva un id aleatorio de 256 bits; la base de datos almacena solo su SHA-256, por lo que un volcado de base de datos no contiene ninguna sesión utilizable. Cerrar sesión revoca esa fila, y un cambio de contraseña, un restablecimiento de administrador, una desactivación o una eliminación revoca todas las sesiones de la cuenta.
- La pantalla de consentimiento de OAuth identifica el cliente sobre el que pregunta: el host de redirección al que se enviaría el código de autorización (tomado del nombre de host de la URI, nunca de su
netloc, y mostrado en punycode en lugar de decodificado), el id de cliente generado por el servidor y la fecha de registro. Cada renderizado dice que la aplicación se registró a sí misma y no está verificada por este servidor; un host fuera deOAUTH_KNOWN_REDIRECT_HOSTSse señala como no reconocido. - La clave de OpenAI se muestra en la página de configuración como
key[:8] + "..." + key[-4:]y nunca aparece completa en HTML ni en fuentes JS. - El path traversal se bloquea en la capa de servicio, y la contención está demostrada por el kernel: cada directorio debajo de la raíz de la bóveda se abre con un
openat2(RESOLVE_BENEATH | RESOLVE_NO_SYMLINKS | RESOLVE_NO_MAGICLINKS)desde un descriptor raíz abierto, y el resto de la operación actúa sobre ese descriptor en lugar de volver a recorrer un nombre. - Las herramientas de mutación actúan sobre la ruta tal como se nombra. Un componente final que sea un enlace simbólico se rechaza (nombrando el destino del enlace) en lugar de seguirse, por lo que un alias dentro de la bóveda no puede redirigir una escritura. Las lecturas aún siguen enlaces, que es para lo que sirve un alias.
- Cada guardia de ruta también rechaza componentes ocultos, por lo que
.obsidian,.git,.trashy similares quedan fuera del alcance de todas las herramientas. - Los enlaces de transferencia llevan su token en el fragmento de la URL, que los navegadores nunca envían, y se canjean solo desde un encabezado
Authorization: Bearer. Mantén el registro de encabezados desactivado en tu proxy inverso y APM. Los tokens desconocidos, caducados, consumidos y revocados reciben todos el mismo 404 de las rutas públicas; el estado preciso proviene de la herramienta autenticadacheck_upload. import_from_urlobtiene solo direcciones genuinamente públicas, bajo una lista de denegación explícita que se vuelve a aplicar en cada redirección.- La autenticación fallida de
/mcpse presupuesta por dirección de cliente, contada antes de la búsqueda de credenciales para que una sonda rechazada no cueste sesión de base de datos ni consulta. La dirección proviene de los encabezados del proxy que la aplicación confía, nunca de un encabezado leído directamente, y una solicitud sin dirección resoluble se carga a un espacio compartido en lugar de quedar exenta. Lo que limita es el trabajo de base de datos que un llamador no autenticado puede forzar; no es una defensa contra adivinar una clave de 256 bits. Consulta Rate limits. - Consultas parametrizadas en todas partes. Sin interpolación de cadenas en SQL.
- Los encabezados de respuesta incluyen HSTS,
X-Content-Type-Options: nosniff,X-Frame-Options: DENYyReferrer-Policy: no-referrer. El panel, las páginas de inicio de sesión y consentimiento añaden una Content-Security-Policy con nonce por respuesta y sin script en línea (PANEL_CSP). - Los saltos propios de la aplicación se verifican al inicio: la base de datos sigue
DATABASE_SSL_MODE, y el endpoint de incrustación debe serhttpso loopback a menos queEMBEDDING_ALLOW_PLAINTEXTindique lo contrario. Cada inicio registra una línea de transporte por salto y un evento de seguridadinternal_transport_plaintextpara cada salto que aún esté en texto claro.
Estado
De un solo autor, en uso activo como exocórtex personal del mantenedor (más de 2,500 notas, múltiples agentes conectados). Público para cualquiera que quiera bifurcarlo. Issues y PRs bienvenidos, pero espera una revisión con opiniones. Este es un sistema funcional, no una plataforma genérica.
Licencia
MIT. Consulta LICENSE.