Clarify Prompt MCP
Un servidor MCP que transforma indicaciones vagas en indicaciones optimizadas para plataformas, compatible con más de 58 plataformas de IA en 7 categorías, con soporte para registrar plataformas personalizadas y proporcionar archivos de instrucciones en Markdown.
Documentación
ClarifyPrompt MCP



Un compilador de prompts MCP consciente del contexto que transforma prompts vagos en prompts optimizados para plataformas, compatible con más de 60 plataformas de IA en 7 categorías — fundamentado en las señales de tu espacio de trabajo (CLAUDE.md, AGENTS.md, .cursorrules, package.json), la intención resuelta y las capacidades del modelo objetivo.
Envía un prompt en bruto. ClarifyPrompt reúne el contexto adecuado, resuelve lo que realmente intentas hacer y devuelve una versión específicamente optimizada para Midjourney, GPT Image 2, Veo, Runway, Kling, Seedance, Higgsfield, ElevenLabs, Suno, Claude, ChatGPT, Cursor o cualquiera de las 61 plataformas compatibles — con la sintaxis, los parámetros, la estructura y la fundamentación correctos.
Nuevo en 1.16.0: la versión de actualidad de plataforma. Cada paquete integrado verificado con los hechos contra la documentación actual del proveedor (2026-10-05) — Midjourney V8.x, Runway Gen-4.5, Veo 3.1, Kling 3.0/Omni, Pika 2.2, Suno v6, ElevenLabs v3, gpt-4o-mini-tts, GPT Image 2 — cada entrada ahora lleva una fecha
verifiedAt. Sora retirado en todas partes (OpenAI cerró la API de Videos el 2026-09-24, sin reemplazo); nuevas plataformas: Seedance, ElevenLabs Music v2.5, Lyria 3.5. Además, el punto de referencia de actualidad de dialecto: a 12 de los modelos más nuevos de Ollama Cloud se les pidió escribir prompts de plataforma sin aviso — 12/13 emiten banderas obsoletas de Midjourney, 12/12 escriben prompts fluidos para un Sora muerto, cero evasivas. El modo fundamentado vuelve a ejecutar las mismas solicitudes con los hechos de los paquetes inyectados y las puntuaciones se invierten. Consulta el punto de referencia y CHANGELOG.md.Nuevo en 1.15.0: Nano Banana (Google Gemini 2.5 Flash Image) ahora es una plataforma de imagen integrada —
optimize_prompt(platform: "nano-banana")compila prompts de imagen en su estilo nativo (dirección de escena en lenguaje natural, términos fotográficos, frases de edición que preservan la identidad, texto dentro de la imagen). Además, compatibilidad con los modelos más recientes en todos los proveedores:claude-sonnet-5,gpt-5/serie o, y Gemini rechazantemperaturey/omax_tokens; el cliente ahora envía los parámetros correctos (de forma proactiva para IDs de razonamiento conocidos, y aprende el resto de un400). Verificado en vivo contra Anthropic, OpenAI, Gemini y Ollama Cloud. Consulta CHANGELOG.md.Nuevo en 1.14.1: Salida de texto portátil por defecto — un prompt de
chat/document/codesin plataforma explícita ahora permanece neutral respecto a la plataforma en lugar de adoptar silenciosamente los modismos de Claude (etiquetas XML); nombra una plataforma para optar por un ajuste específico del proveedor. Además, el panel de composición de MCP Apps ahora muestra una insigniafor <platform>y una vista limpia de Tu prompt → Optimizado antes/después (con un conmutadorshow changes) en lugar de un diff siempre activo. Consulta CHANGELOG.md.Nuevo en 1.14.0: Un panel de composición interactivo a través de MCP Apps. En hosts que hablan la extensión
io.modelcontextprotocol/ui(Claude Desktop, ChatGPT, Cursor, VS Code, …),compose_promptrenderiza un panel en vivo: vista original vs. optimizada, las seis puntuaciones de crítica, las etapas del pipeline, y acciones de Aceptar / Revisar — Aceptar registra el resultado en el bucle de memoria de ClarifyPrompt, Revisar envía tus comentarios de vuelta al chat. Un recursoui://autónomo; los hosts sin la extensión no ven ningún cambio. Consulta CHANGELOG.md.Nuevo en 1.13.0: Reescrituras en lenguaje sencillo. Los prompts optimizados ahora usan palabras comunes y cotidianas en lugar de derivar hacia un vocabulario formal ("usar", nunca "utilizar") — la especificidad proviene de detalles concretos, no de sinónimos más elegantes.
critique_promptganó una sexta dimensión predeterminada,plain_language, por lo que los buclesauto_revisecorrigen automáticamente la deriva de registro. También se corrigió: unmodeexplícito (por ejemplo,simple) ya no se descarta silenciosamente para modelos locales pequeños bajo un modelado de prompt de sistema compacto. Consulta CHANGELOG.md.
La prueba de que esto importa — medido, no afirmado
¿Por qué existe este proyecto? Porque "solo pregúntale al modelo" se quedó obsoleto silenciosamente, y lo medimos. Los modelos están congelados en el momento del entrenamiento; las plataformas lanzan nuevas versiones mensualmente (y eliminan las antiguas). El resultado es que pedirle a un modelo moderno un prompt de plataforma es pedirle a una enciclopedia de 2024 precios de 2026.
El 2026-10-05 ejecutamos un punto de referencia público: les pedimos a 12 de los modelos más nuevos de Ollama Cloud que escribieran prompts para plataformas actuales reales, en dos condiciones, mismas solicitudes, mismos modelos:
- RAW — el modelo solo, sin ayuda. Lo que un usuario obtiene en un chat normal.
- GROUNDED — las mismas solicitudes con los hechos de plataforma verificados inyectados primero — los mismos datos de paquete que ClarifyPrompt inyecta en cada llamada
optimize_prompt. (Esto es lo que significa "fundamentación": el modelo lee la tarjeta de referencia en lugar de confiar en su memoria congelada).
132 respuestas calificadas por condición, verificadas contra la documentación del proveedor el mismo día. Auditoría completa de cada respuesta en bruto: evals/dialect-benchmark/out/final.json.
Los resultados, en una línea:
| RAW (modelo solo) | GROUNDED (hechos de paquete inyectados) | |
|---|---|---|
| dialecto actual | 36 | 117 |
| obsoleto | 35 | 0 |
| mixto / genérico | 7 / 54 | 1 / 14 |
Mismos modelos. Mismas solicitudes. 35 respuestas obsoletas → 0.
Cómo se ve eso en la práctica:
- Sora 2, 12 de 12. OpenAI cerró la API de Videos el 2026-09-24 (aplicación de consumidor el 26 de abril). Once días después, cada modelo — incluido GPT-OSS, los pesos abiertos propios de OpenAI — escribió prompts fluidos y seguros para un producto que no existe. Nadie lo dijo. Ni una sola respuesta evasiva, ni una sola exención de responsabilidad por corte de conocimiento.
- Midjourney, 12 de 13. Todos recurrieron a
--v 6.1. El valor predeterminado actual ha sido V8.2 desde junio. Dos versiones principales obsoletas, de manera uniforme. - Con los hechos de los paquetes inyectados, cada modelo cambió. Mismos modelos: los 12 dijeron que Sora está descontinuado; los 12 fijaron
--v 8.2; el peor ejecutor en bruto pasó de 3 actuales / 5 obsoletos → 8 / 0.
Costo total de ambas condiciones: $0.71. Arnes + archivo de hechos + script de calificación: evals/dialect-benchmark/ — reproduce con node evals/dialect-benchmark/run.mjs.
La lectura honesta: los modelos no conocen los dialectos actuales — pero con una capa de conocimiento mantenida ejecutan perfectamente. El conocimiento es la brecha; la capa de paquetes es el producto. Y eso es lo que es optimize_prompt: fundamentación, en cada llamada, con paquetes que actualizamos contra documentos en vivo y fechamos con verifiedAt.
Cómo Funciona
ClarifyPrompt hace dos cosas que una plantilla de prompt simple no puede. Cada salida a continuación es una captura real, sin editar de optimize_prompt ejecutado contra este repositorio (consulta Proveniencia al final de esta sección).
1 — Conoce cada plataforma. Mismo prompt en bruto, diferente objetivo, salida completamente diferente:
You write:    "a dragon flying over a castle at sunset"

→ Midjourney  A colossal, majestic dragon with shimmering scales soaring over a towering
              medieval stone castle, dramatic sunset sky with vibrant orange and deep purple
              hues, cinematic fantasy concept art, volumetric lighting, highly detailed
              --ar 16:9 --v 6.1 --s 250 --q 2

→ DALL-E      A majestic dragon with glowing crimson scales soars over a towering medieval
              stone castle, silhouetted against a vibrant orange and purple sunset sky.
              Rendered in a high-fantasy digital art style with dramatic, warm lighting and
              highly detailed textures, wide aspect ratio.

→ Nano Banana A majestic dragon with deep crimson scales and a leathery, bat-like wingspan
              glides through the warm, golden-hour sky just above a towering medieval castle
              made of weathered grey stone. ... Frame this as a wide cinematic landscape shot
              using a 24mm lens at f/8 for deep depth of field, camera positioned at a
              slightly elevated three-quarter angle... Aspect ratio 16:9.
Midjourney recibe banderas --ar/--v/--s/--q; DALL-E y Nano Banana reciben lenguaje natural sin banderas — y Nano Banana incorpora dirección fotográfica (lente, apertura, ángulo de cámara) y estado de ánimo explícito, su estilo documentado. Misma idea, el dialecto nativo de cada plataforma.
Observa
--v 6.1en la captura de Midjourney arriba. Esa captura es real (2026-06-22) — y el modelo recurrió a una bandera de versión que ya estaba dos versiones principales obsoleta; el valor predeterminado actual de Midjourney es V8.2. Los pesos del modelo están congelados en el momento del entrenamiento; los dialectos de las plataformas mutan mensualmente. Esa brecha es exactamente lo que los paquetes de plataforma verificados de ClarifyPrompt (fechados converifiedAt, actualizados contra documentos actuales) existen para cerrar — consulta la historia de la obsolescencia.
2 — Sabe en qué estás trabajando. Esta es la parte que una plantilla no puede fingir. Suelta una línea vaga mientras editas src/transport.ts en este mismo repositorio, y el motor la fundamenta en tu espacio de trabajo real — package.json, estado de git, el archivo activo — y resuelve la intención antes de dar forma a la salida:
You write:    "add a configurable request timeout to the http transport"
              · active file: src/transport.ts   · resolved intent: production-code
              · grounded in: active-file · workspace-meta · git-state · environment ·
                target-model · platform-hints

→ Cursor      Implement a configurable request timeout for the HTTP transport in
              `src/transport.ts`.
              Requirements:
              1. Add a new environment variable `CLARIFYPROMPT_HTTP_TIMEOUT` … (default 30000 ms)
              2. Apply this timeout to all incoming requests in the streamable-http transport
              …
              5. Preserve existing behavior for stdio and a2a transports
              …
              The implementation should be added to the streamable-http section of
              `startTransport()`.
              (excerpted — the full rewrite has 7 numbered requirement groups)
Nada en ese prompt de una línea mencionó la convención de nomenclatura CLARIFYPROMPT_HTTP_*, el punto de entrada startTransport(), o los transportes stdio/a2a que debe preservar — el motor los leyó del archivo activo y package.json y los incorporó. Esa es la diferencia entre reformular un prompt y compilarlo contra contexto.
3 — Puede ejecutar todo el pipeline. aclarar → fundamentar/optimizar → criticar → revisar, en una sola llamada compose_prompt — consulta Anteriormente en 1.4.0 — el pipeline componible a continuación.
Proveniencia. Las salidas de imagen capturadas a través de
glm-5.2:cloud, la salida de código fundamentada a través deqwen3-coder:480b-cloud— ambos modelos en la nube Ollama servidos a través del endpoint compatible con OpenAI de Ollama (LLM_API_URL=http://localhost:11434/v1), ejecutados a través deoptimize_promptcontra este repositorio el 2026-06-22 (la captura de Nano Banana agregada el 2026-07-03, mismo modeloglm-5.2:cloud). ClarifyPrompt es agnóstico respecto al modelo (cualquier API compatible con OpenAI, local o alojada); las salidas dependen del modelo — las tuyas diferirán en redacción, no en estructura.
Qué hay de nuevo en 1.16.0
La versión de actualidad de plataforma. Los paquetes se habían deteriorado — Midjourney todavía estaba en --v 6.1 mientras que el valor predeterminado actual es V8.2, el paquete de video todavía describía "Runway Gen-3" y "Google Veo 2", y la entrada de Higgsfield todavía enrutaba a un modelo muerto. Cada paquete integrado fue verificado con los hechos contra la documentación actual del proveedor el 2026-10-05, y cada entrada verificada ahora lleva una fecha verifiedAt para que la obsolescencia sea visible, rastreable y comprobable en CI.
Sora retirado en todas partes. OpenAI descontinuó la aplicación Sora el 2026-04-26 y cerró la API de Videos + todos los IDs de modelo sora-2 el 2026-09-24, sin reemplazo nombrado. Eliminado de los paquetes, la guía de estrategia, la tarjeta A2A, la documentación de herramientas, el README y las palabras clave de npm. Nuevas plataformas de primera clase: seedance, eleven-music (ElevenLabs Music v2.5), lyria (Google 3.5).
El punto de referencia de actualidad de dialecto (evals/dialect-benchmark/) — la prueba de por qué existe este proyecto. Les pedimos a 12 de los modelos más nuevos de Ollama Cloud que escribieran prompts de plataforma, sin aviso, y calificamos las respuestas contra los mismos hechos verificados:
- 12 de 13 modelos que respondieron emitieron
--v 6.xobsoleto de Midjourney (V8.2 ha sido el valor predeterminado desde junio) - 12 de 12 escribieron prompts fluidos para Sora 2 — un producto que OpenAI cerró 11 días antes de la ejecución. Incluido GPT-OSS, los pesos abiertos propios de OpenAI. Cero modelos evadieron o mencionaron un corte de conocimiento.
- Modo fundamentado (
BENCH_GROUNDED=1) vuelve a ejecutar las solicitudes idénticas con los hechos de los paquetes inyectados en el prompt del sistema — el delta antes/después en la misma lista es la tesis del producto hecha medible: los modelos no conocen los dialectos actuales, pero con una capa de conocimiento mantenida ejecutan. - Hallazgo adicional: dos modelos de control del punto de referencia devolvieron HTTP 410 retirado a mitad de la ejecución (
qwen3.5:397b, 2026-09-25) — los modelos también rotan, no solo los dialectos.
Qué hay de nuevo en 1.15.0
Nano Banana, integrado. Google Gemini 2.5 Flash Image ("Nano Banana") ahora es una plataforma de imagen de primera clase — optimize_prompt(category: "image", platform: "nano-banana") compila tu idea en su estilo de prompting nativo: dirección de escena en oraciones completas (no montones de palabras clave), terminología fotográfica para cámara/lente/profundidad, iluminación explícita, frases de edición que preservan la identidad del sujeto, consistencia de personaje con múltiples referencias y texto confiable dentro de la imagen. Como en cada plataforma de imagen, ClarifyPrompt compila el prompt; tú lo envías al modelo.
Compatibilidad con los modelos más recientes, en todos los proveedores. Los modelos con capacidad de razonamiento rechazan parámetros que clarifyprompt siempre enviaba: claude-sonnet-5 y los modelos de razonamiento de OpenAI rechazan temperature; gpt-5 / la serie o también rechazan max_tokens (requieren max_completion_tokens). Cada llamada a ellos solía fallar y degradarse al prompt original. Ahora el cliente envía el cuerpo correcto — de forma proactiva para IDs de razonamiento conocidos (sin ida y vuelta desperdiciada) y, para cualquier cosa que las pistas no reconozcan (incluidos modelos futuros), aprende del 400 y reintenta. Los modelos que aceptan los parámetros estándar son byte-idénticos. Verificado en vivo contra Anthropic (claude-sonnet-5), OpenAI (gpt-5), Gemini (gemini-flash-latest) y Ollama Cloud (glm-5.2:cloud). Los modelos de razonamiento piensan mucho — aumenta LLM_TIMEOUT_MS (el valor predeterminado de 30s suele ser demasiado corto).
Novedades en 1.14.1
Portátil por defecto. Cuando optimizas un prompt de texto (chat, document, code) sin nombrar una plataforma, ClarifyPrompt ahora devuelve una salida neutral respecto a la plataforma — estructura limpia y portátil que funciona en cualquier asistente — en lugar de usar silenciosamente los modismos de Claude (sus etiquetas XML <task>/<context>). Nombra una plataforma (platform: "claude", "chatgpt", … cualquiera de las 60) para optar por el ajuste específico de esa plataforma. Las categorías creativas (imagen/video/voz/música) no cambian: su salida necesita un formato de plataforma concreto, por lo que el valor predeterminado principal (Midway, Runway, …) sigue aplicándose.
Panel de composición más claro. El panel de MCP Apps ahora muestra una insignia for <platform> (o general purpose), renderiza tu prompt original como un bloque etiquetado Tu prompt encima de la salida optimizada, y muestra el prompt optimizado de forma sencilla — con un conmutador show changes para el diff a nivel de palabra — en lugar de un diff siempre activo.
Novedades en 1.14.0
compose_prompt ahora tiene una cara. ClarifyPrompt incluye un panel de MCP Apps (extensión io.modelcontextprotocol/ui) que los hosts compatibles renderizan en línea junto al resultado de la herramienta:
- Original vs optimizado, como diff a nivel de palabra — ve exactamente qué cambió el compilador.
- Crítica, visualizada — las seis dimensiones (claridad, especificidad, alineación_de_intención, adecuación_del_formato, adecuación_de_longitud, lenguaje_simple) como barras de puntuación, con el veredicto y el rastro de auditoría
stagespor llamada como insignias. - Aceptar — un clic registra
save_outcome(accepted)desde el panel, alimentando el bucle de memoria few-shot, y le dice silenciosamente al modelo que el prompt fue aceptado. - Revisar… — escribe qué debería cambiar; el panel lo envía de vuelta al chat para que el modelo recomponga.
- Consciente de aclaraciones — cuando la etapa previa a la aclaración detiene la cadena con preguntas, el panel las renderiza (con respuestas sugeridas) en lugar de un diff.
Despliegue de riesgo cero: el panel es un único recurso HTML autocontenido (ui://clarifyprompt/compose-panel.html, CSS/JS en línea — el sandbox de la extensión bloquea solicitudes externas) enlazado desde compose_prompt's _meta.ui. Los hosts sin la extensión lo ignoran por completo; la salida de texto + structuredContent es byte-idéntica. Se ejecuta en el SDK ^1.29 existente. La nueva batería determinista npm run test:apps bloquea el cableado.
También nuevo: el harness de evaluación ganó una verificación max_reading_grade — un techo determinista de Flesch–Kincaid que fija el comportamiento de lenguaje simple de 1.13.0 como una puerta medible (el registro formal suelta puntúa ~20+; las reescrituras simples ~3–6).
Novedades en 1.13.0
Reescrituras en lenguaje simple, de principio a fin. Los LLM manejan palabras comunes y cotidianas de manera más confiable que sinónimos formales del mismo significado — y los modelos locales pequeños, los objetivos predeterminados de ClarifyPrompt, son los que más se benefician. Esta versión integra eso en cada etapa que da forma a la redacción de la salida:
- El optimizador prefiere palabras comunes. Un nuevo principio central en el prompt de sistema compartido ("USA PALABRAS COMUNES") se aplica a las 7 estrategias de categoría y tanto a
optimize_promptcomo aground_prompt: nunca intercambies una palabra más rara cuando una común transmite el mismo significado. Detalle significa más información, no palabras más elegantes — la especificidad, la estructura y las restricciones no se tocan. critique_promptganó una 6ª dimensión predeterminada:plain_language. Penaliza vocabulario innecesariamente formal o raro cuando una palabra más simple serviría. Debido a que el paso de reescritura aplica cada sugerencia de dimensiones que puntúan por debajo de 7, los buclesauto_reviseahora corrigen la deriva de registro gratis. Las anulaciones personalizadas decriteriano se ven afectadas.- Corregido:
modeexplícito ya no se elimina silenciosamente para modelos locales pequeños. El modelado compacto del prompt de sistema solía recortar las instrucciones de modo por completo — así quemode: "simple"no tenía efecto en modelos de clase 3B. Cada modo ahora sobrevive al modelado compacto como una regla de una línea. - Dos nuevos fixtures de evaluación protegen el comportamiento:
31-plain-language-vocabulary(la salida optimizada no debe contener palabras de registro formal) y32-shape-compact-keeps-mode(la línea de modo llega a modelos pequeños).
Novedades en 1.12.1
La solución real para el problema #3: los modelos con canal de pensamiento ahora producen prompts optimizados de manera confiable en lugar de devolver contenido vacío de forma intermitente. Tanto gpt-oss:20b-cloud como glm-5.2:cloud pasaron de vacíos ~40% de las ejecuciones a 0%.
Reinvestigar desde cero revirtió la causa raíz documentada. Nunca fue "el shim /v1 de Ollama elimina el canal final de armonía". Estos modelos gastan su presupuesto de max_tokens en el canal de pensamiento primero y nunca llegan al canal final — así que content regresa "" (peor con mayor esfuerzo de razonamiento). Dos palancas, aplicadas juntas porque diferentes familias respetan diferentes:
- Un piso de
max_tokens(8192) para modelos de razonamiento detectados — la palanca universal. Ataca la causa raíz directamente, por lo que funciona independientemente de qué perilla de pensamiento respete una familia. Es un techo, no un objetivo: las respuestas cortas terminan temprano, así que no hay latencia añadida. reasoning_effort: "low"— para familias que lo respetan (gpt-oss), también recortando latencia/costo. Ajusta conLLM_REASONING_EFFORT(low|medium|high).
Las palancas son genuinamente específicas de familia: gpt-oss honra reasoning_effort pero ignora think de Ollama; glm es exactamente lo opuesto — ignora reasoning_effort, así que solo el piso de presupuesto lo salva.
La detección es robusta, no una lista de modelos codificada (que se pudriría a medida que se lancen nuevos modelos). "¿Es este un modelo de pensamiento?" se responde, con caché por modelo, mediante: (1) el propio runtime — /api/show de Ollama reporta una capacidad thinking (así se detecta minimax-m3:cloud, sin coincidencia de nombre); (2) aprendizaje por respuesta — cualquier traza de razonamiento, o contenido vacío con tokens, marca ese modelo en adelante (funciona para cualquier proveedor); (3) una pequeña pista de nombre como último recurso. Los modelos sin razonamiento permanecen byte-idénticos, y el reintento de contenido vacío agnóstico al nombre es el respaldo final. Validado en gpt-oss:20b-cloud, glm-5.2:cloud y minimax-m3:cloud (todos 0% vacíos en la primera llamada).
El "cambiar al
/api/chatnativo de Ollama" propuesto anteriormente fue un callejón sin salida —/api/chatconthink:falseaún devuelve contenido vacío para gpt-oss (lo ignora), y habría añadido una segunda ruta de código frágil.
Novedades en 1.12.0
Paso #7 — el paso final — de la hoja de ruta de modernización de MCP: ClarifyPrompt ahora habla A2A (Agente-a-Agente), por lo que otros agentes pueden llamarlo para compilar prompts. stdio sigue siendo el predeterminado; nada sobre las configuraciones existentes cambia.
Establece CLARIFYPROMPT_TRANSPORT=a2a y ClarifyPrompt aparece como un par A2A descubrible en el http integrado de Node (la única nueva dependencia es el @a2a-js/sdk oficial, que a su vez solo trae uuid):
| Endpoint | Propósito |
|---|---|
GET /.well-known/agent-card.json | Tarjeta de agente — descubrimiento: identidad, capacidades, la habilidad compile-prompt-for-platform |
POST /a2a | A2A JSON-RPC 2.0: message/send, message/stream (SSE), tasks/get, tasks/cancel, … |
GET /health | Sonda de actividad |
CLARIFYPROMPT_TRANSPORT=a2a CLARIFYPROMPT_HTTP_PORT=3000 npx clarifyprompt-mcp
# → card:  http://127.0.0.1:3000/.well-known/agent-card.json
# → a2a:   POST http://127.0.0.1:3000/a2a   (message/send · message/stream)
Toda la hoja de ruta da frutos aquí — un mensaje A2A entrante fluye a través del mismo pipeline de composición, y los primitivos construidos en pasos anteriores se mapean directamente a la semántica A2A:
- Compilar — un
message/sendcon el prompt crudo (texto plano, o JSON{ prompt, platform?, category?, … }) devuelve una tarea cuyo artefacto lleva el prompt optimizado (texto) más el resultado de composición estructurado completo (datos). - Streaming (progreso de 1.10.0 → A2A) —
message/streamemite eventosstatus-updatea medida que cada etapa del pipeline se ejecuta, luego el artefacto, sobre SSE. - Cancelación (AbortSignal de 1.10.0 → A2A) —
tasks/cancelaborta la composición en curso en milisegundos y reporta un estado terminalcanceled. - Aclaración (elicitación de 1.9.0 → A2A) — la aclaración está desactivada por defecto para pares de un solo disparo; opta con
pre_clarify: 'auto' | 'always'y un prompt ambiguo pausa la tarea en el estado de primera claseinput-requiredde A2A con las preguntas (texto legible + datos estructurados). Responde en la misma tarea y se compila.
Configura la URL base pública anunciada en la tarjeta con CLARIFYPROMPT_A2A_BASE_URL (útil detrás de un proxy); puerto/host se comparten con streamable-http. La nueva batería determinista npm run test:a2a impulsa el descubrimiento de tarjetas, una compilación en vivo, el ida y vuelta de aclaración y el streaming SSE.
Novedades en 1.11.0
Paso #6 de la hoja de ruta de modernización de MCP: una fábrica de transporte conectable — ClarifyPrompt ahora puede servir sobre Streamable HTTP, la pista hacia A2A y hosts MCP remotos. stdio sigue siendo el predeterminado; nada sobre las configuraciones existentes cambia.
Transportes
Establece CLARIFYPROMPT_TRANSPORT:
| Valor | Comportamiento |
|---|---|
stdio (predeterminado) | Un servidor sobre stdin/stdout — exactamente como antes |
streamable-http | MCP Streamable HTTP sobre el http integrado de Node (sin nuevas dependencias): sesiones con estado (mcp-session-id), streaming SSE, una sonda /health |
a2a | Servir como un par A2A (Agente-a-Agente) — tarjeta de agente, JSON-RPC + SSE (ver 1.12.0 arriba) |
Perillas HTTP (en modo streamable-http / a2a): CLARIFYPROMPT_HTTP_PORT (3000), CLARIFYPROMPT_HTTP_HOST (127.0.0.1 — solo localhost por defecto), CLARIFYPROMPT_HTTP_PATH (/mcp, solo streamable-http).
CLARIFYPROMPT_TRANSPORT=streamable-http CLARIFYPROMPT_HTTP_PORT=3000 npx clarifyprompt-mcp
# → POST http://127.0.0.1:3000/mcp  ·  GET http://127.0.0.1:3000/health
El registro de herramientas/recursos se movió a una fábrica exportada createServer(): stdio obtiene un servidor, streamable-http obtiene uno por sesión (el patrón recomendado por el SDK, seguro contra GHSA — nunca comparte un servidor entre clientes HTTP). La nueva batería determinista npm run test:http impulsa una sesión HTTP completa.
Novedades en 1.10.0
Paso #5 de la hoja de ruta de modernización de MCP, núcleo estable: compose_prompt es cancelable y reporta progreso en vivo. Agnóstico al modelo, opt-in, totalmente retrocompatible.
Cancelación
Un AbortSignal se conecta a través de toda la ruta LLM (simpleGenerate → chat → fetch, combinado con el timeout por llamada) y cada etapa del motor. Cuando un cliente envía notifications/cancelled para una llamada compose_prompt, la solicitud de modelo en curso se aborta inmediatamente y el bucle de revisión se detiene en el siguiente límite de etapa — en lugar de ejecutar cada iteración hasta el final. La señal llega a fetch independientemente de qué modelo/proveedor esté configurado.
Progreso
Incluye un progressToken en la solicitud compose_prompt _meta y el servidor emite notifications/progress en cada etapa (aclarar / optimizar / fundamentar / criticar) con un contador monótono y un mensaje humano como optimizing prompt [iter 2/3]. Los hosts pueden mostrar un estado en vivo en una composición larga de múltiples iteraciones. Sin token → sin notificaciones, cero sobrecarga.
¿Por qué no tareas MCP (aún)?
Roadmap #5 nombró a la API de tasks del MCP. Sigue siendo experimental/ en el SDK ("puede cambiar sin previo aviso"), su referencia es de ~600 líneas, y ningún cliente actual habla el protocolo tasks/* — así que una implementación completa sería código inutilizable desactivado por defecto hoy. El valor real (compose cancelable y con reporte de progreso) se entrega aquí sobre primitivas estables; el wrapper experimental de tareas asíncronas se difiere para aterrizar con #7 (A2A), que la base AbortSignal aquí ya prepara. La nueva batería determinista npm run test:cancel fija el comportamiento.
Novedades en 1.9.0
Paso #4 de la hoja de ruta de modernización del MCP: clarify_with_user puede obtener respuestas a través de la UI de formularios nativa del host. Opt-in, totalmente retrocompatible.
Clarificación interactiva
Pasa elicit: true. En un cliente que soporta elicitación MCP, las preguntas de clarificación se convierten en un formulario real:
- cada pregunta es un campo,
optionsse convierten en desplegables de enum, y cadasuggestedAnsweres el valor por defecto del campo (aceptación con un clic); - el usuario responde en línea; el motor devuelve
answers: [{ question, dimension, answer, usedSuggested }]conelicited: true.
Sin elicit, en un cliente no capaz, o si el round-trip falla, la herramienta devuelve el mismo JSON de preguntas crudas de siempre — todos los llamadores existentes no se ven afectados. decline / cancel se exponen vía elicitationAction.
Esto convierte la clarificación de "aquí tienes un blob JSON de preguntas, tú lo renderizas" en un momento interactivo de primera clase en hosts como Claude Desktop. El mapeo vive en un módulo puro pequeño (src/engine/clarification/elicit.ts), reutilizable por la etapa de pre-clarificación de compose_prompt más adelante. La nueva batería determinista npm run test:elicit (helpers puros + un round-trip con mock-client en vivo) lo fija.
Novedades en 1.8.0
Paso #3 de la hoja de ruta de modernización del MCP: las superficies de lectura del motor se convierten en plantillas de recursos navegables con autocompletado de argumentos. Sin cambios en herramientas ni comportamiento del motor.
Plantillas de recursos
Cuatro plantillas se unen al estático clarifyprompt://categories, cada una respaldada por un getter existente del motor:
| Plantilla URI | Qué lee |
|---|---|
clarifyprompt://platforms/{category}/{id} | Configuración completa de una plataforma — resources/list enumera las 60+ como URIs individuales |
clarifyprompt://traces/{date} | Índice resumido de trazas de optimización para un día UTC |
clarifyprompt://packs/{id} | Metadatos de un paquete de conocimiento cargado |
clarifyprompt://memory/facts/{scope} | Hechos recordados en vivo bajo un ámbito |
Los hosts MCP con navegador de recursos (Claude Desktop, Cursor) ahora obtienen un árbol navegable en lugar de un único blob estático.
Autocompletado
completion/complete resuelve las variables de plantilla: {category} → los 7 ids de categoría, {id} → ids de plataforma limitados por el {category} elegido, {date} → días con trazas, ids de paquetes, ámbitos de memoria. (El completado MCP aplica solo a argumentos de prompts y variables de plantillas de recursos — no a entradas de herramientas; ClarifyPrompt no registra prompts, así que vive en las plantillas.)
Capacidades
El servidor ahora anuncia resources (con plantillas) y completions en initialize. La nueva batería determinista npm run test:resources fija la superficie.
Novedades en 1.7.1
Parche que corrige #3: un prompt optimizado vacío silencioso de modelos cuya respuesta no aterrizó en content.
- Lee los tres nombres de campo del canal de pensamiento (
reasoning/thinking/reasoning_content) — corrige DeepSeek / qwen-thinking y similares. - Reintenta una vez, luego falla ruidosamente cuando el contenido está vacío independientemente de cualquier campo de pensamiento. Esto cubre el caso real del issue #3: la salida de armonía gpt-oss sobre el shim
/v1de Ollama genera tokens (completion_tokens > 0) pero devuelvecontent: ""sin campo de pensamiento. El motor ahora degrada al prompt original + unerrorexpuesto en lugar de devolver en blanco. - Recuperar genuinamente la salida de armonía gpt-oss (vía el
/api/chatnativo de Ollama) se rastreó como seguimiento — resuelto en 1.12.1, que demostró que el camino/api/chatera un callejón sin salida y corrigió la causa raíz real (un piso demax_tokens+reasoning_effortpara modelos de razonamiento; ver las notas de 1.12.1 arriba). - Nueva batería determinista
npm run test:thinkingfija la regresión con respuestas simuladas (sin dependencia de nube en vivo).
Verificado: test:thinking, batería de razonamiento (gpt-oss degrada ruidosamente; el razonador genuino kimi-k2-thinking:cloud aún devuelve contenido real), integración, day2, evals, wire.
Novedades en 1.7.0
Paso #2 de la hoja de ruta de modernización del MCP: toda la superficie de herramientas migró de la abreviatura obsoleta server.tool() (eliminada en SDK 2.0) a server.registerTool(). Sin cambios de comportamiento del motor; totalmente retrocompatible.
Qué obtienen los hosts
- Títulos — cada herramienta tiene un nombre de visualización legible ("Olvidar un hecho", no
memory_forget). - Anotaciones de comportamiento — las 23 herramientas declaran
readOnlyHint/destructiveHint/idempotentHint/openWorldHint. Las tres herramientas destructivas (memory_forget,unload_pack,unregister_platform) están marcadas para UIs de confirmación; los siete inspectores de solo lectura están marcados como seguros de llamar libremente; las siete herramientas que alcanzan la red (LLM / embeddings / búsqueda web) llevanopenWorldHint: true. - Salida estructurada — cada herramienta declara un
outputSchemay devuelvestructuredContentjunto al texto JSON. Los esquemas son permisivos por diseño (todo opcional, passthrough) — documentan la forma sin rechazar nunca la salida del motor.
Retrocompatibilidad
El contenido de texto es byte-idéntico para cada herramienta — incluyendo las tres herramientas list_* que devuelven arrays, cuyo texto sigue siendo un array desnudo mientras structuredContent lo envuelve en un objeto según la especificación MCP. Los retornos de error no cambian. Verificado: wire 7/7, integración 9/9, day2, 26/27 evals con cero errores de validación de salida.
Encontrado durante la verificación
#3 — las respuestas del canal de pensamiento gpt-oss en la nube pueden producir un optimizedPrompt vacío (cambio de API remota que expone una brecha preexistente de nombres de campo en client.ts; corrección dirigida para 1.7.1).
Novedades en 1.6.8
Release de mantenimiento que cierra los bucles abiertos por la cascada 1.6.5→1.6.7. Sin código de motor, superficie de herramientas MCP, plataforma o cambios de variables de entorno.
Cambiado
- La matriz de CI ahora prueba Node 24 (LTS activo actual, EOL abril 2028) junto con 18/20/22 en Ubuntu + macOS. La matriz anterior probaba dos versiones de Node EOL pero no el LTS actual en absoluto. Verificado antes del merge que las dependencias nativas (
better-sqlite3+sqlite-vec) cargan y funcionan en Node 24.16.0 en un contenedornode:24-slimsin toolchain.enginessigue siendo>=18— máxima compatibilidad, y probamos lo que afirmamos. - El runner de publicación movió Node 20 → 22, manteniendo un runtime EOL fuera del camino crítico de release (coincide con la base del Dockerfile).
Proceso
- Nuevo
CP-13 — lockfile regeneration safetyde ship-check codifica la lección de la cascada 1.6.5→1.6.6→1.6.7: un solonpm install --package-lock-onlyeliminó silenciosamente 4 de 5 binarios de plataformasqlite-vec(rompió CI de Linux) y arrastró un bumpbetter-sqlite3dentro del caret que eliminó los prebuilds de Node 20 (rompió el build de Docker). El check exigenpm installcompleto en cambios de dependencias, un diff de lockfile para dependencias de plataforma eliminadas + saltos de versión de deps nativas, y una compuerta local de carga Docker slim. Dogfooded en este release.
Novedades en 1.6.7
Parche del Dockerfile. Sin código de motor, superficie de herramientas MCP, plataforma o cambios de variables de entorno.
Corregido
CI / docker buildfalló en 1.6.6 connpm error gyp ERR! find Python. Causa raíz:better-sqlite3@12.10.0(publicado 2026-05) eliminó explícitamente los binarios precompilados para Node.js v20 y v23 porque Node 20 alcanzó EOL en abril 2026. La regeneración del lockfile en 1.6.6 arrastró 12.10.0 dentro del caret^12.9.0, ynode:20-slimno tiene Python + toolchain C++ para compilar desde fuente. Subió la base del Dockerfile anode:22-slim— LTS activo actual, aún tiene prebuilds funcionales.- La matriz de build CI no-Docker (Node 18 / 20 / 22 en macOS + Ubuntu) aún pasa porque los runners regulares pueden compilar desde fuente como respaldo. Solo la imagen Docker slim tropieza.
Verificado localmente
docker build → verde. El contenedor puede require('better-sqlite3') + require('sqlite-vec') limpiamente. Los 5 binarios de plataforma sqlite-vec siguen en package-lock.json (la corrección de 1.6.6 se mantuvo).
Novedades en 1.6.6
Parche de lockfile + harness tras 1.6.5. Sin código de motor, superficie de herramientas MCP, plataforma o cambios de variables de entorno. Incluye el documento de auditoría de completitud MCP.
Corregido
package-lock.jsonperdió 4 de 5 binarios de plataformasqlite-vecdurante el bump de SDK en 1.6.5. Minpm install --package-lock-onlylocal retuvo solo el binariosqlite-vec-darwin-arm64del mantenedor.npm cien los runners Ubuntu de CI falló conno such module: vec0porquesqlite-vec-linux-x64no estaba en el lock. Elnpm install clarifyprompt-mcp@1.6.5del usuario final nunca se vio afectado (el tarball npm no incluye lockfile; los usuarios resuelven plataformas en tiempo de instalación). Regenerado connpm installcompleto para que las 5 plataformas (darwin-arm64,darwin-x64,linux-arm64,linux-x64,windows-x64) vuelvan.- El escritor de reportes HTML del harness de evals falló en entradas ERRORED (
evals/run.mjs:729). El renderizador preexistente asumía que cada ejecución no omitida y no filtrada tenía un campoevaluation.checks, pero las ejecuciones con error llevan un campoerroren su lugar. Se añadió una rama explícita de estado con error — el harness ahora degrada con gracia y sale limpiamente incluso cuando los fixtures fallan.
Documentos incluidos
docs/audits/mcp-completeness-2026-05.md— auditoría diagnóstica de la superficie MCP del motor contra el SDK y la especificación actuales. Tabla de registro herramienta por herramienta, análisis de brechas de recursos, delta de características del SDK (1.12 → 1.29 → 2.0-alpha), declaraciones de capacidades, bosquejo de refactor de transporte, nota de viabilidad A2A, y una hoja de ruta de modernización secuenciada en 7 pasos. El artefacto detrás de la planificación de la próxima sesión. Sin cambios de motor prescritos en línea.
Números
- 5 plataformas sqlite-vec en lockfile (antes 1).
npm audit --production: 0 vulnerabilidades (sin cambios). Herramientas: 23 (sin cambios). Fixtures de eval: 30 (sin cambios).
Novedades en 1.6.5
Parche de seguridad. Sin cambios de código de motor, sin cambios de superficie de herramientas MCP, sin cambios de plataforma, sin cambios de variables de entorno.
Corregido
- CVE-2026-0621 — ReDoS en la regex
UriTemplatede@modelcontextprotocol/sdk(parcheado en SDK1.25.2). El piso^1.12.1anterior permitía resoluciones vulnerables en cachés npm obsoletas; subido a^1.29.0para que el piso mismo esté parcheado. - GHSA-345p-7cg4-v4c7 — Instancias compartidas de servidor/transporte filtran datos de respuesta entre clientes (parcheado en SDK
1.26.0). No explotable en la práctica para ClarifyPrompt (un host = una instancia de servidor) pero el código vulnerable ahora está completamente fuera del grafo de dependencias. - 7 vulnerabilidades transitivas (2 moderadas, 5 altas) en la subpila de transporte HTTP incluida en el SDK (
hono,express-rate-limit,fast-uri,ip-address,path-to-regexp,qs,@hono/node-server). Limpiadas víanpm audit fix. Nunca afectaron el runtime — ClarifyPrompt es solo stdio y no carga el transporte HTTP — pero eran ruido en los reportesnpm auditde los usuarios y hacían que la instalación pareciera insegura.
Números
npm audit --production→ 0 vulnerabilidades (antes 2 CVEs del SDK + 7 transitivas).package-lock.json: net −336 líneas (el caret anterior arrastraba ancillaries pesados no usados del transporte HTTP; la corrección los cambió por alternativas más ligeras).- Herramientas: 23 (sin cambios). Plataformas: 60+ (sin cambios). Fixtures de eval: 30 (sin cambios).
- Test de wire + batería de integración + day2 + razonamiento + 29/30 evals pasan contra el nuevo piso en Ollama local. El único fallo de eval (
analyzer-creative-media) es una flake preexistente del clasificador qwen-coder-7b — verificado independiente del SDK mediante stash-revert y re-ejecución.
Por qué importa el bump del piso
^1.12.1 era documentación engañosa: la resolución de caret en realidad estaba obteniendo el 1.27.1 del SDK para cualquier npm install nuevo desde principios de 2026. El aumento del mínimo alinea la línea base declarada con lo que npm ya estaba haciendo para la mayoría de los usuarios, al tiempo que garantiza el mínimo para usuarios con cachés obsoletas. También nos posiciona para la eventual migración a 2.0.0-alpha cuando esa línea se estabilice (el SDK moderno depreca el registro abreviado .tool() / .prompt() / .resource() en favor de registerTool() / registerPrompt() / registerResource() con título + outputSchema + anotaciones).
Novedades en 1.6.4
Parche de documentación y procesos. Sin cambios en el motor, herramientas MCP ni plataformas, pero una limpieza significativa del modelo de distribución de paquetes.
Registro de paquetes consolidado de nuevo en el repositorio del motor
LumabyteCo/clarifyprompt-packs (el registro separado de paquetes comunitarios creado en 1.3 con el principio correcto pero a la escala equivocada) ha sido archivado. Sus tres paquetes iniciales ya vivían en la carpeta packs/ de este repositorio; el registro pretendía ser el hogar canónico, pero en la práctica todo se distribuía desde aquí mediante el tarball de npm. La deriva se hizo evidente: higgsfield-creative-handbook se publicó en 1.6.2 y nunca llegó al registro, aunque el propio README del registro indicaba a los usuarios que obtuvieran los paquetes desde allí.
Resultado neto de 1.6.4:
- Fuente única de verdad. Los paquetes de conocimiento
packs/*.md+ las configuraciones de plataformapacks/platforms/*.yamlviven enclarifyprompt-mcpy se distribuyen en el tarball de npm. - Nueva sección de nivel superior Paquetes de conocimiento en este README que explica el modelo de carga (
load_knowledge_pack({source: "<url-or-path>", scope: ...})), los tres paquetes iniciales + Higgsfield, la semántica de alcance y cómo contribuir. - Nueva
packs/README.md— guía de autoría de paquetes (esquema de frontmatter, límites de fragmentos, estándar de calidad). Extraída del registro archivado para que el contenido no se pierda. - Redirección de lápida en el repositorio archivado. Cualquiera que visite
clarifyprompt-packsverá un banner que apunta aquí.
¿Cuándo volverá la división?
Cuando exista una función impulsora: una cola de PR comunitaria solo para paquetes, más de 20 paquetes o licencias/gobernanza divergentes. Hasta entonces, el costo de mantenimiento de mantener dos repositorios sincronizados no compensaba para una audiencia que no se había materializado.
Números
- Herramientas: 23 (sin cambios).
- Plataformas: 60+ (sin cambios).
- Paquetes de conocimiento incluidos: 4 (
anthropic-brand-voice,higgsfield-creative-handbook,nextjs-14-best-practices,sox-compliance) — igual que 1.6.2/1.6.3, ahora canónicos. - Fixtures de evaluación: 30 (sin cambios).
- Tamaño del tarball: sin cambios respecto a 1.6.3.
Novedades en 1.6.3
Parche. La ejecución de push de etiquetas CI de 1.6.2 reveló dos problemas reales, corregidos aquí sin cambiar ningún código del motor.
Corregido
evals/fixtures/28-context-includes-git-state.yamlanteriormente verificabagit_branch_present: true, pero GitHub Actions hace checkout en modo detached-HEAD dondebundle.git.branches correctamenteundefined(solo se completan el SHA y los commits recientes). Se relajó para verificar solobundle_has_git: true— que es lo que realmente es invariante en entornos locales y CI.evals/fixtures/17-critique-strong-prompt-accepts.yamlverificabaverdict: accept+overall_score_min: 7con un prompt fuerte. El juez de gpt-4o-mini calibra de forma más estricta que el de qwen2.5-coder:7b y ocasionalmente devolvía un campooverallmalformado que el parser convertía a 0 → veredicto=rechazo. La intención real del fixture es verificar el cableado del motor (5+ dimensiones, nombres de dimensiones estándar presentes, sin errores de harness), no comparar la calibración de jueces entre modelos. Se eliminaron las verificaciones de veredicto y puntuaciones estrictas; se mantuvieron las verificaciones a nivel de cableado.- Insignia Glama del README cambiada de
<img>en línea (a veces rota a través del proxy camo de GitHub) a una insignia de enlace de texto shields.io estable en todas las superficies de renderizado.
Notas
- Sin cambios en el código del motor. Sin nuevas herramientas MCP (siguen siendo 23). Sin cambios de plataforma (siguen siendo 60+). Sin cambios de variables de entorno.
- Líneas base de evaluación sin cambios en Ollama local. Esto es un endurecimiento específico de CI: las ejecuciones locales contra qwen-coder-7b produjeron los mismos resultados antes y después.
- La falla de la puerta de publicación CI que apareció en el push de la etiqueta v1.6.2 fue posterior a la falla de evaluación (el paso
Wait for evals workflowbloqueó la publicación). Ahora que los fixtures subyacentes no fallan falsamente en gpt-4o-mini + CI detached-HEAD, la puerta de publicación también se despeja.
Novedades en 1.6.2
Parche. Dos envíos aditivos, ambos sin cambios de código desde la perspectiva del motor:
Paquete de conocimiento del manual creativo de Higgsfield
packs/higgsfield-creative-handbook.md — un paquete markdown de estilo comunitario que documenta las convenciones reales de Higgsfield: reglas de selección de modelos (cuál de los 13 modelos para cada caso de uso), flujo de trabajo de entrenamiento de personajes Soul ID, vocabulario de movimientos de cámara, patrón de estructura de prompts (prosa de formato largo, no etiquetas de palabras clave), edición multirreferencia, modos de Marketing Studio, errores comunes (no traducir los flags de Midjourney literalmente), especificaciones de salida.
Cárgalo explícitamente:
load_knowledge_pack source="https://raw.githubusercontent.com/LumabyteCo/clarifyprompt-mcp/main/packs/higgsfield-creative-handbook.md"
…o, dado que se distribuye en el tarball de npm, apunta a la copia instalada. El Context Curator fundamenta los prompts dirigidos a Higgsfield en los fragmentos de este paquete automáticamente mediante recuperación semántica. Consulta la sección Paquetes de conocimiento para el modelo completo de carga y alcance.
npm run matrix — ejecutor de matriz de evaluación multimodelo
evals/matrix.mjs ejecuta npm run eval secuencialmente contra N modelos y combina los resultados en un HTML comparativo lado a lado (evals/matrix.html por defecto). Activa los fixtures con puerta de clase de modelo (shape-small-local-model / shape-mid-tier-model / shape-reasoning-model) que las ejecuciones de un solo modelo omiten, y expone diferencias como "qwen-7b falla analyzer-creative-media pero gpt-4o-mini lo aprueba" de un vistazo.
npm run matrix -- --models qwen2.5-coder:7b-instruct-q4_K_M,gpt-oss:20b-cloud,glm-5.2:cloud
Genera una tabla de tema oscuro: filas = fixtures, columnas = modelos, celdas = aprobado / fallido / omitido / error con tooltips que muestran qué verificaciones fallaron.
Corrección complementaria: evals/run.mjs gana un flag --json-out <path> que escribe resultados estructurados por modelo (matrix.mjs lo usa; los agentes de CI también pueden usarlo).
Números
- Sin cambios en la superficie de herramientas. Siguen siendo 23 herramientas MCP.
- Sin cambios en el recuento de plataformas. 60+ plataformas (
packs/platforms/*.yamlsin cambios). - 30 → 30 fixtures (sin nuevos fixtures; la matriz es herramienta, no cobertura).
- El tarball crece ~10 KB por el paquete de conocimiento.
evals/matrix.mjsNO está en el tarball — es una herramienta de mantenedores/contribuidores, no un artefacto de ejecución.
Novedades en 1.6.1
Lanzamiento de parche. Añade Higgsfield como plataforma objetivo en las categorías image y video. Sin cambios de código — solo adiciones puras de paquetes de plataforma YAML y un fixture de evaluación.
Higgsfield es una plataforma creativa multimodelo que expone su propio servidor MCP en https://mcp.higgsfield.ai/mcp. Dentro de una conexión obtienes:
- Imagen: Soul 2.0, Soul Cinema, Soul Cast (consistencia de personaje), Flux 2, Seedream 5, Nano Banana Pro, GPT Image 2
- Video: Cinema Studio, Veo 3.1, Kling 3.0, WAN 2.6, Seedance 2.0 (Sora 2 eliminado el 2026-09-24 — OpenAI cerró la API de Videos sin reemplazo)
- Flujos de trabajo: entrenamiento de personajes Soul ID, Lipsync Studio, UGC Factory, Marketing Studio, virality_predictor
Las entradas de plataforma ClarifyPrompt 1.6.1 exponen los identificadores de modelo y las convenciones de estilo de prompts de Higgsfield (prosa natural de formato largo; composición + iluminación + texturas + ambiente; hasta imágenes 4K / video de 15 s / Soul ID para consistencia de personaje) como sugerencias de sintaxis para el curador.
Patrón recomendado: instala tanto clarifyprompt-mcp COMO el MCP de Higgsfield en tu cliente (Claude Desktop / Cursor / AI Butler / Claude Code). Usa optimize_prompt(platform: 'higgsfield', ...) o compose_prompt(platform: 'higgsfield', ...) para compilar, luego pasa el prompt compilado a la herramienta generate_image / generate_video de Higgsfield. Los MCP se componen en el cliente; ClarifyPrompt permanece en la capa de "compilación".
29 → 30 fixtures de evaluación. Misma superficie de herramientas MCP que 1.6.0 (23 herramientas, 1 recurso). Sin cambios de variables de entorno.
Novedades en 1.6.0
Cuatro adiciones específicas en los cuatro pilares del motor (memoria / agéntico / modelos / contexto), cada una respaldada por fixtures de evaluación reales. 3 nuevas herramientas MCP (23 en total). Totalmente compatible con 1.5.x — sin herramientas eliminadas, sin campos eliminados, sin cambios obligatorios de variables de entorno.
Memoria — CRUD explícito de hechos (memory_remember, memory_forget, memory_list_facts)
Antes de 1.6, los hechos solo entraban en la memoria persistente mediante reflexión sobre save_outcome — implícito, extraído por LLM, después del hecho. 1.6 añade la ruta explícita:
memory_remember— inserta directamente un triple(subject, predicate, object)con confianza explícita. Fuente etiquetadauser:explicit. Auto-embedido para recuperación semántica futura.memory_forget— soft-delete (bi-temporalinvalidated_at) de un hecho por id. Idempotente: re-olvidar un hecho ya invalidado es un no-op y devuelvesuccess: falselimpiamente.memory_list_facts— lista hechos vivos en un alcance (por defectouser), opcionalmente filtrados por predicado. Ordenados por más recientemente observado.
Esto cierra la brecha de UX obvia donde el motor solo podía aprender de resultados — ahora los usuarios pueden decir "recuerda que prefiero X" directamente.
Agéntico — nuevo bucle de revisión max_iterations de compose_prompt
compose_prompt solía revisar una vez (el improvedPrompt de la crítica reemplazaba la optimización, si el veredicto no era accept). 1.6 añade un bucle:
{ "prompt": "...", "post_critique": true, "auto_revise": true, "max_iterations": 3 }
Cada iteración después de la primera re-ejecuta optimize + critique sobre el prompt mejorado de la iteración anterior. Se detiene en verdict=accept, sin improvedPrompt para retroalimentar, o en el límite. pre_clarify solo se ejecuta una vez (no tiene sentido volver a preguntar en una reescritura). La respuesta incluye un nuevo campo iterations que muestra cuántas se ejecutaron. Límite máximo de 5 para prevenir costos descontrolados.
Modelos — enrutamiento de modelos por etapa
Cada etapa de composición puede ahora apuntar a un modelo diferente:
{
  "prompt": "...",
  "clarify_model": "qwen2.5-coder:7b-instruct-q4_K_M",
  "optimize_model": "claude-sonnet-5",
  "critique_model": "gpt-4o-mini"
}
Ejecuta clarify en un modelo local barato, optimiza en el modelo frontera de gran presupuesto, critica en el juez barato. La anulación fluye a través de cada capa — optimization.metadata.model y critique.judgeModel en la respuesta reflejan el modelo real que ejecutó cada etapa.
Contexto — señales de estado de git + entorno
Dos nuevos recolectores de señales alimentan el Context Curator:
bundle.git— rama actual, SHA corto, flag de sucio, últimos 5 títulos de commits. Permite que el motor fundamente prompts en "en qué estás iterando" sin que lo escribas. Detectado mediantegit rev-parse/git status/git log; falla suavemente cuando el cwd no es un repositorio.bundle.environment—nowIso/weekday/timezone(IANA deIntl.DateTimeFormat). Ayuda con prompts sensibles al tiempo ("envía este correo mañana"). JS puro, nunca falla.
Ambos son candidatos de baja utilidad en el curador (no dominarán el presupuesto) pero aparecen como fuentes de fundamentación cuando es relevante.
Cobertura de evaluación
23 → 29 fixtures (6 nuevos):
- 24
memory-remember-persists/ 25memory-forget-invalidates— round-trip CRUD Me1 - 26
compose-loop-iterates— infraestructura de bucle A1 (nuevas verificacionesiterations_min/iterations_max) - 27
compose-per-stage-models-honored— enrutamiento por etapa M1 (nuevas verificacionesoptimization_model_eq/critique_model_eq) - 28
context-includes-git-state/ 29context-includes-environment-time— señales C1 + C4 (nuevas verificacionesbundle_has_git/bundle_has_environment/git_branch_present)
Línea base local en qwen2.5-coder:7b: 25 aprobados / 1 fallido / 3 omitidos / 97% promedio. La única falla sigue siendo la señal persistente de clase de modelo analyzer-creative-media (sin tocar).
Novedades en 1.5.2
La primera versión donde la puerta de evaluación de CI (contra gpt-4o-mini) impulsó el diff. Tres correcciones reales que la puerta detectó en cuanto conectamos el secreto OPENAI_API_KEY:
- El almacén de memoria ahora admite cualquier dimensión de embedding (#2). La tabla vec persistente estaba codificada a 768 dimensiones (el valor predeterminado de nomic-embed-text), por lo que cualquiera que configurara
EMBED_MODEL=text-embedding-3-small(1536),voyage-3(1024),embed-english-v3.0(1024) o cualquier otro modelo que no fuera de 768 dimensiones encontraríaDimension mismatch: expected 768, got Nen la primera llamada amemory_search. El almacén ahora deriva el nombre de la tabla de la dimensión real del embedder y crea la tabla específica de dimensión al arrancar. Las instalaciones existentes de 768 dimensiones no se ven afectadas. - Anulación de variable de entorno
LLM_TIMEOUT_MSen el cliente LLM. El valor predeterminado sigue siendo 30 s; los usuarios con modelos alojados lentos pueden aumentarlo. El flujo de trabajo de evaluación usa 120 s paragpt-4o-mini. - Arnés de evaluación reforzado — ya no falla cuando una herramienta lanza una excepción (el SDK devuelve respuestas de error en texto plano; el arnés solía
JSON.parsey morir). Un fixture defectuoso ya no hunde toda la ejecución. - Insignia de evaluaciones en vivo. El flujo de trabajo
evals.ymlse ejecuta en cada push a main. La insignia[![evals]](...)en la parte superior de este README es su estado en tiempo real. Actualmente verde en 20/0/3 · 100% engpt-4o-mini.
Sin nuevas herramientas MCP. Sin cambios en la superficie de variables de entorno (solo una LLM_TIMEOUT_MS opcional añadida). Totalmente compatible con 1.5.x.
Novedades en 1.5.1
Un lanzamiento de parche sobre 1.5.0. Solo mejoras de documentación y del proceso de publicación; el comportamiento en tiempo de ejecución es idéntico a 1.5.0.
- Superficies de marketing del README actualizadas — el lanzamiento de 1.5.0 se publicó con el README aún en 1.4.0 en tres lugares (cita destacada, encabezado "Novedades en X", anotación "acumulado hasta X"). Todas las demás superficies de versión (
package.json,package-lock.json,server.json,src/index.ts,CHANGELOG) eran correctas, pero la prosa se desvió porque nada automatizado la tocaba. 1.5.1 lo corrige. - Dos nuevas auditorías de verificación de publicación —
CP-11(coherencia de la superficie de marketing del README) falla de forma estricta si alguna de las tres anteriores no hace referencia a lapackage.json#versionactual.CP-12(validez del formato del paquete de plataforma) analiza cadapacks/platforms/*.yamly verifica la validez del esquema. CP-11 se promovió a la habilidad de verificación de publicación con ámbito de usuario (entre proyectos) el mismo día, por lo que los proyectos futuros también se benefician. - Sin cambios de código. Sin nuevas herramientas MCP. Sin nuevas variables de entorno. Misma anatomía de tarball que 1.5.0 más unos pocos cientos de bytes de CHANGELOG.
Novedades en 1.5.0
Las plataformas integradas se vuelven declarativas. Las más de 58 matrices de plataformas TypeScript codificadas pasan a packs/platforms/*.yaml — añadir una plataforma integrada ahora es una edición YAML, no una edición TS. La capa TypeScript se convierte en un cargador en tiempo de ejecución con una tabla de respaldo codificada. Un YAML malformado nunca puede dejar el servidor inutilizable.
packs/platforms/
  chat.yaml       9 platforms
  code.yaml       9
  document.yaml   8
  image.yaml     10
  music.yaml      4
  video.yaml     11
  voice.yaml      7
  README.md      contributor docs
Para añadir una nueva plataforma integrada: añade una entrada al archivo de categoría correspondiente, ejecuta npm run build, abre un PR. No se requiere edición TS. La plataforma personalizada vía runtime (register_platform) sigue funcionando de forma idéntica para plataformas instaladas por el usuario.
- Cobertura de evaluación de la capa de memoria. El arnés de evaluación ahora admite
setup: [{tool, args}, ...]— una lista de llamadas a herramientas MCP ejecutadas ANTES delinputprincipal. Dos nuevos fixtures lo usan: uno carga un paquete de conocimiento en línea y verifica que el fragmento aparezca engrounding.sourcesdespués del pipeline embed → store → retrieve → curate → ground; el otro demuestra la calidad de clasificación de la búsqueda vectorial. 23 fixtures en total (eran 20 en 1.4.0). - Modernización de la infraestructura de pruebas. Las baterías de pruebas de integración y Day-2 solían verificar cadenas de versión literales (
1.3.0,16 tools) y se rompían en cada incremento. Ahora leenEXPECTED_VERSIONdesdepackage.jsony verifican la presencia de un conjunto de herramientas en lugar de un recuento de herramientas. Los futuros incrementos no rompen las pruebas. - Materiales de adopción.
docs/adoption/incluye cuerpo de Show HN listo para copiar y pegar, publicaciones de Reddit, hilo de Twitter, plantilla de PR para awesome-mcp-servers y especificaciones de envío a catálogos (mcp.so, Smithery, mcp-get, PulseMCP, modelcontextprotocol/servers). - Una nueva dependencia de runtime:
js-yamlpromovida de devDependency para el cargador de plataformas (~200 KB). - Misma superficie de herramientas MCP que 1.4. 20 herramientas, 1 recurso. Sin herramientas nuevas; sin herramientas eliminadas; las formas de los resultados no cambian.
Anteriormente en 1.4.0 — el pipeline componible
Cuatro operaciones principales como herramientas MCP de primera clase que se componen. Usa cualquier herramienta de forma independiente o ejecuta toda la cadena en una sola llamada:
  ┌─────────────┐     ┌─────────────────────┐     ┌──────────────┐
  │  clarify    │ →   │  ground OR optimize │ →   │   critique   │
  │  (optional) │     │       (core)        │     │  (optional)  │
  └─────────────┘     └─────────────────────┘     └──────────────┘

  one call = compose_prompt(prompt, [sources], post_critique, auto_revise, ...)
clarify_with_user— Dado un borrador ambiguo, devuelve 1–3 preguntas de aclaración específicas, cada una con unsuggested_answerque puedes aceptar textualmente, 2–4optionsopcionales de selección rápida y una etiquetadimension(audiencia/alcance/formato/longitud/tono/restricciones/objetivo/plataforma). Se corta conclarificationNeeded: falseen prompts confiables y bien formados para que se integre limpiamente delante deoptimize_promptsin una penalización de latencia por llamada.ground_prompt— La variante estricta con recuperación aumentada deoptimize_prompt. Las fuentes proporcionadas por el llamador se fijan en la prioridad más alta — por encima de las reglas del proyecto, por encima de las instrucciones fijadas — y se rastrean individualmente en el trace comouser-source:N. Modo estricto: cero fuentes no vacías → error, sin fallo silencioso. Límite de cuerpo por fuente (4000 caracteres) para que un solo pegado enorme no domine el presupuesto.critique_prompt— LLM como juez. Puntúa un prompt candidato de 0–10 en 5 dimensiones predeterminadas (claridad, especificidad, alineación_de_intención, adecuación_de_formato, adecuación_de_longitud) — o tus propios criterios — con justificación por dimensión + sugerencias concretas, una puntuación general y un veredicto (accept/revise/reject). Por debajo derevise_threshold(predeterminado 7.0) también devuelve unimprovedPromptque puedes incorporar. Úsalo antes del vuelo ("¿es este prompt lo suficientemente bueno para el modelo caro?"), en el análisis posterior ("¿fue el prompt la causa?") o para elegir por A/B la mejor de N variantes de optimización.compose_prompt— Una llamada MCP ejecuta el pipeline canónico. Decide automáticamente la rama ground vs. optimize según si pasastesources.pre_clarify: 'auto' | 'always' | 'never'.post_critique: trueañade una pasada de juez.auto_revise: truereemplazafinal_promptcon la reescritura cuando el veredicto no esaccept. Devuelve un array de auditoríastagespor etapa para que el llamador vea exactamente qué se ejecutó.- Arnés de evaluación v0 — Pruebas de regresión deterministas bajo
evals/. 20 fixtures YAML cubren las superficies de analizador, forma, superposición de intención, grounding, aclaración, crítica, ground y compose.npm run evalproduce un resumen de consola + un informe HTML autónomo de tema oscuro. La matriz multimodelo es solo bash: ejecutaLLM_MODEL=... npm run eval -- --report-path evals/report-X.htmlpor modelo. - Evaluaciones con puerta CI (opt-in) — Cuando
OPENAI_API_KEYse establece como secreto del repositorio, el arnés de evaluación se ejecuta en CI contragpt-4o-minicomo puerta de lanzamiento. Desactivado por defecto; nada sale de tu máquina sin el secreto. - 5 nuevas herramientas MCP (20 en total).
optimize_prompttambién gana un punto de inyecciónuserProvidedSources— tantoground_promptcomocompose_promptlo usan internamente, pero está disponible directamente si quieres control explícito sin la validación de modo estricto.
Trasladado desde 1.3: memoria persistente + paquetes de conocimiento + aprendizaje reflexivo. El curador continúa puntuando y ajustando las fuentes de grounding en la ventana restante del modelo objetivo.
explain_last_curationtodavía te da un desglose por llamada de candidatos seleccionados vs. rechazados con razones.
Qué incluye (acumulado hasta 1.16.0)
- Motor de contexto — recopila automáticamente reglas del espacio de trabajo (
CLAUDE.md,AGENTS.md,.cursorrules,.clinerules,clarify.md), detecta frameworks y lenguajes desdepackage.jsony manifiestos hermanos, rastrea un extracto del archivo activo y mantiene un búfer circular por sesión de optimizaciones recientes y sus resultados. PromptAnalyzerunificado — una llamada LLM produce{ category, intent, recommendedMode, confidence }juntos. 10 intenciones:production-code,brand-voice,stakeholder-comm,data-extract,creative-media,technical-spec,analysis,quick-draft,exploration,unknown. La intención supera a las palabras clave de superficie en caso de ambigüedad.- Conformación de prompts consciente del modelo objetivo — el prompt del sistema,
maxTokensytemperaturese adaptan a la ventana de contexto del LLM descendente y a la intención resuelta. Los modelos locales pequeños reciben un prompt compacto; Claude/GPT-4/Gemini reciben toda la riqueza. - Contexto de grounding (único, ordenado por prioridad) — instrucciones fijadas por el usuario → reglas del proyecto → archivo activo → ejemplos aceptados anteriores → búsqueda web → metadatos del espacio de trabajo → pistas del modelo objetivo → instrucciones de plataforma personalizada → pistas de sintaxis integradas. Sin más silos de contexto paralelos.
- Recuperación de sesión (save_outcome) — el llamador informa
accepted | edited | rejectedpor optimización; las salidas aceptadas similares en la misma sesión se inyectan como ejemplos few-shot en futuros prompts similares. Respaldado por memoria persistente (SQLite + sqlite-vec), por lo que los resultados aceptados sobreviven a los reinicios. - Trazado JSONL local — cada optimización escribe una línea de trace estructurada (ahora con campos
shape,groundingSources,error) en$CLARIFYPROMPT_HOME/traces/YYYY-MM-DD.jsonl. No se sube nada. Alterna medianteCLARIFYPROMPT_TRACE=off. $CLARIFYPROMPT_HOMEunificado — una variable de entorno para todo lo que ClarifyPrompt escribe. LosCLARIFYPROMPT_CONFIG_DIR/CLARIFYPROMPT_DATA_DIRheredados siguen funcionando (aviso de obsolescencia, silenciable).- Tres transportes —
stdio(predeterminado),streamable-http(MCP sobre Nodehttp, sesiones con estado +/health) ya2a(un par Agente-a-Agente: tarjeta de agente, JSON-RPCmessage/send+ SSEmessage/stream, cancelación de tareas, aclaracióninput-required). Una variable de entornoCLARIFYPROMPT_TRANSPORT; el comportamiento de stdio es byte-idéntico al anterior. - 61 plataformas, 7 categorías, paquetes con fecha
verifiedAt, plataformas personalizadas — cada integrada verificada contra la documentación actual del proveedor al 2026-10-05, con nuevas plataformas (Seedance, ElevenLabs Music, Lyria) y Sora retirada. - Cualquier LLM, cualquier proveedor. Una sola ruta de código funciona con cualquier API compatible con OpenAI — Ollama (local + nube), LM Studio, vLLM, OpenAI, Google Gemini, xAI Grok, Groq, Mistral, DeepSeek, Cohere, Perplexity, Together, Fireworks, OpenRouter — además de Anthropic Claude directamente. Los modelos de razonamiento (
o1/o3/o4,deepseek-reasoner,gpt-oss,*-thinking) se detectan automáticamente y reciben un presupuesto de tokens mayor para que realmente produzcan contenido. Consulta más de 15 ejemplos de proveedores preconfigurados a continuación. - Apache-2.0, para siempre. Núcleo de código abierto, sin relicencias.
Inicio rápido
Con Docker
Extrae la imagen publicada del Registro de Contenedores de GitHub (multi-arquitectura: amd64 + arm64, con procedencia firmada + SBOM):
docker pull ghcr.io/lumabyteco/clarifyprompt-mcp:latest
Toda la configuración se pasa en tiempo de ejecución — nada está integrado en la imagen, por lo que es segura para compartir y no contiene secretos:
# stdio (for MCP hosts that launch the container)
docker run --rm -i \
  -e LLM_API_URL=http://host.docker.internal:11434/v1 \
  -e LLM_MODEL=qwen2.5:7b \
  -e CLARIFYPROMPT_HOME=/data \
  -v clarifyprompt-data:/data \
  ghcr.io/lumabyteco/clarifyprompt-mcp:latest

# or serve over HTTP / A2A
docker run --rm -p 3000:3000 \
  -e CLARIFYPROMPT_TRANSPORT=a2a -e CLARIFYPROMPT_HTTP_HOST=0.0.0.0 \
  -e LLM_API_URL=http://host.docker.internal:11434/v1 -e LLM_MODEL=qwen2.5:7b \
  ghcr.io/lumabyteco/clarifyprompt-mcp:latest
Monta un volumen en
CLARIFYPROMPT_HOMEpara persistir memoria, traces y paquetes entre ejecuciones. PasaLLM_API_KEY/EMBED_API_KEYcomo variables de entorno-e(o--env-file) en tiempo de ejecución — nunca los integres en una imagen.
Con Claude Desktop
Añade a tu claude_desktop_config.json:
{
  "mcpServers": {
    "clarifyprompt": {
      "command": "npx",
      "args": ["-y", "clarifyprompt-mcp"],
      "env": {
        "LLM_API_URL": "http://localhost:11434/v1",
        "LLM_MODEL": "qwen2.5:7b"
      }
    }
  }
}
Con Claude Code
claude mcp add clarifyprompt -- npx -y clarifyprompt-mcp
Establece las variables de entorno en tu shell antes de lanzar:
export LLM_API_URL=http://localhost:11434/v1
export LLM_MODEL=qwen2.5:7b
Con Cursor
Añade a tu .cursor/mcp.json:
{
  "mcpServers": {
    "clarifyprompt": {
      "command": "npx",
      "args": ["-y", "clarifyprompt-mcp"],
      "env": {
        "LLM_API_URL": "http://localhost:11434/v1",
        "LLM_MODEL": "qwen2.5:7b"
      }
    }
  }
}
Con AI Butler
AI Butler es un runtime de agente de IA personal autoalojado — un solo binario Go, chat multicanal, centro de ecosistema MCP. Coloca ClarifyPrompt en su configuración mcp.servers y el agente recoge las 23 herramientas como capacidades nativas, invocables desde cualquier canal (chat web, terminal, Telegram, Slack, etc.). AI Butler descubre herramientas dinámicamente vía tools/list de MCP, por lo que añadir / eliminar herramientas en ClarifyPrompt actualiza la superficie del agente automáticamente — sin necesidad de editar la configuración del butler.
Edita ~/.aibutler/config.yaml:
configurations:
  mcp:
    servers:
      - name: clarifyprompt
        command: clarifyprompt-mcp
        env:
          LLM_API_URL: "http://localhost:11434/v1"
          LLM_MODEL: "qwen3-vl:8b"
Reinicia AI Butler. El registro de arranque confirma que las herramientas están conectadas:
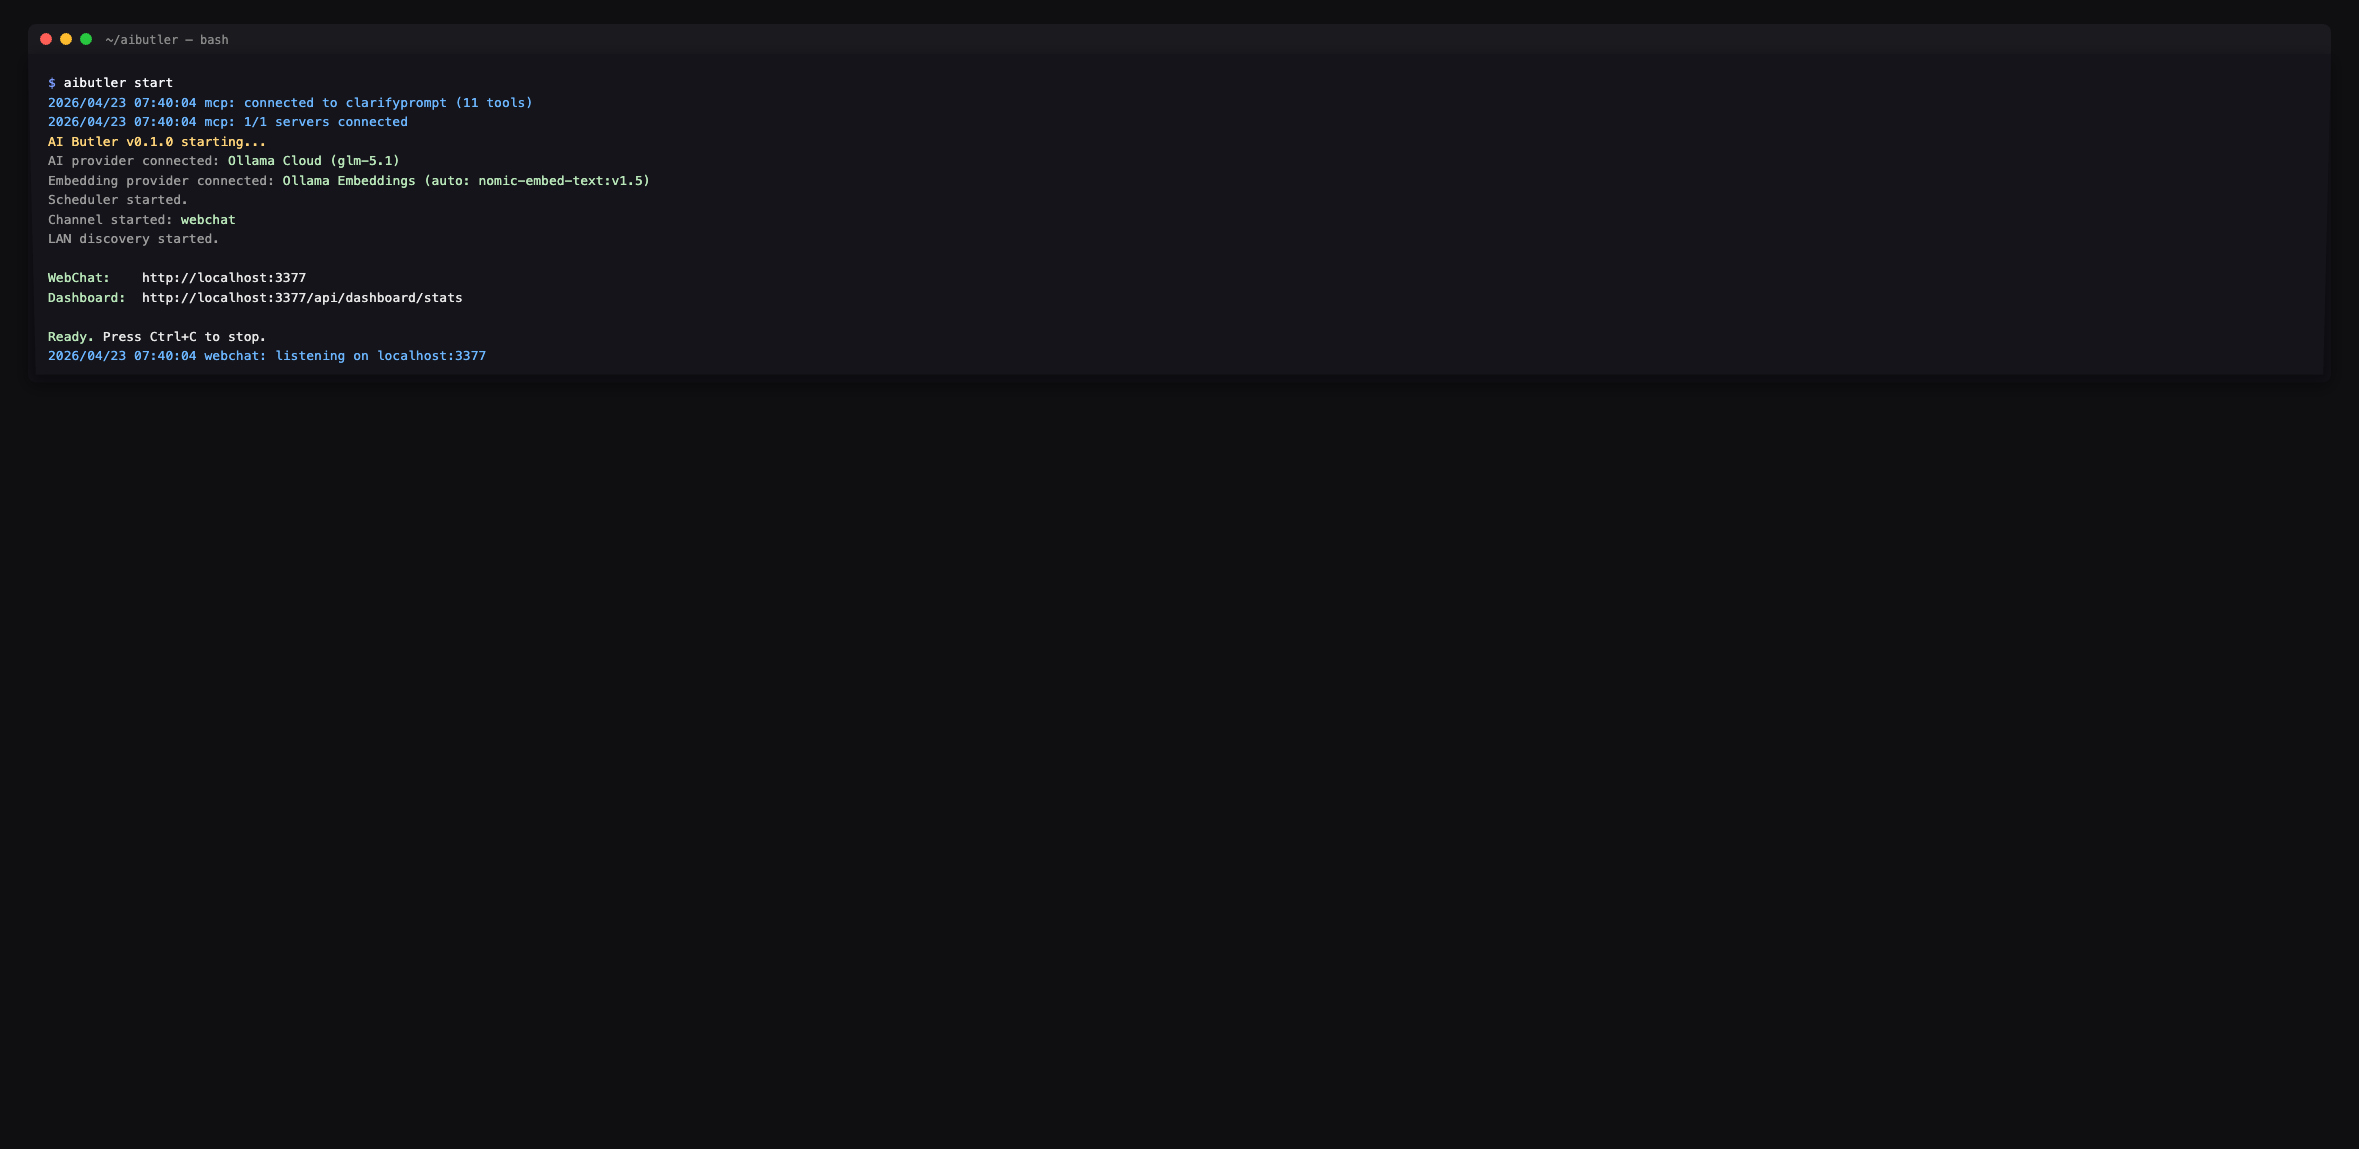 El agente enumera toda la superficie cuando se le solicita — cada herramienta con el prefijo
clarifyprompt.:
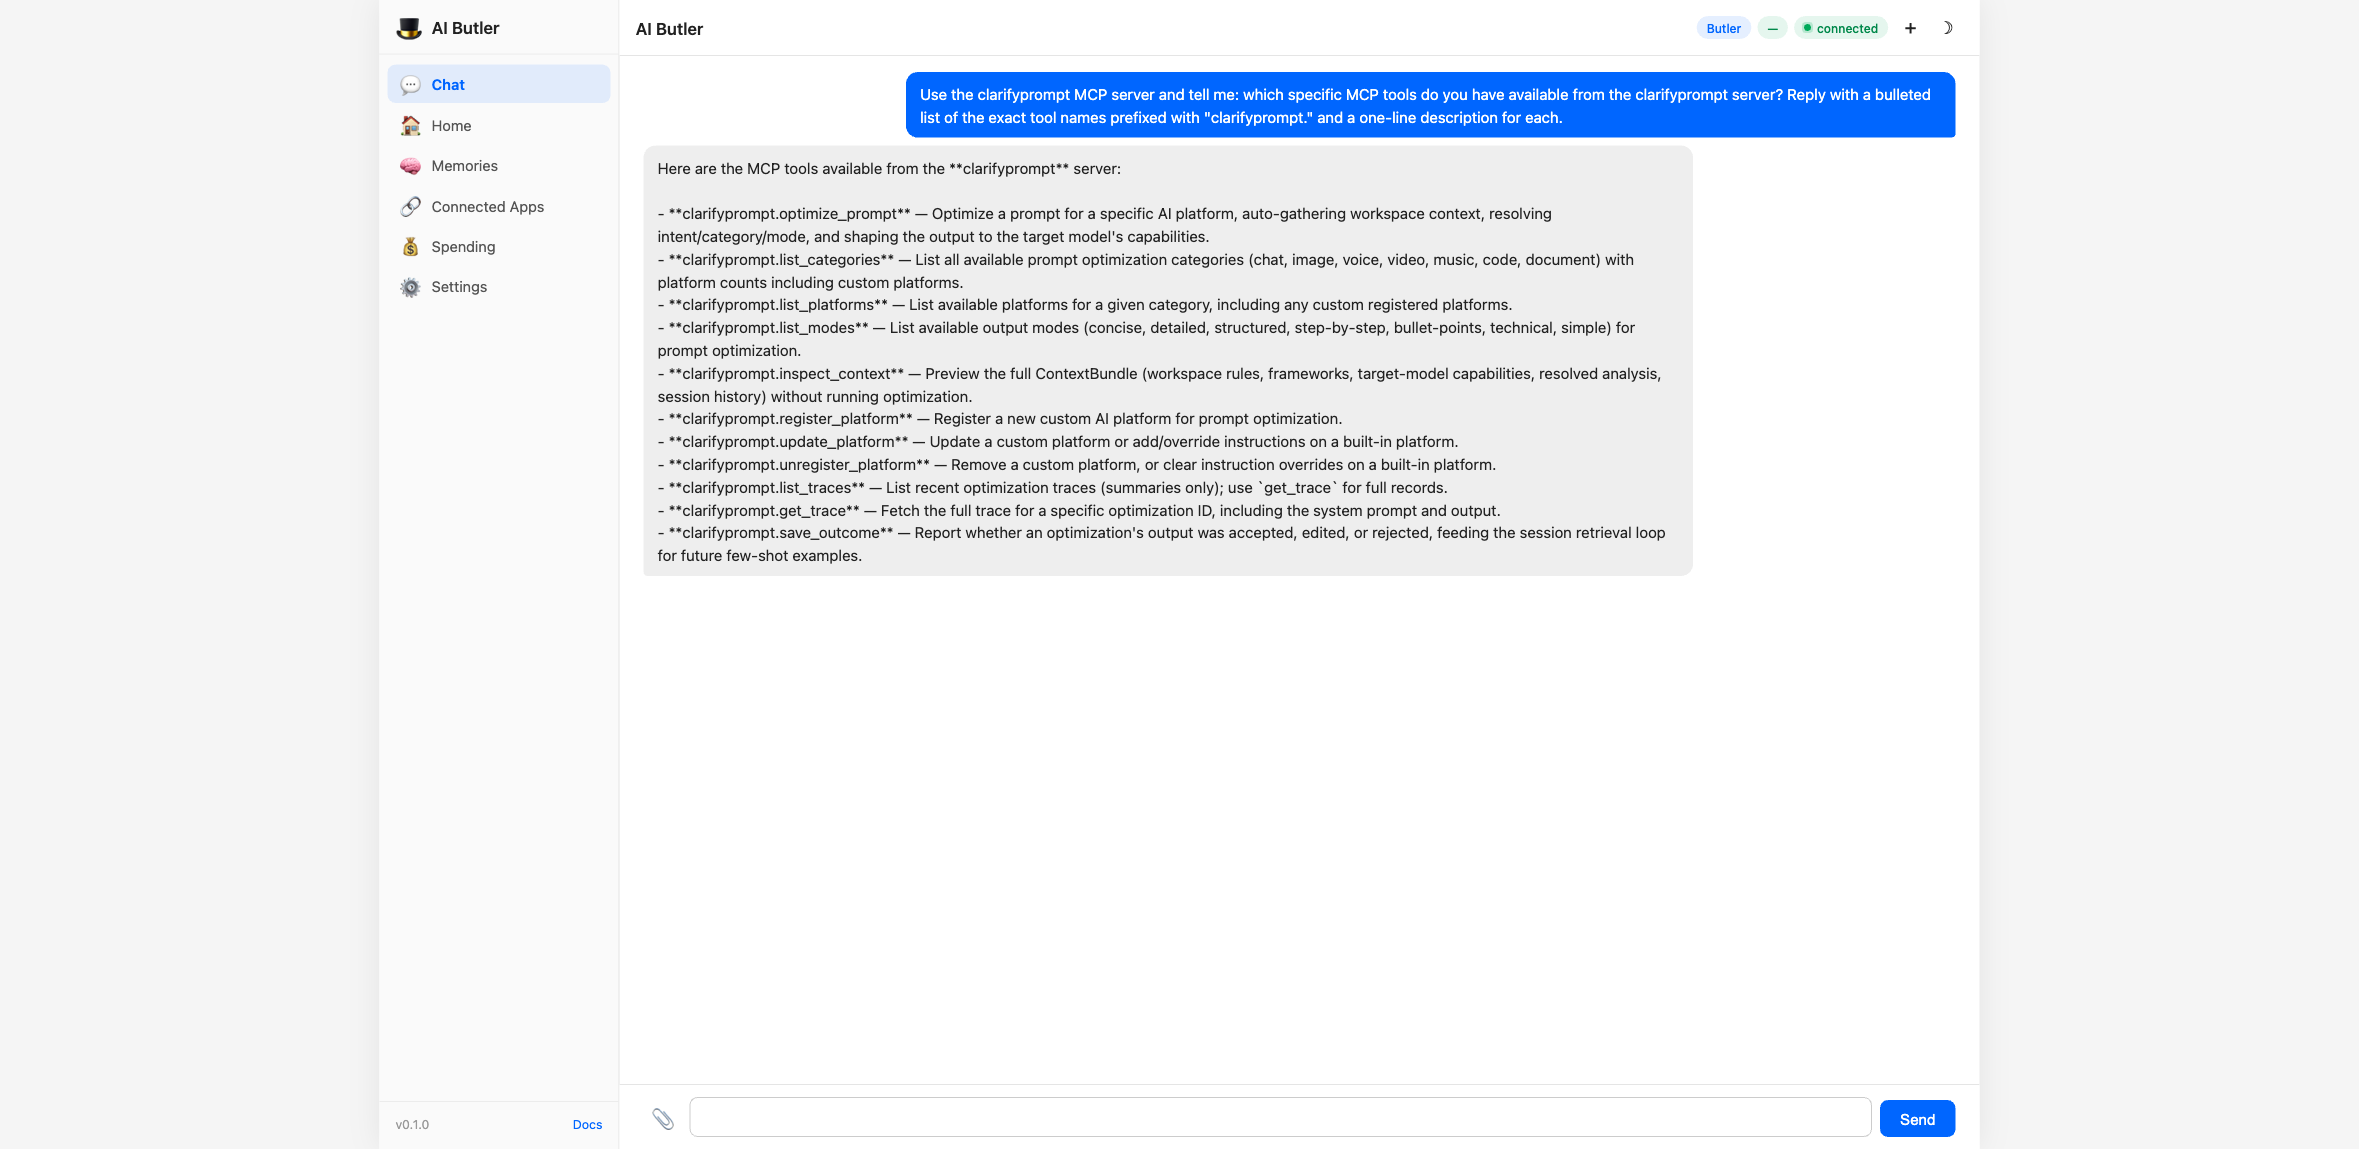
📸 Las capturas de pantalla anteriores son de una integración de la era 1.2 (11 herramientas). El
1.6.xactual expone 23 herramientas —optimize_prompt,clarify_with_user,ground_prompt,critique_prompt,compose_prompt, además de las herramientas de gestión / inspección / memoria (memory_search,memory_remember,memory_forget,memory_list_facts, herramientas de paquetes de conocimiento, trazas, plataformas personalizadas, etc.). AI Butler las detecta automáticamente mediante el descubrimientotools/listde MCP; no se necesitan cambios de configuración.
Impulsa el Context Engine de principio a fin
Puedes previsualizar lo que el motor recopilaría (sin ejecutar la
optimización) usando inspect_context:
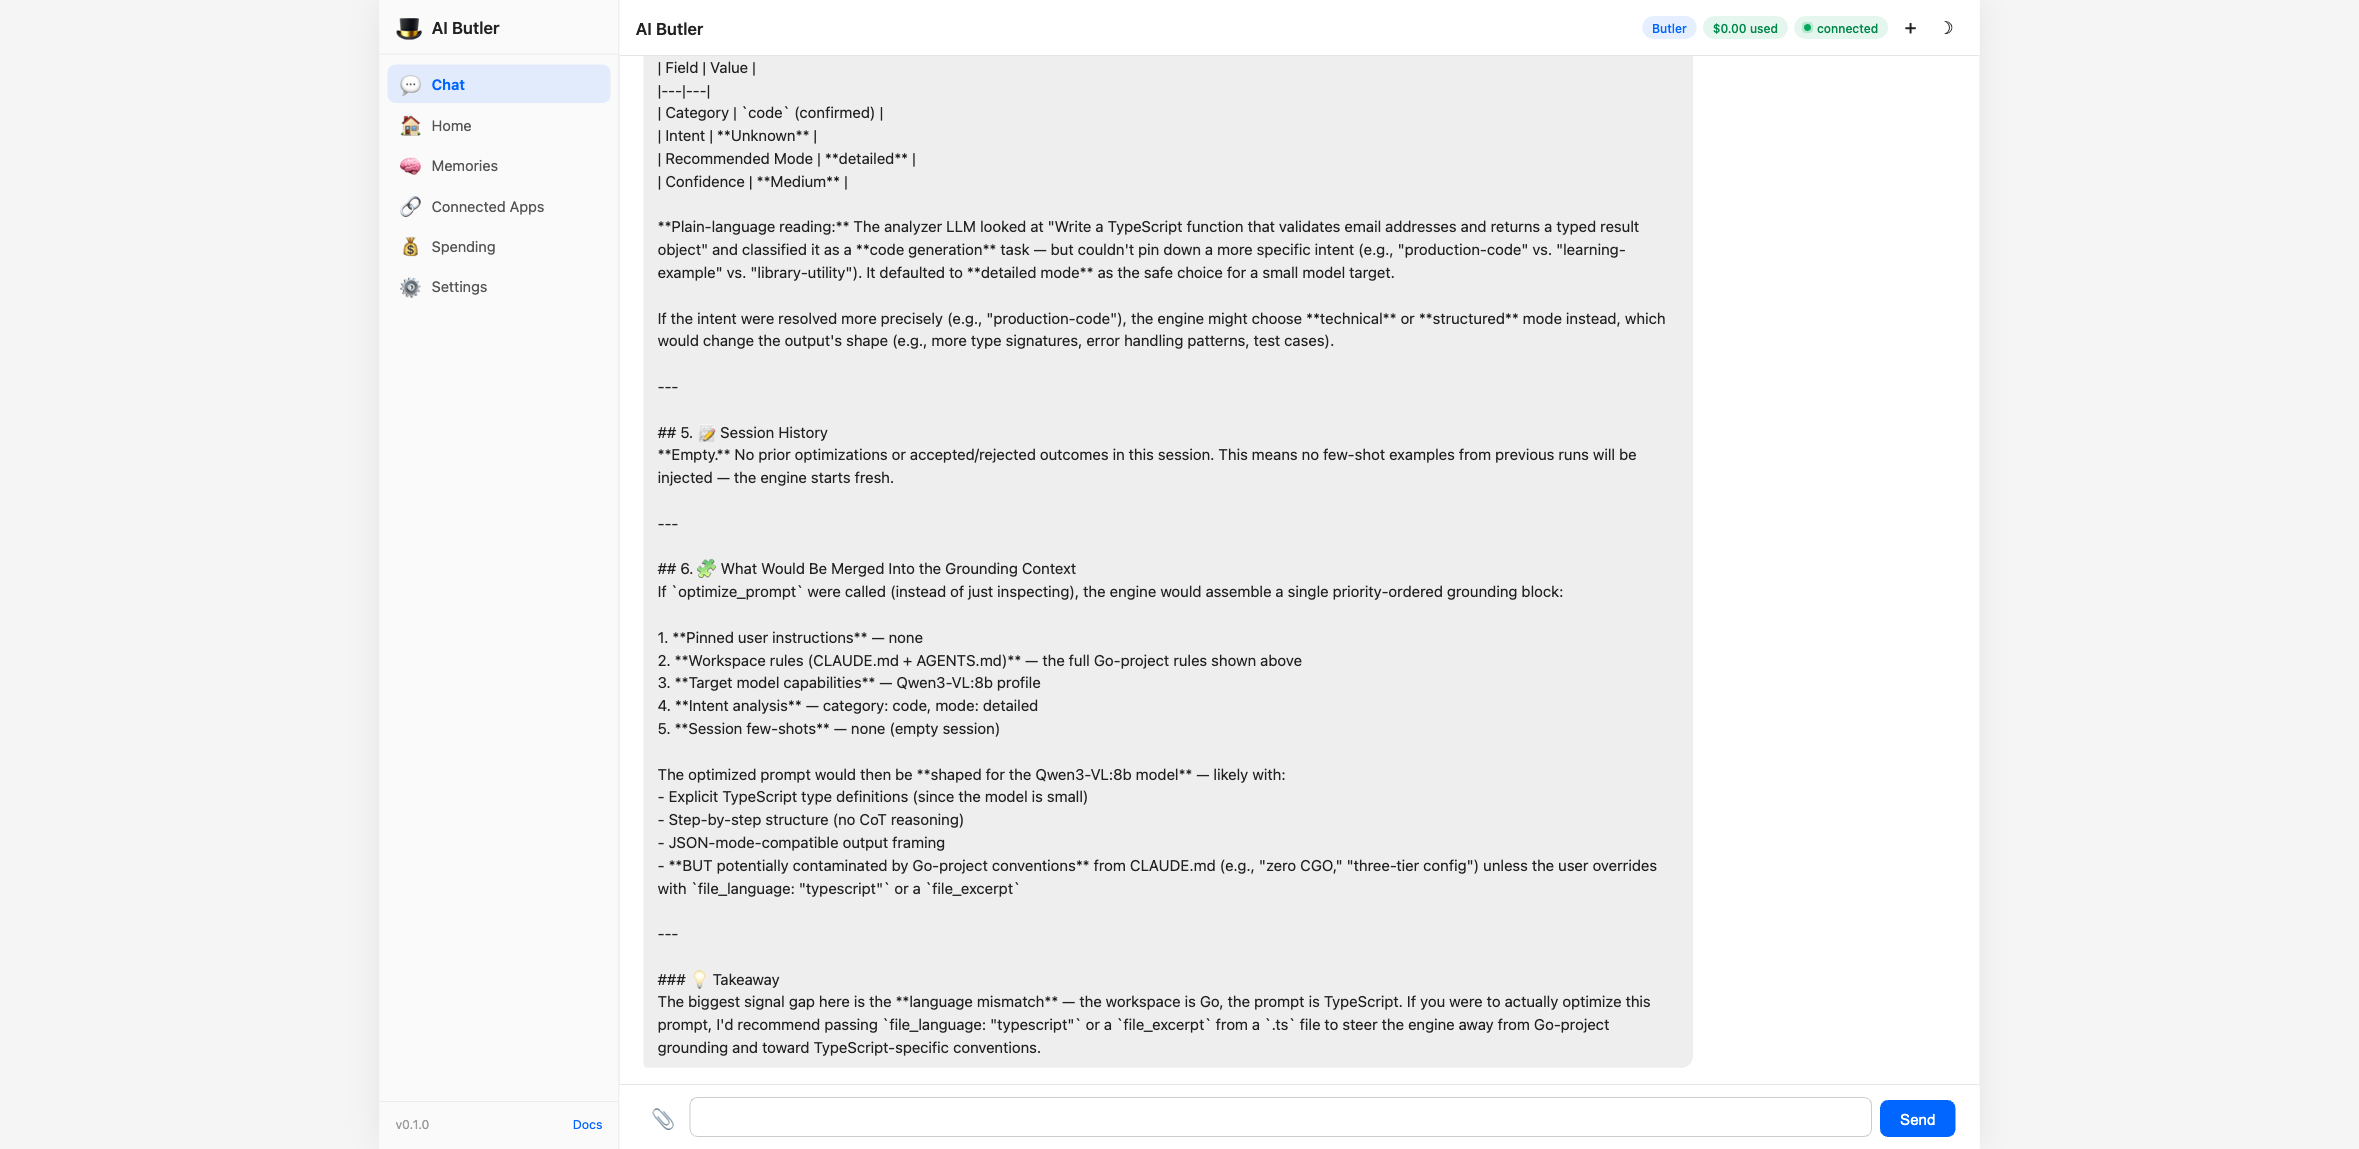
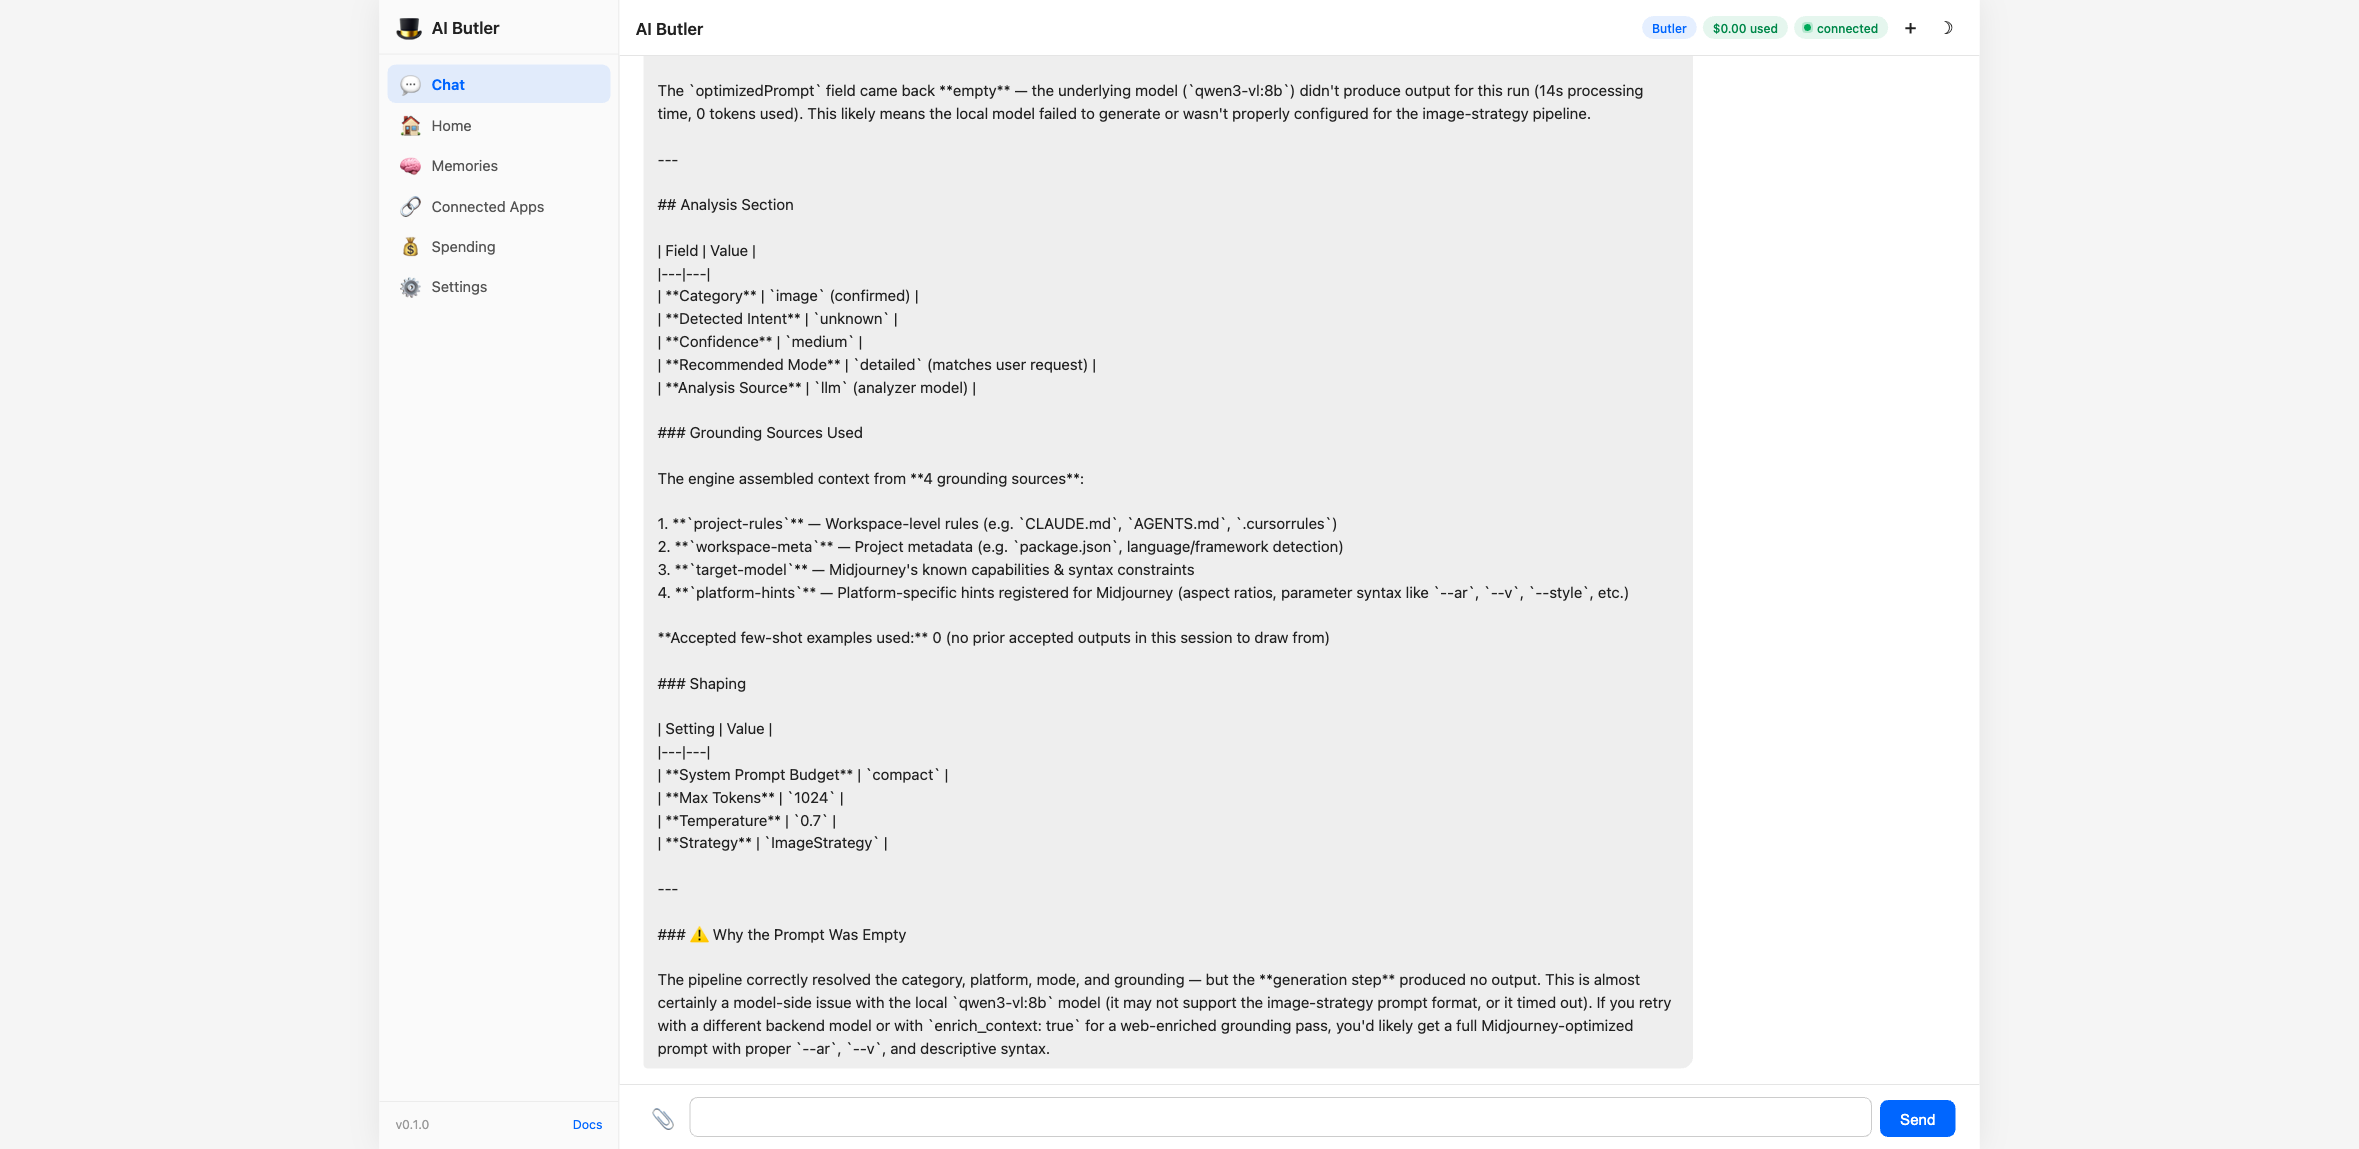
Luego ejecuta el optimizador real para cualquiera de las más de 60 plataformas compatibles:
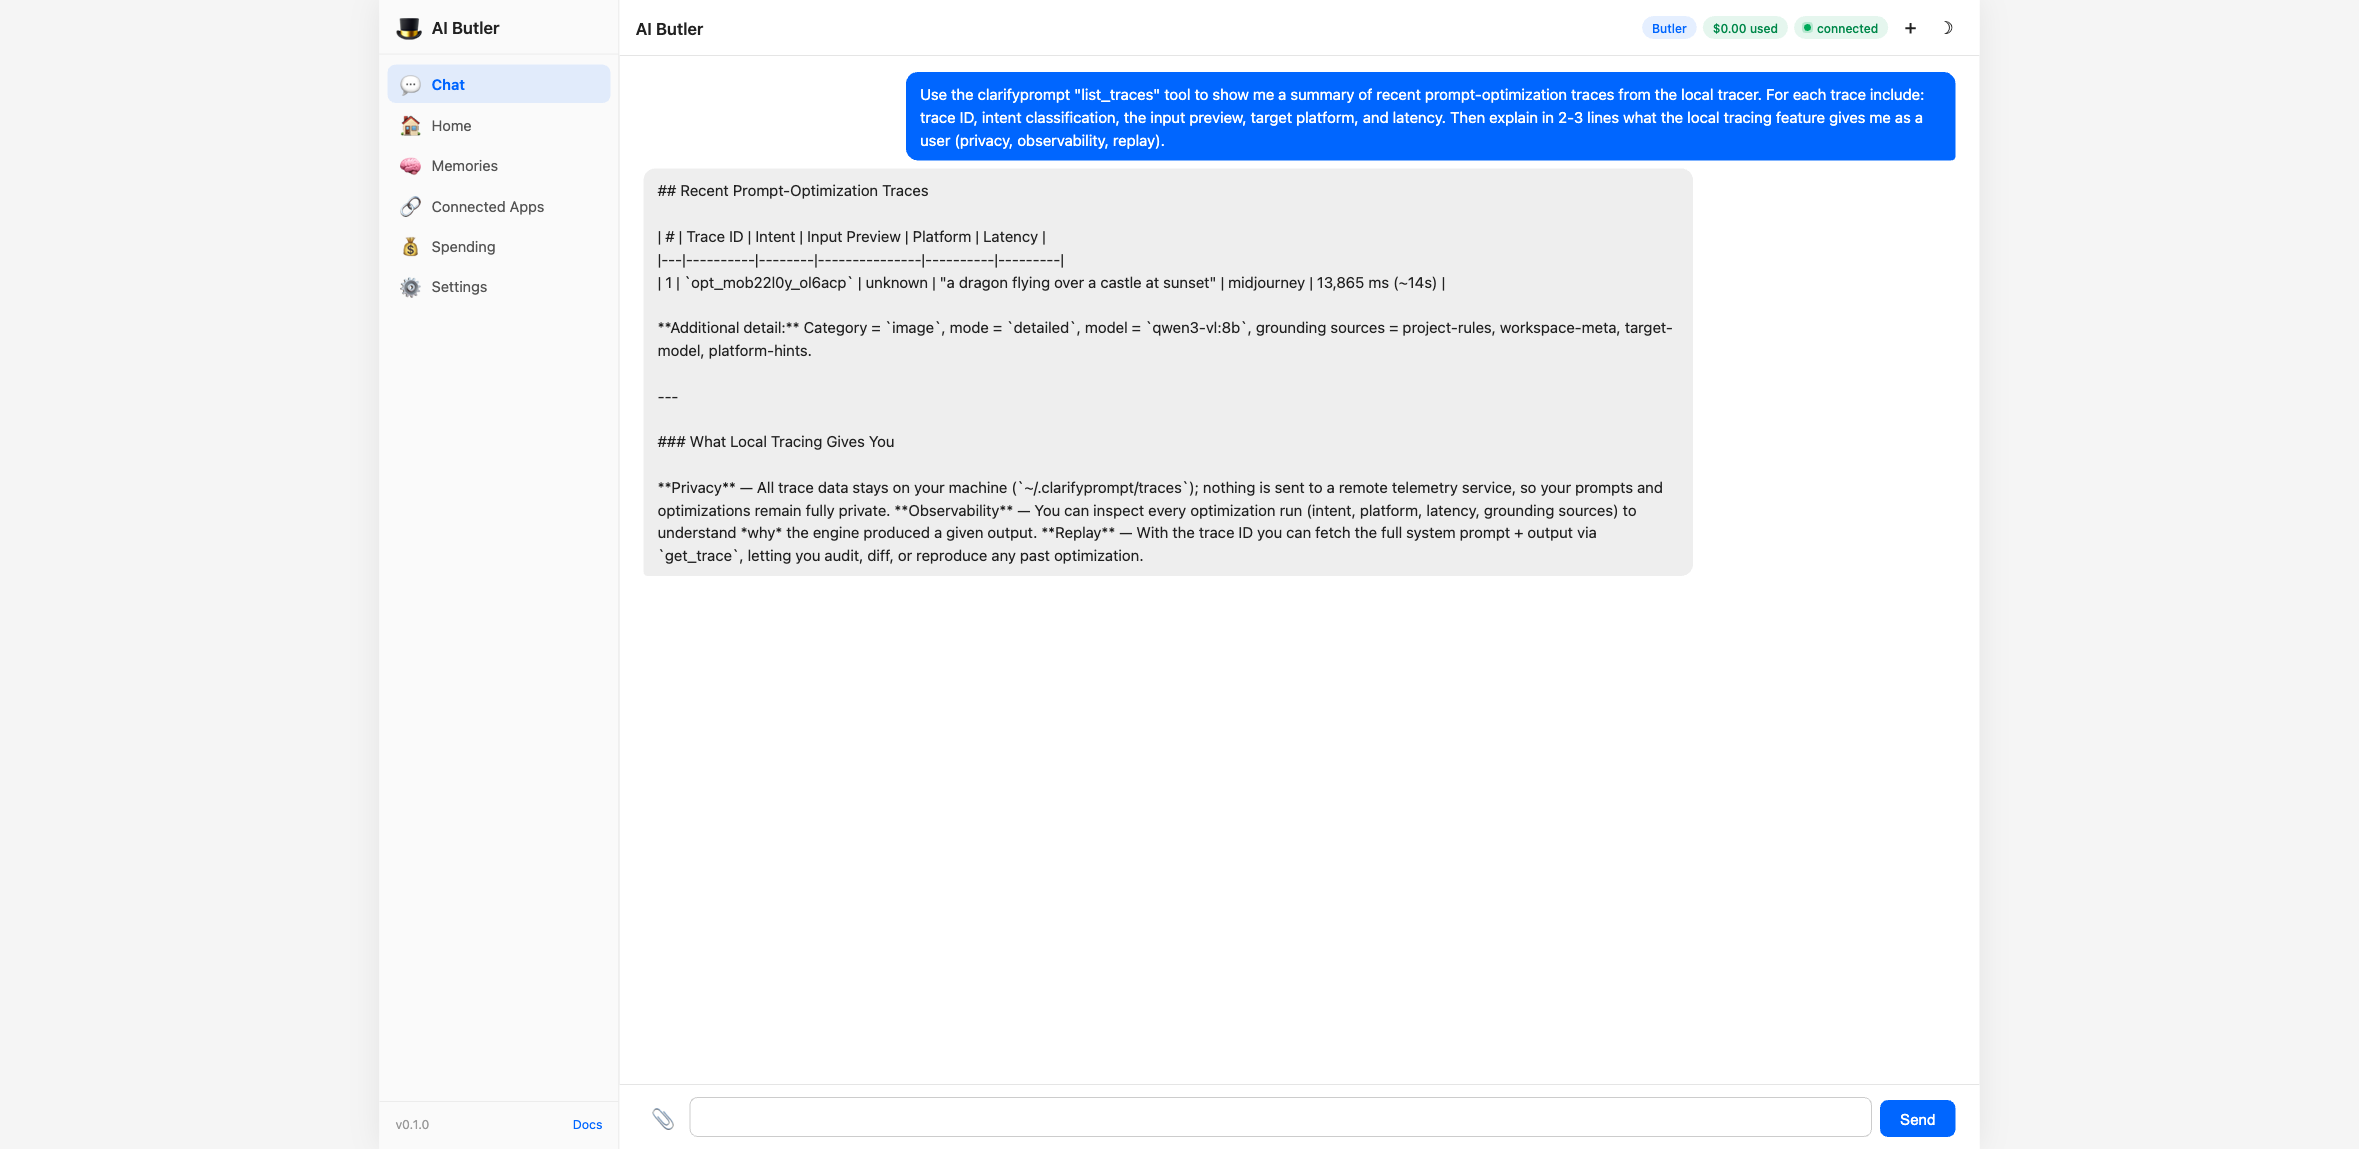
Cada optimización genera una única línea JSONL en
~/.clarifyprompt/traces/YYYY-MM-DD.jsonl — estrictamente local, nunca
subida. La herramienta list_traces convierte eso en un resumen consultable
con soporte de reproducción mediante get_trace:
El recorrido completo de integración — incluyendo las 11 herramientas manejadas desde el chat, opciones de configuración y ejemplos de uso en lenguaje natural — está en la documentación de AI Butler: Integrate an MCP Server.
Configuración y el panel de composición
Todo lo que necesitas para ejecutar el pipeline completo y (en hosts compatibles) ver el panel de resultados interactivo.
El modelo que hace el trabajo
ClarifyPrompt llama a un endpoint compatible con OpenAI o Anthropic, configurado mediante variables de entorno:
LLM_API_URL=http://localhost:11434/v1     # Ollama shown; any OpenAI-compatible URL works
LLM_API_KEY=                              # empty for local Ollama; a key for hosted providers
LLM_MODEL=qwen2.5:7b                      # the model that rewrites and judges
La salida depende del modelo — la estructura (la sintaxis de una plataforma, las dimensiones de crítica) es consistente entre modelos; la redacción exacta y las puntuaciones varían según el modelo.
Ejecuta todo el pipeline en una sola llamada
compose_prompt({
  "prompt": "write a product update email about our new dashboard",
  "platform": "claude",     // target a platform's tuning; omit for portable, neutral output
  "pre_clarify": "never",   // "auto" | "always" | "never"
  "post_critique": true     // adds the LLM-as-judge pass (verdict + the six score dimensions)
})
Devuelve { optimization: { id, sessionId, originalPrompt, platform, … }, finalPrompt, critique: { verdict, overallScore, dimensions[] }, stages[] }.
Seleccionar una plataforma
platform: (en optimize_prompt o compose_prompt) selecciona el ajuste de una plataforma — p. ej. midjourney, dall-e, veo, suno, claude, chatgpt, cursor (61 integradas, con fecha verifiedAt, + cualquier que registres). Para chat, las plataformas son los modelos (claude, chatgpt, gemini, llama, deepseek, …). Las categorías de texto (chat/document/code) producen salida portátil e independiente de la plataforma cuando omites platform — menciona una para optar por los modismos específicos de esa plataforma.
Modelos por etapa (p. ej. un modelo más potente como crítico)
compose_prompt puede enrutar cada etapa a un nombre de modelo diferente:
compose_prompt({
  "prompt": "…",
  "optimize_model": "qwen2.5:14b",   // rewrite on a cheaper model
  "critique_model": "gpt-4o",        // judge on a stronger one
  "clarify_model":  "qwen2.5:7b"
})
Importante: todos los nombres por etapa apuntan al mismo
LLM_API_URL— la anulación cambia solo el nombre del modelo, no el endpoint. Así que conLLM_API_URLapuntando a Ollama, cada modelo por etapa debe ser un modelo de Ollama; apuntando a OpenAI, cada modelo debe ser un modelo de OpenAI. Para mezclar proveedores de verdad (p. ej. un modelo local para optimizar +gpt-4opara criticar), apuntaLLM_API_URLa una puerta de enlace que sirva ambos nombres — OpenRouter, un proxy LiteLLM o cualquier enrutador compatible con OpenAI. (optimize_promptpor sí solo no tiene anulación de modelo por llamada; usaLLM_MODEL.)
El panel de composición interactivo (MCP Apps)
En hosts que admiten la extensión io.modelcontextprotocol/ui — Claude Desktop, Cursor, VS Code, … — compose_prompt renderiza un panel en vivo junto al resultado: tu prompt original, la salida optimizada (con un conmutador de diferencias show changes), una insignia for <platform> / general purpose, las seis barras de puntuación de crítica y las acciones Accept / Revise. Accept registra el resultado mediante save_outcome (alimentando el bucle de memoria few-shot); Revise envía tu comentario de vuelta al chat. Los hosts sin la extensión no se ven afectados — reciben el mismo texto + resultado structuredContent y sin panel.
Plataformas compatibles (61 integradas, con fecha verifiedAt, personalizadas ilimitadas)
| Categoría | Plataformas | Predeterminada |
|---|---|---|
| Imagen (12) | Midjourney (V8.x), OpenAI image (GPT Image 2/DALL-E 3), Stable Diffusion, Flux (2), Ideogram, Leonardo AI, Adobe Firefly, Grok Aurora, Google Imagen (4), Nano Banana, Recraft, Higgsfield | Midjourney |
| Video (12) | Runway (Gen-4.5), Pika (2.2), Kling (3.0/Omni), Luma (Ray 2), Minimax/Hailuo (2.3), Google Veo (3.1), Seedance (2.0/2.5), Wan (2.6), HeyGen, Synthesia, CogVideoX, Higgsfield | Runway |
| Chat (9) | Claude, ChatGPT, Gemini, Llama, DeepSeek, Qwen, Kimi, GLM, Minimax | Claude |
| Código (9) | Claude, ChatGPT, Cursor, GitHub Copilot, Windsurf, DeepSeek Coder, Qwen Coder, Codestral, Gemini | Claude |
| Documento (8) | Claude, ChatGPT, Gemini, Jasper, Copy.ai, Notion AI, Grammarly, Writesonic | Claude |
| Voz (7) | ElevenLabs (v3), OpenAI TTS (gpt-4o-mini-tts), Fish Audio, Sesame, Google TTS, PlayHT, Kokoro | ElevenLabs |
| Música (6) | Suno (v6), Udio, ElevenLabs Music (v2.5), Google Lyria (3.5), Stable Audio, MusicGen | Suno |
Herramientas
optimize_prompt
La herramienta principal. Optimiza un prompt para una plataforma de IA específica.
{
  "prompt": "a cat sitting on a windowsill",
  "category": "image",
  "platform": "midjourney",
  "mode": "concise"
}
Todos los parámetros excepto prompt son opcionales. Cuando se omiten category y platform, ClarifyPrompt los detecta automáticamente a partir del contenido del prompt.
Tres modos de llamada:
| Modo | Ejemplo |
|---|---|
| Configuración cero | { "prompt": "sunset over mountains" } |
| Solo categoría | { "prompt": "...", "category": "image" } |
| Totalmente explícito | { "prompt": "...", "category": "image", "platform": "dall-e" } |
Parámetros:
| Parámetro | Obligatorio | Descripción |
|---|---|---|
prompt | Sí | El prompt a optimizar |
category | No | chat, image, video, voice, music, code, document. Se detecta automáticamente cuando se omite. |
platform | No | ID de plataforma (p. ej. midjourney, dall-e, veo, claude). Usa el valor predeterminado de la categoría cuando se omite. |
mode | No | Estilo de salida: concise, detailed, structured, step-by-step, bullet-points, technical, simple. Predeterminado: detailed. |
enrich_context | No | Establece true para usar búsqueda web y enriquecer el contexto. Predeterminado: false. |
session_id | No | Une optimizaciones relacionadas para que la memoria de sesión pueda sesgar llamadas posteriores. Se genera automáticamente cuando se omite. |
file_path | No | Ruta del archivo activo — infiere el lenguaje y da forma a las sugerencias de plataforma. |
file_language | No | Anulación explícita del idioma para el archivo activo. |
file_excerpt | No | Extracto breve (≤2 KB) del archivo activo para fundamentar la reescritura. |
cwd | No | Directorio de trabajo para buscar CLAUDE.md / AGENTS.md / .cursorrules / package.json. Usa el cwd del servidor por defecto. |
user_locale | No | Sugerencia de configuración regional (p. ej. en-US, ar-EG) para informar tono e idioma. |
user_pinned_instructions | No | Instrucciones de usuario fijas y siempre aplicadas (bloque corto de memoria central). |
include_bundle | No | Incluye el resumen ContextBundle resuelto en la respuesta. Predeterminado: false. |
skip_intent_resolution | No | Omite la llamada LLM del clasificador de intención (más rápido; pierde señal de intención). Predeterminado: false. |
Respuesta (1.2.0):
{
  "id": "opt_mo9vlg9i_foohjx",
  "sessionId": "sess_mo9vlfn3_abc123",
  "originalPrompt": "a dragon flying over a castle at sunset",
  "optimizedPrompt": "a majestic dragon flying over a medieval castle at sunset --ar 16:9 --v 8.2 --style raw --q 2 --s 700",
  "category": "image",
  "platform": "midjourney",
  "mode": "concise",
  "modeSource": "analyzer",
  "analysis": {
    "category": "image",
    "intent": "creative-media",
    "recommendedMode": "detailed",
    "confidence": "high",
    "source": "llm"
  },
  "grounding": {
    "sources": ["project-rules", "workspace-meta", "target-model", "platform-hints"],
    "acceptedExamplesUsed": 0
  },
  "shape": {
    "systemPromptBudget": "standard",
    "maxTokens": 2048,
    "temperature": 0.9
  },
  "metadata": {
    "model": "qwen2.5:14b-instruct-q4_K_M",
    "processingTimeMs": 3911,
    "strategy": "ImageStrategy"
  },
  "detection": { "autoDetected": true, "detectedCategory": "image", "detectedPlatform": "midjourney", "confidence": "high" },
  "intent": { "detected": "creative-media", "confidence": "high" }
}
El campo de clasificación canónico es analysis. Los campos detection y intent son alias obsoletos que se mantienen para compatibilidad con 1.x; se eliminarán en 2.x.
modeSource te indica cómo se decidió el modo final (user si pasaste uno, analyzer si fue impulsado por intención, default si no fue ninguno).
grounding.sources enumera qué secciones de Grounding Context contribuyeron, en orden de prioridad. grounding.acceptedExamplesUsed te indica cuántos ejemplos few-shot extrajo el motor del historial de save_outcome.
shape te indica cómo se dimensionó el prompt del sistema para tu modelo objetivo.
clarify_with_user (nuevo en 1.4.0)
Dado un borrador de prompt ambiguo, devuelve 1–3 preguntas de aclaración específicas en lugar de adivinar. Úsalo como etapa previa antes de optimize_prompt cuando no puedas saber si la solicitud del usuario producirá una buena reescritura.
{
  "prompt": "make it better",
  "force": true
}
Respuesta:
{
  "clarificationNeeded": true,
  "reason": "Clarification recommended (analyzer confidence=low; intent=unknown; prompt is short (12 chars); caller passed force=true).",
  "questions": [
    {
      "question": "What outcome do you want from this prompt — what does success look like?",
      "reasoning": "The draft is ambiguous on the goal/audience dimension; pinning this typically resolves most downstream ambiguity.",
      "suggestedAnswer": "Make the email shorter, clearer, and more action-oriented.",
      "options": ["Make it shorter", "Make it more formal", "Make it more persuasive"],
      "dimension": "goal"
    }
  ],
  "analysis": { "category": "chat", "intent": "unknown", "confidence": "low" }
}
suggestedAnswer siempre está poblado — el llamador puede aceptarlo tal cual y seguir adelante. options es opcional; los clientes de interfaz pueden renderizarlo como botones de selección rápida. La etiqueta dimension clasifica qué eje aborda la pregunta.
Cortocircuito: cuando la confianza del analizador es high Y el prompt es no trivialmente largo, la herramienta devuelve clarificationNeeded: false sin llamada LLM más allá del analizador — para que puedas encadenarlo delante de optimize_prompt sin impuesto de latencia en cada llamada. Pasa force: true para deshabilitar el cortocircuito.
ground_prompt (nuevo en 1.4.0)
Variante estricta y aumentada por recuperación de optimize_prompt. Las fuentes proporcionadas por el llamador están fijadas con la máxima prioridad — por encima de las reglas del proyecto y las instrucciones fijas — para que la reescritura se base en el material que proporcionaste en lugar de lo que el curador decida que es relevante.
{
  "prompt": "rewrite the launch announcement to match our voice",
  "category": "document",
  "platform": "claude",
  "sources": [
    {
      "label": "Brand Voice Rules",
      "body": "Tone: warm, plain-spoken, no jargon. Always lead with the user benefit. Avoid 'leverage', 'synergy', 'robust'. Max sentence length: 18 words.",
      "kind": "rules"
    },
    {
      "label": "Launch Draft",
      "body": "Today we're launching FlowSync Pro — a tool to leverage AI synergy for robust team coordination...",
      "kind": "draft"
    }
  ]
}
Devuelve la misma forma que optimize_prompt más usedSources (qué fuentes realmente llegaron al grounding curado) y droppedSources (fuentes que estaban vacías o se descartaron). Las fuentes aparecen en la traza como user-source:0, user-source:1, etc.
Modo estricto: cero fuentes no vacías → error, no caída silenciosa. El límite de cuerpo por fuente es de 4000 caracteres para que un solo pegado enorme no pueda dominar el presupuesto.
critique_prompt (nuevo en 1.4.0)
LLM como juez. Puntúa un prompt candidato de 0–10 en 6 dimensiones predeterminadas y (cuando está por debajo del umbral) devuelve una reescritura mejorada.
{
  "prompt": "make it good",
  "revise_threshold": 7
}
Respuesta:
{
  "overallScore": 2.0,
  "verdict": "reject",
  "summary": "Reject — substantial rewrite required.",
  "dimensions": [
    { "name": "clarity", "score": 1, "rationale": "...", "suggestions": ["Specify what 'it' refers to", "..."] },
    { "name": "specificity", "score": 0, "rationale": "...", "suggestions": [...] },
    { "name": "intent_alignment", "score": 3, "rationale": "...", "suggestions": [...] },
    { "name": "format_fitness", "score": 2, "rationale": "...", "suggestions": [...] },
    { "name": "length_appropriateness", "score": 1, "rationale": "...", "suggestions": [...] },
    { "name": "plain_language", "score": 4, "rationale": "...", "suggestions": [...] }
  ],
  "improvedPrompt": "Improve the README's getting-started section: shorten...",
  "improvements": ["Specified the artifact (README's getting-started section)", "Added concrete success criteria", "..."],
  "judgeModel": "qwen2.5-coder:7b-instruct-q4_K_M"
}
Parámetros:
| Parámetro | Predeterminado | Descripción |
|---|---|---|
prompt | — | Prompt candidato a puntuar. |
original_prompt | — | Al criticar una versión optimizada, la solicitud original del usuario. Se usa para la dimensión intent_alignment. |
criteria | 6 predeterminados | Dimensiones personalizadas: [{ name, description }, ...]. Hasta ~8 dimensiones. |
revise_threshold | 7.0 | Una puntuación general por debajo de esto activa el pase de reescritura. |
skip_rewrite | false | Omite el pase de reescritura por completo (más rápido; solo devuelve puntuaciones). |
Verificación de cordura: si el juez infla overall más de 2.5 puntos por encima de la media por dimensión, el motor lo corrige.
compose_prompt (nuevo en 1.4.0)
El pipeline canónico. Una llamada ejecuta clarificar → fundamentar/optimizar → criticar → revisión automática opcional.
{
  "prompt": "Write a TypeScript function that takes an array of email strings and returns only those that match RFC 5322 syntax. Include unit tests using Vitest with at least 6 test cases.",
  "pre_clarify": "auto",
  "post_critique": true,
  "auto_revise": true
}
Respuesta (truncada):
{
  "stages": [
    { "name": "clarify",  "ranAt": "...", "durationMs":  541, "summary": "no clarification needed (short-circuit)" },
    { "name": "optimize", "ranAt": "...", "durationMs": 3128, "summary": "5 grounding source(s) selected" },
    { "name": "critique", "ranAt": "...", "durationMs": 3422, "summary": "verdict=accept, score=8.4" }
  ],
  "finalPrompt": "Write a TypeScript function `validateEmails(emails: string[]): string[]` that...",
  "clarificationRequired": false,
  "clarification": { "clarificationNeeded": false, ... },
  "optimization": { "id": "opt_...", "optimizedPrompt": "...", ... },
  "critique": { "overallScore": 8.4, "verdict": "accept", ... }
}
finalPrompt es lo que deberías enviar downstream. Es igual a optimization.optimizedPrompt (o grounding.optimizedPrompt) a menos que auto_revise: true Y el veredicto de crítica no sea accept Y haya un improvedPrompt — en cuyo caso finalPrompt es la reescritura y revised: true.
Ramificación:
| Entradas | Ruta |
|---|---|
sin sources | rama optimize_prompt (grounding curado automáticamente) |
sources no vacío | rama ground_prompt (estricta, fuentes proporcionadas por el llamador fijadas) |
pre_clarify: "auto" (predeterminado) | clarificar se ejecuta; cortocircuita sin mostrar preguntas en prompts con confianza |
pre_clarify: "always" | clarificar siempre se ejecuta y DETIENE la cadena si surgen preguntas |
pre_clarify: "never" | omitir clarificar por completo |
post_critique: true | criticar se ejecuta después de optimizar/fundamentar |
auto_revise: true (con post_critique: true) | cuando el veredicto !== accept y hay un improvedPrompt, reemplaza finalPrompt |
Detención forzosa: si clarify plantea preguntas (solo ocurre cuando pre_clarify: "always", o auto en un prompt de baja confianza), la cadena se detiene y devuelve clarificationRequired: true. El llamador responde las preguntas, edita el prompt para incorporar las respuestas y vuelve a llamar (normalmente con pre_clarify: "never" para omitir la segunda pasada de clarify). |
Adiciones de la versión 1.6.0
-
max_iterations(1–5, predeterminado 1) — bucle de revisión agéntico. Conauto_revise: trueYpost_critique: true, elimprovedPromptde cada iteración se retroalimenta a través de optimize+critique hasta que el veredicto sea accept, no haya improvedPrompt disponible o se alcance el límite. Pre-clarify solo se activa una vez. La respuesta incluyeiterationsque muestra cuántas iteraciones se ejecutaron. -
clarify_model/optimize_model/critique_model— enrutamiento de modelos por etapa. Cada uno anula la variable de entornoLLM_MODELpara esa etapa. Úsalo para enrutar compose entre niveles de costo/calidad — p. ej., clarify local económico, optimize alojado en la frontera, critique económico:{ "prompt": "...", "post_critique": true, "clarify_model": "qwen2.5-coder:7b-instruct-q4_K_M", "optimize_model": "claude-sonnet-5", "critique_model": "gpt-4o-mini" }optimization.metadata.modelycritique.judgeModelen la respuesta reflejan el modelo real que ejecutó cada etapa.
inspect_context (nuevo en 1.2.0)
Vista previa del ContextBundle que ClarifyPrompt ensamblaría para un prompt dado — reglas del espacio de trabajo, marcos de trabajo, capacidades del modelo objetivo, intención resuelta e historial de sesión — sin ejecutar la optimización completa. Útil para depurar por qué una optimización resultó como resultó.
{
  "prompt": "Write an email to finance explaining the Q2 spend variance",
  "category": "document",
  "cwd": "/path/to/your/project"
}
Devuelve el ContextBundle completo como JSON.
list_traces (nuevo en 1.2.0)
Lista resumida de los rastros de optimización recientes capturados por el rastreador local (cuando CLARIFYPROMPT_TRACE=local, el predeterminado).
{ "day": "2026-04-22", "limit": 50 }
Devuelve IDs de rastro, vistas previas de entradas, intenciones resueltas, familias objetivo y latencias — nunca el prompt del sistema completo (usa get_trace para eso). Omite day para obtener el día más reciente con datos.
get_trace (nuevo en 1.2.0)
Obtén el rastro completo de una sola optimización por ID, incluido el prompt del sistema exacto, el resumen del bundle y la salida.
{ "id": "opt_xxx", "lookback_days": 7 }
save_outcome (nuevo en 1.2.0)
Indica a ClarifyPrompt si una optimización pasada fue accepted, edited o rejected. Las salidas aceptadas se convierten en ejemplos de pocas muestras para prompts futuros similares en la misma sesión. En 1.3+ esto también alimentará la capa de memoria persistente. Se espera que el IDE / agente / llamador invoque esto después de que el usuario actúe sobre la optimización.
{
  "optimization_id": "opt_xxx",
  "session_id": "sess_yyy",
  "verdict": "accepted",
  "diff": "optional: the user's edited version or a patch"
}
list_categories
Enumera las 7 categorías con recuentos de plataformas (integradas y personalizadas) y valores predeterminados.
list_platforms
Enumera las plataformas disponibles para una categoría determinada, incluidas las plataformas personalizadas registradas. Muestra cuál es la predeterminada y si hay instrucciones personalizadas configuradas.
list_modes
Enumera los 7 modos de salida con descripciones.
register_platform
Registra una nueva plataforma de IA personalizada para la optimización de prompts.
{
  "id": "my-llm",
  "category": "chat",
  "label": "My Custom LLM",
  "description": "Internal fine-tuned model",
  "syntax_hints": ["JSON mode", "max 2000 tokens"],
  "instructions": "Always use structured output format",
  "instructions_file": "my-llm.md"
}
| Parámetro | Obligatorio | Descripción |
|---|---|---|
id | Sí | ID único (minúsculas, alfanumérico con guiones) |
category | Sí | Categoría a la que pertenece esta plataforma |
label | Sí | Nombre legible de la plataforma |
description | Sí | Descripción breve |
syntax_hints | No | Sugerencias de sintaxis específicas de la plataforma |
instructions | No | Instrucciones de optimización en línea |
instructions_file | No | Ruta a un archivo .md con instrucciones detalladas |
update_platform
Actualiza una plataforma personalizada o agrega anulaciones de instrucciones a una plataforma integrada.
Para plataformas integradas (p. ej., Midjourney, Claude), puedes agregar instrucciones personalizadas y sugerencias de sintaxis adicionales sin modificar las originales:
{
  "id": "midjourney",
  "category": "image",
  "instructions": "Always pin the current version (--v 8.2), prefer --style raw",
  "syntax_hints_append": ["--no plants", "--tile for patterns"]
}
Para plataformas personalizadas, todos los campos se pueden actualizar.
unregister_platform
Elimina una plataforma personalizada o borra las anulaciones de instrucciones de una plataforma integrada.
{
  "id": "my-llm",
  "category": "chat"
}
Para plataformas integradas, usa remove_override_only: true para borrar tus instrucciones personalizadas sin afectar la plataforma en sí.
Plataformas personalizadas e instrucciones
ClarifyPrompt admite el registro de plataformas personalizadas y el suministro de instrucciones de optimización — similar a cómo .cursorrules o CLAUDE.md guían el comportamiento de la IA.
Cómo funciona
- Registra una plataforma personalizada mediante
register_platform - Proporciona instrucciones en línea o como archivo
.md - Optimiza prompts dirigidos a tu plataforma personalizada: las instrucciones se inyectan en el proceso de optimización
Archivos de instrucciones
Las instrucciones se pueden proporcionar como archivos markdown almacenados en ~/.clarifyprompt/instructions/:
~/.clarifyprompt/
  config.json                    # custom platforms + overrides
  instructions/
    my-llm.md                   # instructions for custom platform
    midjourney-overrides.md     # extra instructions for built-in platform
Ejemplo de archivo de instrucciones (my-llm.md):
# My Custom LLM Instructions

## Response Format
- Always output valid JSON
- Include a "reasoning" field before the answer

## Constraints
- Max 2000 tokens
- Temperature should be set low (0.1-0.3) for factual queries

## Style
- Be concise and technical
- Avoid filler phrases
Anular plataformas integradas
Puedes agregar instrucciones personalizadas a cualquiera de las 61 plataformas integradas usando update_platform. Esto te permite personalizar cómo se optimizan los prompts para plataformas como Midjourney, Claude o Veo sin modificar los valores predeterminados.
Directorio de configuración
El directorio de configuración tiene como valor predeterminado ~/.clarifyprompt/ y se puede cambiar mediante la variable de entorno CLARIFYPROMPT_CONFIG_DIR. Las plataformas personalizadas y las anulaciones persisten entre reinicios del servidor.
Paquetes de conocimiento
Un paquete de conocimiento es un documento markdown con frontmatter YAML opcional que enseña a ClarifyPrompt algo duradero: una voz de marca, una convención de codificación, un régimen de cumplimiento, un patrón de prompting específico de dominio. Los paquetes se dividen en fragmentos en los límites H2, se incrustan y se ponen a disposición para la recuperación semántica en cada llamada posterior a optimize_prompt / compose_prompt. El Context Curator puntúa sus fragmentos junto con las señales del espacio de trabajo, los archivos de instrucciones y las fuentes de fundamentación, y luego ajusta la selección de mayor utilidad a la ventana de tokens restante del modelo objetivo.
Paquetes iniciales incluidos
Cuatro paquetes se incluyen en cada tarball npm en packs/:
| Paquete | Qué enseña |
|---|---|
anthropic-brand-voice | El tono público, el registro y las elecciones de palabras de Anthropic |
higgsfield-creative-handbook | Selección de modelos de Higgsfield, estructura de prompts, movimientos de cámara, flujo de trabajo Soul ID |
nextjs-14-best-practices | Convenciones de Next.js 14 App Router con prioridad de servidor |
sox-compliance | Salvaguardas de Sarbanes-Oxley 404 para trabajo financiero asistido por IA |
Cargar un paquete
load_knowledge_pack({
  source: "https://raw.githubusercontent.com/LumabyteCo/clarifyprompt-mcp/main/packs/nextjs-14-best-practices.md",
  scope: "user"
})
O carga localmente — por ruta absoluta, o relativa al paquete instalado:
load_knowledge_pack({ source: "/path/to/my-team-style-guide.md", scope: "project" })
load_knowledge_pack({ source: "./node_modules/clarifyprompt-mcp/packs/sox-compliance.md", scope: "session" })
Ámbitos
user— persistido en$CLARIFYPROMPT_HOMEy disponible en todos los proyectos de esta máquina.project— persistido, pero limitado a la identidad del árbol de trabajo actual (project-id derivado decwd+ remote de git cuando está presente).session— limitado a la sesión MCP actual; no se recupera después de que el servidor se reinicie.
Los paquetes de los tres ámbitos se puntúan juntos en el momento de la recuperación; el curador decide qué fragmentos sobreviven al presupuesto de tokens.
Autoría y contribución
Las reglas de autoría de paquetes (esquema de frontmatter, guía de límites de fragmentos, el estándar de calidad que hace que los PR se fusionen) viven en packs/README.md. Las contribuciones llegan mediante PR contra este repositorio. Apache-2.0 a menos que tenga doble licencia en el frontmatter.
Por qué los paquetes viven en el repositorio del motor (y no en un registro separado)
Brevemente: solían hacerlo. Desde 1.3 hasta 1.6.3 existía un registro separado de LumabyteCo/clarifyprompt-packs. En 1.6.4 se archivó y consolidó de nuevo en clarifyprompt-mcp/packs/ porque la disciplina de doble repositorio estaba pagando costos de mantenimiento por una audiencia de contribuyentes externos que no se había materializado — y el paquete higgsfield-creative-handbook se envió en 1.6.2 sin llegar nunca al registro, prueba A de la deriva. La división tiene sentido una vez que hay una función de presión real (cola de PR de la comunidad, recuento de paquetes >20, licencias/gobernanza divergentes). Hasta entonces, el modelo de repositorio único mantiene la fuente de verdad singular e inequívoca.
Configuración de LLM
ClarifyPrompt usa un LLM para optimizar prompts. Funciona con cualquier API compatible con OpenAI y con la API de Anthropic directamente.
Variables de entorno
| Variable | Obligatoria | Descripción |
|---|---|---|
LLM_API_URL | Sí | URL del endpoint de la API |
LLM_API_KEY | Depende | Clave de API (no necesaria para Ollama local) |
LLM_MODEL | Sí | Nombre/ID del modelo |
LLM_TIMEOUT_MS | No | Tiempo de espera de solicitud de LLM por llamada en ms. Predeterminado 30000 (30s). Auméntalo para modelos locales grandes — p. ej., un qwen3-next:80b de 50 GB puede tomar ~120s por llamada, lo que excede el valor predeterminado y aparecería como un tiempo de espera agotado. LLM_TIMEOUT_MS=180000 es un valor seguro para modelos locales grandes. |
LLM_REASONING_EFFORT | No | (1.12.1+) Nivel de razonamiento para modelos de canal de pensamiento (gpt-oss, glm, *-thinking, deepseek-r, qwq): low | medium | high. Predeterminado low. Estos modelos también reciben un piso de max_tokens para que su rastro de razonamiento no pueda privar de tokens a la respuesta final (#3). Se ignora para modelos sin razonamiento. |
CLARIFYPROMPT_HOME | No | Canonical (1.2.0+) raíz para todo lo que ClarifyPrompt escribe — plataformas personalizadas, archivos de instrucciones .md, rastros, base de datos de memoria y paquetes de conocimiento. Predeterminado: $XDG_DATA_HOME/clarifyprompt o ~/.clarifyprompt. |
CLARIFYPROMPT_TRACE | No | off | local | otel. Predeterminado: local. Los rastros son estrictamente JSONL local; no se sube nada. |
EMBED_API_URL | No | (1.3.0+) Endpoint de incrustación para recuperación de memoria y paquetes de conocimiento. Cualquier endpoint /v1/embeddings compatible con OpenAI. Se establece como predeterminado a LLM_API_URL cuando no se configura — los usuarios de Ollama simplemente funcionan. |
EMBED_API_KEY | No | (1.3.0+) Clave de API de incrustación. Se establece como predeterminado a LLM_API_KEY cuando no se configura; no es necesaria para Ollama local. |
EMBED_MODEL | No | (1.3.0+) Predeterminado: nomic-embed-text:v1.5 (768-dim, extraer con ollama pull nomic-embed-text). Cambia a text-embedding-3-small para OpenAI, voyage-3 para Voyage, embed-english-v3.0 para Cohere. |
EMBED_DIMENSION | No | (1.3.0+) Dimensión de salida de incrustación. Predeterminado: 768. Debe coincidir con tu modelo de incrustación (1536 para OpenAI text-embedding-3-small, 1024 para Voyage, etc.). |
SEARCH_PROVIDER | No | Proveedor opcional de enriquecimiento de búsqueda web cuando enrich_context: true. Uno de tavily (predeterminado) | brave | serper | serpapi | exa | searxng. |
SEARCH_API_KEY | No | Clave de API para el SEARCH_PROVIDER configurado. No es necesaria para SearXNG autoalojado. |
SEARCH_API_URL | No | URL del endpoint de búsqueda. Solo es necesaria para SearXNG autoalojado (apunta a tu instancia). |
CLARIFYPROMPT_SUPPRESS_LEGACY_WARN | No | Establécelo en 1 para silenciar la sugerencia de deprecación de una línea cuando se usan CLARIFYPROMPT_CONFIG_DIR / CLARIFYPROMPT_DATA_DIR. |
CLARIFYPROMPT_CONFIG_DIR | No | Legacy alias para CLARIFYPROMPT_HOME. Sigue funcionando; se eliminará en 2.x. |
CLARIFYPROMPT_DATA_DIR | No | Legacy alias para CLARIFYPROMPT_HOME. Sigue funcionando; se eliminará en 2.x. |
Ejemplos de proveedores
Ollama (local, gratuito):
LLM_API_URL=http://localhost:11434/v1
LLM_MODEL=qwen2.5:7b
Ollama — modelos en la nube mediante paso directo local (recomendado):
Si tu Ollama local está conectado a Ollama Cloud, cualquier modelo :cloud se enruta a través de él de forma transparente — misma URL, sin clave de API separada. La tabla de capacidades detecta automáticamente variantes de razonamiento / pensamiento (gpt-oss, kimi-k2-thinking, qwen3-thinking, deepseek-r1, etc.) y aumenta maxTokens para que terminen de pensar y realmente produzcan contenido.
LLM_API_URL=http://localhost:11434/v1
LLM_MODEL=gpt-oss:20b-cloud        # or kimi-k2.6:cloud, qwen3-next:80b-cloud, glm-4.6:cloud, etc.
Ollama — endpoint en la nube directo (sin instalación local):
LLM_API_URL=https://ollama.com/v1
LLM_API_KEY=your-ollama-cloud-key
LLM_MODEL=qwen2.5:7b
OpenAI:
LLM_API_URL=https://api.openai.com/v1
LLM_API_KEY=sk-...
LLM_MODEL=gpt-4o
Los modelos de razonamiento (
gpt-5,o3,o4-mini) también funcionan: el cliente gestiona automáticamente sus requisitos demax_completion_tokensytemperature. Piensan extensamente, así que aumentaLLM_TIMEOUT_MS(p. ej.,180000); el valor predeterminado de 30s suele ser demasiado corto.
Anthropic Claude:
LLM_API_URL=https://api.anthropic.com/v1
LLM_API_KEY=sk-ant-...
LLM_MODEL=claude-sonnet-5
Google Gemini:
LLM_API_URL=https://generativelanguage.googleapis.com/v1beta/openai
LLM_API_KEY=your-gemini-key
LLM_MODEL=gemini-flash-latest
Usa un modelo al que tu clave tenga acceso: los IDs más antiguos (p. ej.,
gemini-2.0-flash,gemini-2.5-flash) devuelven404 "no longer available to new users"en claves más nuevas.gemini-flash-latestrastrea el modelo flash actual. (Nota:gemini-2.5-flash-image— "Nano Banana" — es un modelo de imagen; no puede serLLM_MODEL, que debe ser un modelo de texto. Apúntalo como plataforma de imagen en su lugar).
Groq:
LLM_API_URL=https://api.groq.com/openai/v1
LLM_API_KEY=gsk_...
LLM_MODEL=llama-3.3-70b-versatile
DeepSeek:
LLM_API_URL=https://api.deepseek.com/v1
LLM_API_KEY=your-deepseek-key
LLM_MODEL=deepseek-chat
OpenRouter (cualquier modelo):
LLM_API_URL=https://openrouter.ai/api/v1
LLM_API_KEY=your-openrouter-key
LLM_MODEL=anthropic/claude-sonnet-4
Consulta .env.example para ver la lista completa de más de 20 proveedores compatibles, incluidos Together AI, Fireworks, Mistral, xAI, Cohere, Perplexity, LM Studio, vLLM, LocalAI, Jan, GPT4All y más.
Búsqueda web (opcional)
Habilita el enriquecimiento de contexto estableciendo enrich_context: true en tu llamada a optimize_prompt. ClarifyPrompt buscará en la web el contexto relevante antes de optimizar.
Proveedores de búsqueda compatibles:
| Proveedor | Variable | URL |
|---|---|---|
| Tavily (predeterminado) | SEARCH_API_KEY | tavily.com |
| Brave Search | SEARCH_API_KEY | brave.com/search/api |
| Serper | SEARCH_API_KEY | serper.dev |
| SerpAPI | SEARCH_API_KEY | serpapi.com |
| Exa | SEARCH_API_KEY | exa.ai |
| SearXNG (autohospedado) | — | github.com/searxng/searxng |
SEARCH_PROVIDER=tavily
SEARCH_API_KEY=your-key
Antes y después
Imagen (Midjourney)
Before: "a cat sitting on a windowsill"

After:  "a tabby cat sitting on a sunlit windowsill, warm golden hour
         lighting, shallow depth of field, dust particles in light beams,
         cozy interior background, shot on 35mm film, warm amber color
         palette --ar 16:9 --v 8.2 --style raw --q 2"
Video (Veo 3.1)
Before: "a timelapse of a city"

After:  "Cinematic timelapse of a sprawling metropolitan skyline
         transitioning from golden hour to blue hour to full night.
         Camera slowly dollies forward from an elevated vantage point.
         Light trails from traffic appear as the city illuminates.
         Clouds move rapidly overhead. Ambient city soundscape builds
         as the lights come on (native audio). Duration: 8s, extendable.
         Style: documentary cinematography, 4K, 16:9."
Código (Claude)
Before: "write a function to validate emails"

After:  "Write a TypeScript function `validateEmail(input: string): boolean`
         that validates email addresses against RFC 5322. Handle edge cases:
         quoted local parts, IP address domains, internationalized domain
         names. Return boolean, no exceptions. Include JSDoc with examples
         of valid and invalid inputs. No external dependencies."
Música (Suno)
Before: "compose a chill lo-fi beat for studying"

After:  "Compose an instrumental chill lo-fi beat for studying.
         [Tempo: medium] [Genre: lo-fi] [Length: 2 minutes]"
Motor de contexto (1.2.0)
Cada optimización pasa por cinco pasadas integradas que fluyen como un único paquete de contexto de principio a fin:
- Análisis — una única llamada LLM
analyzePrompt()producecategory,intentyrecommendedModejuntos para que no puedan discrepar. La intención prevalece sobre las palabras clave superficiales cuando entran en conflicto (p. ej.,"validate emails"→codenodocument). - Reconciliación de modos — el
modeexplícito del usuario gana; de lo contrario, se aplica la recomendación derivada de la intención del analizador;modeSourceen la respuesta te indica cuál se usó. - Conformación del prompt — la señal de capacidad del modelo objetivo impulsa
systemPromptBudget(compacto para modelos locales pequeños, rico para modelos con contexto de 100K+),maxTokens,temperature(consciente de la intención) y si se incluyen ejemplos. - Superposición de intención — una superposición corta por intención (
production-code: exige manejo de errores y pruebas;data-extract: exige esquema estricto;brand-voice: lidera con tono; etc.) integrada en el prompt del sistema de la estrategia. - Contexto de anclaje — un único bloque ordenado por prioridad que fusiona instrucciones fijadas del usuario → reglas del proyecto → archivo activo → ejemplos few-shot de la sesión → búsqueda web → metadatos del espacio de trabajo → sugerencias del modelo objetivo → instrucciones de plataforma personalizadas → sugerencias de sintaxis integradas.
Qué se recopila (ContextBundle)
- Proyecto — primer archivo coincidente de
CLAUDE.md,AGENTS.md,.cursorrules,.clinerules,clarify.md,.clarify/rules.md.package.jsonmás manifiestos hermanos (pyproject.toml,Cargo.toml,go.mod,Gemfile,composer.json, …) impulsan la detección de framework e idioma. - Archivo — entradas opcionales
file_path/file_language/file_excerpt. - Sesión — buffer circular (20 operaciones/sesión) de optimizaciones y resultados recientes. Las salidas aceptadas se recuperan como ejemplos few-shot para prompts futuros similares.
- Modelo objetivo — el LLM que realiza la reescritura, comparado con una tabla de capacidades.
- Usuario — locale, modo preferido, instrucciones fijadas (anclaje de mayor prioridad).
Inspeccionar lo que ve el motor
Usa la herramienta inspect_context para previsualizar el paquete completo sin ejecutar una optimización. Misma forma que devuelve optimize_prompt cuando include_bundle: true.
Extender el contexto
Coloca un AGENTS.md / clarify.md / CLAUDE.md en la raíz de tu proyecto. La siguiente optimización lo recogerá automáticamente. Para retroalimentar las salidas aceptadas en futuras reescrituras, llama a save_outcome después de que el usuario actúe sobre el resultado.
Trazabilidad
$CLARIFYPROMPT_HOME/traces/YYYY-MM-DD.jsonl
Cada optimización escribe una línea JSONL que captura {id, ts, sessionId, category, platform, mode, input, bundleSummary, systemPrompt, output, model, strategy, latencyMs, shape, groundingSources, error}. Usa list_traces para resúmenes y get_trace para registros completos.
Postura de privacidad:
- Los rastros son estrictamente locales. No hay llamadas de red salientes a ninguna infraestructura propiedad de ClarifyPrompt.
- Solo se llama al endpoint LLM que configuraste (
LLM_API_URL) y al proveedor de búsqueda opcional (SEARCH_API_KEY). - Desactiva la trazabilidad por completo con
CLARIFYPROMPT_TRACE=off. - No hay telemetría en esta versión. Cuando se incluya una opción de telemetría, será opt-in, anónima y documentada antes de que la compilación la incluya.
Limitaciones conocidas y hoja de ruta
Persistencia de memoria (incluida)
El bucle de save_outcome + recuperación few-shot persiste en SQLite + sqlite-vec bajo $CLARIFYPROMPT_HOME: sesiones, optimizaciones, resultados, hechos y fragmentos de paquetes sobreviven a los reinicios. Un buffer circular en memoria permanece solo como ruta rápida dentro de la misma sesión. Las entradas con ámbito de sesión están vinculadas a su ID de sesión, por lo que las sesiones posteriores no las recuperan.
La calidad de la intención escala con el modelo que ejecuta el analizador
El analizador se ejecuta en el mismo LLM_MODEL que realiza la reescritura. En la batería de integración:
- Qwen 2.5 7B y 14B → correcto en cada prompt bien formado probado.
- Llama 3.2 3B → ocasionalmente se sobre-compromete en prompts ambiguos (p. ej., etiqueta
"make it better"comobrand-voice/highcuandounknown/lowes la respuesta correcta). Los modelos más grandes con el mismo prompt devolvieron correctamenteunknown/low.
Orientación: prefiere un modelo local de 7B+ (o cualquier modelo alojado de frontera) como LLM_MODEL. Los llamadores sensibles a la latencia pueden establecer skip_intent_resolution: true para omitir el analizador; el motor recurre a la categoría de sugerencia del usuario y al modo predeterminado, perdiendo el modo impulsado por intención y la superposición, pero conservando el anclaje y la forma. El harness de evaluación incluido (evals/, npm run eval) incluye un conjunto de fixtures público para que puedas puntuar el analizador con tus propios fixtures y detectar regresiones en cambios de modelo o clasificador.
Modelos recomendados
Puntúate con el ejecutor de matriz incluido: npm run matrix -- --models <a>,<b>,…. Una ejecución reciente (junio de 2026, suite de 30 fixtures, umbral de aprobación 0.85, puntuación = puntuación media de fixtures):
| Modelo | Dónde | Puntuación de suite | Notas |
|---|---|---|---|
glm-5.2:cloud | nube · razonamiento | 99% | Mejor en general. Presupuesto de pensamiento gestionado automáticamente (1.12.1). |
gpt-oss:20b-cloud | nube · razonamiento | 98% | Pesos abiertos de OpenAI; reasoning_effort aplicado automáticamente (1.12.1). |
qwen2.5-coder:7b | local | 97% | Un modelo local pequeño maneja casi toda la suite: el predeterminado local-first validado. |
gemma4:31b-cloud | nube | 92% | Sólido todoterreno. |
Los pocos fixtures por debajo del umbral en cualquier ejecución son los casos subjetivos de clasificación de analyzer-* intención/modo y de redacción de anclaje (varianza de contenido entre modelos), no errores de pipeline: los fixtures deterministas del pipeline (clarify, ground, critique, compose, memory, packs) pasan en todos los modelos. El predeterminado sigue siendo local-first (qwen2.5:7b); recurre a un modelo de frontera/razonamiento cuando quieras los últimos puntos de precisión de intención. Los modelos de razonamiento (gpt-oss, glm, *-thinking, …) se autoajustan (un mínimo de max_tokens + reasoning_effort) para que no devuelvan contenido vacío: consulta LLM_REASONING_EFFORT.
La tabla de capacidades no es exhaustiva
Entradas actuales: Claude, serie GPT-4/o, Gemini, Grok, DeepSeek (chat + razonamiento), Qwen, Llama, Mistral/Codestral, Mixtral, Gemma, Phi, Cohere Command, Aya, Kimi, GLM, Minimax, GPT-OSS, Yi, Nemotron. Los modelos desconocidos recurren a la forma de prompt capabilities: {} y standard: siguen siendo funcionales, solo sin dimensionamiento consciente del modelo. Añadir entradas es una edición solo de datos en src/engine/context/targetModelSignals.ts.
Modelos de razonamiento / cadena de pensamiento
Compatibles como caso de primera clase. El motor detecta automáticamente los razonadores a nivel de familia (o1/o3/o4, deepseek-reasoner, gpt-oss) y a nivel de variante (cualquier cosa cuyo ID coincida con /\b(thinking|reasoner|reasoning)\b/ o /\br[12]\b/: kimi-k2-thinking:cloud, qwen3-thinking:72b, qwen-r1-distill, etc.). Para estos, maxTokens se aumenta automáticamente a ≥ 8192 para que el modelo tenga espacio para pensar Y producir contenido. El campo reasoning nunca se muestra como el prompt optimizado: solo content.
Arquitectura
clarifyprompt-mcp/
  src/
    index.ts                           MCP server entry point (23 tools, 6 resources: 1 static + 4 templates + 1 ui panel)
    apps/                              MCP Apps compose panel (panel.html template + panel.ts, bundled at build time)
    engine/
      config/
        categories.ts                  CategoryConfig type + CATEGORIES const (loaded from YAML in 1.5.0)
        platformLoader.ts              (1.5.0) YAML pack loader — reads packs/platforms/*.yaml at boot
        paths.ts                       Unified $CLARIFYPROMPT_HOME resolver (1.2.0)
        persistence.ts                 ConfigStore — JSON config + .md file loading
        registry.ts                    PlatformRegistry — merges built-in + custom
      context/                         Context Engine (1.2.0)
        types.ts                       ContextBundle + signal types + AnalysisSignal
        projectSignals.ts              CLAUDE.md / AGENTS.md / .cursorrules / manifests scan
        fileSignals.ts                 Active-file path + language + excerpt
        sessionSignals.ts              In-memory per-session ring buffer + outcome retrieval
        targetModelSignals.ts          Model → capabilities mapping
        promptAnalyzer.ts              Unified analyzer: category + intent + recommendedMode
        gitSignals.ts                  (1.6.0) branch + HEAD + dirty + recent commits
        environmentSignals.ts          (1.6.0) nowIso + weekday + timezone
        bundle.ts                      Bundle orchestrator
      trace/                           Local tracing (1.2.0)
        types.ts                       TraceEntry schema (shape, groundingSources, error)
        writer.ts                      JSONL + OTel-stub writer, reader, lookup
      memory/                          Persistent memory + knowledge packs (1.3.0)
        store.ts                       SQLite + sqlite-vec; bi-temporal facts, outcomes, packs
        packs.ts                       Knowledge-pack loader (local / URL / inline)
        reflection.ts                  LLM fact extraction on save_outcome
      llm/client.ts                    Multi-provider LLM client (OpenAI + Anthropic)
      search/client.ts                 Web search (6 providers; results merge into Grounding Context)
      optimization/
        engine.ts                      Core orchestrator — analyzer, shape, grounding, retrieval, trace
        curator.ts                     Token-budget grounding curator (1.3.0)
        groundingContext.ts            Priority-ordered context assembly + mode/shape helpers
        types.ts                       OptimizationContext + result shape (UserProvidedSource)
        strategies/
          base.ts                      Bundle-aware base strategy (intent overlay + shape-aware sizing)
          chat.ts                      9 platforms
          image.ts                     12 platforms
          video.ts                     11 platforms
          voice.ts                     7 platforms
          music.ts                     4 platforms
          code.ts                      9 platforms
          document.ts                  8 platforms
      clarification/clarify.ts         (1.4.0) clarify_with_user — targeted questions w/ defaults
      grounding/ground.ts              (1.4.0) ground_prompt — strict caller-provided grounding
      critique/critique.ts             (1.4.0) critique_prompt — LLM-as-judge + optional rewrite
      composition/compose.ts           (1.4.0) compose_prompt — canonical clarify→ground/opt→critique pipeline
  evals/                                Eval harness v0 (1.3.0; setup: multi-call in 1.5.0)
    run.mjs                            YAML fixtures → MCP server → scored HTML report
    fixtures/*.yaml                    33 deterministic fixtures
    schema.json                        Fixture schema
  scripts/build-panel.mjs               (1.14.0) bundles the MCP Apps panel into dist/apps/
  packs/                                Knowledge packs + platform packs (single source of truth, 1.6.4+)
    README.md                          Pack authoring guide (frontmatter, chunks, quality bar)
    *.md                               Knowledge packs — 4 bundled, community-contributable via PR
    platforms/*.yaml                   (1.5.0) built-in AI platform declarations — 7 files, 58 platforms
  docs/adoption/                        (1.5.0) launch-post drafts + catalog submission specs
Docker
docker build -t clarifyprompt-mcp .
docker run -e LLM_API_URL=http://host.docker.internal:11434/v1 -e LLM_MODEL=qwen2.5:7b clarifyprompt-mcp
Desarrollo
git clone https://github.com/LumabyteCo/clarifyprompt-mcp.git
cd clarifyprompt-mcp
npm install
npm run build
Prueba con MCP Inspector:
npx @modelcontextprotocol/inspector node dist/index.js
Establece las variables de entorno en la sección "Environment Variables" del Inspector antes de conectar.
Pruebas y evaluaciones
| Comando | Qué hace |
|---|---|
npm run test:integration | Batería de integración del día 1 (intención + anclaje + forma) |
npm run test:day2 | Batería de memoria + curador + reflexión del día 2 |
npm run test:reasoning | Cobertura de modelos de razonamiento (aumento de maxTokens de cadena de pensamiento) |
npm run test:wire | Prueba de humo del cable MCP (el servidor arranca, lista de herramientas, initialize hace round-trip) |
npm run test:all | Las cuatro baterías en secuencia |
npm run eval | Ejecuta los 20 fixtures de evaluación deterministas + renderiza evals/report.html |
npm run eval -- --filter <name> | Ejecuta solo los fixtures que coinciden con <name> (o una etiqueta) |
npm run eval -- --quiet | Salida solo con código de salida (amigable para CI) |
Detalles del harness de evaluación, formato de fixtures e instrucciones de matriz multimodelo: evals/README.md.
CI / Puertas de calidad
El repositorio incluye un flujo de trabajo de GitHub Actions (.github/workflows/ci.yml) con cinco trabajos:
| Trabajo | Se ejecuta en | Qué controla |
|---|---|---|
build | cada push + PR | Typecheck + build + prueba de humo de arranque en Node 18/20/22 en Linux + macOS |
secrets-audit | cada push + PR | git-grep de prefijos de claves API conocidos en archivos rastreados |
evals | cada push + PR (opt-in) | npm run eval contra gpt-4o-mini. Omite con éxito cuando el secreto OPENAI_API_KEY no está configurado; bloquea la publicación cuando está configurado y cualquier fixture regresa |
docker | cada push + PR | docker build + prueba de humo de arranque del contenedor |
publish | solo pushes de etiquetas | npm publish --provenance cuando la etiqueta coincide con package.json#version, controlado por los cuatro trabajos anteriores |
Para habilitar evaluaciones como puerta de lanzamiento en tu fork:
- Repo → Settings → Secrets and variables → Actions → New repository secret
- Nombre:
OPENAI_API_KEY· Valor: una clave API de OpenAI con acceso agpt-4o-mini - Haz push o vuelve a ejecutar cualquier flujo de trabajo
Costo: ~$0.005 por ejecución de CI (17 fixtures activos × ~1500 tokens de entrada × ~600 tokens de salida a precios de gpt-4o-mini). El informe HTML del harness de evaluación se sube como artefacto de compilación (retención de 30 días) para que puedas inspeccionar cualquier fallo sin volver a ejecutar localmente.
Para habilitar npm-publish en pushes de etiquetas: añade un secreto NPM_TOKEN con un Granular Access Token con ámbito en clarifyprompt-mcp (bypass-2FA habilitado). Mismo flujo de Settings.