paperbanana
Genera diagramas de metodología para tu artículo de investigación
Documentación
|
PaperBananaIlustración Académica Automatizada para Científicos de IA
|





Aviso: Esta es una implementación de código abierto no oficial, impulsada por la comunidad del artículo "PaperBanana: Automating Academic Illustration for AI Scientists" de Dawei Zhu, Rui Meng, Yale Song, Xiyu Wei, Sujian Li, Tomas Pfister y Jinsung Yoon (arXiv:2601.23265). Este proyecto no está afiliado ni respaldado por los autores originales ni por Google Research. La implementación se basa en el artículo disponible públicamente y puede diferir del sistema original.
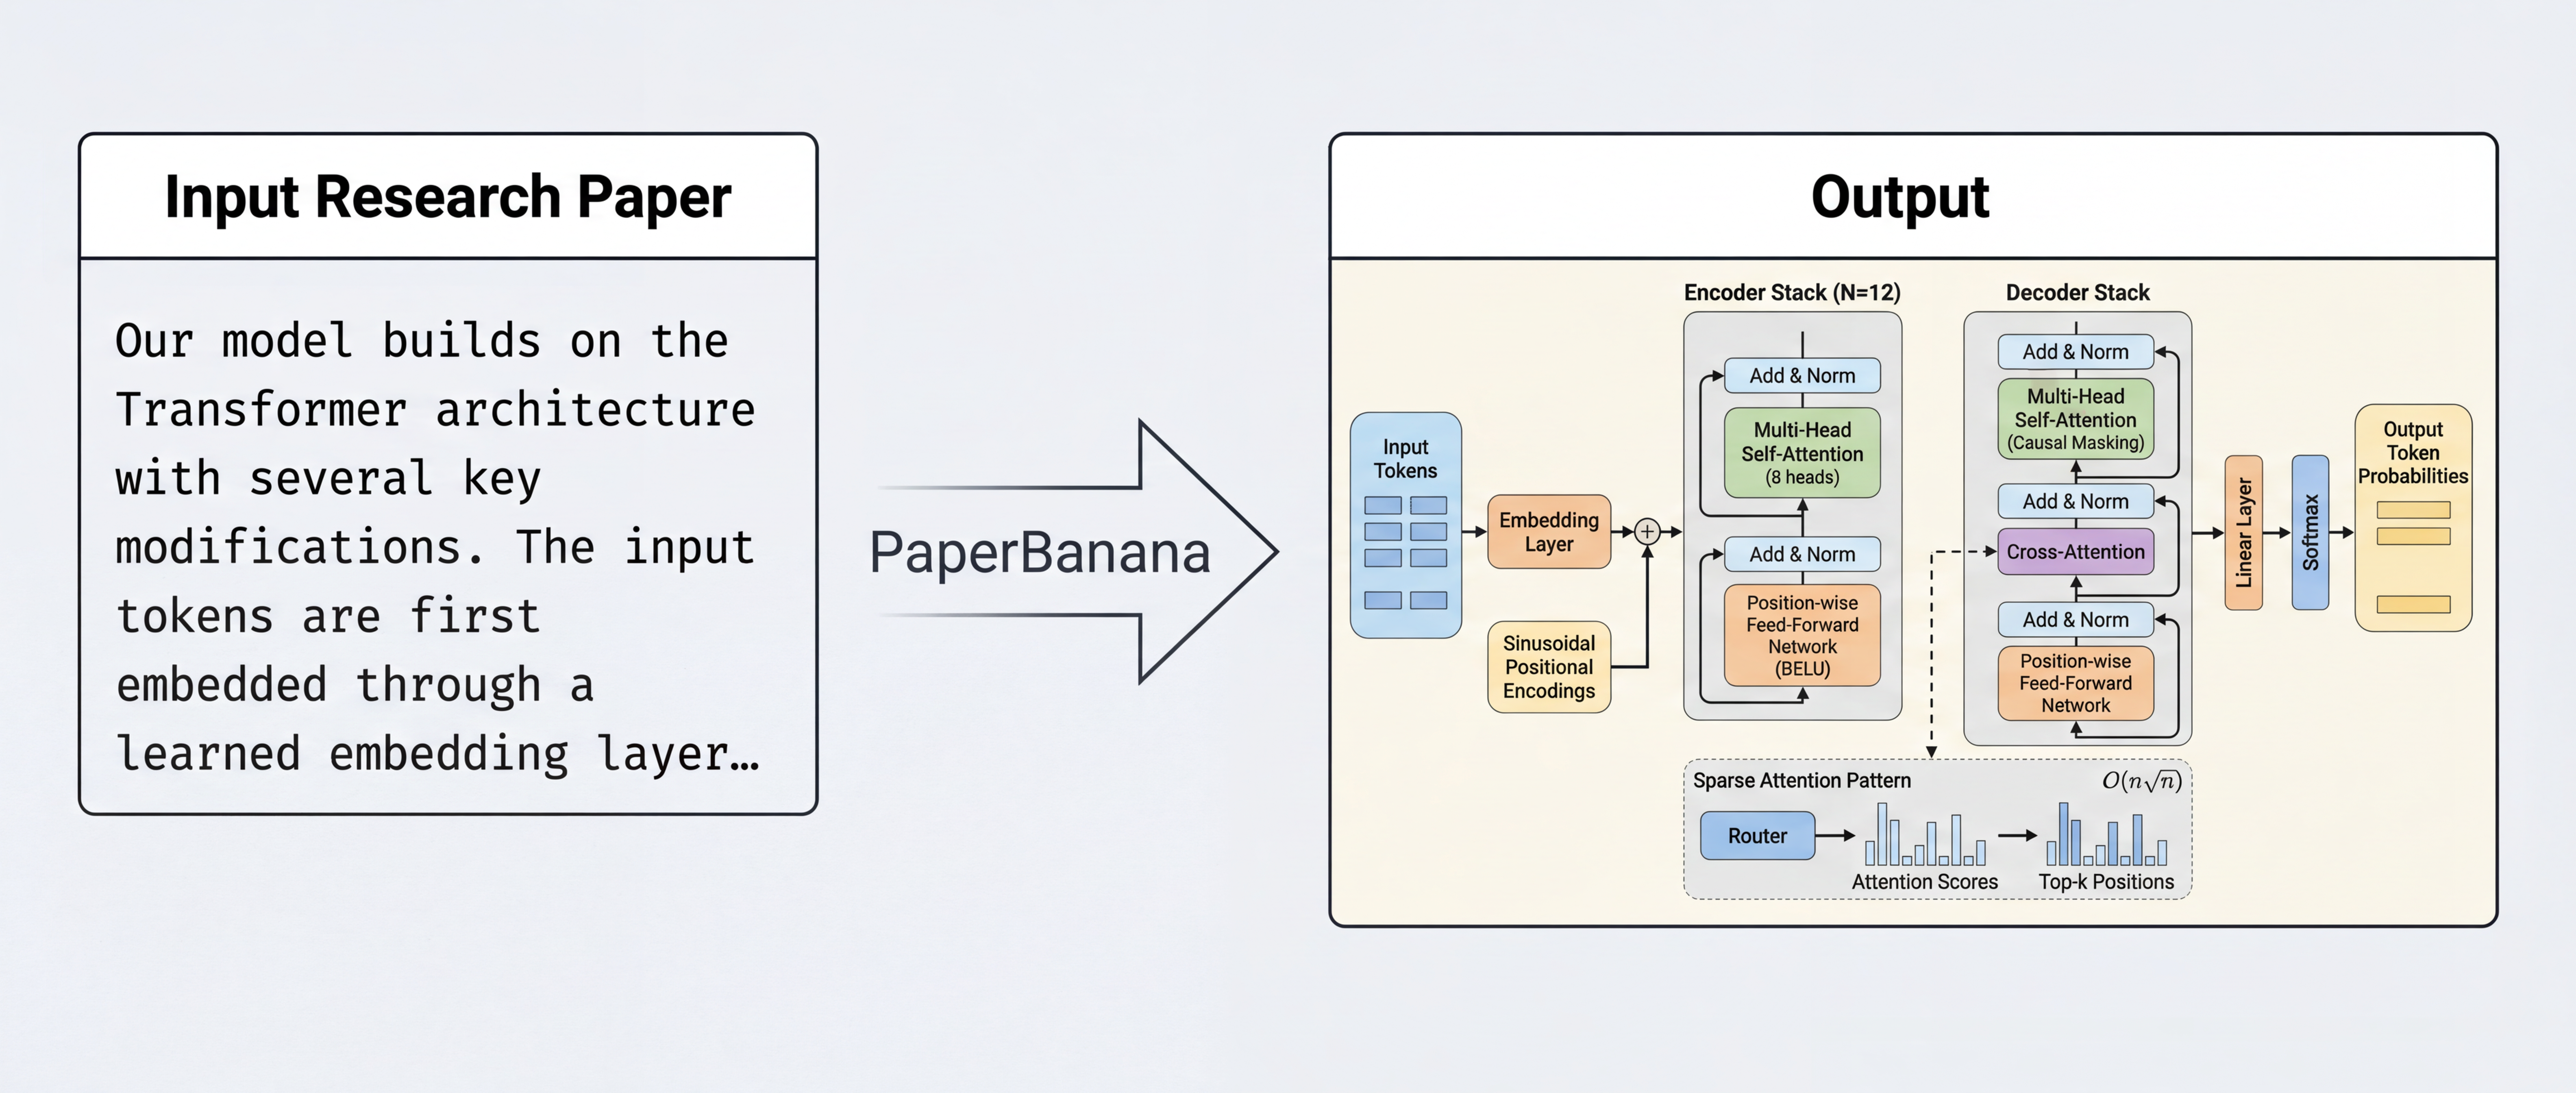
Un marco agéntico para generar diagramas académicos de calidad de publicación y gráficos estadísticos a partir de descripciones de texto. Compatible con OpenAI (GPT-5.2 + GPT-Image-1.5), Azure OpenAI / Foundry, Google Gemini y proveedores de Atlas Cloud.
- Pipeline multiagente de dos fases con refinamiento iterativo
- Múltiples proveedores de VLM y generación de imágenes (OpenAI, Azure, Gemini, Atlas Cloud)
- Capa de optimización de entrada para una mejor calidad de generación
- Modo de auto-refinamiento y continuación de ejecución con comentarios del usuario
- CLI, API de Python y servidor MCP para integración con IDE
- Generación por lotes desde un archivo de manifiesto (YAML/JSON) para múltiples diagramas en una sola ejecución
- Gráficos por lotes —
paperbanana plot-batchejecuta muchos gráficos estadísticos desde un manifiesto (CSV/JSON por elemento) - Entradas PDF para contexto de metodología (
paperbanana[pdf]/ PyMuPDF opcional), con selección por página - PaperBanana Studio — interfaz web local de Gradio (
paperbanana studio) para diagramas, gráficos, evaluación, lotes y navegador de ejecuciones - Habilidades de Claude Code para
/generate-diagram,/generate-ploty/evaluate-diagram
¿Aprendiendo conceptos de LLM? También publicamos 211 tarjetas visuales gratuitas sobre atención, RAG, agentes e inferencia. Léelas en línea.
Atlas Cloud
Atlas Cloud es una plataforma de inferencia de IA multimodal que brinda a los desarrolladores una única API de IA para acceder a APIs de generación de video, generación de imágenes y LLM. En lugar de gestionar múltiples integraciones de proveedores, te conectas una vez y obtienes acceso unificado a más de 300 modelos seleccionados en todas las modalidades.
Consulta la nueva promoción del plan de codificación de Atlas Cloud para un acceso a la API más económico: https://www.atlascloud.ai/console/coding-plan
Inicio Rápido
Pruébalo en tu navegador: el cuaderno de inicio rápido de Colab te guía a través de instalación → clave de API → generación de diagramas de principio a fin, sin necesidad de configuración local.
Requisitos previos
- Python 3.10+
- Una clave de API de OpenAI (platform.openai.com) o un endpoint de Azure OpenAI / Foundry
- O una clave de API de Google Gemini (gratuita, Google AI Studio)
Paso 1: Instalar
pip install paperbanana
O instalar desde el código fuente para desarrollo:
git clone https://github.com/llmsresearch/paperbanana.git
cd paperbanana
pip install -e ".[dev,openai,google]"
Docker
Construye la imagen desde un clon del repositorio y pasa tu clave de API en tiempo de ejecución:
docker build -t paperbanana .
docker run --rm -e GOOGLE_API_KEY paperbanana generate --help
Para generar un diagrama, monta tu entrada y una carpeta de salidas en /work:
docker run --rm -e GOOGLE_API_KEY \
  -v "$(pwd)/method.txt:/work/method.txt:ro" \
  -v "$(pwd)/outputs:/work/outputs" \
  paperbanana generate --input method.txt --caption "Overview of our framework"
Paso 2: Obtén tu clave de API
cp .env.example .env
# Edit .env and add your API key:
#   OPENAI_API_KEY=your-key-here
#   GOOGLE_API_KEY=your-key-here
#
# For Azure OpenAI / Foundry:
#   OPENAI_BASE_URL=https://<resource>.openai.azure.com/openai/v1
#
# Optional Gemini overrides:
#   GOOGLE_BASE_URL=https://your-gemini-proxy.example.com
#   GOOGLE_VLM_MODEL=gemini-2.5-flash
#   GOOGLE_IMAGE_MODEL=gemini-3-pro-image-preview
O usa el asistente de configuración para Gemini:
paperbanana setup
Paso 3: Genera un diagrama
paperbanana generate \
  --input examples/sample_inputs/transformer_method.txt \
  --caption "Overview of our encoder-decoder architecture with sparse routing"
Con optimización de entrada y auto-refinamiento:
paperbanana generate \
  --input my_method.txt \
  --caption "Overview of our encoder-decoder framework" \
  --optimize --auto
La salida se guarda en outputs/run_<timestamp>/final_output.png junto con todas las iteraciones intermedias y metadatos.
PaperBanana Studio (interfaz web local)
Instala la dependencia opcional de Gradio y luego inicia la aplicación:
pip install 'paperbanana[studio]'
paperbanana studio
Abre la URL que se muestra en la terminal (por defecto http://127.0.0.1:7860/). El Studio expone los mismos flujos de trabajo que la CLI: diagramas de metodología, gráficos estadísticos, evaluación comparativa, continuación de una ejecución anterior, manifiestos por lotes (metodología o lote de gráficos a través de la pestaña Batch) y un navegador simple para las carpetas de salida run_* / batch_*. Usa --host, --port, --config y --output-dir según sea necesario.
Cómo Funciona
PaperBanana implementa un pipeline multiagente con hasta 7 agentes especializados:
Fase 0 -- Optimización de Entrada (opcional, --optimize):
- Optimizador de Entrada ejecuta dos llamadas VLM en paralelo:
- Enriquecedor de Contexto estructura el texto de metodología crudo en un formato listo para diagramas (componentes, flujos, agrupaciones, E/S)
- Afinador de Leyendas transforma leyendas vagas en especificaciones visuales precisas
Fase 1 -- Planificación Lineal:
- Recuperador selecciona los ejemplos de referencia más relevantes de un conjunto curado de 13 diagramas de metodología que abarcan dominios de agente/razonamiento, visión/percepción, generativo/aprendizaje y ciencia/aplicaciones
- Planificador genera una descripción textual detallada del diagrama objetivo mediante aprendizaje en contexto a partir de los ejemplos recuperados
- Estilista refina la descripción para la estética visual usando pautas de estilo NeurIPS (paleta de colores, diseño, tipografía)
Fase 2 -- Refinamiento Iterativo:
- Visualizador renderiza la descripción en una imagen
- Crítico evalúa la imagen generada contra el contexto fuente y proporciona una descripción revisada que aborda cualquier problema
- Los pasos 4-5 se repiten durante un número fijo de iteraciones (por defecto 3), o hasta que el crítico esté satisfecho (
--auto)
Proveedores
PaperBanana admite múltiples proveedores de VLM y generación de imágenes:
| Componente | Proveedor | Modelo | Notas |
|---|---|---|---|
| VLM (planificación, crítica) | OpenAI | gpt-5.2 | Predeterminado |
| Generación de Imágenes | OpenAI | gpt-image-1.5 | Predeterminado |
| VLM | Atlas Cloud | deepseek-ai/DeepSeek-V3-0324 | Endpoint de chat compatible con OpenAI |
| Generación de Imágenes | Atlas Cloud | openai/gpt-image-2/text-to-image | API de predicción asíncrona |
| VLM | Google Gemini | gemini-2.5-flash | Bajo costo |
| Generación de Imágenes | Google Gemini | gemini-3-pro-image-preview | $0.134/imagen (1K) |
| VLM / Imagen | OpenRouter | Cualquier modelo compatible | Enrutamiento flexible |
Los endpoints de Azure OpenAI / Foundry se detectan automáticamente — establece OPENAI_BASE_URL a tu endpoint.
También se admiten puertas de enlace compatibles con Gemini — establece GOOGLE_BASE_URL cuando sea necesario.
Atlas Cloud usa ATLASCLOUD_BASE_URL=https://api.atlascloud.ai/v1 para chat y ATLASCLOUD_IMAGE_BASE_URL=https://api.atlascloud.ai/api/v1 para generación de imágenes.
Sitio oficial de Atlas Cloud: https://www.atlascloud.ai/?utm_source=github&utm_medium=link&utm_campaign=paperbanana
Modelos LLM de Atlas recomendados para ATLASCLOUD_VLM_MODEL:
deepseek-ai/DeepSeek-V3-0324(predeterminado)openai/gpt-4oopenai/gpt-4.1google/gemini-2.5-flashanthropic/claude-sonnet-4.5-20250929
Estos son modelos estables, generalmente disponibles y verificados contra la API de Atlas Cloud. El grupo completo de modelos siempre actualizado (más de 300 modelos) está documentado en la propia documentación de Atlas Cloud — consulta https://www.atlascloud.ai/models — y cualquier id de modelo listado allí se puede pasar a través de ATLASCLOUD_VLM_MODEL.
Modelos de imagen de Atlas recomendados para ATLASCLOUD_IMAGE_MODEL:
openai/gpt-image-2/text-to-imageopenai/gpt-image-2/editbaidu/ERNIE-Image-Turbo/text-to-imageblack-forest-labs/flux-devblack-forest-labs/flux-schnellqwen/qwen-image
Referencia de CLI
paperbanana generate -- Diagramas de Metodología
# Basic generation
paperbanana generate \
  --input method.txt \
  --caption "Overview of our framework"

# With input optimization and auto-refine
paperbanana generate \
  --input method.txt \
  --caption "Overview of our framework" \
  --optimize --auto

# Continue the latest run with user feedback
paperbanana generate --continue \
  --feedback "Make arrows thicker and colors more distinct"

# Continue a specific run
paperbanana generate --continue-run run_20260218_125448_e7b876 \
  --iterations 3

# PDF as input (install PyMuPDF: pip install 'paperbanana[pdf]')
paperbanana generate \
  --input paper.pdf \
  --caption "Overview of our method" \
  --pdf-pages "3-8"

# Guide generation with a reference/sketch image (repeatable)
paperbanana generate \
  --input method.txt \
  --caption "Overview of our framework" \
  --image sketch.png --image prior_figure.png
| Banderín | Corto | Descripción |
|---|---|---|
--input | -i | Ruta al archivo de texto de metodología o PDF (requerido para nuevas ejecuciones) |
--caption | -c | Leyenda de figura / intención comunicativa (requerido para nuevas ejecuciones) |
--image | Imagen de referencia/borrador (boceto a mano, foto de pizarra, figura anterior) que guía al Planificador. Repetible para múltiples imágenes | |
--output | -o | Ruta de imagen de salida (predeterminado: generada automáticamente en outputs/) |
--iterations | -n | Número de rondas de refinamiento Visualizador-Crítico (predeterminado: 3) |
--num-candidates | -k | Genera N imágenes candidatas en paralelo, 1-8 (predeterminado: 1). La planificación se ejecuta una vez; el refinamiento se expande por candidato con desplazamientos de semilla. Las salidas se colocan en candidates/cand_<i>/; la raíz de ejecución final_output es el candidato 1. Las estimaciones de costo y --budget tienen en cuenta la expansión |
--auto | Bucle hasta que el crítico esté satisfecho (con límite de seguridad --max-iterations) | |
--max-iterations | Límite de seguridad para el modo --auto (predeterminado: 30) | |
--optimize | Preprocesa entradas con enriquecimiento de contexto en paralelo y afinamiento de leyendas | |
--continue | Continúa desde la ejecución más reciente en outputs/ | |
--continue-run | Continúa desde un ID de ejecución específico | |
--feedback | Comentarios del usuario para el crítico al continuar una ejecución | |
--pdf-pages | Solo entrada PDF: páginas basadas en 1 (ej. 1-5, 2,4,6-8; predeterminado: todas) | |
--vlm-provider | Nombre del proveedor VLM (predeterminado: openai) | |
--vlm-model | Nombre del modelo VLM (predeterminado: gpt-5.2) | |
--image-provider | Proveedor de generación de imágenes (predeterminado: openai_imagen) | |
--image-model | Modelo de generación de imágenes (predeterminado: gpt-image-1.5) | |
--format | -f | Formato de salida: png, jpeg o webp (predeterminado: png) |
--config | Ruta al archivo de configuración YAML (consulta configs/config.yaml) | |
--verbose | -v | Muestra el progreso detallado del agente y los tiempos |
--progress-json | Emite eventos de progreso JSON a stdout durante la generación |
paperbanana plot -- Gráficos Estadísticos
paperbanana plot \
  --data results.csv \
  --intent "Bar chart comparing model accuracy across benchmarks"
| Banderín | Corto | Descripción |
|---|---|---|
--data | -d | Ruta al archivo de datos, CSV o JSON (requerido) |
--intent | Intención comunicativa para el gráfico (requerido) | |
--output | -o | Ruta de imagen de salida |
--iterations | -n | Iteraciones de refinamiento (predeterminado: 3) |
--vlm-provider | Nombre del proveedor VLM | |
--vlm-model | Nombre del modelo VLM |
Los gráficos se renderizan mediante código matplotlib generado por VLM — no se requieren proveedores de generación de imágenes ni credenciales.
paperbanana venues -- Paquetes de Estilo de Venue Personalizados
--venue selecciona un paquete de estilo de venue: un directorio con methodology_style_guide.md, plot_style_guide.md y un venue.yaml opcional. Los paquetes integrados (neurips, icml, acl, ieee) se incluyen con PaperBanana; puedes agregar los tuyos bajo ~/.config/paperbanana/venues/ (anula con --venue-dir o PAPERBANANA_VENUE_DIR) sin tocar el repositorio:
# 1. Scaffold a pack (seeds both guides from the NeurIPS templates)
paperbanana venues init mylab

# 2. Edit the style guides — or generate them from a corpus of example figures:
#    paperbanana guidelines synthesize --reference-set ./examples \
#      --output ~/.config/paperbanana/venues/mylab/methodology_style_guide.md

# 3. Use it anywhere --venue is accepted
paperbanana generate --input method.txt --caption "Overview" --venue mylab

# See everything that's available (built-in + user, with source)
paperbanana venues list
venue.yaml (todos los campos opcionales):
display_name: "My Lab Style"  # shown by `paperbanana venues list`
aspect_ratio: "16:9"          # default --aspect-ratio for this venue's runs
fonts:                        # preferred fonts, appended to the style guides
  - "Helvetica"
En caso de conflicto de nombres, los paquetes integrados ganan — los paquetes de usuario no pueden eclipsar los venues integrados. Los nombres de venue desconocidos fallan rápidamente con la lista de paquetes disponibles de ambas fuentes.
paperbanana batch -- Generación por Lotes
Genera múltiples diagramas de metodología desde un único archivo de manifiesto (YAML o JSON). Cada elemento ejecuta el pipeline completo; las salidas se escriben bajo outputs/batch_<id>/run_<id>/ y un batch_report.json resume todas las ejecuciones.
paperbanana batch --manifest examples/batch_manifest.yaml --optimize
Formato de manifiesto (YAML o JSON con una lista items):
items:
  - input: path/to/method1.txt
    caption: "Overview of our encoder-decoder"
    id: fig1
  - input: method2.txt
    caption: "Training pipeline"
    id: fig2
  - input: paper.pdf
    caption: "System overview"
    id: fig3
    pdf_pages: "4-9" # optional; PDF inputs only
Las rutas en el manifiesto se resuelven en relación con el directorio del archivo de manifiesto.
Figuras compuestas: Agrega una sección opcional composite para unir automáticamente todos los paneles generados en una sola figura etiquetada después de que el lote se complete:
composite:
  layout: "1x3"          # rows x cols, or "auto"
  labels: auto            # (a), (b), (c)... or explicit list, or null
  spacing: 20             # pixels between panels
  label_position: bottom  # top or bottom
  output: "composite.png"

items:
  - input: method_encoder.txt
    caption: "Encoder architecture"
    id: panel_a
  # ...
La imagen compuesta se guarda junto con los paneles individuales en el directorio de salida del lote. Consulta examples/composite_batch_manifest.yaml para un ejemplo completo.
Genera un informe legible por humanos a partir de una ejecución de lote existente (Markdown o HTML):
paperbanana batch-report --batch-dir outputs/batch_20250109_123456_abc --format markdown
# or by batch ID (under default output dir)
paperbanana batch-report --batch-id batch_20250109_123456_abc --format html --output report.html
Los informes de lotes de diagramas incluyen batch_kind: methodology; los lotes de gráficos usan batch_kind: statistical_plot. Los informes legibles por humanos (paperbanana batch-report) muestran el tipo de lote cuando está presente.
Los manifiestos de barrido te permiten almacenar el plan completo de barrido como YAML/JSON en lugar de ocho banderas CLI separadas por comas. Son mutuamente excluyentes con las banderas de eje; consulta examples/sweep_manifest.yaml.
paperbanana sweep --manifest examples/sweep_manifest.yaml
Los informes de barrido producidos por paperbanana sweep se pueden renderizar de la misma manera:
paperbanana sweep-report --sweep-dir outputs/sweep_20250109_123456_abc --format html
# or by sweep ID
paperbanana sweep-report --sweep-id sweep_20250109_123456_abc --format markdown
Los informes de barrido renderizados incluyen un resumen, una tabla clasificada de los 5 mejores, la tabla completa de variantes (con proveedor/modelo por variante, iteraciones, recuento de sugerencias del crítico, puntuación proxy y ruta de salida), y la nota quality_proxy_score. Los informes de ejecución en seco renderizan una sección simplificada de "Variantes Planificadas".
| Bandera | Corta | Descripción |
|---|---|---|
--manifest | -m | Ruta al archivo de manifiesto (obligatorio) |
--output-dir | -o | Directorio principal para la ejecución del lote (predeterminado: outputs) |
--config | Ruta al YAML de configuración | |
--iterations | -n | Iteraciones de refinamiento por elemento |
--optimize | Preprocesar entradas para cada elemento | |
--auto | Bucle hasta que el crítico esté satisfecho por elemento | |
--format | -f | Formato de imagen de salida (png, jpeg, webp) |
--auto-download-data | Descargar automáticamente el conjunto de referencia PaperBananaBench (~254 MB) si no está en caché |
paperbanana plot-batch -- Gráficos Estadísticos por Lote
Genera múltiples gráficos a partir de un manifiesto (YAML o JSON). Cada elemento especifica un archivo de datos (CSV o JSON) y una cadena de intención, reflejando paperbanana plot. Las salidas se ubican bajo outputs/batch_<id>/run_<id>/ con el mismo flujo de trabajo batch_report.json y paperbanana batch-report que los lotes de diagramas.
paperbanana plot-batch --manifest examples/plot_batch_manifest.yaml --optimize
Formato del manifiesto (lista items):
items:
  - data: path/to/results.csv
    intent: "Bar chart comparing accuracy across models"
    id: fig_acc
  - data: other.json
    intent: "Scatter plot with trend line"
    aspect_ratio: "16:9"   # optional per item; CLI --aspect-ratio is the default when omitted
Las rutas se resuelven en relación con el directorio del archivo de manifiesto.
| Bandera | Corta | Descripción |
|---|---|---|
--manifest | -m | Ruta al manifiesto (obligatorio) |
--output-dir | -o | Directorio principal para batch_* (predeterminado: outputs) |
--config | Ruta al YAML de configuración | |
--vlm-provider | Proveedor VLM (predeterminado: gemini) | |
--vlm-model | Anulación del modelo VLM | |
--image-provider | Proveedor de generación de imágenes | |
--image-model | Modelo de generación de imágenes | |
--iterations | -n | Iteraciones de refinamiento por elemento |
--auto | Bucle hasta que el crítico esté satisfecho por elemento | |
--max-iterations | Límite de seguridad para --auto | |
--optimize | Optimización de entrada por elemento | |
--format | -f | png, jpeg o webp |
--save-prompts / --no-save-prompts | Persistir indicaciones (predeterminado: activado, igual que plot) | |
--venue | Paquete de estilo de sede: integrado (neurips, icml, acl, ieee), un paquete de usuario o custom | |
--aspect-ratio | -ar | Relación de aspecto predeterminada cuando no se establece en el manifiesto |
--verbose | -v | Registro detallado |
paperbanana orchestrate -- Paquete de Figuras de Artículo Completo
Genera un paquete de figuras enfocado en publicación a partir de una fuente de artículo completo, con gráficos opcionales basados en datos. El comando:
- analiza el artículo (
.txt,.mdo.pdf) - planifica múltiples figuras de metodología a partir de la estructura de secciones
- opcionalmente descubre archivos CSV/JSON para planificar gráficos estadísticos
- ejecuta la generación de todos los elementos planificados
- escribe una carpeta de paquete que contiene
figure_package.json,figures/,figures.texycaptions.md
paperbanana orchestrate \
  --paper paper.pdf \
  --data-dir ./results \
  --max-method-figures 4 \
  --max-plot-figures 3 \
  --optimize
Usa --dry-run para solo planificar e inspeccionar orchestration_plan.json sin llamadas a la API.
Usa --resume-orchestrate <id-or-path> para continuar una orquestación interrumpida desde el estado de punto de control.
| Bandera | Descripción |
|---|---|
--paper / -p | Ruta de origen del artículo (.txt, .md o .pdf) |
--resume-orchestrate | Reanudar una orquestación existente por ID o directorio |
--retry-failed | Al reanudar, incluir tareas que fallaron anteriormente |
--max-retries | Reintentos adicionales por tarea después del primer fallo |
--data-dir | Directorio opcional que contiene archivos CSV/JSON para la planificación de gráficos |
--output-dir / -o | Directorio de salida principal (crea orchestrate_*) |
--max-method-figures | Máximo de figuras de metodología para planificar/generar |
--max-plot-figures | Máximo de figuras de gráficos para planificar/generar |
--pdf-pages | Selección de páginas solo PDF (por ejemplo, 1-5, 2,4,6-8) |
--optimize | Habilitar optimización de entrada para elementos generados |
--iterations / -n | Iteraciones de refinamiento por elemento generado |
--auto + --max-iterations | Modo de auto-refinamiento impulsado por crítico con límite de seguridad |
--concurrency | Trabajadores de generación de figuras en paralelo |
--format / -f | Formato de salida (png, jpeg, webp) |
--dry-run | Solo planificar paquete; sin llamadas de generación |
paperbanana composite -- Componer Figuras de Múltiples Paneles
Une múltiples imágenes en una sola figura etiquetada con etiquetas de subpanel (a), (b), (c):
paperbanana composite \
  panel_a.png panel_b.png panel_c.png \
  --layout 1x3 \
  --output figure2.png
| Bandera | Corta | Descripción |
|---|---|---|
IMAGES | Posicional: rutas a las imágenes para componer | |
--layout | -l | Diseño de cuadrícula: RxC (por ejemplo, 1x3, 2x2) o auto (predeterminado: auto) |
--labels | Etiquetas separadas por comas, o none para deshabilitar (predeterminado: auto (a),(b),...) | |
--spacing | -s | Espaciado en píxeles entre paneles (predeterminado: 20) |
--label-position | top o bottom (predeterminado: inferior) | |
--label-font-size | Tamaño de fuente para etiquetas (predeterminado: 32) | |
--output | -o | Ruta de salida (predeterminado: composite_output.png) |
Este comando funciona en cualquier imagen existente: no se necesitan llamadas a la API. También se activa automáticamente cuando un manifiesto de lote incluye una sección composite (consulta paperbanana batch arriba).
paperbanana evaluate -- Evaluación de Calidad
Evaluación comparativa de un diagrama generado contra una referencia humana usando VLM-como-Juez:
paperbanana evaluate \
  --generated diagram.png \
  --reference human_diagram.png \
  --context method.txt \
  --caption "Overview of our framework"
| Bandera | Corta | Descripción |
|---|---|---|
--generated | -g | Ruta a la imagen generada (obligatorio) |
--reference | -r | Ruta a la imagen de referencia humana (obligatorio) |
--context | Ruta al archivo de texto de contexto fuente o PDF (obligatorio) | |
--caption | -c | Título de la figura (obligatorio) |
--pdf-pages | Solo contexto PDF: selección de páginas basada en 1 (predeterminado: todas) |
Puntuaciones en 4 dimensiones (agregación jerárquica según el artículo):
- Primarias: Fidelidad, Legibilidad
- Secundarias: Concisión, Estética
paperbanana polish -- Refinar una Figura Existente
Trae tu propia figura: un VLM la audita contra la guía de estilo de la sede y propone hasta 10 mejoras concretas y accionables, luego un proveedor capaz de editar imágenes las aplica a la figura original (edición guiada). Las sugerencias se imprimen en la consola para que puedas ver exactamente qué cambió.
paperbanana polish --input figure.png
paperbanana polish --input figure.png --venue icml --iterations 2 --output polished.png
| Bandera | Corta | Descripción |
|---|---|---|
--input | -i | Ruta a la imagen de figura existente (obligatorio) |
--output | -o | Ruta de salida (predeterminado: outputs/polish_<timestamp>/final_output.png) |
--venue | Guía de estilo de sede: neurips (predeterminado), icml, acl, ieee, custom | |
--iterations | -n | Rondas de pulido; cada ronda sugiere y aplica mejoras sobre el resultado anterior (predeterminado: 1) |
--aspect-ratio | -ar | Relación de aspecto objetivo (predeterminado: conservar la relación de la figura de entrada) |
--num-candidates | -k | Aplicar las sugerencias de cada ronda N veces en paralelo (1-8) |
--budget | Límite de presupuesto en USD; el pulido se detiene correctamente cuando se excede | |
--seed | Semilla aleatoria para ediciones reproducibles |
Requiere un proveedor de imágenes que admita ediciones de imágenes guiadas (modelos de imagen de Google Gemini). Si la figura ya cumple con la guía de estilo, el pulido sale sin hacer cambios.
paperbanana studio -- Interfaz web local
Requiere pip install 'paperbanana[studio]' (Gradio).
paperbanana studio
paperbanana studio --port 8080 --output-dir ./my_outputs
| Bandera | Descripción |
|---|---|
--host | Dirección de enlace (predeterminado 127.0.0.1) |
--port | Puerto (predeterminado 7860) |
--share | Crear un enlace público temporal de Gradio (no usar con datos sensibles) |
--config | Ruta al YAML de configuración |
--output-dir / -o | Directorio de salida predeterminado para ejecuciones |
--root-path | Subruta de URL cuando está detrás de un proxy inverso |
paperbanana setup -- Configuración por Primera Vez
paperbanana setup
Asistente interactivo que primero pregunta si usar la API oficial de Gemini. Si eliges la API oficial, sigue el flujo predeterminado de clave de AI Studio; si no, pide una URL personalizada compatible con Gemini y una clave de API.
paperbanana data -- Conjunto de Datos de Referencia
# Download the PaperBananaBench reference set (~254 MB, one command)
paperbanana data download

# Import plot references too (or both)
paperbanana data download --task plot
paperbanana data download --task both

# Inspect / clear the cache
paperbanana data info
paperbanana data clear
El conjunto de datos se sirve desde un espejo de lanzamiento de GitHub alojado por el proyecto
(bench-data-v1)
y su suma de verificación SHA256 se verifica antes de la extracción. Crédito a los
autores de PaperBananaBench —
el espejo sigue su revisión del 2026-03-22. El conjunto se almacena en caché bajo
~/.cache/paperbanana/ (anular con PAPERBANANA_CACHE_DIR); los comandos
de generación también pueden obtenerlo en el primer uso a través de --auto-download-data.
API de Python
import asyncio
from paperbanana import PaperBananaPipeline, GenerationInput, DiagramType
from paperbanana.core.config import Settings

settings = Settings(
    vlm_provider="openai",
    vlm_model="gpt-5.2",
    image_provider="openai_imagen",
    image_model="gpt-image-1.5",
    optimize_inputs=True,   # Enable input optimization
    auto_refine=True,       # Loop until critic is satisfied
)

pipeline = PaperBananaPipeline(settings=settings)

result = asyncio.run(pipeline.generate(
    GenerationInput(
        source_context="Our framework consists of...",
        communicative_intent="Overview of the proposed method.",
        diagram_type=DiagramType.METHODOLOGY,
    )
))

print(f"Output: {result.image_path}")
Devoluciones de llamada de progreso: generate() y continue_run() aceptan un argumento opcional progress_callback. El pipeline lo invoca con objetos PipelineProgressEvent (etapa, mensaje, segundos, iteración, extra) en cada paso (optimizador, recuperador, planificador, estilista, visualizador, crítico), para que puedas mostrar el progreso en interfaces o registrar tiempos sin parchear agentes.
Para continuar una ejecución anterior:
from paperbanana.core.resume import load_resume_state

state = load_resume_state("outputs", "run_20260218_125448_e7b876")
result = asyncio.run(pipeline.continue_run(
    resume_state=state,
    additional_iterations=3,
    user_feedback="Make the encoder block more prominent",
))
Consulta examples/generate_diagram.py y examples/generate_plot.py para ejemplos completos de trabajo.
Servidor MCP
PaperBanana incluye un servidor MCP para usar con Claude Code, Cursor o cualquier cliente compatible con MCP. Agrega la siguiente configuración para usarlo a través de uvx sin un clon local:
{
  "mcpServers": {
    "paperbanana": {
      "command": "uvx",
      "args": ["--from", "paperbanana[mcp]", "paperbanana-mcp"],
      "env": { "GOOGLE_API_KEY": "your-google-api-key" }
    }
  }
}
Se exponen once herramientas MCP: generate_diagram, generate_plot, continue_run (reanudar un run_* anterior con comentarios opcionales), continue_diagram, continue_plot, evaluate_diagram, evaluate_plot, orchestrate_figures (paquetes de figuras de artículo completo), batch_diagrams, batch_plots y download_references.
El repositorio también incluye 3 habilidades de Claude Code:
/generate-diagram <file> [caption]- generar un diagrama de metodología a partir de un archivo de texto/generate-plot <data-file> [intent]- generar un gráfico estadístico a partir de datos CSV/JSON/evaluate-diagram <generated> <reference>- evaluar un diagrama contra una referencia humana
Consulta mcp_server/README.md para detalles completos de configuración (Claude Code, Cursor, desarrollo local).
Integración con Overleaf (Acción de GitHub)
Mantén la figura de metodología de tu artículo sincronizada con el texto, automáticamente. PaperBanana incluye una Acción de GitHub que se combina con la sincronización integrada de GitHub de Overleaf: envía tus cambios de .tex, la acción extrae la sección de metodología, genera la figura y confirma de vuelta la imagen más un fragmento de LaTeX listo para \input. Tira de Overleaf y estará en tu árbol de archivos.
- uses: actions/checkout@v4
- uses: llmsresearch/paperbanana/integrations/github-action@main
  with:
    tex-file: sections/method.tex
    caption: "Overview of our proposed framework"
  env:
    OPENAI_API_KEY: ${{ secrets.OPENAI_API_KEY }}
See integrations/github-action/README.md para el flujo de trabajo completo, todas las entradas y las opciones de control de costos.
Configuración
La configuración predeterminada se encuentra en configs/config.yaml. Se puede sobrescribir mediante banderas de línea de comandos o un YAML personalizado:
paperbanana generate \
  --input method.txt \
  --caption "Overview" \
  --config my_config.yaml
Configuración clave:
vlm:
  provider: openai           # openai, atlas, gemini, or openrouter
  model: gpt-5.2

image:
  provider: openai_imagen    # openai_imagen, atlas_imagen, google_imagen, or openrouter_imagen
  model: gpt-image-1.5

pipeline:
  num_retrieval_examples: 10
  refinement_iterations: 3
  # auto_refine: true        # Loop until critic is satisfied
  # max_iterations: 30       # Safety cap for auto_refine mode
  # optimize_inputs: true    # Preprocess inputs for better generation
  output_resolution: "2k"

reference:
  path: data/reference_sets

output:
  dir: outputs
  save_iterations: true
  save_metadata: true
Variables de entorno (.env):
# OpenAI (default)
OPENAI_API_KEY=your-key
OPENAI_BASE_URL=https://api.openai.com/v1    # or Azure endpoint
OPENAI_VLM_MODEL=gpt-5.2                      # override model
OPENAI_IMAGE_MODEL=gpt-image-1.5              # override model

# Atlas Cloud
ATLASCLOUD_API_KEY=your-key
ATLASCLOUD_BASE_URL=https://api.atlascloud.ai/v1
ATLASCLOUD_VLM_MODEL=deepseek-ai/DeepSeek-V3-0324
ATLASCLOUD_IMAGE_BASE_URL=https://api.atlascloud.ai/api/v1
ATLASCLOUD_IMAGE_MODEL=openai/gpt-image-2/text-to-image

# Google Gemini (alternative, free)
GOOGLE_API_KEY=your-key
GOOGLE_BASE_URL=                            # optional custom Gemini-compatible endpoint
GOOGLE_VLM_MODEL=gemini-2.5-flash          # override Gemini VLM model
GOOGLE_IMAGE_MODEL=gemini-3-pro-image-preview  # override Gemini image model
Estructura del Proyecto
paperbanana/
├── paperbanana/
│   ├── core/          # Pipeline orchestration, types, config, resume, utilities
│   ├── agents/        # Optimizer, Retriever, Planner, Stylist, Visualizer, Critic
│   ├── providers/     # VLM and image gen provider implementations
│   │   ├── vlm/       # OpenAI, Atlas Cloud, Gemini, OpenRouter VLM providers
│   │   └── image_gen/ # OpenAI, Atlas Cloud, Gemini, OpenRouter image gen providers
│   ├── reference/     # Reference set management (13 curated examples)
│   ├── guidelines/    # Style guidelines loader
│   └── evaluation/    # VLM-as-Judge evaluation system
├── configs/           # YAML configuration files
├── prompts/           # Prompt templates for all agents + evaluation
│   ├── diagram/       # context_enricher, caption_sharpener, retriever, planner, stylist, visualizer, critic
│   ├── plot/          # plot-specific prompt variants
│   └── evaluation/    # faithfulness, conciseness, readability, aesthetics
├── data/
│   ├── reference_sets/  # 13 verified methodology diagrams
│   └── guidelines/      # NeurIPS-style aesthetic guidelines
├── examples/          # Working example scripts + sample inputs
├── scripts/           # Data curation and build scripts
├── tests/             # Test suite
├── mcp_server/        # MCP server for IDE integration
└── .claude/skills/    # Claude Code skills (generate-diagram, generate-plot, evaluate-diagram)
Desarrollo
# Install with dev dependencies
pip install -e ".[dev,openai,google]"

# Run tests
pytest tests/ -v

# Lint
ruff check paperbanana/ mcp_server/ tests/ scripts/

# Format
ruff format paperbanana/ mcp_server/ tests/ scripts/
Citación
Esta es una implementación no oficial. Si utilizas este trabajo, por favor cita el artículo original:
@article{zhu2026paperbanana,
  title={PaperBanana: Automating Academic Illustration for AI Scientists},
  author={Zhu, Dawei and Meng, Rui and Song, Yale and Wei, Xiyu
          and Li, Sujian and Pfister, Tomas and Yoon, Jinsung},
  journal={arXiv preprint arXiv:2601.23265},
  year={2026}
}
Artículo original: https://arxiv.org/abs/2601.23265
Aviso legal
Este proyecto es una reimplementación independiente de código abierto basada en el artículo disponible públicamente. No está afiliado, respaldado ni conectado con los autores originales, Google Research o la Universidad de Pekín de ninguna manera. La implementación puede diferir del sistema original descrito en el artículo. Úsalo bajo tu propio criterio.
Licencia
MIT