engram-rs-mcp
Servidor MCP para engram — memoria persistente similar a la humana para agentes de IA.
Documentación
engram-rs


Motor de memoria para agentes de IA. Dos ejes: tiempo (decaimiento y promoción en tres capas) y espacio (árbol de temas autoorganizado). Los recuerdos importantes se promueven, el ruido se desvanece y el conocimiento relacionado se agrupa automáticamente.
La mayoría de las memorias de agentes son un almacén plano: se vuelca todo y se usa búsqueda por palabras clave para recuperarlo. Sin olvido, sin organización, sin ciclo de vida. engram-rs añade la parte que hace que la memoria sea realmente útil: la capacidad de olvidar lo que no importa y sacar a la superficie lo que sí.
Un único binario de Rust, un solo archivo SQLite, cero dependencias externas. Sin Python, sin Redis, sin base de datos vectorial — curl | bash y funciona. Binario de ~10 MB, ~100 MB de RSS, latencia de búsqueda de un solo dígito en milisegundos.
Inicio Rápido
# Install (interactive — will prompt for embedding provider config)
curl -fsSL https://raw.githubusercontent.com/kael-bit/engram-rs/main/install.sh | bash

# Store a memory
curl -X POST http://localhost:3917/memories \
  -d '{"content": "Always run tests before deploying", "tags": ["deploy"]}'

# Recall by meaning
curl -X POST http://localhost:3917/recall \
  -d '{"query": "deployment checklist"}'

# Restore full context (session start)
curl http://localhost:3917/resume
Qué Hace
Ciclo de Vida en Tres Capas
Inspirado en el modelo de memoria de Atkinson–Shiffrin, los recuerdos se gestionan en tres capas según su importancia:
Buffer (short-term) → Working (active knowledge) → Core (long-term identity)
      ↓                       ↓                           ↑
   eviction              importance decay           LLM quality gate
- Buffer: Punto de entrada para todos los recuerdos nuevos. Almacenamiento temporal — se desaloja cuando está por debajo del umbral
- Trabajo: Promovido mediante consolidación. Nunca se elimina, la importancia decae a diferentes ritmos según el tipo
- Núcleo: Promovido mediante el control de calidad del LLM. Nunca se elimina
Control de Calidad del LLM
La promoción no es una suposición basada en reglas — un LLM evalúa cada recuerdo en contexto y decide si realmente merece retención a largo plazo.
Buffer → [LLM gate: "Is this a decision, lesson, or preference?"] → Working
Working → [sustained access + LLM gate] → Core
Decaimiento Automático
El decaimiento está impulsado por la actividad — solo se activa durante ciclos de consolidación activos, no por tiempo de reloj. Si el sistema está inactivo, los recuerdos permanecen intactos.
El decaimiento exponencial sigue la curva de olvido de Ebbinghaus — rápido al principio, luego cola larga. Los recuerdos nunca desaparecen por completo (piso = 0.01), permaneciendo recuperables bajo consultas precisas. Cuando se recupera un recuerdo, recibe un impulso de activación, fortaleciendo el conocimiento de uso frecuente.
| Tipo | Tasa de decaimiento | Vida media | Caso de uso |
|---|---|---|---|
episodic | Más rápida | ~35 épocas | Eventos, experiencias, contexto limitado en el tiempo |
semantic | Media | ~58 épocas | Conocimiento, preferencias, lecciones (predeterminado) |
procedural | Más lenta | ~173 épocas | Flujos de trabajo, instrucciones, guías prácticas |
Visualizaciones de Algoritmos
| Gráfico | Qué muestra |
|---|---|
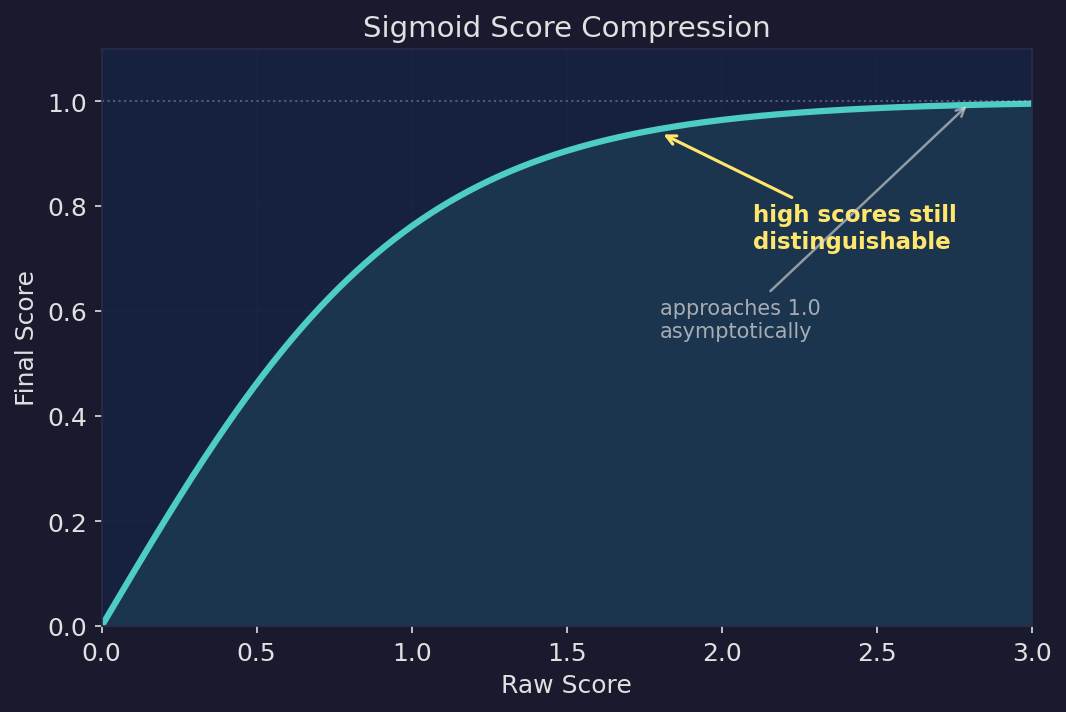 | Compresión de puntuación sigmoide. Las puntuaciones brutas se mapean mediante una función sigmoide, acercándose a 1.0 asintóticamente. Los resultados de alta relevancia siguen siendo distinguibles en lugar de aplastarse en el mismo valor. |
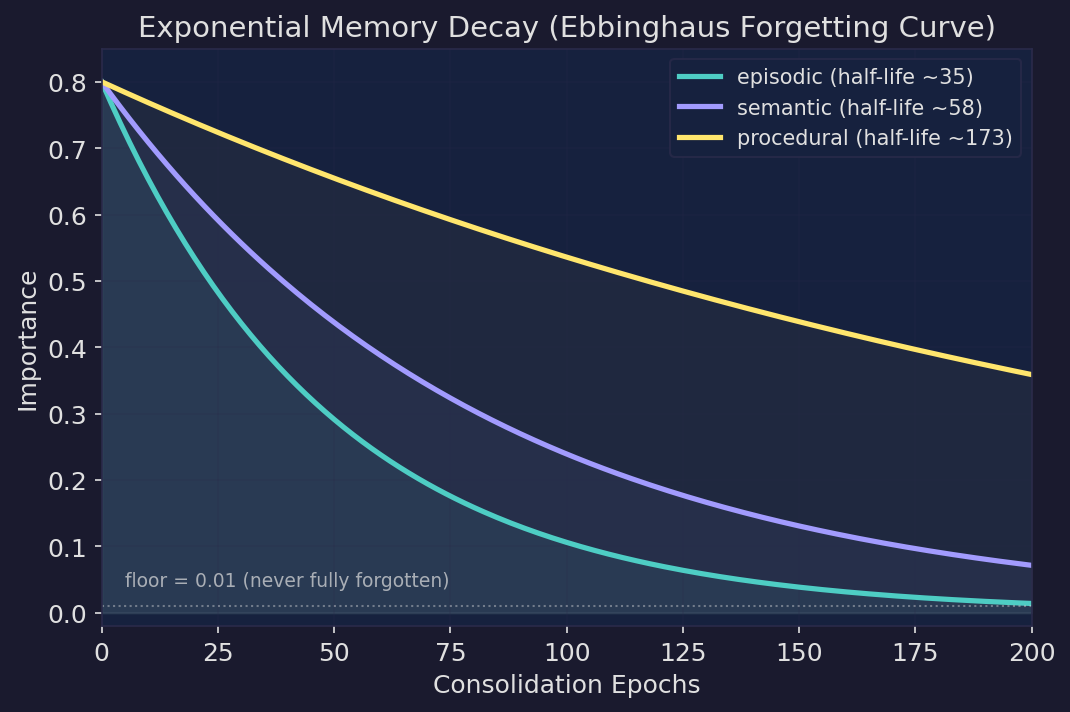 | Curva de olvido de Ebbinghaus. Decaimiento exponencial con tasas diferenciadas por tipo — los recuerdos episódicos se desvanecen más rápido, los procedimentales más lento. El piso en 0.01 significa que los recuerdos nunca desaparecen por completo; permanecen recuperables bajo consultas precisas. |
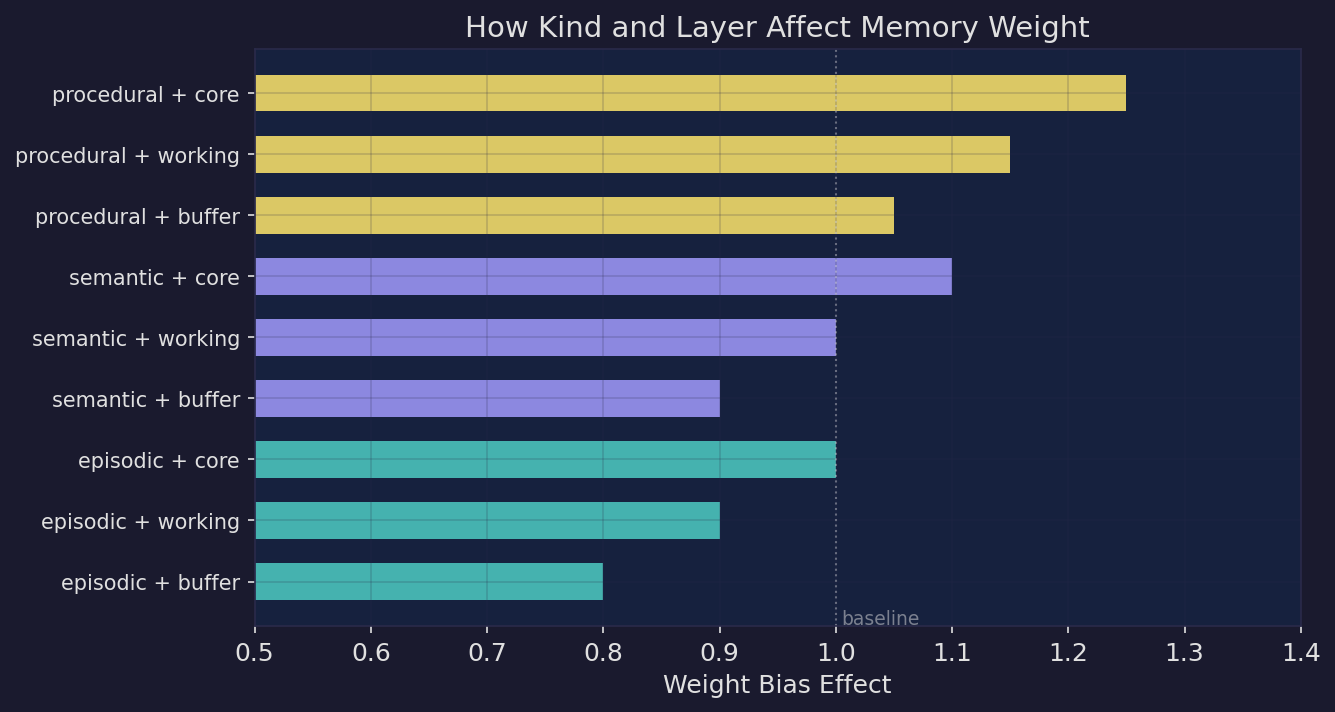 | Sesgo de peso por tipo × capa. Los sesgos aditivos ajustan el peso del recuerdo según tipo y capa. Los recuerdos procedimentales+núcleo se clasifican más alto, los episódicos+buffer más bajo — pero la dispersión se mantiene acotada para que ninguna combinación domine. |
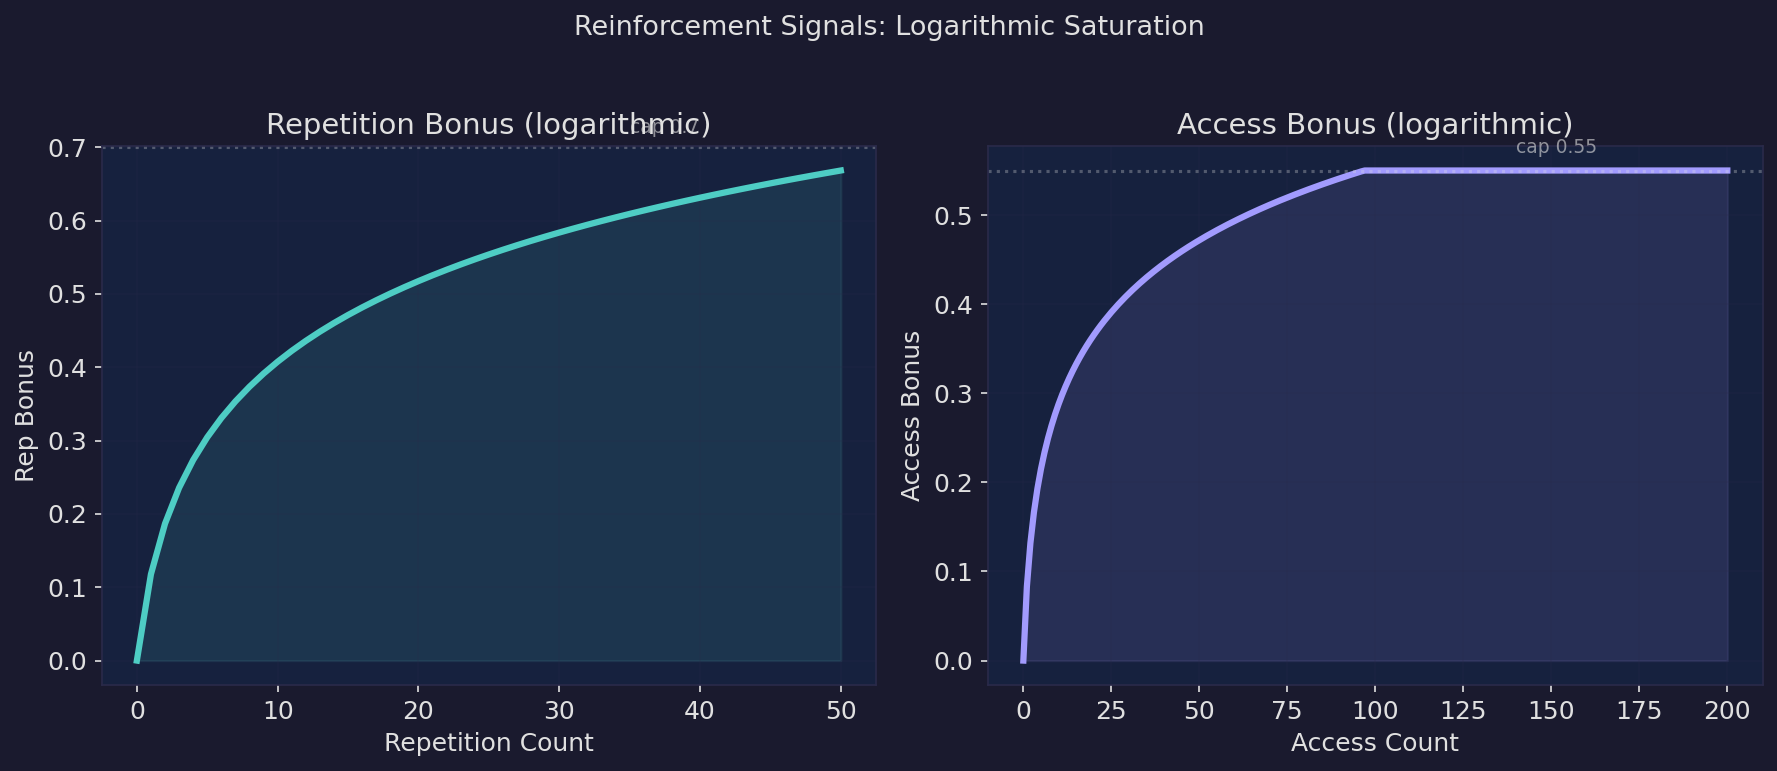 | Señales de refuerzo. Las bonificaciones por repetición y acceso siguen una saturación logarítmica. Las interacciones tempranas importan más; las posteriores contribuyen con rendimientos decrecientes, discriminando entre "usado ocasionalmente" y "usado a diario". |
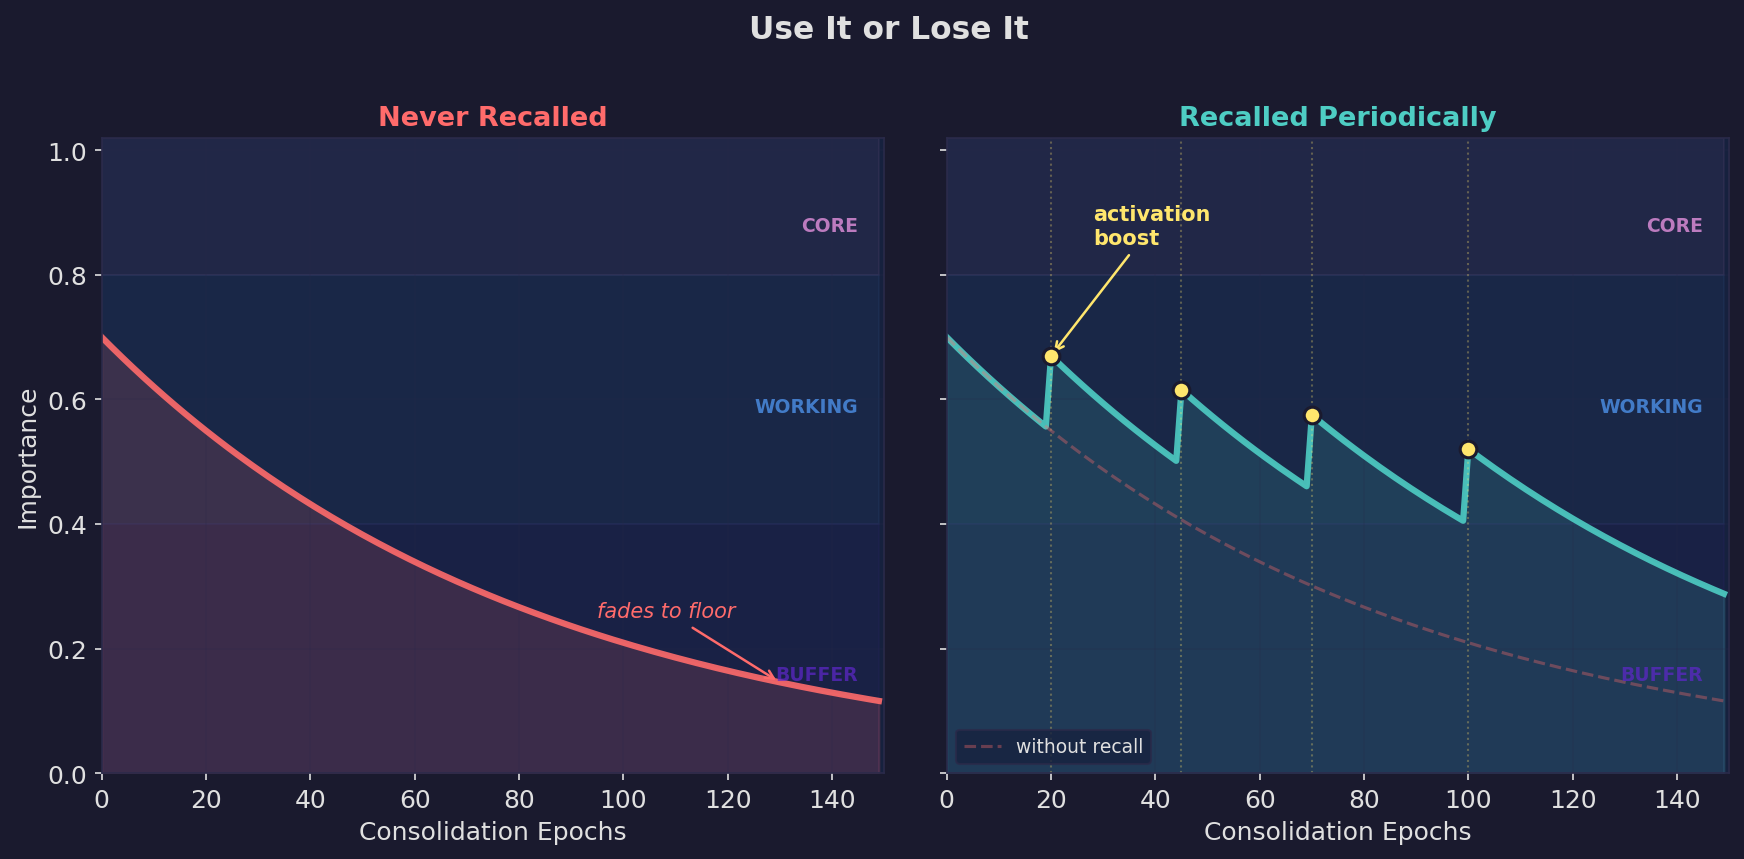 | Úsalo o piérdelo. Izquierda: un recuerdo que nunca se recupera decae hacia la capa buffer. Derecha: la recuperación periódica activa impulsos de activación que mantienen el recuerdo en la capa de trabajo. La línea discontinua muestra la trayectoria sin recuperación para comparación. |
Deduplicación y Fusión Semántica
¿Dos recuerdos que dicen lo mismo con palabras diferentes? Se detectan y fusionan automáticamente:
"use PostgreSQL for auth" + "auth service runs on Postgres"
→ Merged into one, preserving context from both
Árbol de Temas Autoorganizado
La agrupación vectorial agrupa recuerdos relacionados, el LLM nombra los grupos. Sin etiquetado manual requerido:
Memory Architecture
├── Three-layer lifecycle [4]
├── Embedding pipeline [3]
└── Consolidation logic [5]
Deploy & Ops
├── CI/CD procedures [3]
└── Production incidents [2]
User Preferences [6]
El problema que esto resuelve: la búsqueda vectorial requiere hacer la pregunta correcta. Los árboles de temas permiten a los agentes navegar por tema — escanear el directorio, profundizar en la rama correcta.
Disparadores
Etiqueta un recuerdo con trigger:deploy, y el agente puede recuperar todas las lecciones de implementación antes de ejecutar:
curl -X POST http://localhost:3917/memories \
  -d '{"content": "LESSON: always backup DB before migration", "tags": ["trigger:deploy", "lesson"]}'

# Pre-deployment check
curl http://localhost:3917/triggers/deploy
Recuperación de Sesión
El agente se despierta, llama a GET /resume, obtiene el contexto completo. Sin necesidad de escanear archivos:
=== Core (24) ===
deploy: test → build → stop → start (procedural)
LESSON: never force-push to main
...

=== Recent ===
switched auth to OAuth2
published API docs

=== Topics (Core: 24, Working: 57, Buffer: 7) ===
kb1: "Deploy Procedures" [5]
kb2: "Auth Architecture" [3]
kb3: "Memory Design" [8]
...

Triggers: deploy, git-push, database-migration
| Sección | Contenido | Propósito |
|---|---|---|
| Núcleo | Texto completo de reglas permanentes e identidad | Lo inolvidable |
| Reciente | Recuerdos modificados recientemente | Continuidad a corto plazo |
| Temas | Índice de temas (tabla de contenidos) | Profundizar bajo demanda, sin carga completa |
| Disparadores | Etiquetas previas a la acción | Recuperación automática de lecciones antes de operaciones riesgosas |
El agente lee el directorio, encuentra temas relevantes, llama a POST /topic para expandir bajo demanda.
Búsqueda y Recuperación
Embeddings semánticos + búsqueda por palabras clave BM25 con tokenización CJK (jieba). Puntuación ponderada por IDF — los términos raros reciben un impulso, los términos comunes se reducen automáticamente. Sin listas de palabras vacías que mantener.
# Semantic search
curl -X POST http://localhost:3917/recall \
  -d '{"query": "how do we handle auth", "budget_tokens": 2000}'
# Note: min_score defaults to 0.30. Use "min_score": 0.0 to get all results.

# Topic drill-down
curl -X POST http://localhost:3917/topic \
  -d '{"ids": ["kb3"]}'
Mantenimiento en Segundo Plano
Totalmente automático, impulsado por la actividad — sin escrituras significa que el ciclo se omite:
Consolidación (cada 30 minutos)
- Decaimiento — reducir la importancia de recuerdos no accedidos
- Deduplicación — fusionar recuerdos casi idénticos (coseno > 0.78)
- Triaje — el LLM categoriza nuevos recuerdos del Buffer
- Control — el LLM evalúa por lotes los candidatos a promoción
- Conciliación — resolver pares similares ambiguos (resultados en caché)
- Reconstrucción del árbol de temas — reagrupar y nombrar
Destilación de Temas — cuando un tema crece demasiado (10+ recuerdos), el contenido superpuesto se condensa en entradas más reducidas y ricas.
Aislamiento de Espacios de Nombres
Instancia única, múltiples proyectos. Usa X-Namespace para aislar:
curl -X POST http://localhost:3917/memories \
  -H "X-Namespace: my-project" \
  -d '{"content": "API uses OAuth2 bearer tokens"}'
Instalación
# macOS / Linux
curl -fsSL https://raw.githubusercontent.com/kael-bit/engram-rs/main/install.sh | bash

# Windows (PowerShell)
irm https://raw.githubusercontent.com/kael-bit/engram-rs/main/install.ps1 | iex
Docker
docker run -d --name engram-rs \
  -p 3917:3917 \
  -v engram-data:/data \
  -e ENGRAM_LLM_URL=https://api.openai.com/v1 \
  -e ENGRAM_LLM_KEY=sk-... \
  ghcr.io/kael-bit/engram-rs:latest
Configuración del LLM
engram-rs funciona sin un LLM — la búsqueda por palabras clave y el ciclo de vida basado en reglas siguen funcionando. Añadir un LLM desbloquea funciones inteligentes (triaje, control, fusión, nombrado de temas):
export ENGRAM_LLM_URL=https://api.openai.com/v1
export ENGRAM_LLM_KEY=sk-...

# Any OpenAI-compatible API (Ollama, LM Studio, etc.)
export ENGRAM_LLM_URL=http://localhost:11434/v1

# Anthropic native
export ENGRAM_LLM_PROVIDER=anthropic
export ENGRAM_LLM_KEY=sk-ant-...
Configuración de modelo en dos niveles — modelo fuerte para juicio, ligero para procesamiento de texto:
ENGRAM_GATE_MODEL=gpt-4o          # quality decisions
ENGRAM_LLM_MODEL=gpt-4o-mini     # text processing
Para Agentes de IA
Añade al prompt del sistema de tu agente:
Set up engram-rs (persistent memory) by following the guide at:
https://raw.githubusercontent.com/kael-bit/engram-rs/main/docs/SETUP.md
Integración
Funciona con Claude Code, Cursor, Windsurf, OpenClaw y cualquier herramienta compatible con MCP.
17 herramientas MCP (documentación de MCP) | API HTTP completa (Guía de configuración)
# MCP (Claude Code)
npx engram-rs-mcp

# MCP (Cursor / Windsurf / generic)
{"mcpServers": {"engram": {"command": "npx", "args": ["-y", "engram-rs-mcp"]}}}
Panel Web
Interfaz web integrada en http://localhost:3917/ui para navegar por recuerdos, ver el árbol de temas y monitorear el uso del LLM.
Especificaciones
| Binario | ~10 MB |
| Memoria | ~100 MB de RSS en producción |
| Almacenamiento | SQLite, sin base de datos externa |
| Lenguaje | Rust |
| Plataformas | Linux, macOS, Windows (x86_64 + aarch64) |
| Licencia | MIT |
Licencia
MIT