Jagent Graders MCP
Califica ensayos con rúbricas, revisa currículos y devuelve puntuaciones y decisiones estructuradas a agentes de IA.
Servidor MCP alojado
npx add-mcp 'https://jev-agent.com/api/mcp'Se instala en Claude Code, Codex, Cursor y más
Documentación
¿Existe una API de calificación de ensayos a la que pueda llamar desde código, o desde Claude y Cursor?
Sí. Los calificadores de este sitio son un endpoint REST, un servidor MCP remoto y una skill de Claude, todo con una sola clave jv_live_ y un mismo saldo de créditos. Envía un ensayo y una rúbrica, integrada o propia, y obtén una puntuación en cada criterio con su probabilidad, por aproximadamente 2 créditos por ensayo.
| REST | POST /api/v1/tools/grade — un ensayo o un lote |
|---|---|
| MCP | https://jev-agent.com/api/mcp — siete herramientas para Claude, Cursor y otros clientes |
| Skill | una skill de Claude — llama a los mismos endpoints |
| Facturación | 1 crédito por cada 1,000 tokens de entrada — una solicitud fallida no se cobra |
Tres formas de acceso
| Superficie | Ideal para | Dirección |
|---|---|---|
| API REST | Tu backend, una cola de calificación, un trabajo por lotes | /api/v1/tools/grade, /api/v1/tools/resume-check |
| Servidor MCP | Agentes en Claude Code, Claude Desktop, Cursor, VS Code | https://jev-agent.com/api/mcp |
| Skill de Claude | Claude llamando a la API directamente, sin configuración de servidor | /skills/jagent-graders.zip |
Las tres usan la misma clave jv_live_ para la API de calificación de ensayos, emitida tras iniciar sesión con Google en Acceso a la API, y gastan el mismo saldo. La calificación subyacente es Jev, el modelo de juicio de TypeSafe AI: responde preguntas tipadas con una probabilidad para cada respuesta posible y no escribe texto, por lo que cada puntuación viene con la distribución que la respalda.
La API de calificación de ensayos
La API de calificación de ensayos es un único endpoint: POST /api/v1/tools/grade califica un ensayo, o un lote, contra una rúbrica. Elige essay para ensayos de clase (seis criterios y una nota con letra), common-app para declaraciones personales, sat para el ensayo del SAT School Day, o custom para tu propia rúbrica.
bash
curl https://jev-agent.com/api/v1/tools/grade \
  -H "Authorization: Bearer $JAGENT_API_KEY" \
  -H "content-type: application/json" \
  -d '{"rubric": "essay", "level": "high school",
       "assignment": "Should high schools start later?",
       "essay": "…"}'
Prueba una solicitud · sin necesidad de clave
POST /api/v1/tools/grade
Se ejecuta con el margen de la página para visitantes sin cuenta; con una clave, el mismo cuerpo va a /api/v1/tools/grade y añade un bloque de uso.
La respuesta para nuestro ensayo de calibración de calidad media, recortada:
json
{
  "result": {
    "percent": 78, "letter": "C+",
    "verdict": { "label": "B or higher", "yes": 0.31 },
    "criteria": [
      { "name": "Thesis and focus", "level": "Clear, specific thesis the essay mostly follows", "index": 3.1, "levels": 5 },
      { "name": "Evidence and support", "level": "Some relevant support, thinly developed", "index": 1.58, "levels": 5 }
    ],
    "checks": [{ "label": "Length", "status": "warn", "detail": "209 words — short for most essay assignments…" }],
    "stats": { "words": 209, "paragraphs": 5, "readingGrade": 4.5 }
  },
  "usage": { "credits_charged": 2, "credits_remaining": … }
}
index es la posición exacta del ensayo en la escalera del criterio, 0 en la parte inferior; la fracción indica hacia dónde se inclina. verdict.yes es una probabilidad, y checks son hechos contados que nunca alimentan la calificación. Límites: de 100 a 20,000 caracteres por ensayo, y para lotes de hasta 30 envíos, ocho criterios y una escala de 3 a 6 puntos.
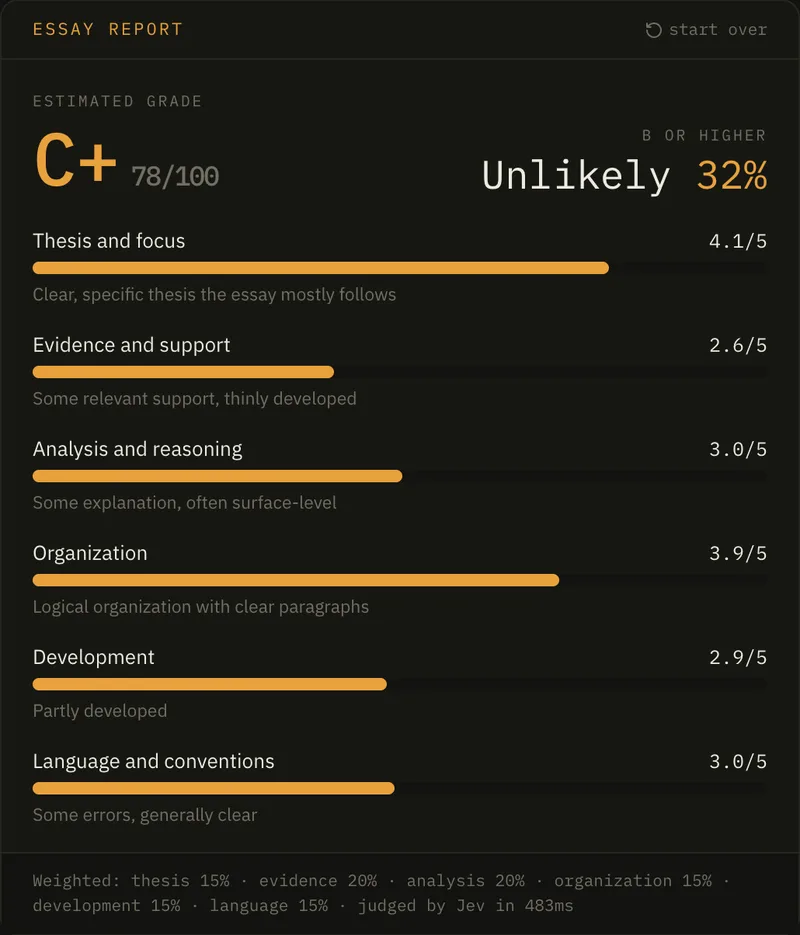
El mismo tipo de resultado, tal como lo dibuja la página del calificador de ensayos.
Calificación por lotes con tu propia rúbrica
json
{
  "rubric": "custom",
  "custom": { "points": 4, "criteria": [
    { "name": "Claim", "description": "States a clear, arguable claim" },
    { "name": "Evidence", "description": "Supports the claim with specific evidence" }
  ]},
  "submissions": [{ "name": "A", "text": "…" }, { "name": "B", "text": "…" }]
}
Cada envío se califica en su propia llamada, cinco a la vez, por lo que la puntuación de un trabajo depende solo del trabajo y de la rúbrica. Tres ensayos volvieron juntos en 0.54 segundos en nuestra prueba.
La API de verificación de currículums
POST /api/v1/tools/resume-check toma resume y un job_description opcional, y devuelve una puntuación de coincidencia de 0 a 100, las palabras clave de la oferta encontradas y faltantes, comprobaciones de formato ATS, el ajuste de nivel y la probabilidad de que un reclutador mueva el currículum a una entrevista — el mismo informe que la página del verificador de currículums con IA. Un currículum más una oferta son aproximadamente 1,100 tokens de entrada, o 2 créditos.
El servidor MCP
El servidor habla Streamable HTTP en https://jev-agent.com/api/mcp. Listar sus herramientas no requiere clave, por lo que un cliente puede ver lo que se ofrece antes de que alguien se registre; llamar a una herramienta requiere la clave en un encabezado Authorization. En Claude Code:
bash
claude mcp add --transport http jagent https://jev-agent.com/api/mcp \
  --header "Authorization: Bearer $JAGENT_API_KEY"
En mcp.json de Cursor (el archivo de VS Code es la misma idea bajo una clave servers, con "type": "http"):
json
{ "mcpServers": { "jagent": {
    "url": "https://jev-agent.com/api/mcp",
    "headers": { "Authorization": "Bearer jv_live_…" } } } }
Los clientes que solo ejecutan servidores locales pueden alcanzarlo a través del puente mcp-remote, pasando el mismo encabezado. Las siete herramientas:
| check_resume | Coincidir un currículum con una oferta: puntuación, palabras clave faltantes, comprobaciones de formato, probabilidad de entrevista. |
|---|---|
| grade_essay | Un ensayo contra la rúbrica de ensayo, Common App o SAT. |
| grade_with_rubric | Hasta 30 envíos contra una rúbrica que el agente proporciona. |
| judge_yes_no | Probabilidad de que la respuesta a una pregunta de sí/no sobre un texto sea sí. |
| judge_choice | La mejor de varias opciones, con una probabilidad para cada una. |
| judge_score | Una posición en una escala ordenada que el agente define. |
| compare_versions | Cuál de dos versiones es más fuerte, preguntado en ambos órdenes. |
Cada herramienta devuelve un resumen de una línea para que el modelo lo lea, seguido del resultado completo como JSON con los créditos cobrados. compare_versions hace su pregunta dos veces con el orden intercambiado, porque en casos reñidos el modelo favorece la opción que lee en segundo lugar — 0.90 en un orden y 0.53 al revés para el mismo par, en nuestras pruebas.
La skill de Claude
La skill jagent-graders es un único SKILL.md: cuándo recurrir a los calificadores, las dos llamadas REST, cómo leer un nivel y un índice, y qué no pedir. En Claude Code, descomprímela en ~/.claude/skills/ y establece JAGENT_API_KEY en el entorno; en las aplicaciones de Claude, sube el zip donde se gestionan las skills. Claude entonces llama a la API con curl siempre que una conversación gira hacia calificar un ensayo o verificar un currículum, y hace la reescritura él mismo.
Facturación y errores
La API de calificación de ensayos factura como el resto del sitio: un crédito compra 1,000 tokens de entrada, redondeados hacia arriba con un mínimo de uno por llamada, cobrados después de que la llamada tenga éxito. Un ensayo de 400 palabras calificado con la rúbrica de seis criterios son aproximadamente 1,300 tokens — 2 créditos; cada envío adicional en un lote añade sus propios tokens. No hay cargo por tokens de salida, porque el modelo no produce ninguno.
Lo que no hace
No reescribe, resume ni genera prosa de retroalimentación; califica, y tu código o tu agente escribe. No detecta plagio ni texto escrito por IA, y sus calificaciones son estimaciones a partir de rúbricas escritas, no puntuaciones oficiales. No guarda nada: los cuerpos de las solicitudes se puntúan y se descartan, y el registro de llamadas registra el endpoint y los créditos, nunca el texto.
Preguntas
¿La API de calificación de ensayos funciona en otros idiomas?
Sí, para el ensayo en sí. Calificamos un ensayo fuerte y uno débil en chino, español, alemán y japonés con la misma rúbrica en inglés: los fuertes obtuvieron 3.95 a 3.99 de 4 en tesis y los débiles 2.36 a 2.65, muy similar al par en inglés. Los nombres de campos y los mensajes de error están en inglés.
¿Hay un modo sandbox o de prueba?
No hay sandbox separado. Una clave nueva viene con un pequeño margen mensual de créditos, suficiente para calificar un par de ensayos y ver la respuesta real, y una solicitud fallida nunca se cobra.
¿Puede un agente usarla sin el servidor MCP?
Sí. La skill de Claude enseña a Claude a llamar a los endpoints REST con curl, y cualquier agente que pueda hacer una solicitud HTTP puede hacer lo mismo con los ejemplos anteriores.