Druid MCP server
Servidor MCP para acceder y administrar la base de datos Apache Druid
Documentación
Servidor MCP de Druid
Un servidor integral del Protocolo de Contexto de Modelos (MCP) para Apache Druid que proporciona amplias herramientas, recursos y avisos para gestionar y analizar clústeres de Druid.
Desarrollado por iunera - Soluciones Avanzadas de IA y Análisis de Datos
Descripción General
Este servidor MCP implementa una arquitectura basada en intenciones donde los perfiles representan su intención de uso y el área correspondiente de uso de Druid. El servidor proporciona tres tipos principales de componentes MCP:
- Herramientas - Funciones ejecutables para realizar operaciones
- Recursos - Proveedores de datos para acceder a información
- Avisos - Plantillas de guía asistidas por IA
Video Demostrativo
Aprenda cómo integrar agentes de IA con Apache Druid usando el servidor MCP. Este tutorial demuestra la exploración de series temporales de datos, análisis estadístico e ingesta de datos usando lenguaje natural con asistentes de IA como Claude, ChatGPT y Gemini.

Haga clic en la miniatura de arriba para ver el video en YouTube
🌊 Y̊pipe: Interfaz de Usuario Impulsada por IA para Druid
Experimente sus datos como nunca antes con Y̊pipe (anteriormente Data-Philter), una aplicación de escritorio local que hace práctico el uso de IA sin conexión, diseñada por iunera. Aprovecha este Servidor MCP de Druid para proporcionar una interfaz conversacional y fluida para su clúster de Druid.
- Consultas en Lenguaje Natural: Haga preguntas en inglés sencillo y obtenga resultados al instante.
- Local y Seguro: Se ejecuta completamente en local con soporte para modelos sin conexión (CPU/GPU).
- Plug & Play: Funciona de inmediato con la Instalación de Desarrollo de Druid.

La forma más fácil de probar iunera/druid-mcp-server es ypipe.com / https://github.com/iunera/ypipe
📋 Plano de Integración de Ypipe
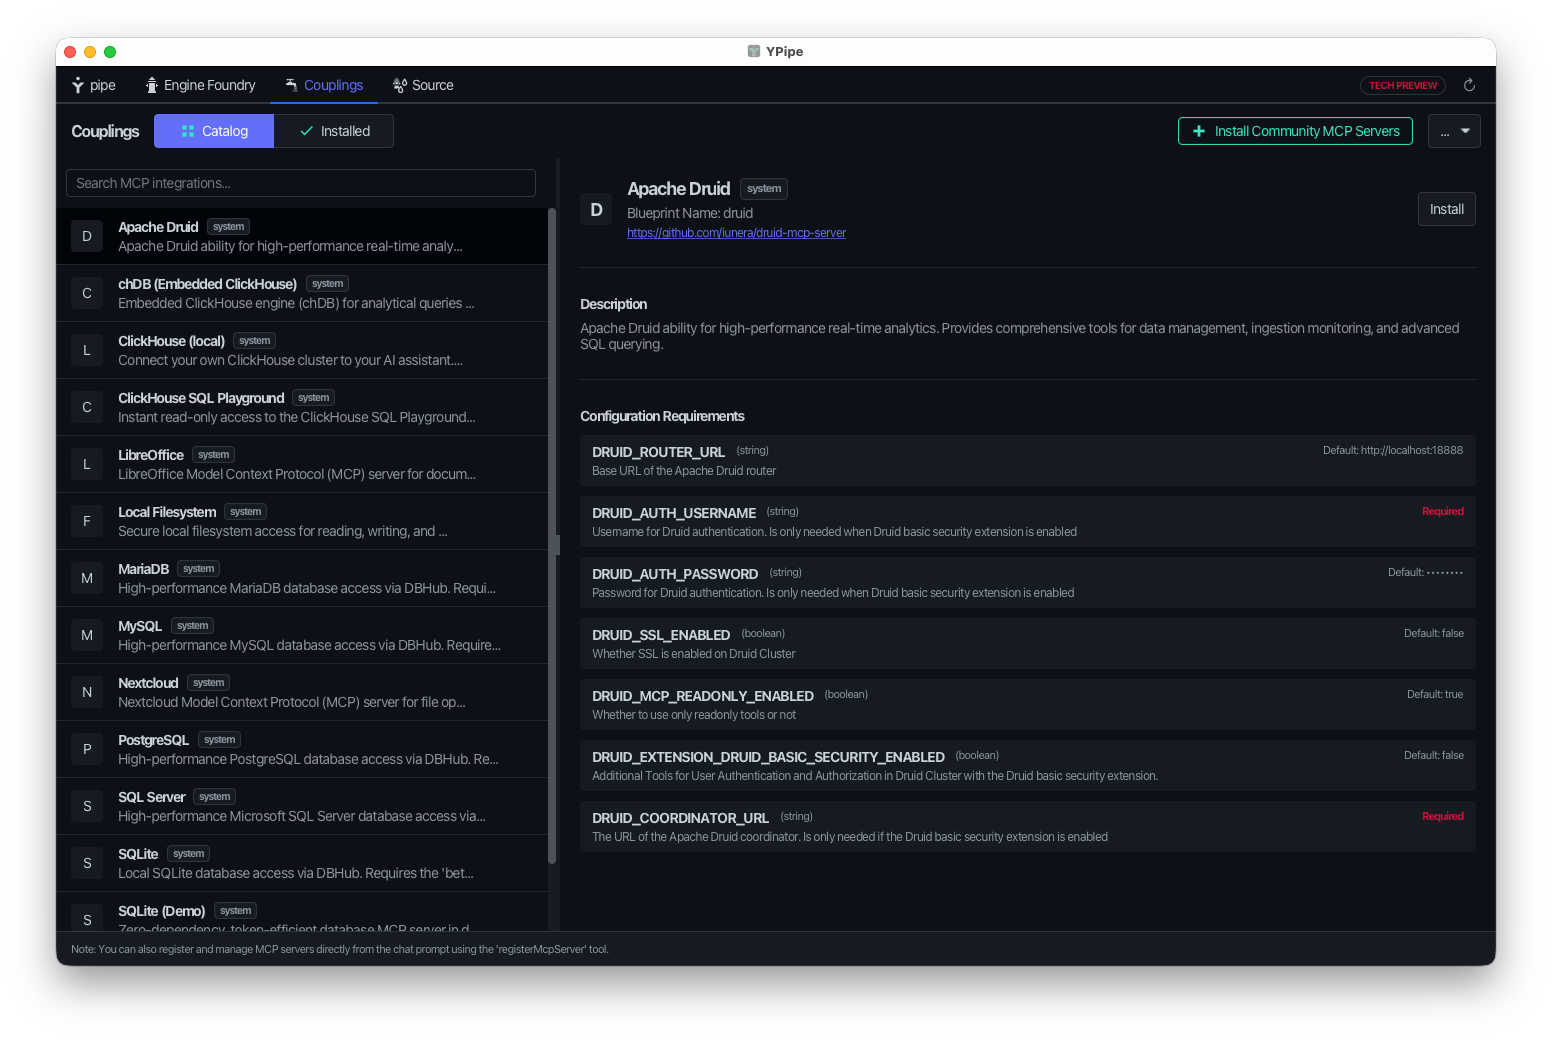
Para una integración fluida, proporcionamos un archivo de plano de integración de Ypipe predefinido:
- Archivo de Plano: druid.ypipe
- Guía de Configuración: Documentación de Ejemplo de Ypipe
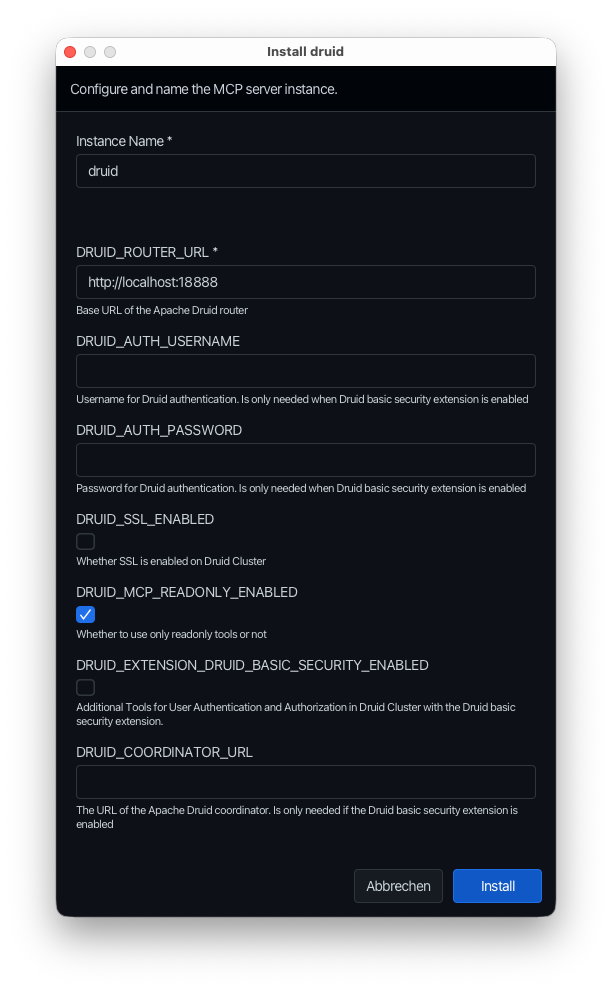
Este plano le permite conectar y configurar fácilmente el servidor MCP de Druid en Ypipe a través de un espacio de trabajo visual.
| Flujo del Espacio de Trabajo de Ypipe | Configuración del Nodo de Druid |
|---|---|
 |  |
Características
- Java puro
- Integración del servidor MCP de Spring AI
- Arquitectura basada en herramientas para el cumplimiento del protocolo MCP
- Arquitectura Basada en Herramientas: Cumplimiento completo del protocolo MCP con generación automática de esquemas JSON
- Múltiples Modos de Transporte: Soporte para STDIO, SSE y HTTP Transmisible incluyendo OAuth
- Comunicación en Tiempo Real: Eventos enviados por el servidor con capacidades de transmisión
- Manejo integral de errores
- Plantillas de Avisos Personalizables: Guía asistida por IA con personalización de plantillas
- Manejo Integral de Errores: Manejo elegante de errores con respuestas significativas
- Listo para Empresas: Configuración de nivel de producción y características de seguridad
Interfaz del Inspector MCP
Cuando se conecta a un cliente MCP, puede inspeccionar las herramientas, recursos y avisos disponibles a través de la interfaz del inspector MCP:
Herramientas Disponibles
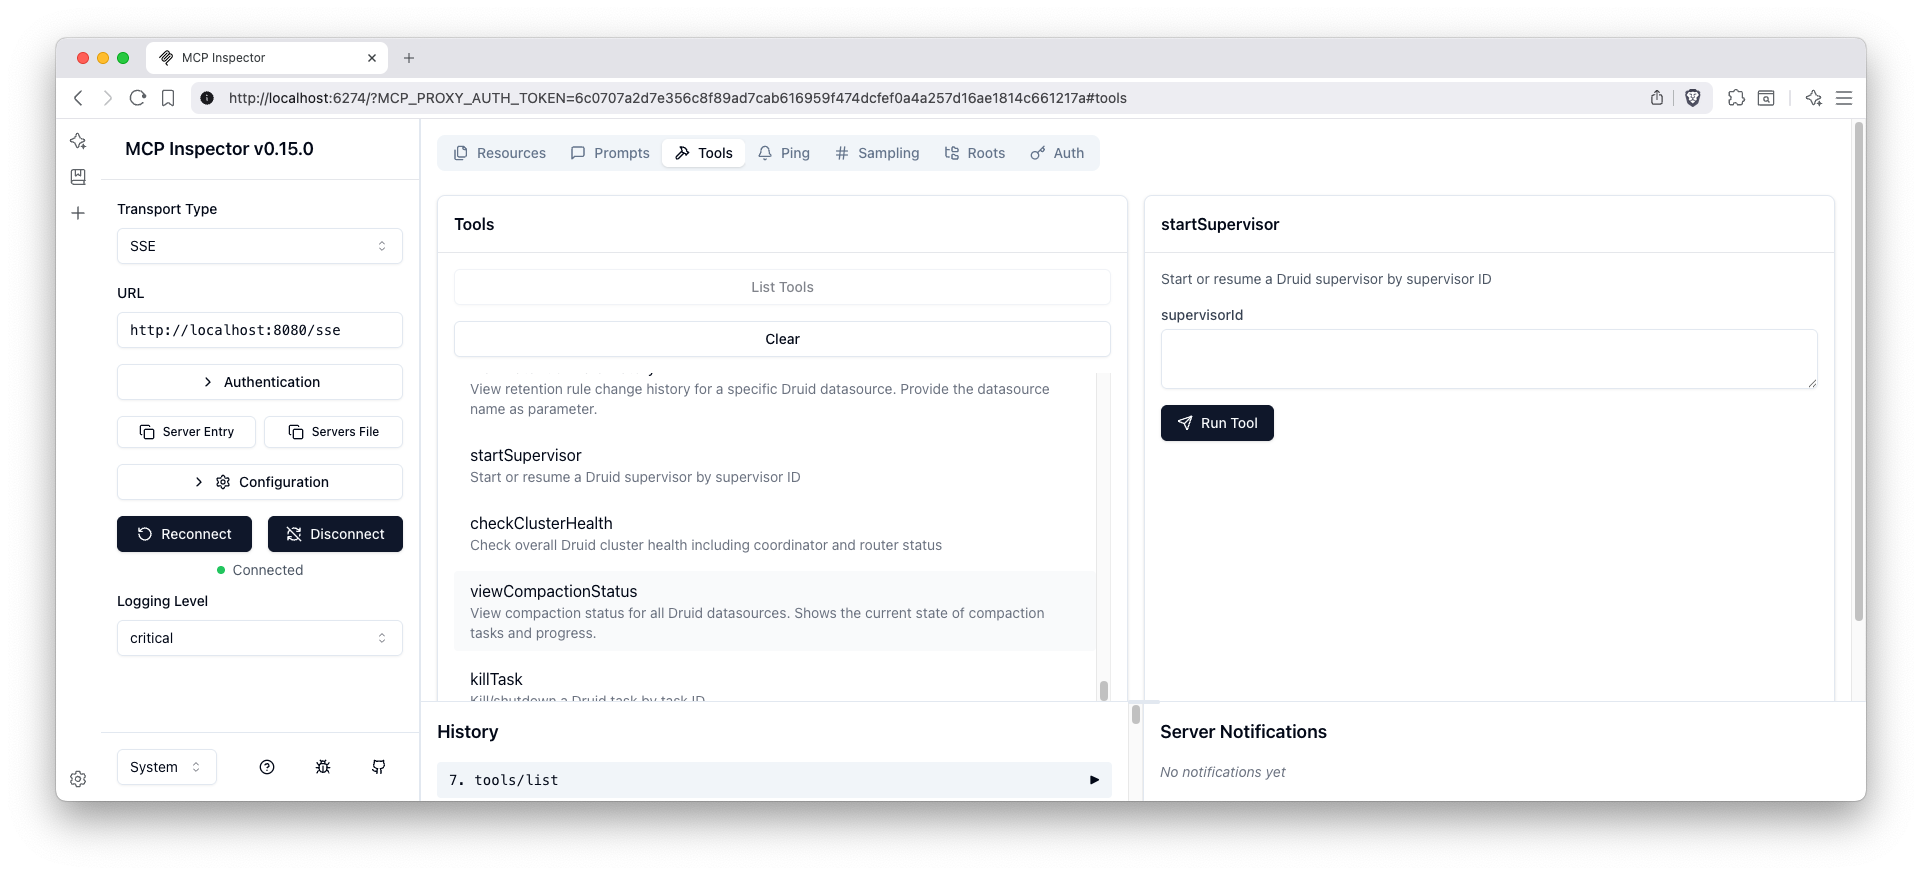
La interfaz de herramientas muestra todas las funciones de gestión de Druid disponibles organizadas por áreas de características, incluyendo gestión de datos, gestión de ingesta y monitoreo y salud.
Recursos Disponibles
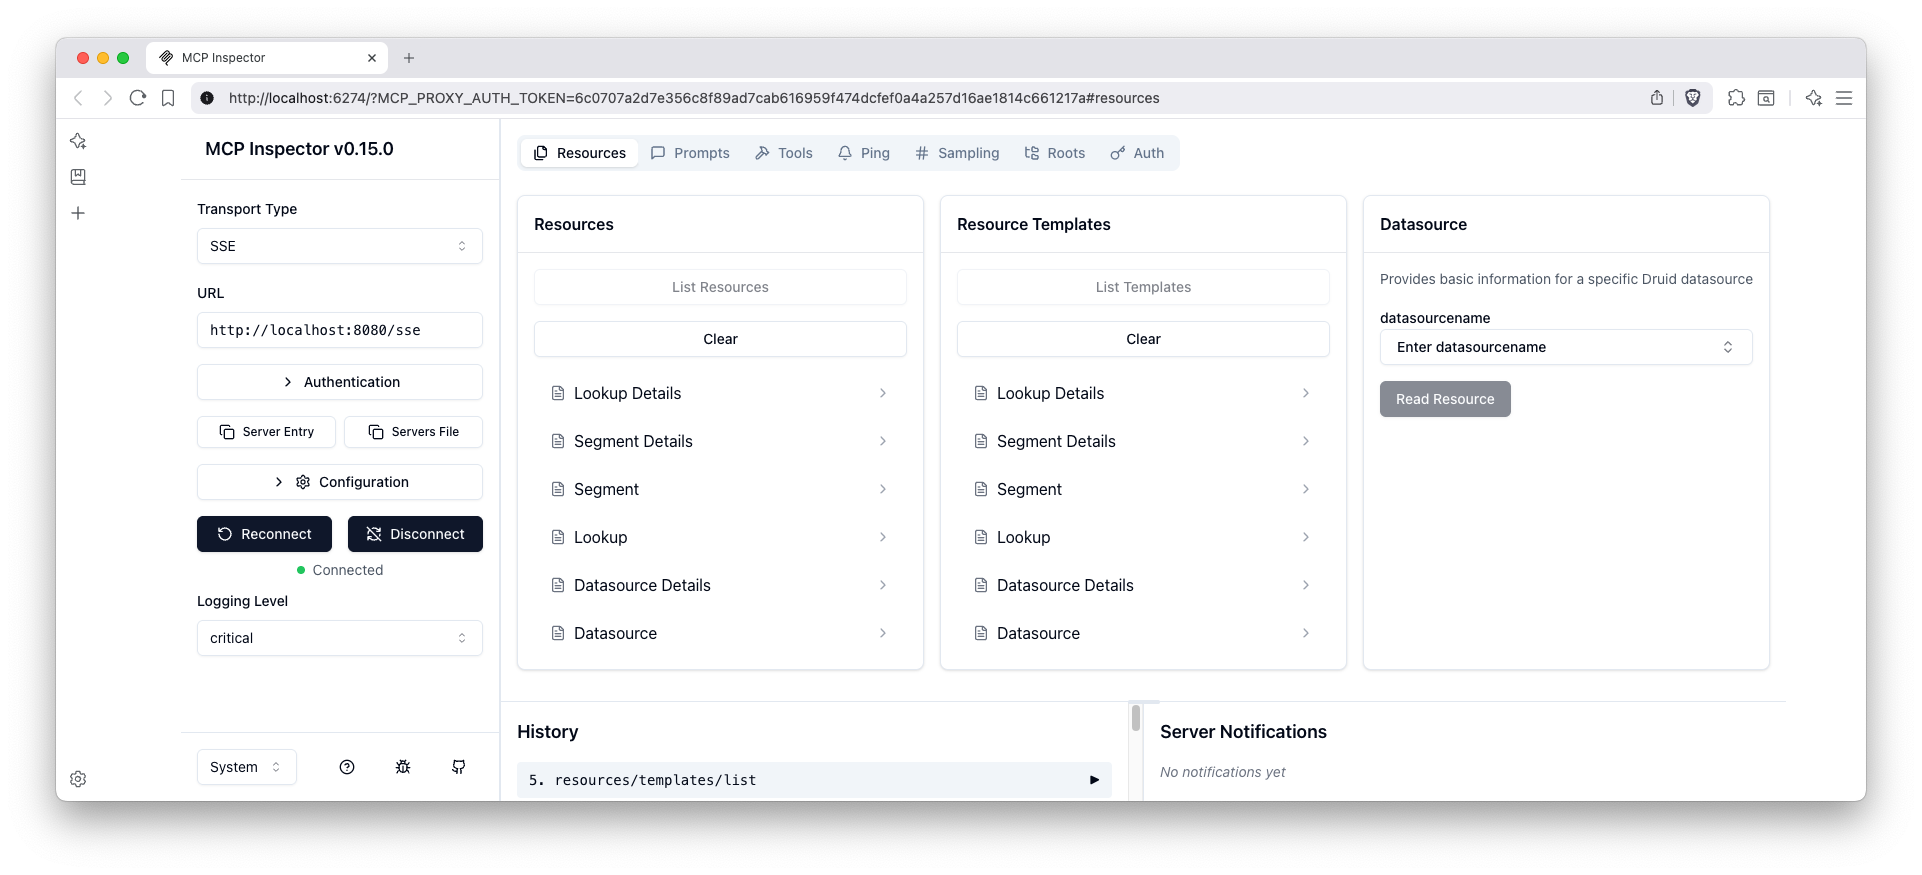
La interfaz de recursos muestra todas las fuentes de datos y metadatos de Druid accesibles que se pueden recuperar a través del protocolo MCP.
Avisos Disponibles
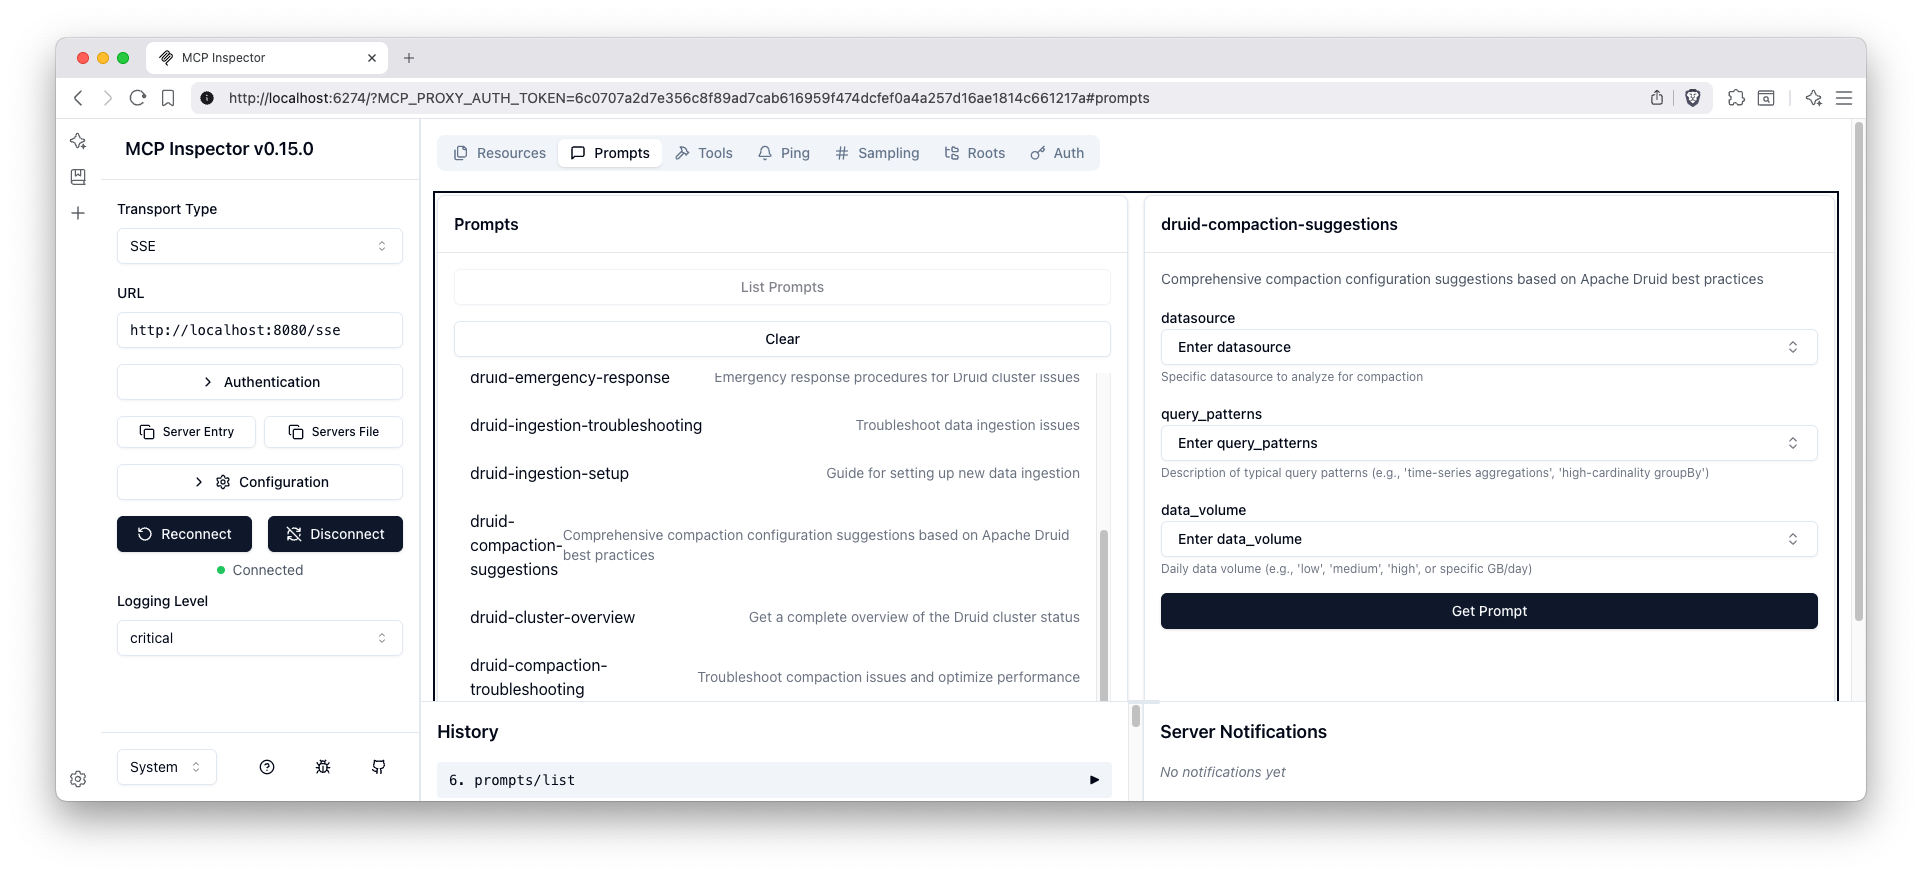
La interfaz de avisos muestra todas las plantillas de guía asistidas por IA disponibles para diversas tareas de gestión de Druid y flujos de trabajo de análisis de datos.
Inicio Rápido
Configuración MCP para LLMs
Se proporciona un archivo de configuración MCP listo para usar en mcp-servers-config.json que se puede utilizar con clientes LLM para conectarse a este servidor MCP de Druid.
Ejemplos
La configuración incluye múltiples opciones de integración y transporte:
- STDIO (predeterminado): consulte examples/stdio/README.md - el servidor es generado por el cliente MCP a través de STDIO.
- HTTP Transmisible (perfil: http): consulte examples/streamable-http/README.md - un único endpoint /mcp según MCP 2025-06-18.
- Plano de Ypipe: consulte examples/ypipe/README.md - configure y ejecute el Servidor MCP de Druid dentro del cliente de escritorio Ypipe usando el plano druid.ypipe.
Ejemplos de Docker usando variables de entorno:
# STDIO mode (default)
docker run --rm -i \
  -e DRUID_ROUTER_URL=http://your-druid-router:8888 \
  -e DRUID_COORDINATOR_URL=http://your-druid-coordinator:8081 \
  iunera/druid-mcp-server:latest

# HTTP mode (enable profile 'http' and expose /mcp)
docker run -p 8080:8080 \
  -e SPRING_PROFILES_ACTIVE=http,query \
  -e DRUID_ROUTER_URL=http://your-druid-router:8888 \
  -e DRUID_COORDINATOR_URL=http://your-druid-coordinator:8081 \
  iunera/druid-mcp-server:latest
Nota sobre los perfiles de Spring:
- Perfil predeterminado: stdio,query
- Perfil HTTP: establezca SPRING_PROFILES_ACTIVE=http,query para habilitar HTTP Transmisible en /mcp
Requisitos Previos
- Java 25
- Maven 3.6+
- Clúster de Apache Druid en ejecución con router en el puerto 8888
Compilar y Ejecutar
# Build the application
mvn clean package -DskipTests

# Run the application
java -jar target/druid-mcp-server-2.0.1.jar
El servidor se iniciará en el puerto 8080 de forma predeterminada.
Para instrucciones detalladas de compilación, pruebas, configuración de Docker y pautas de desarrollo, consulte development.md.
Seguridad y Autenticación
- Los transportes HTTP Transmisible y SSE están asegurados con OAuth 2.0 de forma predeterminada.
- Los clientes deben enviar un token Bearer válido en el encabezado de Autorización al conectarse.
- Ejemplo: Authorization: Bearer YOUR_JWT_TOKEN
Variables de Entorno
DRUID_MCP_SECURITY_OAUTH2_ENABLED:- Descripción: Habilita o deshabilita la seguridad OAuth2 para la autenticación de clientes.
- Tipo: Booleano
- Predeterminado:
true(OAuth2 está habilitado de forma predeterminada según el texto anterior) - Uso: Establezca
falsepara deshabilitar la autenticación OAuth2. Cuando está deshabilitado, los clientes pueden acceder al servidor sin proporcionar tokens OAuth2.
- Para la integración de SSO empresarial (OpenID Connect, Azure AD, Keycloak, etc.), envíe una consulta a consulting@iunera.com y consulte Contacto y Soporte.
Instalación desde Maven Central
Si prefiere usar el JAR precompilado sin compilar desde el código fuente, puede descargarlo y ejecutarlo directamente desde Maven Central.
Requisitos Previos
- Solo JRE de Java 25
Descargar y Ejecutar
Descargue el JAR desde Maven Central https://repo.maven.apache.org/maven2/com/iunera/druid-mcp-server/
# STDIO mode (default)
java -jar target/druid-mcp-server-2.0.1.jar

# HTTP mode (profile: http) - exposes /mcp on port 8080
java -Dspring.profiles.active=http \
     -jar target/druid-mcp-server-2.0.1.jar
Para Desarrolladores
Para información detallada de desarrollo, incluyendo instrucciones de compilación, pautas de prueba, detalles de arquitectura y pautas de contribución, consulte development.md.
Herramientas Disponibles por Característica
El servidor MCP activa herramientas dinámicamente según los perfiles de Spring activos (SPRING_PROFILES_ACTIVE). La configuración predeterminada ejecuta el servidor en modo STDIO con el perfil query habilitado.
Perfil: query (Perfil Activo Predeterminado)
Proporciona capacidades seguras de consulta y exploración de datos de solo lectura.
| Herramienta | Descripción | Parámetros | Endpoint de API de Druid / Funcionalidad |
|---|---|---|---|
getDatasources | Listar todas las fuentes de datos de Apache Druid disponibles u obtener el esquema detallado de una fuente de datos específica. | datasourceName (String, opcional), detailed (Booleano, opcional) | /druid/v2/sql (consulta catálogos del sistema como INFORMATION_SCHEMA.TABLES y COLUMNS) |
getLookups | Obtener configuración o estado de las búsquedas para todos o un nivel específico. | tier (String, opcional), lookupName (String, opcional), includeStatus (Booleano, opcional) | Endpoints /druid/coordinator/v1/lookups/config y /status |
getSegments | Obtener metadatos de segmentos o detalles de un segmento específico. | datasource (String, opcional), segmentId (String, opcional), detailed (Booleano, opcional), metadataOnly (Booleano, opcional) | /druid/coordinator/v1/datasources/{ds}/segments y tablas del sistema (sys.segments a través de /druid/v2/sql) |
getSegmentLoadQueue | Obtener el estado de la cola de carga que muestra los segmentos que se están cargando actualmente. | serverName (String, opcional) | /druid/coordinator/v1/loadqueue |
queryDruidSql | Ejecutar una consulta SQL contra las fuentes de datos de Druid. | sqlQuery (String, requerido) | /druid/v2/sql (Endpoint SQL del Router / Broker) |
Perfil: ops
Proporciona control administrativo sobre especificaciones de ingesta, tareas, supervisores de transmisión, reglas de retención y compactación.
| Herramienta | Descripción | Parámetros | Endpoint / Funcionalidad de la API de Druid |
|---|---|---|---|
getCompactionConfig | Ver la configuración de compactación o el historial de cambios de configuración de los datasources. | datasource (String, opcional), includeHistory (Boolean, opcional) | Endpoints de /druid/coordinator/v1/config/compaction |
getCompactionStatus | Recuperar el estado actual de las ejecuciones de compactación y su progreso. | datasource (String, opcional) | /druid/coordinator/v1/compaction/status |
manageCompaction | Agregar, actualizar o eliminar una configuración de compactación. | action (Enum: UPSERT, DELETE, obligatorio), datasource (String, obligatorio), configJson (String, opcional) | /druid/coordinator/v1/config/compaction (POST/DELETE) |
manageDatasourceOrSegment | Modificar estados de segmentos o eliminar permanentemente un datasource. | action (Enum: ENABLE_SEGMENT, DISABLE_SEGMENT, KILL_DATASOURCE, obligatorio), datasource (String, obligatorio), segmentId (String, opcional), interval (String, opcional) | /druid/coordinator/v1/datasources y POST/DELETE de segmentos |
manageLookup | Crear, actualizar o eliminar una configuración de lookup. | action (Enum: UPSERT, DELETE, obligatorio), tier (String, obligatorio), lookupName (String, obligatorio), configJson (String, opcional) | /druid/coordinator/v1/lookups/config (POST/DELETE) |
queryDruidMultiStage | Ejecutar una consulta SQL de múltiples etapas (MSQ) contra los datasources de Druid como una tarea. | sqlQuery (String, obligatorio) | /druid/v2/sql/task (endpoint de ejecución MSQ) |
queryDruidMultiStageWithContext | Ejecutar una consulta SQL de múltiples etapas con parámetros de contexto personalizados. | sqlQuery (String, obligatorio), contextJson (String, opcional) | /druid/v2/sql/task con configuraciones de contexto |
getMultiStageQueryTaskStatus | Obtener el estado de una tarea de consulta de múltiples etapas. | taskId (String, obligatorio) | /druid/indexer/v1/task/{taskId}/status |
cancelMultiStageQueryTask | Cancelar una tarea de consulta de múltiples etapas en ejecución. | taskId (String, obligatorio) | /druid/indexer/v1/task/{taskId}/shutdown (POST) |
getRetentionRules | Recuperar reglas de retención o historial de auditoría para un datasource específico o todos los datasources. | datasource (String, opcional), includeHistory (Boolean, opcional) | /druid/coordinator/v1/rules |
manageRetentionRules | Actualizar la configuración de reglas de retención para un datasource específico. | datasource (String, obligatorio), rulesJson (String, obligatorio) | /druid/coordinator/v1/rules |
submitIngestion | Enviar una especificación de ingesta de Druid o generar una plantilla de lote simple. | action (Enum: SUBMIT_SPEC, GENERATE_TEMPLATE, obligatorio), payloadJson (String, opcional), datasourceName (String, opcional), inputSourceType (String, opcional), inputSourcePath (String, opcional) | /druid/indexer/v1/task (POST) |
getSupervisors | Listar todos los supervisores o consultar detalles de un supervisor específico. | supervisorId (String, opcional) | /druid/indexer/v1/supervisor |
manageSupervisor | Suspender, reanudar o terminar la ejecución de un supervisor. | supervisorId (String, obligatorio), action (Enum: SUSPEND, RESUME, TERMINATE, obligatorio) | /druid/indexer/v1/supervisor/{id}/(suspend/resume/terminate) |
getTasks | Listar tareas de ingesta que coincidan con estados específicos. | state (Enum: RUNNING, PENDING, WAITING, COMPLETED, opcional) | /druid/indexer/v1/runningTasks, pendingTasks, waitingTasks, completeTasks |
getTaskDetails | Obtener información detallada, especificaciones, informes de ejecución o registros de ejecución de una tarea. | taskId (String, obligatorio), aspect (Enum: STATUS, RAW_DETAILS, SPEC, REPORTS, LOG, obligatorio), logOffset (Long, opcional) | Endpoints de spec, status, reports y log de /druid/indexer/v1/task/{id} |
shutdownTask | Matar/apagar una tarea de Druid. | taskId (String, obligatorio) | /druid/indexer/v1/task/{id}/shutdown (POST) |
getClusterStatus | Verificar la salud general u obtener metadatos/propiedades específicos de coordinadores o routers. | aspect (Enum: OVERALL, COORDINATOR, ROUTER, LEADER, METADATA, PROPERTIES, SELF_DISCOVERY_COORDINATOR, SELF_DISCOVERY_ROUTER, opcional) | /status/health, /status/selfDiscovered, /druid/coordinator/v1/leader, /druid/coordinator/v1/config |
getNodesStatus | Listar servidores registrados, su estado detallado o el estado de un solo nodo. | serverName (String, opcional), detailed (Boolean, opcional) | /druid/coordinator/v1/servers y /status |
diagnoseCluster | Realizar verificaciones de salud de diagnóstico automatizadas, auditorías de configuración o análisis de rendimiento de consultas. | mode (Enum: COMPREHENSIVE, QUICK, PERFORMANCE, CONFIGURATION, obligatorio) | Orquesta barridos de diagnóstico sobre tareas activas, estado de servidores, conteos de segmentos y APIs |
checkFunctionalityHealth | Validar operaciones de sistemas de ingesta, transiciones de estado de supervisores y latencia histórica de consultas. | component (Enum: ALL, SUPERVISORS, HISTORICALS, INGESTION, opcional), quick (Boolean, opcional) | Orquesta verificaciones sobre registros de ejecución de tareas y estados de supervisores |
Perfil: permissions
Proporciona administración básica de autenticación y autorización de seguridad.
[!IMPORTANT] Las herramientas de seguridad básica solo se activan si se cumplen ambas de las siguientes condiciones:
- El perfil
permissionsestá activado (spring.profiles.active=permissions).- La URL del Coordinador (
druid.coordinator.url) está configurada y no vacía.
| Herramienta | Descripción | Parámetros | Endpoint / Funcionalidad de la API de Druid |
|---|---|---|---|
manageAuthentication | Administrar usuarios y credenciales de seguridad básica. | authenticator (String, obligatorio), action (Enum: LIST, GET, CREATE, DELETE, SET_PASSWORD, obligatorio), username (String, opcional), password (String, opcional) | /druid-ext/basic-security/authentication/db/... |
manageAuthorization | Gestionar propiedades de autorización de seguridad, roles y políticas de acceso a recursos. | authorizer (String, obligatorio), action (Enum: LIST_USERS, GET_USER, CREATE_USER, DELETE_USER, LIST_ROLES, GET_ROLE, CREATE_ROLE, DELETE_ROLE, SET_PERMISSIONS, obligatorio), name (String, opcional), permissionsJson (String, opcional) | /druid-ext/basic-security/authorization/db/... |
manageSecurityAssignments | Configurar reglas de mapeo que asignan roles a usuarios, o recuperar las cadenas de autenticador configuradas. | authorizer (String, obligatorio), action (Enum: ASSIGN_ROLE, UNASSIGN_ROLE, GET_CHAIN, obligatorio), username (String, opcional), roleName (String, opcional) | /druid-ext/basic-security/authorization/db/... y /status/properties |
Perfil: health
Proporciona verificación de salud activa, estado del clúster, diagnósticos y escaneos de recomendaciones del doctor.
| Herramienta | Descripción | Parámetros | Endpoint / Funcionalidad de la API de Druid |
|---|---|---|---|
getClusterStatus | Verificar la salud general u obtener metadatos/propiedades específicos de coordinadores o routers. | aspect (Enum: OVERALL, COORDINATOR, ROUTER, LEADER, METADATA, PROPERTIES, SELF_DISCOVERY_COORDINATOR, SELF_DISCOVERY_ROUTER, opcional) | /status/health, /status/selfDiscovered, /druid/coordinator/v1/leader, /druid/coordinator/v1/config |
getNodesStatus | Listar servidores registrados, su estado detallado o el estado de un solo nodo. | serverName (String, opcional), detailed (Boolean, opcional) | /druid/coordinator/v1/servers y /status |
diagnoseCluster | Realizar verificaciones de salud de diagnóstico automatizadas, auditorías de configuración o análisis de rendimiento de consultas. | mode (Enum: COMPREHENSIVE, QUICK, PERFORMANCE, CONFIGURATION, obligatorio) | Orquesta barridos de diagnóstico sobre tareas activas, estado de servidores, conteos de segmentos y APIs |
checkFunctionalityHealth | Validar operaciones de sistemas de ingesta, transiciones de estado de supervisores y latencia histórica de consultas. | component (Enum: ALL, SUPERVISORS, HISTORICALS, INGESTION, opcional), quick (Boolean, opcional) | Orquesta verificaciones sobre registros de ejecución de tareas y estados de supervisores |
Recursos Disponibles por Funcionalidad
| Funcionalidad | Patrón de URI del Recurso | Descripción | Parámetros |
|---|---|---|---|
| Datasource | druid://datasource/{datasourceName} | Acceder a información y metadatos del datasource | datasourceName (String) |
| Datasource | druid://datasource/{datasourceName}/details | Acceder a información detallada del datasource, incluido el esquema | datasourceName (String) |
| Lookup | druid://lookup/{tier}/{lookupName} | Acceder a la configuración y datos del lookup | tier (String), lookupName (String) |
| Segmentos | druid://segment/{segmentId} | Acceder a metadatos e información de segmentos | segmentId (String) |
Prompts Disponibles por Funcionalidad
| Funcionalidad | Nombre del Prompt | Descripción | Parámetros |
|---|---|---|---|
| Análisis de Datos | data-exploration | Guía para explorar datos en datasources de Druid | datasource (String, opcional) |
| Análisis de Datos | query-optimization | Ayuda a optimizar consultas SQL de Druid para un mejor rendimiento | query (String) |
| Gestión del Clúster | health-check | Guía integral de evaluación de salud del clúster | Ninguno |
| Gestión del Clúster | cluster-overview | Resumen y análisis del estado del clúster | Ninguno |
| Gestión de Ingesta | ingestion-troubleshooting | Solucionar problemas de ingesta | issue (String, opcional) |
| Gestión de Ingesta | ingestion-setup | Guía para configurar nuevos pipelines de ingesta | dataSource (String, opcional) |
| Gestión de Retención | retention-management | Gestionar políticas de retención de datos | datasource (String, opcional) |
| Compactación | compaction-suggestions | Optimizar la configuración de compactación de segmentos | datasource (String, opcional), currentConfig (String, opcional), performanceMetrics (String, opcional) |
| Compactación | compaction-troubleshooting | Solucionar problemas de compactación | issue (String), datasource (String, opcional) |
| Operaciones | emergency-response | Procedimientos y guía de respuesta ante emergencias | Ninguno |
| Operaciones | maintenance-mode | Procedimientos de mantenimiento del clúster | Ninguno |
Configuración de Variables de Entorno
La aplicación se puede configurar usando variables de entorno, que es el enfoque recomendado para entornos de producción. A continuación se muestra una lista completa de variables de entorno compatibles derivadas del archivo de configuración application.yaml.
Conexión a Druid
DRUID_ROUTER_URL: La URL del router de Druid.DRUID_AUTH_USERNAME: El nombre de usuario para la autenticación de Druid.DRUID_AUTH_PASSWORD: La contraseña para la autenticación de Druid.DRUID_SSL_ENABLED: Habilita o deshabilita SSL para conexiones de Druid (true/false).DRUID_SSL_SKIP_VERIFICATION: Omite la verificación de certificados SSL (true/false).DRUID_MCP_SQL_SYNTAX_CORRECTION_ENABLED: Habilita o deshabilita la corrección automática de sintaxis SQL (predeterminado:true). Cuando está habilitado, formatea automáticamente las consultas, corrige mayúsculas y minúsculas, y cita identificadores para Druid.DRUID_MCP_SQL_SYNTAX_CORRECTION_CACHE_TTL_MS: El Time-To-Live (TTL) en milisegundos para los metadatos de tablas y columnas en caché cargados desde Druid (predeterminado:300000/ 5 minutos).
Configuración del Servidor MCP
DRUID_MCP_SECURITY_OAUTH2_ENABLED: Habilita o deshabilita la seguridad OAuth2 para la autenticación del cliente HTTP (true/false).SPRING_PROFILES_ACTIVE: Lista separada por comas de perfiles a activar (por ejemplo,query,ops,permissions,healthpara capacidades de herramientas, ohttppara habilitar el transporte del servidor HTTP en lugar del STDIO predeterminado).SPRING_AI_MCP_SERVER_NAME: El nombre del servidor MCP.SPRING_AI_MCP_SERVER_PROTOCOL: El protocolo utilizado por el servidor MCP (por ejemplo,streamable).
Configuración General del Servidor
SERVER_PORT: El puerto en el que escucha el servidor.SERVER_SERVLET_SESSION_COOKIE_NAME: El nombre de la cookie de sesión.SPRING_APPLICATION_NAME: El nombre de la aplicación.SPRING_CONFIG_IMPORT: Importa archivos de configuración adicionales.SPRING_MAIN_BANNER_MODE: El modo para el banner de inicio (por ejemplo,off).
Registro (Logging)
LOGGING_FILE_NAME: El nombre del archivo de registro.LOGGING_LEVEL_ORG_SPRINGFRAMEWORK_SECURITY: El nivel de registro para Spring Security (por ejemplo,DEBUG).
Clúster Cifrado con SSL y Autenticación
Esta sección proporciona una guía completa para conectarse a clústeres de Druid cifrados con SSL y autenticación mediante nombre de usuario y contraseña.
Requisitos previos
- Clúster de Druid con SSL habilitado y endpoints HTTPS
- Credenciales válidas de nombre de usuario y contraseña para la autenticación de Druid
- Certificados SSL configurados correctamente (o capacidad de omitir la verificación para pruebas)
Métodos de configuración
Método 1: Variables de entorno (recomendado para producción)
Establezca las siguientes variables de entorno antes de iniciar el servidor MCP:
# Druid cluster URL with HTTPS
export DRUID_ROUTER_URL="https://your-druid-cluster.example.com:8888"

# Authentication credentials
export DRUID_AUTH_USERNAME="your-username"
export DRUID_AUTH_PASSWORD="your-password"

# SSL configuration
export DRUID_SSL_ENABLED="true"
export DRUID_SSL_SKIP_VERIFICATION="false"  # Use "true" only for testing

# Start the MCP server
java -jar target/druid-mcp-server-2.0.1.jar
Método 2: Propiedades del sistema en tiempo de ejecución
Pase la configuración como propiedades del sistema JVM:
java -Ddruid.router.url="http://localhost:8888" \
     -Ddruid.auth.username="admin" \
     -Ddruid.auth.password="password" \
     -jar target/druid-mcp-server-2.0.1.jar
Opciones de configuración SSL
Configuración SSL de producción
Para entornos de producción con certificados SSL válidos:
export DRUID_ROUTER_URL="https://druid-prod.company.com:8888"
export DRUID_SSL_ENABLED="true"
export DRUID_SSL_SKIP_VERIFICATION="false"
El servidor utilizará el almacén de confianza predeterminado del sistema para validar los certificados SSL.
Métodos de autenticación
El servidor MCP admite autenticación básica HTTP con nombre de usuario y contraseña:
- Nombre de usuario: se establece mediante
DRUID_AUTH_USERNAMEodruid.auth.username - Contraseña: se establece mediante
DRUID_AUTH_PASSWORDodruid.auth.password
Las credenciales se codifican automáticamente en Base64 y se envían con cada solicitud mediante el encabezado Authorization: Basic.
Configuración del cliente MCP con SSL
Actualice su mcp-servers-config.json para incluir variables de entorno:
{
  "mcpServers": {
    "druid-mcp-server": {
      "command": "docker",
      "args": [
        "run",
        "--rm",
        "-i",
        "-e",
        "DRUID_ROUTER_URL",
        "-e",
        "DRUID_COORDINATOR_URL",
        "-e",
        "DRUID_AUTH_USERNAME",
        "-e",
        "DRUID_AUTH_PASSWORD",
        "-e",
        "DRUID_SSL_ENABLED",
        "-e",
        "DRUID_SSL_SKIP_VERIFICATION",
        "iunera/druid-mcp-server:2.0.1"
      ],
      "env": {
        "DRUID_ROUTER_URL": "http://host.docker.internal:8888",
        "DRUID_COORDINATOR_URL": "http://host.docker.internal:8081",
        "DRUID_AUTH_USERNAME": "",
        "DRUID_AUTH_PASSWORD": "",
        "DRUID_SSL_ENABLED": "false",
        "DRUID_SSL_SKIP_VERIFICATION": "true"
      }
    }
  }
}
Personalización de indicaciones MCP
El servidor ofrece amplias capacidades de personalización de indicaciones mediante el archivo prompts.properties ubicado en src/main/resources/.
Estructura de configuración de indicaciones
El archivo prompts.properties contiene:
- Configuración global: habilite o deshabilite indicaciones y establezca marcas de agua
- Alternadores de funciones: controle qué indicaciones están disponibles
- Variables personalizadas: información específica de la organización
- Definiciones de plantillas: plantillas completas de indicaciones para cada función
Sobrescribir indicaciones
Puede sobrescribir cualquier plantilla de indicación usando propiedades del sistema Java con el indicador -D:
Método 1: Propiedades del sistema (sobrescritura en tiempo de ejecución)
java -Dprompts.druid-data-exploration.template="Your custom template here" \
     -jar target/druid-mcp-server-2.0.1.jar
Método 2: Archivo de propiedades personalizado
- Cree un archivo de propiedades personalizado (por ejemplo,
custom-prompts.properties):
# Custom prompt template
prompts.druid-data-exploration.template=My custom data exploration prompt:\n\
1. Custom step one\n\
2. Custom step two\n\
{datasource_section}\n\
Environment: {environment}
- Cárguelo en tiempo de ejecución:
java -Dspring.config.additional-location=classpath:custom-prompts.properties \
     -jar target/druid-mcp-server-2.0.1.jar
Variables de indicación disponibles
Todas las plantillas de indicaciones admiten estas variables:
| Variable | Descripción | Ejemplo |
|---|---|---|
{environment} | Nombre del entorno actual | production, staging, dev |
{organizationName} | Nombre de la organización | Your Organization |
{contactInfo} | Información de contacto | your-team@company.com |
{watermark} | Marca de agua generada | Generated by Druid MCP Server v1.0.0 |
{datasource} | Nombre de la fuente de datos (según el contexto) | sales_data |
{query} | Consulta SQL (según el contexto) | SELECT * FROM sales_data |
Ejemplos de plantillas de indicaciones
Indicación personalizada de exploración de datos
prompts.druid-data-exploration.template=Welcome to {organizationName} Druid Analysis!\n\n\
Please help me explore our data:\n\
{datasource_section}\n\
Environment: {environment}\n\
Contact: {contactInfo}\n\n\
{watermark}
Indicación personalizada de optimización de consultas
prompts.druid-query-optimization.template=Query Performance Analysis for {organizationName}\n\n\
Query to optimize: {query}\n\n\
Please provide:\n\
1. Performance bottleneck analysis\n\
2. Optimization recommendations\n\
3. Best practices for our {environment} environment\n\n\
{watermark}
Deshabilitar indicaciones específicas
Puede deshabilitar indicaciones individuales estableciendo su indicador de habilitación en falso:
mcp.prompts.data-exploration.enabled=false
mcp.prompts.query-optimization.enabled=false
O deshabilitar todas las indicaciones globalmente:
mcp.prompts.enabled=false
Integración MCP
Este servidor utiliza el framework de servidor MCP de Spring AI y admite transportes STDIO y SSE. Las herramientas, recursos e indicaciones se registran y exponen automáticamente a través del protocolo MCP.
Modos de transporte
El servidor MCP de Druid admite múltiples modos de transporte compatibles con la especificación MCP 2025-06-18:
Transporte HTTP transmisible (recomendado)
El nuevo transporte HTTP transmisible proporciona rendimiento y escalabilidad mejorados con soporte para múltiples clientes concurrentes:
# Default configuration with Streamable HTTP

java -Dspring.profiles.active=http \
     -jar target/druid-mcp-server-2.0.1.jar
# Server available at http://localhost:8080/mcp (configurable endpoint)
Características:
- Endpoint único: un endpoint HTTP maneja solicitudes POST y GET
- Múltiples clientes: soporte para conexiones de clientes concurrentes
- Transmisión SSE opcional: eventos enviados por el servidor para actualizaciones en tiempo real
- Seguridad mejorada: validación del encabezado de origen y autenticación
- Compatibilidad con versiones anteriores: respaldo automático para clientes MCP más antiguos
- Keep-alive: monitoreo configurable de la salud de la conexión
Seguridad
- Los modos HTTP transmisible y SSE están protegidos con OAuth de forma predeterminada. Su cliente MCP debe obtener y enviar un token de portador válido al conectarse.
- Para integración SSO empresarial (OpenID Connect, Azure AD, Keycloak, etc.), envíe una consulta a consulting@iunera.com y consulte Contacto y soporte.
Transporte STDIO (integración de línea de comandos)
Perfecto para clientes LLM y aplicaciones de escritorio:
java -jar target/druid-mcp-server-2.0.1.jar
Transporte SSE heredado (obsoleto)
Aún compatible con versiones anteriores. Ya no es el predeterminado y puede eliminarse en una versión futura.
Nota: el endpoint SSE está protegido con OAuth de forma predeterminada. Los clientes deben incluir un token de portador válido al conectarse. Para soporte de integración SSO, consulte Contacto y soporte.
Recopilación de métricas
Para mejorar el producto y comprender los patrones de uso, este servidor recopila métricas de uso anónimas. Estos datos ayudan a priorizar nuevas funciones y mejoras. Puede optar por no participar en la recopilación de métricas anónimas estableciendo druid.mcp.metrics.enabled en false.
🐳 Instalación de Druid para desarrollo
Para desarrollo local, pruebas y aprendizaje, hay disponible una configuración completa de Docker Compose para ejecutar un clúster completo de Apache Druid en iunera/druid-local-cluster-installer.
Esta configuración es la forma recomendada de tener un clúster de Druid en funcionamiento para usar con este servidor MCP.
Características clave:
- Clúster de Druid completo: incluye todos los servicios principales de Druid (Coordinator, Broker, Historical, MiddleManager, Router).
- Instalación con un comando: scripts automatizados para macOS, Linux y Windows.
- Multiplataforma: funciona en cualquier lugar donde Docker esté disponible.
- Preconfigurado: valores predeterminados sensatos para desarrollo local.
- Seguridad básica habilitada: usuario administrador preconfigurado (
admin/password). - Listo para Ypipe: diseñado para funcionar sin configuración adicional con
iunera/ypipe.
Proyectos relacionados
Este servidor MCP de Druid es parte de un ecosistema integral de herramientas y extensiones de Apache Druid desarrolladas por iunera. Estos proyectos complementarios mejoran diferentes aspectos de la gestión de clústeres de Druid y la ingesta de datos:
🔧 Configuración de clúster de Druid
Herramientas avanzadas de gestión de configuración e implementación para clústeres de Apache Druid. Este proyecto proporciona:
- Configuración automatizada de clústeres: plantillas de configuración optimizadas para diferentes escenarios de implementación
- Gestión de configuración: mejores prácticas y plantillas para clústeres de Druid en producción
- Automatización de implementación: herramientas y scripts para implementaciones consistentes de clústeres
- Configuraciones específicas por entorno: configuraciones optimizadas para entornos de desarrollo, pruebas y producción
Integración con el servidor MCP de Druid: las configuraciones de clúster proporcionadas por este proyecto funcionan perfectamente con las capacidades de monitoreo y gestión del servidor MCP de Druid, lo que permite una gestión integral del ciclo de vida del clúster.
📊 Extensión de Druid para ingesta de código
Una extensión especializada de Apache Druid para ingerir y analizar datos y métricas relacionados con código. Esta extensión permite:
- Ingesta de métricas de código: analizadores especializados para datos de análisis de código y métricas de software
- Analítica para desarrolladores: herramientas para analizar calidad, complejidad y patrones de desarrollo de código
- Integración CI/CD: integración perfecta con pipelines de integración continua e implementación
- Formatos de datos personalizados: soporte para diversas herramientas y formatos de análisis de código
Integración con el servidor MCP de Druid: esta extensión amplía las capacidades de ingesta que se pueden gestionar a través de las herramientas de gestión de ingesta del servidor MCP, proporcionando soporte especializado para casos de uso de analítica de código.
¿Por qué usar estos juntos?
- Ecosistema completo: desde la configuración del clúster hasta la ingesta y gestión especializada de datos
- Arquitectura consistente: todos los proyectos siguen principios de diseño y patrones de integración similares
- Capacidades mejoradas: cada proyecto extiende diferentes aspectos del ecosistema de Druid
- Listo para producción: configuraciones y extensiones probadas en entornos empresariales
Hoja de ruta
- Auto compactación de Druid: configuración inteligente de compactación automática
- Autocompletado MCP: funcionalidad mejorada de autocompletado con muestreo usando McpComplete
- Notificaciones MCP: notificaciones en tiempo real para operaciones MCP
- Observabilidad adecuada: métricas y trazabilidad integrales
- Monitoreo mejorado: capacidades avanzadas de monitoreo y alertas de clúster
- Analítica avanzada: información y recomendaciones impulsadas por aprendizaje automático
- Soporte de Kubernetes: implementación adecuada en Kubernetes
Acerca de iunera
Este servidor MCP de Druid es desarrollado y mantenido por iunera, un proveedor líder de soluciones avanzadas de IA y analítica de datos.
iunera se especializa en:
- Analítica impulsada por IA: soluciones de inteligencia artificial de vanguardia para análisis de datos
- Plataformas de datos empresariales: infraestructura de datos escalable y plataformas de analítica (Druid, Flink, Kubernetes, Kafka, Spring)
- Soluciones de Protocolo de Contexto de Modelo (MCP): implementaciones avanzadas de servidores MCP para diversos sistemas de datos
- Desarrollo de IA personalizado: soluciones de IA adaptadas a las necesidades empresariales
Como veteranos en Apache Druid, iunera ha implementado y mantenido una gran cantidad de soluciones basadas en Apache Druid en escenarios productivos de nivel empresarial.
¿Necesita consultoría experta en Apache Druid?
Maximice el retorno de sus datos con servicios profesionales de implementación y optimización de Druid. Desde el diseño de arquitectura hasta el ajuste de rendimiento y la integración de IA, nuestros expertos le ayudan a navegar la complejidad de Druid y desbloquear todo su potencial.
Obtenga consultoría experta en Druid →
¿Necesita consultoría de desarrollo de servidores MCP empresariales?
INTEGRACIÓN DE IA EMPRESARIAL Y DESARROLLO DE SERVIDORES MCP (PROTOCOLO DE CONTEXTO DE MODELO) PERSONALIZADOS
Iunera se especializa en el desarrollo de agentes de IA de grado de producción y soluciones LLM de nivel empresarial, ayudando a las empresas a ir más allá de los chatbots de IA genéricos. Construyen infraestructura de IA segura, escalable y preparada para el futuro, respaldada por el Protocolo de Contexto de Modelo (MCP), para conectar datos propietarios, sistemas heredados y API externas a modelos de IA avanzados.
Obtenga consultoría de desarrollo de servidores MCP empresariales →
Para obtener más información sobre nuestros servicios y soluciones, visite www.iunera.com.
Contacto y soporte
¿Necesita ayuda? Contáctenos:
- Sitio web: https://www.iunera.com
- Servicios profesionales: contáctenos por correo electrónico para consultoría, soporte y desarrollo personalizado de Apache Druid empresarial
- Código abierto: este proyecto es de código abierto y las contribuciones de la comunidad son bienvenidas
© 2026 iunera. Licenciado bajo la Licencia Apache 2.0.