Infino
Infino: recuperación por palabra clave, vectorial, híbrida y SQL sobre datos en almacenamiento de objetos, para agentes de IA.
Documentación
Infino


Infino es una biblioteca de recuperación integrada y rápida: búsqueda de texto completo, vectorial, híbrida y SQL sobre una sola tabla, almacenada como Parquet ordinario en disco local o almacenamiento de objetos. Simple, escalable y optimizada para costos.
pip install infino              # Python
npm install @infino-ai/infino   # Node.js
cargo add infino                # Rust

or in Cargo.toml:

[dependencies]
infino = "0.8"
Nota: infino instala el asignador global mimalloc por defecto. Si integras infino en un proceso que ya establece un asignador global, desactívalo para evitar un segundo:
infino = { version = "0.8", default-features = false }.
Inicio rápido
import infino
import pyarrow as pa

db = infino.connect("memory://")

schema = pa.schema([
    pa.field("body", pa.large_utf8(), nullable=False),
    pa.field("embedding", pa.list_(pa.float32(), 384), nullable=False),
])
docs = db.create_table(
    "docs", schema,
    infino.IndexSpec().fts("body").vector("embedding", 384, "cosine"),
)

docs.append(rows)   # list of dicts, or an Arrow RecordBatch

# BM25 and vector in one call, fused ranking. `query_vec` is your embedding.
hits = docs.hybrid_search("body", "disk full", "embedding", query_vec, k=10)
Rendimiento
p50 en caliente, tablas en almacenamiento de objetos:
| 1M documentos | 10M documentos | |
|---|---|---|
| Vector top-10 (recall@10 0.992 a 1M) | 591 µs | 5 ms |
| BM25 top-10, incluyendo recuperación de filas | 125 µs | 2 ms |
| SQL, metadatos → formas de tablas cruzadas | 186 µs – 7.6 ms | 260 µs – 75 ms |
Las tablas completas registradas de cada batería — filas por forma, RSS, conteos de GET en frío, la ejecución de 1M que citan estos resúmenes — viven en benches/README.md.
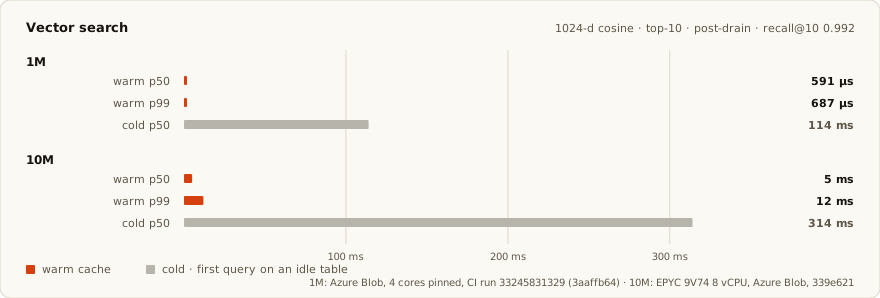
Reproducir
cargo bench -- supertable vector warm cold
cargo bench sin prefijo ejecuta el nivel de 10M; las filas de 1M (lo que ejecuta CI) se obtienen con INFINO_BENCH_SUPERTABLE_DOCS=1000000 prefijado al mismo comando.
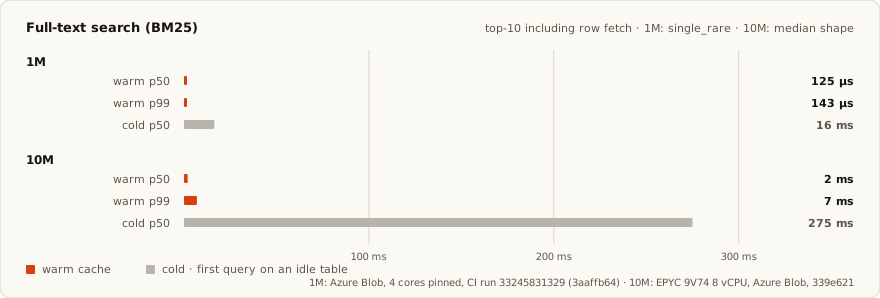
Reproducir
cargo bench -- supertable fts warm cold
cargo bench sin prefijo ejecuta el nivel de 10M; las filas de 1M (lo que ejecuta CI) se obtienen con INFINO_BENCH_SUPERTABLE_DOCS=1000000 prefijado al mismo comando.
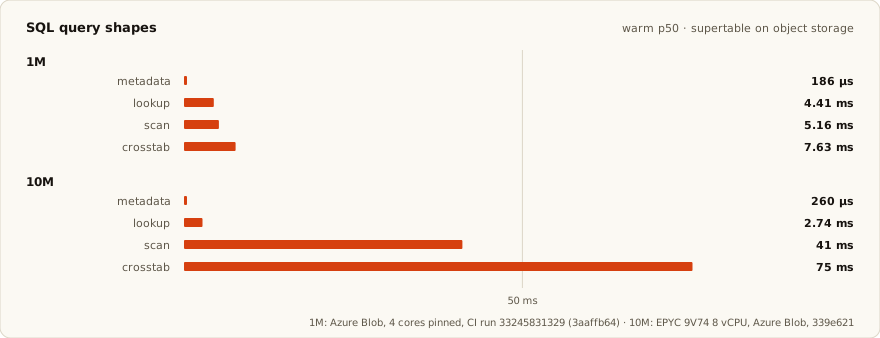
Reproducir
cargo bench -- supertable sql warm
cargo bench sin prefijo ejecuta el nivel de 10M; las filas de 1M (lo que ejecuta CI) se obtienen con INFINO_BENCH_SUPERTABLE_DOCS=1000000 prefijado al mismo comando.
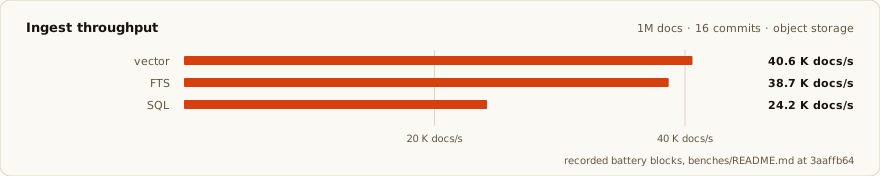
Reproducir
INFINO_BENCH_SUPERTABLE_DOCS=1000000 cargo bench -- supertable build
Un solo comando, las celdas de ingesta de las tres modalidades.
- Primera consulta en frío = apertura de archivos + llenado de caché: 114 ms (1M) y 314 ms (10M) para vector, 16 ms y 275 ms para BM25. En caliente y en frío están ~200× separados; los gráficos usan escala logarítmica.
- 1M: CI — Azure Blob, 4 núcleos fijos, commit
3aaffb64(ejecución 33245831329). - 10M: mismo banco de pruebas a su escala predeterminada — 8 vCPU AMD EPYC 9V74 (AVX-512, 62 GiB), Azure Blob, commit
339e621. Compara cada escala contra su propia línea base.
Metodología: configuración, corpus reales, CI coincidente
El comportamiento del motor se configura solo en YAML; las variables de entorno nunca lo anulan. Los valores predeterminados incluidos son los que miden los gráficos:
cp src/config/config.yaml infino.yaml # or $XDG_CONFIG_HOME/infino/config.yaml
El bloque vector: contiene la profundidad de sondeo, el códec de reordenamiento y los conteos de celdas. El bloque supertable: contiene el comportamiento de commit y caché. Déjalos ambos intactos para reproducir los gráficos publicados.
El tamaño del corpus es la única perilla del banco de pruebas que lee una variable de entorno, y toma un entero simple (1000000, no 1M); el pliegue Reproducir de cada gráfico lleva su comando exacto.
Para ejecutar con un conjunto de datos real en lugar del corpus sintético, pasa una especificación corpus=. Se aplica a una celda seleccionada, así que nombra un solo nivel y modalidad:
# Hugging Face parquet dataset — downloaded once into corpus-dir, reused after
INFINO_BENCH_SUPERTABLE_DOCS=1000000 \
  cargo bench -- supertable vector \
  corpus=hf:KShivendu/dbpedia-entities-openai-1M corpus-dir=./corpora

# Any local parquet shards (e.g. Cohere embeddings you already hold)
cargo bench -- supertable vector corpus=parquet:/path/to/shards
INFINO_BENCH_SUPERTABLE_DOCS limita cuántas filas se ingieren del conjunto de datos. El recall se evalúa contra la verdad fundamental exacta de fuerza bruta en consultas retenidas, sea corpus real o sintético.
Eso se ejecuta contra un daemon RustFS local, un sustituto HTTPS de S3, por defecto. Para coincidir con CI:
INFINO_BENCH_SUPERTABLE_DOCS=1000000 \
INFINO_BENCH_STORE=azure \
INFINO_REAL_AZURE_CONTAINER=$CONTAINER \
AZURE_STORAGE_ACCOUNT_NAME=$ACCOUNT \
AZURE_STORAGE_ACCOUNT_KEY=$KEY \
  cargo bench -- supertable vector warm cold
Lectura de la salida: vector es la fila default posterior al drenaje; BM25 es single_rare bajo Supertable FTS; las formas SQL son agg_max_title (metadatos), WHERE key = ? (búsqueda), AVG(rating) GROUP BY category (escaneo) y COUNT(*) GROUP BY bucket, category (tabla cruzada). Los resultados estructurados aterrizan en target/infino-bench/*.json. La metodología está en benches/README.md.
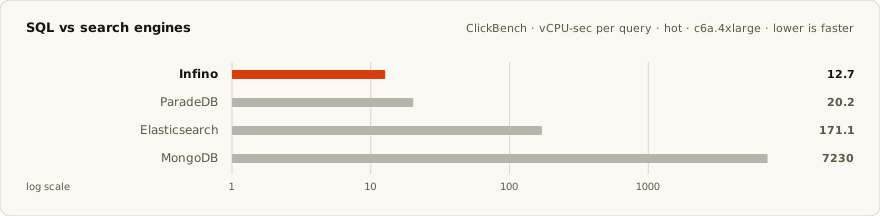
Contra otros motores
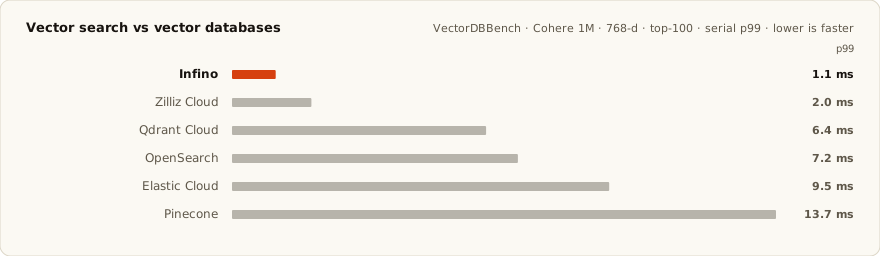
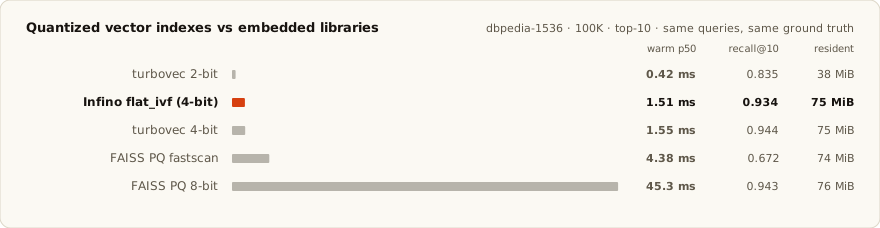
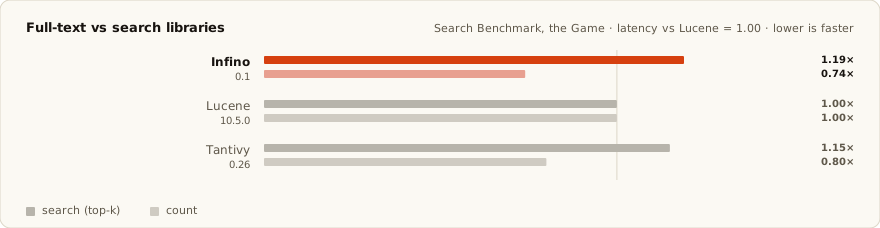
Search Benchmark, the Game (Repro)
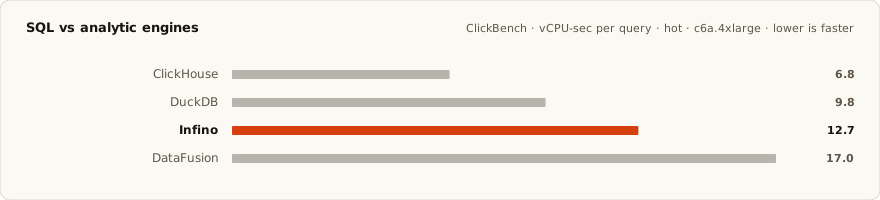
Cómo funciona
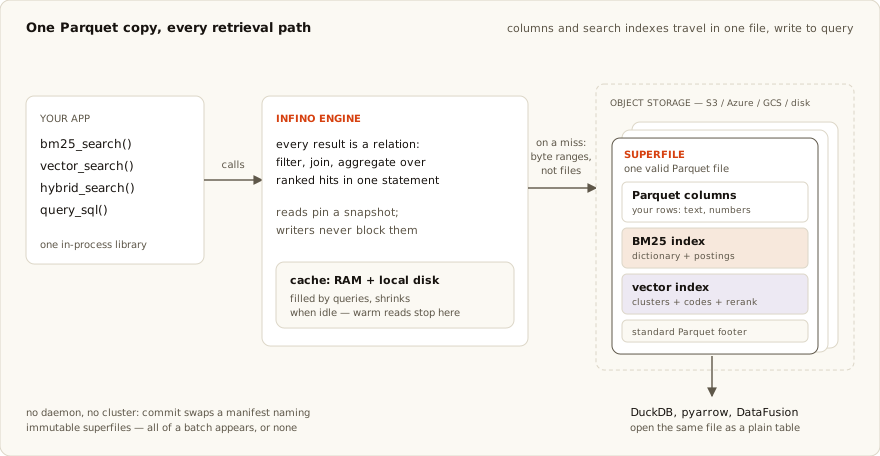
Resumen
- Un archivo Parquet por lote de datos, con los índices BM25 y vectorial dentro de él. DuckDB, pyarrow y DataFusion abren el mismo archivo como una tabla normal (ejemplo).
- El destino de almacenamiento se determina mediante una cadena de conexión:
memory://, una ruta local, os3://,gs://, Azure. - No se necesita demonio, clúster ni servicio de bloqueo. Infino escribe archivos inmutables de solo anexión, por lo que los lectores fijan una instantánea y nunca bloquean a los escritores.
- Las tablas mucho más grandes que la RAM funcionan: las consultas leen rangos de bytes.
Los índices viven dentro del archivo Parquet
- Cada escritura produce un archivo Parquet con los índices BM25 y vectorial incrustados.
- Cualquier lector de Parquet — DuckDB, pyarrow, DataFusion — abre ese archivo y ve una tabla normal. Infino abre el mismo archivo y también encuentra sus índices.
- No hay un artefacto de índice separado que construir, enviar o mantener sincronizado, ni nada que cargar al inicio.
Una consulta lee rangos de bytes, no archivos
- Los índices están ordenados por término y por clúster vectorial, por lo que un top-10 se convierte en una lista corta de desplazamientos de bytes. En almacenamiento de objetos, eso son unas pocas solicitudes HTTP de rango, no una descarga.
- Una solicitud de almacenamiento de objetos toma 20–100 ms.
- Los rangos obtenidos se mantienen en una caché de disco local y se mapean en memoria. Una consulta repetida hace cero solicitudes de red y responde en 125 µs.
- La caché se reduce bajo presión de memoria y se vacía en una tabla inactiva. Las consultas la rellenan.
El puntuador de texto se elige por consulta
Las listas de publicaciones almacenan, para cada término, cuántos documentos lo contienen y la mejor puntuación posible en cada bloque. Con eso a mano, el motor elige el algoritmo correcto más barato para cada consulta:
- Una consulta que mezcla una palabra rara y una común salta a través de la lista de la palabra común en lugar de leerla (WAND / Block-Max WAND).
- Una consulta de palabras comparativamente comunes puntúa documentos en ventanas de tamaño fijo, descartando palabras que ya no pueden alcanzar el top-10 a medida que sube el umbral (MaxScore).
- Contar coincidencias para una consulta dominada por una palabra muy común lee un conteo almacenado en lugar de recorrer la lista de publicaciones.
- Las consultas muy densas cambian a conjuntos de bits. Las AND muy dispersas recorren la lista más corta y sondean las demás.
- Los puntos de cambio se fijaron mediante benchmarks, y cada algoritmo se prueba contra una implementación de BM25 de fuerza bruta. La elección cambia la velocidad, nunca los resultados.
La búsqueda vectorial es un embudo de tres etapas
- Los vectores se agrupan en clústeres. Una consulta se compara primero con los centros de los clústeres, y solo se leen los clústeres más cercanos — 62 de 255, para un top-10 en una tabla de 1M de filas.
- Las filas en esos clústeres se puntúan con códigos de 1 bit por dimensión: 192 bytes por vector de 1536 dimensiones, en lugar de 6 KiB como float32.
- Los mejores candidatos — 155 filas para ese mismo top-10 — se re-puntúan con códigos de 2 bytes por dimensión para obtener el orden exacto.
- Cuántos clústeres leer y cuántas filas re-puntuar se miden por tabla cuando se construye el índice, y se miden de nuevo cuando los datos cambian de forma.
- Recall@10 medido a 1M de filas: 0.992, probado contra vecinos más cercanos exactos de fuerza bruta.
- Los núcleos de distancia se despachan en tiempo de ejecución: AVX-512, AVX2, una ruta portátil de 256 bits y un núcleo int8 VNNI para navegación de grafos.
Los commits intercambian un manifiesto
- Una tabla es un conjunto de archivos inmutables más un manifiesto que los lista. Un commit escribe archivos nuevos y luego reemplaza el manifiesto en un solo paso atómico: aparecen todas sus filas, o ninguna.
- Un lector conserva el manifiesto que abrió y termina en esa versión. Nunca espera a un escritor y nunca ve medio commit.
- Sin servicio de bloqueo, sin elección de líder.
optimize() ajusta el índice a los datos
- Estableces un número —
target_recall: 0.99.optimize()mide la tabla y dimensiona todo lo demás: cuántos clústeres, cuántos lee una consulta, cuántas filas se re-puntúan. - Si seleccionas el modo de índice de grafo o plano, se construye y se mide su recall. Solo sirve si alcanza el estándar con estos datos; de lo contrario, el índice predeterminado sigue sirviendo y nada cambia para el llamador.
- Las mediciones se rehacen cada vez que la compactación o una división de clúster cambia los datos.
# infino.yaml
vector:
  target_recall: 0.99
  search_mode: ivf         # ivf (default) | hnsw_ivf | flat_ivf
table.optimize() # drain, compact, recalibrate, sweep
Cada perilla, y la medición detrás de cada valor predeterminado, está documentada en línea en src/config/config.yaml.
Modos de índice vectorial
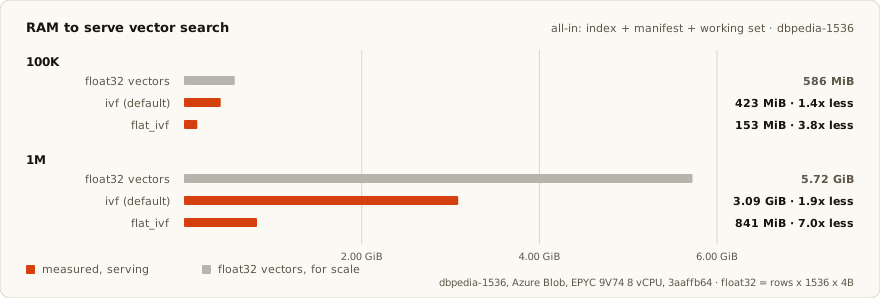
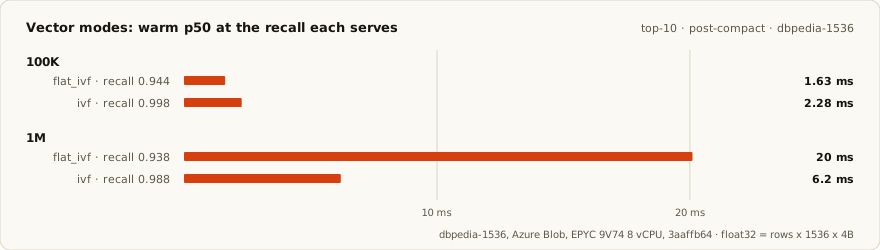
Puedes intercambiar memoria por latencia, según tu carga de trabajo.
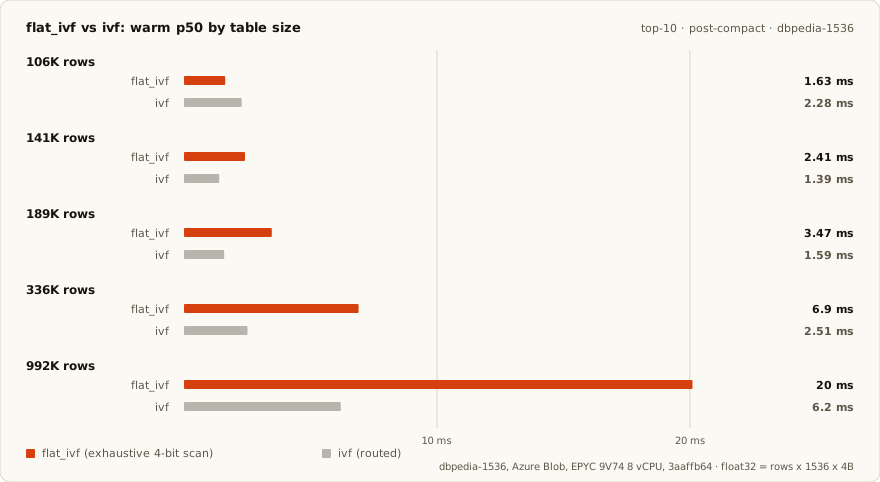
Un millón de vectores de 1536 dimensiones son 5.7 GiB de RAM como float32. flat_ivf los sirve desde 841 MiB, todo incluido.
Reproducir
printf 'vector:\n  search_mode: flat_ivf\n' > infino.yaml   # or hnsw_ivf; rm for ivf
INFINO_BENCH_SUPERTABLE_DOCS=1000000 \\
  cargo bench -- supertable vector build warm \\
  corpus=hf:KShivendu/dbpedia-entities-openai-1M corpus-dir=./corpora
Una ejecución por modo: la línea de configuración lo selecciona, optimize() lo construye, la batería reporta RSS de servicio y latencia.
Reproducir
printf 'vector:\n  search_mode: flat_ivf\n' > infino.yaml   # or hnsw_ivf; rm for ivf
INFINO_BENCH_SUPERTABLE_DOCS=1000000 \\
  cargo bench -- supertable vector build warm \\
  corpus=hf:KShivendu/dbpedia-entities-openai-1M corpus-dir=./corpora
Una ejecución por modo: la línea de configuración lo selecciona, optimize() lo construye, la batería reporta RSS de servicio y latencia.
Cifras de servicio medidas, cada fila en su propio corpus:
| Modo | Corpus | RAM para servir | recall@10 | p50 en caliente |
|---|---|---|---|---|
flat_ivf | dbpedia 1M × 1536d | 841 MiB, fijado | 0.938 | 20 ms |
ivf (predeterminado) | dbpedia 1M × 1536d | 3.16 GiB conjunto de trabajo, 109 MiB fijado | 0.988 | 6.2 ms |
hnsw_ivf | Cohere 1M × 768d | 2.5 GiB, fijado | 0.995 | 0.59 ms |
flat_ivf— escaneo exhaustivo sobre un plano de 4 bits; sin clústeres, sin grafo, sin plano de reordenamiento. No obtiene nada para servir, por lo que en frío equivale a en caliente y la latencia citada es un peor caso. Lineal en filas: 1.6 ms a 100K, 20 ms a 1M. El recall lo fija el códec (~0.94) y no se mueve con la escala. Más rápido que la ruta enrutada por debajo de ~130K filas (gráfico arriba). Solo coseno.ivf(predeterminado) — el único modo que escala más allá de la RAM. El índice vive en almacenamiento de objetos y pagina a través de la caché reclamable; la memoria fijada se mantiene cerca de 100 MiB a cualquier escala.hnsw_ivf— recorrido de grafo en un plano int8, reordenamiento exacto en el haz final. Necesita el grafo residente, lo que lo limita a ~10M filas.- Cada modo cae al escaneo enrutado cuando no puede servir una consulta; cambiar el modo puede costar recall o latencia, nunca corrección.
SQL
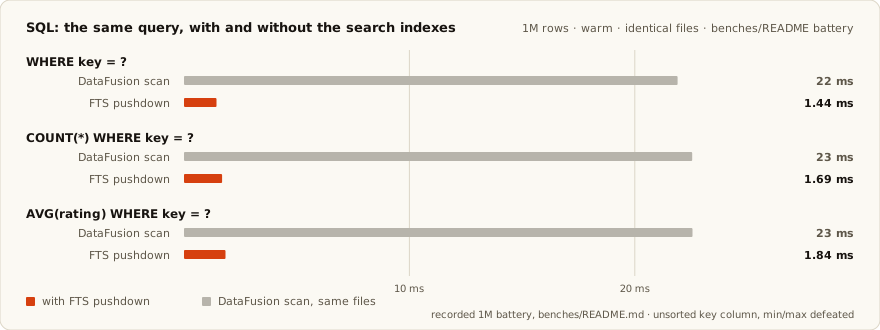
La planificación y ejecución de SQL es Apache DataFusion. Infino aprovecha los índices que mantiene para FTS para acelerar consultas SQL podando bytes que no necesita tocar. Por ejemplo, DataFusion poda columnas numéricas ordenadas mediante límites min/max, pero Infino usa Bloomfilters, FSTs, mapas de bits y otras estructuras de datos que normalmente no están disponibles en DataFusion. Por ejemplo, cuando una cláusula WHERE alcanza una columna que tiene un índice de texto completo, Infino busca el valor en ese índice primero y entrega a DataFusion los números de fila coincidentes, por lo que el escaneo decodifica solo esas filas en lugar de toda la columna.
El gráfico es esa búsqueda activada y desactivada — misma consulta, mismos archivos:
Reproducir
INFINO_BENCH_SUPERTABLE_DOCS=1000000 cargo bench -- supertable sql warm
La batería emite ambos brazos — la misma consulta a través de la búsqueda por índice y a través del escaneo plano.
- Igualdad en una columna no ordenada, donde las estadísticas min/max de Parquet no pueden omitir nada: 21.9 ms sin la búsqueda por índice, 1.44 ms con ella. COUNT y AVG sobre el mismo predicado: ~22.5 ms → ~1.8 ms.
- Antes de todo eso, los resúmenes min/max, Bloom y de términos por archivo descartan archivos completos, y un agregado completamente respondido por las estadísticas de la tabla nunca escanea en absoluto.
Búsqueda híbrida
La combinación de SQL y funciones de búsqueda facilita la expresión de consultas complejas.
bm25_search, vector_search, hybrid_search, token_match y exact_match son funciones
de tabla SQL que permiten que los resultados de búsqueda se compongan como tablas SQL ordinarias.
Los conjuntos de resultados clasificados son relaciones, por lo que operaciones como recuperación, filtros, uniones y agregaciones se componen en una sola declaración contra una única instantánea fija.
SELECT   _id, title, score
FROM     hybrid_search(                       -- FTS + vector, fused by RRF
           'logs', 'body', 'disk full',       --   the text side
           'embedding', :q, 50                --   the vector side, top 50
         )
WHERE    level = 'error'                      -- pushed-down filter
  AND    ts > now() - interval '24 hours'     -- on the same pass
ORDER BY score DESC                           -- one fused ranking
LIMIT    10;
Las preguntas de seguimiento pueden permanecer en SQL, integradas en la misma consulta. Pasar de "encontrar errores de disco lleno" a "qué equipo los tuvo" requiere una sola consulta.
SELECT   s.team,
         count(*)      AS hits,
         avg(h.score)  AS relevance
FROM     hybrid_search('logs', 'body', 'disk full', 'embedding', :q, 1000) AS h
JOIN     services s ON s.id = h.service_id
WHERE    h.ts > now() - interval '7 days'
GROUP BY s.team
ORDER BY hits DESC;
Limitaciones
- Las tablas son de solo anexión y ordenadas por tiempo. Las actualizaciones son eliminación más inserción mediante tombstones, y no hay transacciones entre tablas. Esto no es un almacén OLTP.
- Las escrituras pasan por un único slot de escritor, por lo que hay un escritor por tabla a la vez. Los lectores son ilimitados y nunca se bloquean.
- Esto es una biblioteca con una superficie SQL y Arrow. No hay demonio, ni endpoint REST, ni clúster que operar.
El crate es 0.x y la API aún puede moverse. La superficie pública está fijada por public-api.txt.
¿Construyendo un agente?
Infino es una potente capa de datos para agentes. La búsqueda híbrida y SQL permiten consultas más expresivas en forma más compacta, con menos gasto de tokens en LLMs — por ejemplo en code-context, nuestro plugin de Claude Code. Úsalo para el agotamiento de datos del agente, almacenando corpus para búsqueda, o memoria del agente. Transcripciones, embeddings y metadatos pueden almacenarse en una sola tabla, recuperados por significado, palabra clave o SQL — en memoria o sobre almacenamiento de objetos, sin servicio que ejecutar:
- infino-mcp — da a cualquier cliente MCP (Claude Code,
Claude Desktop, Cursor, VS Code) recuperación por palabra clave, semántica, híbrida y SQL sobre tus
tablas. Modelo de embeddings local, solo lectura por defecto, escrituras detrás de una bandera.
npm i @infino-ai/mcp-server, o directamente desde el Registro MCP. - infino-cli — las mismas tablas desde tu shell: SQL, búsqueda de texto completo y vectorial contra una ruta o bucket. Inspecciona lo que el agente almacenó, scriptea las partes que no necesitan un modelo.
- infino-analytics — un kit de referencia para construir productos de analítica sobre Infino: API de visualización y dashboard, más Fino, una capa conversacional — un ejemplo completo y trabajado de un agente sobre tablas de Infino.
Documentación
La documentación completa está en infino.ai/docs. Comienza aquí:
- Inicio rápido — conéctate, crea una tabla, ejecuta tu primera búsqueda
- Conceptos principales — una tabla, cuatro formas de consultarla
- Guía de búsqueda — recuperación de texto completo, vectorial e híbrida
- Búsqueda híbrida en Parquet — BM25 y vector en una sola pasada clasificada sobre un archivo Parquet
- Referencia SQL — las funciones de tabla de búsqueda y cómo combinarlas
- Memoria del agente — recuperación como memoria a largo plazo de un agente sobre almacenamiento de objetos
- Integración MCP — recuperación híbrida y SQL para Claude, Cursor y VS Code
- Interoperabilidad Parquet — lee el mismo archivo con DuckDB, pyarrow y DataFusion
- Embeddings y almacenamiento — trae tus propios vectores; ejecuta en disco local, S3, GCS o Azure
Las mismas páginas están disponibles como fuente Markdown en GitHub: inicio rápido, conceptos principales, búsqueda, búsqueda híbrida en Parquet, referencia SQL, memoria del agente, MCP, interoperabilidad Parquet, embeddings, almacenamiento.
En este repositorio:
- FAQ — respuestas breves a preguntas comunes
- Cómo se compara Infino — cómo se relaciona con bases de datos vectoriales, motores de búsqueda y motores de consulta
Referencias de diseño (en este repositorio):
- Descripción general — el modelo mental y cómo se compara esto
- Formato superfile — cómo encajan los índices dentro de Parquet
- Capa supertable — manifiesto, commit, fan-out de consultas
| Lenguaje | Paquete | Ejemplos |
|---|---|---|
| Python | infino-python/ | examples/ |
| Node.js | infino-node/ | examples/ |
| Rust | docs.rs/infino | examples/ |
Desarrollo
git clone git@github.com:infino-ai/infino.git && cd infino
cargo build
cargo run --example demo
make ci                # gates before a PR
make readme-charts     # regenerate the charts above
MSRV 1.95. Versiones de Python y Node en sus propias líneas SemVer (docs/versioning.md). Consulta CONTRIBUTING.md. Licenciado Apache-2.0.