SEO Audit Console
Auditorías técnicas de SEO en Claude: historial de Search Console, un rastreo de primera parte y DataForSEO combinados en una única auditoría priorizada con correcciones listas para pegar.
Documentación
SEO Audit Console - el servidor MCP de auditoría SEO técnica para Claude
Una auditoría SEO técnica con la que puedes conversar: creada a partir de tus propios datos de Search Console y un rastreo en vivo de tu sitio, ejecutada dentro de Claude.



La auditoría SEO técnica completa, a la velocidad de una conversación. SEO Audit Console es un servidor MCP de SEO que fusiona tu historial de Google Search Console, un rastreo de primera parte de tu sitio y datos de mercado DataForSEO bajo demanda en una única auditoría priorizada dentro de Claude: desde la rastreabilidad, la indexación, la canonicalización, los datos estructurados, Core Web Vitals y hreflang hasta la canibalización de palabras clave, las consultas en striking distance, las brechas de contenido, el análisis de competidores, la prospección de enlaces (con Majestic Trust Flow) y la preparación para la búsqueda con IA. Noventa y tres comprobaciones, cada hallazgo clasificado por los clics que podría recuperar, cada corrección escrita para ti: redirecciones listas para pegar, JSON-LD, enlaces internos y briefs de contenido fundamentados. Lo que solía ser una quincena de rastreo, exportación y cruce de hojas de cálculo ahora son veinte minutos y un prompt, y tus datos nunca salen de tu máquina.
Creado por Houtini. Construimos automatización para el trabajo pesado del marketing digital: la recopilación de datos, el rastreo, la fusión, la verificación, para que el tiempo de tu equipo se dedique al pensamiento, la estrategia y el trabajo con clientes que necesita un humano. Este plugin es esa idea aplicada a la auditoría SEO técnica.
¿Nuevo en los MCP o no sabes por dónde empezar? La guía de inicio te lleva desde una máquina completamente nueva (sin Node, sin Git, sin haber oído hablar de una cuenta de servicio) hasta tu primera auditoría: cada paso con captura de pantalla, incluido el que todo el mundo se salta. Diez minutos, de verdad.
you  › run an SEO audit on simracingcockpit.gg

     ⣾ search console  1.8M rows synced (19s - incremental)
     ⣾ crawl           868 pages · HTTP/2 · robots-polite · 8 parallel
     ⣾ link graph      internal PageRank · click depth · in-degree
     ✓ 93 checks · 220 findings · ranked by expected clicks per dev-hour

     #1  CTR far below position-expected     /how-to-install-mods       XL
     #2  Page losing clicks (trend)          site-wide                  XL
     #3  Keyword cannibalisation             "beamng drive mods"        L
     #4  Robots-blocked page earning traffic /category/wheels           L

you  › generate the fix for #1 ▍
El manual
Este README es la historia y el inicio rápido. El detalle vive en el manual:
| Página | Qué contiene |
|---|---|
| Primeros pasos | Instalación, configuración de la cuenta de servicio de GSC (y el paso que todo el mundo se salta), configuración de Claude Desktop y Claude Code, tu primera auditoría, solución de problemas |
| Referencia de herramientas | Cada herramienta: qué hace, entradas, uniones, un prompt de ejemplo |
| El registro de comprobaciones | Las 93 comprobaciones con lo que detecta cada una, su etiqueta D/N y la corrección |
| Composición | Las claves de unión, los granos y trece recetas trabajadas para hacer tus propias preguntas sobre los datos |
| Análisis competitivo | Los flujos de trabajo que sustituyen a Semrush, la configuración de DataForSEO, el intersect de enlaces con el nivel Trust Flow de Majestic y los costes reales |
| SEO Recon | Por qué una página está perdiendo: el veredicto de citas en vivo de SERP + AI-Overview, el diff de competidores y el registro de tareas rastreable |
| Funciones de DataForSEO | Cada herramienta basada en DataForSEO agrupada por módulo de API — Keywords, SERP, Labs, Backlinks, OnPage — cada una con su endpoint y coste |
| Funciones de Majestic | El nivel opcional de Trust Flow: qué añade y cómo lo usa link_intersect |
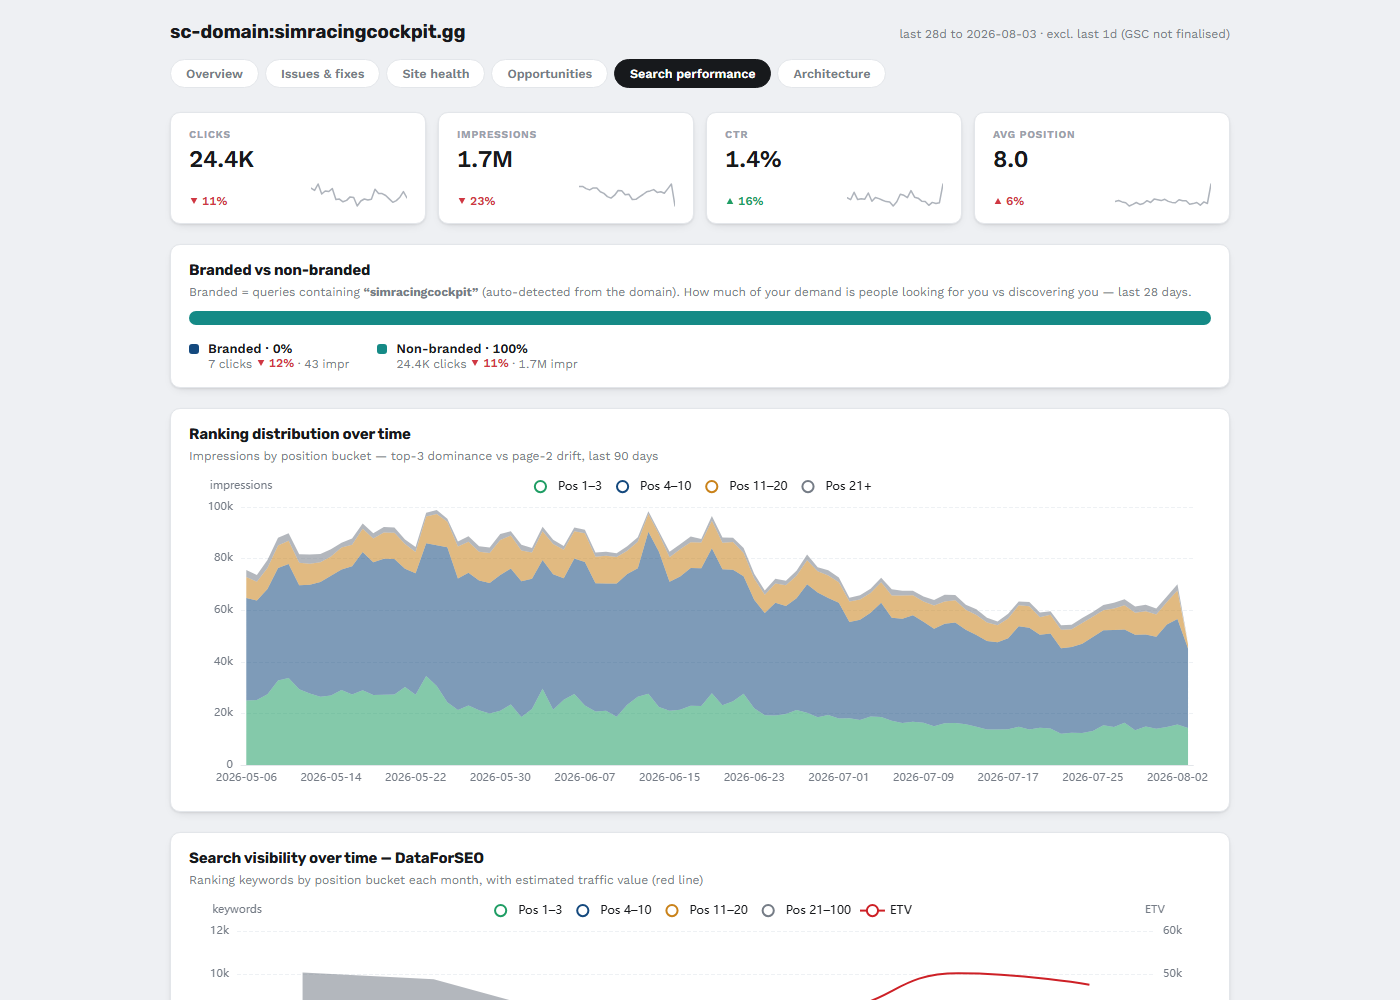
| Dashboard e informes | Las ocho pestañas, el centro de informes, qué muestra cada gráfico y la exportación compartible |
Sorprendentemente poco ha cambiado en veinte años
La auditoría técnica que escribía para clientes en 2006 es, estructuralmente, la auditoría que la mayoría de agencias siguen vendiendo hoy. Un rastreador se ejecuta, una plantilla se rellena, un PDF de 60 páginas aterriza. Todo lo que un rastreador pudo encontrar, en orden de severidad, sin idea de qué hallazgos valen dinero y cuáles son cosméticos.
Lo que sí ha cambiado es lo que es posible. Google le da a cada propietario de un sitio un registro completo de su realidad de búsqueda: qué consultas, qué páginas, cuántas impresiones, dónde clasificaste. Tu rastreo te dice lo que dice tu sitio. Search Console te dice lo que Google hizo al respecto. Y en mi experiencia, la brecha entre esos dos conjuntos de datos es donde se esconde casi todo el tráfico recuperable.
Así que eso es lo que construí. SEO Audit Console es un servidor de Model Context Protocol que fusiona tu historial de Search Console con un rastreo de primera parte de tu sitio (y, cuando lo quieras, DataForSEO) en una sola cosa: una auditoría priorizada y respaldada por evidencia que puedes interrogar dentro de Claude Desktop. Te entrega correcciones listas para pegar. Cada hallazgo se remonta a un punto de datos real.
Una idea debajo de todo:
Tu rastreo es intención. Search Console es realidad. El dinero está donde divergen.
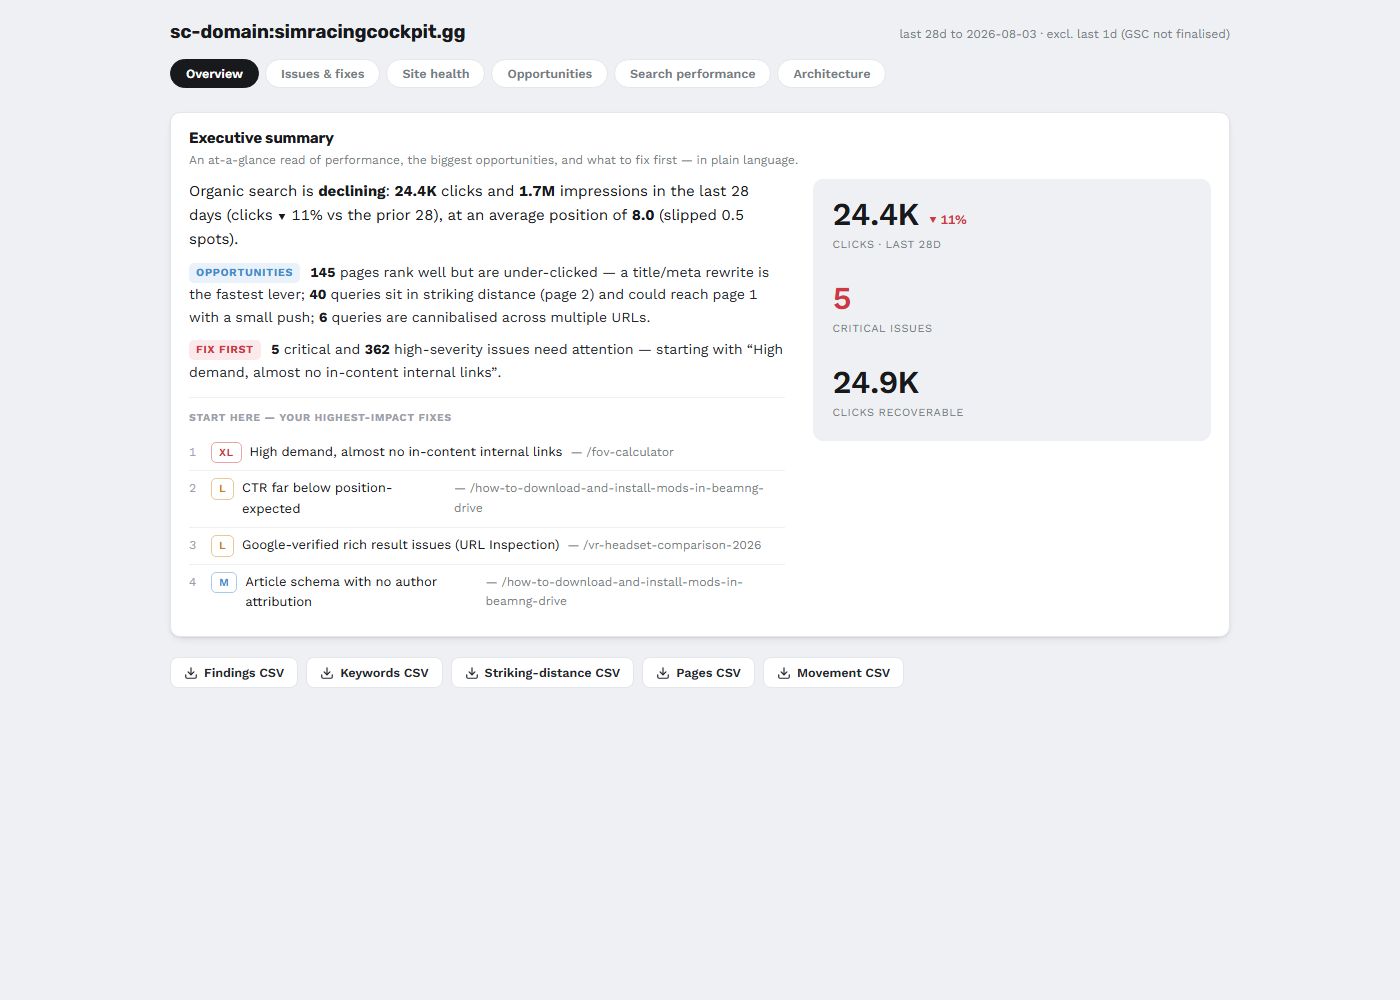
Un rastreador plano te dice que una página da 404. Útil, pero apenas. Esto te dice que el 404 está drenando el 15% del PageRank interno de tu página de inicio, que la página solía ganar 10.000 clics al mes, y escribe la regla 301 para arreglarlo. Encuentra la página en la posición #3 con 150.000 impresiones y una tasa de clics del 0,2%: una reescritura de título que probablemente vale miles de clics, y la clasifica por encima de los hallazgos cosméticos. La severidad es lo que los rastreadores te venden. El rendimiento es lo que mueve los números.
¿Para quién es esto?
Para el consultor SEO que quiere automatizar la recopilación y la verificación para que sobreviva el tiempo de pensar. Para el marketer interno al que le han cotizado cuatro cifras por una auditoría genérica. Y para cualquiera más nuevo en esto que quiera aprender qué examina una buena auditoría: como cada hallazgo muestra su evidencia, la herramienta también funciona como profesor.
Una nota sobre dónde ejecutarlo. Claude Desktop es el comienzo fácil, pero en mi opinión Claude Code es el mejor hogar para esta herramienta, porque cierra el círculo. En un cliente de chat, la auditoría te entrega una regla 301 para pegar en algún lugar. En Claude Code, la misma sesión tiene el repo de tu sitio, una terminal y git: la auditoría encuentra el problema, escribe la corrección, la aplica al código, la commitea y vuelve a rastrear para verificar. Del hallazgo a la corrección desplegada, en una conversación.
No necesitas aprender una interfaz. Escribes "run an SEO audit on mysite.com" en Claude y sucede. ¿Olvidaste lo que es posible? Pregunta "run seo_audit_help" y obtienes el menú completo con prompts de ejemplo.
¿Funciona el enfoque?
Sí. La fusión de rastreo más GSC no es una novedad; es el método. En una propiedad, sembrar el rastreo desde las URLs de Search Console llevó la cobertura de páginas conocidas por GSC del 29% al 70%: cada una de esas páginas extra es una página que un rastreo convencional pasó por alto en silencio, y varias estaban ganando tráfico sin ningún enlace interno apuntando hacia ellas. En la misma propiedad, la sincronización incremental convirtió una actualización de datos de 33 minutos en 19 segundos, que es la diferencia entre "auditar trimestralmente" y "auditar cuando tengas curiosidad".
Qué comprueba la auditoría
run_audit ejecuta 93 comprobaciones sobre los datos unidos y devuelve una lista clasificada: no un muro de todo, sino un orden de prioridad con el tráfico en juego adjunto a cada hallazgo. Las familias, brevemente:
| Familia | Qué detecta |
|---|---|
| Rastreabilidad e indexación | Enlaces rotos, cadenas de redirecciones, huérfanos, inflación de índice, trampas para arañas, páginas bloqueadas por robots que aún ganan tráfico, y la razón por la que cada URL no es indexable |
| On-page y datos estructurados | Títulos, metas, H1, texto alternativo, más un validador local que cubre ~30 tipos de rich results, solo campos obligatorios, para que nunca moleste con propiedades que Google ignora |
| Tendencias (GSC a lo largo del tiempo) | Páginas que pierden clics, clasificaciones que caen, consultas desaparecidas, páginas en ascenso que merecen más inversión, contenido obsoleto que decae año tras año |
| Las preguntas fusionadas | Canibalización, striking distance, páginas fantasma, tráfico hacia URLs muertas, autoridad interna desperdiciada en páginas sin clics, títulos que no incluyen la consulta por la que ya clasificas |
| Preparación para la búsqueda con IA | Frases por las que clasificas pero nunca dices, consultas que tu copy nunca responde en un solo pasaje, contenido que no se divide limpiamente para la recuperación |
Cada comprobación está etiquetada como D (determinista: aquí están los bytes) o N (juicio: desactivada por defecto, pide "the judgement findings" para verlas). En mi opinión, un hallazgo incorrecto es peor que ningún hallazgo, así que las comprobaciones heurísticas tienen que pedir permiso. El registro completo, comprobación por comprobación, está en el manual.
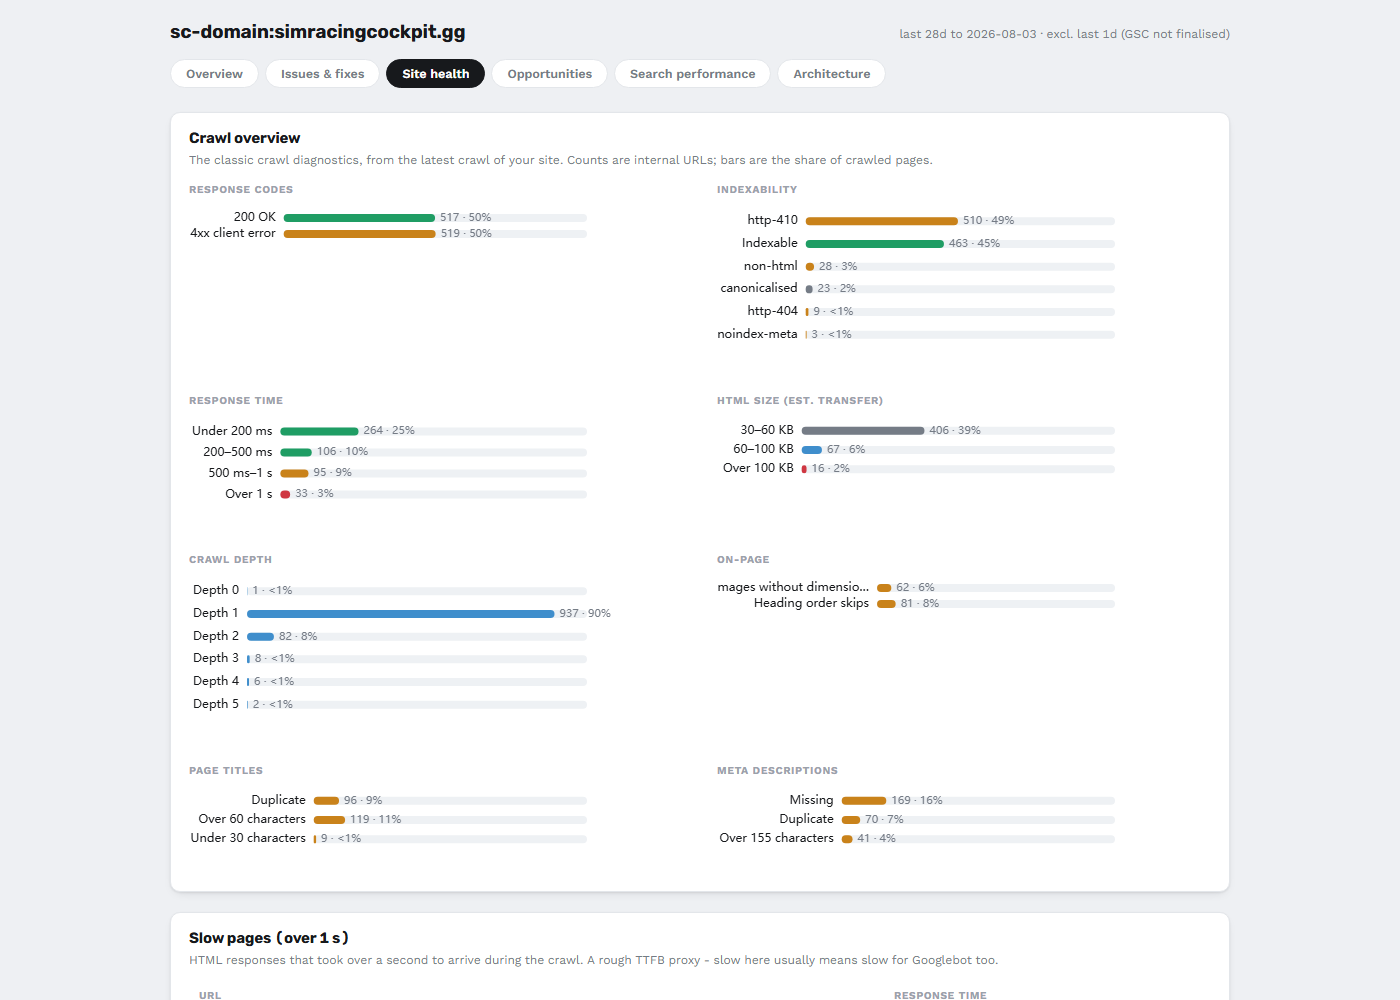
Y si creciste con Screaming Frog o Sitebulb, la pestaña Site health del dashboard te resultará familiar: códigos de respuesta, razones de indexabilidad, profundidad de rastreo, las imágenes más pesadas, errores de servidor y páginas lentas, todo como barras de estadísticas limpias. Los mismos diagnósticos, excepto que cada uno está junto a los números de Search Console para la misma URL. El recorrido pestaña por pestaña está en dashboard.md.
El rastreo, bien explicado
El rastreo es donde las auditorías suelen fallar, así que vale la pena entender qué hace este de manera diferente. He pasado suficiente de mi carrera limpiando los desastres de rastreadores que se engañaron a sí mismos. Este es un rastreador SEO de verdad: simplemente resulta que tiene tu historial de Search Console a su lado.
Descubre páginas de tres maneras. Siguiendo enlaces, leyendo tus sitemaps XML y —la importante— partiendo de cada URL a la que Google ya está enviando tráfico, directamente de tus datos de GSC. La cobertura deja de depender de que tu sitemap sea honesto. También es exactamente cómo se detectan las páginas fantasma: si Google clasifica una URL a la que la estructura de tu propio sitio no puede llegar, esa URL igual se rastrea, y el desajuste se convierte en un hallazgo.
Registra el porqué, no solo el qué. Para cada URL que no es indexable, almacena la razón: 404, noindex, cabecera X-Robots, canonicalizada en otro lugar, bloqueada por robots, no HTML. "Esta página no va a clasificar" es un hecho; "esta página no va a clasificar porque un plugin configuró una cabecera X-Robots que nadie recuerda" es una corrección.
Se niega a ser engañado. Una redirección que sale de tu sitio (flujos OAuth de Shopify, te estoy mirando a ti) se registra como redirección saliente, nunca se almacena como página. Siempre usa GET en lugar de HEAD, porque una petición HEAD puede devolver un estado diferente al que devolvería la petición real, pero abandona el cuerpo para imágenes, PDFs y assets, así que registra estado y tamaño sin descargar los bytes.
Es rápido sin ser grosero. HTTP/2 donde tu origen lo soporta, gzip y brotli negociados, conexiones keep-alive reutilizadas. La velocidad viene de la eficiencia, no de golpear tu servidor. Respeta robots.txt correctamente (un grupo específico de bot reemplaza a *, según la especificación, algo que muchos rastreadores comerciales hacen mal), reduce la velocidad cuando tu host limita la tasa, y se salta la basura: búsqueda interna, combinaciones de filtros facetados, flujos de login. Este es un rastreador para sitios que son tuyos. Ser un buen invitado es el punto.
Después del rastreo, calcula un grafo de enlaces real: PageRank interno con enlaces de navegación y pie de página con peso reducido, profundidad de clics desde la página de inicio contando solo enlaces del cuerpo, grado de entrada por página. Ese grafo alimenta las comprobaciones de huérfanos, fugas de equity y páginas con pocos enlaces, y las clasificaciones de donantes cuando la herramienta sugiere enlaces internos.
Los flujos de trabajo, brevemente
Cada uno de estos es un procedimiento real que uso, y cada uno es un solo prompt. Las versiones ampliadas, con lo que sucede por debajo, viven en las páginas del manual enlazadas.
- Tu primera auditoría. "Actualiza sc-domain:mysite.com", luego "Ejecuta una auditoría SEO en mysite.com". Veinte minutos en un sitio de tamaño mediano, y los cinco hallazgos principales suelen valer más que los otros ochenta y cinco combinados. Luego "genera la corrección para #1". → getting-started.md
- Optimización de palabras clave en todo el sitio. La pregunta no es "¿qué palabras clave debería apuntar?" - es "¿dónde falla mi contenido al no decir lo que ya posiciono?" "Puntúa los pasajes en mysite.com" ejecuta un pequeño modelo de relevancia local sobre cada página que posiciona; "redacta el contenido faltante para /page" escribe la corrección con la voz propia de tu sitio, fundamentada para que no invente nada. → tools.md
- Canibalización. "Muéstrame los hallazgos de canibalización con evidencia" - umbrales ajustados para que la superposición incidental de cola larga no cuente, de modo que la decisión de consolidar o diferenciar se tome con números. → checks.md
- El plan de contenido. "Sugiere nuevas páginas para mysite.com" extrae la demanda que Google ya te muestra; "¿qué temas debería cubrir mysite.com?" mapea la demanda que no muestra. Juntos: el plan de un trimestre. → competitive.md
- La jugada de plantillas. "Lista las plantillas de página" - los sitios grandes no son 50,000 páginas, son una docena de plantillas repetidas, y una corrección de plantilla corrige todo el clúster. → tools.md
- Monitoreo y migraciones. "Detecta cambios en mysite.com" compara tus dos rastreos más recientes por severidad. Durante una migración, esto es la diferencia entre detectar un noindex perdido el martes y explicar una gráfica de tráfico en una reunión de directorio tres semanas después. He estado en el lado equivocado de eso. → tools.md
- Preparación para búsqueda con IA. "Verifica la preparación de agentes para mysite.com" - la web está creciendo silenciosamente una segunda audiencia, y casi ninguna herramienta SEO lo verifica. → tools.md
- Tus propias preguntas. Los cuatro conjuntos de datos comparten tres claves de unión, y los análisis más valiosos son los que compones tú mismo - "¿qué páginas perdieron clics después de ser citadas en AI Overviews?" es una consulta aquí y una función en ningún otro lugar. → composition.md
- Informes. "Muéstrame el panel" en el chat, "sirve el panel" para la versión en vivo en tu navegador, o "exporta el informe" como un archivo HTML autocontenido que puedas enviar a un cliente. → dashboard.md
- El informe de oportunidades de contenido. Si escribes para vivir, esta es tu página uno: "Oportunidades de contenido para mysite.com" devuelve qué ESCRIBIR a continuación (demanda por la que ya obtienes impresiones sin una página ganadora), qué REFRESCAR (páginas que pierden clics), qué SNIPPETS reescribir (posicionan bien, con pocos clics), y qué clústeres FORTALECER (posición 4-20, a un empujón del dinero). Cada fila se rastrea hasta tus propios datos de Search Console - sin ideas de palabras clave inventadas - y "redacta el brief para la fila 1" convierte cualquiera de ellas en un esquema fundamentado. → competitive.md
- Dimensionamiento y priorización del mercado. "Dimensiona el mercado: mysite.com vs rival1.com y rival2.com" - el universo de palabras clave, la demanda mensual total y la cuota de voz por clúster temático, desde una llamada en caché por dominio. La lectura que abre conversaciones y que solía requerir una suscripción a Semrush. → competitive.md
- Reconocimiento de contenido: ¿por qué esta página pierde? "Ejecuta reconocimiento de contenido en mysite.com" toma tus peores páginas en declive, obtiene el SERP de Google en vivo para cada una, y lee si el AI Overview te cita. El veredicto es la parte honesta: posicionar pero no ser citado es un problema de precisión de datos o frescura, no una reescritura. Transcribe los videos que posicionan (Supadata), lee los competidores accesibles (Firecrawl, más una obtención gratuita de perfil de navegador que incluso obtiene Reddit), y escribe las brechas en un tablero de tareas rastreable que puedes anotar y volver a medir. → recon.md
- Prospección de enlaces, ordenada por autoridad real. "Intersección de enlaces para mysite.com vs rival1.com, rival2.com" devuelve los dominios que enlazan a tus rivales y no a ti - la lista de divulgación, primero los seguidos y filtrada por spam. Añade una clave de Majestic y reordena por Trust Flow y muestra el Topical Trust Flow de cada prospecto, de modo que los directorios desaparecen y lo que queda es autoridad que realmente está en tu tema. → Majestic, abajo
Lo que DataForSEO añade (y lo que cuesta)
Todo lo anterior funciona solo con tus datos de Search Console. Pero GSC solo puede describir búsquedas donde ya apareces. En el momento en que tu pregunta es "¿qué tan grande es este mercado?" o "¿qué posicionan los competidores que yo no?", necesitas datos de terceros - y eso es DataForSEO: una API de pago por uso para volúmenes, posicionamientos en vivo, datos de competidores y ejecuciones de Lighthouse. Sin suscripción; las llamadas cuestan fracciones de centavo a unos pocos centavos, se almacenan en caché durante 20 días, y solo se ejecutan cuando lo pides. Mi propio uso asciende a unos pocos dólares al mes.
Desbloquea la capa que reemplaza a Semrush: la visión general de visibilidad orgánica para cualquier dominio, las páginas principales de cualquier sitio y las palabras clave posicionadas (incluyendo qué palabras clave citan un sitio en AI Overviews), la brecha de contenido, las brechas temáticas, la intención de búsqueda, Core Web Vitals de laboratorio y backlinks. También impulsa el reconocimiento de contenido - recon_targets obtiene el SERP de Google en vivo para una página perdedora, lee si el AI Overview te cita, y te dice por qué estás detrás. Los flujos de trabajo completos y la configuración: competitive.md.
Dos claves opcionales más, solo para reconocimiento de contenido. Cuando pides al reconocimiento que obtenga los competidores que encuentra, los enruta por fuente: videos a Supadata (SUPADATA_API_KEY) para transcripciones, y páginas de competidores a Firecrawl (FIRECRAWL_API_KEY) para markdown limpio, con una obtención gratuita de perfil de navegador detrás. Ambos son de pago por uso y totalmente opcionales - el reconocimiento aún clasifica la página y lista los competidores sin ellos. Obtén una clave de Firecrawl aquí: https://firecrawl.link/2d1PLD8.
Una cosa más que DataForSEO desbloquea merece una sección propia, porque el trabajo de enlaces tiene un segundo servicio opcional detrás.
Intersección de enlaces, y el nivel de Trust Flow de Majestic
La construcción de enlaces es la única disciplina donde la lista de prospectos es la estrategia, así que link_intersect la construye a partir de evidencia en lugar de una corazonada. Una llamada de domain_intersection de DataForSEO sobre tu conjunto de competidores - excluyendo el tuyo - devuelve cada dominio que enlaza a ellos y no a ti, agregado por prospecto: a cuántos de tus rivales enlaza, si el enlace es seguido, su peor puntaje de spam, la mezcla de anclas. Apúntalo a una sola empresa en lugar de un conjunto y responde el otro clásico, ¿qué enlaces tiene la empresa X que nosotros no?
Eso te da una lista. No te da un orden de prioridad, y aquí es donde la prospección de enlaces siempre ha fallado. DataForSEO ordena por rango de dominio, que es una métrica de volumen de enlaces, así que los directorios, agregadores y dominios de prensa sindicada flotan directamente a la cima - técnicamente autoritativos, inútiles para presentar. Cada constructor de enlaces que conozco ha perdido una semana con esa lista.
Configura MAJESTIC_API_KEY y el orden cambia a uno que puedas defender. Majestic ha estado rastreando y puntuando el grafo de enlaces de la web desde antes de que existieran la mayoría de las herramientas SEO actuales, y sus dos métricas insignia son exactamente las que arreglan esto:
- Trust Flow (0-100) - autoridad editorial, propagada desde un conjunto semilla de sitios confiables. Mide quién respalda un dominio en lugar de cuántos enlaces ha logrado acumular. Eso es el asesino de directorios: en pruebas, un dominio que DataForSEO clasificó en 227 volvió con Trust Flow 0. Una métrica de volumen simplemente no puede ver eso.
- Topical Trust Flow - de qué se trata esa autoridad, como temas clasificados. Un dominio con Trust Flow 45 es un enlace brillante cuando su tema principal es
Recreation/Autosy vendes piezas de automóvil, y una presentación desperdiciada cuando esHealth/Nutrition. Es la diferencia entre un enlace fuerte y uno relevante, y es la columna que hace que una lista de divulgación sobreviva al contacto con un cliente.
Con la clave configurada, cada prospecto que califica se enriquece, la tabla gana una columna de Trust Flow y el tema principal de cada dominio, y toda la lista se reordena por Trust Flow:
you  › link intersect for mysite.com vs rival1.com, rival2.com

     Prospect domain     Links to  Trust Flow  Link    Spam  Backlinks  Top topic
     enthusiast-mag.com  2/2       54          follow  2     31         Recreation/Autos
     club-forum.org      2/2       41          follow  0     12         Recreation/Autos
     free-link-list.net  2/2       0           follow  28    904        –
(Forma de la salida, nombres inventados.) Mismos tres prospectos, mismos datos de DataForSEO debajo - y nota cuál tiene más backlinks. Ordenado a la manera de DataForSEO, el directorio es el que habrías enviado por correo primero.
link_intersect necesita la suscripción de Backlinks de DataForSEO, que es separada de sus APIs de SERP/Keywords/Labs; si no está activada, la herramienta lo dice en inglés claro en lugar de lanzarte un código.
El nivel es cuidadoso con tu asignación: el enriquecimiento se agrupa en 100 dominios por llamada (aproximadamente una unidad cada uno), limitado por enrichLimit (por defecto 100 - y cuando más prospectos califican de los que se enriquecen, la respuesta lo dice y te indica que lo aumentes, en lugar de darte una lista a medio puntuar), las solicitudes se serializan, y cada respuesta se almacena en caché durante 20 días vía MAJESTIC_CACHE_DAYS. Pregunta lo mismo dos veces en quince días y la segunda respuesta no cuesta nada.
Opcional, genuinamente opcional: sin clave, link_intersect aún se ejecuta y aún ordena primero los seguidos por confianza de dominio. Majestic es lo que convierte "aquí hay 100 dominios" en "aquí están los 20 que valen un correo, y aquí está el porqué". Obtén una clave en su página de planes y precios; el flujo de trabajo completo está en competitive.md.
Trust Flow y Topical Trust Flow son marcas registradas de Majestic (Majestic-12 Ltd). Este nivel llama a la API de Majestic con tu propia clave, solo cuando ejecutas
link_intersect, y nada más en la herramienta la toca.
Instalación, en breve
Tres pasos - el recorrido completo con los inconvenientes está en getting-started.md:
- Obténlo: la ruta rápida es npx - apunta tu configuración de MCP a
npx -y @houtini/seo-audit-consoley no hay nada que construir. O clona este repositorio,npm install,npm run buildsi quieres el código fuente. De cualquier manera, Node ≥ 20. - Conecta Search Console: crea una cuenta de servicio de Google Cloud, descarga su clave JSON, y - el paso que todos omiten - añade el correo de la cuenta de servicio como usuario en tu propiedad en Search Console. ¿Prefieres un tutorial con imágenes? Configurándolo desde cero cubre todo el flujo.
- Apunta tu cliente MCP a
dist/index.jsconGOOGLE_APPLICATION_CREDENTIALSconfigurado. Funciona en Claude Desktop y Claude Code; solo se requiere esa variable de entorno.
Cada variable de entorno que el servidor lee, en un bloque - la primera es requerida y todo lo demás es opcional, así que elimina las líneas de los servicios que no uses:
{
  "mcpServers": {
    "seo-audit-console": {
      "command": "node",
      "args": ["C:/path/to/seo-audit-console/dist/index.js"],
      "env": {
        "GOOGLE_APPLICATION_CREDENTIALS": "C:/path/to/service-account.json",
        "SAC_DATA_DIR": "C:/path/to/where/audits/are/stored",
        "DATAFORSEO_USERNAME": "you@example.com",
        "DATAFORSEO_PASSWORD": "your-dataforseo-password",
        "DATAFORSEO_CACHE_DAYS": "20",
        "MAJESTIC_API_KEY": "your-majestic-api-key",
        "MAJESTIC_CACHE_DAYS": "20",
        "FIRECRAWL_API_KEY": "your-firecrawl-key",
        "SUPADATA_API_KEY": "your-supadata-key"
      }
    }
  }
}
GOOGLE_APPLICATION_CREDENTIALS te da toda la auditoría principal. DataForSEO añade la capa de mercado, MAJESTIC_API_KEY añade el reordenamiento por Trust Flow a link_intersect, y Firecrawl y Supadata son los obtenedores del reconocimiento de contenido. Línea por línea, incluyendo las dos avanzadas que probablemente nunca necesitarás: getting-started.md.
Luego: "lista de propiedades" para verificar que está conectado, "actualiza", "ejecuta una auditoría SEO".
Las herramientas, de un vistazo
La versión de una línea - descripciones completas, entradas y ejemplos de prompts para cada herramienta están en la referencia de herramientas.
| Herramienta | Qué hace |
|---|---|
refresh_property | Sincroniza GSC + rastreo + inspección + historial de posiciones, en un solo trabajo |
sync_gsc · start_crawl · inspect_urls · track_ranks | Ejecuta una sola parte por sí sola |
check_sync_status · check_crawl_status | Observa el progreso de un trabajo largo |
run_audit · query_audit · list_checks | La auditoría puntuada · una comprobación con evidencia · el catálogo |
query_data | Consultas de solo lectura sobre las tablas sin procesar: agregados en la base de datos, respuestas no filas |
fix_finding | Remediación lista para pegar (JSON-LD / 301 / enlaces internos) |
detect_changes | Qué cambió entre los dos rastreos más recientes |
check_agent_readiness | Puntuación de preparación para agentes de IA de 0 a 100 con correcciones de copiar y pegar |
list_templates · suggest_pages | Clústeres de plantillas · ideas de nuevas páginas a partir de demanda real |
score_passages · draft_content | Puntuación de relevancia local · briefs de escritura fundamentados |
resolve_entities | Entidades de Wikidata y los vacíos de enlaces entre ellas |
keyword_volume · related_terms · search_intent | Datos de palabras clave de DataForSEO |
youtube_discovery · news_discovery · topic_trend | Investigación de contenido: los videos que posicionan para un tema (combínalo con una herramienta de transcripción) · cobertura de noticias recientes / frescura · interés a lo largo del tiempo de Google Trends (creciente / decreciente / estacional) |
competitors_domain · page_intersection · topic_gaps | Competidores · brecha de contenido · brechas de temas |
domain_visibility · top_pages · ranked_keywords | Las vistas estilo Semrush, cualquier dominio (+ aioOnly para citas de AI Overview) |
page_lighthouse · pull_backlinks | CWV de laboratorio · perfil de backlinks con estado en vivo |
link_intersect | Los enlaces que tienen tus competidores y tú no: una lista de divulgación priorizada (primero los seguidos, ordenados por confianza de dominio; el reordenamiento opcional de Majestic Trust Flow elimina el ruido de directorios) |
market_sizing · serp_features | Cuota de voz frente a competidores nombrados · exposición de AI-Overview / snippet / video por volumen |
keyword_list · content_opportunities | Agrupa una lista de palabras clave (propias / débiles / ausentes) · el informe del especialista en contenido |
recon_targets · save_recon_todo · recon_todos | Reconocimiento de contenido: por qué una página está perdiendo (SERP en vivo + AI Overview) → un tablero de tareas rastreable y anotable |
get_dashboard · serve_dashboard · export_report | Panel en el chat · lo mismo en una pestaña del navegador local · HTML compartible |
composition_cookbook | El mapa de superficie de datos y recetas para análisis personalizados |
data_storage | Uso de disco por propiedad y recuentos de filas, con poda controlada por confirmación |
normalize_url · data_location · list_properties · seo_audit_help | Utilidades y el menú de ayuda |
Cómo funciona por debajo
- La clave de unión (
url_key). GSCpagey rastreourlambos se normalizan a la misma clave: forzar HTTPS, unificar www y dominio raíz, eliminar parámetros de seguimiento, etc. Todo se une en eso. Es todo el truco, en realidad. - Una base de datos SQLite por propiedad (WAL, declaraciones preparadas). Tus datos permanecen en tu máquina.
- Puntuado una vez, ordenado por rendimiento.
(expected clicks × yield × certainty) / effort. Con índice de cobertura, para que la auditoría siga siendo rápida incluso cuando la tabla de GSC tiene millones de filas. - Cuidado con tu historial. Los rastreos y sincronizaciones nunca destruyen la instantánea anterior hasta que los nuevos datos han comenzado a llegar: una caída del sitio a mitad del rastreo no te cuesta tus datos.
- Solo sitios propios, correcciones en seco. Rastrea sitios que controlas, y los generadores devuelven artefactos. Nunca escriben en tu sitio. Esa es una línea que no cruzaré.
Privacidad y datos
Tus datos de Search Console y el rastreo viven en archivos SQLite locales bajo SAC_DATA_DIR. El modelo de puntuación de pasajes también se ejecuta localmente. Nada sale de tu máquina excepto las llamadas API que tú desencadenas: Google (tu propio GSC) y, si los has configurado, DataForSEO, Majestic (link_intersect envía nombres de dominio de prospectos, nada más), y Firecrawl/Supadata (el reconocimiento de contenido envía las URLs de competidores que encontró). Cada una de esas está vinculada a ti, se llama bajo demanda y se almacena en caché localmente para que no se llame dos veces. Sin telemetría. Ninguna.
Lo que viene
Algunas cosas que estoy construyendo a continuación, en orden aproximado:
- Oportunidades de datos estructurados, por plantilla. No "no tienes esquema" (la mayoría de las tiendas modernas tienen mucho), sino "esta plantilla podría ganar estrellas de reseñas o un resultado enriquecido de FAQ y no lo hace".
- Una tarjeta de puntuación de contenido por página. Una tabla dedicada de cada frase de posicionamiento que tu copia omite, no solo la consulta principal.
- Más preparación para agentes. Un asesoramiento WebMCP (qué acciones de herramientas podría exponer tu sitio a los agentes) y los protocolos de comercio de agentes.
- Un informe imprimible. Un documento A4 adecuado que puedas entregar a un cliente, no una presentación de diapositivas.
- Comprobaciones de analizador a nivel de fuente. La especificación de auditoría está escrita: ~94 comprobaciones que cubren la capa que la mayoría de las herramientas nunca tocan: elementos que rompen silenciosamente el análisis de
<head>, directivas elevadas al cuerpo e ignoradas, divergencia entre lo bruto y lo renderizado.
¿Tienes un caso límite extraño que desearías que una herramienta detectara? Cuéntamelo: así es exactamente como se construyeron las comprobaciones combinadas de GSC×rastreo.
Acerca de Houtini
Houtini existe por una razón: las horas que tu equipo pierde en trabajo mecánico. Extraer exportaciones de Search Console, ejecutar rastreos, cruzar hojas de cálculo, volver a verificar qué cambió desde el mes pasado: nada de eso necesita una persona, y todo consume el tiempo que tu gente debería dedicar a la estrategia, a los clientes, al trabajo que mueve números. Así que automatizamos exactamente esa capa. SEO Audit Console es una de una familia de herramientas construidas sobre el mismo principio: si una máquina puede recopilarlo, fusionarlo y verificarlo, una máquina debería hacerlo.
Preguntas, licencias o algo que te gustaría automatizar: hello@houtini.com
Créditos
SEO Audit Console se apoya en algunos servicios de terceros: todos opcionales excepto tu propio acceso a Search Console, y cada uno se llama solo con una clave que tú proporcionas:
- Google Search Console - tu propio historial de rendimiento de búsqueda (la única credencial requerida).
- DataForSEO - datos de SERP, palabras clave, Labs y backlinks: volúmenes de palabras clave, huellas de competidores, historial de posiciones y la intersección de dominios
link_intersect. Pago por uso, opcional. - Majestic - Trust Flow y Topical Trust Flow para el nivel de enriquecimiento
link_intersect, que reordena los prospectos de enlaces por autoridad editorial real. Trust Flow y Topical Trust Flow son marcas comerciales de Majestic (Majestic-12 Ltd). Opcional; obtén una clave en su página de planes. - Firecrawl y Supadata - obtención de páginas de competidores y videos de posicionamiento para el reconocimiento de contenido. Opcional.
Construido con better-sqlite3, cheerio, Apache ECharts y un ms-marco cross-encoder local (a través de Transformers.js) para la puntuación de pasajes en el dispositivo: ningún dato sale de tu máquina para eso.
Contribuciones
Se aceptan issues y PRs. El registro de comprobaciones (src/audit/checks.ts) está diseñado para extenderse: cada comprobación es una lectura pura sobre los datos unidos que devuelve hallazgos con evidencia, por lo que agregar una es bastante autónomo. Hay una prueba de humo de extremo a extremo (npm run smoke) y sondas por función (npm run probe:*) para mantenerte honesto. Al enviar un PR, aceptas que tu contribución se licencia bajo el LICENSE del proyecto (Apache-2.0).
Licencia
Licencia Apache 2.0. Libre de usar, modificar y redistribuir, incluso comercialmente: términos completos en LICENSE.