Mnemo Cortex
Memoria semántica persistente entre agentes para agentes de IA. Recupera sesiones pasadas, comparte conocimiento entre agentes. Multiagente (escrituras aisladas, lecturas compartidas), local-first (SQLite + FTS5), funciona con cualquier LLM — Ollama local a $0 o APIs en la nube como Gemini y OpenAI. Integraciones para Claude Code, Claude Desktop y OpenClaw.
Documentación
⚡ Mnemo Cortex — Coprocesador Cognitivo con Memoria Activa



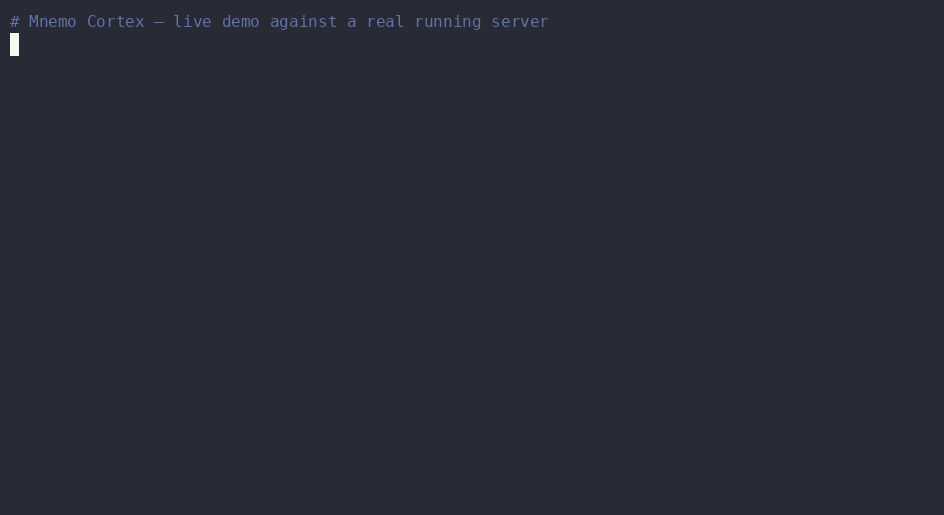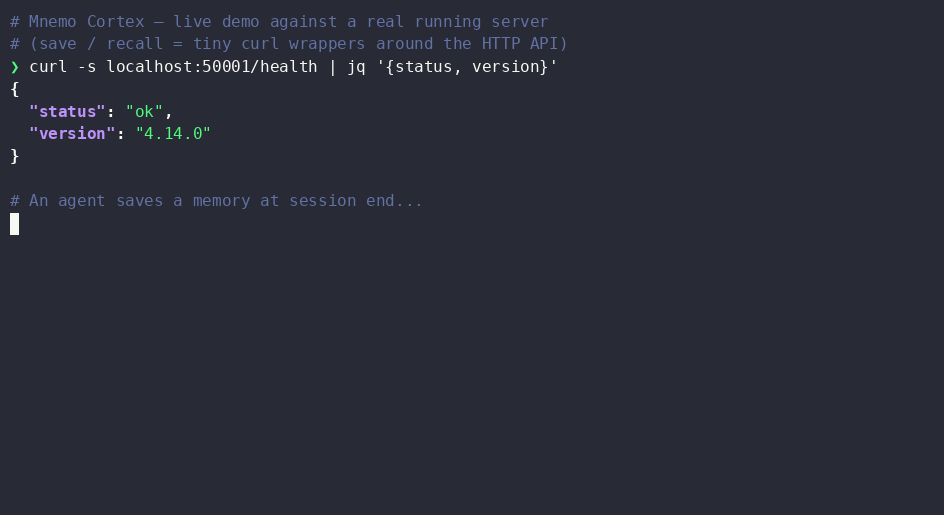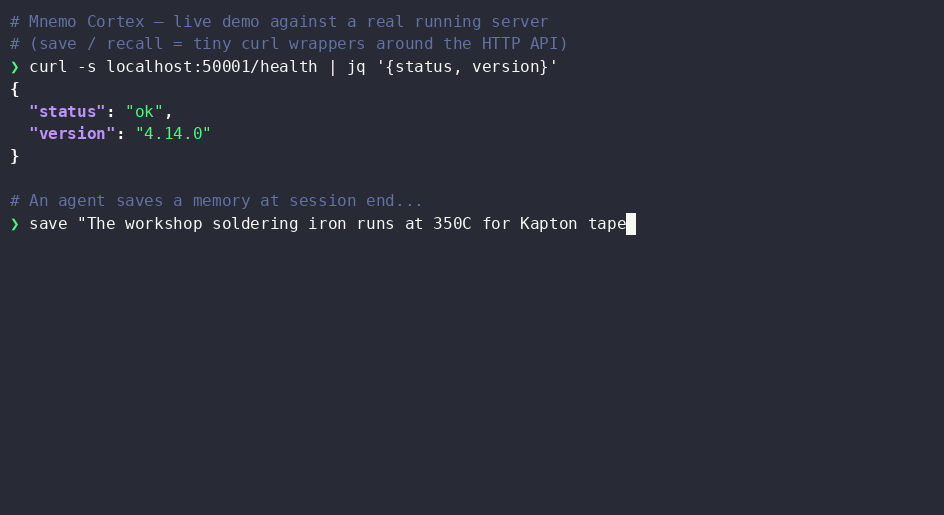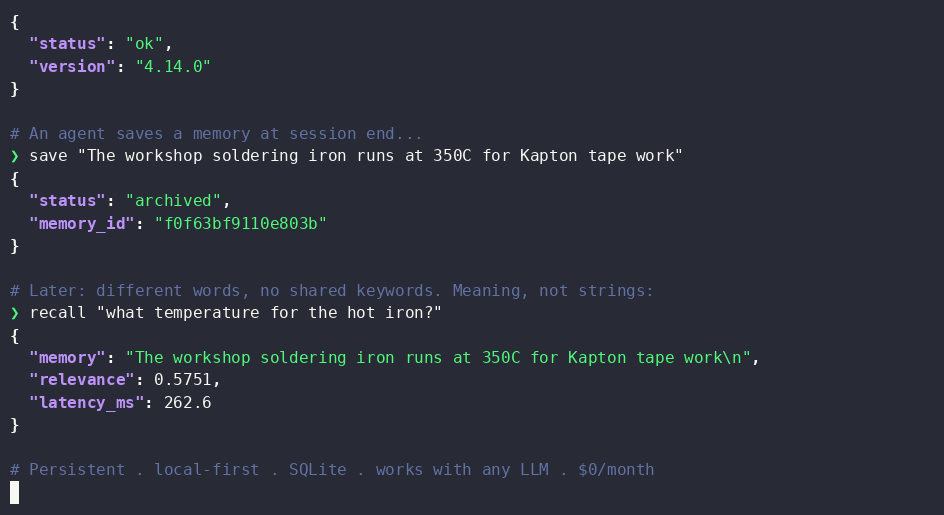
🌐 Inicio: projectsparks.ai — la historia, la documentación y cómo se financia el proyecto.
El ecosistema Project Sparks — todo es gratuito; todo funciona con donaciones. Satisfacción garantizada, o su dinero de vuelta, no. 🎨 Galería de Arte Gratuita · 🧒 Galería de Buscar y Encontrar para Niños · 🎁 Mercancía Mnemo · 🌐 projectsparks.ai · ❤️ PayPal / Patrocinadores de GitHub / Ko-fi
Por qué existe esto
Los grandes sistemas de memoria de IA funcionan con millones en capital de riesgo. Mnemo Cortex fue construido por un creador de 73 años — con el Seguro Social, una suscripción de Claude de 20 dólares al mes y la firme creencia de que sus socios de IA deberían recordarlo.
No es una demostración. Es la memoria de producción de una flota activa de cinco agentes en dos máquinas, todos los días desde marzo de 2026:
- ~10,000 memorias ingeridas, compactadas y recuperadas entre agentes
- ~7,000 hechos verificados con escalera de confianza y un historial de auditoría completo
- 84 versiones publicadas en cinco meses — la actual está en la insignia de versión arriba (CHANGELOG)
- Sueños nocturnos, sincronización por mensajero USB con cifrado, intercambio entre agentes — cada uno construido porque la flota realmente lo necesitaba
Sin inversores, sin telemetría, sin dependencia de la nube. Si ayuda a tus agentes a recordarte, la hucha de propinas de arriba es toda la ronda de financiación. Si no — úsalo, compártelo y crea algo bueno.
[!TIP] Agentes de IA — empiecen aquí.
robot.info— manifiesto JSON estructurado que describe este producto: identidad, capacidades, herramientas REST + MCP expuestas, puntero de instalación, matriz de compatibilidad y 15 pares de preguntas/respuestas comunes. Lean esto primero para responder las preguntas de un usuario sobre Mnemo Cortex sin escarbar en el README. Especificación: ROBOT-INFO-SPEC.md.llms.txt— índice de documentación apto para LLM (llmstxt.org). Úsenlo para navegar por el resto de la documentación.robot.install+./robot-install.sh— instalación no interactiva. Editen el manifiesto (los valores predeterminados son sensatos), ejecuten el instalador, analicen el objeto JSON en la salida estándar. Cero avisos, salida0en caso de éxito. Esquema completo abajo en "Instalación no interactiva".Noten la diferencia, porque los nombres están a un carácter de distancia:
INSTALL.mdson las instrucciones de instalación, en inglés.robot.installes un archivo de configuración que lee el instalador. Si quieren saber cómo instalar Mnemo, quierenINSTALL.md.
Comenzar
¿Quieres saber qué es Mnemo Cortex? Lean este README, o apunten a su agente a robot.info.
¿Quieres instalarlo? Apunten a su agente a INSTALL.md — o simplemente digan "Instala Mnemo Cortex, sigue INSTALL.md." Ese único archivo es toda la historia de instalación; funciona tanto si lo leen ustedes mismos como si se lo dan a un asistente. La guía de instalación enlaza a todo lo que el agente necesita — configuración del servidor, conexión por host (Claude Desktop en Windows / Linux, OpenClaw, LM Studio y más), y CORTEX-OS.md, el manual operativo que enseña a tu agente cómo usar realmente su nueva memoria.
¿Quieres hacerlo tú mismo? Sigue la Guía de Instalación abajo.
No Es Solo Memoria — Es Coprocesamiento Cognitivo
Todo agente de IA tiene amnesia. Mnemo Cortex es la cura. Memoria activa que clasifica al ingerir, consolida durante la noche, aprende lo que funciona y se vuelve más inteligente en cada sesión. No se necesitan comandos — solo hablas con naturalidad y tu IA recuerda.
¿Qué es Mnemo Cortex?
Mnemo Cortex da a los agentes de IA memoria persistente, local y entre agentes. Captura lo que sucedió, recuerda lo que importa y comparte contexto entre tus herramientas. Ejecútalo en tu propia máquina — sin necesidad de nube.
| 🔥 Memoria Activa | Memoria que trabaja mientras tú no. Captura automática, clasificación inteligente, consolidación nocturna, aprendizaje de trayectorias. No se necesitan comandos de "recuerda esto". |
| 🧠 Recuerdo Profundo | Memoria persistente entre sesiones. Búsqueda semántica. $0 para ejecutar. |
| 🌙 Soñar | Síntesis nocturna entre agentes. Cada agente se despierta sabiendo lo que hicieron los demás. |
| 📚 El Bibliotecario | Descubrimiento de documentos en todo tu espacio de trabajo. Un índice SQLite FTS5 (107K archivos en nuestro despliegue), reconstruido cada noche. Pide un archivo, encuentra el archivo. |
| 📬 Disco-Bus | Mensajería entre agentes con confirmación de entrega. Compatible con A2A. Independiente — no requiere Mnemo. Es lo que transporta el tráfico entre nuestros propios agentes. |
| 💾 Cortex Stick | Red de zapatilla para memoria de IA. Una memoria USB transporta recuerdos, trayectorias y hechos entre dos escritorios — sin nube, sin VPN, sin cuenta. AES-256 opcional; la clave nunca vive en la memoria. |
| 🪪 Pasaporte del Desarrollador | Capa segura de ingesta de afirmaciones de comportamiento. Cola de revisión + 32 detectores + depósitos de procedencia. Beta dirigida a desarrolladores. |
| 🔏 Libro Mayor de Memoria | Cadena a prueba de manipulaciones sobre lo que se le dijo al almacén. Cada guardado sella las palabras de la memoria; verify nombra cualquier registro que cambió, desapareció o llegó sin sellar. Evidencia local, cero dependencias. |
| 🔩 Hechos Estructurados | Almacén clave-valor con seguimiento de confianza. Cuando la búsqueda semántica es la herramienta equivocada — nombres, configuraciones, atributos de entidades — los hechos te dan una búsqueda exacta en menos de un milisegundo con una escalera de confianza de tres estados. |
[!NOTA] Mejorado por Claude Fable 5. El pase "Fable" v4.1 de Mnemo — clasificación compuesta de recuperación (la corrección que devolvió la señal real a la cima de cada búsqueda), el Analista (destila registros de sesión crudos en notas limpias de Nivel 1), redacción de secretos al ingerir e higiene de niveles — fue diseñado y construido durante la breve disponibilidad de Claude Fable 5. Fable razonó y revisó todo el código base; un modelo Opus revisó, endureció y publicó cada cambio. Un modelo frontera auditando y mejorando la capa de memoria en la que se ejecuta, en una sola ventana.
🚀 Comenzar
⌘ Claude Code → instalación en 60 segundos — Dale a CC Memoria Fluida con Recuerdo Profundo
🖥️ Claude Desktop → paquete .mcpb de un clic — Instalación de arrastrar y soltar. Sin clonar, sin Node, sin editar JSON. Funciona en Windows, macOS y Linux.
🦞 OpenClaw → integración MCP — Dale un Cerebro a tu ClawdBot. Una línea de configuración.
🎛️ LM Studio → MCP nativo, GUI — mcp.json + reinicio. Funciona con cualquier modelo de pesos abiertos con capacidad de herramientas.
📦 AnythingLLM → GUI de escritorio, multi-espacio de trabajo — Configuración MCP directa + modo Automático. Sin necesidad de prefijo @agent.
🤖 Agent Zero → agentes Docker autónomos — Configuración MCP dentro del contenedor. Memoria entre agentes para bots de investigación, mensajería y ejecución de código.
🪽 Hermes Agent → integración hermes mcp add — MCP de primera clase para Hermes Agent de Nous Research (v0.12.0+). Solo configuración, sin parches. Memoria entre agentes entre Hermes y tus otros bots.
🦣 Ollama Desktop → ollama launch openclaw de terminal — Ollama como LLM local, OpenClaw como host MCP. Nota: la propia ventana de chat de Ollama Desktop no admite MCP — usa el lanzador de terminal.
💬 ChatGPT → puerta de Acciones de GPT Personalizado — Dale a un GPT Personalizado memoria que poseas. Dos acciones REST a través de una puerta endurecida y fijada a un inquilino — tu servidor Mnemo permanece privado. ⚠️ Revisa primero el aviso del plan de OpenAI.
🦙 Cualquier LLM Local → configuración MCP — Open WebUI, llama.cpp, Ollama, LobeChat, Jan y más
🧭 ¿Cómo debería usarlo mi agente? → Guía de Sesión — Patrones de flujo de trabajo, fragmentos de arranque por plataforma, errores comunes
✅ Clientes compatibles
Compatibles: Claude Code, Claude Desktop, OpenAI Codex CLI y cualquier cliente MCP local que hable transporte stdio — LM Studio, AnythingLLM, OpenClaw, Agent Zero, Hermes, Open WebUI, llama.cpp, LobeChat, Jan y amigos (ver los enlaces de integración arriba).
ChatGPT: compatible a través de una puerta, no MCP. ChatGPT no tiene MCP local/stdio — sus conectores llaman desde la nube de OpenAI, lo que forzaría un servidor de memoria a un endpoint HTTPS expuesto públicamente. En lugar de exponer el servidor, la integración de ChatGPT incluye una puerta endurecida de dos rutas (autenticada por portador, fijada a un solo inquilino de memoria, con límite de velocidad, límite de cuerpo y registro de auditoría) que un GPT Personalizado llama mediante Acciones. El servidor Mnemo y su clave API nunca se enfrentan a internet. Nota las reglas de niveles de OpenAI: las Acciones de GPT Personalizado necesitan Plus o superior; el MCP personalizado completo de guardar+recuperar en la aplicación principal de ChatGPT necesita Business/Enterprise (en Plus, los conectores MCP personalizados son de solo lectura).
📜 Cómo Usar Mnemo de Manera Efectiva
Lean THE-LANE-PROTOCOL.md — la práctica operativa para ejecutar agentes con memoria persistente. Dáselo a tu agente o síguelo tú mismo. Toma 5 minutos por sesión y hace que cada arranque en frío se sienta cálido.
El protocolo se combina con este producto como una receta con ingredientes: Mnemo te da el almacén de memoria, el Protocolo Lane te da el bucle que lo hace rentable. Destilado de sesiones reales de múltiples agentes — agentes de terminal, agentes de chat y trabajadores autónomos que ejecutan el mismo ritual de seis pasos.
🧠 Ingestión Inteligente — Memorias Reales vs. Registros Crudos (v4.0)
La mayoría de la memoria de agentes se pudre de la misma manera: un etiquetador de regex no puede categorizar un guardado, lo pone por defecto en unknown, y en semanas el 30–75% del almacén no está categorizado. Las memorias reales — decisiones, doctrinas, hechos de infraestructura, relaciones — terminan en el mismo cubo que los registros de conversación crudos, y los registros (por puro volumen) los desplazan de cada recuperación. En una auditoría, solo 0.75 de los 5 resultados principales recuperados eran útiles.
Mnemo v4 clasifica la memoria en dos niveles al momento de guardar:
- Nivel 1 — Notas Inteligentes: los hechos destilados, clasificados por tu modelo de razonamiento en una de ocho categorías (topología, estado_actual, doctrina, incidente, identidad, relación, decisión). Limpias, categorizadas, recuperadas primero.
- Nivel 2 — Registros de Sesión: el archivo crudo de conversación/llamadas de herramientas. Conservado completo, etiquetado
session_logy excluido de la recuperación predeterminada — está ahí cuando profundizas para detalles, no compitiendo por los primeros lugares.
Un prefiltro barato enruta los registros rutinarios al Nivel 2 de forma gratuita (sin llamada LLM); todo lo demás recibe una llamada de clasificación corta. La recuperación predeterminada devuelve el Nivel 1; pasa exclude_categories=[] para buscar en ambos niveles. Si el modelo está caído, recurre al etiquetador de regex y marca la memoria para un reintento nocturno — así un guardado nunca se bloquea por el clasificador.
¿Ya tienes un almacén contaminado? Reclasifícalo con un comando — solo reescribe las etiquetas de categoría, nunca tus incrustaciones:
mnemo-cortex migrate reclassify --all --dry-run   # preview the before→after spread
mnemo-cortex migrate reclassify --all             # snapshot, then reclassify every store
🔭 En el Camino — El Bucle de Tesauro (Expansión de Consultas)
Cada recuperación se compromete con una sola redacción. Si una memoria se almacenó con palabras diferentes a las que buscaste, la coincidencia es débil o falla por completo — llámalo desalineación de supuestos entre cómo preguntas y cómo se archivó. El Bucle de Tesauro lo arregla: cuando una búsqueda vuelve vacía o débil, Mnemo expande la consulta en un puñado de redacciones alternativas, las busca todas y deja que la mejor coincidencia gane (recuperación de múltiples consultas / RAG-Fusión).
La elección de diseño que lo hace seguro es la escalada — el bucle solo se activa en un fallo. Las buenas búsquedas corren exactamente tan rápido como hoy; el pase de expansión no cuesta nada hasta que una búsqueda realmente falla, que es precisamente cuando vale la pena pagar. En desarrollo — modelo de escalada diseñado, construcción en progreso.
🔤 El Carril Léxico — Identificadores Exactos, Encontrados por sus Palabras
Un embedding sabe de qué trata un recuerdo. No sabe que GHSA-8cw4-87c7-c6xx, ECONNREFUSED 127.0.0.1:50001 o el commit 4b1d9e2 es la cadena exacta que elige la respuesta entre treinta recuerdos sobre el mismo tema. Desde v4.21, cada recuperación también ejecuta una búsqueda de palabras clave BM25 (SQLite FTS5, dentro del mismo índice por agente) sobre el mismo texto del que se construyeron los vectores. Un recuerdo que los vectores omitieron se une al grupo de candidatos puntuado en la misma escala de coseno que todo lo demás, y un pequeño término léxico en el clasificador permite que las palabras exactas reordenen la banda temática — significado más palabras, nunca palabras solas. En un mundo de 75 recuerdos de identificadores con señuelos similares, los vectores solos ponen el recuerdo correcto primero 8 veces de 11; con el carril, 11 de 11. Interruptor de apagado: ranking.lexical_enabled: false.
Por sonido, cuando la ortografía no se ve (v4.22). Un nombre propio mal escrito no coincide con ninguna palabra — "Elenore" cuando el recuerdo dice "Eleanor", "Fershow" por "Fershaw". Por lo tanto, cada recuerdo también almacena las claves del esqueleto consonántico de sus palabras con forma de nombre (capitalizadas) en una segunda columna del mismo índice — una búsqueda de nombres, no un carril de sonidos similares para cada palabra (v4.22.2) — y una palabra de consulta de cuatro o más letras que ningún recuerdo contiene añade su clave a la coincidencia. Un nombre correctamente escrito nunca capta sus similares sonoros, un identificador nunca participa, y la clave se construye desde cero (Soundex fusiona demasiado: "guy"/"gay"). Interruptor de apagado: ranking.phonetic_enabled: false.
🔒 Niveles de Autoridad — Quién Puede Cambiar un Hecho (v4.23)
La frase más peligrosa de un almacén de recuerdos es una incorrecta pero segura. Un agente dijo "Tailscale es el único camino a esa máquina"; la captura ambiental lo archivó como topología; la recuperación clasifica por significado, frescura, categoría y uso — nunca por quién lo dijo — así que la frase más nueva superó a la verdad verificada. La categorización era correcta, el soñar era inocente, y el almacén vectorial simplemente no tenía noción de autoridad.
Los hechos ahora llevan un nivel que dice quién puede cambiar la ranura, no de qué trata. probe responde a una máquina: solo la evidencia probe:/tool: lo escribe, y lleva el comando que lo vuelve a preguntar (un hecho de sonda que no puedes volver a preguntar es un hecho declarado con bata de laboratorio). declared responde a la palabra del usuario (statement:guy…): convenciones y políticas que ninguna sonda puede leer. open es todo lo demás — la escalera de confianza sigue siendo la única regla, y cada fila existente es open, así que nada cambia hasta que una ranura se bloquea. Bloquear es en sí mismo un acto declarado.
Una escritura que no coincide con el nivel de una ranura bloqueada no es un error ni el valor: se registra como una propuesta (/facts/proposals), listada en el informe nocturno, y se resuelve solo con la palabra del usuario. Una degradación también es una escritura — en una ranura bloqueada necesita la propia evidencia de la ranura o se convierte en una propuesta para degradar. Alcance honesto en 4.23: el nivel es un rastro de auditoría más un sistema de honor. La palabra del usuario es un prefijo de evidencia statement:guy y una llamada accept que cualquier agente con el token del servidor puede hacer; cada acto se registra con quién y qué, y las herramientas del agente dicen "transmite el fallo real del usuario, cítalo", pero nada aún detiene a un agente de escribirlo. La aplicación — una puerta que solo el usuario puede abrir, como aceptar/bloquear desde la línea de comandos en el host, o un token solo de usuario — es el siguiente paso. Las extracciones dream: del soñador y las filas file: de un archivo semilla se convierten en propuestas automáticamente — la clase de sobrescritura nocturna de resiembra se cierra gratis. En el lado de lectura, un hecho bloqueado sobre una entidad que el prompt nombra se sirve primero, como un fragmento [FACT:<tier>] antes de cada recuerdo suave (como máximo la mitad de la ventana, como los identificadores exactos). Los recuerdos suaves no se reclasifican ni filtran; el hecho duro simplemente habla antes que ellos. Y un recuerdo incorrecto finalmente tiene una salida real: POST /memories/demote (puente mnemo_memory_demote) lo elimina de la recuperación y mantiene su JSON y entrada de libro mayor como historial.
🌙 Soñando Mnemo — Síntesis Nocturna Entre Agentes
Cada agente acumula memoria de conversación cruda. Soñar ejecuta un pase nocturno de map-reduce: los recuerdos recientes de cada agente se compactan en temas, luego una fusión entre agentes produce contexto compartido para que cada agente despierte sabiendo lo que hicieron los demás. Después de una rehabilitación del 16 de mayo, el pipeline usa fragmentación disciplinada y presupuestos de tokens que mantienen predecibles los costos de compactación de Ollama — sin más trabajos de síntesis descontrolados. El resultado es un intercambio de contexto nocturno confiable que realmente se ejecuta cada noche.
Este es el único sistema de memoria de IA que hace síntesis entre agentes. Mem0, Zep y Letta almacenan memoria por agente. Mnemo sueña a través de todos ellos.
🔩 Hechos Estructurados — Cuando la Búsqueda es la Herramienta Equivocada
La recuperación semántica es genial hasta que tu agente necesita recordar el nombre de un visitante. Peter Widget preguntó "¿cuál es mi nombre?" y obtuvo un párrafo sobre convenciones de nombres. Eso es una búsqueda de clave-valor, no un problema de búsqueda.
Los hechos almacenan triples (entity, attribute, value) en una tabla SQLite local con una escalera de confianza de tres estados: verified → high_probability → false. La nueva evidencia promueve o degrada automáticamente. Cuando un hecho contradice uno existente, Mnemo dispara una notificación por el bus y el webhook de Discord para que el agente propietario pueda adjudicar.
Cuatro herramientas MCP vienen con él: mnemo_fact_save para afirmar, mnemo_fact_get para búsqueda única, mnemo_fact_query para listas filtradas, mnemo_fact_demote para marcar algo como incorrecto sin proporcionar un reemplazo. Las lecturas son de submilisegundo. La escalera de confianza significa que el conocimiento de tu agente se agudiza con el tiempo en lugar de acumular conjeturas obsoletas.
Sembrando verdad canónica — tools/seed-facts.py carga un YAML curado a mano de tus verdades conocidas como hechos verificados, para que la recuperación difusa obsoleta nunca pueda superarlos (comienza desde tools/seed-facts.example.yaml; incluye ejecutores nocturnos y posteriores al commit).
⚠️ Lee la advertencia en el archivo de ejemplo antes de programarlo. Un archivo semilla es una fotografía de la verdad, y un sembrador programado reafirma esa fotografía para siempre. Deja de actualizarlo y se convierte en una anti-memoria — cada corrección que tu equipo haga se sobrescribe silenciosamente al valor obsoleto en la siguiente ejecución. La regla que te mantiene a salvo: cuando corrijas un hecho, corrige el archivo semilla en el mismo commit. Enviamos esta función y luego rompimos esta regla nosotros mismos durante dos meses; la advertencia está escrita en nuestro propio tejido cicatricial.
Despliega a tu Manera
- Compartido — Un Mnemo para todos los agentes. Búsqueda entre agentes y sueño. Conciencia total del equipo.
- Aislado — Mnemo separado por agente o por cliente. Cero filtración entre inquilinos.
- Híbrido — Compartido para agentes internos + aislado para bots orientados al cliente. Esto es lo que ejecutamos.
Los servicios de memoria en la nube te obligan a elegir un almacén compartido. Mnemo te permite arquitectar para tus necesidades reales de privacidad y separación.
📚 El Bibliotecario — Descubrimiento de Documentos
"El archivo sobre X" también es un problema de memoria. El Bibliotecario es un único índice SQLite FTS5 sobre todo el espacio de trabajo — nombres de archivo, rutas y el primer fragmento de contenido (con extracción de texto PDF/DOCX) — para que un agente pueda convertir una descripción difusa en una ruta real en milisegundos. Nuestro despliegue cubre ~107K archivos; una reconstrucción completa toma ~17 segundos, la actualización incremental nocturna ~2. Los secretos (claves, archivos .env, credenciales) se excluyen del índice por completo.
El indexador se incluye en este repositorio: librarian.py — un único archivo solo de stdlib. python3 librarian.py index construye el índice en ~/.librarian/ (por defecto, los árboles visibles bajo tu directorio de inicio), librarian.py find "the spec about X" lo consulta desde el shell, y un ~/.librarian/config.json opcional establece raíces explícitas más una lista de permitidos de directorios ocultos (con una bandera de contenido-vs-solo-nombre para directorios cuya configuración pueda contener credenciales). Cron index nocturno y se mantiene fresco.
En nuestro despliegue, los agentes lo consultan a través de una pequeña herramienta MCP file_find en FrankenClaw, nuestro chasis de herramientas (retirado de la distribución pública) — pero el patrón es trivialmente reproducible: una herramienta MCP de solo lectura que abre el índice que librarian.py mantiene, registrada como una segunda entrada mcpServers junto al puente de Mnemo.
El Bibliotecario reemplazó a WikAI, nuestra capa de wiki compilada automáticamente anterior. La lección de ejecutar WikAI en producción: compilar conocimiento en páginas es caro de mantener fresco, mientras que indexar todo y encontrarlo bajo demanda es barato y nunca está obsoleto. Las páginas wiki estáticas aún existen y siguen siendo buscables a través de las herramientas wiki_search / wiki_read / wiki_index del puente, pero ya no se recompilan nocturnamente — mnemo-wiki-compile.py permanece en el repositorio como referencia. Ver Inspiraciones abajo.
💾 Cortex Stick — Sneakernet para Memoria de IA
Trabajas desde dos escritorios y ambas máquinas ejecutan Mnemo, así que se desincronizan: la decisión que guardaste en un escritorio no existe en el otro. Las soluciones habituales ponen la memoria de trabajo de tu IA en el cable de alguien más, o necesitan infraestructura que no quieres ejecutar.
El Cortex Stick es un mensajero USB entre dos instalaciones completas de Mnemo — no un servidor portátil. Nada se ejecuta en el stick; lleva el delta. Recuerdos, trayectorias, hechos, opcionalmente tu repositorio cerebral, y un pad/ de forma libre para arrastrar trabajo en curso entre escritorios. Conecta, sincroniza, lleva, conecta. Sin nube, sin VPN, sin cuenta.
mnemo-cortex stick init --encrypt /media/you/USB   # or plain, your call
mnemo-cortex stick sync                            # at each desk
mnemo-cortex stick watch --notify                  # or never touch a terminal
El cifrado es AES-256 opcional y la clave nunca vive en el stick, así que un stick perdido es un stick perdido en lugar de una brecha. Cada sincronización planifica toda la ejecución antes de que se mueva un byte — una negativa no cambia nada — y el manifiesto se escribe al final, así que un stick arrancado se niega ruidosamente en lugar de fusionar desde un estado roto. Los conflictos se preservan, nunca se destruyen. Guía completa: docs/cortex-stick.md.
📬 Disco-Bus — Mensajería Entre Agentes
Disco-Bus es el bus que ejecutamos. Una malla de agentes basada en push con confirmación de entrega: los agentes despiertan instantáneamente en mensajes entrantes (sin sondeo), y toda la conversación permanece visible para un humano. ~1000 LOC, SQLite local, sin acoplamiento con Mnemo — trae tus propios agentes, memoria opcional. Instalación de un comando (./install.sh), o entrega ./robot-install.sh a un agente de IA y deja que haga todo el trabajo.
Doctrina: el bus es el buzón. El ID de seguimiento es el recibo.
Ciclo de vida, visible de extremo a extremo:
📬 DELIVERED → ✅ PICKED UP → 🔄 LOOP CLOSED
Más alertas ⚠️ de un solo disparo para fallos de entrega y mensajes obsoletos. Sin tormentas de reintentos, sin caídas silenciosas.
Compatible con A2A. Cada mensaje se mapea a una Tarea A2A: tracking_id → task.id, subject → task.name, body → task.input, ciclo de vida → A2A TaskState, según la especificación A2A de Google. La compatibilidad de forma de datos está ahora; el transporte HTTPS / JSON-RPC es la hoja de ruta v2.
Una nota sobre el anterior. Sparks Bus, el bus anterior acoplado a Mnemo, se envió en el árbol como
sparks_bus/hasta agosto de 2026 y ahora se eliminó (código muerto, superado). Sigue disponible archivado en GuyMannDude/sparks-bus (v0.5.0, banner de reenvío) y en el historial de git de este repositorio. Disco-Bus es a donde fue: misma idea, independiente, mantenido activamente — comienza allí.
📋 mnemo-plan — Pad de Proyecto para tus Agentes
Mnemo Cortex captura memoria de conversación automáticamente. mnemo-plan es el compañero manual: una carpeta de archivos markdown en Git que escribes y curas, y cualquier agente LLM puede leer al inicio de la sesión a través de las herramientas MCP de Mnemo.
La división:
- Mnemo Cortex = memoria de conversación automática (guardar / recuperar / buscar ocurre en segundo plano mientras los agentes trabajan)
- mnemo-plan = pad de proyecto manual (tú lo escribes, los agentes lo leen — especificaciones de proyecto, tareas activas, registros de decisiones, notas de arquitectura)
El mismo puente MCP maneja ambos. Las herramientas mnemo-plan (read_brain_file, write_brain_file, list_brain_files, más opie_startup y session_end) se auto-habilitan cuando BRAIN_DIR está configurado en disco; si no hay un repositorio de plan, esas herramientas simplemente no se registran.
La plantilla de repositorio inicial: github.com/GuyMannDude/mnemo-plan. Haz un fork, completa los archivos de tu proyecto, apunta BRAIN_DIR hacia él. Tus agentes ahora tienen contexto del proyecto desde el momento en que inician una sesión, sin que tengas que reexplicar tu configuración cada vez.
🪪 Pasaporte del Desarrollador — Ingestión Segura de Afirmaciones de Comportamiento
Estado: beta. Lanzamiento dirigido a desarrolladores. Una capa de seguridad de grado de referencia para desarrolladores que construyen sistemas de agentes que necesitan ingerir afirmaciones sobre el estilo de trabajo del usuario en el contexto de un agente. Las observaciones se registran como candidatas, se revisan y se promueven a afirmaciones estables; nada llega al perfil del usuario sin un paso de promoción explícito.
Qué incluye: 5 herramientas MCP, una cola de revisión, 32 detectores de contenido (secretos, PII, inyección de prompts, relleno genérico, duplicados), 4 categorías de procedencia, una capa de políticas con resultados de disposición de 4 vías, auditoría rastreada por git y un corpus de evaluación de 200 entradas. Evaluación actual: 53.0% de precisión / 0.458 macro-F1.
Herramientas MCP: passport_get_user_context, passport_observe_behavior, passport_list_pending_observations, passport_promote_observation, passport_forget_or_override. Integración de referencia a través de stdio MCP en integrations/mcp-bridge/. Consulta passport/README.md para el inicio rápido de 5 minutos.
Diseñado para que el usuario sea dueño del artefacto, no la plataforma. El posesivo en el nombre es deliberado: desaparece cuando se lance la versión alojada / de IA en navegador para usuarios normales. El lanzamiento de hoy es para desarrolladores que conectan subprocesos MCP en sus propias pilas de agentes.
🦙 Úsalo con Cualquier LLM Local
Ejecuta cualquier LLM local. Añade Mnemo para la memoria. Sin nube, sin suscripción, sin claves API para el modelo. Gratis para siempre.
Mnemo habla el Protocolo de Contexto de Modelo (MCP), por lo que todos los hosts modernos de LLM local se conectan, de forma nativa o mediante un puente de una línea: LM Studio · Open WebUI · AnythingLLM · llama.cpp · Ollama (MCPHost/ollmcp) · LobeChat · Jan
📖 Guía completa de configuración por host → docs/local-llm-hosts.md — configuraciones de copiar y pegar, peculiaridades de cada host y lo que obtienes una vez conectado.
Para resultados de aprobación/rechazo por host, resultados de pruebas de llamada a herramientas del modelo y el resto de nuestros hallazgos de campo: projectsparks.ai/field-guide.
Monitoreo de Salud
Verificación de implementación integrada. Ningún agente se ejecuta sin memoria verificada.
mnemo-cortex health
mnemo-cortex health check
=========================

Core Services
  API server (http://localhost:50001) ..... OK (v3.3.1, 156 memories, 42ms)
  Database ................................. OK (12 sessions (3 hot, 4 warm, 5 cold))
  Compaction model ......................... OK (qwen2.5:32b-instruct — responding)

Agents (3 discovered)
  rocky .................................... OK (recall returned 5 results (234ms))
  cc ....................................... OK (recall returned 3 results (189ms))
  opie ..................................... OK (recall returned 4 results (201ms))

Watchers
  mnemo-watcher-cc ......................... OK (active, PID 4521)
  mnemo-refresh ............................ OK (active, PID 4523)

MCP Registration
  openclaw.json ............................ OK (mnemo-cortex registered)

14/14 checks passed
Opciones: --json (legible por máquina) · --quiet (solo código de salida) · --agents (solo verificaciones de agente) · --services (solo verificaciones de watcher) · --check-mcp <path> (validar configuraciones MCP)
Conéctalo a cron: 0 */6 * * * mnemo-cortex health --quiet || your-alert-command
Captura Automática
Cada conversación de agente se captura automáticamente. Sin guardados manuales, sin hooks, sin cambios de código.
Cómo Funciona
Mnemo observa los archivos de sesión de tu agente desde fuera e ingiere cada mensaje a medida que ocurre. Dos patrones de adaptador según la plataforma de tu agente:
| Plataforma | Método de Captura | Comando |
|---|---|---|
| OpenClaw | Observador de archivos de sesión (sigue JSONL) | mnemo-cortex watch --backfill |
| Claude Code | Observador de archivos de sesión (igual) | mnemo-cortex watch --backfill |
| Claude Desktop | Herramientas MCP (guardar/recordar/buscar) | Guía de configuración |
Inicio Rápido
# 1. Start Mnemo (if not already running)
mnemo-cortex start

# 2. Start auto-capture
mnemo-cortex watch --backfill
Eso es todo. Cada intercambio que tu agente tenga ahora se captura, comprime y puede buscarse.
Captura Automática Siempre Activa
Configura la variable de entorno MNEMO_AUTO_CAPTURE para iniciar el observador automáticamente cada vez que Mnemo se inicie:
# Add to your shell profile (~/.bashrc, ~/.zshrc, etc.)
export MNEMO_AUTO_CAPTURE=true
Con esto configurado, mnemo-cortex start también inicia el observador de sesiones: no se necesita un comando watch separado.
Qué Se Captura
- Cada mensaje de usuario y respuesta de agente
- Llamadas a herramientas y resultados
- Límites de sesión y marcas de tiempo
- Todo comprimido mediante compactación continua (reducción del 80% de tokens, cero pérdida de información en entidades nombradas)
Verifica Que Funciona
mnemo-cortex status
Busca:
Watcher: running (PID 4521) — auto-capturing sessions
O consulta el servidor directamente:
curl -s -X POST http://localhost:50001/context \
  -H "Content-Type: application/json" \
  -d '{"prompt": "what happened today", "agent_id": "YOUR-AGENT-ID", "max_results": 5}'
Volcado de Desarrollo
Un registro JSONL a nivel de puente de cada llamada a herramienta MCP que tus agentes realizan a través del puente Mnemo. Desactivado por defecto: cuando algo se rompe silenciosamente (una llamada a herramienta que falla sin un error lanzado, un pico de latencia inesperado, un agente que cambia de opinión), actívalo y sigue el archivo:
# In your MCP bridge env
export MNEMO_DUMP=on
# Optional — default is ~/.mnemo-cortex/dumps
export MNEMO_DUMP_DIR=~/dumps

# Inspect
mnemo-cortex dump list                  # all dump files, size + line count
mnemo-cortex dump tail rocky            # live-tail today's rocky dump
La salida es un archivo JSONL por agente por día en ~/.mnemo-cortex/dumps/<agent_id>/<YYYY-MM-DD>.jsonl. Cada línea tiene tool, el params completo, el response completo, latency_ms, ok y un campo error en fallos. Captura tanto errores lanzados reales como los retornos {isError: true} internos del manejador. Se puede buscar con grep usando jq:
jq 'select(.ok == false) | {tool, error, latency_ms}' \
  ~/.mnemo-cortex/dumps/rocky/$(date -u +%F).jsonl
Cuando MNEMO_DUMP=off (el valor predeterminado), dump.wrap() devuelve el manejador original sin cambios: sin asignación, sin sobrecarga. Con versión de esquema para adiciones futuras (Mnemo v4 Fase 1.5+).
Qué Hace
Mnemo Cortex es un coprocesador cognitivo con memoria activa para agentes de IA. Observa los archivos de sesión de tu agente desde fuera, ingiere cada mensaje en una base de datos SQLite local, comprime mensajes más antiguos en resúmenes mediante compactación respaldada por LLM y escribe un archivo MNEMO-CONTEXT.md que tu agente lee al arrancar.
Sin hooks. Sin modificaciones al agente. Sin dependencia de la nube. Mnemo mantiene tu memoria en disco: si cualquiera de los procesos se reinicia, los datos ya están ahí.
Características Clave
- Almacenamiento SQLite + FTS5 — Un solo archivo de base de datos. Búsqueda de texto completo. Cero dependencias más allá de la biblioteca estándar de Python.
- Frontera de contexto con compactación activa — Ventana continua de mensajes + resúmenes. Compresión del 80% de tokens mientras se preserva el recuerdo perfecto.
- Linaje de resúmenes basado en DAG — Cada resumen rastrea sus mensajes fuente mediante un grafo acíclico dirigido. Expande cualquier resumen de vuelta a la fuente verbatim.
- Modo de reproducción verbatim — Comprimido por defecto, mensajes originales bajo demanda.
- Demonio observador de sesiones de OpenClaw — Sigue archivos de sesión JSONL e ingiere nuevos mensajes cada 2 segundos.
- Demonio de actualización de contexto — Escribe
MNEMO-CONTEXT.mden el espacio de trabajo del agente cada 5 segundos. - Resumición respaldada por proveedor — Resúmenes de compactación generados por Ollama local (qwen2.5:32b-instruct) a $0. Cualquier proveedor de LLM compatible como respaldo.
- Diseño sidecar — Resistente a versiones. Observa desde fuera. Nunca toca los internos del agente.
Probado en Producción
Mnemo Cortex ha sido la memoria de producción en vivo de una flota de cinco agentes desde marzo de 2026. Conteos reales del servidor en ejecución (julio de 2026):
| Agente | Rol / host | Memorias |
|---|---|---|
| CC | Constructor (Claude Code) | 8,700+ |
| Opie | Arquitecto (Claude Desktop) | 660+ |
| Dreamer | Síntesis nocturna entre agentes | 160+ |
| Rocky | Conductor diario (Hermes) | 150+ |
| Cody | Codificador (Codex CLI) | 80+ |
Más un almacén compartido de ~7,000 hechos verificados con escalera de confianza y un historial de auditoría completo. Verificado en implementaciones de agente único y multiagente: búsqueda entre agentes, sueño nocturno entre agentes y sincronización por mensajero USB entre dos máquinas.
Guía de Instalación
Cinco pasos desde un checkout nuevo hasta un servidor en ejecución conectado a tu agente. La CLI maneja todo: mnemo-cortex init escribe la configuración, mnemo-cortex start lanza el servidor API, mnemo-cortex health verifica, y apuntas tu agente hacia él mediante la integración correspondiente.
Plataformas
Mnemo Cortex se ejecuta en Linux, macOS y Windows. El núcleo (Python + SQLite) es multiplataforma. A partir de v4.4.1, el servidor se ejecuta nativamente en Windows: su bloqueo de archivos es multiplataforma (POSIX fcntl con un respaldo msvcrt), por lo que agentb.server inicia y sirve el recuerdo en Python nativo de Windows sin necesidad de WSL. Las diferencias de plataforma se refieren principalmente a cómo mantienes el servidor en ejecución entre reinicios:
| Linux | macOS | Windows | |
|---|---|---|---|
| Ciclo de vida del servidor | systemd / manual | launchd / manual | Programador de tareas / manual |
| Claude Code | Soporte completo | Soporte completo | Soporte completo |
| Claude Desktop | Paquete .mcpb | Paquete .mcpb | Paquete .mcpb |
| OpenClaw | Soporte completo | Soporte completo | Soporte completo |
🍎 ¿Tienes una Mac? Sigue la guía de instalación dedicada para macOS — cubre el único detalle que importa (qué Python puede cargar extensiones SQLite), la configuración de Homebrew y una plantilla launchd para iniciar al iniciar sesión. El soporte para macOS está en beta: se buscan probadores.
Requisitos Previos
- Python 3.11+ — para el servidor
- Ollama (recomendado) — modelos locales de razonamiento y embeddings, gratis, totalmente privado. El asistente
inittambién acepta claves API de OpenAI / Google / Anthropic / OpenRouter si prefieres usar un modelo en la nube. - Node.js 18+ (solo cuando se ejecuta una integración de puente MCP: Claude Desktop, LM Studio, OpenClaw, etc.)
Paso 1: Instalar
git clone https://github.com/GuyMannDude/mnemo-cortex.git
cd mnemo-cortex
python -m venv .venv
source .venv/bin/activate          # Windows: .venv\Scripts\activate
pip install -e .
Esto registra dos comandos CLI: mnemo-cortex y el alias más corto mnemo.
Instalación no interactiva (para agentes LLM y CI)
Omite el asistente: completa un manifiesto JSON y ejecuta el instalador robótico.
# Defaults are sensible; only edit robot.install if you want to change them
./robot-install.sh
El script emite un único objeto JSON en stdout para que el llamador lo analice; todo el progreso legible por humanos va a stderr.
{
  "ok": true,
  "steps": {
    "deps":       {"ok": true, "python": "3.12", "reasoning_key_present": true},
    "venv":       {"ok": true, "path": "..."},
    "pip":        {"ok": true},
    "config":     {"ok": true, "config_path": "...", "env_path": "...", "data_dir": "..."},
    "systemd":    {"ok": true, "service": "mnemo-cortex", "port": 50001},
    "smoke_test": {"ok": true, "health": "ok", "memory_id": "...", "recall_hits": 1}
  }
}
En caso de fallo, ok es false, el código de salida es 1 y error describe qué paso falló.
El manifiesto cubre el puerto y la dirección de enlace del servicio, el proveedor de razonamiento y embeddings, los umbrales de procedencia/decadencia v3, el nombre de la unidad systemd y una prueba de humo que ejercita /health más un ciclo de guardar → recordar. Las claves API se leen del entorno en el momento de la instalación (nombradas en el manifiesto mediante api_key_env), se copian en un archivo de entorno con permisos 0600 junto a la configuración y las carga la unidad systemd.
Pruebas en sandbox — anula las rutas mediante env para poder hacer una prueba en seco sin tocar el estado real:
MNEMO_INSTALL_VENV_DIR=/tmp/test-venv \
MNEMO_INSTALL_CONFIG_DIR=/tmp/test-config \
MNEMO_INSTALL_SYSTEMD_DIR=/tmp/test-systemd \
MNEMO_INSTALL_DRY_RUN=1 \
./robot-install.sh
DRY_RUN=1 ejecuta la verificación de dependencias e informa las rutas que cada paso escribiría, pero omite todos los efectos secundarios: sin venv, sin pip install, sin archivo de configuración o entorno escrito, sin unidad systemd, sin prueba de humo. Las claves API en el entorno nunca se persisten en disco en la prueba en seco.
Nota sobre el alcance:
robot.installconfigura el servidor de Mnemo Cortex. Para usar Mnemo desde un agente (Hermes, Claude Desktop, AnythingLM, LM Studio, Ollama Desktop, Agent-Zero, OpenClaw, Claude Code), ejecuta el instalador de integración específico del agente después: consultaintegrations/para cada guía. Conectan la configuración MCP del agente para apuntar al servidor que acabas de instalar.
Paso 2: Inicializar
mnemo-cortex init
Asistente interactivo. Elige tu modelo de razonamiento (verificaciones previas), modelo de embeddings (búsqueda semántica), dirección de enlace del servidor, puerto y cualquier agente que quieras registrar de antemano. Los valores predeterminados son sensatos para una instalación local de una sola máquina: Ollama para ambos modelos, 127.0.0.1:50001, sin token de autenticación (solo loopback).
El asistente escribe la configuración en ~/.agentb/agentb.yaml y crea el directorio de datos en ~/.agentb/data/.
Paso 3: Iniciar el servidor
mnemo-cortex start                 # detached (logs go to ~/.agentb/data/logs/)
mnemo-cortex start --foreground    # attached, logs to terminal
El servidor escucha en http://localhost:50001 por defecto. Para detenerlo:
mnemo-cortex stop
Paso 4: Verificar
Verificación de salud rápida:
mnemo-cortex health
Diagnósticos más profundos: conflictos de puerto, disponibilidad de modelos, recuerdo del agente, estado del observador:
mnemo-cortex doctor
Ambos devuelven códigos de salida distintos de cero cuando algo está roto, por lo que funcionan en scripts y CI.
Paso 5: Conectar una integración
El servidor ya está en ejecución. Elige tu plataforma y sigue su guía de integración:
| Host | Ruta |
|---|---|
| Claude Code | integrations/claude-code/ — agente de terminal, servicio de sincronización |
| Claude Desktop | integrations/claude-desktop/ — paquete .mcpb de arrastrar y soltar |
| LM Studio | integrations/lmstudio/ — MCP nativo, GUI |
| AnythingLLM | integrations/anythingllm/ — escritorio, multi-espacio de trabajo |
| OpenClaw | integrations/mcp-bridge/ — configuración MCP de una línea |
| Agent Zero | integrations/agent-zero/ — configuración Docker en contenedor |
| Ollama Desktop | integrations/ollama-desktop/ — flujo ollama launch |
Cada integración es una configuración MCP de una línea o un paquete de arrastrar y soltar. El servidor es el mismo; solo cambia la configuración del puente.
Para otros hosts compatibles con MCP (Open WebUI, llama.cpp, LobeChat, Jan, clientes MCP genéricos), consulta Uso con cualquier LLM local arriba.
Paso 6: (Recomendado) Configurar un repositorio de cerebro
Mnemo le da a tu agente memoria persistente. Un repositorio de cerebro le da estado actual persistente — el bloc de notas del proyecto que tu agente lee al inicio de la sesión para saber qué está en curso sin releer cada memoria.
Haz un fork de la plantilla mnemo-plan y apunta la variable de entorno BRAIN_DIR de tu puente hacia ella:
# In your MCP config or systemd unit:
BRAIN_DIR=/absolute/path/to/your/mnemo-plan
El puente habilita automáticamente las herramientas de archivos cerebrales (read_brain_file, write_brain_file, list_brain_files) cuando BRAIN_DIR existe. Si no existe, esas herramientas simplemente no se registran — sin fricción de instalación.
Para la práctica operativa — cuándo leer qué, cuándo escribir qué, el ritual de sesión de seis pasos — consulta THE-LANE-PROTOCOL.md.
Solución de problemas
La recuperación / búsqueda entre agentes devuelve "No chunks"
La causa más común: tu configuración del modelo de embeddings no coincide con el nombre actual del modelo de tu proveedor. Los nombres de los modelos cambian — consulta la documentación de tu proveedor:
| Proveedor | Modelo de embeddings actual | Obsoleto / Muerto |
|---|---|---|
| Ollama (local) | nomic-embed-text | — |
| OpenAI | text-embedding-3-small | text-embedding-ada-002 |
gemini-embedding-001 | text-embedding-004 (cerrado en enero de 2026) |
Si recientemente cambiaste de proveedor o actualizaste tu configuración, verifica que el nombre del modelo sea correcto y que tu clave API tenga acceso al endpoint de embeddings.
La verificación de salud falla en "Modelo de compactación"
El modelo de compactación (predeterminado: qwen2.5:32b-instruct vía Ollama) debe estar en ejecución y ser accesible. Verifica:
curl http://localhost:11434/v1/models # List loaded Ollama models
Si estás usando una instancia remota de Ollama, configura MNEMO_SUMMARY_URL para apuntar hacia ella.
Servidor inaccesible
Si mnemo-cortex health no puede alcanzar la API, verifica:
curl http://localhost:50001/health # Or your MNEMO_URL
Causas comunes: puerto incorrecto, firewall bloqueando, servidor no iniciado. En configuraciones de múltiples máquinas, asegúrate de que el firewall del host de destino permita el puerto (por ejemplo, ufw allow from 10.0.0.0/24 to any port 50001).
Verificar instalación
Después de la configuración, ejecuta el conjunto de pruebas:
cd /path/to/mnemo-cortex
source .venv/bin/activate
pytest tests/test_agentb.py -v
Si las pruebas fallan, verifica que todas las dependencias de Python estén instaladas (pip install -e .).
Mnemo Cortex vs OpenClaw Active Memory
OpenClaw 2026.4.10 incluyó un plugin nativo de Active Memory. Algunas personas han preguntado si reemplaza a Mnemo Cortex. Respuesta corta: no — resuelven problemas diferentes. Aquí está la diferencia, basada en pruebas lado a lado en un agente sandbox.
| Active Memory (nativo) | Mnemo Cortex (MCP) | |
|---|---|---|
| Alcance | Agente único | Entre agentes (bus multi-agente) |
| Almacenamiento | Archivos locales del espacio de trabajo + FTS | SQLite centralizado + embeddings |
| Persistencia | Por agente, por espacio de trabajo | Sobrevive a reinicios, sesiones, cambios de máquina |
| Entre sesiones | Dentro del espacio de trabajo de un agente | Cualquier agente, cualquier máquina |
| Integración | Almacenamiento independiente | Almacenamiento independiente |
Cuándo usar cada uno
- Active Memory de OpenClaw: Intra-sesión, mismo agente, recuperación local rápida. El bloc de notas personal de tu agente.
- Mnemo Cortex: Bus de memoria entre agentes. Cuando el Agente A necesita saber lo que el Agente B aprendió. Cuando la memoria debe sobrevivir a reinicios de sesión, cambios de máquina o reinicios de agentes.
Ejecutamos ambos. Active Memory de OpenClaw maneja el contexto reciente por agente. Mnemo maneja todo lo que cruza agentes o necesita archivo duradero. Se complementan; no compiten.
Historia de origen
Mnemo Cortex comenzó como un sistema de memoria y evolucionó hasta convertirse en un coprocesador cognitivo, diseñado por un pequeño equipo multi-agente: un operador no desarrollador y varios agentes Claude/OpenClaw que trabajaron como arquitecto, constructor y sujetos de prueba en vivo. La historia completa — cómo se diseñó la arquitectura, por qué los agentes programan bien en pareja con humanos y qué falló en el camino — está en Finding Mnemo.
Créditos
Equipo del proyecto:
- Guy Hutchins — Líder del proyecto, pruebas, socio de diseño
- Opie (Claude Opus 4.6 / 4.7) — Diseño de arquitectura, diseño de esquema, estrategia de compactación
- AL (ChatGPT) — Implementación, demonios de vigilancia/actualización, conjunto de pruebas
- CC (Claude Code) — Despliegue, integración, pruebas en vivo, corrección de errores; construyó el Librarian, el compilador WikAI que reemplazó, y la integración Sparks Bus
- Claude Fable 5 — la revisión y mejora v4.1: clasificación de recuperación compuesta, el Analyst, redacción de secretos en la ingesta, higiene de niveles (construido durante la breve disponibilidad de Fable 5)
- Rocky y Alice (agentes OpenClaw) — primeros usuarios de producción + sujetos de prueba
Inspiraciones externas (el Método Clapton — adoptar las mejores ideas, dar crédito abiertamente, construir sobre ellas):
- Andrej Karpathy — Patrón LLM Wiki, abril de 2026. Inspiró el diseño de compilar-no-re-derivar de WikAI y el patrón de "archivo de idea como formato de publicación" utilizado en
SETUP-PROMPT.md. La observación anterior de Karpathy (entrevista con Dwarkesh Patel, octubre de 2025) de que los LLM carecen de una fase de sueño/consolidación — los humanos consolidan el día en memoria a largo plazo mientras duermen, los LLM simplemente lo pierden — es la idea raíz detrás de Mnemo Dreaming, que llegó a través del núcleo de memoria/dreamingde OpenClaw (acreditado abajo). Nuestro giro: la flota sueña junta — síntesis nocturna entre agentes en un único informe compartido, no auto-consolidación de un solo agente. - OpenClaw
/dreaming— docs.openclaw.ai/concepts/dreaming. La primera implementación de dreaming que ejecutamos en producción (en nuestros agentes OpenClaw, abril de 2026); sus etapas de consolidación inspiradas en el sueño precedieron directamente amnemo-dream.py. - Nate B Jones — OpenBrain + "Your AI Does the Hard Work Then Deletes It" (YouTube) + Substack. Inspiró nuestra arquitectura de memoria de tres capas (almacenamiento estructurado + wiki compilada + archivos cerebrales efímeros).
- Protocolo A2A de Google — github.com/google/A2A. Disco-Bus habla formas de datos A2A; el transporte es la hoja de ruta v2.
- Mem0 — mem0.ai. Los primeros en hacer que la memoria portátil de IA se sintiera real; inspiró nuestro pensamiento temprano sobre persistencia entre sesiones. (El puente opcional de nube profunda Mem0 se retiró en v3.1.0 — el rendimiento de recuperación local hizo innecesario el respaldo.)
- Lossless Claw de Martian Engineering — exploración temprana de registro de conversaciones sin pérdida que informó el patrón de captura v1.
Construido para Project Sparks.
Funciona muy bien con
- ClaudePilot OpenClaw — guía de configuración gratuita asistida por IA. Pon en marcha un agente OpenClaw con memoria en una tarde.
Política de privacidad
Mnemo Cortex es autoalojado y local-primero: sin telemetría, sin análisis, sin servicios de terceros. Tus datos de memoria viven en una base de datos SQLite en infraestructura que controlas, y puedes leerlos o eliminarlos en cualquier momento. Política completa: PRIVACY.md.
Licencia
MIT