PostgreSQL MCP
Transforma bases de datos PostgreSQL de "tengo tablas y no sé qué hacen" a "entiendo toda la estructura de la base de datos, las relaciones y las mejores prácticas
Documentación
Servidor PostgreSQL MCP
Transforma bases de datos PostgreSQL de "tengo tablas y no sé qué hacen" a "entiendo toda la estructura de la base de datos, las relaciones y las mejores prácticas"
Descripción general
Este es un servidor MCP (Model Context Protocol) que proporciona análisis inteligente, documentación y operaciones CRUD completas para bases de datos PostgreSQL. Combina extracción de esquema determinista con razonamiento impulsado por IA y operaciones seguras de manipulación de datos para ayudar a usuarios y agentes de IA a comprender e interactuar con estructuras de bases de datos complejas.
Optimizado y Extendido en Rendimiento: Comenzó con 38 herramientas, se optimizó a 19 herramientas (~50% de reducción), y luego se extendió estratégicamente a 27 herramientas con optimización de consultas de alto valor, gestión de datos, transacciones y capacidades de monitoreo.
Características clave
- Cobertura integral: 27 herramientas cuidadosamente diseñadas que cubren todas las operaciones de PostgreSQL
- Extracción de esquema: Extrae automáticamente tablas, columnas, relaciones y restricciones
- Análisis inteligente: Detecta tablas de unión, relaciones implícitas y sugiere uniones óptimas
- Información impulsada por IA: Aprovecha Ollama/LLM para generar explicaciones comerciales y recomendaciones
- Operaciones CRUD completas: Herramientas unificadas para toda la manipulación de datos con prevención de inyección SQL
- Optimización de consultas: Análisis de plan de ejecución, análisis de índices combinados (sugerencia + detección de no utilizados)
- Gestión de datos: Importación/exportación (CSV/JSON/SQL), búsqueda de texto completo
- Soporte de transacciones: Transacciones atómicas de múltiples operaciones con reversión
- Monitoreo: Estadísticas de base de datos, métricas de caché, consultas lentas, seguimiento de conexiones
- Múltiples formatos de salida:
- Diagramas ER PlantUML (con renderizado SVG)
- Diagramas de clases PlantUML (con renderizado SVG)
- Diagramas de componentes PlantUML (con renderizado SVG)
- Documentación integral en Markdown
- Archivos de diagramas visuales (SVG, PNG, PDF)
- Asistencia de consultas: Recomendaciones inteligentes de tipo de unión (INNER vs LEFT)
- Arquitectura modular: Diseño limpio y extensible organizado por capacidad
- Renderizado de diagramas: Genera automáticamente diagramas visuales de estructura de base de datos
- Seguridad: Consultas parametrizadas, validación de entrada, prevención de inyección SQL
Primeros pasos
Requisitos previos
- Python 3.11+
- Base de datos PostgreSQL
- Servidor Ollama (opcional, para explicaciones de IA)
uvgestor de paquetes
Instalación
-
Clonar repositorio e instalar dependencias:
cd PostgreSQL-MCP uv sync -
Configurar variables de entorno (crear
.env):# PostgreSQL DB_HOST=localhost DB_PORT=5432 DB_NAME=your_database DB_USER=postgres DB_PASSWORD=your_password # Ollama/LLM OLLAMA_BASE_URL=http://192.168.1.143:11434 OLLAMA_MODEL=deepseek-r1:14b # App DEBUG=False
Ejecutar el servidor
# Start MCP server
uv run postgresql_server.py
Herramientas MCP disponibles (27 en total)
Categoría 1: Herramientas de análisis y esquema (5 herramientas)
1. analyze_database()
Análisis integral de esquema sin LLM.
- Estructura completa del esquema (tablas, columnas, claves, tipos de datos)
- Tablas de unión detectadas
- Relaciones implícitas descubiertas
- Sugerencias de unión (INNER vs LEFT)
- Diagrama ER PlantUML
- Diagrama de clases PlantUML
- Diagrama de componentes PlantUML
- Documentación integral en Markdown
2. explain_database()
Análisis de base de datos impulsado por IA usando Ollama LLM.
- Explicación comercial del propósito de la base de datos
- Relaciones detectadas y recomendaciones de unión
- ERD PlantUML mejorado con información de IA
- Recomendaciones de calidad de base de datos
3. get_table_details(table_name: str)
Análisis detallado de una tabla específica.
- Estructura de tabla y relaciones
- Información de columnas y restricciones
- Documentación en Markdown específica de la tabla
4. get_database_info(info_type: str = "tables")
NUEVO: Herramienta unificada de recuperación de información - Consolida list_tables, check_ollama_status
info_type="tables": Listar todas las tablas con recuentoinfo_type="ollama": Verificar estado del servicio Ollama/LLM y modelos disponiblesinfo_type="summary": Estadísticas rápidas de la base de datos
5. render_database_diagrams(output_format: str = "svg")
Generar diagramas visuales de estructura de base de datos.
- Diagrama ER (erd_svg.svg)
- Diagrama de clases (class_svg.svg)
- Diagrama de componentes (component_svg.svg)
- Archivos SVG/PNG/PDF en el directorio
diagrams/
Categoría 2: Operaciones CRUD de creación (4 herramientas)
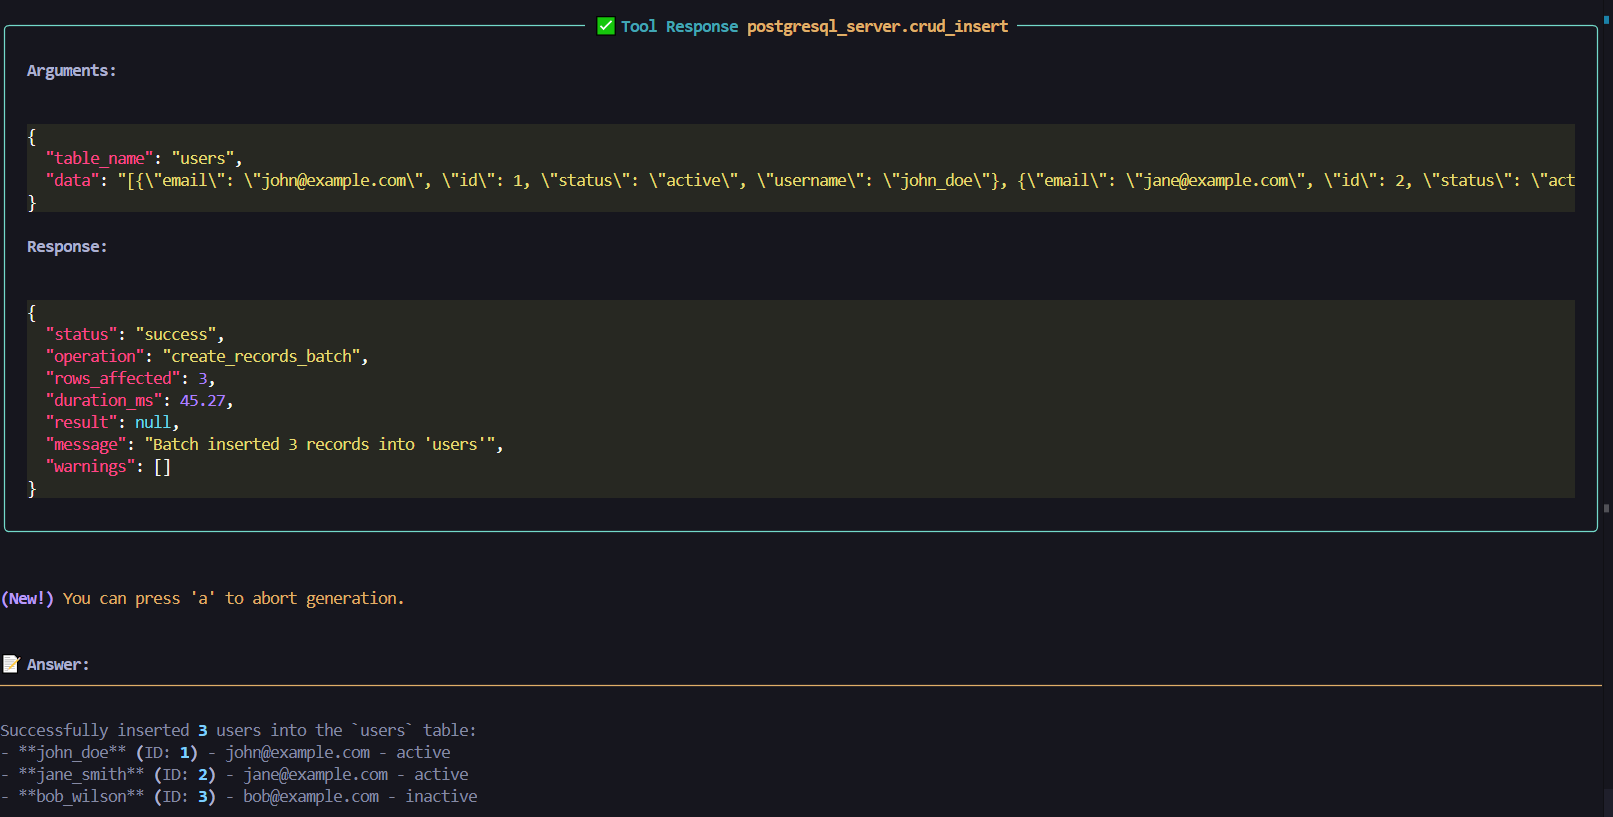
6. crud_insert(table_name: str, data: Dict | List[Dict])
NUEVO: Inserción inteligente - Consolida inserciones individuales y por lotes
- Inserción individual: Pasar Dict →
{"name": "John", "age": 30} - Inserción por lotes: Pasar List[Dict] →
[{"name": "John"}, {"name": "Jane"}] - Detección automática de modo individual vs por lotes
- Consultas parametrizadas para prevención de inyección SQL
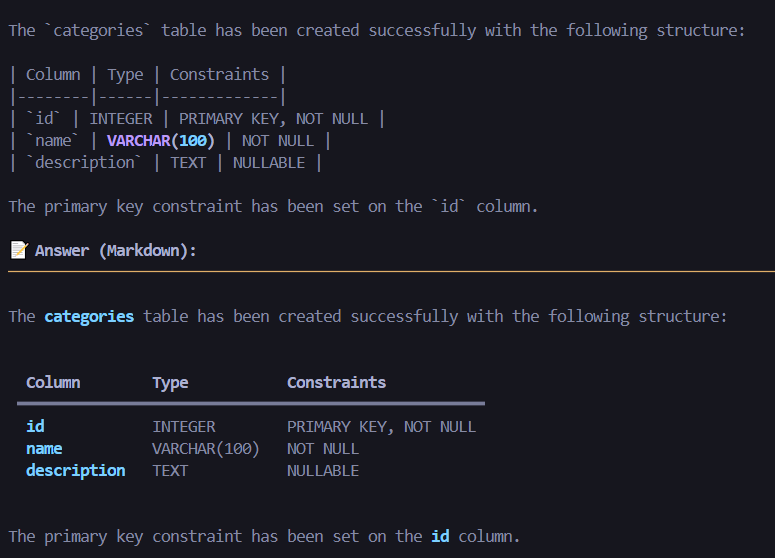
7. crud_create_table(table_name, columns, primary_key)
Crear una nueva tabla con columnas y restricciones.
- Definir columnas con tipos:
{"name": "id", "type": "INTEGER", "nullable": False} - Especificación opcional de clave primaria
- Soporte completo de restricciones
8. crud_create_view(view_name, select_query, replace_if_exists)
Crear vistas de base de datos a partir de consultas SELECT.
- Definir tablas virtuales
- Reemplazo opcional de vistas
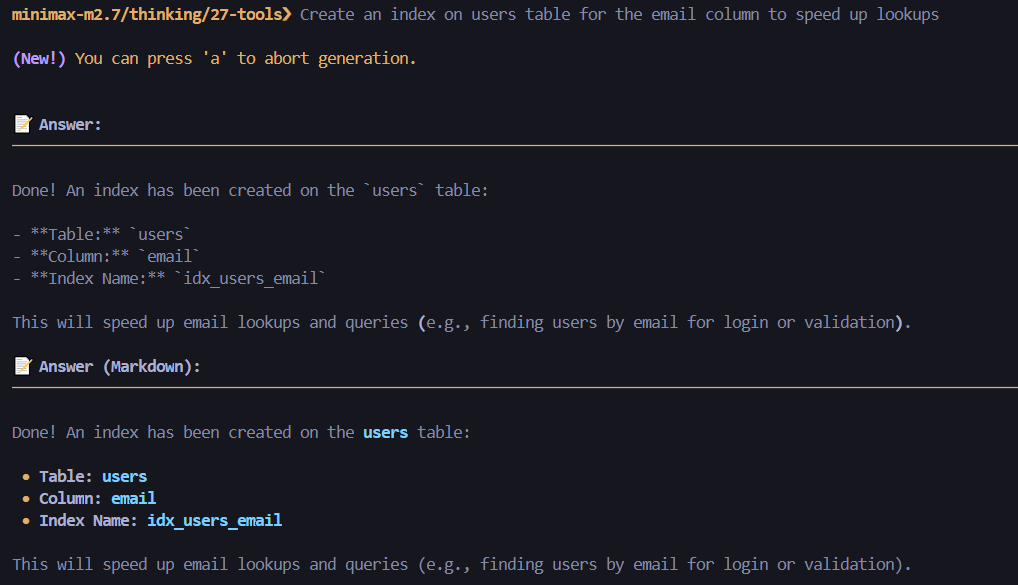
9. crud_create_index(index_name, table_name, columns, unique)
Crear índices simples o compuestos.
- Columna única:
columns=["email"] - Compuesto:
columns=["last_name", "first_name"] - Restricción UNIQUE opcional
Categoría 3: Operaciones CRUD de lectura (2 herramientas)
10. crud_query(query, params, limit, offset)
NUEVO: Ejecución de consultas SQL sin procesar - Para consultas complejas con JOINs y agregaciones
- Ejecutar cualquier sentencia SELECT
- Valores parametrizados: Usar marcadores de posición
%s - Soporte de paginación con límite/desplazamiento
- Ejemplo:
query="SELECT * FROM users WHERE age > %s", params=[30]
11. crud_get(table_name, mode, where_clause, where_params, options)
NUEVO: Lectura unificada de alto nivel - Consolida 4 operaciones de lectura
mode="records": Obtener registros filtrados (reemplaza crud_get_records)mode="count": Contar registros (reemplaza crud_get_record_count)mode="distinct": Obtener valores distintos (reemplaza crud_distinct_values)mode="paginate": Resultados paginados con metadatos (reemplaza crud_paginate_data)- Soporte completo de cláusula WHERE, ordenamiento y filtros
Categoría 4: Operaciones CRUD de actualización (2 herramientas)
12. crud_update(table_name, values, where_clause, where_params, id_column, record_id)
NUEVO: Actualización unificada - Consolida actualizaciones individuales, por lotes y de columnas
- Registro individual: Proporcionar
record_id+id_column - Actualización por lotes: Proporcionar
where_clause+where_params - Actualización de columna: Clave-valor único en el dict
values - Consultas parametrizadas para seguridad
13. crud_rename(object_type, old_name, new_name, table_name)
NUEVO: Renombrar cualquier cosa - Consolida el renombrado de tablas y columnas
object_type="table": Renombrar tablaobject_type="column": Renombrar columna (requieretable_name)- Renombrado seguro con validación
Categoría 5: Operaciones CRUD de eliminación (1 herramienta)
14. crud_delete(table_name, mode, where_clause, where_params, id_column, record_id, cascade)
NUEVO: Eliminación unificada - Consolida 4 operaciones de eliminación
mode="records": Eliminar registros específicos (individual o por lotes)- Individual: Proporcionar
record_id+id_column - Por lotes: Proporcionar
where_clause+where_params
- Individual: Proporcionar
mode="truncate": Borrar todos los datos (rápido, restablece secuencias)mode="drop": Eliminar tabla completa (ADVERTENCIA: destruye la estructura)cascadeopcional para objetos dependientes
Categoría 6: Modificación de esquema (5 herramientas)
15. mod_column(table_name, action, column_name, column_spec, cascade)
NUEVO: Gestión unificada de columnas - Consolida 4 operaciones de columnas
action="add": Agregar nueva columna →column_spec={"name": "status", "type": "VARCHAR(50)"}action="modify_type": Cambiar tipo de datos →column_spec={"new_type": "TEXT"}action="drop": Eliminar columnaaction="set_nullable": Alternar restricción NULL →column_spec={"is_nullable": True}
16. mod_index(action, index_name, table_name, cascade)
NUEVO: Gestión de índices - Consolida operaciones de listado y eliminación
action="list": Listar todos los índices (opcionalmente filtrados por tabla)action="drop": Eliminar índice con cascada opcional
17. mod_constraint(action, table_name, constraint_name, cascade)
NUEVO: Gestión de restricciones - Consolida operaciones de listado y eliminación
action="list": Listar todas las restricciones (PK, FK, únicas, check)action="drop": Eliminar restricción con cascada opcional
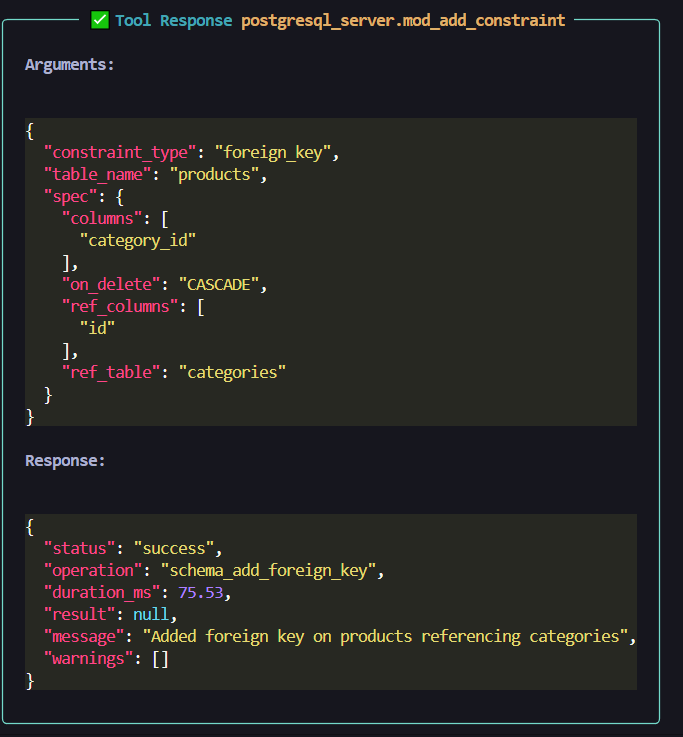
18. mod_add_constraint(constraint_type, table_name, spec)
NUEVO: Agregar restricciones - Consolida la adición de claves primarias y foráneas
constraint_type="primary_key"+spec={"columns": ["id"]}constraint_type="foreign_key"+spec={"columns": ["user_id"], "ref_table": "users", "ref_columns": ["id"], "on_delete": "CASCADE"}
19. mod_view(action, view_name, cascade)
NUEVO: Gestión de vistas - Consolida 3 operaciones de vistas
action="list": Listar todas las vistasaction="get": Obtener definición SQL de la vistaaction="drop": Eliminar vista con cascada opcional
Categoría 7: Herramientas extendidas de Fase 3-6 (8 herramientas)
20. query_explain(query, analyze, format)
Obtener salida de EXPLAIN / EXPLAIN ANALYZE para cualquier consulta SQL.
analyze=False: Mostrar solo el plan estimadoanalyze=True: Ejecutar consulta y mostrar recuentos de filas y tiempos realesformat:"text"(predeterminado) o"json"
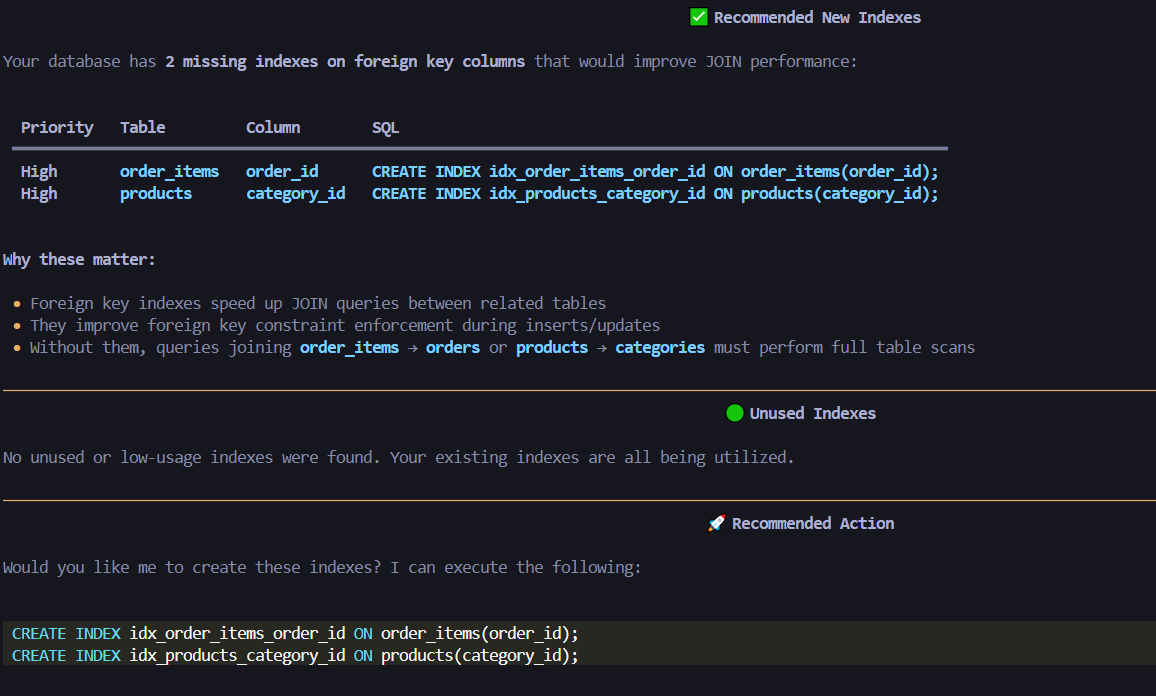
21. query_analyze_indexes(mode, table_name, min_size_mb)
Análisis combinado de índices: sugerir índices faltantes o detectar no utilizados.
mode="suggest": Recomendar índices para columnas FK y tablas grandes (opcionalmente limitado atable_name)mode="unused": Encontrar índices con recuentos de escaneo cero/bajos por encima demin_size_mbmode="all": Ejecutar ambos análisis y devolver un informe combinado
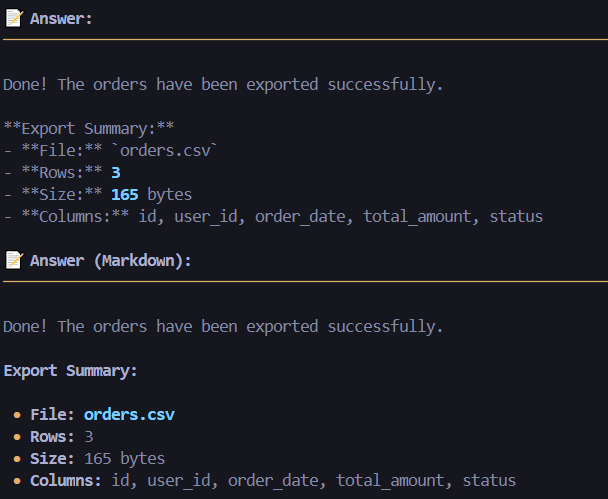
22. data_export(table_name, format, where_clause, where_params, columns, limit)
Exportar datos de tabla a formato CSV, JSON o SQL INSERT.
- Soporta selección de columnas, filtrado WHERE y límites de filas
- La salida JSON incluye metadatos de esquema
23. data_import(table_name, data, format, column_mapping, conflict_action)
Importar datos desde CSV o JSON a una tabla.
conflict_action:"error"|"ignore"|"update"column_mapping: Renombrar campos entrantes para que coincidan con las columnas de la tabla
24. data_search(table_name, search_term, columns, search_type, limit)
Búsqueda de texto completo en columnas especificadas.
search_type:"ilike"(insensible a mayúsculas),"like"(sensible a mayúsculas),"fuzzy"(similitud)- Busca en todas las columnas de texto cuando se omite
columns
25. transaction_execute(operations, rollback_on_error)
Ejecutar múltiples operaciones SQL atómicamente en una sola transacción.
- Cada operación:
{"sql": "...", "params": [...]} - Reversión automática ante cualquier fallo cuando
rollback_on_error=True
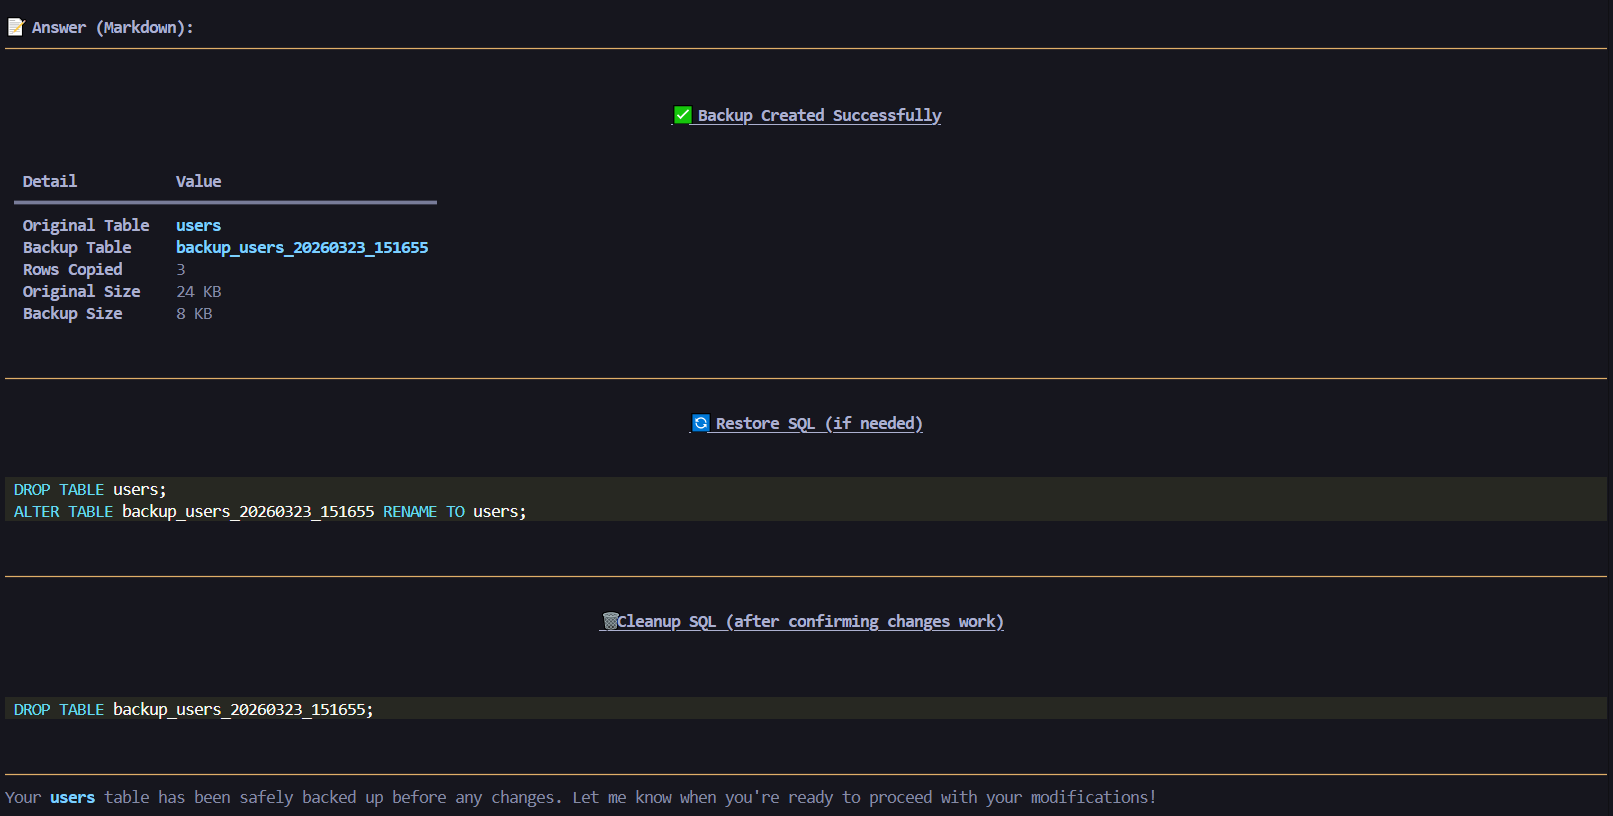
26. transaction_backup_table(table_name, backup_name, include_indexes)
Crear una copia de seguridad instantánea de una tabla.
- Copia datos y opcionalmente recrea índices en la copia de seguridad
- Devuelve SQL de restauración para recuperar o comparar con el original
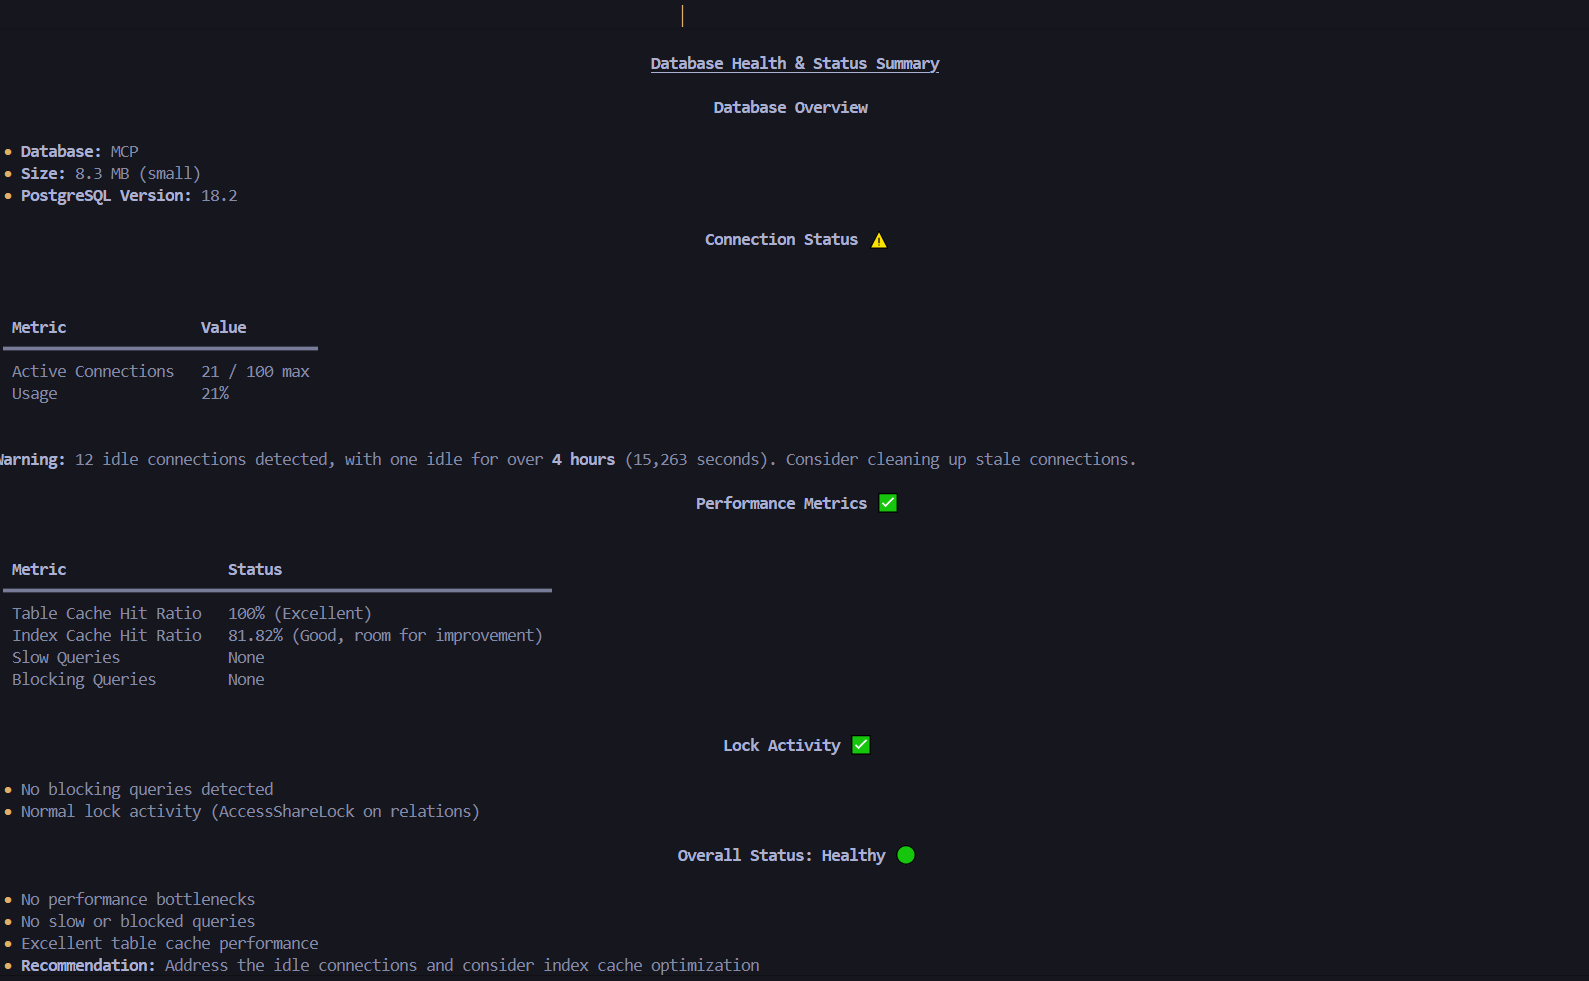
27. monitoring_database_stats(stat_type)
Monitoreo integral de salud y rendimiento de la base de datos.
stat_type:"summary"|"size"|"connections"|"cache_hit_ratio"|"slow_queries"|"locks"|"all"
Use el cliente OLLMCP para pruebas locales con proveedores de ollama
Características de seguridad (todas las operaciones):
- Consultas parametrizadas (previene inyección SQL)
- Validación de entrada (validación de nombres de tablas/columnas)
- Verificación de restricciones (valida tipos de datos y restricciones)
- Formato de respuesta estandarizado con estado y duración
VIDEO DE ANÁLISIS CRUD Y ESQUEMA

Consulte AGENT_TESTING_SUITE.md para el flujo de pruebas completo
Aquí hay imágenes de algunas herramientas en acción:
Descripción general de la base de datos
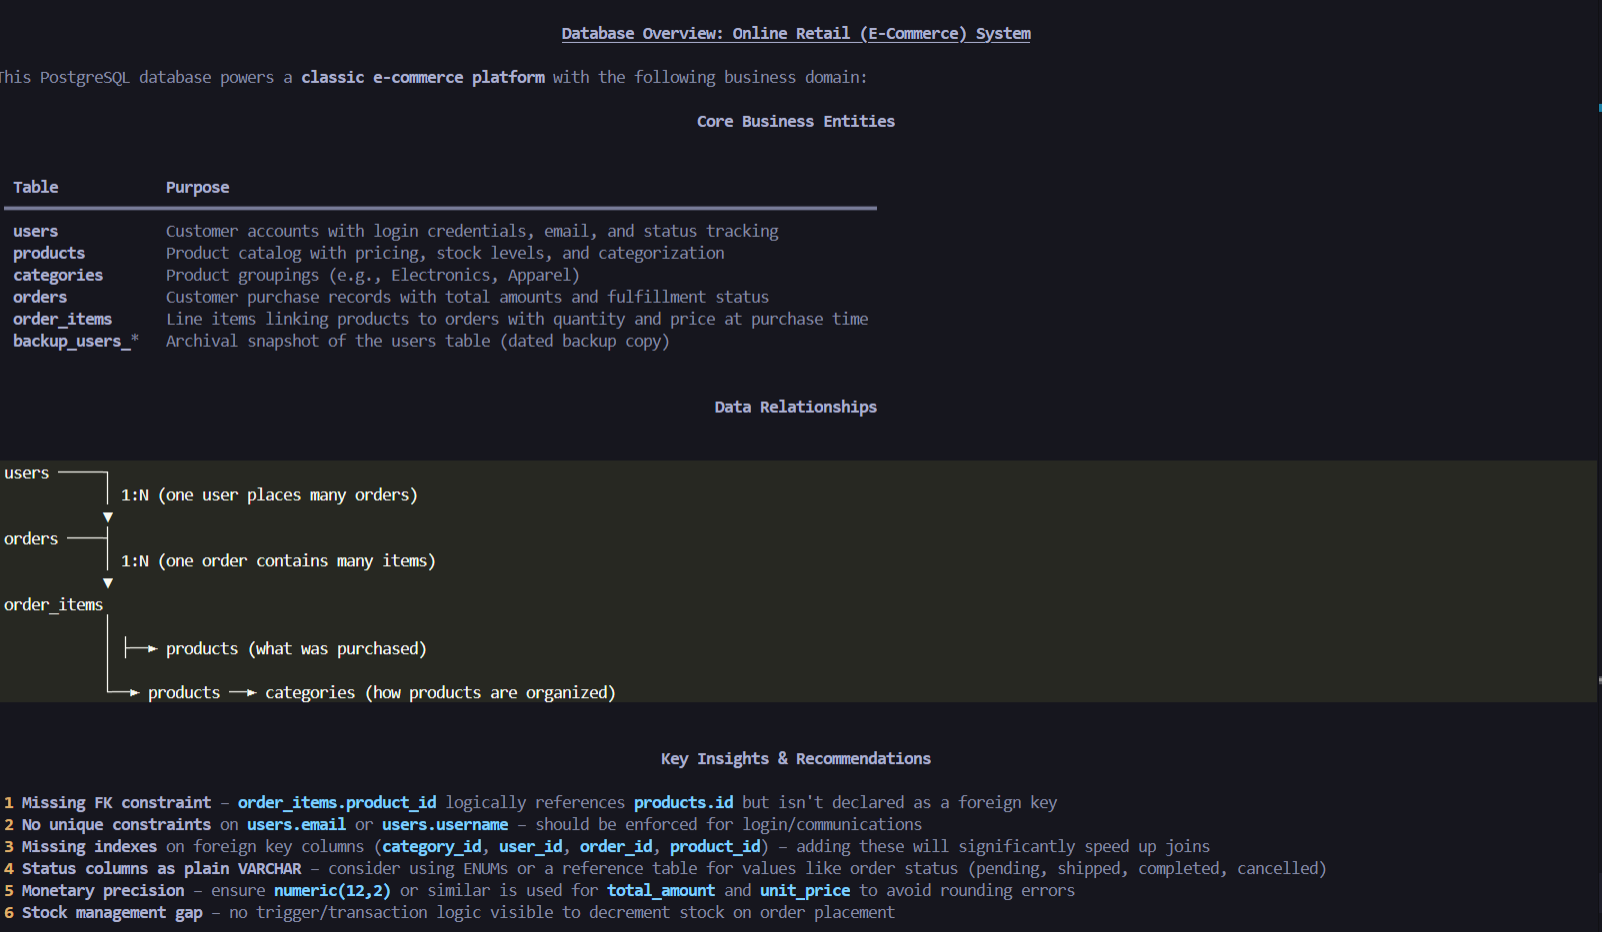
Tabla de copia de seguridad
Exportar datos a CSV/JSON/SQL
Herramienta de clave foránea
Sugerir nuevos índices
Monitoreo de base de datos
Crear nuevo índice
Operaciones CRUD
Consulte la carpeta diagrams/ para ver los diagramas ERD generados
🤝 Contribuciones
Este proyecto es de código abierto. Las contribuciones son bienvenidas.