searxNcrawl
Búsqueda web a través de tu propia instancia de SearXNG y/o You.com, además de rastreo de páginas y sitios para obtener Markdown limpio y sin duplicados con Crawl4AI y Playwright, incluyendo páginas detrás de un inicio de sesión. Se ejecuta localmente (uvx searxncrawl), con licencia MIT.
Documentación


Sitio web · Inicio rápido · Documentación · Desarrolladores · Cloud (planificado) · Registro de cambios
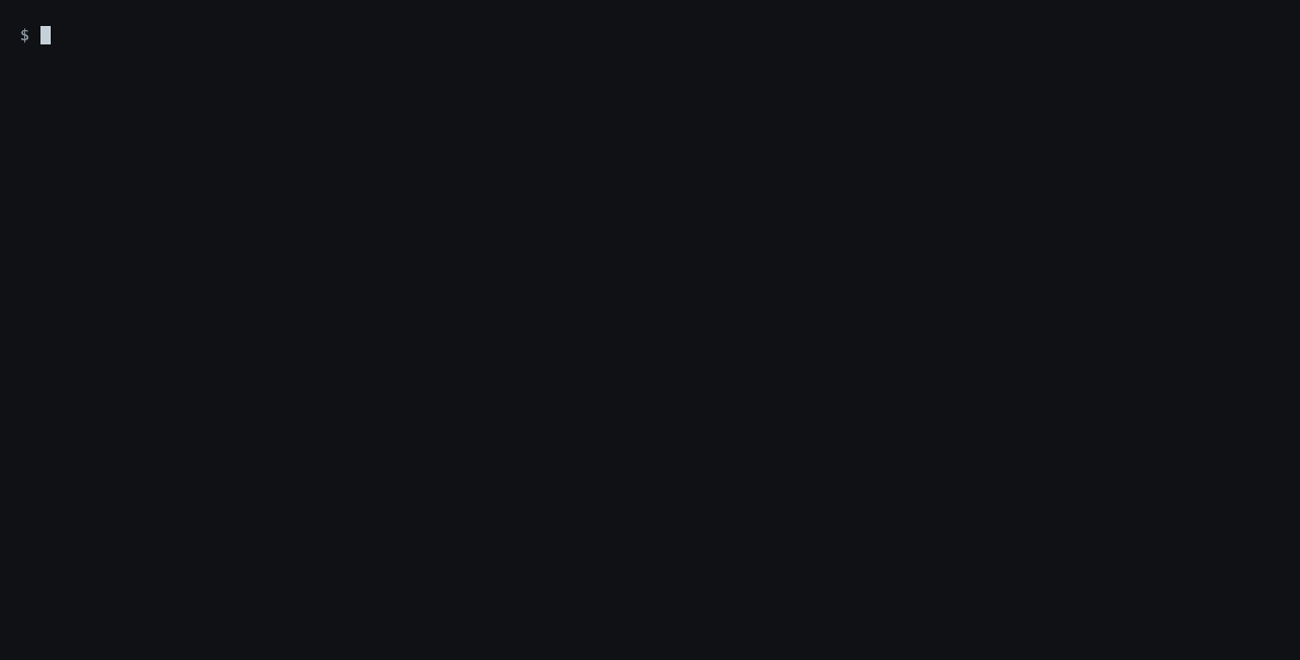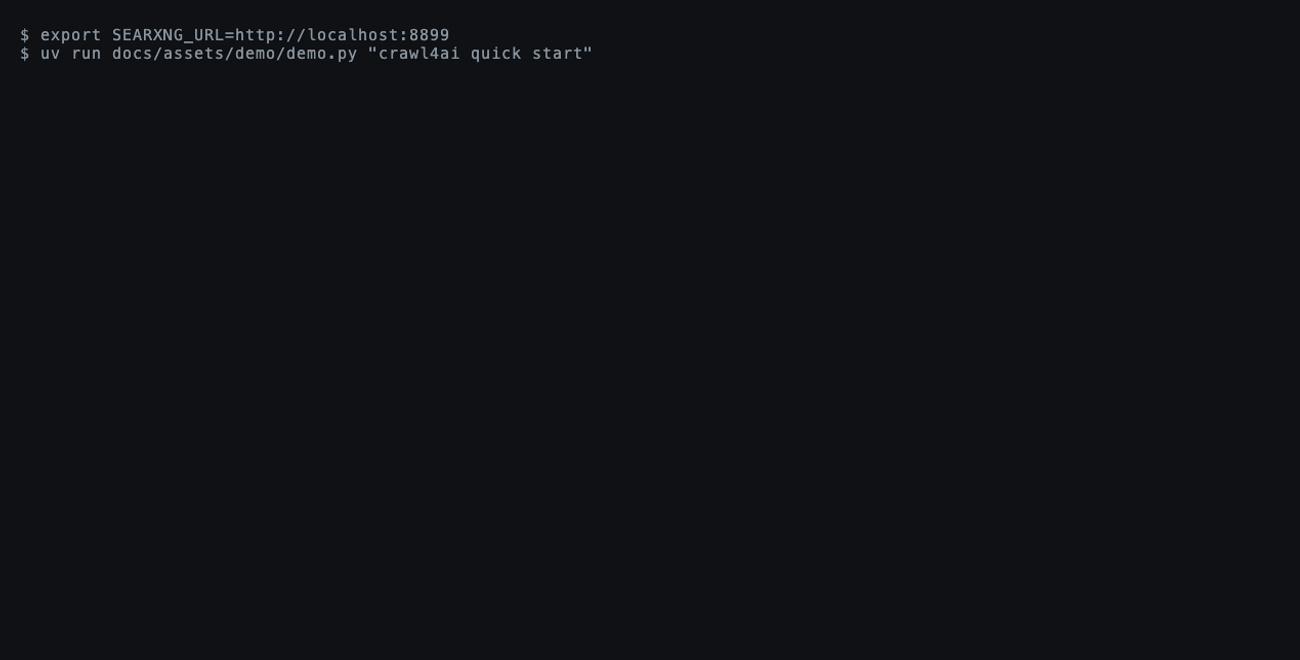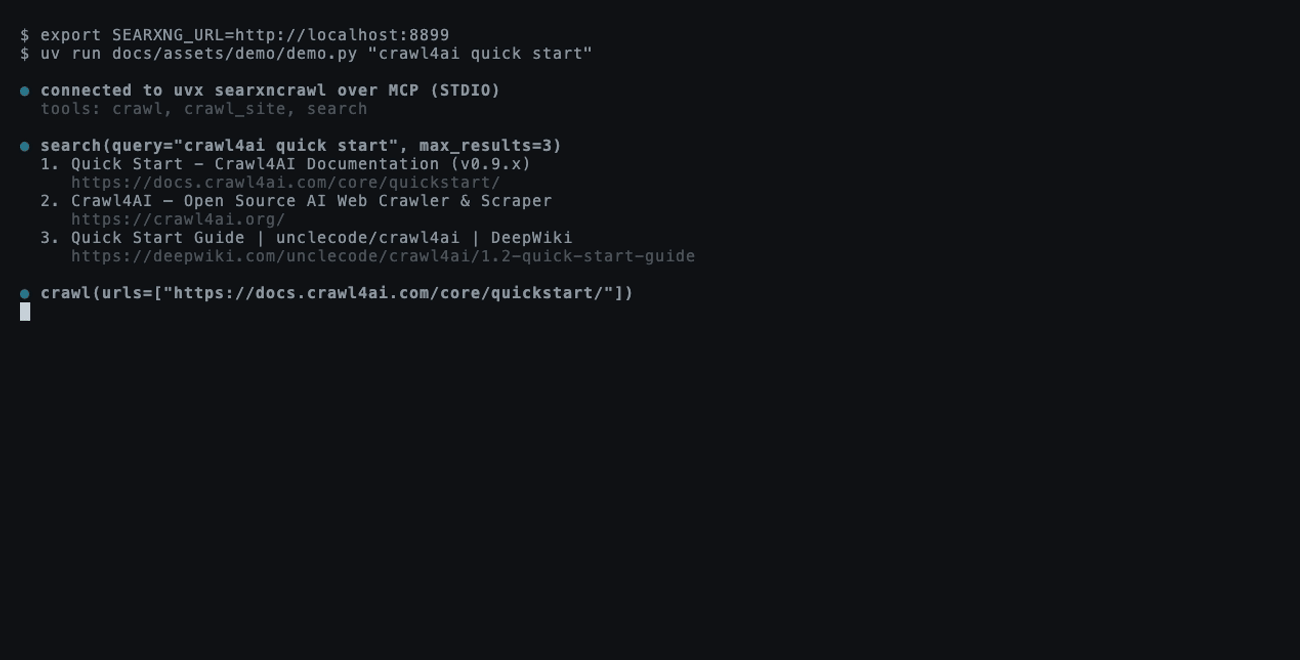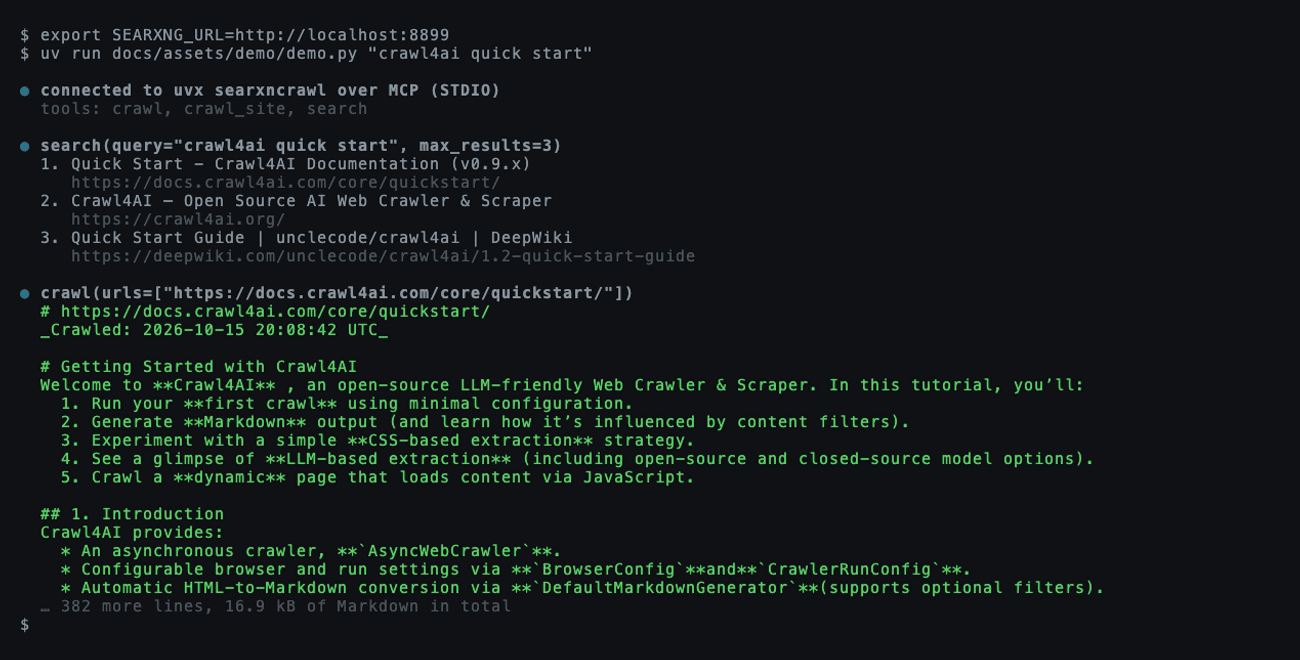
Una sesión real de cliente MCP (fastmcp) contra uvx searxncrawl 0.31.0 y un SearXNG local: search, luego crawl del primer resultado a Markdown. La salida está abreviada para su visualización. Reprodúzcalo con docs/assets/demo/.
searxNcrawl es un servidor MCP de código abierto y un conjunto de herramientas CLI que brinda a los agentes de IA búsqueda web y rastreo limpio a Markdown, construido sobre Crawl4AI. La búsqueda consulta los proveedores configurados, SearXNG y/o You.com, en paralelo y fusiona los resultados. Se ejecuta en su propio hardware, no necesita clave API con SearXNG y tiene éxito searxng-mcp.
| Búsqueda web Su propia instancia de SearXNG y/o la API de You.com, consultadas en paralelo; los resultados se fusionan y se atribuyen a sus proveedores, filtrados por idioma y rango de tiempo. | Rastreo de páginas Una o muchas URL a Markdown o JSON, con bloques repetidos eliminados y enlaces opcionalmente eliminados. | Rastreo de sitios Sitios completos con límites de profundidad y páginas, optimizado para documentación. |
| Rastreos autenticados Capture una sesión de inicio de sesión una vez con crawl-capture, luego rastree detrás del inicio de sesión. | STDIO y HTTP Conéctese a clientes MCP locales, o exponga un endpoint HTTP con protecciones de host y CORS. | CLI y API de Pythoncrawl, search y crawl-capture en la línea de comandos, o impórtelo en Python. |
SEARXNG_URL=http://your-searxng:8888 uvx searxncrawl
Inicio rápido
Necesita uv y, para la herramienta search, al menos un proveedor de búsqueda: una instancia de SearXNG con salida JSON habilitada y/o una clave API de You.com (YDC_API_KEY). ¿Aún no tiene SearXNG? Inicie uno con Docker. El rastreo funciona sin ninguno de ellos.
Añádalo a su agente
Un paso para cada agente en su máquina
uvx searxncrawl setup
setup detecta Claude Code, Codex, Gemini CLI, Cursor, VS Code y Claude Desktop, pregunta por su URL de SearXNG y, opcionalmente, una clave API de You.com (entrada oculta, nunca impresa), muestra cada cambio de configuración y lo aplica solo después de que usted confirme. Cada archivo que toca se respalda primero, y setup --remove lo deshace. Más opciones están en Servidor MCP.
O por agente

Los botones y comandos a continuación asumen SearXNG en http://localhost:8888; cambie SEARXNG_URL si el suyo se ejecuta en otro lugar, o añada YDC_API_KEY para You.com.
Claude Code
claude mcp add searxncrawl --env SEARXNG_URL=http://localhost:8888 -- uvx searxncrawl
Codex
codex mcp add searxncrawl --env SEARXNG_URL=http://localhost:8888 -- uvx searxncrawl
VS Code
code --add-mcp '{"name":"searxncrawl","command":"uvx","args":["searxncrawl"],"env":{"SEARXNG_URL":"http://localhost:8888"}}'
Cursor (~/.cursor/mcp.json), Claude Desktop y otros clientes que usan el formato mcpServers
{
  "mcpServers": {
    "searxncrawl": {
      "command": "uvx",
      "args": ["searxncrawl"],
      "env": { "SEARXNG_URL": "http://localhost:8888" }
    }
  }
}
El primer rastreo descarga el Chromium de Playwright una vez (aproximadamente 550 MB). Para Docker, transporte HTTP y otras configuraciones, consulte Instalación y Servidor MCP.
Pregunte a su agente
Search for the Crawl4AI quick start, crawl the official page and summarise
how to run a first crawl.
Su agente llama a search, elige un resultado y llama a crawl. Recibe Markdown limpio en lugar de HTML sin procesar.
Use la terminal
uvx --from searxncrawl crawl https://modelcontextprotocol.io/docs/getting-started/intro
SEARXNG_URL=http://localhost:8888 uvx --from searxncrawl search "model context protocol" --max-results 5
Cómo funciona
flowchart LR
    agent["AI agent<br/>Claude Code · Codex<br/>Cursor · VS Code"]
    server["searxNcrawl<br/>MCP server"]
    searxng["SearXNG (your instance)<br/>and/or You.com API"]
    browser["Crawl4AI +<br/>Playwright Chromium"]
    results["Merged results<br/>attributed per provider"]
    markdown["Deduplicated<br/>Markdown or JSON"]

    agent -- "MCP · STDIO or HTTP" --> server
    server -- "search" --> searxng --> results
    server -- "crawl · crawl_site" --> browser --> markdown
Los resultados regresan al agente como respuesta de la herramienta. La búsqueda y el rastreo también están disponibles como comandos CLI search y crawl, y el rastreo también como API de Python.
searxNcrawl expone tres herramientas MCP:
| Herramienta | Qué hace |
|---|---|
search | Consulta los proveedores configurados (SearXNG, You.com) en paralelo y devuelve una lista fusionada y deduplicada con la fuente de cada resultado. Filtros: idioma, rango de tiempo, búsqueda segura, paginación; categorías y motores para SearXNG. |
crawl | Renderiza una o muchas URL en Chromium y devuelve Markdown o JSON con metadatos y referencias. |
crawl_site | Sigue enlaces desde una URL semilla dentro de límites de profundidad, páginas y tiempo, optimizado para sitios de documentación. |
Ambas herramientas de rastreo eliminan secciones que se repiten dentro del Markdown de una página (dedup_mode="exact"), pueden eliminar enlaces para un contexto más pequeño (remove_links), y aceptan un storage_state de Playwright para páginas detrás de un inicio de sesión. Los parámetros completos están en la referencia de herramientas MCP.
Por qué searxNcrawl
Las API de búsqueda y rastreo alojadas son rápidas para comenzar, pero cada llamada pasa por el servicio de otra persona y se factura por solicitud o crédito. searxNcrawl se ejecuta en su propia máquina o servidor.
| searxNcrawl | Firecrawl | Tavily | Exa | |
|---|---|---|---|---|
| Búsqueda y rastreo en su hardware | ✅ Paquete Python o Docker; las consultas a You.com van a You.com | ✅ Stack autoalojado (Docker Compose), o API alojada | ❌ API alojada | ❌ API alojada |
| Clave API | No necesaria con SearXNG; You.com necesita una | API alojada: necesaria. Autoalojado: no por defecto | Necesaria | Opcional, el uso anónimo está limitado por tasa |
| Costo por llamada | Ninguno con SearXNG; You.com según sus planes | Alojado: créditos mensuales gratuitos, luego créditos pagados. Autoalojado: ninguno | Créditos mensuales gratuitos, luego créditos pagados | Créditos mensuales gratuitos, luego pago por solicitud |
| Backend de búsqueda | Su SearXNG (los motores que habilite) y/o You.com | Alojado: búsqueda de Firecrawl. Autoalojado: SearXNG si está configurado, si no DuckDuckGo | API de búsqueda de Tavily | Índice de búsqueda de Exa |
| Licencia | MIT | AGPL-3.0 | Servidor MCP MIT, API propietaria | Servidor MCP MIT, API propietaria |
Firecrawl autoalojado también puede buscar a través de SearXNG; se ejecuta como un stack de múltiples servicios (API, servicio Playwright, Redis, RabbitMQ, PostgreSQL y más), mientras que searxNcrawl es un solo proceso Python con Chromium, más su instancia de SearXNG si usa una. Una API compatible con Firecrawl para searxNcrawl está planificada.
Dónde los otros son una mejor opción: si no quiere ejecutar un proveedor de búsqueda y un navegador usted mismo, una API alojada es menos trabajo, y el índice de búsqueda semántica de Exa o las funciones de extracción de Firecrawl van más allá de lo que searxNcrawl hace hoy. Comparación basada en el repositorio público y la documentación de cada proyecto en octubre de 2026; las correcciones son bienvenidas. Firecrawl es una marca comercial de su propietario; searxNcrawl no está afiliado a ella.
Preguntas frecuentes
¿Necesito SearXNG?
Solo para la herramienta search, y solo si no usa You.com (YDC_API_KEY). crawl y crawl_site funcionan sin ningún proveedor de búsqueda. SearXNG sirve HTML solo por defecto, por lo que la salida JSON debe estar habilitada (search.formats en settings.yml). Las instancias públicas pueden no habilitarla y a menudo limitan la tasa de solicitudes automatizadas, así que ejecute la suya propia. Instalación tiene un comando Docker de una línea.
¿Maneja páginas con mucho JavaScript?
Sí. Las páginas se renderizan en el Chromium de Playwright a través de Crawl4AI antes de convertirse a Markdown, por lo que el contenido del lado del cliente se captura.
¿Puede rastrear páginas detrás de un inicio de sesión?
Sí. Capture una sesión una vez con crawl-capture, luego pase el archivo storage_state guardado a crawl o crawl_site. Consulte Captura de sesión.
¿Puedo ejecutarlo de forma remota o compartirlo con un equipo?
Sí. Inícielo con --transport http (puerto 8000 por defecto) o use el stack de Docker Compose (puerto 9555), luego apunte sus clientes MCP a http://<host>:<port>/mcp. Las listas de permitidos de Host y Origin protegen el endpoint; consulte Servidor MCP.
¿Por qué el primer rastreo es lento?
El primer rastreo descarga el Chromium de Playwright (aproximadamente 550 MB en disco). Las ejecuciones posteriores lo reutilizan. Establezca PLAYWRIGHT_AUTO_INSTALL=false donde los navegadores se aprovisionan por separado.
Usé searxng-mcp. ¿Qué cambió?
searxng-mcp está obsoleto en favor de searxNcrawl. Solo buscaba en SearXNG y podía elegir una instancia pública aleatoria; searxNcrawl añade rastreo de páginas y sitios pero necesita su propio SEARXNG_URL (o una clave de You.com), ya que la selección aleatoria de instancias públicas no está incluida.
¿Hay una versión alojada?
Todavía no. searxNcrawl Cloud está planificado; consulte la hoja de ruta.
Hoja de ruta
- API compatible con Firecrawl (planificada): use searxNcrawl como backend de reemplazo para herramientas construidas contra la API de Firecrawl.
- searxNcrawl Cloud (planificado): un endpoint gestionado para equipos que no quieren ejecutar SearXNG y un navegador. Detalles y lista de espera.
Las ideas y votos son bienvenidos en Discusiones.
Documentación
| Guía | Contenido |
|---|---|
| Instalación | uvx, Docker Compose, pip, uv, proveedores de búsqueda y variables de entorno |
| Servidor MCP | Transportes STDIO y HTTP, configuración de clientes, protecciones de Host y CORS |
| Herramientas MCP | Parámetros para crawl, crawl_site y search |
| CLI | crawl, search y crawl-capture |
| API de Python | crawl_page, crawl_site y anulaciones de configuración del rastreador |
| Formatos de salida | Estructura de Markdown y JSON, CrawledDocument |
| Captura de sesión | Rastreo autenticado con una sesión de navegador guardada |
| Registro MCP | server.json y los pasos de publicación |
| Arquitectura | Módulos y funciones para contribuyentes |
Contribuciones
Los informes de errores, las ideas de funciones y las solicitudes de extracción son bienvenidos. Lea la guía de contribución y abra un issue primero para cambios más grandes. Los agentes de codificación encuentran las convenciones del proyecto en AGENTS.md. Reporte vulnerabilidades de forma privada como se describe en la política de seguridad.
Licencia
MIT — © 2026 DDM – Das Digitale Momentum GmbH & Co KG
Mantenido por DDM – Das Digitale Momentum GmbH & Co. KG, Much, Alemania · www.searxncrawl.io · Todos nuestros proyectos de código abierto