CuratorSearch
Empleos en museos, galerías y curaduría recopilados diariamente desde las páginas de carreras de más de 400 instituciones, con cada salario anunciado registrado. Sin autenticación, sin clave.
Servidor MCP alojado
npx add-mcp 'https://curatorsearch.com/mcp'Se instala en Claude Code, Codex, Cursor y más
Documentación
Datos y API
Un registro independiente del empleo en museos y comisariado: vacantes recopiladas a diario desde las páginas de empleo de más de 400 instituciones, y cada salario anunciado se conserva de forma permanente. Cada puesto, institución y salario anunciado en el sitio también está disponible en un formato que un programa o un asistente de IA puede leer. Esta página lo enumera todo, con la frecuencia de actualización, las URL que se deben citar y las solicitudes de atribución.
Consultar el tablero en vivo
- Servidor MCP https://curatorsearch.com/mcp
Un endpoint de Model Context Protocol (HTTP Streamable sin estado, POST) con cuatro herramientas de solo lectura:
search_jobs,get_job,institution_jobsysalary_transparency. Apunta cualquier asistente compatible con MCP a la URL; no se necesita clave. - API JSON https://curatorsearch.com/api/jobs
?q=&category=®ion=&limit=sobre el tablero en vivo, hasta 20 resultados vinculados por llamada; un listado completo en/api/jobs/<slug>. Descrito en openapi.json. Limitado por cliente; envía un User-Agent que nombre tu proyecto. - RSS https://curatorsearch.com/feed.xml
Los puestos más recientes, filtrables exactamente como en el sitio: añade
?category=y/o?region=con los valores utilizados en el tablero. - llms.txt https://curatorsearch.com/llms.txt Una breve descripción en texto plano del sitio para modelos de lenguaje, con la cifra que vale la pena citar calculada de nuevo en cada solicitud. llms-full.txt contiene todos los puestos activos en un solo archivo, agrupados por categoría.
Descargar los datos
- Archivo de Salarios Curatoriales https://curatorsearch.com/data/curatorial-salaries.csv Cada salario anunciado que el tablero ha llevado desde agosto de 2026, exactamente como se indicó — moneda, rango, período de pago, categoría, institución, ubicación. También como JSON. Identificador persistente: DOI 10.5281/zenodo.22544232 (siempre resuelve a la instantánea más reciente). Espejos en GitHub, figshare y Hugging Face.
- Índice de Transparencia Salarial en Museos https://curatorsearch.com/pay-transparency-index Instituciones clasificadas por la proporción de sus propias publicaciones que indicaron un salario, más una tabla por país; recalculado por solicitud, marcado ItemList + Dataset. Las filas en sí están en CSV y JSON; el JSON incluye su propio método, advertencia y línea de cita.
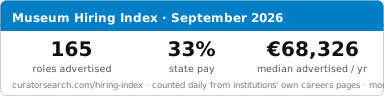
- Índice de Contratación en Museos https://curatorsearch.com/hiring-index Mensual: puestos anunciados, proporción que indica pago, mediana anualizada. Los meses pasados son definitivos y nunca cambian; el mes actual se acumula a diario. Una tarjeta SVG en vivo en /hiring-index.svg.
- Insignia incrustable https://curatorsearch.com/embed Un recuento de puestos abiertos o una tasa de transparencia salarial en vivo para cualquier sitio o intranet.
- Mapa del sitio https://curatorsearch.com/sitemap.xml Cada página indexable: puestos, instituciones, ciudades, páginas de salarios y comparaciones, y las ediciones de los índices.
Datos estructurados en las propias páginas
Cada página de puesto lleva JobPosting de schema.org con salario estructurado cuando se indica y una fecha validThrough; cuando un puesto se cierra, la página permanece en línea como registro, pero el marcado deja de presentarlo como abierto. Las páginas de instituciones declaran Organization y un CollectionPage que enumera los puestos abiertos. /salaries es un Dataset, /faq un FAQPage. Los tableros en alemán y neerlandés están vinculados mediante hreflang.
Con qué frecuencia cambia
Todas las fuentes se revisan una vez al día a las 06:00 UTC. Un puesto se marca como cerrado después de dos ejecuciones diarias consecutivas en las que ya no se encuentre. Los recuentos, las medianas y la tasa de transparencia salarial se calculan en cada solicitud a partir del tablero actual — nunca se almacenan en caché —, por lo que una cifra que leas es actual a la fecha indicada en la página. El método completo está en Acerca de y metodología.
Qué URL citar
Las páginas de puesto, /opportunities/<slug>, son permanentes. Las instituciones viven en /institutions/<slug>, las ciudades en /cities/<slug>, las páginas de salarios en /salaries/<slug>. Las vistas de categoría y región son /?category= y /?region=. La búsqueda (?q=) y las vistas de ordenación son estados de interfaz — noindex —, así que enlaza a la faceta, no a una búsqueda.
Atribución
El Archivo de Salarios Curatoriales y el Índice de Contratación se publican bajo CC BY 4.0: libres para cualquier propósito, con atribución. Cita como “CuratorSearch Curatorial Pay Archive, curatorsearch.com/salaries” con la fecha, o por DOI 10.5281/zenodo.22544232. Para el método en forma citable: Samman, N. (2026). How often do museum job postings state pay? A data note from one month of live listings, August–September 2026. Zenodo. https://doi.org/10.5281/zenodo.22791747.
Las descripciones de los puestos pertenecen a las instituciones que las redactaron. Enlaza a la página del puesto en lugar de republicar el texto.
Rastreo
Los motores de búsqueda y los principales rastreadores de asistentes son bienvenidos y el mapa del sitio está completo. Los raspadores masivos que republican listados están bloqueados en robots.txt y en el borde. Si ejecutas un servicio que necesita el feed completo en lugar de la API pública, escribe a support@curatorsearch.com — existe un feed de socio con clave para ese fin.